

基于 NVIDIA GB10 的桌面 AI 系统只有一个任务,而且它们出色地完成了这项任务:将 128GB 的统一内存和 1 petaflop 的计算能力放在离用户足够近的桌面上,实现即时迭代。但它们缺少的是与组织现有存储的连接。每个 DGX Spark 和 OEM 版本都配备一个短的 M.2 插槽,这限制了本地容量约为 4TB,并将机器上的所有数据集、模型和检查点都置于数据中心的治理、访问控制、备份和审计跟踪之外。如果这种情况发生在实验室、部门或园区,就会产生数十个孤立的 4TB 数据孤岛,每个孤岛都存储着相同模型和数据集的副本,而每个孤岛的安全性都取决于它所放置的桌面。
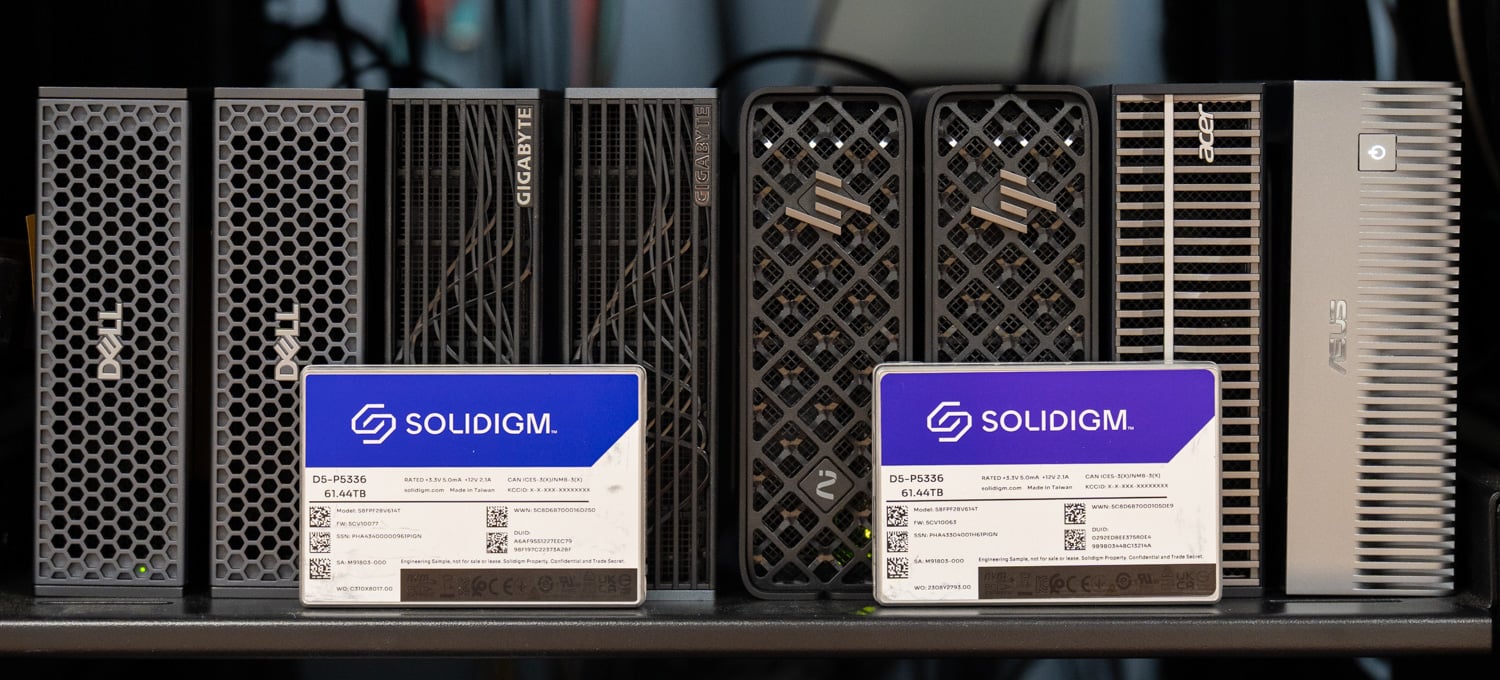
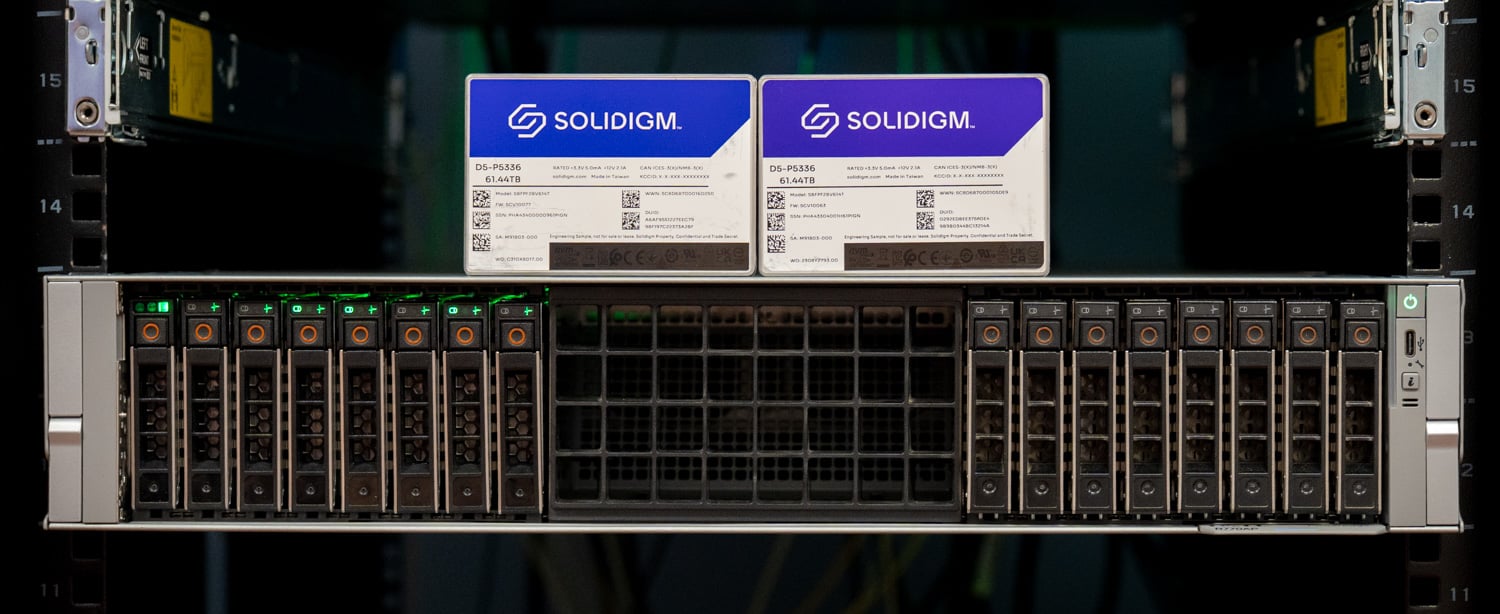
这个项目将存储问题重新带回数据中心。我们用一台戴尔 PowerEdge R770AP 服务器搭建了一个 DGX Spark 共享存储主机,配备了八块 Solidigm D5-P5336 QLC SSD 固态硬盘(采用 Graid SupremeRAID RAID 5 阵列)、博通 400GbE 网卡以及 Tuxera Fusion 服务(通过 RDMA 提供 NFS 服务),然后将八块 Spark 存储设备连接到其 100GbE 端口。每个 Spark 存储设备都通过一条线路挂载同一个受控的、奇偶校验保护的存储池;每个模型和数据集的单个副本供所有设备使用,工作站无需超出其自带的存储空间,而且 Spark 存储设备本身可以放置在阵列旁边的机架中,便于安全维护、散热和共享。这个方案的关键在于数据存储的位置,任何配备高速网卡的 NVMe 服务器都可以胜任这项工作。俄勒冈州立大学正在探索一个用于人工智能学习的大规模 Spark 实验室,并希望让学生能够访问数十 TB 的研究数据集。在我们设计构建方案时,该大学与我们分享了他们的想法。对于如此大规模的数据,共享存储是适合本次评估的方法。
关键精华
- 一个阵列,八个 Spark,无需客户端软件: 来自五个 OEM 厂商的八个 DGX Spark 设备,通过 Graid SupremeRAID 和 Tuxera Fusion 后面的单个 Solidigm D5-P5336 QLC 阵列,利用它们已有的 100GbE 端口,在标准的 Ubuntu 系统上通过一行挂载命令,挂载 NFS/RDMA 共享。
- 托管模型的加载方式与本地模型相同: 一台 Spark 从共享阵列加载 78GB Qwen3.5-122B-A10B-NVFP4 模型耗时 269.6 秒,比同一台 Spark 从其内部 NVMe 加载所需时间 239.6 秒缩短了 13%。八台 Spark 同时加载同一单个副本,完成时间为 232.8 到 326.5 秒。
- 每张办公桌上放一份,就能取代一个资料筒: 模型和数据集存储在受管控且具备奇偶校验保护的数据中心存储上,取代了工作站上每台 4TB M.2 固态硬盘上的副本,从而提高了存储利用率,减少了数据复制,而且 Spark 无需升级存储或占用桌面空间。对于像俄勒冈州立大学正在探索的那种大型人工智能学习实验室(其研究数据集高达数十 TB),这种方法在我们评估中最适合其用例。
- 硬盘容量决定了性能上限,而网络还有提升空间: 八个 Spark 设备同时读取数据时,八盘位 RAID 5 阵列的读写速度接近 25GiB/s,约合 214Gb/s,这占用了主机中两块 Broadcom BCM57608 网卡 800Gb/s 带宽的 27%。单个 Spark 设备从该阵列读取数据的速度为 10.8GiB/s,与我们在 GB10 系统中测得的最快内置 M.2 接口速度相当。
- 治理与协议密不可分: 带有 RDMA 的 NFS 将每个用户的文件夹、共享数据集和托管模型放在一个命名空间中,并带有 Active Directory、Kerberos 和 LDAP 钩子,这使得数据能够在 Spark 移入机架的同时保持在数据中心的控制之下。
每张办公桌上都摆放一个人工智能岛的问题
DGX Spark及其来自戴尔、技嘉、惠普、宏碁和华硕的OEM版本均采用GB10平台,存储容量上限也相同。在我们最初的DGX Spark评测中,存储容量是该平台最明显的瓶颈。其内置插槽仅支持短款M.2固态硬盘,因此标配的8TB 2280规格固态硬盘无法安装。我们在8月份评测的Luisuantech GP Spark解决了这个问题,它通过一个四盘位M.2外置硬盘盒连接到一个100GbE网口,对于一台桌面上的Spark来说,这是一个简洁的解决方案;而在实验室规模下,则相当于每张桌面上都配备了一个更大的存储模块。
容量问题只占一半;另一半在于数据一旦到达桌面电脑后会发生什么。一个78GB的模型被下载到Spark服务器上,IT人员根本看不到这个副本。一个研究数据集被暂存在本地闪存上,这意味着它不受备份计划、访问策略和机构审计的约束。实验室里的十台Spark服务器意味着十份相同的权重数据副本,占用了780GB的闪存空间,而这些空间原本可以用于其他用途;同时,数据集也可能随着机器被带出十个不同的位置。随着设备数量的增加,问题会变得更加严重,无论是GB10系统还是任何桌面AI基础设施。每个管理过大量笔记本电脑的组织都了解这种模式,而当时的解决方案也是一样的:将数据保存在数据中心的共享存储上,让终端设备仅仅作为终端设备使用。
值得庆幸的是,NVIDIA 在 Spark 的设计中预留了足够的端口来实现这一点。每个 Spark 单元都集成了 ConnectX-7 芯片,并配备两个 QSFP56 插槽,通过一对 PCIe Gen5 x4 链路提供高达 200Gb 的可用带宽。在我们的DGX Spark 集群评测中,我们介绍了一种角色分离配置,其中一个插槽连接到对等 Spark 单元,另一个用于存储。本项目为每个 Spark 单元使用一个 100GbE 存储插槽,第二个插槽则可用于集群或其他扩展带宽。在 100GbE 带宽下,每个 Spark 单元到存储主机的理论带宽约为 12.5GB/s,这超过了大多数此类系统内置 M.2 插槽提供的带宽。
一旦数据存储在链路的另一端,Spark 的角色就发生了变化。它变成了一个计算端点,配备启动盘和本地缓存盘,容量不再是按工作站单独购买的。模型或数据集只需写入一次,即可被所有客户端读取,因此存储利用率提高,副本数量减少。数据保护转移到服务器机箱内的奇偶校验保护阵列,访问控制、静态加密、备份和审计等功能也与其它功能一样,在现有系统中运行。由于 Spark 现在只需要电源和 100GbE 链路,因此完全没有必要放在桌面上。将其安装在存储主机旁边的机架上,可以降低温度、减少噪音、增强物理安全性,并随时供其他用户使用。
存储主机
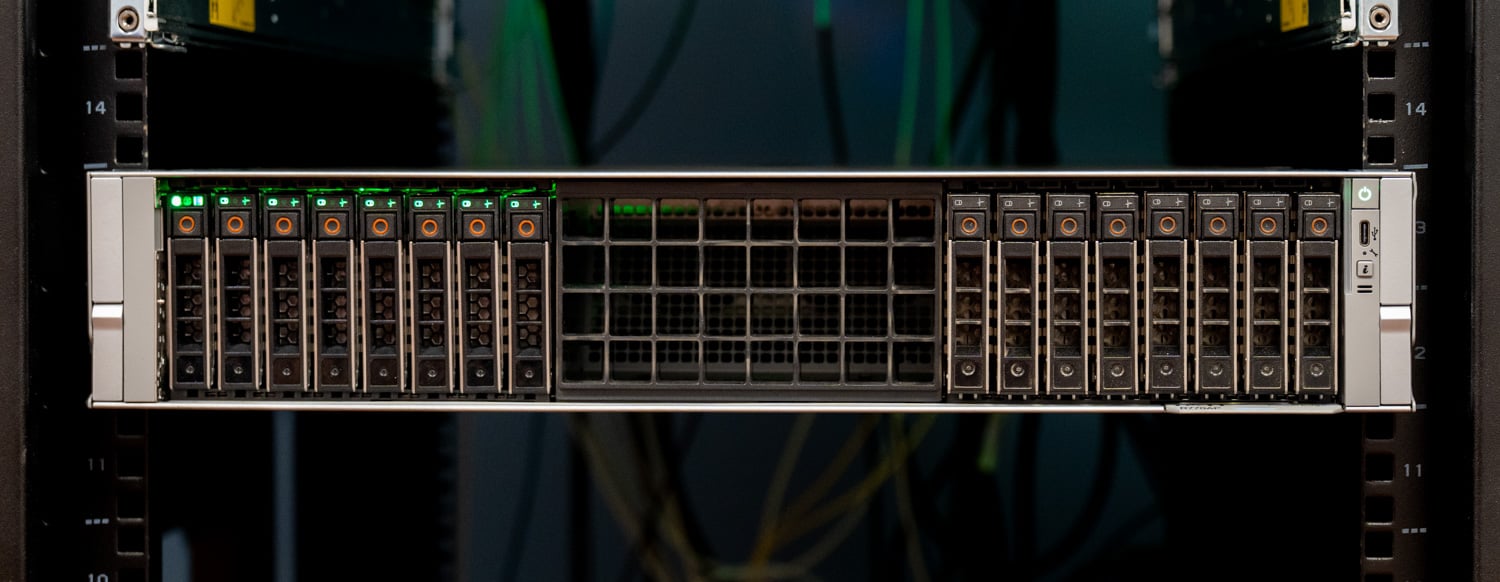
存储主机是一台戴尔 PowerEdge R770AP,也就是我们今年早些时候评测过的那款 2U Xeon 6 平台。之所以选择它,是因为项目开始时实验室里正好有一台空着的。任何配备高速网卡和小型 GPU 的 NVMe 服务器都可以胜任这项工作,R770AP 就是其中一种选择,尽管配置略高。我们的这台服务器搭载了两颗 Xeon 6 6978P 处理器,24 个 DIMM 插槽共 1.5TB DDR5 内存,使用了其两组 8 个 Gen5 NVMe 硬盘位中的一组,并将硬盘和 Graid GPU 连接到 CPU 0,两个 400GbE 网卡连接到 CPU 1。服务器运行的是 Ubuntu 24.04 操作系统。
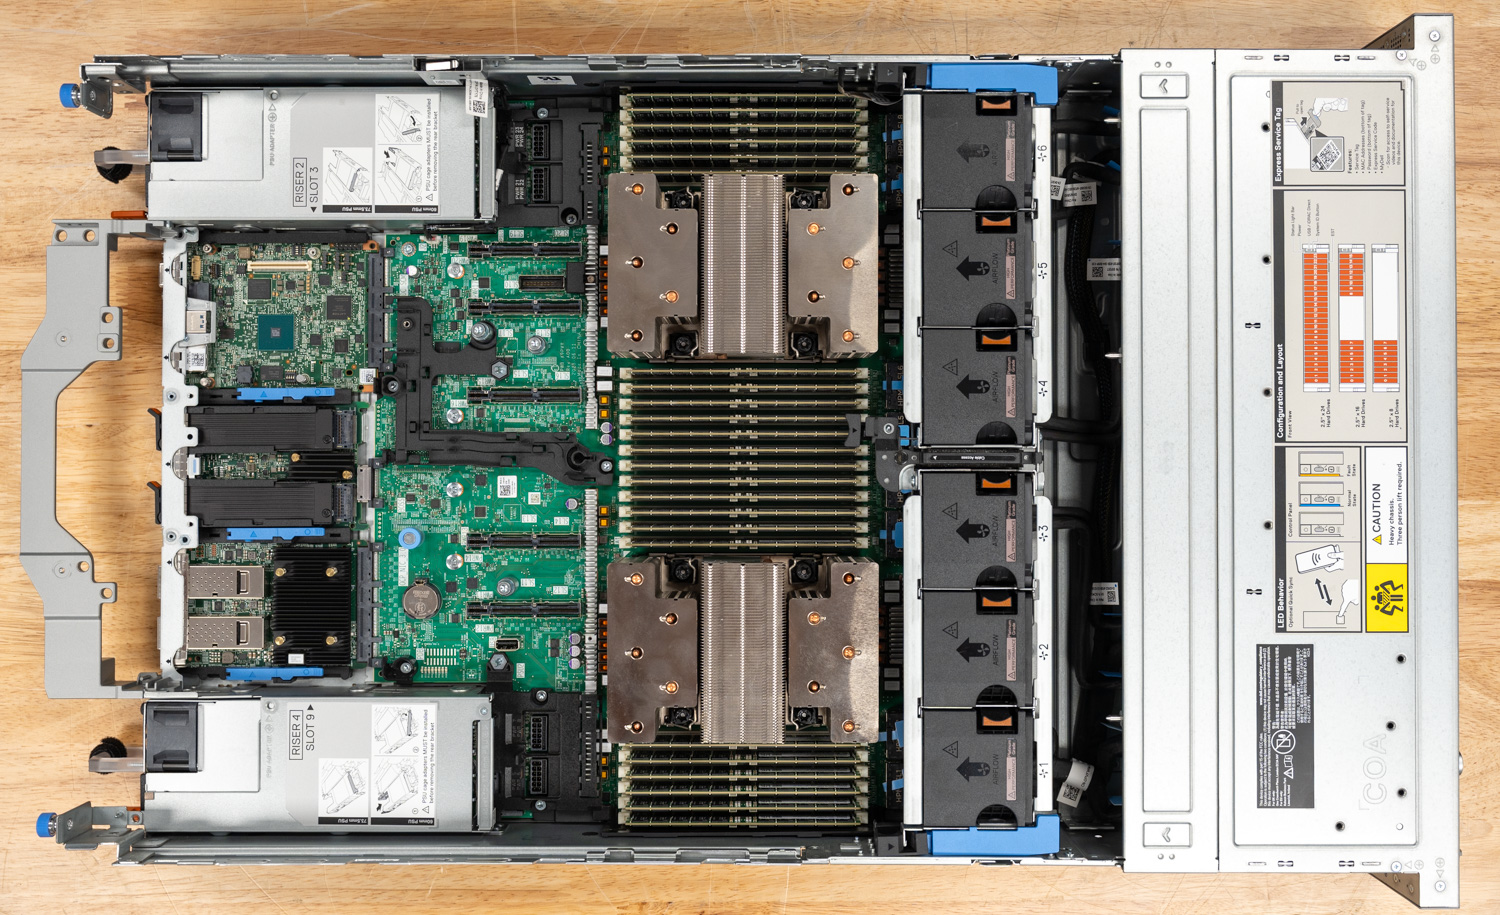
| 元件 | 存储主机配置 |
|---|---|
| 服务器 | 戴尔 PowerEdge R770AP,2U,16 个 2.5 英寸 Gen5 NVMe 硬盘位 |
| 中央处理器 | 2 个 Intel Xeon 6 6978P 处理器 |
| 内存 | 1.5TB DDR5 (24x 64GB) |
| 存放 | 8 个 Solidigm D5-P5336 61.44TB U.2 PCIe 4.0 QLC(491.52TB 原始) |
| 的RAID | Graid SupremeRAID,所有八个硬盘均采用 RAID 5 模式,CPU 0 搭载 NVIDIA RTX A2000 GPU。 |
| 文件系统 | SupremeRAID 虚拟驱动器上的 XFS |
| 文件服务器 | Tuxera Fusion(Fusion NFS,私有预览版),基于 RDMA 的 NFS 4.1(端口 20049 上的 RPC-RDMA),用户模式 |
| 社交 | 2 个 Broadcom BCM57608 (Thor 2) 单端口 400GbE 网卡,PCIe Gen5 x16 接口,位于 CPU 1 上,支持 RoCEv2。 |
| Switch 开关 | 戴尔 PowerSwitch Z9864F-ON,64 个 800GbE OSFP112 端口,企业级 SONiC |
| 客户链接 | 800G 光纤端口分接成 8 个 100GbE 端口,每个 Spark 设备使用一条链路,每个存储网卡连接四个 Spark 设备,分别位于不同的 VLAN 上。 |
| 客户 | 2 台戴尔 Pro Max(配备 GB10 处理器)、2 台技嘉 AI TOP Atom 处理器、2 台惠普 ZGX Nano G1n 处理器、1 台宏碁 Veriton GN100 处理器、1 台华硕 Ascent GX10 处理器 |
| OS | Ubuntu的LTS 24.04 |
为什么选择QLC,以及为什么选择D5-P5336
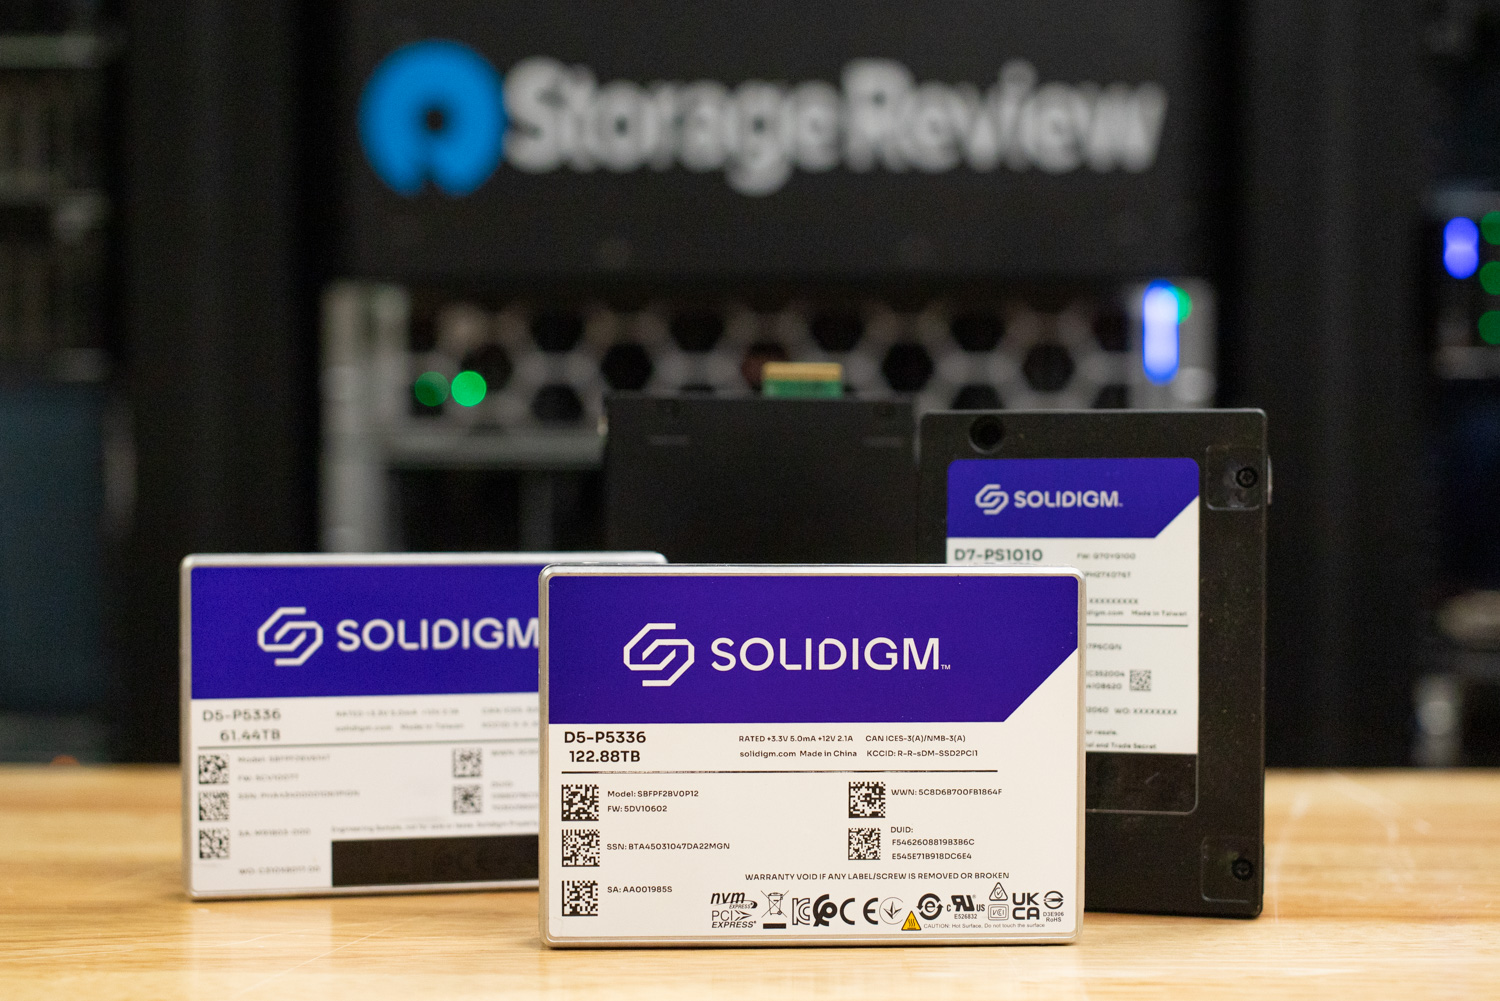
在与俄勒冈州立大学讨论Spark实验室概念时,容量是首要考虑因素,因为涉及的研究数据集非常庞大。这台服务器的任务是存储一屋子Spark程序可能需要的所有数据,并以可供多个客户端同时读取的形式提供这些数据。这是一个读取密集型、大块、高容量的应用场景,而这正是QLC闪存的强项。D5 -P5336系列容量从7.68TB到122.88TB不等;这里使用的61.44TB U.2固态硬盘,经Solidigm公司评测,顺序读取速度高达7,000MB/s,顺序写入速度高达3,000MB/s,4K随机读取IOPS高达1.005万,耐久性高达65.2PBW(相当于五年内每天写入0.58次),采用192层QLC NAND闪存,并配备16KB间接单元。
八块 61.44TB 的硬盘占据了 R770AP 前面板一半的硬盘位,而实际生产环境中,用户可以选择该系列中任意容量的硬盘,并根据需要选择任意数量的硬盘位。即便如此,八块硬盘组成 RAID 5 阵列也能提供约 430TB 的可用空间,并具备单盘容错能力。这比 Spark 的 M.2 插槽容量高出 100 多倍,足以满足一个部门的模型库、学生共享的数据集以及每个用户的主目录的需求。如果将剩余的八个硬盘位也装满,容量就能翻倍,而无需更改网络设计。本文稍后将展示硬盘容量扩展的优势。
对于这种工作负载而言,16KB 的间接单元至关重要,因为 Solidigm 更大的间接单元虽然提高了存储密度和成本,但却牺牲了小随机写入的效率。而对于用于存储模型和数据集的共享存储来说,小随机写入只是少数情况。模型加载是大量的顺序读取操作。数据集流式传输也是大量的顺序读取操作。检查点和学生文件只需写入一次,即可频繁读取。由此产生的分工对于 Spark 实验室来说是合适的:共享的 QLC 阵列存储所有被多个进程读取的数据,而 Spark 自身的 M.2 接口则处理单个进程写入的临时数据和交换数据。
GPU 上的 RAID:Graid SupremeRAID
在八块第四代 NVMe 硬盘上构建 RAID,每块硬盘的读取速度均为 7,000MB/s,此时传统硬件 RAID 卡就会成为瓶颈,因为每个字节都必须通过卡的 PCIe 插槽传输。软件 RAID 则面临着不同的资源挑战。Graid SupremeRAID 将奇偶校验计算卸载到 GPU 上,并将数据传输路径保持在主机 PCIe 通道上,因此我们在SupremeRAID AE 测试中使用 16 块硬盘时,速度可以扩展到 180GB/s 以上。在本测试中,我们使用 NVIDIA RTX A2000(一款小型工作站 GPU)运行 SupremeRAID。
八块 D5-P5336 硬盘在交付给 Graid 之前,均经过安全擦除并按顺序填充,然后配置成一个 RAID 5 阵列。生成的虚拟硬盘采用 XFS 文件系统格式化,并由 Tuxera 提供服务。RAID 5 非常适合这种共享场景:即使一块硬盘发生故障,阵列也能保持在线;重建过程不会中断用户数据;容量损失仅为八分之一的硬盘。对于更注重重建窗口保护而非容量的生产环境部署,RAID 6 或 RAID 10 也是合理的选择,而 SupremeRAID 同时支持这两种级别。
网络架构:博通 400GbE 和 800G 核心网
该网络架构的存储端由R770AP中的两块博通BCM57608 Thor 2网卡组成,每块网卡都是一个单端口400GbE网卡,采用PCIe Gen5 x16接口。博通将BCM57608定位为业界功耗最低的400G网卡,其功能特性也使其非常适合该架构:支持RoCEv2增强型DCQCN拥塞控制、自适应路由、基于硅信任根的安全启动以及内联kTLS加密卸载。RoCEv2在该设计中通过RDMA传输NFS数据,拥塞控制功能可防止多个客户端同时拉取数据时相互干扰。在构建过程中,bnxt_en驱动程序报告称,在持续负载下,400G端口上的光模块温度达到了70℃的警告阈值。我们通过对R770AP的风扇转速进行小幅调整解决了这个问题,之后网卡运行正常。
两块网卡都连接到我们实验室的 800G 核心交换机Dell PowerSwitch Z9864F-ON上,该交换机运行企业级 SONiC 协议。Z9864F-ON 提供 64 个 800GbE OSFP112 端口,并可将其中任意端口扩展为 2 个 400G、4 个 200G 或 8 个 100G。其中一块 800G 光模块扩展为 8 个 100G 端口,将八个 Spark 存储设备分别连接到同一交换机,该交换机也负责终止两个 400G 存储链路。每块 400G 网卡位于独立的 VLAN 中,服务于四个 Spark 存储设备,因此存储主机提供两个 RDMA 目标,负载按设计均匀分配到这两个目标上。实际上,这是一个全速率拓扑:一侧有 8x100G 的客户端带宽,另一侧有 2x400G 的存储带宽,中间有一个容量为 102.4Tbps 的交换机。
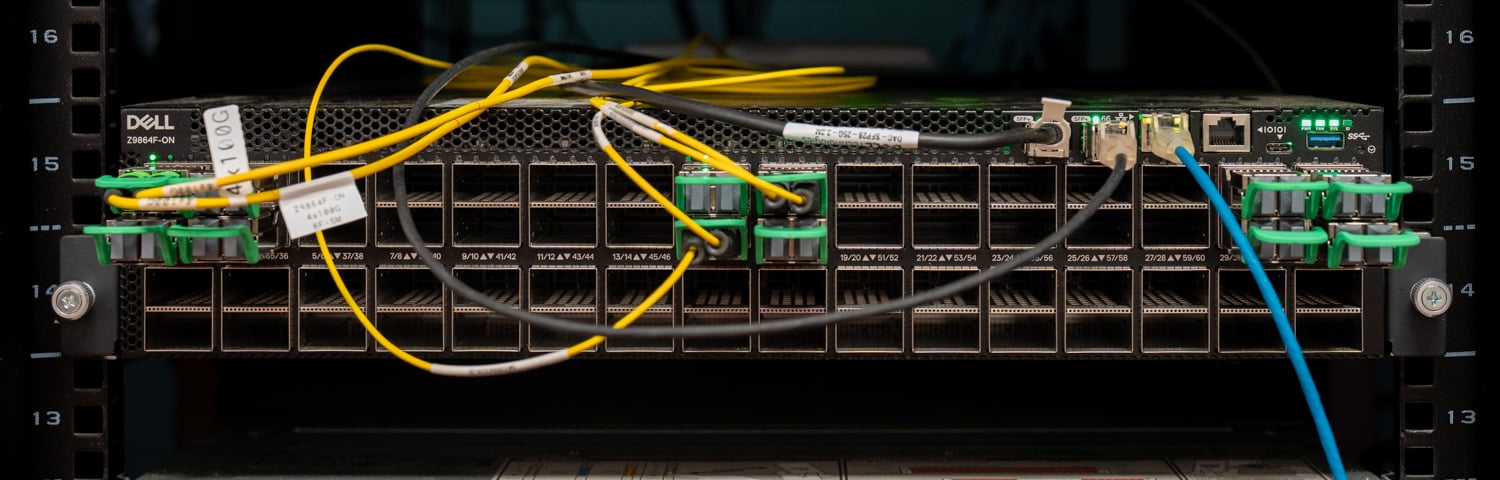
在任何存储软件接入网络之前,我们对网络架构进行了验证。R770AP 与另一台主机之间通过 400G 链路进行的服务器间测试显示,双向传输速率均达到线速;来自 Spark 的 RDMA 流量也证实了 100G 分支端口能够全速运行。Tuxera 的工程师配置好 NFS 共享后,我们使用 iperf3 对 Spark 到各自网卡的传输进行了测试,结果显示四个并行数据流能够稳定传输 99Gbps 的数据,且无重传。
为什么选择 NFS,以及为什么选择 Tuxera
Graid 提供了一种高速块设备,存储主机可以将 Spark 用作 NVMe-oF 块目标或文件共享。我们在 GP Spark 评测中测试了块路径,它对单个客户端运行良好。但对于拥有多个 Spark 的实验室来说,我们需要不同的方案。块卷是一对一的;每个用户都需要一个 LUN,一旦两个用户想要访问相同的数据集,就需要进行复制,而这正是我们整个设计旨在解决的问题。NFS 位于维恩图的中心:单个命名空间可以容纳共享数据集、托管模型和每个用户的文件夹。每个 Spark 挂载点都使用 Ubuntu 中已有的 NFS 客户端,而且大学在 Spark 实验室上部署的 Kubernetes 和 Slurm 工具也都支持 NFS。
Fusion NFS是 Tuxera Fusion 的 NFS 部分,Tuxera Fusion 是一款多协议文件服务器,在单个用户模式多线程核心上支持 SMB 和 NFS;我们最早在2024 年与 Solidigm 和 Tuxera 合作的媒体工作流项目中接触到了 Fusion SMB。Tuxera声称,在单条 200GbE 连接上使用 RDMA 时,其传输速度最高可达 22.7GB/s,高于内核 NFSD 和 Ganesha(根据 Tuxera 自身的测试)。该产品支持 NFS 4.1、主动-主动横向扩展集群、透明故障转移以及 Active Directory、Kerberos 和 LDAP 集成。最后一点是治理机制:控制用户登录 Spark 的同一目录也控制着他们对共享资源的访问权限。需要注意的是,本文中提到的所有 Tuxera 数据都存在一个前提条件:我们运行的版本是 Fusion NFS 的内部预览版,Tuxera 表示该版本尚未针对性能进行全面优化,并且该软件尚未正式上市。正式版计划于 2026 年 11 月 SC'26 之后发布。
Tuxera 在 R770AP 上安装了 Fusion,使用 XFS 格式化了 Graid 卷,并在标准端口上配置了 NFS,在 20049 端口上配置了 RPC-RDMA,由于本项目仅使用 NFS,因此未配置 SMB 监听器。初始线程配置为四个协议线程,每个协议线程包含八个线程,分别用于传输发送和接收、VFS 数据以及 VFS 元数据,Tuxera 将其描述为调优的起点。实验室版本特意省略了目录服务;大学部署将在其基础上叠加自己的身份服务。在 Spark 端,挂载共享只需一条命令:
sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs
这一行代码就包含了全部的客户端集成,无需驱动程序、启动器配置,也无需在 Spark 上安装任何厂商软件。明天,另一个用户登录到另一个 Spark 实例,运行同样的代码,就能看到相同的文件。
配置验证:八个 Spark 算法运行于同一数据集
在进行任何模型构建工作之前,我们对每个 Spark 实例分别进行了健全性检查:使用 16 个作业,队列深度为 16,对阵列上各自的文件夹进行 10.0 万次顺序 fio 读取。这八个实例的读取速度在 100 到 11.2 GiB/s 之间,每个实例都达到了 100GbE 链路的饱和状态。然后,我们进行了一次全面测试,以验证所有八个实例都能胜任各自的负载。每次测试都保持 16 个线程,队列深度为 16,并将它们分别分配到 1、2、4 和 8 个 Spark 实例上,进行 100 万次顺序读取、64 万次随机读取、16 万次顺序读取和 4 万次随机读取的工作负载测试,包括读写操作和直接 I/O,每次测试持续 60 秒。每个 Spark 实例都写入阵列上各自的文件夹,每个存储网卡对应四个文件夹,并且整个堆栈中没有任何 QoS 设置。在所有八个Spark节点同时加载的情况下,每个节点的100万次顺序读取性能在3.09至3.13GiB/s之间,64万次随机读取性能在6,648至6,779 IOPS之间,4千次随机写入性能在2,136至2,155 IOPS之间。测试涵盖了来自五个OEM厂商的资源,分布在两个VLAN上,且未强制执行公平性策略。每个Spark节点都已接入阵列,并获得了均衡的资源分配,配置已准备就绪,可以应对重要的工作负载。
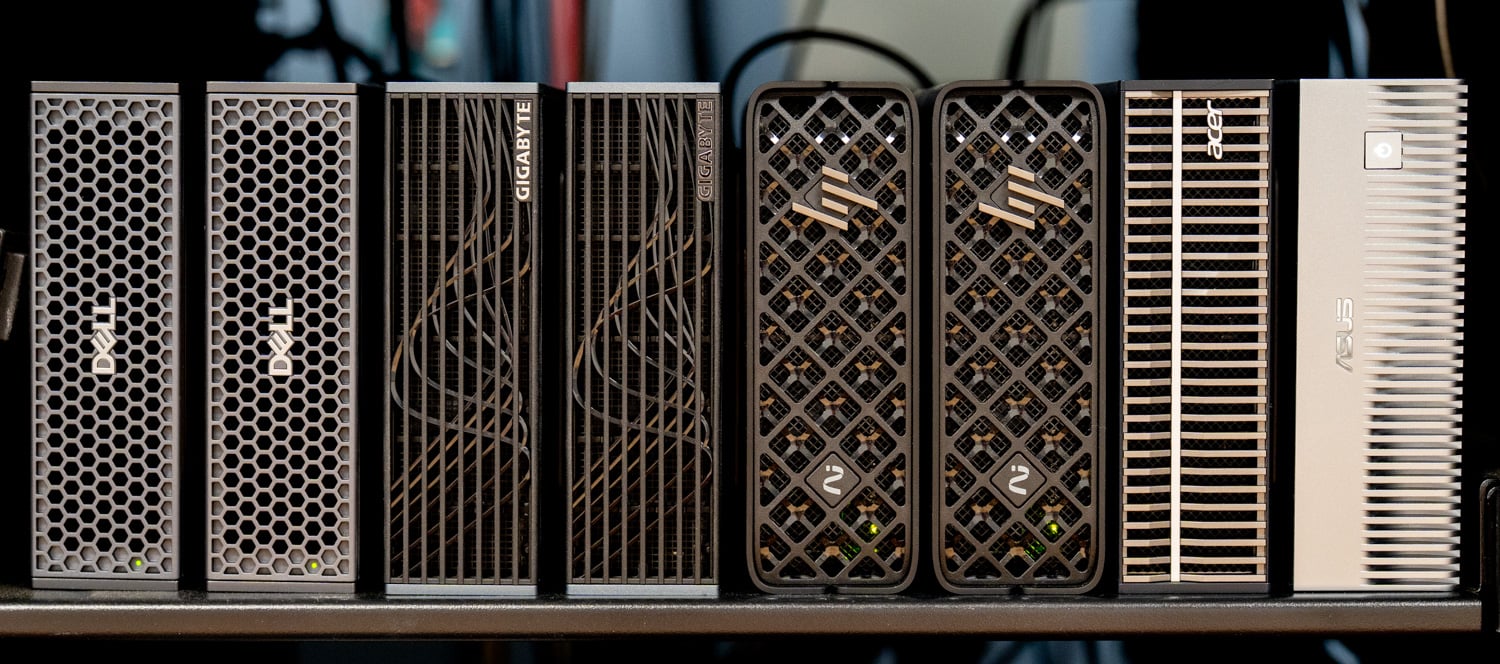
| Spark(八个客户端,每个客户端 2 个线程 x QD16) | 存储网卡 | 1M顺序读取 | 64K 随机读取 IOPS | 4K 随机读取 IOPS | 4K随机写入IOPS |
|---|---|---|---|---|---|
| 戴尔 Pro Max 带 GB10 (1) | 1 | 3,176MiB/秒 | 6,648 | 10,000 | 2,150 |
| 技嘉 AI TOP ATOM (1) | 1 | 3,195MiB/秒 | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | 3,201MiB/秒 | 6,696 | 10,100 | 2,136 |
| 宏碁Veriton GN100 | 1 | 3,194MiB/秒 | 6,670 | 10,100 | 2,149 |
| 戴尔 Pro Max 带 GB10 (2) | 2 | 3,184MiB/秒 | 6,694 | 10,200 | 2,155 |
| 技嘉 AI TOP ATOM (2) | 2 | 3,187MiB/秒 | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | 3,189MiB/秒 | 6,678 | 10,100 | 2,151 |
| 华硕Ascent GX10 | 2 | 3,163MiB/秒 | 6,734 | 10,300 | 2,145 |
主机配置:两个网卡,并留有足够的余量
同样的测试也能解答实验室或企业在购买前必须解决的问题:性能上限在哪里?以及主机的哪个部分决定了性能上限?下面的四个面板展示了在固定负载从一个 Spark 扩展到八个的情况下,所有四种工作负载的读取吞吐量;写入吞吐量将在下文的文本和表格中进行介绍。
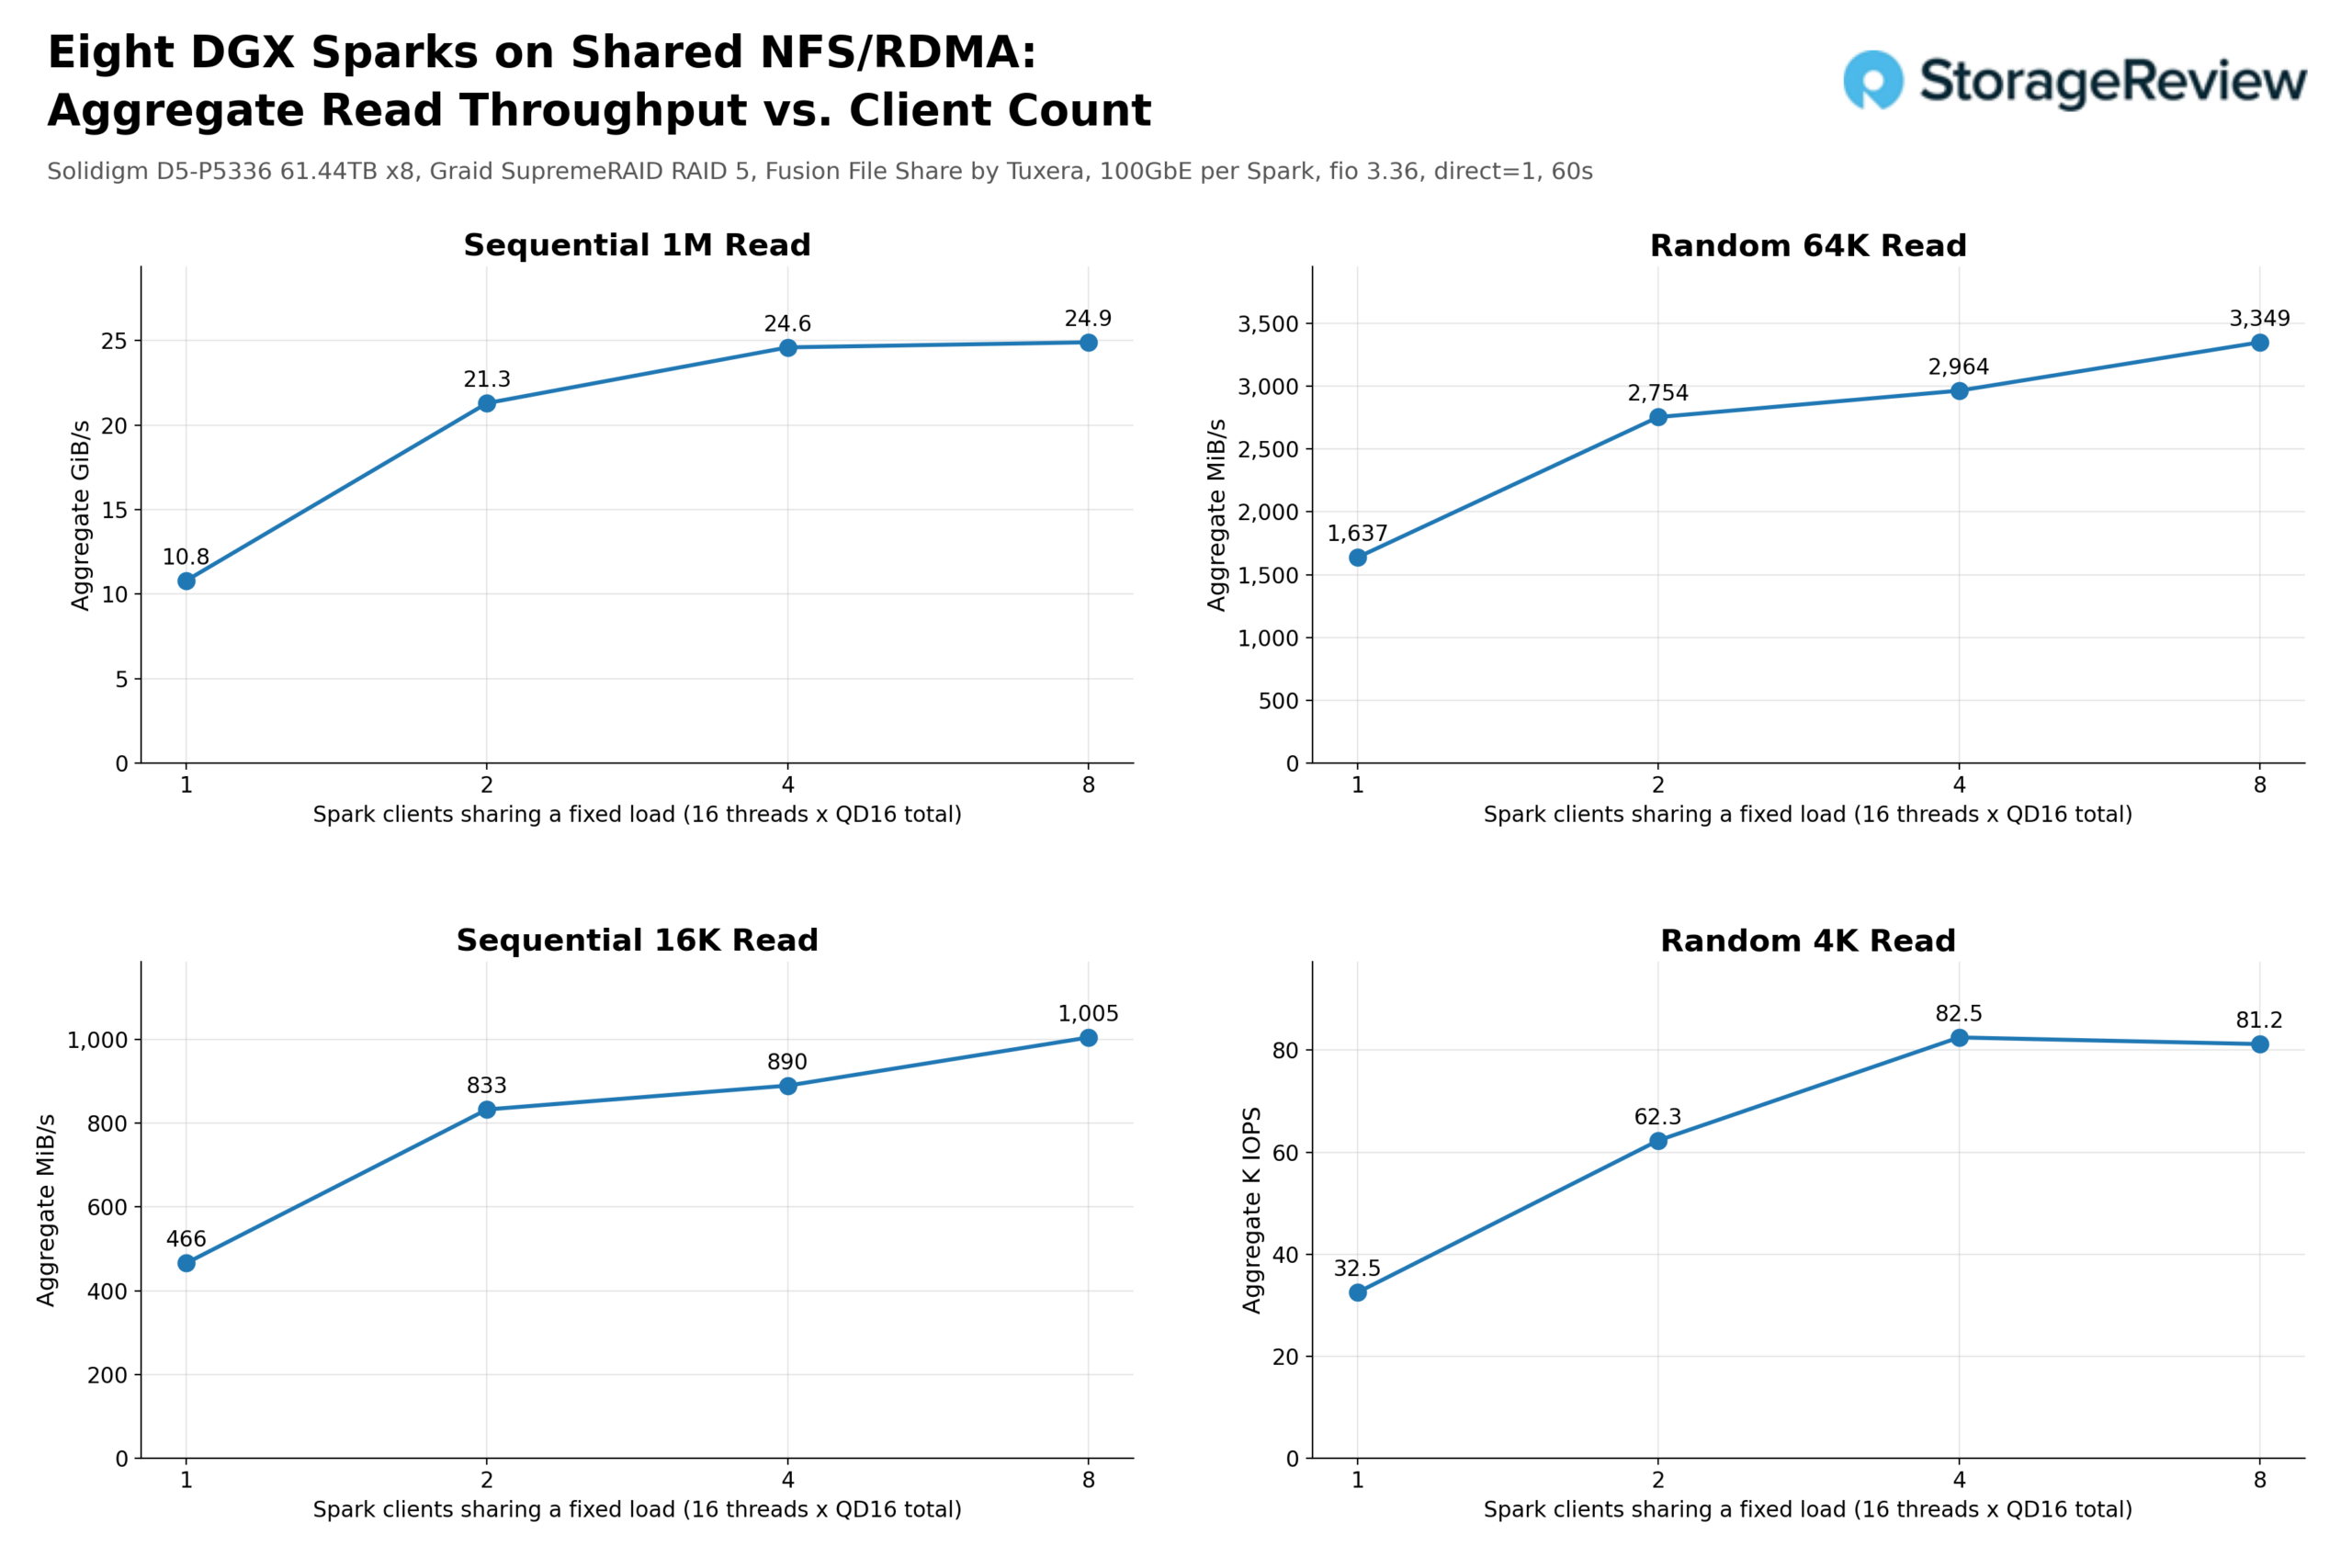
聚合 1M 顺序读取速度从单台 Spark 上的 10.8GiB/s 提升至两台 Spark 上的 21.3GiB/s、四台 Spark 上的 24.6GiB/s 以及八台 Spark 上的 24.9GiB/s。换算成网络带宽,分别为 93Gb/s、183Gb/s、212Gb/s 和 214Gb/s,而两块 Broadcom 400GbE 网卡的总带宽为 800Gb/s。因此,在满负荷运行八个客户端的情况下,该阵列使用了主机 27% 的网络容量。接近 25GiB/s 的峰值速度属于八盘 RAID 5 QLC 阵列;网卡、交换机以及 Spark 自身的 100GbE 链路从未成为瓶颈。
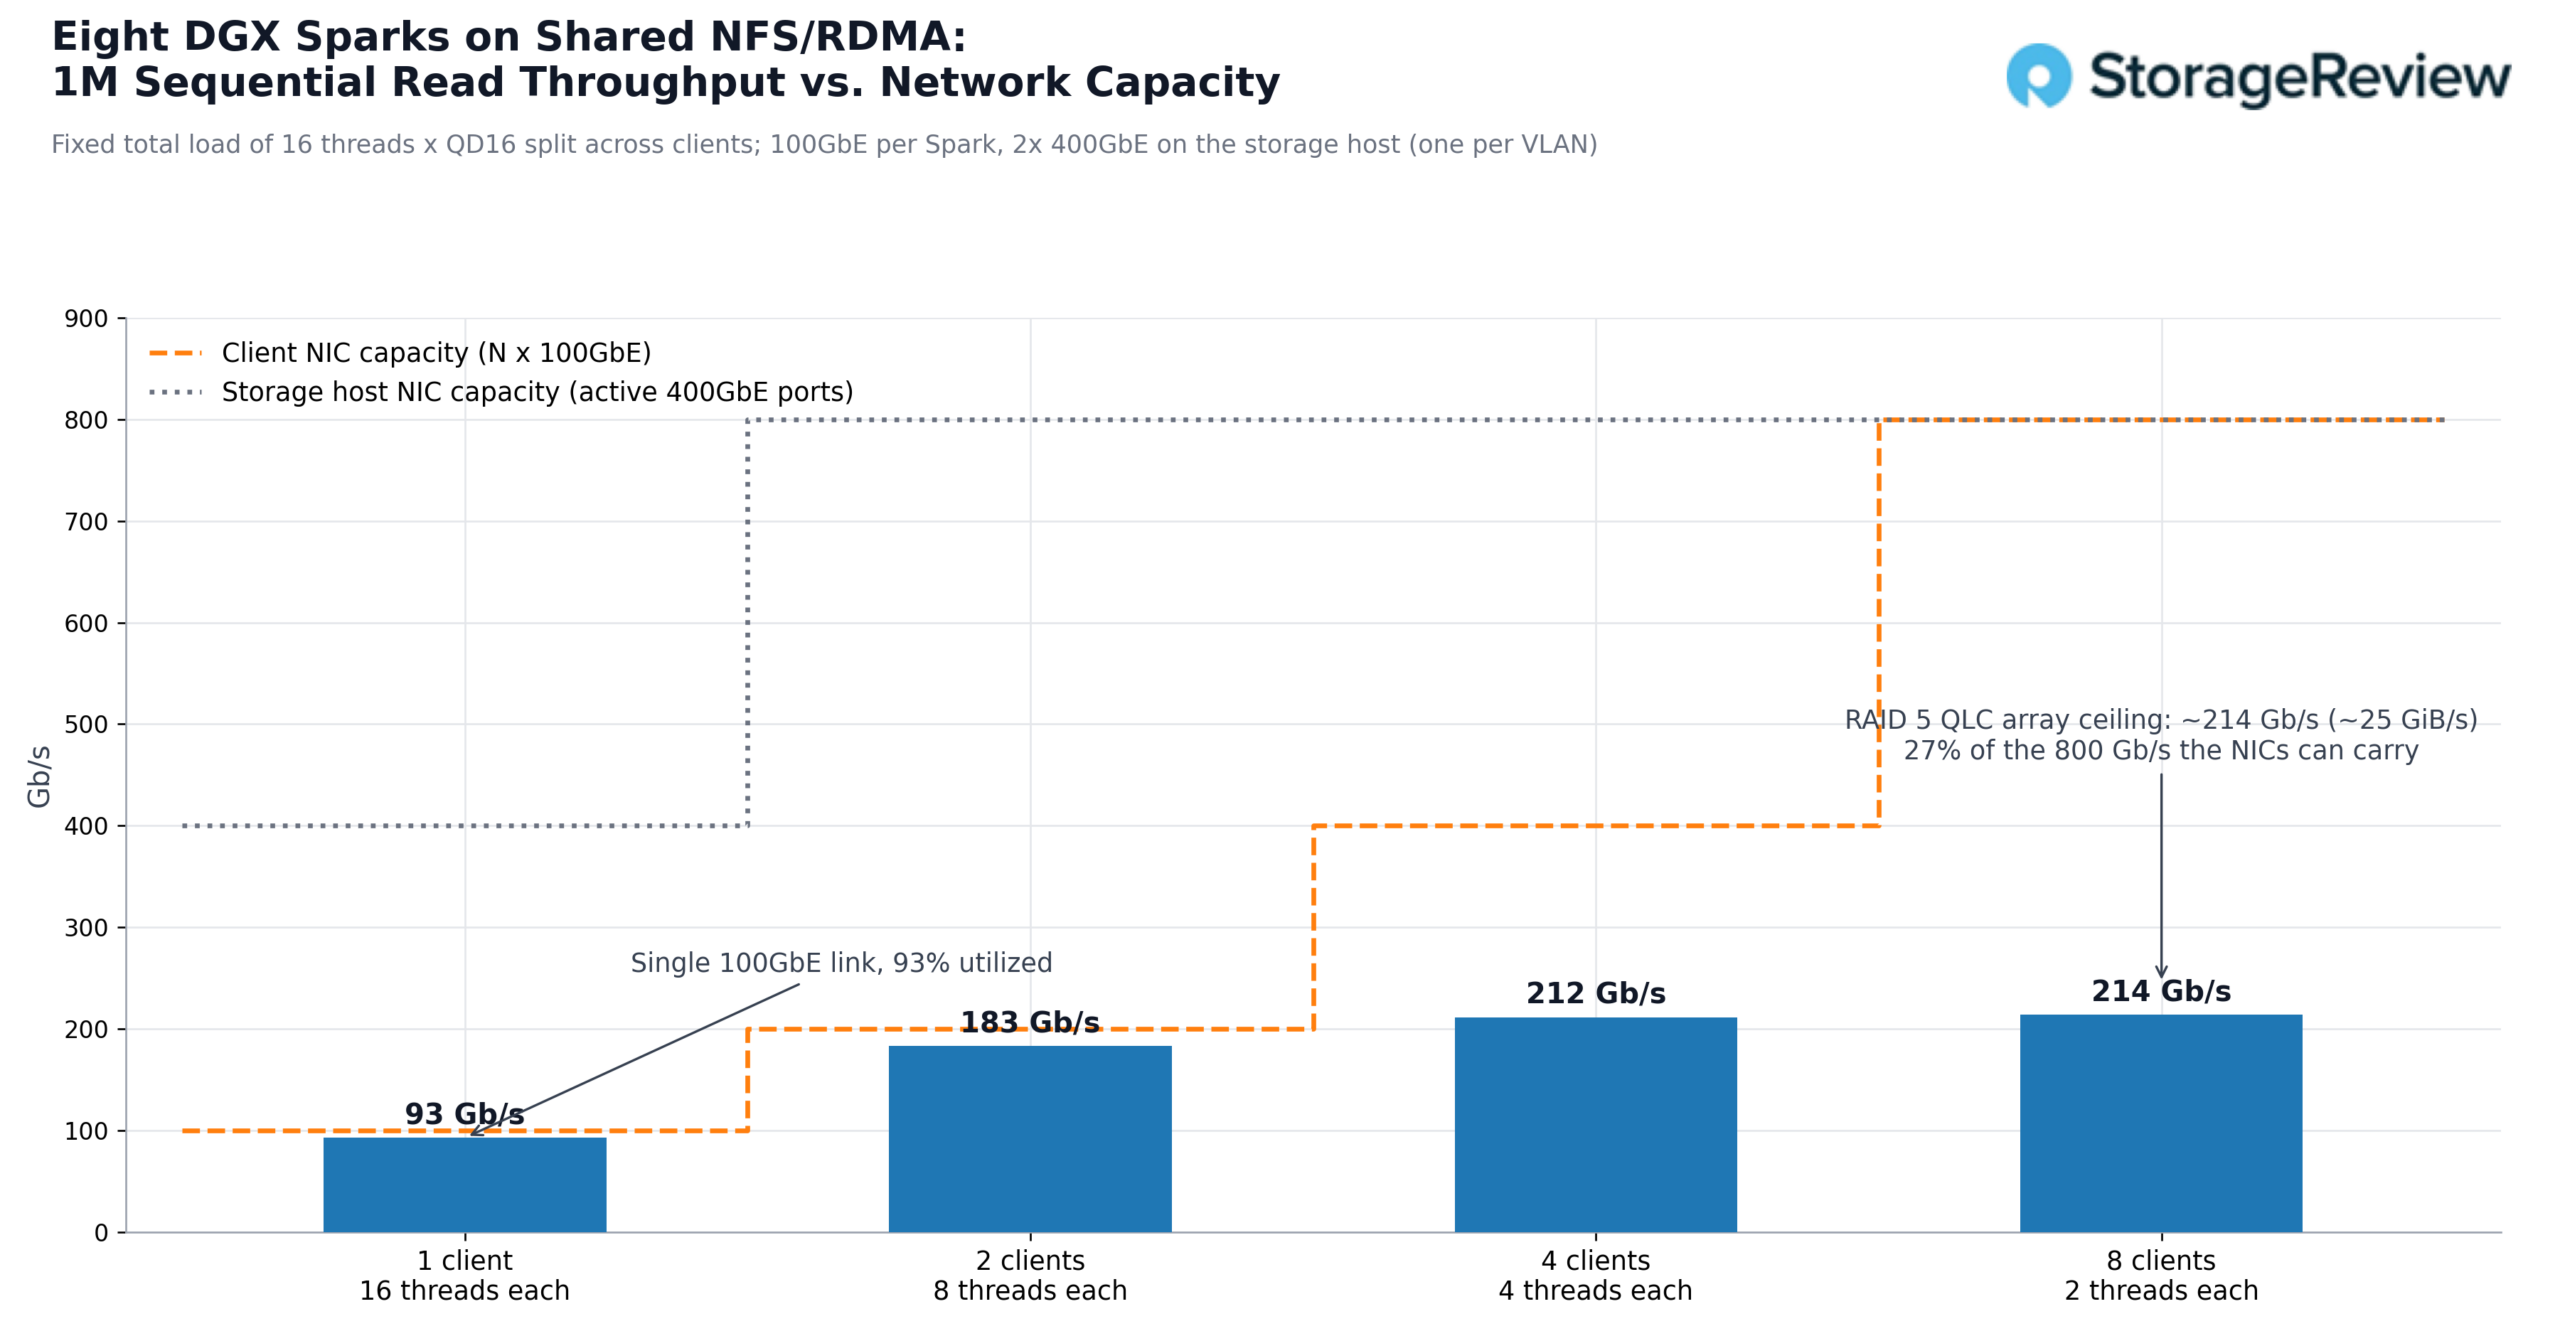
两块服务器端网卡已经能够以线速覆盖八块 Spark 硬盘,并且也能覆盖 R770AP 中的另外八个硬盘位:无论是作为第二个阵列还是扩展 RAID 集,硬盘数量翻倍都能在相同的两个端口后提供更大的读取带宽,并且还有剩余带宽。I/O 性能也同样如此。4K 随机读取的性能从单个客户端的 32.5K IOPS 提升到四个或更多客户端时稳定的约 81K IOPS,随着每个客户端队列深度的减小,每次 I/O 操作的延迟从 7.9 毫秒降至 3.1 毫秒;64K 随机读取的性能从 1,637 MiB/s 提升到 3,349 MiB/s,在这两种情况下,网络带宽都远未达到极限。
另一个重要的比较是与 Spark 自身存储的对比。在我们单独评测 GB10 时,使用 GDSIO 从内置 M.2 接口读取 1M 字节数据,Acer Veriton GN100 和 GIGABYTE AI TOP ATOM 的读取速度最高接近 11.2GiB/s。配备 GB10 的 Dell Pro Max 和 HP ZGX Nano G1n 的读取速度约为 5.5GiB/s,而 ASUS Ascent GX10 的读取速度接近 5GiB/s。相比之下,Luisuantech GP Spark 的外置 NVMe-oF 固态硬盘通过相同的 100GbE 端口实现了 9.5Gb/s 的读取速度。Spark 从共享的 QLC 阵列读取数据的速度为 10.8GiB/s,与该组中速度最快的内置硬盘相当,并且大约是速度最慢的内置硬盘的两倍(通过单根网线读取),而其他所有 Spark 都能读取这些数据。由于测试工具不同:内置硬盘使用 GDSIO,而 Spark 通过 NFS 使用 fio,因此这是一个速度范围的比较。
完整的测试结果如下所示,其中包含了每种客户端数量下所有四种工作负载的汇总数据。每行读取操作数都会随着客户端数量的增加而增加,直到阵列达到容量上限;而每行写入操作数则保持不变,无论 Spark 客户端数量是 1 还是 8,因为 RAID 5 奇偶校验路径都会将阵列的写入上限固定,而与共享该阵列的客户端数量无关。对于一个旨在被多个客户端读取并在数据摄取时写入一次的共享阵列来说,这正是该设计的目标场景。
| 总计(共 16 个线程) | 1 Spark | 2个火花 | 4个火花 | 8个火花 |
|---|---|---|---|---|
| 1M顺序读取 | 10.8GiB/秒 | 21.3GiB/秒 | 24.6GiB/秒 | 24.9GiB/秒 |
| 1M顺序写入 | 2.4GiB/秒 | 2.4GiB/秒 | 2.4GiB/秒 | 2.4GiB/秒 |
| 64K 随机读取 | 1,637MiB/秒 | 2,754MiB/秒 | 2,964MiB/秒 | 3,349MiB/秒 |
| 64K 随机写入 | 722MiB/秒 | 719MiB/秒 | 723MiB/秒 | 703MiB/秒 |
| 16K 顺序读取 | 466MiB/秒 | 833MiB/秒 | 890MiB/秒 | 1,005MiB/秒 |
| 16K 顺序写入 | 57MiB/秒 | 60MiB/秒 | 62MiB/秒 | 28MiB/秒 |
| 4K 随机读取 | 32.5K IOPS | 62.3K IOPS | 82.5K IOPS | 81.2K IOPS |
| 4K 随机写入 | 17.8K IOPS | 17.7K IOPS | 17.5K IOPS | 17.2K IOPS |
共享存储上的托管模型
fio 扫描结果证明阵列和网络完全能够胜任。接下来对用例至关重要的测试是,位于共享阵列上的模型加载速度是否与位于 Spark 自身 NVMe 上的模型加载速度相同,因为整个设计依赖于这种工作流程:集中托管的单个副本,可供任何用户加载。我们选择了 NVFP4 中的 Qwen3.5-122B-A10B 模型,这是一个拥有 122 亿参数的混合专家模型,占用 78GB 磁盘空间,可以加载到单个 Spark 的 128GB 统一内存中。我们测量了从启动推理服务器到服务器报告运行正常所需的时间,以及该时间段内的平均存储带宽,并分别在三种场景下进行测试:单个 Spark 从其内部 NVMe 加载;同一个 Spark 通过 NFS/RDMA 从共享阵列加载;以及所有八个 Spark 同时从阵列加载同一个副本。
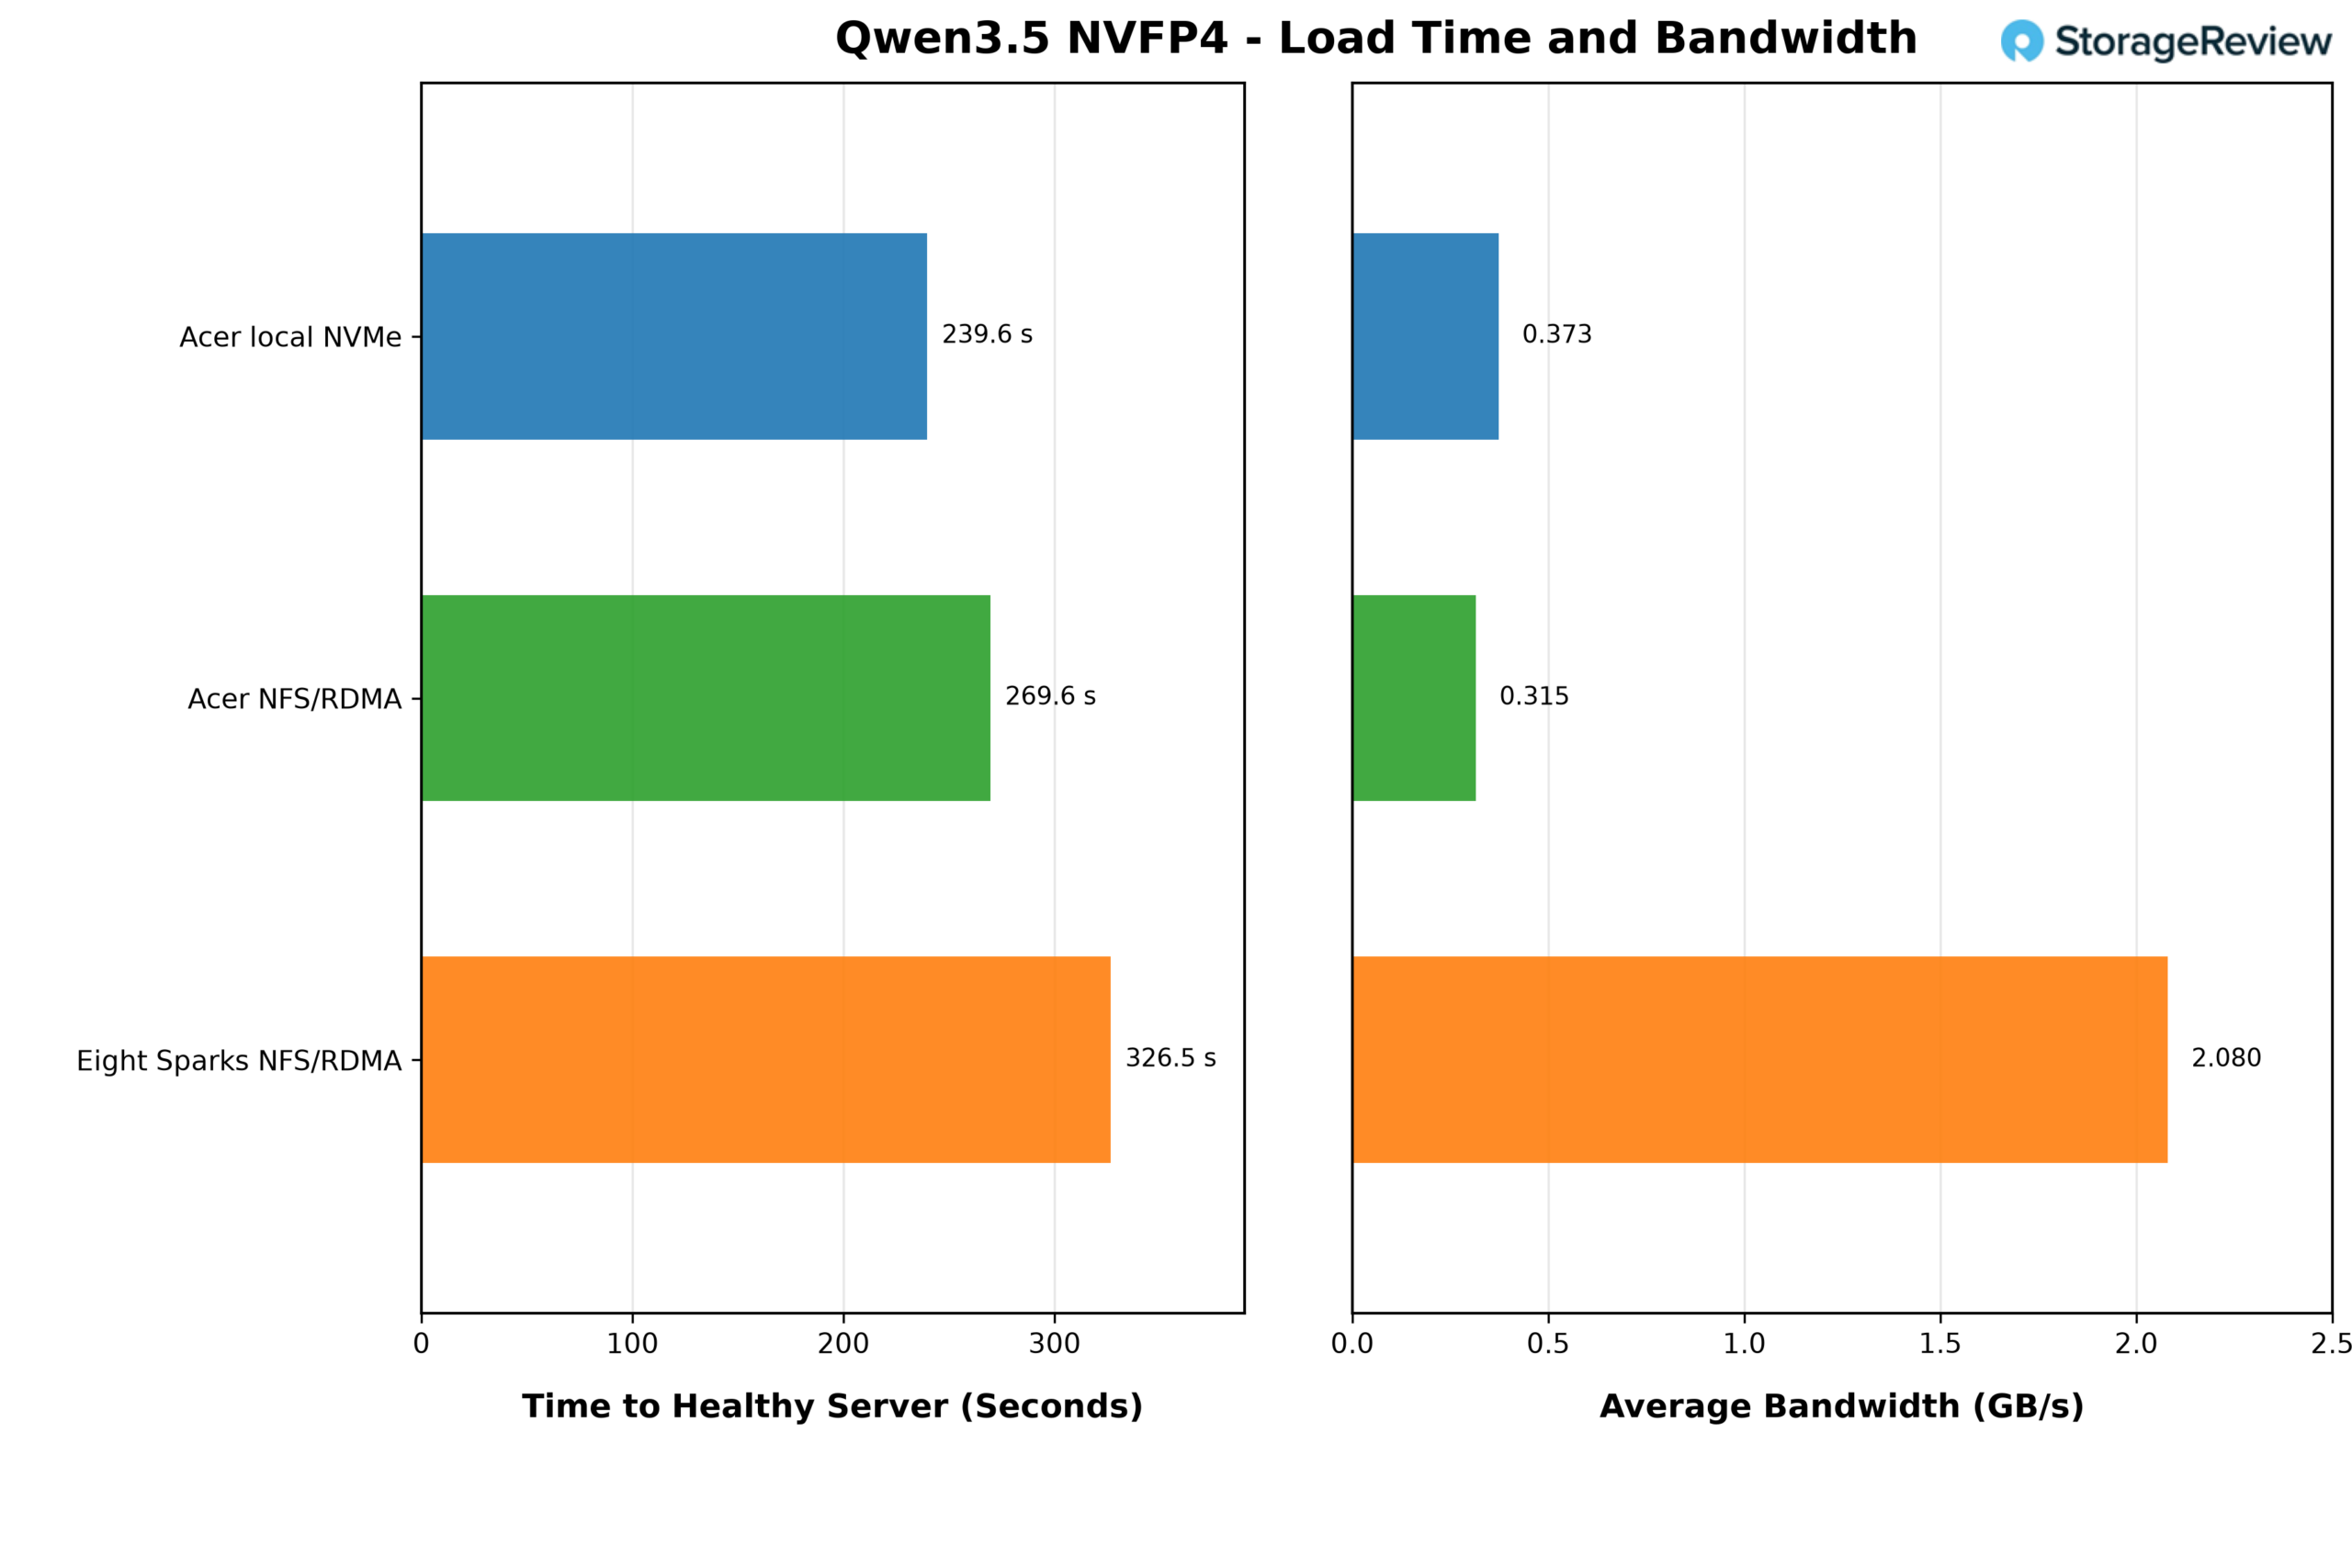
从内部 NVMe 存储,Acer Veriton GN100 以平均 0.373GB/s 的速度,耗时 239.6 秒完成服务器的健康状态加载。而从通过 NFS/RDMA 共享的阵列加载,同样的 Spark 模型耗时 269.6 秒,速度为 0.315GB/s,比前者慢了约 30 秒,即 13%。平均值表明,在四分钟内加载 78GB 的数据,Spark 模型加载在两种情况下都不受存储限制。GB10 自身对权重的处理决定了加载速度,而存储则在大部分时间内处于等待状态。
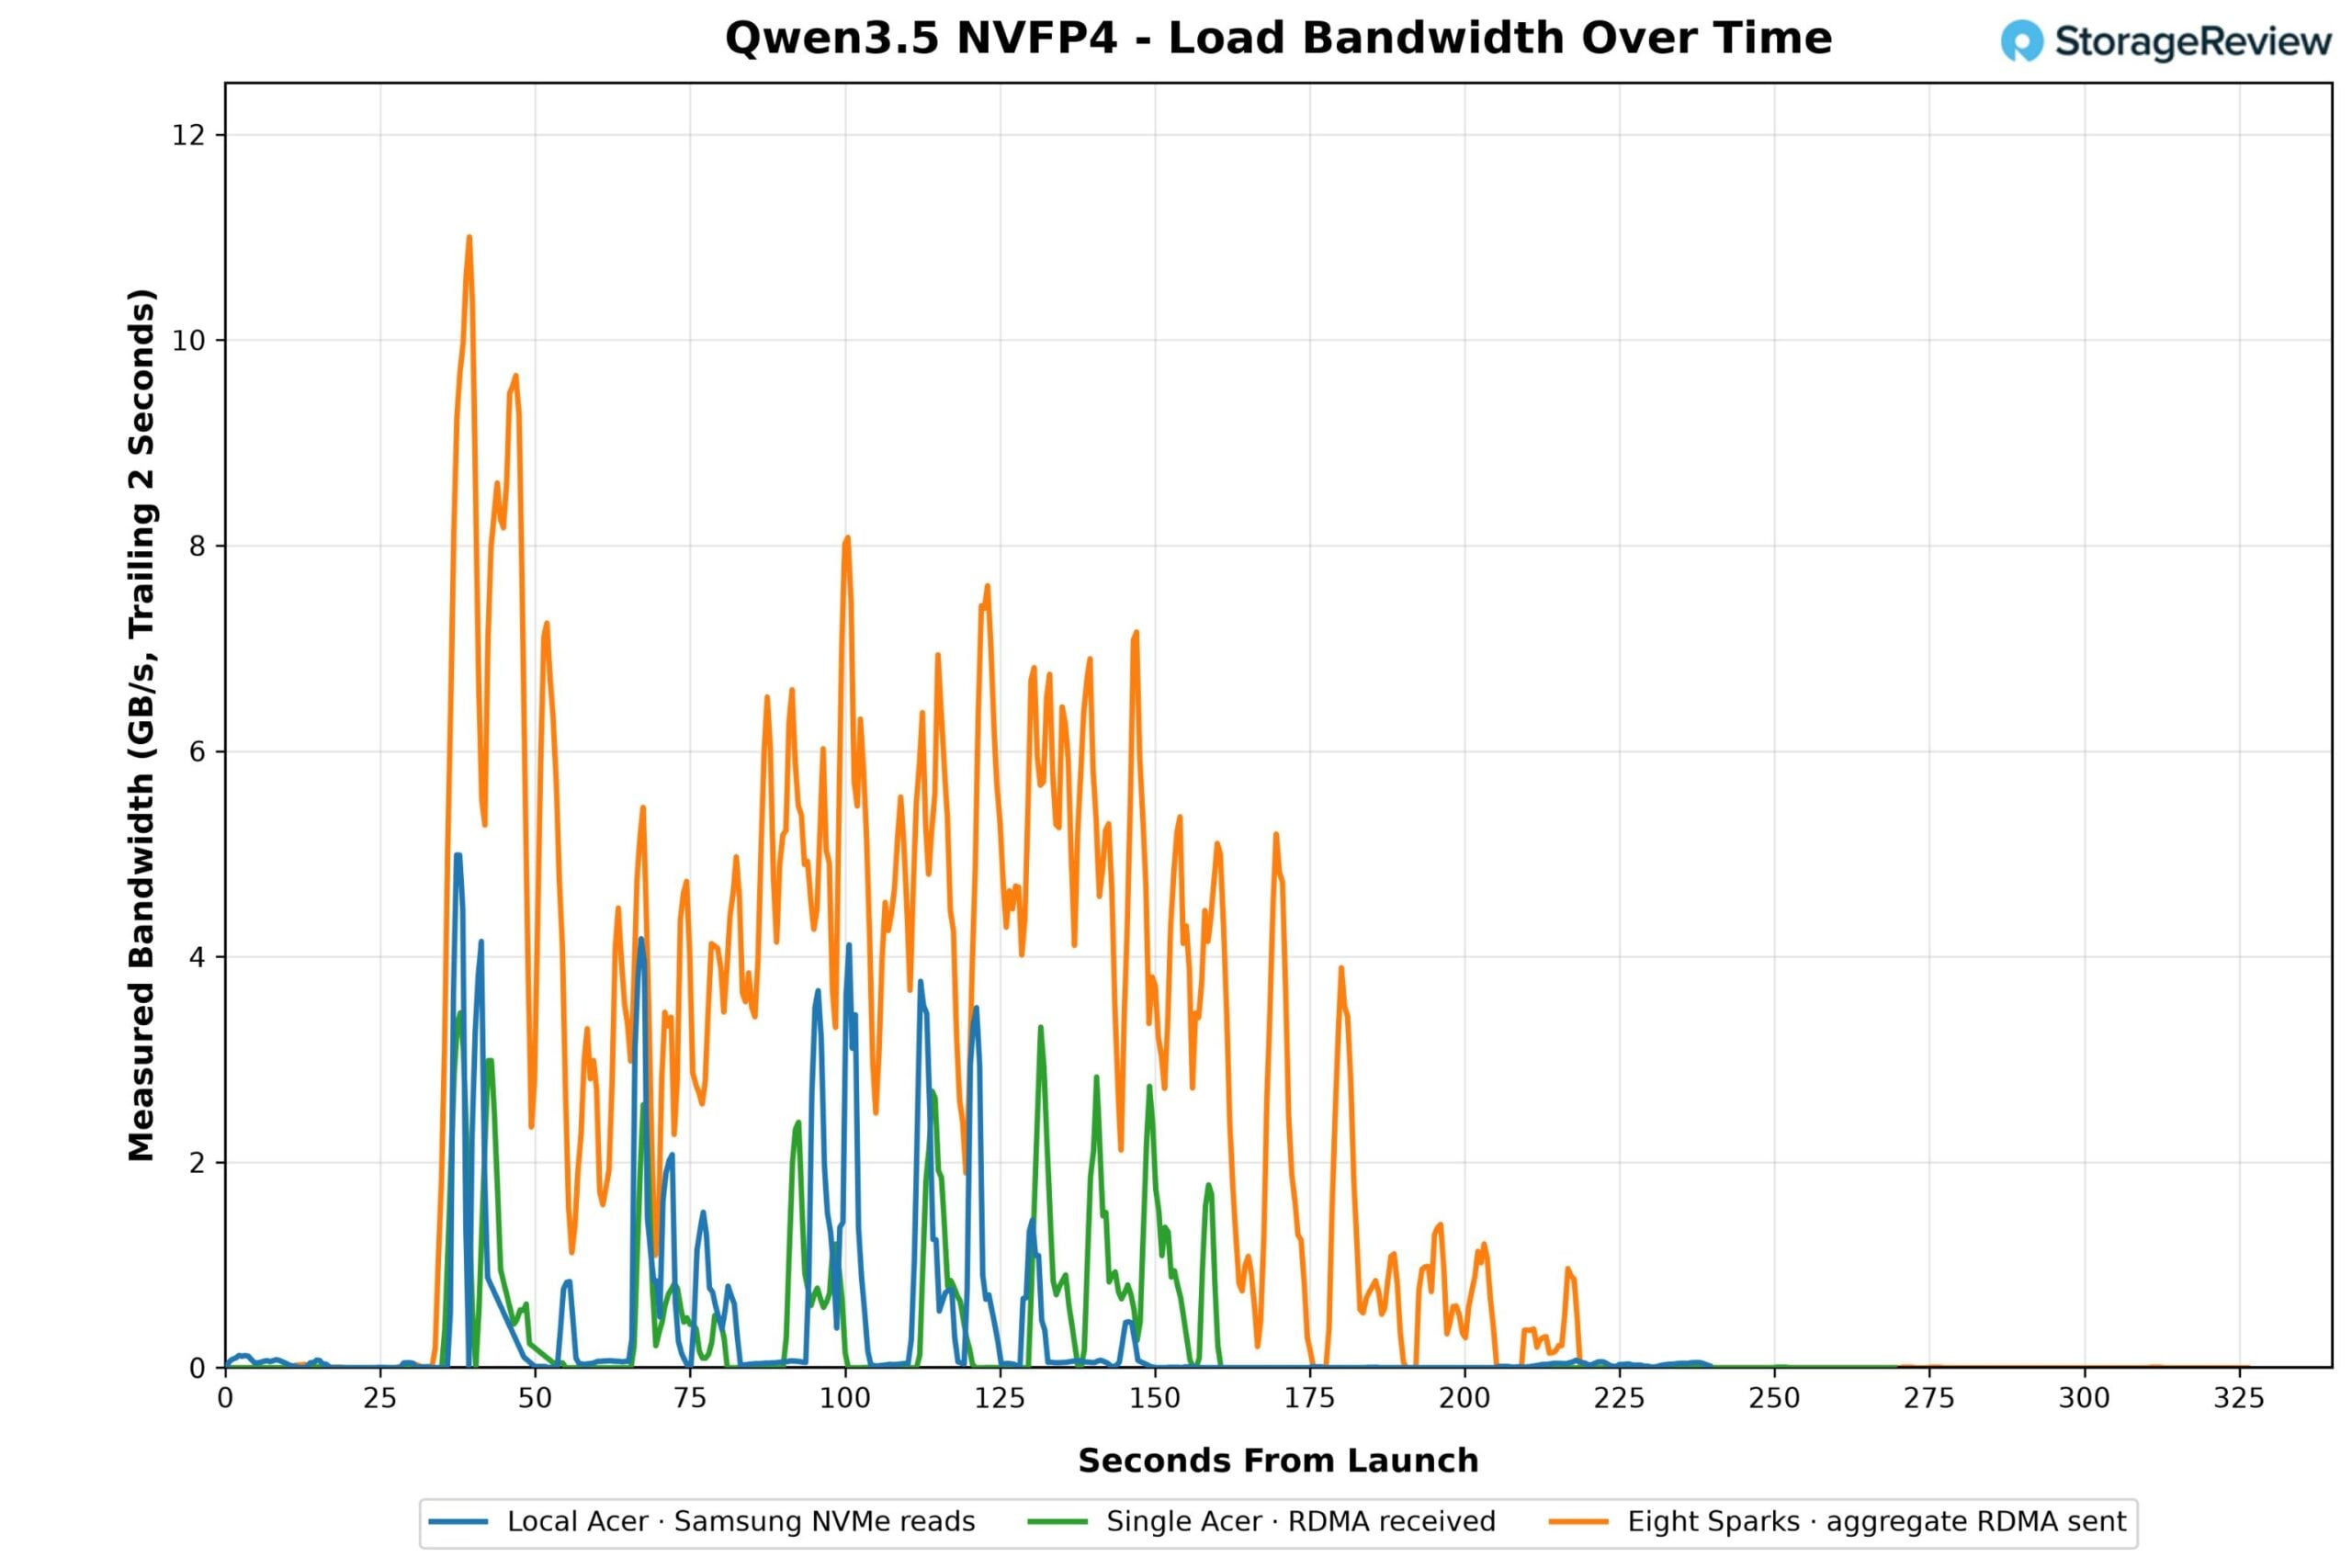
带宽跟踪显示了这种模式:本地 NVMe 读取以突发形式出现,峰值接近 5GB/s,但突发之间间隔较长;单个 NFS 客户端也显示出相同的突发形状,但峰值略低。八个 Spark 的聚合曲线显示了阵列在并发需求下的性能。当所有八个 Spark 同时读取相同的 78GB 数据时,阵列在第一分钟内达到了 11GB/s 的聚合峰值,然后在接下来的两分钟内稳定在 4 到 8GB/s 之间,期间 Spark 处理其权重,整个时间段内的平均速度为 2.08GB/s。与 fio 扫描显示的 25GiB/s 的阵列容量相比,八个 Spark 同时加载模型仅使用了可用容量的一小部分。
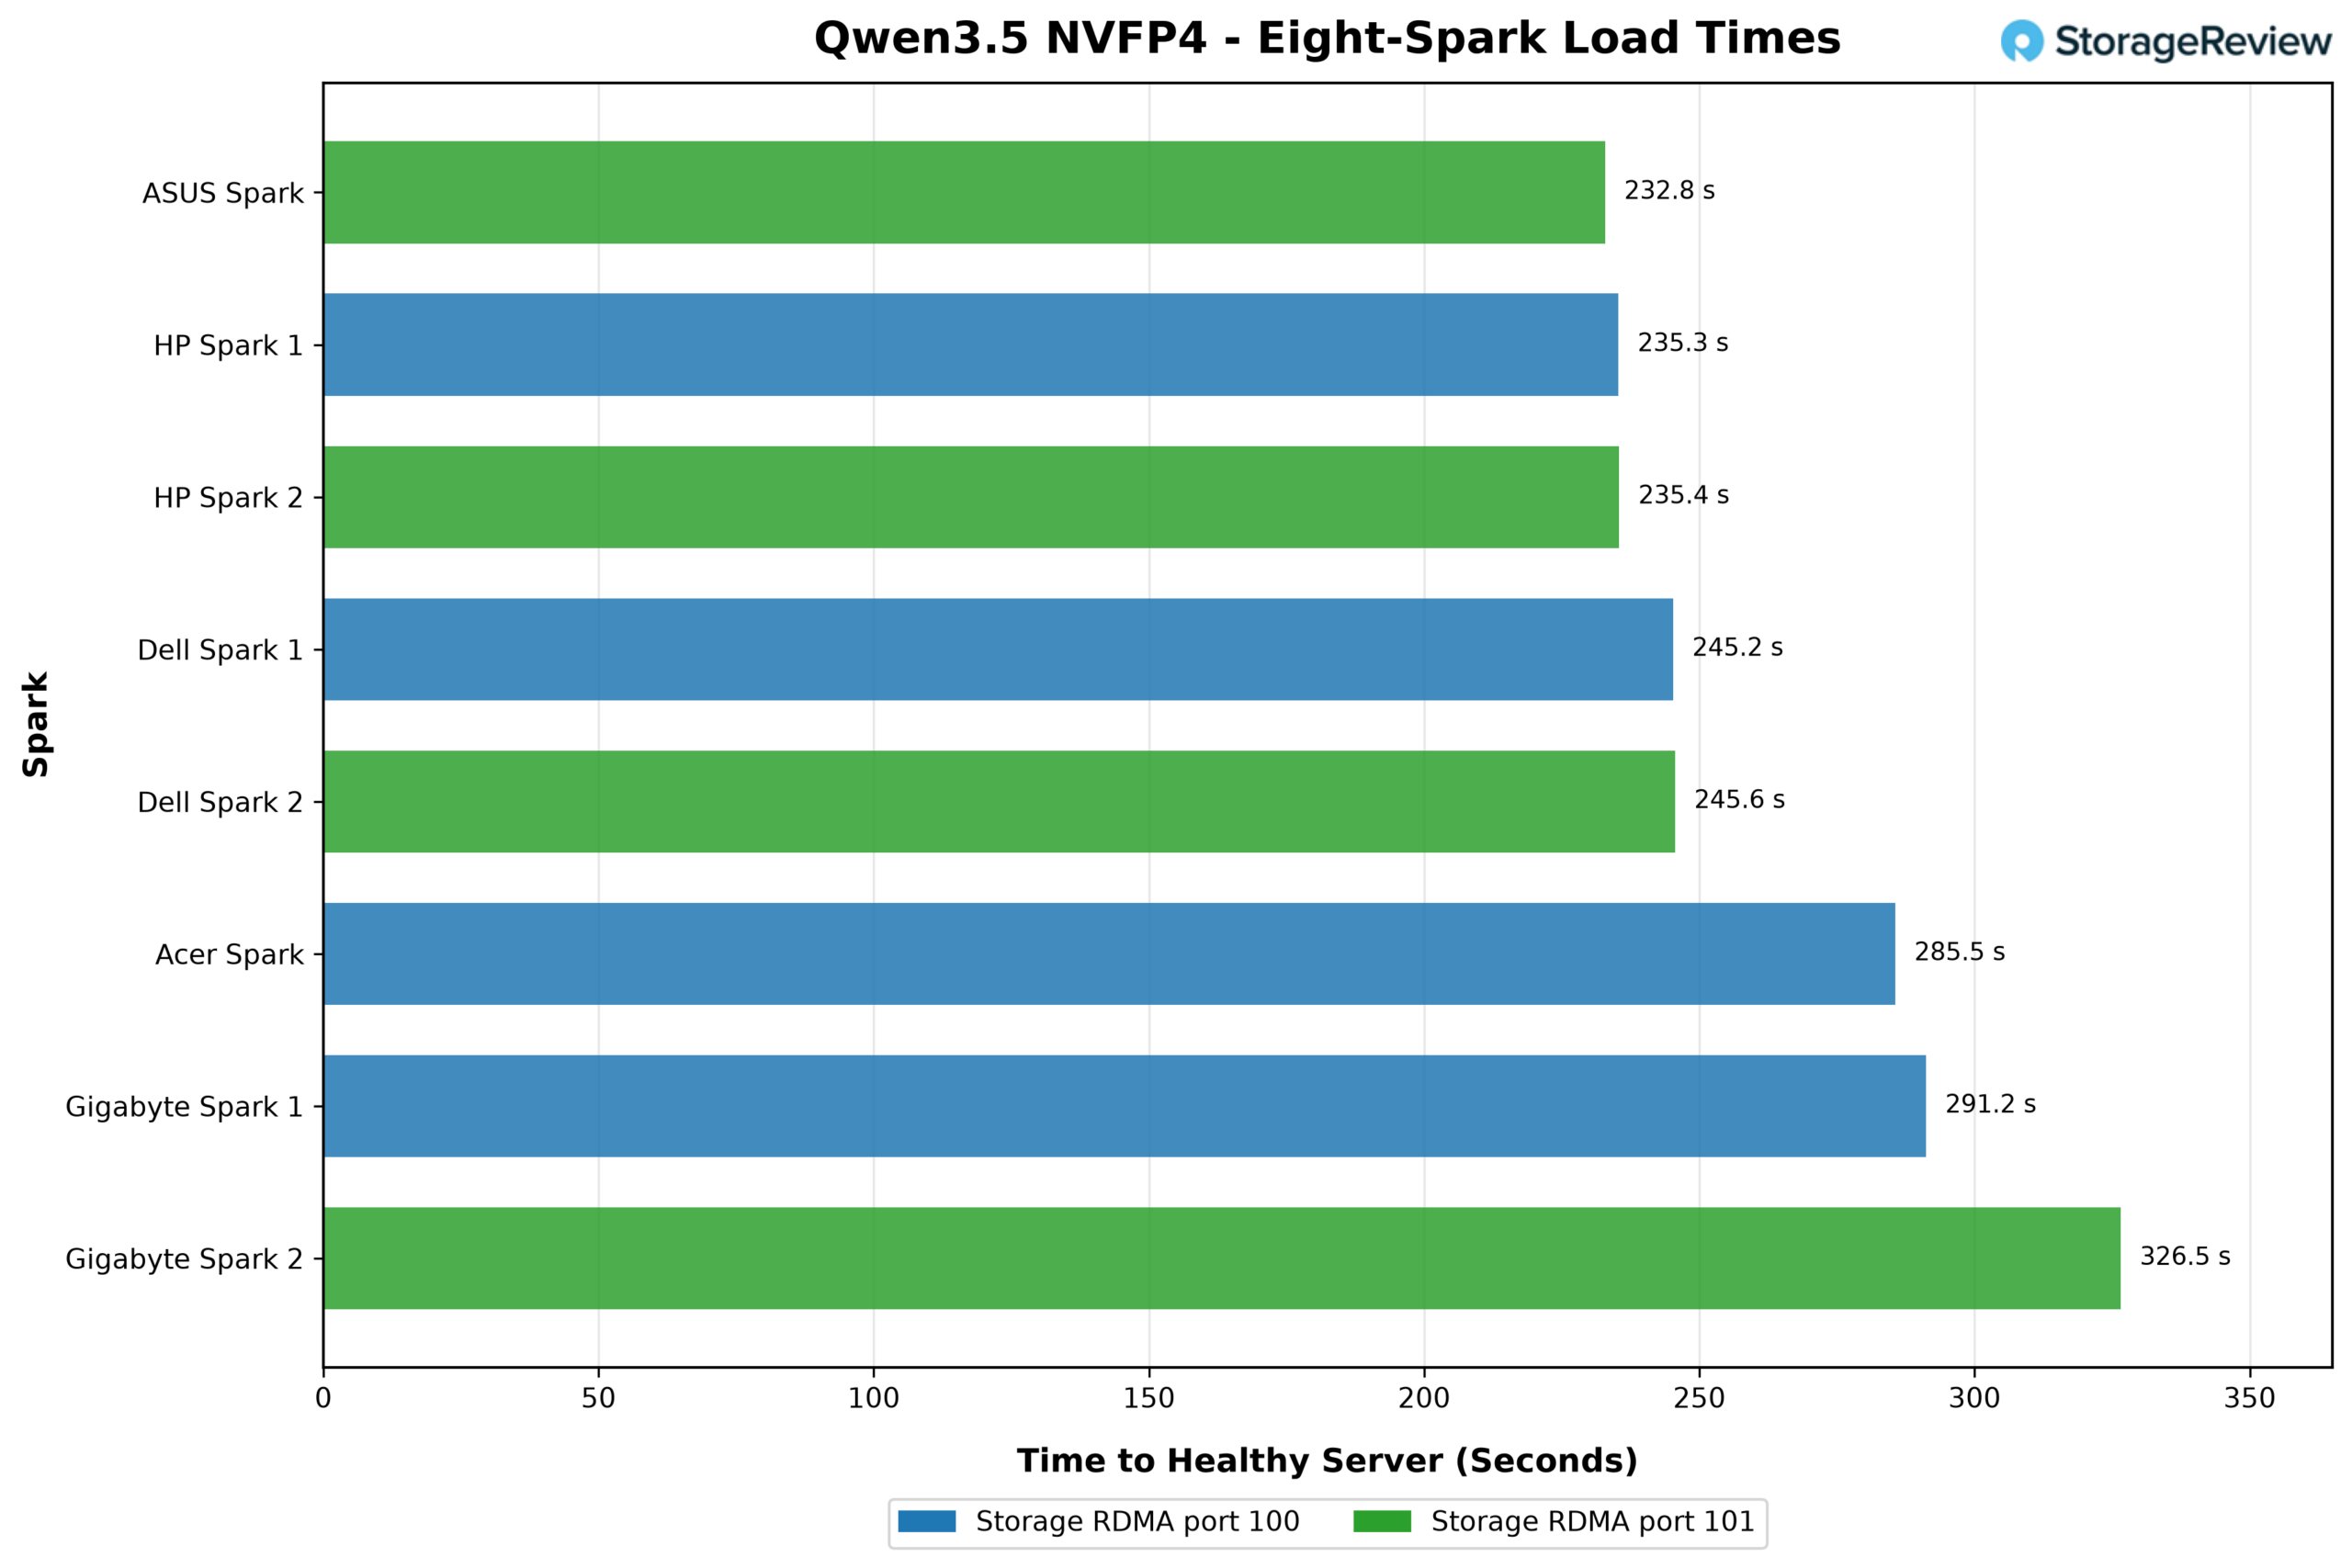
在八组测试中,各单元的加载时间从华硕 Ascent GX10 的 232.8 秒到技嘉 AI TOP ATOM 单元的 326.5 秒不等,两台惠普 ZGX Nano G1n 系统的加载时间分别为 235.3 秒和 235.4 秒,两台搭载 GB10 单元的戴尔 Pro Max 系统的加载时间分别为 245.2 秒和 245.6 秒。八台 Spark 设备同时从共享阵列加载数据,其中五台的性能优于单台 Spark 设备通过 NFS/RDMA 单独加载,三台的性能优于本地 NVMe 加载。这种差异并非厂商差异所致;由于协议栈中没有 QoS,每次测试中等待阵列加载的设备都会有所不同,而且每张存储网卡上的两台设备在测试结果的快慢两端分布均匀。
对于实验室而言,其结果是可以在数组上保留每个模型的一个副本,任何 Spark 或每个 Spark 加载它所需的时间与加载本地副本所需的时间大致相同,无需下载步骤,不占用本地容量,也无需在桌面上保存权重副本。
俄勒冈州立大学用例
俄勒冈州立大学地球、海洋与大气科学学院一直是我们在人工智能基础设施建设方面的长期合作伙伴,从科考船上的实时海洋研究到与 Metrum AI 合作的人工智能辅助学术评估,双方都有过合作。俄勒冈州立大学研究与学术计算主任 Chris Sullivan 和他的架构师 Thomas Olson 正在探索一个可扩展至 100 个单元的大型 Spark 人工智能学习实验室,他们关于存储的思考在两个方面为我们的设计提供了参考。
首先,存储必须独立于 Spark 设备。俄亥俄州立大学曾考虑过在 Spark 设备上部署文件系统,但最终放弃了这种方案,因为在教室环境中,添加或移除单个节点都会中断所有人的存储服务。而采用中央阵列,任何 Spark 设备都可以挂载该阵列,这意味着可以添加、移除、重装系统或将 Spark 设备交给其他学生,而不会影响其他学生的数据。其次,存储必须能够跟随用户移动。我们将俄亥俄州立大学的要求描述为增强版的 AI 文件共享,学生可以在系统之间移动时存储持久性信息。使用 NFS,每个学生对应一个文件夹;登录任何 Spark 设备,挂载共享文件夹,即可访问学生的工作内容。
正是因为数据集的存在,俄亥俄州立大学(OSU)才认为这比对用户主目录服务器更为重要。地球、海洋与大气科学学院希望将其数十TB的海洋和大气研究数据提供给学生用于自己的研究。桌面存储无法满足这一需求:一个4TB的M.2插槽甚至无法容纳如此庞大的数据集,即使实验室里摆满了外置硬盘盒,也意味着每个桌面都需要购买并存储一份数据,并且还要不断更新,这对于任何院系来说都是难以承受的。在我们评估后发现,将数据集中一次存储并通过100GbE网络挂载才是最符合要求的方案。同一阵列还存储着模型库,因此学生可以直接运行Qwen、Llama或其他任何模型,无需下载。同样的原理也适用于企业将桌面人工智能系统部署为开发人员工作站的情况:通过高速网络传输生产数据集,让系统直接在本地进行处理,这样就无需为了满足桌面机器的读取需求而搭建第二个数据湖。数据保留在数据中心内,并受到现有访问控制、加密和备份机制的保护,而Spark在迁移出数据中心时,不会存储任何重要信息。
结语
桌面AI硬件功能强大,但并不擅长融入企业的数据体系。每台GB10系统都只有一个M.2插槽,这恰恰暴露了这一点:用户所需的数据最终都会被复制到本地闪存上,IT人员无法察觉,数据也缺乏保护,并且每个需要相同数据的用户都会遇到同样的问题。对于单个Spark设备来说,外置本地存储盒是一个合理的解决方案。但对于实验室、部门或企业来说,如果部署数十台设备,每个拥有独立数据的桌面就如同一个数据孤岛。而解决方案其实是数据中心多年前就已采用的:将所有容量置于高速网络之后,集中管理,然后共享。Spark设备本身就具备高速网络连接功能;这个项目展示了为数据提供存储位置后会发生什么,也证明了Spark设备本身就应该放在机架上。
一台戴尔服务器中的八块 Solidigm D5-P5336 QLC 固态硬盘组成 RAID 5 阵列,为八台 Spark 设备提供单一的奇偶校验保护数据集。两块博通 400GbE 网卡和一台配备 800G 分线器的戴尔 Z9864F-ON 路由器,为每台 Spark 设备提供 100GbE 网络连接。Tuxera 的 Fusion NFS over RDMA 技术使得在默认的 Ubuntu 系统上只需一行命令即可挂载该网络,并可通过目录服务钩子实现访问控制。在所有八台设备上施加固定负载的情况下,该阵列实现了 24.9GiB/s 的总顺序读取速度(均匀分配,未启用 QoS)。其中一台 Spark 设备就达到了 10.8GiB/s 的链路饱和速度,与我们测试过的任何 GB10 系统中性能最佳的内置硬盘速度相当;该速度峰值仅使用了两块服务器端网卡 27% 的带宽,因此该网络的容量足以支持比这台服务器负载更高的设备。模型测试证实了工作流程:一个 78GB 的模型在共享阵列上托管一次,在单个 Spark 上的加载速度比本地 NVMe 快 13%,在八个 Spark 上同时加载,其中五个 Spark 的完成速度比单个 NFS 运行更快。
QLC闪存之所以能实现这种经济效益,是因为工作负载对容量和读取操作都非常密集,而这正是D5-P5336的优势所在。一台服务器就能存储一百台Spark服务器本地都无法承载的数据,而且所有数据都只有一个副本,所有副本都由数据中心统一管理。俄勒冈州立大学拥有生产级研究存储,用于处理那些刻不容缓的工作。克里斯·沙利文和托马斯·奥尔森正在探索的概念是该大学目前尚不具备的教育存储层级:一个由服务器和少量大容量硬盘组成的、可容纳一个或多个机架Spark服务器的受控共享存储池,可以将数十TB的真实海洋学和大气数据放在大型人工智能学习实验室的前端,而该实验室的Spark服务器就运行在同一架构上。
本报告由 Solidigm 赞助。 本报告中表达的所有观点和意见均基于我们对所考虑产品的公正看法。
本文中提及的商业产品仅供参考,并不代表俄勒冈州立大学的认可。



 Amazon