

金士顿全新 DC3000ME 是公司最新推出的企业级 NVMe SSD,采用 U.2 2.5 英寸规格,专为数据中心和服务器级工作负载而设计。它基于 PCIe 5.0 x4 接口,将高带宽吞吐量与 3D eTLC NAND 相结合,实现了强大的可靠性和容量扩展能力。该固态硬盘提供 3.84TB、7.68TB 和 15.36TB 三种容量配置,专为超大规模基础设施、AI 和 HPC 集群、云服务和交易系统等高需求环境而设计。
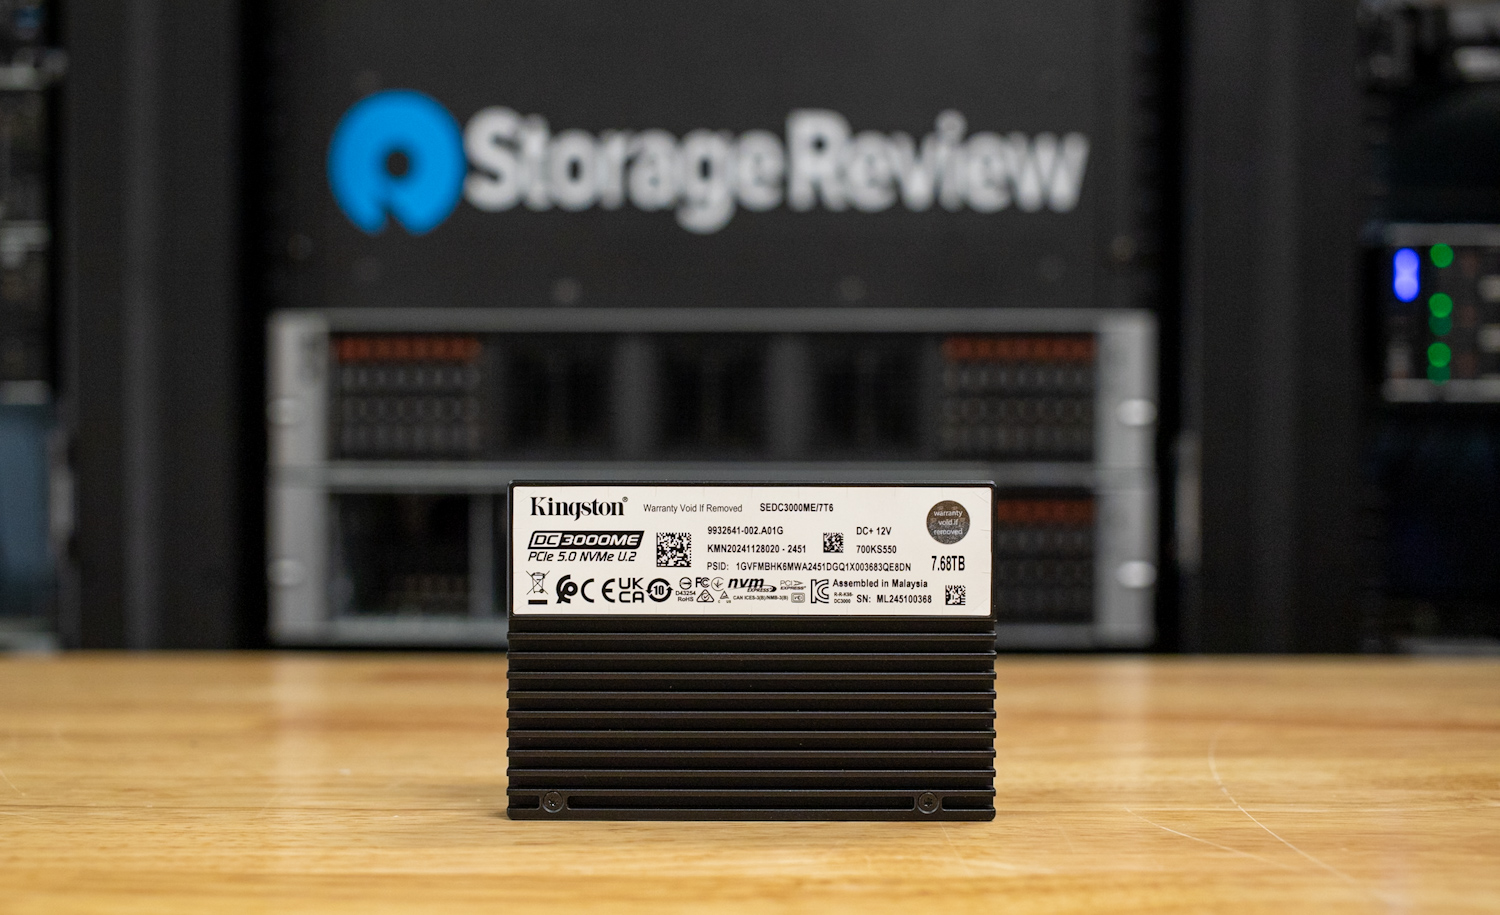
金士顿DC3000ME 绩效简介
DC3000ME 所有容量型号的顺序读取性能均相同,每个型号最高可达 14,000MB/s。无论选择哪种容量,此速度对于高度依赖快速数据访问的工作负载而言都是理想之选。然而,顺序写入速度差异很大。3.84TB 型号的速度限制为 5,800MB/s,而 7.68TB 型号则大幅提升至 10,000MB/s。15.36TB 型号的速度略逊一筹,为 9,700MB/s。
从随机性能来看,7.68TB 是所有硬盘中最快的,读取速度最高可达 2.8 万 IOPS,写入速度最高可达 500,000 万 IOPS。这超过了 3.84TB 和 15.36TB 的硬盘,后两者的读取速度上限均为 2.7 万 IOPS。写入速度方面,3.84TB 型号的写入速度仅为 300,000 万 IOPS,而 15.36TB 型号则达到了 400,000 万 IOPS。7.68TB 版本在处理繁忙、高需求任务方面能力最强。
从性能/容量角度来看,7.68TB 型号还提供了最均衡的吞吐量和 IOPS 组合,使其成为日志记录、OLTP 数据库或主动 AI 模型训练等写入密集型应用程序的理想选择。3.84TB 型号可能更适合读取密集型或混合工作负载,这些工作负载对容量的要求不高;而 15.36TB 型号则以峰值写入 IOPS 换取原始存储密度。
金士顿DC3000ME 企业特色
DC3000ME 配备了一些在生产系统中至关重要的便捷企业级功能。它内置断电保护 (PLP),可在突发断电时保护数据。此外,它还支持 AES-256 加密和 TCG Opal 加密,以确保静态数据的安全。DC3000ME 支持多达 128 个命名空间,这对于虚拟化或容器化用例尤为有用。这种级别的命名空间支持与先进的 U.2 SSD 相当,对于大规模虚拟化环境尤其有用。金士顿还内置了遥测工具,用于跟踪硬盘的健康状况、介质磨损和工作温度,让管理员能够了解长期可靠性。
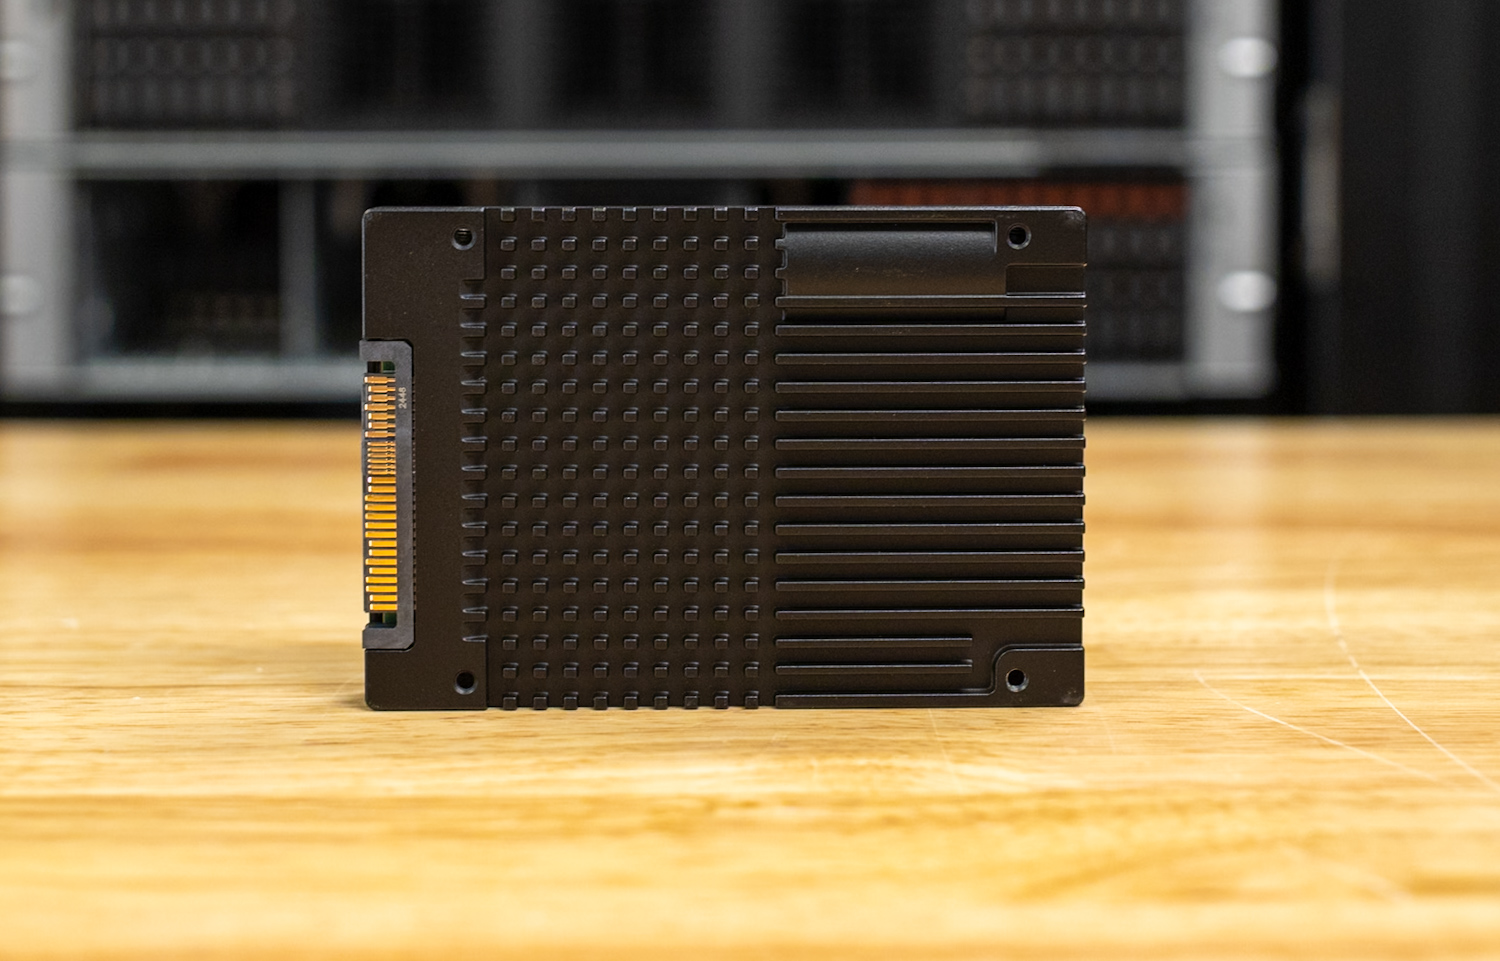
功耗范围从空闲状态下的 8W 到完整写入期间的最高 24W,这似乎是高密度 U.2 SSD 在高负载下的典型值。金士顿指定的最大读取功率为 8.2W,与空闲状态下的数值非常接近,在读取密集型工作负载下,功耗变化幅度较小。其耐用性等级符合您对企业级硬盘的预期,支持五年内每天进行一次完整写入。这相当于 7,008 TBW 到 28,032 TBW 之间的数值,具体取决于容量。
Kingston DC3000ME 拥有两百万小时的 MTBF 评级和金士顿的五年有限保修,以及免费技术支持。
金士顿 DC3000ME 规格
| 规格 | 信息 |
| 外形 | U.2,2.5英寸 x 15毫米 |
| 接口 | PCIe NVMe Gen5 x4(向后兼容 Gen4) |
| 容量 | 3.84TB、7.68TB、15.36TB |
| NAND型 | 3D eTLC NAND |
| 顺序读/写(MB / s) | 3.84TB – 14,000 / 5,800 7.68TB – 14,000 / 10,000 15.36TB – 14,000 / 9,700 |
| 随机读/写 IOPS (4K) | 3.84TB – 2,700,000 / 300,000 7.68TB – 2,800,000 / 500,000 15.36TB – 2,700,000 / 400,000 |
| 延迟QoS(99%) | 读取:<10µs,写入:<70µs |
| 静态和动态磨损均衡 | 是 |
| 断电保护控制 | 是(电源容量) |
| 加密 | TCG Opal 2.0,AES 256 位加密 |
| 命名空间管理 | 最多支持 128 个命名空间 |
| 企业诊断 | 遥测、介质磨损、温度、健康状况等。 |
| 耐久性(TBW/DWPD,5年) | 3.84TB – 7,008 TBW,1 DWPD 7.68TB – 14,016 TBW,1 DWPD 15.36TB – 28,032 TBW,1 DWPD |
| 能量消耗 | 空闲:8W,最大读取:8.2W,最大写入:24W |
| 工作温度 | 0°C至70℃, |
| 尺寸 | 100.50mm点¯x69.8mm点¯x14.8mm |
| 重量 | 3.84TB-146.2克 7.68TB-151.3克 15.36TB-152.3克 |
| 振动(非工作) | 10G峰值(10–1000Hz) |
| 平均无故障时间 | 2万小时 |
| 保固与支援 | 5年有限保修,提供免费技术支持 |
金士顿DC3000ME性能测试
路测平台
本次评测中,我们使用一台运行 Ubuntu 22.04.02 LTS 的戴尔 PowerEdge R760 服务器作为所有工作负载的测试平台。该服务器配备了Serial Cables Gen5 JBOF接口,可广泛兼容 U.2、E1.S、E3.S 和 M.2 固态硬盘。我们的系统配置如下:
-
-
- 2 个英特尔至强金牌 6430(32 核,2.1GHz)
- 16个64GB DDR5-4400
- 480GB 戴尔 BOSS 固态硬盘
- 串行电缆 Gen5 JBOF
-
驱动器比较
CDN 性能
为了模拟真实的混合内容 CDN 工作负载,我们对 SSD 进行了多阶段基准测试,旨在复制内容密集型边缘服务器的 I/O 模式。测试过程涵盖了各种大小的块,包括大块和小块,分布在随机和顺序操作中,并具有不同的并发级别。
在主要性能测试之前,每个SSD都使用100MB大小的块完成了1%顺序写入的全设备填充。此过程使用同步I/O和128的队列深度,允许同时执行四个作业。此阶段确保驱动器进入代表实际使用情况的稳定状态。顺序填充之后,执行第二个三小时的随机写入饱和阶段,使用加权块大小分割(块大小/百分比)分布,其中98.51K传输量占比最高(128%),其次是低于8K直至XNUMXK的块。此步骤模拟了分布式缓存环境中常见的碎片化和不均匀的写入模式。
主要测试套件侧重于扩展的随机读写操作,以测量驱动器在可变队列深度和作业并发性下的行为。每次测试持续五分钟(300秒),之后有三分钟的空闲时间,以便内部恢复机制稳定性能指标。
- 使用固定块大小分布执行,其中 128K(98.51%)为宜,其余 1.49% 的操作由较小的传输大小组成,范围从 64K 到 8K。每种配置分别包含 1、2 和 4 个并发作业,队列深度分别为 1、2、4、8、16 和 32,以分析典型边缘写入条件下的吞吐量可扩展性和延迟。
- 我们采用了一个高度混合的块大小配置文件,模拟了 CDN 内容检索,首先以 128K(83.21%)的占比为主,然后是超过 30 个较小块大小的长尾,大小范围从 4K 到 124K,每个块大小都具有不同的频率表示。这种分布反映了在视频片段提取、缩略图访问和元数据查找过程中遇到的各种请求模式。这些测试还针对完整的作业数量和队列深度矩阵进行了测试。
这种预处理、饱和度和混合大小随机访问测试的组合旨在揭示 SSD 如何处理持续的类似 CDN 的环境,强调在带宽密集和高度并行化场景中的响应能力和效率。
CDN 工作负载读取 1
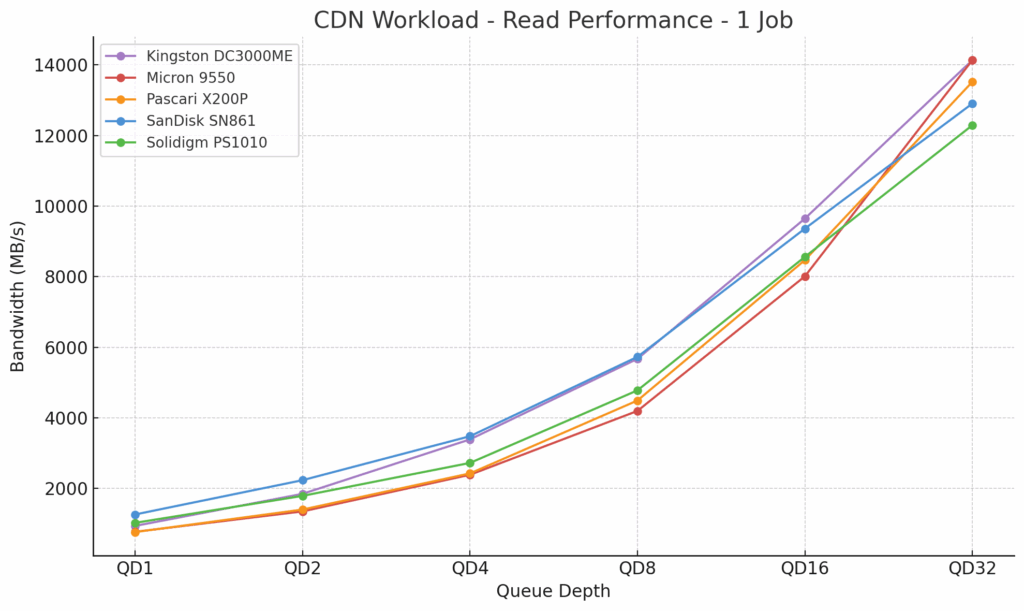
在我们的 CDN 工作负载读取测试(1 个作业)中,金士顿 DC3000ME 表现出色,并能随着队列深度的增加而高效扩展。在队列深度 1 时,它的速度达到了 940MB/s,落后于闪迪 SN861 约 26%。然而,随着队列深度的增加,DC3000ME 缩小了差距,并超越了几款第五代固态硬盘。在队列深度 5 时,金士顿 DC4ME 的速度达到了 3000MB/s,比美光 3,390 快约 42%,比 Pascari X9550P 快 40%,比 Solidigm PS200 快约 25%,尽管它略低于闪迪 SN1010 约 861%。在 QD2.6 测试中,DC16ME 的速度达到了 3000MB/s,比 Solidigm PS9,645 快了约 1010%,比美光 13 快了约 9550%。在 QD20 的最大测试深度下,金士顿的吞吐量达到了 32MB/s,与美光 14,131 相当,比 Solidigm PS9550 快了约 1010%,比 SanDisk SN15 快了近 861%。
 CDN 工作负载读取 2
 CDN 工作负载读取 2
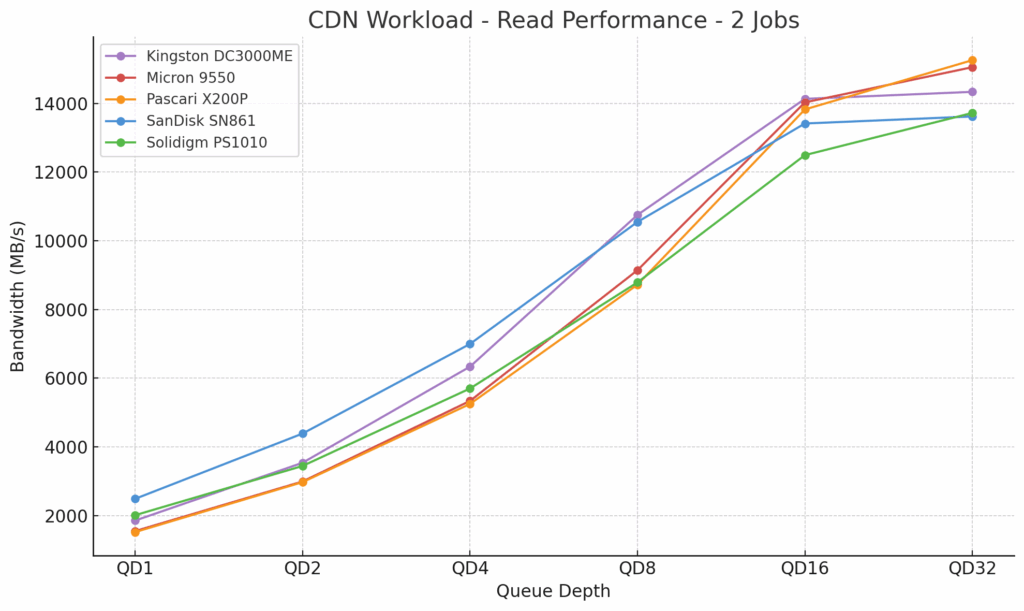
在双任务 CDN 读取工作负载中,金士顿 DC2ME 在所有队列深度下再次保持强劲性能。在 QD3000 下,其速度达到 1MB/s。这比美光 1,854(9550MB/s)快 1,548%,比 Pascari X20P(200MB/s)快 1,519%,比 Solidigm PS22(1010MB/s)快约 2,011%,但比闪迪 SN8(861MB/s)慢 2,487%。
在第 4 季度,金士顿的速度达到了 6,335MB/s,明显优于美光(5,337MB/s)、Pascari(5,249MB/s)和 Solidigm(5,609MB/s)。然而,它仍然落后于 SanDisk,后者以 6,996MB/s 的速度位居榜首。
到 QD16 时,金士顿的速度达到了 14,131MB/s,目前处于领先地位。在最后一个测试点 QD32 时,它的速度略有提升,达到 14,336MB/s,分别落后 Pascari(15,257MB/s)和美光(15,052MB/s)约 6% 和 5%,但仍然稳固领先于 SanDisk(13,619MB/s)和 Solidigm(13,721MB/s)。
CDN 工作负载读取 4
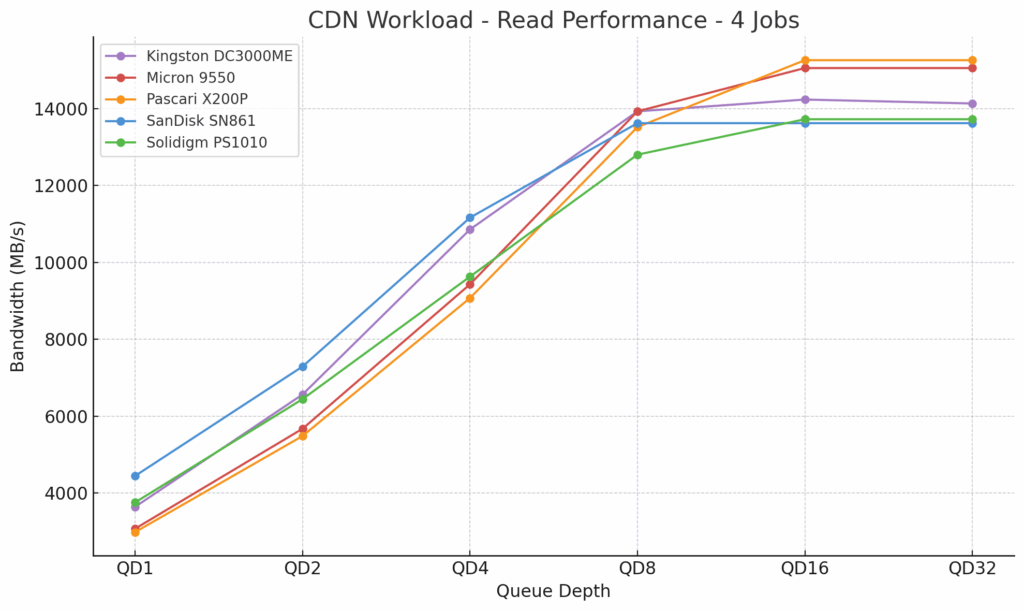
在四项任务同时运行的情况下,金士顿 DC3000ME 在 CDN 读取性能方面继续保持领先地位。在 QD1 时,它达到了 3,639MB/s,超过了美光 9550(3,070MB/s)和 Pascari X200P(2,982MB/s),但仍比 SanDisk SN22 慢 861%,后者以 4,443MB/s 的速度领跑同级别。到 QD4 时,金士顿达到了 10,854MB/s,比美光(15MB/s)提高了 9,427%,比 Pascari(20MB/s)高出 9,070%,略高于 Solidigm(9,627MB/s)。然而,它仍然落后于 SanDisk 的 11,161MB/s。
到第 8 季度,金士顿的吞吐量达到 13,926MB/s,几乎与美光持平,与闪迪(13,619MB/s)和 Solidigm(12,800MB/s)大致持平。在 QD16 和 QD32 季度,金士顿的吞吐量稳定在 14,131-14,233MB/s 左右,略低于美光和 Pascari(两者均在 15,052-15,257MB/s 左右),但仍远超闪迪(13,619MB/s)和 Solidigm(13,721MB/s)。
CDN 工作负载写入 1
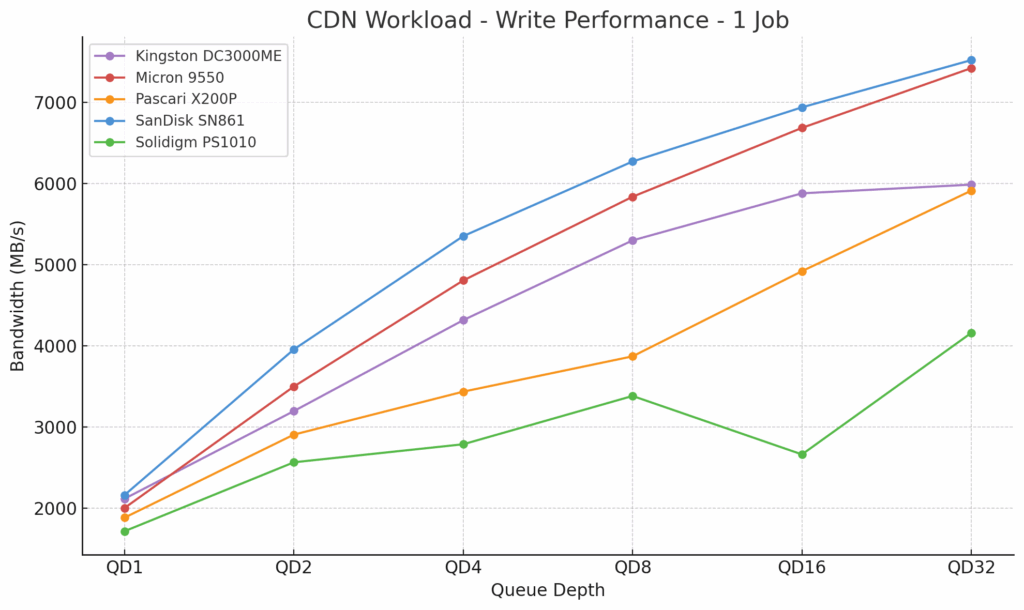
在我们的 CDN 写入工作负载(1 个作业)中,金士顿 DC3000ME 在不同队列深度下均表现出一致的扩展性。在 QD1 时,它的速度达到了 2,118MB/s,快于美光 9550(2,004MB/s)、Pascari X200P(1,885MB/s)和 Solidigm PS1010(1,718MB/s),但仅略微落后于闪迪 SN861(2,164MB/s)。在 QD4 时,金士顿的速度达到了 4,318MB/s,比 Solidigm(55MB/s)快 2,789%,比 Pascari(26MB/s)快 3,437%,但比美光(10MB/s)慢 4,807%,比闪迪(19MB/s)慢 5,353%。
到第 16 季度,它的速度达到了 5,880MB/s,比 Pascari(4,921MB/s)高出 20%,比 Solidigm(2,664MB/s)高出一倍多,但仍落后美光(11MB/s)6,686%,比 SanDisk(15MB/s)低 6,939%。到第 32 季度,金士顿的速度达到 5,987MB/s,再次接近 Pascari(5,913MB/s),但落后美光(7,422MB/s)和 SanDisk(7,521MB/s)约 20% 和 25%。
CDN 工作负载写入 2
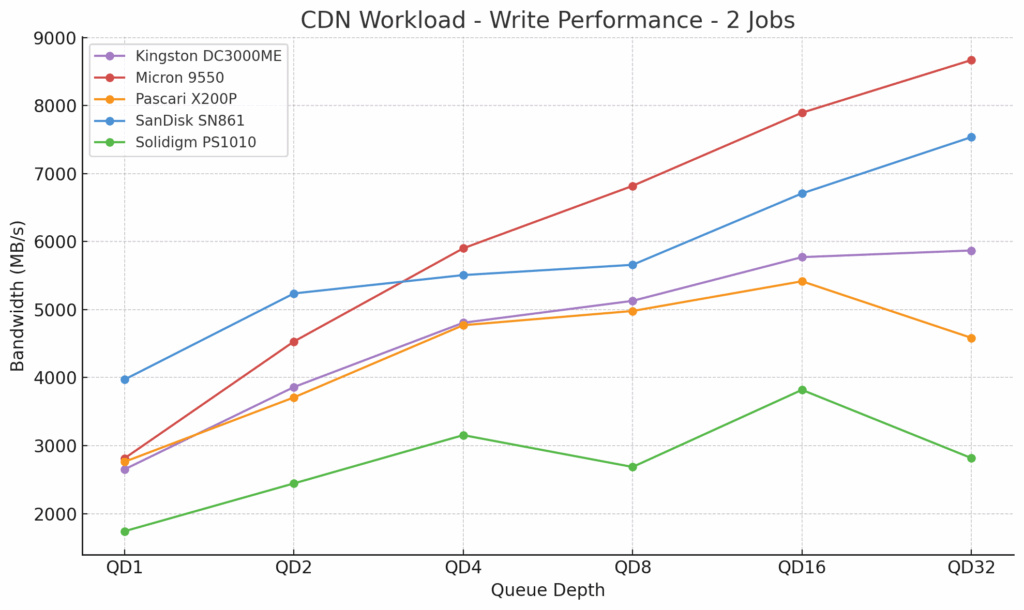
在双任务 CDN 写入工作负载中,金士顿 DC2ME 表现出了稳定的性能,尽管它总体上落后于速度最快的第五代企业级 SSD。在 QD3000 测试中,它的速度为 5MB/s,略低于美光 1(2,651MB/s)和 Pascari X9550P(2,813MB/s),比闪迪 SN200(2,762MB/s)慢了约 33%。
随着队列深度的增加,DC3000ME 也保持了同步。在 QD4 时,它的速度达到了 4,807MB/s,比美光 23(9550MB/s)慢了约 5,902%,比 SanDisk SN13(861MB/s)慢了 5,508%,但领先于 Solidigm PS1010(3,154MB/s)。
在 QD16 时,金士顿的传输速度为 5,772MB/s,仍然落后于美光 (7,896MB/s) 和闪迪 (6,709MB/s),但继续优于 Solidigm PS1010 (3,820MB/s) 和 Pascari X200P (5,417MB/s)。在 QD32 时,DC3000ME 的峰值速度达到 5,870MB/s,比美光 32 (9550MB/s) 慢 8,670%,比闪迪 SN22 (861MB/s) 慢 7,537%,但仍领先于 Solidigm PS1010 (2,817MB/s) 和 Pascari (4,585MB/s)。
CDN 工作负载写入 4
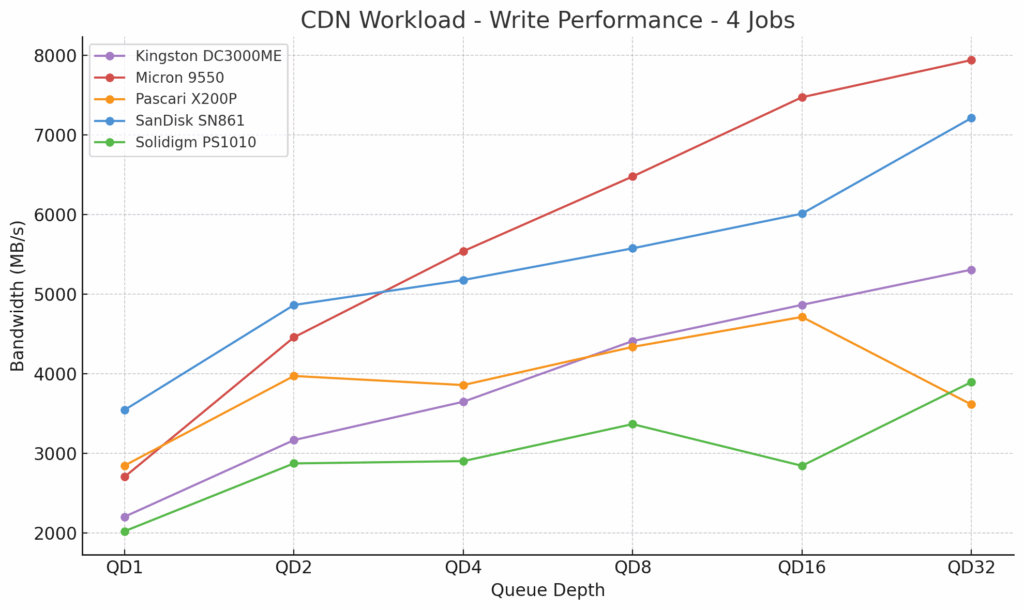
在四任务 CDN 写入工作负载中,金士顿 DC4ME 在所有队列深度上都表现稳定,尽管总体上落后于排名前两位的第五代硬盘。在 QD3000 时,它达到了 5MB/s,落后于 Pascari X1P(2,202MB/s)、美光 200(2,845MB/s)和闪迪 SN9550(2,703MB/s),但领先于 Solidigm PS861(3,544MB/s)。在 QD1010 时,金士顿达到了 2,020MB/s,再次落后于闪迪(2MB/s)和美光(3,165MB/s),但仍领先于 Solidigm(4,863MB/s)。
在中等队列深度下,金士顿 DC3000ME 在 QD3,647 时达到了 4MB/s,在 QD4,410 时达到了 8MB/s。虽然这显示出不错的扩展性,但在两个测试点上,它仍然落后于美光硬盘(5,539MB/s 和 6,478MB/s)和闪迪硬盘(5,177MB/s 和 5,575MB/s)。在 QD16 时,金士顿达到了 4,865MB/s,比 QD8 略有提升,但仍然落后于闪迪硬盘(6,011MB/s)和美光硬盘(7,474MB/s)。在 QD32 时,DC3000ME 达到了 5,307MB/s 的峰值,远远领先于 Solidigm(3,894MB/s),但明显落后于美光(7,941MB/s)和闪迪(7,212MB/s)。尽管金士顿硬盘并非性能领先者,但它保持了一致的扩展性和效率。
DLIO 检查点基准
为了评估固态硬盘 (SSD) 在 AI 训练环境中的实际性能,我们使用了数据和学习输入/输出 (DLIO) 基准测试工具。DLIO 由阿贡国家实验室开发,专门用于测试深度学习工作负载中的 I/O 模式。它能够深入了解存储系统如何应对检查点设置、数据提取和模型训练等挑战。下图展示了两款固态硬盘如何在 36 个检查点上执行整个过程。在训练机器学习模型时,检查点对于定期保存模型状态至关重要,可防止中断或断电期间进度丢失。这种存储需求需要强大的性能,尤其是在持续或密集的工作负载下。我们使用了 2.0 年 13 月 2024 日发布的 DLIO 基准测试 XNUMX 版。
为了确保基准测试能够反映真实场景,我们基于 LLAMA 3.1 405B 模型架构进行测试。我们使用 torch.save() 实现了检查点,以捕获模型参数、优化器状态和层状态。我们的设置模拟了一个八 GPU 系统,实现了混合并行策略,其中四路张量并行和双向流水线并行处理分布在八个 GPU 上。此配置的检查点大小为 4GB,代表了现代大型语言模型的训练需求。
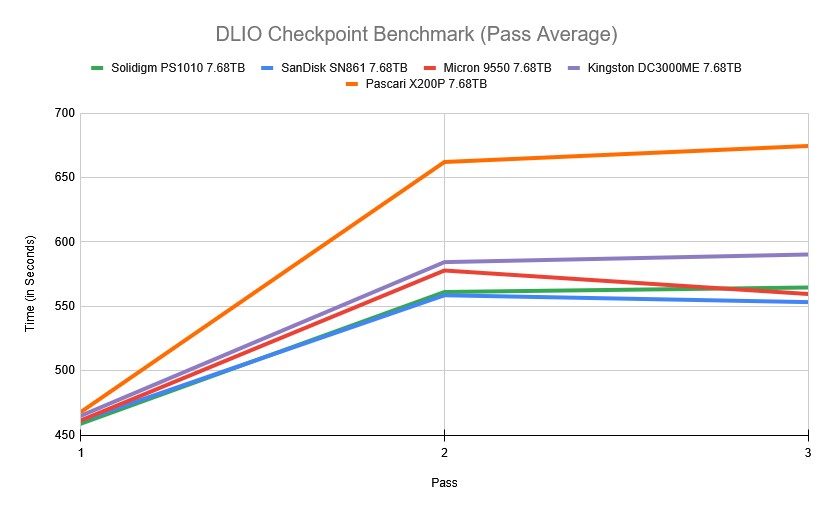
在 DLIO 平均测试结果中,金士顿 DC3000ME 7.68TB 略逊于顶级竞争对手,在五款硬盘中处于中等水平。第一次测试的平均时间为 465.04 秒,第二次测试为 584.38 秒,第三次测试为 590.30 秒。虽然金士顿 DC200ME 的速度始终快于 Pascari X7.68P 674.48TB(后者在三次测试中均创下了最高记录,第三次测试中达到 3 秒),但其仍落后于美光 3000 9550TB 和 Solidigm PS7.68 1010TB,后两款硬盘在最后一次测试中均低于 7.68 秒。
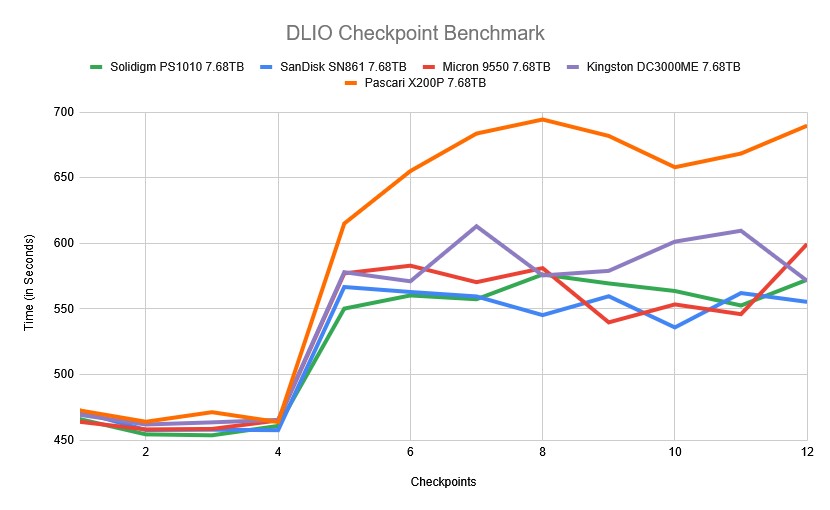
如下图所示,金士顿 DC3000ME 开局强劲,早期测试点的成绩与顶级竞争对手不相上下。在测试点 1,它的成绩为 469.27 秒,略低于美光 9550 的 464.01 秒,并领先于 Pascari X200P 的 472.65 秒。从测试点 2 到 4,它的成绩稳定在 461.92 秒到 465.44 秒之间,同样接近美光 9550 和 Solidigm PS1010,这两款处理器的成绩都在 453 到 465 秒之间徘徊。
测试进行到中段(检查点 5 至 8),金士顿 DC3000ME 的检查点时间出现跳跃式增长,在第 613.01 个检查点达到峰值 7 秒。这一成绩高于美光 9550(570.42 秒)和闪迪 SN861 7.68TB(559.56 秒),但仍明显优于 Pascari X200P,后者在同一时间段内的最高成绩为 694.38 秒。测试接近尾声时,金士顿 DC3000ME 略微稳定下来,在第 571.36 个检查点的成绩为 12 秒,比美光 28 慢了大约 9550 秒,但仍然快于 Pascari X200P,后者的成绩为 689.68 秒。总体而言,金士顿 DC3000ME 7.68TB 表现出了稳定的性能,并在整个检查点工作负载中保持在竞争范围内,处于中等水平。
FIO性能基准
为了衡量每款 SSD 在常见行业指标上的存储性能,我们利用 FIO。每块 SSD 都经过相同的测试流程,其中包括一个预处理步骤:使用顺序写入工作负载两次全盘填充,然后测量稳态性能。随着被测工作负载类型的变化,我们会再次运行一次基于新传输大小的预处理填充。
在本节中,我们重点关注以下 FIO 基准:
- 128K 连续
- 64K随机
- 16K随机
- 4K随机
由于高容量 QLC SSD 专为大传输尺寸而设计,我们的写入速度测试仅限于 16K 随机数据。对于 4K 数据,我们利用 16K 工作负载的预填充状态来仅测量 4K 随机读取性能。
128K 顺序前提条件 (IODepth 256 / NumJobs 1)
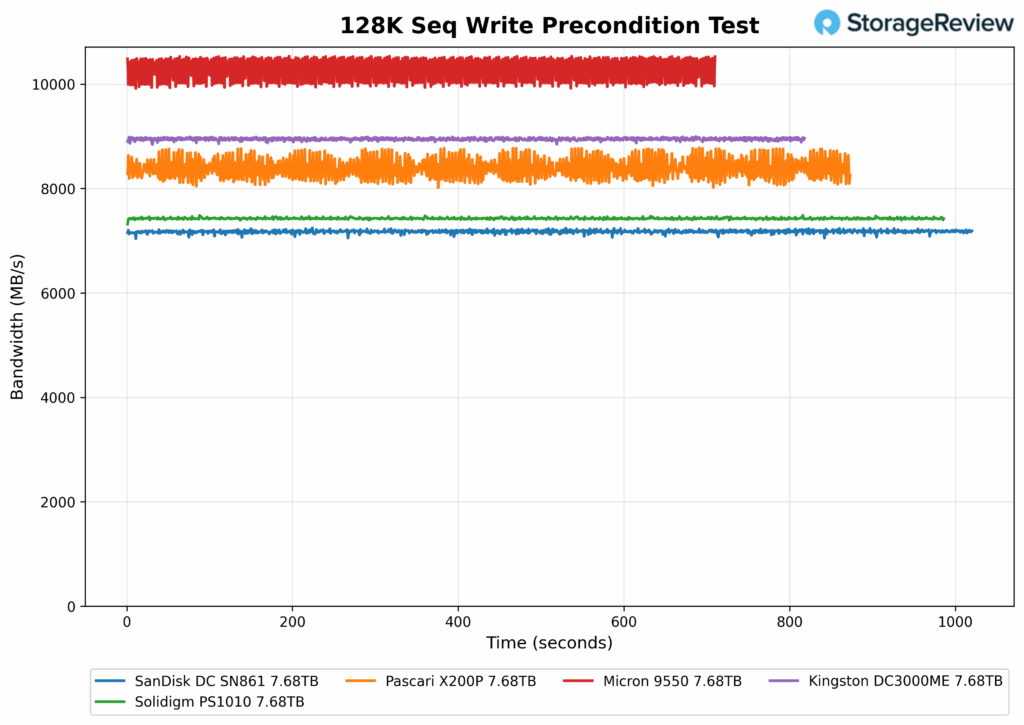
在这项高队列深度预处理测试中,金士顿 DC3000ME 在 8,944.9 秒的运行过程中保持了 1,000MB/s 的稳定写入带宽(尽管测试刚过 800 秒就结束了)。虽然速度并非最快(略逊于美光 9550,后者的峰值达到了 10.3GB/s),但金士顿 DC3000ME 表现出了稳定的吞吐量,且波动很小。
128K 顺序预处理延迟 (IODepth 256 / NumJobs 1)
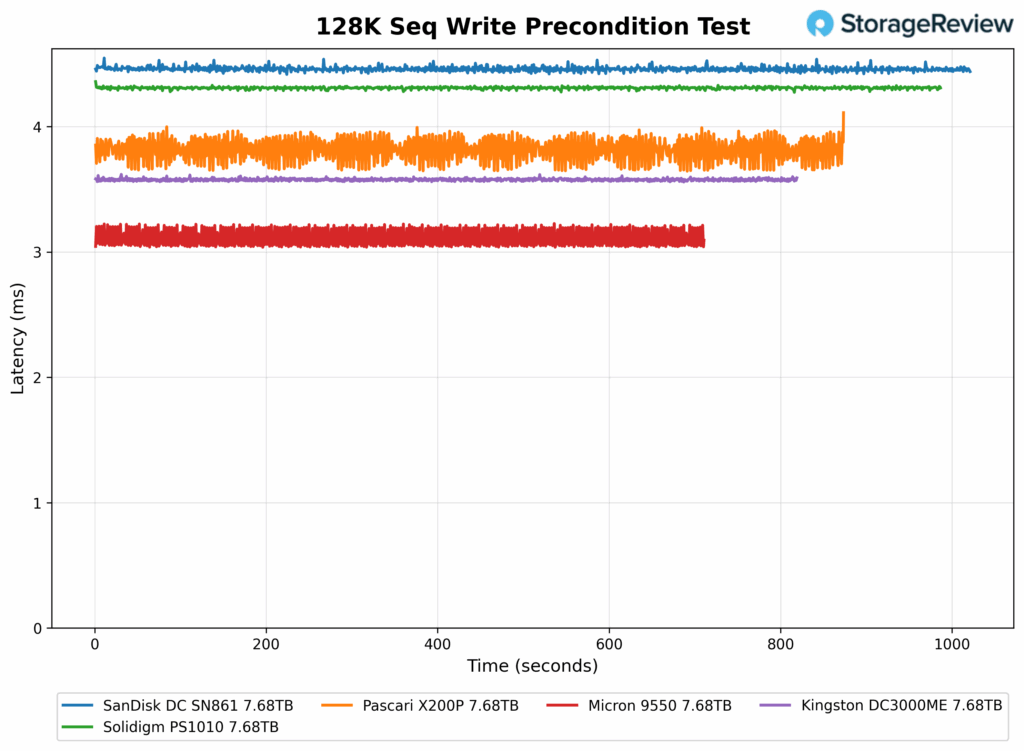
在 128K 顺序写入预设延迟测试中,金士顿 DC3000ME 的平均延迟为 3.577 毫秒(随时间保持稳定,波动最小),仅次于美光硬盘。
128K 顺序写入(IODepth 16/NumJobs 1)
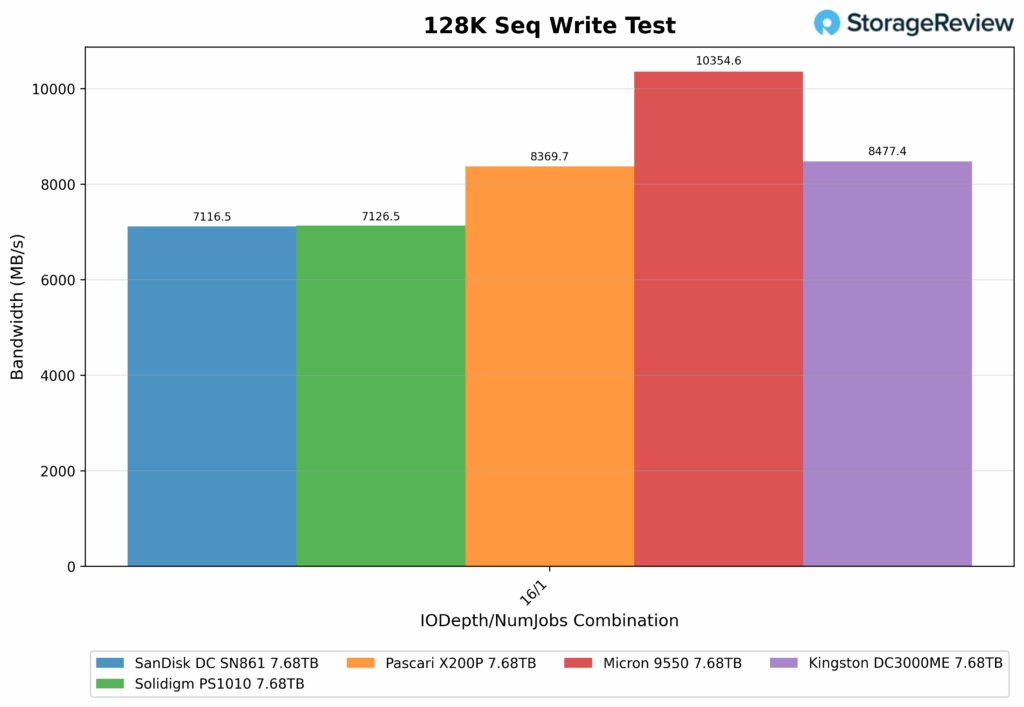
在 128K 顺序写入测试中,金士顿 DC3000ME 的速度达到了 8,477.4MB/s,略低于美光 9550,后者的速度为 10,354.6MB/s,位居榜首。金士顿 DC3000ME 的表现优于 Pascari X200P,并稳固领先于 Solidigm PS1010 和闪迪 SN861,后者的速度均在 7,100MB/s 左右。金士顿的表现体现了速度与稳定性之间的良好平衡。
128K 顺序写入延迟 (IODepth 16 / NumJobs 1)
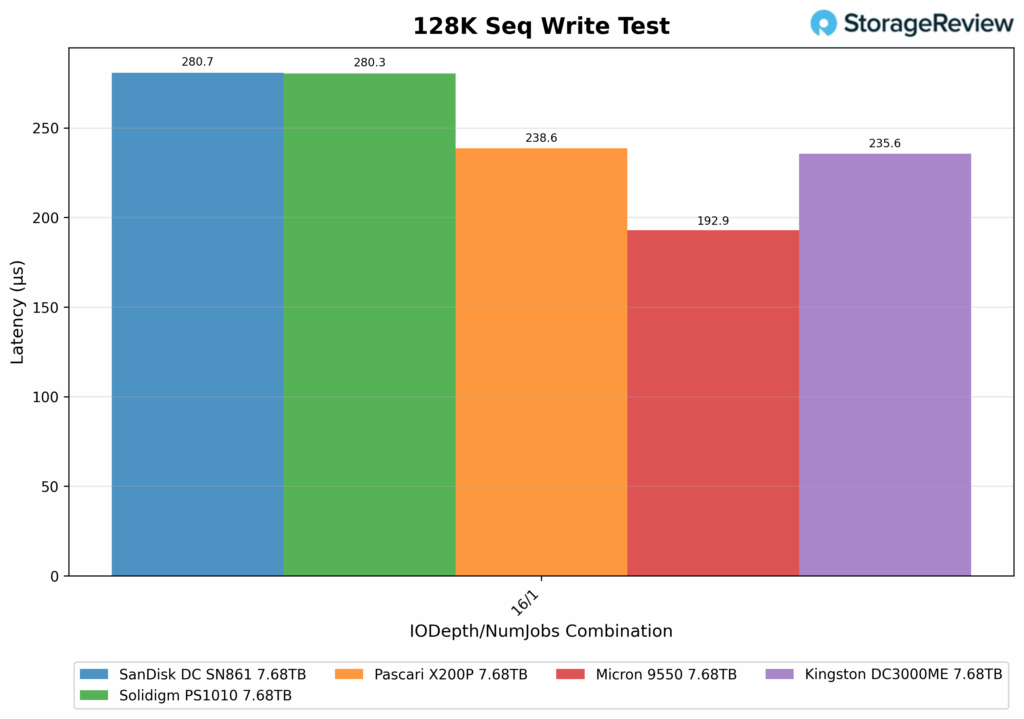
在 128K 顺序写入延迟测试中,金士顿 DC3000ME 表现出色,平均延迟为 235.6µs。这使其领先于闪迪 SN861 和 Solidigm PS1010,后两者的延迟分别为 280.7µs 和 280.3µs。虽然速度不如美光 9550(延迟为 192.9µs),但金士顿 DC3000ME 仍保持竞争力,并且略胜 Pascari X200P(延迟为 238.6µs)。
128K 顺序读取(IODepth 64 / NumJobs 1)
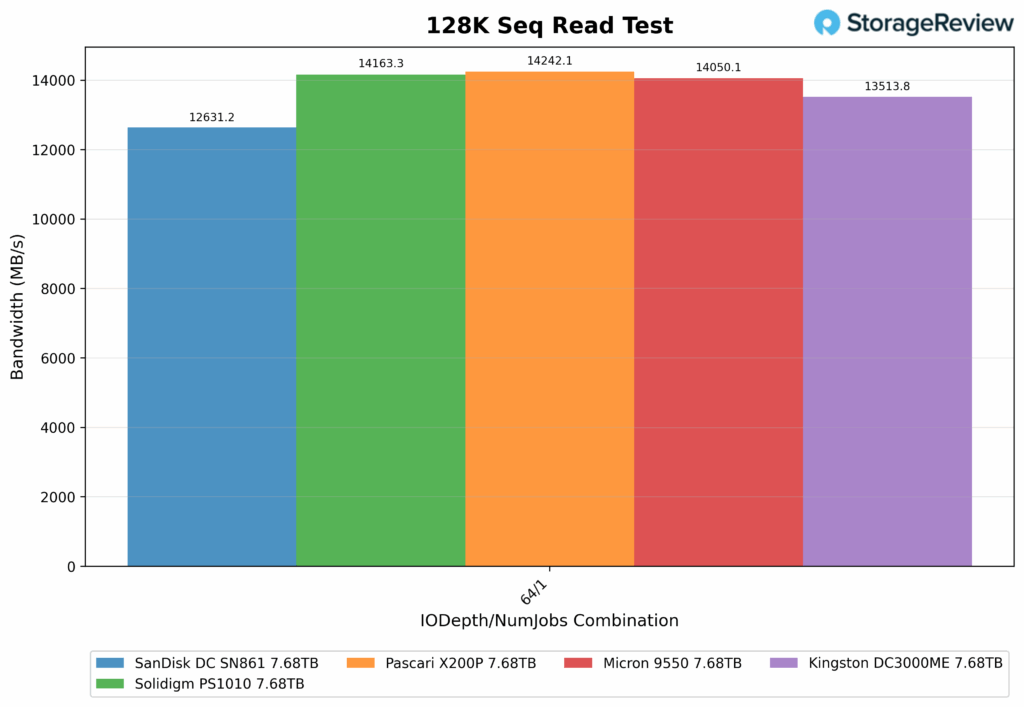
在队列深度为 128 的 64K 顺序读取测试中,单任务执行速度达到 3000MB/s。虽然这在测试的硬盘中排名第四,但它仍然提供了强劲的吞吐量(实际差异很小)。它落后于 Pascari X13,513.8P(200MB/s)约 14,242.1%,落后于 Solidigm PS5.1(1010MB/s)约 14,163.3%,落后于 Micron 4.6(9550MB/s)约 14,050.1%。它也轻松超越了 SanDisk SN3.8,后者的速度较低,仅为 861MB/s。尽管如此,金士顿 DC12,631.2ME 的成绩仍然强劲,与测试中的顶级硬盘相比,差距很小。
128K 顺序读取延迟 (IODepth 64 / NumJobs 1)
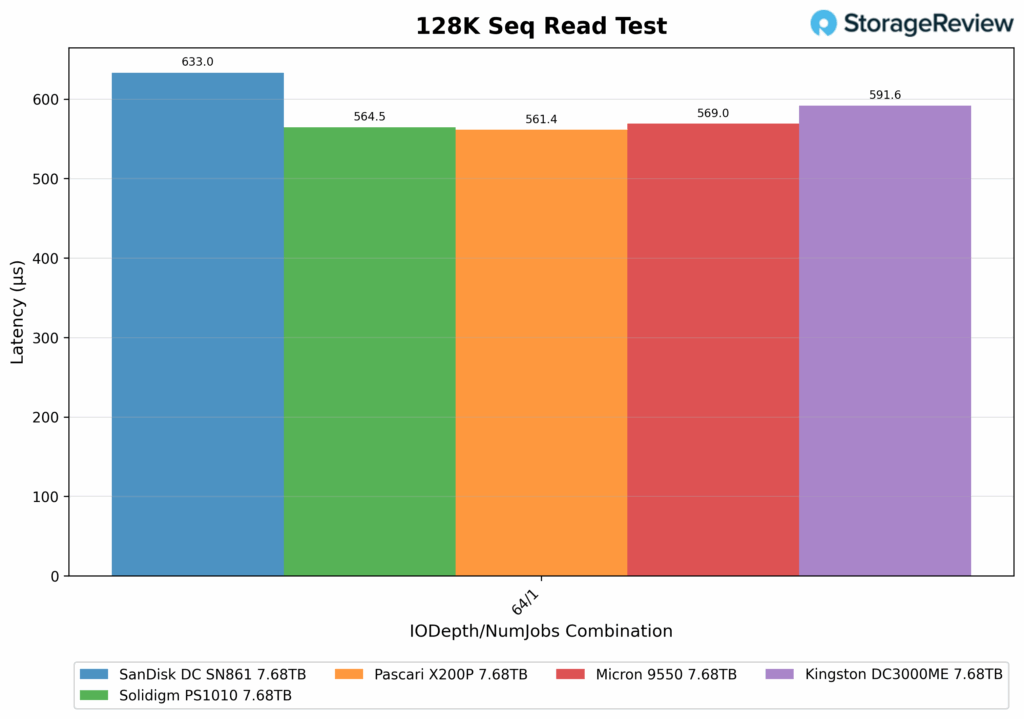
延迟方面,金士顿 DC3000ME 的平均延迟为 591.6µs,处于中等水平。该结果比美光 5.4(9550µs)高 569.0%,比 Solidigm PS5.4(1010µs)低 564.5%。Pascari X200P 以 561.4µs 的延迟略微领先,而闪迪 SN861 的响应速度最慢,为 633.0µs。最终,金士顿 DC3000ME 在高队列深度读取条件下保持了相对较低的延迟。
64K 随机写入
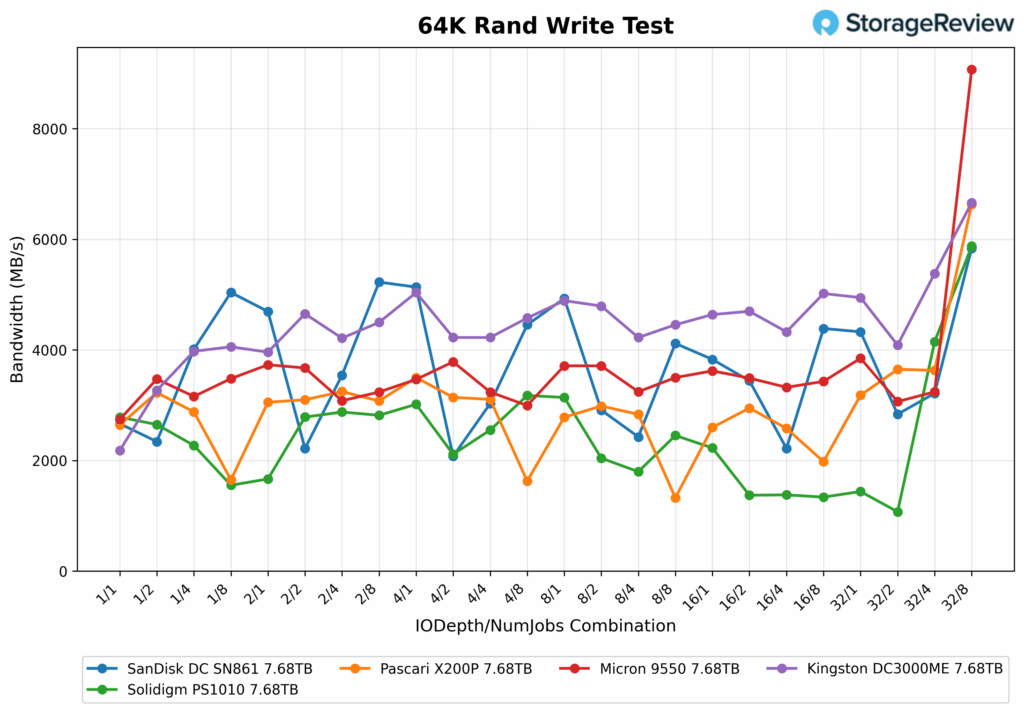
在 64K 随机写入测试中,金士顿 DC3000ME 在各种队列深度和线程组合下始终保持高性能,在 6,649(IO 深度)/32(作业数)配置下峰值达到 8MB/s。这一成绩在所有工作负载和测试点中名列前茅。
纵观整个图表,金士顿 DC3000ME 的带宽趋势在 4,000 至 5,000MB/s 之间保持稳定,在中高并发设置下表现尤为强劲,例如 32/4(5,380MB/s)和 16/8(5,017MB/s)。即使在 1/4 和 2/4 等较轻的条件下,其带宽也保持在 4200MB/s 以上。与其他硬盘相比,金士顿 DC3000ME 在大多数测试点上通常处于领先或接近领先水平,在整个测试过程中既提供了高峰值吞吐量,又提供了稳定的性能。
64K随机写入延迟
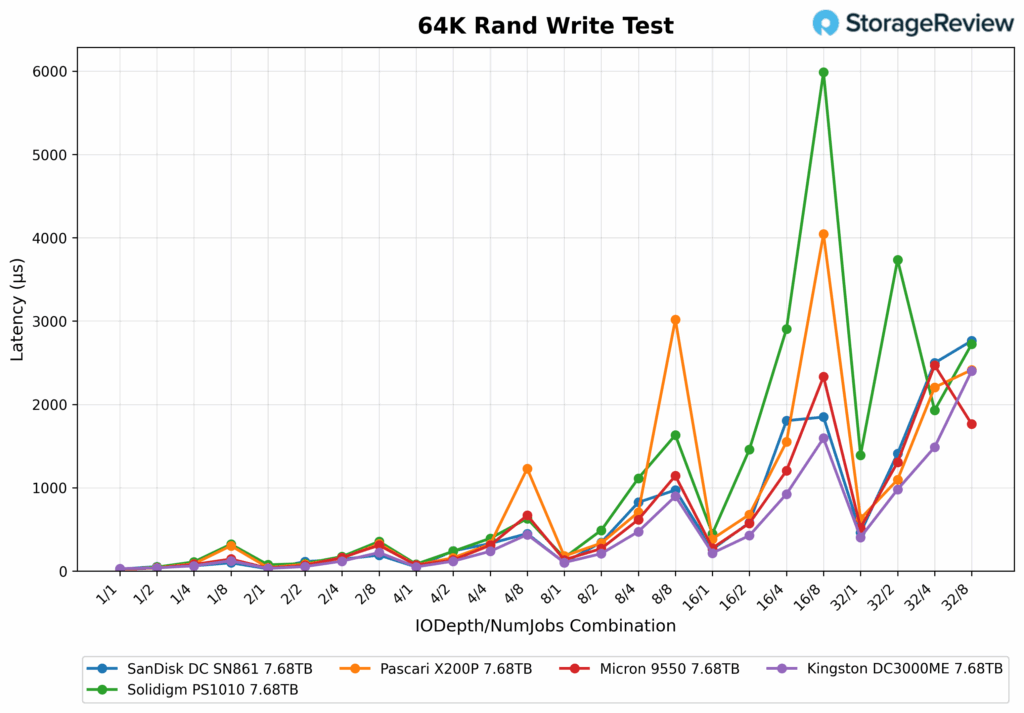
在 64K 随机写入延迟测试中,金士顿 DC3000ME 在大多数队列深度和作业组合下始终保持较低的响应时间,即使在高负载下也展现出强大的写入效率。例如:
- 在 4/1 时,显示 49µs
- 在 8/1 时,延迟保持在 102µs 的低位
- 在 16/4 时,测量时间为 1,486µs
- 在最高测试负载 32/8 下,它达到了 2,402µs
这些结果表明,金士顿 DC3000ME 的扩展性可预测,避免了其他驱动器中出现的严重延迟峰值,尤其是 Pascari 和 Solidigm 驱动器,它们在 3,000–6,000µs 以上表现出不稳定的跳跃(最明显的是 16/8)。
64K 随机读取
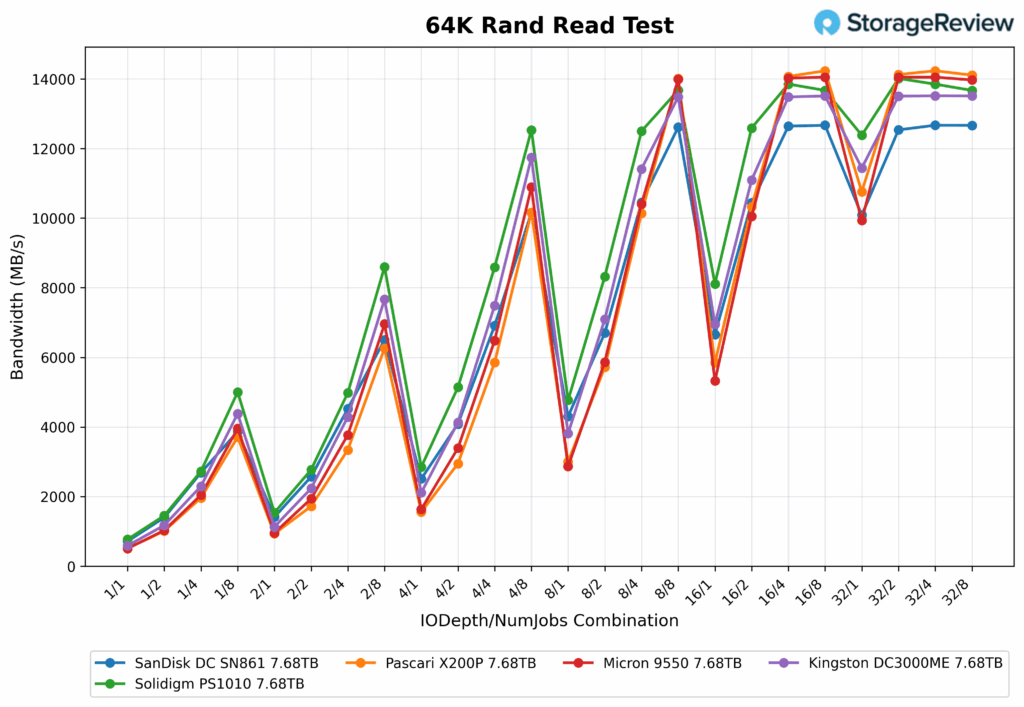
在 64K 随机读取测试中,金士顿 DC3000ME 在整个 IOdepth/NumJobs 矩阵中表现出色且性能稳定,最终位居第四(略微领先)。峰值带宽在 13,515/32 时达到 4MB/s,在 16/4(13,482MB/s)和 32/8(13,512MB/s)时也达到了类似的高吞吐量,在高并行读取工作负载下展现出卓越的可扩展性。在 1/4 和 2/2 等较低负载下,金士顿 DC3000ME 的测得速度分别为 2,298MB/s 和 2,234MB/s。
64K随机读取延迟
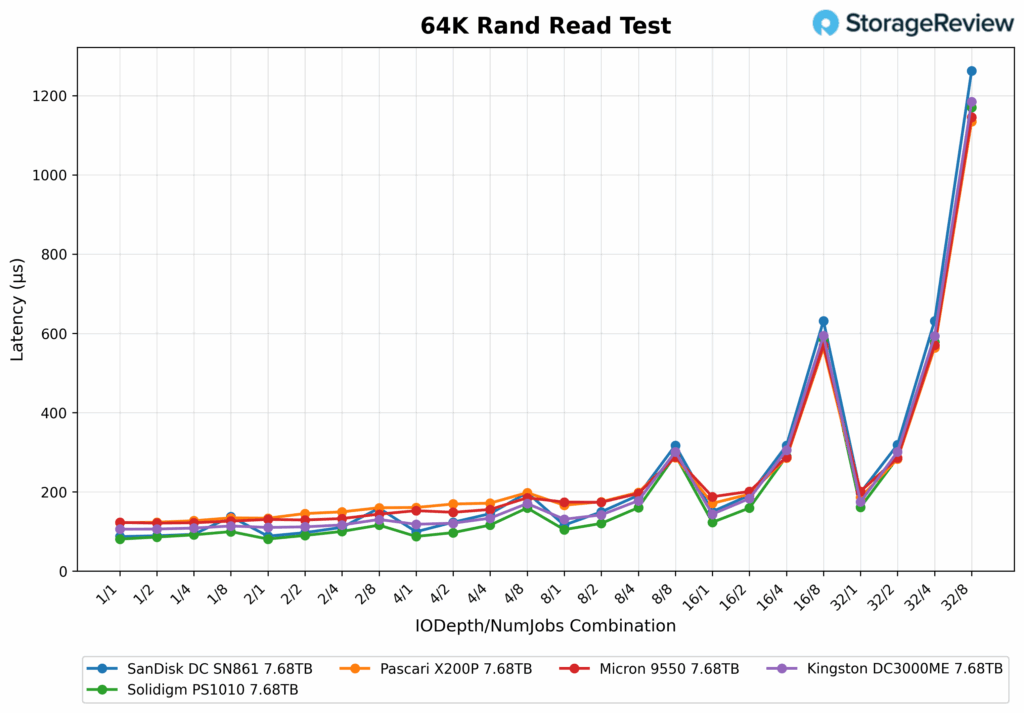
金士顿 DC3000ME 64K 延迟在所有测试点都保持相对较低。所有硬盘的表现都相似,尽管闪迪 SN861 在测试结束时的峰值明显高于所有其他测试硬盘。从 1/2 开始,金士顿 DC3000ME 的延迟为 106µs,108/1 时为 4µs,131/8 时为 1µs,133/4 时为 4µs,177/8 时为 4µs。在更高的并发度下,延迟在 305/16 时增加到 4µs,174/32 时为 1µs,301/32 时为 2µs,并在 1,184/32 时达到峰值 8µs,与同类产品持平。总体而言,金士顿 DC3000ME 的延迟曲线与顶级产品非常接近,抖动或异常峰值极小(所有测试的驱动器都是这种情况)
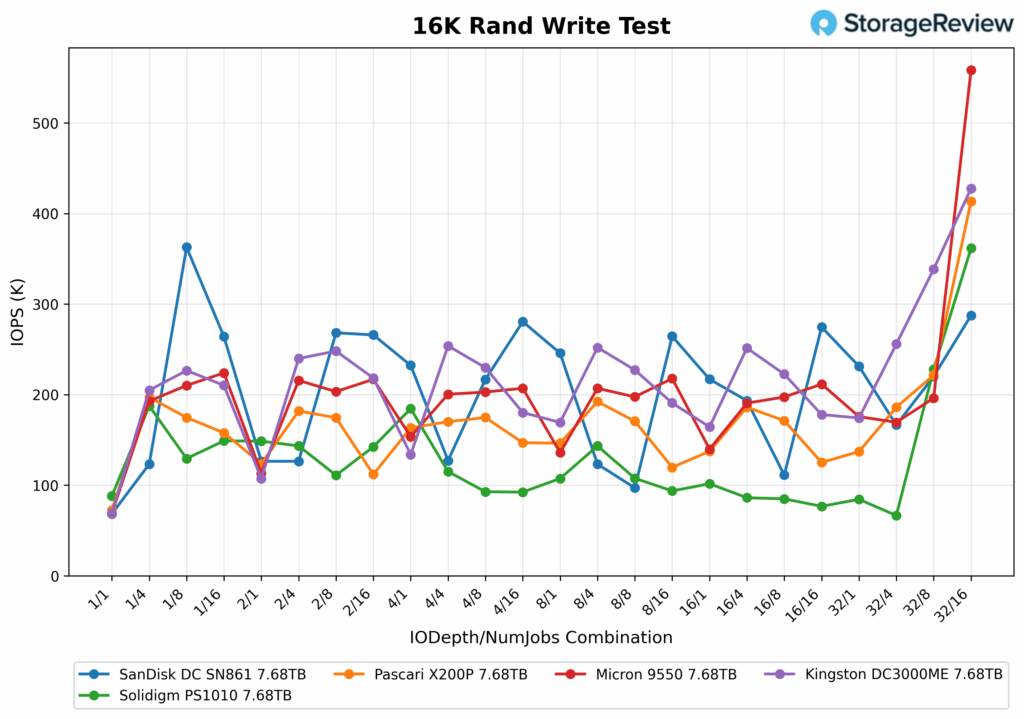
16K 随机写入
在 16K 随机写入测试中,金士顿 DC3000ME 在所有队列深度和线程数范围内均展现出强劲的带宽,最终在竞品硬盘中位居第二。在 427,592/32 配置下,其最高 IOPS 达到了 16。其他优异表现包括 338,521/32 配置下的 8 IOPS、251,428/16 配置下的 4 IOPS 以及 226,606/1 配置下的 8 IOPS,这些均在不同并行负载下展现出卓越的控制器效率。即使在 2/16 和 1/4 等中等负载设置下,该硬盘也分别达到了 218,300 IOPS 和 204,867 IOPS。总体而言,金士顿 DC3000ME 在整个测试矩阵中(除少数区域外)始终保持 160,000 以上的 IOPS,使其成为此类工作负载下性能较为均衡的硬盘之一。
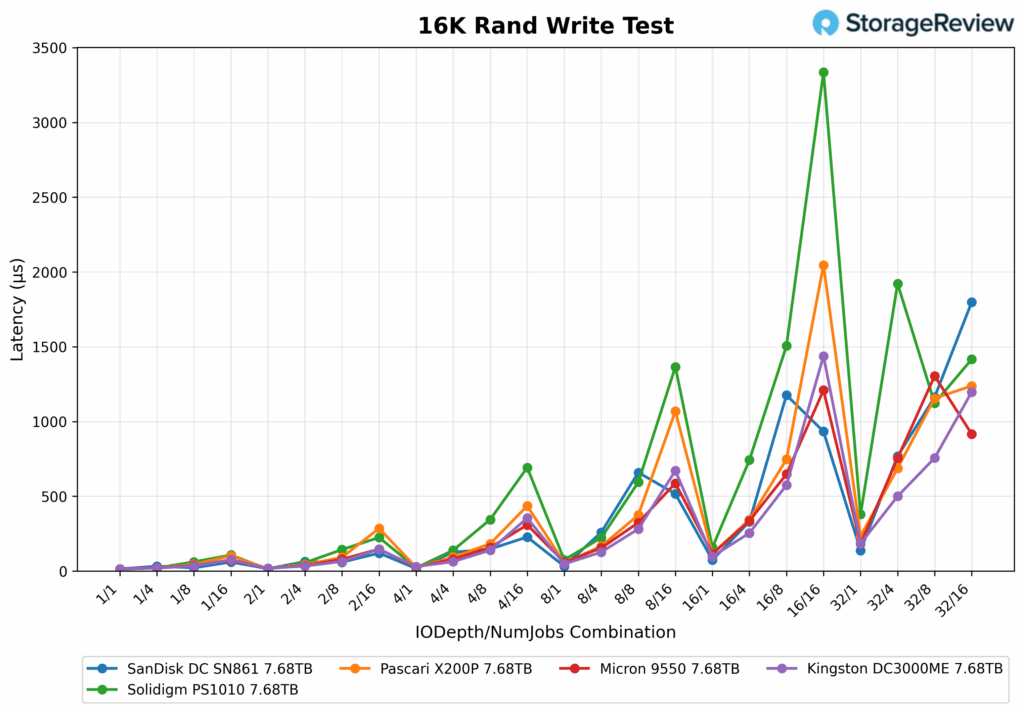
16K随机写入延迟
金士顿 DC3000ME 16K 写入延迟性能非常稳定,在测试结束时位居榜首(Pascari 硬盘以微弱差距落后)。金士顿 DC3000ME 的亮点包括:14/1 倍速时 1µs,18/2 倍速时 1µs,19/1 倍速时 4µs,29/1 倍速时 2µs。随着负载增加,金士顿保持了良好的延迟曲线:126/8 倍速时 4µs,146/2 倍速时 16µs,254/16 倍速时 4µs,575/16 倍速时 8µs。即使在最重的配置 32/16 下,延迟也保持在 1,197µs 的范围内。
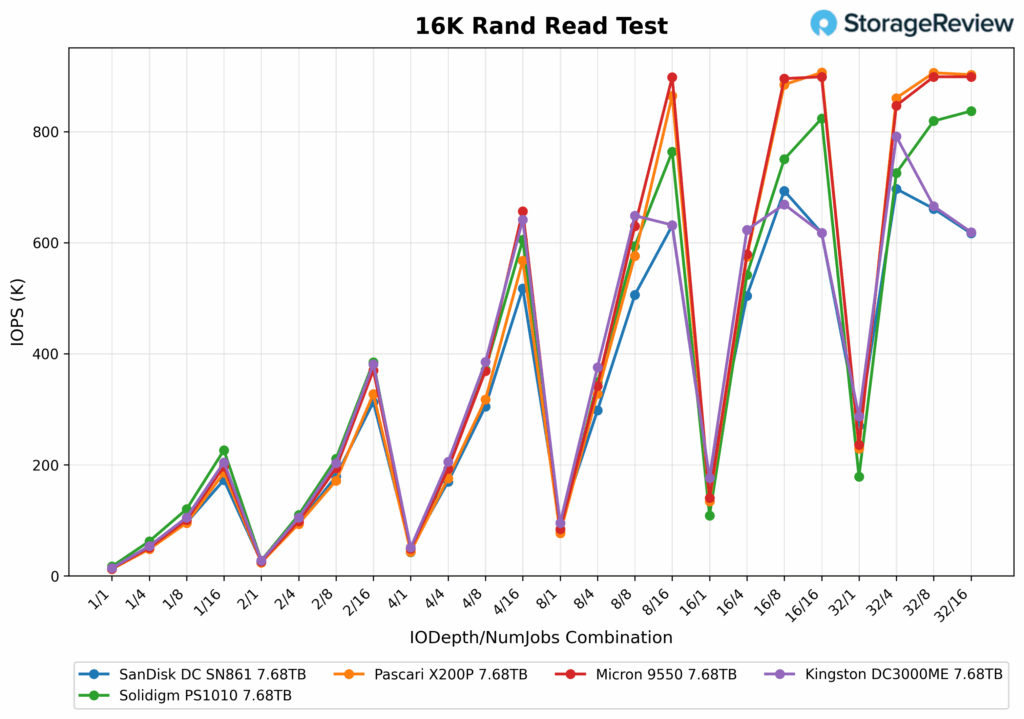
16K随机读取
在16K随机读取条件下,金士顿DC3000ME一直保持着强劲的性能,直到达到8/8时才开始略微落后。峰值IOPS在QD800(648,686个作业)下略低于32K(641),其次是QD4(16个作业)下的623K IOPS,以及QD16(3000个作业)下的XNUMXK IOPS。遗憾的是,金士顿DCXNUMXME最终与闪迪SanDisk硬盘一起,在排行榜上垫底。
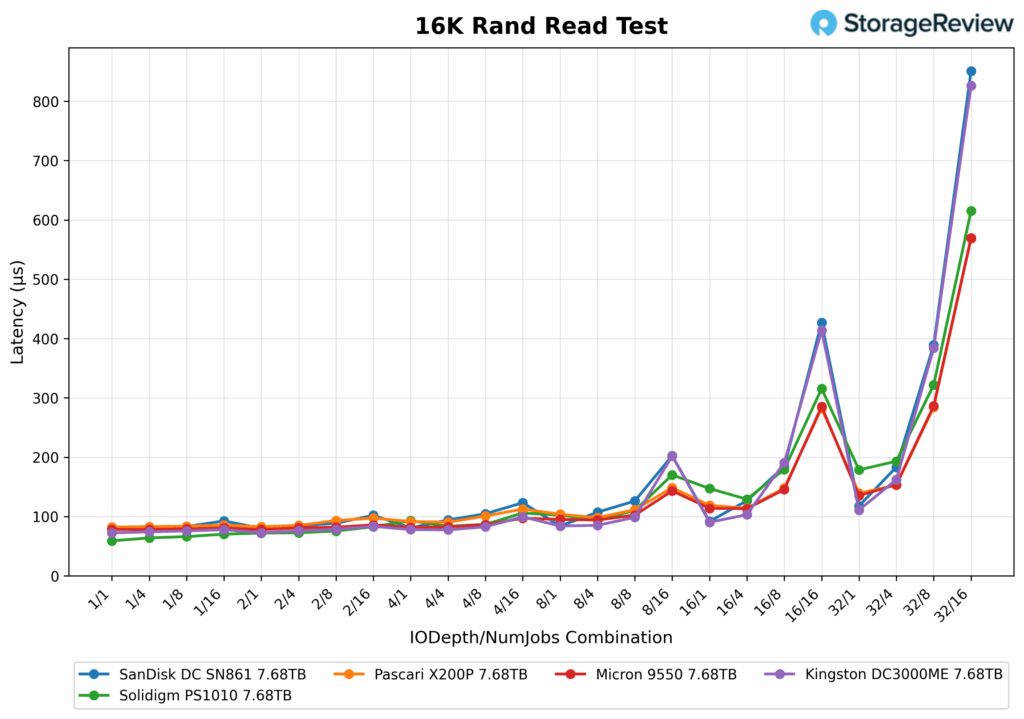
16K随机读取延迟
在峰值吞吐量(QD8/8)下,金士顿 DC3000ME 的延迟仅为 99µs,并且在大多数配置下都保持在一个较窄的低延迟范围内,直到 16/8 左右才开始出现问题。在 QD1/4 下观察到最佳延迟(74µs),在低到中等队列深度下也观察到了其他低于 80µs 的结果。在 QD32/16 等更重的负载下,金士顿 DC3000ME 的延迟为 826µs,明显高于其他测试的硬盘(SanDisk 除外)。
4K 随机读取
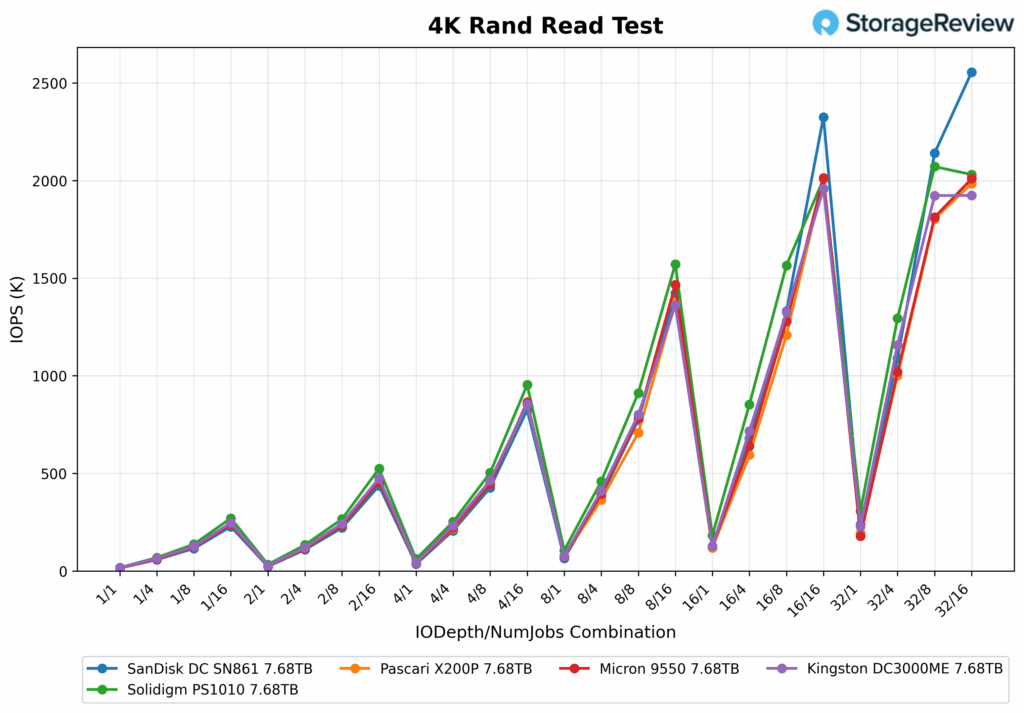
在 4K 随机读取测试中,金士顿 DC3000ME 在整个测试范围内表现出色,在 1,957.92/16 配置下峰值达到 16K IOPS。它在 1,923.42/32 配置下保持了 8K IOPS 的高吞吐量,在 1,361.32/8 配置下为 16K IOPS,在 1326.03/16 配置下为 8K IOPS,与 Solidigm 和美光一起持续位居榜首。
 4K随机读取延迟
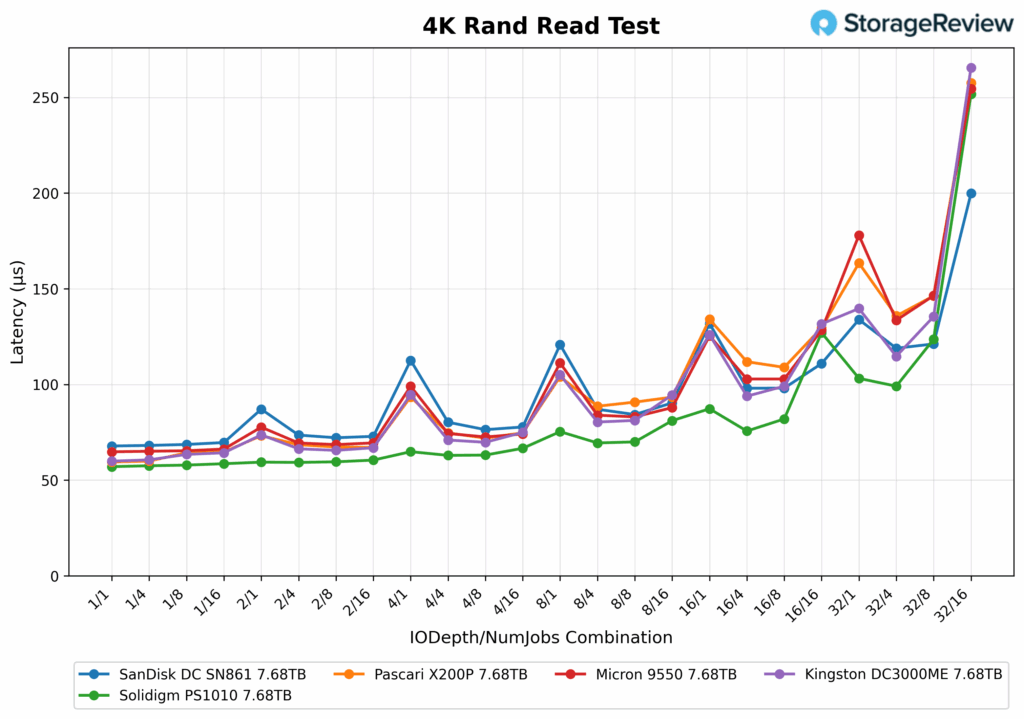
 4K随机读取延迟
金士顿 DC3000ME 在整个 4K 随机读取测试中保持低延迟,在 60/1 配置下最低为 1µs。在 1/4 配置下,延迟略有提升至 61µs,在 1/8 配置下则稳定在 63µs。随着并发性的增加,金士顿 DC3000ME 的延迟呈现可预测的上升趋势:66/2 配置下为 4µs,67/2 配置下为 16µs,71/4 配置下为 4µs,80/8 配置下为 4µs。在更高配置下,延迟略有上升:94/16 配置下为 4µs,99/16 配置下为 8µs,135/32 配置下为 8µs,266/32 配置下则达到峰值 16µs。
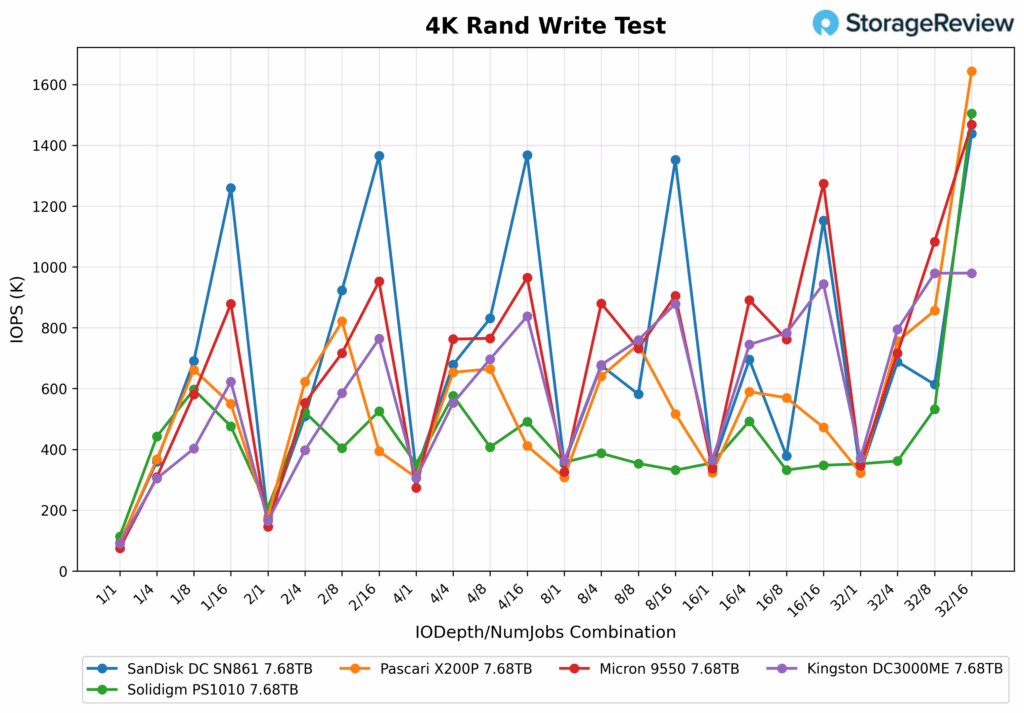
4K 随机写入
在4K随机写入方面,金士顿DC3000ME表现强劲,在979,636/32倍速下最高可达16 IOPS,在979.173/32倍速下最高可达8 IOPS,远逊于表现最佳的Pascari X200P,后者峰值超过1.6万IOPS。即便如此,金士顿DC3000ME在中等负载下的表现也相当不错,例如在879/8倍速下为16K IOPS,在944/16倍速下为16K IOPS,在745/16倍速下为4K IOPS。
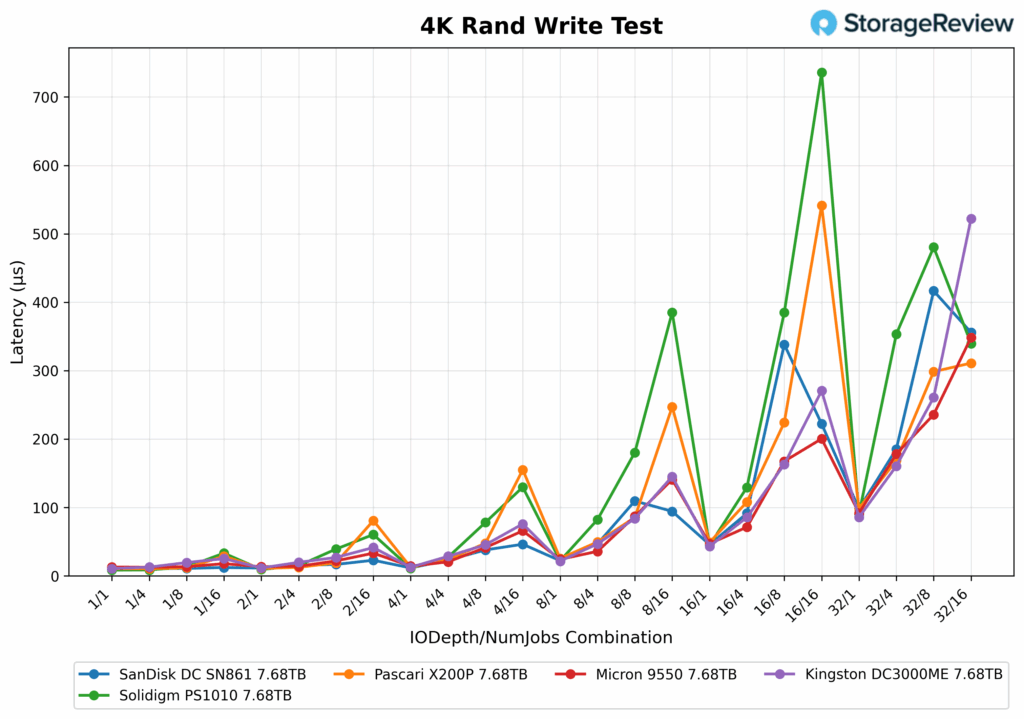
4K随机写入延迟
在随机写入延迟方面,金士顿 DC3000ME 在 11/1 深度下起始延迟为 1µs,在达到 20/50 深度之前保持在 8-8µs 左右,在 261/32 深度下扩展至 8µs,在 522/32 深度下扩展至 16µs。虽然延迟并非最低,但金士顿 DC3000ME 保持了可预测且适度的扩展,没有像 Solidigm 和 Pasarci 等驱动器那样出现峰值,而后者在超过 16 个线程后波动较大。
GPU 直接存储
我们在这个测试平台上进行的测试之一是 Magnum IO GPU 直接存储 (GDS) 测试。GDS 是 NVIDIA 开发的一项功能,允许 GPU 在访问存储在 NVMe 驱动器或其他高速存储设备上的数据时绕过 CPU。GDS 无需通过 CPU 和系统内存路由数据,而是实现 GPU 和存储设备之间的直接通信,从而显著降低延迟并提高数据吞吐量。
GPU 直接存储的工作原理
传统上,当 GPU 处理存储在 NVMe 驱动器上的数据时,数据必须先经过 CPU 和系统内存,然后才能到达 GPU。这个过程会造成瓶颈,因为 CPU 会成为中间人,增加延迟并消耗宝贵的系统资源。GPU 直接存储通过使 GPU 能够通过 PCIe 总线直接从存储设备访问数据,消除了这种低效率。这种直接路径减少了与数据移动相关的开销,从而实现了更快、更高效的数据传输。
AI 工作负载(尤其是涉及深度学习的工作负载)是高度数据密集型的。训练大型神经网络需要处理数 TB 的数据,数据传输的任何延迟都可能导致 GPU 利用率不足和训练时间延长。GPU Direct Storage 通过确保尽快将数据传送到 GPU、最大限度地减少空闲时间并最大限度地提高计算效率来解决这一挑战。
此外,GDS 对于涉及流式传输大型数据集的工作负载(例如视频处理、自然语言处理或实时推理)尤其有益。通过减少对 CPU 的依赖,GDS 可加速数据移动并释放 CPU 资源以用于其他任务,从而进一步提高整体系统性能。
读取吞吐量
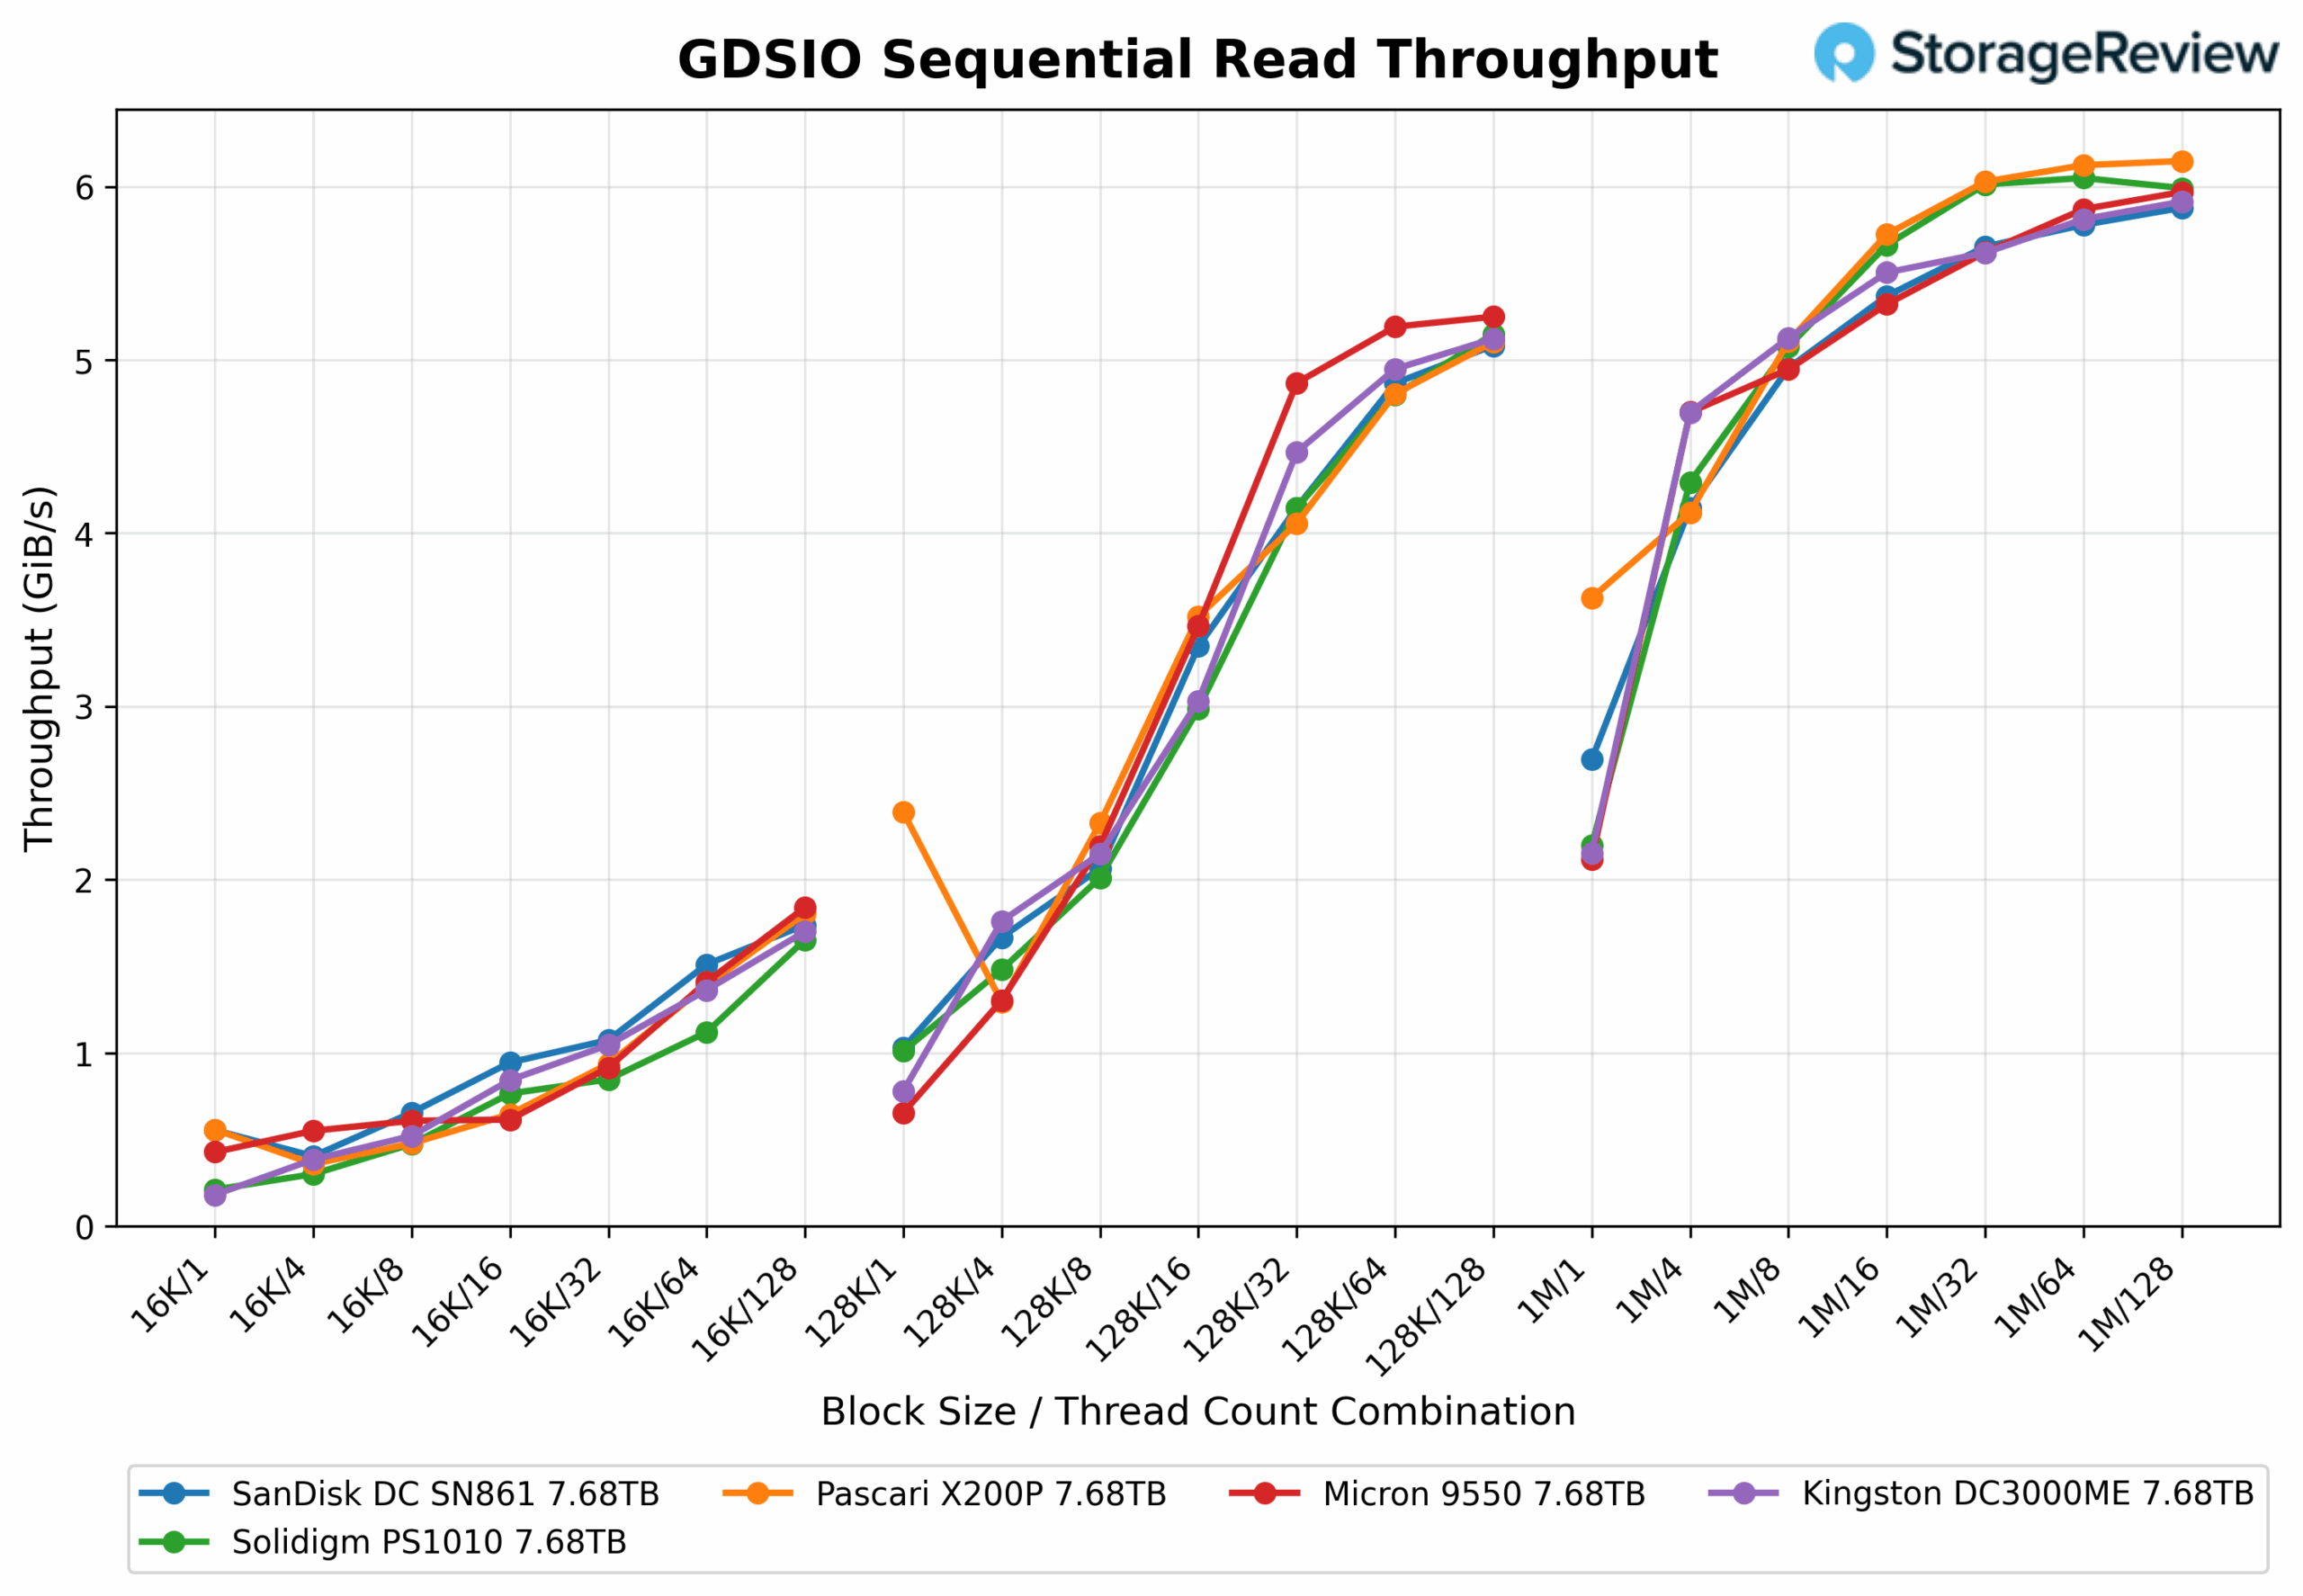
在我们的 GDSIO 顺序读取测试中,金士顿 DC3000ME 在 16K、128K 和 1MB 块大小下均展现出一致高效的吞吐量扩展,但性能趋势会因传输大小而略有不同。在 16K 块大小下,吞吐量随着线程数的增加而稳步上升,金士顿 DC3000ME 在 3.70 个线程时达到峰值 32GiB/s,然后在 3.41 个线程时逐渐下降至 128GiB/s。对于 128K 传输,该驱动器在 5.88 个线程时达到了 16GiB/s 的最佳结果,并在 32 个线程时保持该水平,然后在 5.35 个线程时下降至 128GiB/s 左右。在 1MB 大小下,金士顿 DC3000ME 吞吐量较早达到稳定状态,在 6.54 个线程时达到 16GiB/s,在 5.91 个线程时略微下降至 128GiB/s。
阅读延迟
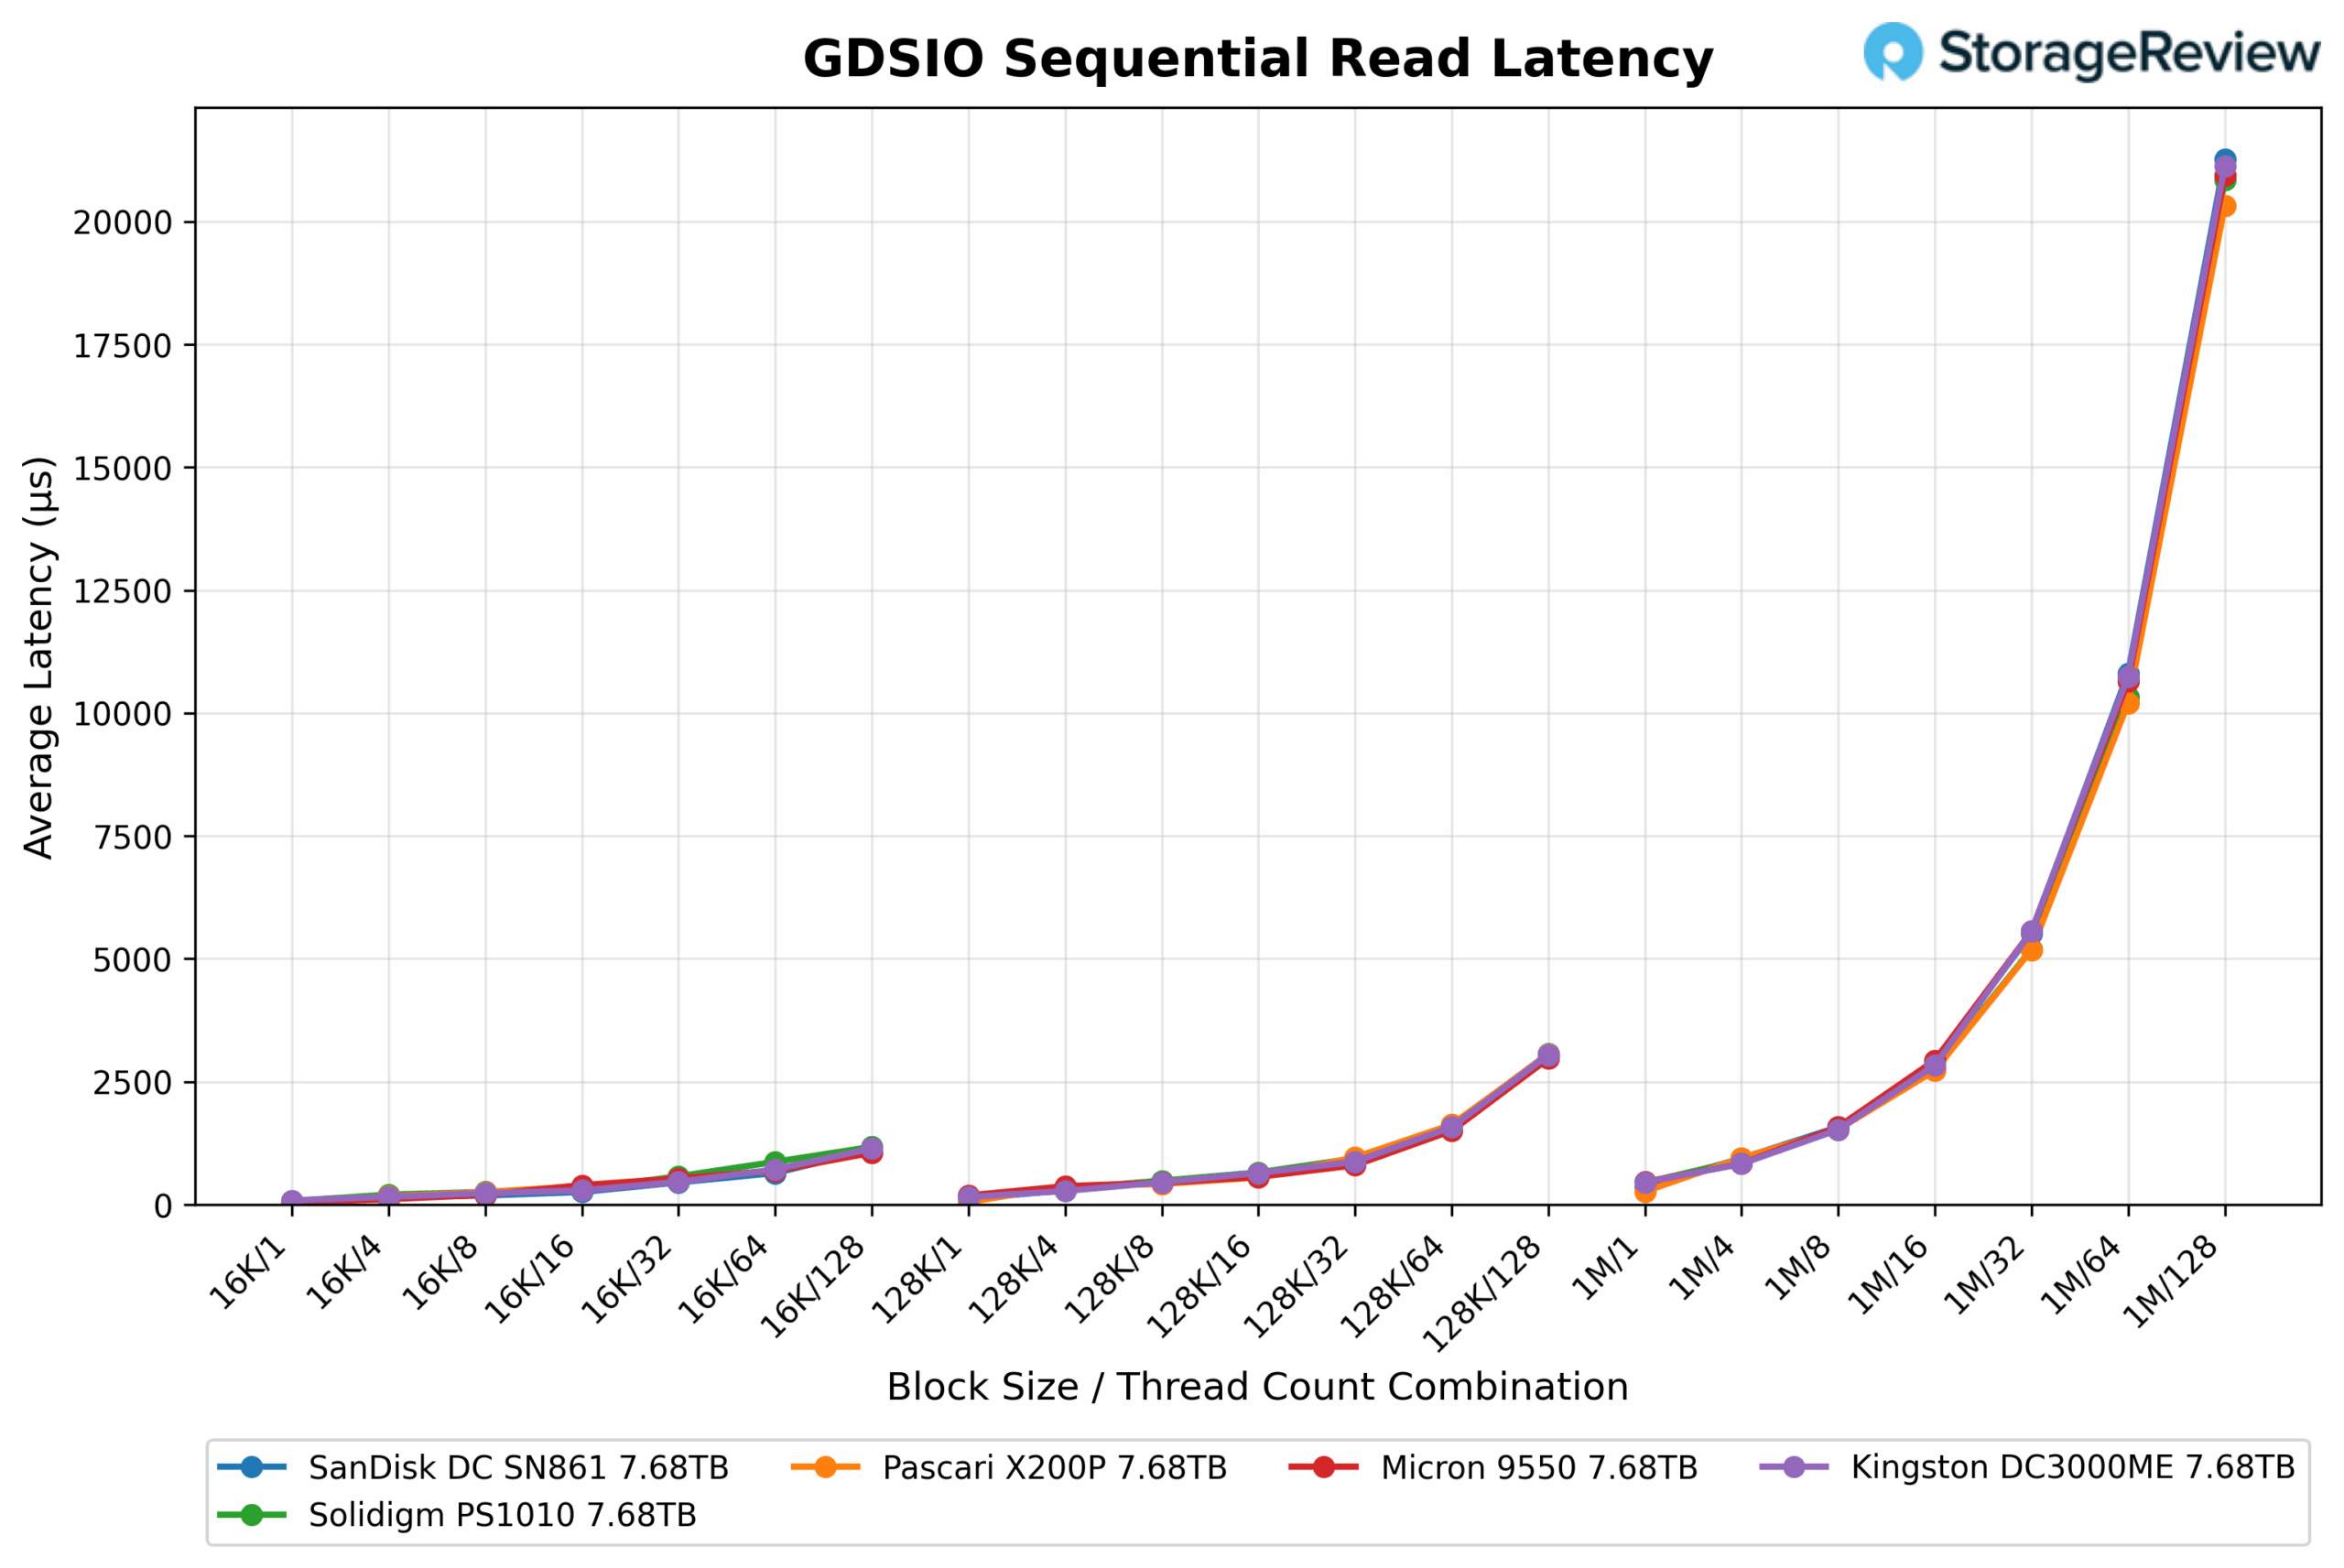
在延迟方面,DC3000ME 表现出可预测的扩展性(所有测试的硬盘都是如此):较低的线程数在所有块大小上都产生了较短的响应时间,并且随着线程数的增加,延迟会增加。在 16K 时,延迟从 504µs 开始,到 582 个线程时逐渐增加到 128µs。在 128K 时,金士顿 DC3000ME 的延迟从 2,60µs 开始,在最高线程数时增加到 3,228µs。在 1MB 块大小下,由于负载较大,延迟出现了更大的跃升,从单线程时的 2,609µs 开始,到 2,703 个线程时增加到 128µs。
写吞吐量
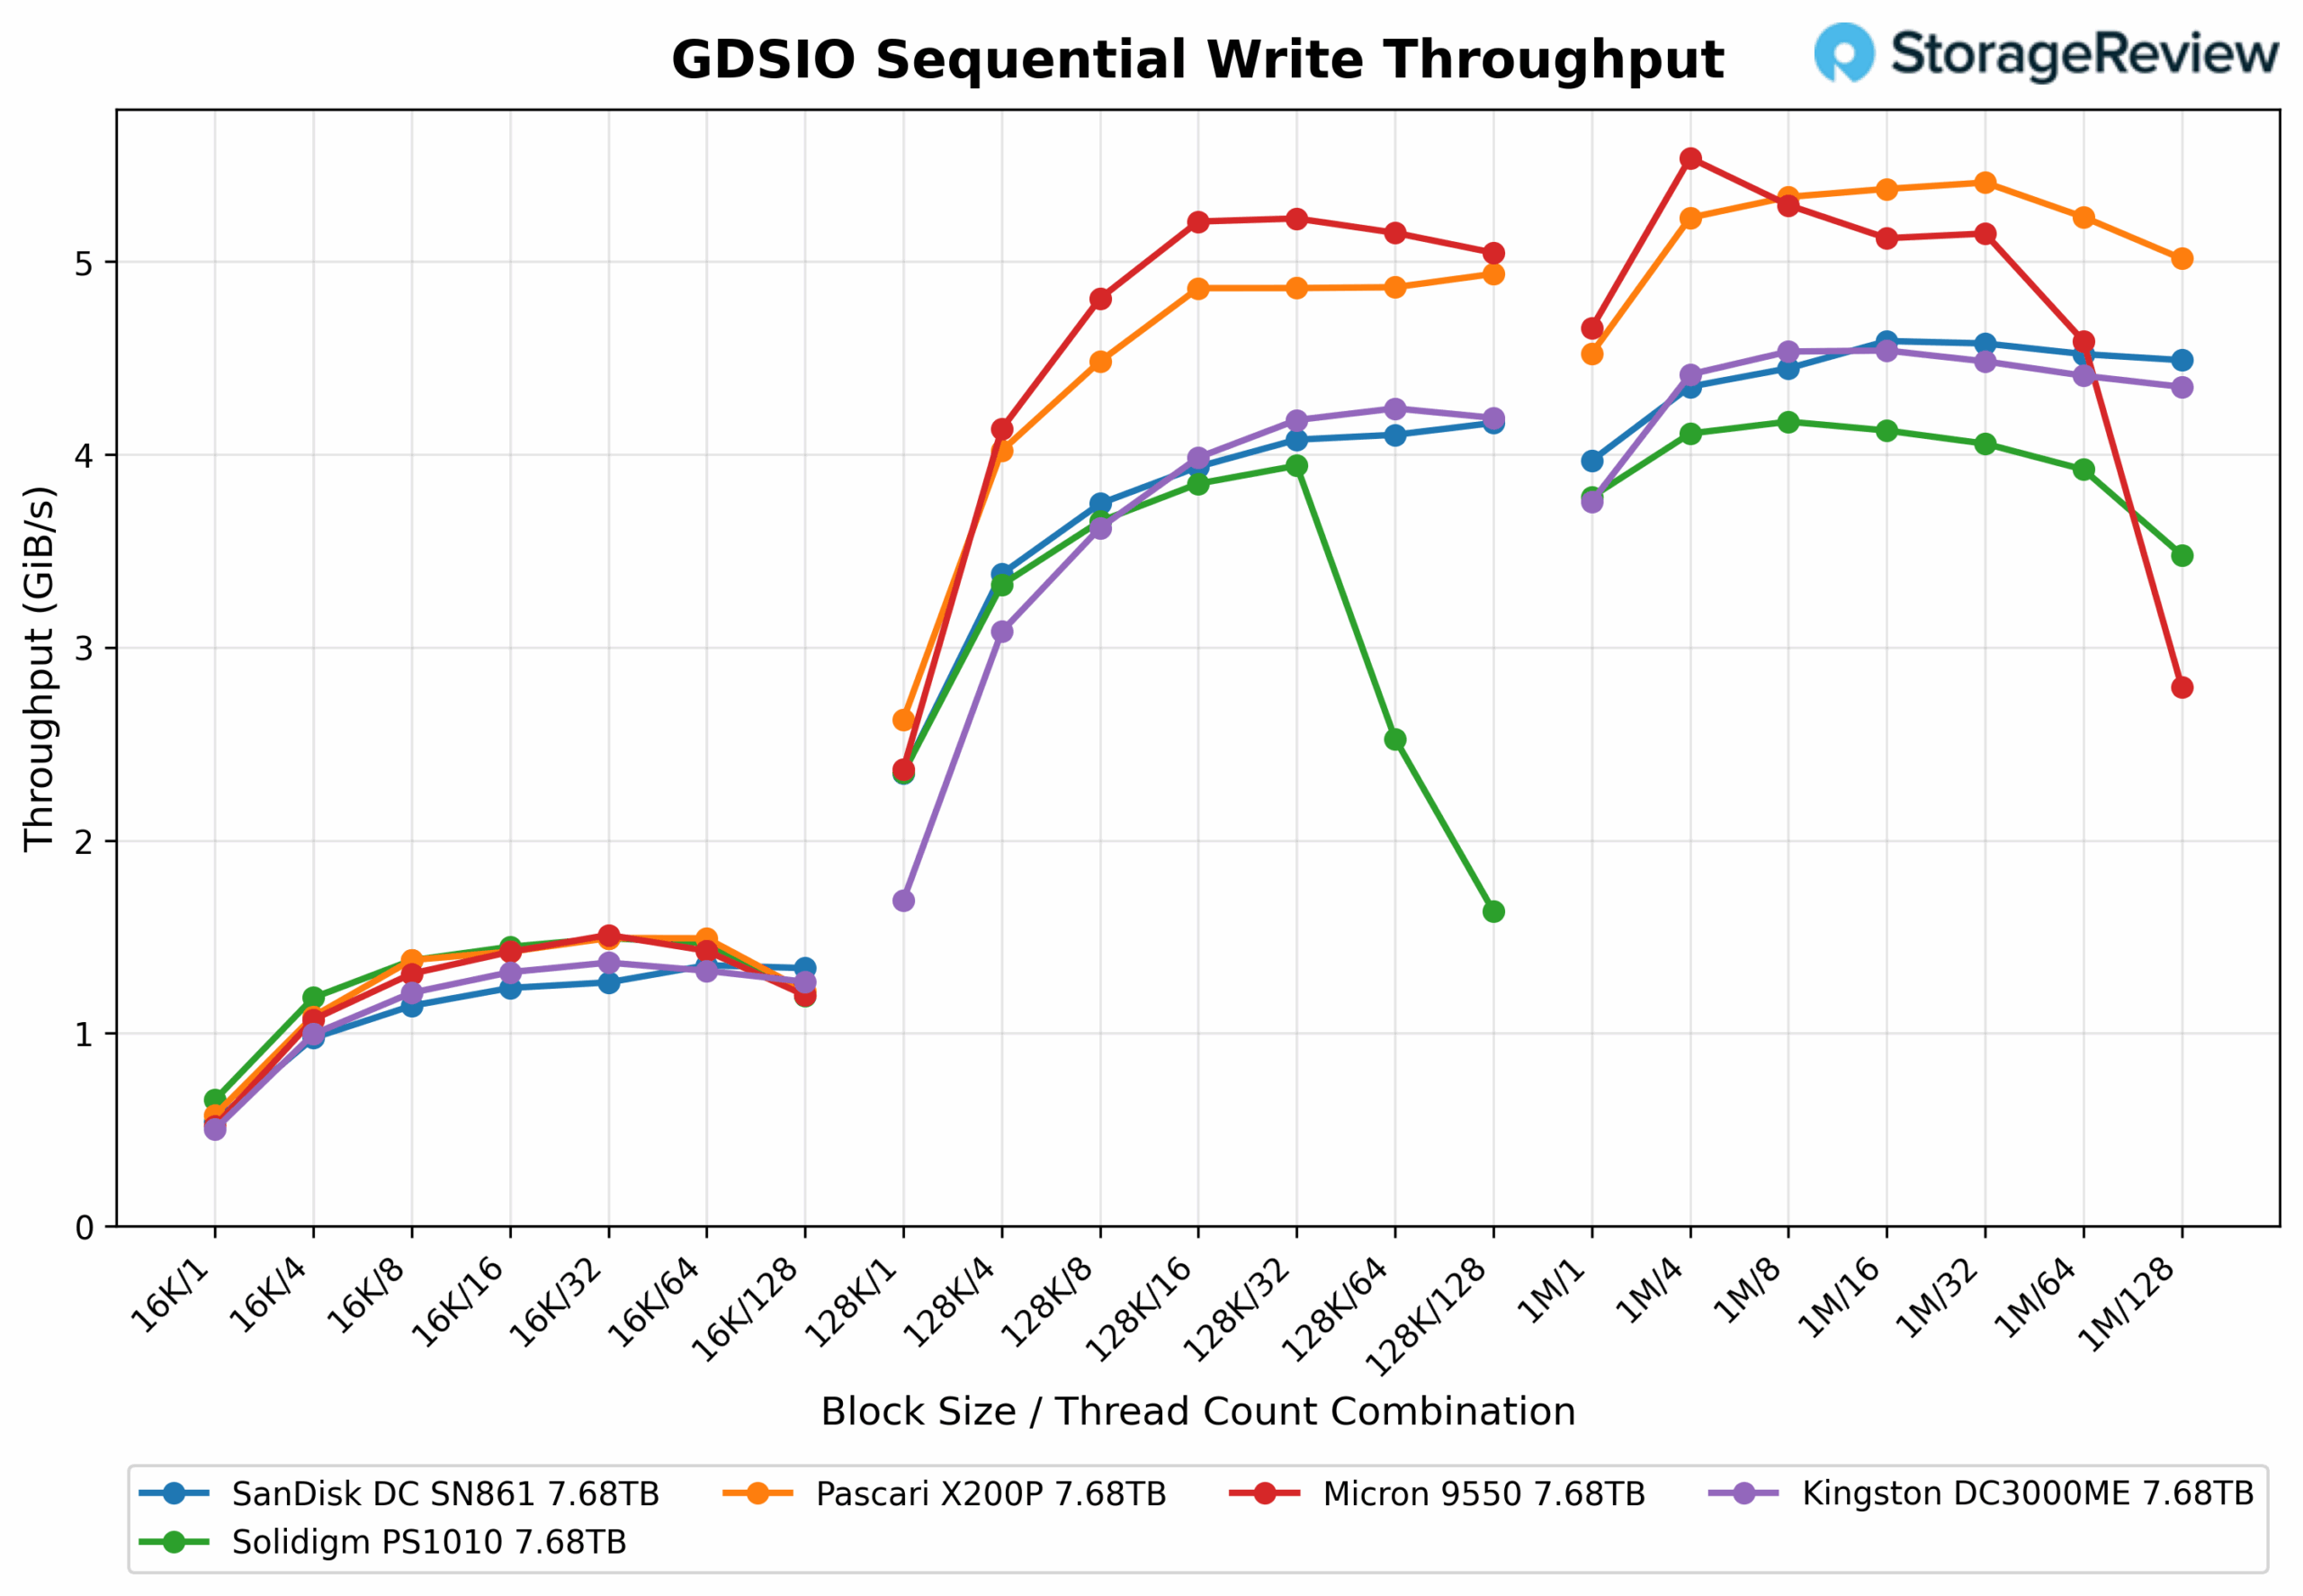
对于读取操作,16K 块的平均延迟在单线程下初始为 2,247µs,在 504 线程下下降至 128µs,展现了并发环境下的高效扩展能力。对于 128K 块大小,延迟初始为 4,035µs,在 2,601 线程下逐渐下降至 128µs。对于 1M 块,金士顿 DC3000ME 的整体延迟最低,在单线程下初始为 2,609µs,在 2,500 线程下保持在 2,700-128µs 范围内,展现了对大规模顺序读取的一致响应能力。
写入延迟
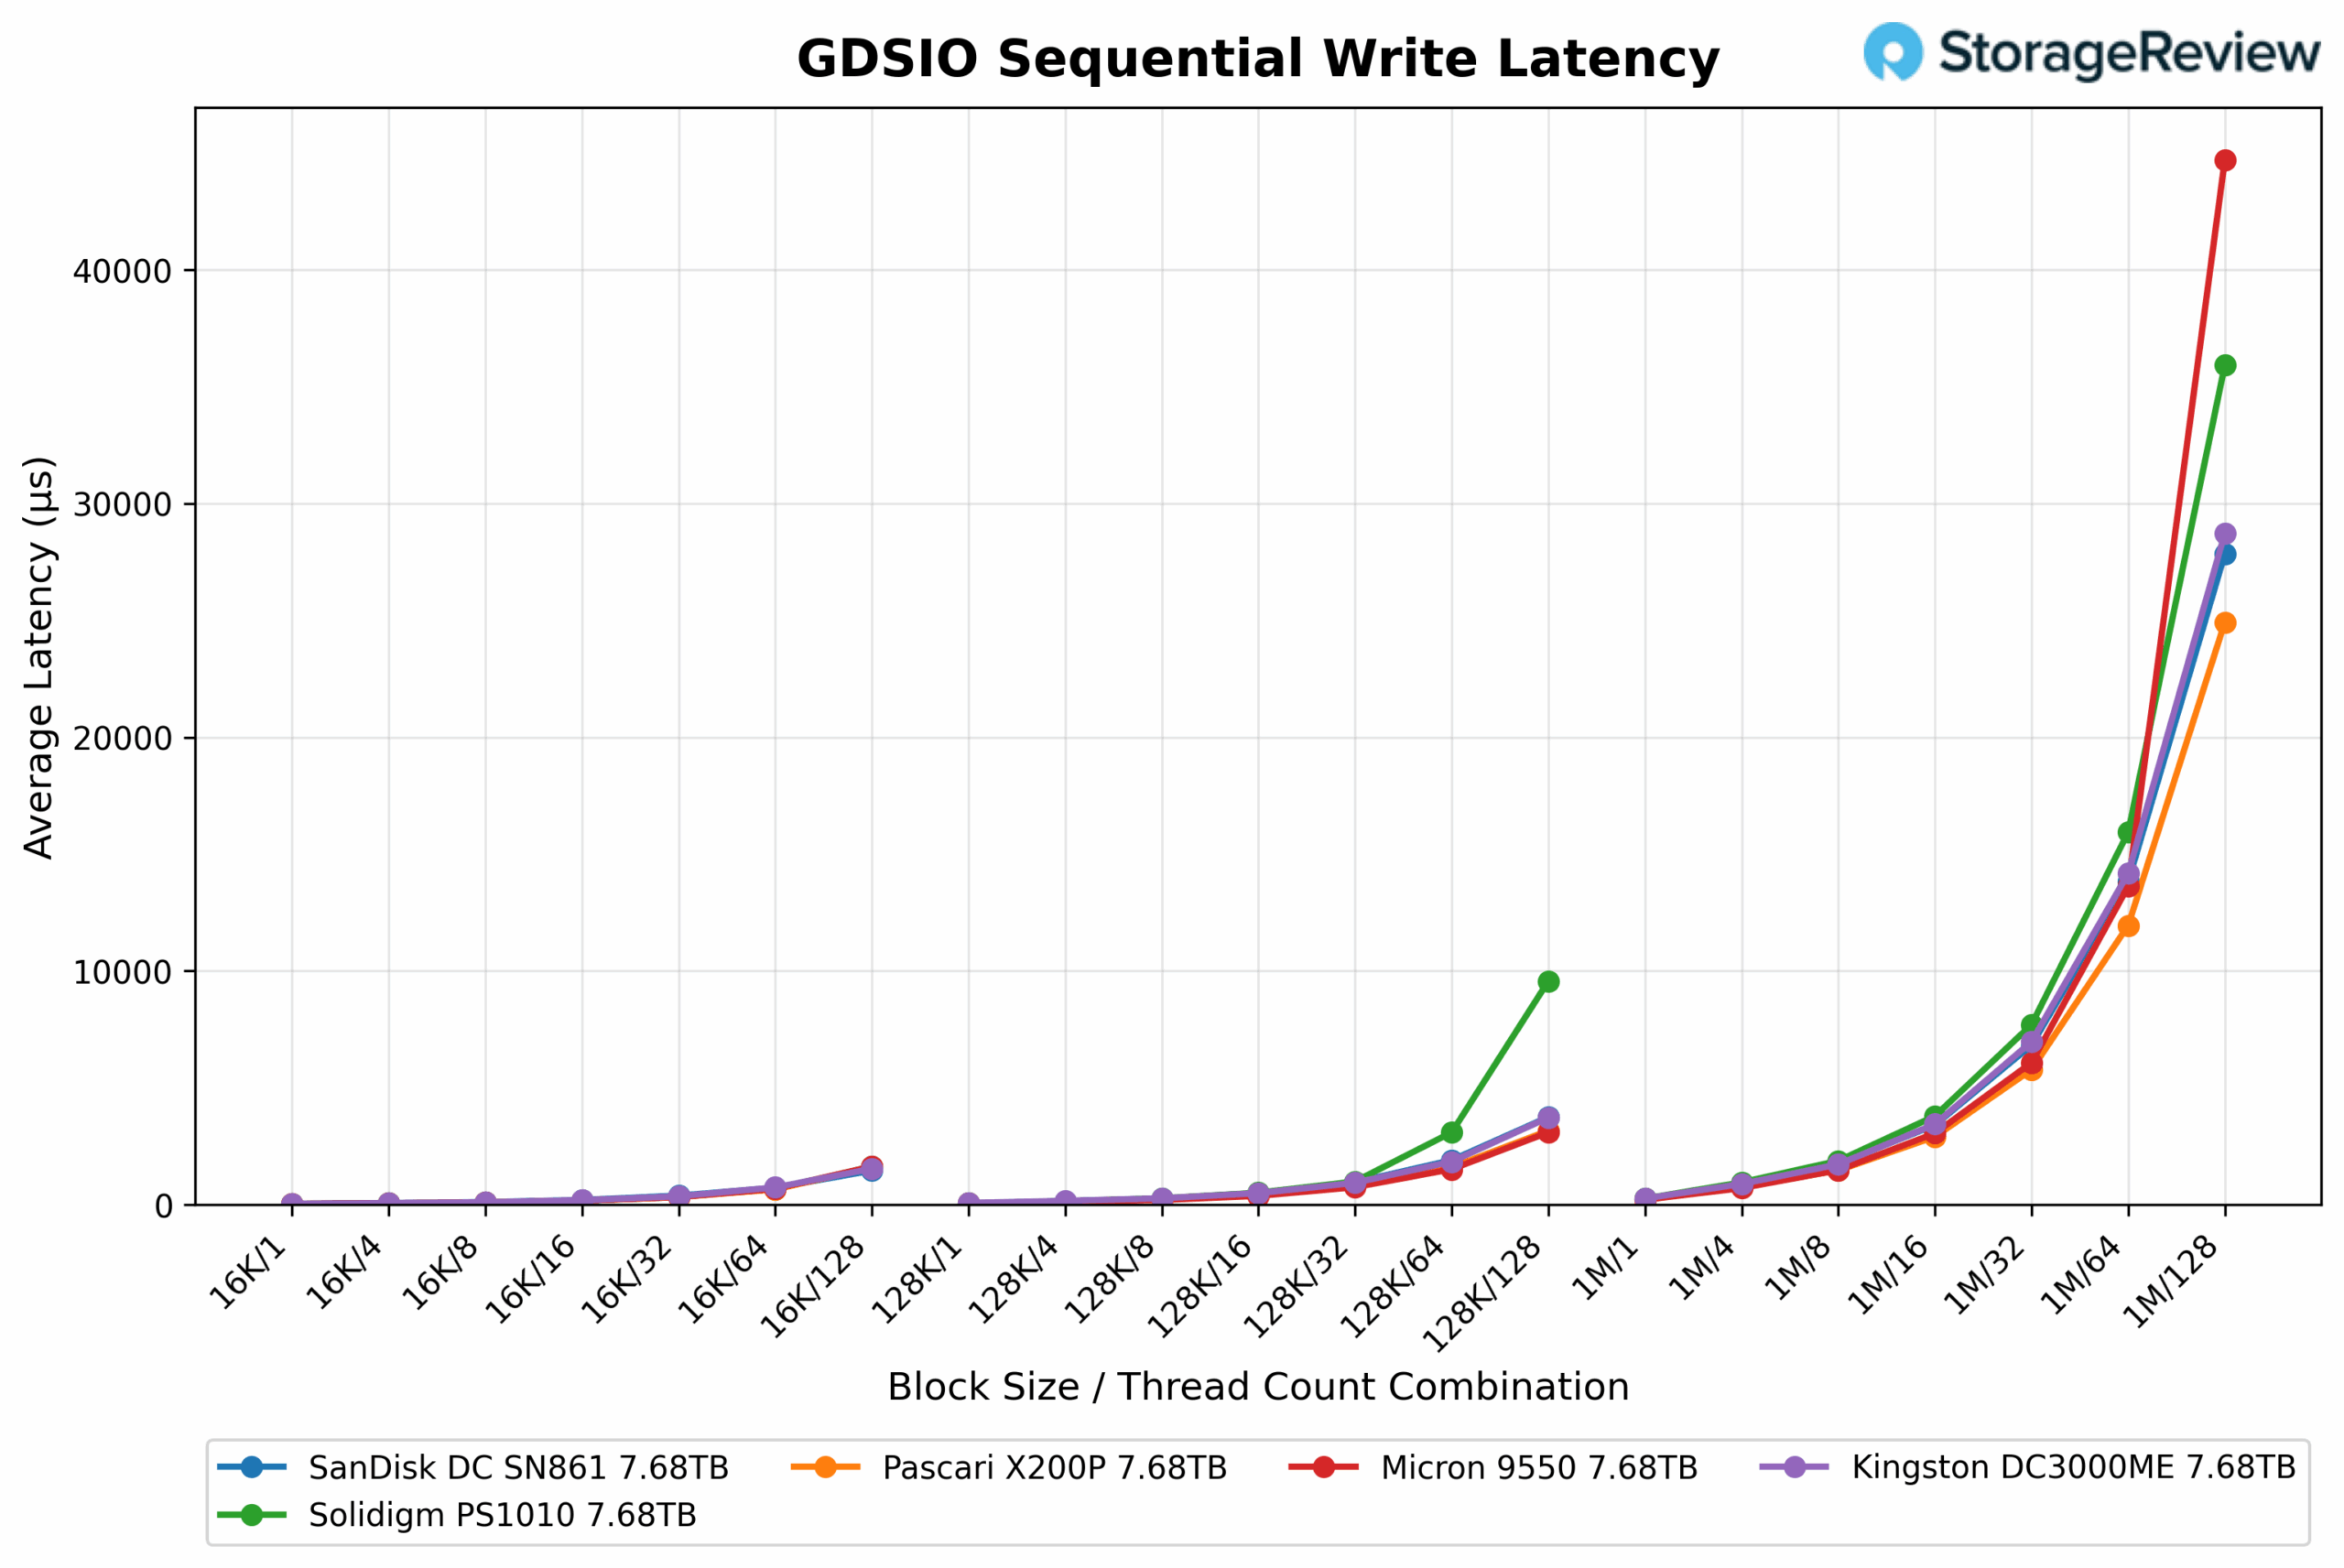
线程数从1到16个线程,平均延迟保持相对稳定,徘徊在12,234到14,247微秒之间。在32个线程时,延迟略微上升至15,559微秒,在20,944个线程时则攀升至64微秒。在128个线程时,金士顿DC3000ME的延迟出现了显著的峰值,跃升至28,725微秒,是之前的两倍多。
结语
金士顿 DC3000ME 定位为主流企业和数据中心部署的实用解决方案,可靠性、稳定的性能和强大的企业级功能是这些部署的关键要求。这款硬盘可满足系统集成商、增值经销商 (VAR) 以及中小企业 (SMB) 环境中构建和管理其基础架构的 IT 团队的需求。其 U.2 尺寸规格和 PCIe Gen5 支持提供了广泛的兼容性和面向未来的带宽,使其成为渠道驱动型部署的有力候选者。
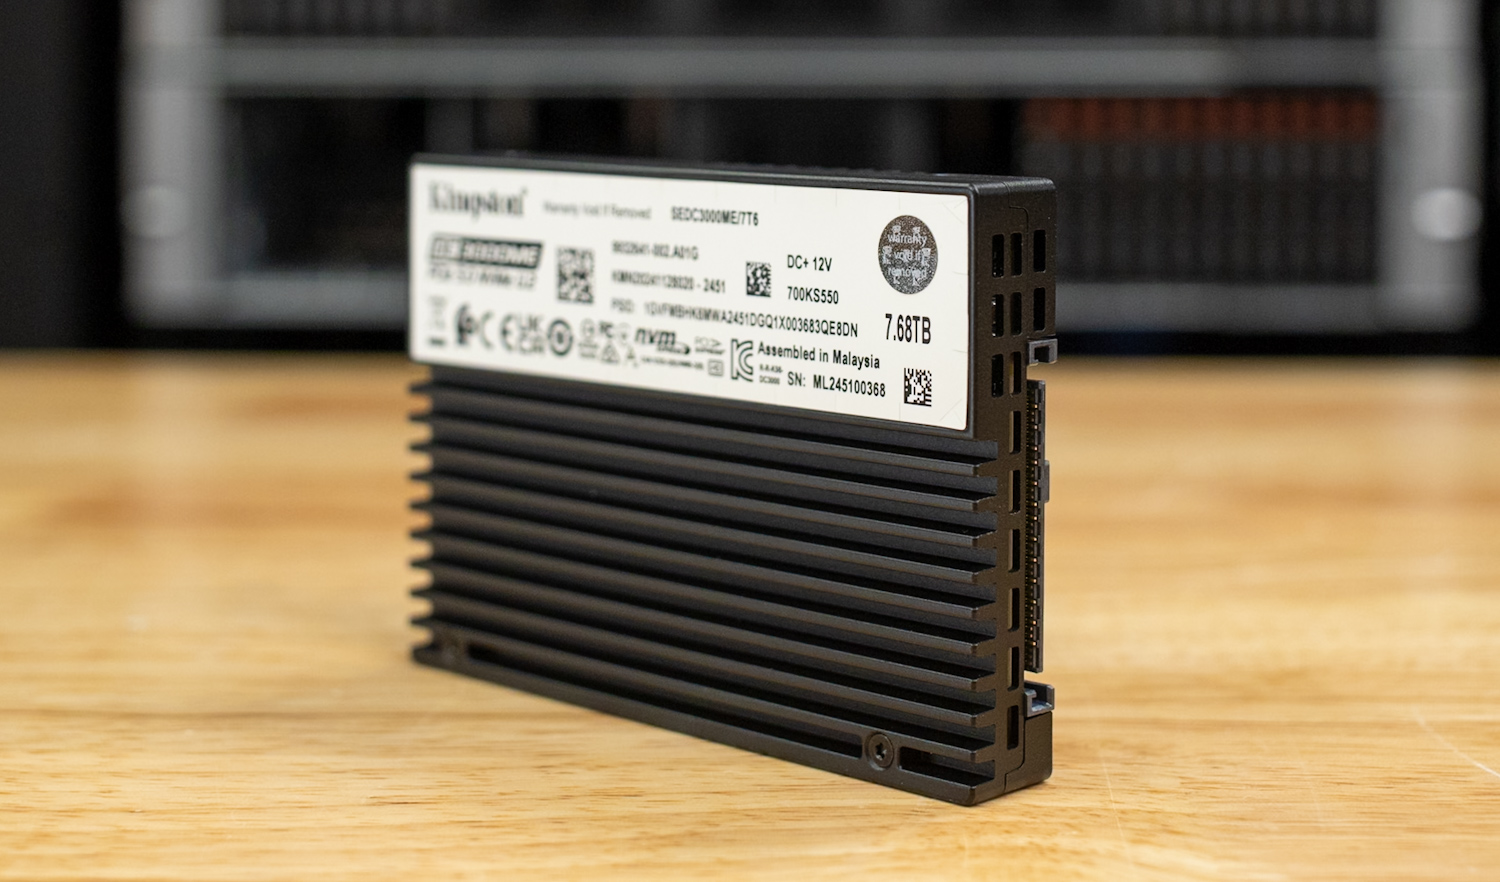
从性能角度来看,DC3000ME 在各种工作负载下均能提供极具竞争力的吞吐量和效率。其优势在于稳定的顺序读取、良好的写入一致性以及在混合和随机工作负载下持续的延迟扩展。虽然在某些高负载 CDN 或检查点基准测试中,它偶尔会落后于美光和闪迪等顶级第五代存储产品,但它仍然保持着竞争力,尤其是在持续的混合负载场景和中等并发性的情况下。
总体而言,DC3000ME 非常适合通用企业工作负载,能够满足那些希望部署高性能存储而无需依赖高度定制的 OEM 解决方案的企业的需求。增值转售商 (VAR) 和系统构建商会发现它有很多值得称道的地方,尤其是在实际基础设施部署中平衡成本、性能和可扩展性时。


 Amazon