

联想ThinkSystem SR650 V4是一款灵活强大的双路2U机架式服务器,旨在满足云服务、电信和高性能计算 (HPC) 等行业的需求。无论是优化横向扩展工作负载,还是通过高密度计算为数据中心的未来发展做好准备,SR650 V4 都比其前代产品 SR650 V3 有了显著的升级。

联想SR650 V4和SR650 V3的区别
加工厂
处理器性能是SR650 V4最重要的升级之一。SR650 V3采用的是第四代英特尔® 至强® 可扩展处理器,而SR650 V4则引入了英特尔® 至强® 第六代平台(原代号“Granite Rapids”)。我们的评测重点关注专为计算密集型工作负载设计的P核心(性能核心)架构。V4支持单路或双路处理器,每个插槽最多可配备86个P核心(最多172个线程),提供更高的核心频率(最高可达4 GHz)和最高350W的TDP。
这种转变使企业能够在每台服务器上处理更苛刻的应用,从而减少物理空间占用。该架构为虚拟化和繁重的数据库操作奠定了坚实的基础。此外,V4 架构支持海量 PCIe 带宽,每个处理器最多可支持 88 条 PCIe 5.0 通道,这对于为现代高速网络适配器和 NVMe 存储阵列提供流畅的数据传输至关重要。
| CPU型号 | 内核/线程 | 基频 | 最大涡轮 | L3缓存 | TDP |
|---|---|---|---|---|---|
| 6787P | 86 / 172 | 2.0 GHz | 3.8 GHz | 336 MB | 350W 瓦 |
| 6781P | 80 / 160 | 2.0 GHz | 3.8 GHz | 336 MB | 350W 瓦 |
| 6767P | 64 / 128 | 2.4 GHz | 3.9 GHz | 336 MB | 350W 瓦 |
| 6761P | 64 / 128 | 2.5 GHz | 3.9 GHz | 336 MB | 350W 瓦 |
| 6760P | 64 / 128 | 2.2 GHz | 3.8 GHz | 320 MB | 330W 瓦 |
| 6747P | 48 / 96 | 2.7 GHz | 3.9 GHz | 288 MB | 330W 瓦 |
| 6745P | 32 / 64 | 3.1 GHz | 4.3 GHz | 336 MB | 300W 瓦 |
| 6741P | 48 / 96 | 2.5 GHz | 3.8 GHz | 288 MB | 300W 瓦 |
| 6740P | 48 / 96 | 2.1 GHz | 3.8 GHz | 288 MB | 270W 瓦 |
| 6737P | 32 / 64 | 2.9 GHz | 4.0 GHz | 144 MB | 270W 瓦 |
| 6736P | 36 / 72 | 2.0 GHz | 4.1 GHz | 144 MB | 205W 瓦 |
| 6732P | 32 / 64 | 3.8 GHz | 4.3 GHz | 144 MB | 350W 瓦 |
| 6731P | 32 / 64 | 2.5 GHz | 4.1 GHz | 144 MB | 245W 瓦 |
| 6730P | 32 / 64 | 2.5 GHz | 3.8 GHz | 288 MB | 250W 瓦 |
| 6724P | 16 / 32 | 3.6 GHz | 4.3 GHz | 72 MB | 210W 瓦 |
| 6714P | 8 / 16 | 4.0 GHz | 4.3 GHz | 48 MB | 165W 瓦 |
| 6530P | 32 / 64 | 2.3 GHz | 4.1 GHz | 144 MB | 225W 瓦 |
| 6527P | 24 / 48 | 3.0 GHz | 4.2 GHz | 144 MB | 255W 瓦 |
| 6521P | 24 / 48 | 2.6 GHz | 4.1 GHz | 144 MB | 225W 瓦 |
| 6520P | 24 / 48 | 2.4 GHz | 4.0 GHz | 144 MB | 210W 瓦 |
| 6517P | 16 / 32 | 3.2 GHz | 4.2 GHz | 72 MB | 190W 瓦 |
| 6515P | 16 / 32 | 2.3 GHz | 3.8 GHz | 72 MB | 150W 瓦 |
| 6511P | 16 / 32 | 2.3 GHz | 4.2 GHz | 72 MB | 150W 瓦 |
| 6507P | 8 / 16 | 3.5 GHz | 4.3 GHz | 48 MB | 150W 瓦 |
| 6505P | 12 / 24 | 2.2 GHz | 4.1 GHz | 48 MB | 150W 瓦 |
内存
在内存方面,SR650 V4 相较于 V3 有了显著提升,子系统性能得到了极大增强。它支持高达 6400 MHz 的 DDR5 内存速度(每个通道 1 个 DIMM),相比上一代 4800 MHz 的限制有了大幅提升。该系统配备 32 个 DIMM 插槽(每个处理器 16 个),每个处理器分布在 8 个内存通道中。它支持标准 RDIMM、3DS RDIMM 以及新型多路复用 DIMM (MRDIMM),后者最高运行速度可达 8000 MHz,能够满足高带宽应用的需求。使用 256GB 3DS RDIMM,该服务器可支持高达 8TB 的系统内存。

此外,V4 版本还引入了对 CXL 2.0(Compute Express Link)内存扩展的支持。管理员可以在 E3.S 硬盘托架(特别是 E3.S 2T 规格)中安装多达 12 个 CXL 内存模块。这使得系统能够突破传统处理器内存容量和带宽的限制,从而降低下一代工作负载的计算延迟,并通过减少内存闲置来降低总体拥有成本 (TCO)。
存放
联想SR650 V4的存储性能体现了其向高性能NVMe高密度和灵活外形尺寸方向发展的趋势。V4在支持传统的3.5英寸和2.5英寸硬盘的同时,还大幅扩展了对E3.S NVMe外形尺寸的支持。该系统最多可容纳32块E3.S 1TB硬盘或12块E3.S 2TB硬盘,与传统的U.2 SSD相比,可提供更高的存储密度和更佳的散热性能。

至关重要的是,V4 支持直接的 NVMe 连接,无需超额分配(1:1),从而确保高速存储不会因 PCIe 通道共享而受到瓶颈限制。此外,M.2 热插拔启动盘选项的加入进一步提升了可维护性。
社交
在网络方面,SR650 V4 配备了两个专用的 OCP 3.0 插槽,均支持 PCIe Gen 5 x16。这是一项关键升级,无需占用标准 PCIe 转接卡插槽即可实现冗余的高速网络连接(例如,双端口 200GbE 或单端口 400GbE)。升级到 PCIe 5.0 后,理论带宽翻倍(32 GT/s 对比 16 GT/s),使 V4 能够处理要求最苛刻的云和 AI 网络流量。

电源和冷却
SR650 V4 提供增强型电源选项,功率范围从 800W 到 3200W,并有钛金和铂金两种能效等级可选。该系统还支持 -48V 直流和 HVAC/HVDC 选项,以满足特定数据中心的需求。

为了应对高TDP处理器和内存产生的热量,联想推出了Neptune液冷散热方案。“Neptune核心模块”采用开式液冷技术,可有效散发处理器、内存和电压调节器的热量,能够捕获超过80%的服务器热量,从而显著降低数据中心的冷却成本。
总体而言,SR650 V4 在性能、密度和散热效率方面实现了显著提升,满足了现代企业环境的需求。
Lenovo ThinkSystem SR650 V4 规格
| 规格 | 信息 |
|---|---|
| 系统规格 | |
| 外形 | 2U机架 |
| 处理器 | 最高可选配 2 个英特尔® 至强® 6700/6400 系列(P 核心)处理器;每个 CPU 最高可达 86 个核心;最高 TDP 可达 350W。 |
| 内存 | 32 个 DIMM 插槽(每个处理器 16 个);支持高达 6400 MHz 的 TruDDR5 RDIMM 和高达 8000 MHz 的 MRDIMM |
| 记忆体扩充 | 支持 E3.S 2T 外形尺寸的 CXL 2.0 内存模块(最多 12 个 DIMM 插槽) |
| 内存最大值 | 最高支持 8TB 系统内存(使用 256GB 3DS RDIMM 内存条) |
| 磁盘驱动器托架 | 接待: 最多可支持 24 个 2.5 英寸 NVMe/SAS/SATA 硬盘位、16 个 3.5 英寸 SAS/SATA 硬盘位或 32 个 E3.S NVMe 硬盘位。 中: 最多可支持 8 个 2.5 英寸简易更换 背面: 最多可支持 8 个 2.5 英寸或 4 个 3.5 英寸热插拔硬盘 |
| 存储控制器 | 最多支持 36 个板载 NVMe 端口(1:1 连接);支持 RAID/HBA |
| 网络接口 | 两个 OCP 3.0 SFF 插槽,带 PCIe 5.0 x16 主机接口 |
| PCI 扩展槽 | 最多 10 个 PCIe 5.0 插槽(后部);可选前置 PCIe 插槽 |
| GPU支持 | 多达 10 个单宽 GPU 或 2 个双宽 GPU |
| 端口 | 接待: 外部诊断端口、可选 USB 接口和 Mini-DP 接口 背面: 2 个 USB 3.0 接口、1 个 VGA 接口、1 个 RJ-45 管理接口、可选串口 |
| 散热器 | 最多可支持 6 个热插拔风扇(N+1 冗余);可选配 Neptune 液冷模块 |
| 电源 | 最多可配备两个热插拔冗余交流/直流电源(800W–3200W) |
| 系统管理 | XClarity Controller 3 (XCC3);可选配 XCC3 Premier |
| 安全功能 | TPM 2.0、PFR 信任根(NIST SP800-193)、机箱入侵检测、可锁定边框 |
| 操作系统 | Microsoft Windows Server、RHEL、SLES、Ubuntu Server |
| 保修政策 | 3年基础保修(可配置) |
| 尺寸 | 高 87 毫米(3.4 英寸)x 宽 440 毫米(17.3 英寸)x 深 800 毫米(31.5 英寸) |
| 重量 | 最大重量:38.8 千克(85.5 磅) |
联想 ThinkSystem SR650 V4 设计和构建
联想ThinkSystem SR650 V4是一款标准的2U平台,它充分利用了物理空间,在组件密度、气流和可维护性之间实现了平衡。机箱尺寸为高3.4英寸、宽17.3英寸、深31.5英寸,最大配置重量为85.5磅。这些尺寸使其与其他2U企业级服务器完全一致,同时又为高性能CPU、高密度内存配置和灵活的存储背板提供了足够的深度。
联想ThinkSystem成熟的工业设计极具辨识度,坚固的钢制机箱和清晰明了的功能性标识令人印象深刻。内部布局简洁实用,注重直通式气流、模块化组件分区以及无需工具即可轻松维护。整体结构坚固耐用,设计精良,体现了该平台专为数据中心环境下的持续运行而设计,而非追求美观。
控制面板
前面板高度可配置。我们的测试系统配备了 8 盘位 2.5 英寸硬盘背板,但机箱可以轻松扩展至 16 盘位甚至 24 盘位,无需额外配置。客户还可以选择 3.5 英寸硬盘位以获得更高的原始容量,或选择更新的 E3.S 背板选项以实现高性能 NVMe 硬盘密度。AnyBay 支持允许 SAS、SATA 和 NVMe 硬盘共存于同一硬盘笼中,为混合存储部署提供了极大的灵活性。

前面板包含必要的操作控制按钮:电源按钮、ID按钮以及指示系统运行状况和网络活动的状态指示灯。一个可拉出的信息标签方便用户快速访问XCC网络访问标签和序列号。可选的本地连接包括用于故障排查车访问的Mini DisplayPort和USB端口,这对于“无人值守”数据中心的故障排除至关重要。
后面板
机箱后部设计旨在实现最大的I/O密度。根据转接卡配置的不同,最多可容纳10个PCIe Gen 5插槽。此外,还预留了两个OCP 3.0插槽,从而可以释放标准PCIe转接卡的空间,用于安装其他扩展卡,例如GPU或存储控制器。
除了扩展功能外,后面板还设有板载 BMC 管理网络端口、两个 USB-A 端口以及用于本地控制台访问的 VGA 输出端口。双热插拔电源安装在后部,既保证了维护的便捷性,又不会影响气流或扩展布局。
全内走线
内部布局简洁,并针对气流进行了优化。32 个 DIMM 内存插槽位于双 CPU 插槽两侧,这样的布局确保了机箱前部六个高性能热插拔风扇能够提供畅通无阻的前后散热。这些风扇完全免工具更换,整个风扇托架无需工具即可拆卸。拆卸托架后,即可直接访问 AnyBay 存储区域,从而简化了维护、升级和背板更换。

存储线缆沿机箱侧面整齐布线,避免阻碍CPU和内存的空气流通。对于使用Neptune液冷模块的配置,内部布局略有变化以适应冷却液循环,但核心部件的维护性依然很高。M.2启动盘模块安装在导风板或硬盘笼上,无需拆卸其他组件即可轻松访问。
X清晰度控制器3
SR650 V4 搭载了全新的 XClarity Controller 3 (XCC3)。与前几代产品相比,这款管理引擎性能显著提升,启动速度更快,HTML5 界面响应也更加灵敏。平台资源管理器可提供详细的电源和散热状态遥测数据,帮助管理员优化数据中心效率。
XCC3 支持多种远程管理功能,包括远程控制(KVM)、虚拟媒体挂载和固件更新。其界面直观,提供系统运行状况、活动事件和硬件清单的仪表盘视图。在自动化方面,XCC3 完全支持 Redfish REST API。
联想 ThinkSystem SR650 V4 性能
本节将分析 Blender、y-cruncher、vLLM 和 Phoronix 的基准测试结果。初始测试在配备 Intel Xeon 6740P 处理器的 Lenovo ThinkSystem SR650 V4 上进行,以便评估该平台以性能为导向的 P 核架构以及在 CPU 密集型工作负载下的整体吞吐量。评测过程中,我们调整了系统配置以启用 GPU 加速测试。得益于 Lenovo 的 GPU 加速套件,这一过渡过程非常顺利。该套件包含高性能风扇、升级的散热片、改进的导风罩以及支持更高性能加速器的 GPU 扩展卡。安装过程无需对机箱进行任何重大改动,即可与现有系统布局完美融合。
升级散热和气流组件后,我们在平台上添加了一块NVIDIA L40S GPU。这使我们能够扩展测试范围,涵盖Blender GPU渲染和推理基准测试等GPU加速工作负载,同时保持稳定的散热和一致的系统性能。此次升级的模块化设计凸显了SR650 V4的灵活性,使其能够轻松地从注重效率的CPU配置过渡到适用于混合计算工作负载的CPU+GPU平衡平台。
联想ThinkSystem SR650 V4配置:
- CPU: 2x 英特尔至强 6740P
- 记忆: 1TB 内存
- 存储: 4 x 960GB 固态硬盘
- GPU: 英伟达 L40S
搅拌机4.5
Blender 是一款开源 3D 建模应用程序。本次基准测试使用 Blender Benchmark 实用程序运行。分数以每分钟采样数计算,数值越高,性能越好。
在 Blender CPU 基准测试中,联想 ThinkSystem SR650 V4 在所有场景下均表现出色,渲染性能稳定,在 Monster 场景中达到每分钟 1136.99 个样本,在 Junkshop 场景中达到每分钟 707.60 个样本,在 Classroom 场景中达到每分钟 562.53 个样本。测试结果反映了双 Intel Xeon 6740P 处理器强大的多线程扩展能力,即使场景复杂度增加,性能依然保持稳定。
| Blender CPU(每分钟采样数;越高越好) | 联想 ThinkSystem SR650 V4(2x 英特尔至强 6740P,1TB 内存) |
|---|---|
| 怪物 | 1136.99 |
| 旧货店 | 707.60 |
| 课堂 | 562.53 |
在Blender CPU无SMT基准测试中,SR650 V4的渲染吞吐量显著提升,在Monster场景中达到每分钟4686.40个样本,在Junkshop场景中达到每分钟2223.96个样本,在Classroom场景中达到每分钟2385.98个样本。GPU测试结果凸显了该系统加速复杂渲染工作负载的能力,与仅使用CPU渲染相比,其吞吐量大幅提高。
| Blender CPU(无 SMT)(每分钟采样数;越高越好) | 联想 ThinkSystem SR650 V4(2x 英特尔至强 6740P,1TB 内存) |
|---|---|
| 怪物 | 4686.40 |
| 旧货店 | 2223.96 |
| 课堂 | 2385.98 |
y 粉碎机
y-cruncher 是一款多线程、可扩展的程序,能够计算圆周率和其他数学常数,精度可达万亿位小数。自 2009 年发布以来,它已成为超频玩家和硬件爱好者常用的基准测试和压力测试应用程序。
在 y-cruncher 测试中,联想 SR650 V4 的性能随着问题规模的增大而平滑扩展,凸显了该平台强大的多线程计算性能和内存带宽。该系统配备双 Intel Xeon 6740P 处理器和 1TB 内存,仅需 20 多秒即可完成 10 亿位小数的圆周率计算,并且在计算 250 亿位小数时仍保持稳定高效,耗时 362 秒。测试结果表明,在持续的 CPU 和内存压力下,SR650 V4 的性能扩展性符合预期,使其非常适合处理繁重的数学运算和压力测试场景。
| Y-Cruncher(总计算时间) | 联想 ThinkSystem SR650 V4(2x 英特尔至强 6740P,1TB 内存) |
|---|---|
| 1亿 | 20.715小号 |
| 2.5亿 | 44.412小号 |
| 5亿 | 81.937小号 |
| 10亿 | 152.743 |
| 25亿 | 362.566 |
vLLM 在线服务 LLM 推理性能
vLLM 是目前最流行的 LLM 高吞吐量推理和服务引擎。vLLM 在线服务基准测试是一个性能评估工具,用于衡量该推理引擎在并发请求下的实际服务能力。它通过向运行中的 vLLM 服务器发送请求来模拟生产环境的工作负载,并可配置请求速率、输入/输出长度和并发客户端数量等参数。该基准测试会测量关键指标,包括吞吐量(每秒令牌数)、首令牌时间 (TTF) 和单次输出令牌时间 (TPOT),帮助用户了解 vLLM 在不同负载条件下的性能。
我们测试了涵盖各种架构、参数规模和量化策略的一系列模型的推理性能,并评估了不同并发配置下的吞吐量。
密集模型性能
密集模型遵循传统的LLM架构,在推理过程中使用所有参数和激活值,因此其计算量比稀疏模型更大。为了全面评估不同模型规模和量化策略下的性能特征,我们对Llama 3.1 8B系列中的多种密集模型配置进行了基准测试。
Llama 3.1 8B 精密 FP8
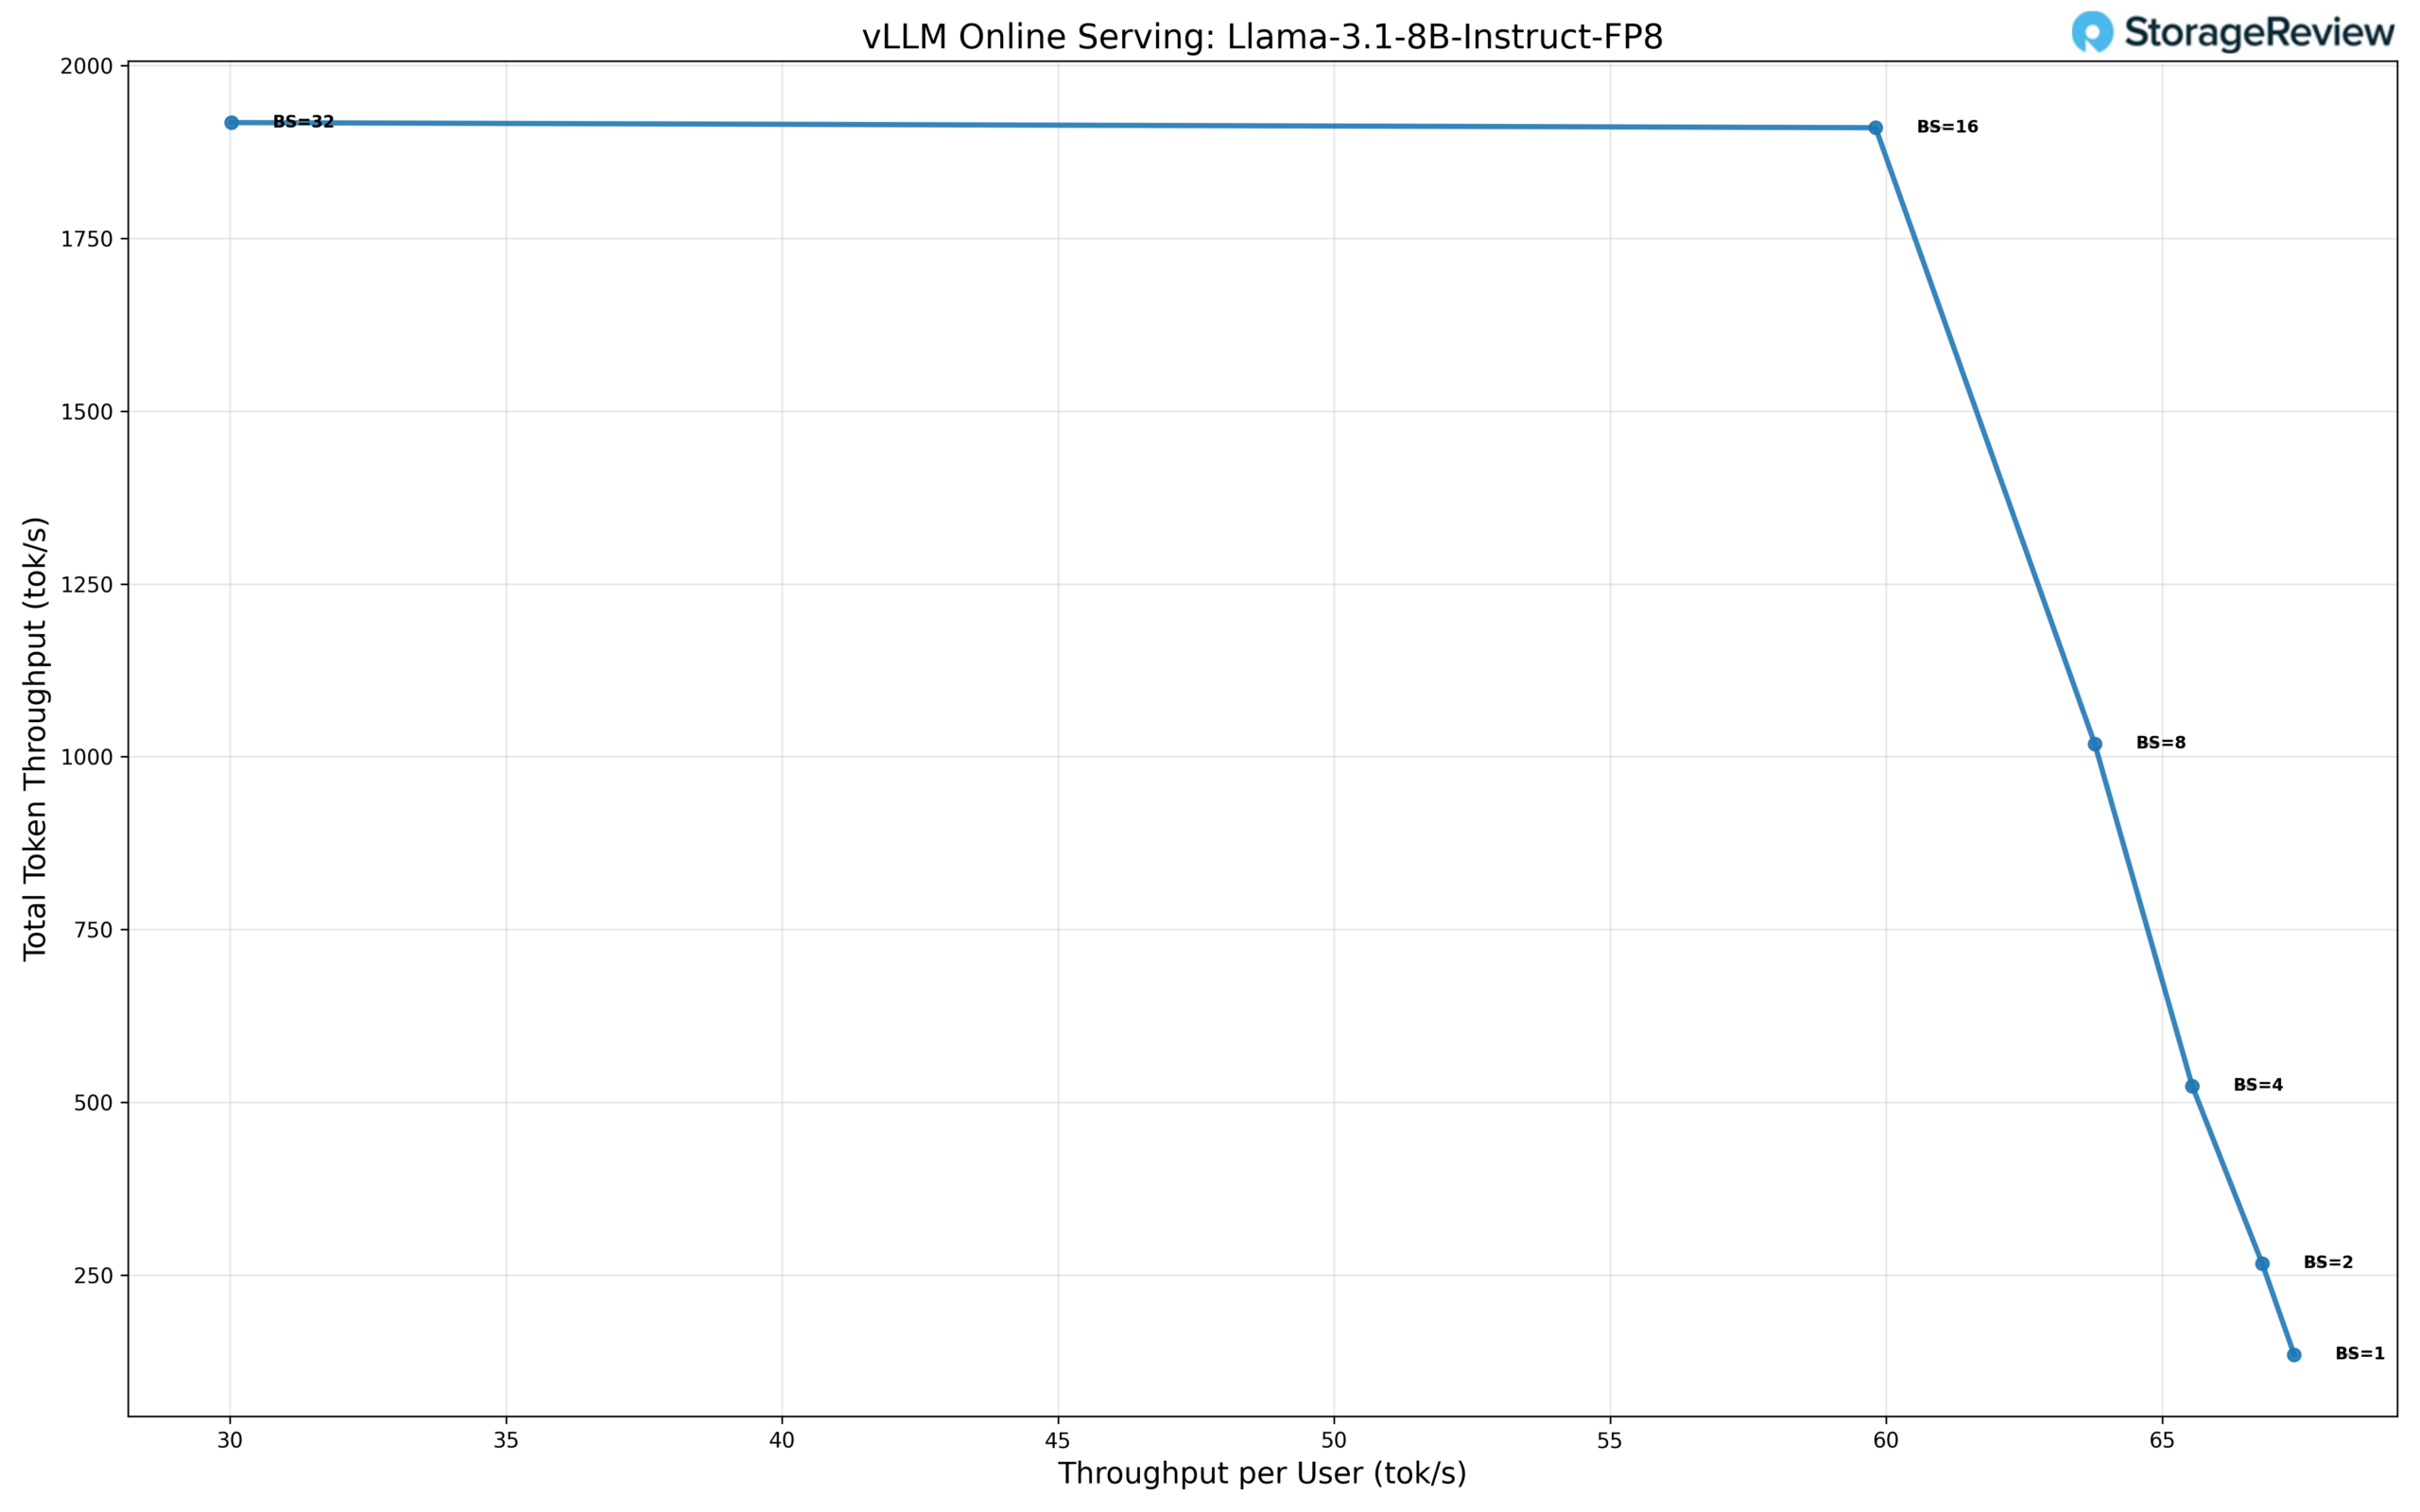
以 FP8 精度运行的 Llama 3.1 8B 模型展现出与标准精度配置不同的扩展特性,它在中等并发水平下优先考虑效率,但在较高批处理大小下牺牲峰值吞吐量。在单用户并发 (BS=1) 下,该模型每个用户可提供 67.8 tok/s 的处理能力,总吞吐量为 135.6 tok/s,TPOT 约为 3.1 ms,与全精度相比,单流基线更低。
随着批处理大小的增加,总吞吐量迅速增长,而单用户吞吐量则以可控的方式下降。当批处理大小为 2 时,总吞吐量增加到 271 tok/s,单用户吞吐量为 66.8 tok/s。当批处理大小为 4 时,总吞吐量达到 523 tok/s;当批处理大小为 8 时,模型吞吐量达到 1,017 tok/s,单用户吞吐量为 63.6 tok/s。在这些较低的并发水平下,延迟保持稳定,这使得 FP8 非常适合轻量级的多用户推理场景。
扩展性持续到 BS=16,此时模型保持总吞吐量为 1,918 tok/s,每个用户吞吐量为 60.0 tok/s。当 BS=32 时,总吞吐量趋于稳定,约为 1,920 tok/s,而每个用户的吞吐量则下降至 30.0 tok/s。这一稳定状态表明,FP8 配置比标准精度配置更早达到其饱和点,这体现了其在效率和可预测性方面优于最大总吞吐量的策略。
总体而言,FP8 的总吞吐量从 BS=1 到 BS=16-32 的峰值大约提高了 14 倍。延迟在 BS=16 之前保持稳定,然后在更高的并发性下与吞吐量一起趋于平缓,这凸显了 FP8 对于均衡的、对延迟敏感的推理工作负载来说是一个实用的选择,而不是极端的批量扩展。
Llama 3.1 8B 标准精度
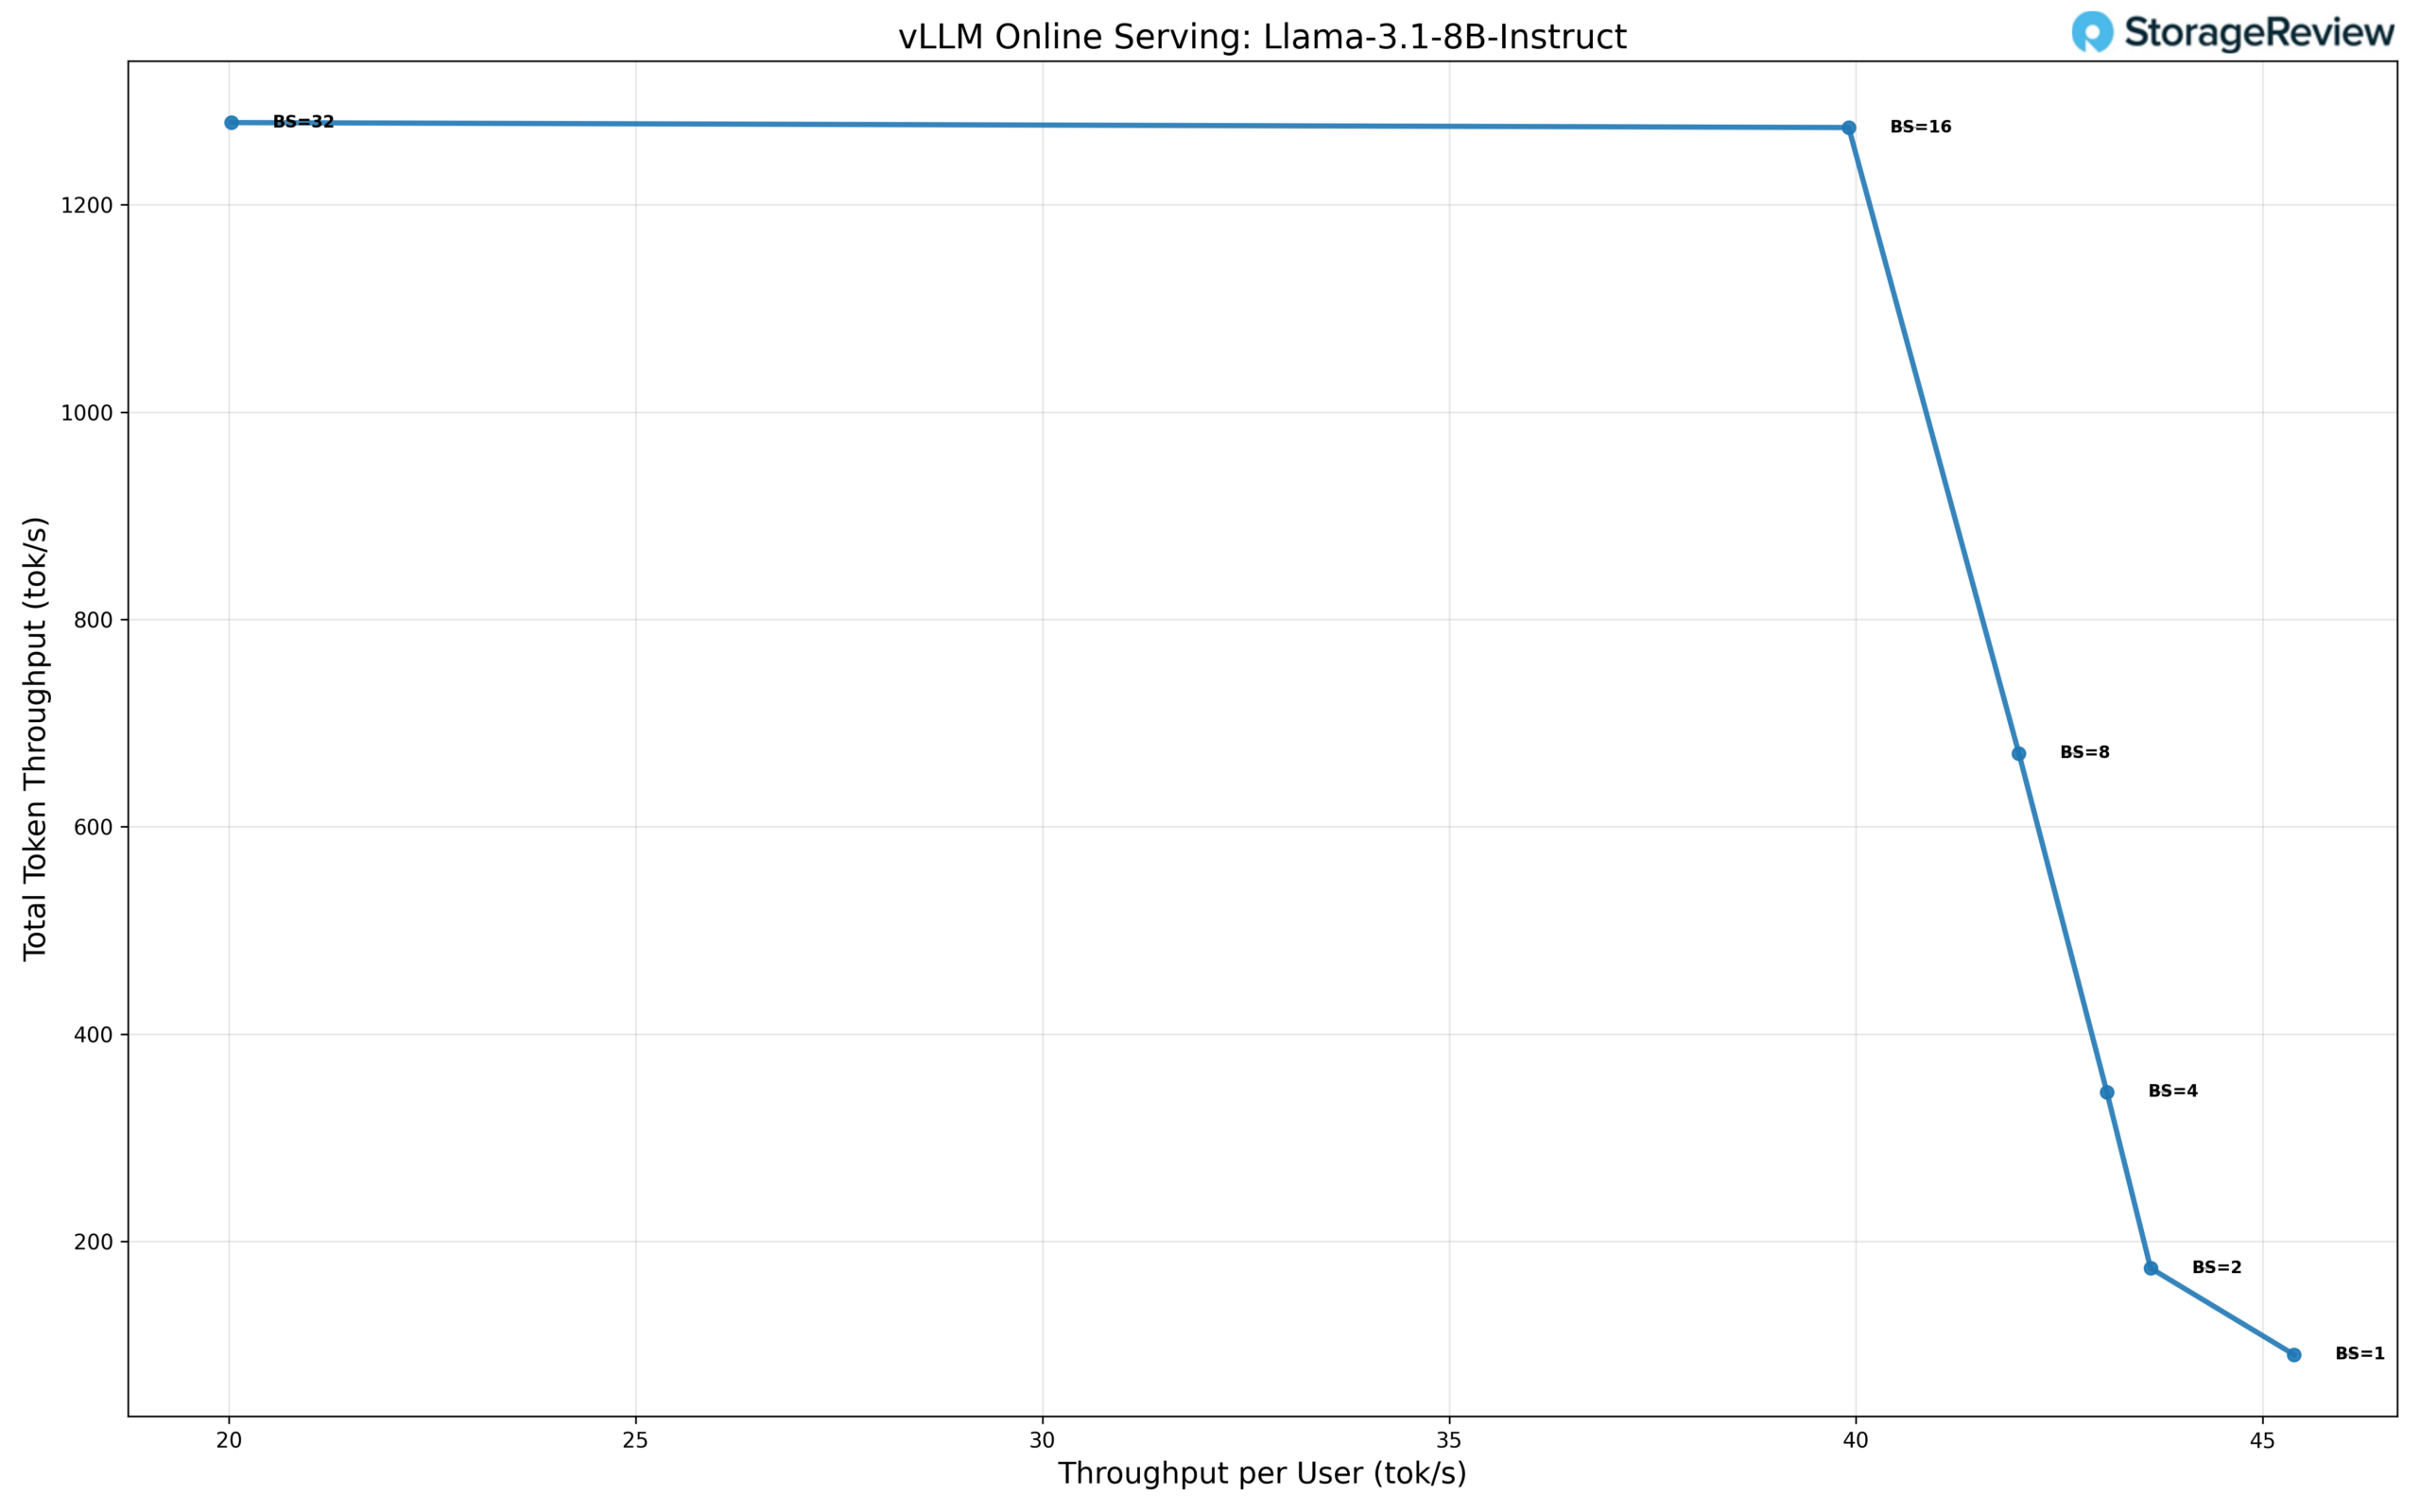
在标准精度下,Llama 3.1 8B 模型在较低并发水平下展现出可预测的扩展性,在小批处理规模下具有出色的单用户性能,并随着并发量的增加而稳步提升总吞吐量。在单用户操作(BS=1)下,该模型每个用户可提供约 45.8 tok/s 的吞吐量,总吞吐量达到 91.6 tok/s,为延迟敏感型工作负载树立了可靠的基准。
随着并发量的增加,总吞吐量能够高效扩展,而单用户吞吐量则逐渐下降。当 BS=2 时,总吞吐量提升至 176 tok/s,单用户吞吐量为 44.0 tok/s;当 BS=4 时,吞吐量达到 344 tok/s,单用户吞吐量为 43.0 tok/s。这种趋势一直持续到 BS=8,此时模型保持了 672 tok/s 的总吞吐量,单用户吞吐量为 42.0 tok/s,表明资源利用率良好,且单用户吞吐量没有显著下降。
扩展性持续到 BS=16,此时总吞吐量达到峰值,约为 1,280 tok/s,每个用户吞吐量为 40.0 tok/s。当 BS=32 时,总吞吐量基本保持稳定在 1,280 tok/s 左右,而每个用户的吞吐量下降到 20.0 tok/s,表明执行流水线已达到饱和。这一平台期表明,在标准精度下,该模型在 BS=16 左右达到最佳工作点,从而平衡了吞吐量和响应速度。
总体而言,标准精度在 BS=1 到峰值时,总吞吐量大约提升了 14 倍,并且在中等并发水平下保持了稳定的单用户性能。这种特性使得标准精度非常适合那些优先考虑稳定延迟和可预测扩展性而非激进批量扩展的部署场景。
稀疏模型性能
稀疏模型,特别是专家混合模型(MoE)架构,是一种新兴的高效扩展语言模型的方法。这些架构在保持较高总参数数量的同时,每个词元仅激活一部分参数,从而有可能提高每个激活参数的性能。
Qwen3-Coder-30B-A3B FP8 性能
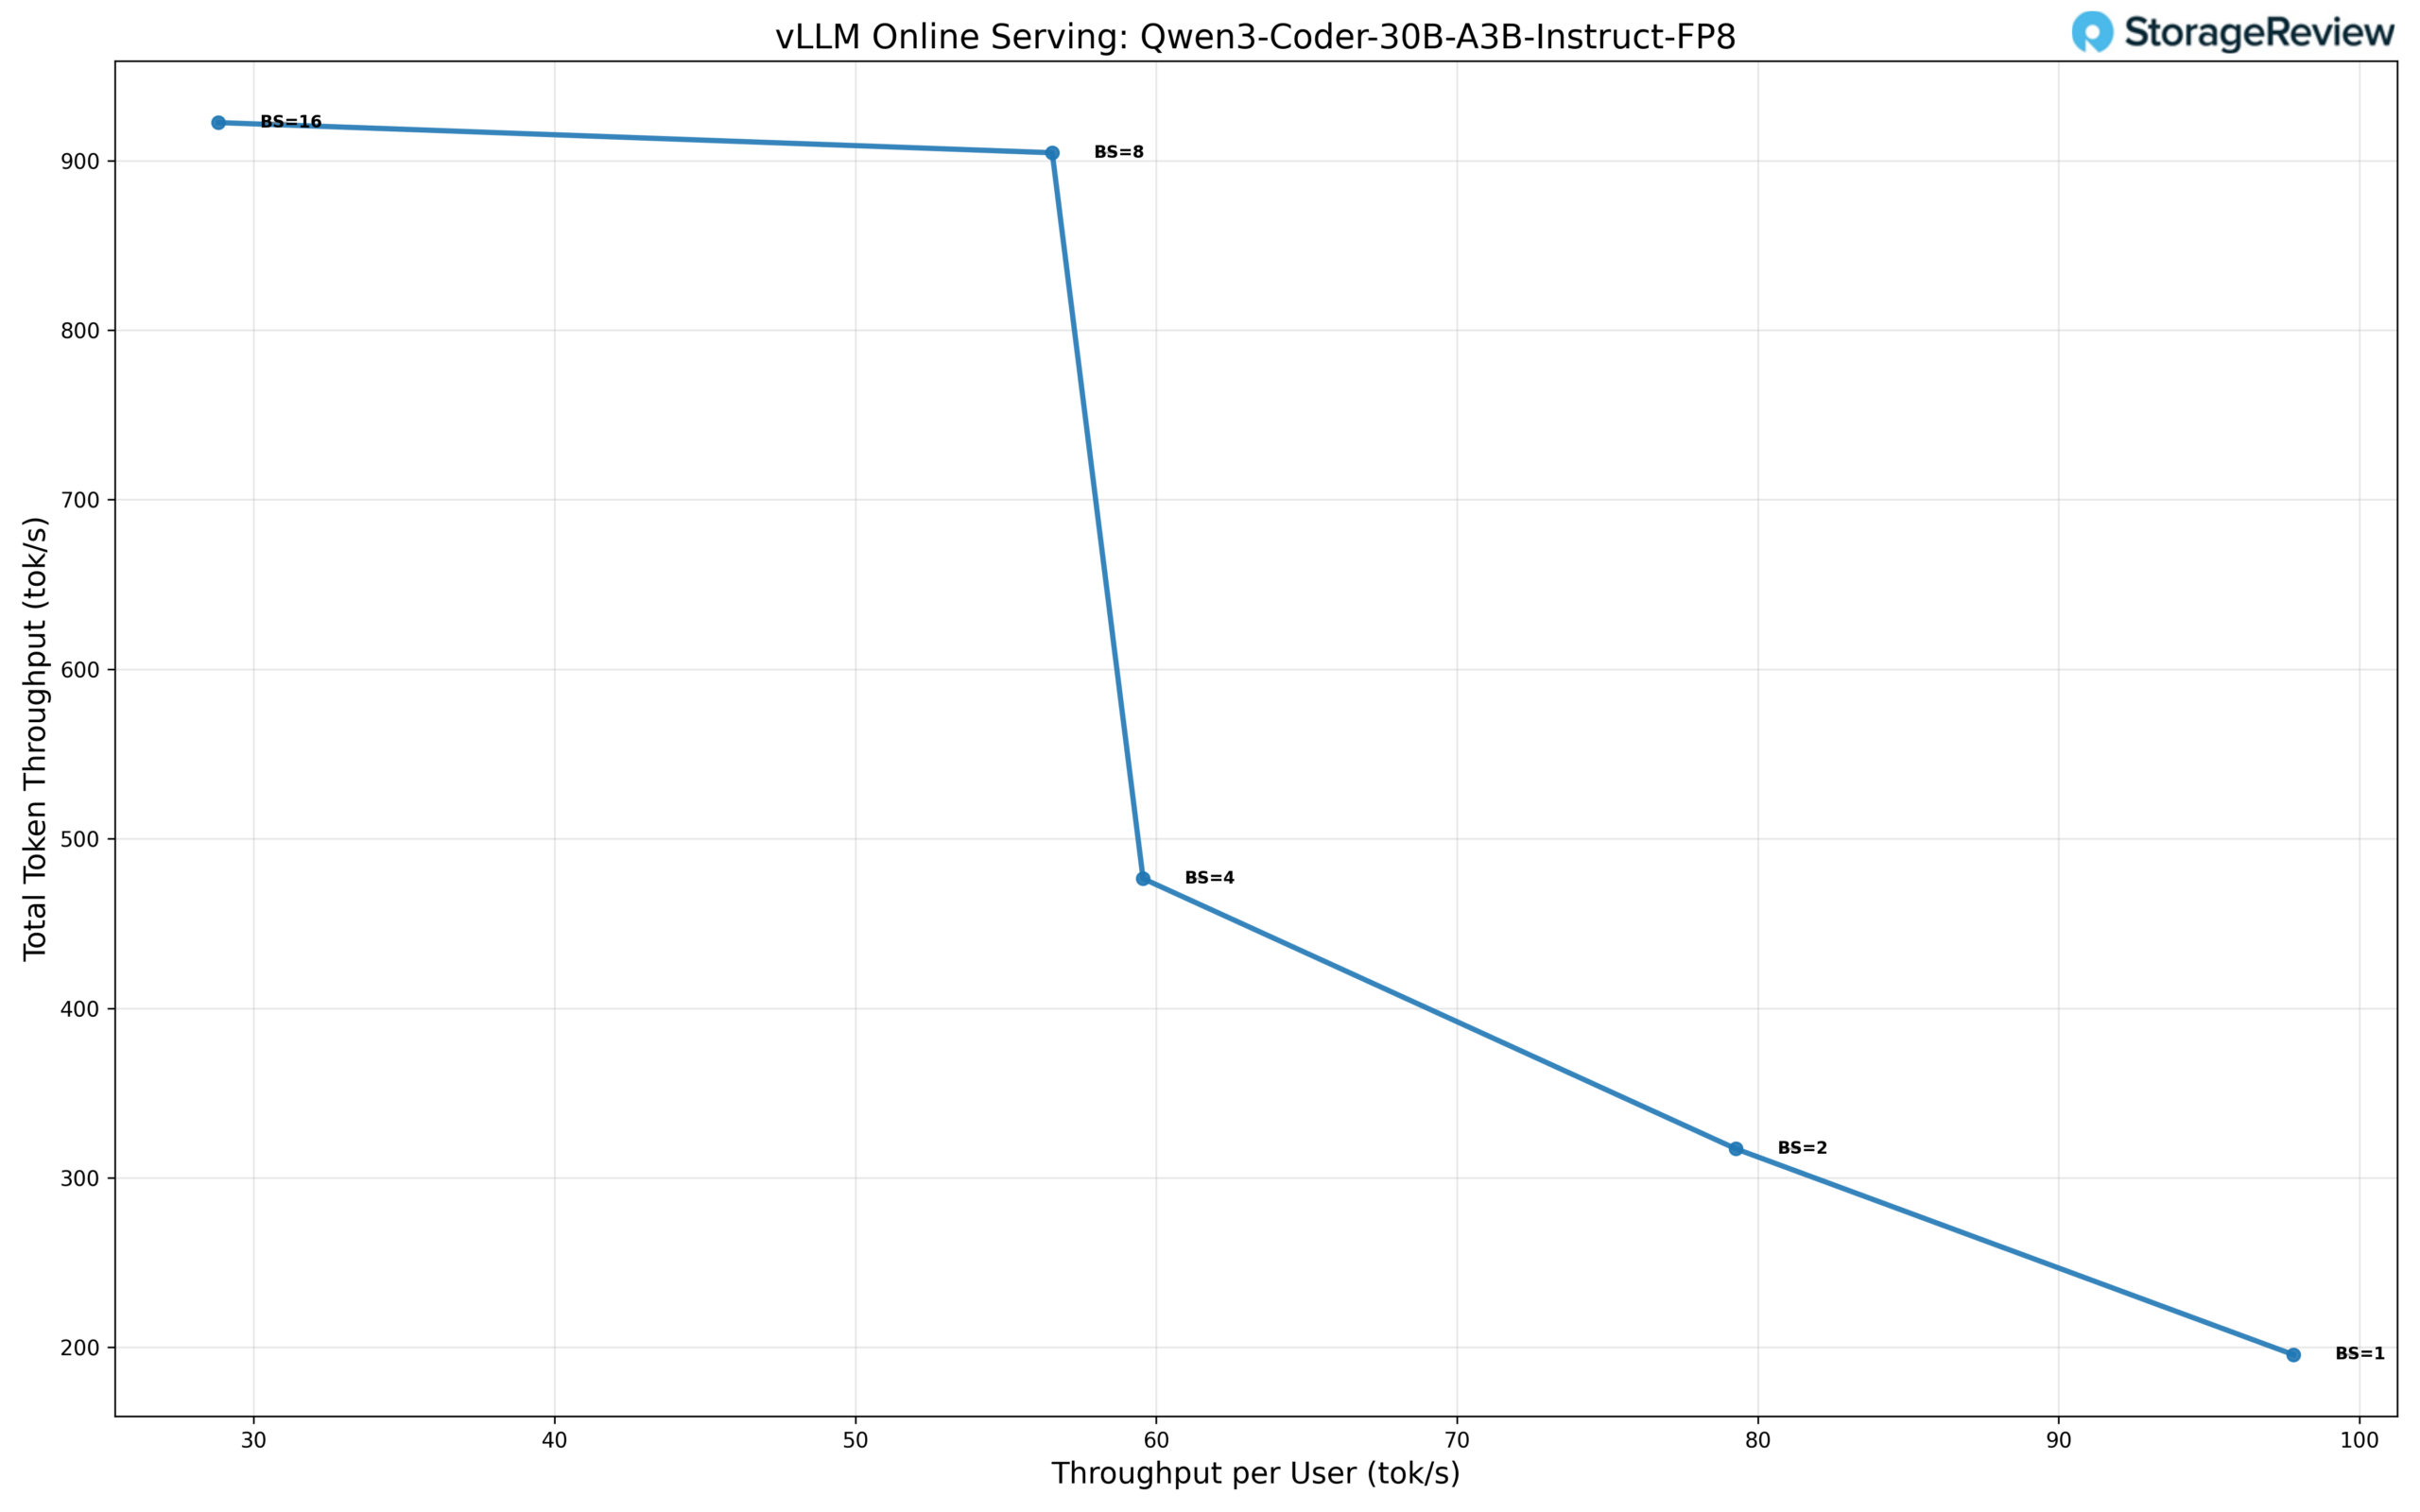
以 FP8 精度运行的 Qwen3-Coder-30B-A3B 模型展现出针对中等并发场景优化的扩展性能,在提供强大单用户性能的同时,比小型模型更快达到性能饱和。在单用户操作 (BS=1) 下,该模型单用户吞吐量约为 98 tok/s,总吞吐量为 196 tok/s,建立了较高的单流基准,体现了该模型针对代码生成工作负载的优化。
随着并发量的增加,总吞吐量能够高效扩展,而单用户吞吐量则以可控的方式下降。当批处理数 (BS) 为 2 时,总吞吐量提升至 317 tok/s,单用户吞吐量为 79 tok/s;当 BS 为 4 时,总吞吐量达到 477 tok/s,单用户吞吐量为 59 tok/s。这些结果表明,通过低到中等的批处理,可以有效地利用可用的计算资源,而不会导致单用户响应速度的急剧下降。
该模型在 BS=8 时达到峰值总吞吐量,维持在约 905 tok/s 的总吞吐量,其中每个用户 56 tok/s。在 BS=16 时,模型的扩展性略有提升,总吞吐量略微增加至 920 tok/s,而每个用户的吞吐量则下降至 29 tok/s,表明推理流水线已达到饱和。超过此点后,增加并发量对总吞吐量的提升微乎其微,却会显著影响每个用户的性能。
总体而言,Qwen3-Coder-30B-A3B FP8 的总吞吐量从 BS=1 到 BS=16 的峰值提升了约 4.7 倍。延迟和吞吐量特性表明,此配置最适合对单次请求性能要求较高的中等规模多用户编码工作负载。不过,其主要目标并非极致的批量扩展。
微扩展数据类型性能
微尺度量化是一种先进的量化方法,它对小块权重应用精细的缩放因子,而不是对大参数组进行均匀量化。NVIDIA 的 NVFP4 格式通过分块浮点表示来实现这项技术,其中每个包含 8 到 32 个值的微尺度块共享一个典型的指数作为缩放因子。这种精细化的方法在保持数值精度的同时实现了 4 位表示,从而维持了 Transformer 架构所需的动态范围。该格式与 NVIDIA 的 Tensor Core 架构集成,支持高效的混合精度计算,并在矩阵运算期间进行即时解压缩。
GPT-OSS-20b 性能
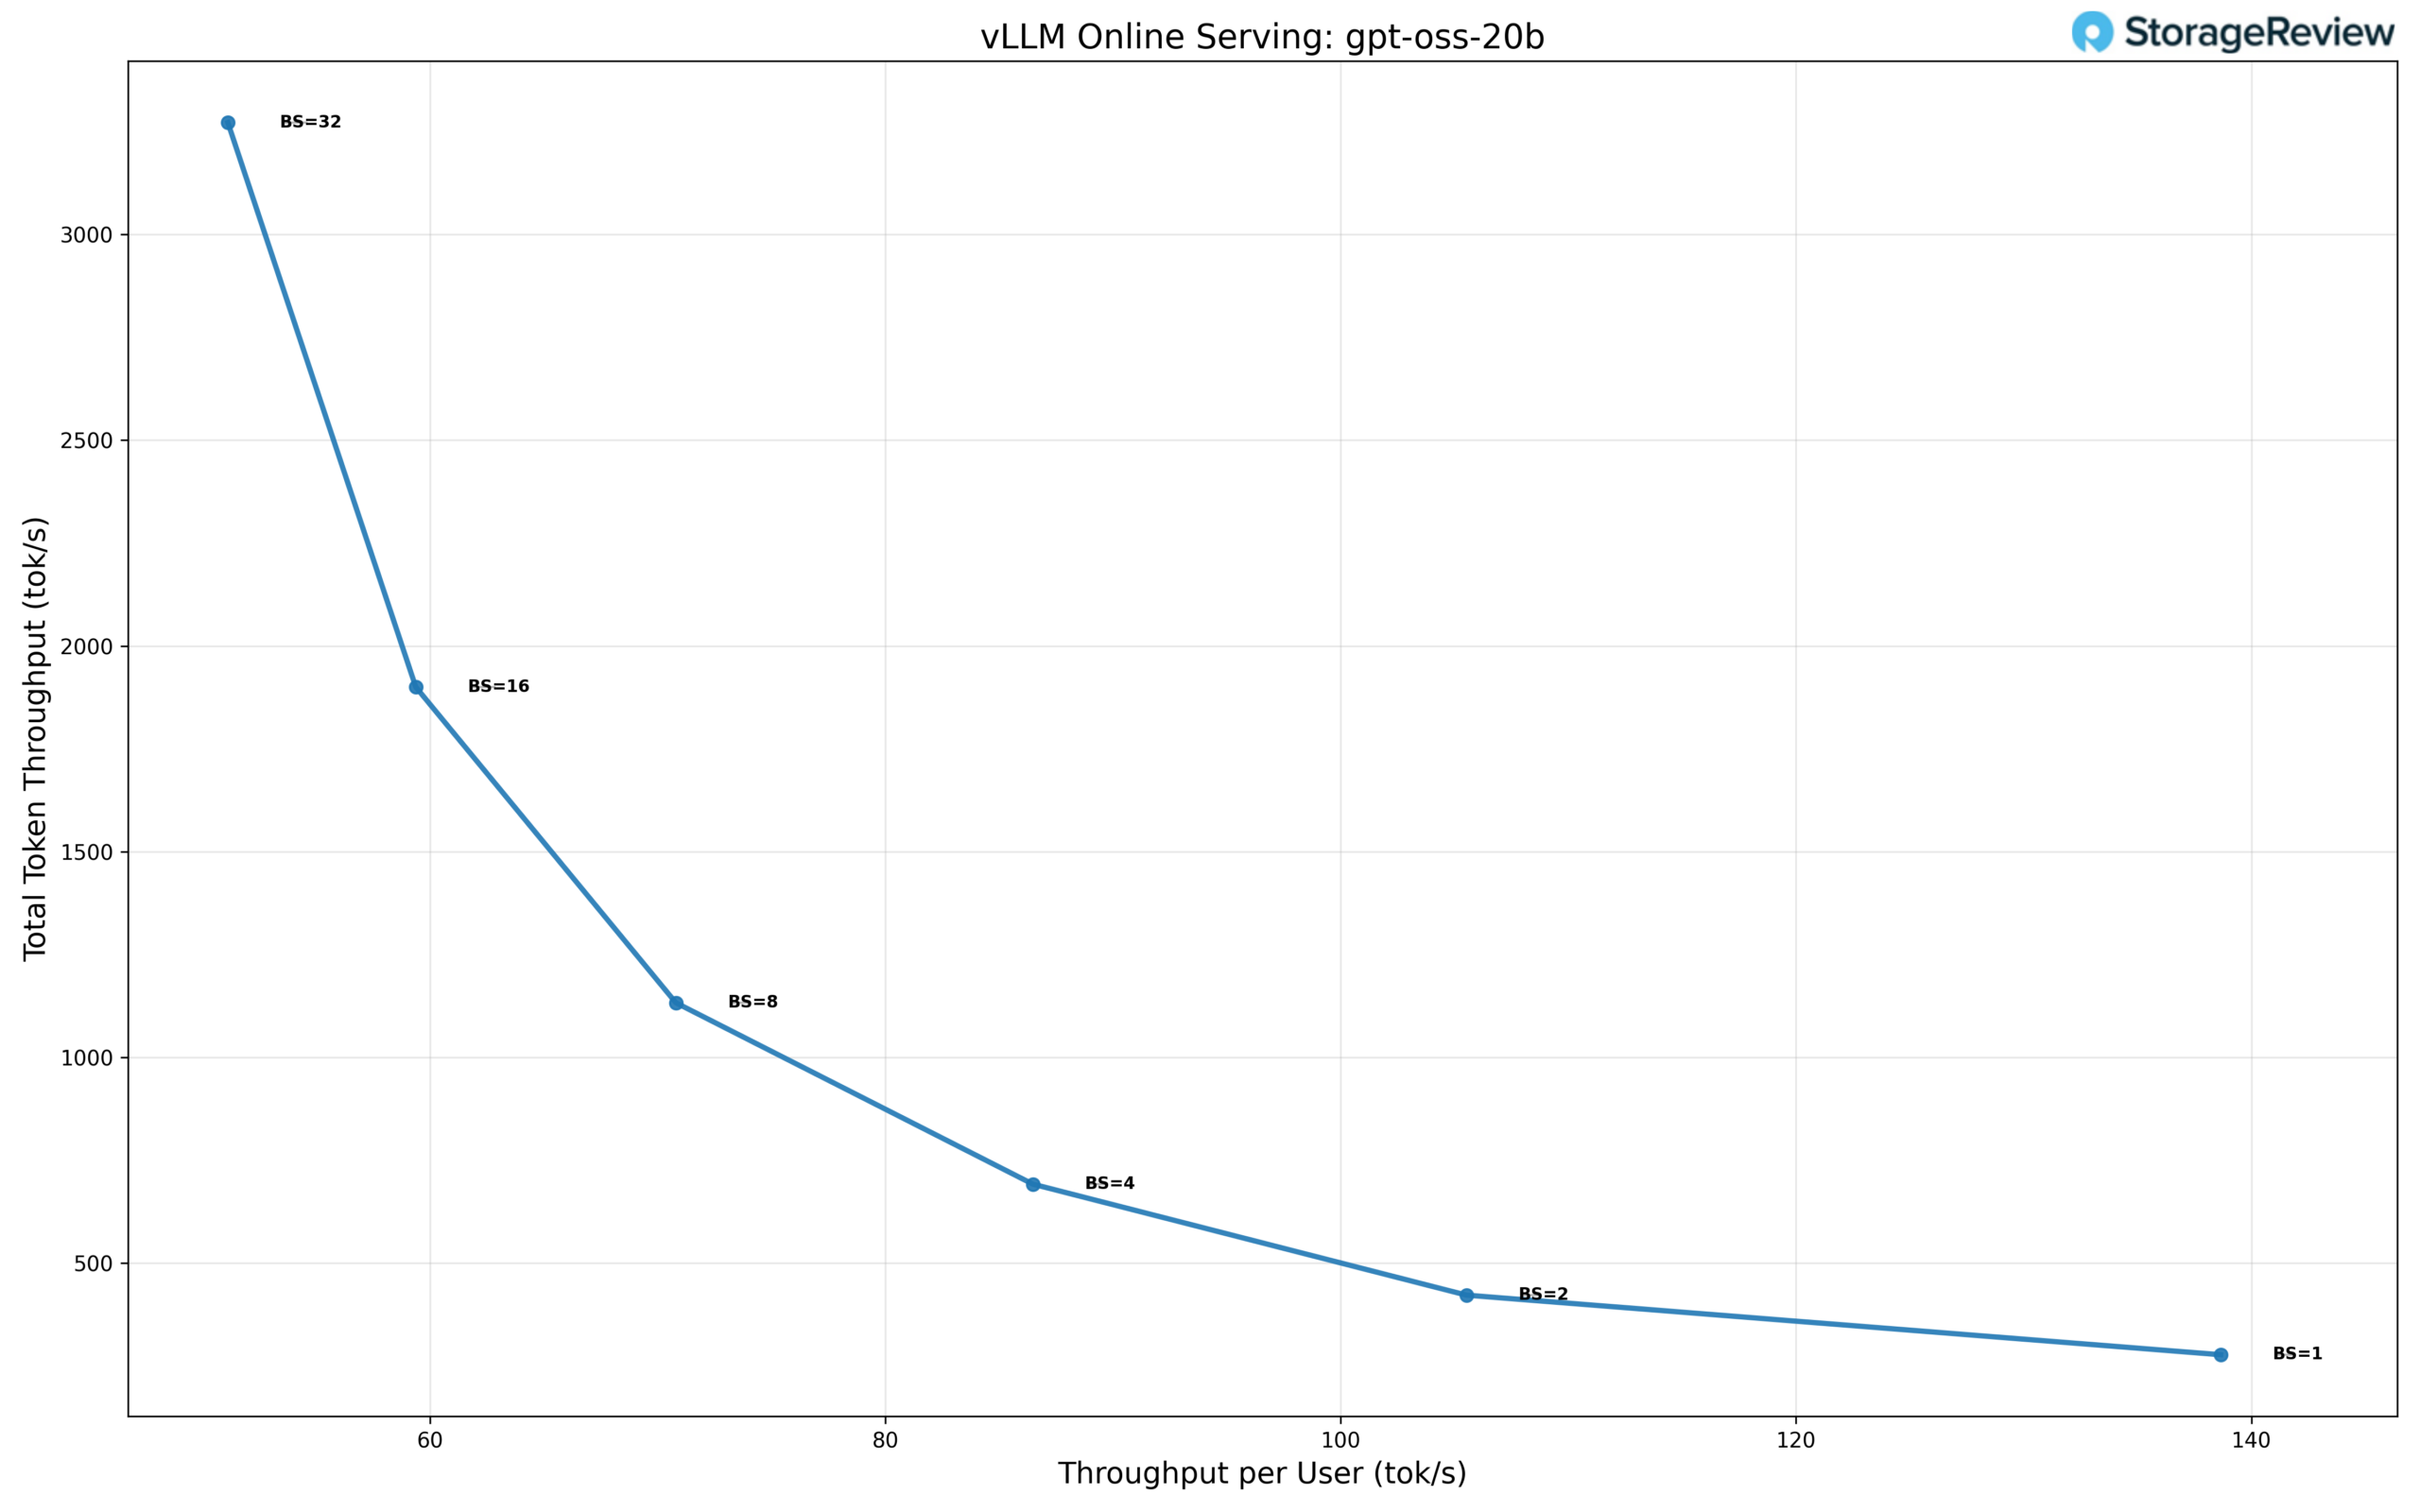
gpt-oss-20b 模型在不断提高的并发级别下展现出强大的扩展性,尤其是在大批处理规模下具有极高的聚合吞吐量。在单用户并发(BS=1)下,该模型每个用户的处理能力约为 138 tok/s,总吞吐量达到 276 tok/s,为单流推理树立了良好的基准。
随着并发量的增加,总吞吐量迅速增长,而单用户吞吐量则如预期般下降。当批处理数 (BS) 为 2 时,总吞吐量提升至 420 tok/s,单用户吞吐量为 105 tok/s;当 BS 为 4 时,总吞吐量达到 690 tok/s,单用户吞吐量为 86 tok/s。这种稳步增长表明,通过低到中等的批处理方式,可以有效地利用可用的计算资源。
扩展性在 BS=8 时持续提升,此时模型总吞吐量约为 1,120 tok/s,每个用户吞吐量为 70 tok/s;在 BS=16 时,总吞吐量提升至 1,900 tok/s,每个用户吞吐量为 60 tok/s。这些结果表明,即使并发量增加,gpt-oss-20b 仍能保持相对较高的单用户性能,使其非常适合多用户服务场景。
该模型在批处理大小为 32 时达到峰值总吞吐量,约为 3,250 tok/s,此时单用户吞吐量降至 50 tok/s。与单用户性能相比,总吞吐量提高了 11.8 倍。虽然随着批处理大小的增加,单用户吞吐量持续下降,但整体扩展效率依然强劲,表明该模型能够从更高的并发性中获益,而不会过早达到饱和点。
总体而言,gpt-oss-20b 展现出均衡的扩展性能,兼具出色的单用户性能和强大的批量扩展能力。这使其成为在多用户负载较高的情况下,既需要快速响应的单用户推理,又需要高聚合吞吐量的部署方案的理想选择。
Phoronix 基准测试
Phoronix 测试套件是一个开源的自动化基准测试平台,通过 OpenBenchmarking.org 支持超过 450 个测试配置文件和 100 多个测试套件。它能够处理从安装依赖项到运行测试和收集结果的所有操作,使其成为性能比较、硬件验证和持续集成的理想选择。
流内存带宽
SR650 V4 提供了 369.6GB/s 的内存带宽,展现了对数据密集型工作负载的强大吞吐量,并证实了健康的多通道内存性能。
7-Zip 压缩
该系统拥有 584,499 MIPS 的性能,压缩和解压缩性能出色,体现了其强大的多核效率和整数计算能力。
内核编译
服务器在 256.175 秒内完成了 allmod 内核构建,这是一个令人满意的结果,突显了其高效处理并行编译和开发人员工作流程的能力。
Apache的Web服务器
SR650 V4 的请求吞吐量为 61,654 R/s,表现出强大的 Web 服务性能,能够维持较高的请求吞吐量,适用于前端托管或轻量级虚拟化堆栈。
OpenSSL 验证
该平台每秒处理 712.6 亿字节,展现了强大的加密验证性能,证实了 CPU 具备安全、证书密集型操作的能力。
| Phoronix 基准测试 | 联想ThinkSystem SR650 V4 |
|---|---|
| 资讯 | 369,58.3 MB / s的 |
| 7个邮递区号 | 584,499米每秒 |
| 内核编译(allmod) | 256.175秒 |
| Apache(每秒请求数) | 61,654.47 卢比/秒 |
| OpenSSL | 712,633,776,990 字节/秒 |
结语
ThinkSystem SR650 V4 的平台更新意义非凡,因为它并非仅仅是更换了 CPU。联想利用这一代产品,在限制实际部署的诸多方面进行了实质性的改进,包括内存带宽、PCIe 通道可用性、存储密度以及根据需求变化调整配置的能力。升级到英特尔至强 6 处理器带来了更多核心选择和每个插槽更大的 I/O 空间,而其他平台方面的改进,例如支持 MRDIMM 的更快 DDR5 内存和可选的 CXL 扩展,都使 SR650 V4 能够在工作负载对内存需求日益增长的情况下保持竞争力。
在存储方面,尽管我们此次评测的配置仅限于 U.2 接口,但联想大力推广的 E3.S 接口提供了更高的 NVMe 密度、1:1 连接以及更佳的散热性能,这与现代基础设施的构建方式相契合,尤其适用于需要更多本地闪存的虚拟化架构,以及对 GPU 的支持与原始计算能力同等重要的 AI 相关流程。此外,双 OCP 3.0 Gen5 x16 插槽的加入也带来了实用的升级:您可以部署强大的网络功能,而无需占用原本用于加速器、存储设备或专用适配器的 PCIe 插槽。
如果您目前使用的是 SR650 V3,并且感觉内存速度、PCIe 扩展空间或 NVMe 容量限制了您的需求,那么 SR650 V4 将是您理想的升级之选。它保留了 SR650 系列广受欢迎的可维护性和可配置性,同时还提供了更大的平台扩展空间,帮助 IT 团队避免陷入困境。无论您是构建虚拟化集群、升级横向扩展服务,还是组装 CPU/GPU 均衡的节点,SR650 V4 都能满足您的关键需求,并为未来的发展预留了空间。


 Amazon