

高可用性已从数据中心的奢侈品变为常规弹性规划中的一项重要内容。小型企业和边缘站点现在运行着销售点系统、监控系统和共享存储,这些系统每宕机一分钟都会造成损失,然而传统的解决方案——双控制器企业级阵列——其规模和价格是针对数据中心而非分支机构机房或壁挂式机架设计的。这种不匹配导致小型 IT 部门只能依靠备份和快照来保护数据,而无法保障业务连续性:单控制器 NAS,无论设计多么精良,仍然是一个单点故障。
高可用性对 QNAP 来说并非新鲜事物,该公司一直提供双控制器硬件和基于复制的恢复方案。QuTS hero h6.0的变革在于效率。全新的高可用性管理器将集群功能集成到普通硬件的操作系统中,使两台相同的 NAS 设备能够在同一个 IP 地址后组成一个主备集群。这样,当一台设备出现故障时,另一台设备可以立即接管,客户端几乎感觉不到任何变化。对于希望合理配置 IT 投资的企业而言,这意味着只需一台 NAS 设备即可实现高可用性,而无需购置第二套基础设施。
这就是我们的方案:为了检验其在实际应用中的表现,我们在实验室搭建了一个高可用性集群,该集群由两台配备希捷IronWolf Pro硬盘和QNAP E1.S SSD缓存的QNAP TS-h765eU系统组成。然后,我们模拟边缘节点发生故障的情况,对其进行测试。我们在传输过程中断开了活动节点的电源。我们还断开了其网络连接,但保持心跳信号畅通。在这两种情况下,问题都是一样的:文件传输能否成功?故障节点恢复后,系统会如何恢复?
QNAP TS-h765eU 概述
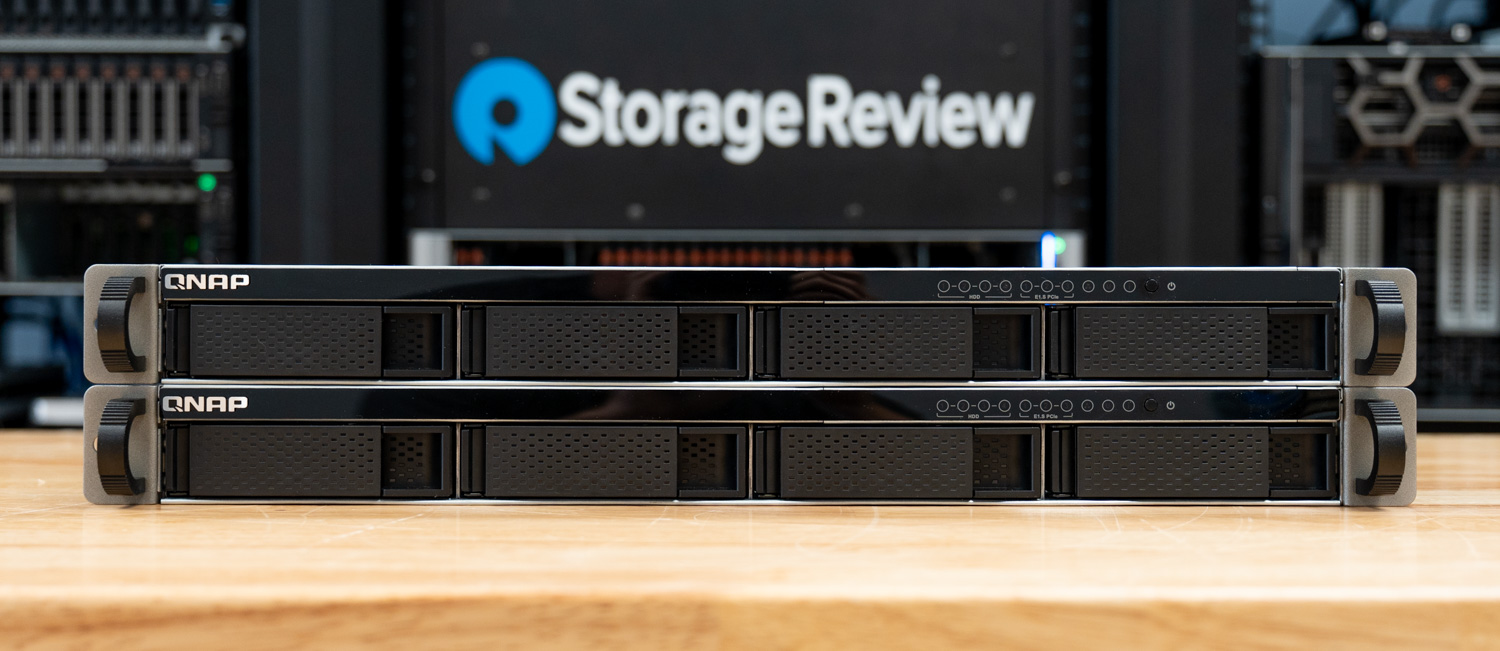
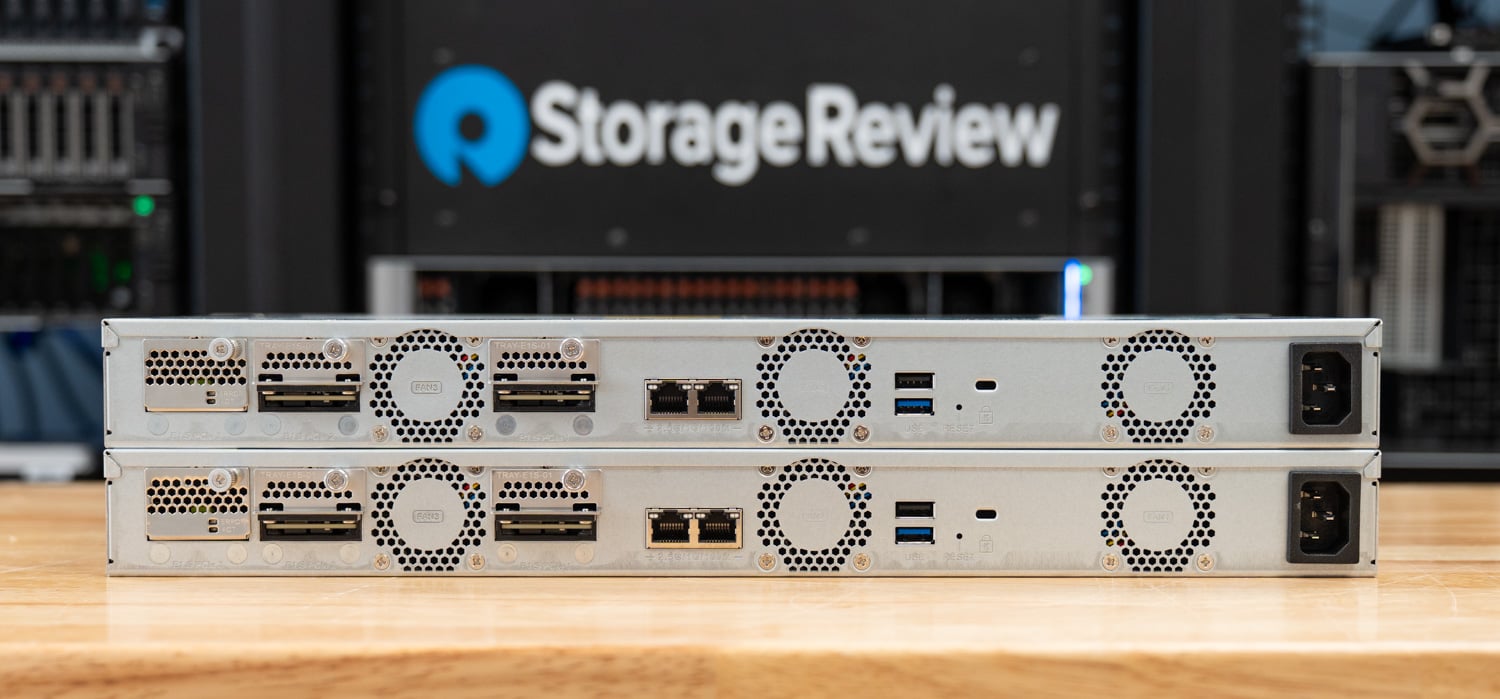
TS-h765eU 之所以成为构建高可用性 (HA) 系统的理想选择,正是因为其硬件相对简单。这款 1U 短深度机架式 NAS 机箱深度仅为 292.1 毫米(12 英寸),专为小型媒体柜、壁挂式网络机架以及无法安装全深度机箱的边缘部署环境而设计。每个单元正面提供四个 3.5 英寸 SATA 硬盘位,背面则配备三个 E1.S/M.2 PCIe NVMe 插槽,使其具备混合存储特性:机械硬盘提供大容量存储,闪存则用于缓存或高速存储。
QNAP 还将其指定为长期供应模式,保证供应至 2031 年,这对于跨站点采用统一平台的组织来说非常重要。
TS-h765eU 内部搭载英特尔凌动 x7405C 四核处理器,最高主频可达 3.4GHz,配备 8GB DDR5 内存(可升级至 16GB),支持 ECC 纠错。网络连接方面,标配两个 2.5GbE 端口,可通过将 E1.S 插槽更换为 QNAP 的 QXG-ES10G1T 模块来实现 10GbE 连接。
| 规格 | QNAP TS-h765eU |
|---|---|
| 中央处理器 | 英特尔凌动 x7405C 四核处理器,最高主频 3.4GHz |
| 内存 | 8GB DDR5内存,可升级至16GB(带内ECC) |
| 驱动器托架 | 4 个 3.5 英寸 SATA |
| 闪存插槽 | 3 个 E1.S / M.2 PCIe NVMe |
| 社交 | 2 个 2.5GbE 端口,可通过可选的 QXG-ES10G1T E1.S 模块实现 10GbE 端口 |
| 外形 | 1U 短深度机架式安装,深度 292.1 毫米(12 英寸) |
| 运行系统 | QuTS hero h6.0(基于 ZFS) |
| 可用性 | 2031年之前的长期供应模式 |
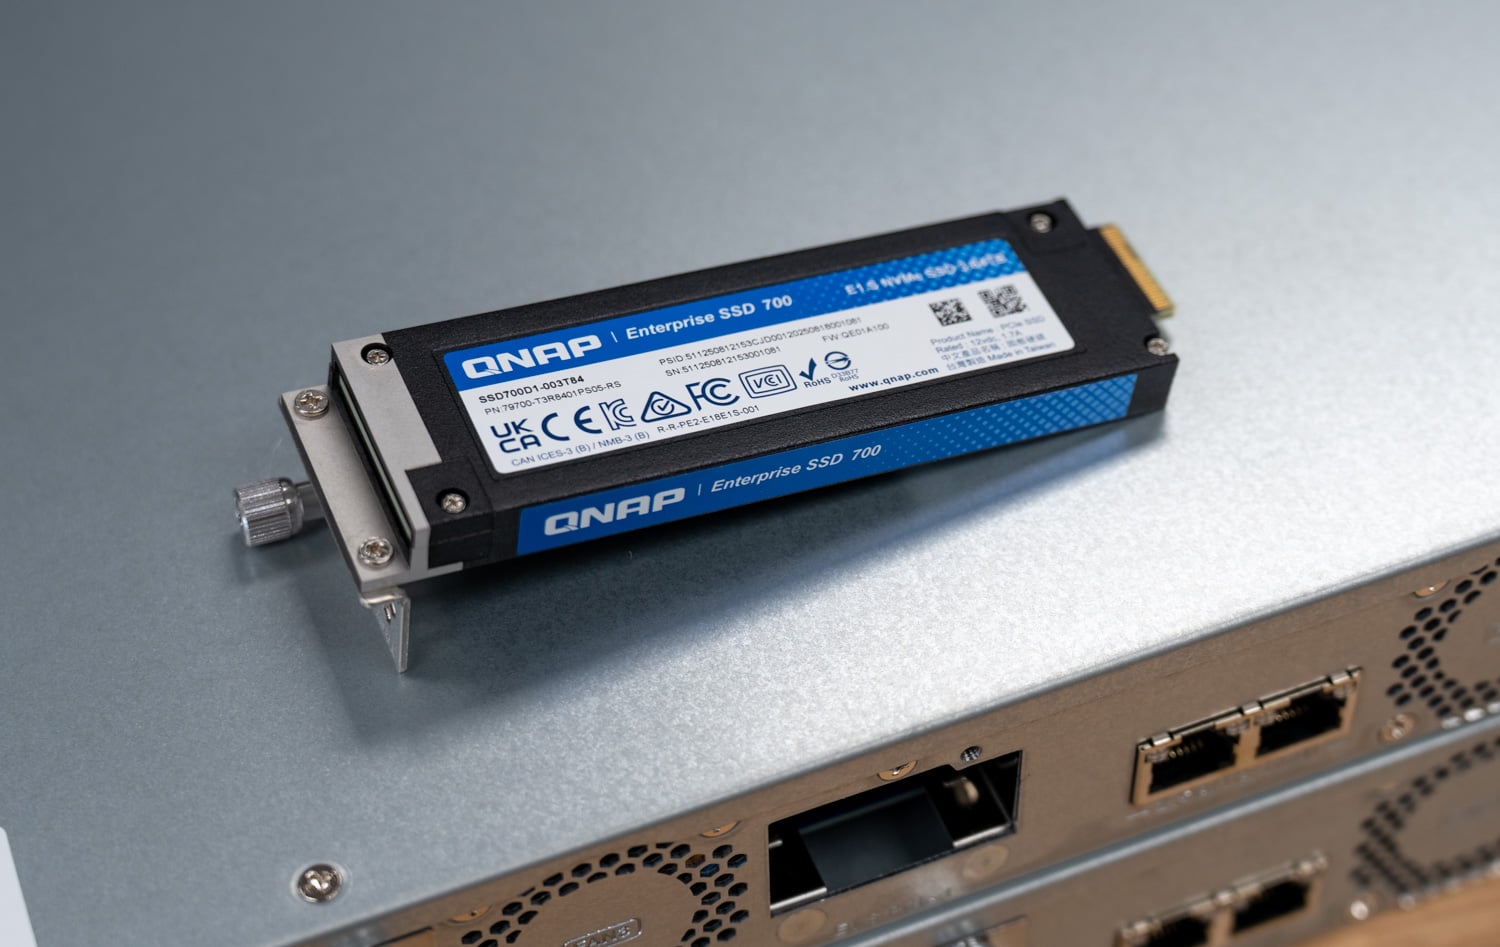
本次评估中,每个节点均配备四块希捷 IronWolf Pro 30TB 硬盘 (ST30000NT011),组成 RAID 5 存储池;另配备两块 3.84TB QNAP SSD700 E1.S 硬盘 (SSD700D1-003T84),组成 RAID 0 缓存。两个系统均运行 QuTS hero h6.0.0.3500 和 High Availability Manager 2.0.421。
QuTS hero h6.0 和 HA 管理器架构
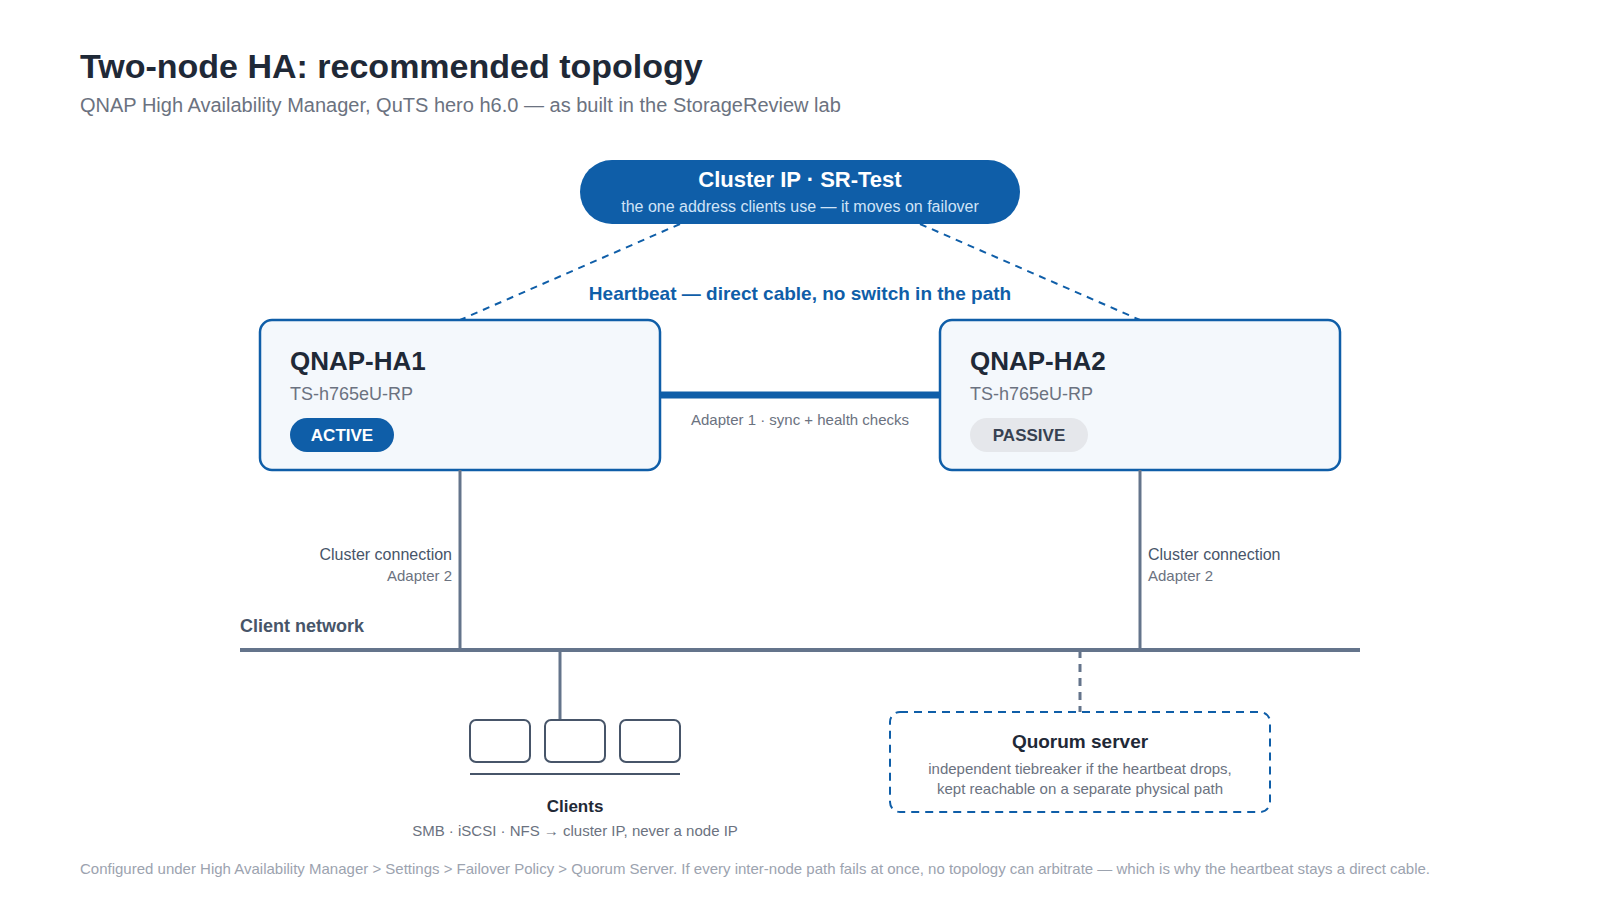
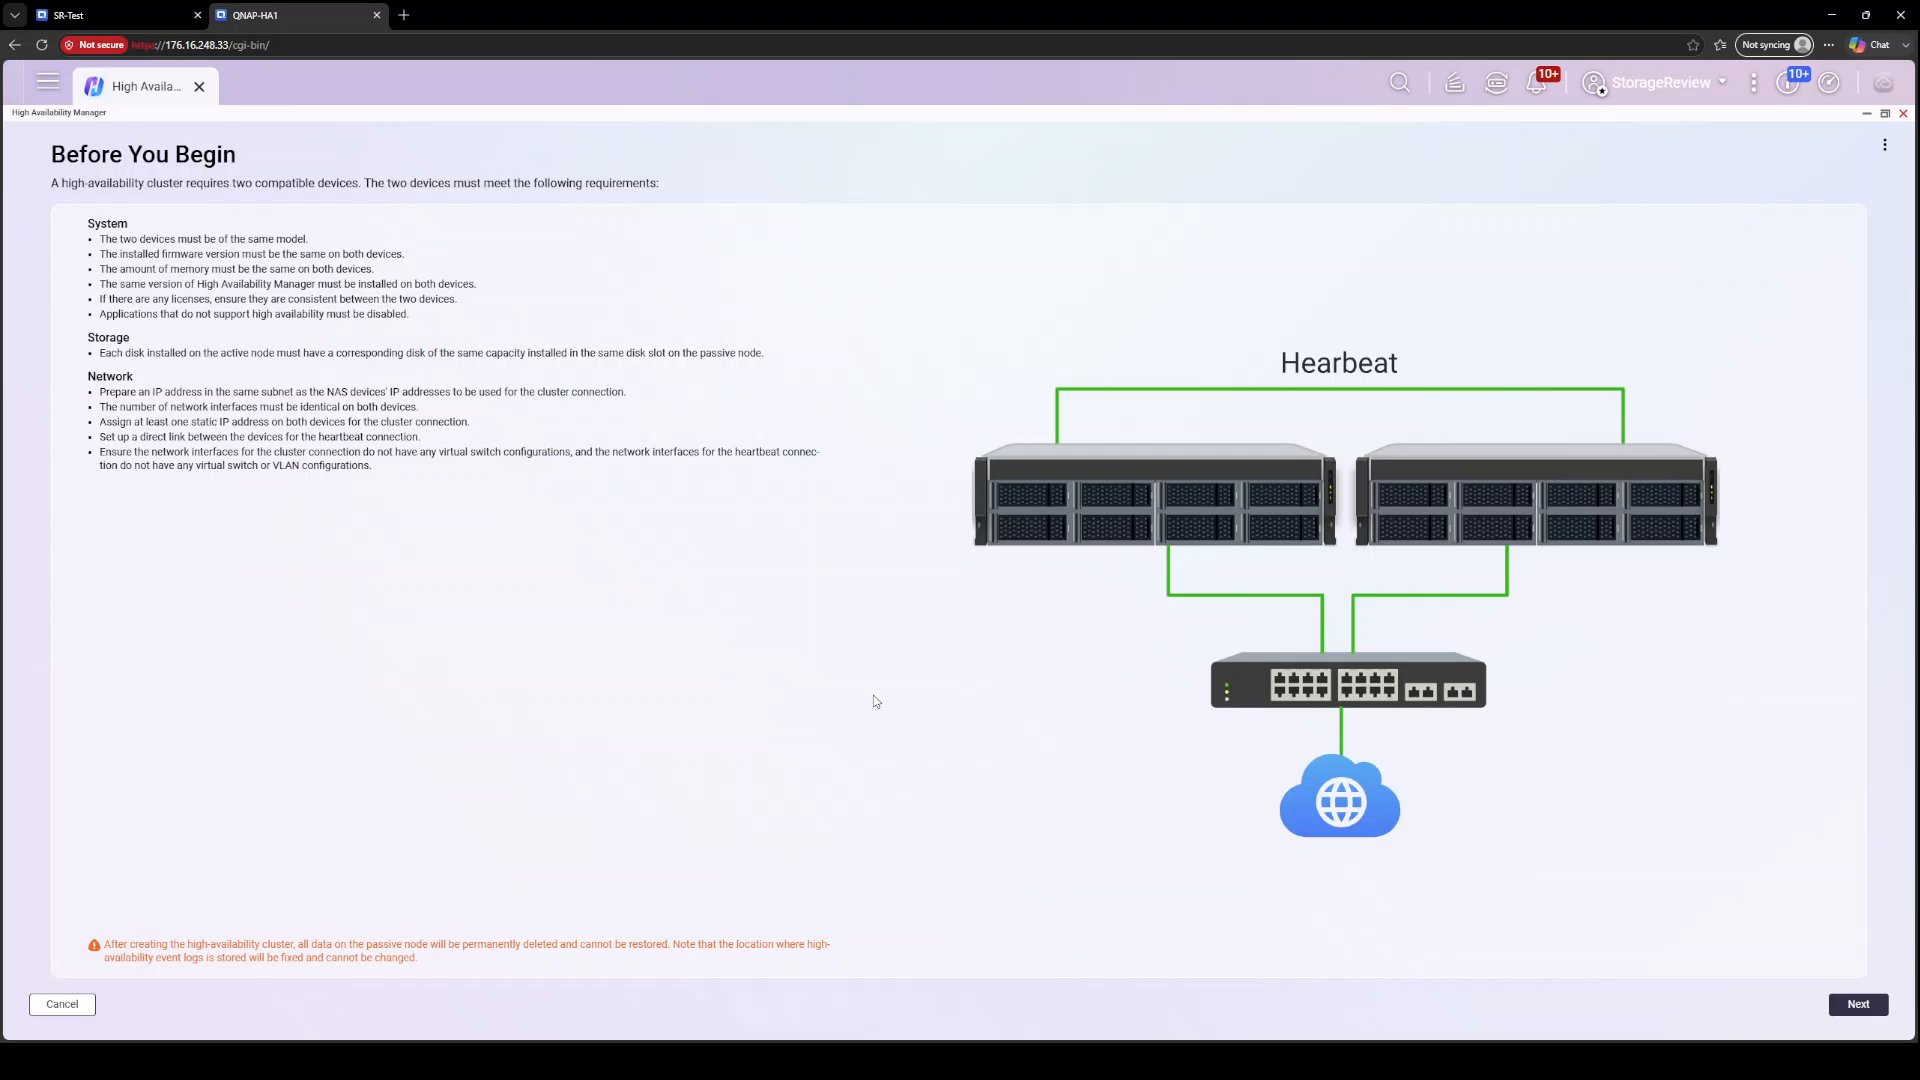
高可用性管理器是 QuTS hero h6.0 的核心功能,它采用经典的双主备架构。一台 NAS(活动节点)负责所有数据和服务。另一台 NAS(备用节点)通过专用的心跳连接与活动节点持续同步,随时准备接管。客户端无需直接与任何节点通信;集群会提供一个统一的 IP 地址和主机名,当前处于活动状态的节点会响应该地址和主机名。发生故障转移时,集群 IP 会重定向后端流量,因此映射驱动器、iSCSI 发起程序和备份作业无需重新指向。
心跳链路是该设计的核心。QNAP 要求两个设备之间直接连接,路径中不能有任何交换机,它承载着健康检查流量和节点间块级数据同步。一个独立的集群连接则通过普通网络处理面向客户端的流量。为了进一步防止脑裂,QNAP 还部署了仲裁服务器,它是网络上的第三个见证节点,可以帮助节点在心跳停止时判断是否应该提升自身地位。我们将在本文后续部分详细介绍脑裂及其部署拓扑结构。
QNAP 表示,h6.0 中超过 90% 的 NAS 服务支持高可用性 (HA),并且集群可以通过 JBOD 扩展柜扩展容量。但也有一些限制。h6.0 的另一项重要功能——不可变快照,目前在 HA 集群中不受支持,因此管理员暂时需要在两种保护措施之间做出选择。此外,HA 还要求两台系统完全相同,型号和固件版本必须一致,配对向导会强制执行此要求,然后才会允许您继续。
构建 QNAP 高可用性集群
集群创建从两台配置相同的 TS-h765eU 设备开始。从指定的活动节点开始,高可用性管理器向导会引导您完成一个简短的配对过程。向导通过心跳链路发现被动节点,然后要求您为网络接口分配角色:集群连接作为访问集群的通信通道,以及心跳连接(QNAP 指出该连接专用于数据同步,并且必须是设备之间的直接链路)。在我们的配置中,向导将心跳链路分配给了适配器 1,将集群连接分配给了适配器 2。
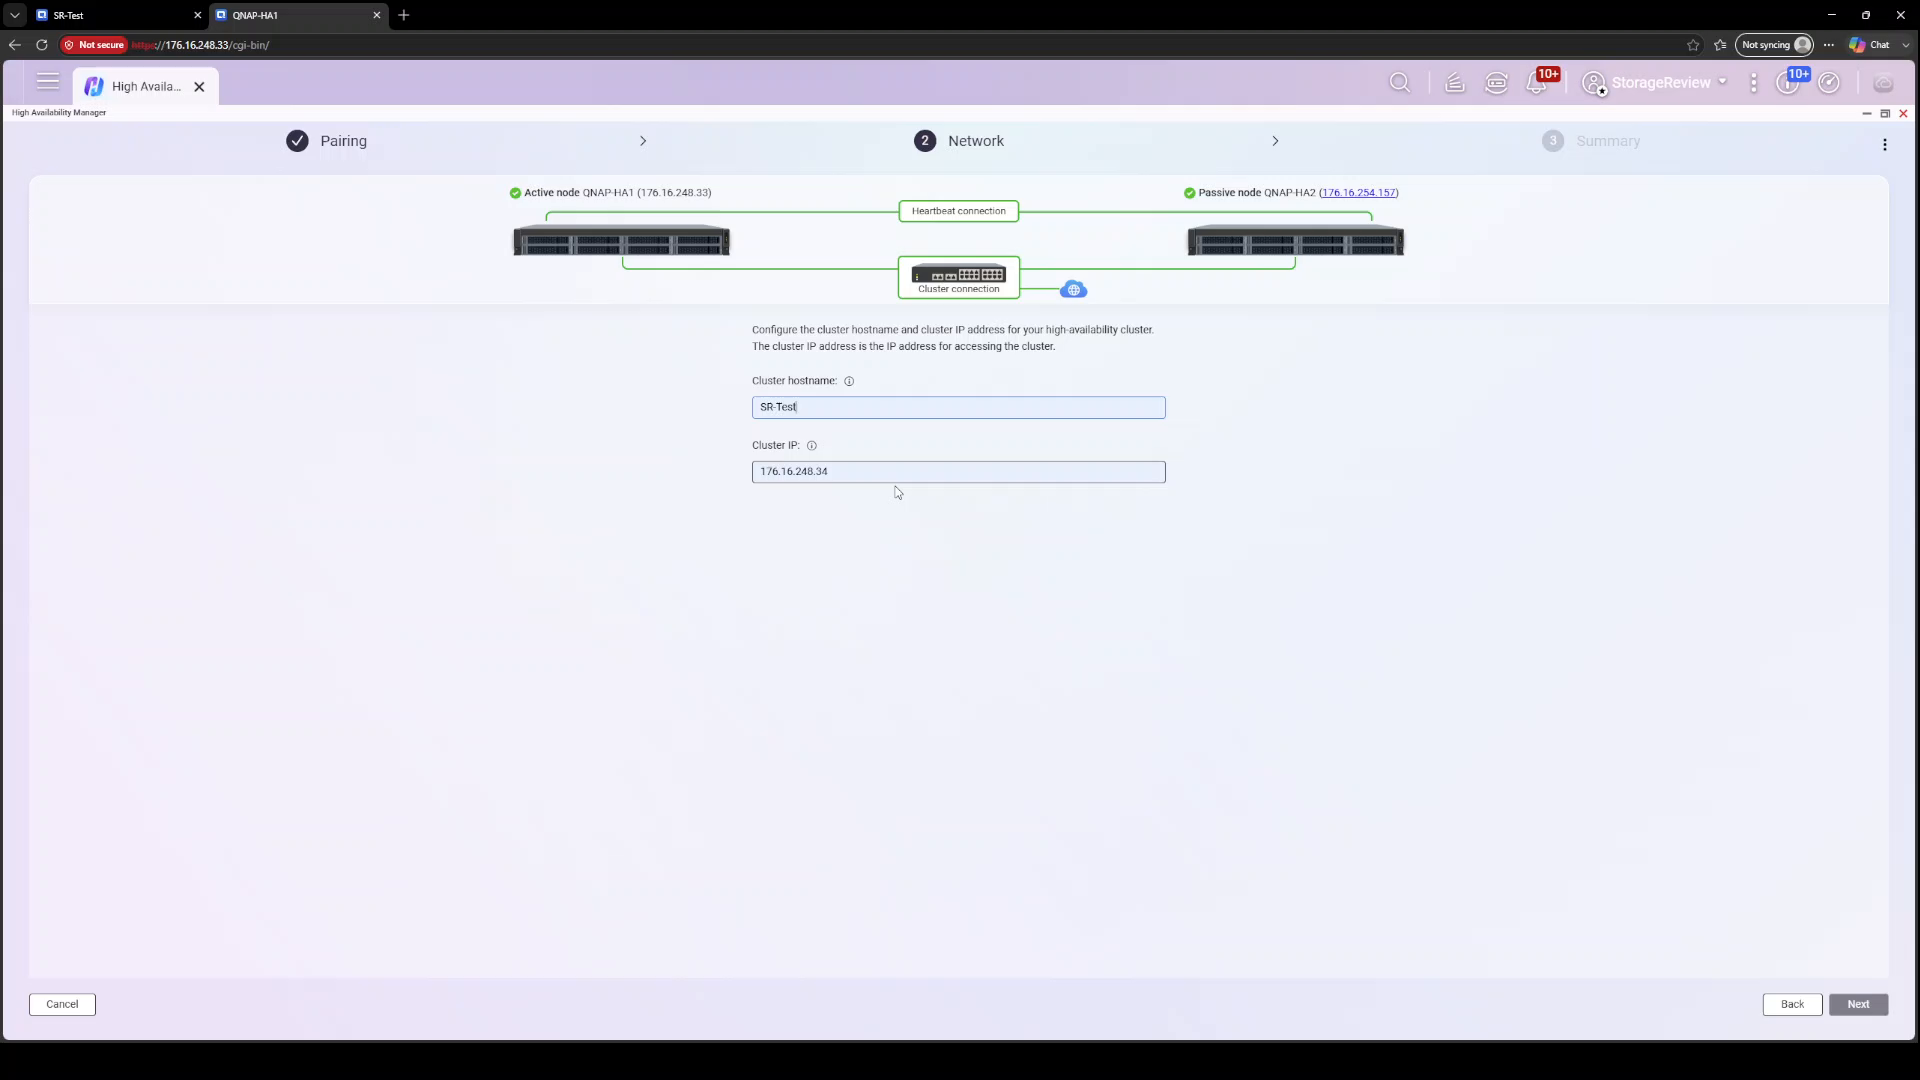
接下来是集群标识。您需要分配集群主机名和集群 IP 地址,从那时起,客户端将使用这两个地址。我们的集群名为 SR-Test,IP 地址为 176.16.248.34,位于节点 QNAP-HA1 (176.16.248.33) 和 QNAP-HA2 (176.16.254.157) 的前端,这两个节点位于实验室网络中不同的 /24 子网中;向导程序顺利地将它们配对。
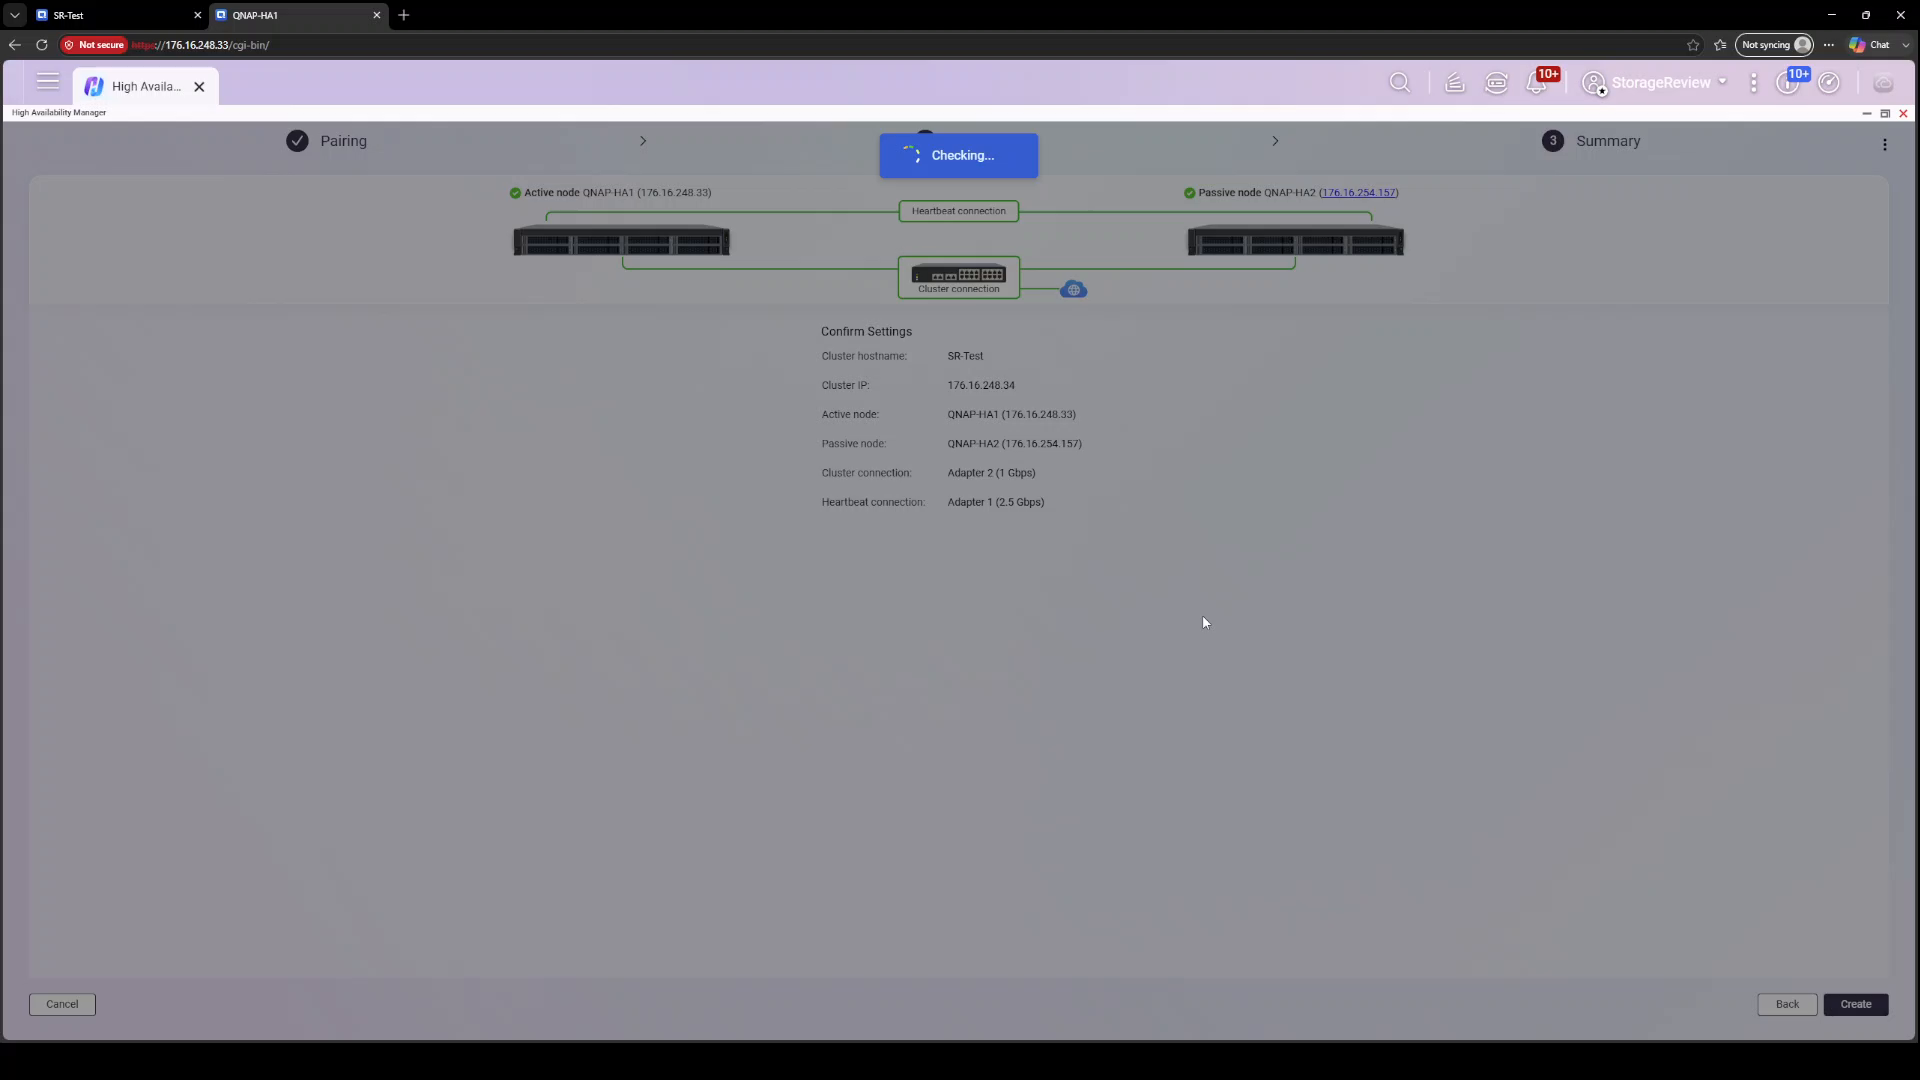
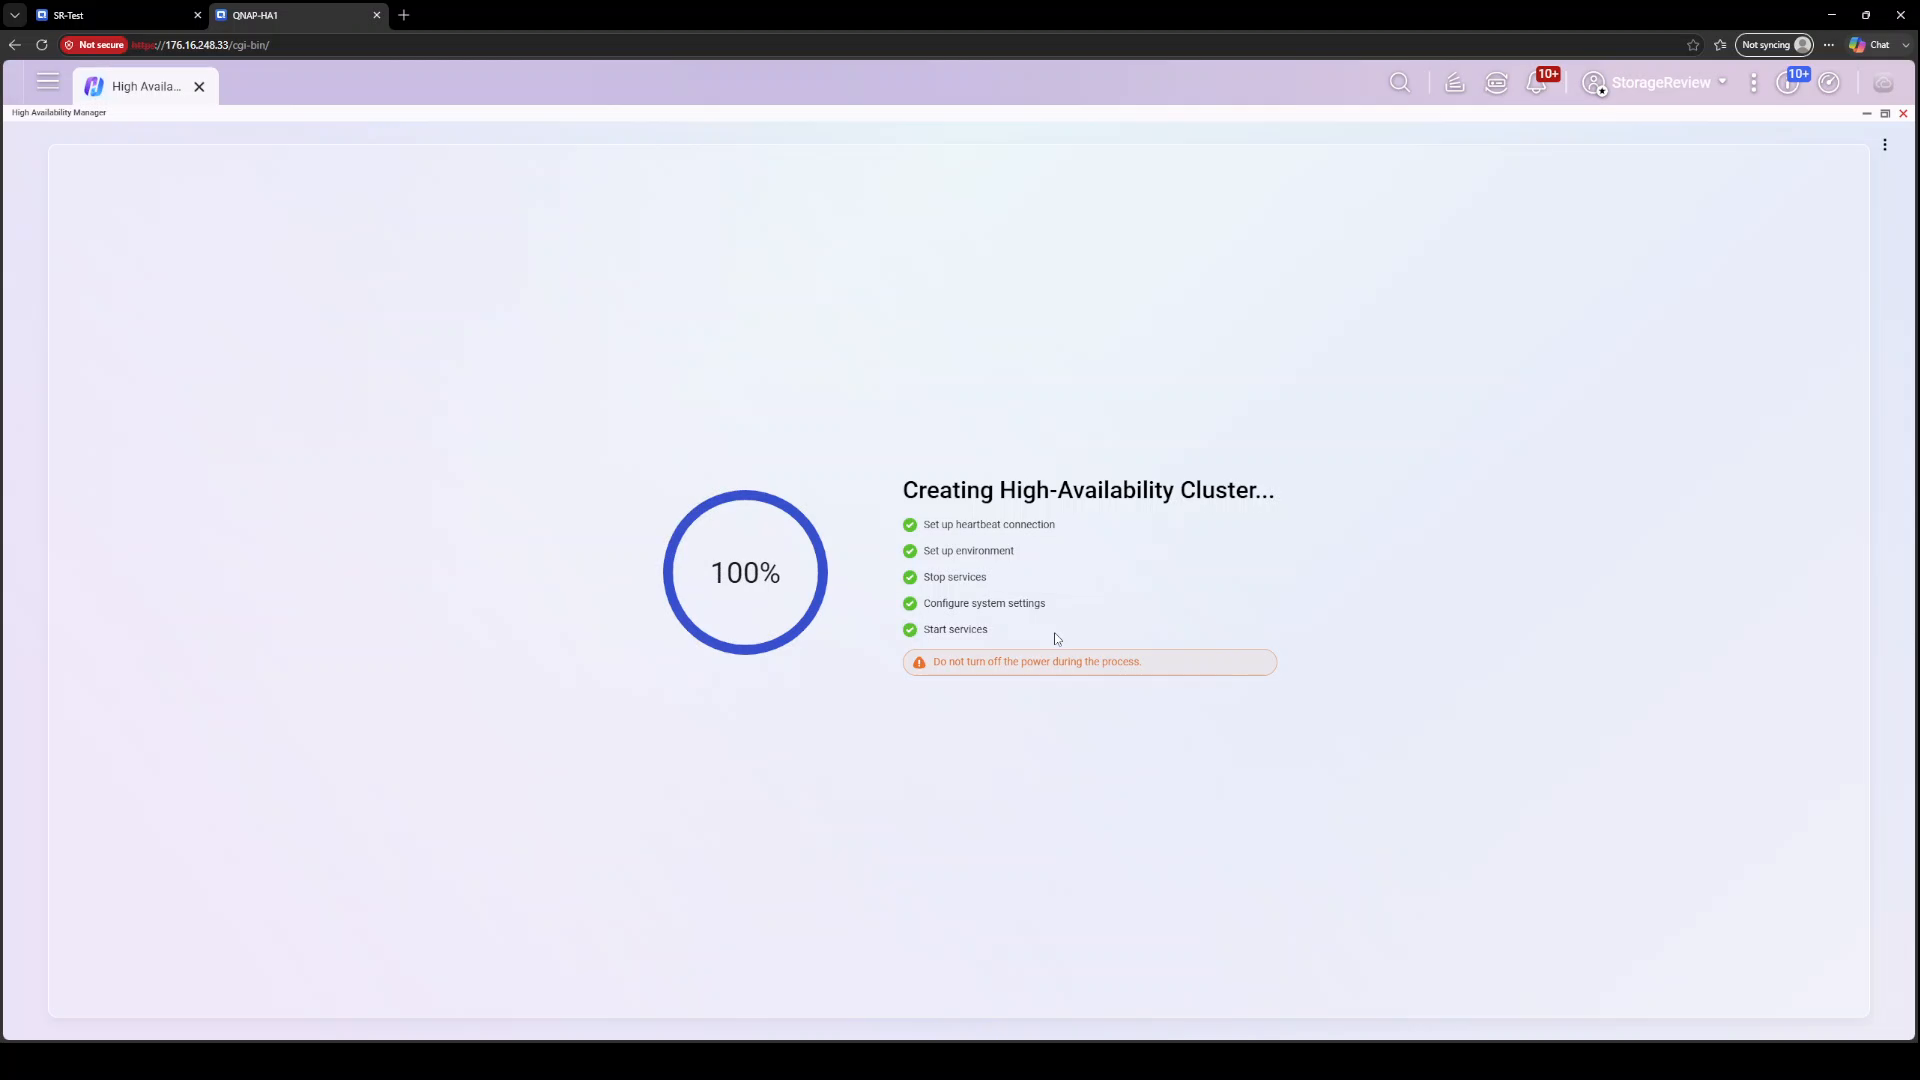
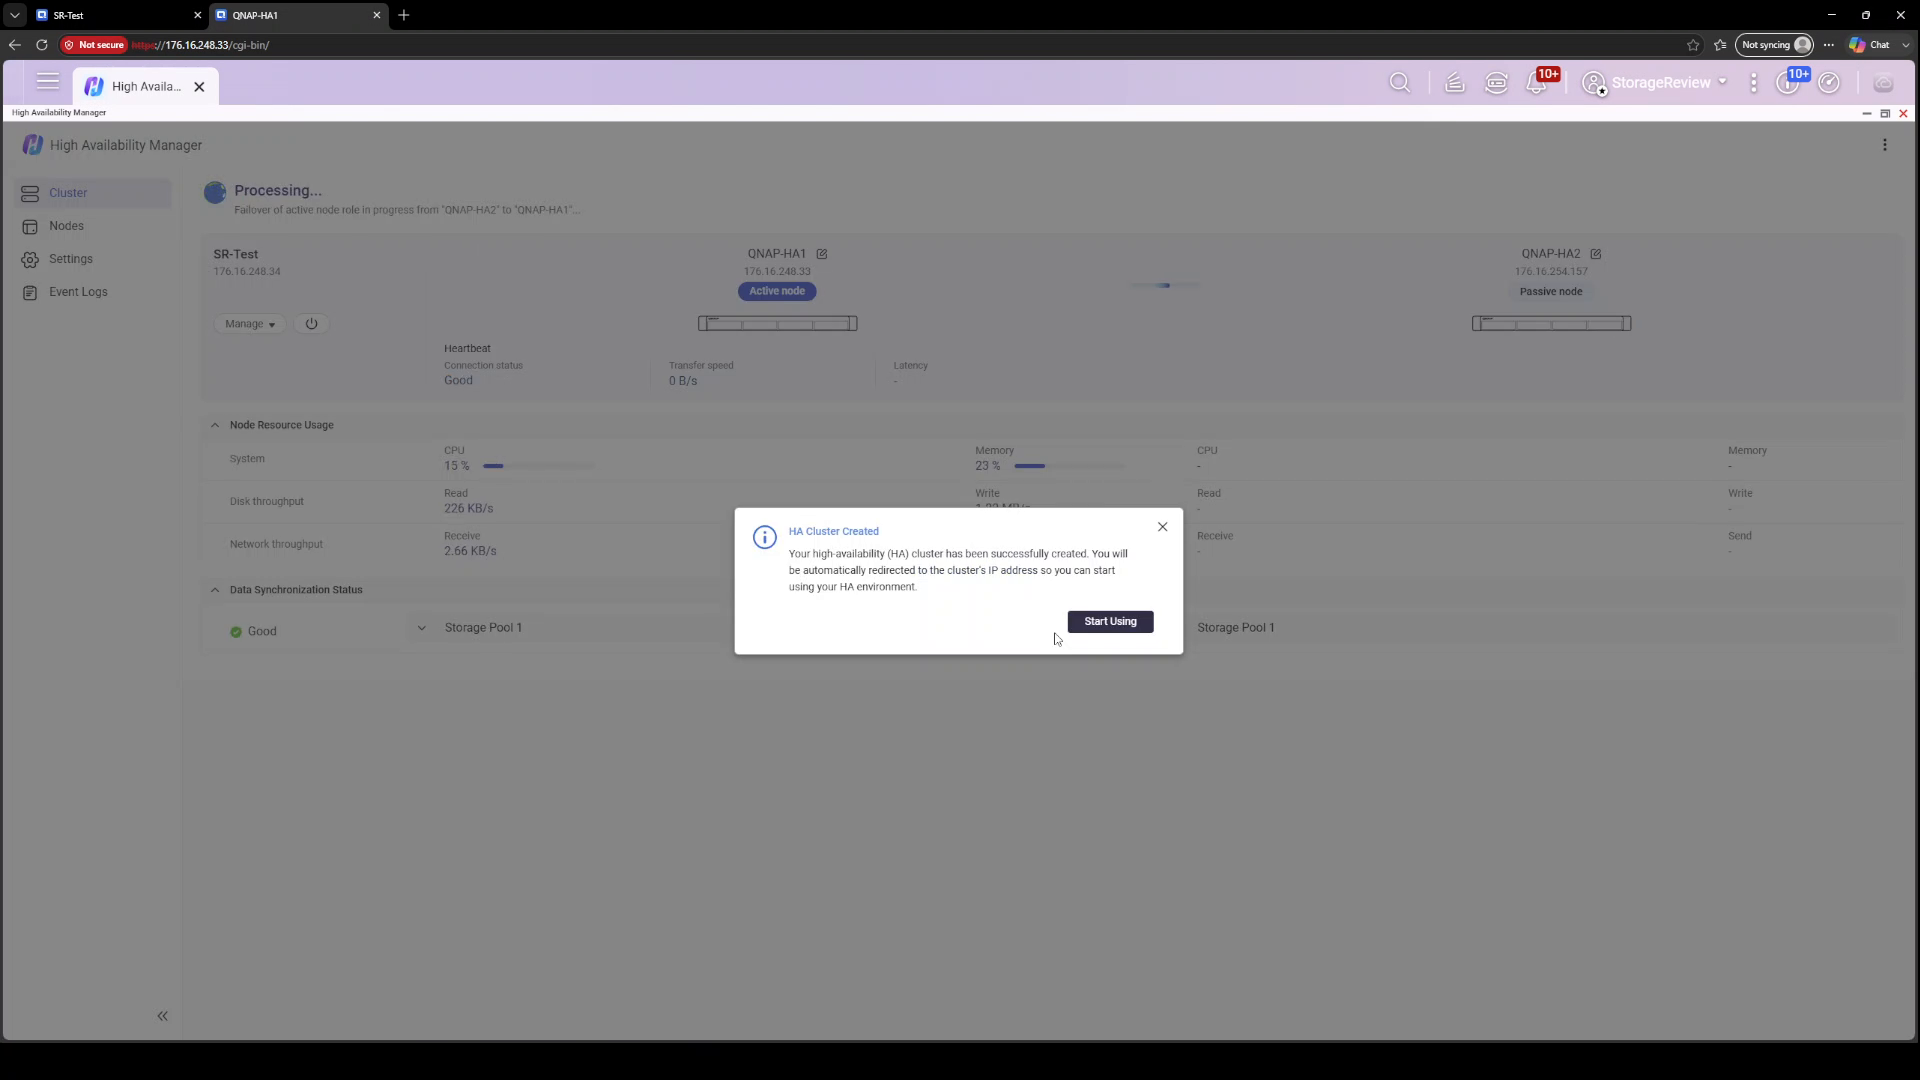
设置确认后,向导会执行五步构建过程:设置心跳连接、设置环境、停止服务、配置系统设置以及启动服务。用户界面会强调,在此期间请勿关闭任何设备。在我们的系统中,构建过程本身大约耗时五分半钟,之后 HA Manager 会报告集群已创建,并将我们重定向到集群 IP 地址。从开始到结束,将两台独立的 NAS 设备迁移到服务集群,向导运行时间不到十分钟。
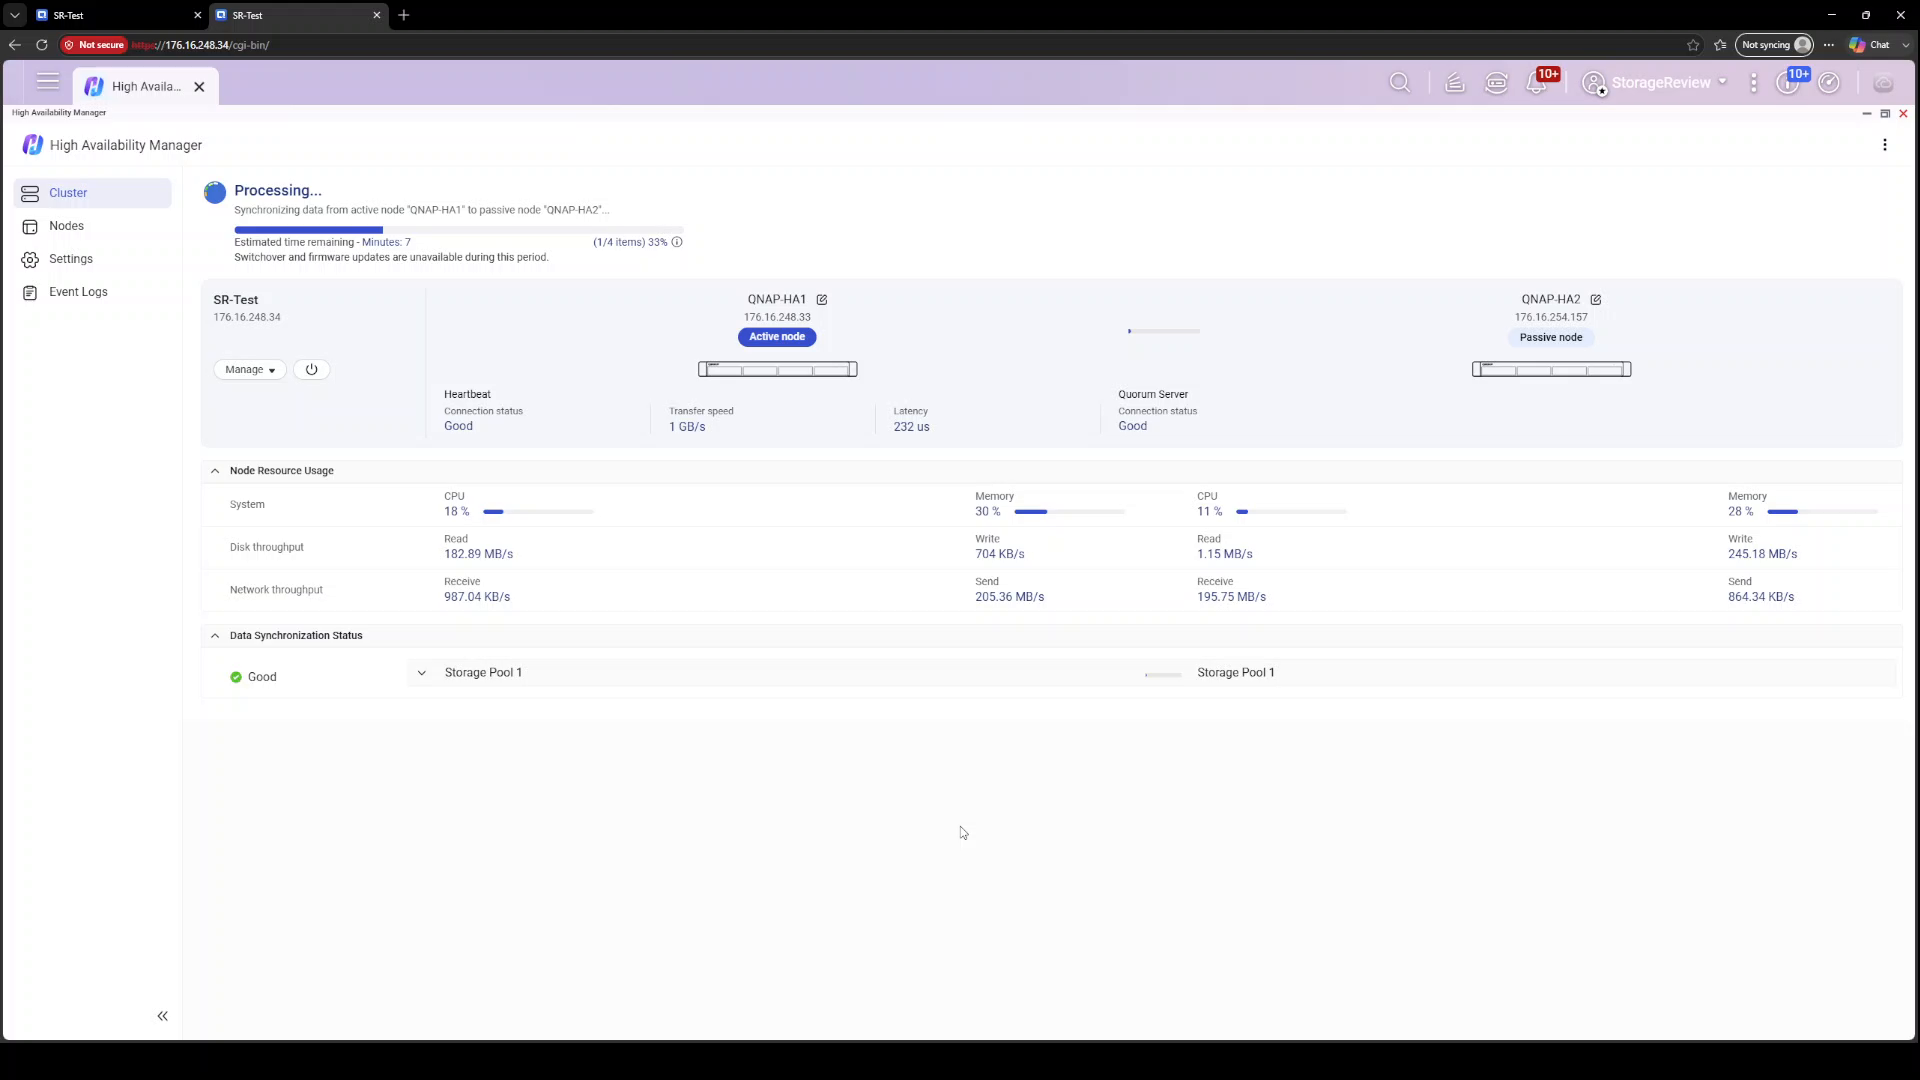
最繁重的任务是初始同步,在此过程中,活动节点会将其存储池逐块复制到被动节点。HA Manager 在仪表盘顶部清晰地显示了进度条、项目计数和预计时间,并发出警告,提示在同步完成之前,切换和固件更新将不可用。在此阶段观察心跳统计数据是整个过程中最令人印象深刻的部分之一:传输速度从大约 900 MB/s 到 1.2 GB/s 不等,延迟在几百微秒,其中一个典型读数是 1 GB/s 时延迟仅为 232 微秒。我们的初始同步大约用了十分钟完成,与仪表盘最初预估的九分钟完全吻合。
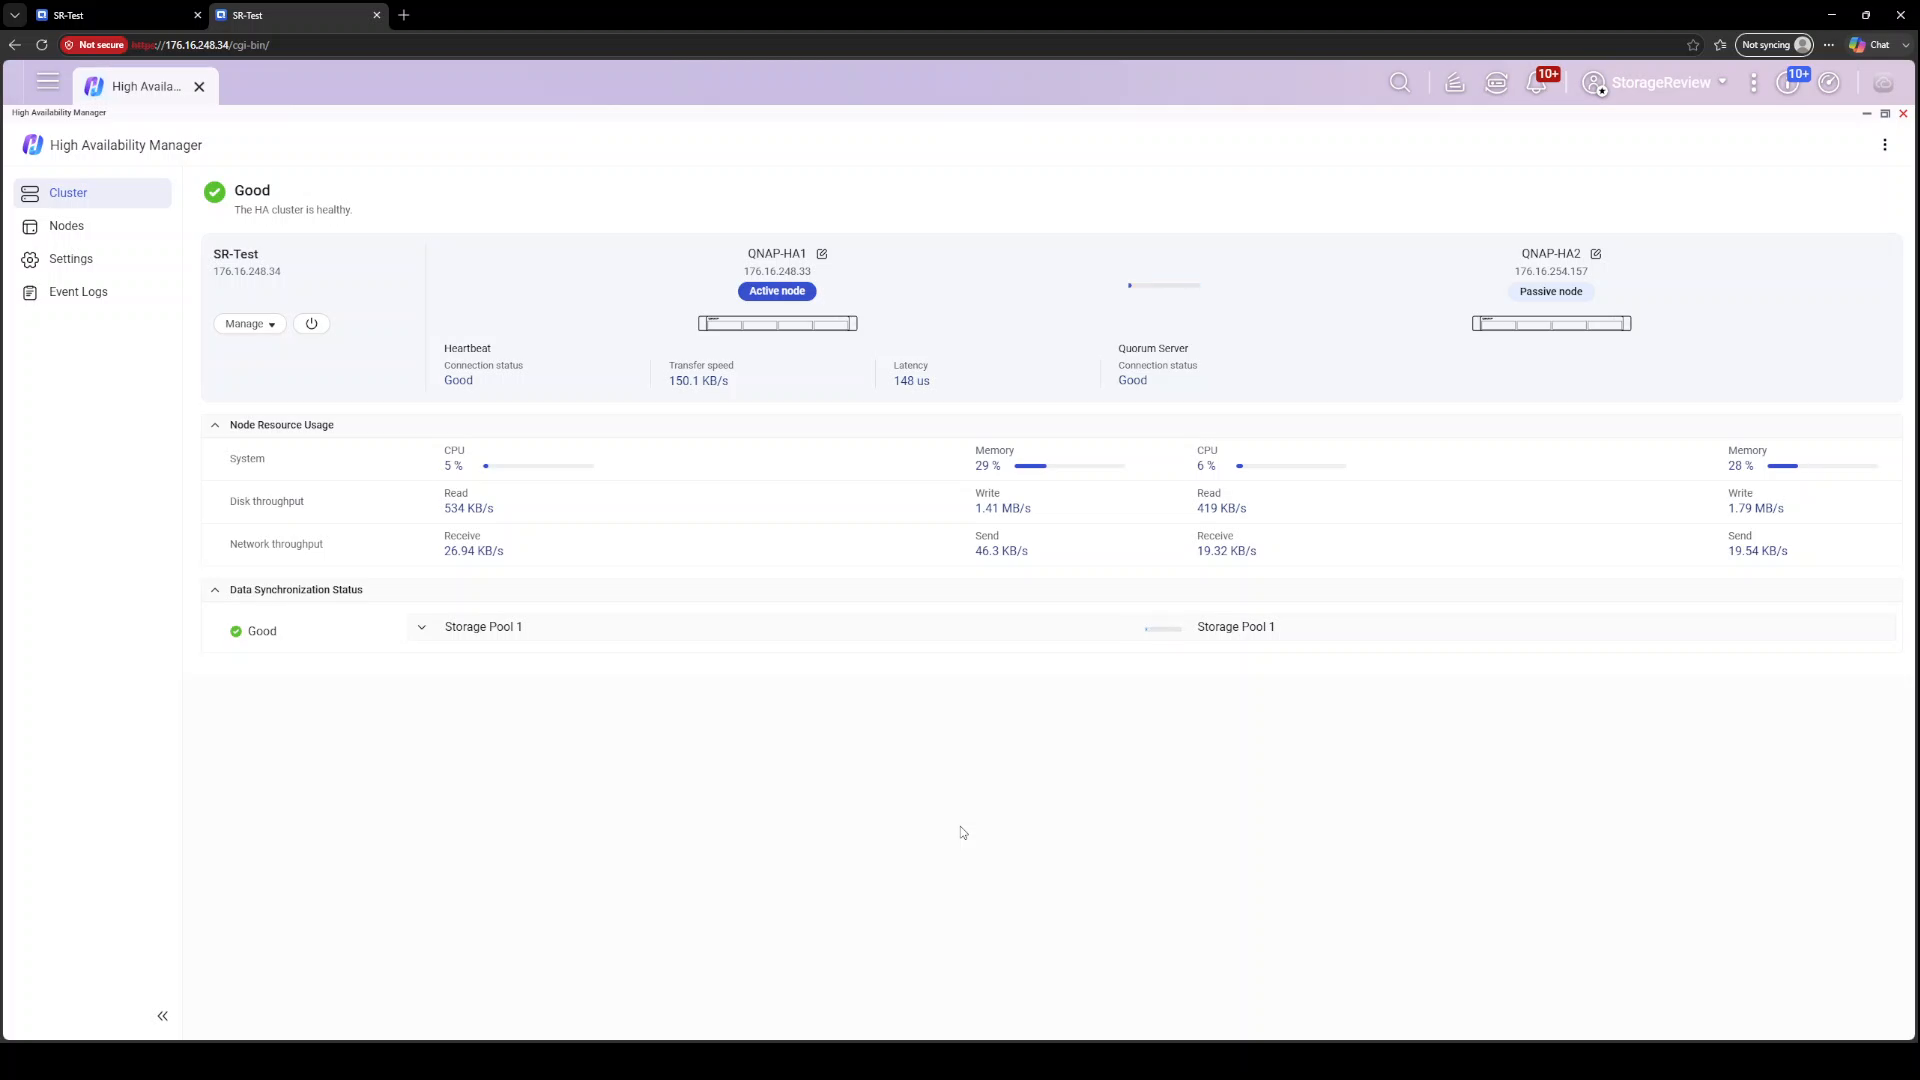
同步完成后,仪表盘状态变为“良好”:集群运行正常,心跳已连接,两个节点均可见,并并排显示实时 CPU、内存、磁盘吞吐量和网络统计信息,下方还显示每个存储池的同步状态。这是一个简洁明了、信息丰富的视图,解答了管理员真正关心的两个问题:集群是否运行正常?我的数据是否已同步?
故障转移测试 1:活动节点断电
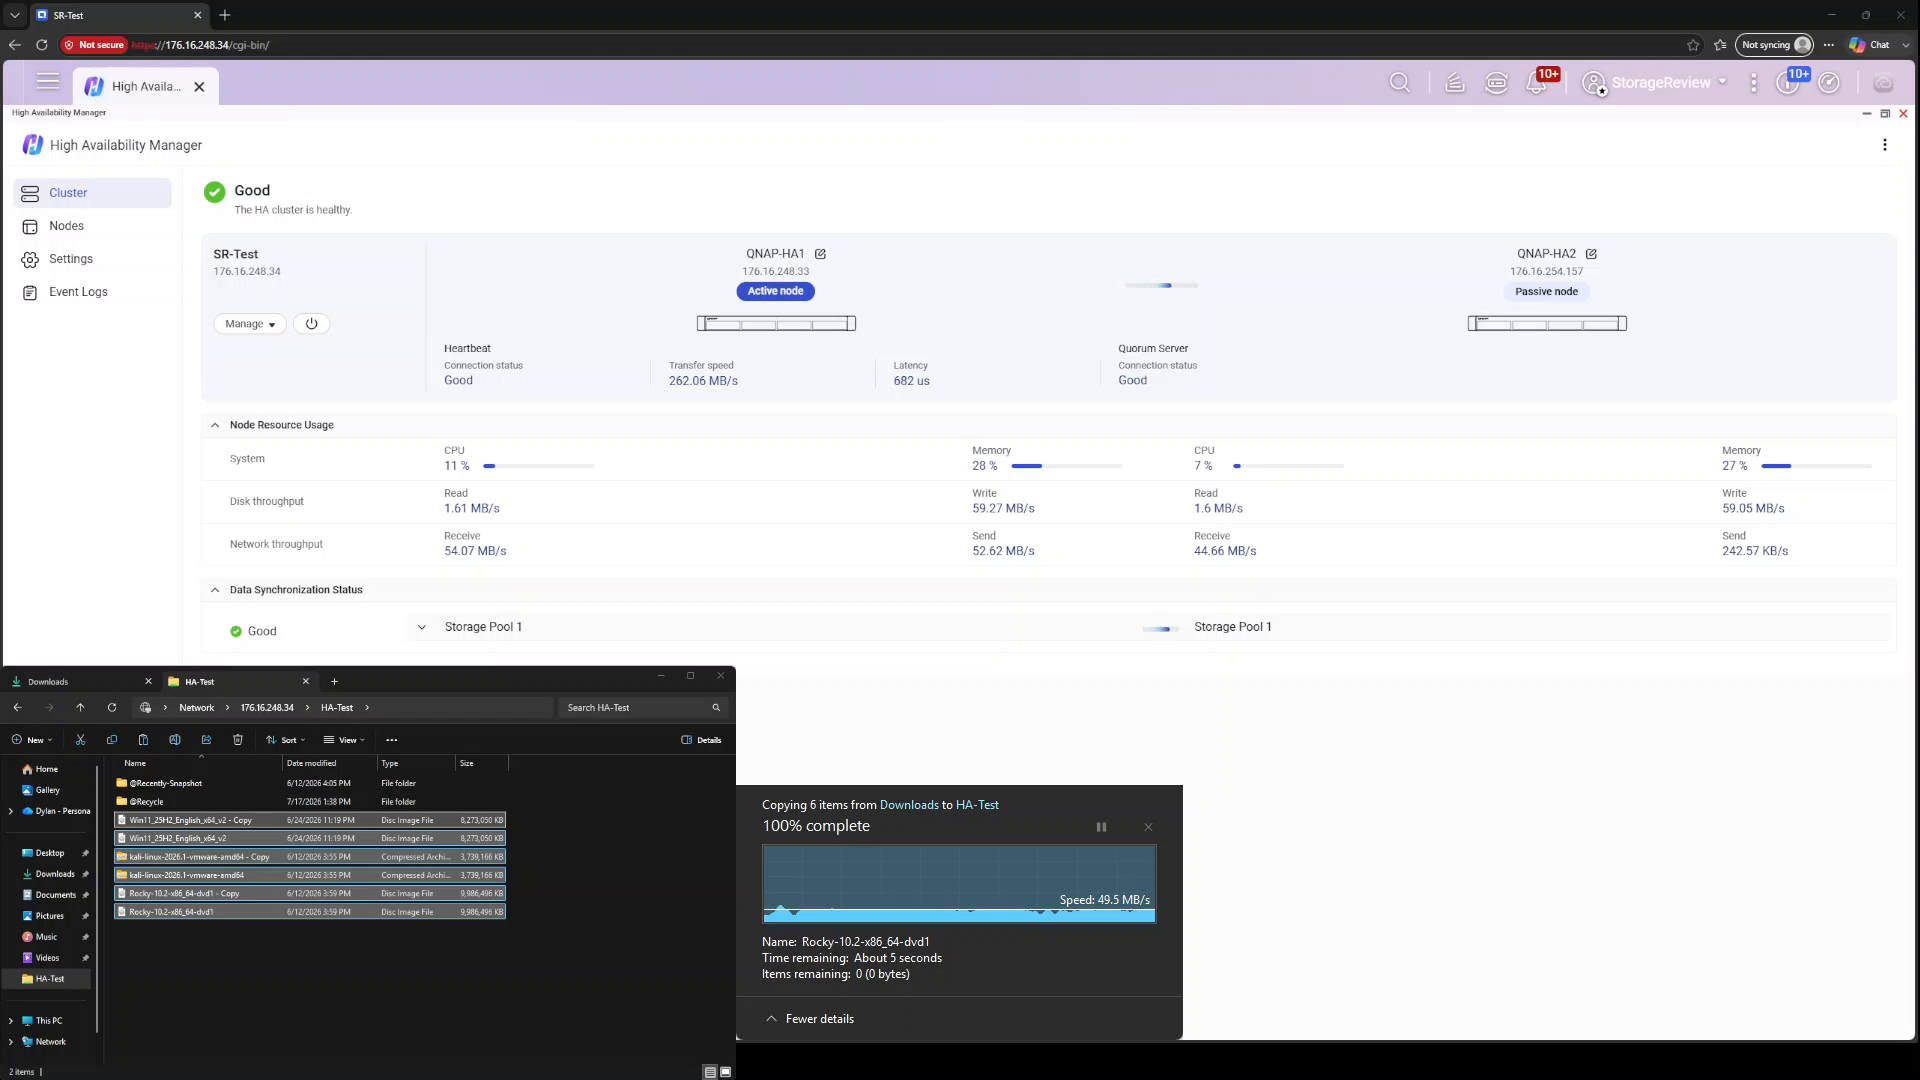
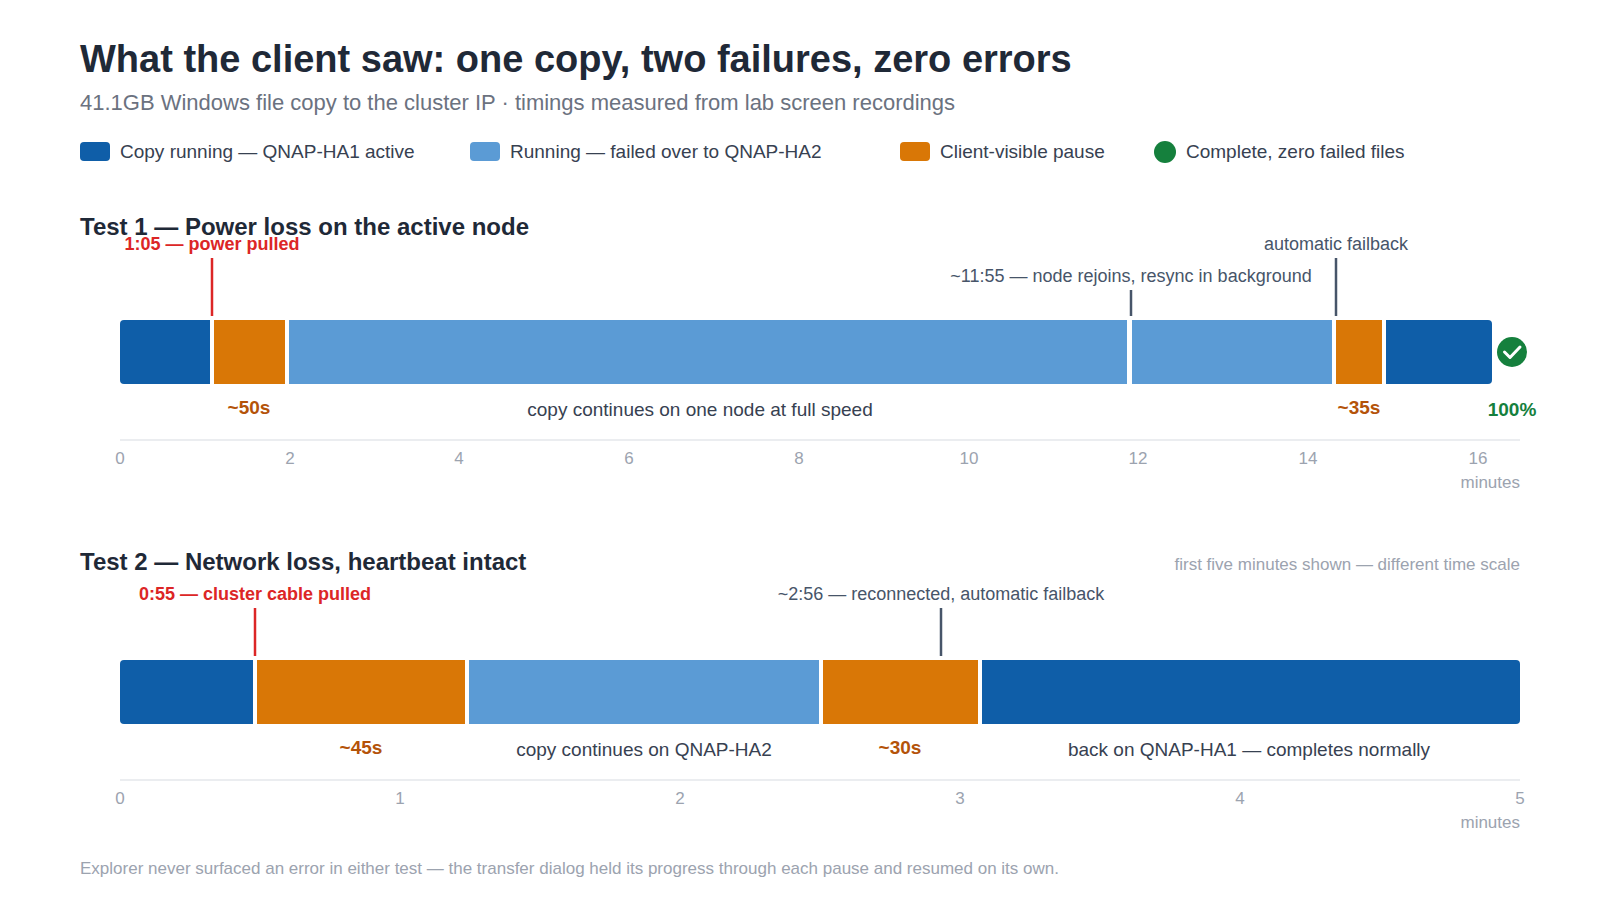
我们遇到的第一个故障场景是直接的:活动节点完全断电。我们启动了一个 Windows 文件复制流程,将客户端上的文件复制到集群 IP 地址上的 SMB 共享文件夹,共 41.1GB,包含六个文件,其中包括 Windows 11 和 Rocky Linux 的 ISO 镜像以及两个 Kali Linux 虚拟机归档文件。复制过程中,我们突然断开了 QNAP-HA1 的电源。
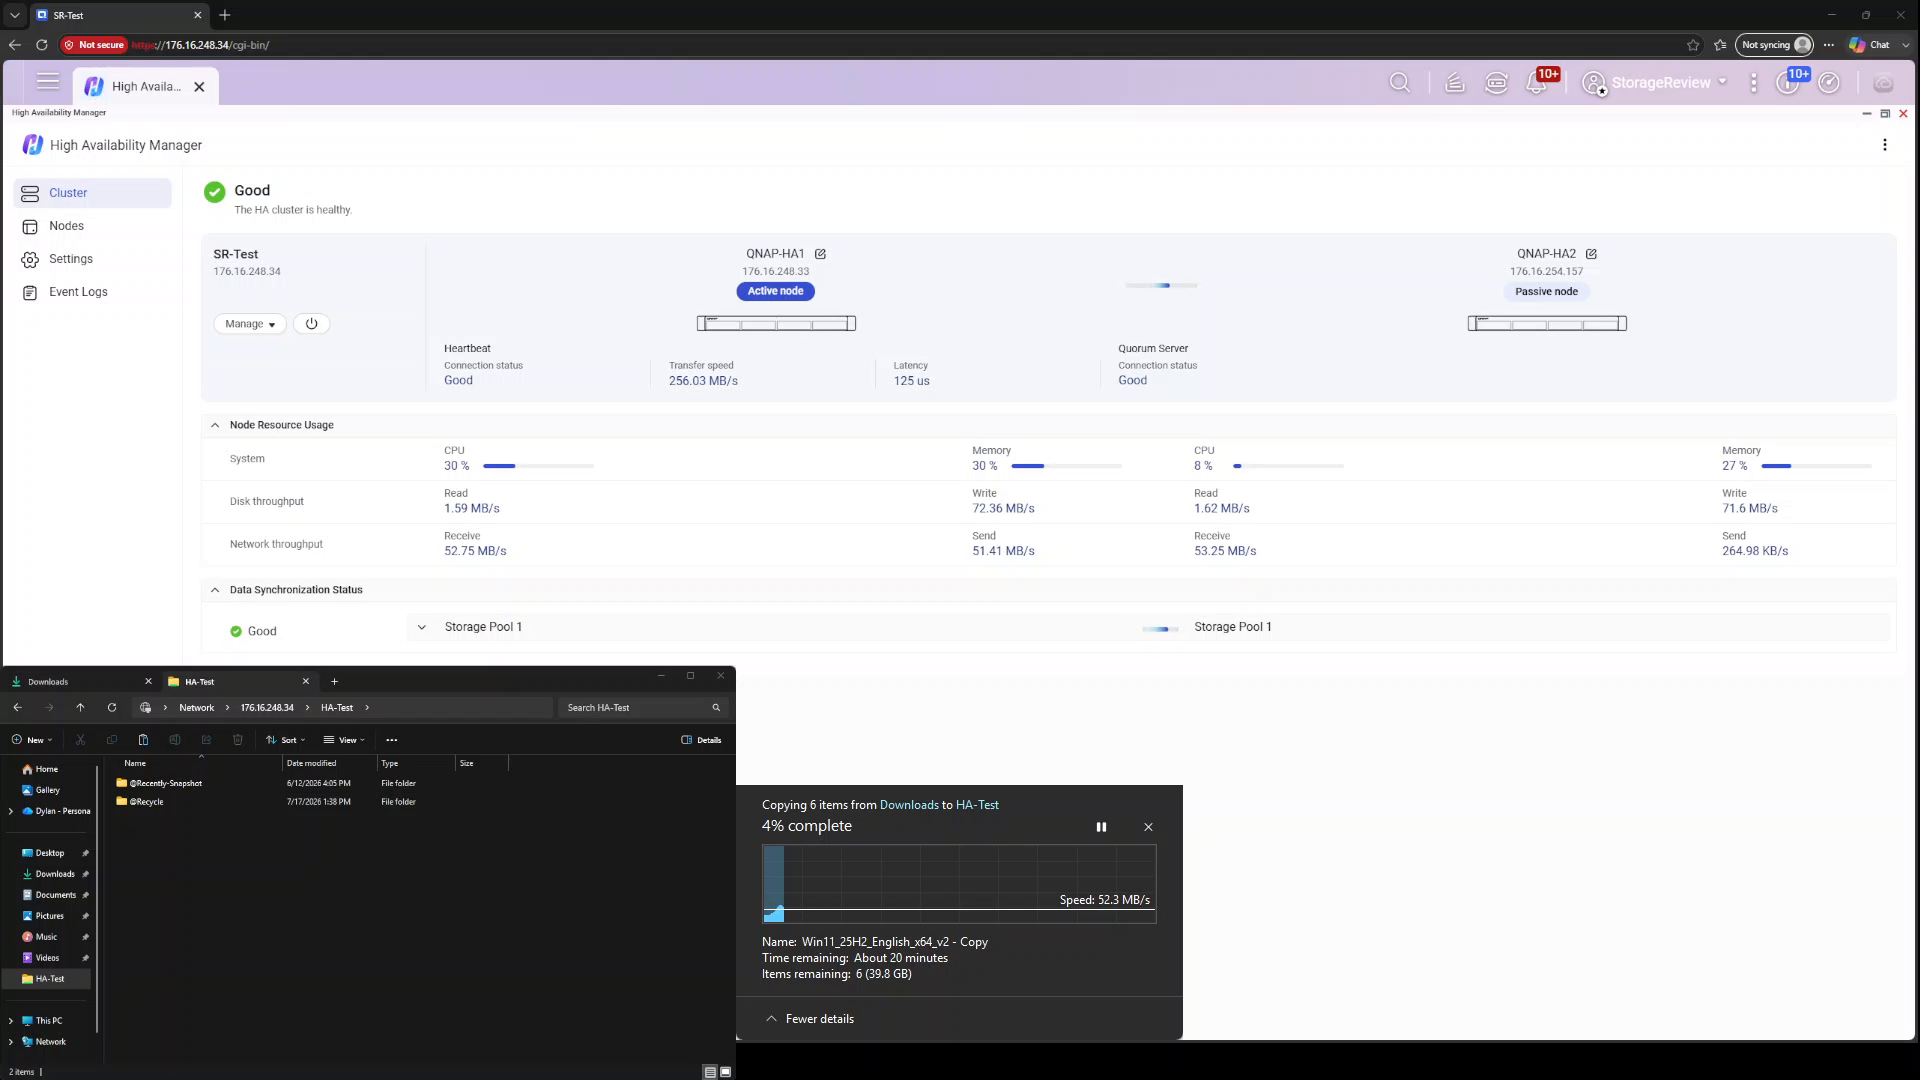
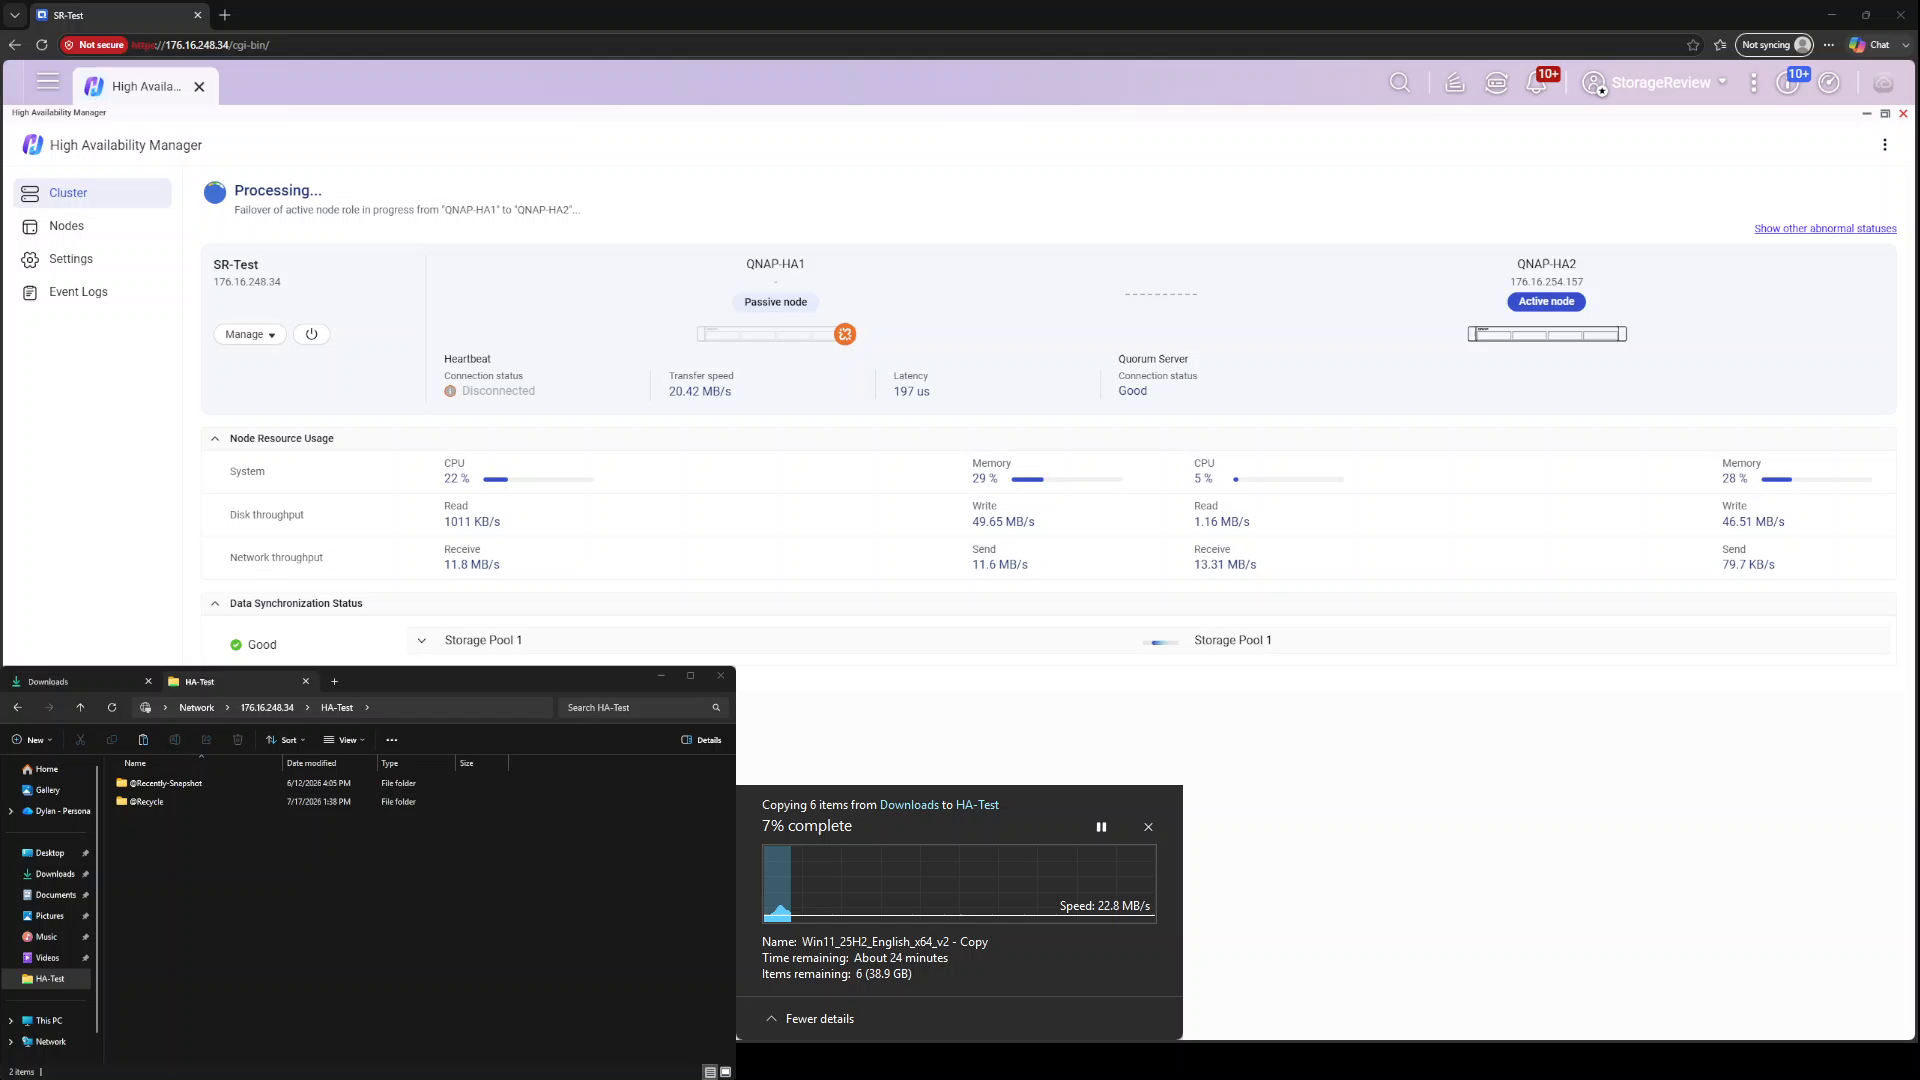
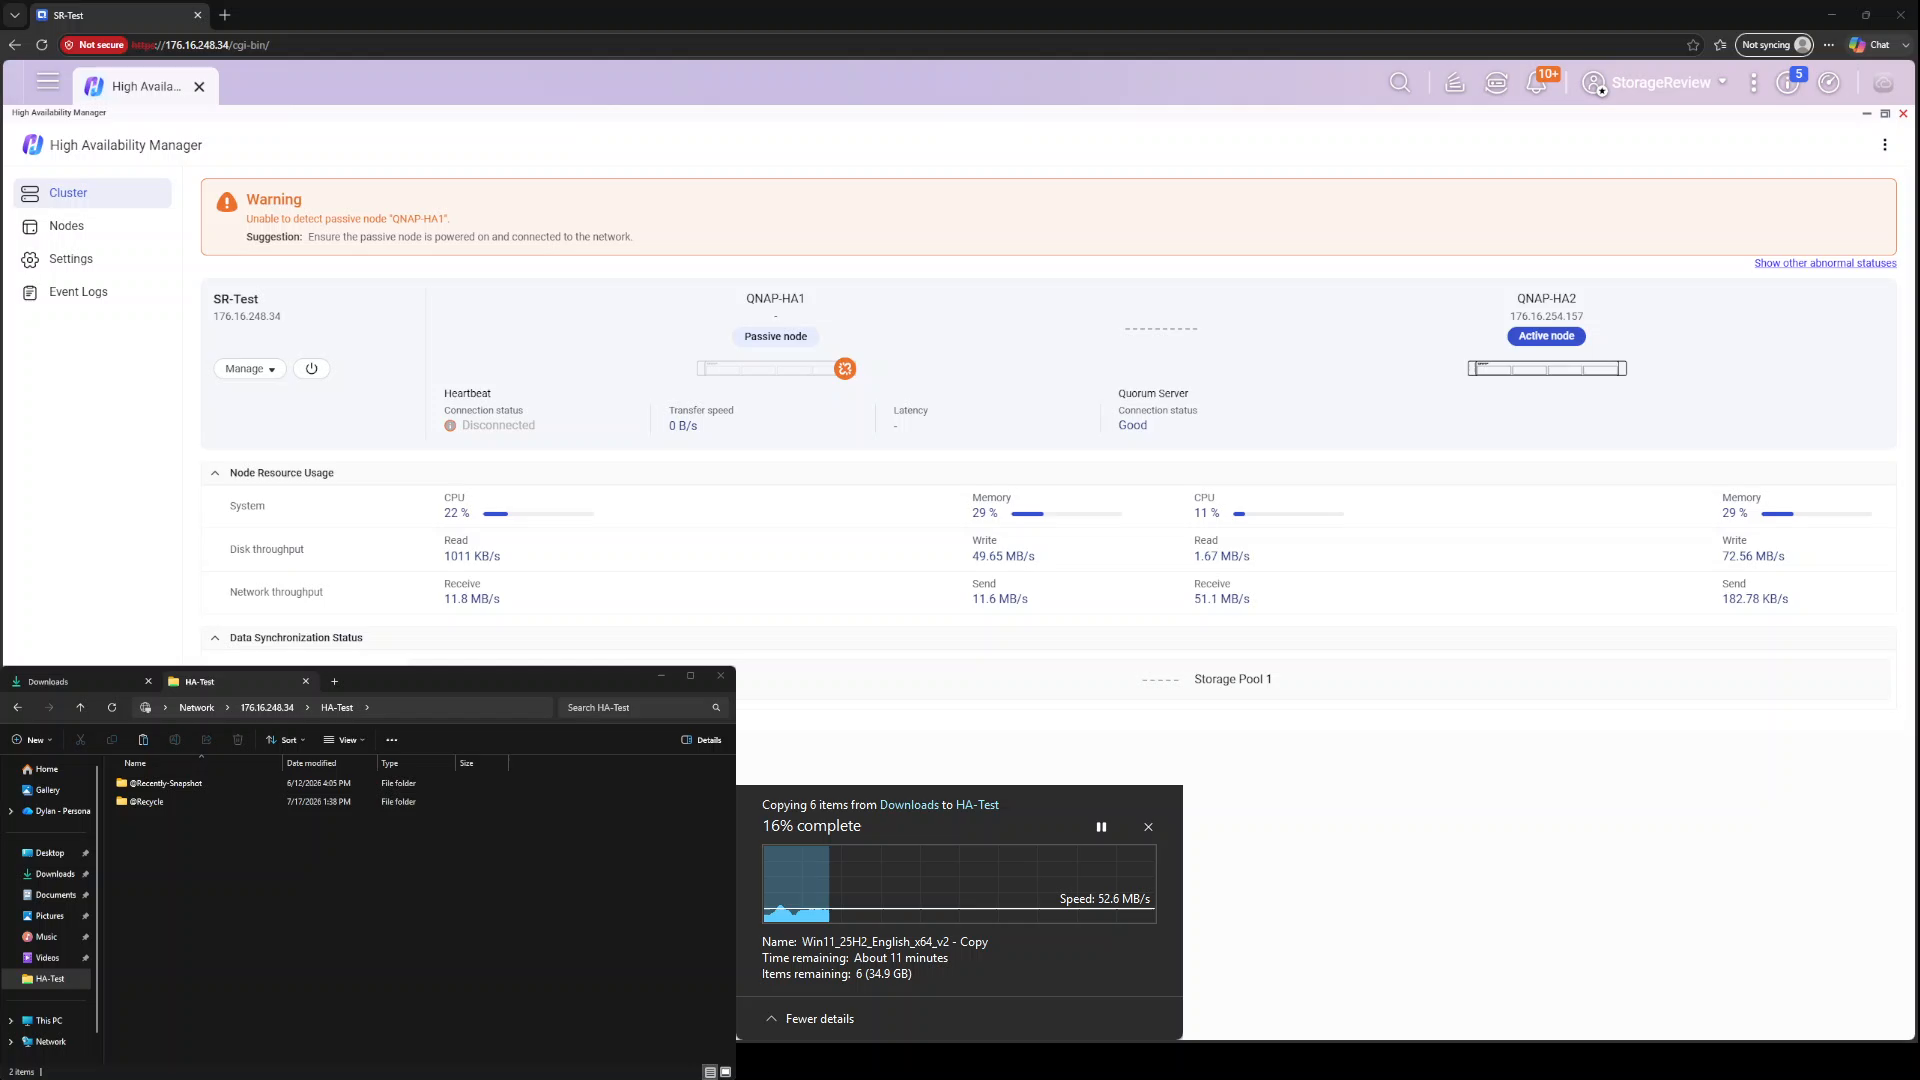
从客户端的角度来看,从断电到数据恢复传输,复制过程暂停了不到一分钟(大约 50 秒),而 Explorer 始终没有显示任何错误;传输对话框保持进度,然后在 QNAP-HA2 升级为活动节点后恢复运行。HA Manager 短暂地报告了活动节点角色的故障转移正在进行中,然后弹出一个警告横幅:无法检测到被动节点 QNAP-HA1,并建议确保该节点已开机并连接到网络。在集群仅运行一个节点的情况下,传输继续以全速通过相同的集群 IP 进行,这正是 HA 所承诺的“降级但仍可运行”的状态。
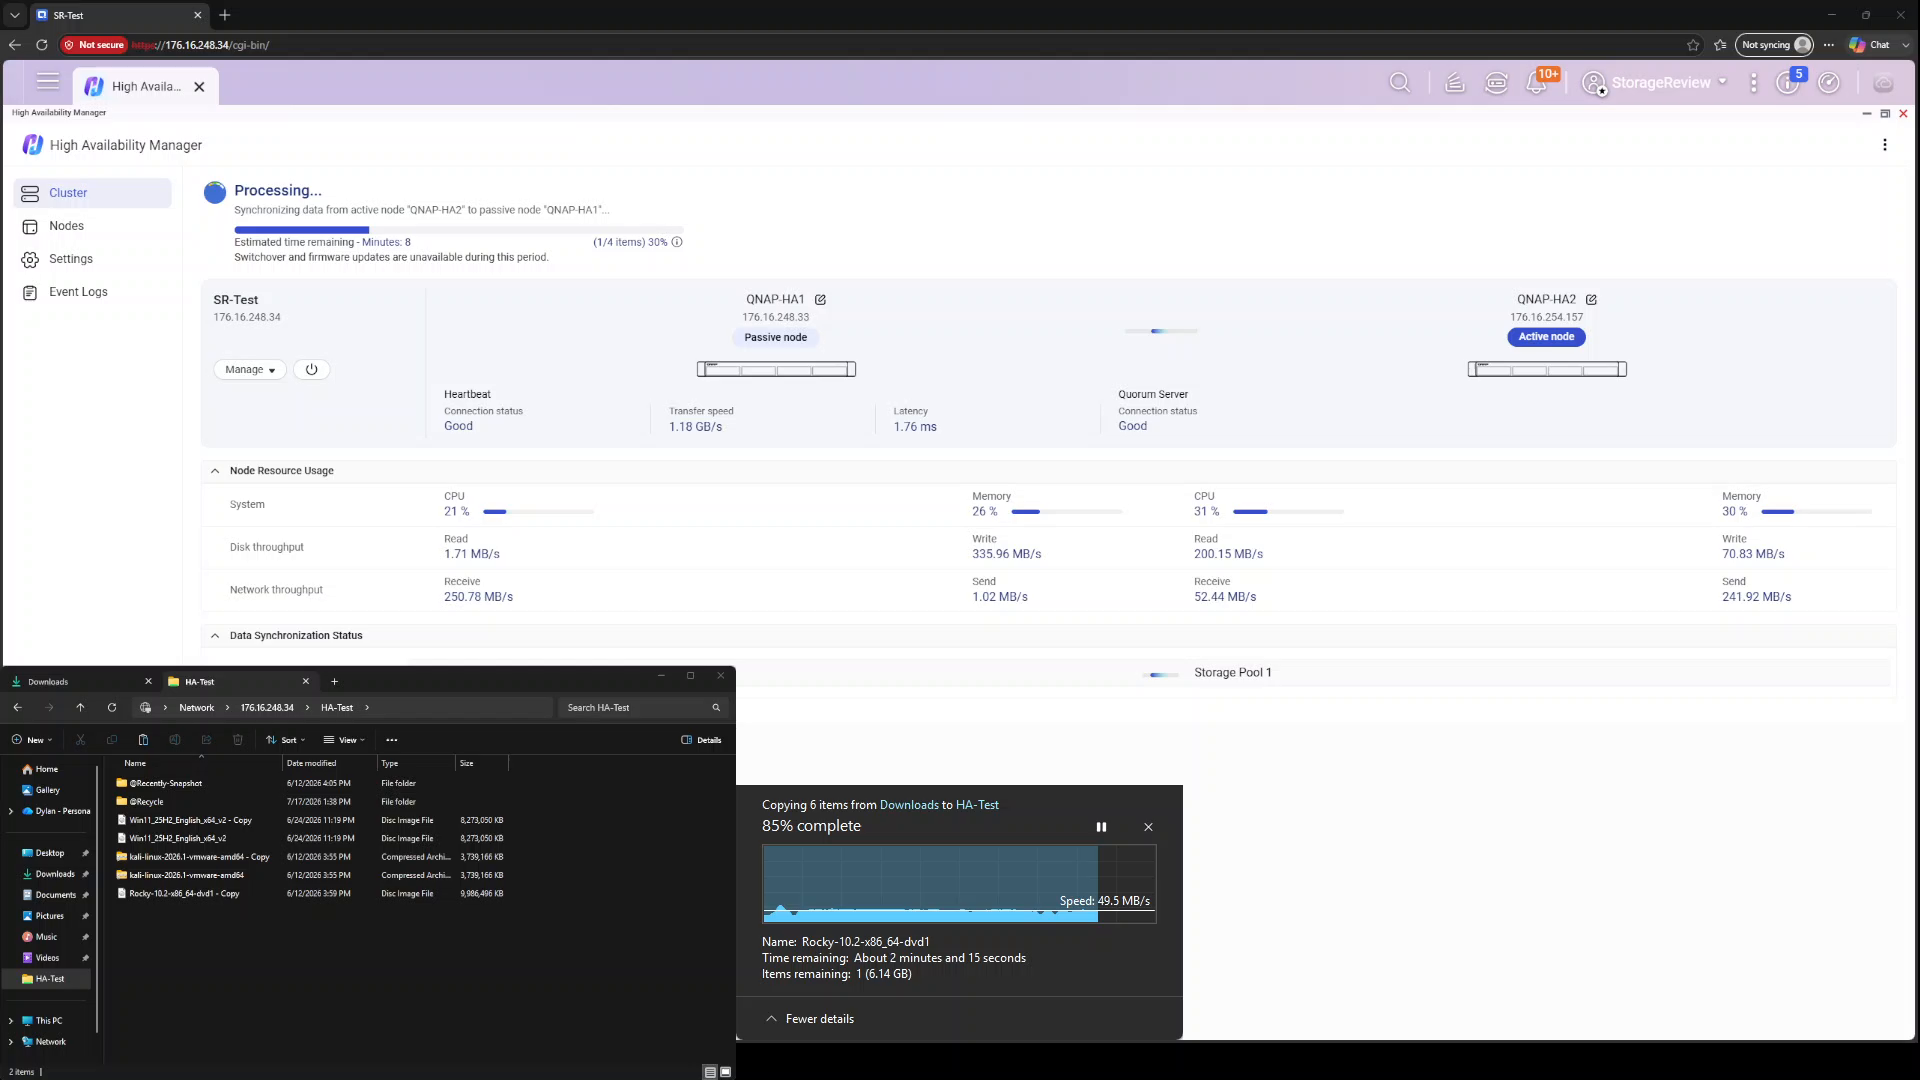
QNAP-HA1 恢复供电后,自动触发了反向过程。该节点在断电约十分钟后启动并以被动成员身份重新加入集群,HA Manager 开始将数据从活动节点 QNAP-HA2 同步回 QNAP-HA1,进度和预计时间同样显示在仪表盘上,而我们的文件复制工作则继续进行,未受任何干扰。故障恢复过程无需人工干预:重新同步完成后,集群暂停传输约 35 秒,将活动角色切换回 QNAP-HA1,然后让复制工作运行至完成。运行结束时,集群状态恢复正常,传输进度达到 100%,成功经历了硬断电、单节点运行、节点恢复和故障恢复等一系列操作,所有操作均在单次复制任务中完成。
故障转移测试 2:网络丢失但心跳信号保持完整
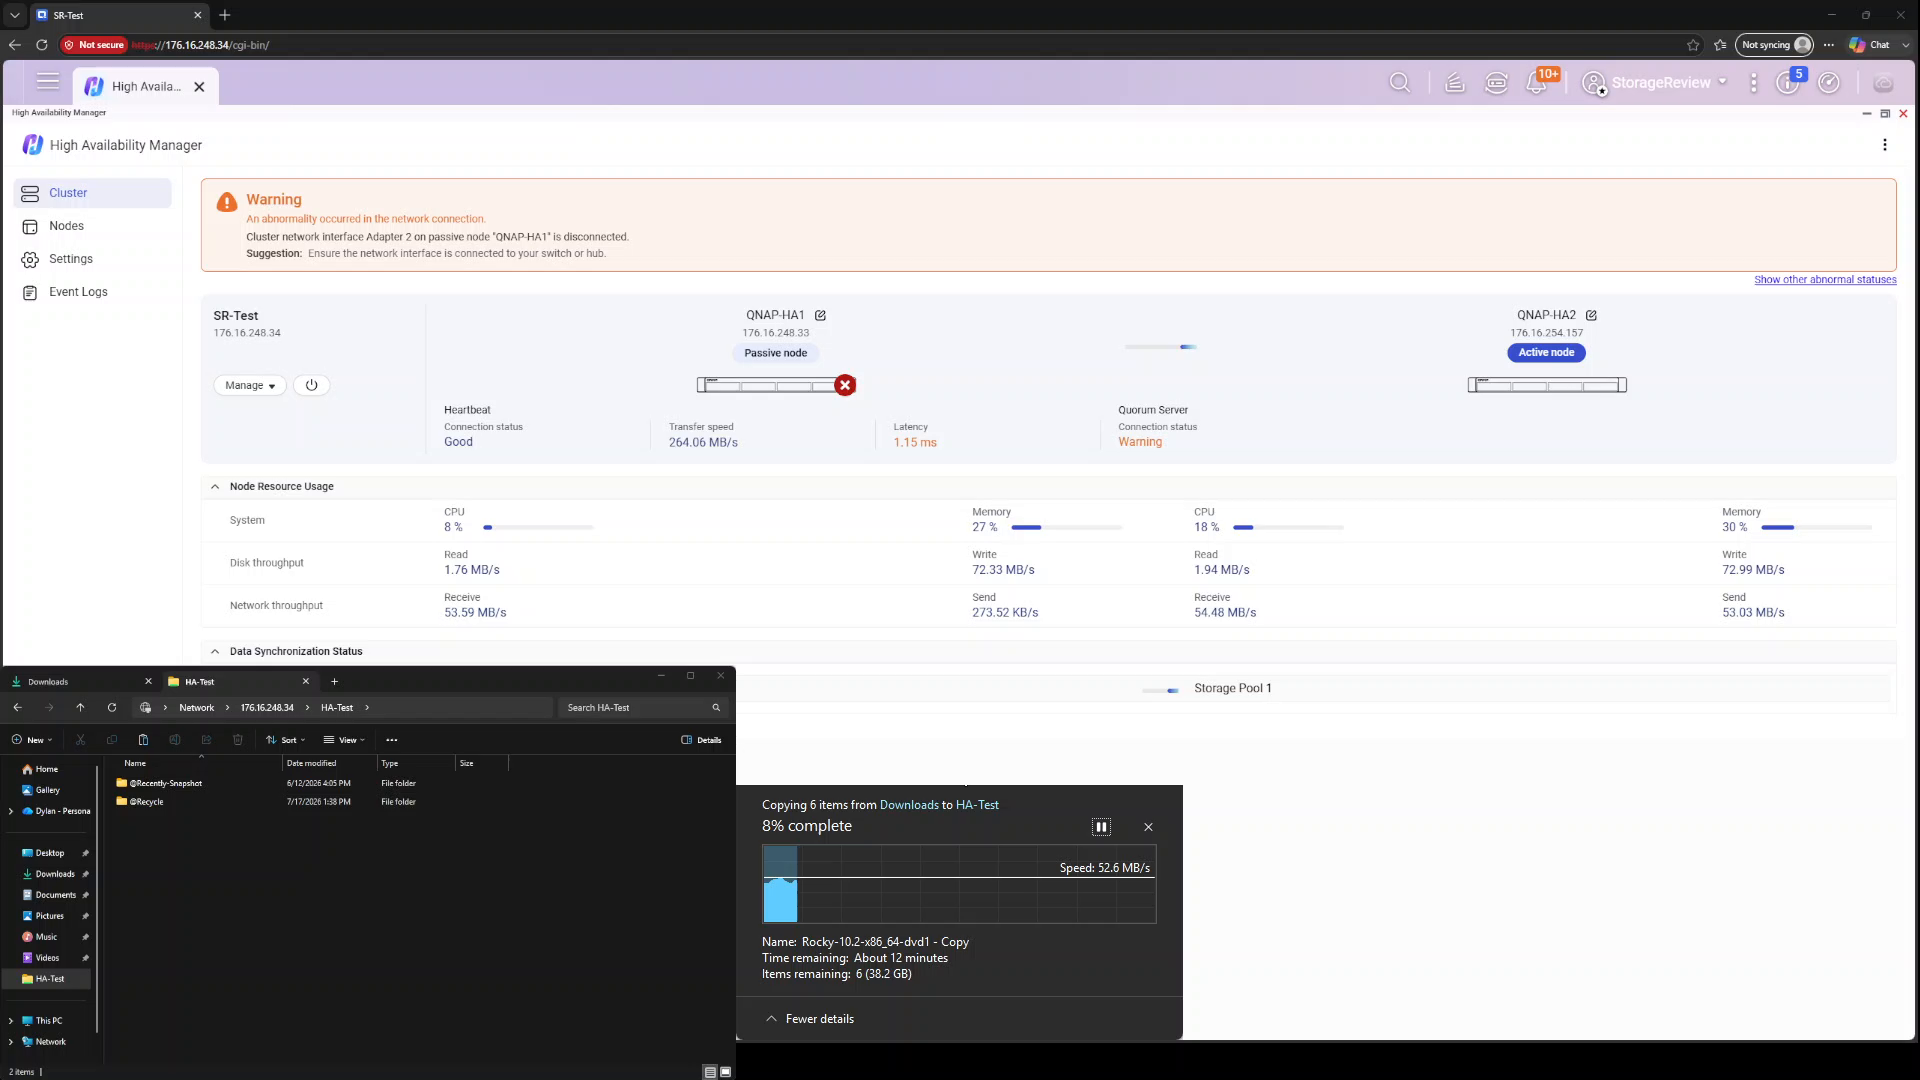
第二种情况更为微妙,也更常见于实际环境中:活动节点失去了面向客户端的网络连接(例如交换机端口故障、网线脱落或收发器损坏),但节点本身仍在运行,心跳链路也保持畅通。在这种情况下,脑裂保护至关重要,因为两个节点都处于活动状态且可以相互通信,集群必须决定哪个节点应该拥有集群 IP 地址。
我们对集群 IP 重复了相同的 Windows 文件复制操作,并断开了活动节点上的集群网络接口。传输暂停了约 45 秒,期间集群将服务迁移到另一个节点,然后恢复传输且未出现故障。HA 管理器准确地标记了故障,警告节点上的集群网络接口适配器 2 已断开连接,并建议检查交换机连接。此外,它还进一步指出,断开连接的节点无法再通过该接口访问仲裁服务器。这种明确指出具体接口、节点和后果的方式,比某些 HA 实现所采用的通用降级标志更具诊断性。
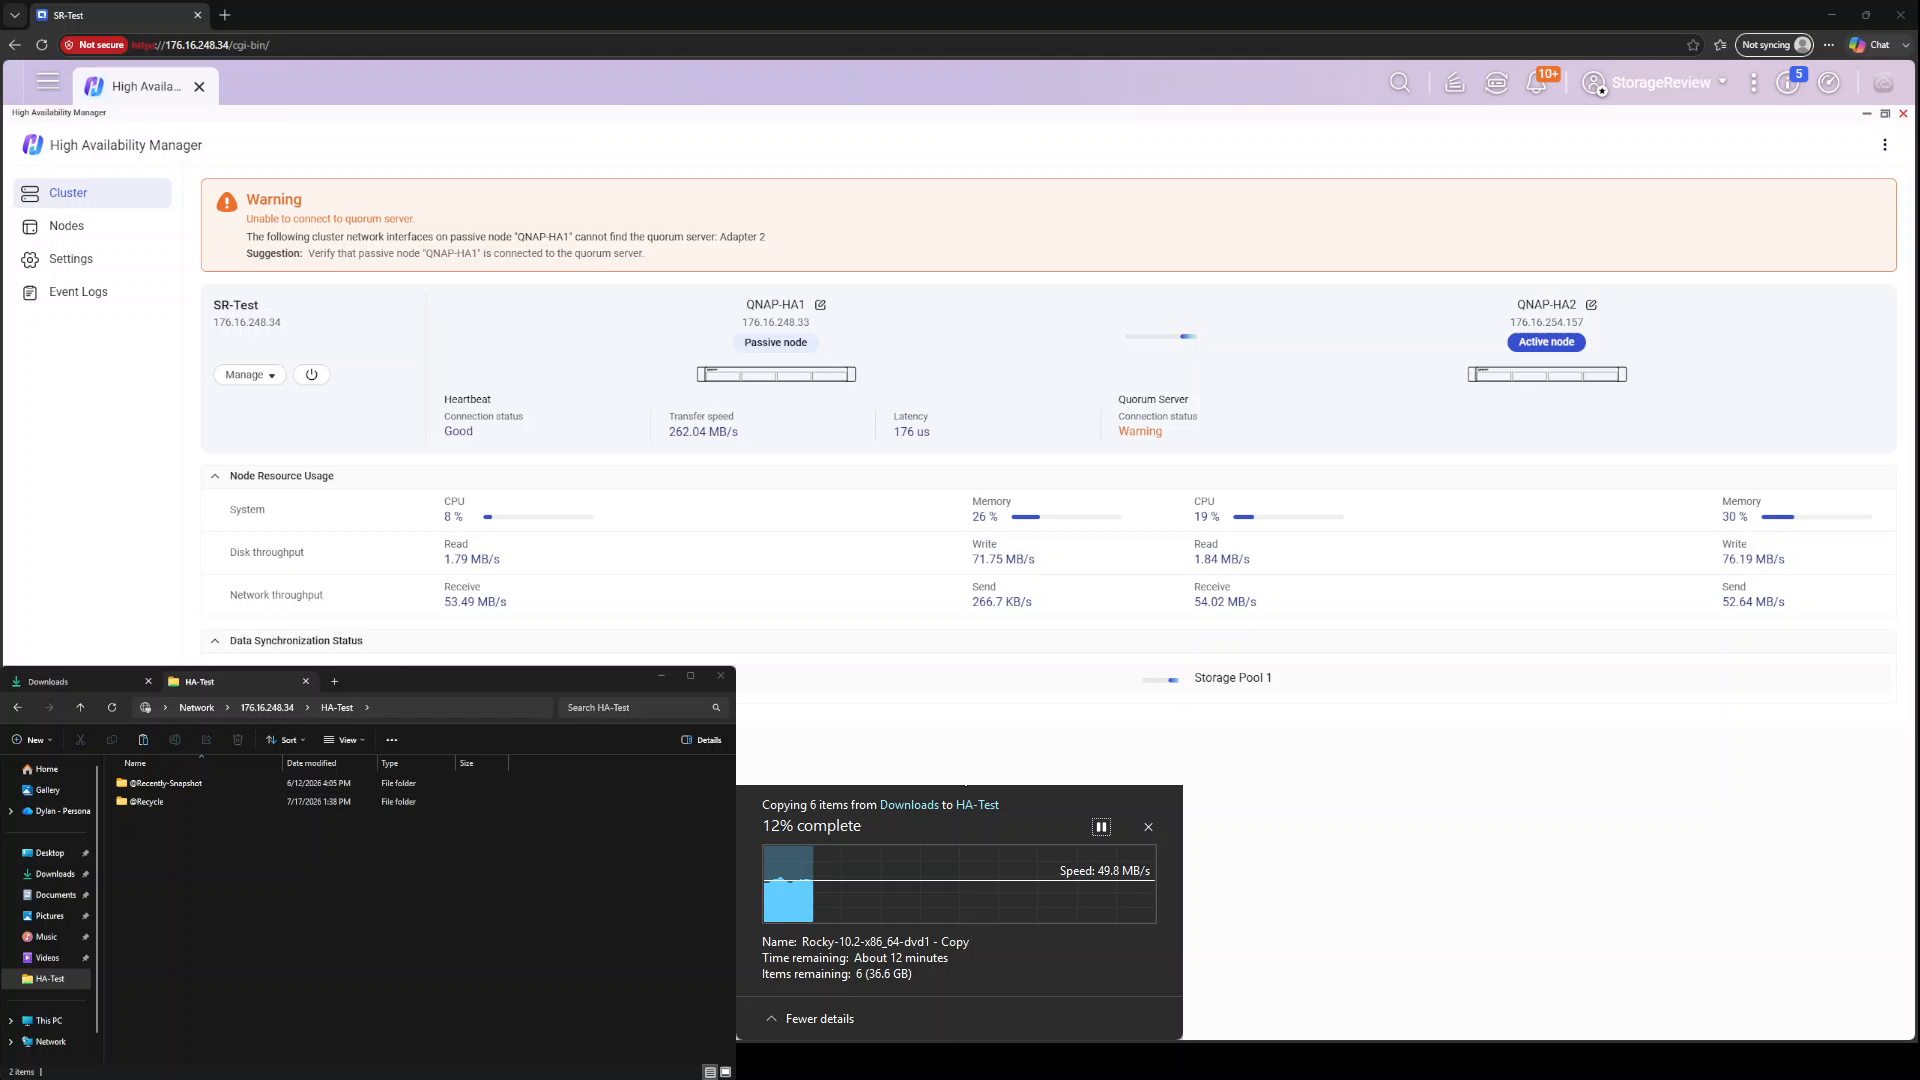
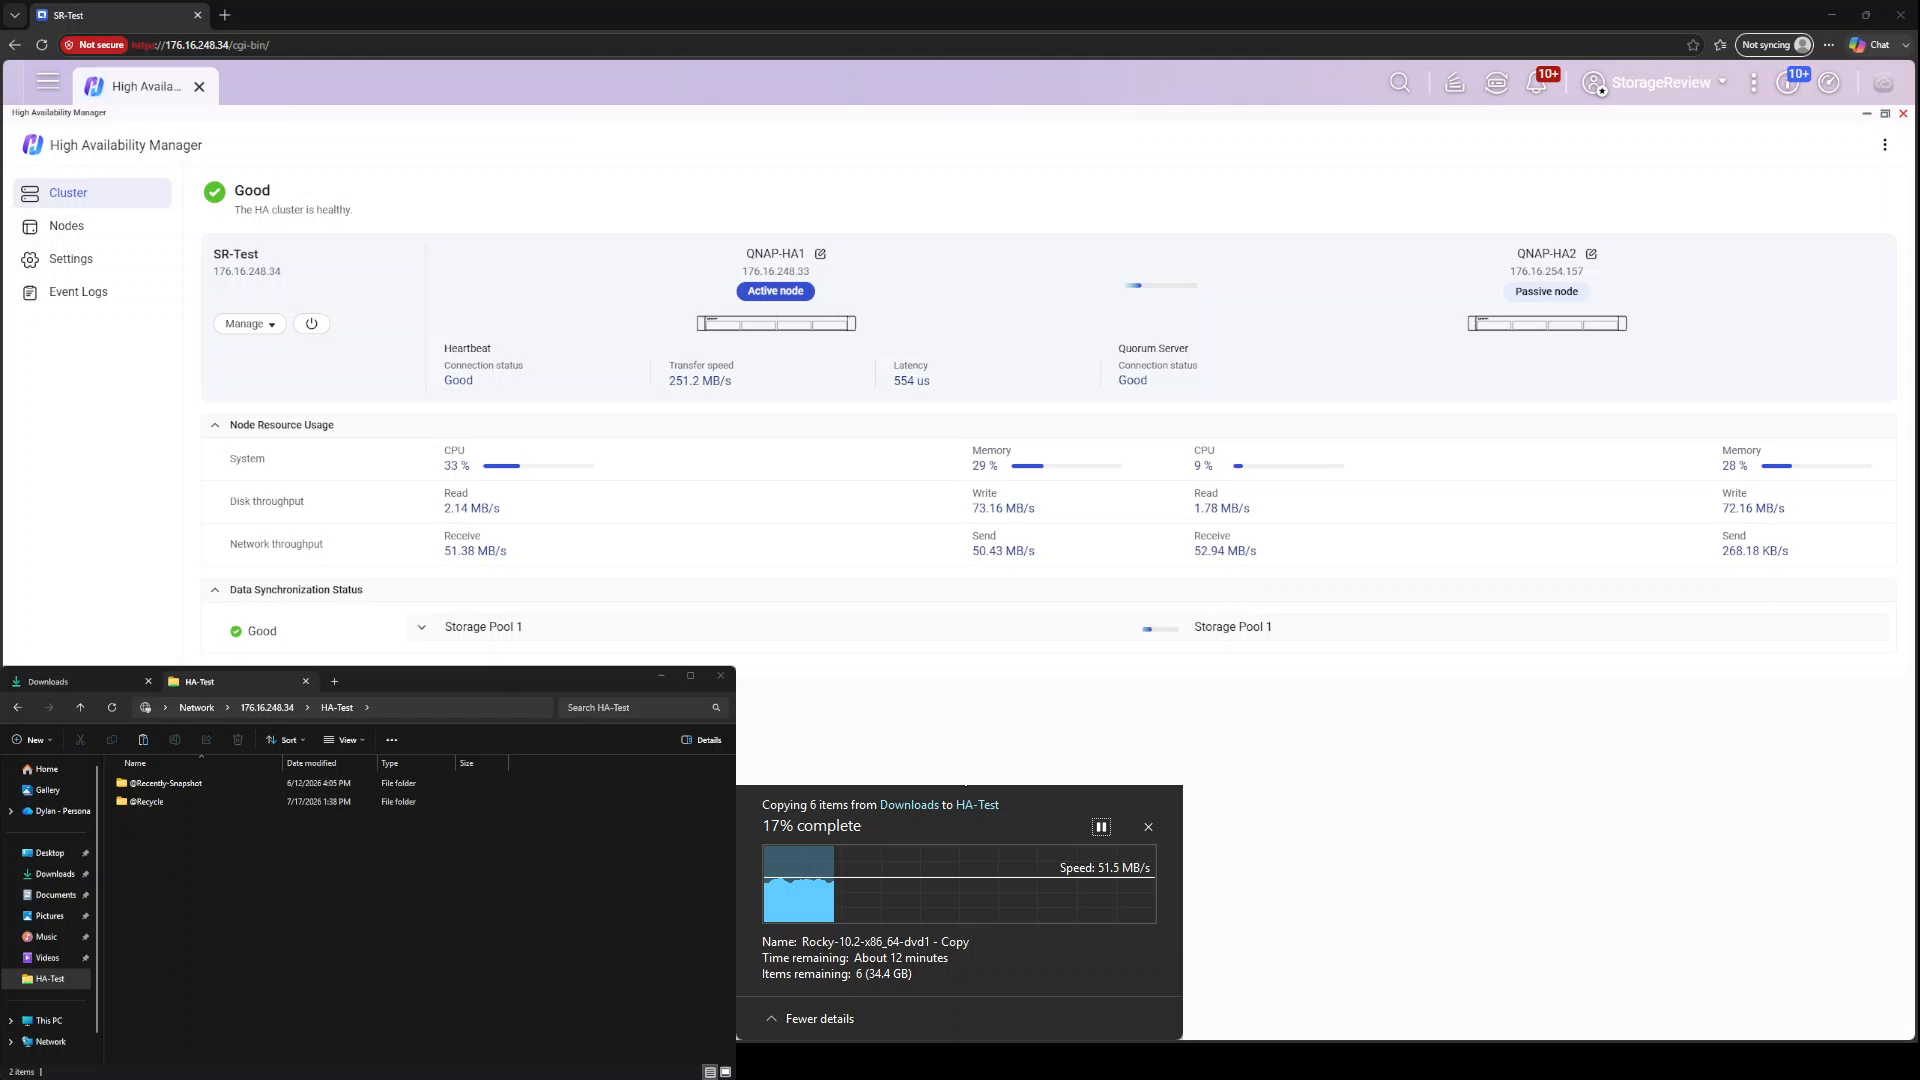
重新连接网络后,节点重新加入集群,故障恢复过程在一分钟内自动完成:在活动角色恢复到 QNAP-HA1 期间,出现了大约 30 秒的第二次暂停,这是客户端唯一能察觉到任何变化的迹象。同一个复制作业连续经历了两次切换,没有出现任何文件丢失的情况。对于任何经历过 SMB 会话因远小于此的原因而中断的人来说,这就是本次演练的主要结果。
正确部署高可用性:脑裂和网络拓扑
像我们这样的故障转移测试证明了集群能够正常工作,但高可用性 (HA) 对在生产环境中的表现不仅取决于 NAS 设备本身,还取决于周围的网络环境。HA Manager 设计用于应对各种场景(例如节点故障、交换机端口失效、上行链路断开),所有这些场景都基于一个共同的假设:两个节点之间至少有一条通信路径在故障后仍然有效。确保这一假设的有效性是 HA 部署中最关键的决策,因为一旦出现问题,就会发生所有高可用性架构都力求避免的状况:脑裂。
QNAP 对此场景有文档说明。脑裂是指两个节点彼此失去通信,但仍各自独立运行,各自扮演主动角色。两个节点都认为自己拥有集群,都愿意接受写入操作,这会导致数据不一致或存储损坏,因为它们可能同时尝试控制共享资源。文档中记录的原因正如您所预期的那样:节点间的网络断开、心跳失败以及网络路径不稳定。请注意这些原因的共同点。脑裂并非由单个节点故障触发;而是由两个健康节点之间的所有路径同时失效触发。这是一个拓扑问题,可以通过拓扑结构问题来解决。
部署规则按预期生效:
将心跳包直接连接到两个节点。QNAP要求心跳包必须通过直连线缆传输,原因就在于此。由于路径中没有交换机、收发器或共享基础设施,唯一可能导致心跳包中断的只有节点本身,而这正是事件故障转移机制的设计初衷。在同机架部署中,这些短深度的 TS-h765eU 设备很可能并排安装,因此无需采取其他措施。
如果节点是分离的,请确保心跳和客户端流量走物理上独立的路径。如果直接连接不切实际,则应将心跳路由到与集群连接不同的交换机上。一旦两个连接都经过同一交换机,该交换机就会成为单点故障,能够同时切断节点间的所有路径,从而将普通的交换机故障演变成潜在的脑裂事件。如果共享的基础设施中的某个组件能够将两个 NAS 设备彼此隔离,那么购买两个 NAS 设备的意义就荡然无存了。这就是我们网络故障转移测试方法背后的逻辑:在保持心跳连接的情况下断开面向客户端的连接,可以模拟在正确分离的拓扑结构中实际发生的交换机或线缆故障,而心跳连接则能够确保故障顺利转移。
启用仲裁服务器。QNAP的第三道安全保障是网络上的见证节点,可在“高可用性管理器”>“设置”>“故障转移策略”>“仲裁服务器”中进行配置。如果节点失去直接连接但仍能访问网络,仲裁服务器会继续监控所有节点并转发它们的状态,从而为每个节点提供一个独立的仲裁机制,使其在提升自身地位之前进行判定。仲裁服务器的连接状态会与心跳信号一起持续显示在高可用性管理器控制面板上,因此可以一目了然地了解其运行状况。
如果最糟糕的情况仍然发生,QuTS hero 会以防御性的方式处理脑裂问题。一旦连接恢复,节点可以再次通信,它们会交换状态信息,识别出双方都曾担任活动角色,并主动停止大部分服务(包括 SMB 和 iSCSI),以避免合并两个不同的数据集。然后,HA Manager 会显示一个“从脑裂中恢复”向导,其中包含两条路径。第一种路径会保留您选择的单个节点上的数据;另一个节点将被擦除,重置为被动成员,然后重新同步。如果您知道哪一侧拥有正确的数据,这是最快的路径。第二种路径会保留两个节点上的数据,方法是在一个节点上恢复服务,同时将另一个节点完全从集群中移除,这样您就可以在手动重新加入集群之前验证和协调数据。这是一个合理的恢复模型,但恢复仍然意味着停机和完全重新同步。脑裂是一种可以通过部署设计来预防的情况,而不是需要计划如何从中恢复的情况。上述三条规则只需要一根网线和五分钟的设置面板操作即可。
监控和管理
第二天的运维工作在 HA Manager 应用中进行,该应用将集群状态、每个节点的资源使用情况、事件日志和节点管理(包括手动切换)整合到一个统一的界面中。在我们的测试中,仪表盘的警告横幅足够具体,能够准确指出故障的接口和节点,而不是泛泛的降级标志,从而起到诊断作用。
QNAP 还将高可用性 (HA) 感知功能集成到了硬件本身。在 HA 集群中,每台 NAS 上的 LCD 面板都可以显示集群名称、节点当前角色和集群 IP 地址,状态 LED 指示灯则能一目了然地指示 HA 状态:绿色常亮表示活动节点,绿色闪烁表示被动节点,红色常亮表示 HA 错误。在满是相同型号的短深度 NAS 的机架中,无需打开浏览器即可识别活动节点,这一贴心的小功能会让技术人员倍感欣喜。对于集群部署,AMIZcloud 还提供了对 HA 组的集中式云监控,可以跨站点显示集群运行状况、延迟和警报信息。
总结
高可用性管理器在我们测试的两种故障模式下都兑现了其核心承诺。活动节点断电导致 Windows 文件复制进程停滞约 50 秒,但没有丢失任何文件;客户端网络连接中断导致进程停滞约 45 秒。在这两种情况下,相同的复制作业都能顺利完成节点恢复和自动故障转移,最多只出现不到一分钟的暂停。客户端无需重新配置任何内容。在故障转移之前、期间和之后,应用程序、文件共享和用户工作流程都通过同一个 IP 地址和主机名继续运行。设置过程也非常便捷;两个独立单元在不到十分钟的向导引导下,加上十分钟的初始同步,就组成了一个服务集群。每次出现故障时,控制面板都会准确地告诉我们应该关注哪个接口、节点和连接。
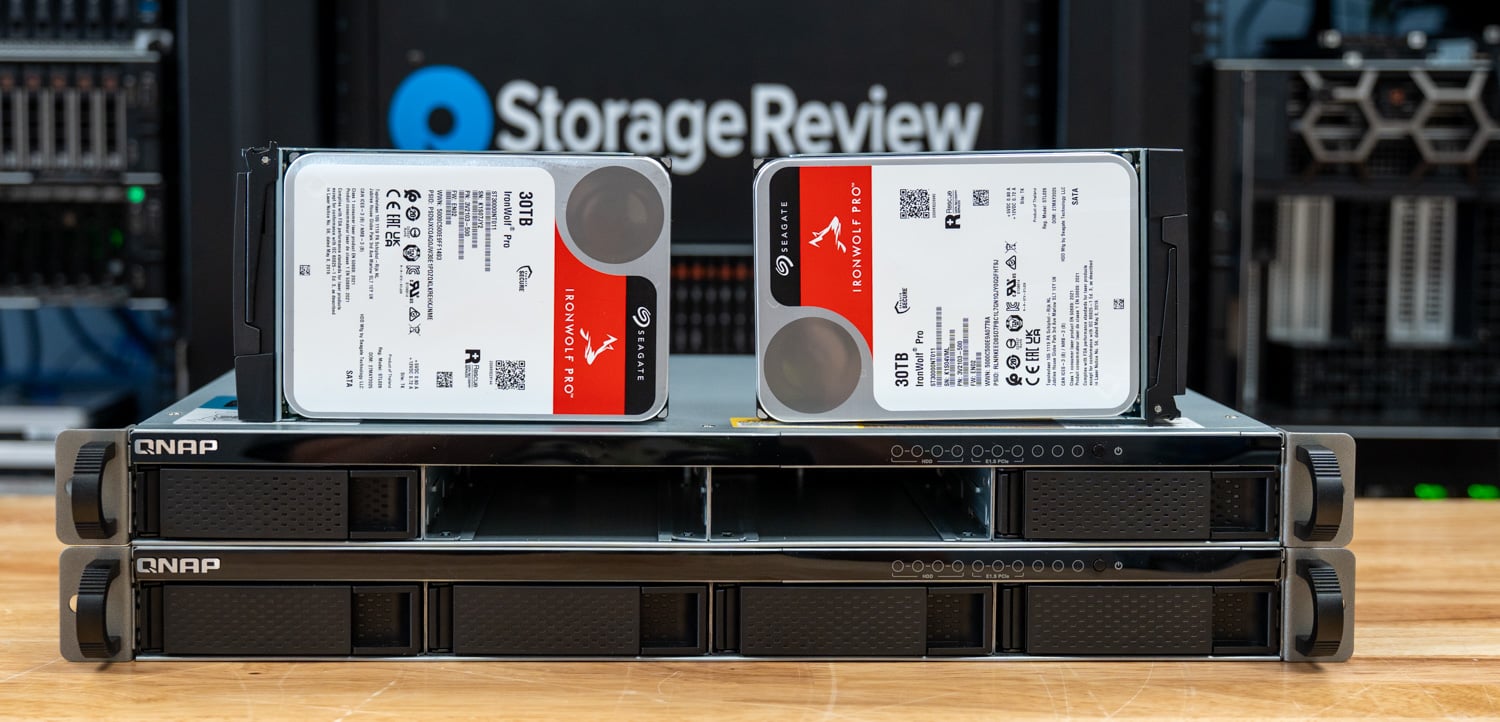
完整的 HA 堆栈:两个 TS-h765eU 单元和填充它们的 IronWolf Pro 硬盘。
不过,高可用性 (HA) 的成本也不容忽视。您需要购买两套设备,而备用节点在需要使用之前一直处于闲置状态。不可变快照(h6.0 的另一项核心保护功能)在目前的 HA 集群中无法使用,因此管理员必须在两者之间做出选择。此外,硬件配置要求必须完全相同,这意味着升级必须成对进行,这可能会限制预算。
最终的解决方案取决于规模是否合适,而HA Manager最适合小型企业和边缘部署。与双控制器企业级阵列相比,两台短深度的TS-h765eU设备在经济效益方面截然不同,同时还能应对控制器丢失这种故障场景,而这正是大多数中小企业购买双控制器阵列的主要原因。与DIY复制方案、快照传输、rsync作业和备份恢复相比,区别在于恢复时间:这些方案虽然可以保护数据,但需要花费数小时重建客户端连接,而HA Manager在我们测试中对客户端而言最严重的故障也只是一分钟的延迟。同样重要的是,它无法承受的故障(所有节点间路径同时中断)可以通过直接连接心跳线、隔离网络路径以及启用仲裁服务器来避免:只需一根网线和五分钟的设置面板配置即可完成拓扑调整。
最后一点是针对双节点设计的:集群最脆弱的时期是数据重新同步,此时只有一个节点保存着数据的唯一有效副本,而其他节点的硬盘则处于高负荷运转状态。因此,在HA集群中,硬盘的选择至关重要。这也是为什么我们搭建的NAS专用硬盘(例如Seagate IronWolf Pro 30TB)在双节点集群中比在独立服务器上更为重要的原因:它们的作用就是确保数据重新同步期间的稳定性。
QNAP TS-h765eU 和 QNAP Hero h6.0 现已上市。欲了解更多信息,请访问QNAP TS-h765eU 产品页面。
本报告由QNAP赞助。本报告中表达的所有观点和意见均基于我们对所讨论产品的客观评价。


 Amazon