

戴爾科技集團推出了 PowerEdge XE8812,這是一款全新的液冷伺服器平台,專為大規模推理和高效能運算工作負載而設計。該系統加入了戴爾人工智慧工廠 (Dell AI Factory) 的 NVIDIA產品組合。它基於 NVIDIA Vera Rubin NVL4 架構構建,在高密度機架級配置中,每個機架最多可容納 144 個 GPU。
截圖
該公告反映出市場對能夠支援日益複雜的人工智慧和模擬工作負載的基礎設施的需求不斷增長。科學研究、工程、自主人工智慧計畫和基因組學等領域的機構都要求系統具備比上一代系統更高的運算密度、記憶體容量和能源效率。
專為人工智慧和高效能運算融合而設計
戴爾 PowerEdge XE8812 是一款無風扇、直接液冷平台,專為運行大規模模擬和資料密集型工作負載的環境而設計。戴爾將此系統定位為適用於分子建模、多物理場模擬和基礎模型開發等應用。
該平台基於NVIDIA Vera Rubin NVL4架構,與基於NVIDIA GB200 NVL4架構的系統相比,顯著提升了主機記憶體容量、CPU核心數量、GPU記憶體以及整體運算資源。戴爾指出,CPU核心數量從144個增加到176個,且每個插槽的記憶體容量和GPU記憶體均比上一代產品提升了50%,足以支援在記憶體中駐留更大規模的AI模型和類比程式。
將資料集和模型駐留在記憶體中可以減少對暫存和交換操作的依賴,這兩種操作都會引入微秒到毫秒的延遲,並大幅降低有效頻寬。這種效能損失在高效能運算 (HPC) 和人工智慧 (AI) 環境中尤其重要,因為資料移動越來越直接地影響著應用程式的整體效能。
該平台還利用 NVIDIA CUDA-X 庫來加速科學運算和 AI 工作負載,使組織能夠運行更大的模擬和模型,而無需將工作負載分配到額外的基礎設施上。
機架級密度和液冷
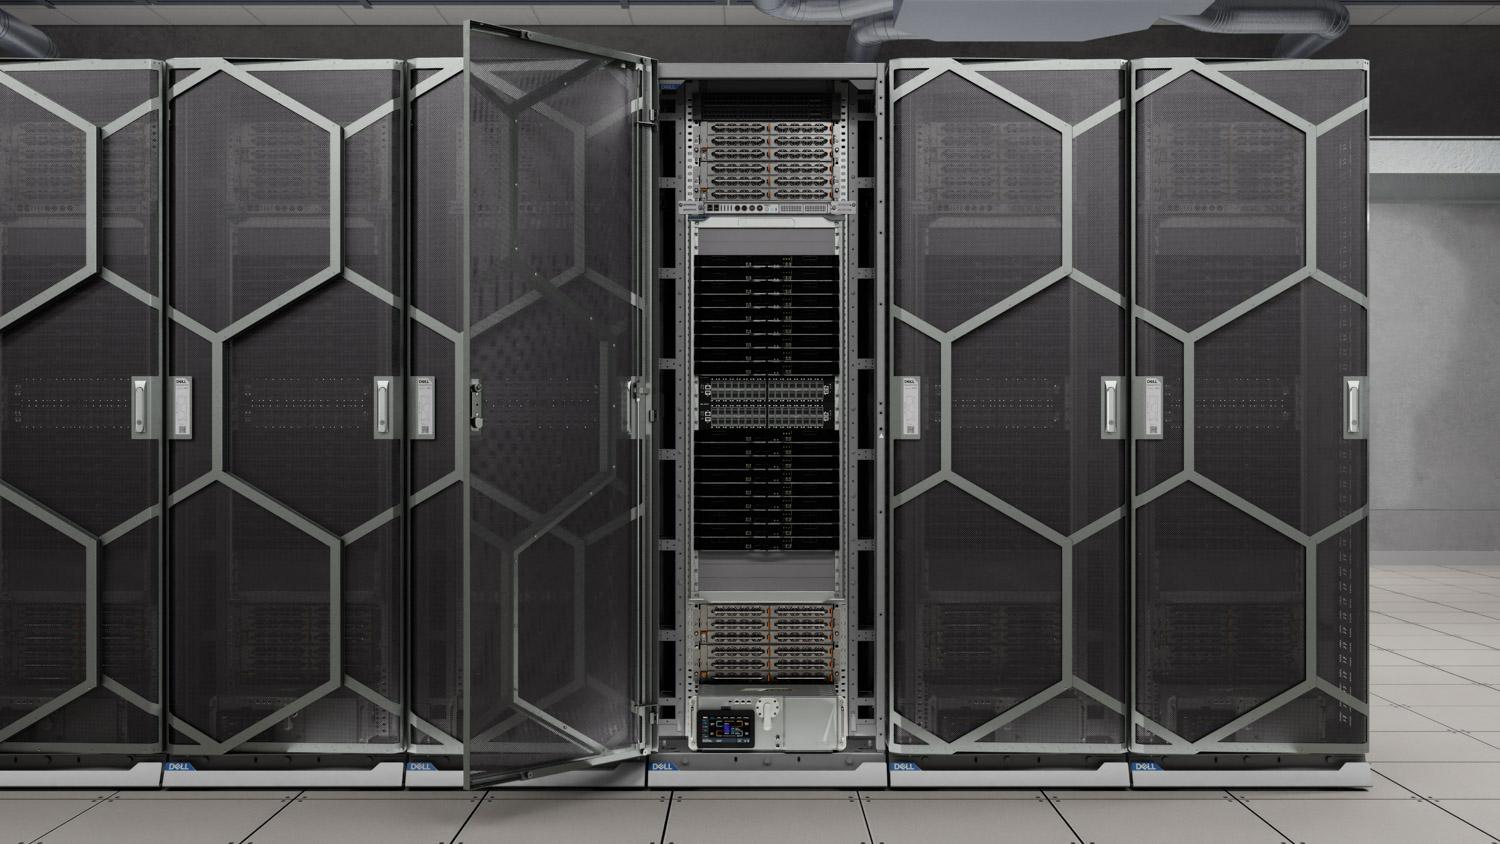
戴爾計畫推出基於開放式機架 v3 (ORv3) 的 XE8812 機架式伺服器,每個機架最多可支援 144 個 GPU,供電能力超過 300kW。該系統採用直接液冷散熱,同時為 CPU 和 GPU 提供冷卻,從而實現更高的組件密度和更佳的散熱效率。
基於 ORv3 的設計提供了一種模組化架構,旨在簡化部署和整合到大規模資料中心環境中。戴爾也透過其基礎設施管理產品組合,著重於運維管理能力。
戴爾整合遠端存取控制器 (iDRAC) 為 PowerEdge 系統提供遠端部署、監控和更新功能。在機架級別,戴爾整合式機架控制器和 OpenManage Enterprise 提供遙測、監控和自動洩漏偵測功能,旨在提高運作可視性並降低基礎設施風險。
工廠整合部署模式
該公司將新平台與戴爾 PowerRack結合,這是一種工廠整合的機架式部署模型,旨在降低大型 AI 和 HPC 叢集的實施複雜性。
戴爾表示,PowerRack 系統以預先驗證配置的形式交付,使企業能夠更快地從安裝過渡到生產工作負載。結合戴爾 ProDeploy 的全方位服務,這種方法取代了手動機架集成,採用即裝即用的機架,戴爾稱這些機架只需六個多小時即可投入實際工作負載運行。
戴爾人工智慧工廠擴大全球佈局
戴爾報告稱,其戴爾人工智慧工廠計劃持續成長,全球已有超過 5,000 家客戶部署了人工智慧基礎設施。
多個備受矚目的部署案例突顯了所支援的工作負載範圍。
在美國,戴爾、英偉達和國家能源研究科學計算中心(NERSC)正在勞倫斯伯克利國家實驗室建造杜德納超級電腦。該系統將採用配備英偉達 Vera Rubin NVL4 技術和英偉達 Quantum-X800 InfiniBand網路的戴爾 PowerEdge XE8812 伺服器,以支援大規模科學計算和資料密集研究。
在法國,人工智慧公司 InstaDeep 正在利用戴爾 AI Factory 的基礎設施來擴展其 Kyber 超級運算集群。該系統可提供約 0.5 exaFLOPs 的 FP16 性能,並支援包括自動化印刷電路板設計在內的工業設計應用。
在英國,韋爾科姆桑格研究所使用配備NVIDIA GPU的戴爾PowerEdge XE系列伺服器來支援基因組研究。該研究所現在每7小時就能產生一個完整的基因組,並在其內部管理超過100 PB的經過整理的基因組數據,這項工作為全球地球生物基因組計畫貢獻了超過70%的基因組。
在澳大利亞,莫納什大學與戴爾、英偉達和美國疾病管制與預防中心資料中心合作部署了MAVERIC超級電腦。該系統採用液冷式戴爾PowerRack基礎設施和基於英偉達GB200 NVL72技術的PowerEdge XE9712伺服器,以支援人工智慧和資料密集研究,涵蓋癌症檢測、氣候行動和基因組學等領域。
庫存情況
戴爾表示,PowerEdge XE8812 將於 2027 年初在全球上市。


 Amazon