

MLCommons 發布了 MLPerf Inference v6.1,此次測試參與機構數量創下新高,共有 30 家提交機構,並提供了 486 個資料中心和邊緣運算結果。測試套件新增了兩項測試:資料中心端對端 RAG 管線測試和單一使用者設備邊緣智慧推理基準測試。此外,測試結果首次包含了 NVIDIA Vera Rubin NVL72、AMD Instinct MI350P、Intel Arc Pro B70 和 AMD Ryzen AI Max+ 395 的同儕審查資料。關於效能提升速度,MLCommons 表示,伺服器場景下單加速器 DeepSeek-R1 測試的最佳結果比一年前的 v5.1 版本提升了 5.7 倍,而 VLM 測試的最佳結果在 v6.0 版本發布後的六個月內提升了 2.99 倍。
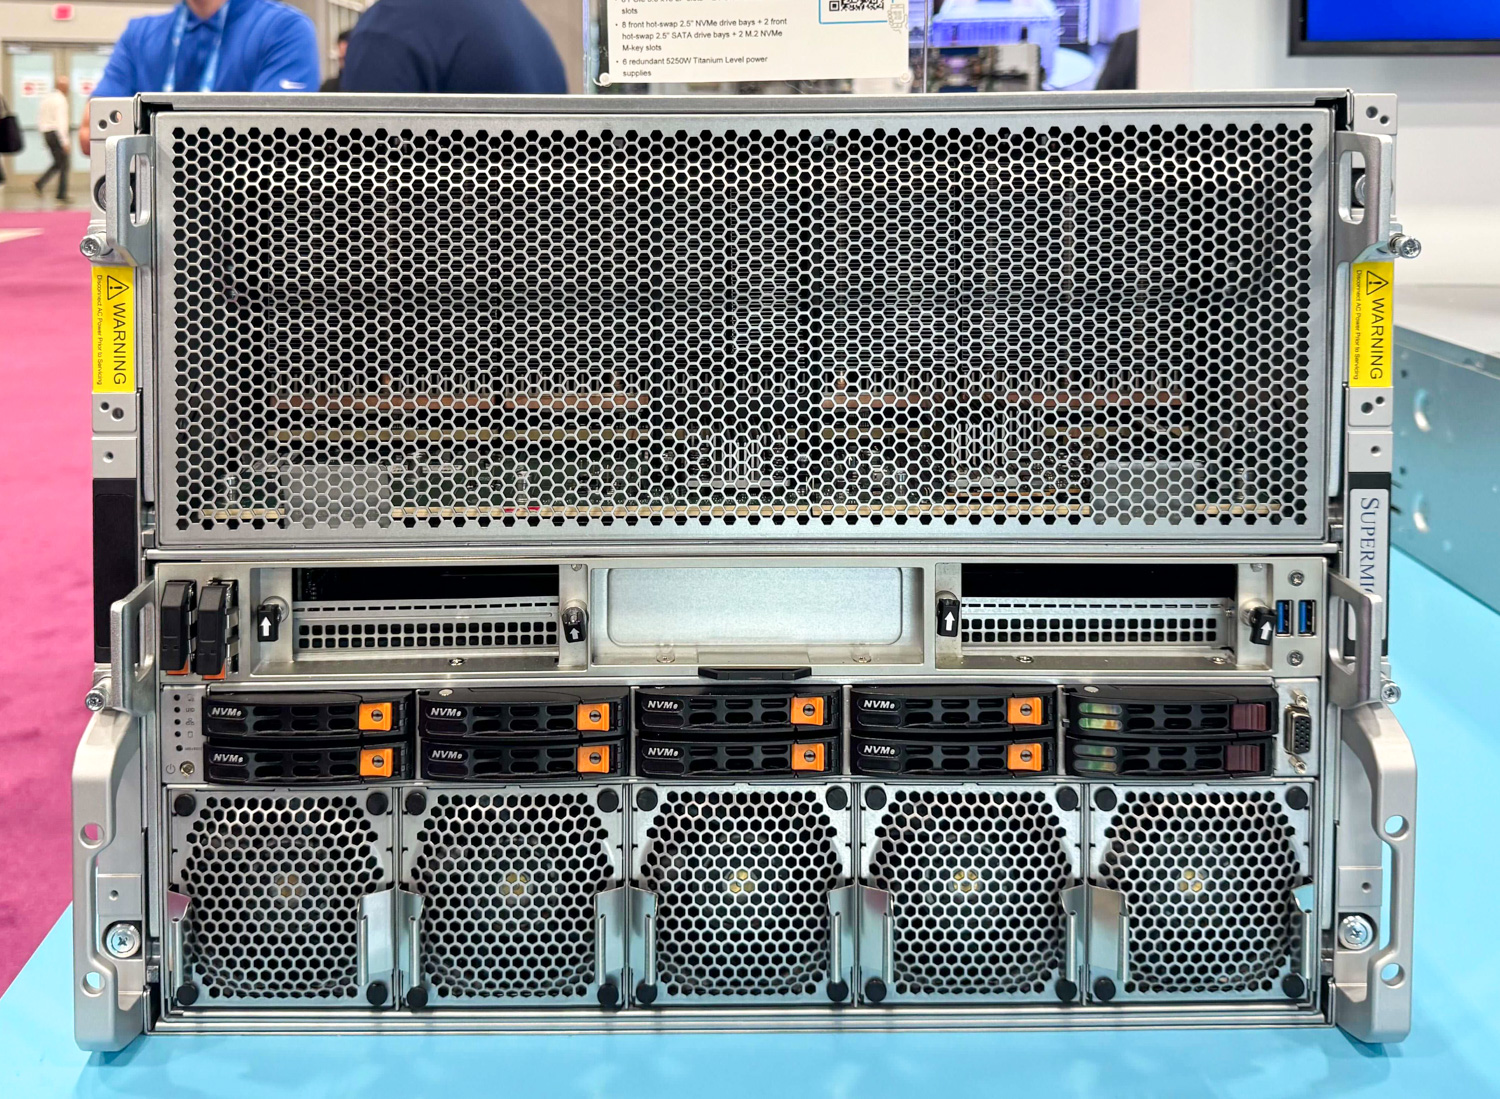
兩項新測試:端對端 RAG 測試和邊緣智能體推理
端到端 RAG 基準測試衡量完整的問答流程,該流程涉及多個模型和一個向量資料庫的協同工作。參考實作同時運行四個模型:gpt-oss-120B 負責查詢分解、充分性檢查和答案生成;gpt-oss-20B 對檢索到的文檔進行評分;e5-base-v2 生成詞嵌入;ColBERTv2 對段落進行重排序。語料庫包含 107,484 個段落,這些段落取自 2,515 個 HTML 檔案;問題來自 Google 的 FRAMES 資料集,包含 824 個多跳任務;每個任務最多可以循環進行 5 輪檢索,直到流程認為已獲得足夠的證據。此測試得出兩個指標:建立 FAISS HNSW 向量資料庫的每秒文檔數,以及針對該向量資料庫回答問題的每秒任務數。 Llama 3.1-8B 評判者根據 97% 的準確率目標對最終答案進行評分,評判過程不計時。
Edge Agentic Inference 基準測試針對的是已移轉到工作站和桌面 AI 裝置上的編碼輔助模式。該模型基於 Qwen3.6-27B,並啟用了「思考關閉」功能,在參考文件的 llama.cpp 中以 Q4_K_M GGUF 格式運行,每個回合處理 32K 上下文視窗。效能工作負載是 20 條從 SWE-bench Verified 資料集中提取的智能體編碼軌蹟的錄製回放,共計 1,007 個回合,以單流方式運行,每個請求同時進行,模擬開發人員在筆記型電腦上運行智能體的方式。報告的指標是每個回合的平均延遲,同時也提供了首次令牌到達時間和每個輸出令牌的到達時間分佈,準確率則透過 BFCL v4 單獨設定為參考分數的 97%。 MLCommons 基於其即將推出的 MLPerf Agentic 資料中心基準測試框架對此測試進行了調整。
「我們新增了端到端 RAG 測試,因為很明顯,問答系統不再局限於基於語料庫訓練的 LLM;利益相關者需要了解當今正在構建的多步驟、多組件管道在實際應用中的性能,」MLPerf 推理工作組聯合主席 Miro Hodak 表示。 “同樣,我們新增了邊緣智能推理測試,因為具有智能屬性的複雜推理系統越來越多地部署在邊緣計算設備上,這給我們的客戶帶來了一系列新的性能挑戰。”
該輪更新也將先前僅限於 DeepSeek-R1 的推測性解碼支援擴展到互動式場景中的 GPT-OSS 基準測試,並為 VLM 測試定義了一個新的互動式場景,目標是在 1.5 秒左右做出回應。
從桌面到機架,全新矽晶片
NVIDIA 的 Vera Rubin NVL72 首次亮相 MLPerf 預覽版評測,NVIDIA 和 Nebius 都提交了基於 VR200 NVL72 的測試結果。 NVIDIA 報告稱,在離線、伺服器和互動式場景下,使用 TensorRT-LLM 演算法的 NVL72 在 DeepSeek-R1 測試中,其令牌吞吐量比 GB300 NVL72 高出 2.5 倍;在使用 NVIDIA Dynamo 和 vLLM 演算法的 Qwen3 視覺語言模型上,其 3.7 倍。以上數據是 NVIDIA 與其上一代產品的比較結果。由於被評為預覽版,該平台預計將在下一輪評測中正式上市。
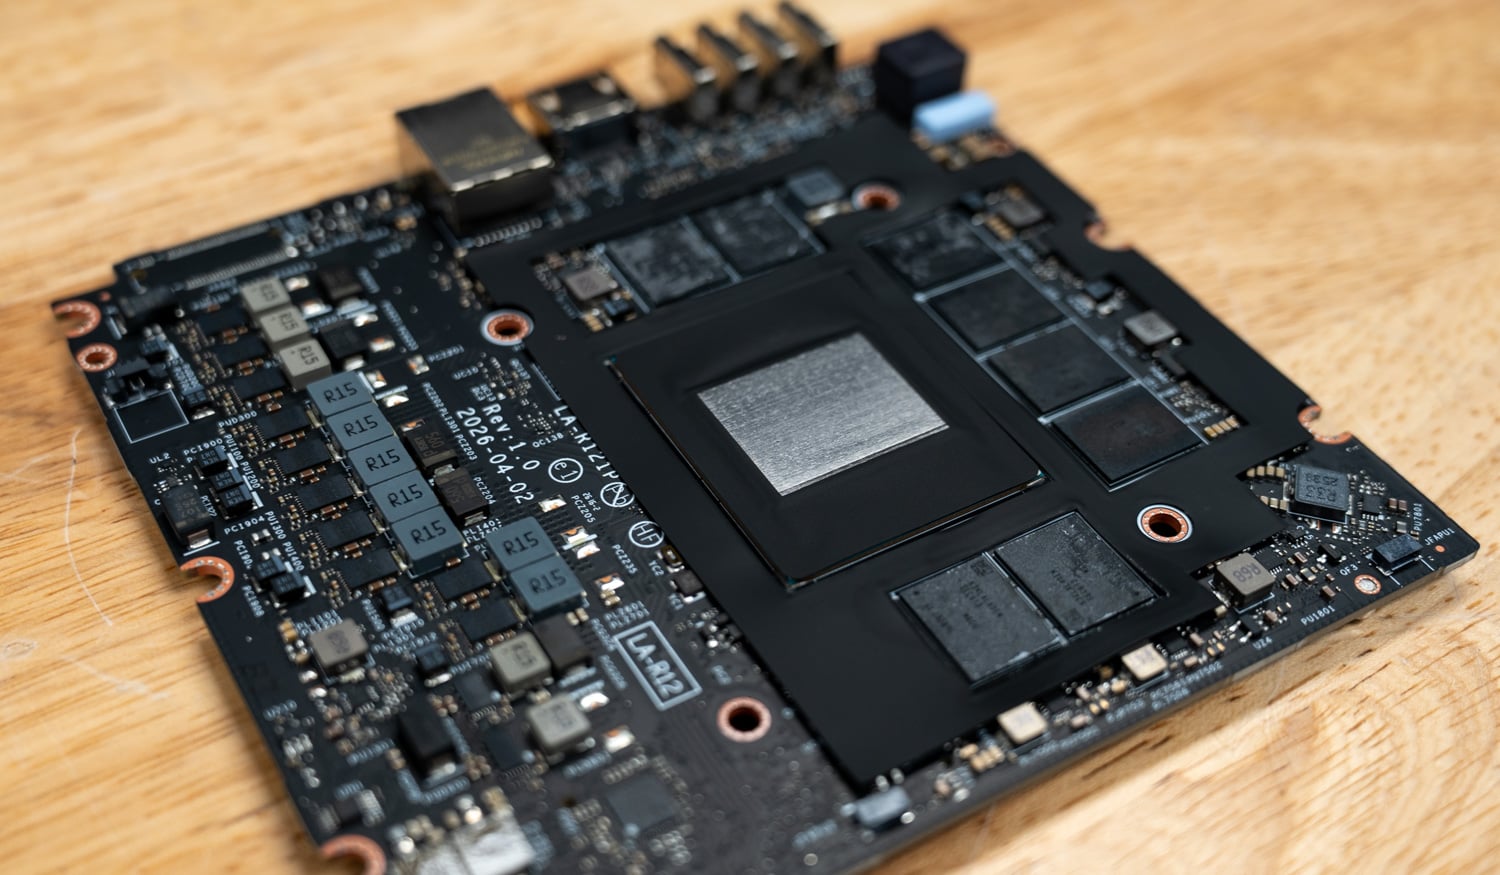
AMD 將其 MLPerf Inference 6.1 參賽作品擴展至涵蓋語言、推理、文字轉視頻和推薦任務的六個模型系列,並部署了 Instinct MI355X、MI350X 和新款 MI350P PCIe 卡。下文將介紹基於 MI355X 構建的 512 GPU Crusoe 集群,以及 AMD 對本輪比賽的詳細分析。
Intel Arc Pro B70 採用四 GPU 架構,總顯存容量達 128GB,並用於 Llama 3.1-8B、Llama 2-70B、gpt-oss-120B、Whisper 以及全新的 E2E-RAG 測試。英特爾報告稱,在相同的硬體配置下,gpt-oss-120B 的伺服器效能較 v6.0 提升了 36%,離線效能提升了 27%。 CPU 方面,英特爾表示,在相同的晶片上,Xeon 6980P 的 Llama 3.1-8B 伺服器吞吐量較 v6.0 提升了 2.4 倍,這完全是軟體層面的提升。
Ryzen AI Max+ 395 的成績由 Atlas Inference 測得。 Atlas Inference 是首次提交測試結果的廠商,它使用相同的引擎和量化方案,分別在 NVIDIA DGX Spark 和 AMD Strix Halo 桌上型電腦上運行了新的 Edge Agentic 工作負載。 Atlas 報告稱,在 DGX Spark 上,Ryzen AI Max+ 的測試結果為每秒 20.1 個令牌,在 64 分鐘內完成了全部 1,007 個回合;在 Strix Halo 上,測試結果為每秒 19.63 個令牌。這比我們在Ryzen AI Halo和DGX Spark 評測中使用現成運行時在這兩個平台上測得的差距要小,而這正是新基準測試旨在呈現的結果。
更大、更多元、更分散
本輪多節點提交數量創下新紀錄,較 v4.0 版本零節點大幅成長,其中三個提交尤為突出。 Crusoe 是另一位首次提交者,他使用 AMD 顯示卡運行了 MLPerf 推理歷史上最大的系統:在標準的 RoCE 乙太網路架構上,64 個節點上分佈著 512 個 Instinct MI355X GPU,提交的模型為 gpt-oss-120b 和 DeepSeek-R1。 AMD 報告稱,該叢集在 gpt-oss-120b 的離線場景下每秒處理 5.75 萬個 token,在伺服器場景下每秒處理 5.39 萬個 token;在 DeepSeek-R1 的離線場景下每秒處理 2.90 萬個 token,在伺服器場景下每秒處理 2.41 萬個 token。 AMD 稱這是 MLPerf 歷史上最高的聚合 token 吞吐量,吞吐量幾乎呈線性增長,節點數量從 1 個增加到 64 個。 gpt-oss-120b 的運作以 512 個獨立的單 GPU 副本形式運行,採用原生 MXFP4 編碼。 DeepSeek-R1 使用 SGLang,每個節點配備一個由 8 個 GPU 組成的副本。 AMD 也單獨引用了一個基於 72 個 GPU 的 GPT-OSS-120B 提交,其擴展效率達到 95%,每秒可處理 100 萬個代幣,這與v6.0 版本中 MI355X 的表現相同。
思科提交了此基準測試的首個跨廠商異質系統,該系統將八塊 NVIDIA H200 和八塊 AMD Instinct MI350X GPU 匯集到一個推理池中,並透過 Cisco Silicon One G200 架構運行,這與思科在其Secure AI Factory中銷售的混合加速器方案相同。 MangoBoost 與戴爾合作提交了該基準測試的參賽作品:分佈在兩大洲的四個站點,分別由 MangoBoost、戴爾、TensorWave 和 Microsoft Azure 託管,橫跨太平洋,作為一個統一的終端運行,MangoBoost 報告稱其擴展效率高達 97%。 MangoBoost 還聲稱首次在 AMD Instinct GPU 上獲得了預填充/解碼分解後的測試結果。
其他結果顯示,CoreWeave 在 GB300 NVL72 上實現了每秒 1.16 萬個令牌的聚合吞吐量,自 v6.0 版本以來,每個 GPU 的離線吞吐量提升了 17%;HPE 指出,在兩台搭載 Blackwell Ultra 處理器的 Compute XD690 伺服器上,DeepSeek-R1 100 個令牌可處理的 50 個令牌; DeepSeek-R1 上,並指出業界正在轉向大規模混合專家模式。 gpt-oss-120b 吸引了 112 個提交,是所有 MLPerf 工作負載中提交數量最多的。
AMD 的兩種 CDNA 4 外形尺寸:OAM 和雙槽 PCIe
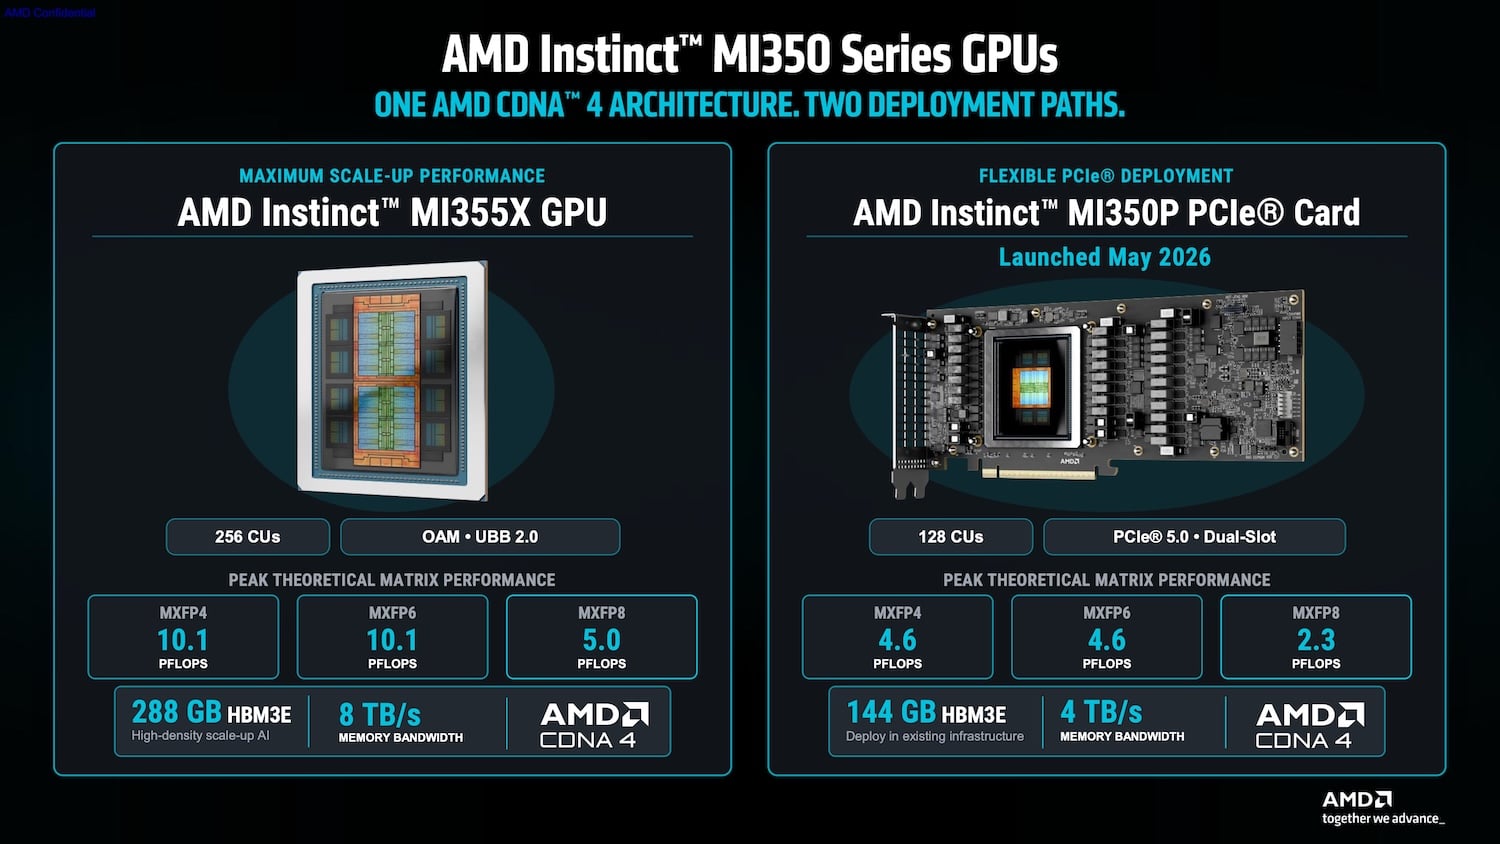
AMD 的 CDNA 4 架構提供兩種實體尺寸規格,以滿足不同的資料中心電源和散熱需求。旗艦級產品 Instinct MI355X 採用 OAM 外形尺寸,基於 OCP 通用基板 (UBB 2.0) 平台,面向高密度運算節點,提供 256 個運算單元、288 GB HBM3E 記憶體和 8 TB/s 的總記憶體頻寬。其理論峰值 MXFP4 和 MXFP6 矩陣計算性能最高可達 10.1 PFLOPS。新推出的 Instinct MI350P 將相同的 CDNA 4 晶片整合到雙槽 PCIe 5.0 擴充卡中,適用於標準企業級機箱,配備 128 個運算單元、144 GB HBM3E 記憶體和 4 TB/s 的頻寬,理論峰值 MXFP4 和 MX P6 矩陣運算效能最高可達 4.6。
軟體驅動的代際性能提升,基於相同的晶片
AMD ROCm v7 中的軟體最佳化在相同的 MI355X 硬體上,於單一 MLPerf 測試週期內實現了可測量的吞吐量提升。在配備 8 個 GPU 的 MI355X 節點上進行的測試表明,GPT-OSS-120B 吞吐量在離線場景下提升了 28%,在伺服器場景下提升了 38%,而 Wan-2.2 SingleStream 效能提升了 70%。在叢集規模下,MLPerf 6.1 中 72 個 MI355X 加速器的總 GPT-OSS-120B 吞吐量高於 6.0 版本中報告的 94 個 GPU 配置。在 AMD 發布的對比測試中,配備 8 個 GPU 的 MI355X 在 GPT-OSS-120B 測試結果中領先 NVIDIA B200 和 B300,而 72 個 GPU 的集群則領先於 NVIDIA GB200。
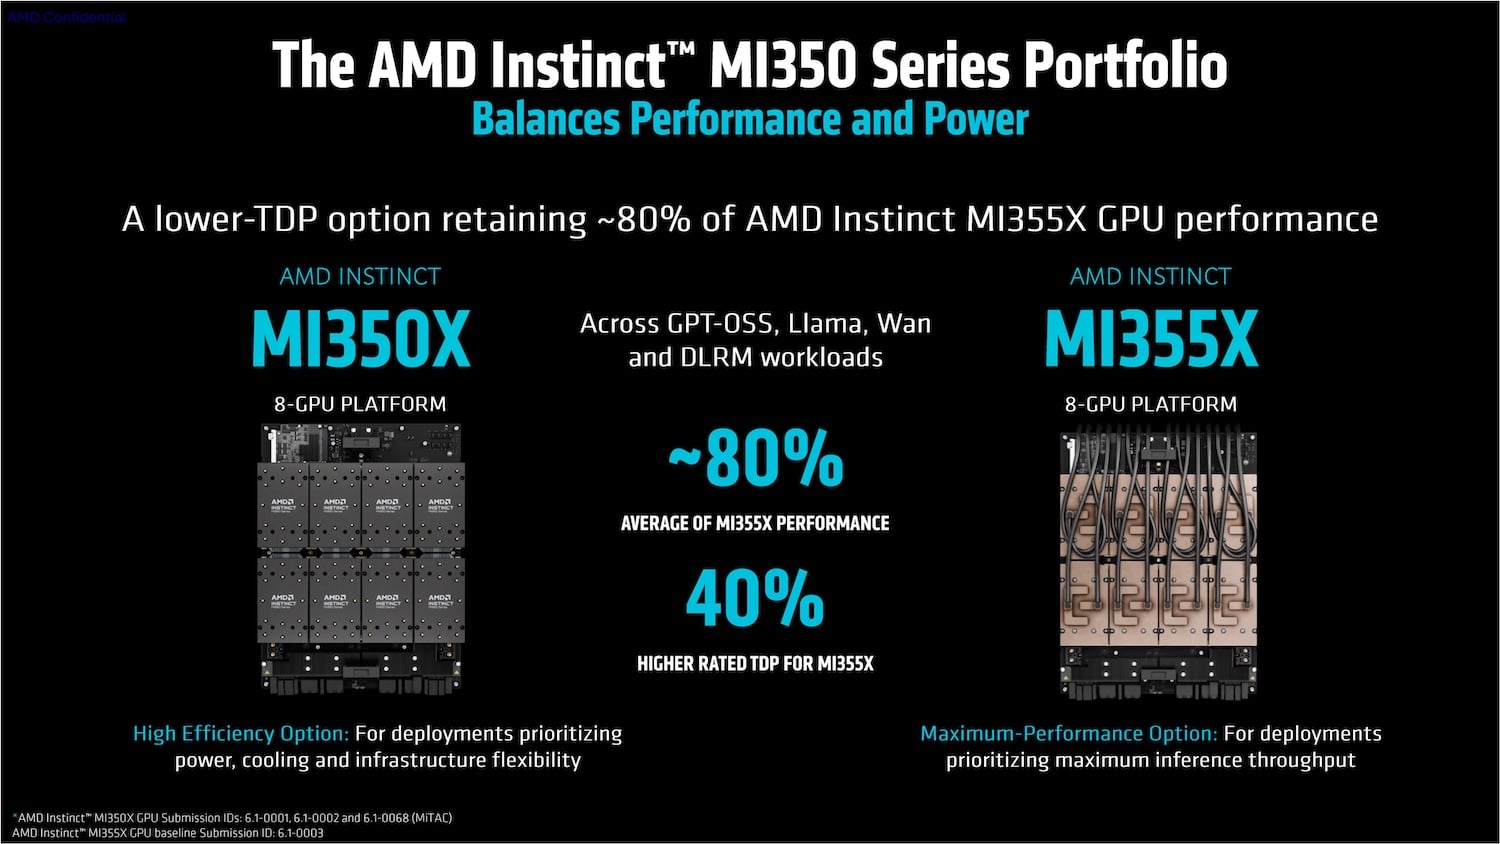
在首輪 MLPerf 測試中,雙槽 MI350P 在五項封閉式工作負載測試中均取得了領先成績,超越了 NVIDIA RTX PRO 6000 Server Edition 和 H200 NVL 的部分測試結果。對於對功耗和散熱預算較為敏感的部署,配備八 GPU 的 MI350X 系統在 GPT-OSS、Llama、WAN 和 DLRM 工作負載測試中,效能達到了 MI355X 平台基準測試效能的約 80%,而 MI355X 的額定 TDP 卻高出 40%。 Signal65 委託進行的一項研究表明,這些吞吐量數據轉化為更低的單文檔營運成本和更高的每美元代幣產出,且延遲限制在一定範圍內。
AMD合作夥伴業績及韓美集群
AMD 表示,來自戴爾科技、甲骨文、惠普企業、超微、MangoBoost、Crusoe 和 MiTAC 等七家合作夥伴提交的類似 MI355X 測試結果,平均與參考系統結果相差在 4% 以內,有些測試結果甚至與參考系統結果持平或略有提高。
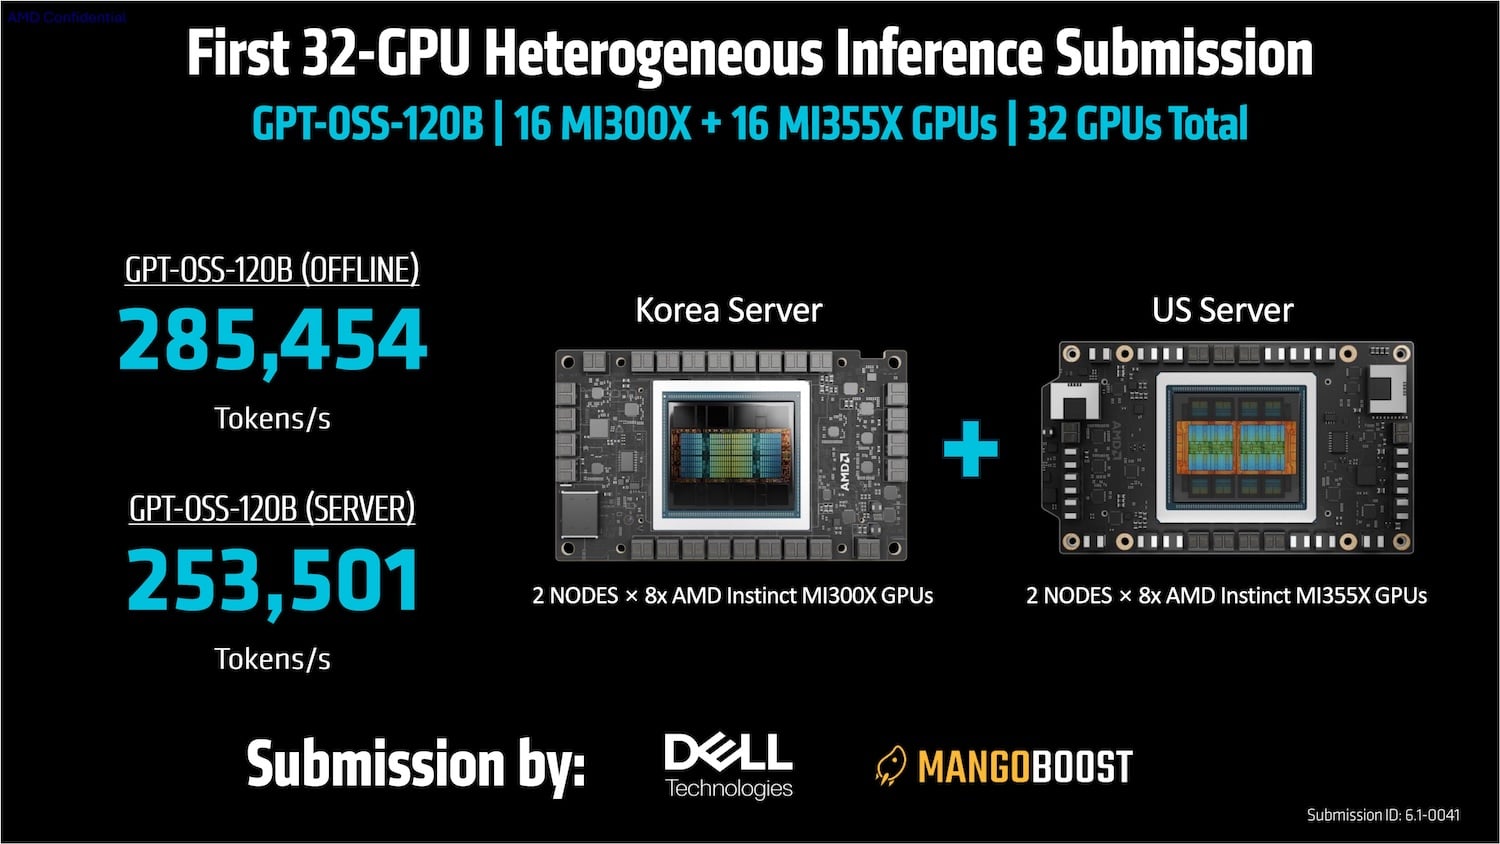
上文提到的 MangoBoost 和戴爾的參賽作品是該基準測試中首個異構 32 GPU 服務配置,它將韓國的 16 顆上一代 Instinct MI300X GPU 與美國的 16 顆 Instinct MI355X GPU 連接成一個統一的 GPT-OSS-120B 端點。這種分離叢集配置每秒可處理 285,454 個離線令牌和 253,501 個伺服器令牌。測試運行在 ROCm 7 上;AMD 指出,基於 HBM4 的 MI400 系列以及後續的 MI500 系列將採用ROCm 10 版本,該版本包含 vLLM、SGLang 和 ROCm.AI 分析工具。
在資料中心中取代 MLPerf 推理的工具
本輪30位提交者中有16位使用了MLPerf以API為中心的測試框架,而v6.0版本中僅有一位開放組提交者使用。該框架透過標準API對託管端點運行真正的客戶端/伺服器架構,這正是資料中心推理的部署方式。它已包含新的Edge Agentic測試、VLM-Interactive、gpt-oss、DeepSeek-R1、Llama 3.1-8B以及文字轉視訊等測試。它是MLPerf Endpoints的基礎,後者將於2026年1.0月開放按需滾動提交,並於2027年取代MLPerf Inference成為資料中心基準測試。 Endpoints v1.0計劃提供標準化結果並擴展代理工作負載。
MLPerf負責人David Kanter表示:「展望未來,MLPerf Endpoints將取代Inference,成為我們資料中心基準測試系列的一部分。我們以API為中心的測試框架的快速普及將有助於實現這一無縫過渡。」 本輪首次提交測試結果的六家公司分別是Atlas Inference、Crusoe、Orrick Industries、本輪首次提交測試結果的六家公司分別是Atlas Inference、Crusoe、Orrick Industries、ScitiX、SSciti研究所、ViemPC Khoshnevis,他提交了單一H200 Llama 3.1-8B測試結果。
此推理輪次是在兩週前發布的MLPerf Storage v3.0 結果之後進行的,完整的資料中心和邊緣表以及提交者的補充資訊可在 MLCommons 結果頁面上找到。


 Amazon