

我們已經評測過幾款GB300 DGX工作站,最近同時在實驗室測試了兩台:華碩ExpertCenter Pro ET900N G3和惠普ZGX Fury AI工作站。這兩台主機並排擺放,我們想將它們連接起來,看看第二塊GB300能為單一機器帶來多大的效能提升,從而更好地協同處理桌面AI工作負載。
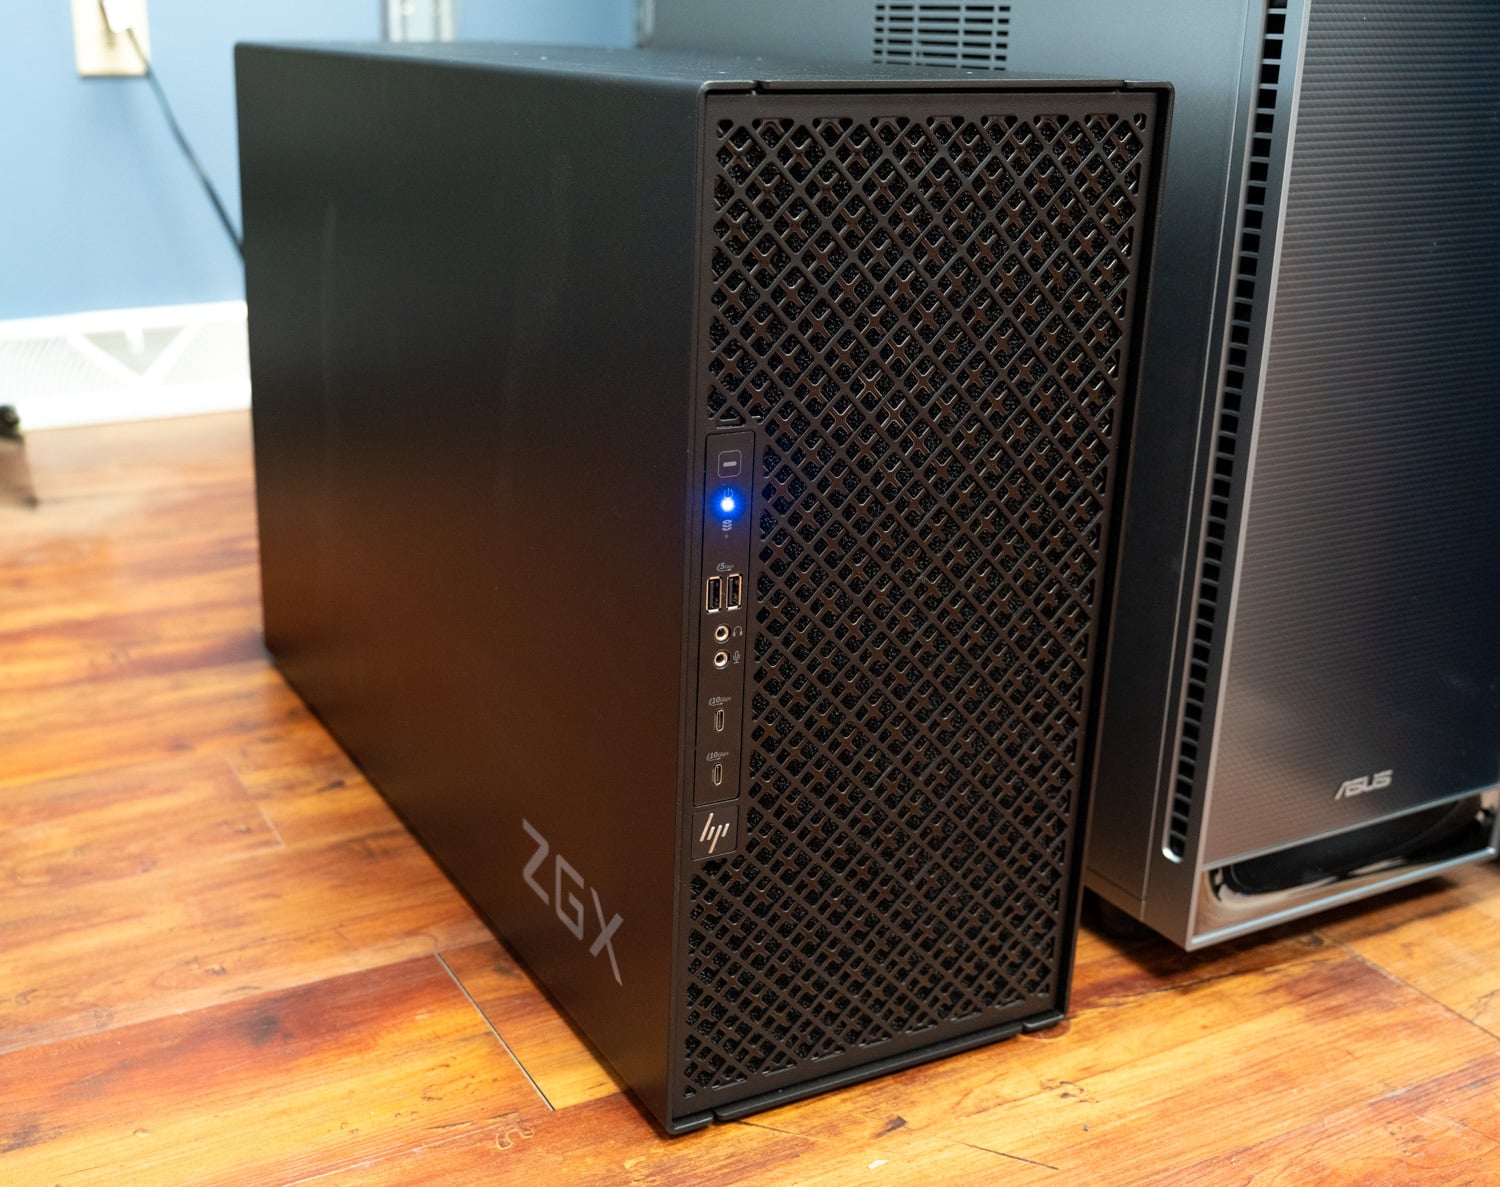
逐步擴展桌面配置並非新概念;NVIDIA 在 GB10 平台上就明確提出了這個理念。 DGX Spark 的獨特之處在於,它允許使用者從一台設備開始,隨著工作負載的成長逐步連接更多設備。 GB300 的初始性能要強得多,但運行更大型的模型或服務更多用戶,即使是我們測試過的速度最快的台式機之一也會面臨挑戰。這正是我們在最初的 MSI 評測中所要表達的觀點:如果你的工作負載需要一台這樣的工作站,那麼很容易理解為什麼最終需要多台。
對許多買家來說,成本將決定何時進行擴展才切實可行。了解兩台工作站目前的協同工作情況,可以讓從一台工作站起步的使用者更清楚地了解日後擴充能帶來哪些好處。
關鍵要點
- 兩條電纜,線路速率的 98%: 華碩 ET900N G3 和惠普 ZGX Fury 的 ConnectX-8 連接埠之間連接了兩個 400G DAC,NCCL 在廣播、縮減和發送/接收方面實現了 98GB/s 的傳輸速度,而該組合的理論傳輸速度為 100GB/s。 GPUDirect RDMA 在每條傳輸軌上都達到了 392Gb/s 的速度,8 個位元組 RDMA 寫入的平均時間為 1.46 µs。 NVIDIA 的測試方案完成了整個設定過程。
- GLM-5.2 在同時效能相同的情況下效能提升了 11 倍: 433GB 的 NVFP4 檢查點將大約 215GB 的專家權重溢出到一台 Station 上的 Grace 記憶體中,該 Station 在 32 個流上每秒處理 139 個輸出標記;在張量並行模式下,透過兩台 B300 進行處理,在 32 個流上達到 1,55 個流上達到 1,55 個每秒,在 14 個流上達到 1,55 個流。
- GLM-5.3 每秒處理令牌數從 188 個增加到 5,018 個: 該組中增益最大的是 27 倍,來自另一個擁有 252GB HBM3e 的型號,該型號在相同的工作負載下仍能以 256 個流的速度攀升,並且在 8,192 個代幣的提示下每秒能保持近 600 個輸出代幣,大約是單個塔的五倍。
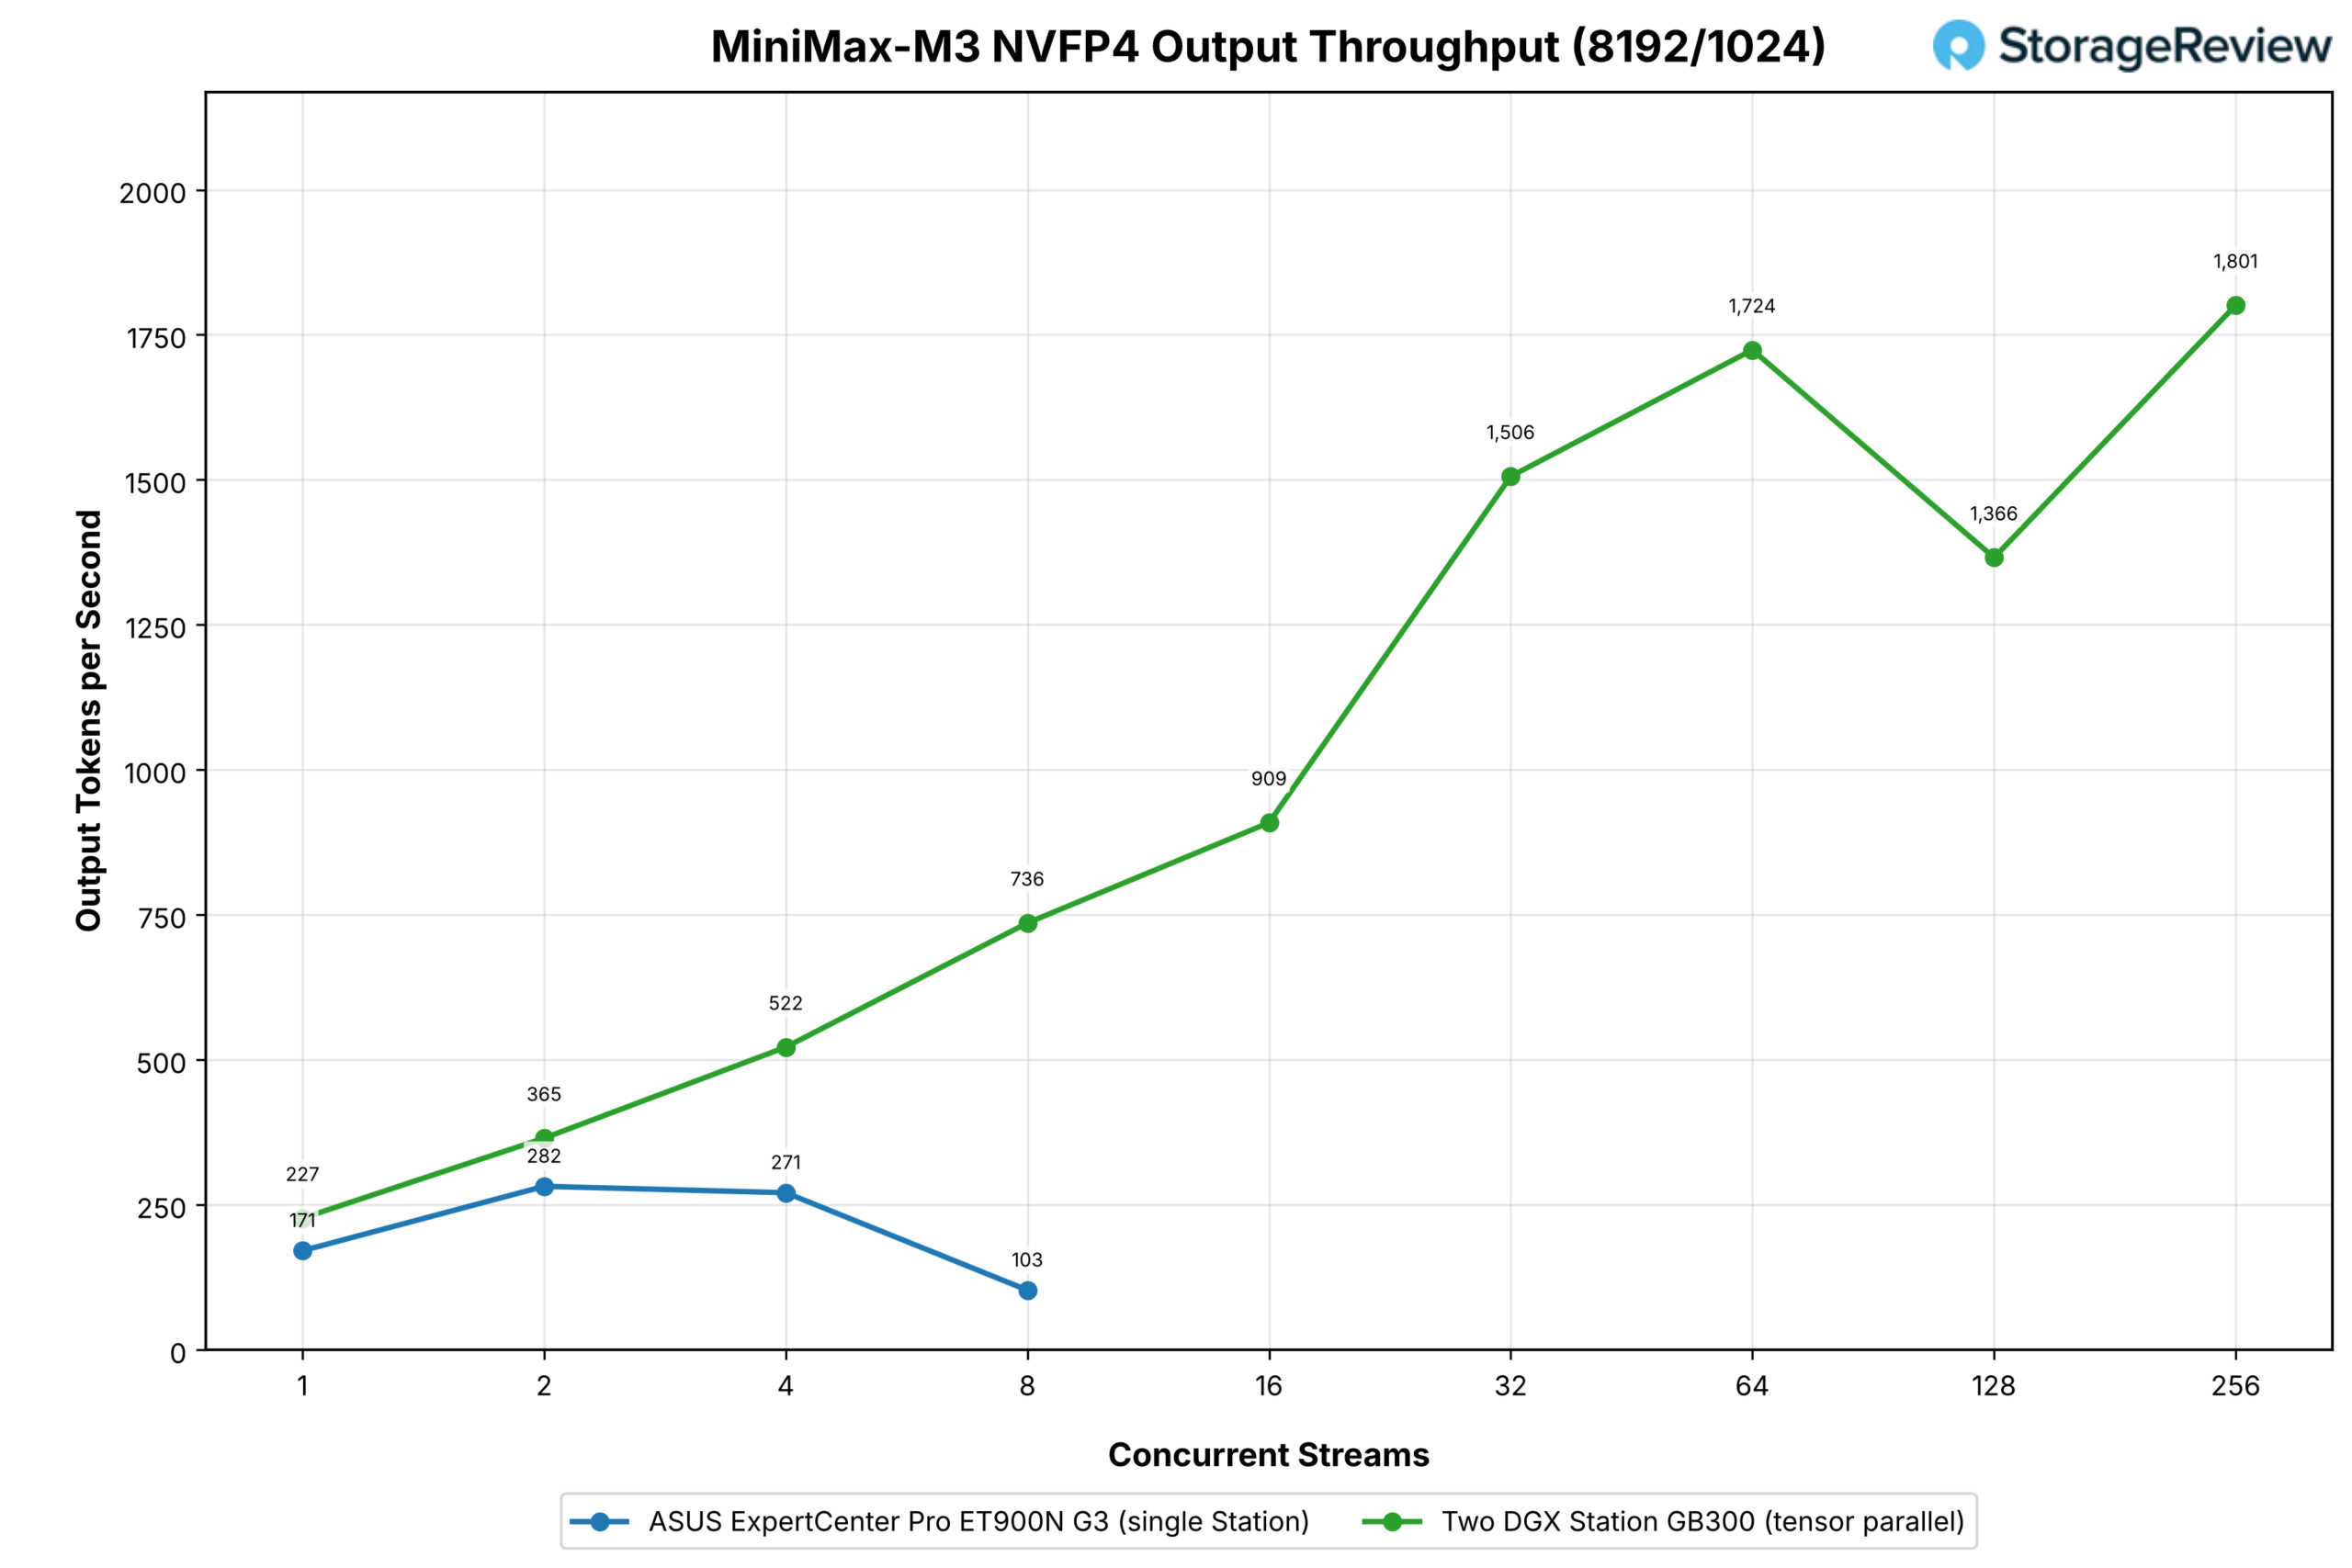
- MiniMax-M3 長提示音在一個工作站上最多只能處理八個資料流: 當 KV 快取耗盡時,單一塔在 8 個流下每秒輸出令牌數降至 103 個;此時,一對塔每秒輸出令牌數為 736 個,速度提升了 7.1 倍,並在 256 個流下繼續提升至每秒 1,801 個。
- 符合條件的模型會獲得第二個副本,並進行預先填充/解碼拆分: 當一個工作站進行預填充,另一個工作站進行解碼時,GLM-5.3 Flash 在 32 個流下將短提示吞吐量提高了三倍(從 828 提高到 2,721),並將長提示吞吐量提高了一倍(從 1,219 提高到 2,448),而 DeepSeek V4.185 個測試裝置在所有測試型號中
DGX 站上的網路連接
在深入了解集群之前,讓我們先回顧一下我們在 MSI 評測中提到的網路功能。 ConnectX-8 SuperNIC 的功能遠不止於提供網路連線。它整合的 PCIe 交換器還負責處理工作站的部分內部 I/O,連接到 Grace 以及兩個 PCIe Gen 6 x4 儲存插槽。
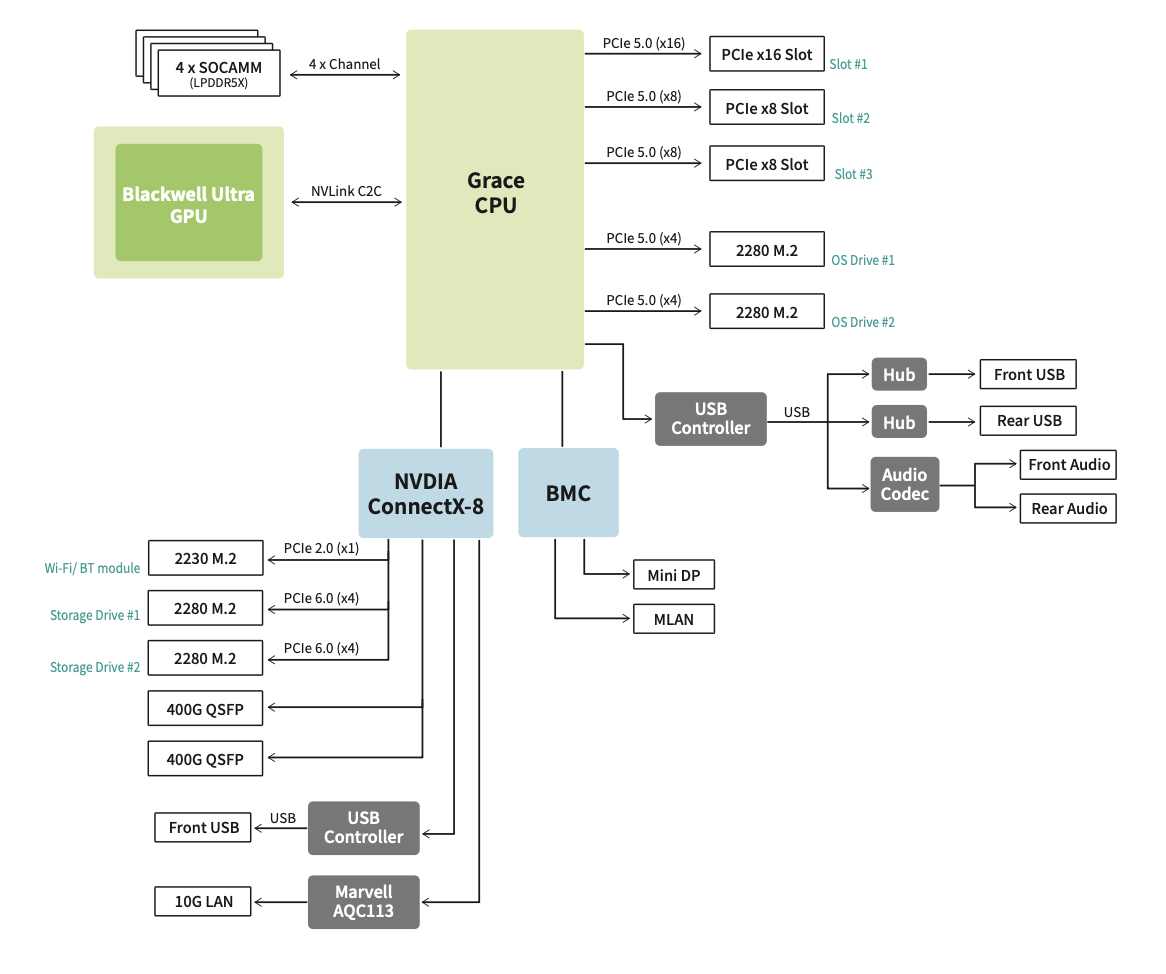
對於實際聯網,該系統提供兩個 QSFP112 端口,每個端口的額定頻寬為 400Gb/s,總頻寬為 800Gb/s,可將站點連接在一起或將其連接到更大的網路。
與我們先前在 DGX Spark 評測中介紹的 DGX Spark 的實作方式相比,Spark 的 400Gb/s 級 ConnectX-7 的效能遠超 GB10 的 PCIe 連線能力。此控制器位於兩條獨立的 PCIe 5.0 x4 連結之後,限制了實際可用的網路總吞吐量約為 200Gb/s。在 Linux 系統中,它的兩個實體連接埠也顯示為四個邏輯乙太網路介面。要獲得全部頻寬,需要將這些介面映射回連接的機箱,配置其後的兩個邏輯接口,並確保 RDMA 流量可以使用兩條 PCIe 路徑。
該工作站為我們提供了一種更簡單的配置,它有兩個 400Gb/s 端口,每個端口都可以作為獨立的網路線路。
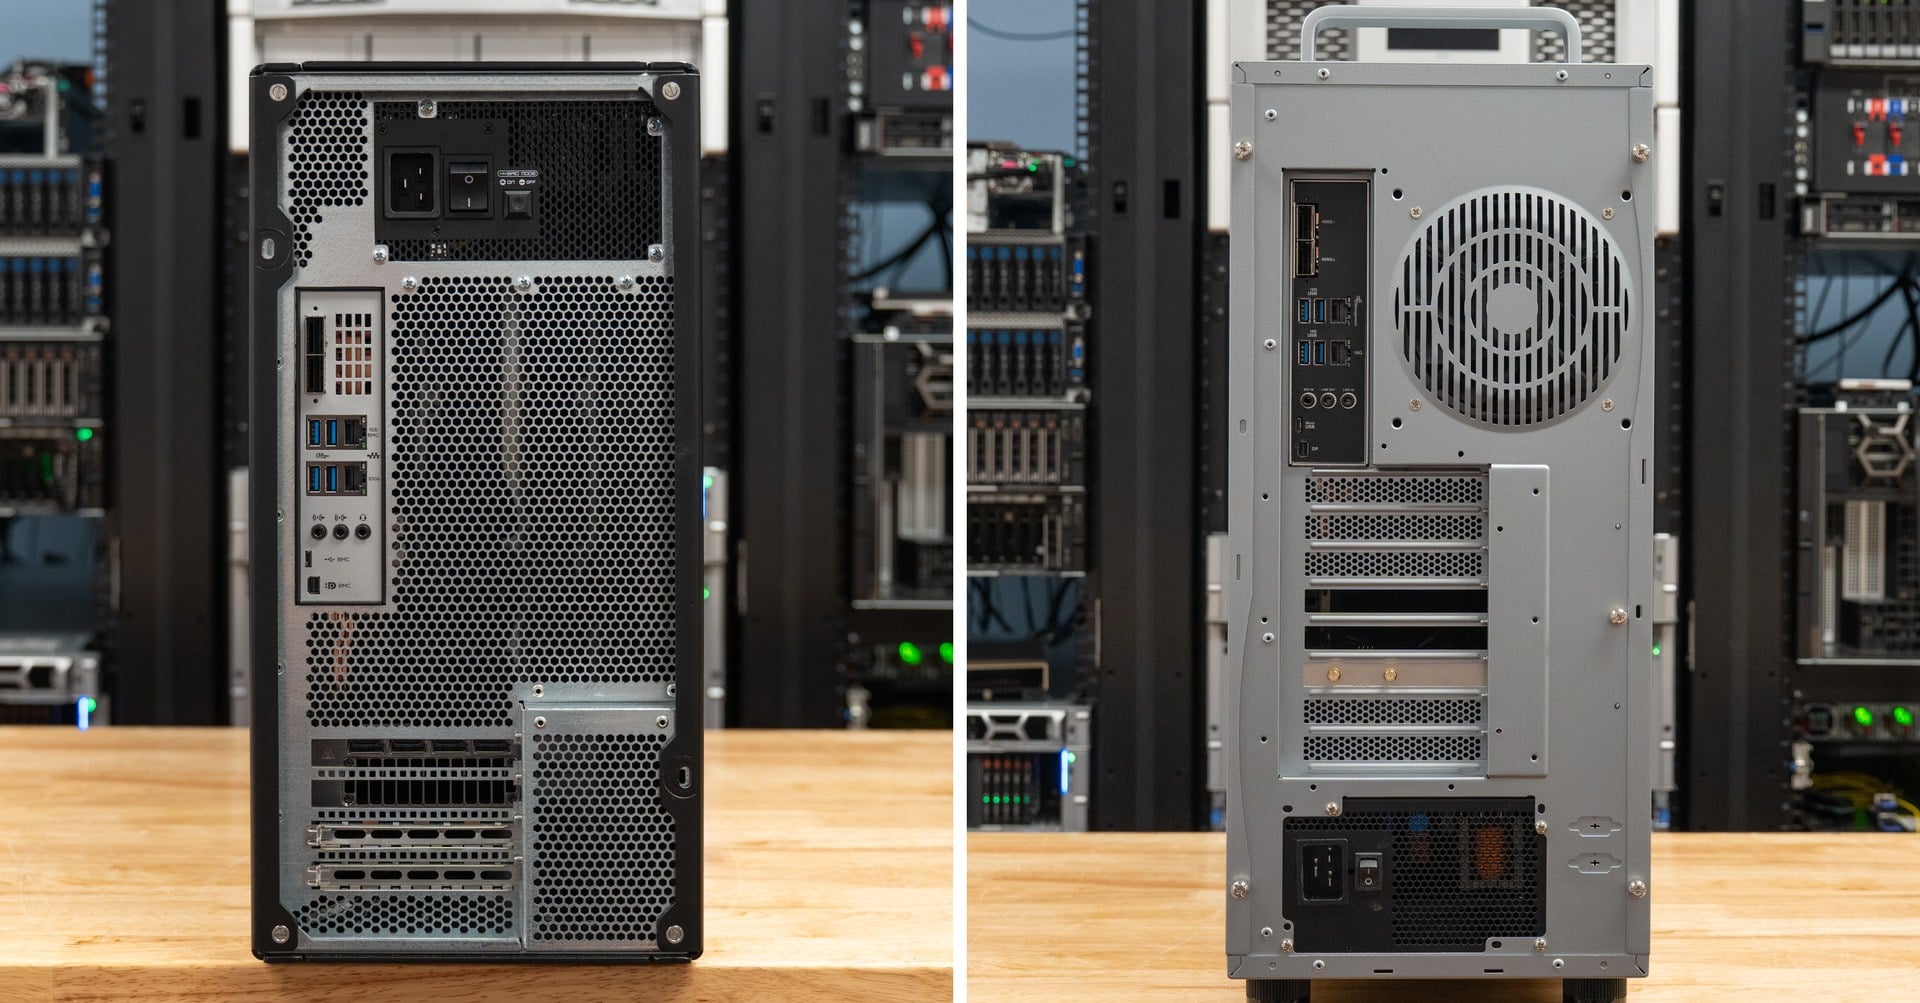
透過兩個 QSFP 插槽傳輸四倍於 Spark 可用頻寬的數據,無疑會增加散熱負載。在我們的測試中,所有設備都能輕鬆應付。 ConnectX-8 本身採用液冷散熱,一些廠商(例如 MSI)會將這種散熱方式延伸到 QSFP 插槽,而其他廠商則像我們在 ASUS 評測中看到的那樣,在插槽上方使用散熱片和專用風扇。這種散熱方式對於光模組尤其有效,因為光模組產生的熱量比被動式 DAC 更高。兩種散熱方案在我們的測試中都表現良好,我們沒有遇到任何網路散熱問題。
連接兩個車站
將兩台 DGX 工作站集群化很簡單:我們使用兩根 400G 直連銅纜 (DAC) 連接 ASUS 和 HP 的匹配 QSFP112 端口,從而獲得兩個獨立的 400Gb/s 連接。
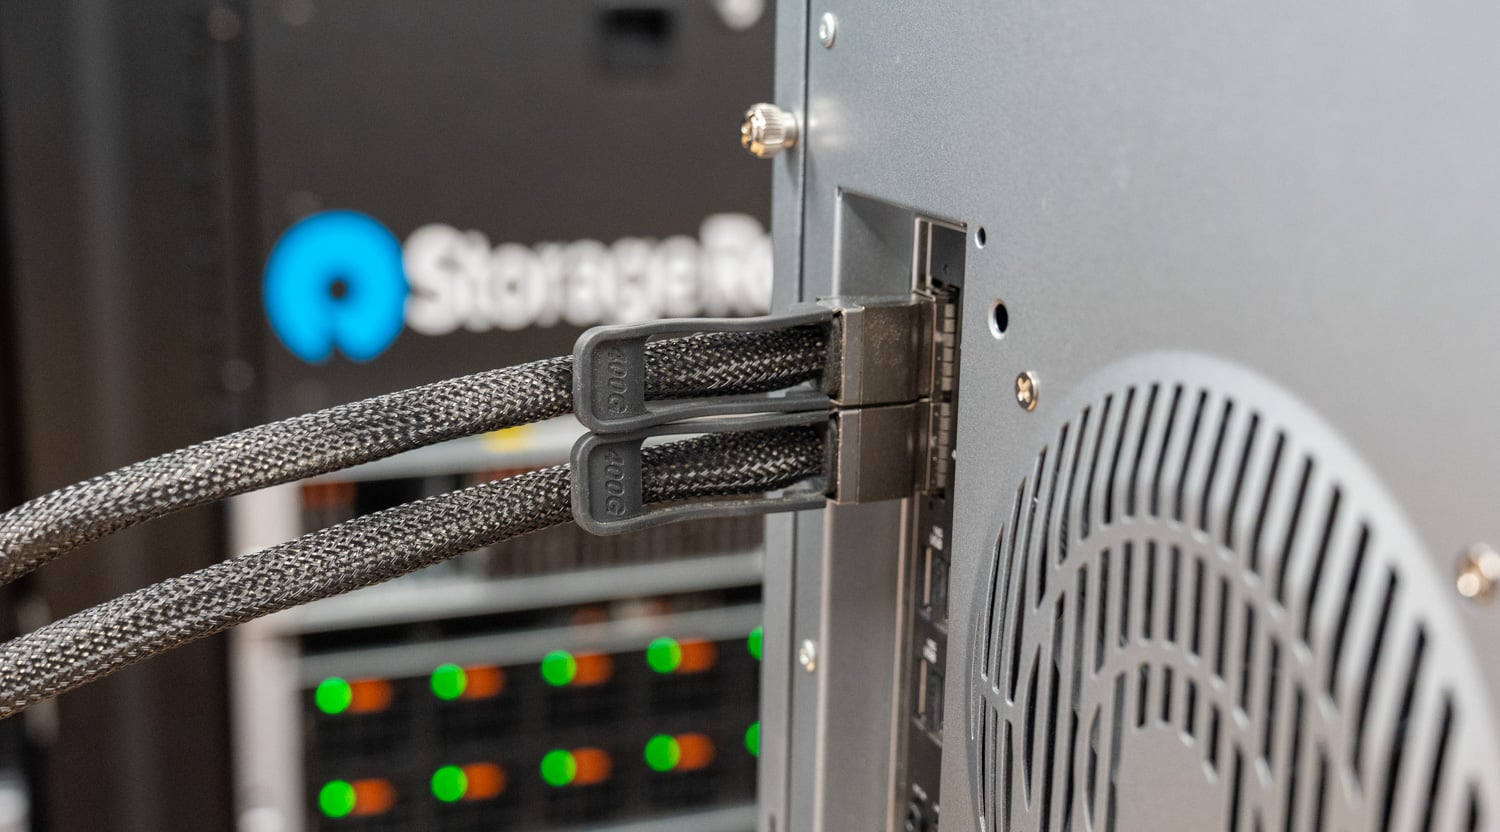
軟體方面,NVIDIA 提供了系統叢集的逐步指南,說明非常清晰,我們只需將連結提供給 Claude Code,它就能自動完成設定。它配置了兩個站點之間的網絡,運行了 NCCL 頻寬測試,並產生了測試結果報告。
該指南是一個編號的腳本,由第三台機器運行,透過 SSH 連接到兩個工作站。連接埠連接方式為匹配的鏈路,QSFP0 連接 QSFP0,QSFP1 連接 QSFP1,每個鏈路都成為獨立的點對點 RoCEv2 鏈路:腳本以 9,000 字節的 MTU 啟動兩個 ConnectX-8 接口,為每個鏈路分配一個私有的 /24 子網,並應用 GPUDirect 運行時運行時。
驗證過程隨後確認兩條連結均已訓練至 400G,巨型影格 ping 套件能夠分別透過兩個連結傳輸,且兩個 RDMA 裝置 mlx5_0 和 mlx5_1 均處於作用中狀態。此外,在每條鏈路上執行 ib_write_bw 命令,證明該交換矩陣能夠傳輸 RDMA 流量,而不僅僅是 ping 套件。之後,將 NCCL 指向這兩個連結(NCCL_IB_HCA=mlx5_0,mlx5_1),然後像其他雙節點執行一樣啟動作業。以下結果即來自上述步驟。
第一張表來自 nccl-tests,它記錄了在兩台 B300 伺服器上執行的分散式推理或訓練作業問題,兩台伺服器都使用兩條匯流排。每個工作站配備一個 GPU,因此每次作業都涉及兩個 GPU 通過兩條 400G 鏈路交換數據,所以總線頻寬列直接對應兩條電纜提供的 100GB/s(800Gb/s)頻寬。峰值是不同訊息大小下的最佳結果;16 GiB 欄位代表測試過的最大訊息大小,此時頻寬已趨於穩定。
| 手術 | 峰值大小 | 峰值總線頻寬 | 總線頻寬為 16 GiB |
|---|---|---|---|
| 全部減少 | 1 GiB | 92.242 GB / s | 91.346 GB / s |
| 全體集合 | 16 GiB | 87.893 GB / s | 87.893 GB / s |
| 減少散射 | 2 GiB | 93.930 GB / s | 92.905 GB / s |
| 廣播 | 16 GiB | 97.975 GB / s | 97.975 GB / s |
| 降低 | 16 GiB | 97.978 GB / s | 97.978 GB / s |
| 總而言之 | 8 GiB | 80.522 GB / s | 80.512 GB / s |
| 發送/接收,單向 | 16 GiB | 97.953 GB / s | 97.953 GB / s |
| 發送/接收,雙向 | 16 GiB | 每方向 83.748 GB/s | 總計 167.496 GB/s |
廣播、降維和單向發送/接收的傳輸速率均達到 98GB/s,佔兩條線載承載能力的 98%。雙向同時傳輸的速率則有所下降,單向降維為 92GB/s,雙向傳輸為 80GB/s。雙向傳送/接收的測試結果作為參考:在兩個 GPU 同時傳送資料的情況下,每個方向的速率穩定在 84GB/s,連結總速率為 167GB/s。
第二張表將 NCCL 降級到原始 RDMA 路徑,每次使用 ib_write_bw 函數寫入一條記憶體通道。 GPUDirect 行記錄了從一塊 B300 的 HBM 到另一塊 B300 的 HBM 進行 1 MiB 資料傳輸的過程,網路卡直接讀寫 GPU 記憶體;兩個記憶體通道的讀寫速度均達到 392Gb/s,佔線路速率的 98%。主機記憶體行是此指南的基本冒煙測試,使用一對來自 Grace 記憶體的佇列,NVIDIA 的測試手冊顯示,在 400G 記憶體通道上,Grace 記憶體的讀寫速度為 220 至 230Gb/s;我們測得的速度為 228Gb/s。延遲行記錄的是 8 位元組的寫入操作:平均延遲為 1.46 微秒。
| 測試 | 頻寬 | 鏈路利用率 |
|---|---|---|
| GPUDirect RDMA、GPU 記憶體、ib_write_bw、1 MiB 傳輸 | ||
| 鐵軌0 | 392.15 Gb / s | |
| 鐵軌1 | 392.15 Gb / s | |
| 主機記憶體 RDMA,兩條軌道 | ||
| RDMA 寫入,單向 | 228.15 Gb / s | |
| RDMA讀取,單向 | 228.23 Gb / s | |
| RDMA 發送,單向 | 228.16 Gb / s | |
| RDMA 寫入,雙向 | 447.10 Gb/s 總吞吐量 | |
| RDMA 寫入延遲,8 位元組 | 平均時間為 1.46 微秒;第 99 百分位數為 1.63 和 1.66 微秒(鐵路運輸)。 | |
我們如何測試集群
由於與這對模型的合作時間有限,我們專注於推理,這是目前最受歡迎的AI工作負載。我們計劃將這項工作擴展到更大的集群。在本文中,我們著重研究了大型模型,並使用張量並行(TP)和預填充/解碼(PD)分解技術,比較了單一Station和兩個Station的性能。
張量並行將模型中的權重張量和計算任務分配到多個GPU上。在我們的雙站配置(TP2)中,每個B300 GPU都承載著模型的一部分,並且兩個GPU同時處理每個請求。這為我們提供了更多的高頻寬記憶體(HBM)來存放權重,以及更多的運算資源來運行這些權重。此外,它還要求GPU在整個推理過程中透過NCCL交換中間結果並進行同步,因此通訊開銷也成為運行模型成本的一部分。
解耦推理將請求的預先填充和解碼階段分配給不同的工作進程。預填充處理輸入提示並建立鍵值 (KV) 緩存,該緩存是模型在生成過程中重複使用的注意力狀態。解碼則使用此狀態逐一產生輸出標記。這兩個階段的處理需求不同:預填運算量大,而解碼則記憶體頻寬密集。在規模較大的系統中,這種解耦推理方式允許運維人員根據需求獨立擴展這些工作進程,正如我們在KV 快取卸載論文中所展示的那樣。
在單節點架構中,當兩個階段共享一個工作節點時,vLLM 可以將對傳入提示的預先填充工作與正在進行的請求的解碼工作交錯進行。這種提示處理可能會增加輸出標記之間的間隔時間。在我們的 PD 架構中,一個工作站負責預先填入並將請求的鍵值快取傳輸到另一個工作站,後者負責解碼。每個工作節點都可以存取其自身的模型副本,包括儲存在 Grace 記憶體中的任何資料。解碼工作節點不再需要在產生標記的同時安排新的提示處理,從而提高了推理吞吐量。
在我們的測試中,模型的記憶體需求決定了我們採用的方法。對於最大的檢查點,單一 Station 需要將大量模型權重卸載到 Grace 內存,此時 TP 方案性能最佳。將權重分散到兩個 GPU 上,可以讓更多模型資料保留在 HBM 記憶體中,從而降低卸載效能損失。對於那些能夠很好地適應單一 Station 的模型(無論是完全運行在 HBM 記憶體中,還是僅少量卸載到 Grace 記憶體),我們使用了 PD 解耦方案。該方案包括使用 DeepSeek V4.1 Flash,其 Engram 查找表位於 Grace DRAM 記憶體中。
為了與先前的測試結果保持一致,我們沿用了先前的方法,即固定輸入序列長度 (ISL) 和輸出序列長度 (OSL)。相同工作負載的測試使用 512 個輸入令牌和 512 個輸出令牌,而預先填充密集型工作負載則使用 8,192 個輸入令牌和 1,024 個輸出令牌。我們在保持序列長度不變的情況下,改變並發請求的數量。
每張圖表中的單站基準線是我們評測的 ASUS ET900N G3,掃描至 32 個流;雙站運行至 256 個流。每個點都是一次運行,因此在某個並發級別上的下降會被報告為已收集。
推理配置
| 型號 | 集群模式 | 軟體 | 推測性解碼 | 格蕾絲的記憶 |
|---|---|---|---|---|
| DeepSeek V4.1 閃光燈 (FP8) | 預先填充/解碼分解,每個站點完整副本 | vllm/vllm-openai:deepseekv41-flash-0909 | 模型自帶繪圖器,固定5個標記 | 每個工作站上,Grace 記憶體中固定了兩張 FP8 記憶圖(188.84GiB),並卸載了 131.97GB 的專家權重。 |
| GLM-5.3 NVFP4 | 張量並行(TP2) | NVIDIA vLLM 26.08 NGC 容器 (vLLM 0.27.1) | MTP,固定5代幣草案 | 叢集上沒有;215GB 的專家權重已卸載到單一 Station 上。 |
| GLM-5.3 Flash NVFP4 | 預填充/解碼分解,華碩預填充,惠普解碼 | vLLM 0.28.1 RC1 | MTP,固定5代幣草案 | 無 |
| GLM-5.2 NVFP4 | 張量並行(TP2) | NVIDIA vLLM 26.08 NGC 容器 (vLLM 0.27.1) | MTP,固定3代幣草案 | 叢集上沒有;約 215GB 的專家權重已卸載到單一 Station 上。 |
| MiniMax-M3 NVFP4 | 張量並行(TP2) | NVIDIA vLLM 26.08 NGC 容器 (vLLM 0.27.1) | EAGLE3,固定3代幣輪抽 | 叢集上沒有;一部分專家被卸載到單一工作站上。 |
推理性能
DeepSeek V4.1 快閃記憶體
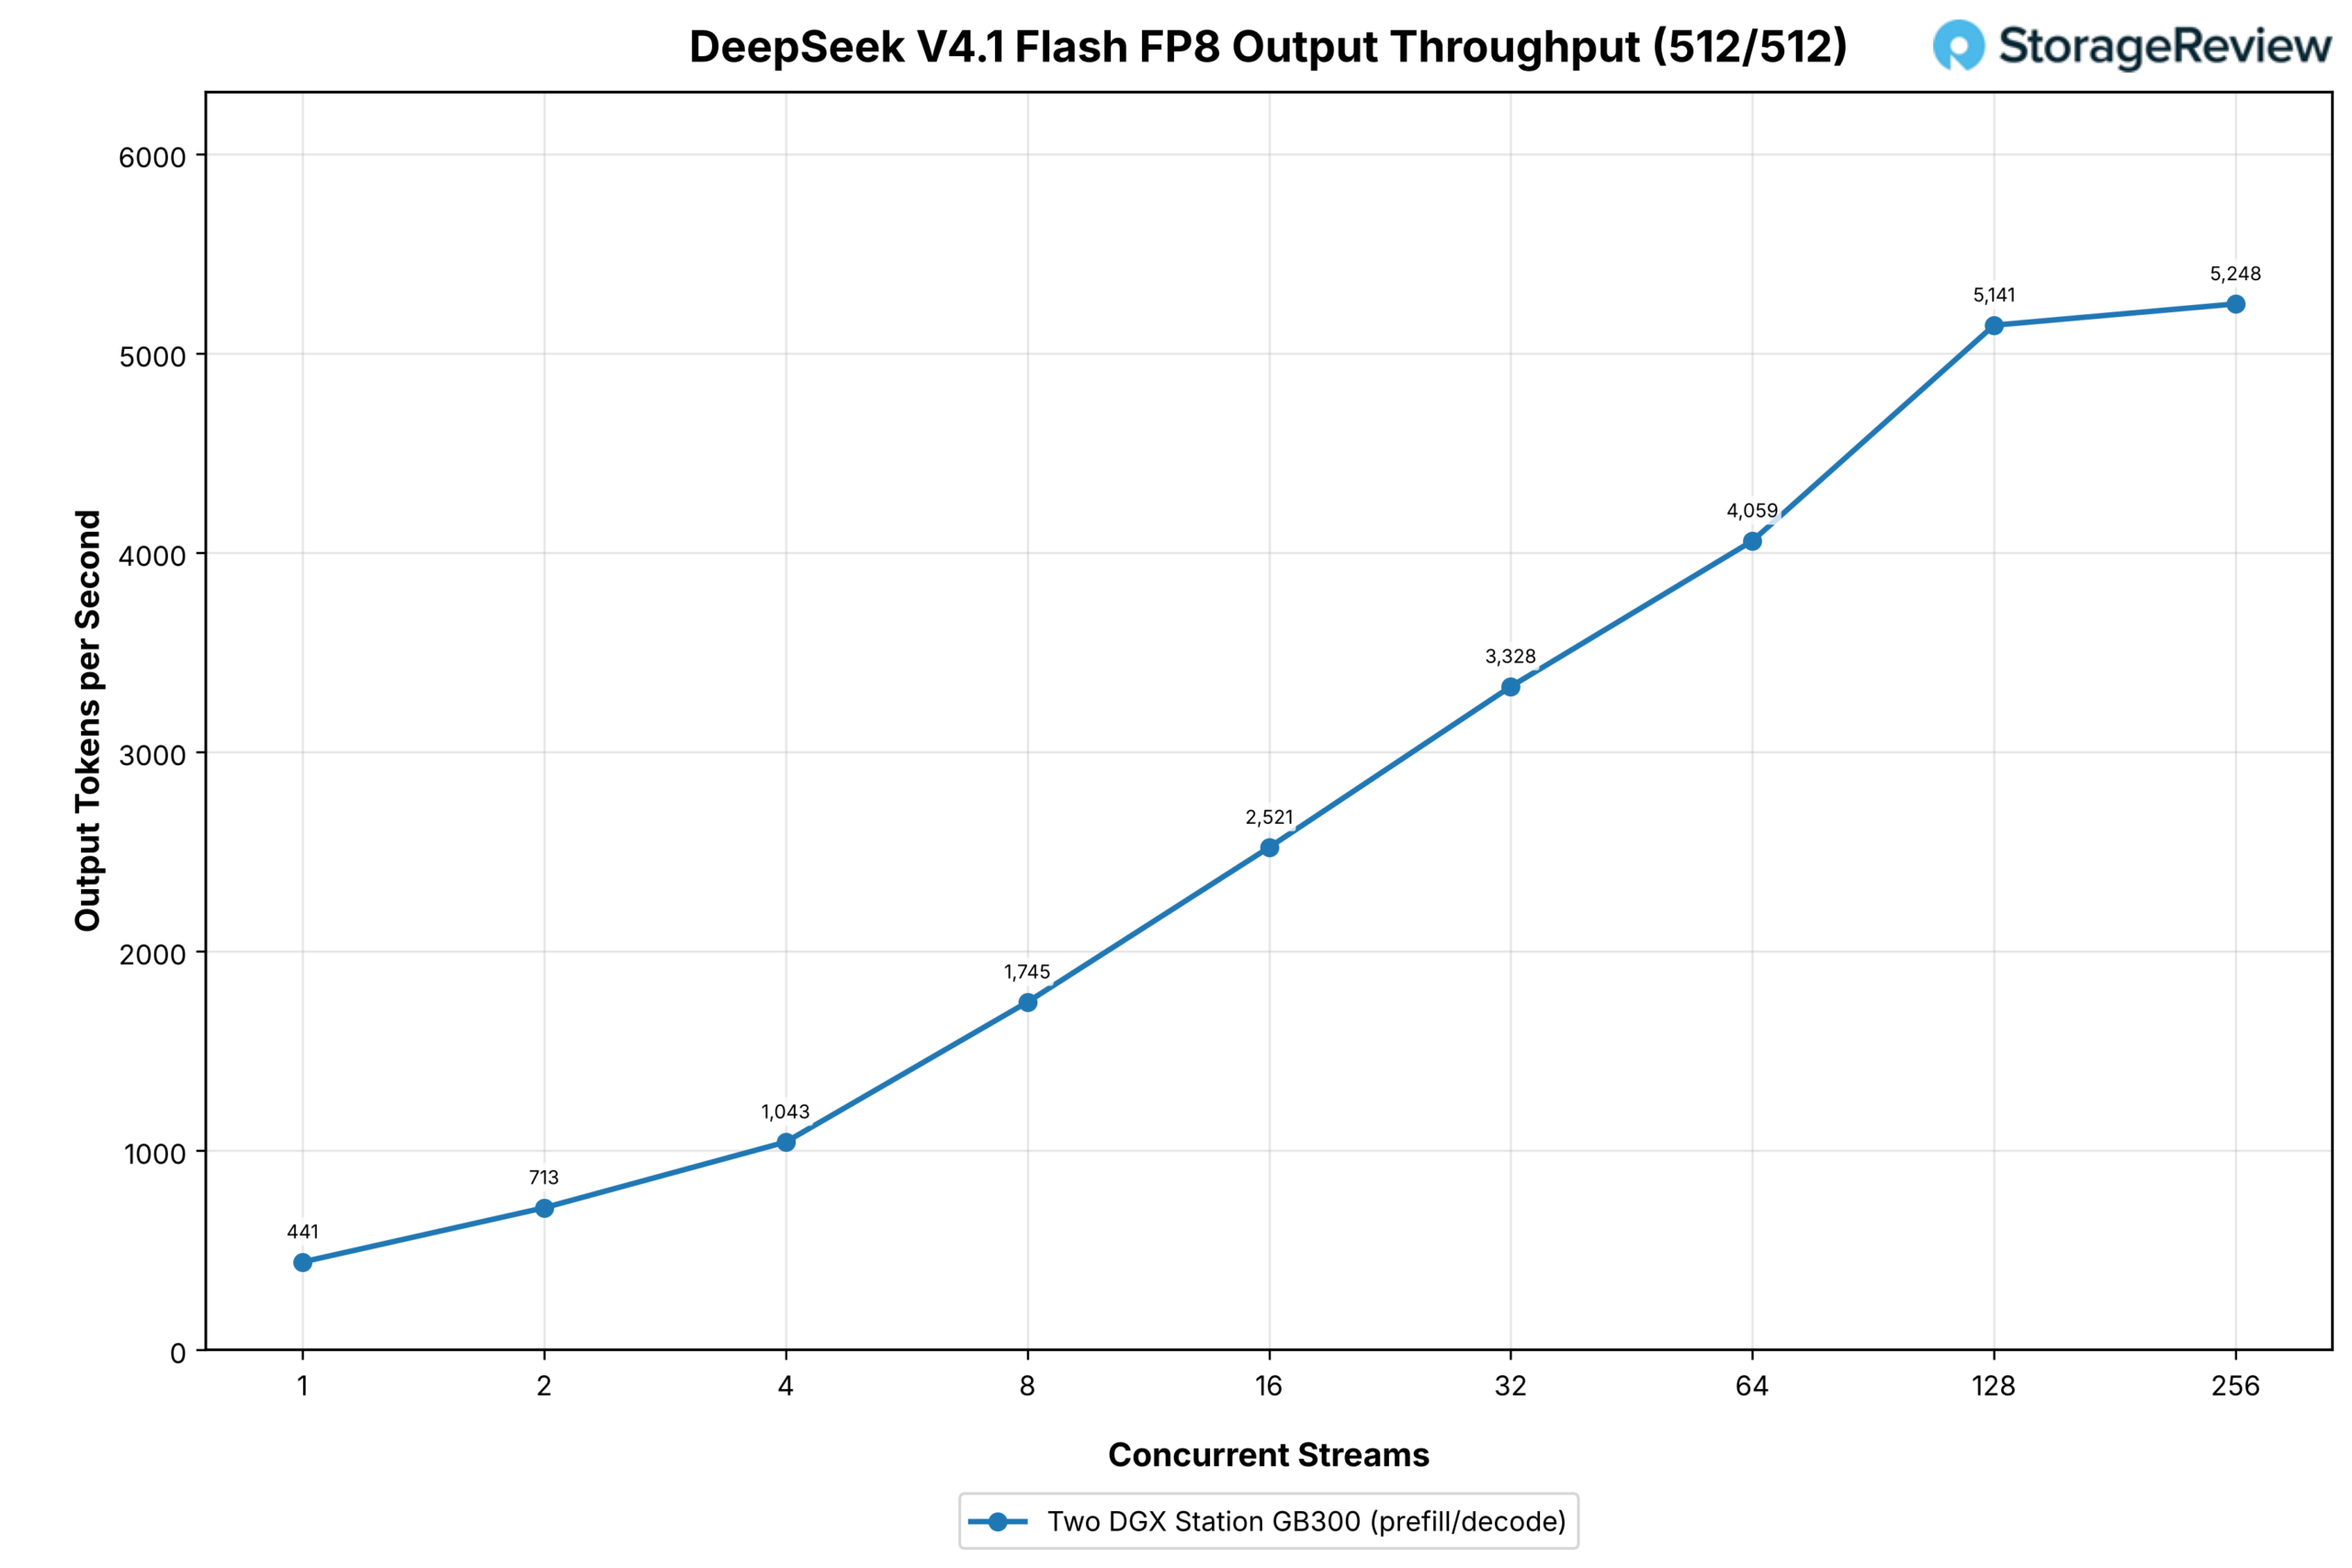
DeepSeek V4.1 Flash 採用分離式運行,一個工作站負責預填充,另一個負責解碼,每個工作站都保存著模型的完整副本:兩個 FP8 Engram 表,總計 188.84GiB,存儲在 Grace 內存中,另有 131.97GB 的專家權重卸載到 Grace 內存中。這使得它成為該系列中唯一兩台機器都使用 Grace 記憶體的配置。同時,它也是這裡唯一沒有單一工作站配置的型號,因為華碩的評測使用的是早期的 V4 Flash 檢查點,兩者不具有直接可比性。
在雙Station叢集上,原生FP8型號在單流模式下每秒輸出441個令牌,在32流模式下達到每秒3,328個令牌,在128流模式下達到每秒5,141個令牌,在256流模式下達到每秒5,248個令牌,是該系列所有型號中輸出吞吐量最高的,曲線僅在峰值處略有趨平緩。作為參考,在我們先前的評測中,單台華碩Station在32流模式下處理V4 Flash時,每秒輸出代幣數為1,766個。
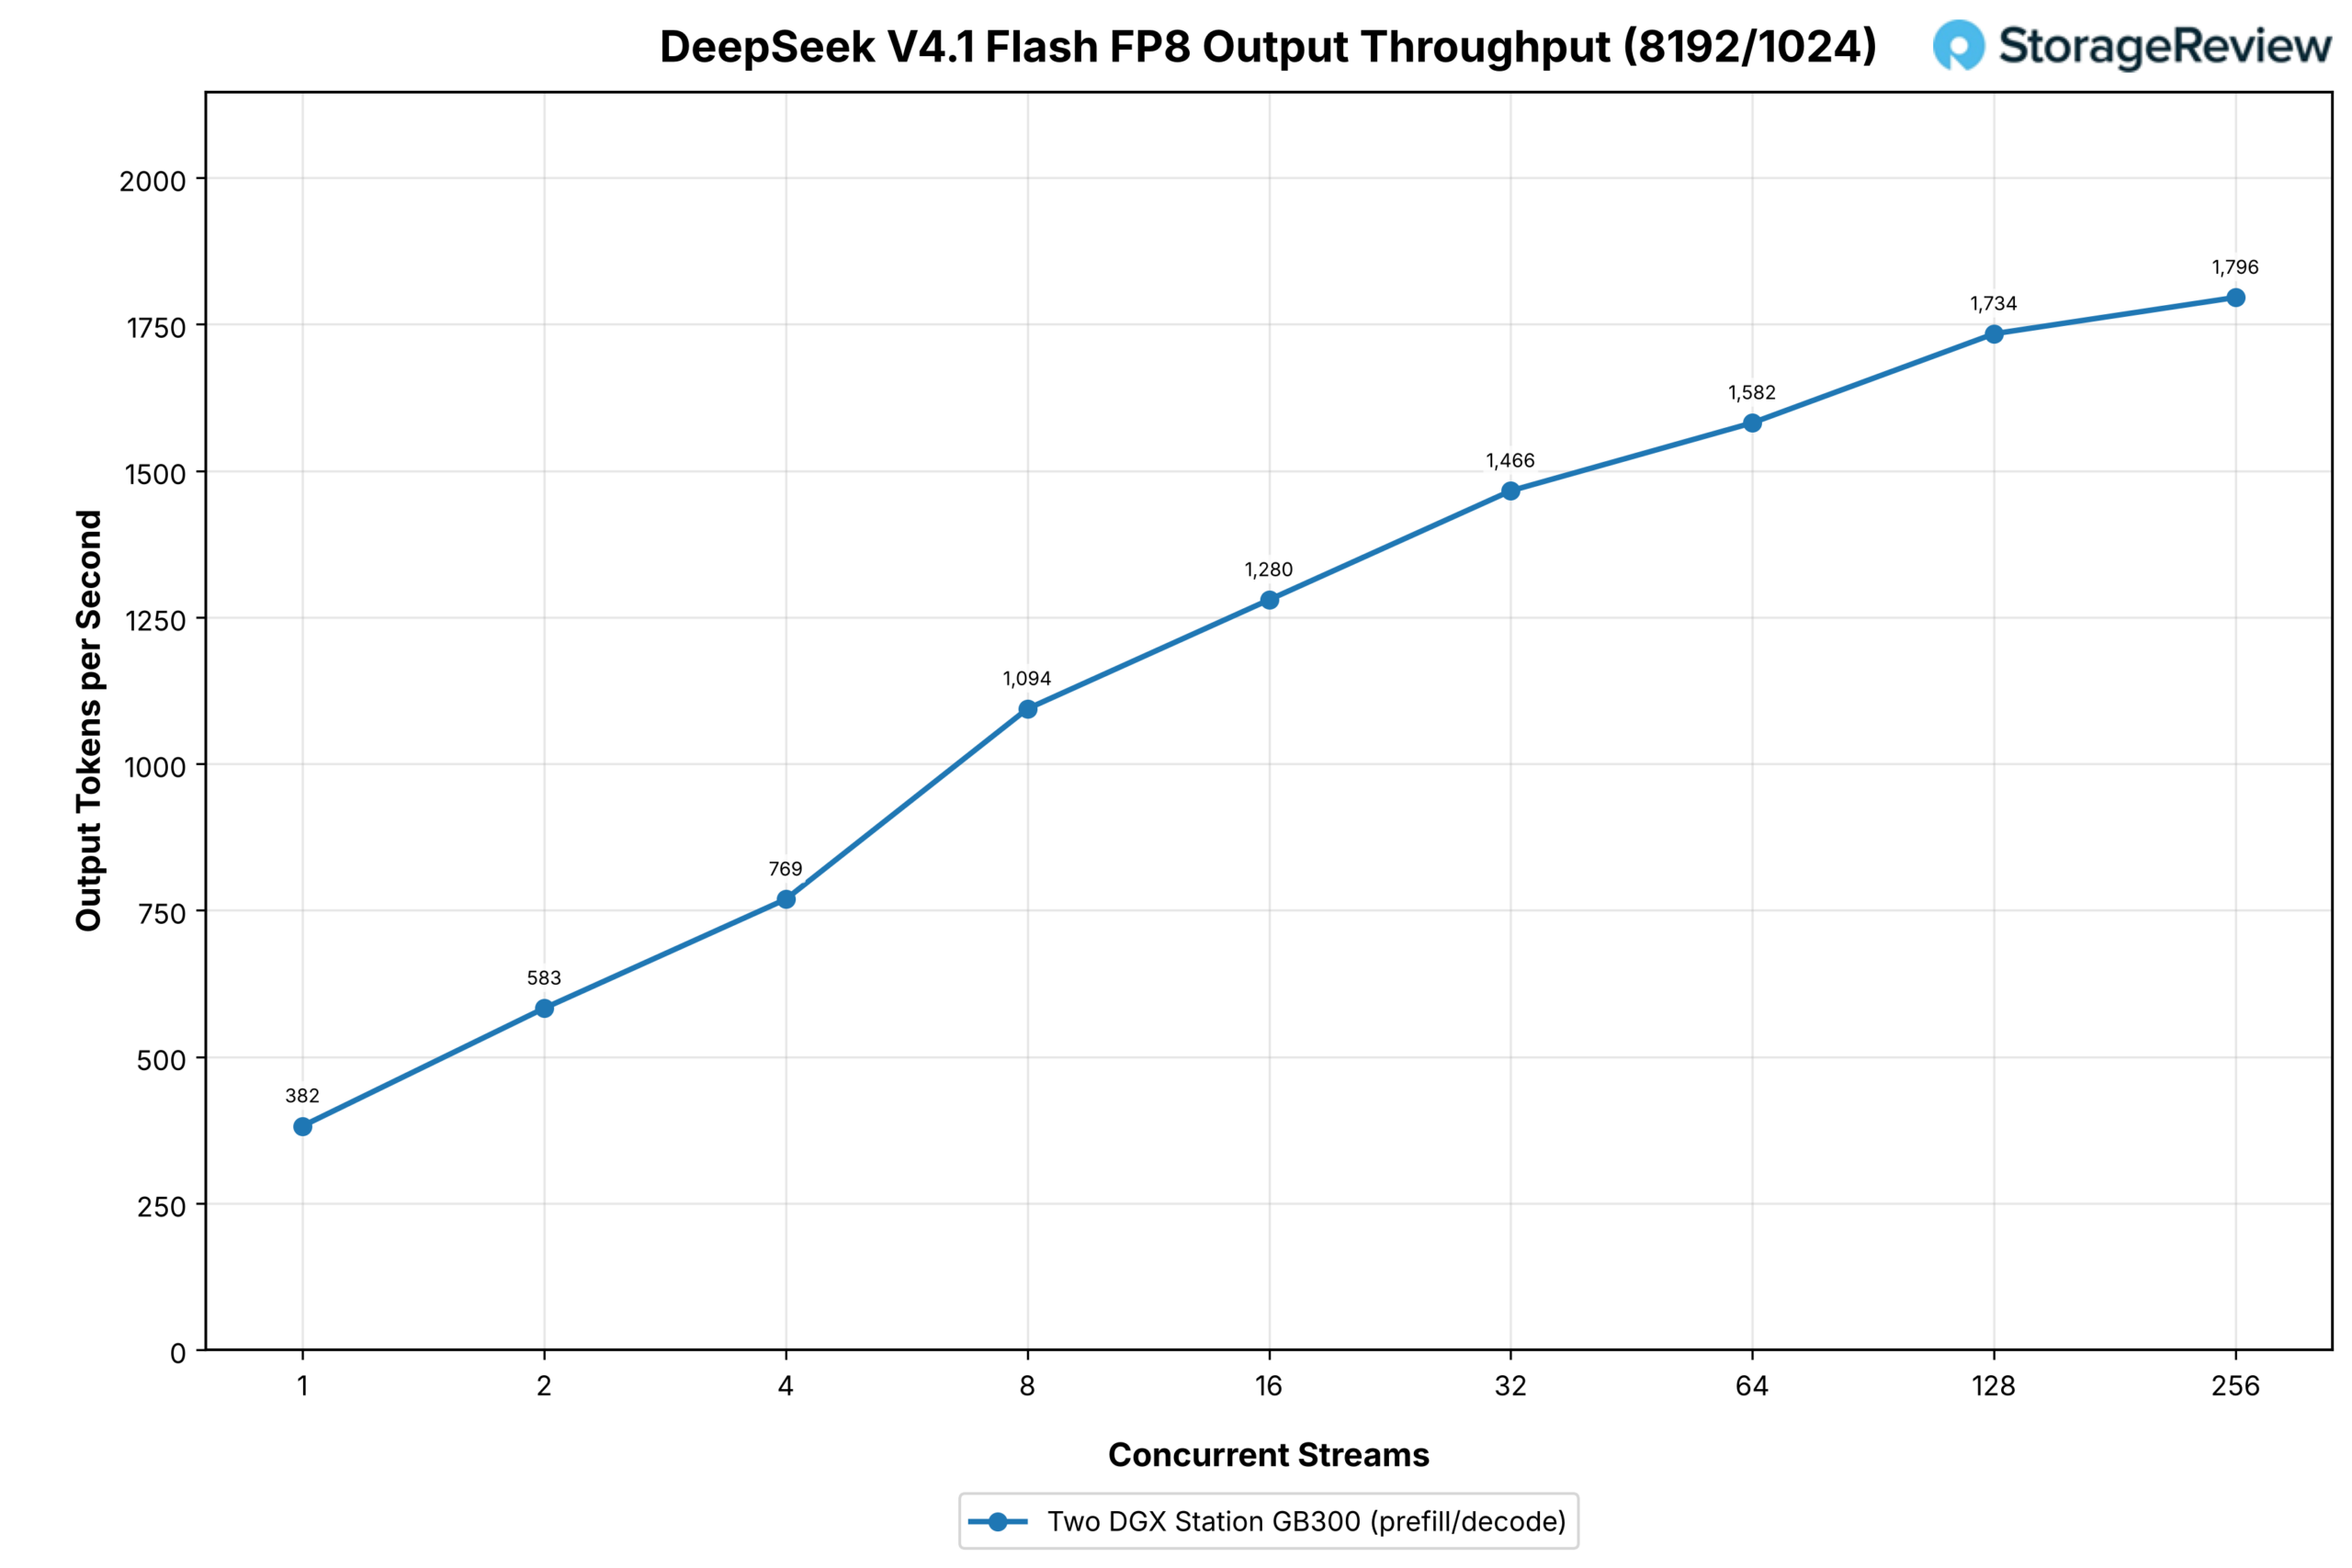
在預填較多的場景下,群集單流輸出速度從每秒 382 個輸出標記提升至每秒 1,466 個(32 個流),以及每秒 1,796 個(256 個流)。由於每個請求攜帶 8,192 個輸入標記,因此在測試高峰期,總吞吐量達到了每秒 16,163 個標記。由於每個 Station 的 Grace 記憶體中都儲存著 Engram 表和 131.97GB 的專家權重,因此無論採用何種配置,曲線在整個測試過程中都保持平滑。
GLM-5.3
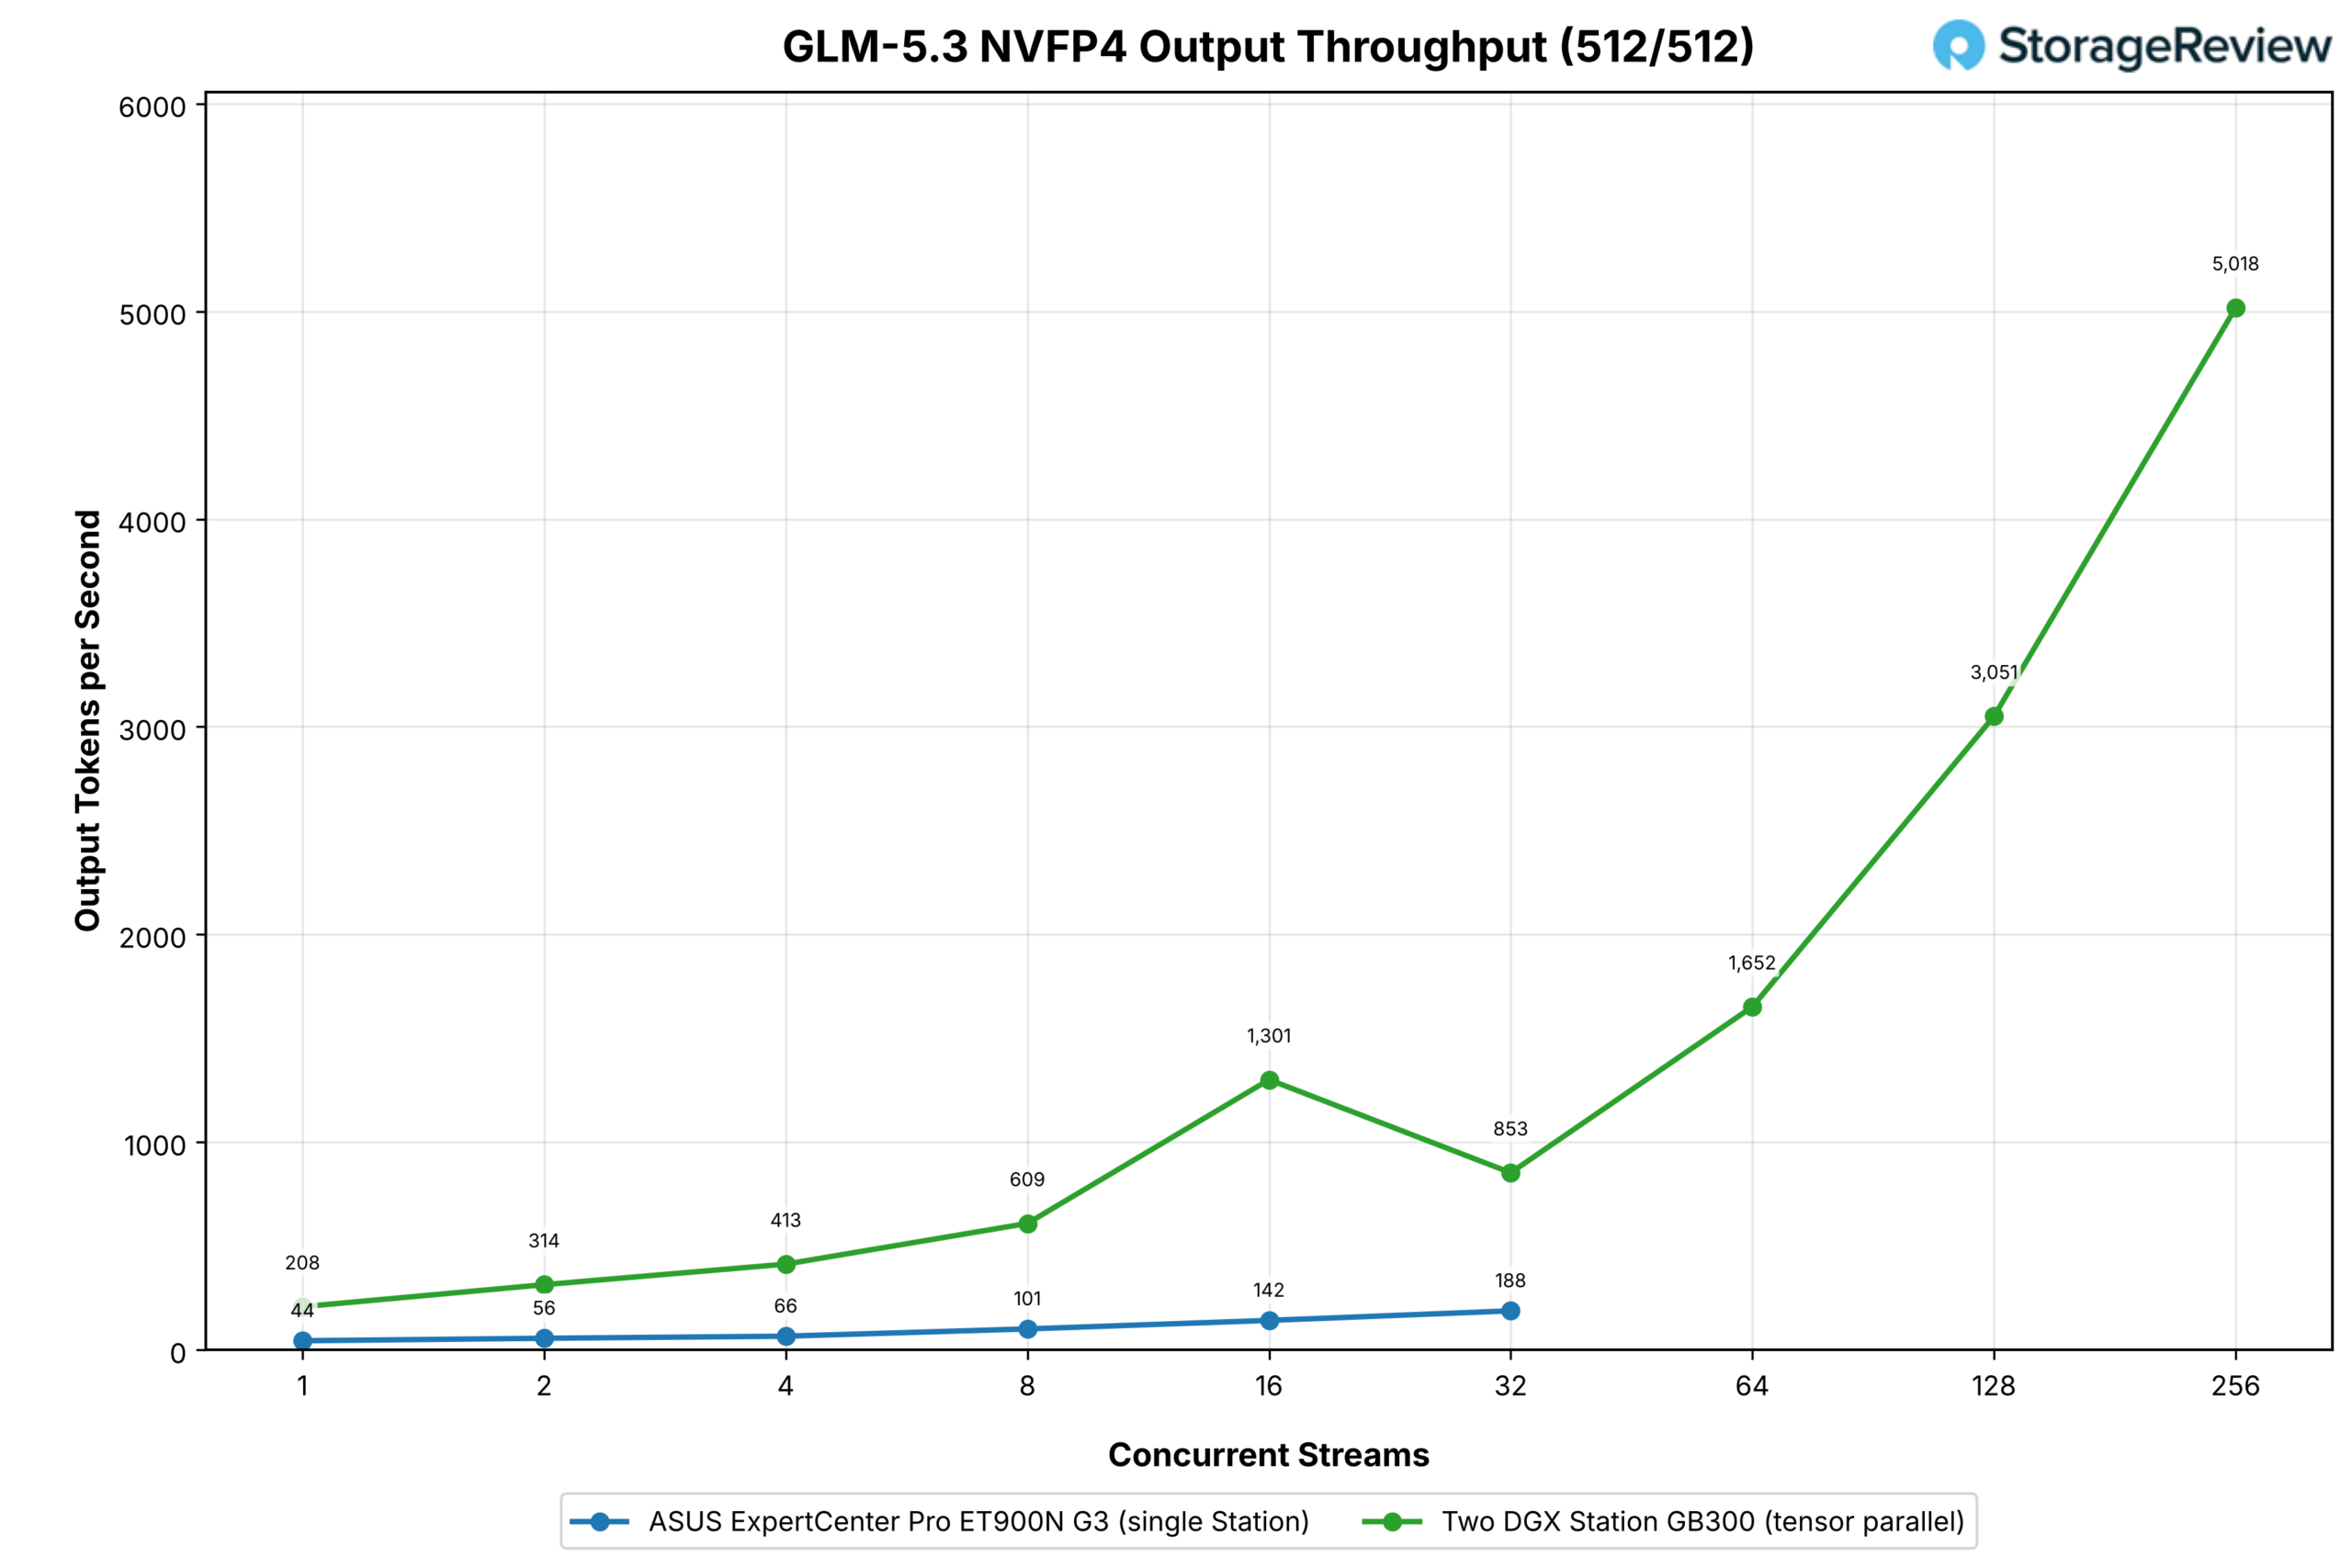
GLM-5.3 在 TP2 中運行,未啟用 Grace 卸載。在單一工作站上,它將 215GB 的專家權重卸載到 Grace 記憶體中,叢集結果在大部分掃描過程中與 GLM-5.2 的結果一致,之後開始出現不平衡。單一工作站的運作速度從單流每秒 44 個輸出標記提升到相同工作負載下每流 32 個輸出標記每秒 188 個。
雙站點群集在單流處理時處理量為 208,在 16 流處理時達到 1,301,是單站點群集的 4.7 倍到 9.2 倍,在 32 流處理時達到 853,然後開始回升,在 64 流處理時達到 1,652,在 128 流處理時達到 1652, 5,018。32 流處理時的數據點是收集到的數據;隨著並發量的增加,批次決策和內核選擇都會發生變化,而且張量並行部署會在每一層添加一個集體處理,該處理必須在下一步之前完成,因此曲線並非直線,但 256 流處理時的峰值是單站點集群在 32 倍流處理時達到的 27 倍集群。
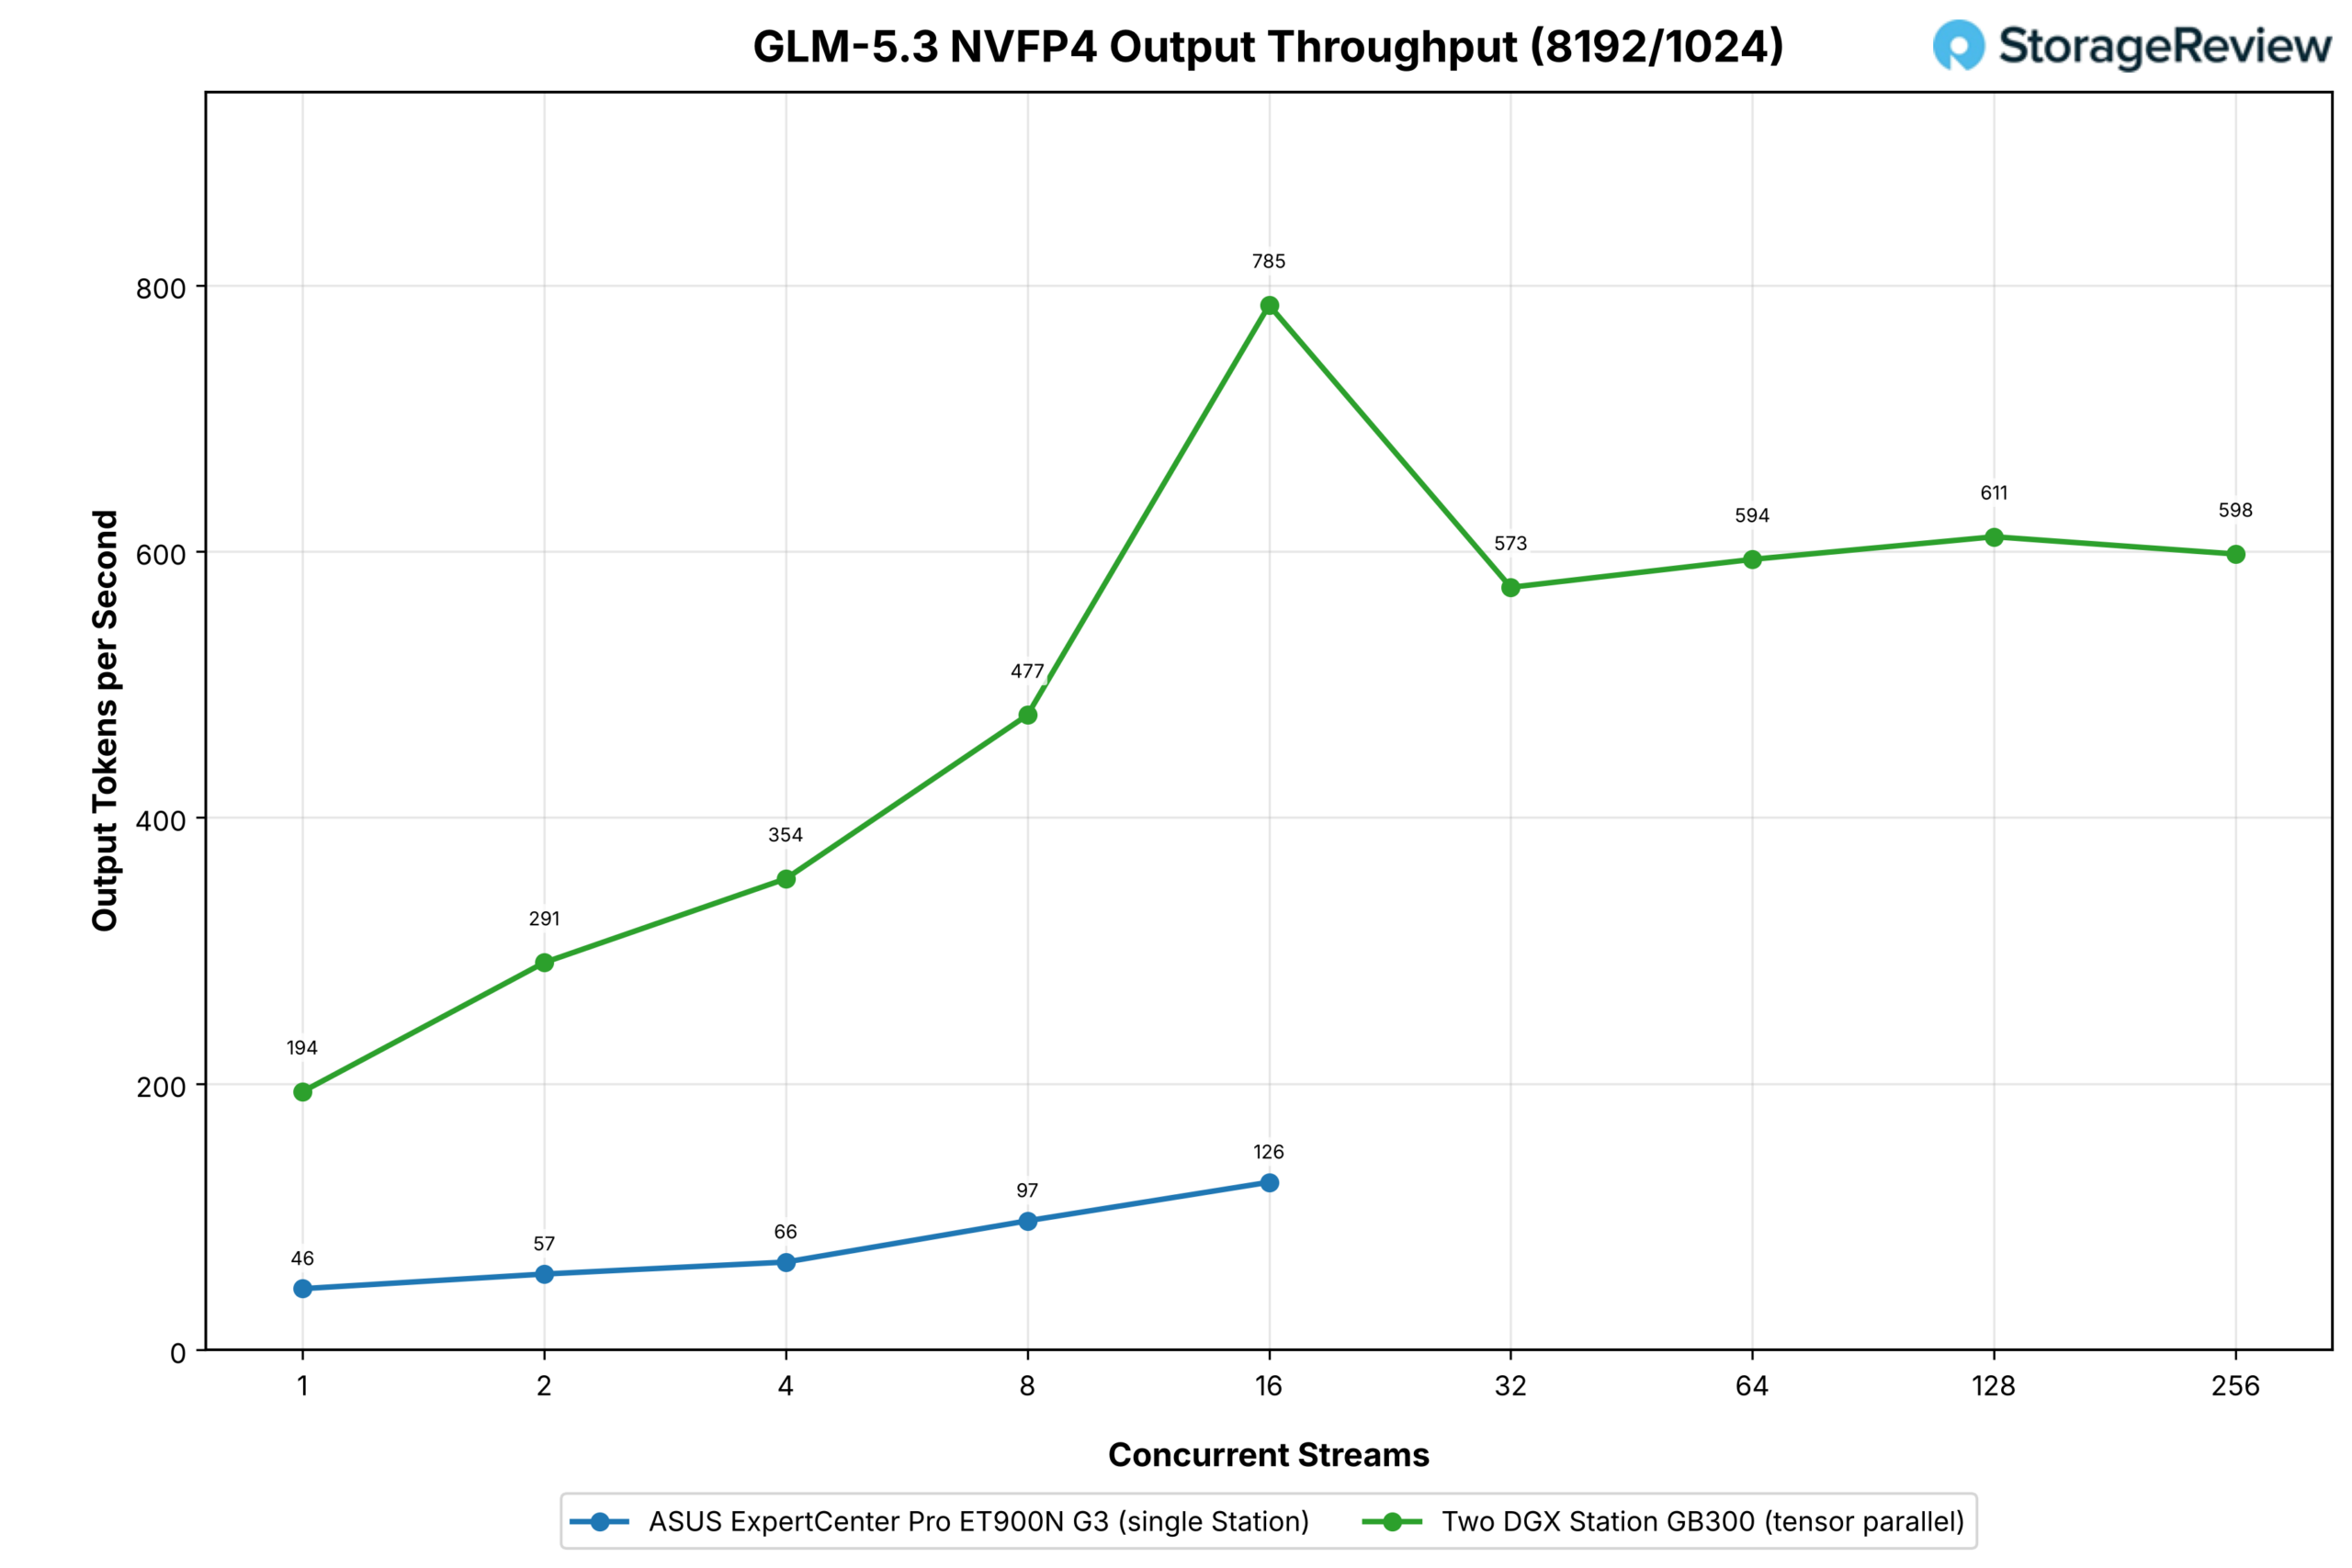
在預填充密集型場景下,單一 Station 的並發流數量設定為 16 個:卸載模型的效能會很快趨於平緩,進一步提升並發量意義不大。其輸出令牌數從單一流時的每秒 46 個提升到 16 個流時的每秒 126 個。群集在同一範圍內從每秒 194 個令牌提升到每秒 785 個令牌,最高時提升了 6.2 倍,然後在 32 個流到 256 個流的範圍內穩定在每秒 573 個令牌到 611 個令牌之間,長單上限下的輸出令牌數接近最佳 600 個令牌,仍然是單上限。
GLM-5.3 閃光燈
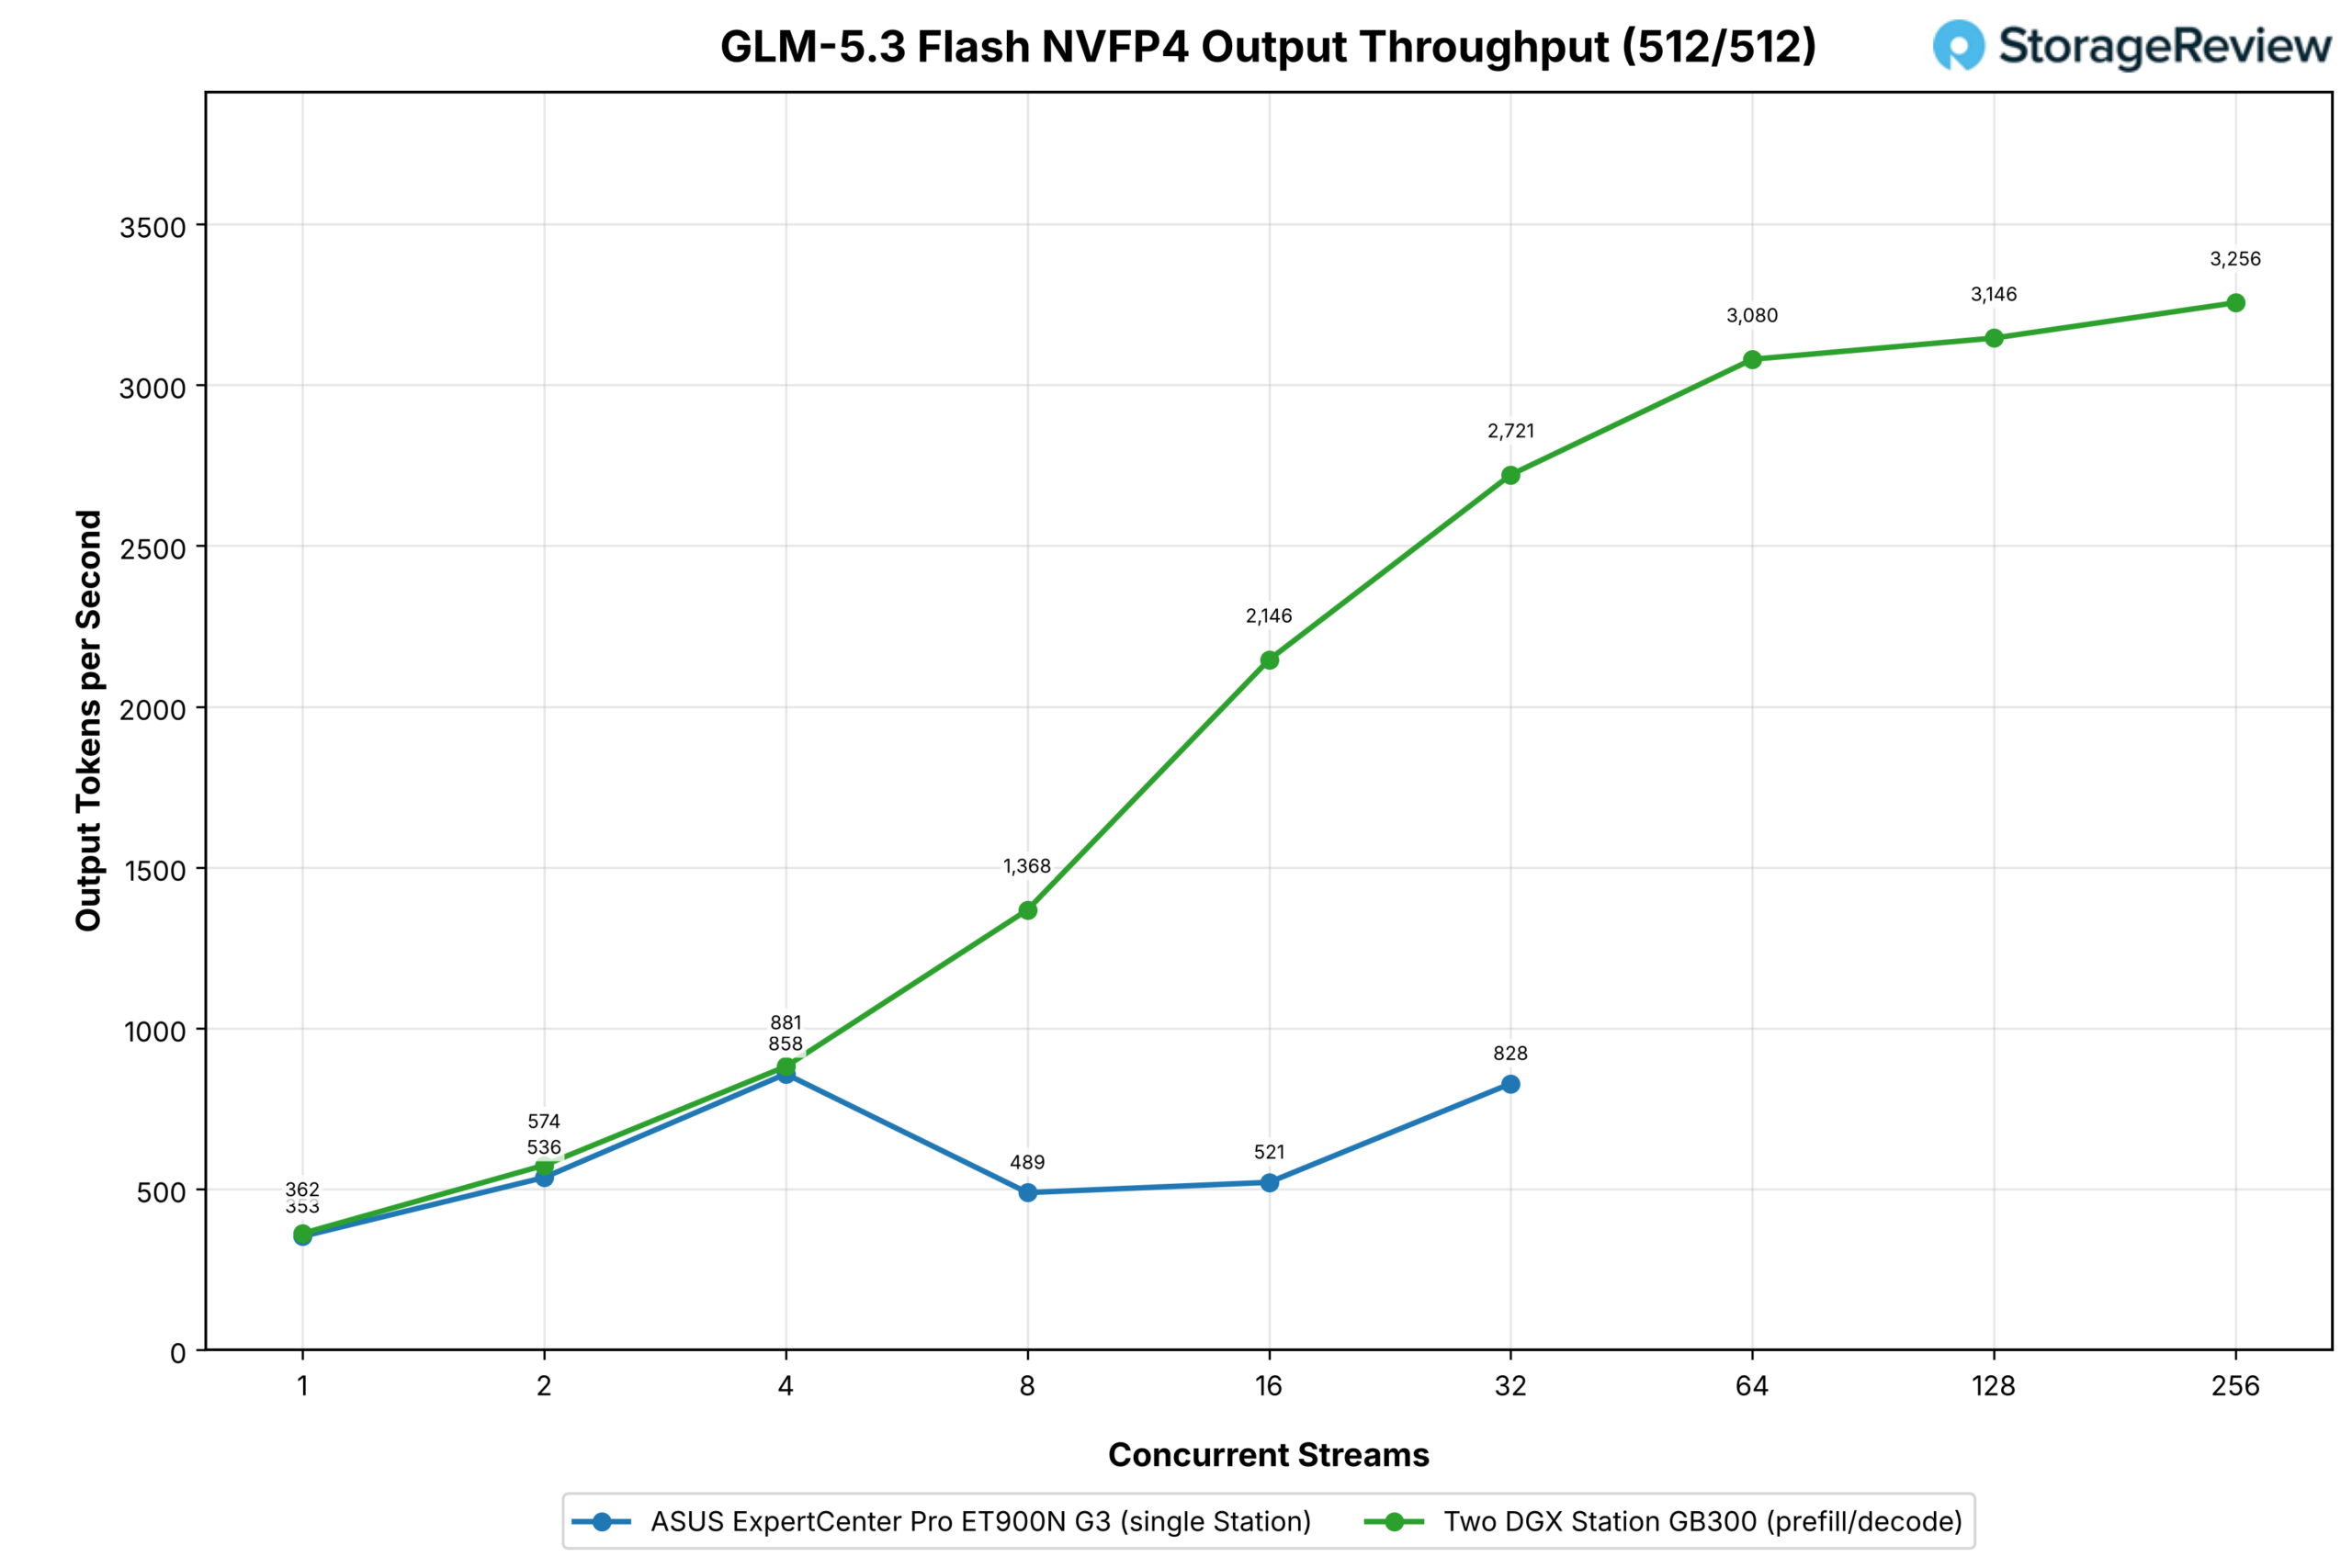
GLM-5.3 Flash 的容量足夠小,每個工作站都能儲存完整副本,因此採用分離式運作方式,由華碩工作站負責預填充,惠普工作站負責解碼。 Flash 的活動參數數量較少,因此在單個工作站上運行速度已經很快:單流模式下每秒輸出 353 個令牌,32 流模式下每秒輸出 828 個令牌,中間部分輸出不均勻(四流模式下每秒輸出 858 個令牌,八流模式下每秒輸出 489 個令牌),我們已將這部分數據記錄為已收集的數據。
在分離的對中,相同的工作負載從單流每秒 362 個輸出令牌增加到 32 個流每秒 2,721 個輸出令牌,是單塔的 3.3 倍,再到 256 個流每秒 3,256 個輸出令牌。
在單流和雙流情況下,這對組合幾乎完全匹配單個站點,這是解碼站點單獨執行相同工作時所預期的結果;一旦有足夠的請求在進行中,預填充站點就會保持忙碌,解碼站點也會受益於無需暫停進行預填充,從而獲得增益。
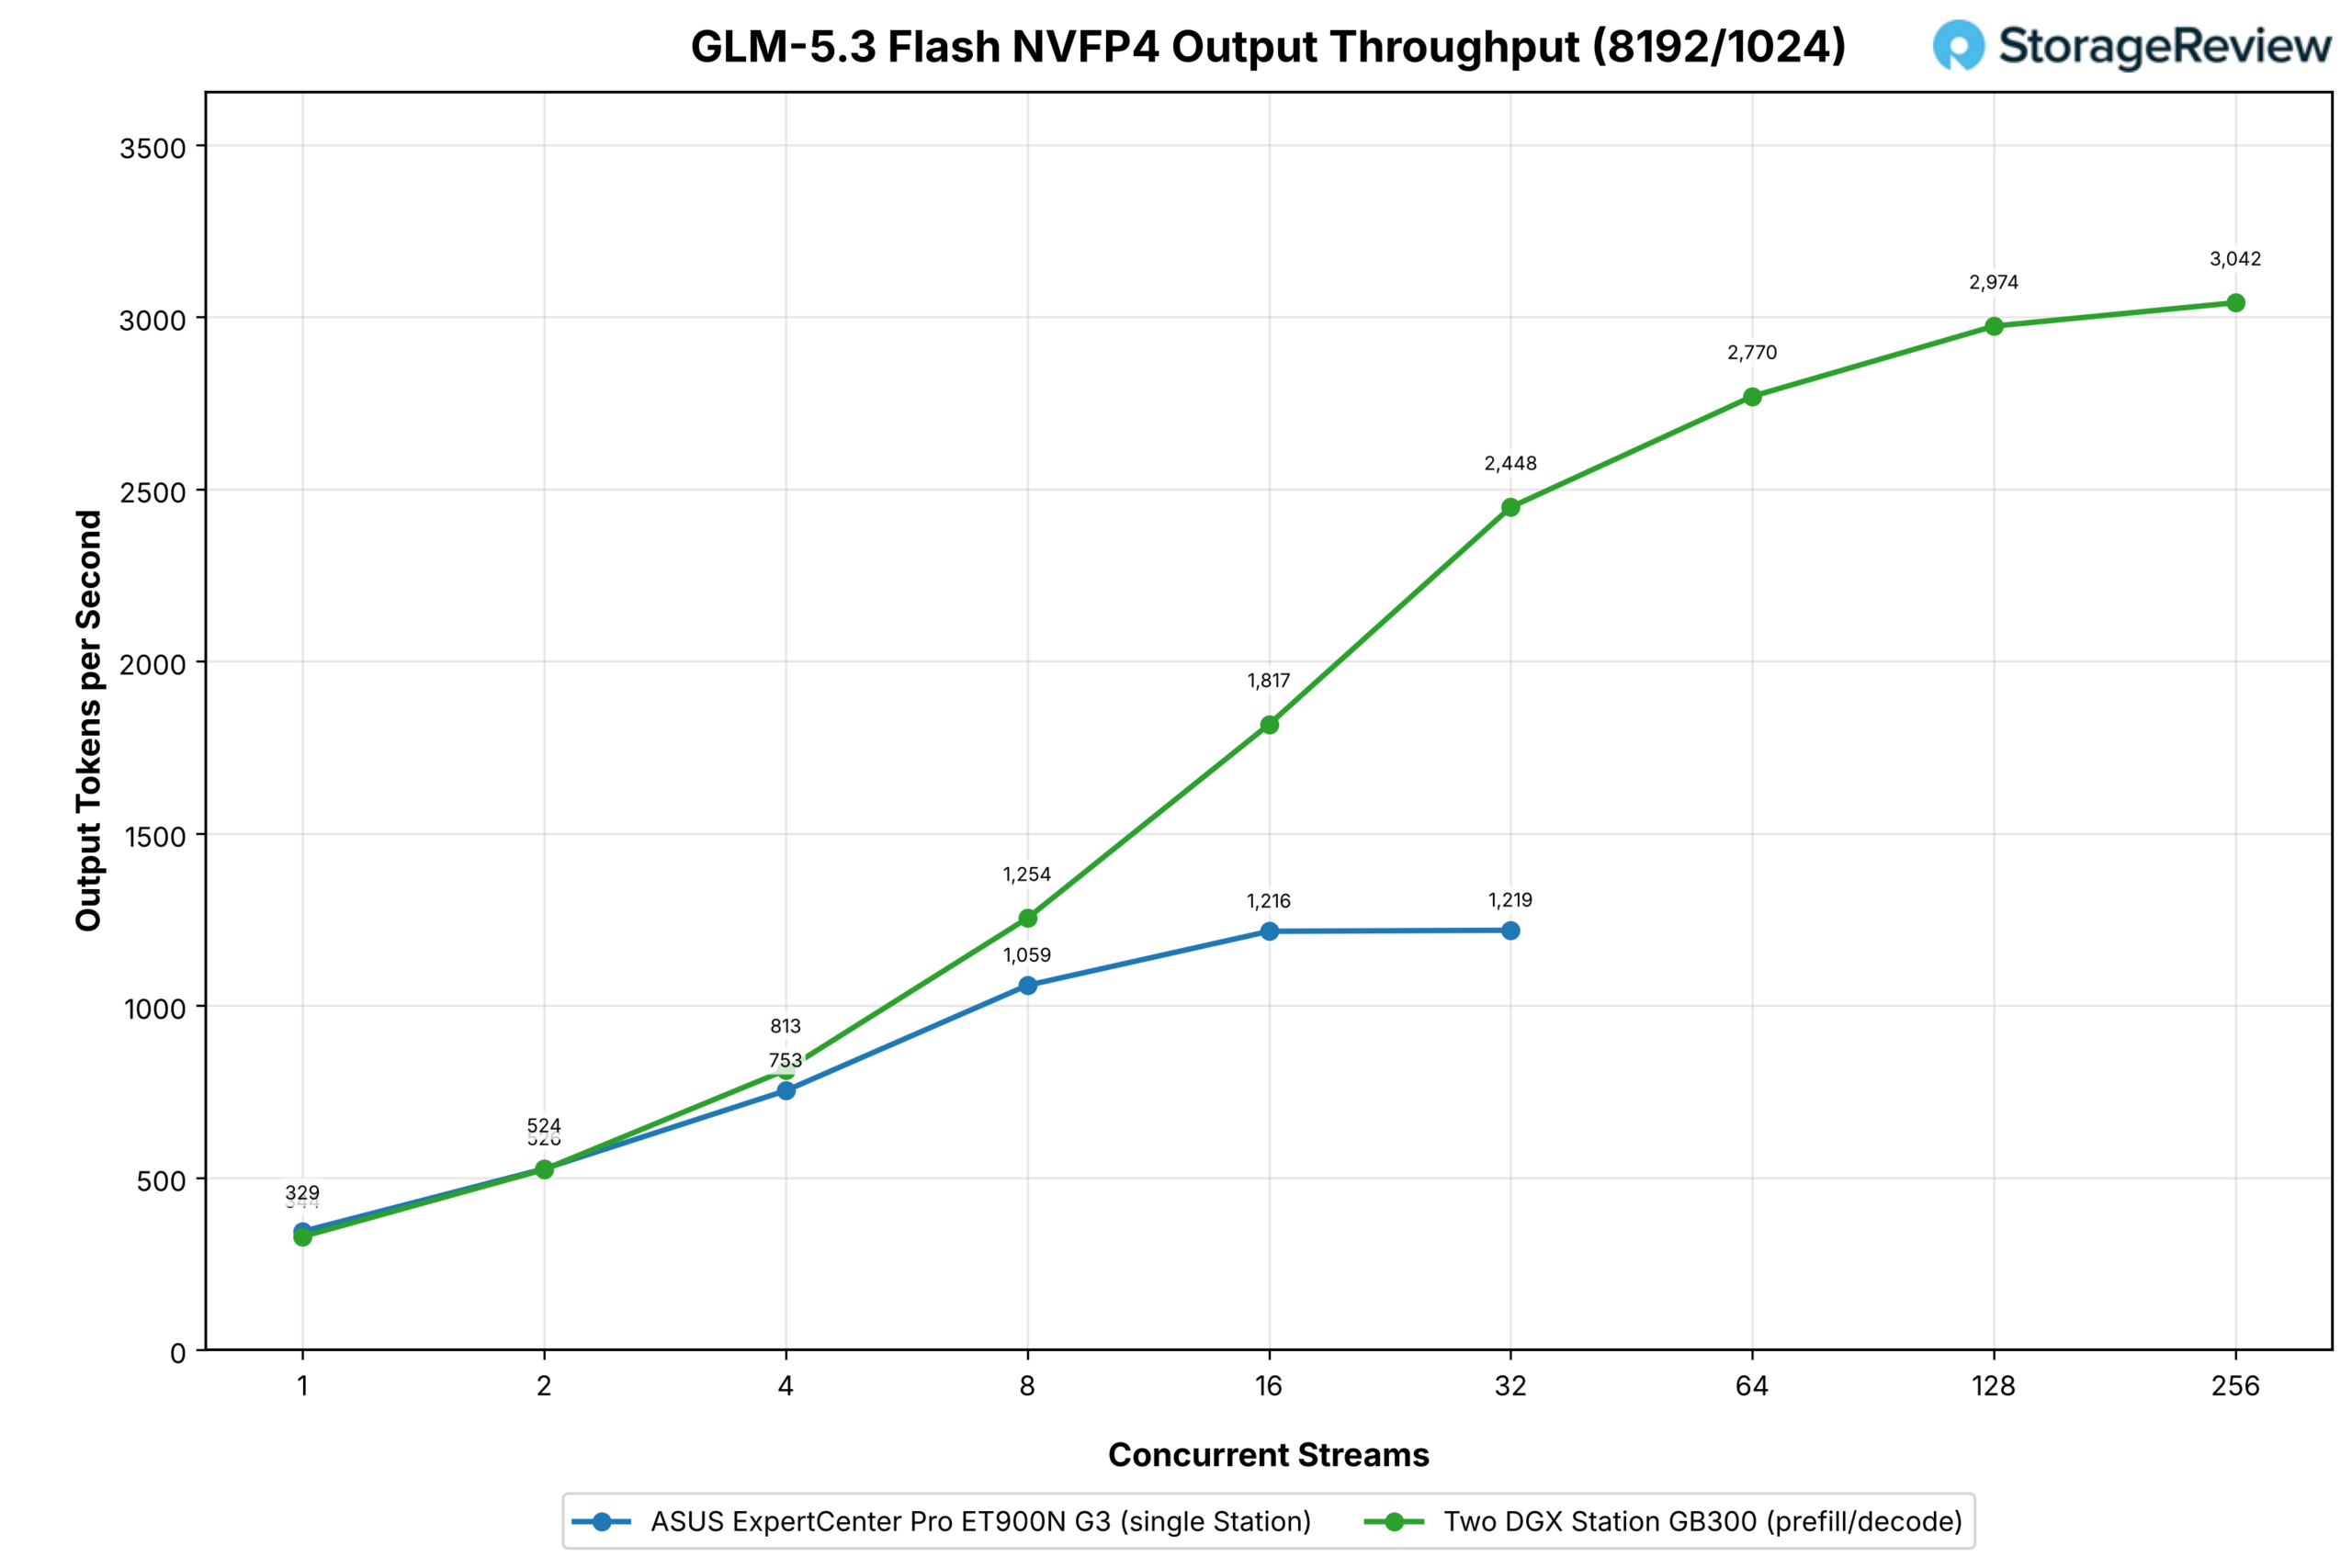
在預填充密集型場景下,單一工作站的輸出令牌處理量從單流時的每秒 344 個提升到 16 流時的每秒 1,216 個,並在 32 流時保持在每秒 1,219 個,之後從 16 流開始趨於穩定。預填充/解碼組合的輸出處理量持續攀升,從單流時的每秒 329 個提升到 32 流時的每秒 2,448 個,是單一工作站輸出處理量穩定時的兩倍,並在 256 流時達到每秒 3,042 個。這種分離式架構正是為了應對長提示符的情況而設計的,因為預填充工作站可以處理長達 8,192 個令牌的提示符,而解碼工作站的鍵值快取和運算則保持生成狀態。
GLM-5.2
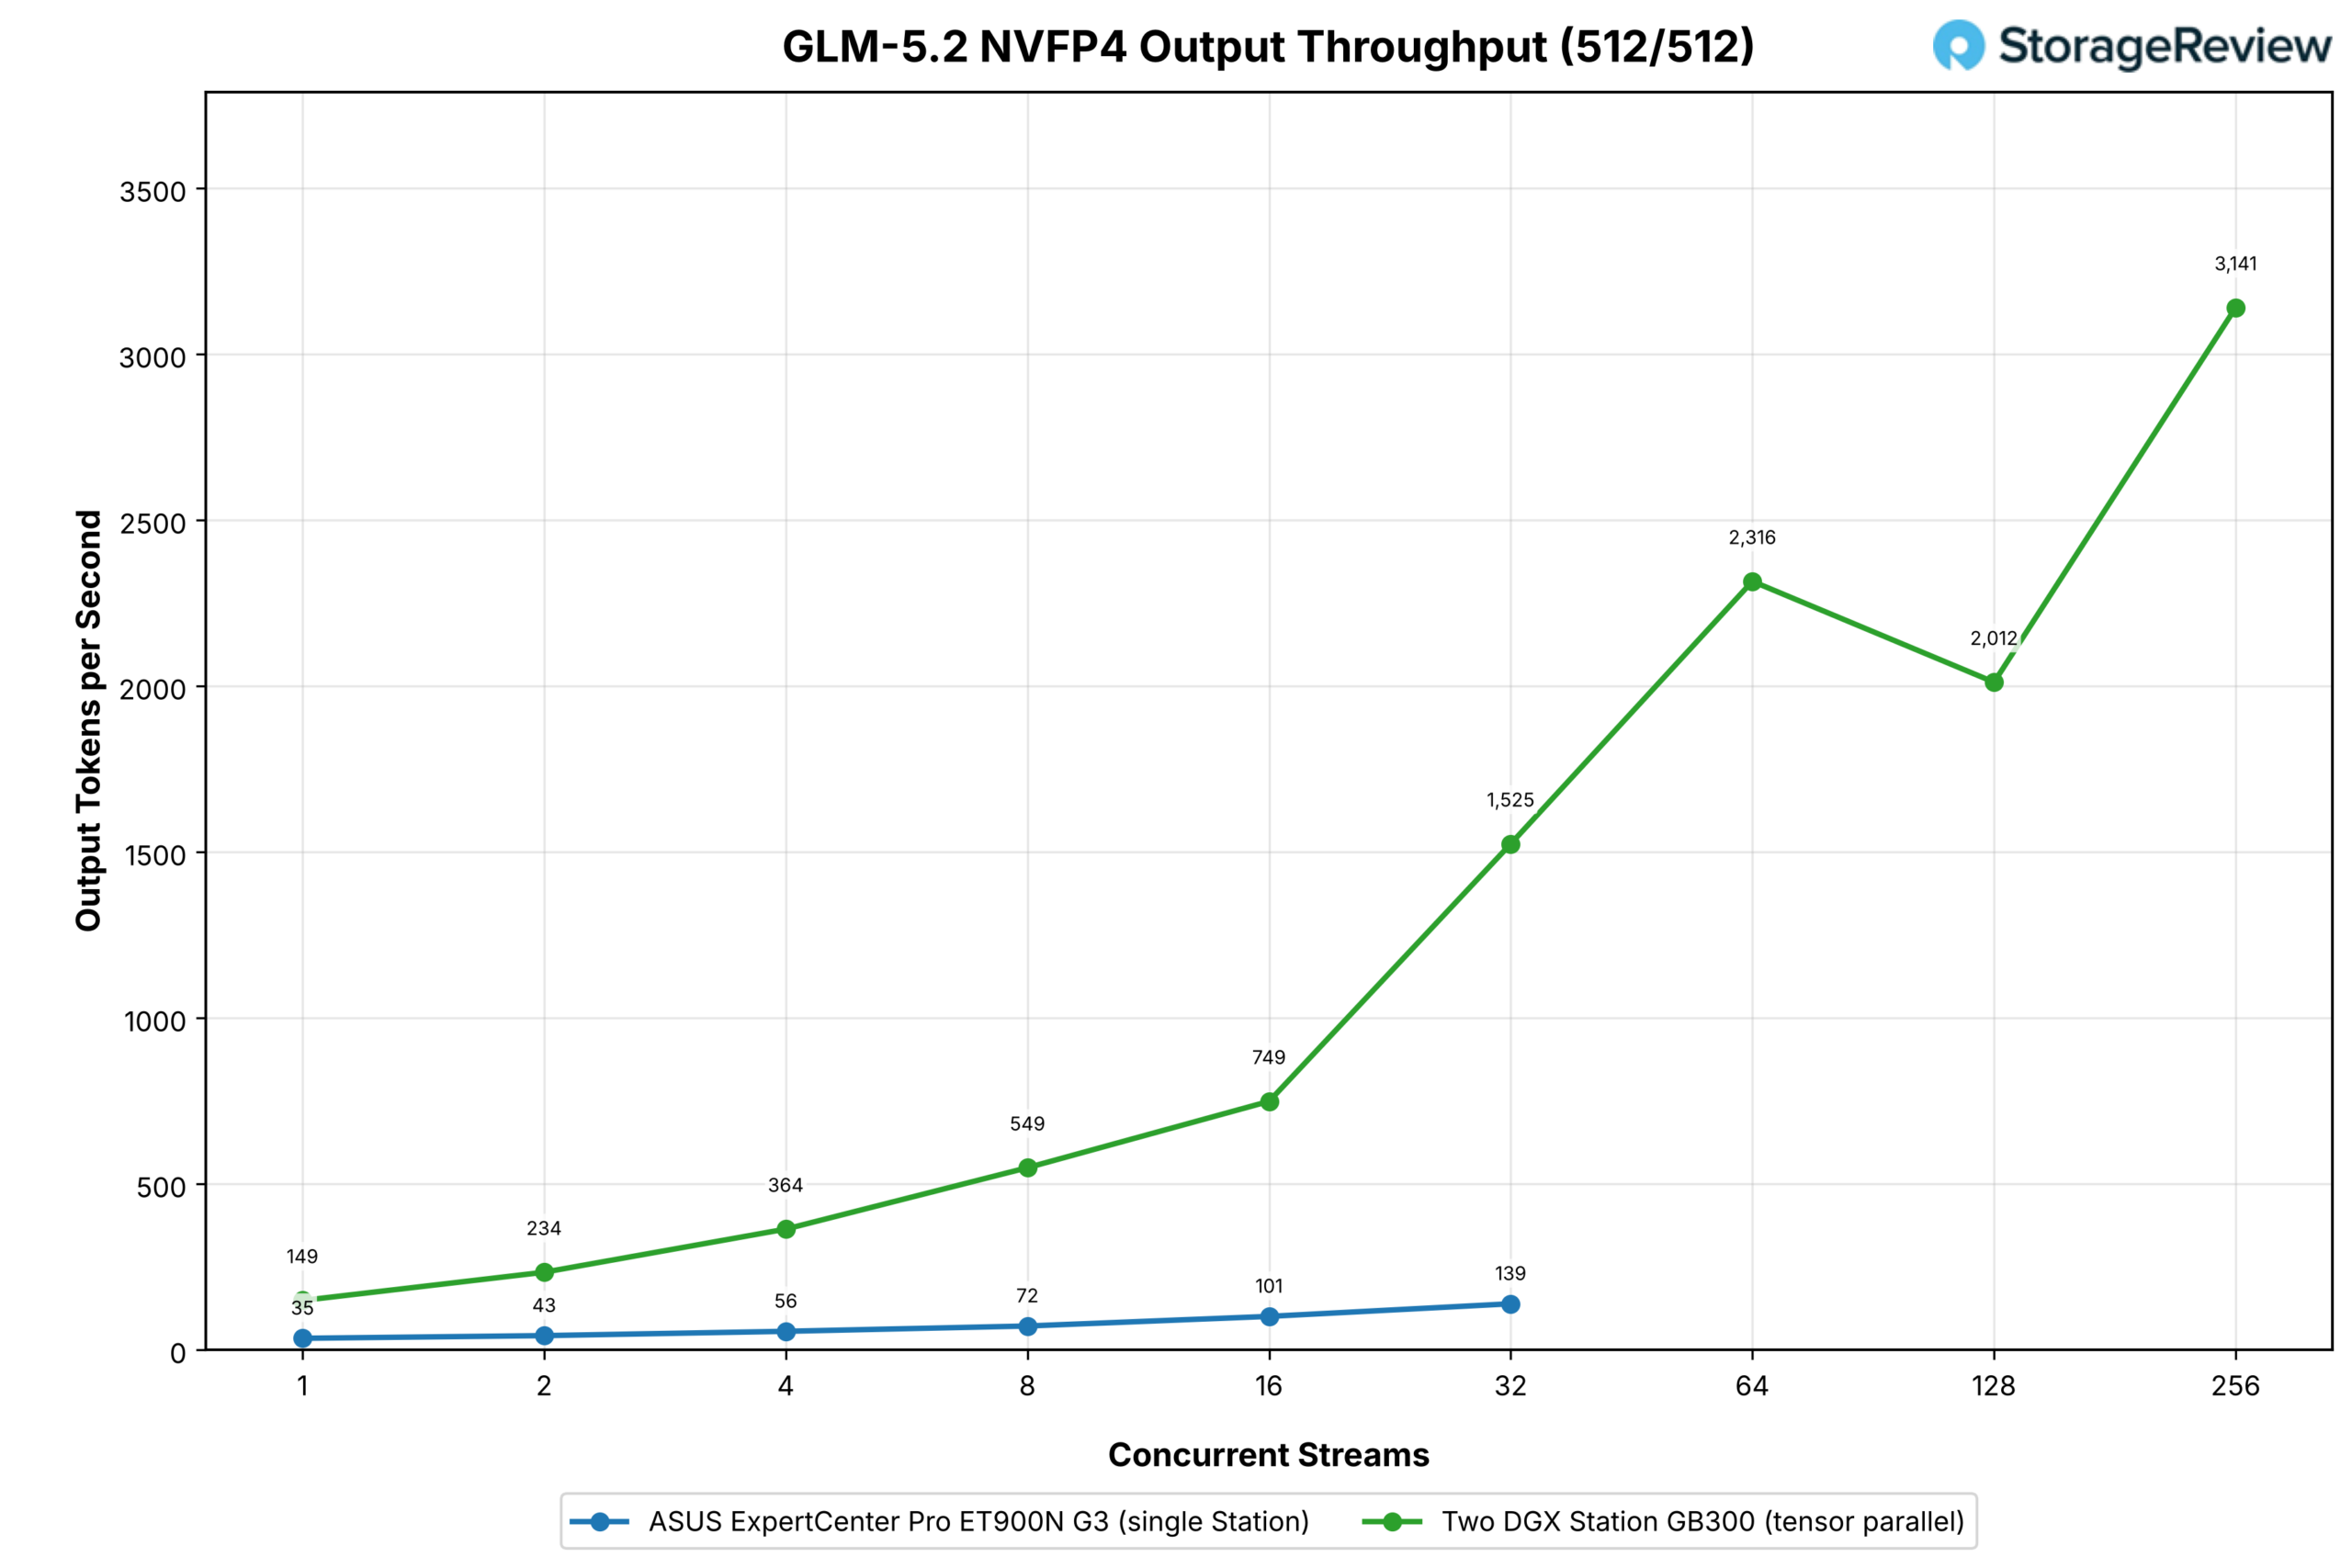
GLM-5.2 在 TP2 模式下運行,叢集未啟用 Grace 卸載,它是最能證明需要第二個 Station 的模型。 NVFP4 檢查點大小約為 433GB,因此在單一 GB300 上,大約 215GB 的專家權重儲存在 Grace 記憶體中,每個涉及這些權重的解碼步驟都會透過 NVLink-C2C 以 396GB/s 的速度傳輸到 LPDDR5X 記憶體。模型分佈在兩個 Station 上,每個 B300 大約可以儲存一半的 HBM3e 記憶體。
在相同的工作負載下,單一 ET900N G3 在單流模式下每秒輸出 35 個令牌,在 32 流模式下每秒輸出 139 個令牌。雙站集群在單流模式下初始輸出速度為每秒 149 個令牌,是單塔的 4.3 倍;在 32 流模式下達到每秒 1,525 個令牌,是單塔的 11 倍;之後性能持續攀升,在 64 流模式下達到每秒 2,316 個令牌,在 256 18 個令牌下達到每秒 2316 個令牌,在 256 141 個令牌,但均超過了 256 181 個令牌,但均超過了 256 181 個令牌,但均超過了 256 181 個令牌,但均超過了 256381 個令牌,但均在工作站流模式下略有下降,為每秒 2,012 個令牌。單一工作站能夠以對話速度服務少數使用者的模式,在雙站叢集下可以服務一個部門。
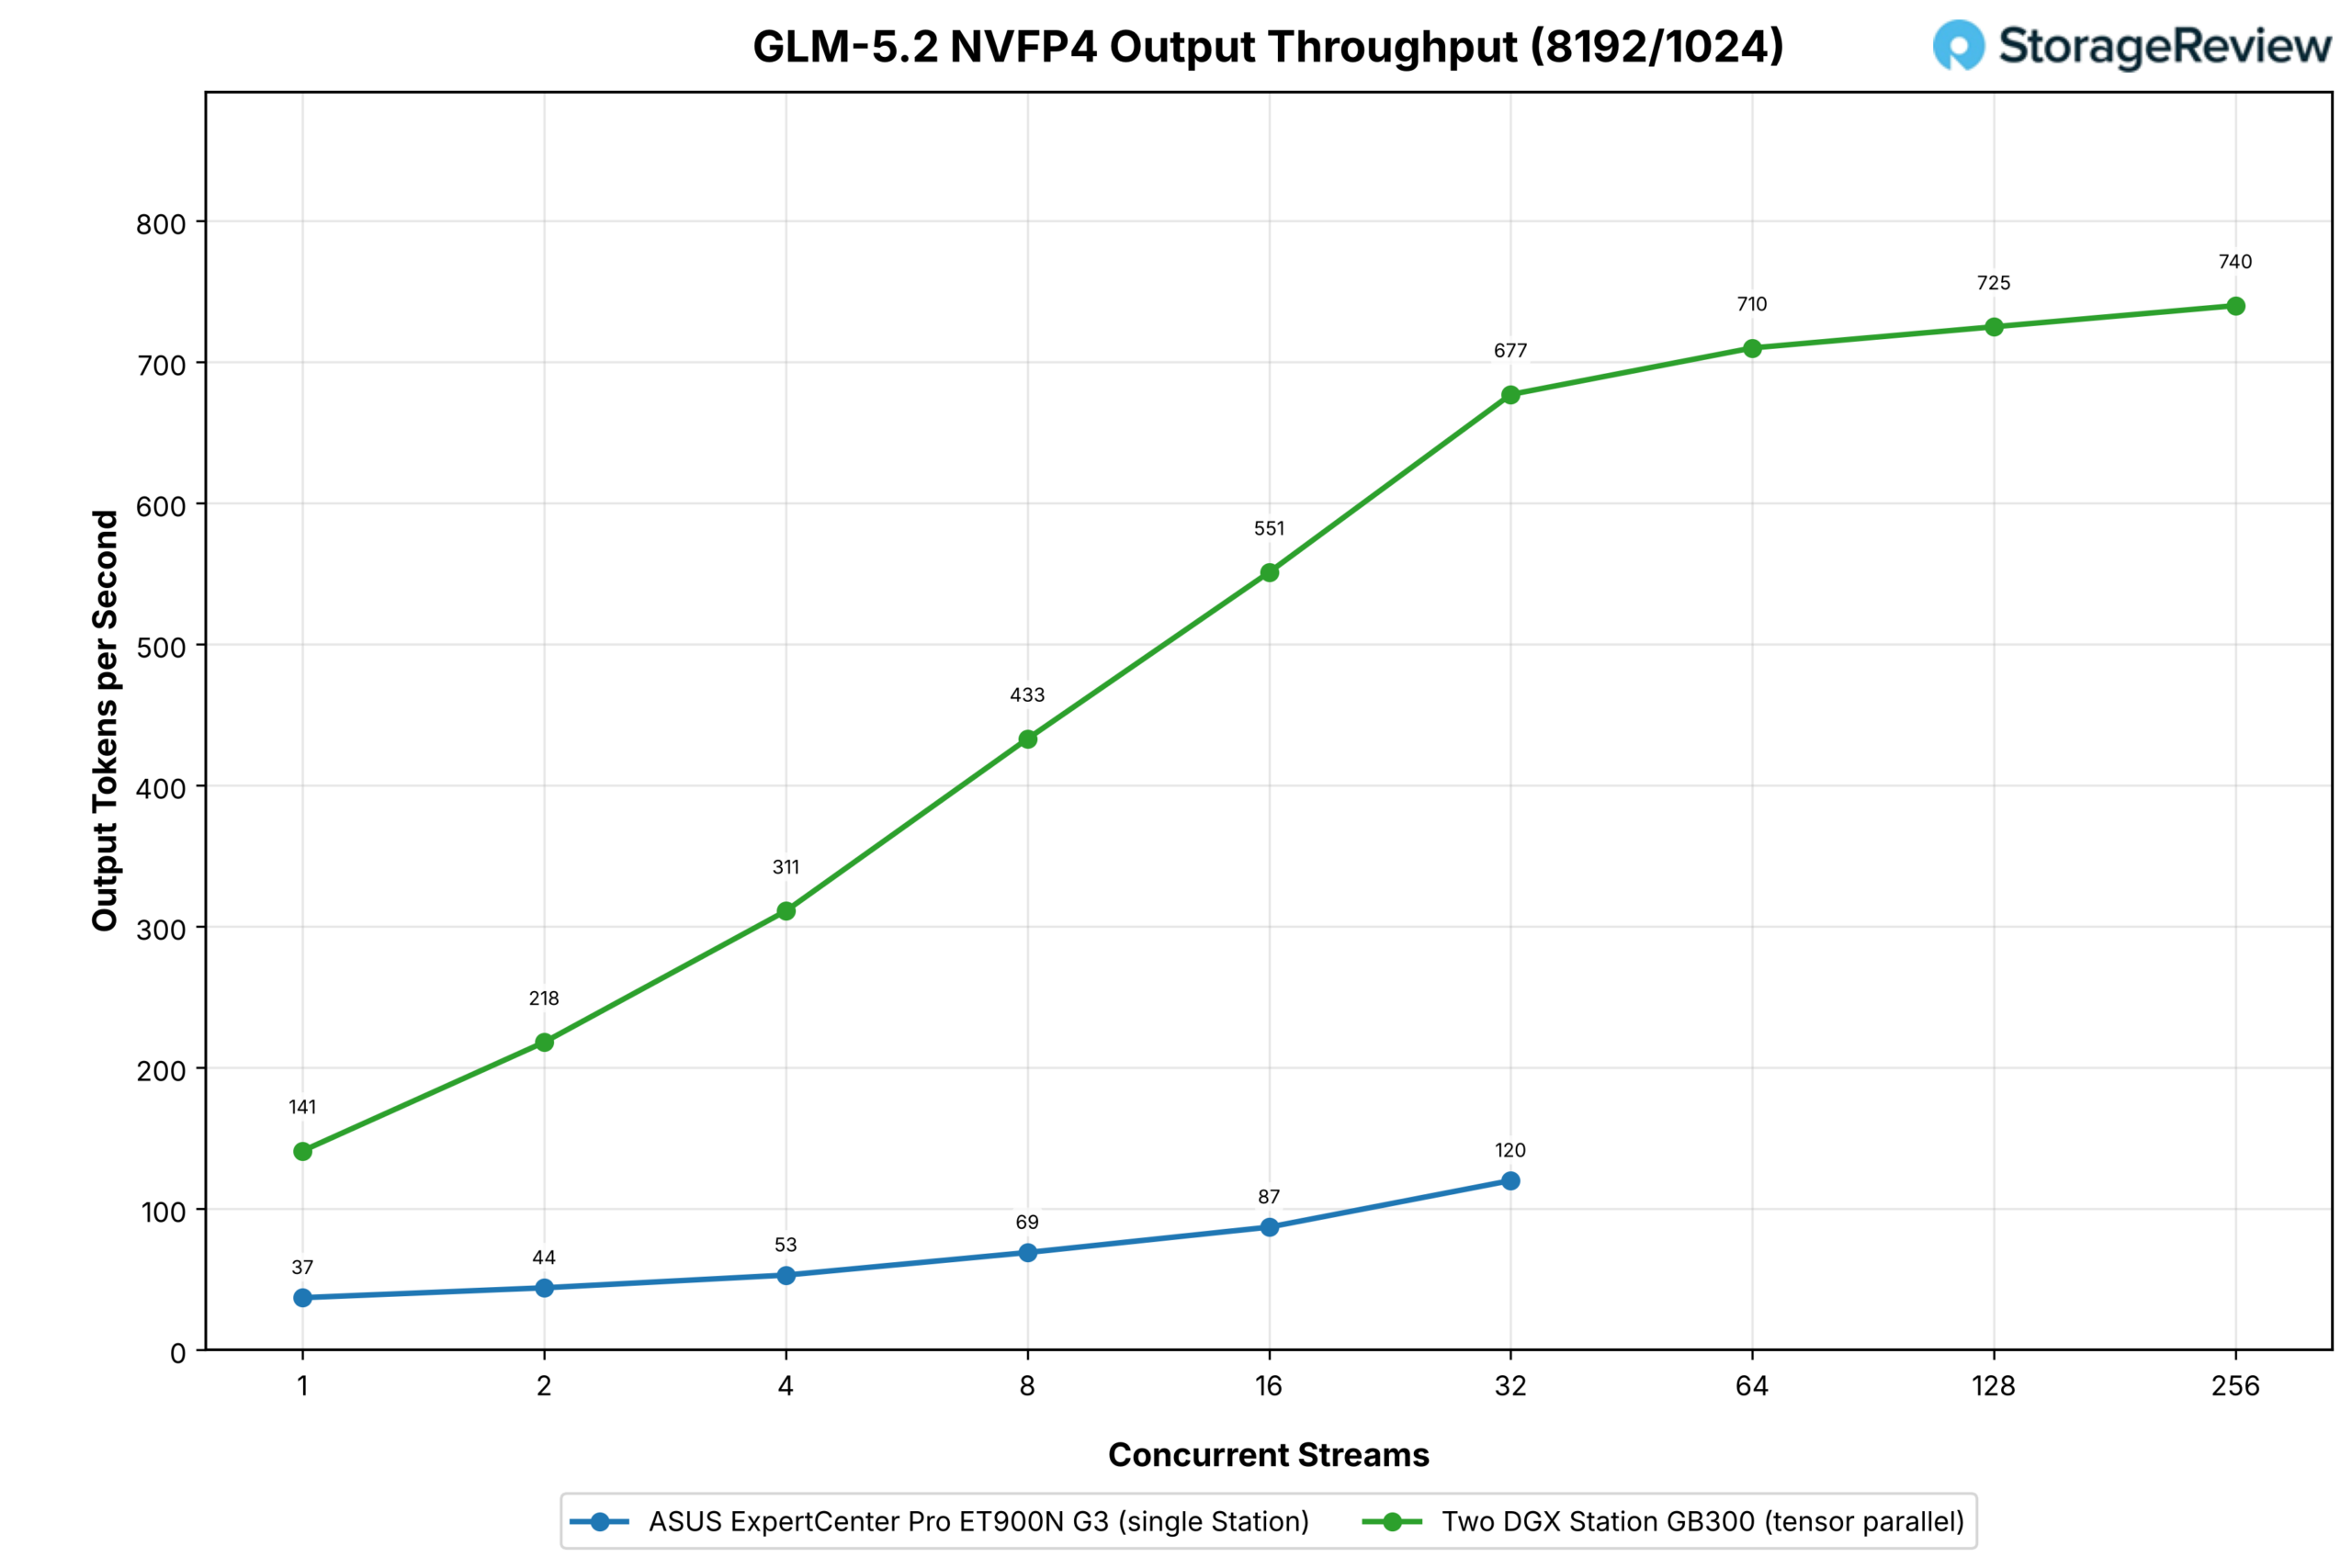
預填充較多的配置文件在較低的高度上也講述了同樣的故事,一個站點從單流每秒 37 個輸出令牌增加到 32 流每秒 120 個,集群在同一範圍內從 141 個增加到 677 個,在掃描底部是 3.8 倍,頂部是 5.6 倍,然後在 256 流中分別趨於 257 2575 257 257 2570 2575 2570 257
較長的提示符號會將更多工作放在預填階段,而這兩種配置都屬於計算密集型,因此第二個工作站所消除的卸載開銷在總開銷中所佔的比例小於短提示符的情況。兩種配置的效能提升都遠超 2 倍,因為第二個工作站將 433GB 的 LPDDR5X 內存全部替換為 HBM 內存,而這比第二個 B300 的計算能力更為重要。
MiniMax-M3
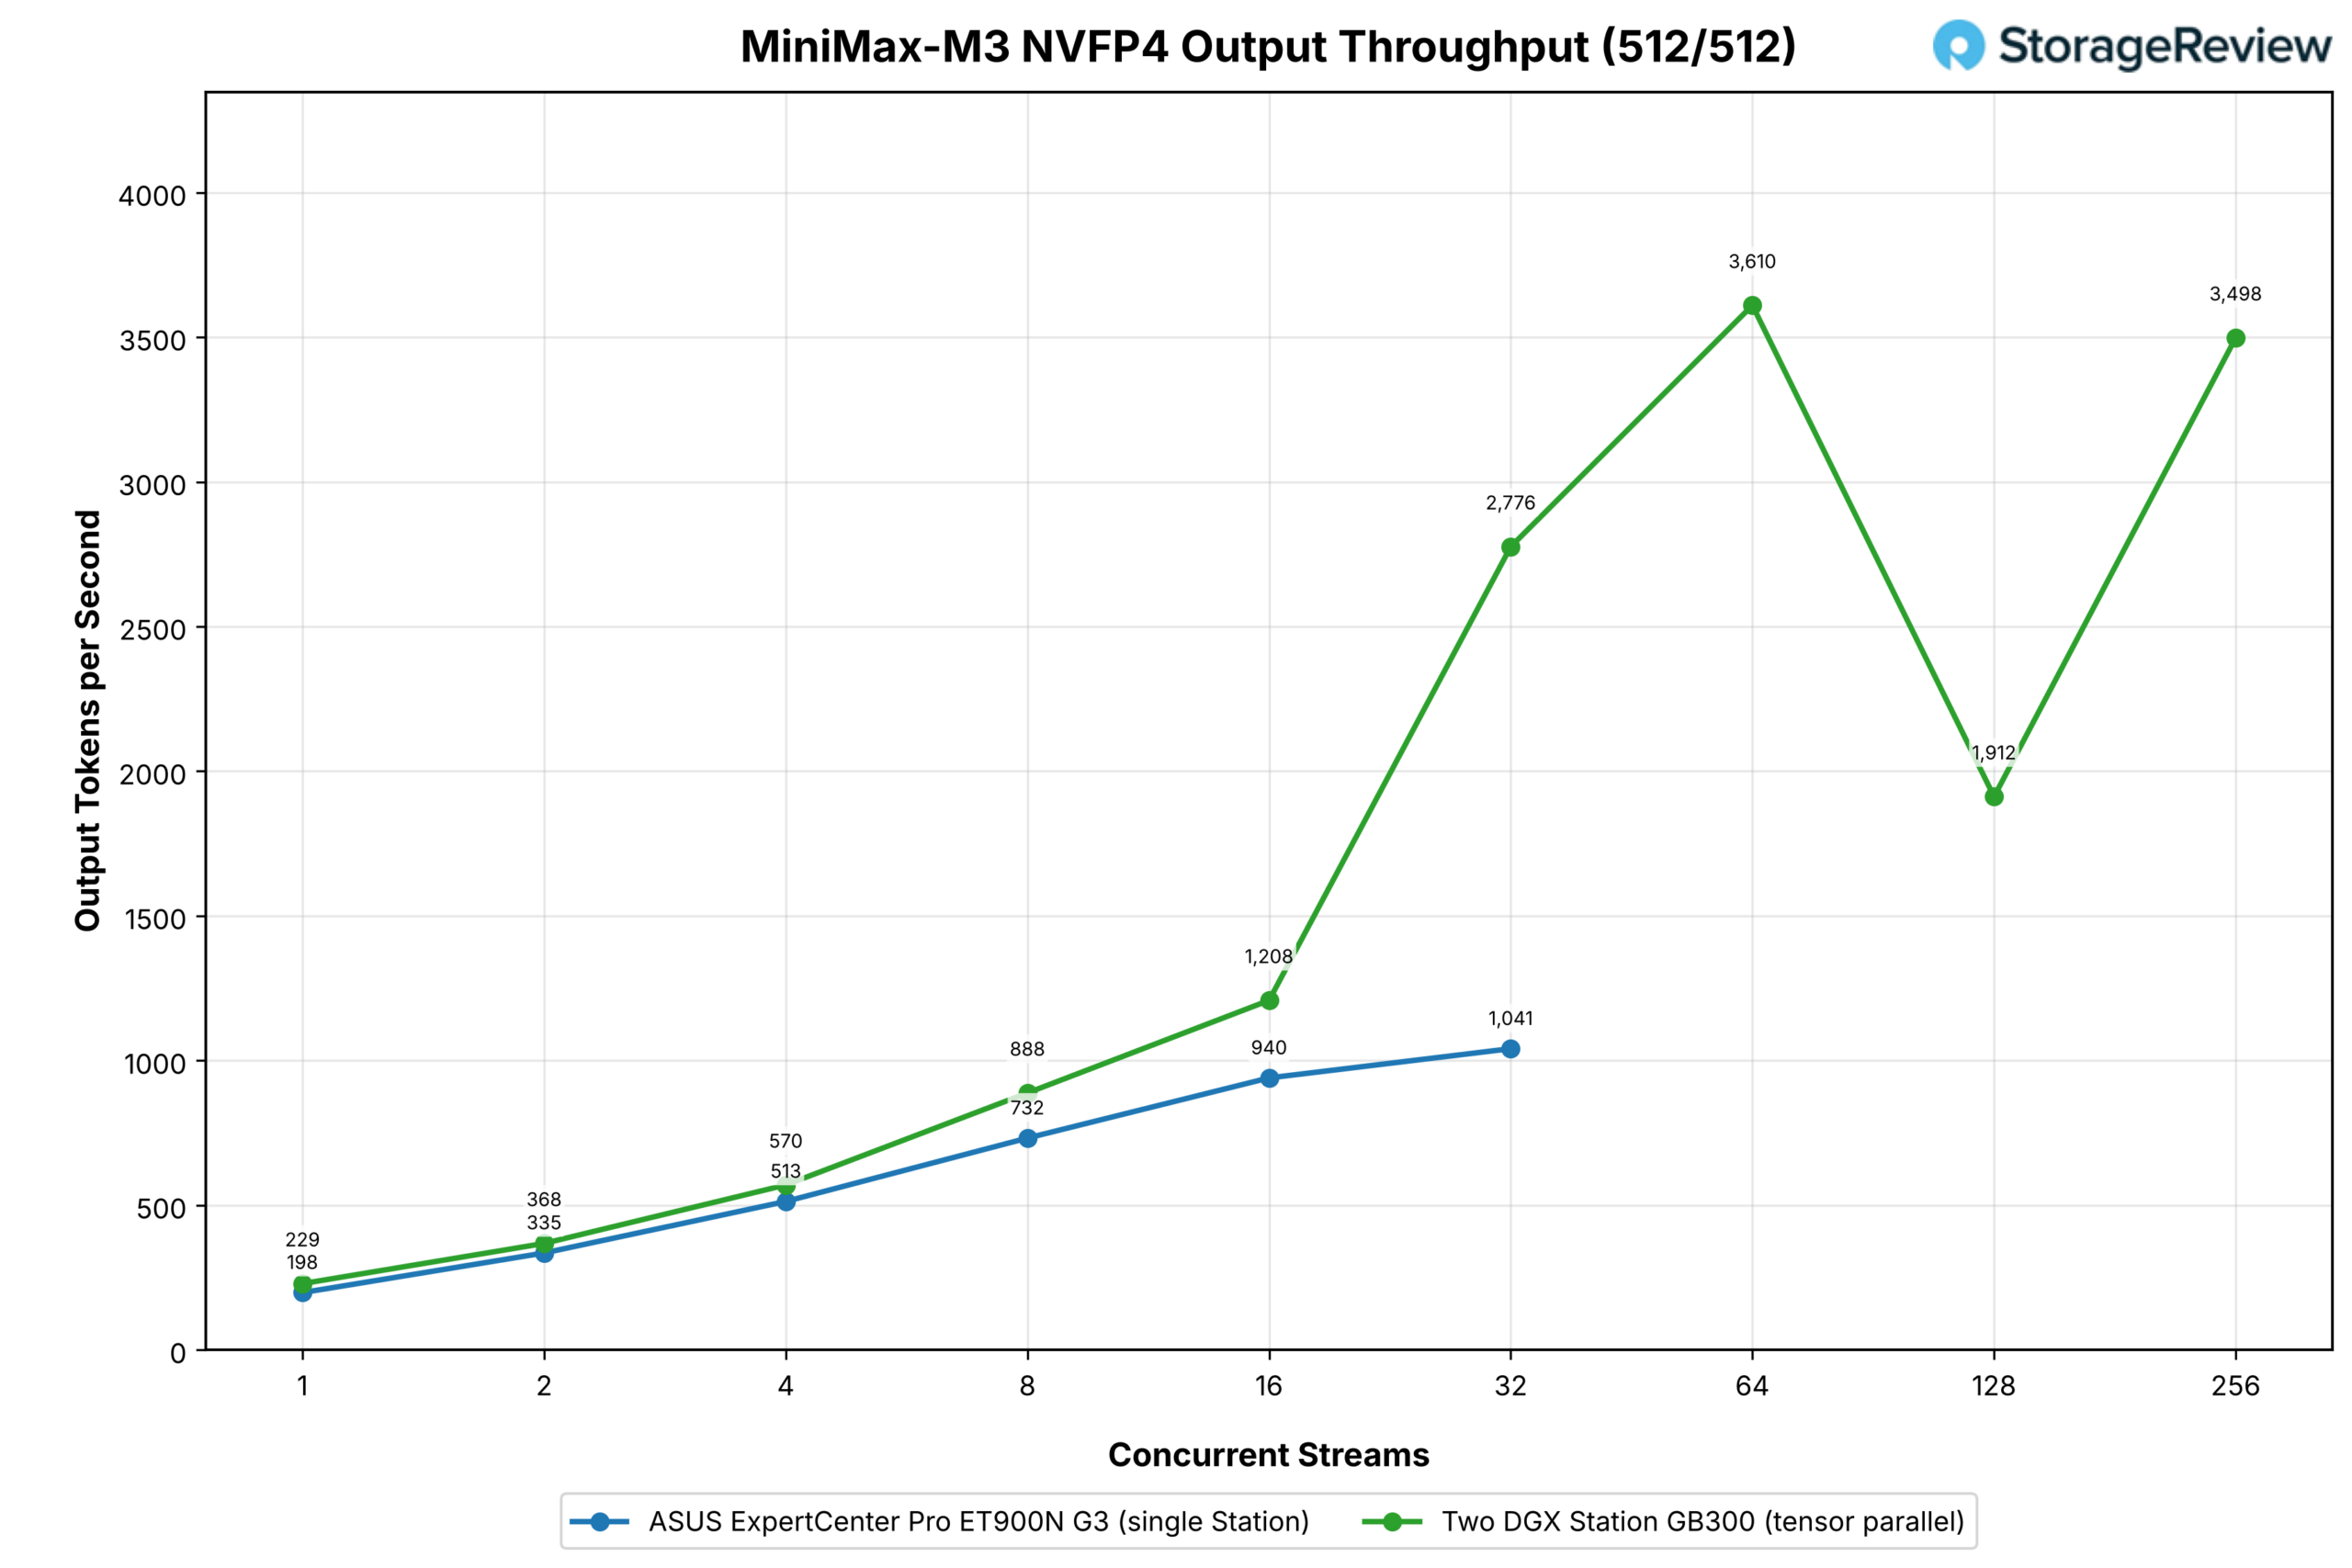
MiniMax-M3 在 TP2 模式下運行,未啟用 Grace 卸載。在一台工作站上,它的效能剛好達到 HBM 記憶體的邊界,部分效能由 Grace 記憶體提供。在華碩的評測中,它在與 EAGLE3 相同的負載下,以 32 個流進行運算時,達到了每秒 1,041 個輸出令牌。
群集在 16 個流中與單一 Station 的表現非常接近(1,208 對 940),之後逐漸拉開差距:在 32 個流時達到 2,776,是單一 Station 的 2.7 倍;在 64 個流時達到 3,610;在 128 個流時略微下降至 1,912 個流時達到 912 個流。兩個 Station 在這裡的貢獻比在 GLM-5.2 中要小,因為一個 Station 已經將該模型的大部分運算都保存在 HBM 中,所以第二個 GPU 的貢獻更接近於純粹的計算擴展,再加上 KV 快取的餘裕。
在預填充量較大的場景下,MiniMax-M3 在一個工作站上的空間就用完了:8,192 個令牌的提示符很快消耗掉了剩餘的 KV 緩存,因此單個塔在兩個流時輸出令牌的峰值為每秒 282 個,在四個流時保持在每秒 271 個,在八個流時下降到八個流時下降到了八個流。
將模型分佈在兩個 Station 上後,相同的資料點分別達到 365、522 和 736,在兩個資料流的情況下,兩個配置的快取均有剩餘,效能提升了 30%;在八個資料流的情況下,效能提升了 7.1 倍,其中一個資料流已耗盡。群集隨後在 16 個資料流的情況下達到 909,在 32 個資料流的情況下達到 1,506,在 64 個資料流的情況下達到 1,724,在 128 個資料流的情況下達到 1,366,在 256 個資料流的情況下達到 1,801,而這個資料流的情況下根本無法達到這個站
結語
兩台 GB300 DGX 工作站透過各自的 ConnectX-8 連接埠連接在一起,正如 NVIDIA 文件中所述,它們可以正常工作;設定過程非常簡單,這是我們首次看到雙系統配置的吞吐量資料。
第二個工作站對於超過 252GB HBM3e 的型號來說物有所值:GLM-5.2 在單個工作站上 32 個流時每秒輸出 139 個令牌,在兩個工作站上達到 1,525 個,在 256 個流時達到 3,141 個,因為拆分後,433GB 型號個,而單一工作站的上限為 188 個;MiniMax-M3 在長提示下,從 8 個流時速度開始下降的塔式處理器,到 256 個流時仍在攀升的雙塔式處理器。
對於可以裝入一個工作站的兩款型號,GLM-5.3 Flash 和 DeepSeek V4.1 Flash,使用第二個盒子的更好方法是給每個工作站一個完整的副本,將預填充與解碼分開,並讓解碼工作進程不停地生成;對於 GLM-5.3 Flash,這在 32 個流的情況下使長長的提示率翻了一番5,248 個令牌。
自從MSI XpertStation WS300 評測以來,我們對產品的看法沒有改變:這是一款針對特定市場的有趣機器,如果您發現自己需要一台,您可能還會發現自己需要更多。
運行這些系統的最佳方式是採用可互換的基礎設施:一個團隊可以安排工作並根據專案變更重新配置的資源池,而 NVIDIA 擁有實現這一目標所需的全部元件。它收購了 Run:ai 用於調度,Brev 用於開發者環境,以及 Lepton 用於計算市場。如果您能夠使用這三者中的任何一個,並搭配一機架的 Station,都會使產品更具吸引力。
雙機配置擴展性良好;我們測得的最佳性能提升體現在 GLM-5.3 模型上,單台 Station 每秒輸出 188 個令牌,而雙機配置下則達到每秒 5,018 個令牌(提升 27 倍),在相同的並發量下,GLM-5.2 模型在 32 個流時性能提升了 11 倍。這兩個模型都只能透過將權重溢出到 Grace 記憶體中才能由單一 Station 處理。這相當於在兩台 400G 伺服器上實現了 GB300 的效能提升,這讓我們不禁好奇,當 NVIDIA 推出搭載下一代 HBM 和 NVLink-C2C 技術的 Vera Rubin Station 時,它的效能將會如何。
此方案的適用範圍並未改變:兩台工作站只需放置在桌面上,無需機架或資料中心,即可運行過去需要GPU伺服器及其配套設施才能運作的模式。因此,對於那些無法獲得資料中心機位或不想等待機位的團隊來說,他們現在也能在身邊輕鬆實現前沿的推理能力。撇開價格不談,NVIDIA已經為這個領域樹立了標竿。 GB300系列產品在我們「最佳本地AI桌面」排行榜上名列前茅,而這次集群數據也進一步印證了這個選擇。



 Amazon