

MSI XpertStation WS300 基於 NVIDIA 最新的 DGX Station 架構,這是迄今為止性能最強的一代,將完整的 GB300 Grace Blackwell Ultra 節點置於您的辦公桌旁。其核心效能是 20 petaFLOPS 的 FP4 運算能力,由單一 Blackwell Ultra GPU 透過 900GB/s 的 NVLink-C2C 連結連接到 72 核心 Grace CPU 提供。兩個處理器共享一個 748GB 的記憶體池:252GB HBM3e 和 496GB LPDDR5X,足以在本地記憶體中駐留一個萬億參數的模型。
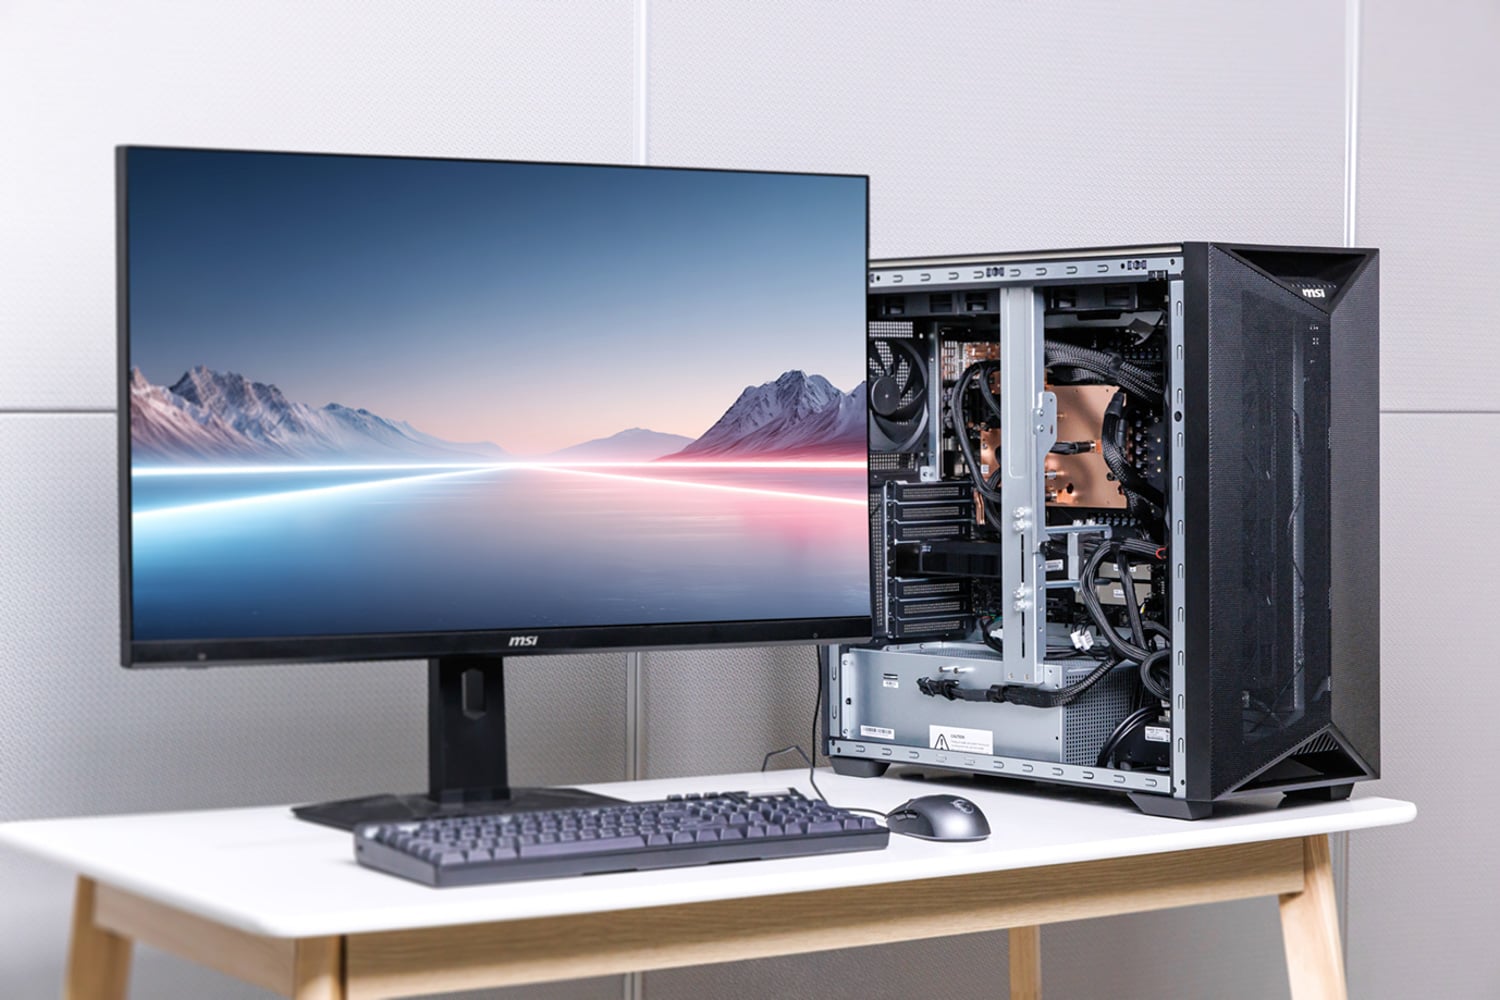
DGX Station 還支援使用其 ConnectX-8 超級網路卡將多個單元集群化,該網路卡提供兩個 400GbE 端口,可提供 800Gb/s 的頻寬。最終打造出一台資料中心等級的設備,無需佔用伺服器機房,即可在家中或辦公室運作。
NVIDIA DGX Station 技術規格
XpertStation WS300 是 MSI 基於 NVIDIA GB300 DGX Station 平台打造的產品。 NVIDIA 提供 Grace Blackwell Ultra 主機板和軟體環境,而 MSI 則提供機箱、液冷散熱、電源供應、儲存佈局、外部 I/O 介面以及服務模式,從而將該平台整合為完整的桌面系統。由於 Grace CPU、Blackwell Ultra GPU、NVLink-C2C 互連和 ConnectX-8 網路是固定的,因此真正的 OEM 差異化體現在周邊系統如何有效地支援、管理和利用這些硬體。 MSI 為此系統配置了四塊 2TB 的 Micron 4600 Gen5 M.2 SSD 用於測試。其中兩塊 SSD 組成 RAID 1 陣列用於啟動存儲,另外兩塊則是獨立的 SSD,用作臨時存儲空間或其他用途。
| 規格 | 信息 |
|---|---|
| 卓越的建築 | |
| 中央處理器 | NVIDIA Grace,72 核心 Arm Neoverse V2 |
| GPU | NVIDIA Blackwell Ultra (B300) |
| 張量核心 | 5th代 |
| CPU-GPU互連 | NVLink-C2C,900 GB/s 雙向 |
| 記憶體應用 | |
| 連貫記憶 | 最大至 748 GB |
| GPU內存 | 最高支援 252 GB HBM3e |
| GPU內存帶寬 | 7.1 TB / s |
| CPU內存 | 最高可達 496 GB LPDDR5X (4 x SOCAMM) |
| CPU記憶體頻寬 | 396 GB / s |
| 儲存 | |
| 引導驅動器 | 2 個 M.2 2280 PCIe 5.0 x4 NVMe 插槽(CPU 直插式),分別安裝了 2 塊 2TB Micron 4600 Gen5 固態硬碟,組成 RAID 1 陣列。 |
| 擴張驅動 | 2 個 M.2 2280 PCIe 5.0 x4 NVMe 固態硬碟(已連接 ConnectX-8),已安裝 2 塊 2TB Micron 4600 Gen5 固態硬碟用於測試。 |
| 網路相關 | |
| NIC | NVIDIA ConnectX-8 SuperNIC,2 x 400G QSFP112(總傳輸速率 800 Gb/s) |
| 乙太網路 - ENET | 1 個 10GBase-T RJ45 介面(Marvell AQC113) |
| 管理端口 | 1 個 1000Base-T RJ45 介面(專用帶外介面) |
| 無線應用 | M.2 2230 Key-E 插槽、PCIe 2.0 x1(Wi-Fi 6E / Wi-Fi 7、藍牙) |
| 擴展 | |
| PCIe插槽 | 1 個 PCIe 5.0 x16 FHFL 雙寬插槽;2 個 PCIe 5.0 x16 FHFL 單寬插槽(x8 訊號) |
| 支援的獨立顯示卡 | NVIDIA RTX PRO 2000 Blackwell、RTX PRO 4000 Blackwell SFF、RTX PRO 6000 Blackwell 工作站/Max-Q |
| 前面板/頂部 I/O | |
| USB | 2 個 USB 3.2 Gen 2 Type-A 連接埠;2 個 USB 3.2 Gen 2 Type-C 連接埠(5V/3A) |
| 音訊 | 2 個插孔(線路輸出/麥克風) |
| 後端I / O | |
| USB | 4 個 USB 10Gbps Type-A 連接埠;1 個 Micro-USB COM(串列埠控制台)接口 |
| 顯示螢幕 | 1 個 Mini DisplayPort 介面(BMC 視頻,最大解析度 1024 x 768,不支援 DP++) |
| 音訊 | 3 個插孔(線路輸入/線路輸出/麥克風) |
| 管理與安全 | |
| BMC | ASPEED AST2600,配備 AMI MegaRAC 韌體、IPMI 2.0 和 Redfish,以及 eMMC 本地儲存。 |
| 安全性 | TPM 2.0、機箱入侵偵測、Microchip CEC1736 硬體信任根 (ERoT) |
| 散熱 | |
| 液體冷卻 | 適用於 1400W CPU + GPU 的液冷模組,GPU、CPU、記憶體和 ConnectX-8 均配備散熱塊。 |
| 散熱器/風扇 | 2 個 360 毫米散熱器;1 個 12025 系統風扇 |
| 電力 | |
| 電源供應 | 1 x 1600W ATX,80 PLUS 白金認證(150 x 86 x 210 mm) |
| 交流輸入 | 100-114Vac,15A,47-63Hz(最大輸出功率1300W);115-240Vac,15-8A,47-63Hz(最大輸出功率1600W) |
| 外形 | |
| 尺寸 | 245.7 x 529.0 x 570.4 毫米(9.67 x 20.83 x 22.46 英吋),寬 x 高 x 深 |
設計和建造
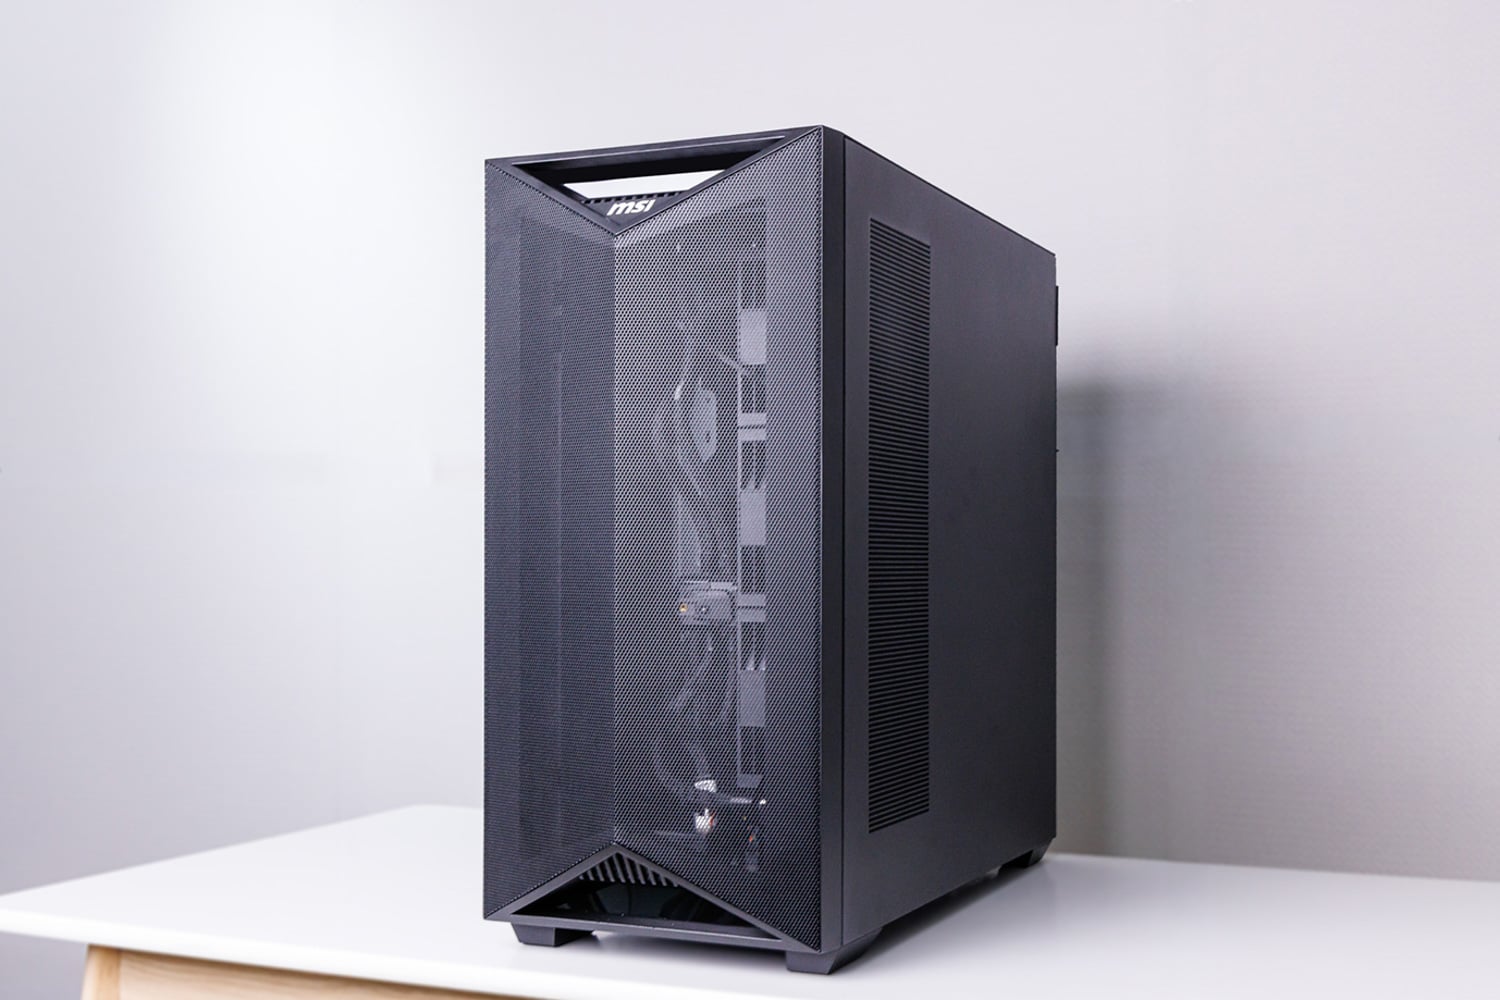
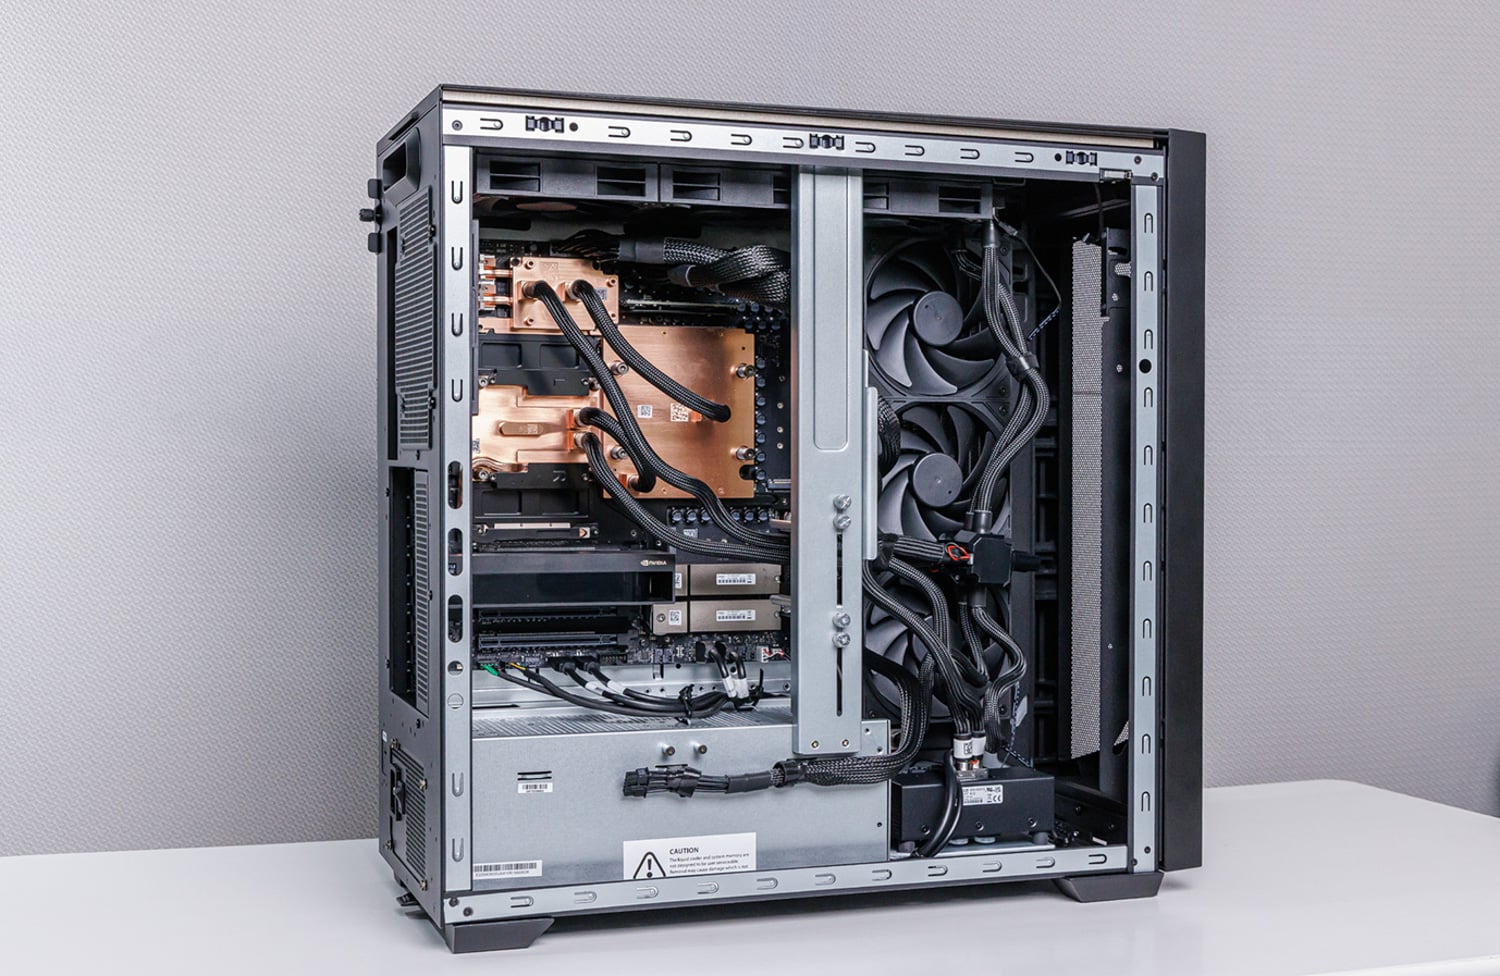
乍一看,XpertStation 就像一台外觀時尚、設計專業的標準現代工作站。但取下側板後,相似之處就僅限於此了。
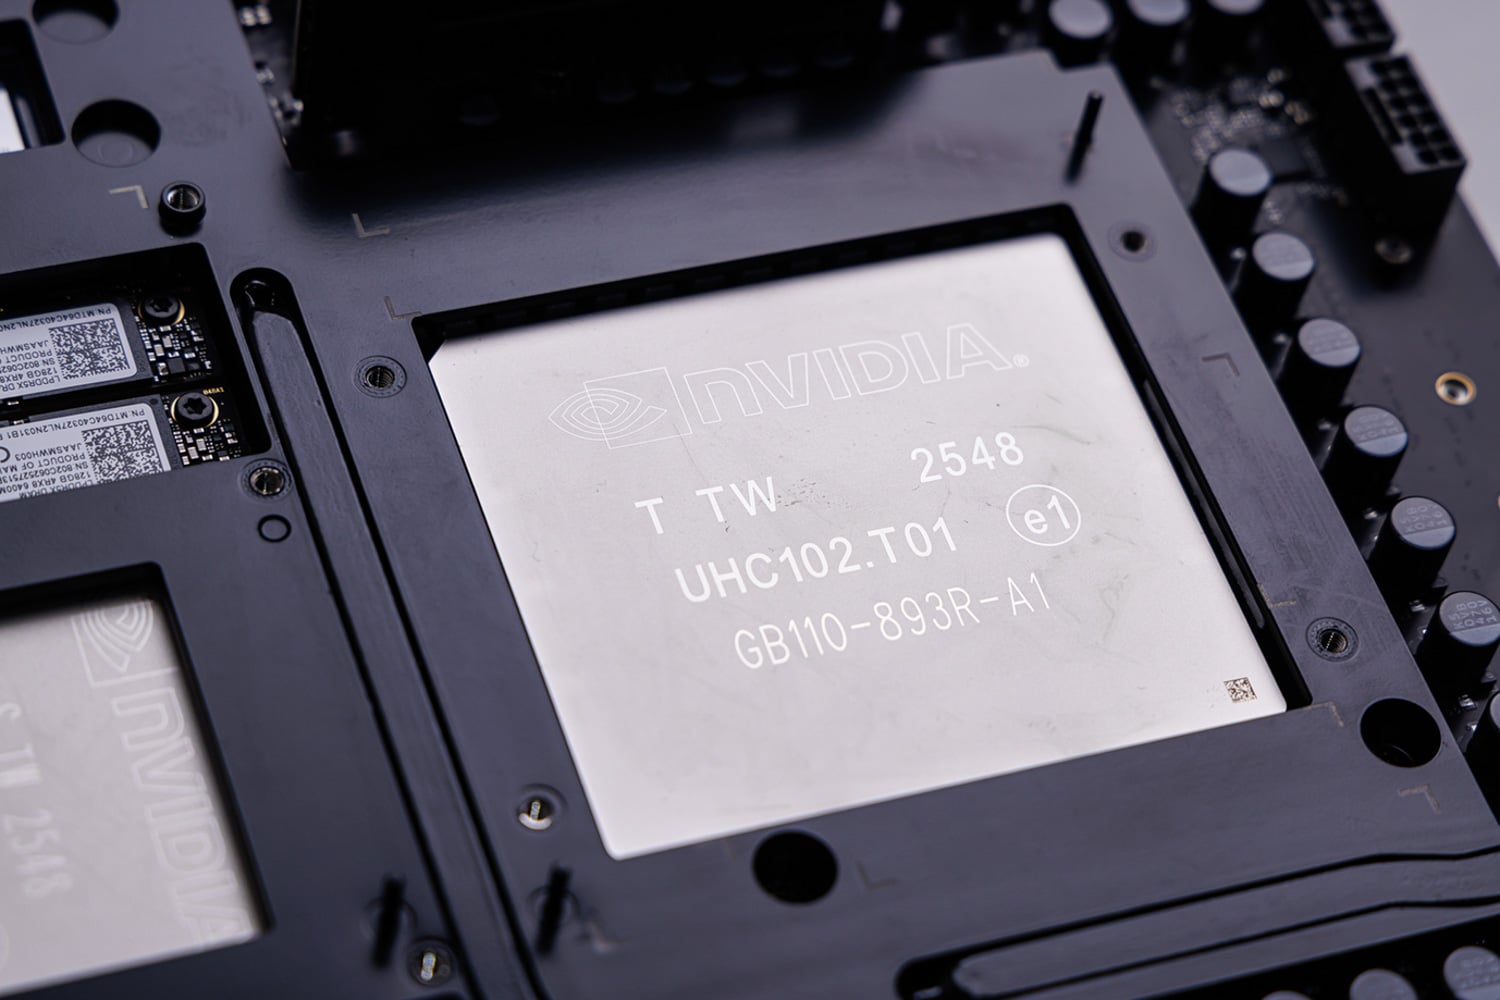
GB300 Grace Blackwell Ultra Desktop Superchip
WS300 的核心是我們的明星產品:NVIDIA 的 B300 GPU,它是基於 Blackwell Ultra 架構。
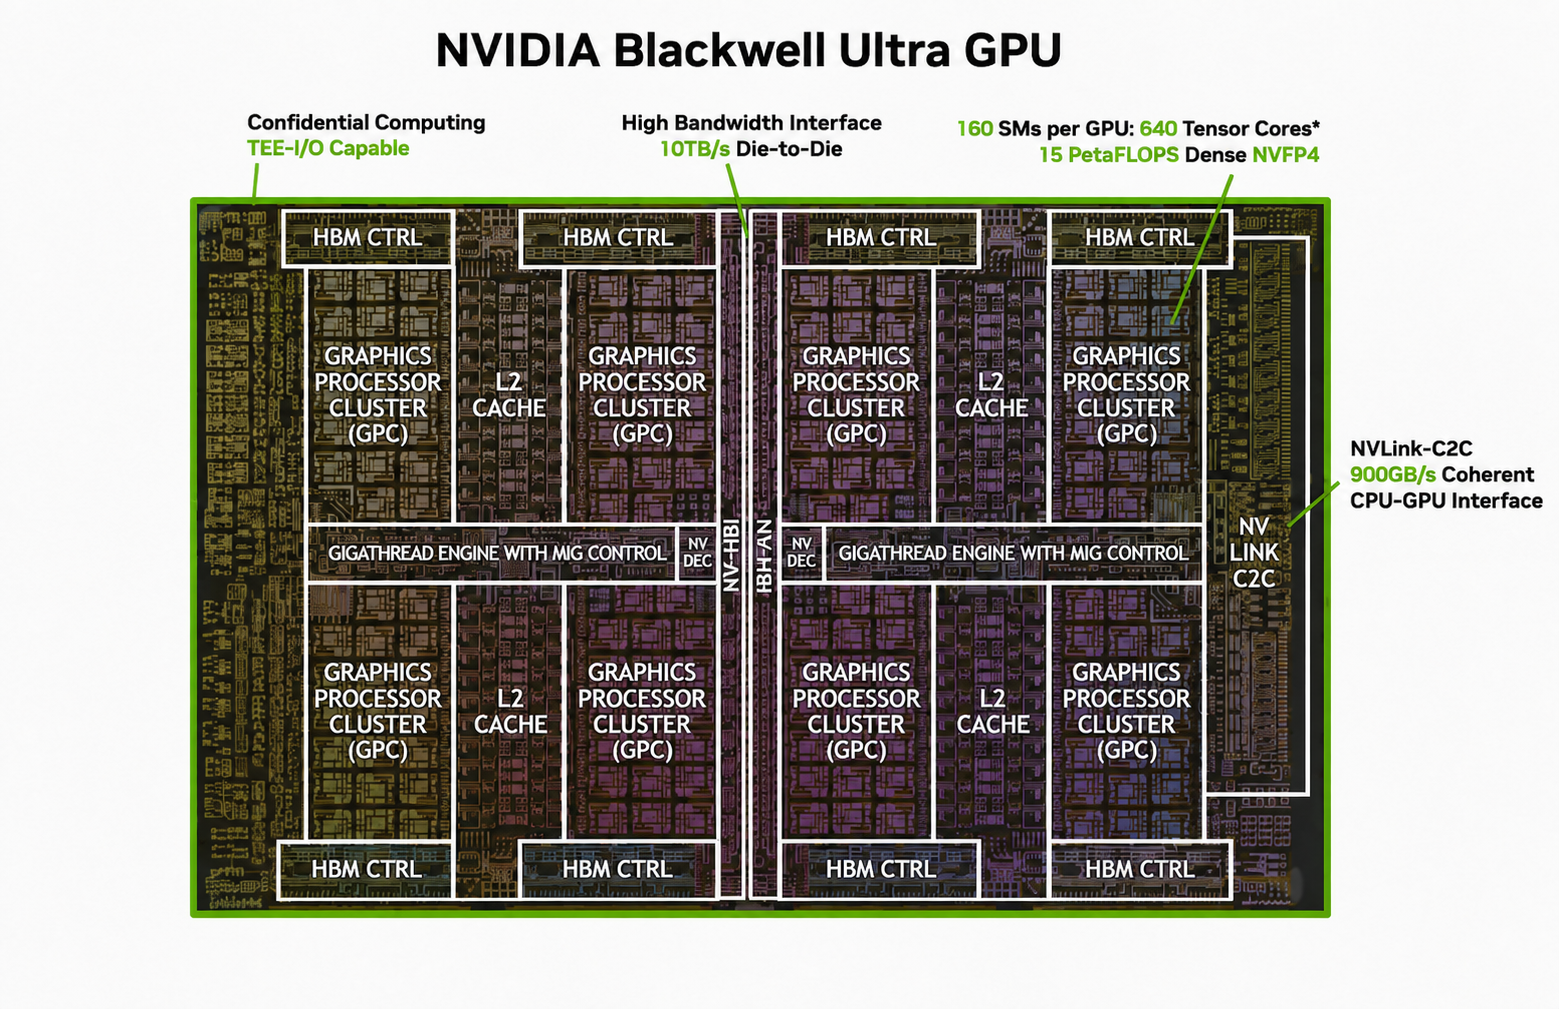
來源:NVIDIA,由 StorageReview 註釋
B300 是目前最先進的 GPU 之一,採用基於台積電 4NP 製程的雙光罩設計。兩個晶片透過 NVIDIA 的 10TB/s NV-HBI 晶片間接口連接,使 GPU 能夠作為單一 CUDA 加速器運作。 DGX Station 中使用的 B300 是基於擁有 208 億個電晶體的 Blackwell Ultra 設計,最多可配備 160 個 SM 單元和 640 個第五代 Tensor Core。它還配備了 252GB 的 HBM3e 顯存,記憶體頻寬高達 7.1TB/s。作為資料中心級產品,B300 缺少常規顯示輸出和 NVENC 硬體編碼器。但它包含七個 NVDEC 引擎和七個 nvJPEG 解碼器。該 GPU 還支援 MIG 技術,允許將其劃分為多達七個獨立的執行個體。在計算方面,B300 提供:
| 精密 | 峰值性能 |
|---|---|
| B300 運算效能 | |
| NVFP4 張量核心 | 20 PFLOPS 稀疏模型 / 15 PFLOPS 密集模型 |
| FP8 / FP6 張量核心 | 10 浮點數 |
| INT8 張量核心 | 330 TOPS |
| FP16 / BF16 張量核心 | 5 浮點數 |
| TF32 張量核心 | 2.5 浮點數 |
| FP32 | 80 TFLOPS |
| FP64 / FP64 張量核心 | 1.3 TFLOPS |
| 峰值速率取決於 GPU 加速頻率。除非另有說明,Tensor Core 規格均採用稀疏性。 | |
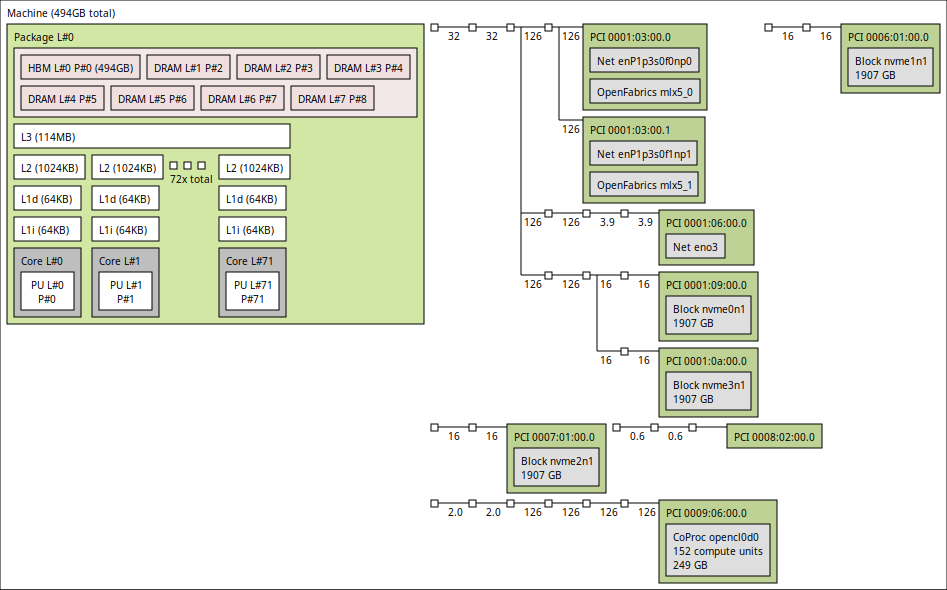
與 B300 搭配的是 NVIDIA 的首款資料中心 CPU Grace。它採用 72 個 Arm Neoverse V2 核心,但周圍的處理器元件均為 NVIDIA 自主設計,包括快取層次結構、記憶體控制器、系統 I/O、可擴充一致性架構 (SCL) 和 NVLink-C2C 介面。 Grace 提供 72 個核心和 72 個硬體線程,每個核心均採用 Armv9 架構,並帶有加密擴展和四個 128 位元 SVE2 向量單元。核心配備一個六路指令解碼器,每個時脈週期最多可分派八條指令;六個標量 ALU;64KB 的 L1 指令快取和資料快取;以及 1MB 的私有 L2 快取。整個晶片上的 CPU 共享 114MB 的 L3 快取。
核心和 L3 快取切片透過 NVIDIA 的可擴展一致性架構 (Scalable Coherency Fabric) 連接,這是一種網狀互連架構,具有 3.2TB/s 的二分頻寬。該架構還將 CPU 核心連接到記憶體、系統 I/O 和 NVLink-C2C 接口,為 Grace 提供維持 B300 正常運作所需的資料傳輸頻寬。在 WS300 中,Grace 負責處理加速器周圍的 CPU 端工作:GPU 核心啟動、資料載入、預處理、標記化和模型編排。下面的拓撲圖清楚地展示了單路設計,其中包含一個 72 核心 Grace CPU 以及圍繞其連接的平台設備。
Grace 搭載 496GB LPDDR5X 內存,提供 396GB/s 的頻寬。 DGX Station 沒有將記憶體直接焊接在底板上,而是採用了四個 SOCAMM 模組。 SOCAMM(系統單晶片高階記憶體模組)將 LPDDR5X 記憶體封裝在緊湊、可拆卸的外形尺寸中。這使得該平台既能保持 LPDDR5X 的頻寬和能源效率優勢,又能實現記憶體的可維護性。只需更換故障模組,無需更換整個底板。
Grace 與 B300 之間透過 NVIDIA 的 NVLink-C2C 介面連接,這是一種封裝級互連,可提供 900GB/s 的雙向頻寬,約為 PCIe Gen5 x16 連接的七倍。更重要的區別在於記憶體一致性。在傳統工作站中,CPU 和獨立 GPU 維護各自獨立的記憶體空間,資料透過 PCIe 在它們之間複製。而藉助 NVLink-C2C,Grace 和 B300 共享一個一致的位址空間,使得每個處理器都可以直接存取連接到對方的記憶體。
最後得到的是一個748GB的連貫位址空間,而不是一塊748GB的HBM記憶體。 B300擁有252GB的HBM3e,讀寫速度為7.1TB/s,而Grace記憶體則提供496GB的LPDDR5X,讀寫速度為396GB/s。 Grace記憶體中的資料仍需要透過C2C連結傳輸,因此HBM仍然是頻繁存取的模型權重、張量和緩衝區的最佳儲存位置。 Grace記憶體則作為一個大容量記憶體層,允許超出B300 252GB本地記憶體容量的工作負載保留在單一系統上,而不是分散到多個GPU上。我們將在後續的測試部分評估使用第二層記憶體對效能的影響。
系統拓撲
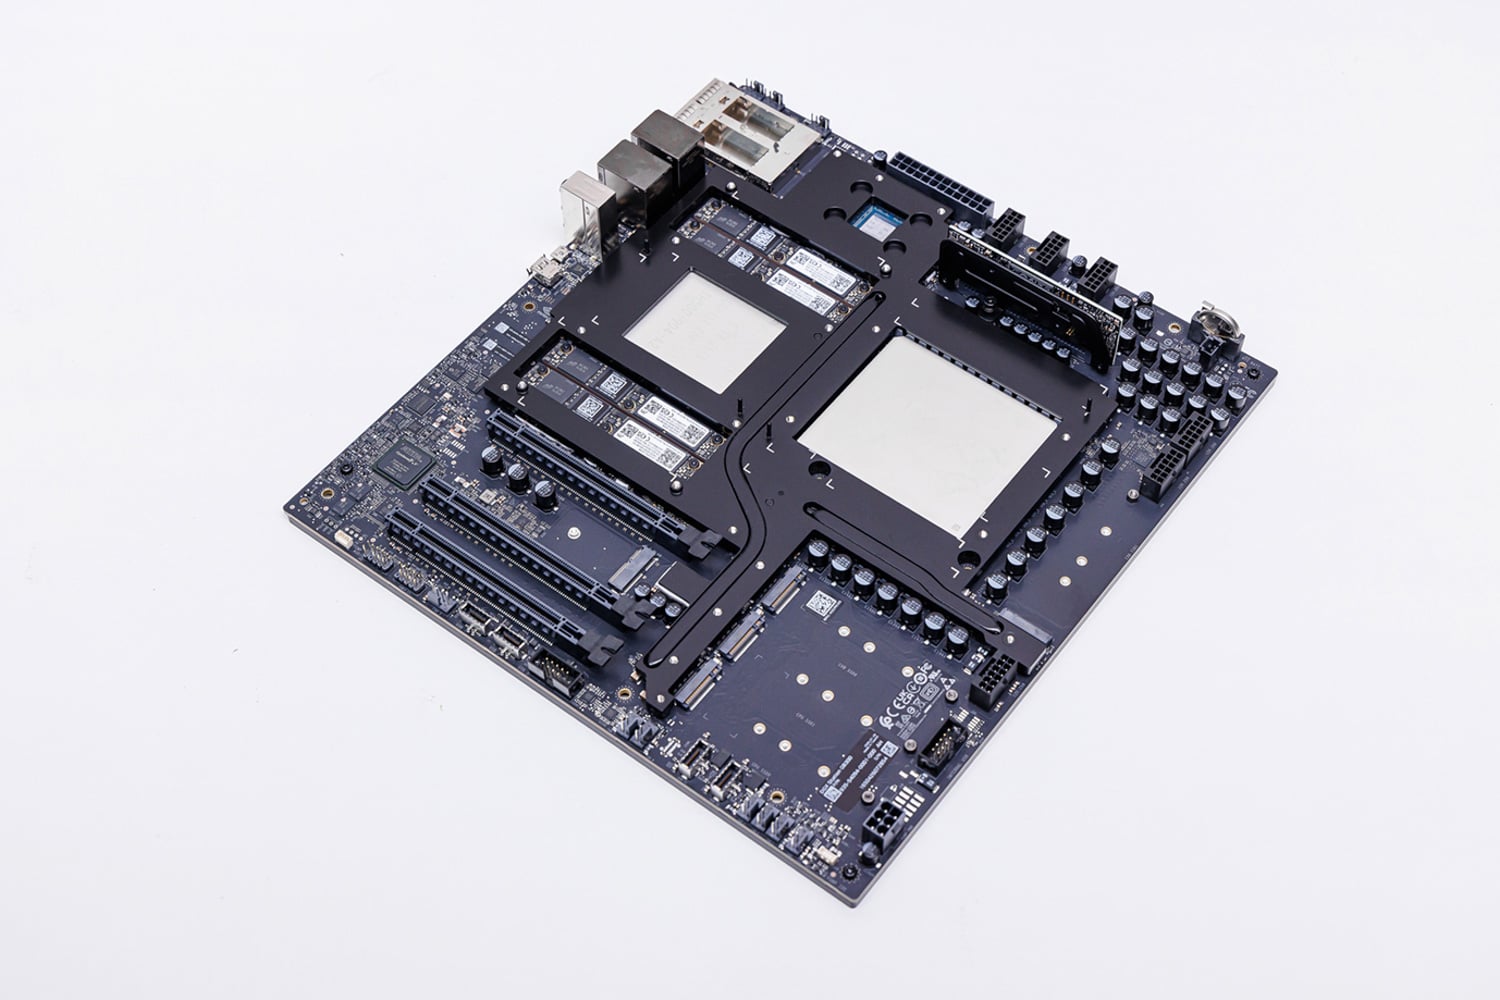
從 GB300 封裝中取出,MSI 的框圖展示了系統其餘部分如何圍繞 Grace 核心連接。 CPU 位於 I/O 拓樸結構的中心,兩個 PCIe 5.0 x4 M.2 插槽直接連接到它。 MSI 為這兩個插槽配備了兩塊 2TB 的Micron 4600 SSD,並配置為 RAID 1,用於安裝作業系統和 NVIDIA 軟體堆疊。三個全尺寸擴充插槽也直接連接到 Grace 核心,包括一個 PCIe 5.0 x16 插槽和兩個 PCIe 5.0 x8 插槽。
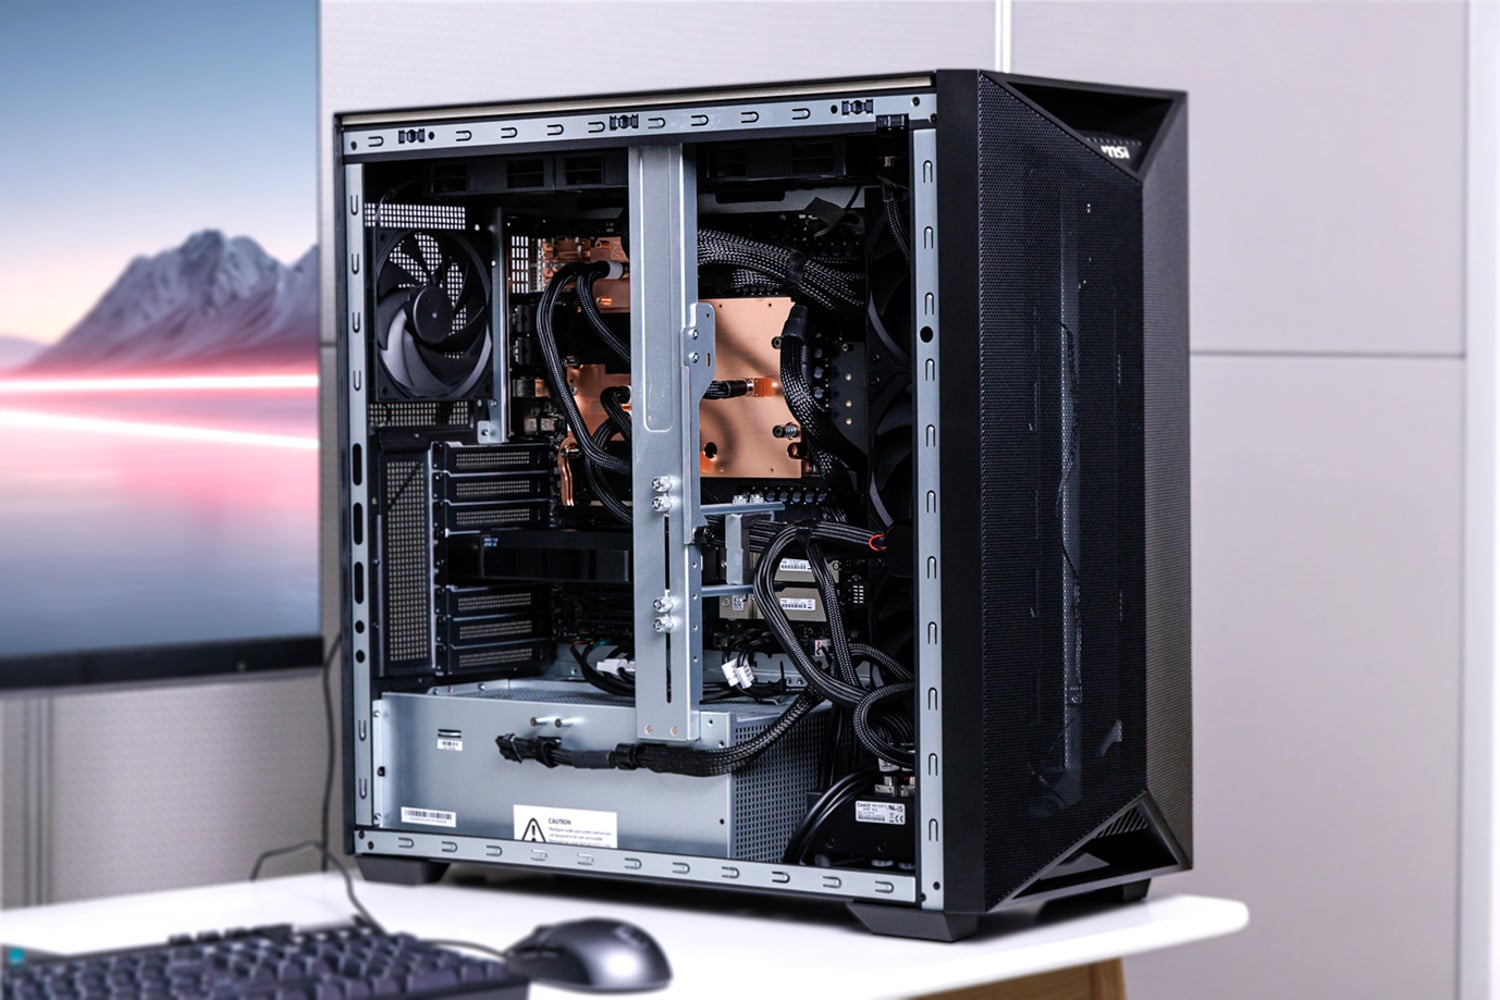
MSI 也為這款機殼預留了安裝大型獨立顯示卡的空間。預先安裝的 12V HPWR 電源線位於機殼前方,方便使用者連接,無需再額外佈線。用於加固機殼的垂直金屬支架還整合了防下垂支架,能夠支撐較長較重的 RTX PRO 顯示卡。
Grace 晶片側的 USB 控制器負責系統的主要前置和後置 USB 連接埠以及音訊編解碼器。 Grace 也連接到 ASPEED AST2600 BMC,後者提供一個專用的 1GbE 管理連接埠、一個解析度限制為 1024 x 768 的 Mini DisplayPort 輸出連接埠以及一個 Micro-USB 串列埠控制台連接埠。 Mini DisplayPort 連接埠僅用於初始設定和故障排除,並非作為系統的主要顯示輸出連接埠。任何計劃將 WS300 用作傳統桌上型電腦的用戶仍需要選購 RTX PRO 擴充卡。
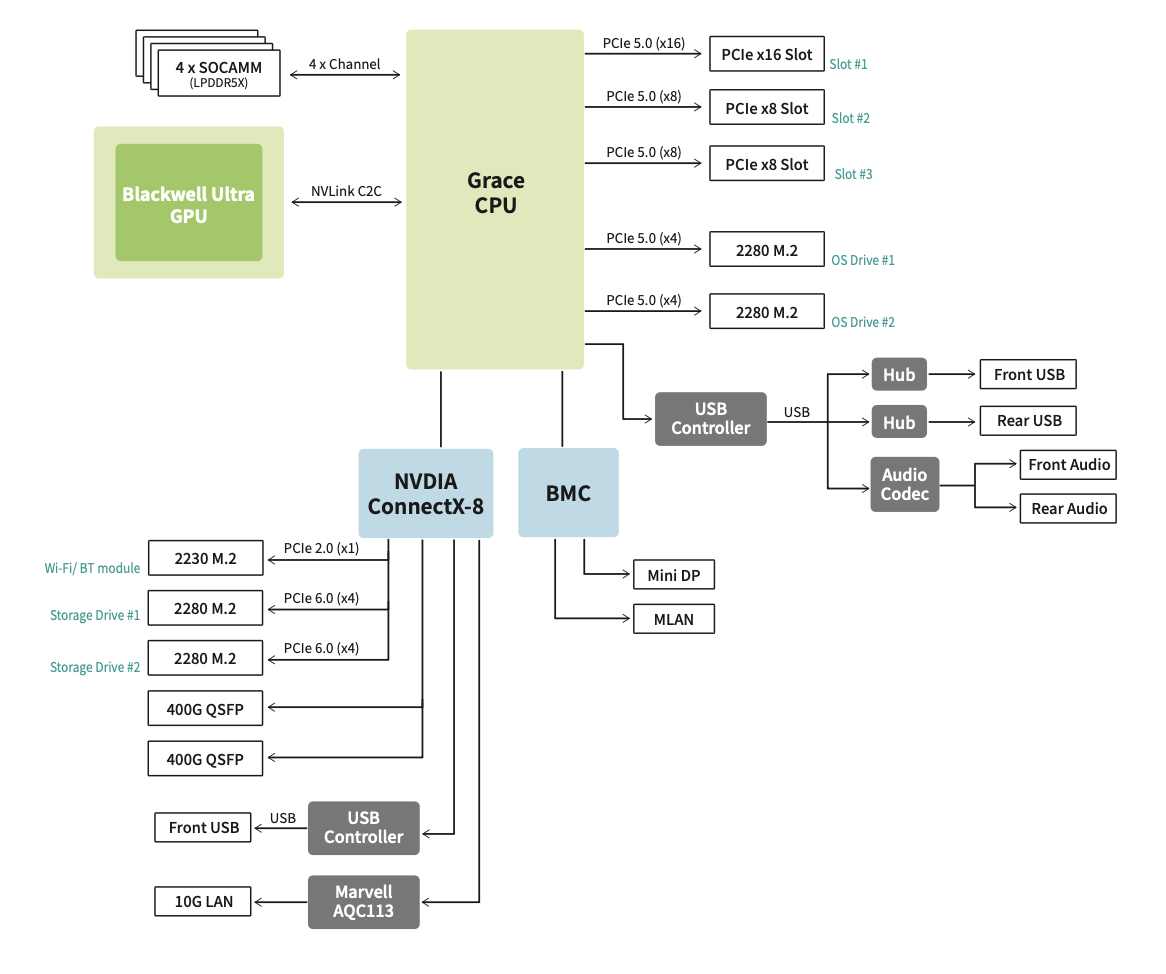
另一大分店是NVIDIA的ConnectX-8 SuperNIC。它最顯著的特點是後面板上的兩個400GbE QSFP112端口,可提供高達800Gb/s的聚合網路頻寬。 ConnectX-8還整合了一個48通道的PCIe交換器;其上行鏈路支援PCIe Gen6,但其下行埠僅支援PCIe 5.0,這使得MSI可以將其用作輔助I/O集線器,而不僅僅是一個網路適配器。
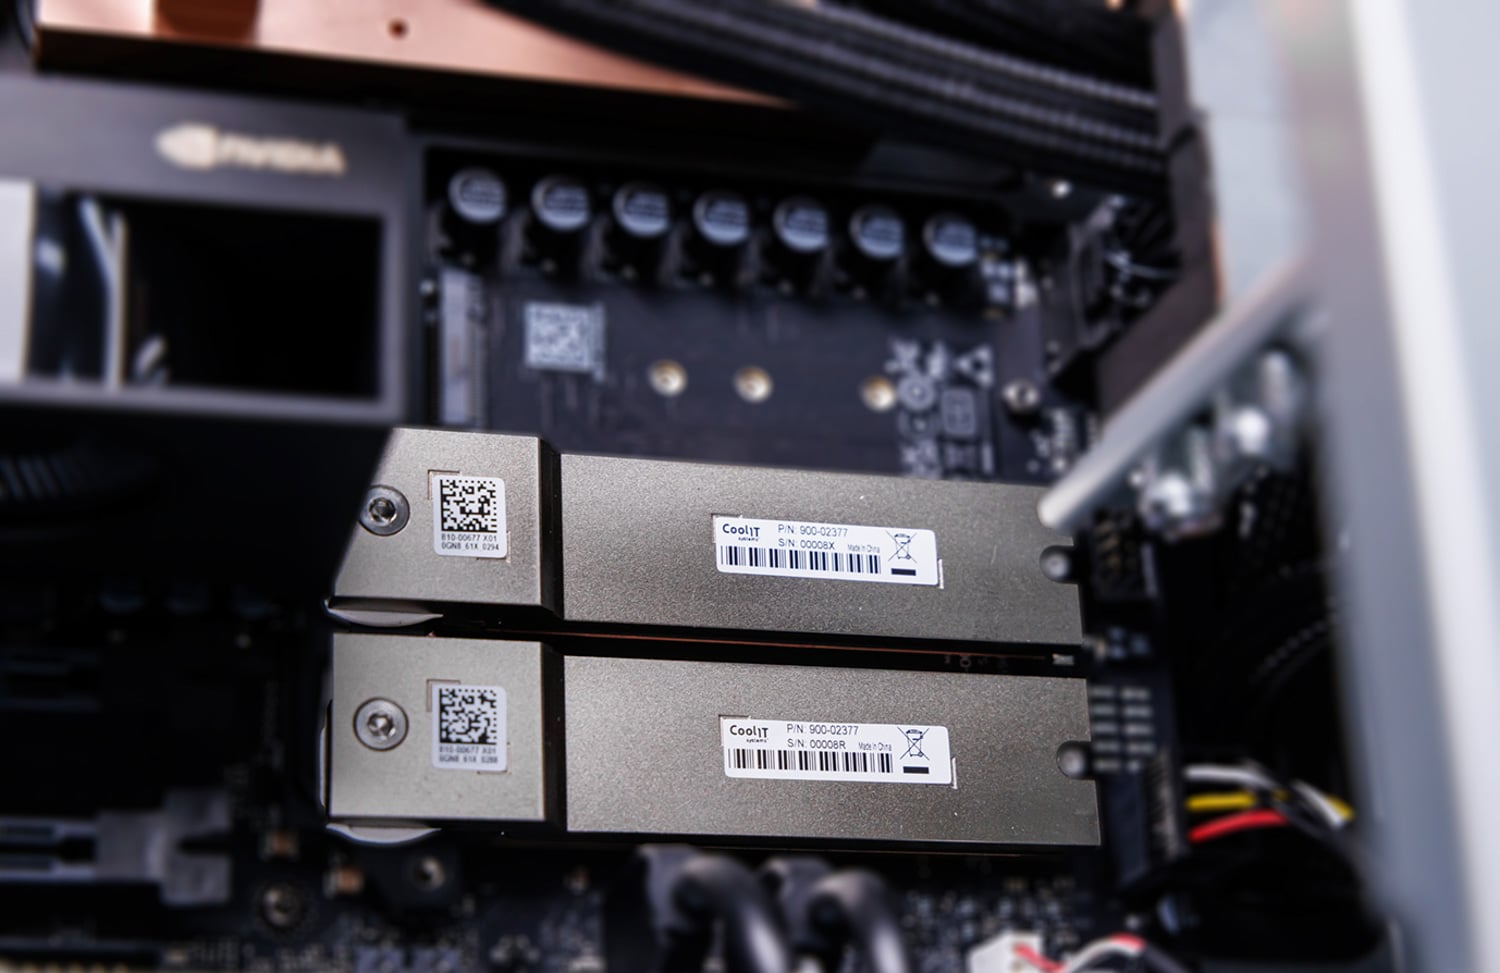
ConnectX-8 的兩個 PCIe 5.0 x4 連結為剩餘的 M.2 2280 插槽供電,MSI 將這些插槽預留用於擴充。同一條鏈路還透過 PCIe 2.0 x1 連接了 M.2 2230 Wi-Fi 和藍牙插槽、用於 10GBase-T 連接埠的 Marvell AQC113 控制器,以及為額外的前面板 USB 介面提供服務的第二個 USB 控制器。
電源和冷卻
WS300 由一個 1,600W 80 PLUS 白金認證的 ATX 電源供電,該電源採用 C19 輸入介面。對於北美地區的安裝,DGX Station 需要一條專用的 20A 電路才能滿足系統的全部功率需求。
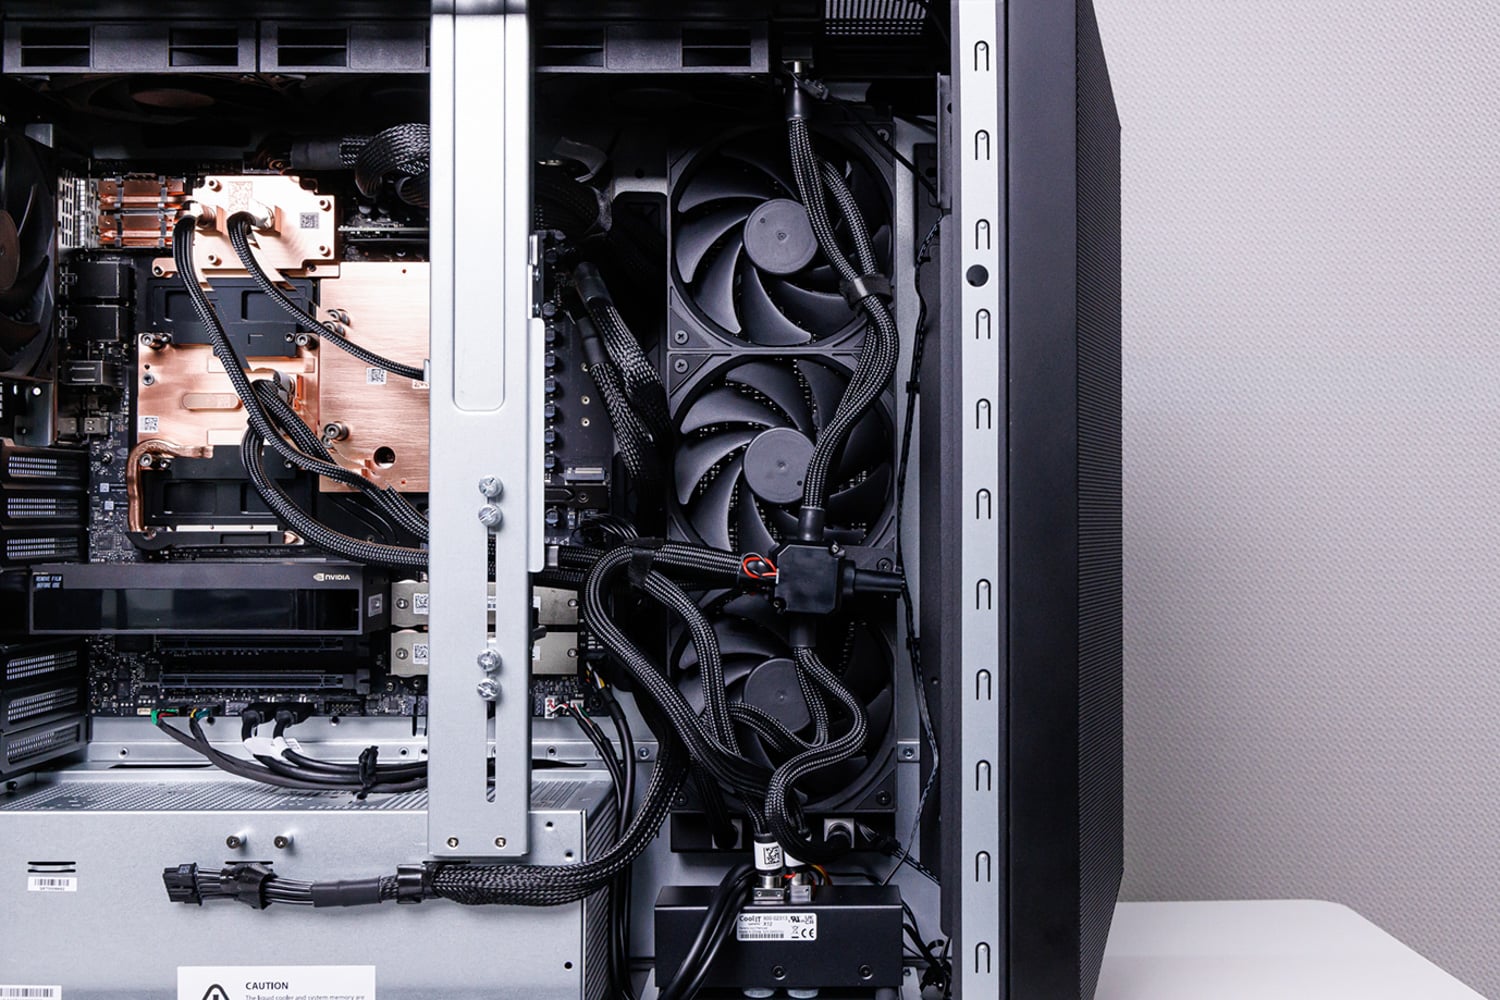
1,600W 的額定功率是整個系統的上限。 Grace、B300、儲存設備、水泵、風扇以及任何可選的 RTX PRO 顯示卡都使用同一個電源供應器。增加高功率顯示卡可以擴展 WS300 的效能,但它並不會使用額外的電源。當 B300 和 RTX 顯示卡同時處於高負載運作時,它們必須共享現有的電源,這可能會降低 B300 GPU 的效能。
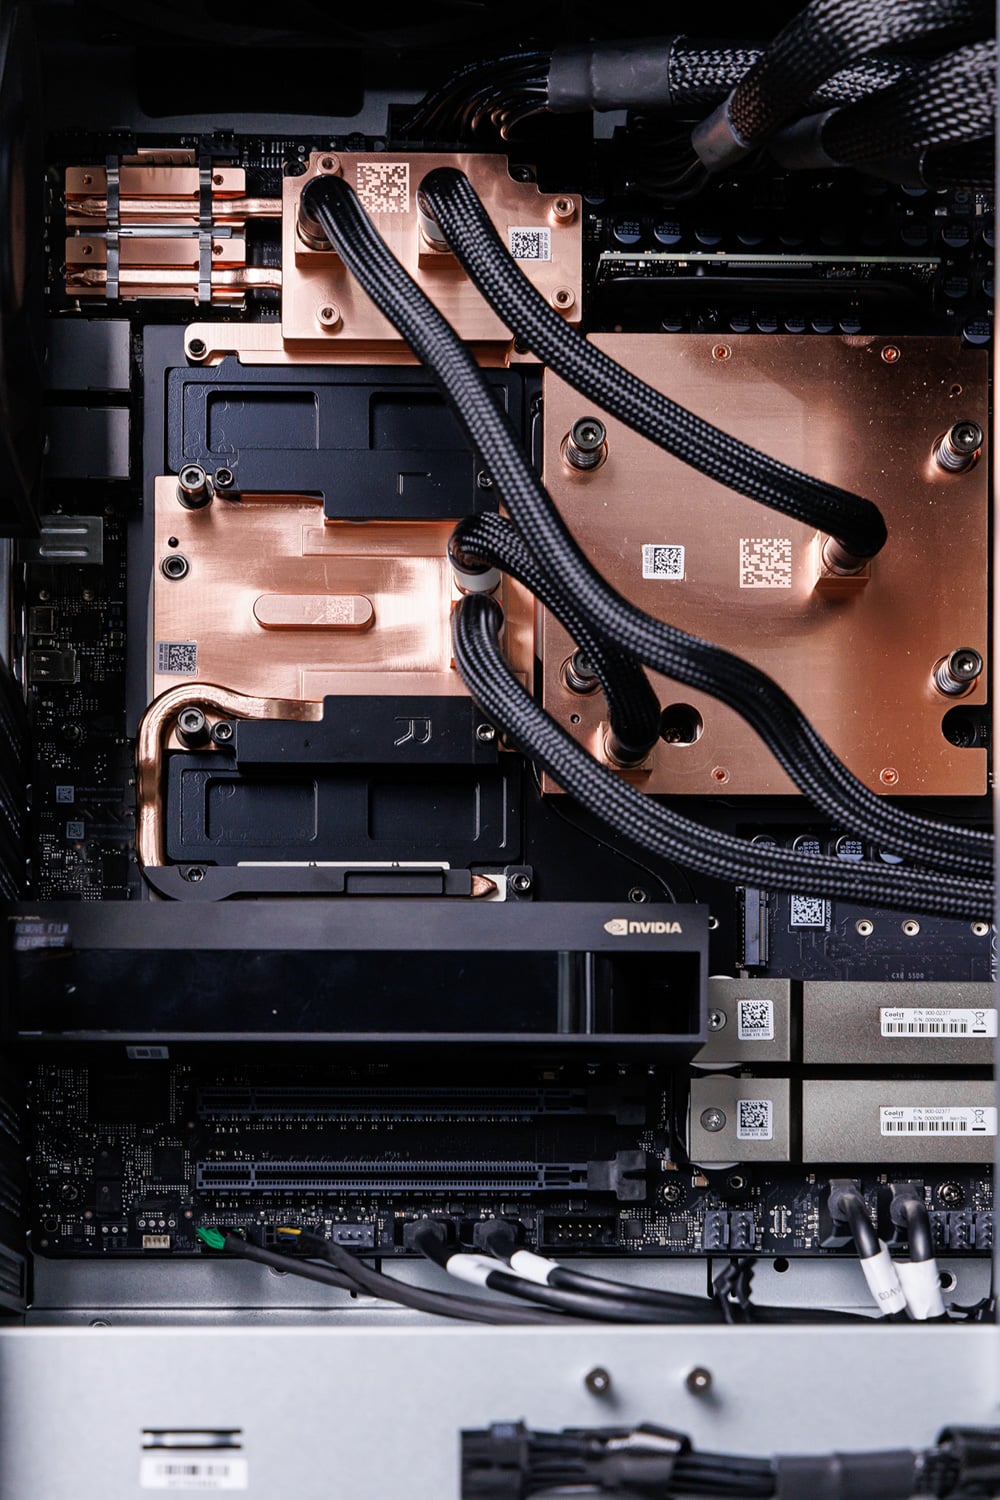
MSI採用客製化水冷系統來應對由此產生的散熱負載,該系統覆蓋B300主機板、Grace CPU、SOCAMM記憶體、ConnectX-8介面以及光驅籠。熱量透過兩個360mm冷排排出,同時一個獨立的120mm風扇負責機殼其他部分的散熱。 MSI官方標稱此散熱系統可為CPU和GPU提供高達1,400W的功率。在我們的測試中,B300主機板的最高溫度為71℃,而CPU在GPU功耗高達1292W的情況下,溫度從未超過65℃。
電力晃動
NVIDIA 透過 vsloshd 服務管理共享預算。在預設的動態模式下,該服務會即時監控 GB300 模組和可選的 RTX PRO 顯示卡的功耗,並在兩者之間靈活分配可用預算,而不是將每個裝置的功耗限制在固定值。根據目前的策略,RTX 顯示卡享有優先權,因此當它需要更多電力時,系統會先降低 GB300 的功耗上限,然後再提高 RTX 的功耗上限。如果沒有安裝 RTX 顯示卡,則 GB300 模組仍可獲得全部預算。
這意味著可選的 RTX PRO 6000 並非只是在 B300 的基礎上增加效能。當兩塊 GPU 都處於高負載運行時,分配給 RTX 顯示卡的電力會直接從 GB300 的預算中扣除,這可能會降低 B300 的頻率和效能。
該平台還包含一個硬體功率煞車器,用於應對系統偵測到供電下降的情況。我們在實際測試中就遇到了這種情況:電源連接器鬆動導致 WS300 降低功率限制,而不是關機或繼續透過受損的連接以全功率運行。機器以低功耗狀態保持在線,直到連接問題解決。
連線能力
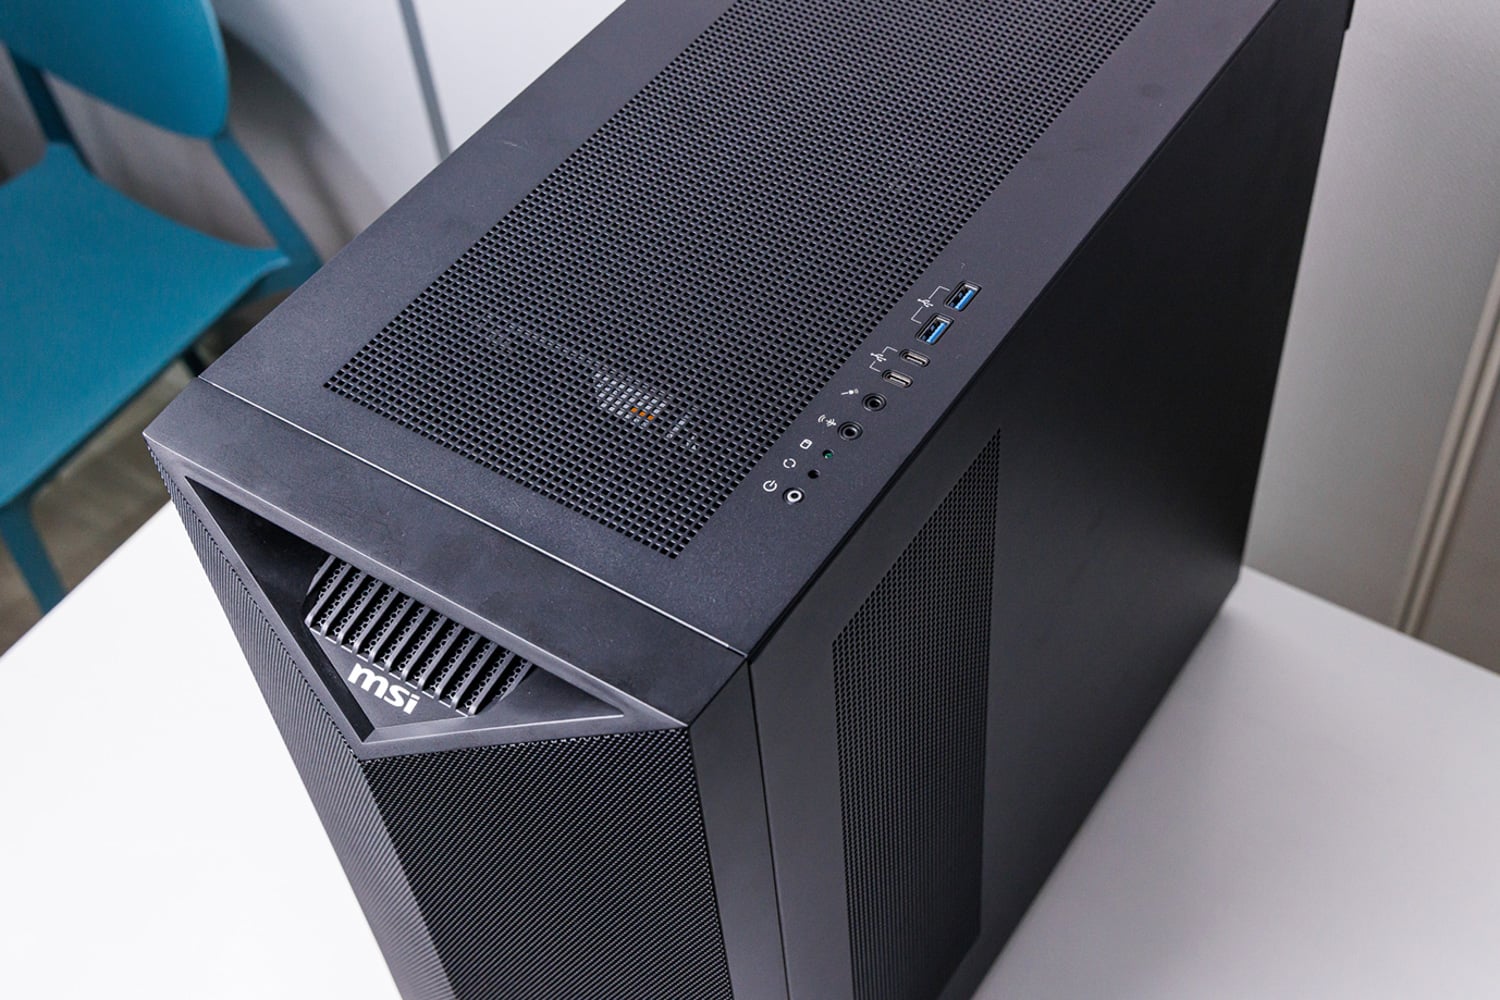
在繼續介紹機箱之前,不妨先快速看一下前置和後置I/O介面。前置I/O接口包括兩個USB 3.2 Gen 2 Type-A接口、兩個USB 3.2 Gen 2 Type-C接口、獨立的線路輸出和麥克風接口,以及電源和重啟控制按鈕。
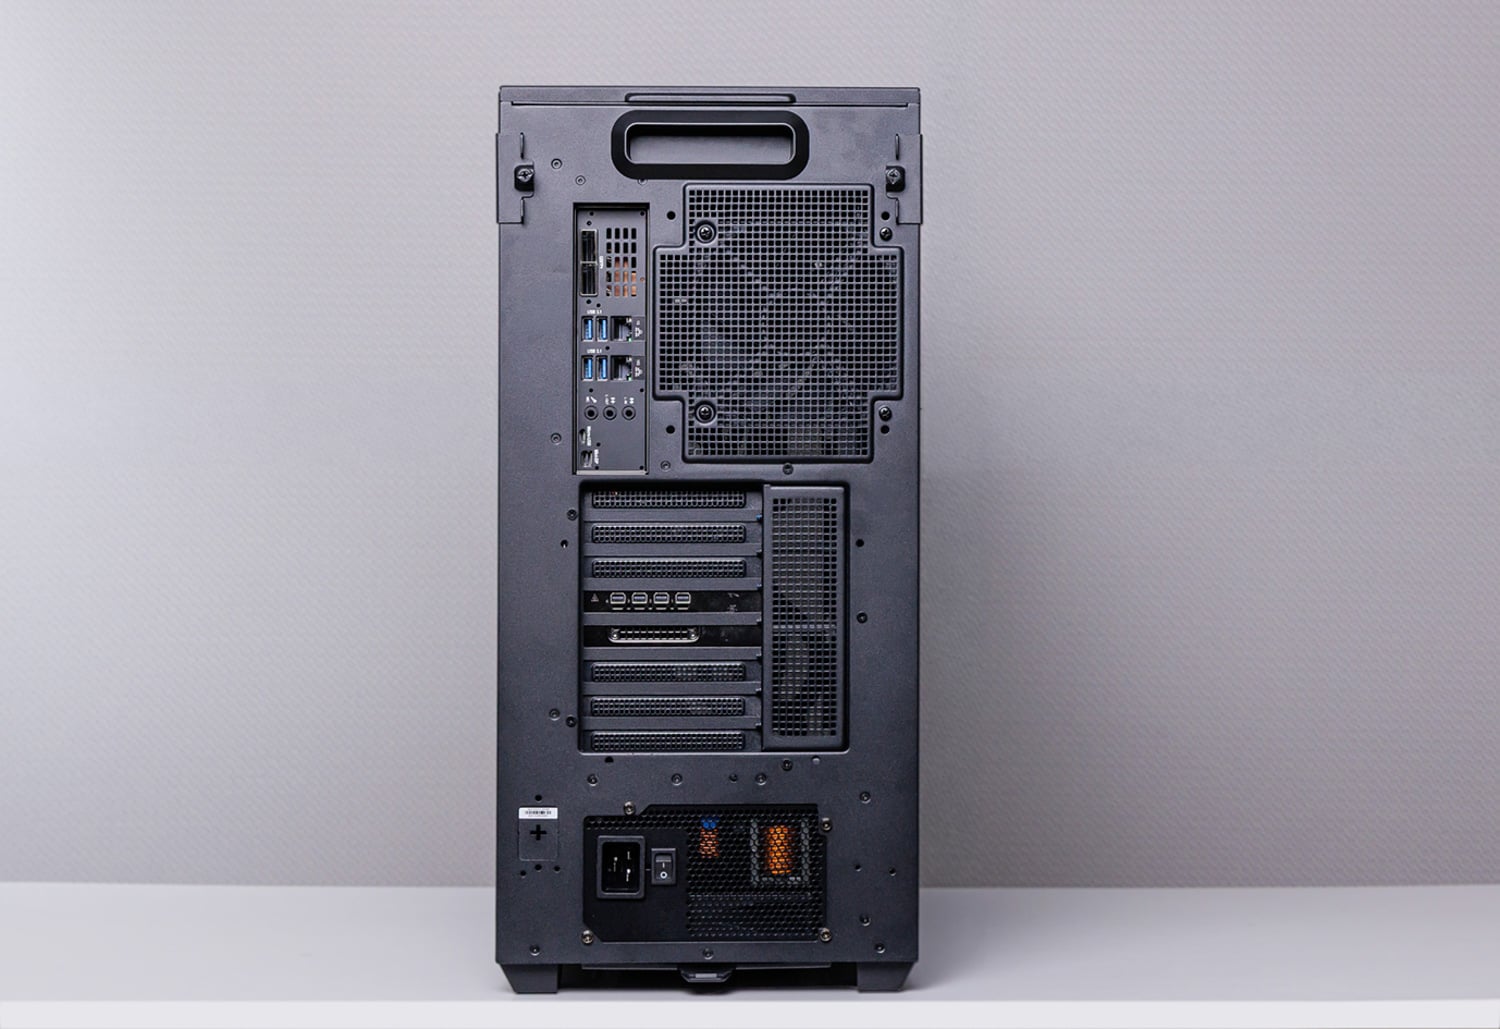
後面板分為工作站介面和下方的伺服器硬體兩部分。 ConnectX-8 提供兩個 400GbE QSFP112 端口,一個獨立的 10GBase-T 端口用於處理常規主機網路連接,一個專用的 1GbE 端口連接到 BMC。四個 10Gbps USB Type-A 連接埠和三個音訊介面用於連接本地週邊。 BMC 還提供一個 Micro-USB 串列埠控制台和一個 Mini DisplayPort 介面。 C19 電源介面位於機殼底部,可透過內部的 M.2 2230 Key-E 插槽新增支援藍牙的 Wi-Fi 6E 或 Wi-Fi 7 模組。
桌面上的資料中心工作負載
以上內容主要介紹了DGX Station的功能;對買家而言,更重要的問題是XpertStation能為團隊帶來哪些功能。 WS300的價值在於,它不僅是一個高容量推理系統,更是一個開發平台。其B300 GPU、Grace CPU、MIG支援、可選的RTX PRO顯示卡以及資料中心軟體棧,將通常依賴共享叢集硬體的多種工作流程移植到了單一本地節點上。
MIG 作為開發工具
想像一下,在同一塊 GPU 上同時執行多個完全獨立的作業,每個作業都與其他作業完全隔離。這就是多執行個體 GPU (MIG) 的工作原理:它在硬體層面上將 B300 分割成多達七個大小相等的切片,即實例。每個實例都擁有自己固定的 SM、HBM、快取和記憶體頻寬份額,擁有獨立的裝置標識,並且在 CUDA 中被視為一個獨立的 GPU。
這使得開發、測試和驗證多 GPU 工作負載;訓練腳本;以及為 Dynamo、LLM-D 等工具進行開發成為可能。
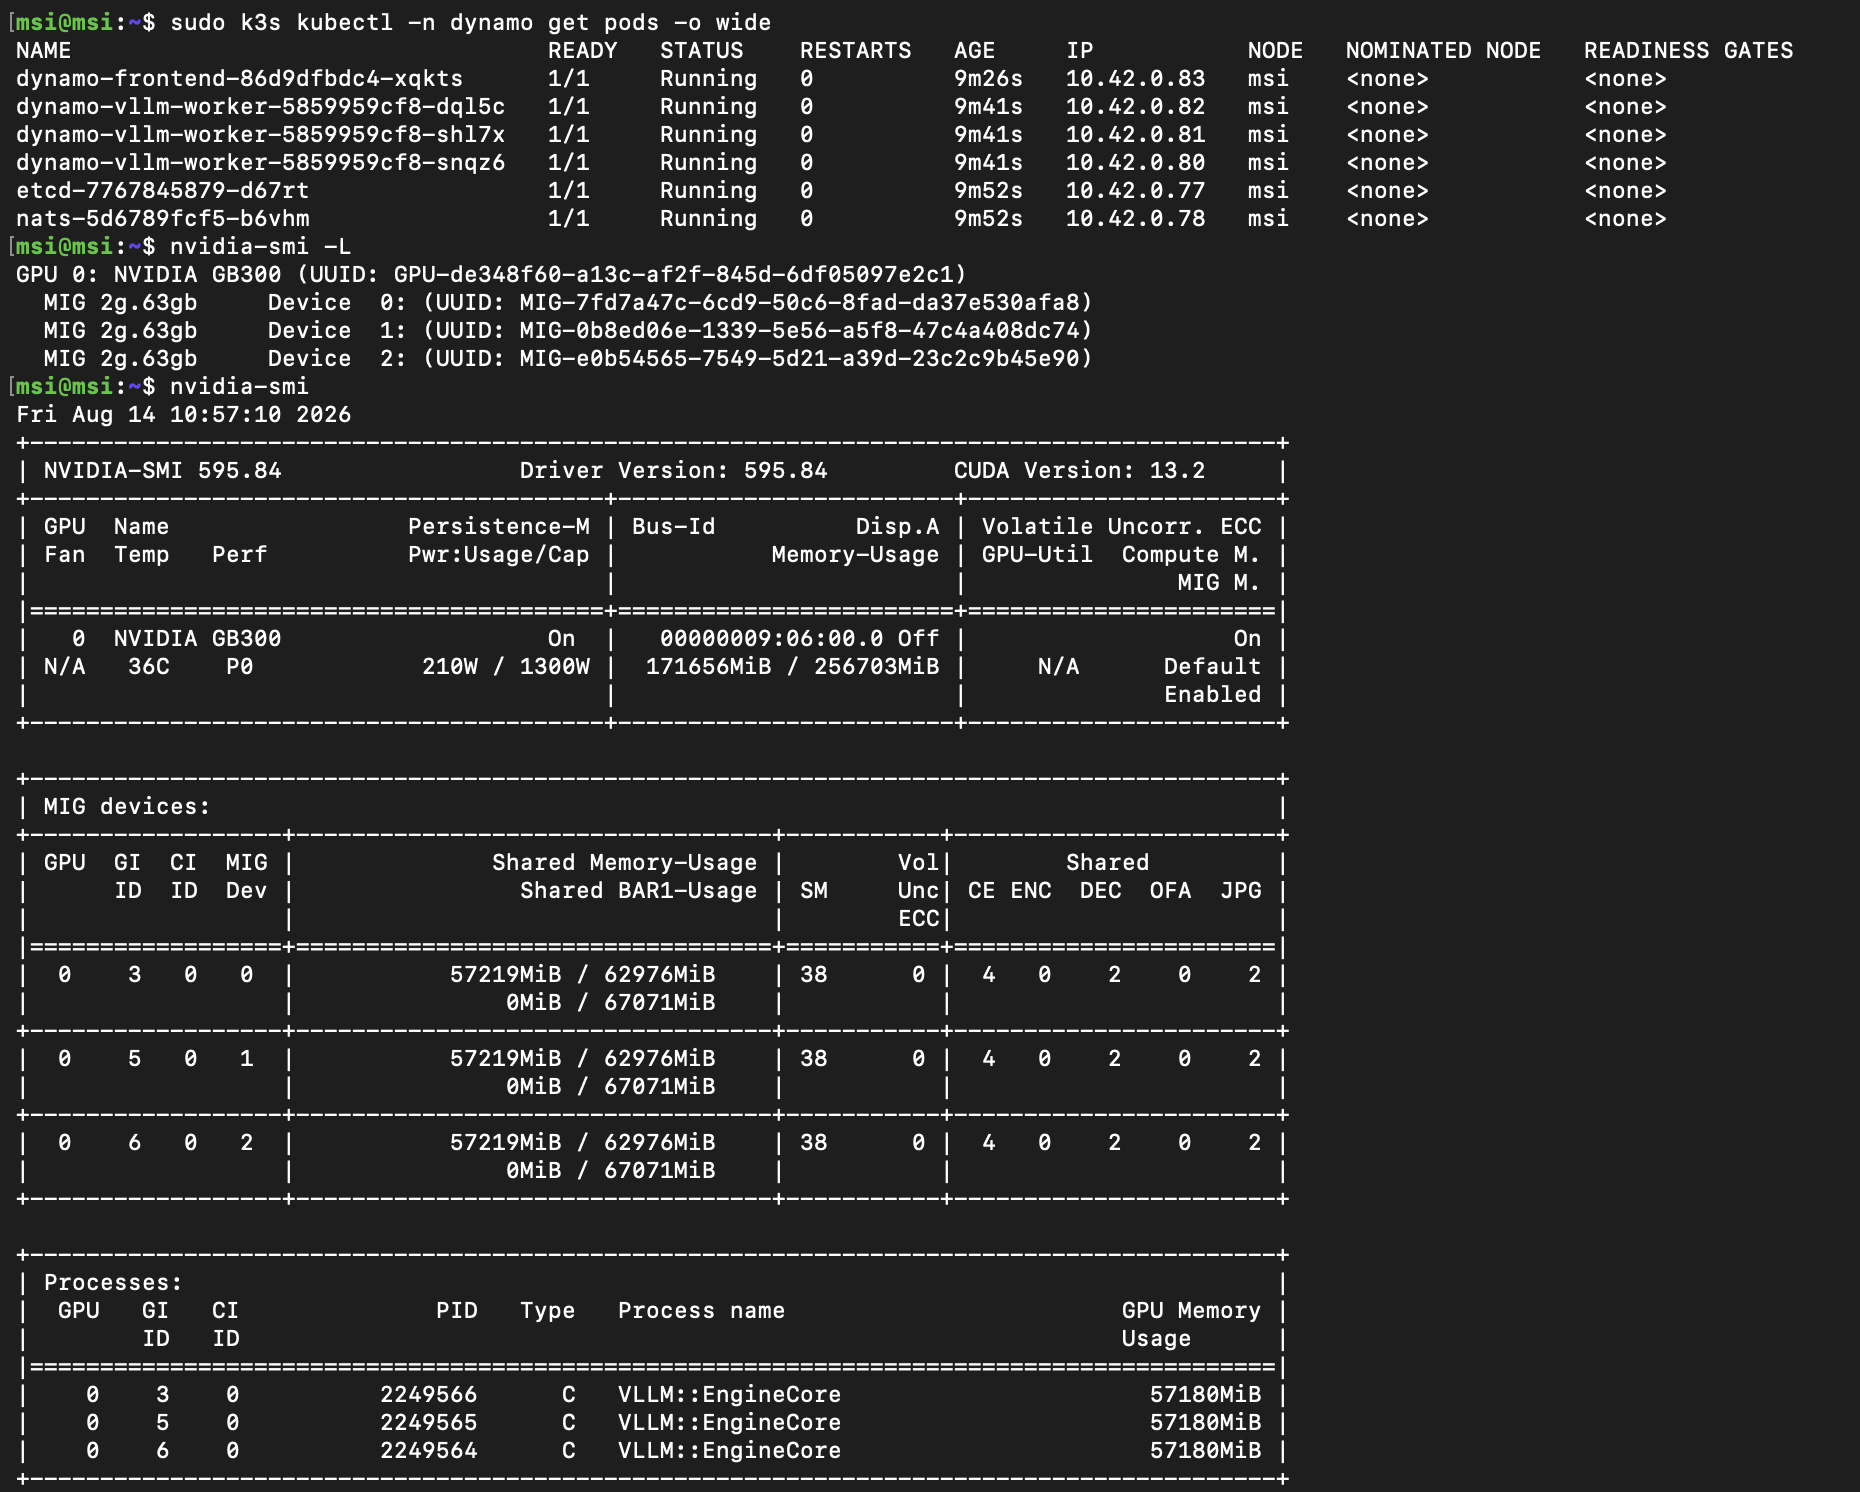
為了進行測試,我們在 B300 上配置了 3 個 MIG 實例,並使用它們在不同的 CUDA 可見設備上啟動 NVIDIA Dynamo 元件。這與我們建立基準測試工具的方式非常相似:驗證其行為是否完全符合預期,這意味著需要反覆在真實硬體上進行迭代測試。擁有一個可以隨時劃分和重新配置的本地 B300,無需佔用共享伺服器的時間,也無需承受機架帶來的功耗、發熱和噪音,這大大降低了此類迭代工作的開銷。
Isaac GR00T 與實體人工智慧循環
另一個特別適合 DGX Station 的工作流程是實體人工智慧。
我們之前測試過這種工作流程,但它需要多台配備不同類型GPU的系統。 DGX Station將先前這些獨立的步驟整合到一台桌上型設備上。
整個流程始於遠端操控:操作員引導機器人完成任務,以採集少量真實場景演示資料。這些數據隨後進入 Isaac GR00T 工作流程。可選的 RTX PRO GPU 負責處理 Isaac Sim 的圖形和光線追蹤需求,而 Isaac Lab 和 GR00T-Mimic 則將原始演示資料擴展為更大規模、更符合物理規律的合成軌跡集合。最後,B300 使用真實場景和合成場景相結合的資料集對 GR00T 模型進行微調。
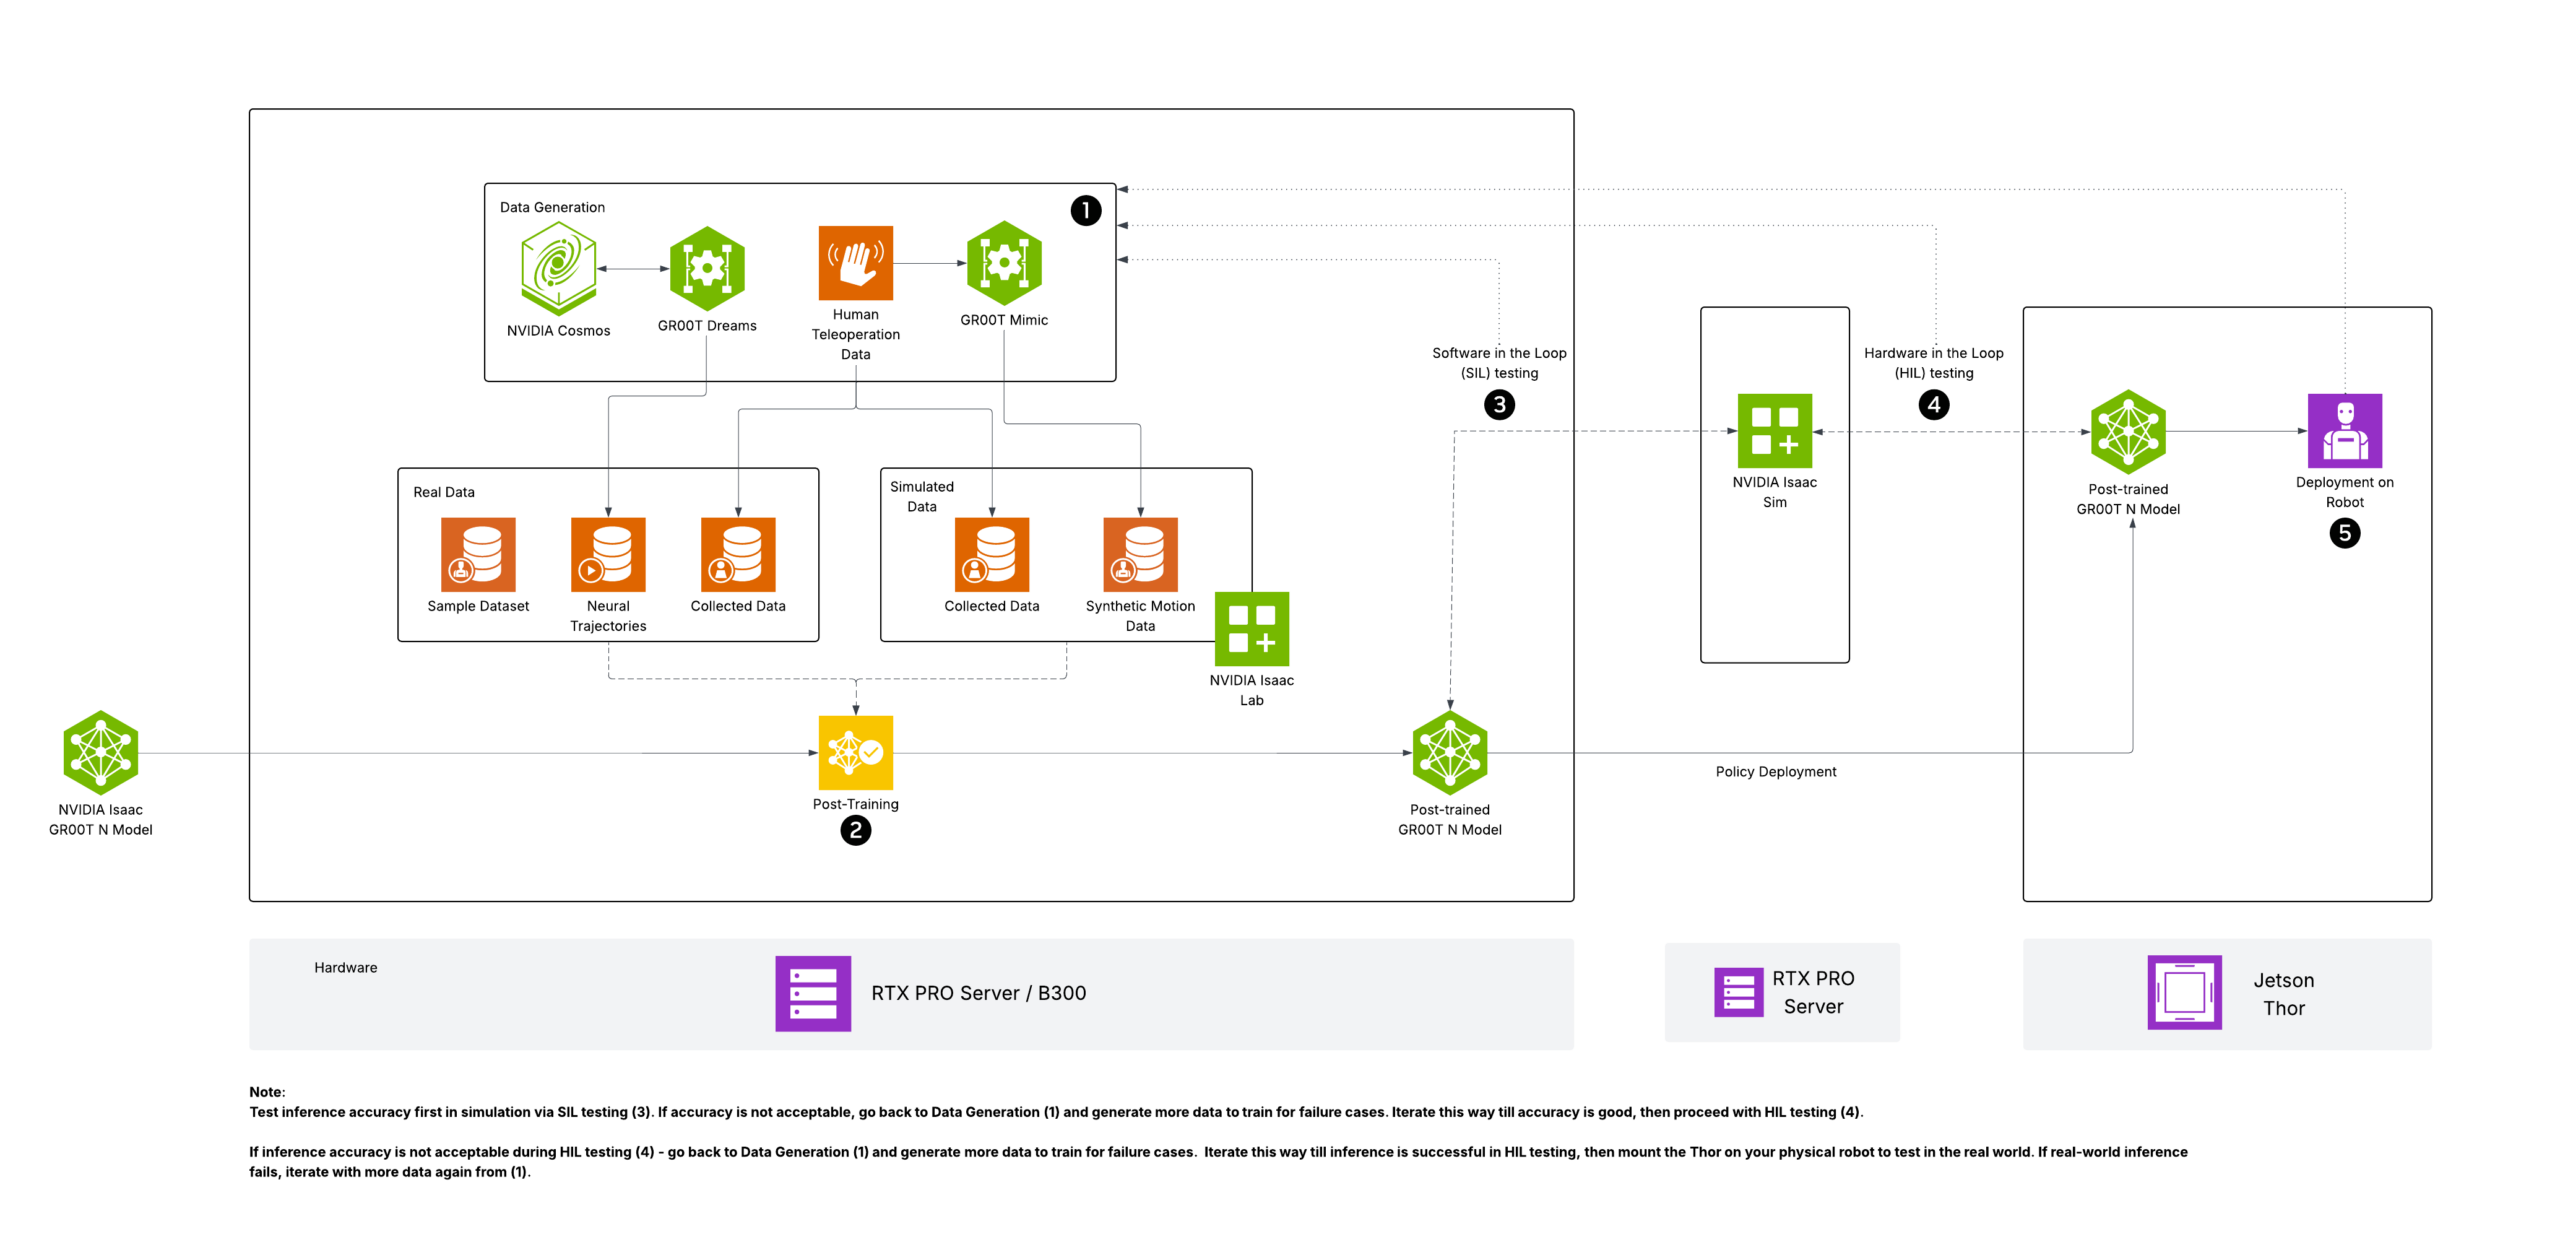
資料來源:英偉達
經過微調後,最終的策略可以在部署到機器人上進行實際評估之前,先在模擬環境中進行驗證。這形成了一個緊湊的開發循環:捕捉真實演示,在模擬環境中重現並調整演示參數,重新訓練模型,然後在硬體上測試更新後的策略。對於那些機器人、操作人員或資料收集視窗有限的團隊來說,將模擬、合成資料產生和模型訓練整合到一個桌面系統中,可以顯著減少每次迭代的阻力。
Blackwell Ultra 核心開發
然而,DGX Station 的最佳應用場景無疑是內核優化。當團隊為 Blackwell Ultra 編寫 CUDA 或 Triton 核心時,在目標架構上運行是必不可少的。 WS300 將 B300 和 252GB HBM3e 記憶體放置在開發人員旁邊,使他們能夠分析實際工作負載、檢查記憶體行為、調整 Tensor Core 路徑、融合操作並進行迭代,而無需佔用八 GPU 伺服器或機架級系統的時間。
大型系統仍然重要,但可以專門用於真正需要它們的工作:例如 NVLink 擴展、NCCL 集體計算、通訊核心、多 GPU 推理以及最終吞吐量驗證。 WS300 在本地處理單 GPU 核心工作,從而使那些昂貴的共享系統能夠用於擴展測試。對於專注於 Blackwell Ultra 優化的團隊來說,這幾乎是市場上最直接的開發機器了。
如果 DGX Station 與首批 Blackwell Ultra 系統一同發售,我們估計首批產品會立即被 AI 實驗室、編譯器團隊、推理引擎開發者以及其他爭相為 B300 優化軟體的團隊搶購一空。即便現在,直接造訪目標 GPU 或許仍是企業購買 DGX Station 的最直接原因。
性能
測試說明:測試在 MSI 提供的遠端系統上進行,StorageReview 在整個評估過程中控制了所有軟體環境。測試系統未安裝 RTX PRO GPU 或任何其他 PCIe 擴充卡。因此,GB300 Superchip 在整個測試過程中都能充分利用系統的加速器功率。
最大可實現 Matmul FLOPS (MAMF)
首先,為了更了解 B300 的運算能力,我們在三台 Blackwell 架構的系統上執行 MAMF 測試。 MAMF(最大可達矩陣乘法 FLOPS)是一種實用的效能指標,旨在衡量機器學習加速器在矩陣乘法運算中實際可達到的峰值浮點運算速度,它比硬體規格中通常宣傳的理論峰值 FLOPS 更準確。
在本測試中,我們對 BF16、FP8 和 NVFP4 中的 3 個系統分別進行掃描,並報告每個精確度下最佳的持續(密集)結果。
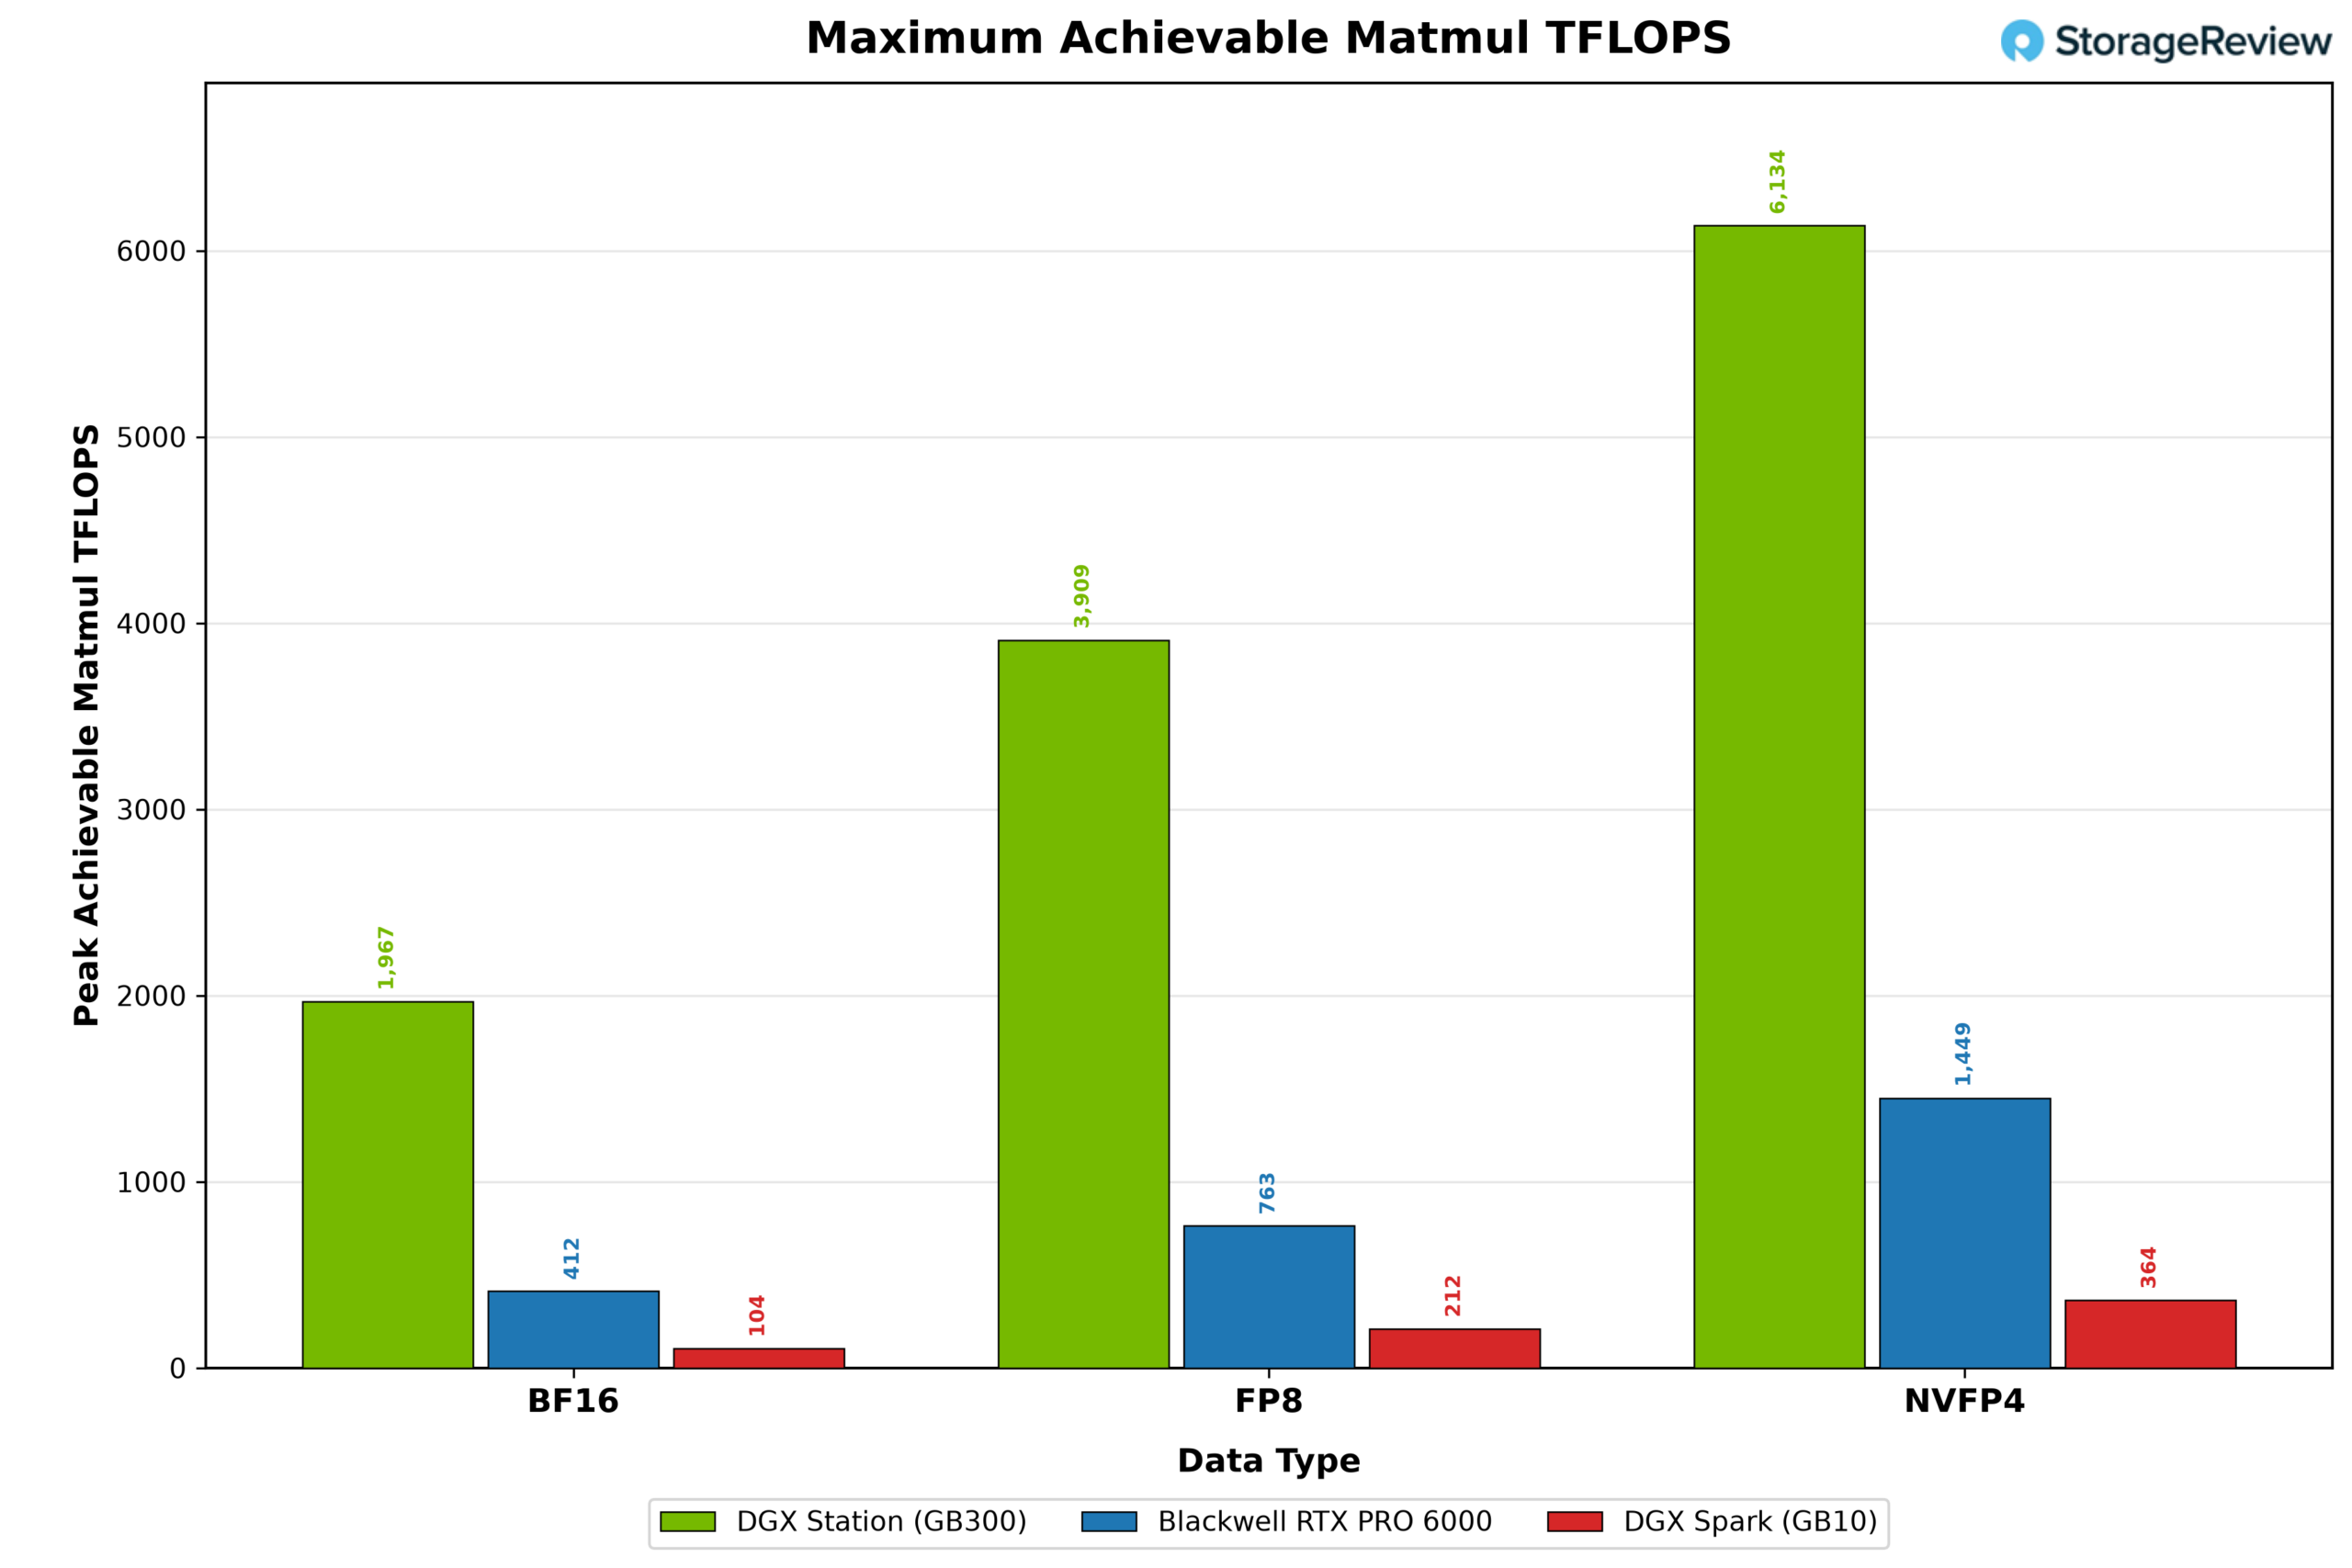
GB300 在所有精度下都遙遙領先。在《戰地16》測試中,其性能達到 1,967 TFLOPS,而RTX PRO 6000和DGX Spark分別為 412 TFLOPS 和 104 TFLOPS。 FP8的性能表現也類似:分別為 3,909、763 和 211 TFLOPS。 NVFP4 性能使 GB300 達到 6,134 TFLOPS,RTX PRO 6000 為 1,449 TFLOPS,Spark 為 364 TFLOPS。在所有三種精準度下,效能比都非常穩定:GB300 比 RTX PRO 6000 領先 4 到 5 倍,比 Spark 領先 17 到 19 倍,而 RTX PRO 6000 則始終保持比 Spark 大約 4 倍的優勢。
NVB 頻寬
只有當加速器能夠持續為其執行單元提供資料時,原始運算吞吐量才有意義。這對於人工智慧推理尤其重要,因為在解碼階段產生令牌通常更多地受限於記憶體頻寬,而非可用的浮點運算次數。
在 GB300 超級晶片上,這種層級結構涵蓋了 B300 的本地 HBM3e 顯存、Grace 的 LPDDR5X 顯存以及連接它們的 NVLink-C2C 互連。 NVIDIA 的 NVBandwidth 工具會測試這些元件之間的不同資料複製路徑,從而顯示 GPU 內部的可用頻寬以及在 GPU 和 CPU 記憶體域之間傳輸資料的成本。
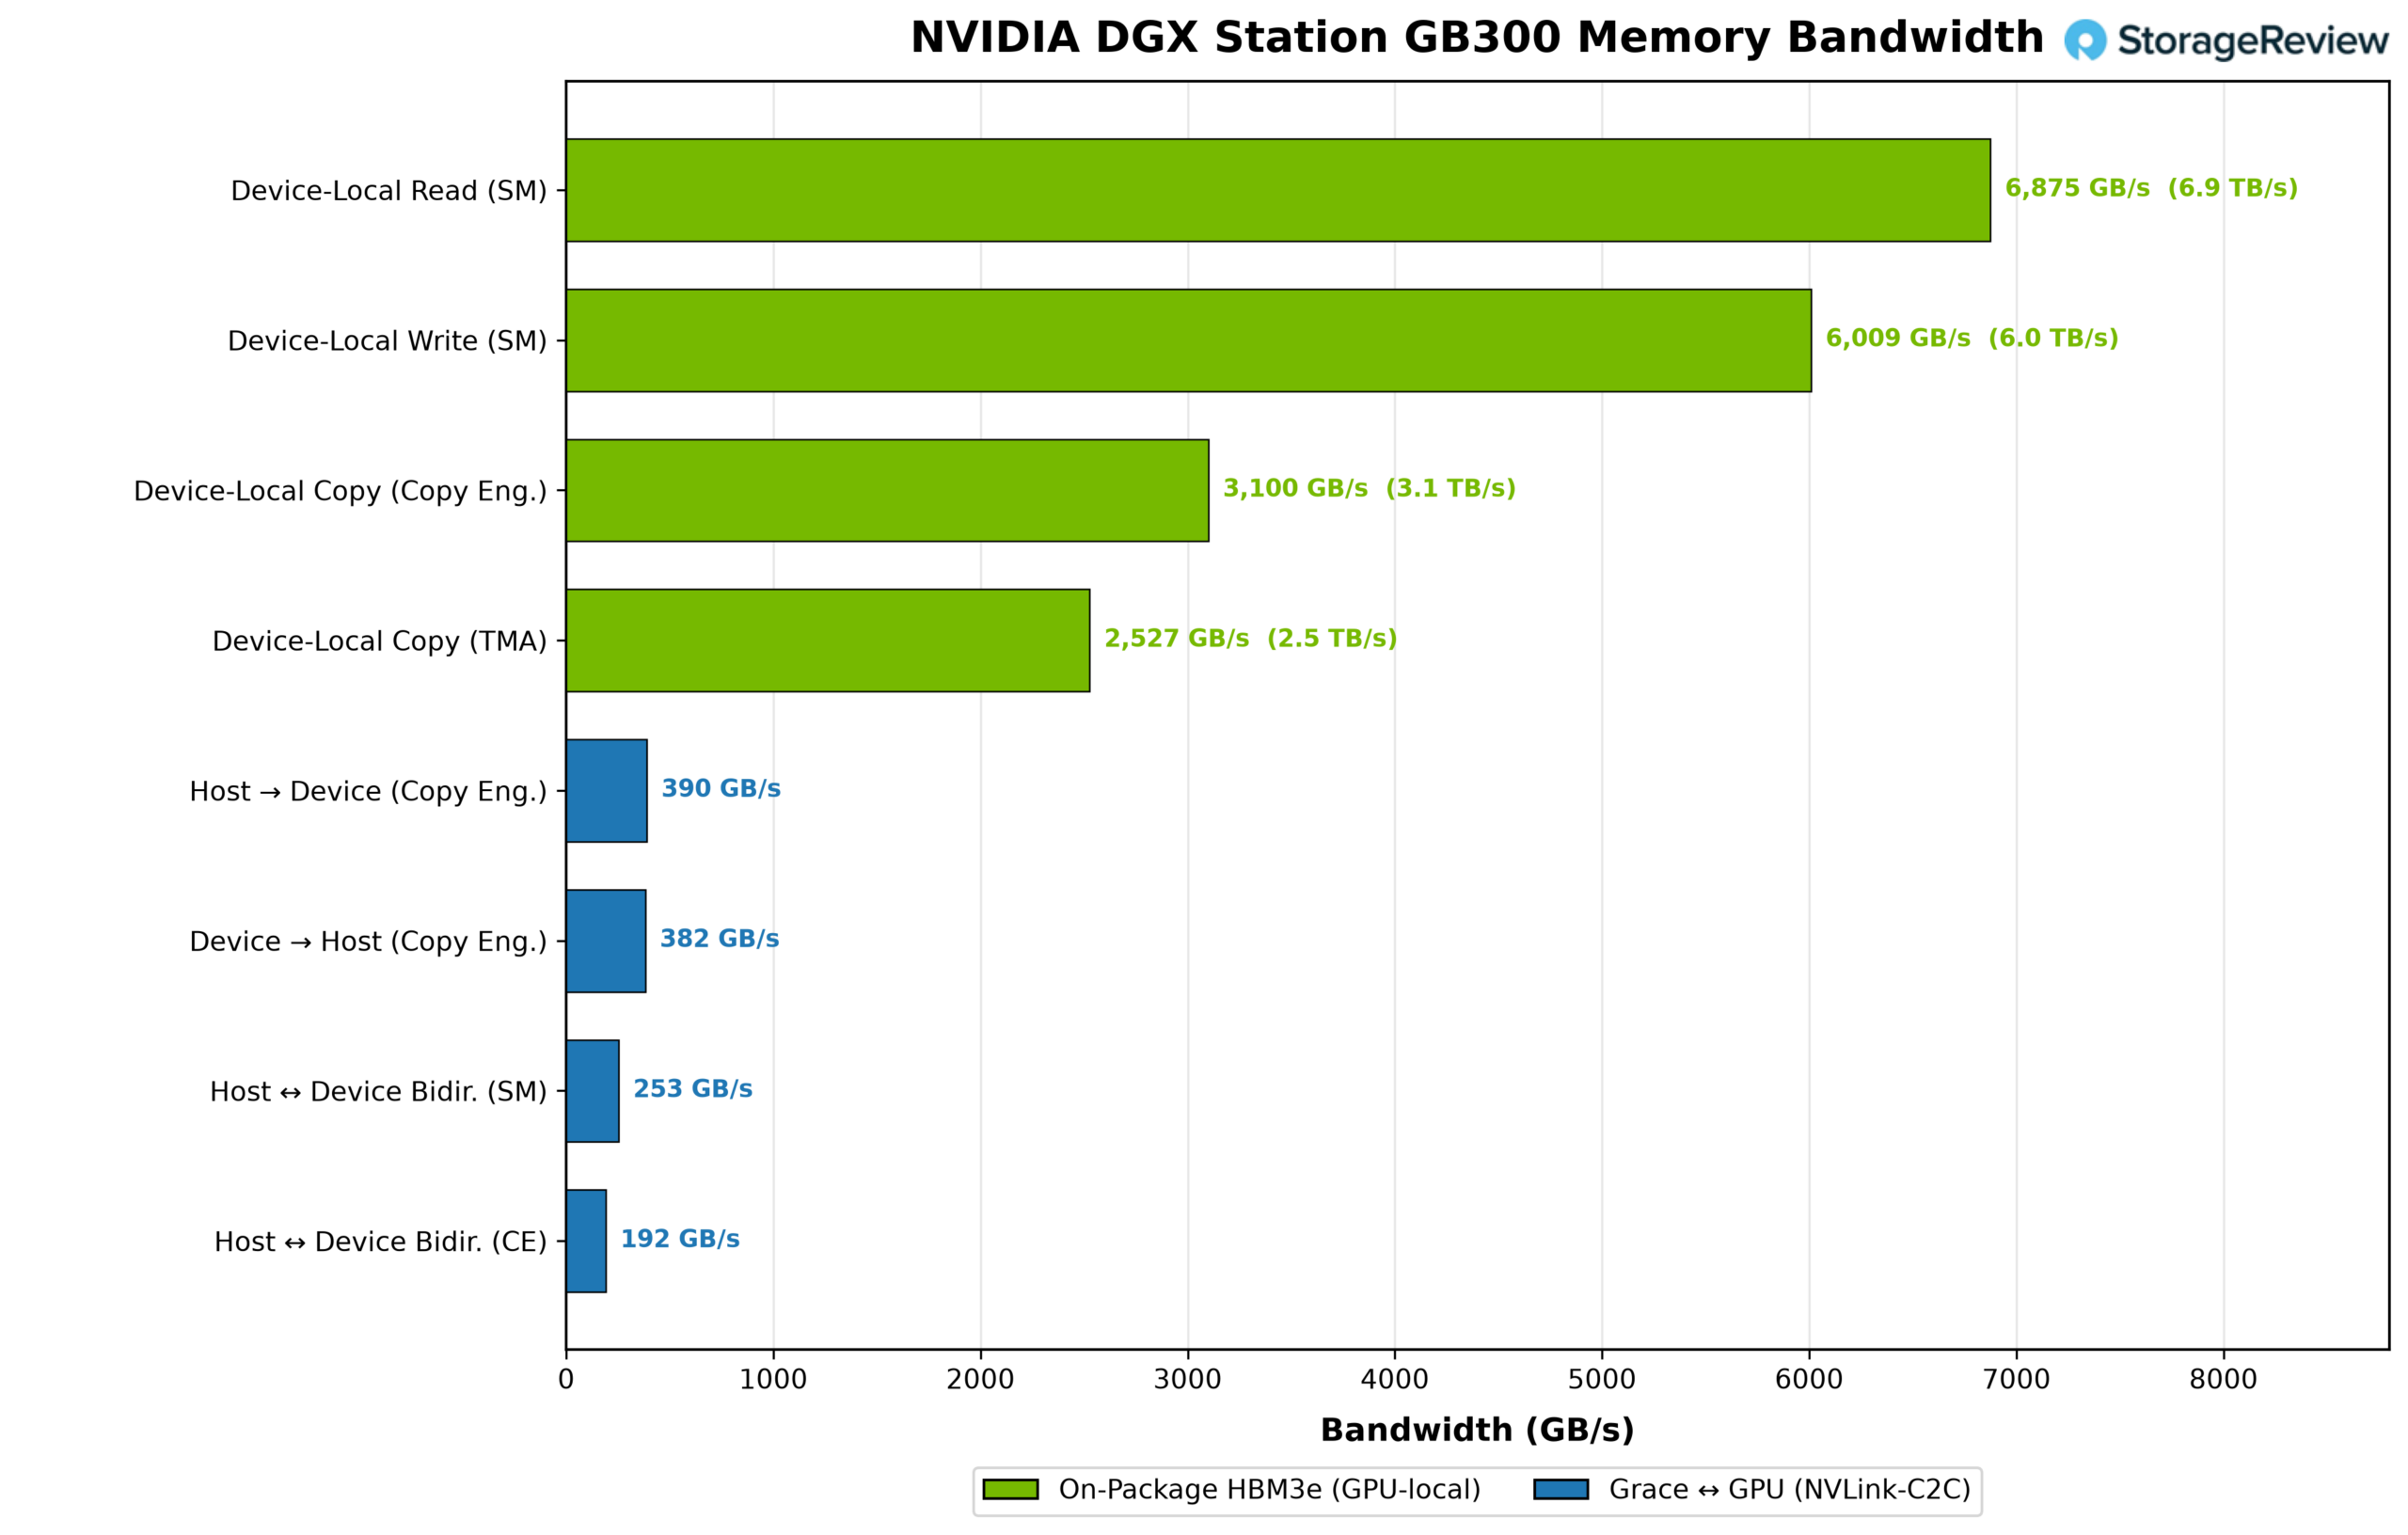
前四項測試測量了B300的252GB HBM3e顯存內的資料傳輸速度。設備本地讀取速度達到6,875 GB/s,約6.9 TB/s,與GPU標稱的7.1 TB/s顯存頻寬僅相差幾個百分點。裝置本地寫入速度達到6,009 GB/s。
HBM 到 HBM 的複製操作速度較慢,因為每次複製都會消耗兩次頻寬:一次用於讀取來源數據,一次用於寫入目標資料。專用複製引擎的速度可達 3,100 GB/s,而張量記憶體加速器 (Tensor Memory Accelerator) 的速度為 2,527 GB/s。
剩餘的測試透過 NVLink-C2C 連接,並存取 Grace 的 496GB LPDDR5X 記憶體。從 Grace 記憶體到 B300 HBM 的傳輸速度達到 390 GB/s,反向傳輸速度達到 382 GB/s。儘管 NVLink-C2C 可在 CPU 和 GPU 之間提供高達 900 GB/s 的相干頻寬,但測得的傳輸速度受限於 Grace 396 GB/s 的 LPDDR5X 記憶體頻寬。雙向傳輸進一步暴露了這個限制。使用基於 SM 的複製方式,並發流量達到 253 GB/s;而透過複製引擎,並發流量達到 192 GB/s。
推理
完成底層測驗後,我們接下來進行LLM推理。此時,重點將從峰值數量轉移到每秒令牌數、首次令牌到達時間以及負載下的延遲,從而更好地了解WS300作為服務系統的效能。
讓我們先來看看GB300 Superchip的核心優勢:它能夠支援容量介於B300 252GB HBM3e記憶體上限兩側的模型。而其748GB的一致性記憶體池正是在此發揮至關重要的作用。測試流程分為五個階段:首先是兩個可以輕鬆裝入HBM內存的模型;其次是一個勉強能裝下但運行時緩存和鍵值緩存空間不足的模型;最後是兩個必須將大部分計算量轉移到Grace內存的模型。
註:文中提及的模型均採用推測性解碼以提高解碼吞吐量,並將強制接受令牌的數量設定為推測性解碼令牌的數量。因此,結果顯示的是最佳情況下的效能;在實際服務中,吞吐量是動態的,並且取決於推測性解碼令牌的品質。
完全符合 HBM 的模型
DeepSeek v4 Flash (0731)
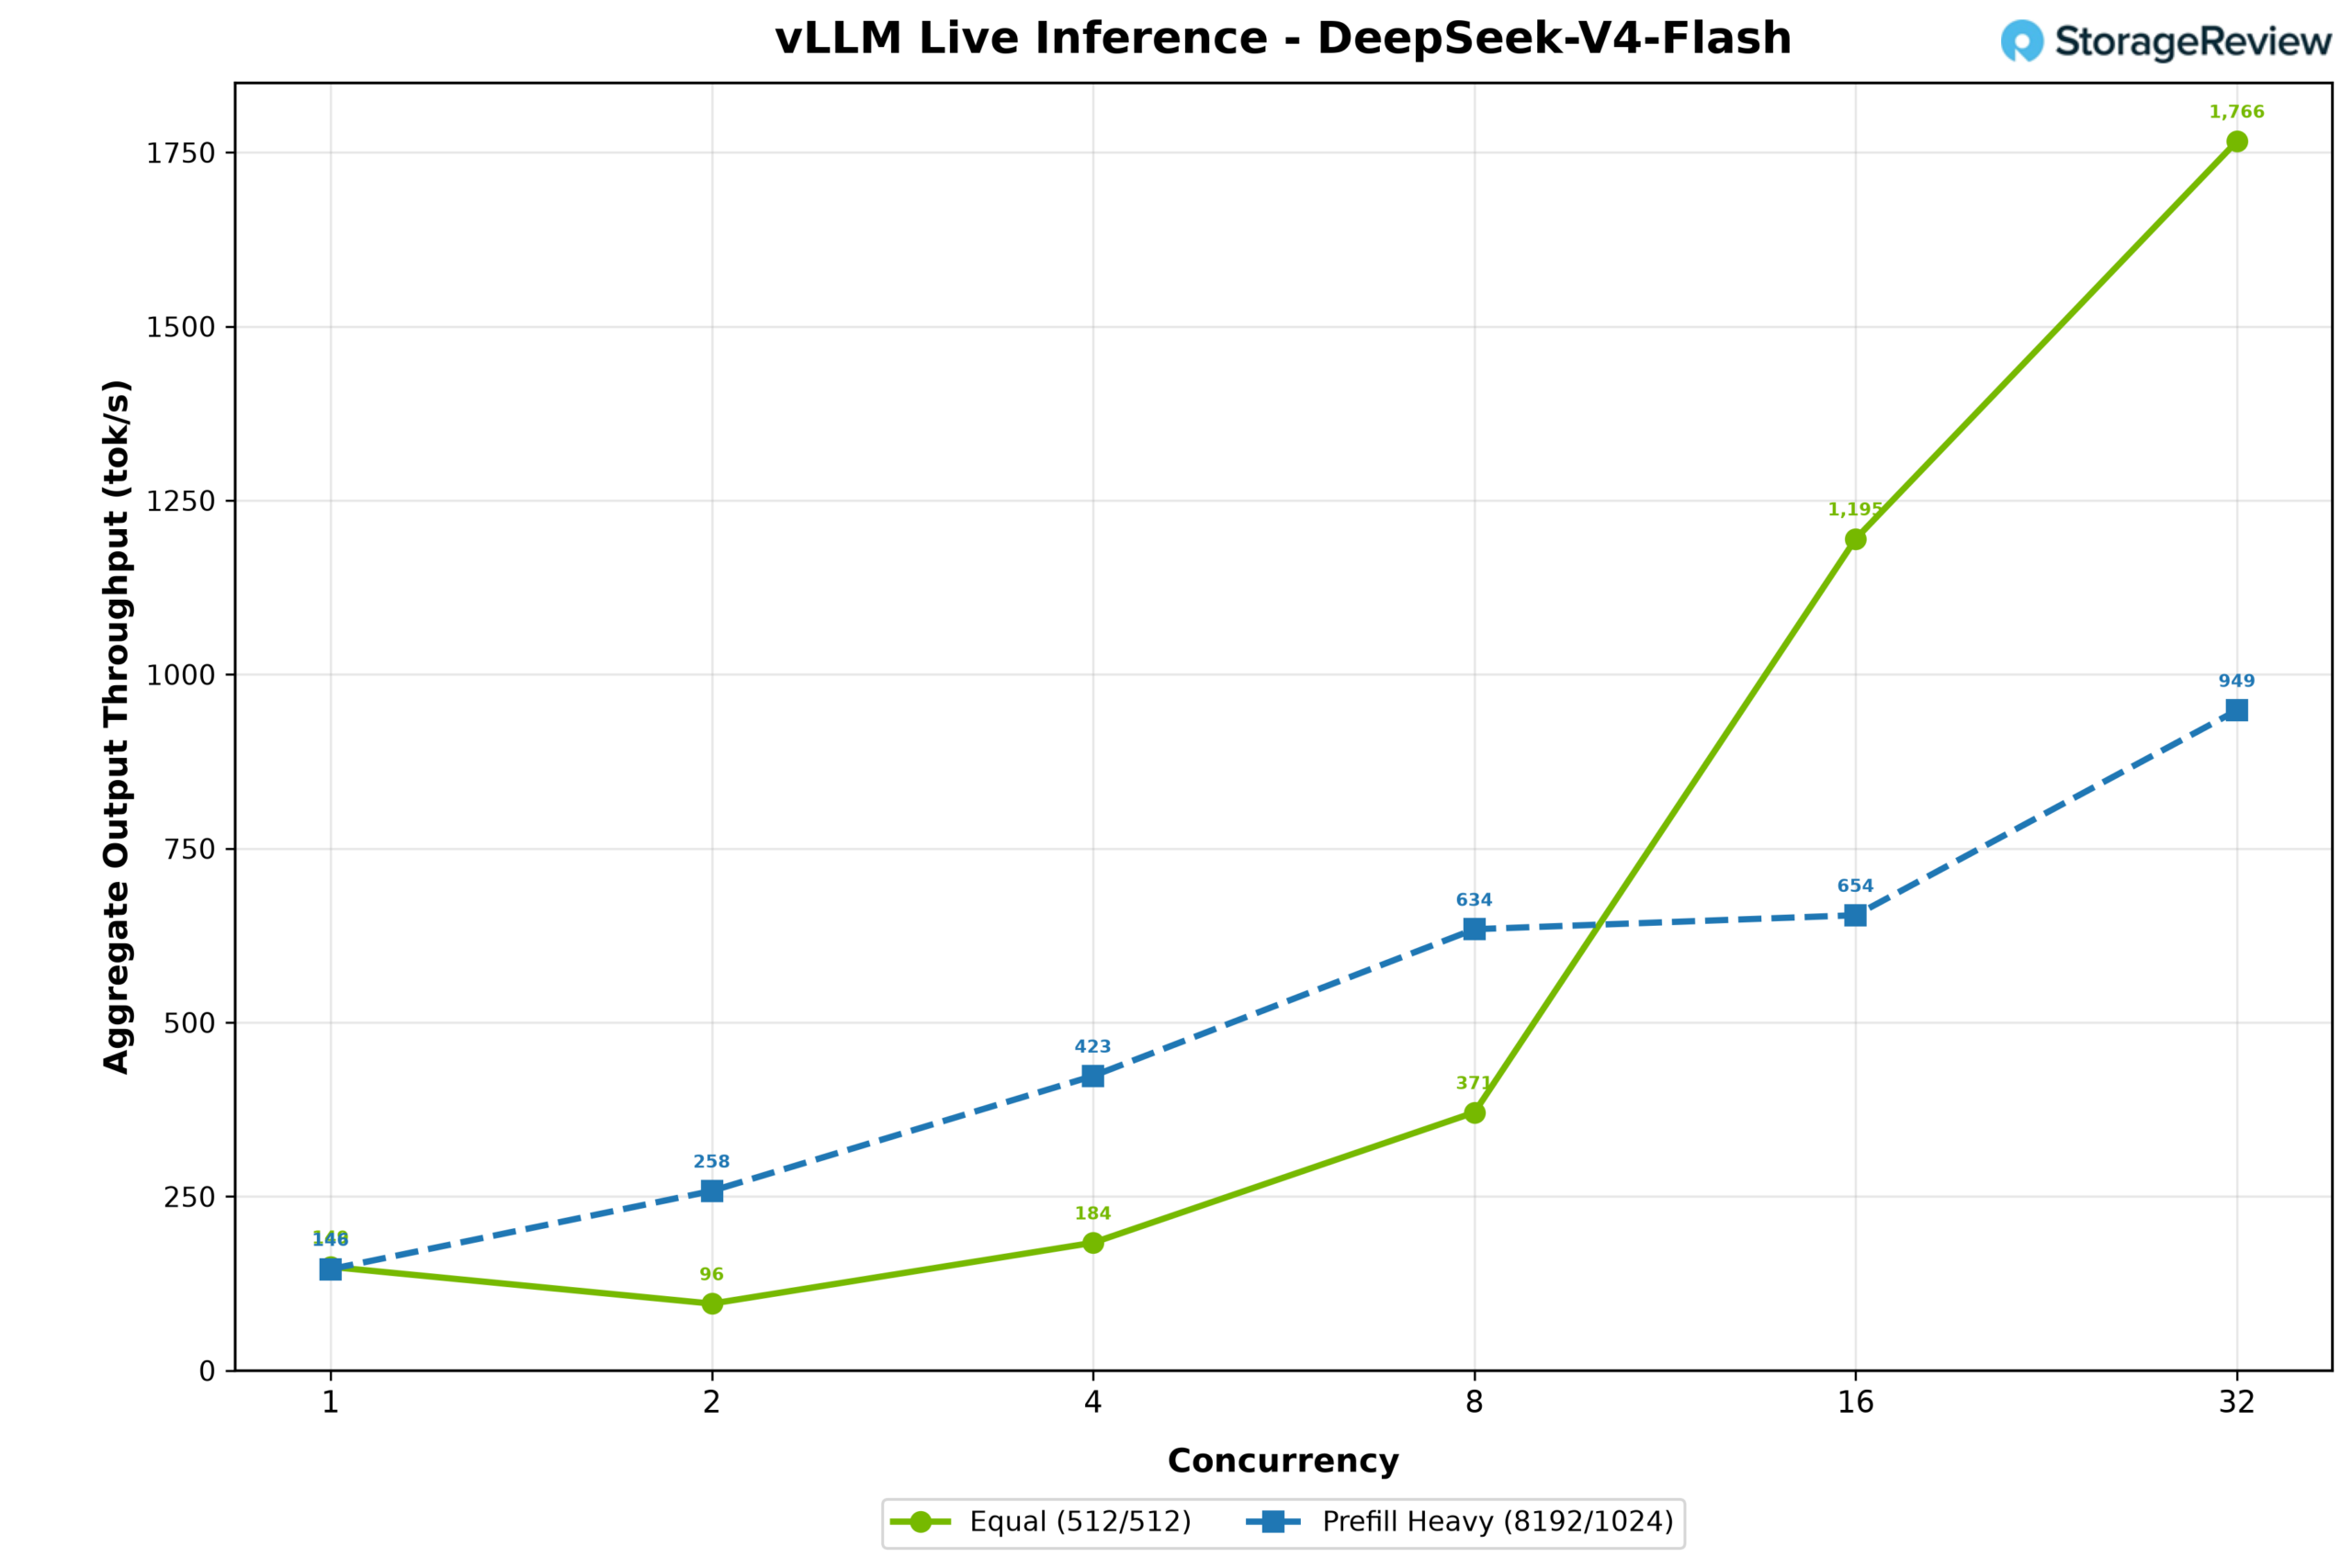
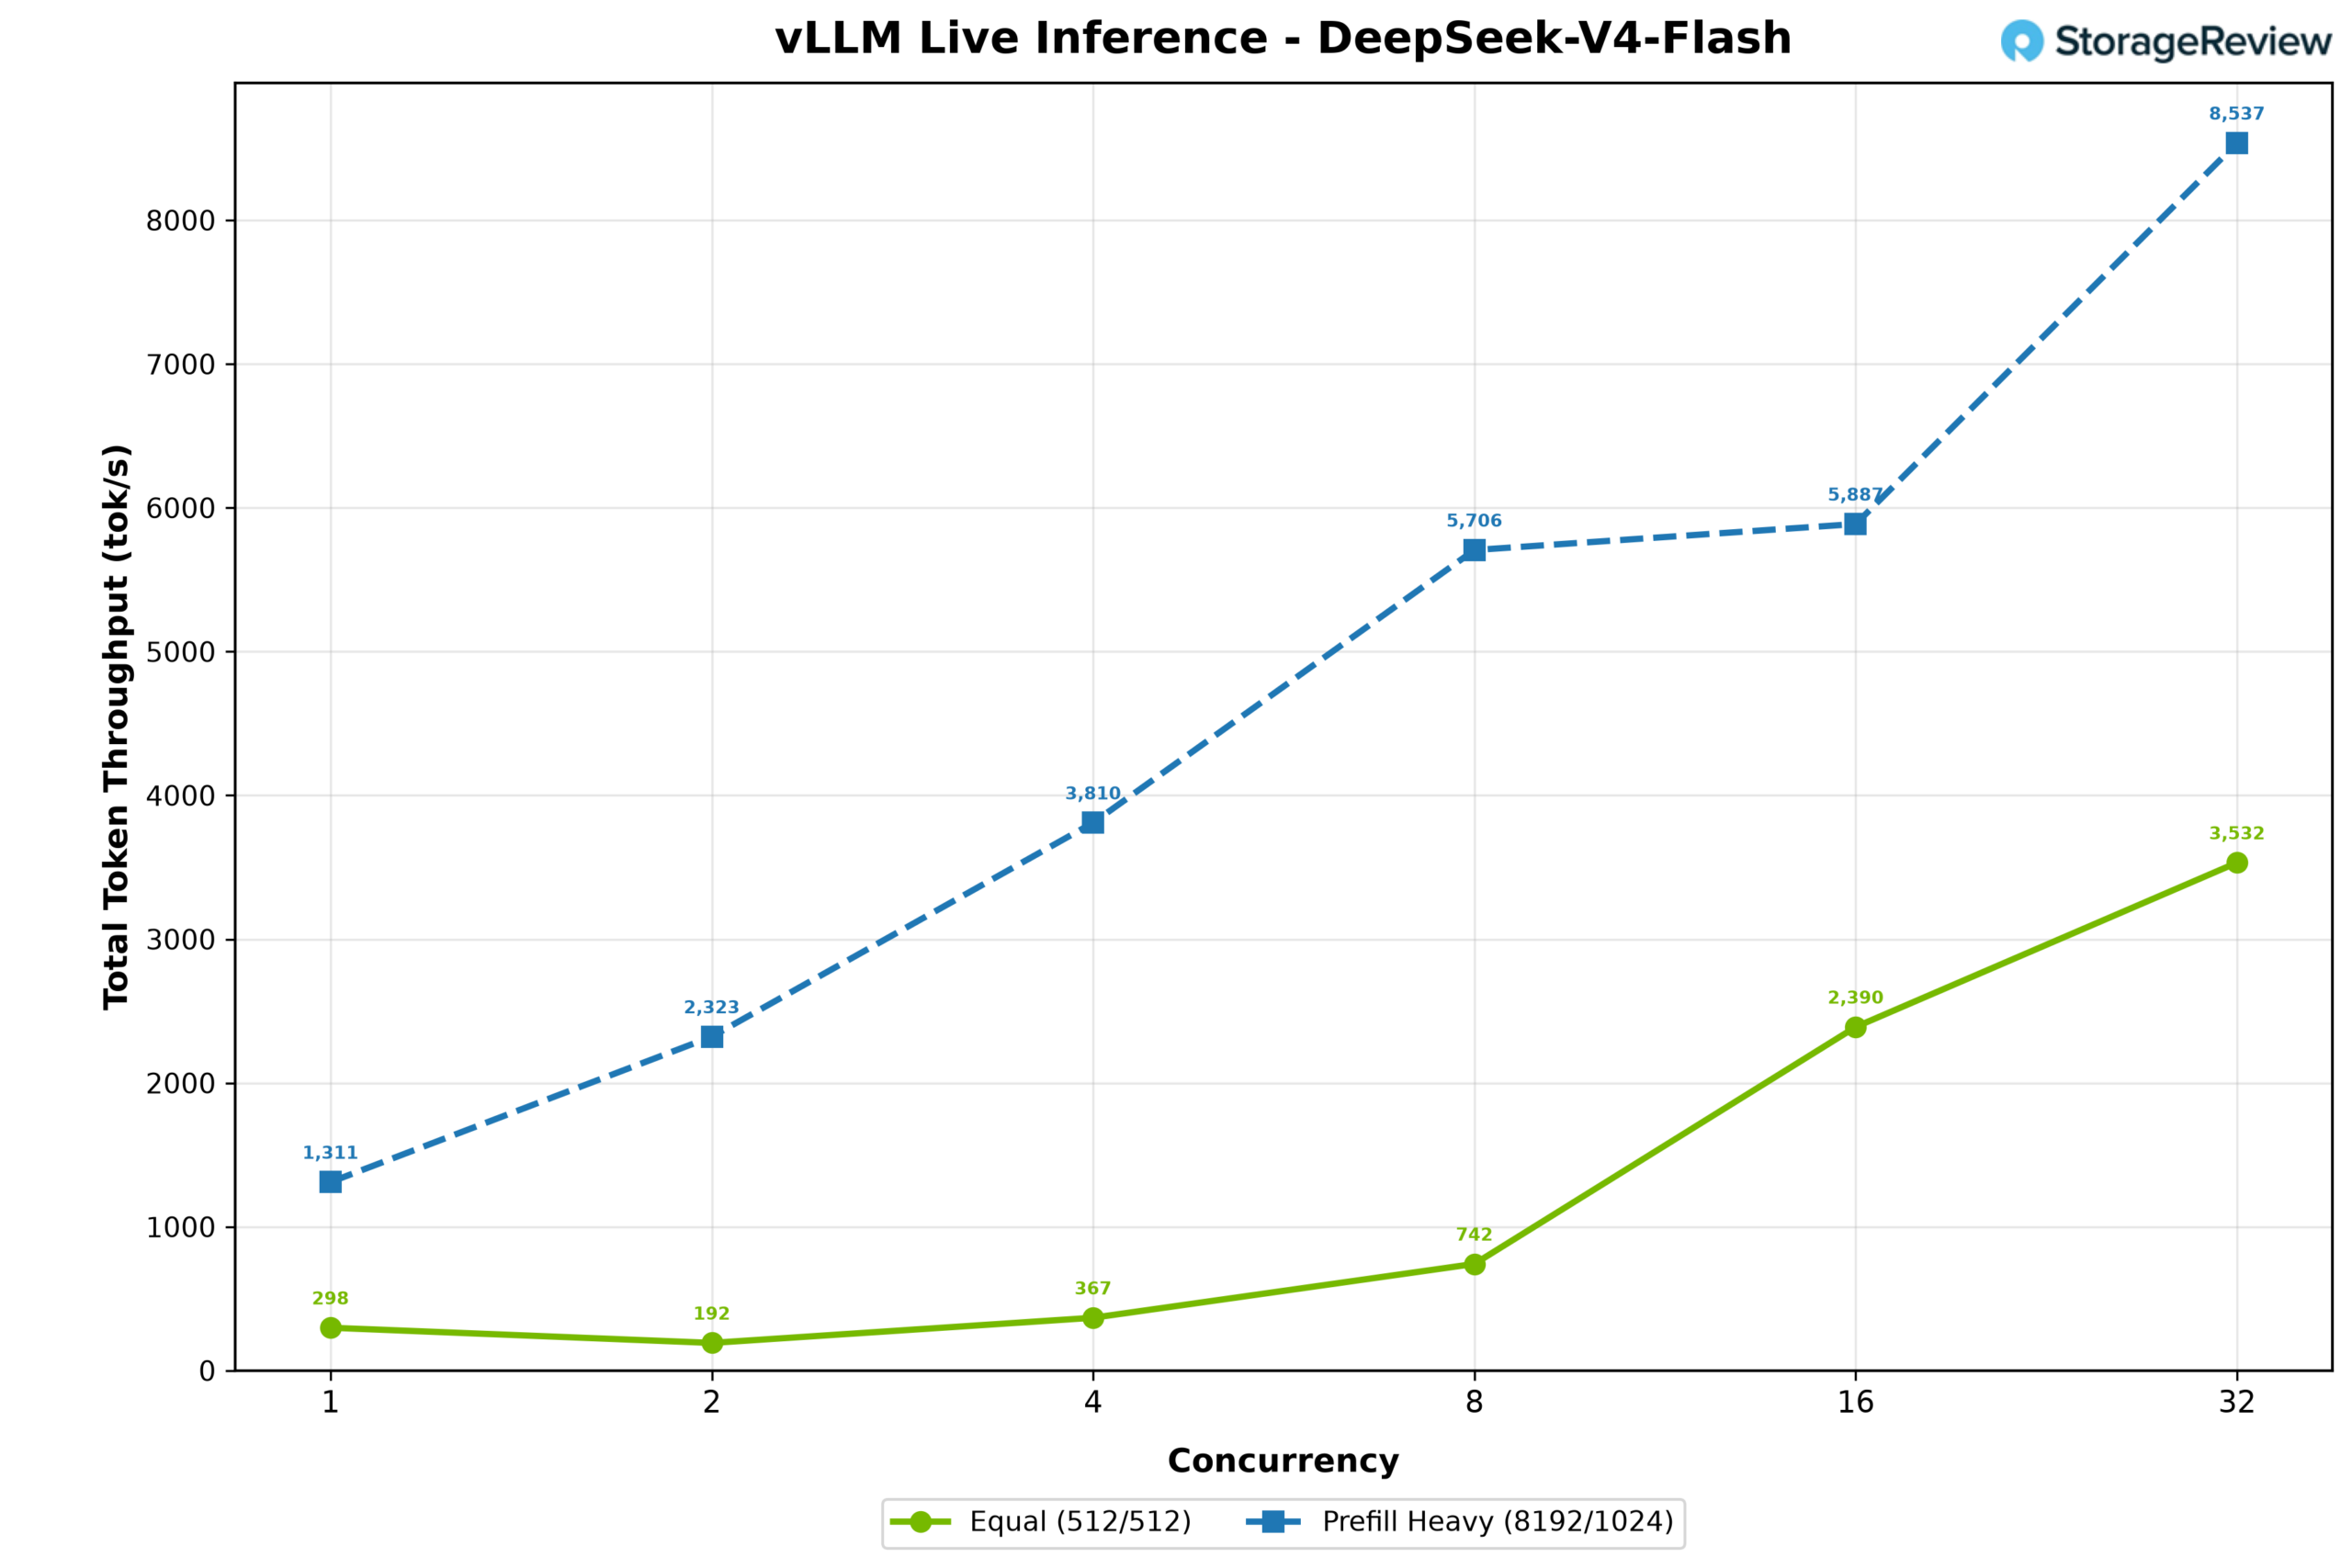
首先測試的是廣受歡迎的 DeepSeek v4 Flash (0731),它作為原生 FP8 檢查點佔用 14+6GB 記憶體。這款車型以其高效易用而著稱,我們在 DGX Station 上也體驗到了這一點。在 512/512 工作負載下,並發數為 1 時輸出吞吐量為每秒 149 個令牌,並發數為 32 時迅速攀升至每秒 1,766 個令牌。預填密集型工作負載的輸出吞吐量則從每秒 146 個令牌擴展到每秒 949 個令牌。
總代幣吞吐量同步成長,其中 512/512 工作負載從每秒 298 個代幣增長到 3,532 個代幣,而預填充密集型工作負載則從每秒 1,311 個代幣增長到 8,537 個代幣。
MiniMax M2.7 (NVFP4)
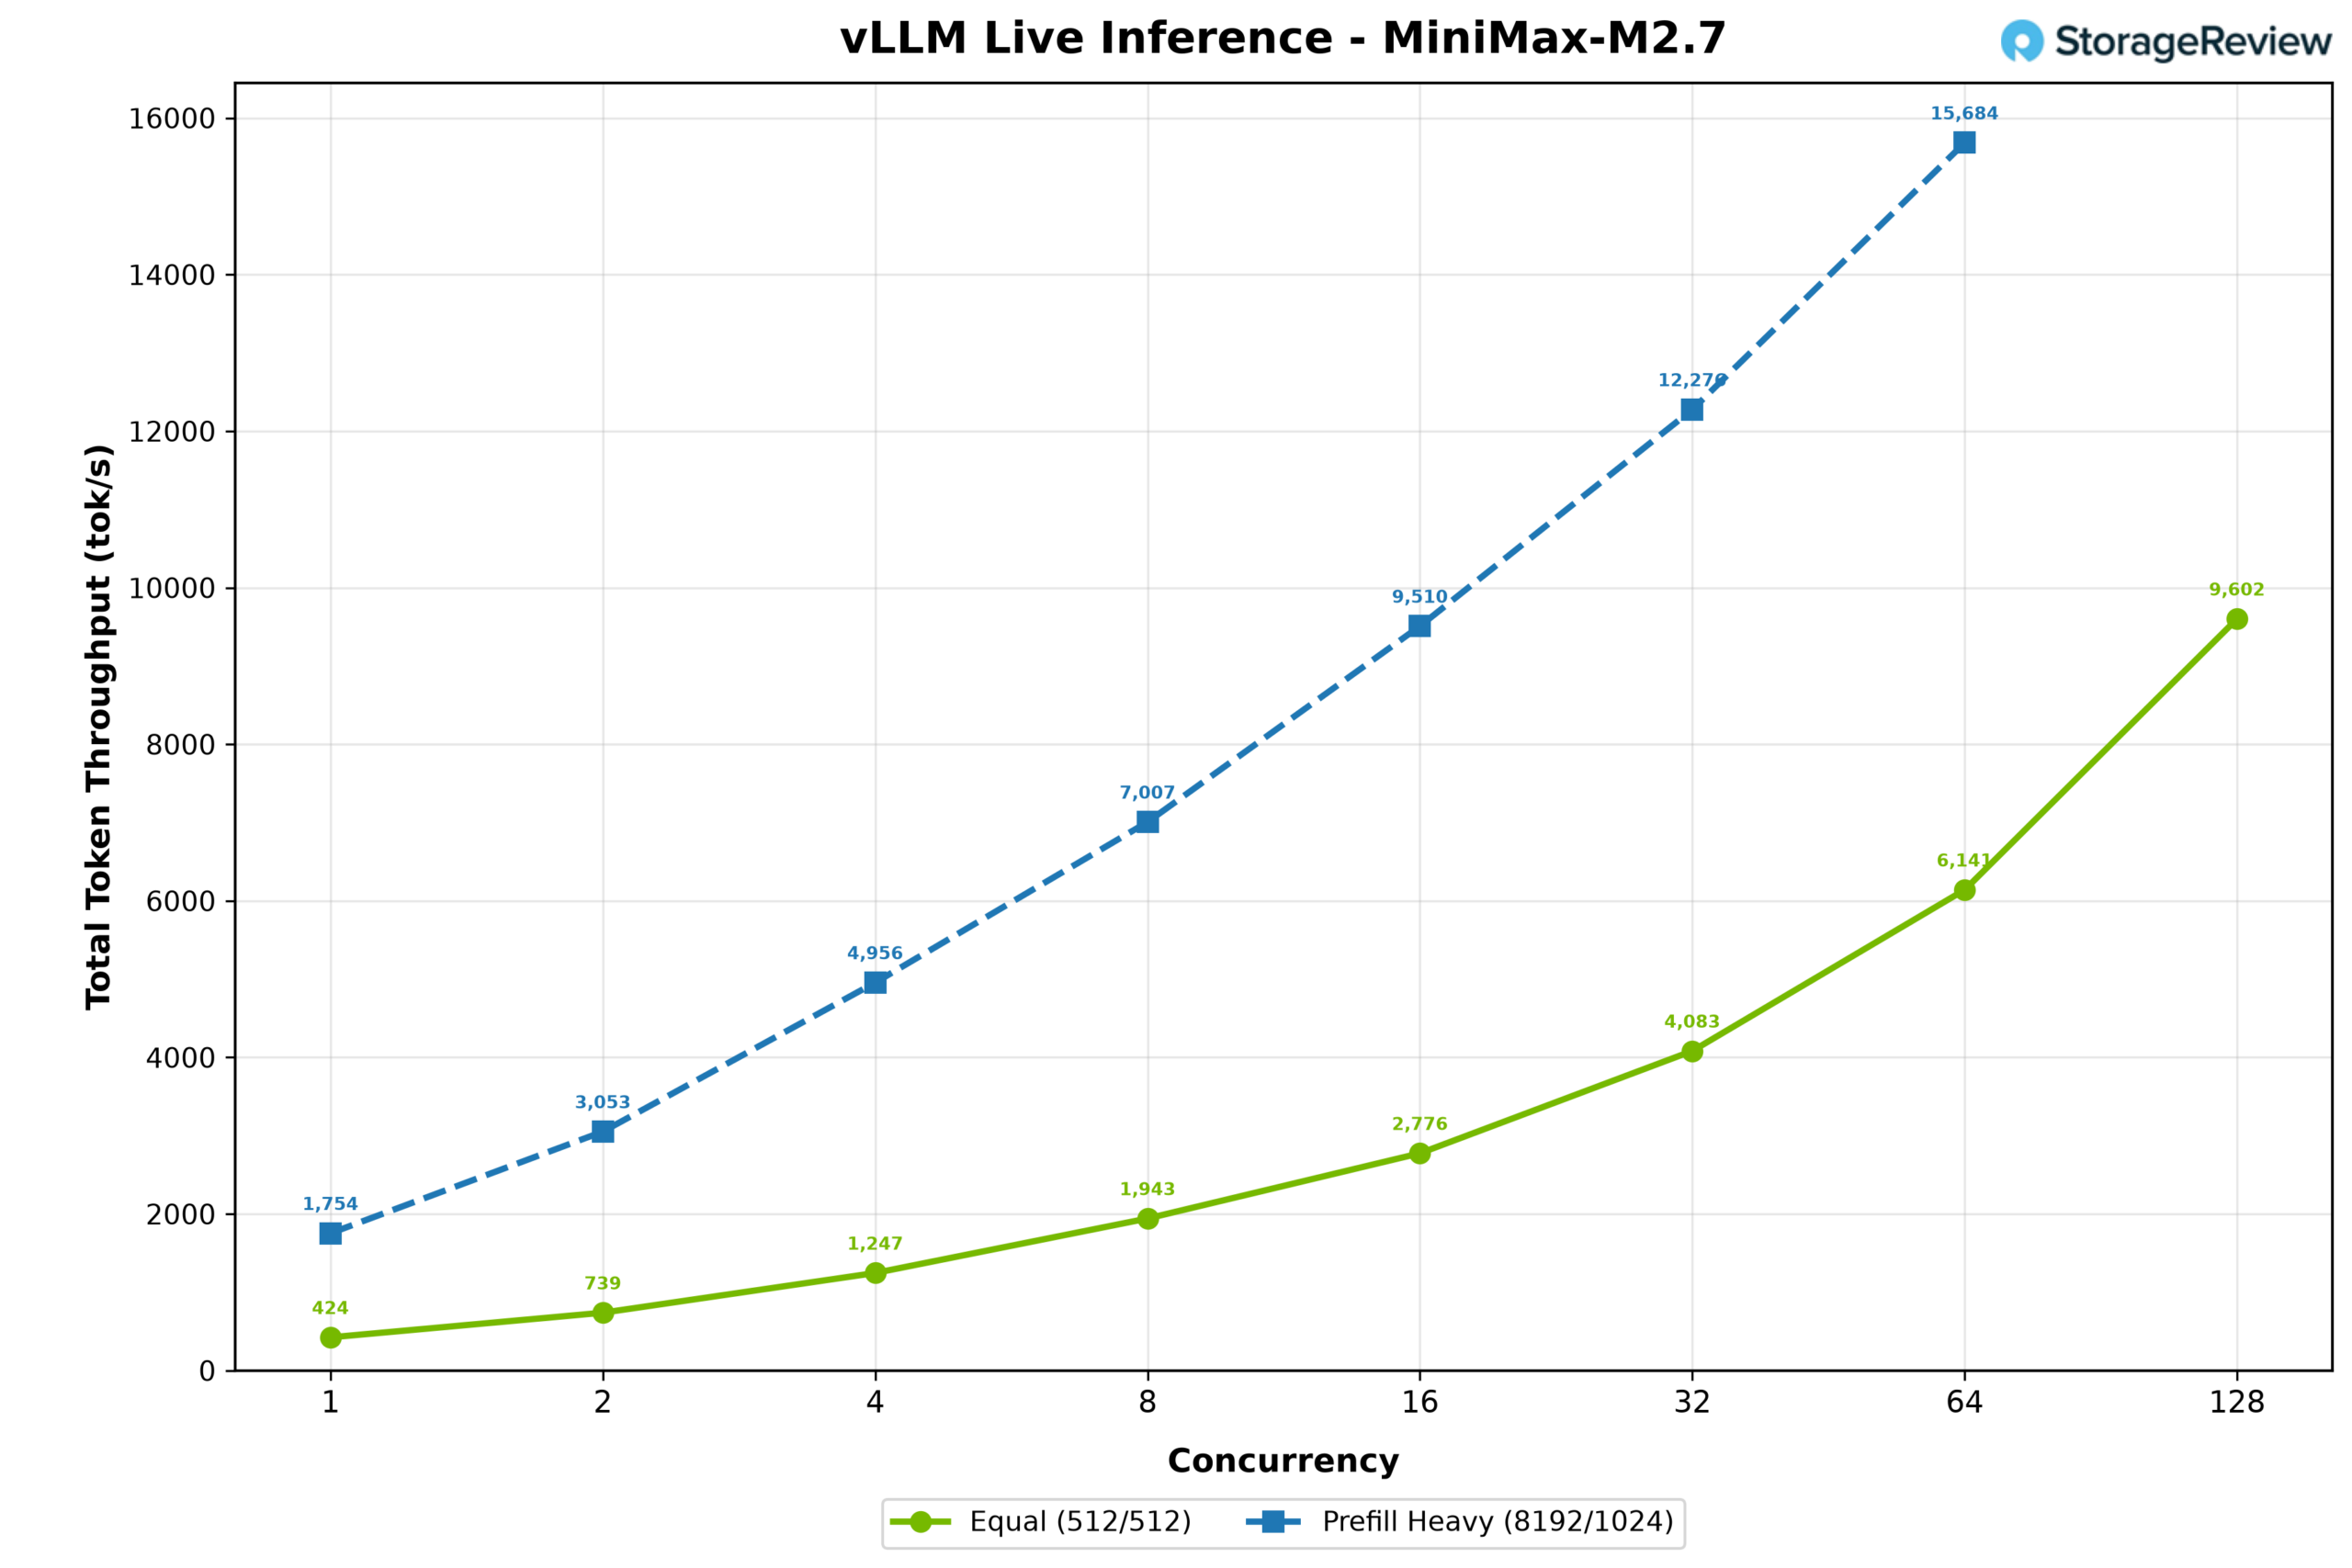
接下來是 MiniMax M2.7,這是我們最喜歡的型號之一,使用 NVIDIA 的 NVFP4 量化演算法進行測試,佔用 125GB 記憶體。在 512/512 工作負載下,輸出吞吐量在並發數為 1 時為每秒 193 個令牌,並迅速擴展到並發數為 128 時的每秒 4,801 個令牌。預填充密集型工作負載的輸出吞吐量從並發數為 1 時的每秒 195 個令牌增加到並發數為 64 時的每秒 1,743 個令牌。總令牌吞吐量則呈現相反的趨勢,預填充密集型工作負載的輸出吞吐量從並發數為 64 時的每秒 1,754 個令牌攀升至每秒 15,684 個令牌,而 512/512 工作負載的輸出吞吐量則從並發數為 128 時的每秒 424 個令牌擴展到 9,602 個令牌。
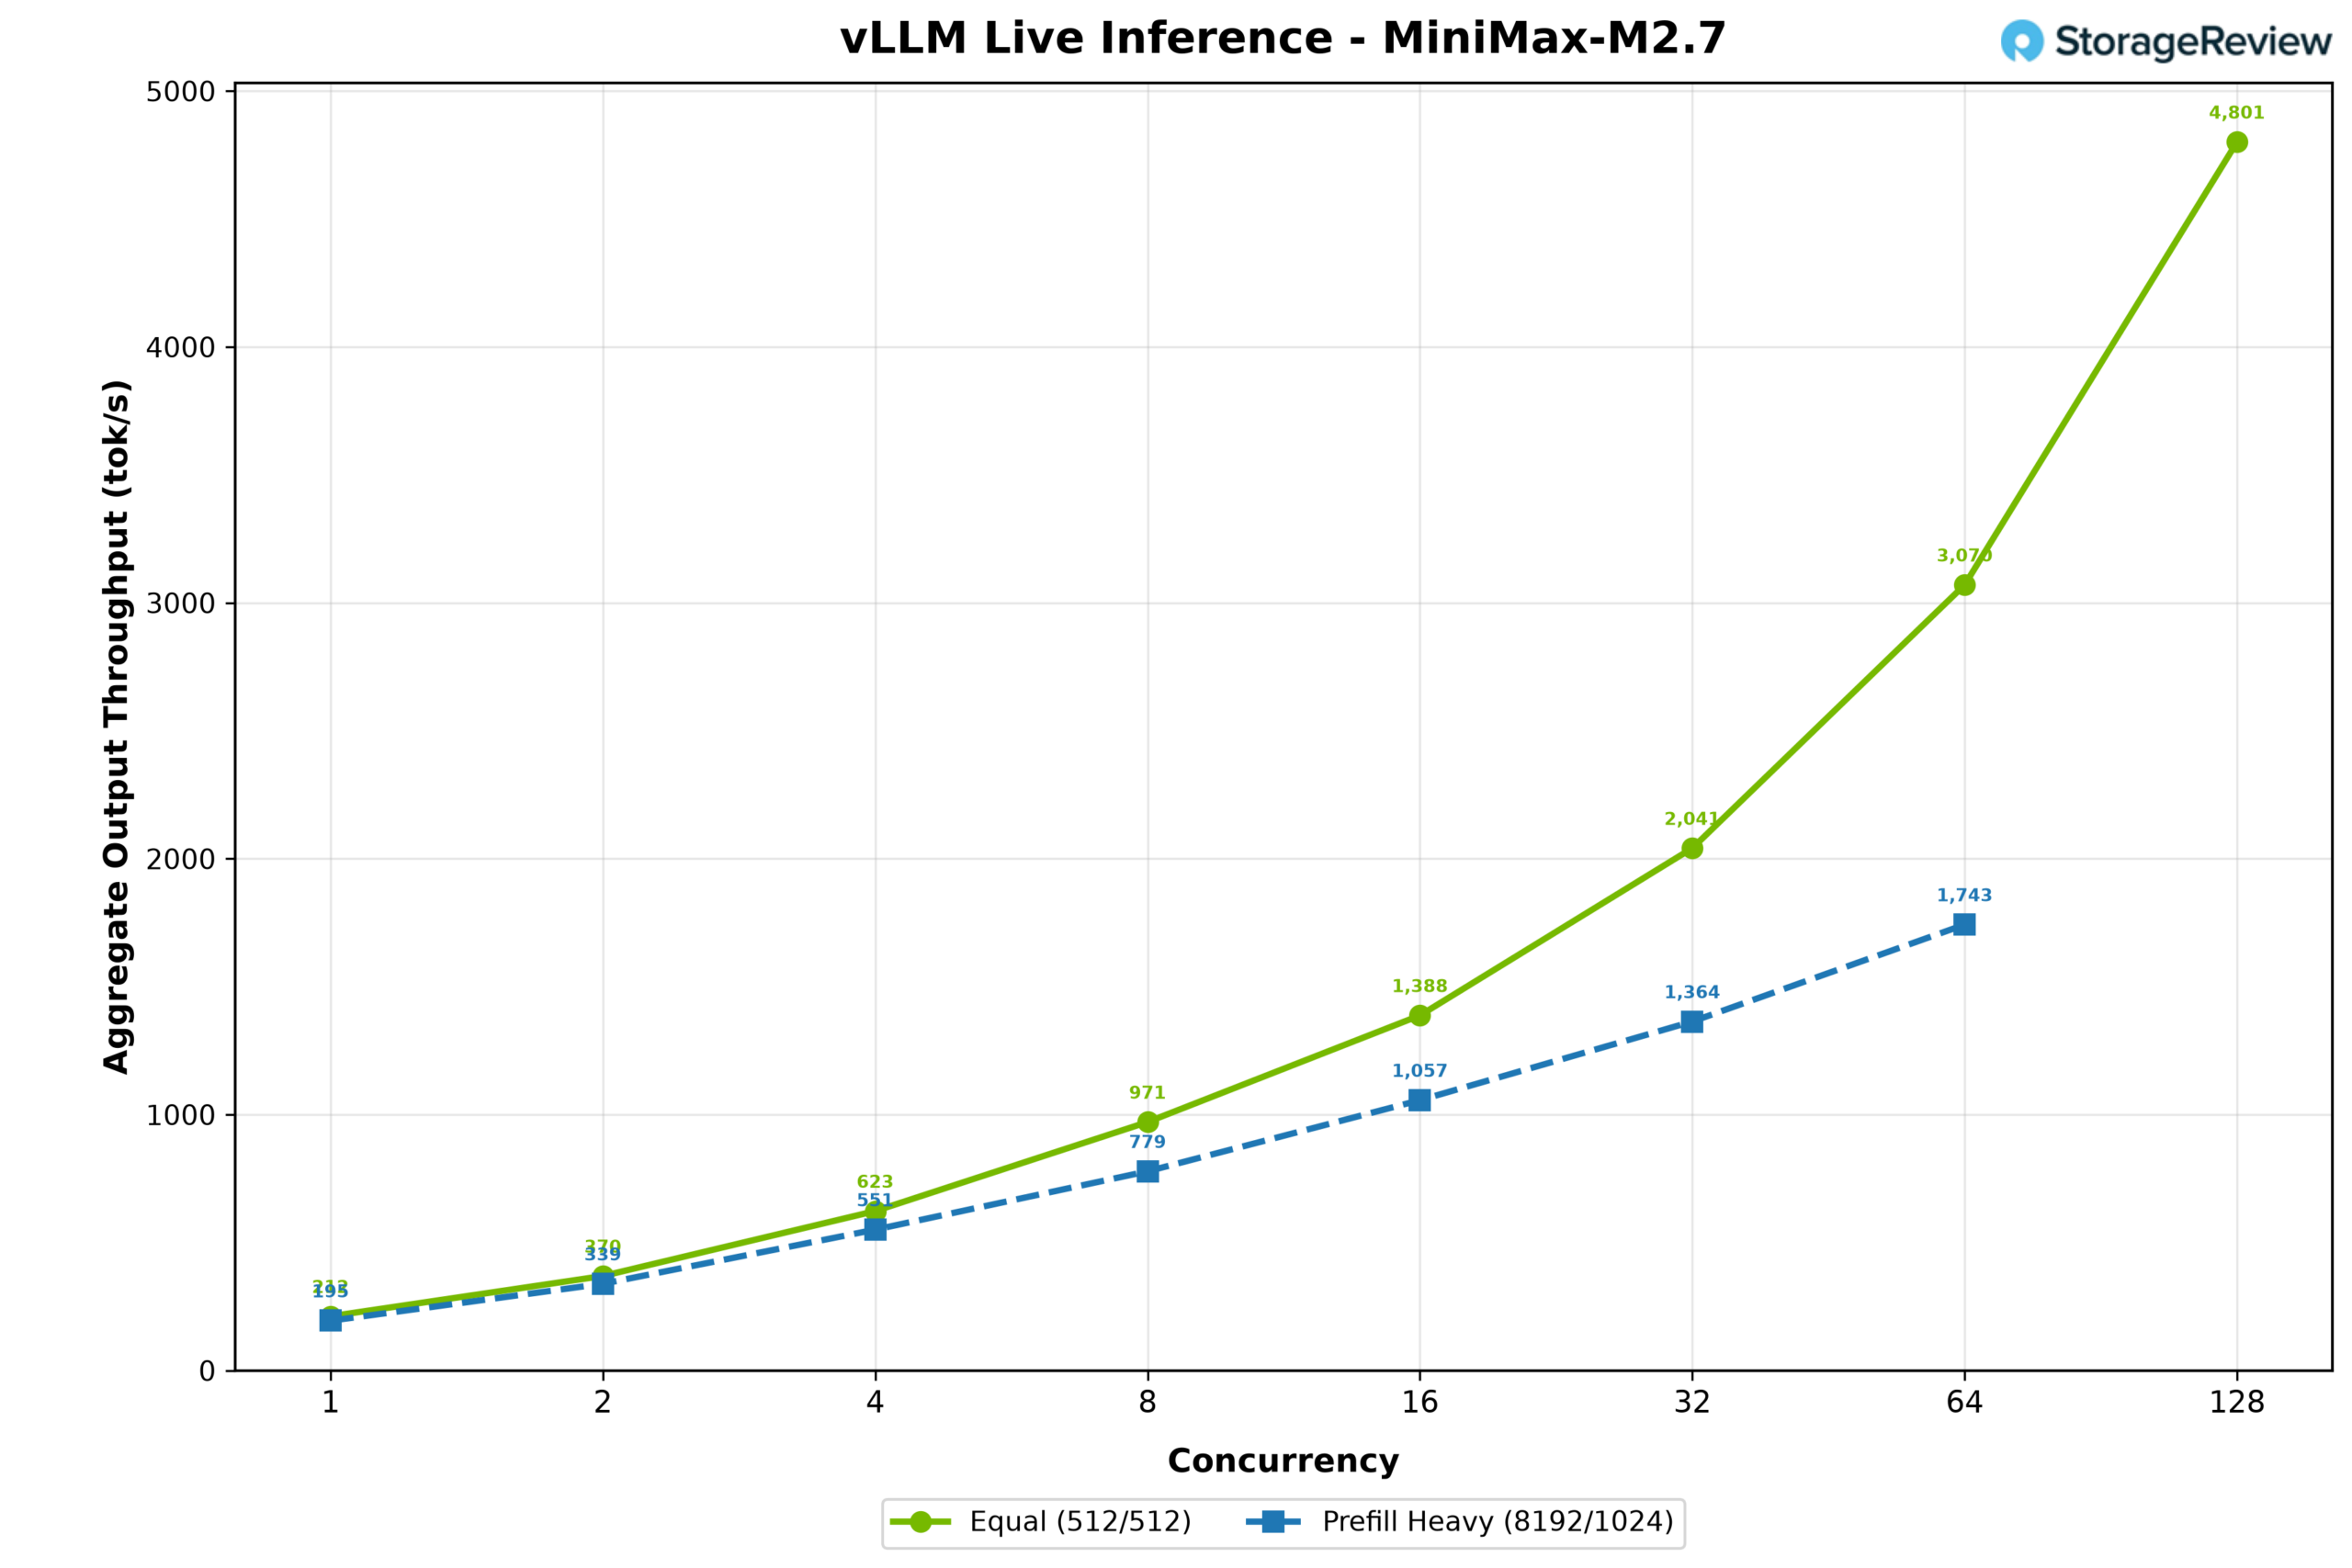
總令牌吞吐量呈現相反的趨勢,預填充密集型工作負載在並發數為 64 時從每秒 1,754 個令牌攀升至每秒 15,684 個令牌,而 512/512 工作負載在並發數為 128 時從每秒 424 個令牌擴展到 9,602 個令牌。
勉強符合 HBM 的模型
MiniMax M3 (NVFP4)
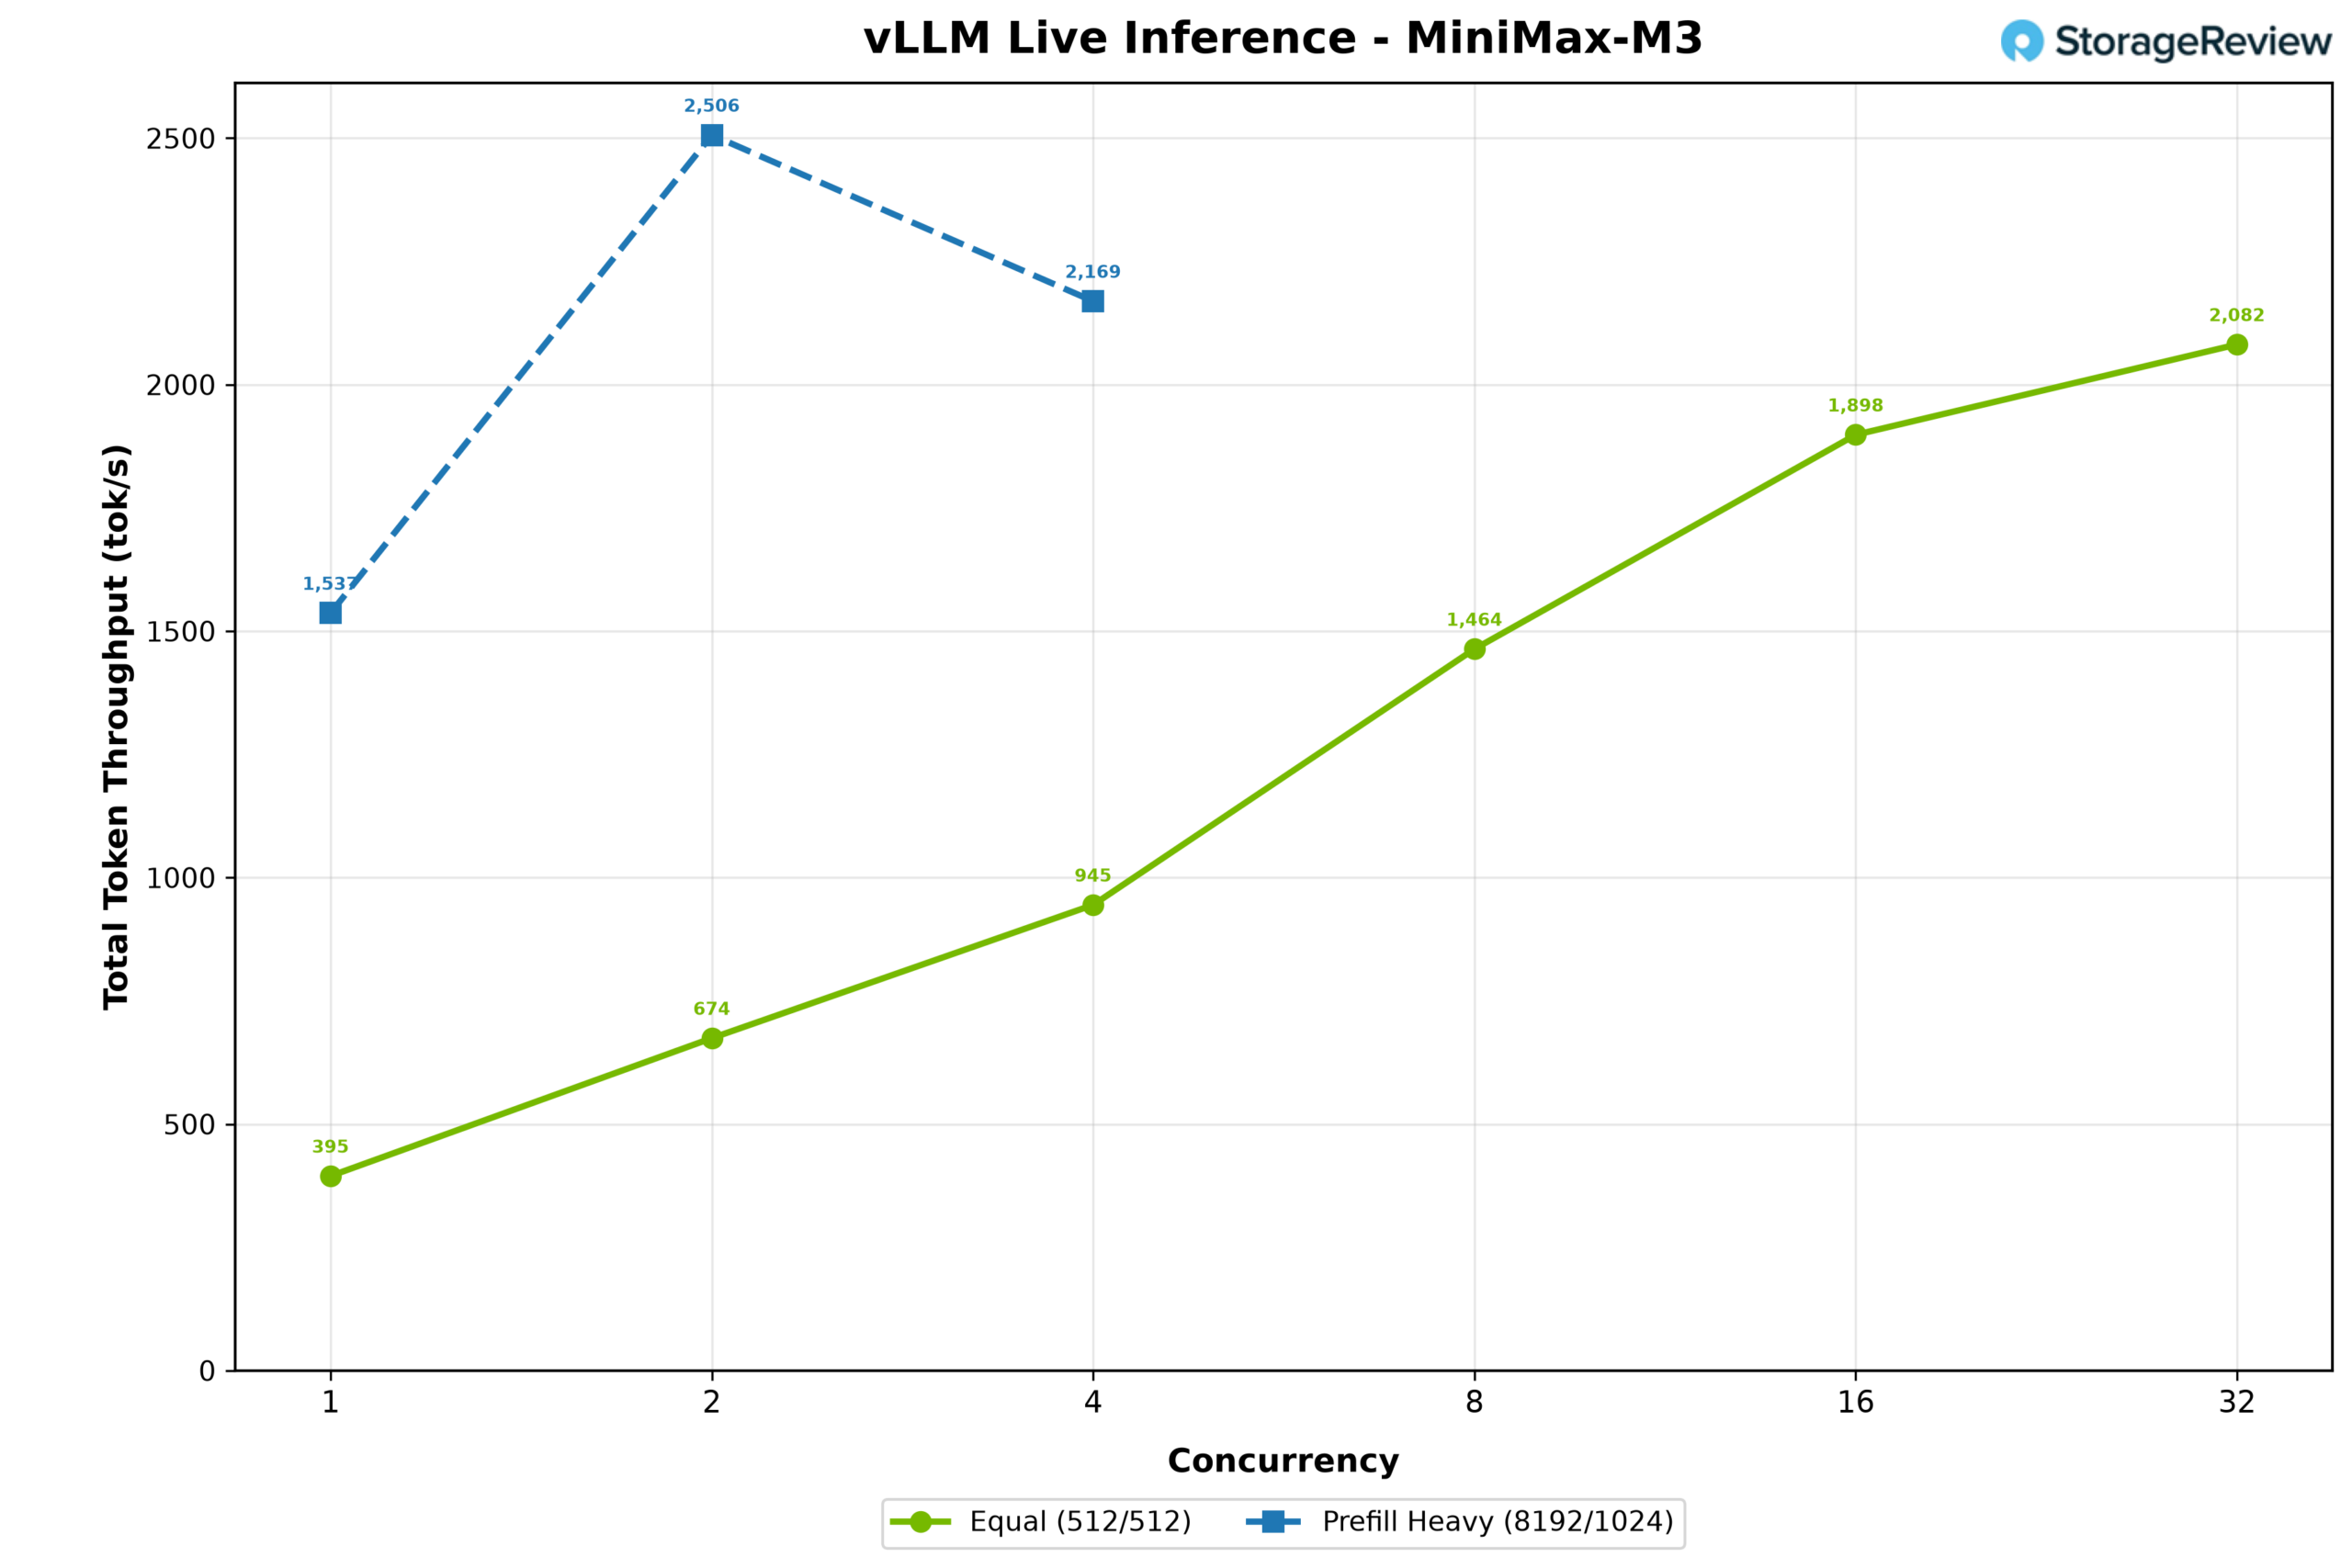
MiniMax M3 展示了實際應用中「勉強夠用」的典型情況。其 233GB 的 NVFP4 檢查點小於 B300 的 252GB HBM,但該型號仍需要空間來儲存運行時和鍵值快取。最終,它佔用了 223GB 的 HBM,其中 21GB 的專家資料被卸載到 Grace 快取中。測試中使用了 EAGLE3-GQA 推測性解碼演算法,合成接受長度為 3 個 token。在 512/512 工作負載下,輸出吞吐量在並發數為 1 時為每秒 197 個 token,並穩步提升至並發數為 32 時的每秒 1,041 個 token。預填充密集型工作負載的輸出吞吐量從並發數為 1 時的每秒 171 個 token 增加到並發數為 2 時的峰值每秒 278 個 token,然後下降到並發數為 4 時的每秒 241 個 token。
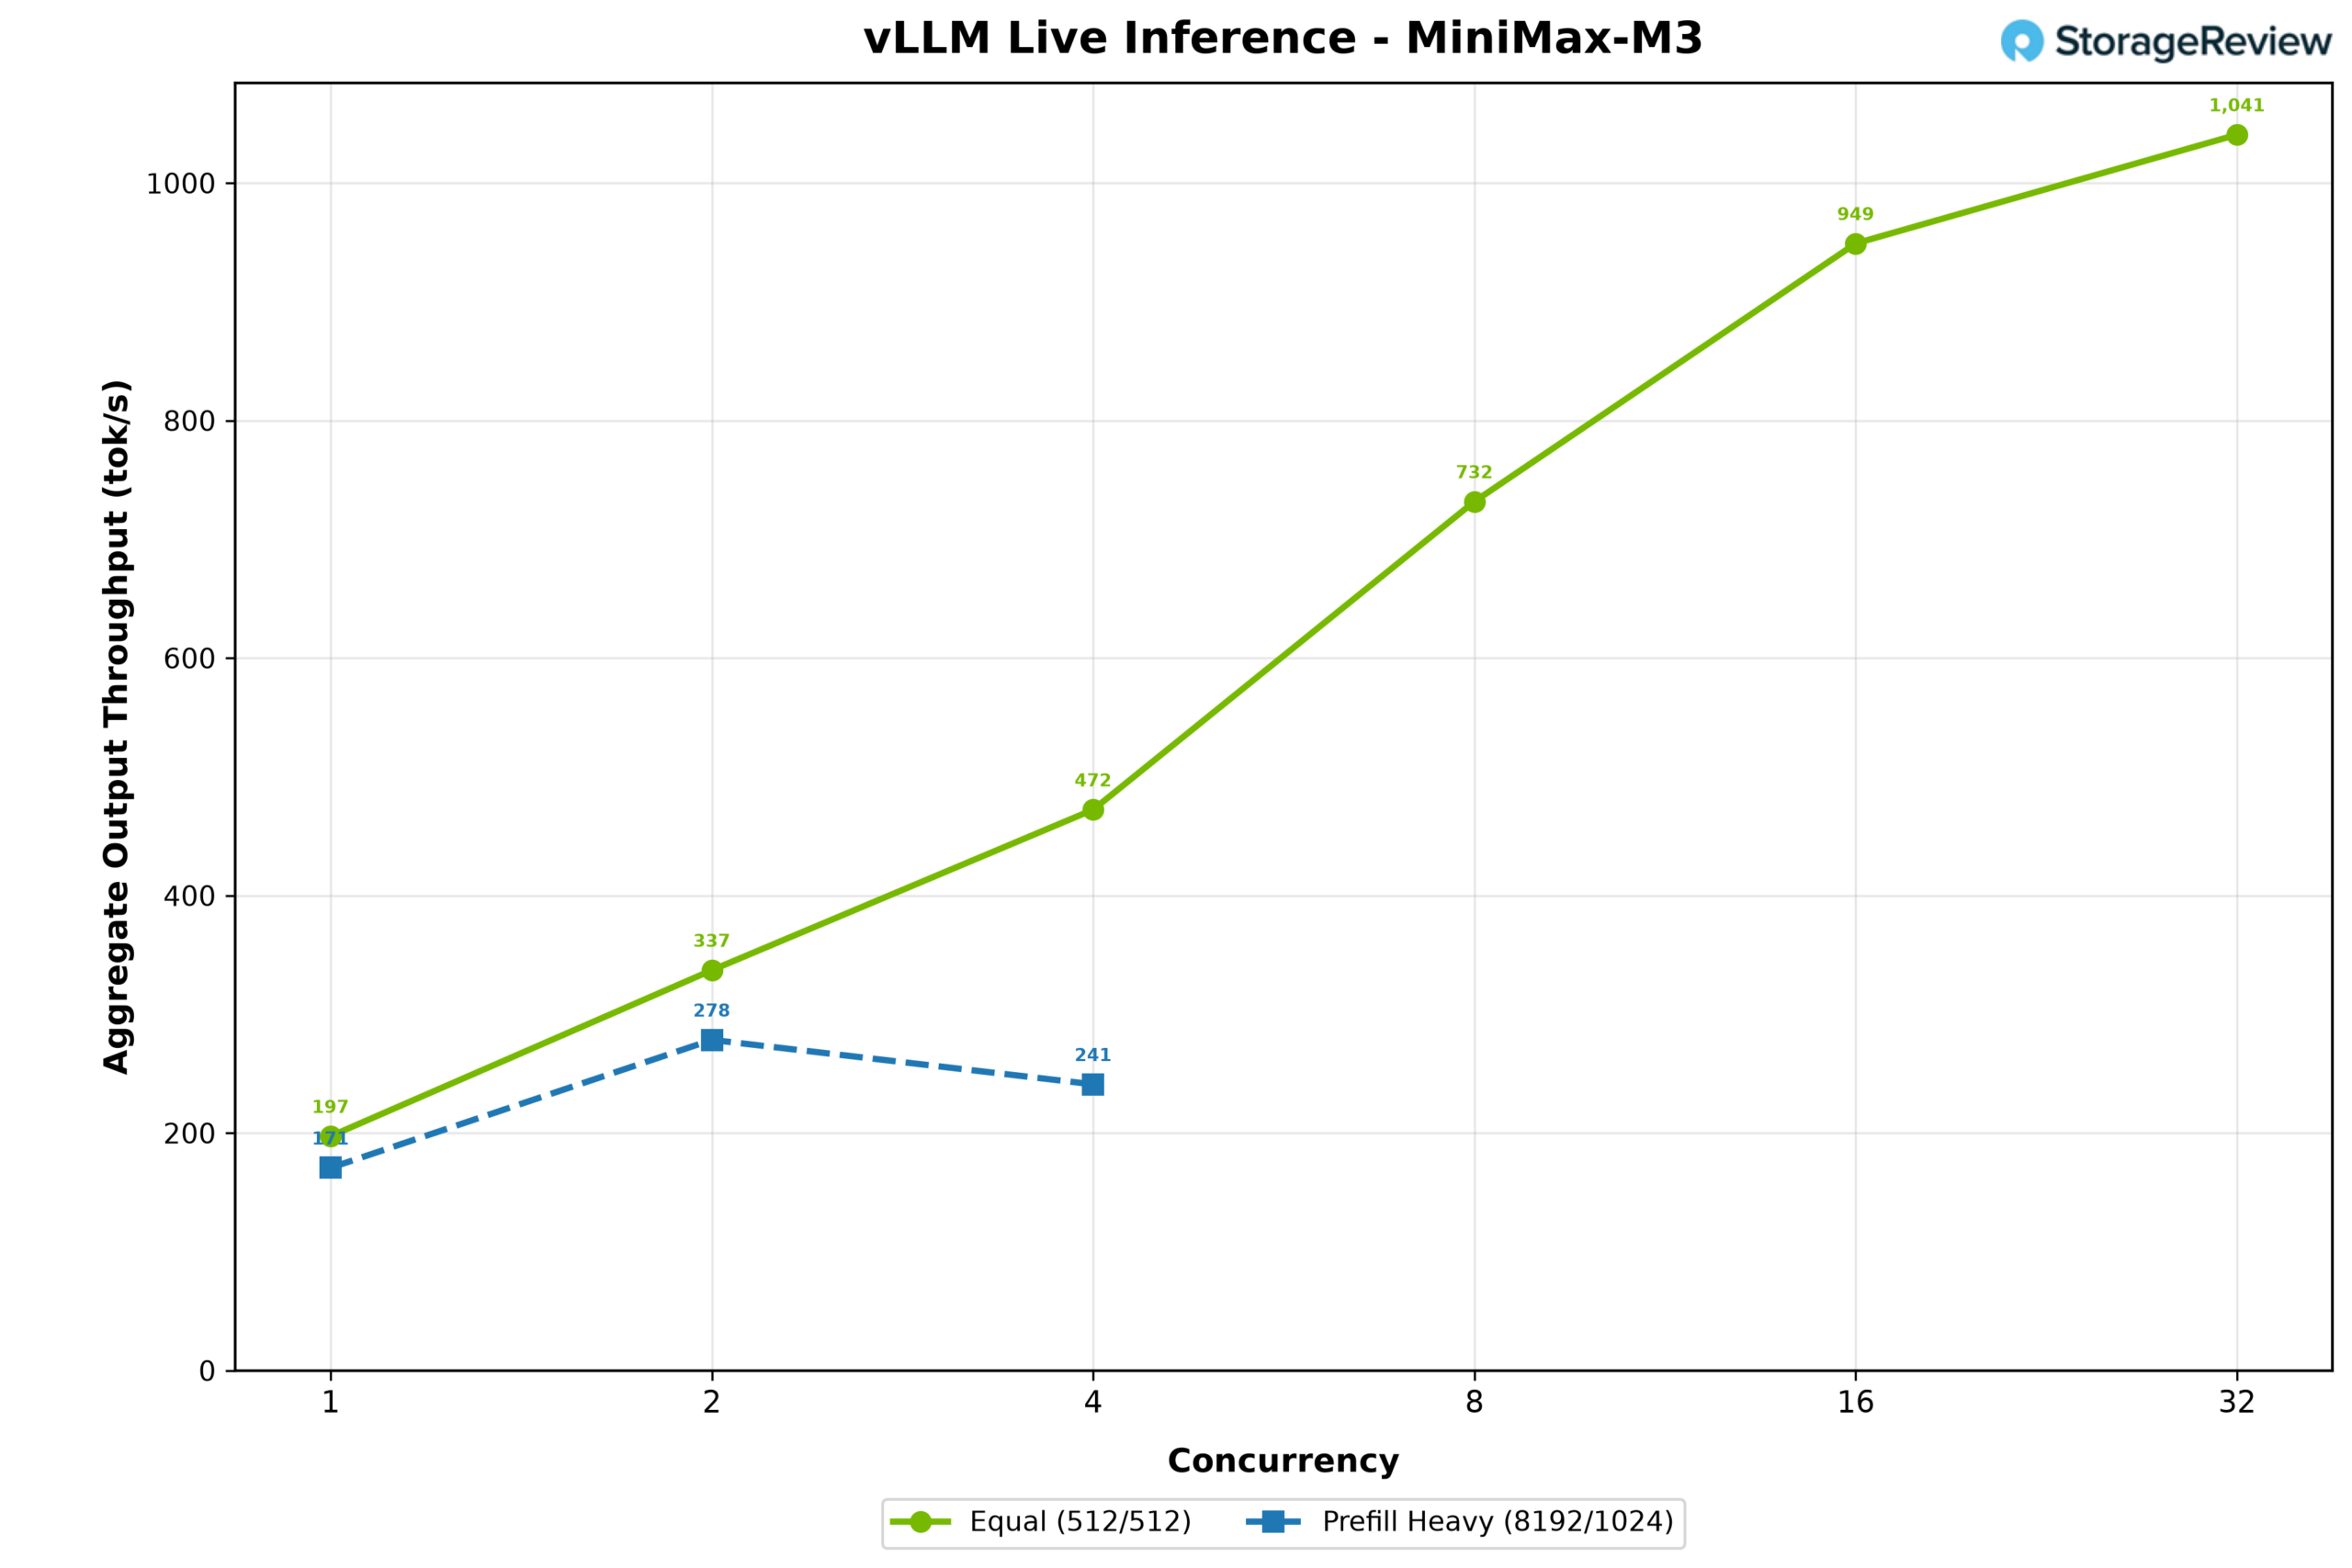
總令牌吞吐量也呈現類似的趨勢,512/512 工作負載從每秒 395 個令牌上升到 2,082 個令牌,而預填充密集型工作負載在並發數為 2 時達到每秒 2,506 個令牌的峰值,之後在並發數為 4 時下降到每秒 2,169 個令牌。
不符合 HBM 的模型
GLM-5.2 (NVFP4)
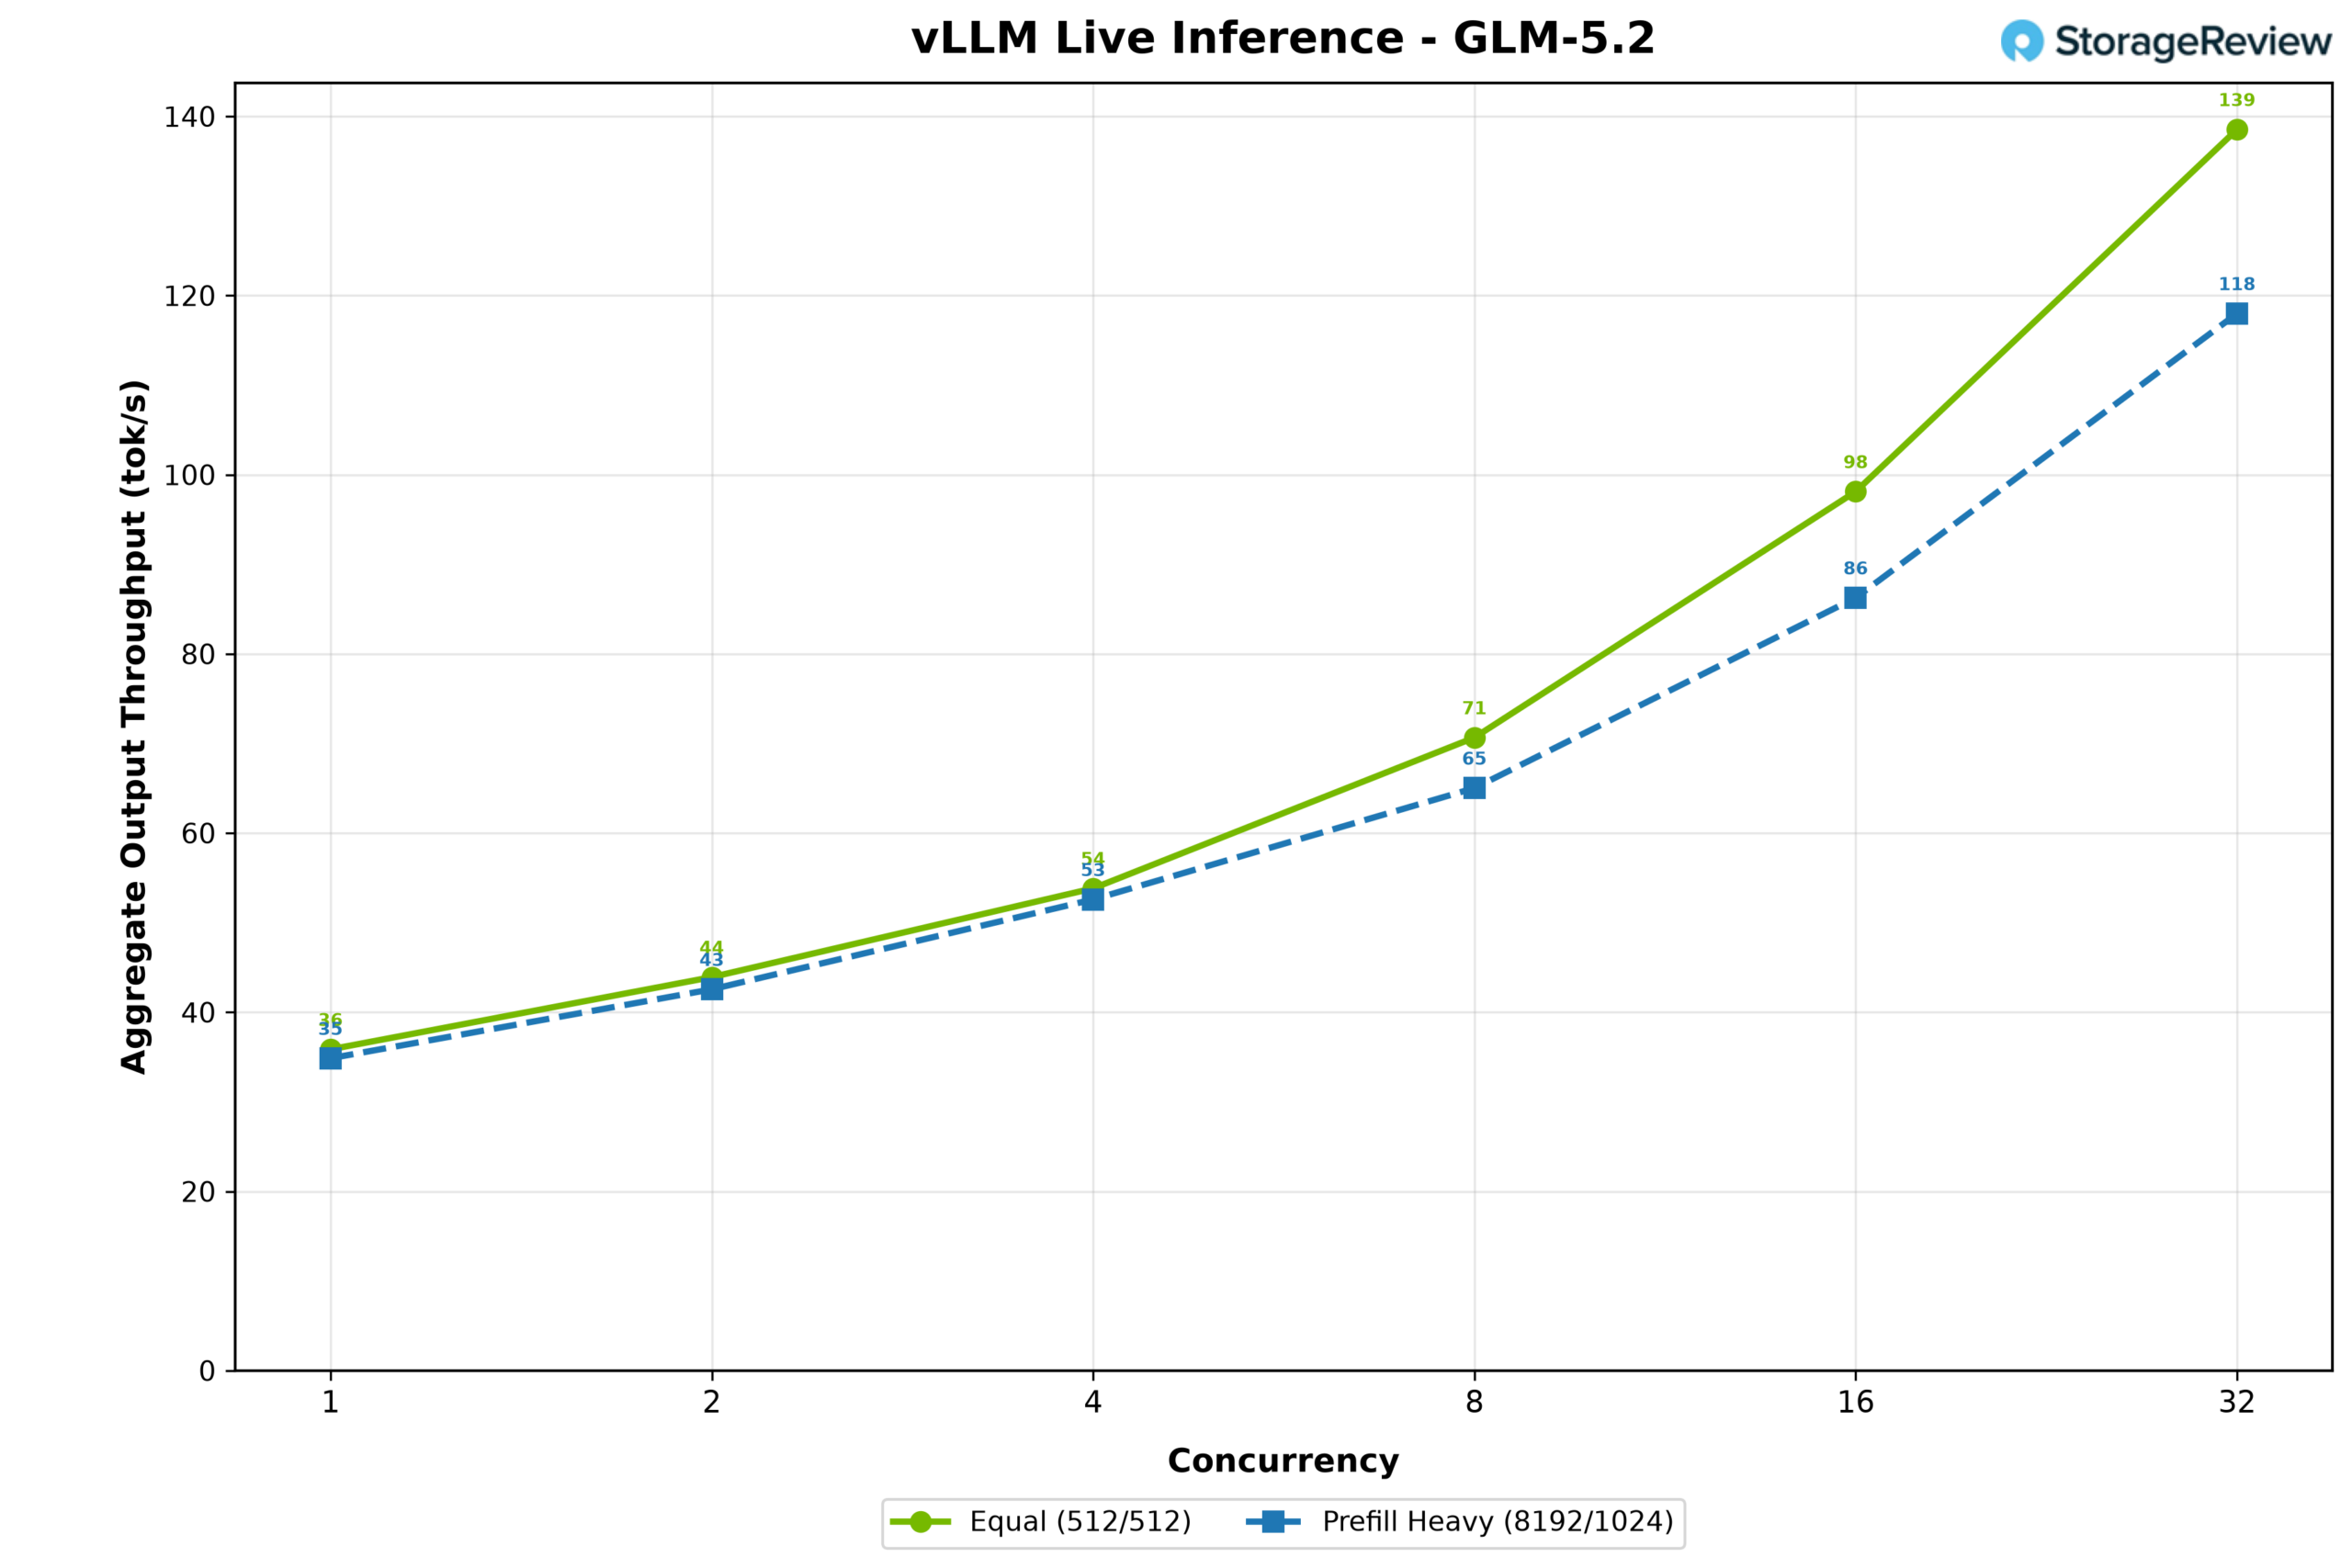
使用 NVIDIA 的 NVFP4 量化處理器對 GLM-5.2 進行了測試。其 433GB 的檢查點使用了 218GB 的 HBM,並將 216GB 的專家權重卸載到 Grace 記憶體中。檢定採用 MTP 推測解碼,合成接受長度為 3 個 token。在 512/512 工作負載下,輸出吞吐量從並發數為 1 時的每秒 36 個 token 提升至並發數為 32 時的每秒 139 個 token。 8,192/1,024 工作負載緊隨其後,從每秒 35 個 token 提升至每秒 118 個 token。兩種工作負載的相似結果表明,模型產生主要受限於在 Grace 記憶體和 GPU 之間移動卸載的專家權重。由於剩餘的 HBM 記憶體不足以支援額外的上下文信息,因此在並發數達到 32 時停止了測試。
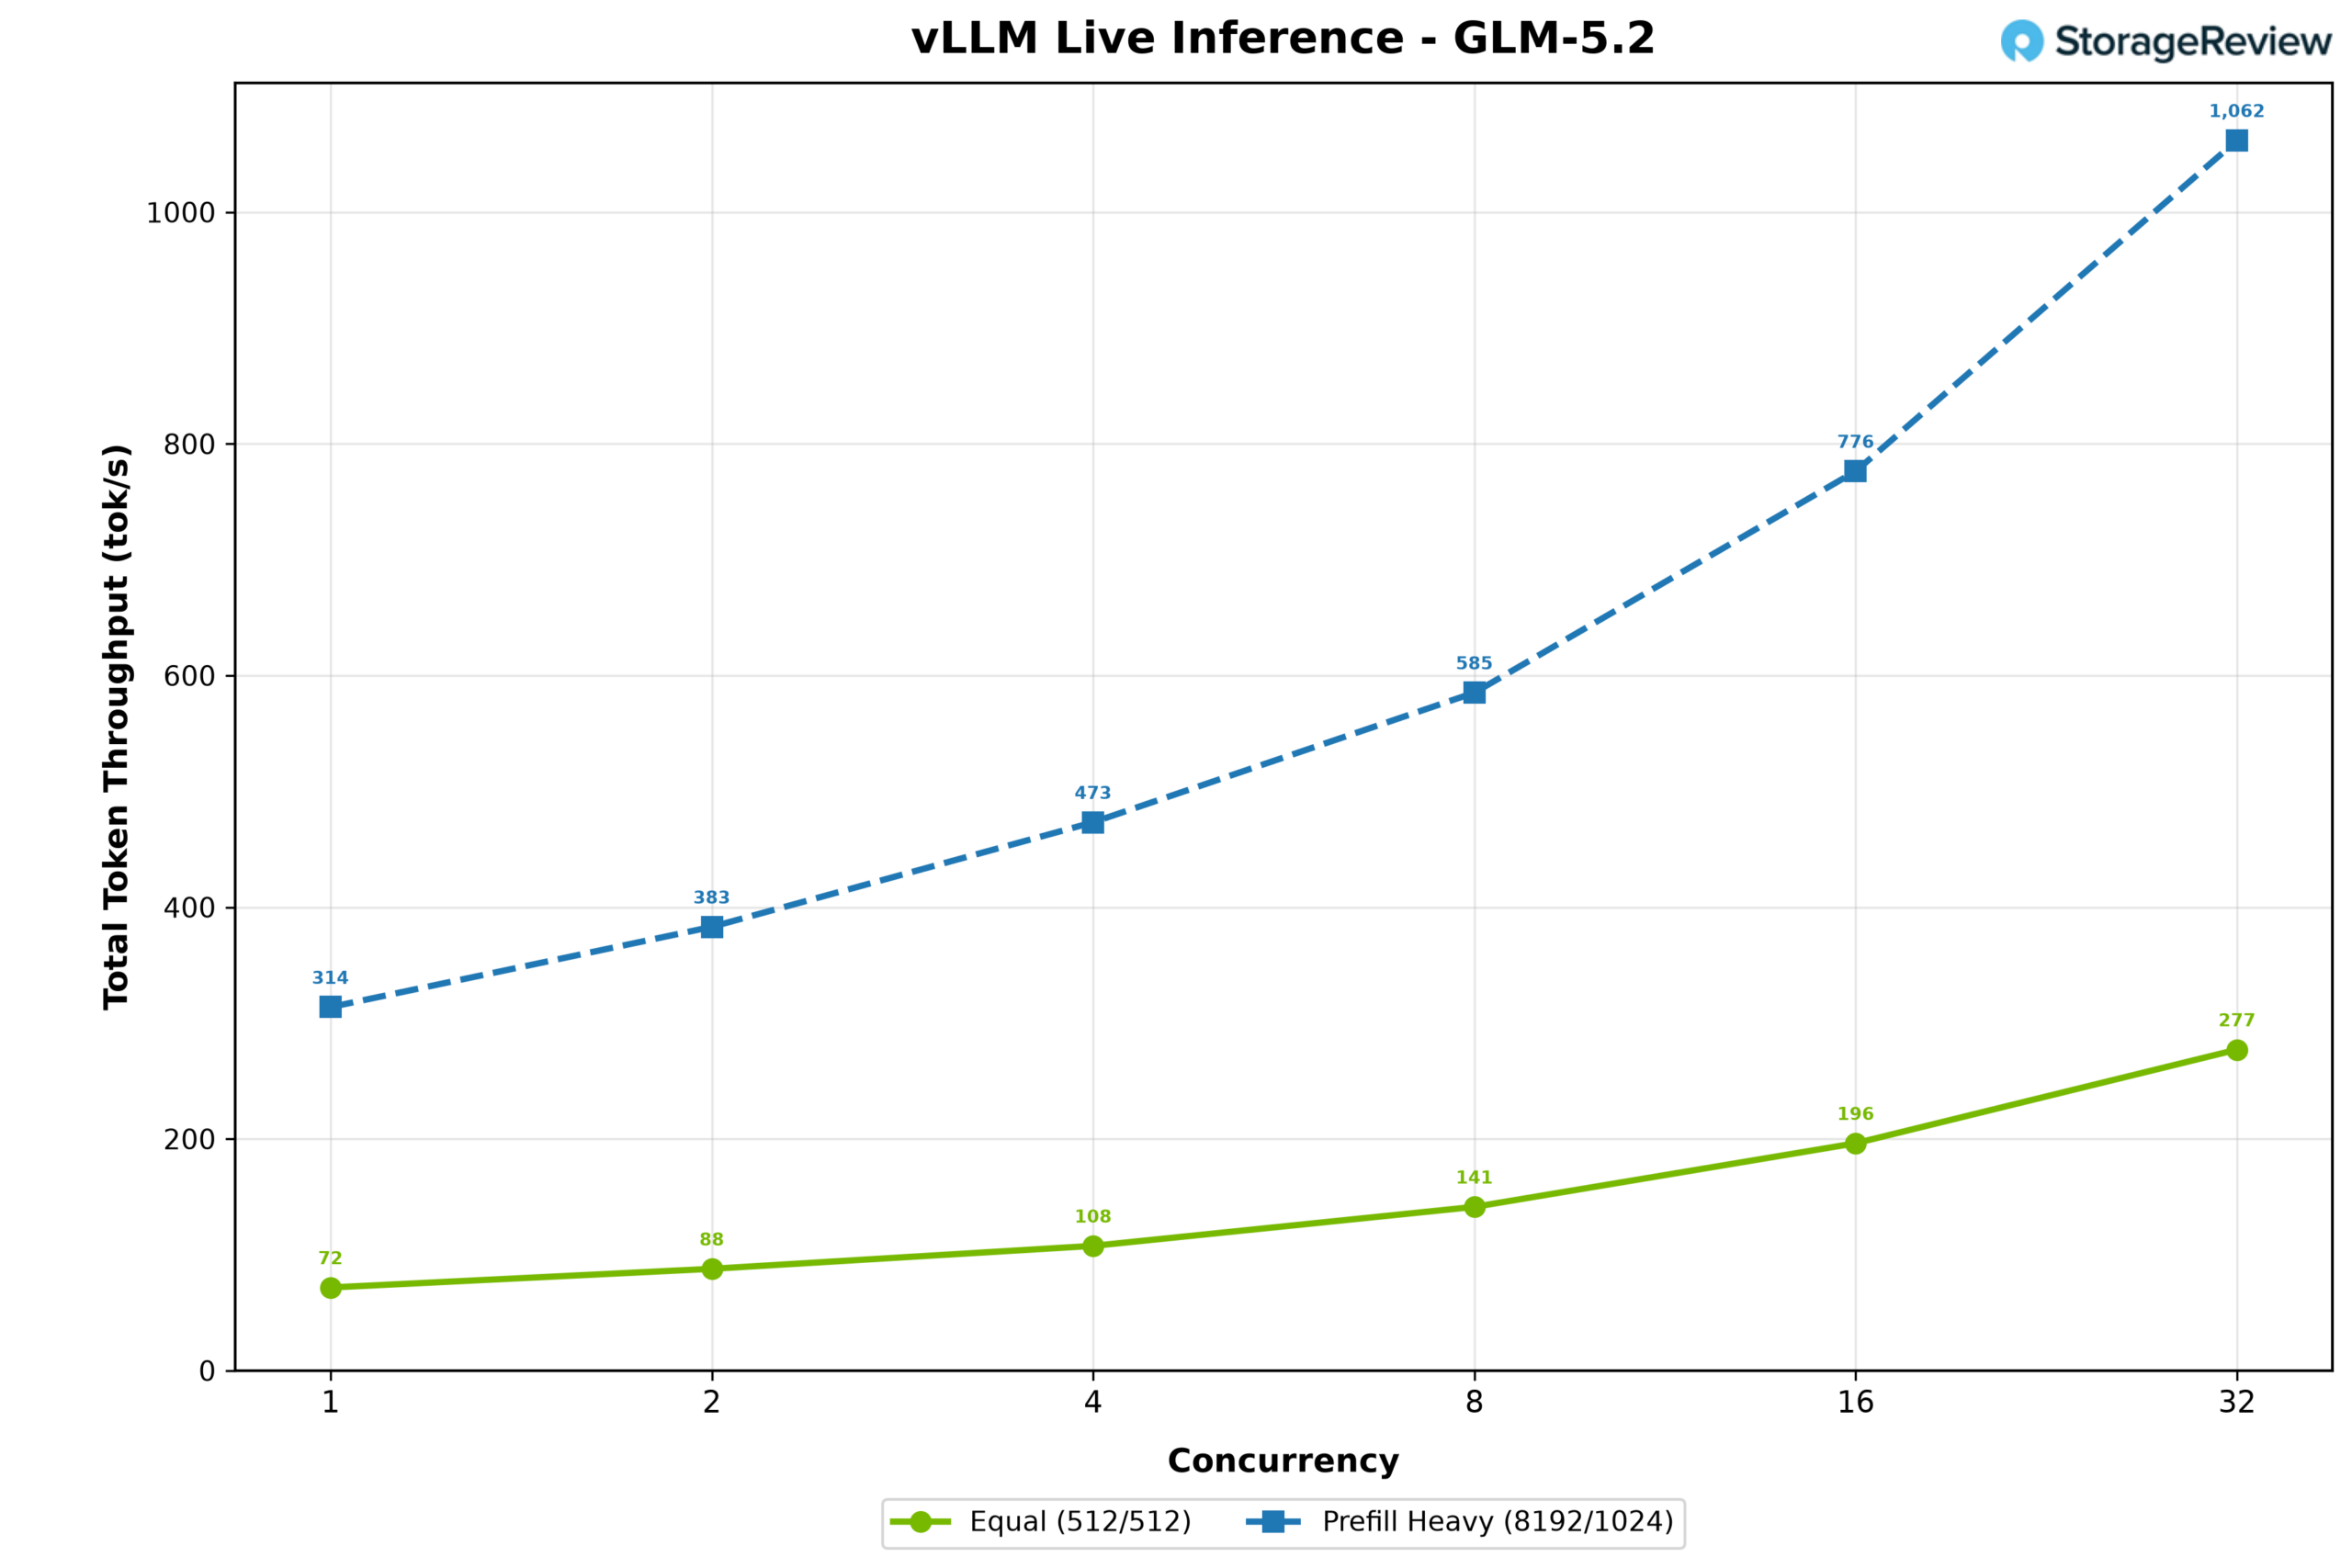
總令牌吞吐量也遵循相同的模式,512/512 工作負載從每秒 72 個令牌增加到 277 個令牌,預填充密集型工作負載從每秒 314 個令牌增加到 1,062 個令牌;在這裡,較長的提示最終將兩種情況區分開來,因為預填充令牌本身也計入總數。
Nemotron-3-Ultra 550B (NVFP4)
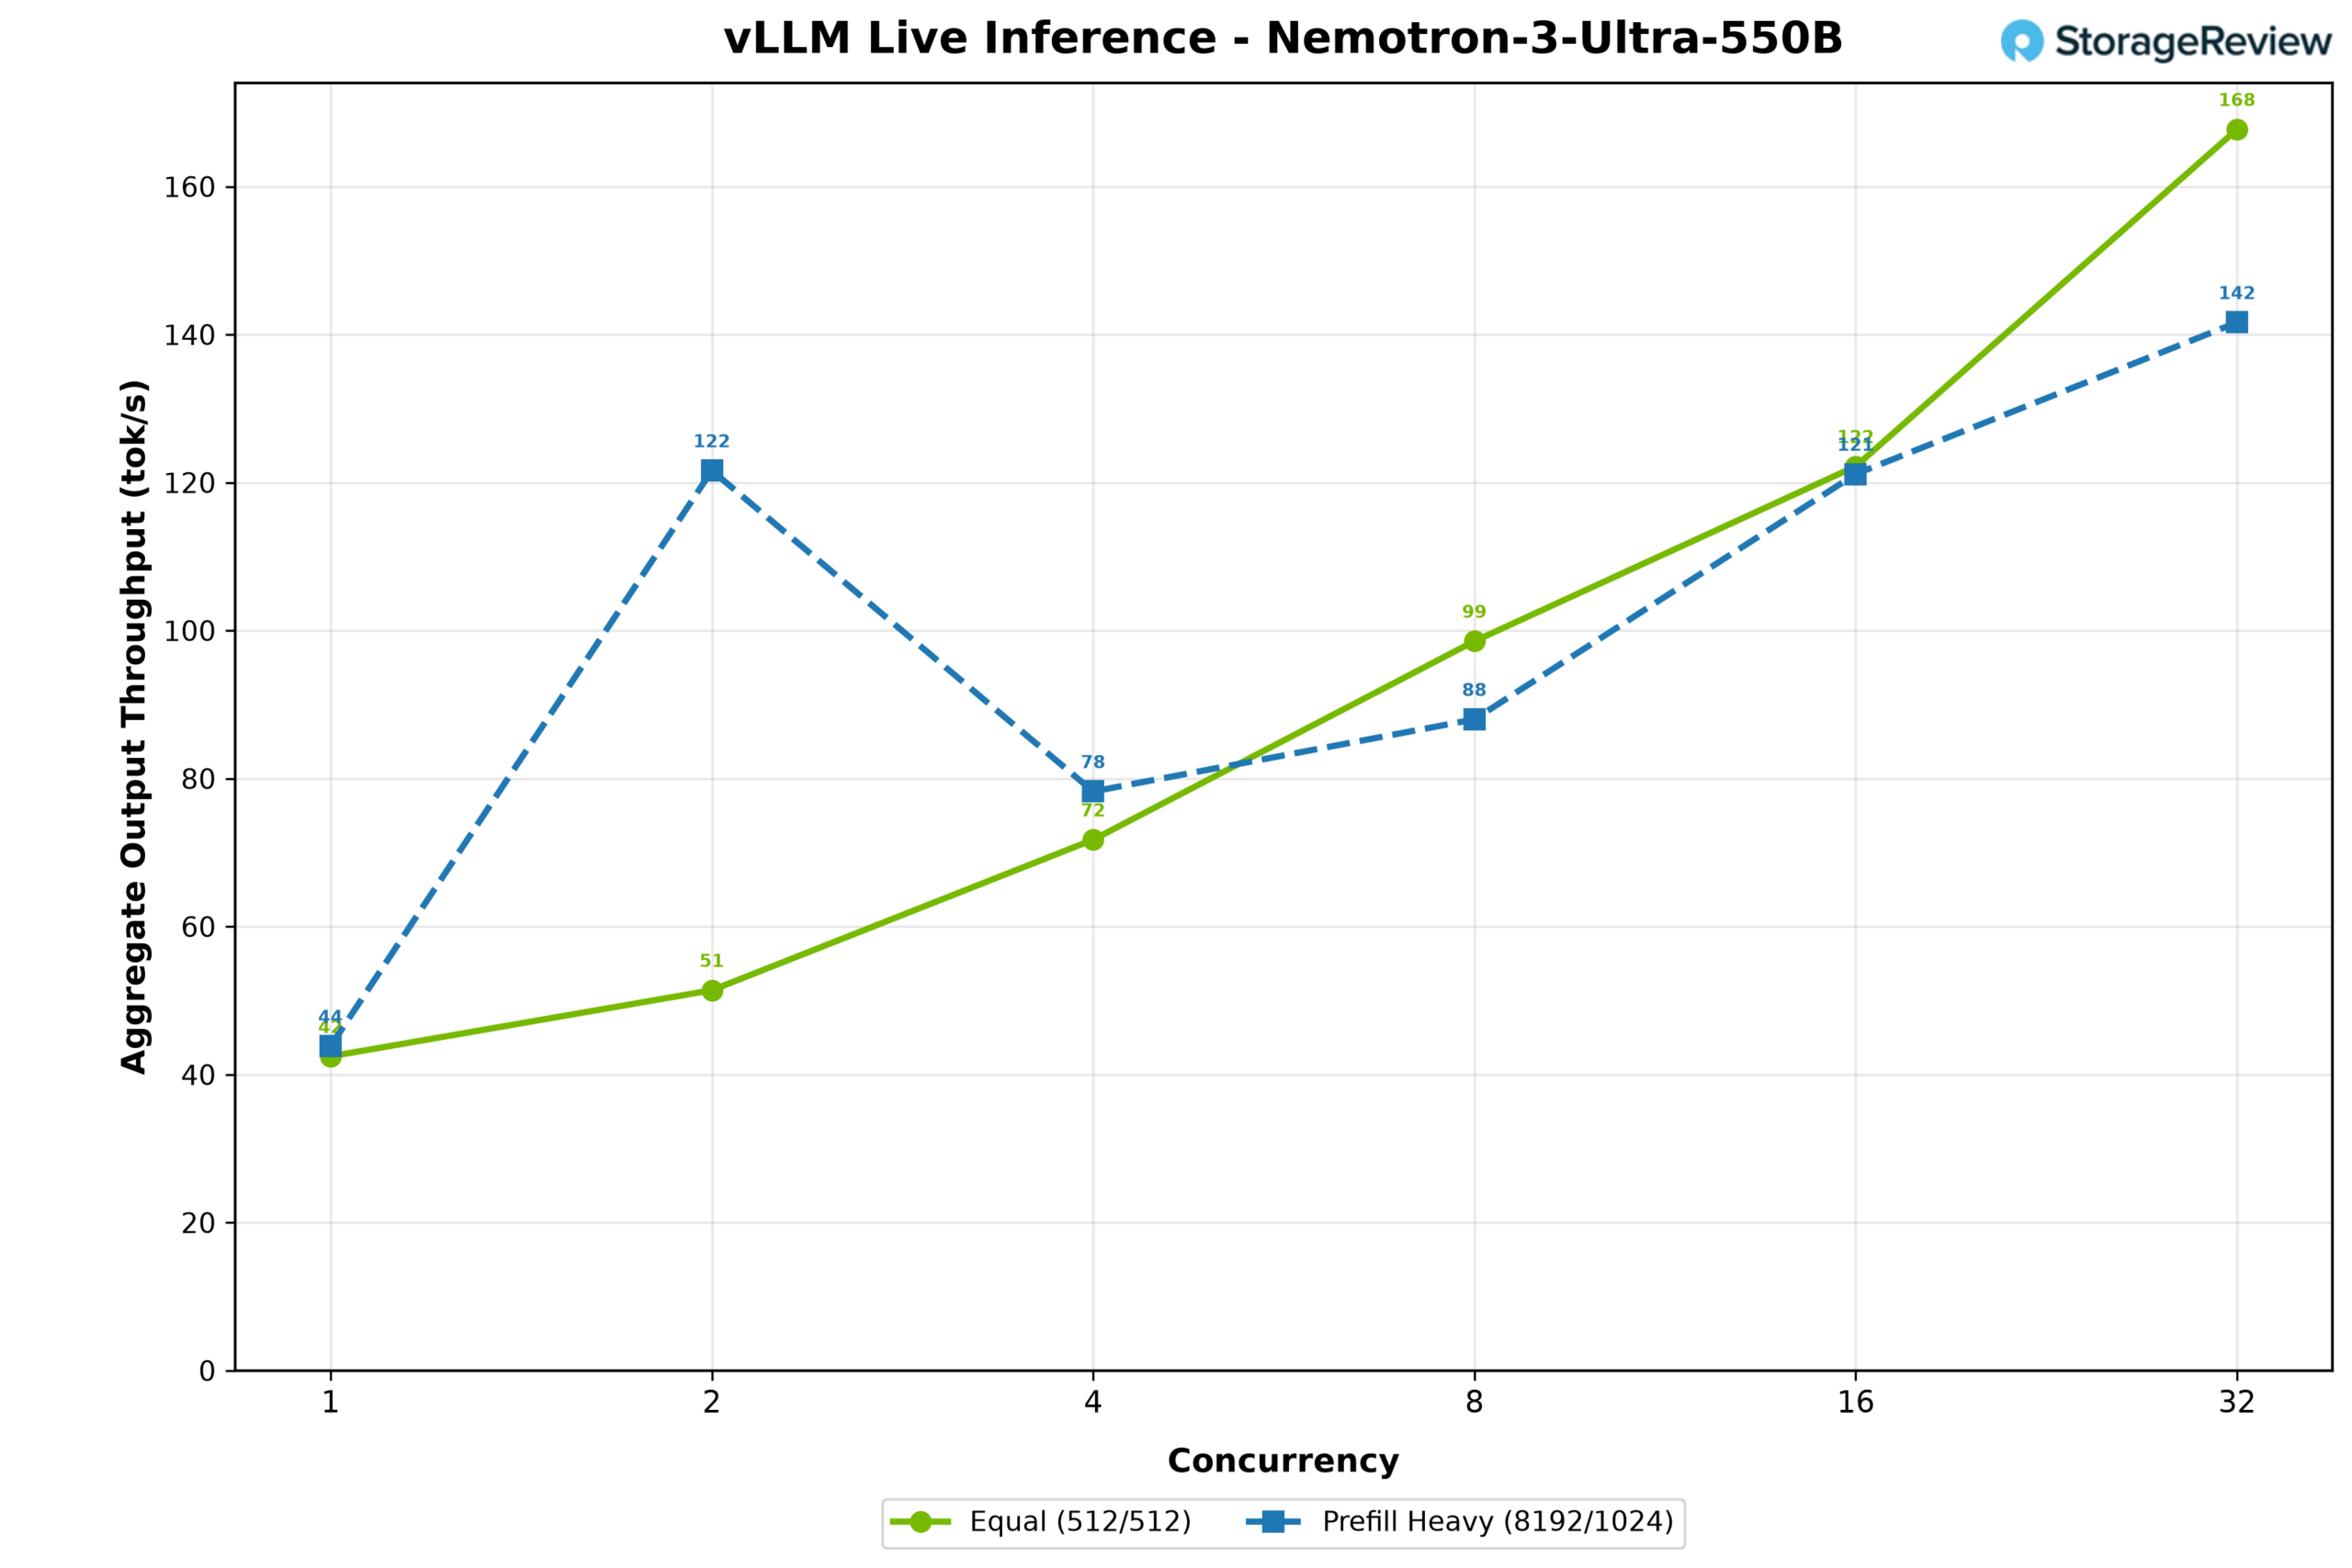
Nemotron-3-Ultra 550B 是我們運行過的最大模型,也是最能直接利用完整一致性池的模型。它是一個 307GB 的 NVFP4 混合 Transformer-Mamba 模型,對於 HBM 來說容量過大,因此將其 114GB 的權重卸載到了 Grace 記憶體中。我們使用了 MTP 推測性解碼,合成接受長度為 5 個 token。在 512/512 工作負載下,輸出吞吐量在同時數量為 1 時為每秒 43 個 token,並在並發數為 32 時攀升至每秒 168 個 token。預填充密集型工作負載的情況則更為有趣:吞吐量從並發數為 1 時的每秒 44 個 token 上升到並發數為 2 時的峰值每秒 122 個 token,但隨後由於較長的提示填滿了有限的 KV 緩存,吞吐量在並發數為 4 時回落至每秒 78 個 token。與 GLM-5.2 類似,這兩個效能曲線非常接近,再次表明限制因素是 Grace 和 GPU 之間的專業資料遷移,而不是運算能力。掃描在並發數達到 32 時結束,原因相同:沒有足夠的 HBM 來提供更多上下文。
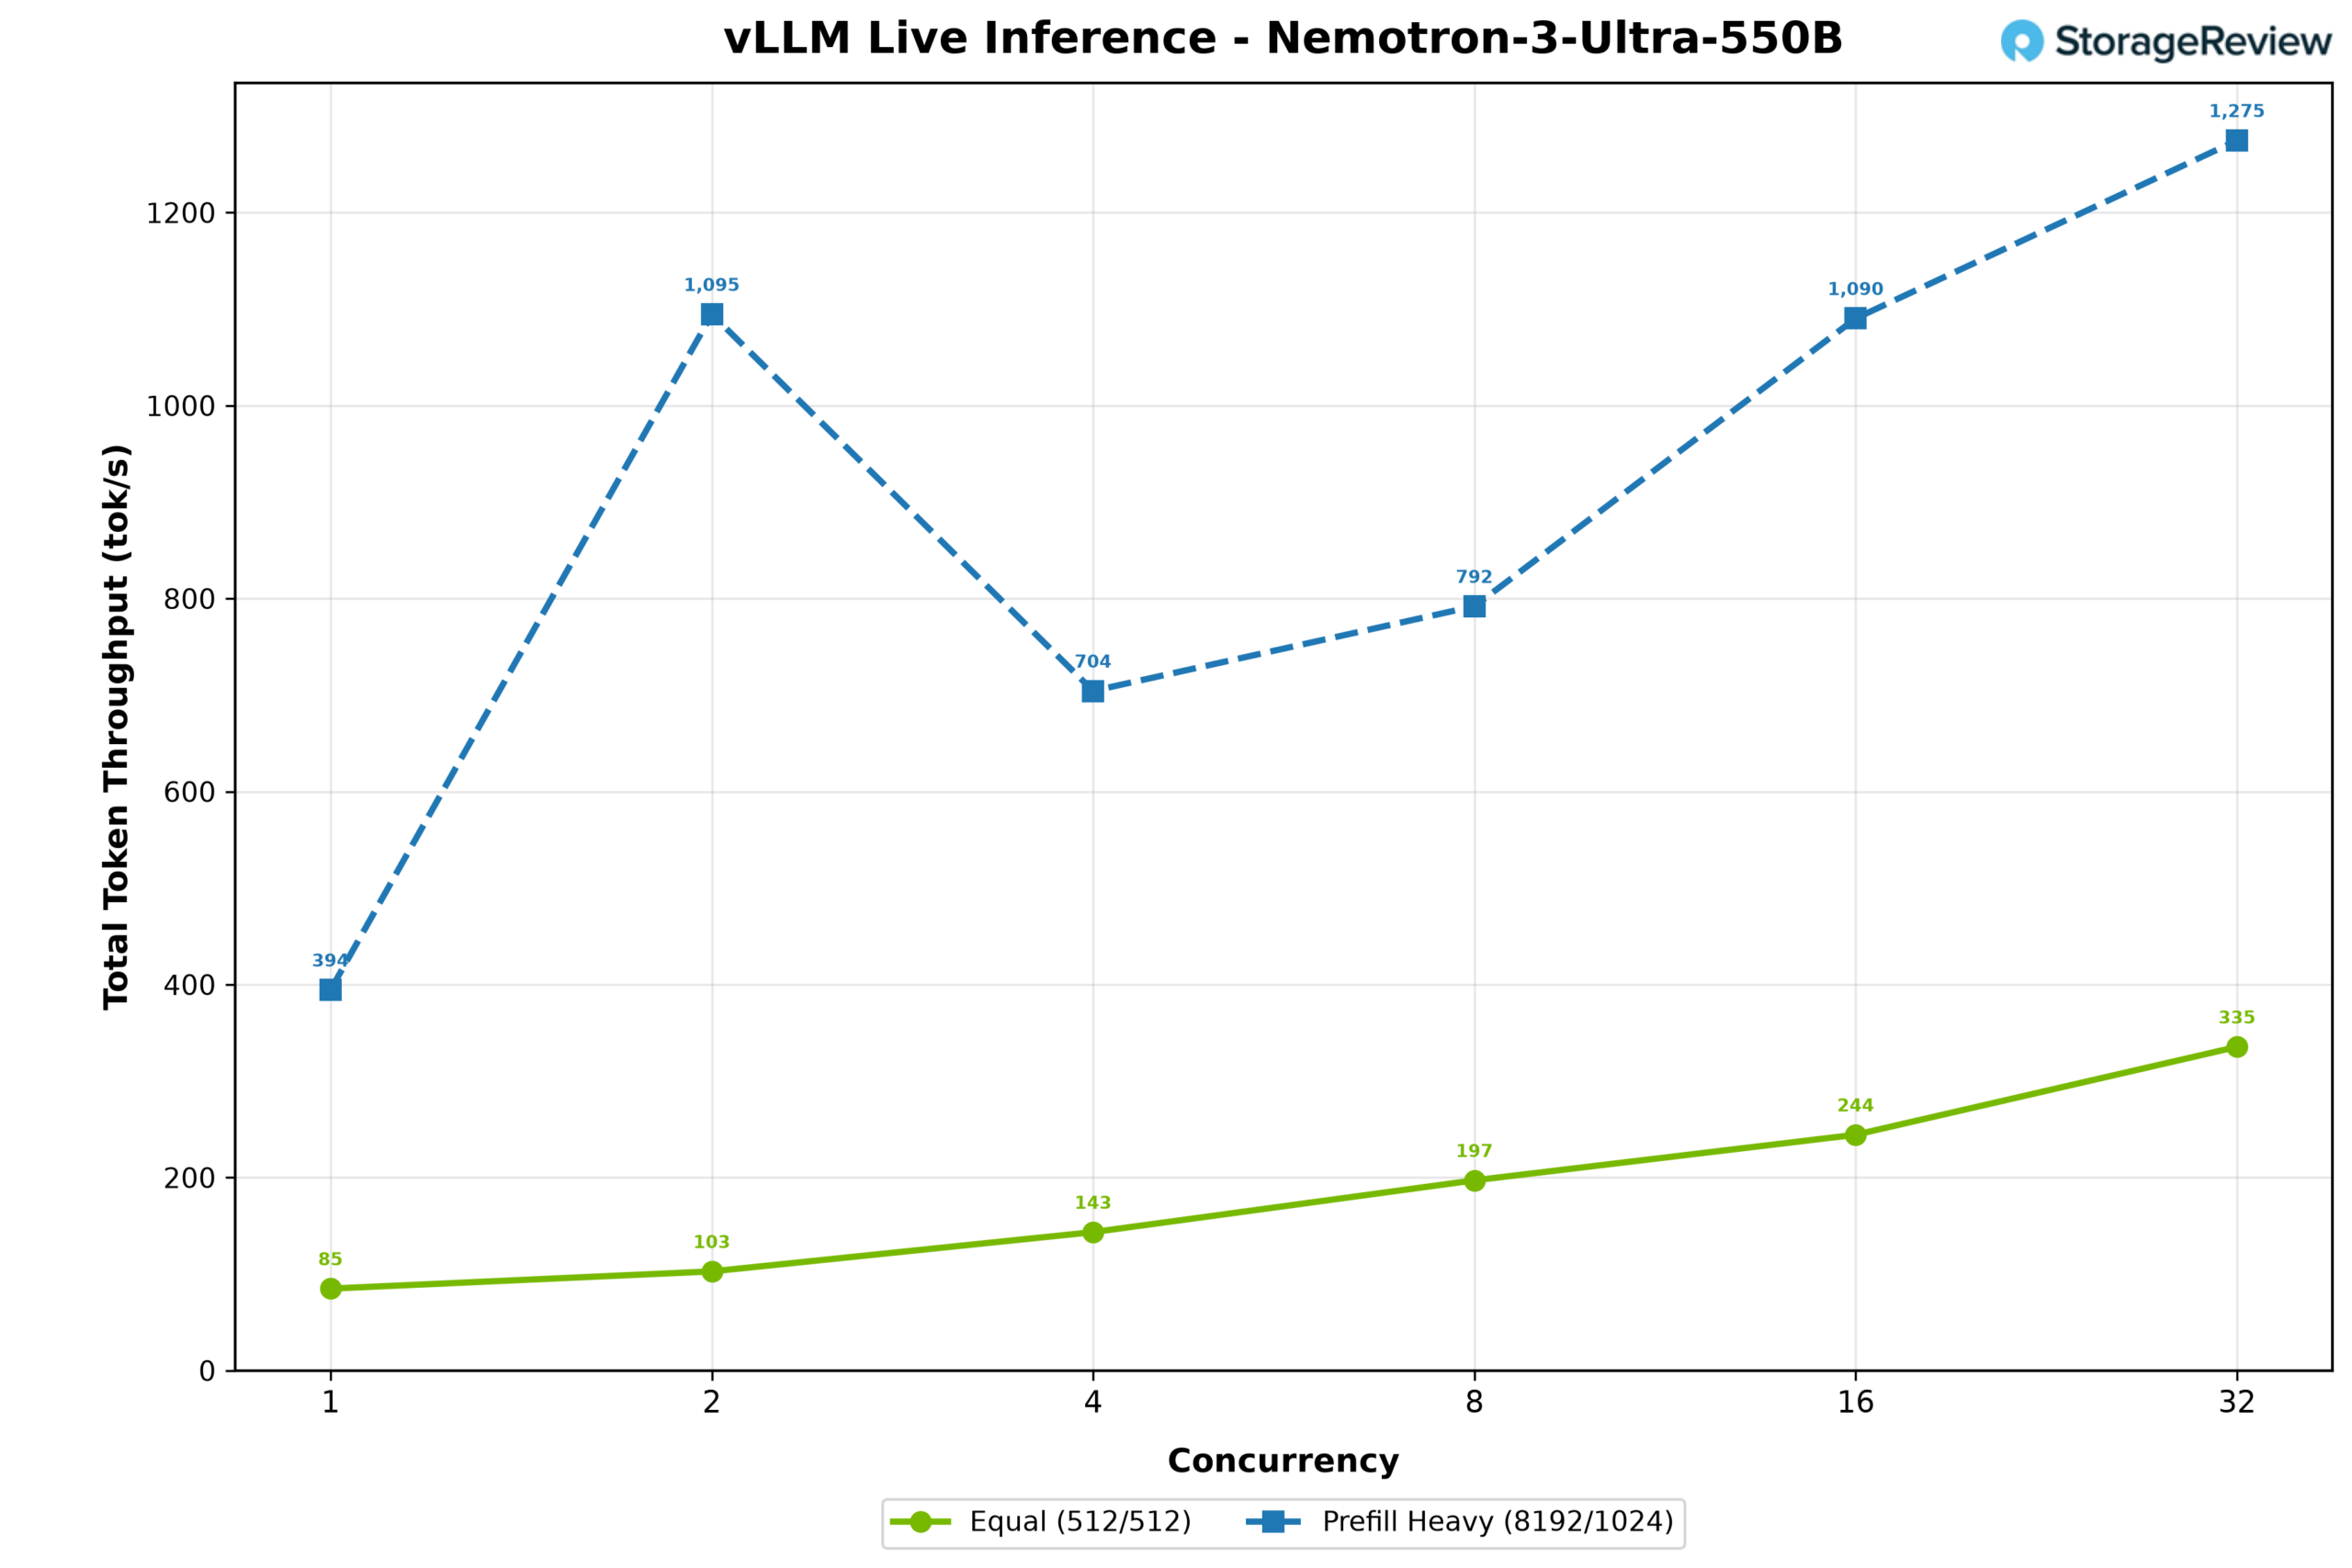
總令牌吞吐量隨後出現,預填充密集型工作負載在並發數為 2 時達到每秒 2,506 個令牌的峰值,然後在並發數為 4 時下降到每秒 2,169 個令牌,而 512/512 工作負載從每秒 85 個令牌擴展到每秒 336 個令牌擴展到。
WS300 比較 Blackwell RTX PRO 6000 比較 DGX Spark
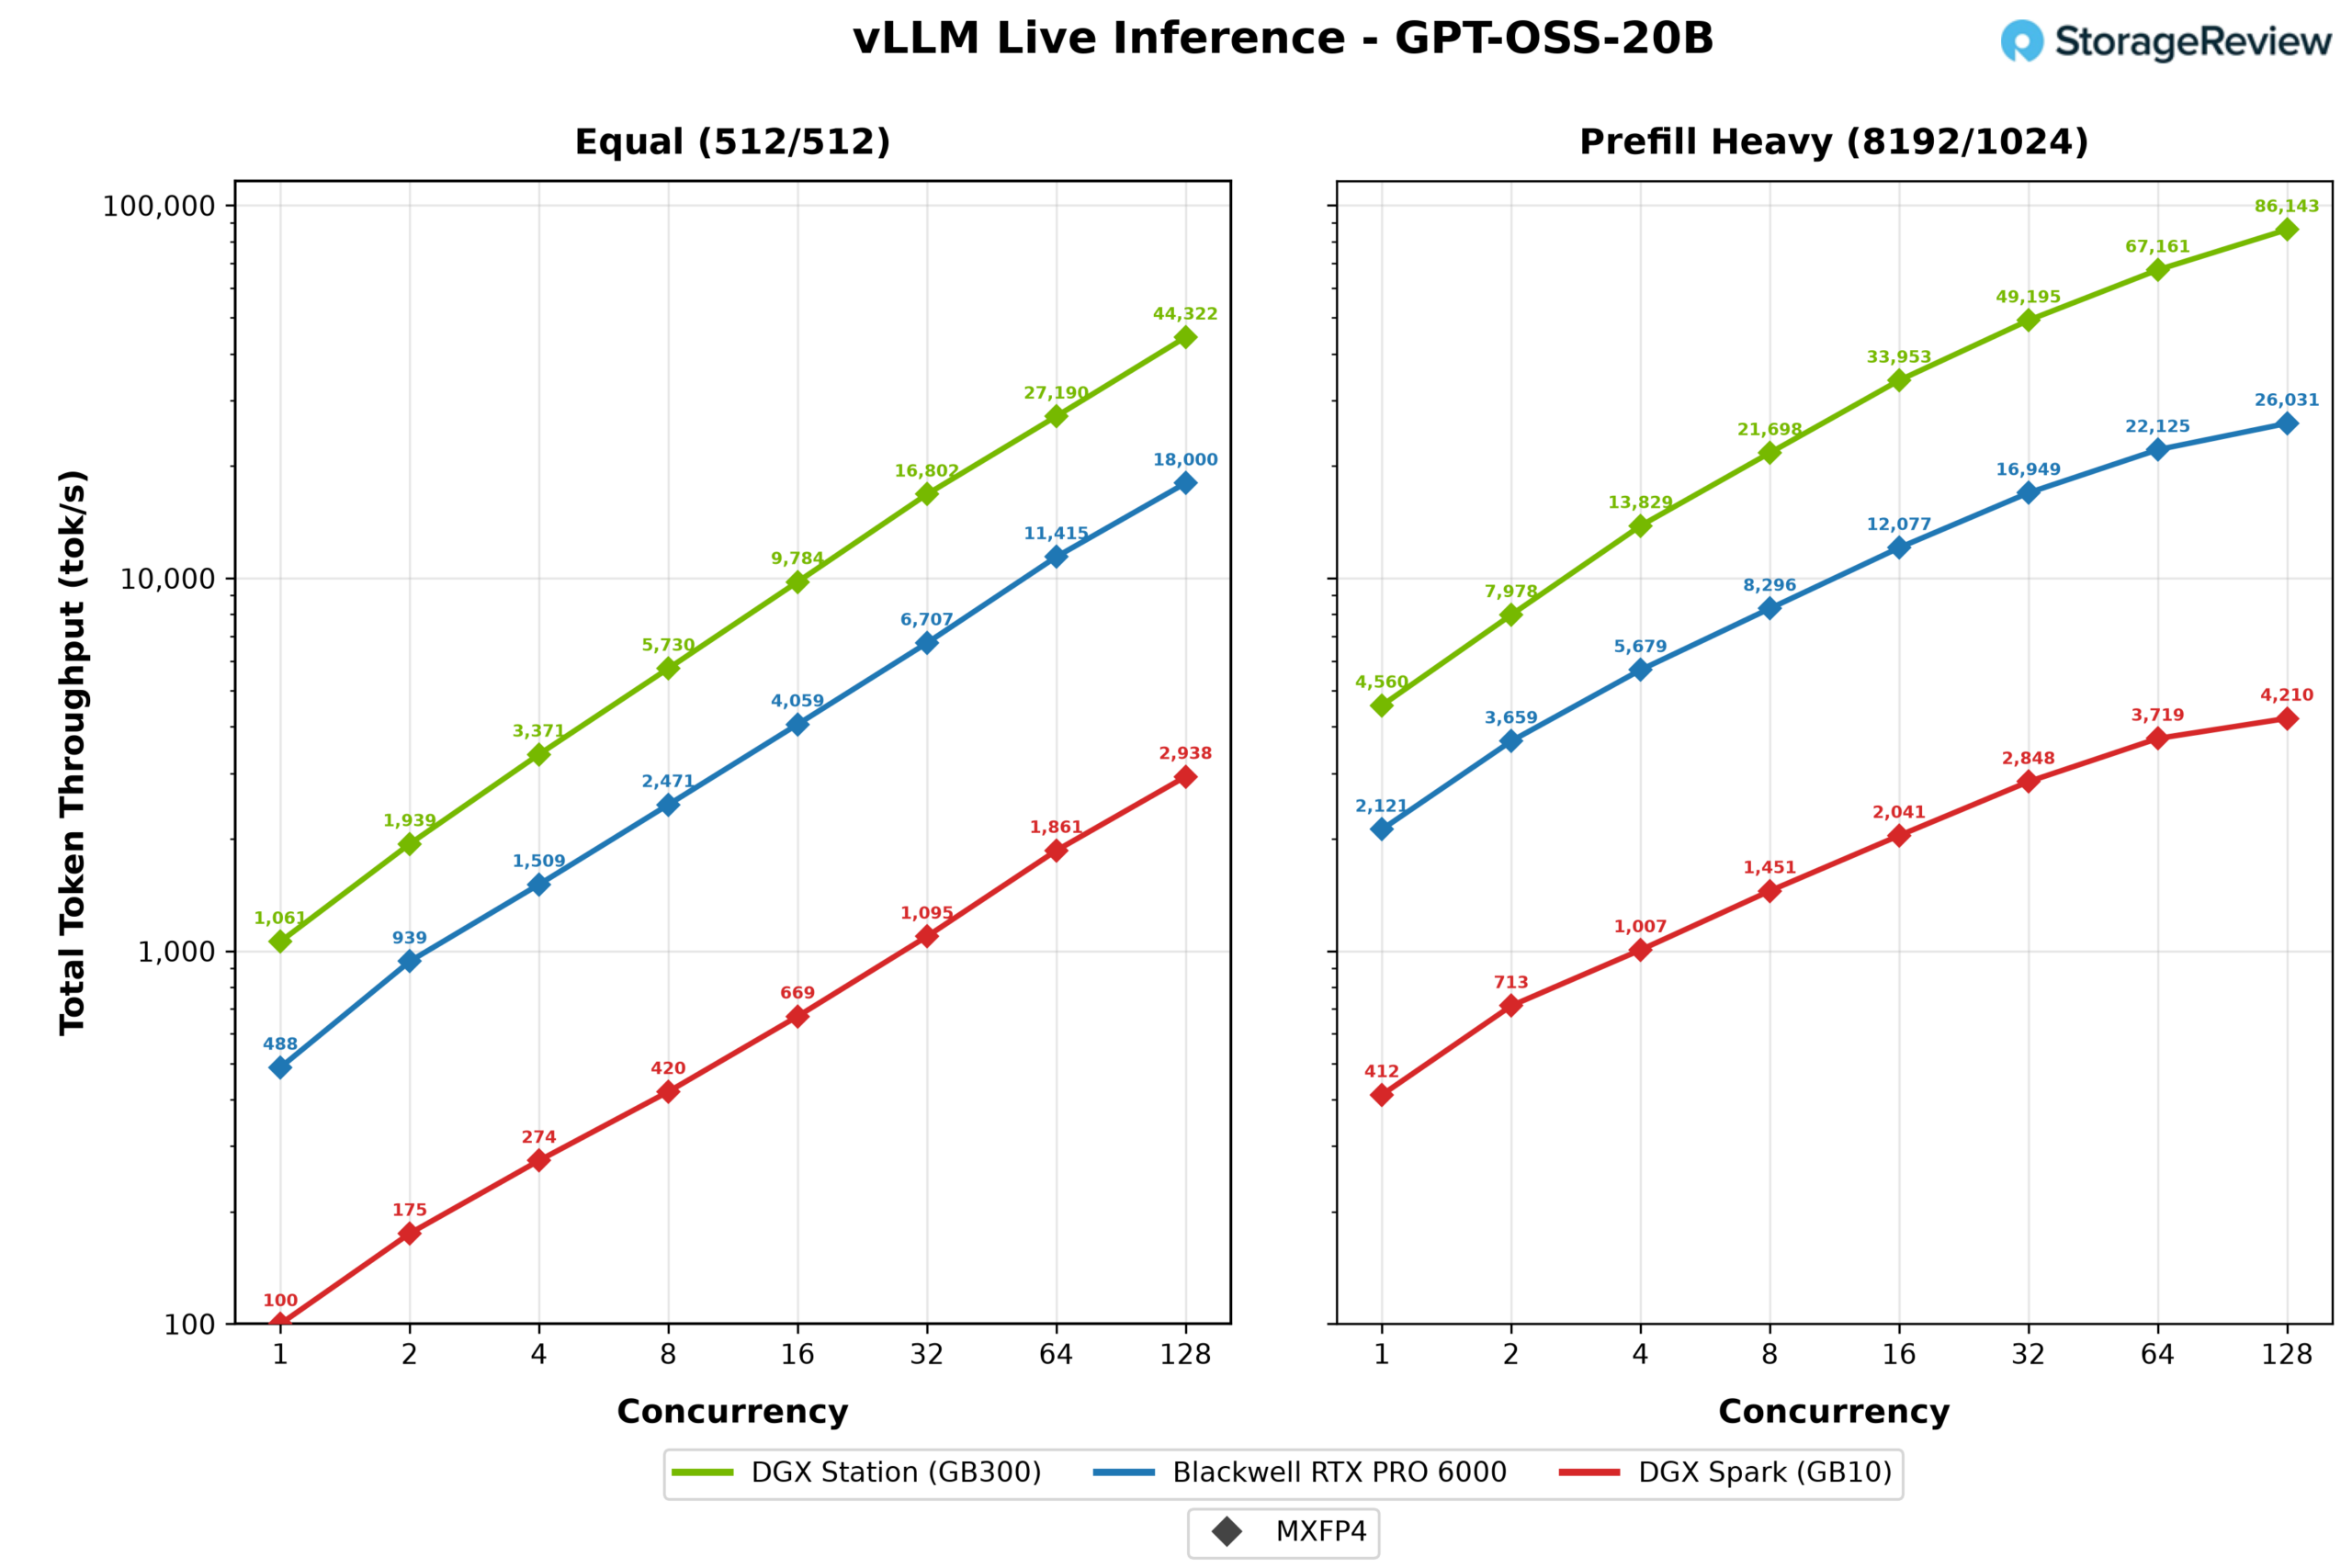
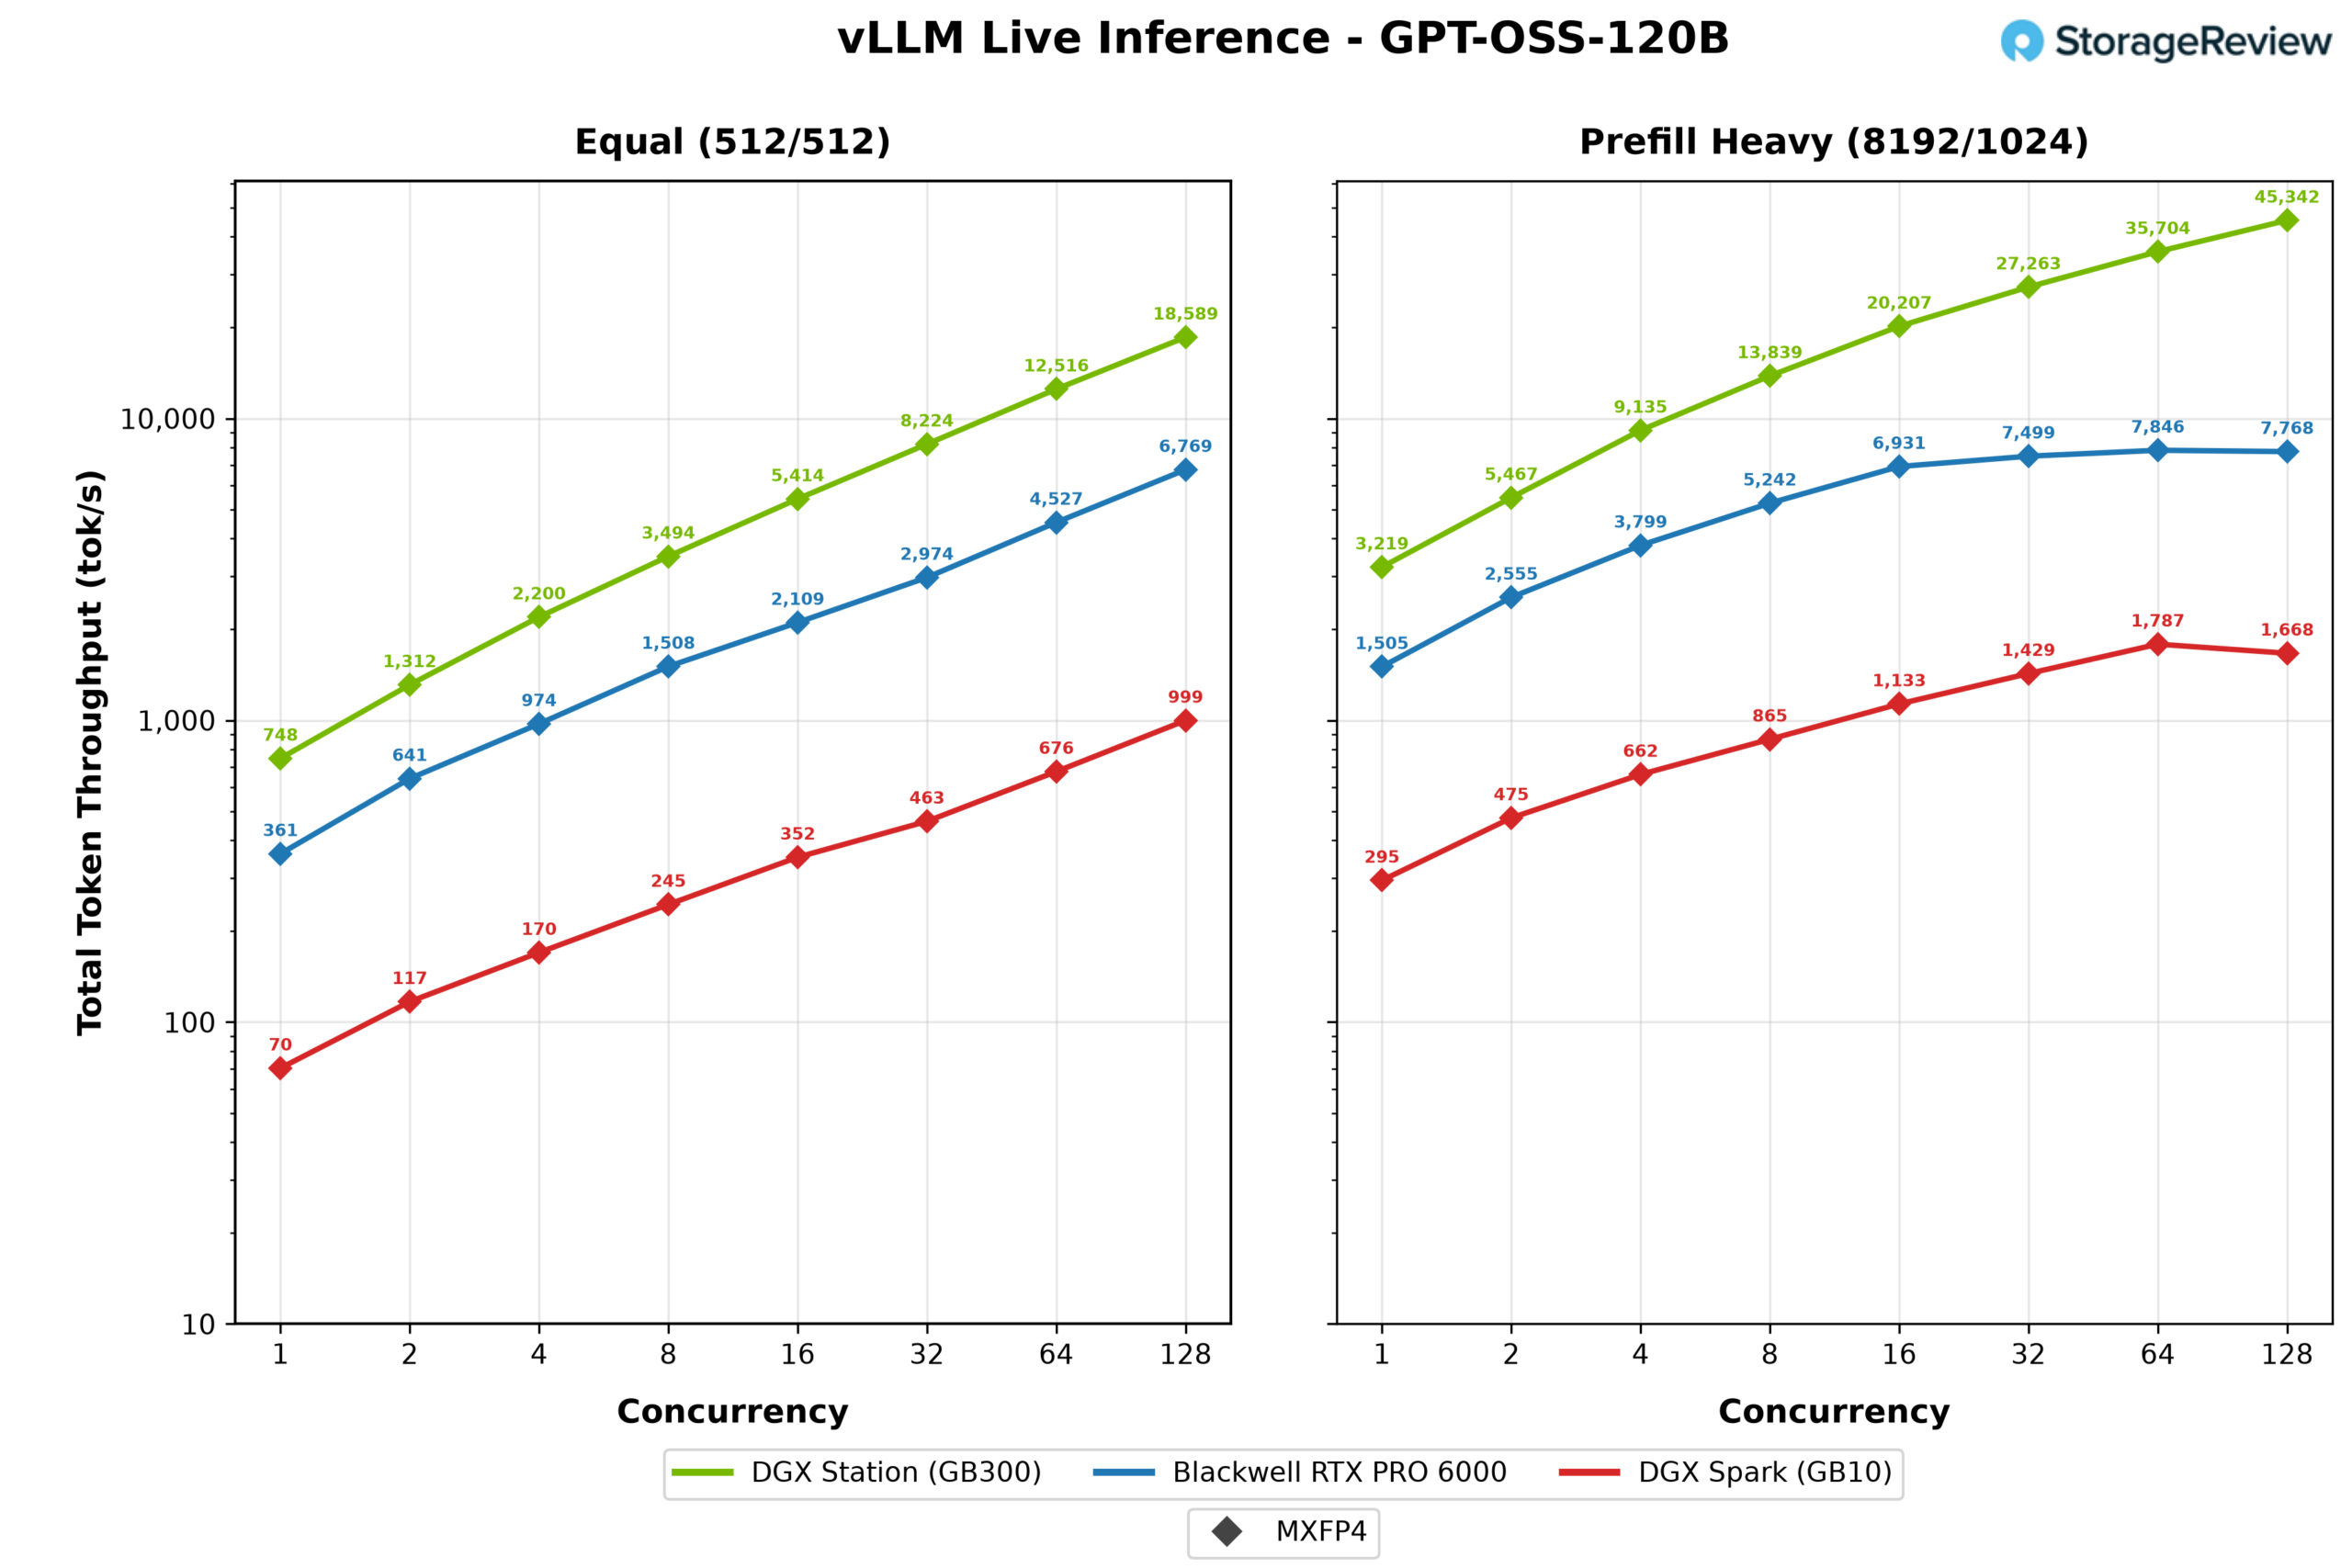
在本推理測試的這一部分中,我們將 WS300 與另外兩種將 Blackwell 放在桌面上或附近的方案進行了比較:一種是 Blackwell RTX PRO 6000,NVIDIA 的 600W 工作站顯示卡,它安裝在我們之前評測過的Dell Pro MaxGN T2中;另一種是基於 GB X10 以代表這裡的 DGi ,為每個系統在兩種場景下運行相同的 vLLM 即時推理工作負載:一種是輸入 512 個輸入和 512 個輸出標記的均衡工作負載,另一種是輸入 8,192 個輸入和 1,024 個輸出標記的預填充密集型工作負載,並發級別從 1 到 128。我們繪製了所有三個系統均可共同運行的每個模型的聚合輸出和總吞吐量圖表:原生 MXFP4 架構的 GPT-OSS-20B 和 GPT-OSS-120B,BF16、FP8 和 NVFP4 架構的 Llama 3.1 8B,以及 BF16 和 FP8 架構的 Mistral Small 架構的 Mistral 24Bder, SmallBder Small 架構的 Mistral 24Bder。
GPT-OSS-20B
GPT-OSS-20B 是這組測試中最友善的,它能輕鬆適應所有三款系統。在相同的工作負載下,WS300 在 128 個同時流的情況下,輸出代幣速度可達每秒 22,161 個,約為 RTX PRO 6000(9,000 個)的 2.5 倍,以及 DGX Spark(1,469 個)的 15 倍。單流測試結果也印證了這一點:工作站每秒輸出令牌 530 個,顯示卡每秒輸出令牌 244 個,而 Spark 每秒輸出令牌 50 個。
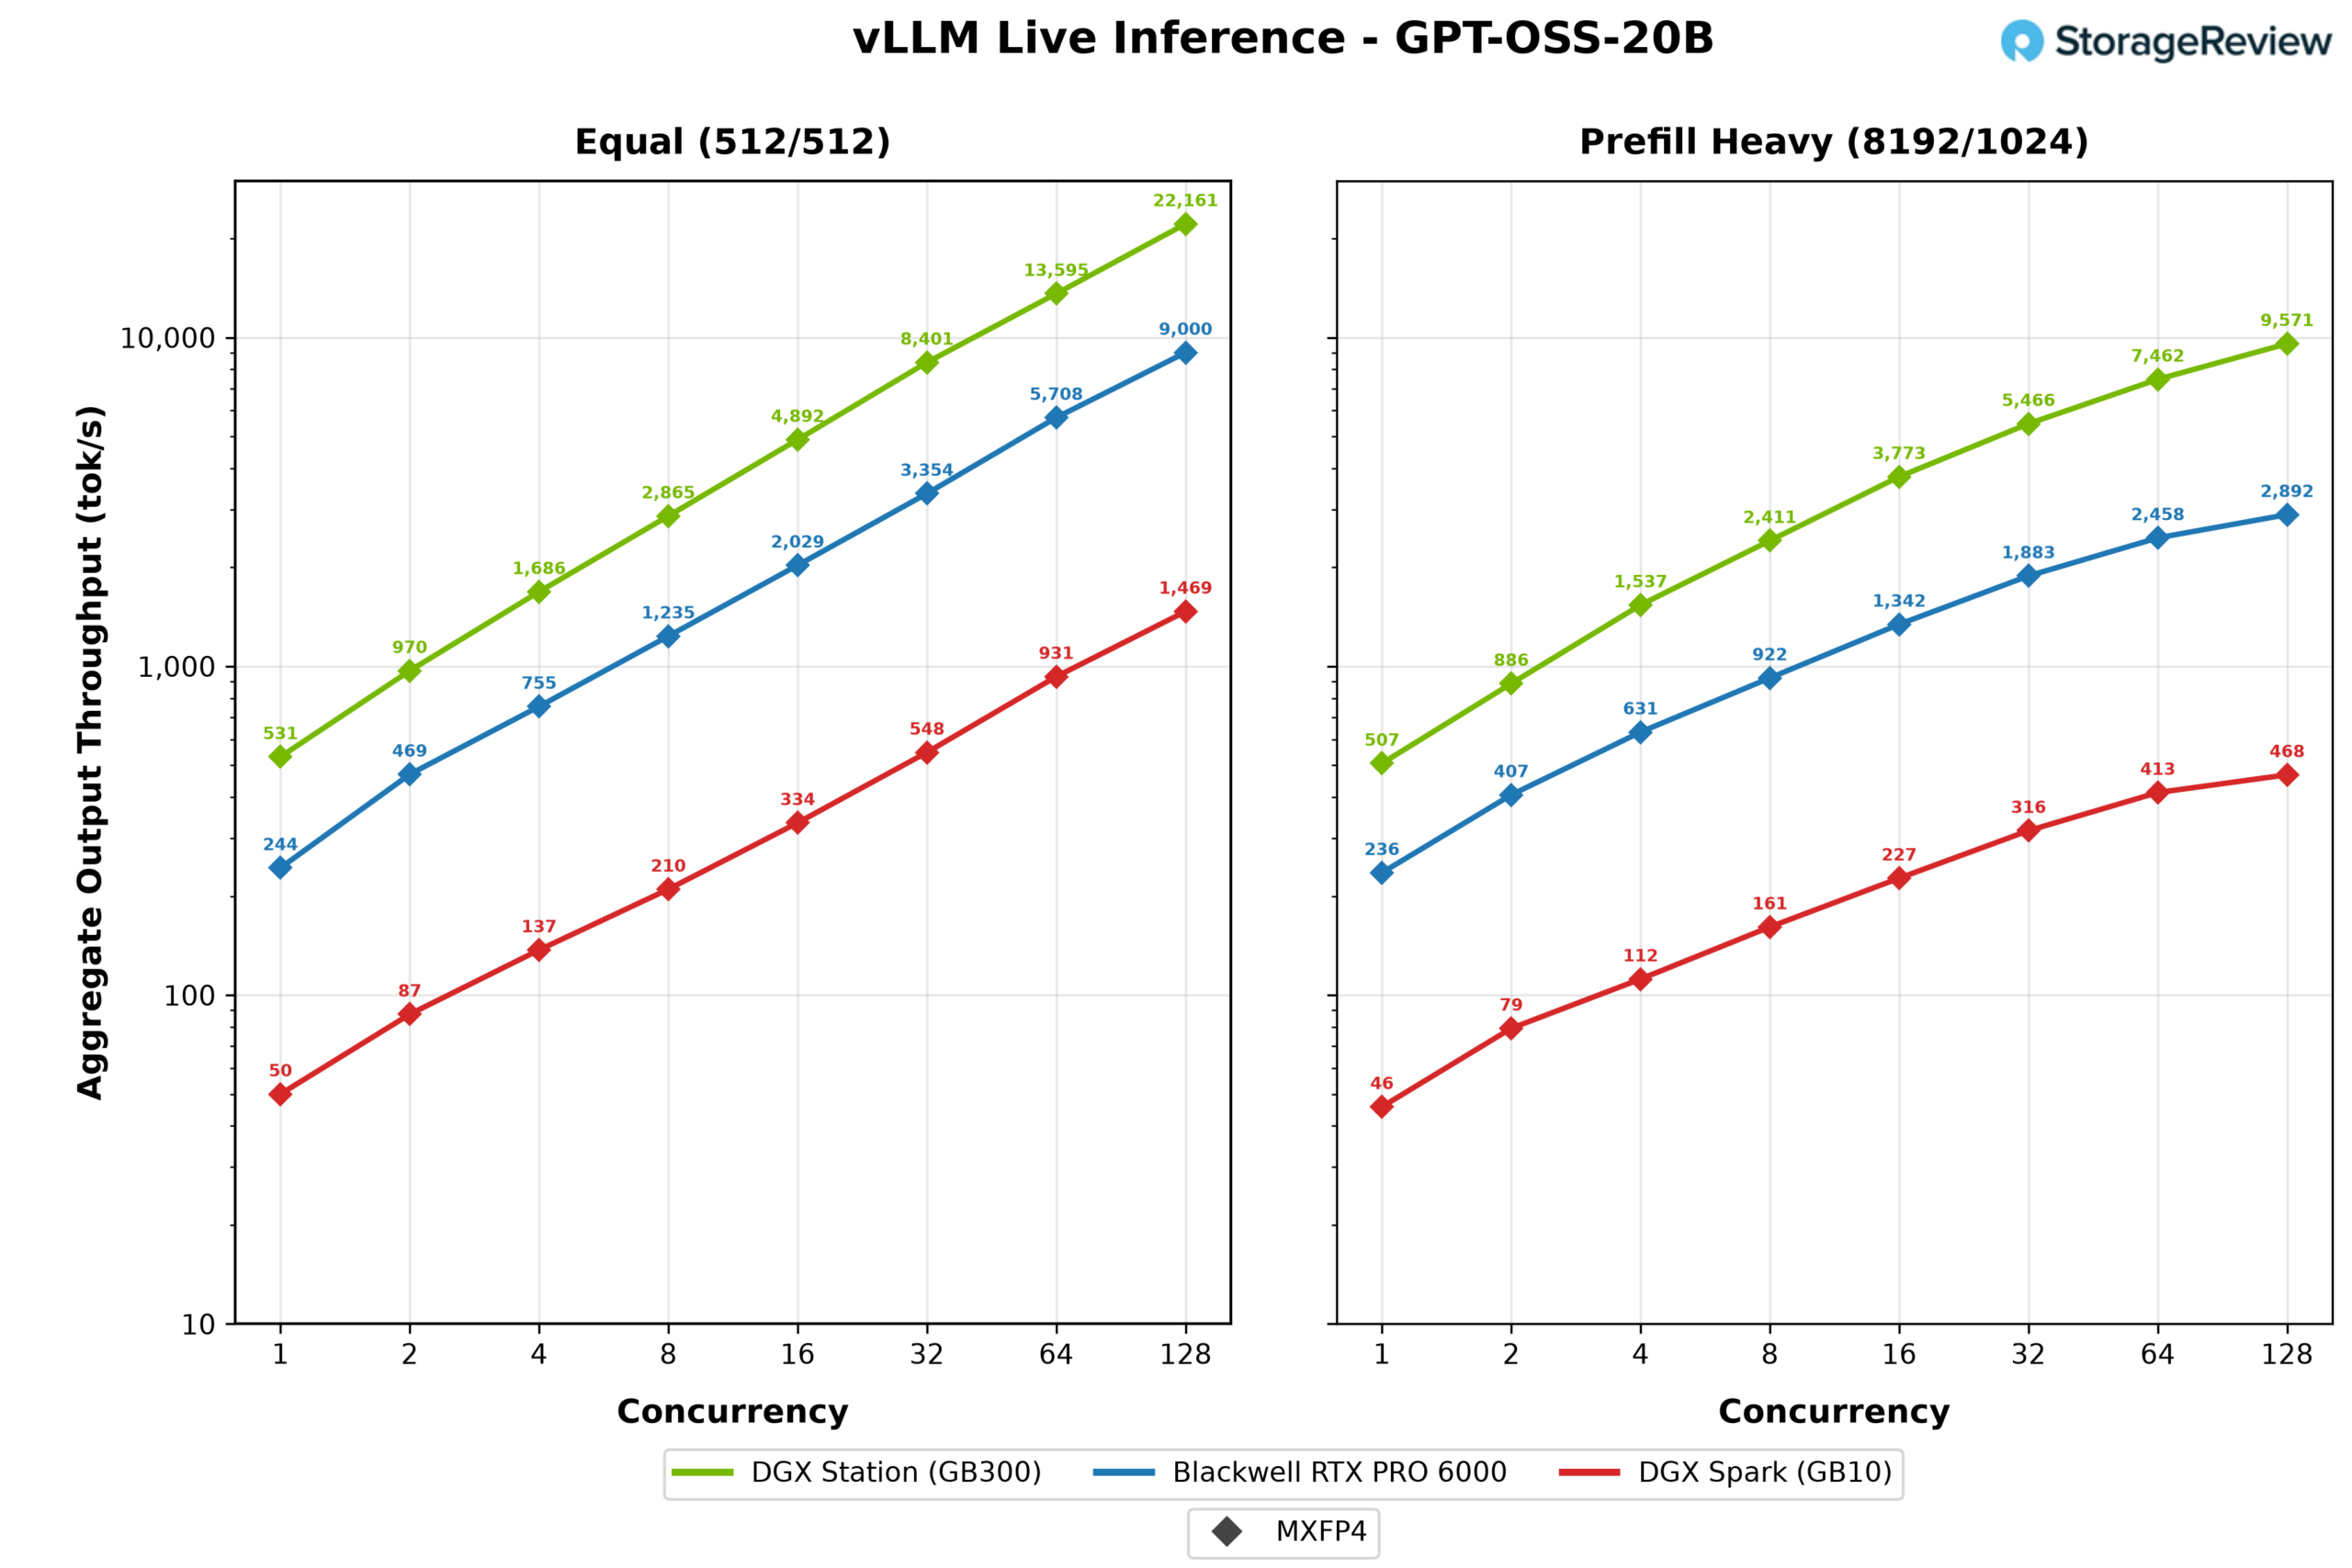
預填操作會進一步拉開各顯示卡之間的差距。在發送 8,192 個令牌提示的情況下,WS300 的峰值輸出令牌數仍高達每秒 9,572 個,加上預先填充操作,總輸出令牌數超過每秒 86,000 個,而 RTX PRO 6000 的最高輸出令牌數為每秒 2,892 個,Spark 則為 468 個每秒。
GPT-OSS-120B
升級到 GPT-OSS-120B 後,三款系統都能載入此模型,但記憶體層次結構開始變得重要。在相同工作負載下,WS300 的峰值輸出令牌速度達到每秒 9,294 個,是 RTX PRO 6000(3,384 個)的 2.7 倍,幾乎是 DGX Spark(500 個)的 19 倍。
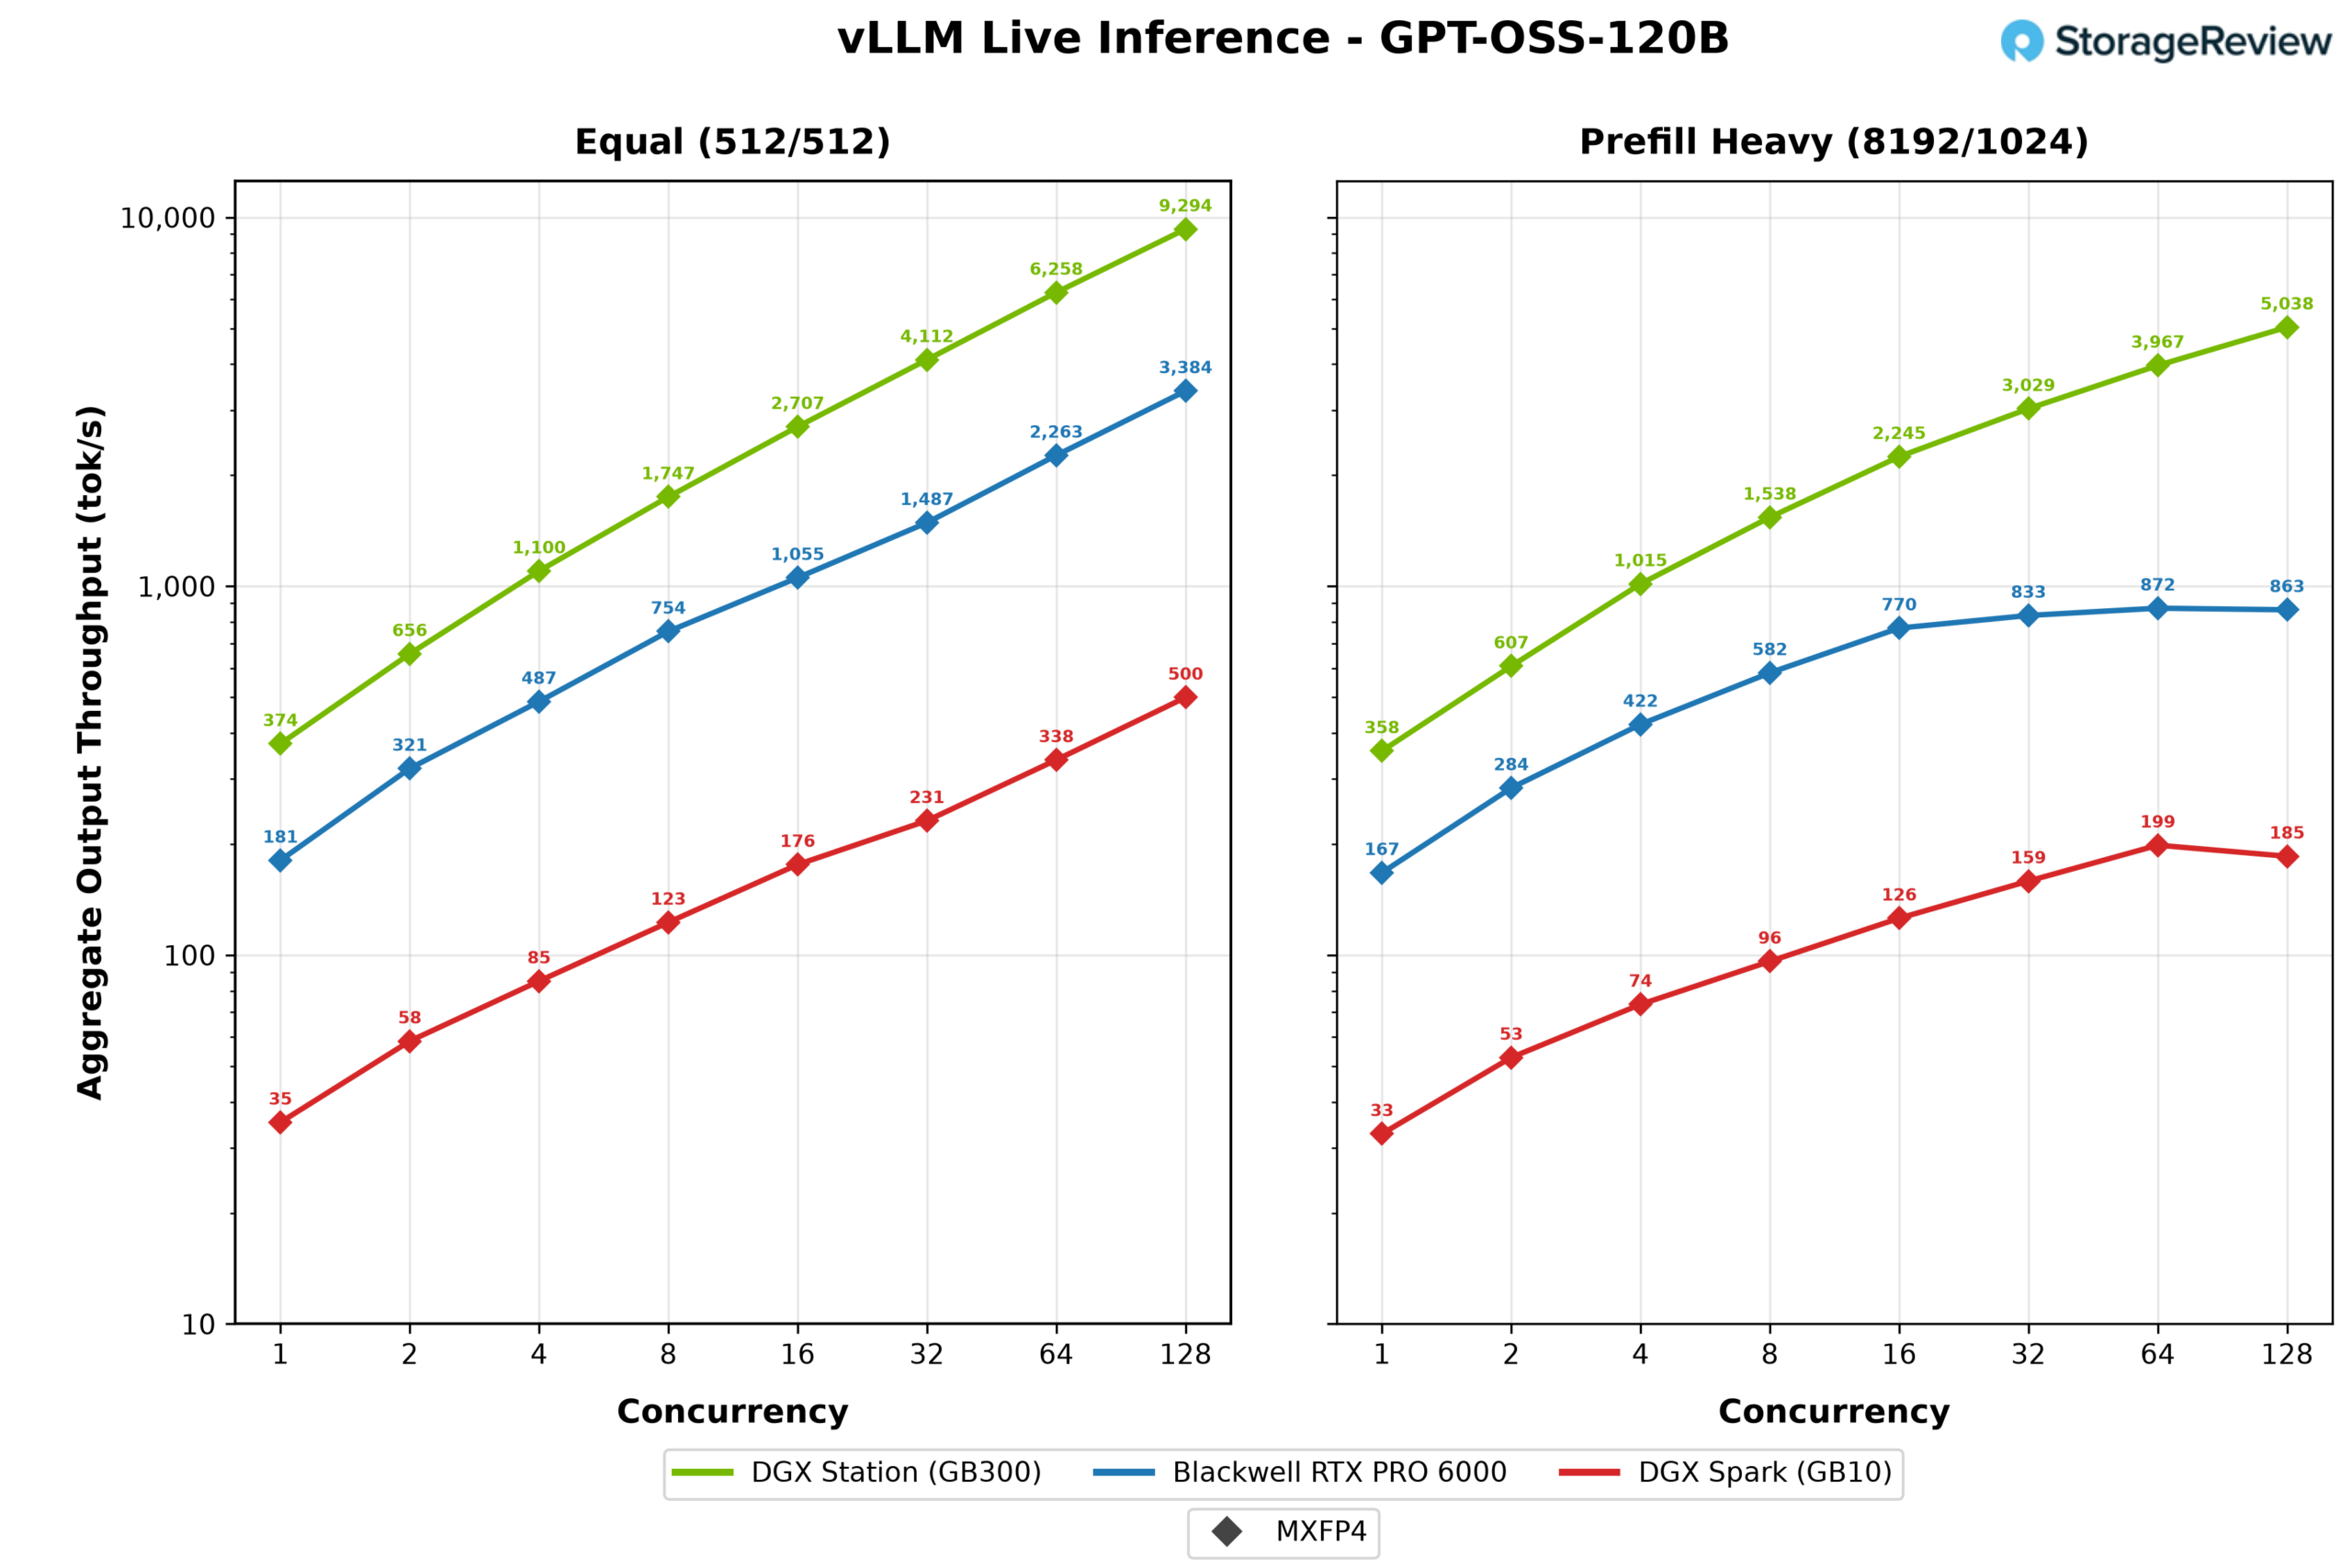
在預填密集型任務中,小型系統的效能瓶頸就顯現出來了。 RTX PRO 6000 在 64 個並發流下輸出代幣速度降至每秒 872 個,Spark 則為 199 個,而 WS300 在 128 個流下仍在持續提升,最終達到 5,038 個,比前者高出近 6 倍。長時間的請求會迅速佔用大量鍵值緩存,記憶體餘量較小的系統在 Station 之前就會耗盡批次空間。
羊駝 3.1 8B
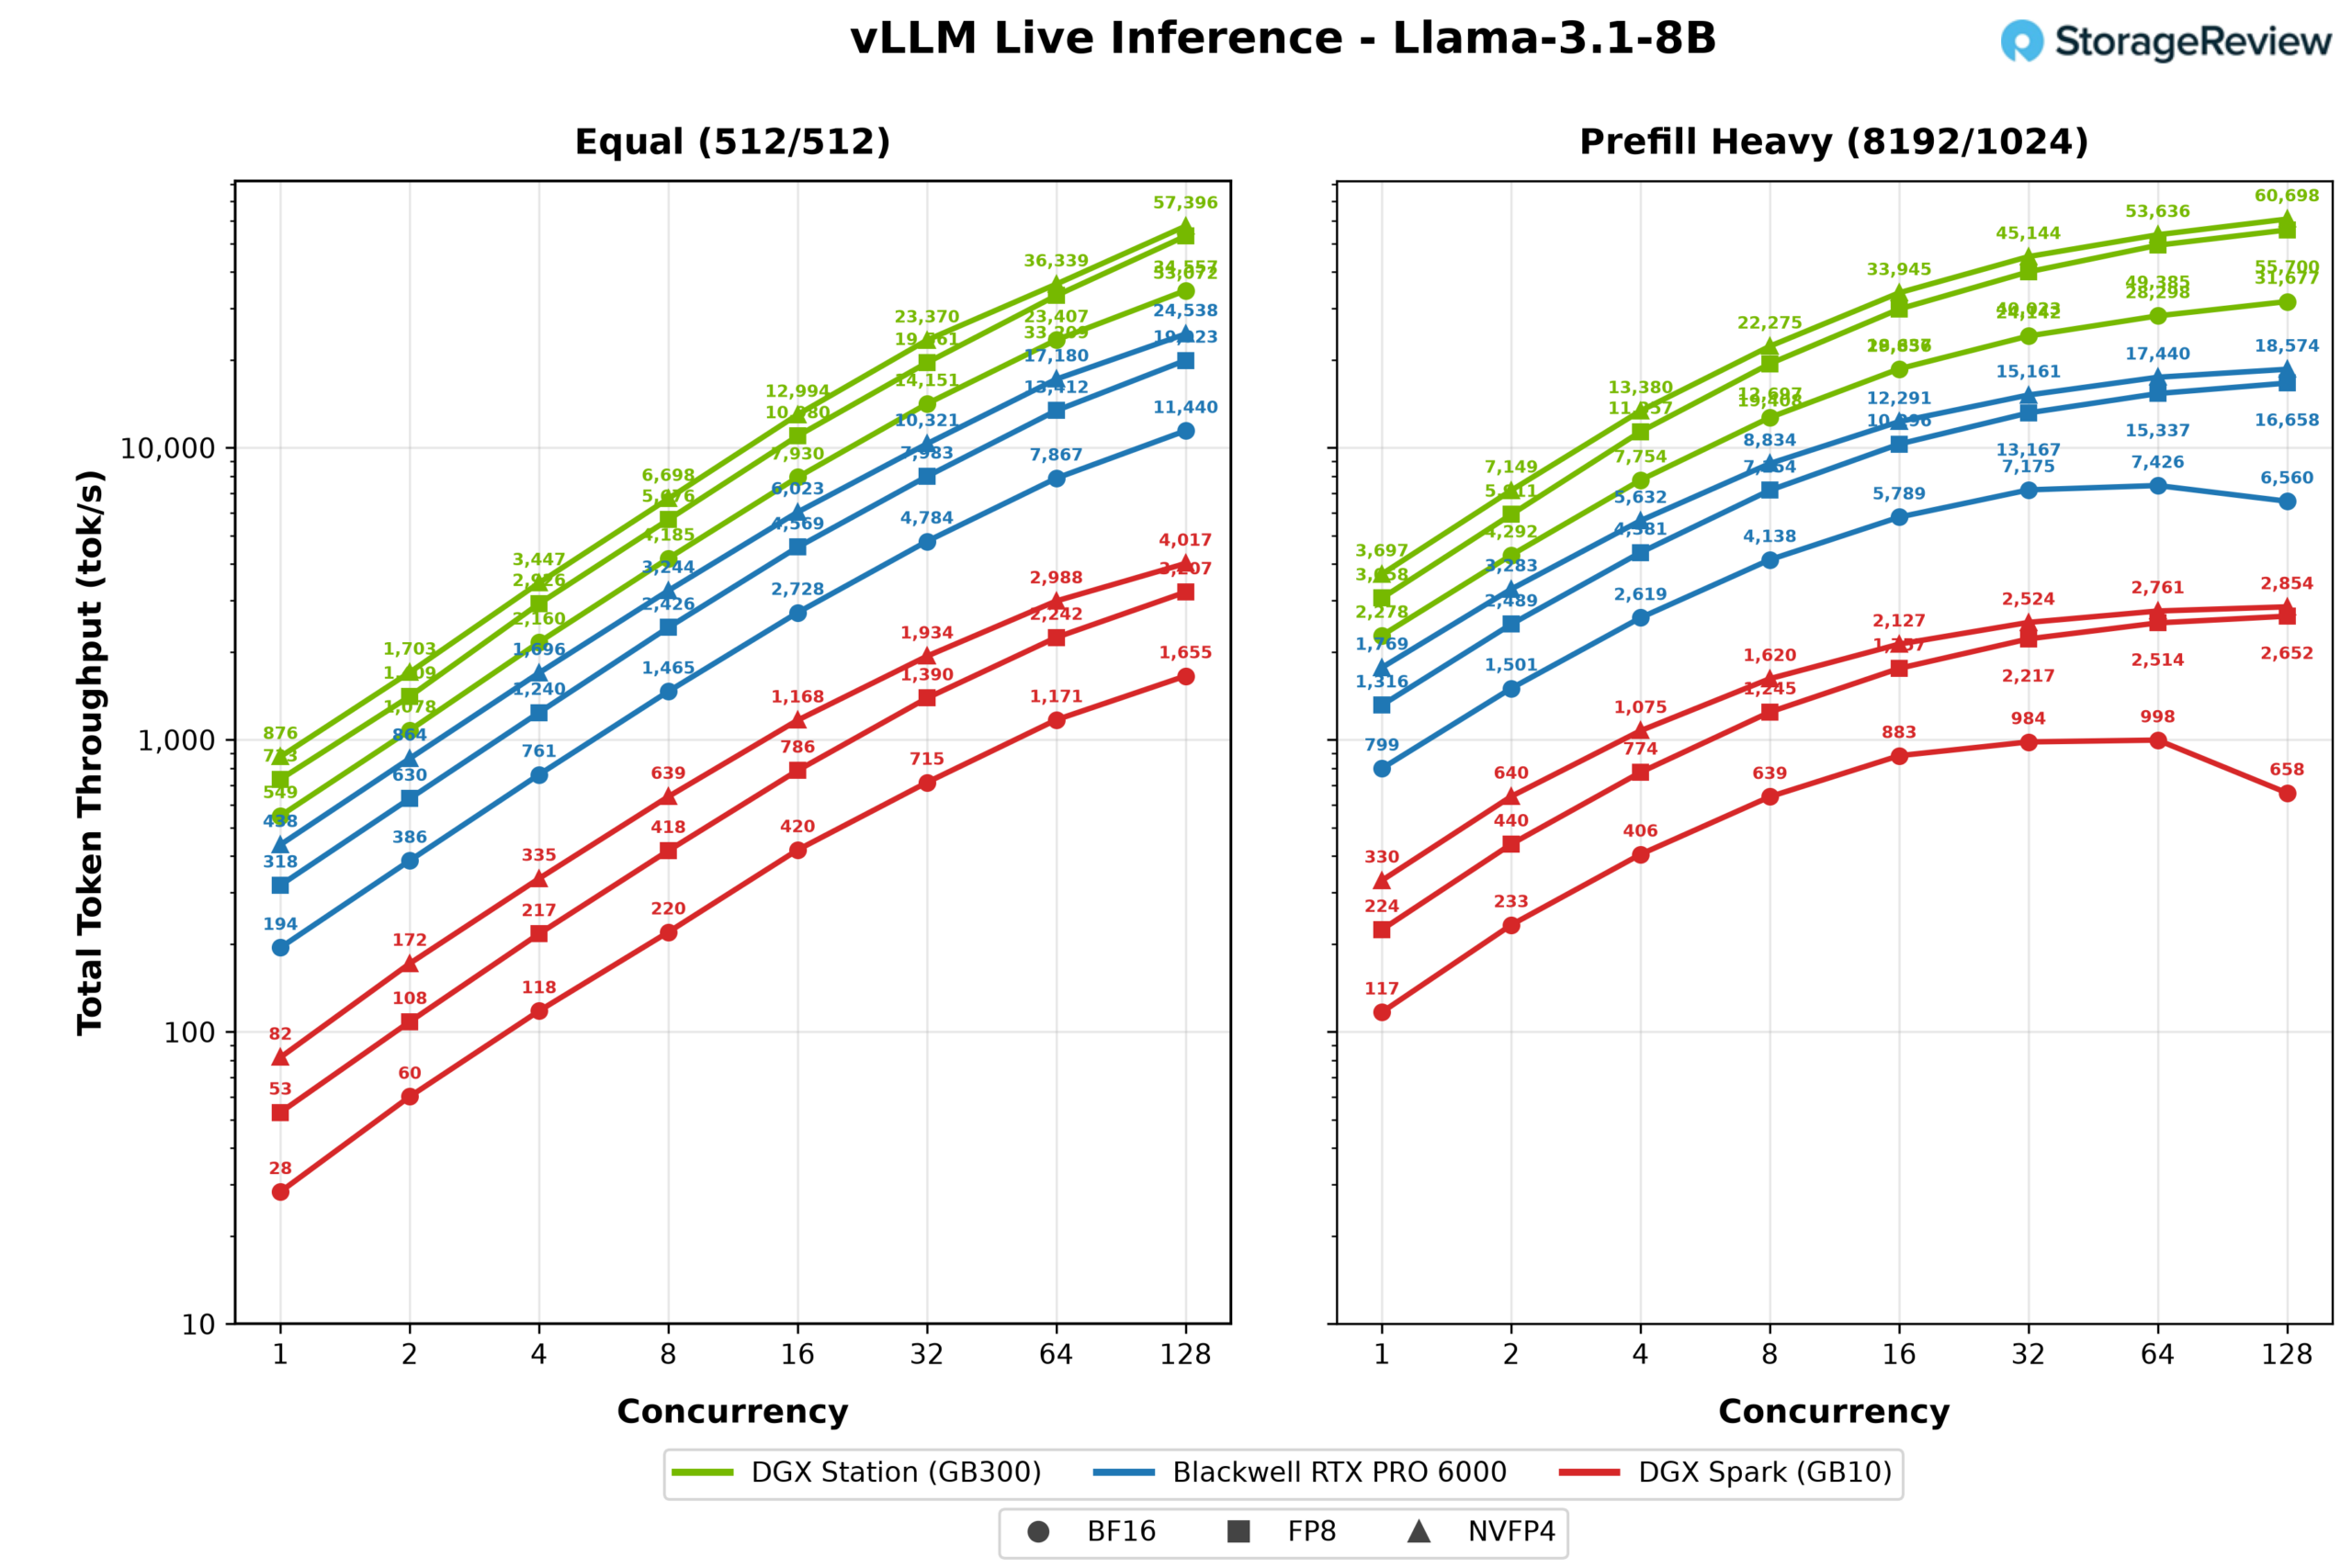
Llama 3.1 8B 的體積足夠小,我們可以在每台系統上分別以 BF16、FP8 和 NVFP4 三種精度運行它,從而最清晰地展現量化在每台機器上帶來的性能提升。在相同工作負載下,128 個同時流的測試結果顯示,WS300 的輸出令牌數從 BF16 的每秒 17,278 個提升至 NVFP4 的每秒 28,698 個,提升幅度達 66%。 RTX PRO 6000 的提升幅度為 114%,從 5,720 個提升至 12,269 個,而 DGX Spark 的提升幅度則高達 143%,從 828 個提升至 2,009 個。值得注意的是:機器越小,量化帶來的優勢就越明顯。
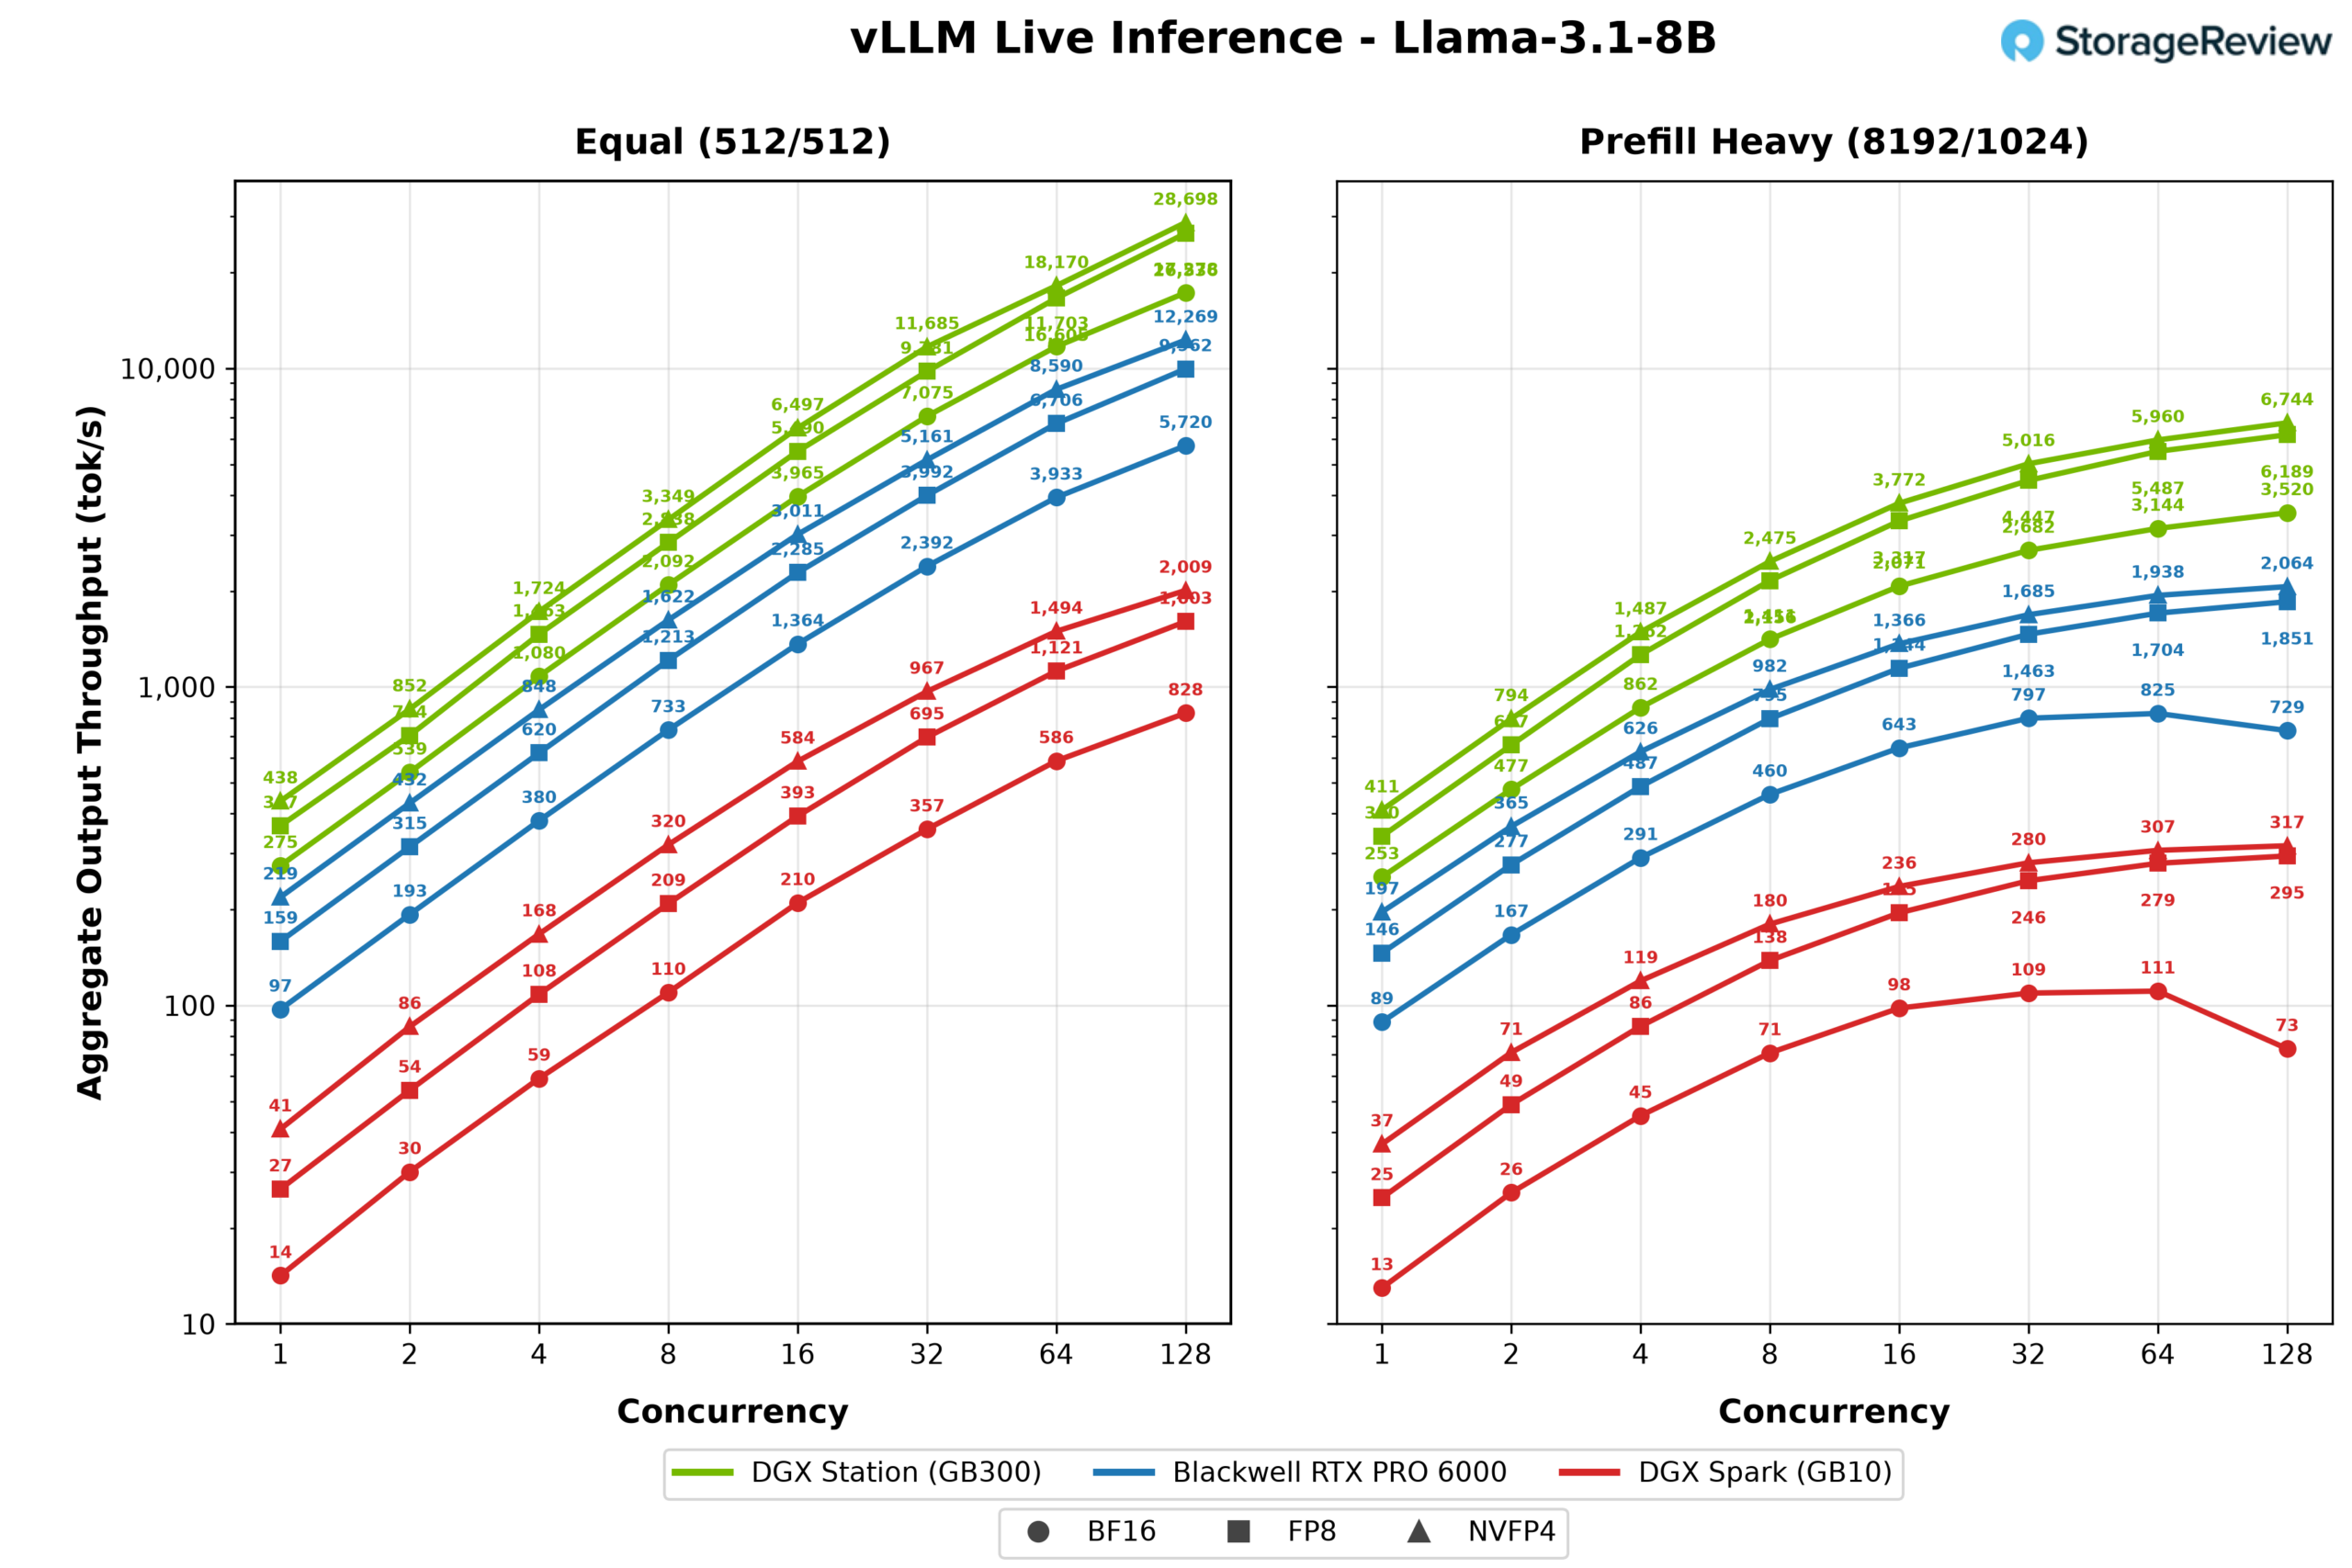
預先填充大量結果壓縮了整個字段,WS300 的 NVFP4 運行峰值達到每秒 6,744 個輸出令牌,而該卡為每秒 2,064 個,Spark 為每秒 317 個。
米斯特拉爾小型 24B
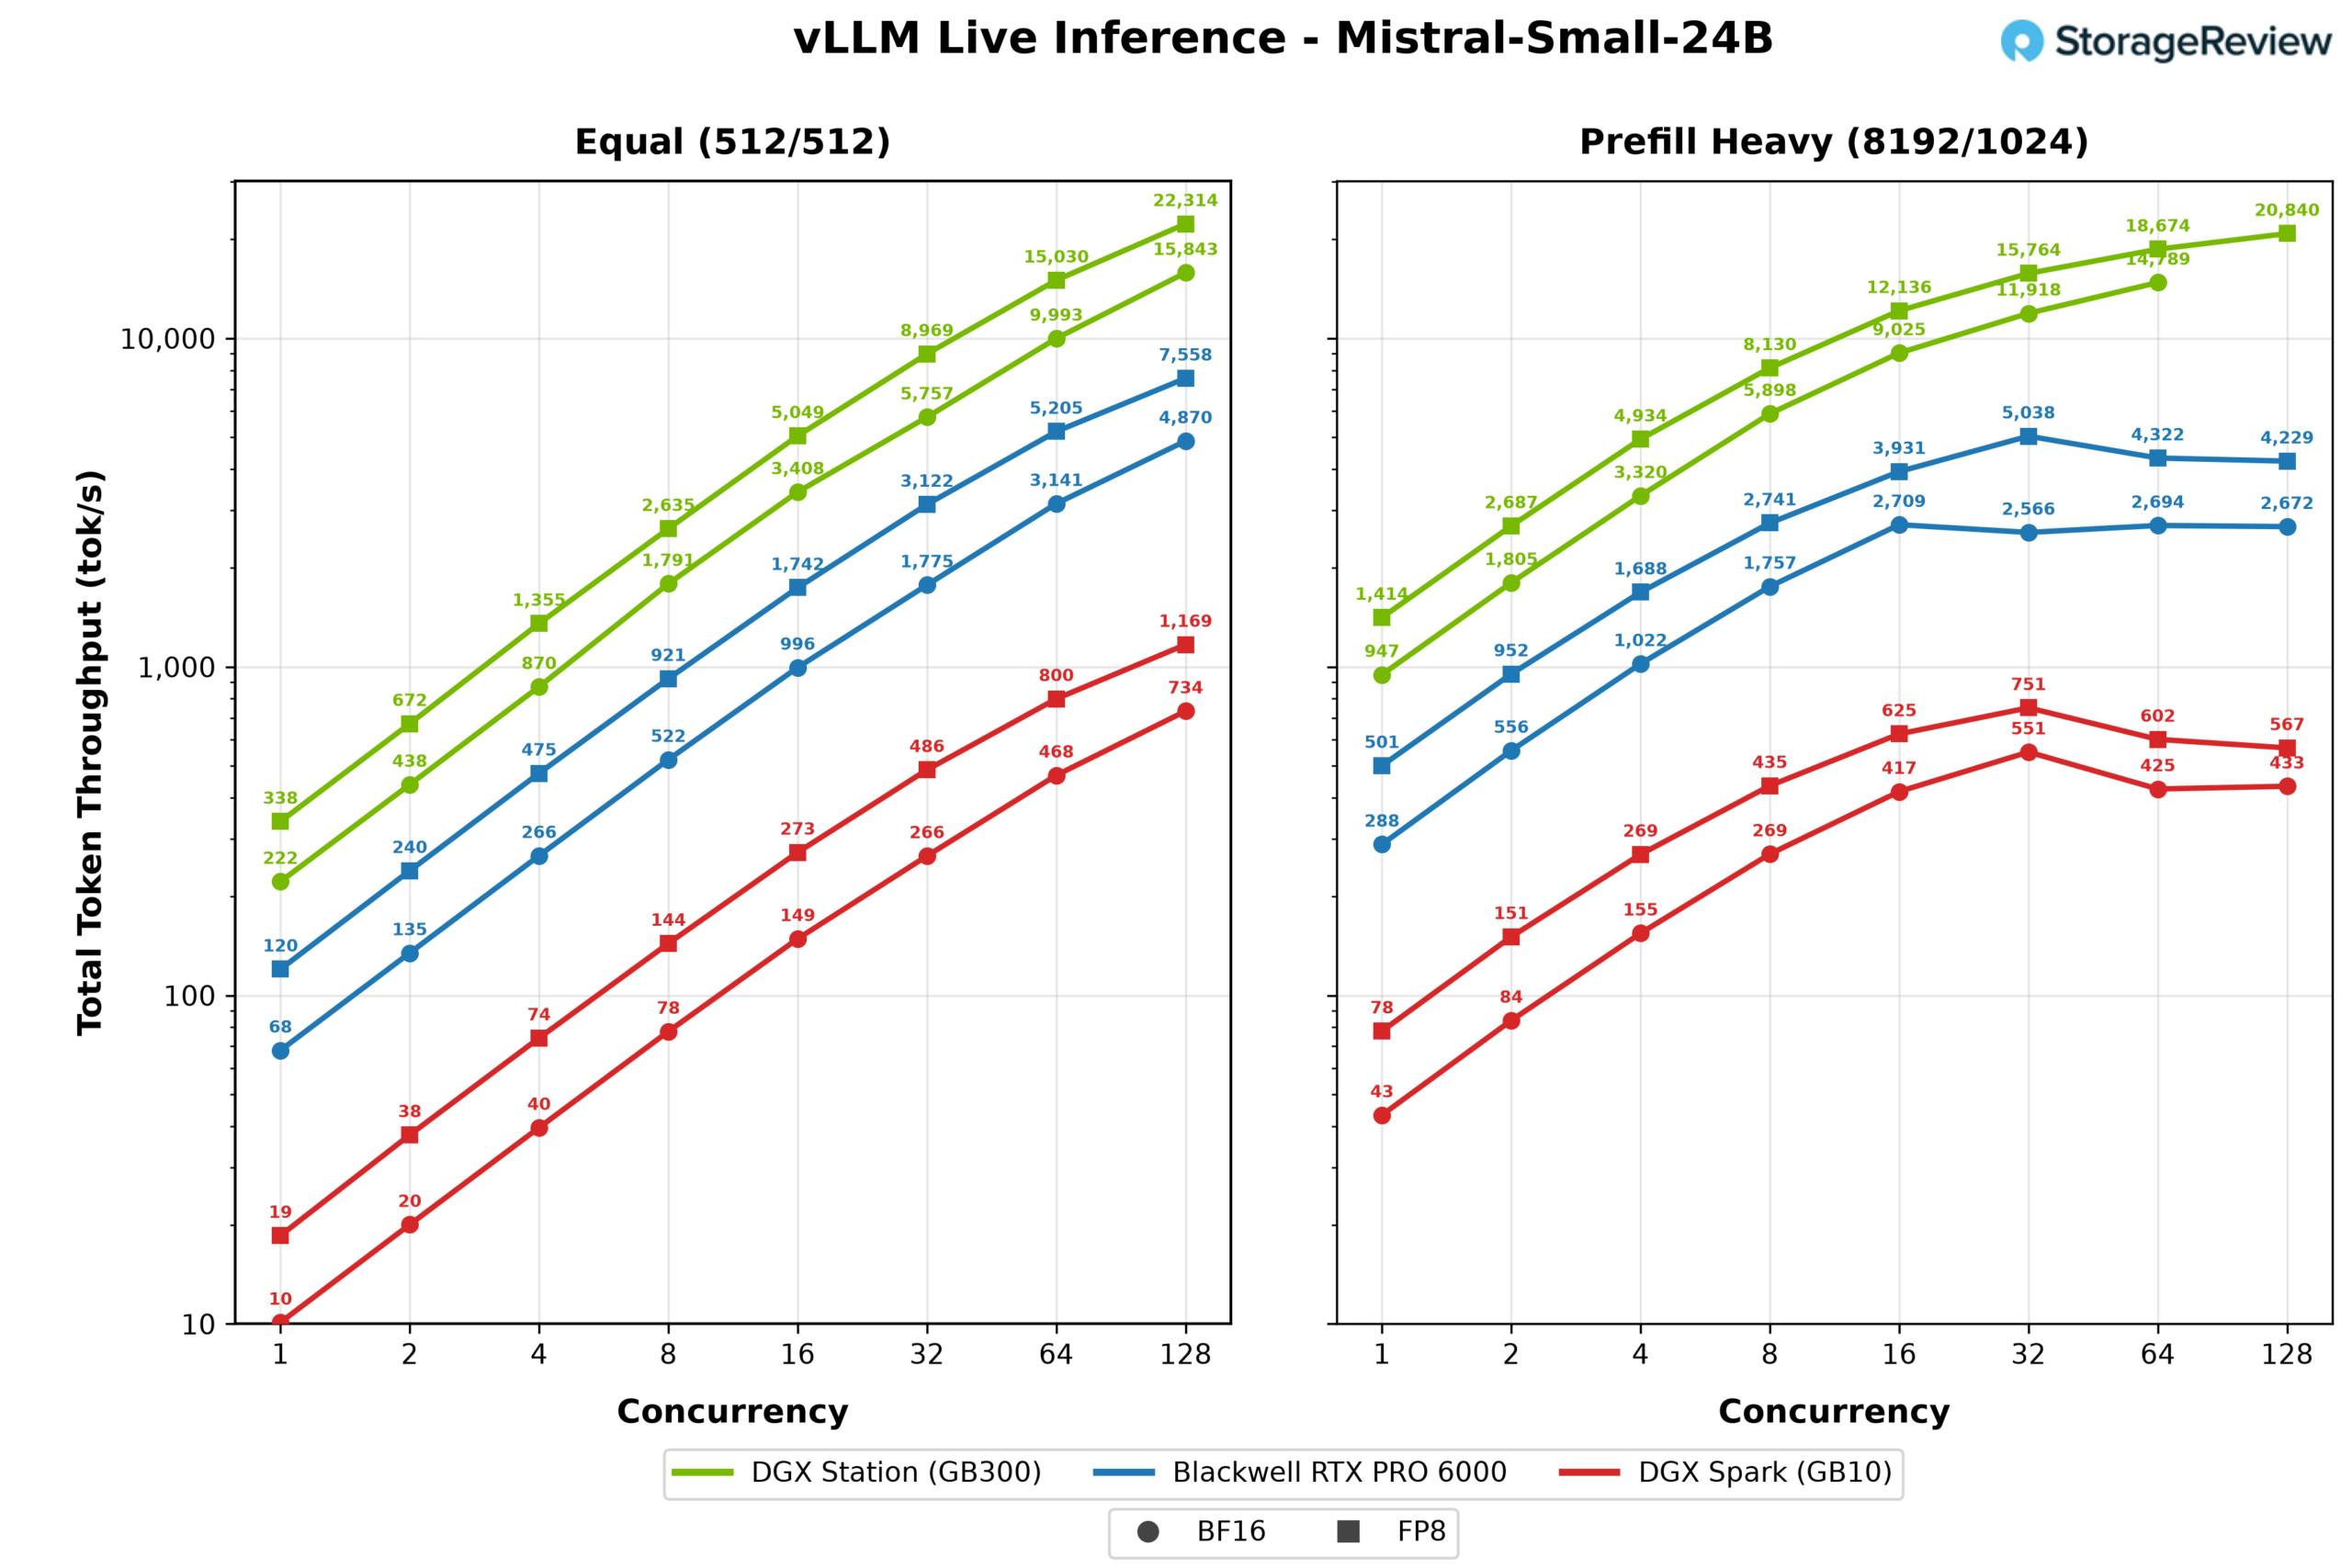
Mistral Small 24B 測試結果顯示,各測試平台之間的差距最大。在相同工作負載下,FP8 模式下,WS300 的峰值輸出令牌數為每秒 11,157 個,是 RTX PRO 6000(3,779 個)的三倍,是 DGX Spark(585 個)的 19 倍。在單流模式下,Station 的每秒令牌數為 169 個,比 Spark 的每秒令牌數(9 個)更接近互動式舒適度。
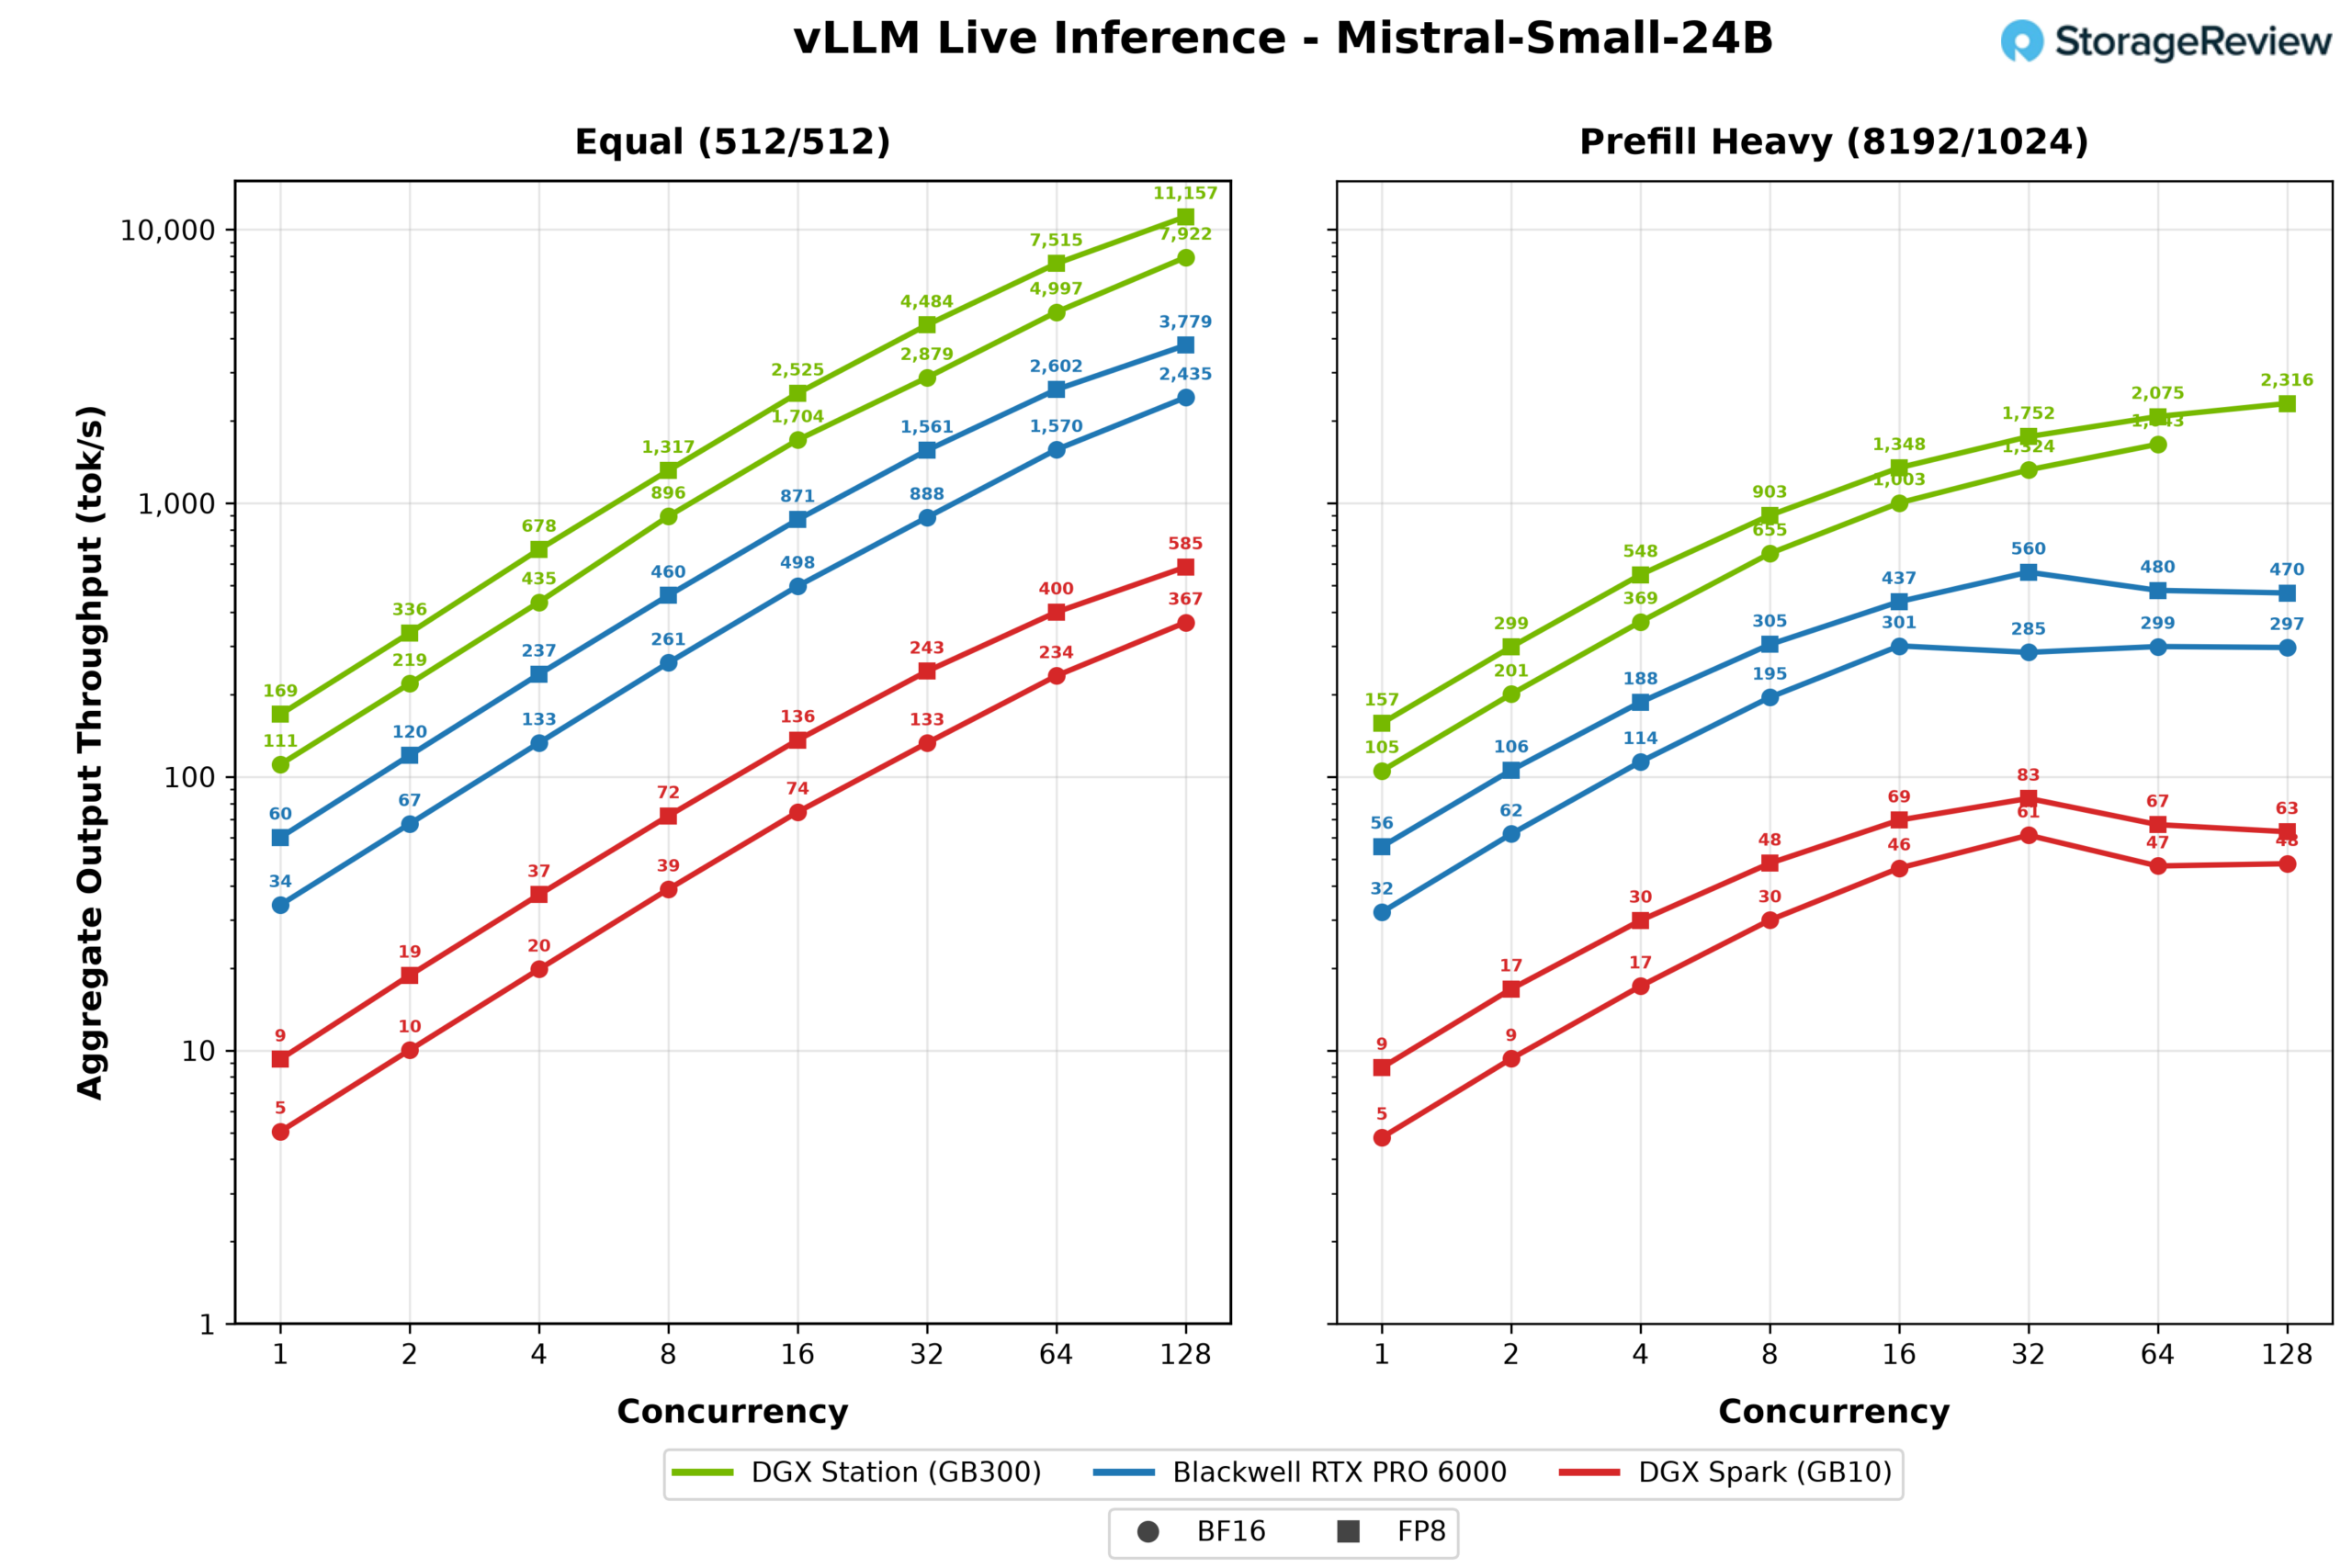
在預填充重負載下,RTX PRO 6000 的峰值僅為每秒 32 個同時流和 560 個輸出令牌,之後便開始下降,而 WS300 則繼續保持每秒 2,316 個並發流和 128 個輸出令牌。
Qwen3編碼器30B
Qwen3 Coder 30B 是一款混合專家模型,其活動參數數量較少。在這項測試中,小型系統縮小了單流效能差距。在相同工作負載下,RTX PRO 6000 在單並發請求中每秒輸出 208 個令牌,而 WS300 為 310 個,這是本次對比中與 Station 最接近的結果,即使是 Spark 也達到了可用的 55 個令牌。批次處理則恢復了通常的排名:在 128 個串流的情況下,Station 在 FP8 模式下每秒輸出 12,425 個令牌,是 RTX PRO 6000 的 2.4 倍,幾乎是 Spark 的 16 倍。
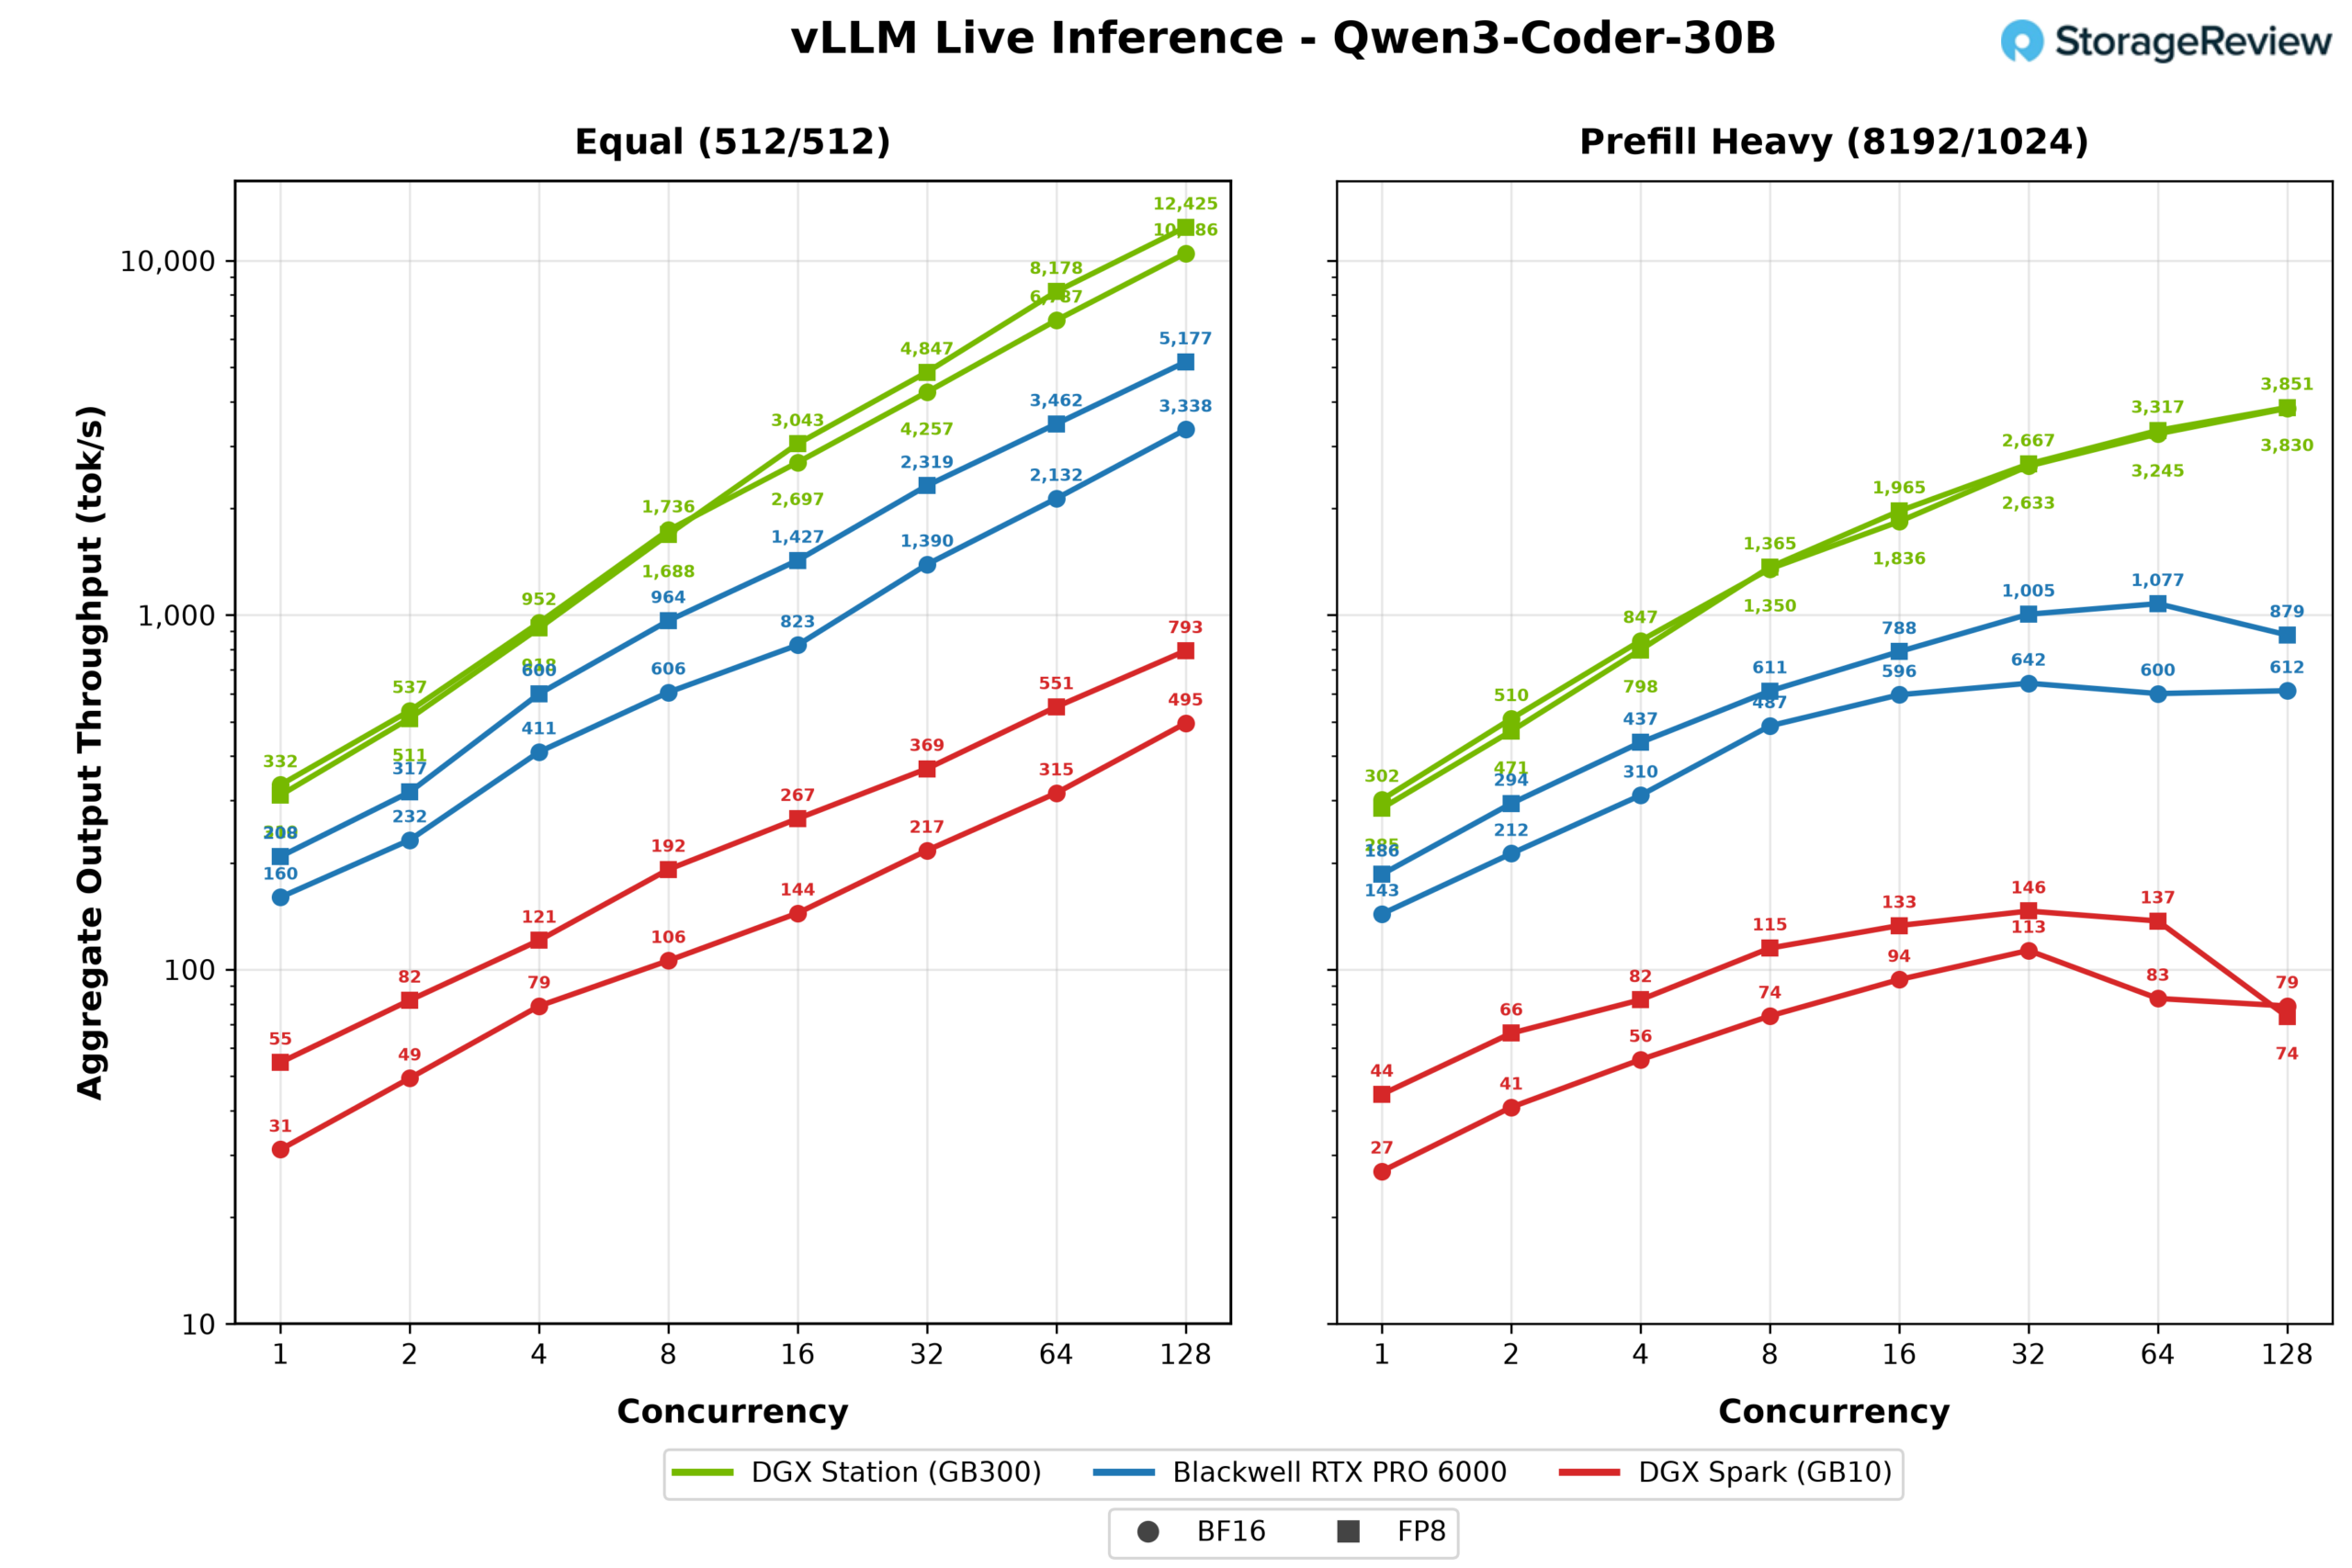
預先填充重型晶片的測試遵循既定模式,WS300 的輸出速度達到每秒 3,851 個代幣,而該卡的峰值為每秒 1,077 個代幣,Spark 的峰值為每秒 146 個代幣。
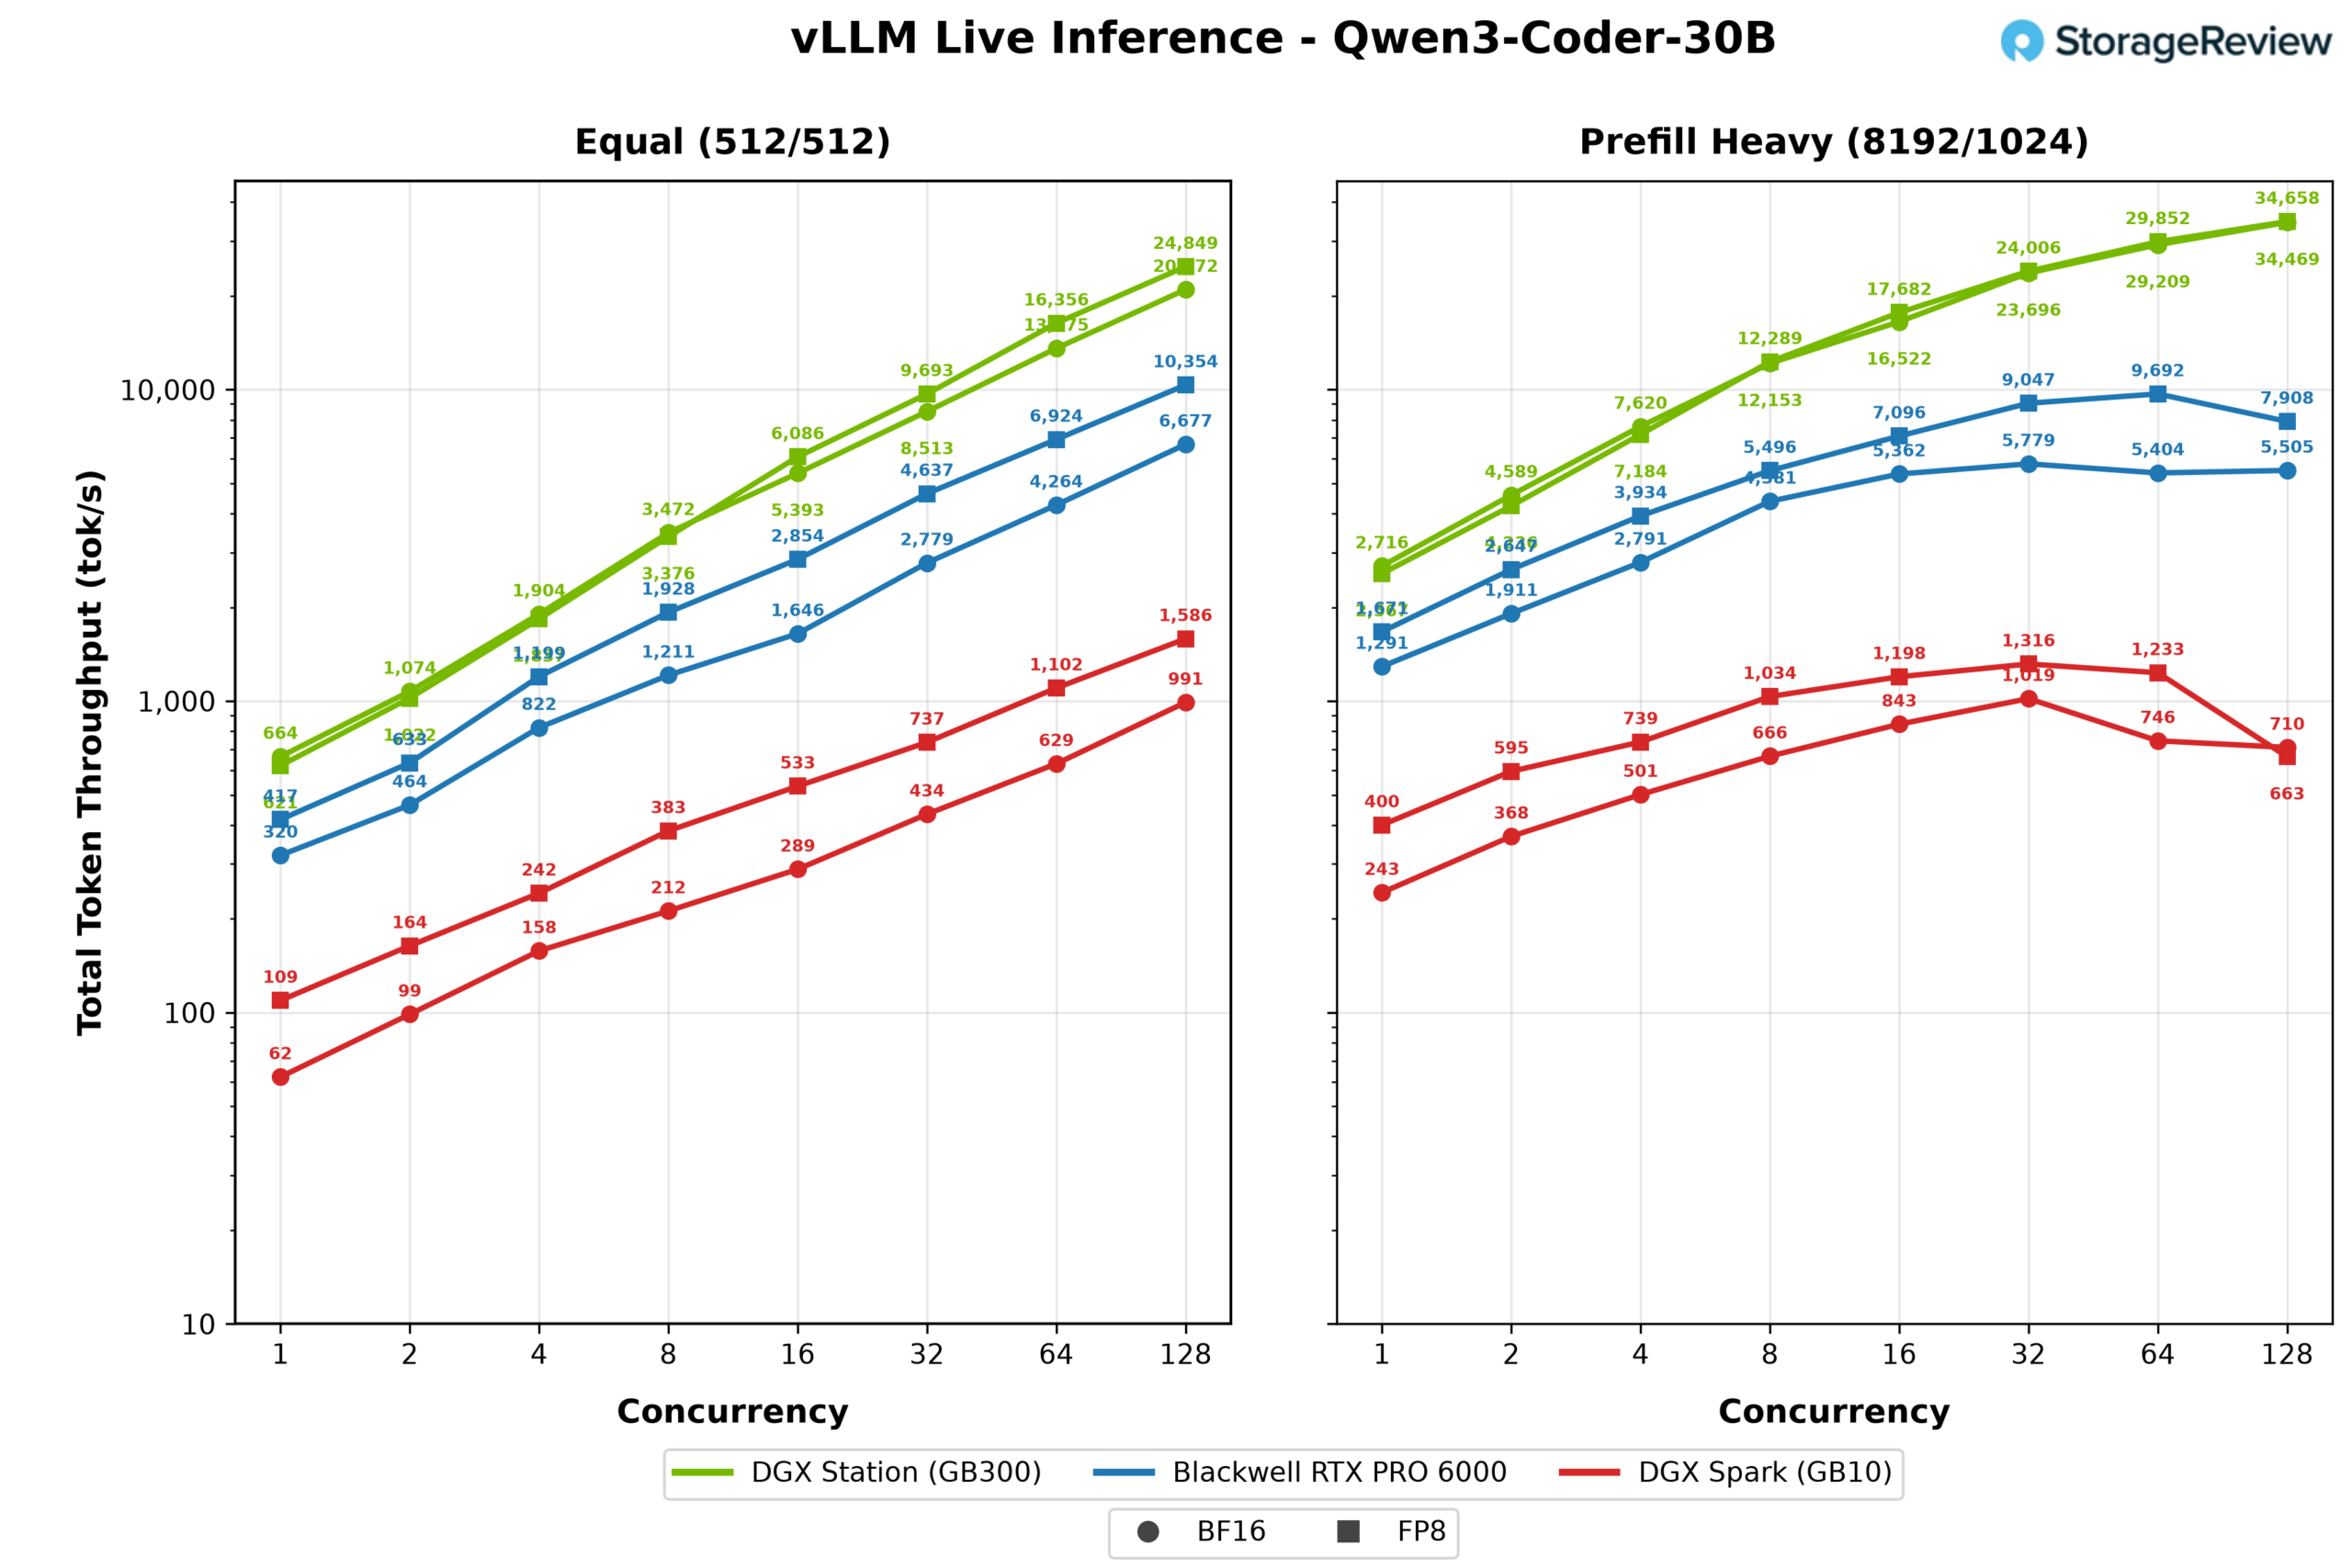
在五個共享模型中,WS300 的吞吐量是 Blackwell RTX PRO 6000 的 2.3 到 3 倍,是 DGX Spark 在滿並發時的 14 到 19 倍,當長時間的提示訊息使 KV 快取壓力增大時,其性能優勢甚至可達顯卡的 6 倍。這三台機器運行相同的 CUDA 堆疊和相同的量化路徑;工作站的優勢在於記憶體容量和頻寬,這體現在並發餘裕和長時間上下文容錯能力上。同樣重要的是,這些圖表無法顯示:上述各節中提到的所有前沿規模模型都無法在其他兩台系統上載入。
GDSIO
現代人工智慧工作負載依賴將資料批次、模型權重和檢查點從儲存設備快速移動到 GPU 內存,以確保加速器始終處於滿載運行狀態。 NVIDIA GPUDirect Storage 摒棄了傳統的雙重拷貝路徑,即資料首先從 SSD 讀取到系統內存,然後再複製到 GPU 內存。
GB300 DGX Station 的實作方式與傳統的 PCIe GPU 伺服器不同。我們測試中使用的 Micron 4600 固態硬碟連接到整合在 ConnectX-8 中的 PCIe 交換器。 ConnectX-8 上游連接到 Grace CPU,而 B300 GPU 則透過 NVLink-C2C 連接到 Grace。 SSD 和 GPU 並不位於同一個 PCIe 交換器下。儲存流量會先經過 ConnectX-8 交換機,進入 Grace PCIe 根複合體,穿過 Grace 一致性架構,再經由 NVLink-C2C 到達 B300 的 HBM3e 顯存。
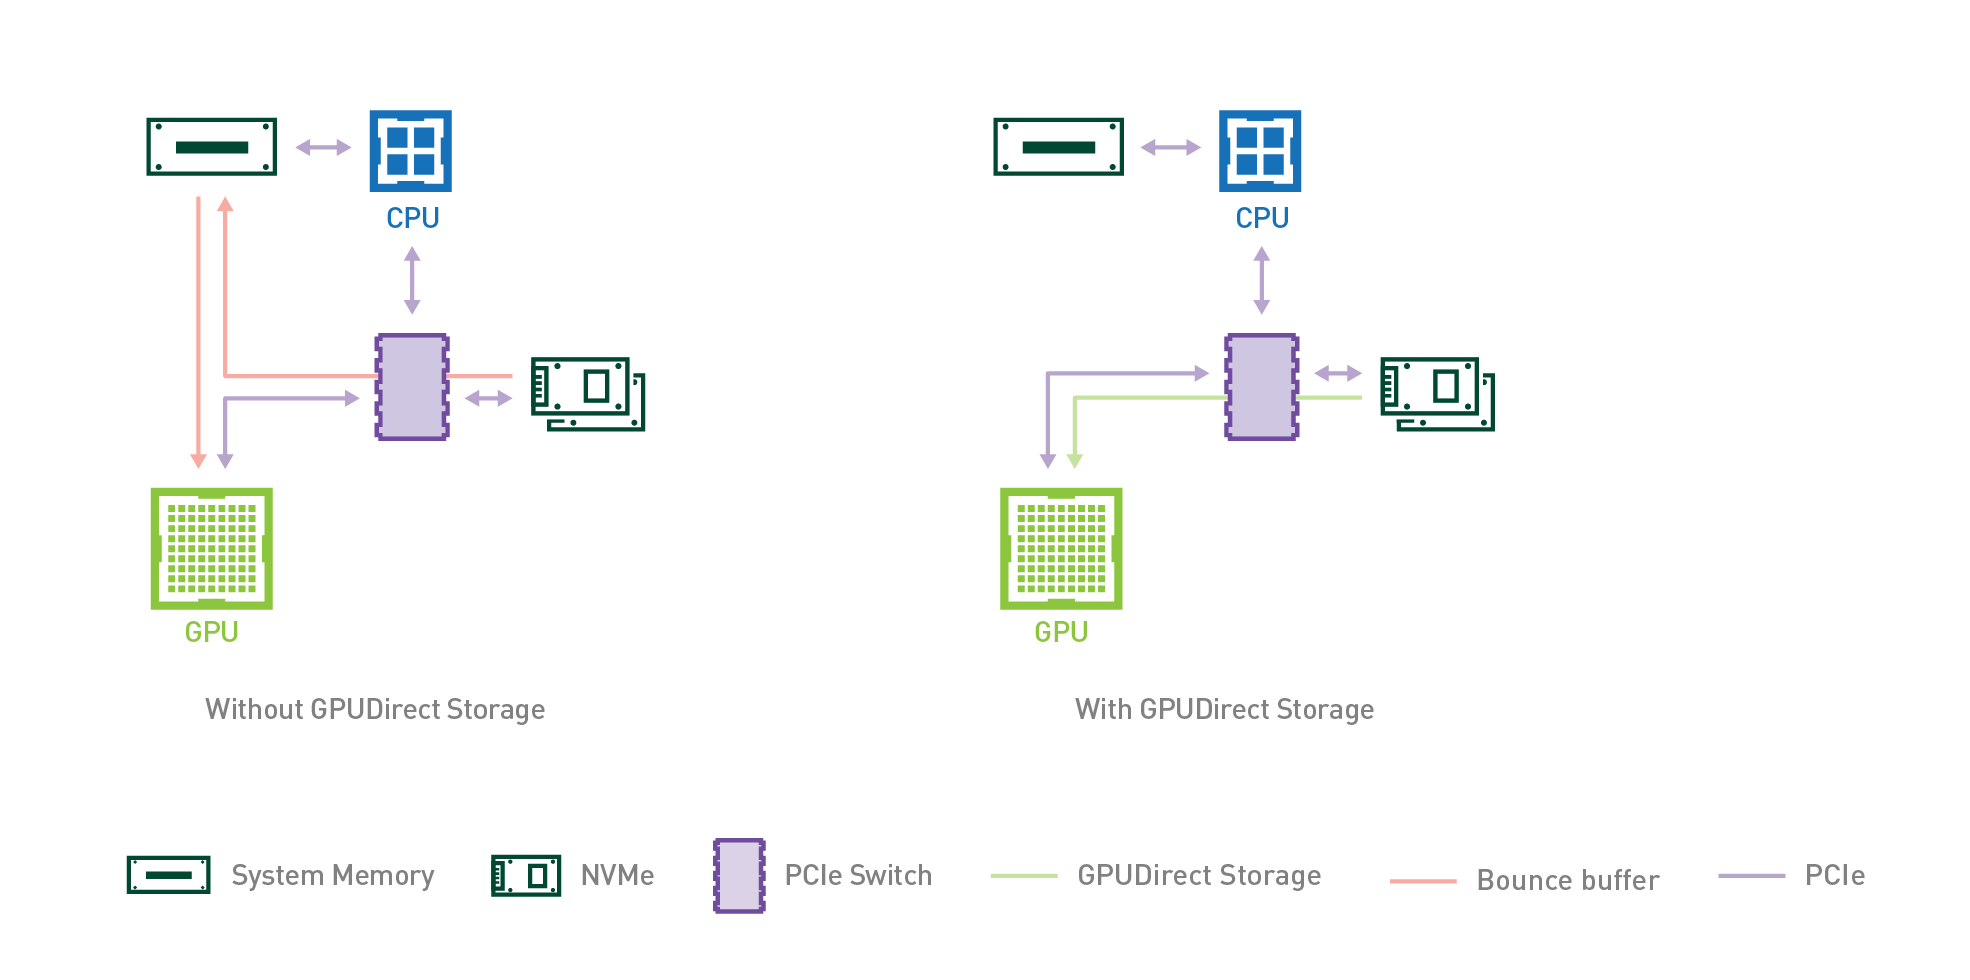
透過 GPUDirect Storage,cuFile 會將 B300 HBM3e 中分配的緩衝區註冊為儲存 I/O 的來源或目標。讀取操作時,Micron 4600 的控制器使用 DMA 將資料放入 HBM3e;寫入作業時,它會從 HBM3e 中檢索資料。這兩個操作都遵循上述 Grace 和 NVLink-C2C 路徑,而無需將有效負載暫存到 Grace 的 LPDDR5X 記憶體中。 Grace 仍然管理檔案系統和 NVMe 控制平面,包括命令提交和位址轉換,但它不會複製資料。因此,即使流量在 SSD 和 B300 記憶體之間傳輸時仍然會經過 Grace,GPUDirect Storage 也省去了系統記憶體暫存步驟。對於 AI 工作負載,順序讀取對應於資料集串流、模型載入和檢查點恢復,而順序寫入對應於檢查點保存和其他傳回儲存的操作。為了測試 GDSIO 效能,我們使用一個獨立的輔助 SSD 來測量儲存效能。
GDSIO 測試配置
- 啟動儲存:2 塊 Micron 4600 2TB 硬碟,組成 RAID1 陣列
- 輔助儲存:2 x Micron 4600 2TB
從 GDSIO 順序讀取效能來看,該單元在執行緒數和區塊大小方面均表現出穩定的擴展性。在 16K 區塊大小下,吞吐量從單執行緒時的 16MiB/s 提升至 16 執行緒時的 250MiB/s,並在 128 執行緒時達到 2.0GiB/s。更大的區塊大小提升速度更快,256K 區塊大小在 64 執行緒時達到 11.8GiB/s,並在 128 執行緒時達到峰值 12.9GiB/s。最佳效能出現在 512K 和 1M 區塊大小下,吞吐量最高可達 13.1GiB/s,其中 1M 區塊大小的工作負載僅需 32 個執行緒即可達到該水平,並在 128 個執行緒時仍能保持該水準。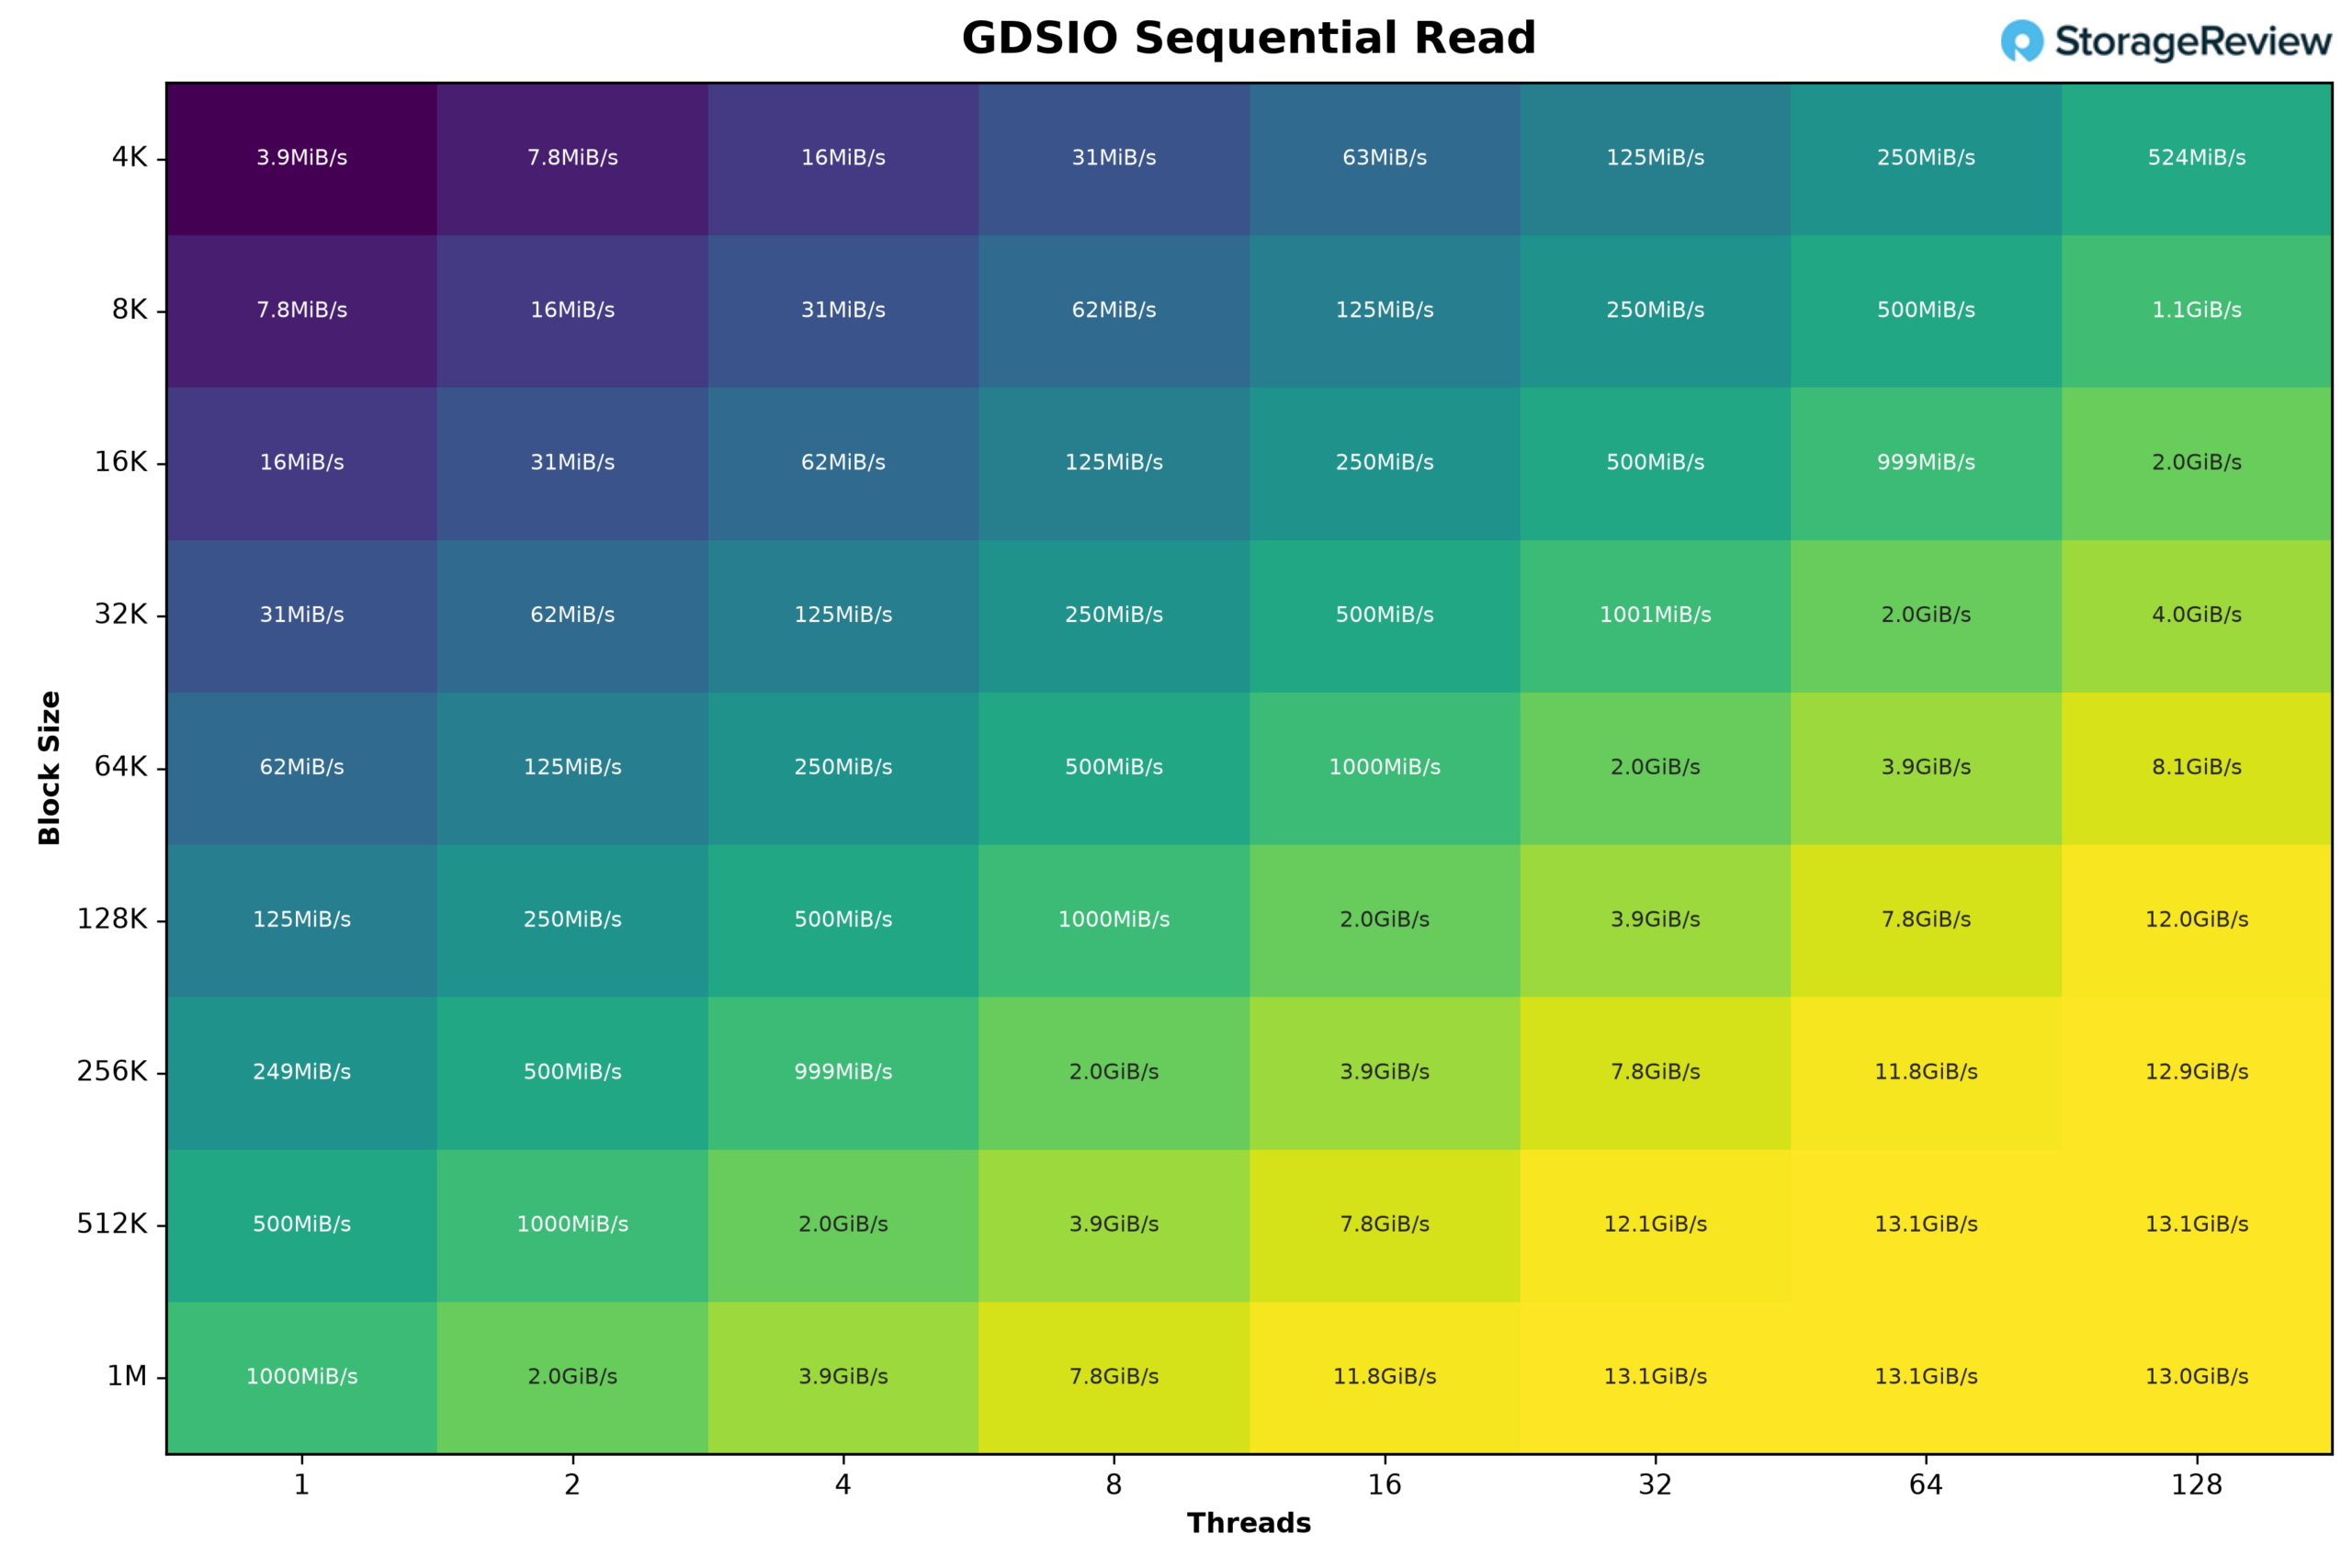
在 GDSIO 順序寫入效能方面,該單元在執行緒數和區塊大小方面均表現出穩定的擴展性。在 16K 區塊大小下,吞吐量從單執行緒時的 16MiB/s 提升至 16 執行緒時的 250MiB/s,並在 128 執行緒時達到 2.0GiB/s。更大的區塊大小提升速度更快,256K 區塊大小在 32 執行緒時達到 7.5GiB/s,在 64 執行緒時達到 12.0GiB/s。 1M 區塊大小的工作負載表現最為出色,僅需 16 個執行緒即可達到 12.0GiB/s 的峰值,並在 128 個執行緒時仍能保持該效能。 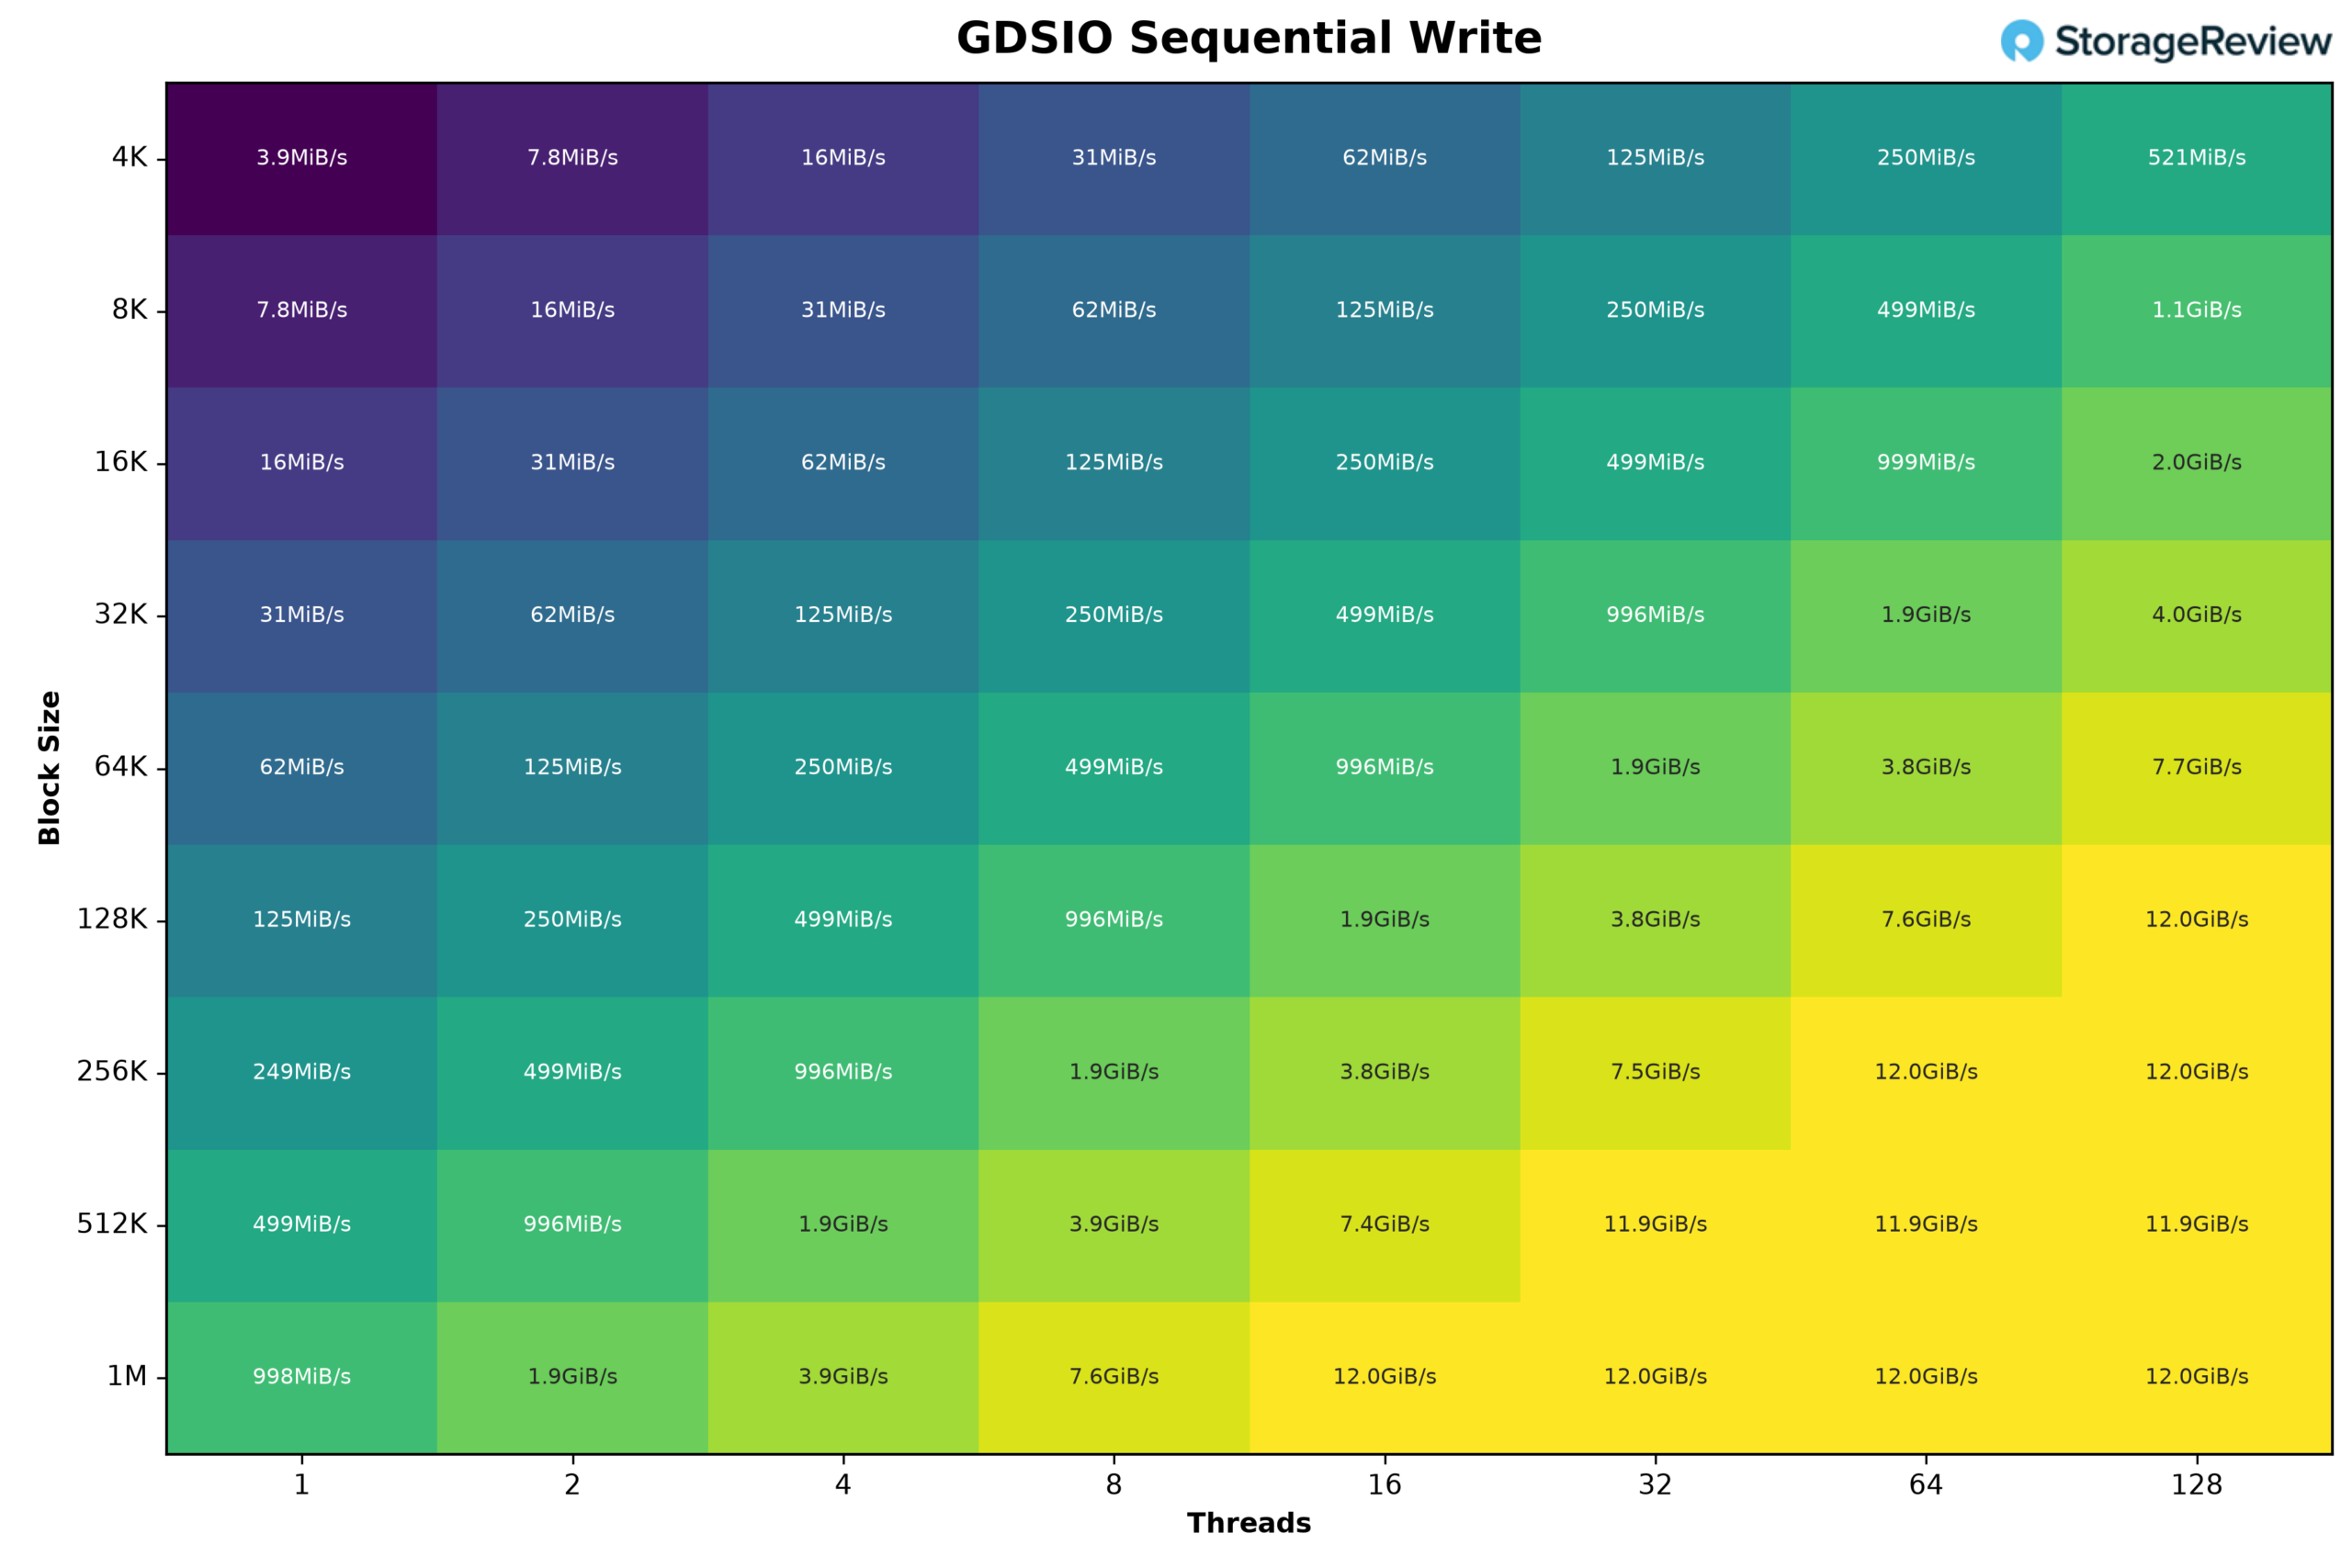
MSI XpertStation WS300 的目標使用者是誰?
WS300 適用於需要直接存取 Blackwell Ultra 但不希望每次實驗都從叢集預訂或雲端請求開始的組織。人工智慧實驗室、推理引擎開發人員、框架和編譯器團隊、機器人團隊以及企業人工智慧團隊都可以將其用作上述工作流程的本地開發節點。 MIG 允許開發人員針對多 GPU 設定進行測試和開發,而 BMC 則使系統能夠進行遠端管理。
對於需要即插即用系統的經驗豐富的AI開發者來說,這套系統也極具吸引力。其價值不僅在於B300主機本身,更在於圍繞它構建的完整平台:252GB HBM3e顯存、Grace協議、496GB LPDDR5X內存、ConnectX-8接口、鏡像啟動存儲、液冷散熱、遠程管理以及MSI官方支持,所有這些都集成在一個機箱內。實際的限制在於Arm架構的主機、需要專用的20A電路,以及安裝大型RTX PRO顯示卡時需要共享1,600W的電源預算。
充分發揮 WS300 的效能也取決於其配套軟體。 NVIDIA 提供了一系列豐富的操作手冊和部署指南,旨在協助團隊快速上線系統並充分利用其資源。我們將在後續報道中探討其中的幾款工具,包括 Brev。 Brev 可以簡化工作站的共享訪問,提高資源利用率,避免如此昂貴的資源閒置。
至於價格,微星尚未公佈,而且這類機器通常都沒有標價;這需要與銷售團隊進行深入洽談,而不是簡單地點擊“加入購物車”按鈕就能確定。真正值得比較的不是與其他工作站,而是人工智慧團隊目前已經投入的成本:預留的叢集時間、雲端GPU的使用承諾,以及等待共享硬體的進度成本。
結語
MSI XpertStation WS300 是我們評測過的功能最強大的工作站,它是一款罕見的能夠徹底改變單一從業者工作方式的產品。通常需要叢集預留空間才能運行的前沿級檢查點、433GB 的 GLM-5.2 以及擁有 550 億個參數的 Nemotron-3-Ultra,現在只需一台放在辦公桌旁的伺服器即可加載和運行,私密且隨時可用。這正是我們對這套系統如此興奮的原因。
DGX Station 的目標用戶是開發者:包括面向 Blackwell Ultra 的核心開發者、推理引擎和框架團隊、運行完整 Isaac 循環的機器人團隊,以及那些因共享硬體而苦惱於實驗安排的用戶。除了這些特定群體之外,購買這些系統的理由相當有限。 Arm 主機將無法使用某些工具鏈;在 120V 電路中,20A 電路是安裝的必要條件;沒有獨立顯示卡就沒有顯示輸出;而且 RTX PRO 6000 工作站的價格要低得多,足以滿足單用戶處理 96GB 內存容量範圍內的模型的需求。
經濟因素也決定了合適的部署規模。一台 WS300 很容易就能在預留的集群時間內得到合理利用,每團隊配備兩台也同樣合理。但進一步堆疊到一定規模後就不再划算了:例如,當一個組織需要購買四台 GB300 塔式伺服器時,同樣的預算完全可以購買一台八路 B300 伺服器,它擁有更大的 GPU 記憶體、更密集的 MIG 分割區以及 GPU 之間的 NVLink 連線。最佳方案是在辦公桌上放置一台,實驗室裡放置兩台,作為資料中心投資的補充。
NVIDIA 提供底板,因此 OEM 廠商之間的差異主要體現在實作方式上,而 MSI 在這方面做得非常出色。 1,400W 的水冷循環系統為 B300 晶片、Grace 散熱器、SOCAMM 記憶體和 ConnectX-8 連接線提供散熱,整個平台在整個測試過程中保持穩定。更深入的評測現已發布:我們的WS300 散熱深度分析報告結合了 MSI 的冷板和散熱器數據,以及長達 2.8 小時的儀器運行測試結果,顯示晶片在滿載情況下溫度保持在 60℃,頻率穩定在 2.07GHz。 1,600W 的功率預算會自動分配到各個組件,當我們測試硬體電源煞車時,即使連接出現故障,它也會降低頻率而不是直接關機。預先安裝的 12V HPWR 電源線和防下垂支架為 RTX PRO 擴充提供了支援。我們測試了首批到貨的 GB300 DGX Station,可以說 XpertStation WS300 為該平台樹立了很高的標準。
XpertStation WS300 現在在我們「最佳本地 AI 桌上型電腦」排行榜上佔據了最佳 GB300 系統位置,並且在我們的「用於智慧 AI 的 RAM、GPU 和儲存」指南中,它也是記憶體討論的核心。


 Amazon