

AMD, Spectro Cloud und Supermicro haben AMD Instinct Coder angekündigt, eine validierte Enterprise-Inferenzplattform für KI-Codierungs-Workloads. Die Lösung kombiniert AMD Instinct GPU-Beschleuniger, die KI-Infrastruktur von Supermicro und das PaletteAI Inference Launchpad von Spectro Cloud und bietet so eine Komplettlösung für die Bereitstellung privater und hybrider KI-Inferenzumgebungen.
Die Architektur ist für Unternehmen, Cloud-Anbieter und unabhängige KI-Betreiber konzipiert, die lokale Verarbeitung, Zugriff auf innovative Modelle, operative Steuerung und Token-Verbrauch in Einklang bringen müssen. Anstatt alle Anfragen des Codierungsagenten an externe, große Sprachmodelle zu senden, verwendet AMD Instinct Coder richtlinienbasiertes Routing, um zu bestimmen, ob eine Anfrage von einem lokal bereitgestellten Modell bearbeitet oder an einen externen Endpunkt für innovative Modelle weitergeleitet wird.
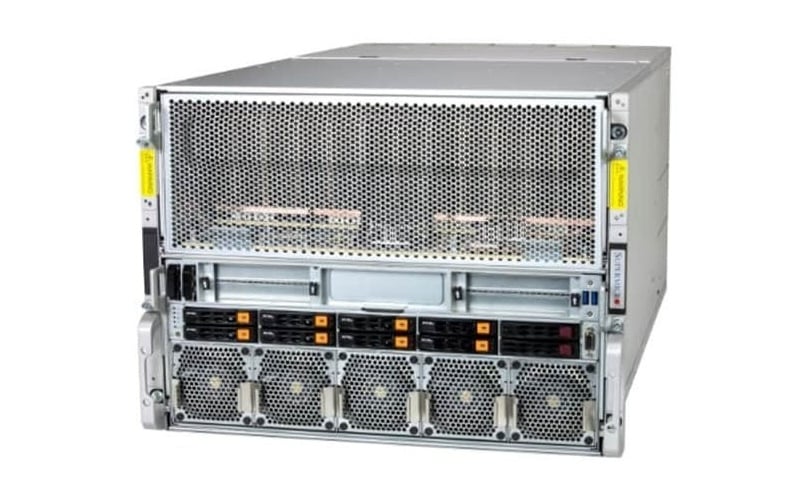
Dieser Ansatz zielt auf Arbeitslasten ab, bei denen Routineaufgaben wie Codierung, Codegenerierung, Zusammenfassung und ähnliches lokal erledigt werden können, während komplexere Schlussfolgerungen oder spezialisierte Funktionen über externe Modelle verfügbar bleiben. Die Plattform soll die Abhängigkeit von einem einzelnen Modellanbieter reduzieren und gleichzeitig sensiblen Code, Eingabeaufforderungen und Kontextdaten – wo angebracht – in einer kontrollierten Infrastruktur speichern. Die Partner behaupten, die Vereinbarung könne die Kosten für KI-Codierungstoken um bis zu 70 % senken. AMD selbst nennt denselben Wert für die Gesamtbetriebskosten und spricht von einer Amortisationszeit von nur sechs Monaten. Beide Angaben wurden bisher nicht unabhängig überprüft.
Die Ankündigung erfolgt zu einem Zeitpunkt, an dem Unternehmen KI-Codierungstools in ihren Entwicklungsteams und automatisierten Workflows skalieren. Gartner prognostiziert in seinem Bericht vom 24. Juni 2026 mit dem Titel „ Gartner sagt voraus, dass die Kosten für KI-Codierung bis 2028 das durchschnittliche Entwicklergehalt übersteigen werden, da der Token-Konsum rasant zunimmt“ , dass die Token-Kosten ohne ein strukturiertes Betriebsmodell die Produktivitätssteigerungen übertreffen könnten. AMD Instinct Coder begegnet dieser Problematik durch Modellrouting, Messung, Kontingente und Workload-Richtlinien.
Die anfängliche Konfiguration wird voraussichtlich AMD Instinct MI325X GPUs nutzen. Jeder MI325X-Beschleuniger verfügt über 256 GB HBM3E-Speicher und eine maximale Speicherbandbreite von bis zu 6 TB/s und ist auf speicherintensive generative KI-Inferenz-Workloads ausgelegt. AMD positioniert die Plattform um sein Instinct-Beschleunigerportfolio und das ROCm-Software-Ökosystem herum, um lokale Inferenz zu unterstützen, ohne dass Unternehmen den gesamten Hardware- und Software-Stack unabhängig zusammenstellen und validieren müssen. Die lokale Inferenz nutzt ein GLM-5.2-Modell, das durch AMD Inference Microservices optimiert wird. Die Plattform stellt Token-Kontingente, Audit-Trails und Kostentransparenz über Grafana- und Prometheus-Dashboards bereit.
Spezifikationen
| Normen | AMD Instinct Coder Referenzkonfiguration |
|---|---|
| Hardware | |
| Server | Supermicro AS-8126GS-TNMR |
| CPUs | 2 x AMD EPYC 9575F, 64 Kerne, 3.3 GHz |
| GPUs | 8 x AMD Instinct MI325X |
| Memory | 3 TB (24 x 128 GB) DDR5 RDIMM 6400 ECC |
| Boot-Speicher | 2 x 960 GB NVMe PCIe Gen4 V6 M.2 |
| Datenspeicher | 8 x 7.68 TB PCIe Gen5 TLC U.2 SSD |
| Netzwerken | 2 x AMD Pensando Pollara 400 HHHL PCIe NIC, 400GbE |
| Tuning | 6 x 5250W redundante (3+3 Konfiguration) hocheffiziente Netzteile der Titan-Klasse |
| Software | |
| Plattform | Spectro Cloud PaletteAI Inference Launchpad |
| Kompetenzen | Full-Stack-KI-Lebenszyklusmanagement Unternehmensführung im großen Maßstab Intelligente lokale Modellroutenplanung, Frontier-Routenplanung, wenn gerechtfertigt Vollständige Transparenz und Kontrolle über KI-Nutzung und -Kosten |
| KI-Modelle | |
| Local | AMD Inferenz-Microservices-Modell GLM-5.2 |
| Grenze (wenn gerechtfertigt) | Anthropischer Claude OpenAI GPT Google Gemini |
| Entwicklertools | |
| Unterstützte IDEs / Tools | Claude Code Cursor Visual Studio Code |
| Unterstützung | |
| Software | Umfassender Full-Stack-Software-Support von Spectro Cloud |
| Hardware | 3 Jahre Vor-Ort-Service am nächsten Werktag durch Supermicro |
| Skalieren | |
| Kapazität | Bis zu 50 Entwickler pro Knoten, 30 gleichzeitig |
Supermicro stellt die zugrundeliegende KI-Infrastruktur für Unternehmen bereit. Zu den unterstützten Systemen gehören luft- und flüssigkeitsgekühlte Acht-GPU-Plattformen, die mit AMD Instinct MI325X- und MI350-Beschleunigern kompatibel sind . Supermicros Beitrag umfasst Vorvalidierung, Rack-Integration und Systemqualifizierung, um die Implementierungskomplexität zu reduzieren und den Übergang von der bereitgestellten Infrastruktur zum produktiven Einsatz zu beschleunigen.
Spectro Cloud PaletteAI Inference Launchpad stellt die operative Softwareebene bereit. Die Plattform unterstützt das Routing zwischen lokalen und externen Modellen, die Durchsetzung workloadspezifischer Richtlinien, die Token-Abrechnung, Verbrauchskontingente und die Trennung von Teams und Benutzern in mehrere Mandanten. Die Software ist so konzipiert, dass sie die lokale Ausführung geeigneter Workloads aufrechterhält und gleichzeitig eine Fallback-Verbindung zu extern gehosteten externen Modellen ermöglicht.
Die resultierende Architektur nutzt gestaffelte Inferenz und weist Modellendpunkte basierend auf erforderlicher Leistung, Sensitivität, Modellfähigkeiten, Kostenzielen und verfügbarer Infrastrukturkapazität zu. Für Plattformteams ermöglicht dies die Standardisierung der Bereitstellung und Steuerung von KI-Codierungsanforderungen für interne Benutzer und Anwendungen. Dan McNamara, Senior Vice President und General Manager für Compute und Enterprise AI bei AMD, beschrieb den Wandel als die Entwicklung der KI-Codierung von einem individuellen Entwicklerwerkzeug hin zu einer unternehmensweiten Plattformentscheidung. BMC gehört zu den ersten Anwendern. Tom Davies, Vice President für SaaS Operations, beschreibt AMD Instinct Coder als kosteneffiziente, leistungsstarke Inferenzschicht für die Helix Agentic Engineering-Arbeit des Unternehmens.
Die erste AMD Instinct Coder-Konfiguration wird voraussichtlich auf Supermicro-Systemen mit AMD Instinct MI325X-GPUs ausgeliefert. Die Partner demonstrieren die Plattform diese Woche auf der Ai4 in Las Vegas. Die endgültigen Produktkonfigurationen, die Verfügbarkeit, der regionale Support und die Preise unterliegen noch der Validierung und Genehmigung durch die Partner. Die oben genannten Spezifikationen beschreiben daher die Referenzkonfiguration und nicht eine ausgelieferte Produktvariante mit veröffentlichtem Preis. Interessierte Organisationen können Spectro Cloud über die Seite „Erste Schritte “ kontaktieren.


 Amazon