

Intel präsentierte auf der SC26 seine Pläne für Hochleistungsrechner, wobei Diamond Rapids, die Serverarchitektur der nächsten Generation von Xeon, im Mittelpunkt steht. Laut Intel wird die Plattform auf bis zu 256 Leistungskerne skalierbar sein und eine Speicherbandbreite von bis zu 1.6 TB/s sowie einen LLC-Cache von bis zu 1.28 GB bieten. Die Präsentation stammt von Jeff McVeigh, Vizepräsident und General Manager für strategische Rechenzentrumsprogramme. Sie umfasst außerdem die Intel-GPU-D-Serie, HPC-Software, Siliziumphotonik und Quantenentwicklung. Intel nannte kein Veröffentlichungsdatum für Diamond Rapids.
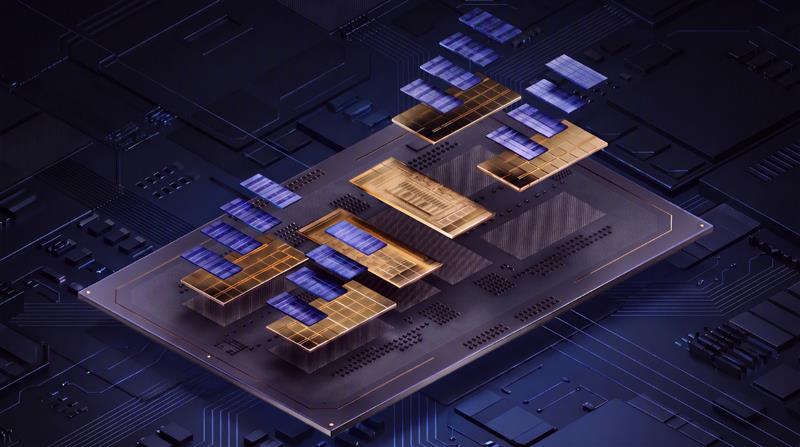
Diamond Rapids CPU-Architektur
Intel beschreibt Diamond Rapids , das auf der Hot Chips-Konferenz als 18A-P-Design vorgestellt wurde, als Kombination aus höherer Rechenleistung, größerer Speicherbandbreite, größeren Caches und erweiterter CPU-Beschleunigung. Die Intel Advanced Performance Extensions (APX) optimieren die Leistung pro Thread, und die von Intel als einheitliches Speichernetzwerk bezeichnete Technologie ermöglicht die Übertragungsrate von 1.6 TB/s. Intel hat jedoch nicht angegeben, wie viele Speicherkanäle oder welche Speichergeschwindigkeit hinter dieser Zahl stehen und ob sie pro Sockel gilt.
Die Architektur unterstützt außerdem Intel AVX 10.2 und die erweiterten Intel Advanced Matrix Extensions (Intel AMX). Intel bezeichnet den Xeon der nächsten Generation als die einzige x86-Server-CPU mit integrierter Matrix-Berechnung für HPC- und KI-Workloads. Zum Vergleich: Die von uns getesteten Topmodelle der AMD EPYC Venice- Architektur verfügen über 256 Zen-6c-Kerne pro Sockel.
McVeigh entwarf den Fahrplan anhand von gemischten Systemen, in denen CPUs Arbeitsabläufe orchestrieren und parallele Kommunikationsbibliotheken ausführen, während Beschleuniger die KI-Arbeit übernehmen. Er schrieb, dass die Zukunft des HPC „offen, heterogen und ausgewogen“ sei.
Intel GPU D-Serie und HPC-Software
Die Intel GPU D-Serie kombiniert KI-Beschleunigung mit FP64-Rechenleistung (Doppelgenauigkeit) auf einer luftgekühlten PCIe-Karte und unterstützt Datentypen von FP4 und MXFP4 bis FP64. Die Intel-GPU D270 verfügt über 160 GB LPDDR5X-Speicher mit einer Speicherbandbreite von 1.5 TB/s; von Partnern entwickelte Konfigurationen sind bis zu 480 GB skalierbar. Intels Argument für Forschungseinrichtungen konzentriert sich auf die Speicherkapazität: Durch die Speicherung größerer Arbeitsdatensätze auf der Karte werden Partitionierung und Datentransfers zwischen Host und Beschleuniger reduziert, die wissenschaftliche Arbeitsabläufe verlangsamen. Intel empfiehlt die Karte außerdem für permanent laufende KI-Agenten, die Code generieren und Rechenaufträge starten.
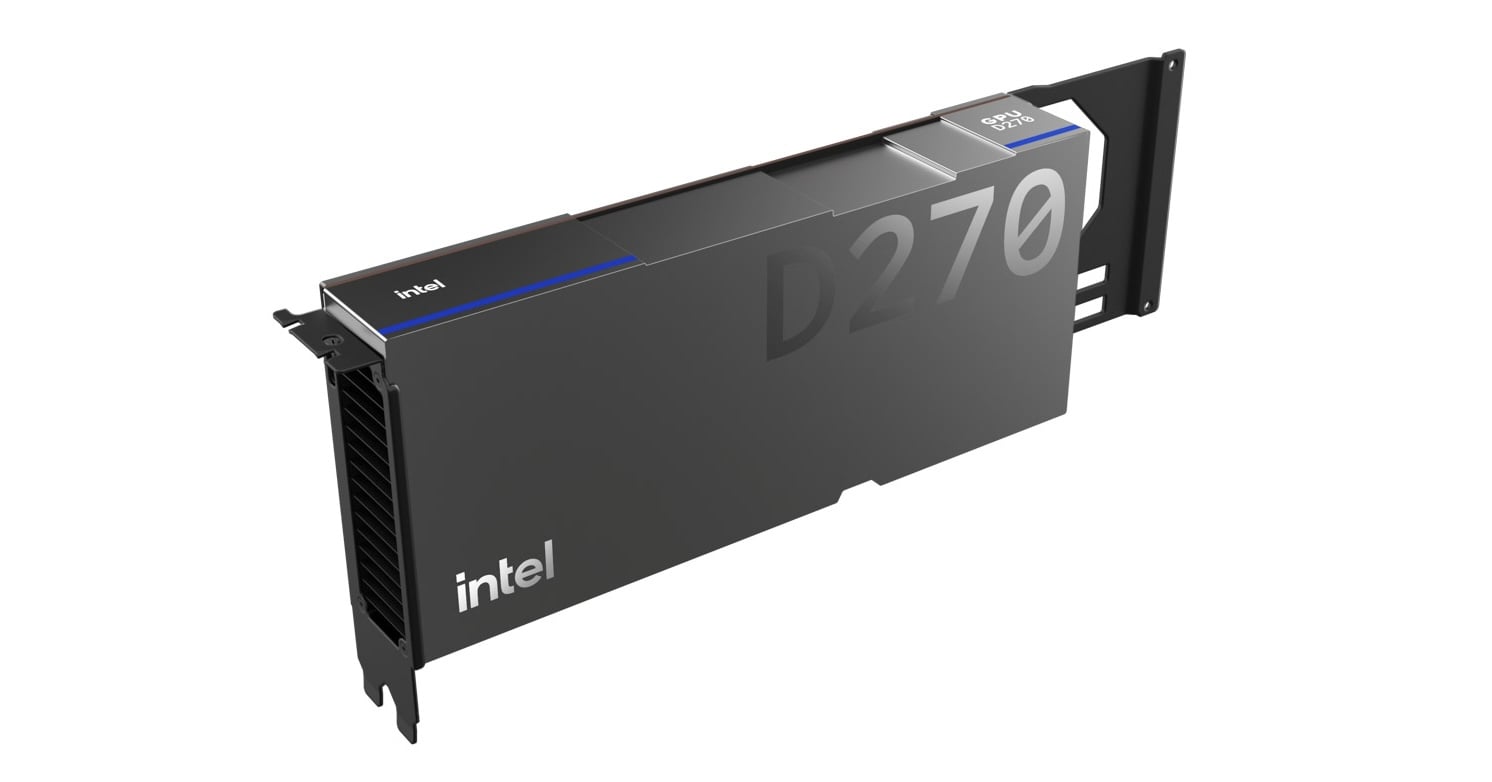
Intel präsentiert auf der SC26 zwei Live-Demos der GPU D270, der D-Serie-Karte mit dem Codenamen Crescent Island. Die erste Demo zeigt eine seismische Bildgebungs-Minianwendung von Veridien, die in weniger als einem Monat von HIP und CUDA auf SYCL portiert wurde. Laut Intel liefen 90 % der Kernel ohne Intel-spezifische Optimierung einwandfrei. Die zweite Demo teilt eine Inferenzpipeline auf: D270-Karten übernehmen das Prefilling, SambaNova SN50-Einheiten die Dekodierung. Xeon 6- und Xeon 6+-Prozessoren orchestrieren die Verarbeitung.
Intel veröffentlichte außerdem Vergleiche mit NVIDIAs RTX PRO 6000 Blackwell Server Edition. Bei FP64-Finanz-Workloads erzielt Intel laut eigenen Angaben bis zu 5.9-fachen Durchsatz bei europäischen Monte-Carlo-Simulationen, 5.6-fachen bei europäischen Black-Scholes-Simulationen, 4.6-fachen bei Binomial-Simulationen und 1.92-fachen bei amerikanischen Black-Scholes-Simulationen. Die D270-Karte verbraucht dabei 350 W, die NVIDIA-Karte 600 W. Für Inferenzberechnungen gibt Intel bis zu 29 % geringere Latenzzeiten bei Drex v2.0 und einen 1.12-fachen Output-Token-Durchsatz bei Qwen3-30B-A3B (FP8) an.
Dies sind Herstellerergebnisse mit Vorserien-Chips, die wir weder getestet noch geprüft haben. Intels Finanztestkonfiguration listet acht NVIDIA-Karten im Vergleich zu einer einzelnen D270 auf und gibt nicht an, ob die Ergebnisse pro Karte normalisiert sind. Die NVIDIA-Inferenzläufe wurden auf einer virtuellen AWS-Maschine durchgeführt.
Intel kündigt an, weiterhin in Intel MPI, Fortran, Compiler-Optimierungen und oneAPI zu investieren, um die reibungslose Funktion bestehender paralleler Codebasen auf gemischten CPU- und GPU-Systemen zu gewährleisten. Zudem arbeitet das Unternehmen an der Integration mit KI-Frameworks, Inferenz-Laufzeitumgebungen und Bereitstellungsumgebungen. Ziel ist es, dass Standardmodelle und -tools vom ersten Tag der Markteinführung an auf neuer Hardware wie der D-Serie lauffähig sind.
Optische Konnektivität und Quantenentwicklung
Intel verwies außerdem auf seine Arbeit im Bereich der Siliziumphotonik, die Licht nutzt, um Daten über größere Entfernungen mit einem Bruchteil des Energieverbrauchs von Kupferleitungen zu übertragen. Intel nannte hierfür keine konkreten Zahlen oder einen Zeitplan für die Produktentwicklung.
Intel bekräftigte seine Argumente für die geplante Übernahme von Classiq im Bereich Quantentechnologie . Diese würde Classiqs automatisierte Plattform zur Synthese von Quantenalgorithmen mit Intels Silizium-Spin-Qubit-Technologie und Chipfertigung kombinieren. Intel geht davon aus, dass die Transaktion vorbehaltlich der behördlichen Genehmigung in der ersten Hälfte des Jahres 2027 abgeschlossen wird.


 Amazon