

NVIDIA hat auf der SC26 eine neue GPU für wissenschaftliches Rechnen angekündigt. Rubin HPC ist Teil der Vera Rubin-Plattform, die über 50,000 CUDA-Kerne auf einer einzigen GPU vereint. NVIDIA rechnet mit der Verfügbarkeit im Jahr 2028. Weitere Neuheiten des Unternehmens auf der SC26 umfassen ein Vera-Rack mit 192 CPUs für Simulationsarbeiten (voraussichtlich Anfang 2027), das Open-Source-Modellpaket Nemotron for Science, neue CUDA-X-Bibliotheken, eine Quanten-Codesign-Plattform mit IBM und Fermilab sowie die Einführung von integrierten optischen Schaltern durch Lambda.
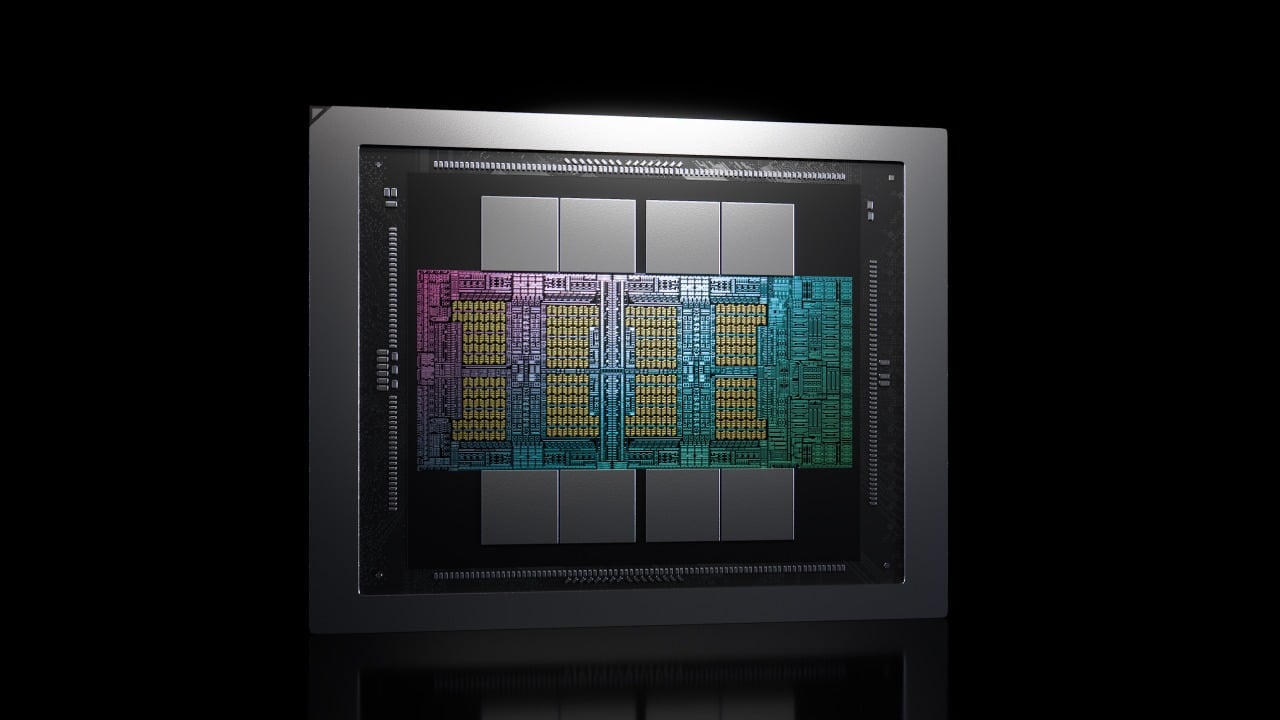
Rubin HPC GPU
NVIDIA beschreibt Rubin HPC als GPU für Simulation und Datenverarbeitung in Wissenschaft, Ingenieurwesen und Analytik, die für die Skalierung von Datenbewegung und Rechenleistung ausgelegt ist. Neben der rekordverdächtigen Kernanzahl hebt das Unternehmen die Beschleunigung spärlicher Daten hervor, die die Kerne mit Daten versorgt, sowie GPU-zu-GPU-Verbindungen über NVLink der siebten Generation. Zu den Zielanwendungen gehören Operationen mit spärlichen Matrizen, Stencil-Berechnungen, Sortierung und Reduktion, die Muster hinter Klimamodellen, Ingenieursimulationen, Genomanalysen und Finanzrisikoanalysen.

Auf der SC26-Konferenz präsentierte NVIDIA, dass Rubin HPC die Leistung von Simulationen und Analysen verdreifacht und alle Präzisionsstufen von FP64 bis FP4 unterstützt. Das Unternehmen nannte keine Basiswerte für diese Verdreifachung und veröffentlichte weder Speicherkapazität, FP64-Durchsatz, Stromverbrauch noch Systemkonfigurationen. Ian Buck, Vizepräsident für Hyperscale- und Hochleistungsrechnen bei NVIDIA, stellte einen Bezug zur Forschung mit Agenten her und erklärte: „Schnellere Simulationen bedeuten schnellere Erkenntnisse“ für Agenten, die an wissenschaftlichen und technischen Problemen arbeiten. Intel präsentierte auf der Messe seine FP64-fähige GPU D270 für dieselben Simulationsanwendungen.
Vera CPU Racks für HPC
Die Vera-CPU-Plattform für HPC ist ein flüssigkeitsgekühltes NVIDIA MGX-Rack mit 192 Vera-CPUs, die über Quantum-X800 InfiniBand verbunden sind. Sie verfügt über ca. 300 TB Arbeitsspeicher, 1 PB Speicherplatz und eine maximale Speicherbandbreite von über 200 TB/s. Jedes 1U-Tray beherbergt acht CPUs sowie NVMe-Speicher und -Management. Das Rack nutzt das Gehäuse, die Stromverteilung und die Kühlung der NVL72-Systeme. Jede CPU besitzt 88 Olympus-Kerne, 176 Threads und SOCAMM2 LPDDR5X-Speicher mit einer Bandbreite von bis zu 1.2 TB/s.

Dies ist eine andere Konfiguration als die von Dell und Supermicro auf der GTC Berlin angekündigten Vera-Racks mit 256 CPUs für Agenten-Sandboxes. Sie verfügen zusätzlich über InfiniBand und SHARP-Netzwerk-Computing für eng gekoppelte Simulationen. NVIDIA gibt an, dass Dell Technologies, HPE, Lenovo und Supermicro die HPC-Racks ab Anfang 2027 anbieten werden. Das Deutsche Klimarechenzentrum (DKRZ) hat Vera-CPUs für seinen von Bull entwickelten Supercomputer HLRE-5 ausgewählt. Dieser umfasst außerdem GB200-Systeme und Quantum-2 InfiniBand und wird voraussichtlich Anfang 2028 in Betrieb gehen.
NVIDIA behauptet, Vera sei doppelt so energieeffizient wie x86-CPUs. In Tests erreichte Vera im OpenFOAM-Motorbike-Large-Case die 1.9-fache Leistung und die 2.4-fache Leistung pro Watt von x86-Systemen. Für das Wettervorhersagemodell prognostiziert NVIDIA die 1.6-fache Leistung und die doppelte Effizienz. Diese Herstellerangaben wurden von uns weder überprüft noch bestätigt, und NVIDIA nannte die verwendeten x86-Prozessoren nicht. In unserem Test der Vera-CPUs schloss ein Vera-System mit zwei Sockeln einen großen OpenFOAM-Mesh-Test 1.44-mal schneller ab als ein System mit 384 EPYC 9965-Kernen und 1.20-mal schneller als ein System mit 240 Xeon 6978P-Kernen.
Im Softwarebereich ist das NVIDIA HPC SDK 26.11 ab sofort verfügbar. Es enthält für Vera optimierte Compiler und Bibliotheken. Ein gemeinsam mit HPC-Zentren und nationalen Forschungseinrichtungen entwickelter Fortran-Compiler der nächsten Generation befindet sich in der öffentlichen Beta-Phase. Laut NVIDIA ermöglicht der Compiler die schnellere Ausführung bestehender Fortran-Programme auf den Plattformen von NVIDIA, ohne dass der Code neu geschrieben werden muss.
Nemotron for Science und CUDA-X Bibliotheken
Nemotron for Science bündelt das offene Modell Nemotron 3.5 Super VL mit wissenschaftlichen Auswertungen, Anleitungen für die Zeit nach dem Training und LitmusBench v0.2, einem offenen Datensatz mit fast 50,000 Aufgaben zum chemischen Denken. Modell und Datensatz sind ab sofort auf Hugging Face verfügbar. Laut NVIDIA wurde das Modell für die lokale Ausführung auf einem 128 GB DGX Spark optimiert. Das Argonne National Laboratory integriert es in sein Multiagentensystem StructBioReasoner für proteinbasierte Therapeutika, und RIKEN stellt es auf seiner KI-Supercomputerplattform RIKYU zur Verfügung.
Bei Kunden, die das Modell nachtrainiert haben, konnte Lila Sciences die Genauigkeit der Quantenpunktsynthese nahezu verdoppeln und auf 61 % steigern. Laut NVIDIA übertrifft dies die 54 % von GPT-6 Astra bei 10- bis 20-fach geringeren Inferenzkosten. Terray Therapeutics konnte im RxnScribe-Test zum Lesen chemischer Reaktionsdiagramme etwa 76 % der annotierten Reaktionen wiederherstellen. Ein Agent des KTH Royal Institute of Technology reparierte 81 % der defekten GROMACS-Molekulardynamik-Setups in einem einzigen nächtlichen Lauf auf einem DGX Spark.
Zu den Neuerungen in CUDA-X gehört das cuPhoton-Toolkit, das Beobachtungen des Event Horizon Telescope in acht Minuten korreliert, während die Analyse zuvor über einen Monat dauerte. cuPotential beschleunigt bestehende Molekularsimulationssoftware um bis zu das Dreifache, und Daviator, ein Satz von GPU-Kernels für das Vienna Ab initio Simulation Package, führt quantenmechanische Berechnungen bis zu 22-mal schneller und mit bis zu 75 % geringeren Kosten durch. NVIDIA hat die Vergleichswerte für cuPotential und Daviator nicht angegeben.
cuSpa und eine GPU-beschleunigte HMMER-Bibliothek sind jetzt Open Source. cuSpa erzielte am Memorial Sloan Kettering Cancer Center eine 900-fache Beschleunigung gegenüber CPUs bei Zellpolygonberechnungen, und die HMMER-Bibliothek führte Benchmark-Suchen bei Basecamp Research bis zu 84-mal schneller durch als Standard-HMMER. Die gemeinsam mit scverse entwickelte rapids-singlecell-Bibliothek wird nun in einem für Agenten optimierten Container ausgeliefert und von 10x Genomics in seine Sentira-Plattform integriert.
Quanten-Codesign mit IBM und Fermilab
Im Bereich der Quantencomputer betreiben NVIDIA und IBM gemeinsam mit IBM-Quantencomputern, darunter auch Systeme mit dem IBM Quantum Nighthawk-Prozessor, eine modulare Quanten-Codesign-Plattform, die in Zusammenarbeit mit dem Fermilab entwickelt wurde. Forscher nutzen diese Plattform zur Evaluierung von Fehlerkorrekturcodes, Dekodierungsalgorithmen und quantenklassischen Anwendungen für die Hochenergie- und Kernphysik. IBM hat eine ähnliche Vereinbarung mit AMD und dem Oak Ridge National Laboratory getroffen und den Nighthawk-Prozessor mit einem Instinct MI355X-Cluster kombiniert. NVIDIA machte keine Angaben zu Systemanzahl, Standort oder Zeitplan.
NVIDIA veröffentlichte außerdem TCBP-JOBS, einen Dekodierungsalgorithmus in der CUDA-Q QEC 0.9.0-Bibliothek. Dieser soll laut NVIDIA bis zu 13,000-mal schneller dekodieren als führende bestehende Algorithmen und die Rechenzeit für neue Quantencomputer-Designs von 12 Wochen auf 45 Minuten verkürzen. Die CUDA-Q-Plattform umfasst zudem einen Dekodierungsserver, eine erweiterte Sammlung fehlertoleranter Primitiven, eine CUDA-Q-Algorithmenbibliothek mit wiederverwendbaren Anwendungskomponenten sowie CUDA-Q Pulse zur Formung der Steuerimpulse, die Qubits ansteuern.
NVIDIA zufolge hat sich der Einsatz von Quantenprozessoren in Supercomputing-Zentren innerhalb von fünf Jahren fast versiebenfacht. Knapp 30 Zentren setzen mittlerweile mehr als 50 Prozessoren ein. Slurm 26.11, das Ende November erscheint, bietet eine Quantenschnittstelle, mit der QPU-Entwickler ihre Hardware einmalig in einer einzigen Datei beschreiben und diese Integration in jedem Zentrum wiederverwenden können. Es unterstützt die Quanten-HPC-Schnittstellen QRMI und QDMI. IBM trägt mit seiner Quantum Resource Management Interface (QRM) dazu bei, sodass Zentren Quantenprozessoren parallel zu CPUs und GPUs einplanen können. Alice & Bob, IBM, IQM, Pasqal, Quantinuum und MQSC setzen Slurm bereits ein. NVIDIA übernahm den Slurm-Entwickler SchedMD Ende 2025.
NVIDIA verwies außerdem auf Arbeiten von IBM und RIKEN im Bereich der quantenklassischen Chemie, einem Finalisten des ACM Gordon Bell Prize 2026. Diese Arbeiten berechneten Bindungsenergien für Protein-Ligand-Komplexe mit bis zu 12,635 Atomen. Das ist mehr als das 40-Fache des bisherigen quantenklassischen Benchmarks mit 303 Atomen. Die klassischen Berechnungen wurden auf dem ROQUO-Supercomputer von RIKEN durchgeführt, der auf NVIDIA GB200-Systemen und Quantum-X800 InfiniBand basiert.
Im Rahmen der Ökosystemprojekte auf der Plattform entwickelten Altera und Oxford Quantum Circuits einen FPGA-basierten Quantencontroller , der die Qubit-Steuerung und -Auslesung über NVQLink mit GPUs verbindet. Quantum Motion integrierte sein Chemie-Framework QUICHE in CUDA-Q. QunaSys nutzte cuQuantum und 1,024 NVIDIA-GPUs der Hopper-Generation auf ABCI-Q, um über 300 Millionen Quantenoperationen zu simulieren und dabei für ein Vier-Wasserstoffatom-Modell chemische Genauigkeit zu erreichen. NVIDIA-Forscher simulierten mit dem Supercomputer JUPITER 104⁴ Qubits unter realistischen Rauschbedingungen.
Lambda setzt integrierte Optiken ein
Lambda nutzt Co-Packaged Optics (CPO)-Switches von NVIDIA Photonics zur Verbindung von GB300 NVL72-Racks in einem Netzwerk mit über 10,000 GPUs. Jeder Switch verfügt über 144 Ports mit 800 Gbit/s und 18 externe Lichtquellen, die Techniker vor Ort austauschen können. Im Gegensatz dazu erfordert ein defekter Laser in einer steckbaren Optik den Austausch des gesamten Moduls. Tests von NVIDIA ergaben eine um etwa 4 % geringere Netzwerklatenz im Rack-Bereich und eine um bis zu 10 % geringere Latenz im Pod-Bereich bei gleichem Durchsatz wie bei steckbaren Optiken.

Die mittlere Temperatur der Optiken im Einsatz betrug 36 °C, im Vergleich zu 51 °C bei herkömmlichen steckbaren Optiken. NVIDIA gibt für seine Photonik-Schalter eine bis zu fünffach höhere Energieeffizienz, eine bis zu 15-fach höhere Zuverlässigkeit und viermal weniger Laser als bei steckbaren Designs an. NVIDIA nutzte die Veranstaltung außerdem, um 20 Jahre CUDA zu feiern. Laut NVIDIA gibt es mittlerweile über 11 Millionen Entwickler und mehr als 1,000 CUDA-X-Bibliotheken.


 Amazon