

Samsung präsentiert diese Woche auf dem OCP Global Summit in San Jose einen gemeinsam mit AMD validierten CXL-Speicherpool. Dieser basiert auf den CMM-D CXL-Speichermodulen und ist für agentenbasierte KI-Inferenz konzipiert. Die Unternehmen haben gemeinsam CXL-Speicher validiert, um Speicherkapazität und Bandbreite parallel zur Anzahl der CPU-Kerne zu skalieren. Hintergrund ist die Annahme, dass agentenbasierte Workloads die CPU-Auslastung stark erhöhen, während die Speicherkapazität mit der Anzahl der Kerne nicht Schritt halten kann. Samsungs Pooling-Demo verspricht eine bis zu 38 Prozent kürzere Zeit bis zum ersten Token und einen bis zu 3.3-fach höheren Durchsatz als bei statischer Speicherzuweisung.
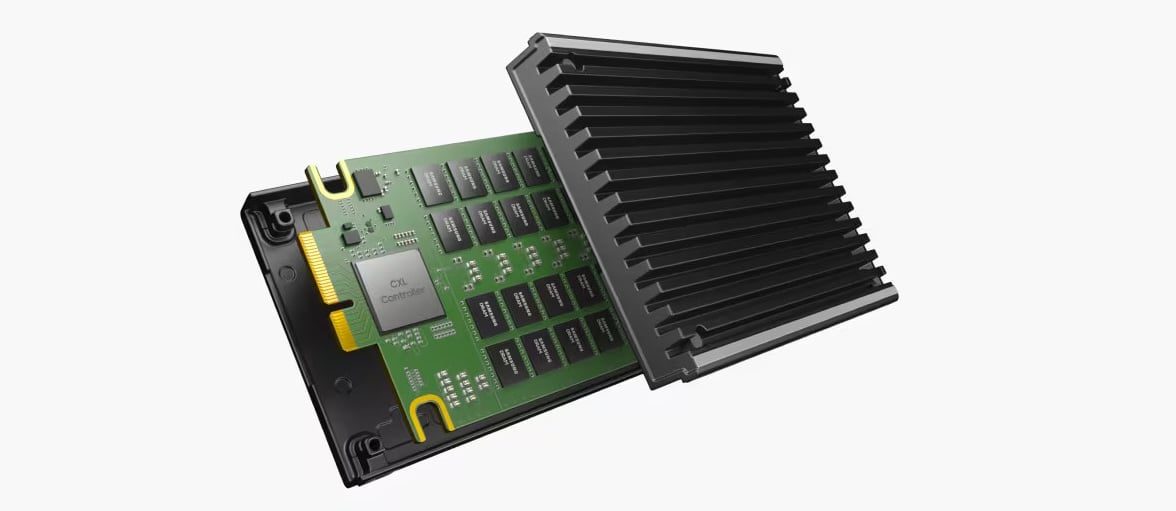
Am Stand C41 in der Messehalle präsentiert Samsung sein Speicher- und Speicherproduktportfolio in Tokenisierungslösungen (HBM4E und LPDDR5X-PIM) und KV-Cache-Lösungen (CMM-D MD310 CXL-Modul, SOCAMM2 LPDDR-Servermodul, PM1763 PCIe Gen6 SSD und BM1773, die Samsung als erste 256-TB-E3.S-QLC-SSD bewirbt). Die Präsentation orientiert sich an den zwei Phasen einer LLM-Pipeline: dem Prefill und der Token-Generierung im High-Bandwidth Memory sowie dem Kontext, der während der Modellgenerierung zwischengespeichert werden muss.
CXL-Speicherpooling-Architektur und gemeinsame Nutzung durch mehrere Knoten
Die Pooling-Demo führt eine KI-Agenten-Workload auf einem GPU-Server gegen einen CXL-Speicherpool aus, der auf der Semantik von Dynamic Capacity Devices (DCD) basiert. Dieser CXL-Mechanismus ermöglicht es einem Pool, Speicher an einen Host zu übergeben und ihn zur Laufzeit wieder zurückzufordern. Mehrere LLM-Instanzen greifen mit elastischer Speicherzuweisung auf den Pool zu. Eine Instanz, die einen Kontext- oder Parameterspitzenwert erreicht, leiht sich Kapazität und gibt sie nach Abschluss des Jobs wieder zurück. Dies ersetzt das übliche Muster, bei dem jeder Knoten für seine Spitzenlast dimensioniert wird und der Überschuss ungenutzt bleibt.
Laut Samsung liegt die TTFT bei der Demo um bis zu 38 Prozent niedriger und der Goodput um bis zu 3.3-mal höher als bei statischer Zuweisung; dies sind Herstellerangaben, und wir haben sie weder durchgeführt noch geprüft.
Die Zusammenarbeit mit AMD bestätigt denselben Ansatz auf AMDs Compute-Plattform. Dort besteht das Problem darin, dass die CPU bei steigender Anzahl agentenbasierter Workloads an ihre Grenzen stößt, während Speicherkapazität und Bandbreite nicht mit der Anzahl der Kerne mitwachsen. Samsung gibt an, dass CMM-D die Anzahl gleichzeitiger Nutzer agentenbasierter KI maximiert, indem beides mit der CPU skaliert wird. Weder die Serverkonfiguration noch die Topologie des CXL-Switches oder die Latenz- und Bandbreitenwerte der Verbindungen für das gemeinsame Setup wurden von den beiden Unternehmen veröffentlicht. Die Multi-Host-Sharing-Komponente der Architektur ist Gegenstand einer Session mit XCENA am 15. Oktober zu dynamischem Pooling, Sharing und speichernaher Verarbeitung.
Samsung verfügt außerdem über Produktionsdaten für die vom Pool erzeugte Speicherebene. Der AI Memory Node mit CMM-D ist am US-Standort von Samsung Semiconductor im Einsatz und dient einem internen KI-Codierungsagenten sowie weiteren Anwendungen. Laut Samsung führte die Hinzufügung einer sogenannten L3.5-Speicherebene zu einer 5- bis 7-fachen KV-Cache-Auslastung. Diese Entwicklung wurde vom Memory Solutions Lab von Samsung, dem Team für KI-Plattformintegrationen und SGLang durchgeführt.
Skalierung der KI-Infrastruktur
Hojun Shim, Corporate Vice President und Leiter des Application Engineering Teams im Speichergeschäft von Samsung, hielt am 12. Oktober eine Executive Session mit dem Titel „Skalierung von Innovationen für das KI-Zeitalter: Maximale Rechenleistung dank hochskalierbarem Speicher“. Samsung argumentiert am Messestand, dass die reine Speichergeschwindigkeit allein die Rechenleistung bei skalierten Modellen nicht ausreichend auslastet. Die Lösung liegt in einer Hierarchie: Arbeitsspeicher mit hoher Bandbreite für aktive Berechnungen, CXL-Fabrics zur bedarfsgerechten Kapazitätserweiterung und SSD-gestützte Speicherebenen für den KV-Cache und die Modellpersistenz.
In einer zweiten Session am 13. Oktober präsentierten Jinin So und Youngha Choi von Samsungs Speichersparte diese Hierarchie unter dem Titel „Tiering the Agent's Memory: From CXL Pooling to SSD-Backed KV Cache Offloading“. Dieses Tiering-Verfahren hatten wir bereits in unserer Arbeit zum KV-Cache-Offloading auf Flash getestet . Die zugehörigen Demos von Samsung umfassten die flexible Datenplatzierung, eine größere maximale NVMe-Datenübertragungsgröße innerhalb des LMCache für KV-Cache-Speicher sowie einen Proof of Concept für eine Vektordatenbank, der die Distanzberechnung auf die SSD verlagert.
Tokenisierung
Im Bereich Tokenisierung präsentiert Samsung HBM4E, dessen Muster seit Mai verfügbar sind und das im August auf der FMS zusammen mit einem HBM5-Modell vorgestellt wurde, sowie LPDDR5X-PIM. Letzteres integriert eine Processing-in-Memory-Einheit in jeden DRAM-Speicherbereich. Laut Samsung bietet die PIM-Technologie die bis zu achtfache effektive Bandbreite von Standard-LPDDR5X und bis zu dreimal so viele Tokens pro Sekunde auf dem Edge AI Accelerator. Diese Werte basieren auf Evaluierungen, die Samsung mit Llama 3.1 8B durchgeführt hat. Die Idee besteht darin, die speicherintensiven Teile der Inferenz innerhalb des DRAM-Gehäuses auszuführen. Dadurch wird die Datenübertragung über die Interconnect-Schnittstelle reduziert, was sowohl den Stromverbrauch als auch die Laufzeit senkt.
Hardware und Architektur
Alle ausgestellten Produkte sind Vorführmodelle oder bereits erhältliche Artikel: Samsung hat dem AMD-Projekt weder eine Artikelnummer (SKU) für den CXL-Poolcontroller noch ein Verfügbarkeitsdatum oder eine Leistungsaufnahme zugeordnet. Die Präsentationen von HBM4E und LPDDR5X-PIM lassen über die bereits angekündigten HBM4E-Muster hinaus keine Rückschlüsse auf einen Produktstart zu. Die Modelle CMM-D MD310, PM1763 und BM1773 sind bereits lieferbar.
| Artikel | Samsung auf dem OCP Global Summit 2026 |
|---|---|
| CXL-Demonstrationen | |
| AMD-Zusammenarbeit | Der CXL-Speicher wurde mit AMD validiert, um Speicherkapazität und Bandbreite mit der Anzahl der CPU-Kerne zu skalieren und CPU-Stotterungen in agentenbasierter KI zu reduzieren. |
| CMM-D Pooling-Demo | DCD-basierter CXL-Speicherpool mit elastischer Zuweisung über mehrere LLM-Instanzen auf einem GPU-Server Bis zu 38 % niedrigere TTFT und bis zu 3.3-fach höherer Durchsatz im Vergleich zur statischen Zuweisung (Samsung-Angaben) |
| KI-Speicherknoten mit CMM-D | Produktionseinführung am US-Campus von Samsung Semiconductor L3.5-Speicherebene mit kompositionsfähiger Speicher, 5- bis 7-fache KV-Cache-Auslastung (Angaben von Samsung) |
| Tokenisierungslösungen | |
| HBM4E | 12-lagige Muster werden seit Mai versandt |
| LPDDR5X-PIM | PIM-Einheit in jeder Bank Bis zu 8-fache effektive Bandbreite im Vergleich zu LPDDR5X und bis zu 3-fache TPS beim Samsung Edge AI Accelerator, Llama 3.1 8B (Angaben von Samsung) |
| KV-Cache-Lösungen | |
| CMM-D MD310 | CXL Speichererweiterungsmodul |
| SOCAMM2 | LPDDR-basiertes Server-Speichermodul |
| PM1763 | PCIe Gen6 SSD, bis zu 28.4 GB/s sequentielle Lesegeschwindigkeit, dargestellt mit Flüssigkeitskühlung |
| BM1773 | 256 TB E3.S QLC SSD |
| Weitere Demos | AiSIO-Beschleuniger-Direktspeicher (100 Mio. IOPS, bis zu 10-mal schnelleres Laden im Kaltstartmodell, Angaben von Samsung) FDP und größere NVMe MDTS in LMCache NCVS-Vektordistanzberechnung im SSD Zusammensetzbarer Speicher mit Live-Migration auf Standard-NVMe |
| Verfügbarkeit | |
| CXL-Pooling mit AMD | Technologievorführung; keine Artikelnummer, kein Datum und keine Leistungsangabe bekanntgegeben |


 Amazon