

VAST Data hat seine Zusammenarbeit mit AMD im Bereich KI-Infrastruktur für Cloud-Anbieter und Unternehmen, die Trainings-, Inferenz-, Retrieval- und agentenbasierte KI-Dienste einsetzen, ausgebaut. Dabei wird das VAST AI-Betriebssystem mit AMD EPYC-Prozessoren der 6. Generation , AMD Instinct-GPUs, AMD-Netzwerkhardware und der ROCm-Software kombiniert.
Die Zusammenarbeit spiegelt einen umfassenderen Infrastrukturwandel wider: von trainingsorientierten KI-Clustern hin zu Umgebungen, die auch persistenten Kontext, hochgradig parallele Inferenz und Agenten-Workflows mit mehreren Durchläufen unterstützen müssen. Diese Implementierungen legen verstärkt Wert auf Datentransfer, KV-Cache-Management, GPU-Nutzung und die Möglichkeit, latenzarmen Zugriff auf große Modell- und Kontextdatensätze zu ermöglichen.
VAST positioniert seine DASE-Architektur (Disaggregated Shared Everything) als gemeinsame Datenschicht für diese Umgebungen. Die Plattform vereint Datei- und Objektspeicher, Datenbanken, Event-Streaming und Datendienste in einem einheitlichen globalen Namensraum. Sie bietet zudem Mandantenfähigkeit und Workload-Isolation für KI-Clouds, die gleichzeitig Kunden- und Anwendungsworkloads verarbeiten.
EPYC 9006-Plattformen für VAST CBox- und EBox-Systeme
VAST hat sich für AMD EPYC-Prozessoren der 6. Generation (ehemals Codename Venice) für seine CBox- und EBox-Plattformen der nächsten Generation entschieden. Das Unternehmen plant, die Prozessoren in seinen CBox-Systemen der sechsten Generation und EBox-Systemen der dritten Generation einzusetzen, die das VAST AI-Betriebssystem unterstützen.
Die Unterstützung für AMD EPYC 9006 führt PCIe Gen6-Konnektivität auf der VAST-Hardwareplattform ein. Laut VAST verdoppelt die neue Schnittstelle die I/O-Bandbreite der vorherigen Generation und verbessert so den Durchsatz von Datei- und Objektspeichern bei gleichzeitig reduzierter Latenz für Datendienste wie Datenbanken, Data Warehouses und Event-Streaming-Workloads, die über VAST DataBase und DataEngine bereitgestellt werden.
Für KI-Infrastrukturen kann eine höhere E/A-Bandbreite dazu beitragen, Engpässe zwischen Rechen-, Netzwerk- und NVMe-Speicherressourcen zu reduzieren. Dies ist insbesondere relevant für das Laden von Modellen, Abruf-Pipelines, den Zugriff auf Checkpoints und externe KV-Cache-Workflows, bei denen die GPU-Speicherkapazität allein nicht ausreicht, um den aktiven Kontext zu erhalten.
Die Referenzarchitektur kombiniert Helios, VAST und DriveNets.
VAST, AMD und DriveNets entwickeln außerdem eine Referenzarchitektur für KI-Infrastrukturen, die auf der Rack-Scale-KI-Infrastruktur AMD Helios, dem VAST AI Operating System und dem DriveNets AI Fabric-Netzwerk basiert.

Die Referenzarchitektur dient als Leitfaden für die Bereitstellung von Modelltrainings-, Inferenz-, Reinforcement-Learning- und KV-Cache-Workloads. Sie berücksichtigt Dimensionierungs- und Verfügbarkeitsaspekte für Organisationen, die KI-Fabriken aufbauen, welche neben GPU-Rechenleistung auch eine gemeinsame Dateninfrastruktur und Hochleistungsnetzwerke benötigen.
VAST erwähnte außerdem die erweiterte Zusammenarbeit mit den Anbietern von Inferenzsoftware, TensorMesh und EmbeddedLLM. Die Bemühungen im Rahmen des Ökosystems konzentrieren sich auf produktionsreife Inferenzarchitekturen für agentenbasierte KI-Anwendungen, wobei jedoch keine konkreten Produktintegrationen und Verfügbarkeitsdetails bekannt gegeben wurden.
KV-Cache-Offload zielt auf hochgradig parallele Inferenz ab
Ein zentraler Bestandteil der Ankündigung ist die erweiterte KV-Cache- Unterstützung mithilfe von AMD Instinct GPUs , AMD Infinity Context, der ROCm-Software und dem VAST AI-Betriebssystem.
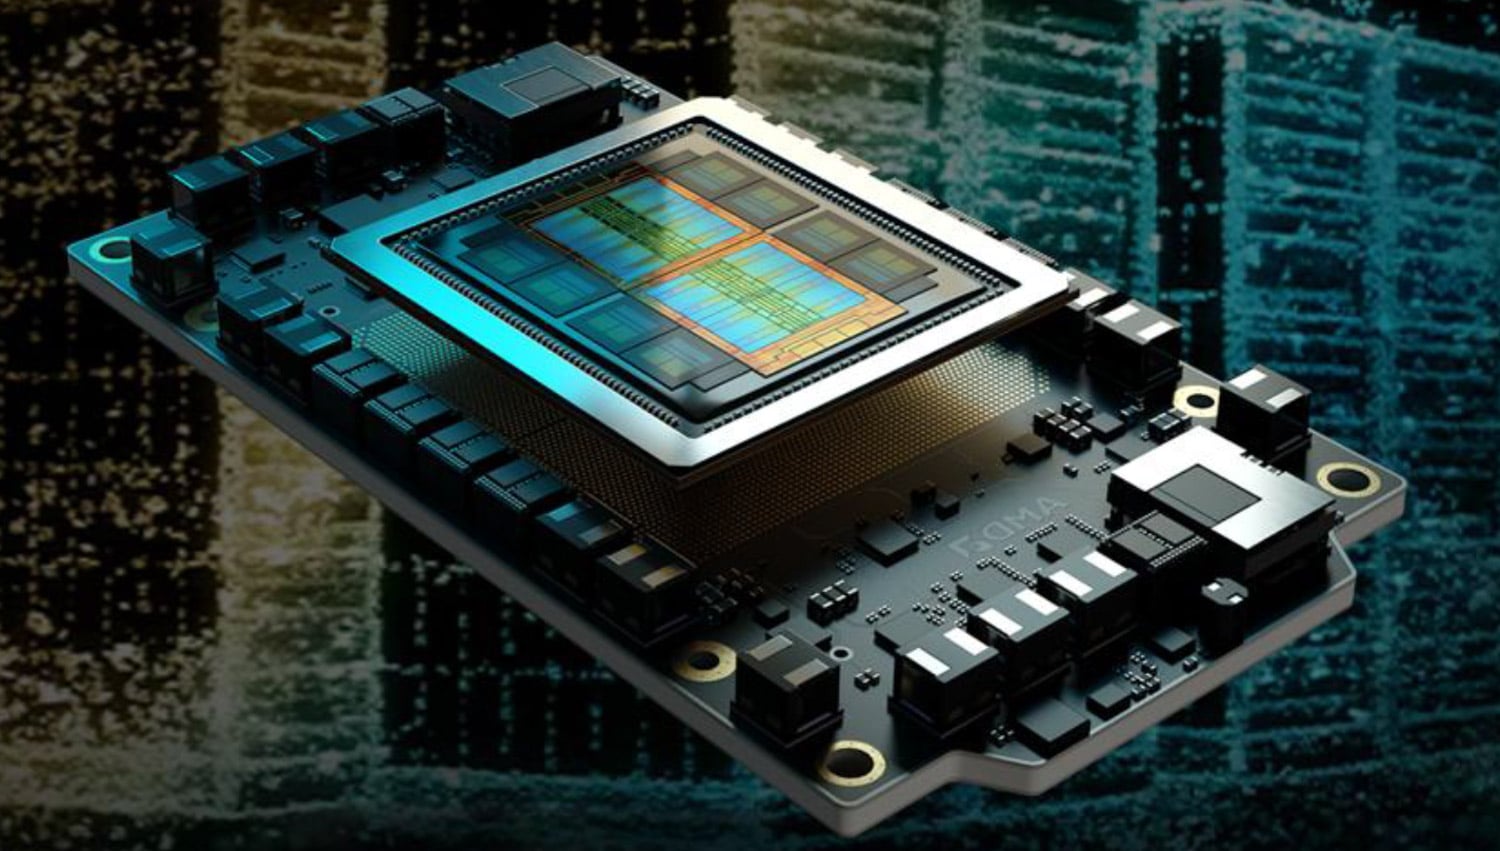
Der KV-Cache speichert während der Inferenz generierte Zwischeninformationen zum Aufmerksamkeitszustand. Das Speichern dieser Daten verbessert die Leistung bei Interaktionen mit mehreren Durchgängen und Workloads mit langem Kontext, jedoch kann ein großer Cache-Speicher viel GPU-Speicher beanspruchen. Durch Auslagerung oder Tiering des KV-Caches auf eine Hochleistungsspeicherplattform kann GPU-Speicher für aktive Workloads freigegeben werden, während der Kontext für nachfolgende Inferenzanfragen erhalten bleibt.
VAST berichtete von ersten Tests mit einer AMD Instinct MI355X GPU , die eine neunfache Verbesserung der Zeit bis zum ersten Token und einen 9.7-fach höheren Token-Durchsatz bei der Verwendung von VAST für KV-Cache-Offloading in hochkonkurrenzbehafteten agentenbasierten KI-Workloads zeigten. Das Unternehmen wies darauf hin, dass diese Ergebnisse von der Hardwareausstattung, den Workload-Charakteristika und der Speicherkonfiguration abhängen.
Die Integration wendet außerdem VAST-Lebenszyklusrichtlinien auf KV-Cache-Daten an. Diese Funktion dient dazu, zwischengespeicherte Informationen automatisch ablaufen zu lassen und zu löschen. Dies ist relevant, wenn der Inferenzkontext sensible, personenbezogene oder regulierte Daten enthält.
Pensando Pollara 400 verbindet GPUs mit gemeinsam genutztem Speicher
Die Architektur nutzt die AMD Pensando Pollara 400 AI NIC, um AMD Instinct GPUs mit dem VAST-Speichercluster zu verbinden. Laut VAST unterstützt die NIC die Datenübertragung von der GPU zum Speicher über NFS über TCP und RDMA und ermöglicht so den Zugriff auf NVMe-SSD-basierte VAST-Cluster für den KV-Cache und umfassendere Inferenzdatenanforderungen.
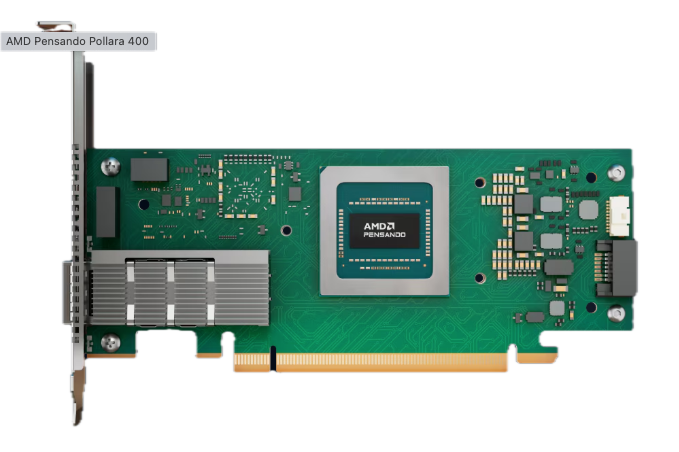
Das resultierende Design ist darauf ausgelegt, KI-Umgebungen zu unterstützen, die Kontextmanagement unabhängig vom GPU-Speicher skalieren müssen. Anstatt den Speicher als separate Persistenzschicht zu behandeln, positioniert VAST die Plattform als Daten- und Ausführungsschicht, die Modelle, Datenbanken, Streaming-Daten, Dateidaten und KI-Kontext in verteilter Infrastruktur verwalten kann.
Für KI-Cloud-Anbieter zielt der Ansatz auf eine höhere GPU-Auslastung und eine verbesserte betriebliche Effizienz ab, da die Bereitstellungen über die GPU-Vermietung und das Batch-Training hinaus in Richtung persistenter Inferenz und agentenbasierter KI-Dienste gehen.


 Amazon