

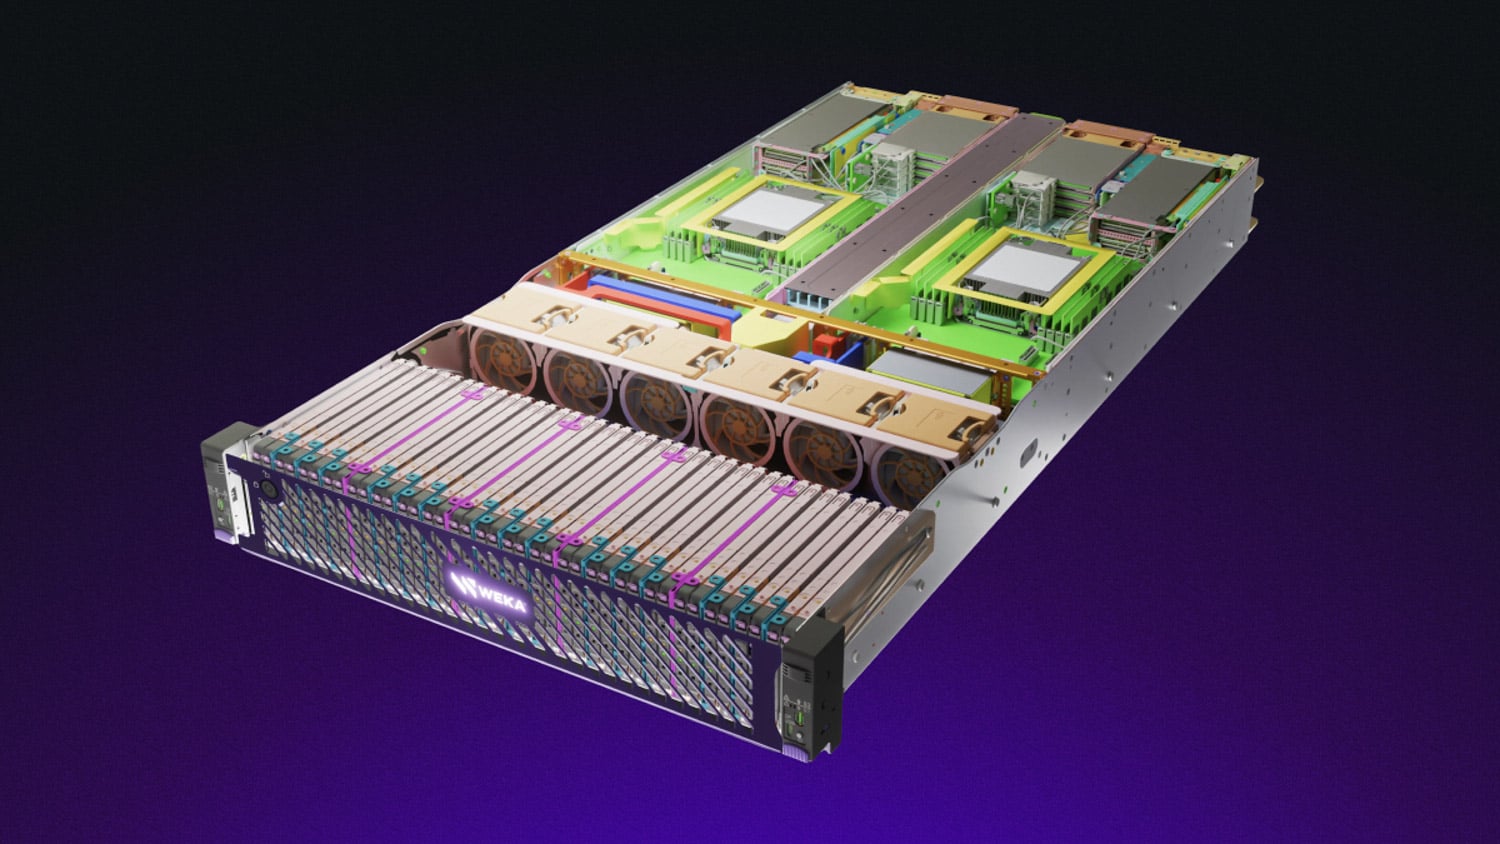
WEKA hat zwei vernetzte Produkte auf den Markt gebracht: NeuralMesh 6, die bisher bedeutendste Software-Version, und WEKApod 3, eine neue Generation von Speichersystemen, die von WEKA speziell für den Betrieb von NeuralMesh 6 entwickelt wurden. NeuralMesh 6 lässt sich weiterhin auf kundenseitig gewählter Hardware einsetzen, während WEKApod eine sofort einsatzbereite Lösung bietet und mit vorinstallierter Software ausgeliefert wird. NeuralMesh 6 bietet native Mandantenfähigkeit, einen kombinierten Protokollstack für Dateien und Objekte, metadatengesteuerte Datenmobilität, kontinuierliche Datenreduktion mit vertraglichen Garantien, Kubernetes-native Operationen und integrierte Observability. WEKApod 3 ist eine speziell entwickelte Hardware, die für den Betrieb dieser Software mit der laut Hersteller höchsten verfügbaren Kapazitäts- und Leistungsdichte in einem einzelnen Rack ausgelegt ist. Es stehen drei Konfigurationen zur Verfügung: Nitro, Prime und Prime Max, die jeweils auf maximale Leistung, ausgewogene Kapazität und maximale Dichte optimiert sind.
Beide Ankündigungen stellen die Veröffentlichung in den Mittelpunkt einer gemeinsamen Marktveränderung: Da sich KI-Workloads von der Trainingsphase hin zu kontextbezogenen, agentenbasierten und abrufgesteuerten Inferenzprozessen im Produktionsmaßstab verlagern, bestimmen zunehmend die Speicher- und Arbeitsspeicherinfrastruktur und nicht nur die Anzahl der GPUs die Kosten pro Token und den erreichbaren Durchsatz.
NeuralMesh 6: Mandantenfähigkeit, einheitliche Protokolle und Datenmobilität
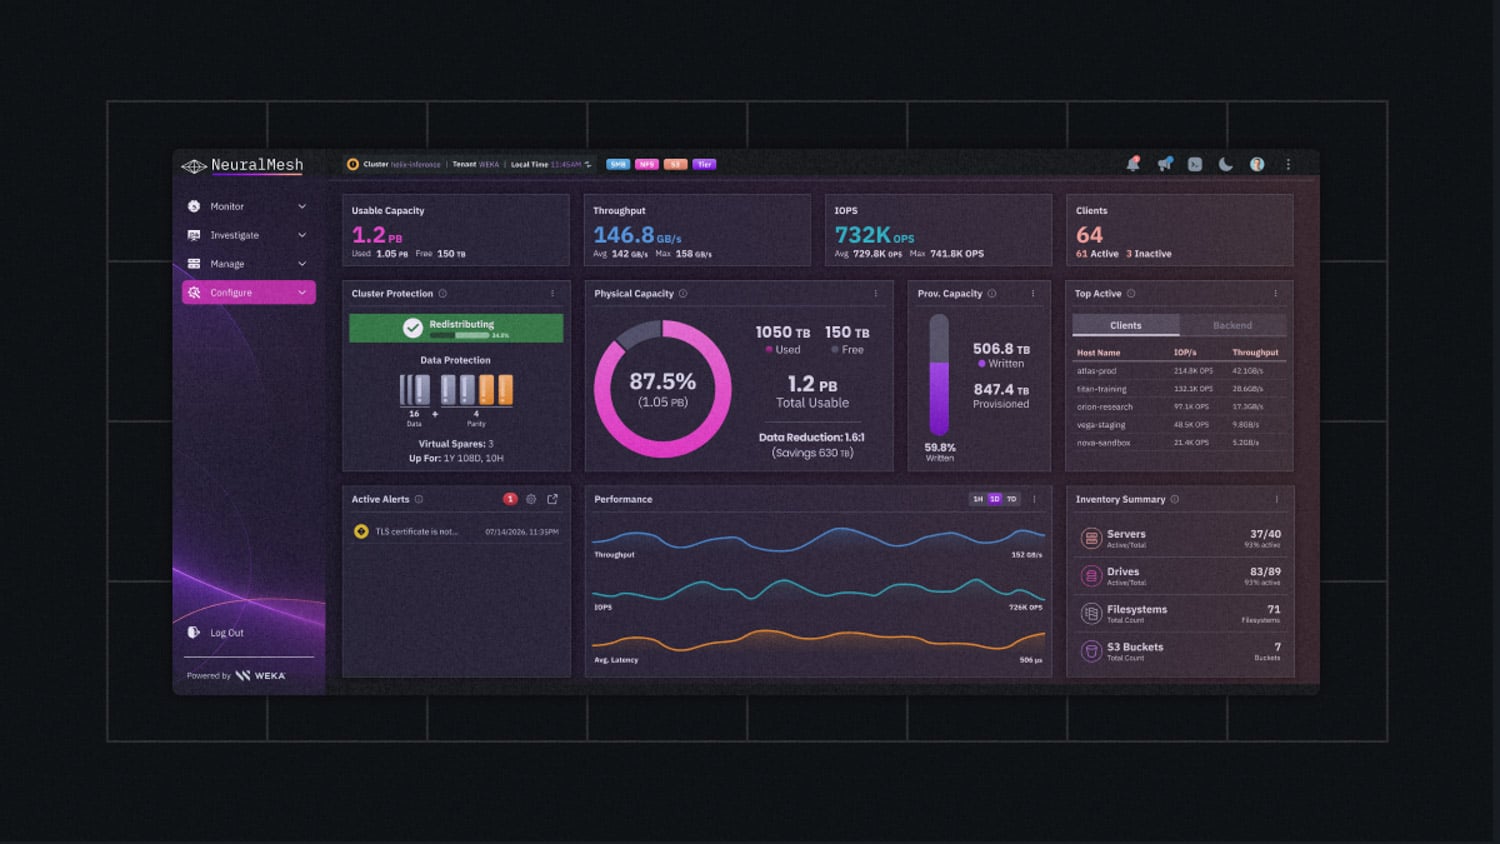
NeuralMesh 6 vereint Funktionen, die Betreiber von KI-Infrastrukturen laut WEKA bisher von verschiedenen Anbietern zusammensuchen mussten: Mandantenfähigkeit, ein einheitlicher Protokollstapel für Dateien und Objekte, Datenmobilität über Standorte hinweg, kontinuierliche Datenreduktion, Kubernetes-native Verwaltung und integrierte Beobachtbarkeit – alles integriert in einen einzigen Software-Stack anstatt aus separaten Teilen zusammengesetzt.
Multi-Tenancy ist in zwei Ebenen unterteilt, die kombiniert werden können. Composable Clusters bieten Hardware-Isolation mit dedizierter CPU, dediziertem Arbeitsspeicher und dedizierten Speicherlaufwerken pro Mandant und sind für Hauptmandanten vorgesehen, die garantierte Ressourcen und vorhersehbare Leistung benötigen. Virtual Multi-Tenancy ergänzt dies um eine VPC-ähnliche Netzwerkisolation durch WEKAs Virtualized RDMA Data Fabric und unterstützt private VLANs, überlappende IP-Adressbereiche, mandantenspezifische Dienstgüte und Verschlüsselung mit unabhängiger Schlüsselverwaltung sowie unabhängige LDAP- oder Active Directory-Authentifizierung pro Mandant. Virtual Multi-Tenancy skaliert auf über 1,000 isolierte logische Mandanten pro Cluster, wobei die Bereitstellung neuer Mandanten in weniger als 30 Minuten erfolgt. Die beiden Ebenen lassen sich kombinieren, sodass ein einzelner WEKA-Hardwarecluster mit 50 Composable Clusters bis zu 50,000 logisch isolierte Mandanten auf derselben physischen Infrastruktur unterstützen kann. Dies ermöglicht ein Wachstum von Dutzenden auf Zehntausende, ohne dass die Systemarchitektur geändert werden muss.
Auf Protokollseite implementiert NeuralMesh 6 einen nativen S3-Stack, in dem dieselben physischen Datenblöcke gleichzeitig über S3 und POSIX adressiert werden können, anstatt über ein Gateway, das zwischen ihnen übersetzt. Eine über NFS oder POSIX geschriebene Datei ist sofort über S3 lesbar und umgekehrt. Dadurch werden doppelte Kopien vollständiger Datensätze vermieden, die sich typischerweise beim Datentransfer zwischen Trainings-, Feinabstimmungs- und Inferenzphasen ansammeln. WEKA hat die S3-Implementierung speziell für KI-Zugriffsmuster entwickelt und unterstützt 2,000 bis 5,000 gleichzeitige S3-Verbindungen pro Knoten – etwa das Fünffache der Parallelität herkömmlicher S3-Architekturen. S3 über RDMA ermöglicht dabei die kopierfreie Übertragung direkt in den GPU-Speicher.
Die Datenmobilität wird durch metadatenbasierte Replikation gewährleistet. Dadurch ist die Zielumgebung sofort durchsuchbar, anstatt dass vor dem Start einer Arbeitslast eine vollständige Datenkopie erforderlich ist. Die Daten werden bedarfsgesteuert geladen, wodurch der WAN-Verkehr reduziert wird und Unternehmen Arbeitslasten dort platzieren können, wo GPU-Kapazität verfügbar ist, anstatt dort, wo die Daten ursprünglich gespeichert wurden. Diese Version ergänzt die Daten um asynchrone Replikation und Remote-Caching als ersten Schritt hin zu einer umfassenderen Föderation und einem globalen Namensraum über Standorte und Clouds hinweg.
Diese Replikationsfähigkeit bildet bereits die Grundlage für reale Implementierungen: Sam Tabar, CEO von WhiteFiber, sagte, dass die intelligente Replikation von NeuralMesh es dem Unternehmen ermöglicht, Datensätze standortübergreifend sichtbar zu machen und genau die Daten, die jeder Job benötigt, zur nächsten GPU-Zuweisung zu übertragen. Dieselbe Architektur steckt auch hinter Project Redwood , dem 111.2 Tbps großen, datenzentrumsübergreifenden Supercluster, über den wir Anfang dieses Monats berichtet haben.
Datenreduzierung – bis zu 6-fache Kapazitätseinsparung
NeuralMesh 6 ermöglicht standardmäßig bei jeder Bereitstellung Datenreduktion, einschließlich Fingerprinting, Similarity Hashing, Deduplizierung und Komprimierung, mit einem Schreib-Overhead von unter 5 %, bis zu 6-facher Kapazitätseinsparung bei KI-Trainingsdaten und einer vertraglichen Garantie, die sowohl die Reduktionsrate als auch die Leistungsauswirkungen abdeckt. Ein neuer Kubernetes Operator automatisiert die Clusterbereitstellung und das Lebenszyklusmanagement für Unternehmen, die Kubernetes als Standardbetriebsmodell nutzen. Laut WEKA verkürzt sich die Bereitstellungszeit dadurch von Wochen auf Stunden. NeuralMesh Observe, das bei jeder Bereitstellung ohne zusätzliche Kosten enthalten ist, bietet SaaS-basierte Multi-Cluster-Dashboards, clientseitige Diagnosefunktionen und Benachrichtigungen, die an Slack, PagerDuty oder E-Mail weitergeleitet werden.
WEKA berichtet über den produktiven Einsatz seiner Augmented Memory Grid- Funktion. Diese erweitert den GPU-Speicher, indem sie den Zugriff auf den persistenten KV-Cache des von NeuralMesh verwalteten NVMe-Speichers in der Oracle Cloud Infrastructure beschleunigt. Benchmarks auf der OCI H100-Infrastruktur zeigten einen zehnfach höheren Token-Durchsatz, zehnmal mehr gleichzeitig bediente Nutzer und siebenmal mehr Token pro GPU. Laut WEKA wurden diese Werte mit DRAM-basierten Alternativen verglichen. Pablo Selem, Senior Director of Software Development bei OCI, beschreibt den Ansatz als Beseitigung von Speicherengpässen, sodass Kunden mit derselben GPU-Ressourcenauslastung einen höheren Durchsatz und mehr Nutzer erreichen können.
WEKApod 3: Maßgeschneiderte Hardware, die auf der Software basiert
WEKApod 3 ist eine Eigenentwicklung von WEKA und keine Referenzarchitektur, die auf Gehäusen von Drittanbietern basiert. Laut Hersteller bietet ein einzelnes WEKApod-Rack eine effektive Kapazität von 1.1 Exabyte auf einer Hardwarebasis mit einer Rohkapazität von 441.5 PB. Damit ist es das erste Einzelrack-System, das die Exabyte-Marke für effektive Kapazität überschreitet. Der Durchsatz pro Rack beträgt 10.2 TB/s bei 210 Millionen IOPS. WEKA gibt eine um 267 % höhere effektive Kapazitätsdichte und eine um 114 % höhere Durchsatzdichte pro Rackeinheit im Vergleich zur jeweils nächstbesten öffentlich verfügbaren Alternative an.
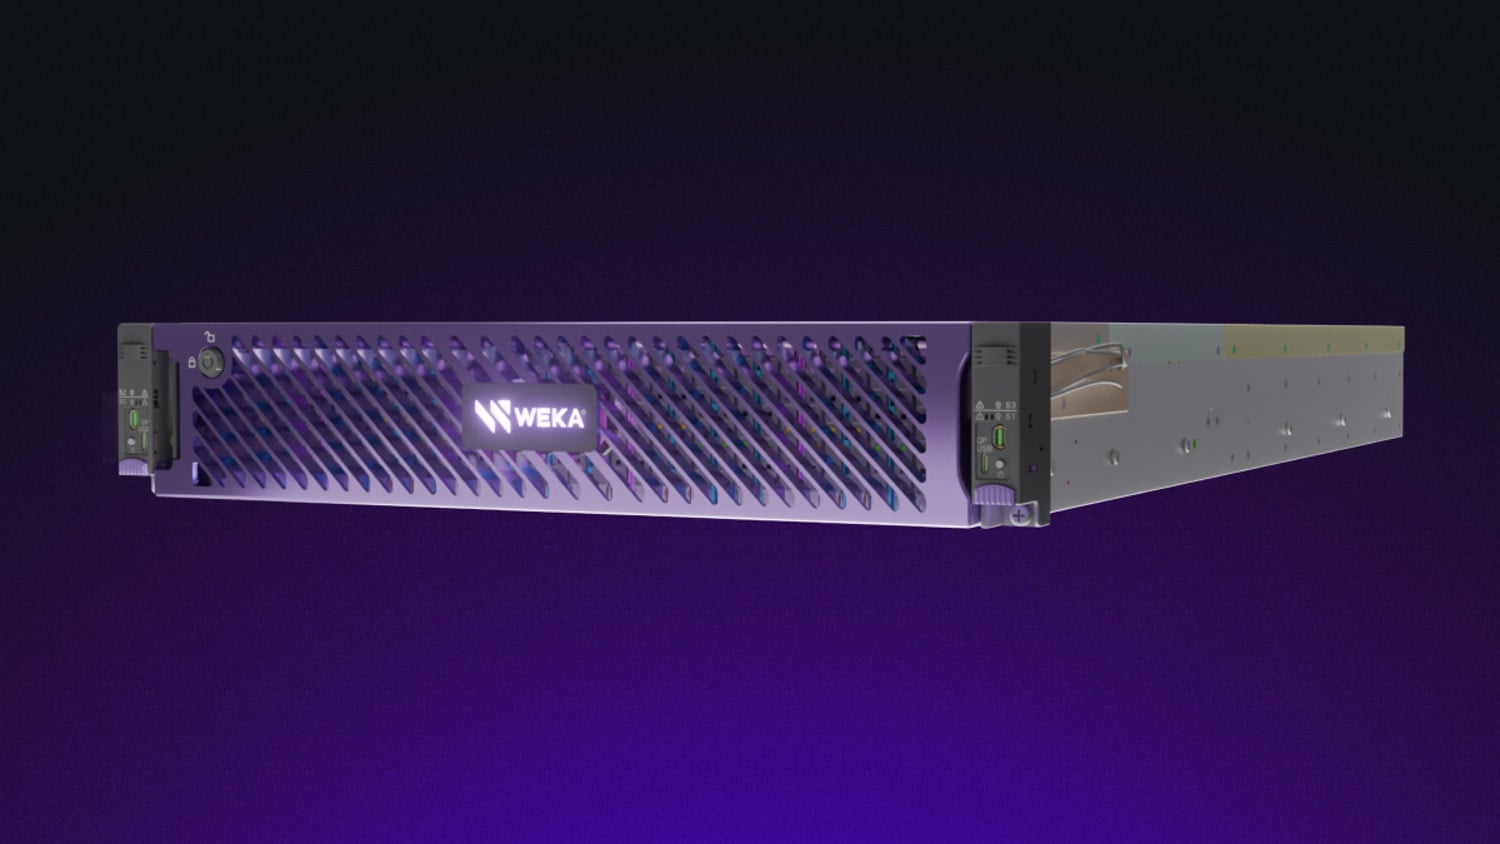
Das Design basiert auf einer internen PCIe Gen 6-Architektur, einer kabelgebundenen Laufwerksverbindung anstelle einer Backplane, NVIDIA ConnectX SuperNIC- Netzwerktechnologie für Spectrum-X-Ethernet-Konnektivität und einer softwaregesteuerten Wärmearchitektur, die für einen Betrieb bei 35 °C Umgebungstemperatur ausgelegt ist und die NVMe-Leistung bei thermischer Belastung drosselt, anstatt das System abzuschalten. WEKA hat mehrere Patente für das Gehäuse, die Laufwerksverbindung, das Wärmemanagement und die Wartungsfreundlichkeit angemeldet. Zu den Wartungsfunktionen gehören Hot-Plug-fähige Boot-Laufwerke mit einem GUI-gestützten Austauschprozess, der laut WEKA nur etwa 10 Minuten statt mehrerer Stunden dauert, sowie die Möglichkeit der Headless-Bereitstellung im Rack-Bereich über NeuralMesh Home mit Cloud-Unterstützung.
Drei Konfigurationen für unterschiedliche Arbeitslastprioritäten
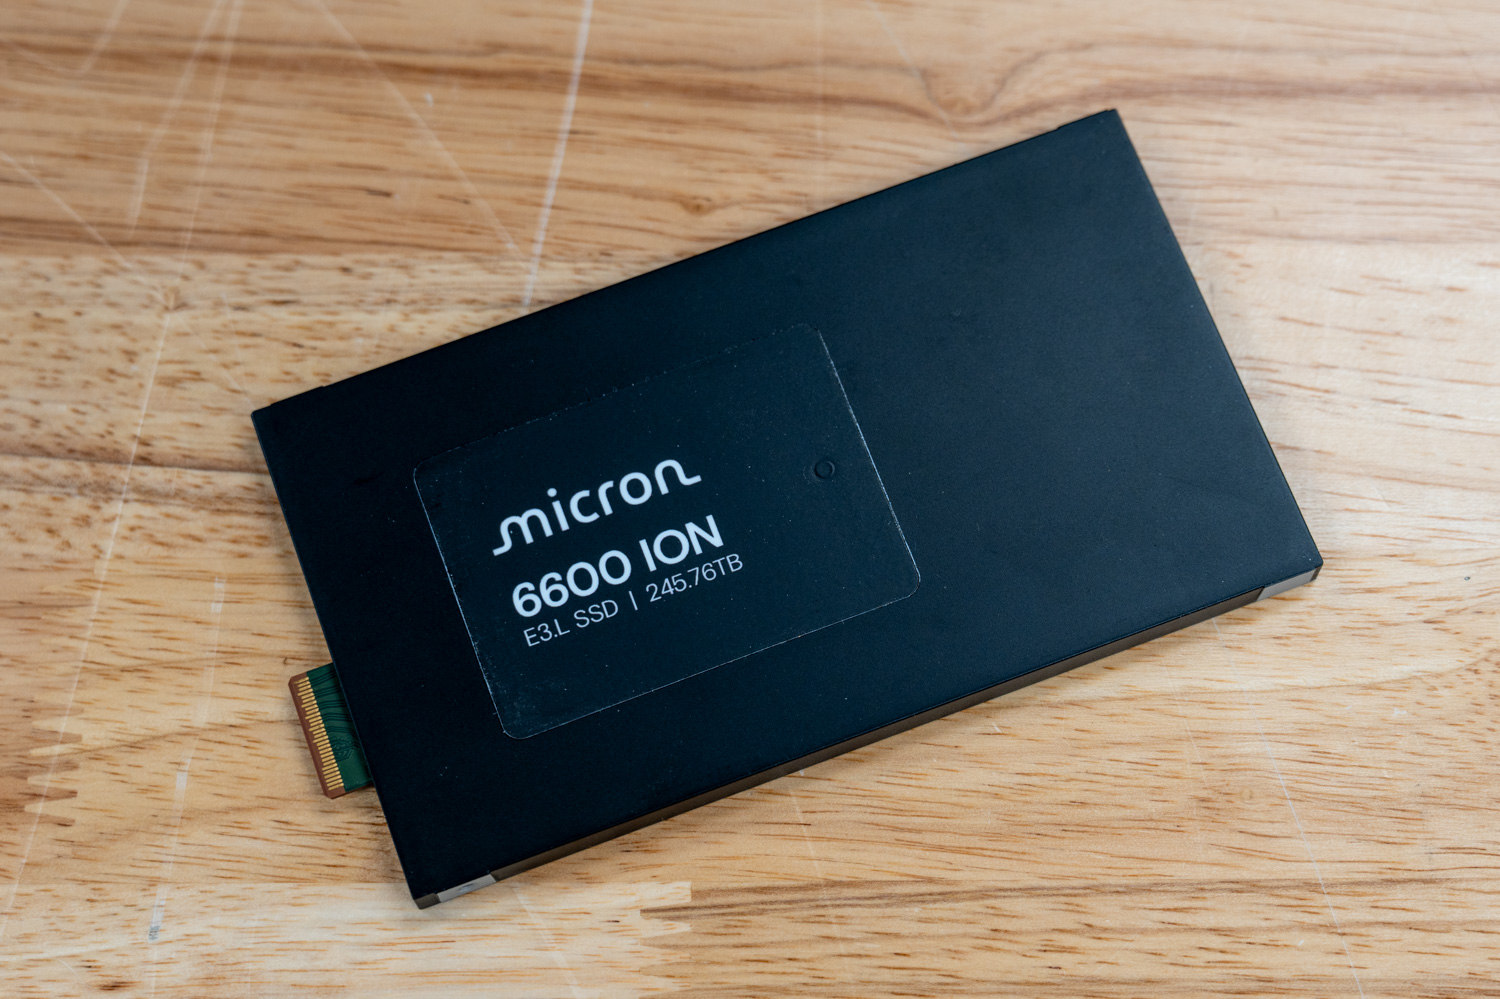
WEKApod Nitro wurde für Workloads entwickelt, bei denen hohe Speicherbandbreite entscheidend ist und die GPU-Auslastung gewährleistet wird. Es verfügt über ein 2-HE-Gehäuse mit vier Nodes, vier unabhängigen Ausfallbereichen und 56 TLC-Laufwerken. Unterstützt wird es durch ein Dual-Port-NVIDIA-ConnectX-Netzwerk mit einem Durchsatz von 800 Gbit/s. WEKApod Prime setzt auf ein ausgewogenes Verhältnis von Kapazität und Leistung mit einer AlloyFlash-Mischung aus TLC- und QLC-Laufwerken. Es ist in einem ähnlichen 2-HE-Gehäuse mit vier Nodes untergebracht und unterstützt 56 Laufwerke. WEKApod Prime Max maximiert die Kapazität auf kleinstem Raum: Ein 2-HE-Gehäuse mit zwei Nodes beherbergt 70 NVMe-Laufwerke. Hierfür werden Micron 6600 ION SSDs mit 245.76 TB Speicherkapazität verwendet . In Kombination mit NeuralMesh-Objektspeicher- und Datenreduktionstechniken wird eine effektive Kapazität von 1.1 Exabyte in einem einzigen 56-HE-Rack erreicht. Um Ihnen einen Eindruck davon zu vermitteln, was diese Festplatte für die Rack-Berechnung bedeutet: Unser Leistungs- und Dichtebericht für die 6600 ION berechnet ein Exabyte in sechs Racks anstatt in 22.
AlloyFlash, die Tiering-Funktion, die die Prime- und Prime-Max-Konfigurationen erst ermöglicht, leitet latenzkritische Operationen automatisch an TLC-Flash-Speicher weiter, während Daten mit hohem Speicherbedarf an QLC-Flash-Speicher geleitet werden, der pro Terabyte etwa 30–40 % günstiger ist – ganz ohne Kundenkonfiguration. Hier zeigt sich am deutlichsten, dass die NeuralMesh-6-Software und die WEKApod-3-Hardware ein Produkt bilden: Die Tiering-Logik der Software sorgt dafür, dass die Hardwarekonfigurationen mit höherer Speicherdichte auch im Produktiveinsatz nutzbar sind und nicht nur eine höhere Speicherkapazität im Datenblatt bieten.
WEKA stützt seine Hardware-Entscheidung auf die aktuellen Einschränkungen in Rechenzentren: Der Bau von Rechenzentren in den USA ging 2025 erstmals seit 2020 zurück, die Wartezeiten für Netzanschlüsse in wichtigen Märkten betragen mittlerweile vier bis sieben Jahre, und Morgan Stanley prognostiziert bis 2028 einen Stromengpass von 49 Gigawatt in den USA. Hinzu kommen anhaltende Probleme bei der NAND-Flash-Versorgung und längere Lieferzeiten für OEMs. WEKA argumentiert, dass ineffiziente Speicherlösungen hinsichtlich Rackplatz und Energieverbrauch direkt mit GPUs um begrenzte physische Ressourcen konkurrieren. Durch die Verwaltung einer eigenen Hardware-Lieferkette anstatt der Abhängigkeit von OEM-Kanälen kann WEKA Kunden, die groß angelegte Infrastrukturprojekte planen, planbarere Preise und kürzere Lieferzeiten bieten.
Jason Hardy, Vizepräsident für Speichertechnologie bei NVIDIA, erklärte, dass das Spectrum-X-Ethernet-Netzwerk dem WEKApod 3 die hohe Bandbreite und geringe Latenz verleiht, die erforderlich sind, um den Datenpfad zwischen Speicher und GPU auch bei hoher Last reibungslos zu halten. Steve McDowell, Chefanalyst bei NAND Research, argumentierte, dass Inferenz im Produktionsmaßstab ein anderes Infrastrukturproblem darstellt als Training. Hierbei seien die Anzahl der Token pro Rack, die Token pro Watt und die Kosten pro Inferenz unter Dauerlast die entscheidenden Kennzahlen – ein Bewertungsmaßstab, anhand dessen Käufer laut McDowell jeden Anbieter vergleichen sollten. Jeremy Werner, Senior Vice President und General Manager der Core Data Center Business Unit von Micron, fügte hinzu, dass die neue WEKApod-Architektur mit Microns 245-TB-SSDs 15.8 Petabyte auf einer 2U-Grundfläche bietet und so Strom und Platz für zusätzliche Rechenleistung spart.
Verfügbarkeit
NeuralMesh 6 wird voraussichtlich in der zweiten Jahreshälfte 2026 allgemein verfügbar sein. Bestehende WEKA-Kunden können das Upgrade kostenlos über die üblichen Vertriebskanäle durchführen. WEKApod Nitro, Prime und Prime Max können ab sofort über das WEKA-Distributoren- und VAR-Netzwerk bestellt werden. Die Auslieferung beginnt im Herbst 2026, NeuralMesh 6 ist bereits vorinstalliert. Darüber hinaus ist WEKApod in dieser Generation erstmals in konfigurierbaren Varianten erhältlich. Kunden können Gehäusetyp, Arbeitsspeicher, Festplattenkapazität und Anzahl der Festplatten frei wählen und so Systeme von unter 1 PB bis hin zu 100 PB und mehr in einem einzigen Setup realisieren.


 Amazon