

WhiteFiber hat WhiteFiber Continuum kommerziell auf den Markt gebracht und damit den im Juli erstmals als Project Redwood vorgestellten GPU-Supercluster mit zwei Standorten in ein marktfähiges Produkt für Unternehmen verwandelt. WhiteFiber bezeichnet Continuum als seine leistungsstärkste Lösung für die netzwerkübergreifende Nutzung von Rechenzentren und als die erste kommerziell erhältliche Architektur für verteilte GPU-Supercluster. Continuum verbindet geografisch getrennte Rechenzentren zu einem einzigen logischen GPU-Supercluster. Laut WhiteFiber entfallen dadurch Bandbreite und Durchsatz als Einschränkungen für die Bereitstellung von KI-Infrastruktur.
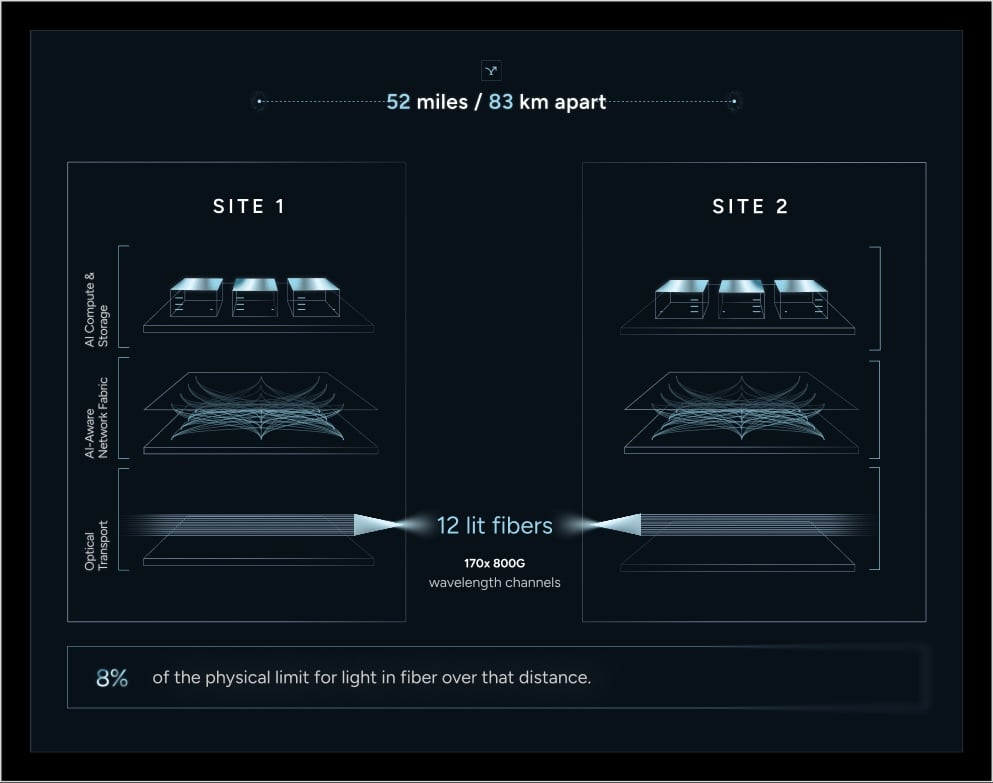
Continuum erstreckt sich über zwei HITRUST-zertifizierte QTS-Einrichtungen, die 83 Kilometer voneinander entfernt liegen und über 12 Zayo-Dark-Fiber-Stränge verbunden sind. DriveNets AI Fabric trägt das Netzwerk, während WEKA NeuralMesh die Datenspeicher- und Speicherinfrastruktur des Clusters bereitstellt. WhiteFiber gibt die Architektur mit einer Gesamtbandbreite von 136 Tbit/s an, die laut Produktseite in 170 800G-Wellenlängenkanäle unterteilt ist. Die garantierte Round-Trip-Latenz von 0.9 Millisekunden liegt laut WhiteFiber innerhalb von 8 % der physikalischen Grenze für Licht in Glasfasern über diese Distanz. Die F&E-Ergebnisse vom Juli ergaben 111.2 Tbit/s in einem Teil des Faserspektrums. WhiteFiber gibt an, dass das Design 136 Tbit/s erreicht, sobald zusätzliche Wellenlängen in Betrieb genommen werden. Tests des gesamten Faserspektrums laufen derzeit, um die garantierten kommerziellen Spezifikationen zu bestätigen. Das Unternehmen hat Patentanmeldungen für die zugrunde liegende Implementierung eingereicht.
„WhiteFiber Continuum ist die Infrastrukturlösung für ein Problem, mit dem die Branche seit Jahren zu kämpfen hat: die geografische Entfernung als Grenze für die Leistungsfähigkeit eines Clusters“, sagte Sam Tabar, CEO von WhiteFiber. „Heute stellen wir es Unternehmen kommerziell zur Verfügung, die KI-Rechenleistung in großem Umfang benötigen, Compliance-Anforderungen erfüllen und auch bei einem Ausfall eines einzelnen Standorts stabil bleiben müssen.“
DriveNets AI Fabric über die 83 km lange Verbindung
DriveNets liefert die Ethernet-basierte KI-Fabric, die beide Standorte verbindet – dieselbe Rolle, die das Unternehmen bereits im Juli in der Forschung und Entwicklung spielte. „Die Ethernet-basierte KI-Fabric von DriveNets bietet höchste Leistung selbst in anspruchsvollsten Umgebungen mit hoher Bandbreite und geringer Latenz. Sie gewährleistet eine effiziente Datenverarbeitung über Supercluster hinweg, maximiert die GPU-Auslastung und optimiert die Energieeffizienz“, so Yossi Kikozashvili, VP Product and GTM für KI-Infrastruktur bei DriveNets. Laut der Produktseite von WhiteFiber verarbeiten beide Standorte gleichzeitig Live-Datenverkehr, wobei lediglich Modellgradienten die Verbindung zwischen den Standorten passieren. So kann ein einzelner Job entweder auf dem gesamten Cluster ausgeführt oder in unabhängige Workloads aufgeteilt werden, die je nach Bedarf auf die verschiedenen Standorte verteilt werden.
WEKA NeuralMesh als gemeinsame Datenschicht
WEKA stellt die Speicher- und Arbeitsspeicherebene mit NeuralMesh bereit und bietet Continuum damit eine einheitliche Speicher- und Arbeitsspeicherinfrastruktur für beide Standorte. Liran Zvibel, Mitgründer und CEO von WEKA, erklärte: „Ein Supercluster ist nur so einheitlich wie seine Daten.“ Er fügte hinzu: „WEKAs NeuralMesh bietet Continuum eine einheitliche, leistungsstarke Speicher- und Arbeitsspeicherinfrastruktur über alle Standorte hinweg, sodass GPUs, die viele Kilometer voneinander entfernt sind, so arbeiten, als wären die Daten lokal.“
Leistungsaggregation und regulatorische Datengrenzkontrolle
Continuum ermöglicht es Telekommunikations- und Metro-Einrichtungen mit freier Strom- und Glasfaserkapazität, zu einem einzigen logischen GPU-Supercluster beizutragen. WhiteFiber präsentiert dies als Möglichkeit, ungenutzte Telekommunikations- und Metro-Ressourcen in Kapazität für Inferenz- und Agenten-Workloads auf der letzten Meile umzuwandeln. Unternehmen können dieselbe Architektur nutzen, um GPUs standortübergreifend zu bündeln und die Leistungs- und Platzgrenzen eines einzelnen Campus zu überwinden. So lässt sich zusätzliche Trainings- und Inferenzkapazität hinzufügen, ohne eine separate Greenfield-Installation zu errichten. Für regulierte Branchen gewährleistet Continuum laut WhiteFiber, dass sensible Workloads innerhalb ihres ursprünglichen Zuständigkeitsbereichs bleiben, während Failover und gebündelte Rechenleistung standortübergreifend erfolgen. Da keiner der Standorte einen Single Point of Failure darstellt, ist die Lösung so konzipiert, dass Trainingsläufe auch bei Ausfall eines Standorts fortgesetzt werden.
WhiteFiber gibt an, dass weitere Standorte im Laufe der Zeit mit demselben Netzwerkansatz demselben logischen Cluster beitreten können, und veranstaltet am 14. Oktober eine technische Präsentation der Architektur mit DriveNets und WEKA.


 Amazon