

AMD, Spectro Cloud y Supermicro han anunciado AMD Instinct Coder, una plataforma de inferencia empresarial validada, diseñada para cargas de trabajo de codificación de IA. Esta solución combina aceleradores de GPU AMD Instinct, la infraestructura de IA de Supermicro y la plataforma de lanzamiento de inferencia PaletteAI de Spectro Cloud para ofrecer una opción integral para la implementación de entornos de inferencia de IA privados e híbridos.
La arquitectura está diseñada para empresas, proveedores de servicios en la nube y operadores de IA soberanos que necesitan equilibrar el procesamiento local, el acceso a modelos de vanguardia, la gobernanza operativa y el consumo de tokens. En lugar de dirigir todas las solicitudes del agente de codificación a modelos de lenguaje externos de gran tamaño, AMD Instinct Coder utiliza un enrutamiento basado en políticas para determinar si una solicitud es atendida por un modelo implementado localmente o reenviada a un punto final de un modelo de vanguardia externo.
Este enfoque se centra en cargas de trabajo donde la codificación rutinaria, la generación de código, el resumen y tareas similares se pueden gestionar localmente, mientras que el razonamiento más complejo o las capacidades especializadas permanecen disponibles a través de modelos externos. La plataforma busca reducir la dependencia de un único proveedor de modelos, manteniendo el código sensible, las indicaciones y los datos contextuales dentro de una infraestructura controlada cuando sea apropiado. Los socios afirman que este sistema puede reducir los costos de los tokens de codificación de IA hasta en un 70%, y la propia documentación de AMD presenta la misma cifra como costo total de propiedad, indicando un retorno de la inversión en tan solo seis meses. Ninguna de estas cifras ha sido verificada de forma independiente.
El anuncio llega en un momento en que las organizaciones están ampliando las herramientas de codificación de IA a través de equipos de desarrollo y flujos de trabajo automatizados. Gartner afirmó en su informe del 24 de junio de 2026, « Gartner predice que los costos de la codificación de IA superarán el salario promedio de un desarrollador para 2028 a medida que aumente el consumo de tokens» , que los costos de los tokens podrían superar las ganancias de productividad sin un modelo operativo estructurado. AMD Instinct Coder aborda esta preocupación mediante el enrutamiento de modelos, la medición, las cuotas y las políticas de carga de trabajo.
Se prevé que la configuración inicial utilice GPU AMD Instinct MI325X. Cada acelerador MI325X incluye 256 GB de memoria HBM3E y un ancho de banda de memoria máximo de hasta 6 TB/s, orientado a cargas de trabajo de inferencia de IA generativa con uso intensivo de memoria. AMD basa la plataforma en su cartera de aceleradores Instinct y el ecosistema de software ROCm, con el objetivo de admitir la inferencia operada localmente sin que las organizaciones tengan que ensamblar y validar de forma independiente la pila completa de hardware y software. La inferencia local ejecuta un modelo GLM-5.2 optimizado mediante AMD Inference Microservices, y la plataforma expone cuotas de tokens, registros de auditoría y visibilidad de costos a través de los paneles de Grafana y Prometheus.
Especificaciones
| Especificación | Configuración de referencia de AMD Instinct Coder |
|---|---|
| Componentes metálicos | |
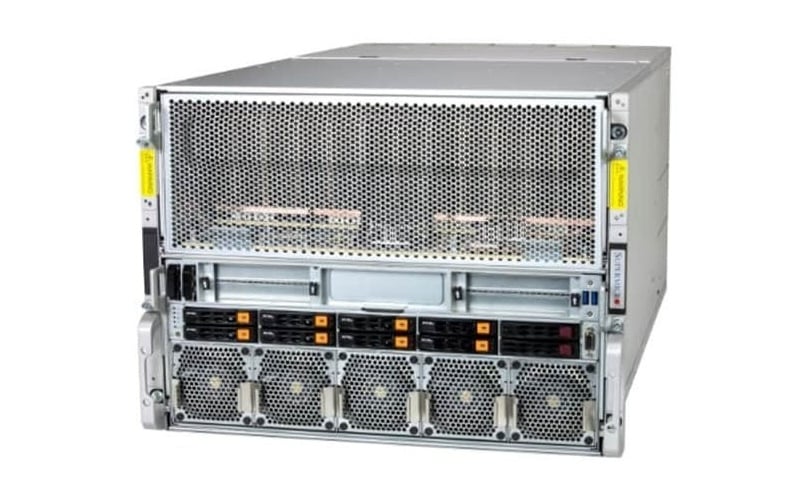
| Server | Supermicro AS-8126GS-TNMR |
| CPUs | 2 x AMD EPYC 9575F, 64 núcleos, 3.3 GHz |
| GPU | 8 x AMD Instinct MI325X |
| Salud Cerebral | 3 TB (24 x 128 GB) DDR5 RDIMM 6400 ECC |
| Almacenamiento de arranque | 2 x 960 GB NVMe PCIe Gen4 V6 M.2 |
| Almacenamiento de datos | 8 unidades SSD PCIe Gen5 TLC U.2 de 7.68 TB |
| Networking | 2 x AMD Pensando Pollara 400 HHHL PCIe NIC, 400GbE |
| Potencia | 6 fuentes de alimentación redundantes de 5250 W (configuración 3+3) de alta eficiencia con certificación Titanium. |
| Software | |
| Plataforma | Plataforma de lanzamiento de inferencias Spectro Cloud PaletteAI |
| Capacidades | Gestión integral del ciclo de vida de la IA Gobernanza empresarial a gran escala Enrutamiento inteligente de modelos locales primero, frontera cuando esté justificado Visibilidad y control totales del uso y el coste de la IA. |
| Modelos de IA | |
| Local | Modelo de microservicios de inferencia AMD GLM-5.2 |
| Frontera (cuando esté justificado) | Claude antrópico GPT abierto AI Google Géminis |
| Herramientas para desarrolladores». | |
| Entornos de desarrollo integrados (IDE) / Herramientas compatibles | Código de Claude Cursor Visual Studio Code |
| Soporte | |
| Software | Soporte integral de software full-stack de Spectro Cloud. |
| Componentes metálicos | 3 años de servicio en el sitio al siguiente día hábil por parte de Supermicro |
| SCALE | |
| CAPACIDAD | Hasta 50 desarrolladores por nodo, 30 concurrentes. |
Supermicro proporciona la infraestructura subyacente de IA empresarial. Sus sistemas compatibles incluyen plataformas de ocho GPU con refrigeración por aire y líquida, compatibles con los aceleradores AMD Instinct MI325X y MI350 Series . La contribución de Supermicro abarca la prevalidación, la integración en rack y la cualificación del sistema, con el objetivo de reducir la complejidad de la implementación y acortar la transición desde la infraestructura entregada hasta la inferencia en producción.
La plataforma Spectro Cloud PaletteAI Inference Launchpad proporciona la capa de software operativa. Esta plataforma admite el enrutamiento entre modelos locales y de borde, la aplicación de políticas específicas para cada carga de trabajo, la medición de tokens, las cuotas de consumo y la separación multiusuario para equipos y usuarios. El software está diseñado para mantener la ejecución local para cargas de trabajo adecuadas, conservando al mismo tiempo la conectividad de respaldo a modelos de borde alojados externamente.
La arquitectura resultante utiliza inferencia por niveles, asignando puntos finales del modelo en función del rendimiento requerido, la sensibilidad, las capacidades del modelo, los objetivos de coste y la capacidad de infraestructura disponible. Para los equipos de plataforma, esto crea una forma de estandarizar cómo se aprovisiona y gestiona la demanda de codificación de IA entre los usuarios y aplicaciones internos. Dan McNamara, vicepresidente sénior y director general de Compute and Enterprise AI en AMD, describió el cambio como la transición de la codificación de IA de una herramienta de desarrollo individual a una decisión de plataforma empresarial. BMC se encuentra entre los primeros usuarios, y Tom Davies, vicepresidente de operaciones SaaS, describe AMD Instinct Coder como una capa de inferencia rentable y de alto rendimiento para el trabajo de Helix Agentic Engineering de la compañía.
Se espera que la configuración inicial de AMD Instinct Coder se implemente en sistemas Supermicro con GPU AMD Instinct MI325X. Los socios presentarán la plataforma en Ai4 en Las Vegas esta semana. Las configuraciones finales del producto, la disponibilidad, el soporte regional y los precios están sujetos a la validación y aprobación de los socios, por lo que las especificaciones anteriores describen la configuración de referencia y no un producto con precio publicado. Las organizaciones interesadas en la evaluación pueden contactar a Spectro Cloud a través de su página de inicio.


 Amazon