

WhiteFiber ha lanzado WhiteFiber Continuum al mercado, convirtiendo el superclúster de GPU de dos sitios que presentó inicialmente como Proyecto Redwood en julio en un producto que las empresas pueden implementar. WhiteFiber describe Continuum como su solución de red entre centros de datos de mayor rendimiento y la primera arquitectura de superclúster de GPU distribuida disponible comercialmente. Conecta centros de datos geográficamente separados en un único superclúster lógico de GPU, y WhiteFiber afirma que esto elimina las limitaciones de ancho de banda y rendimiento sobre cómo y dónde se puede implementar la infraestructura de IA.
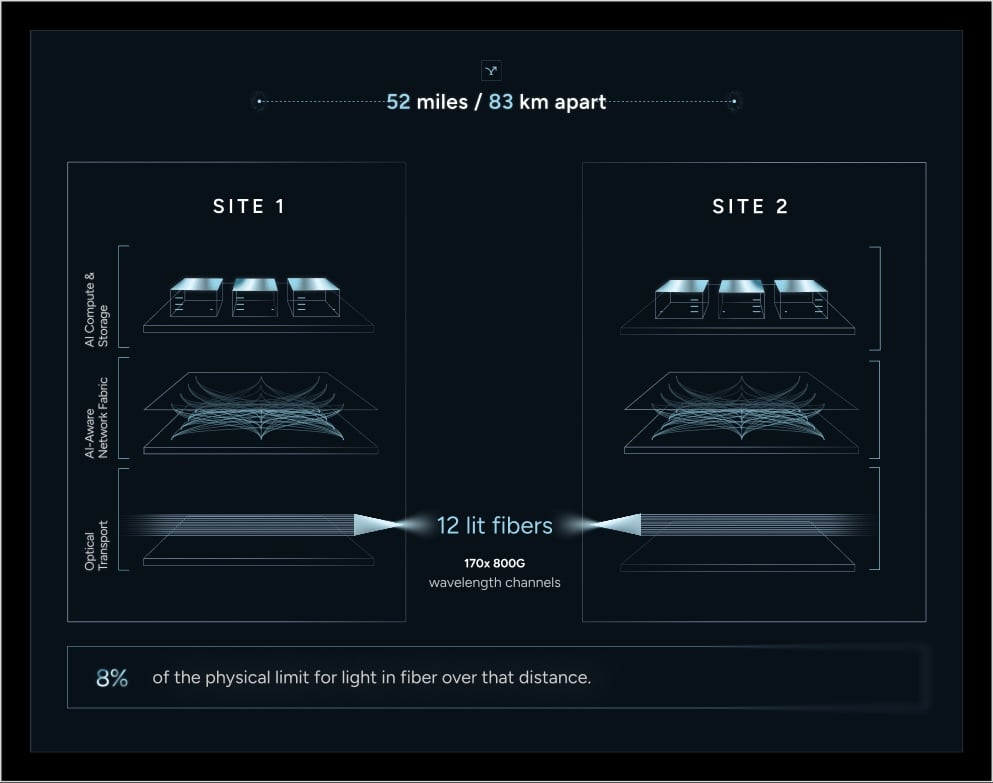
Continuum opera a través de dos instalaciones QTS con certificación HITRUST, separadas por 83 kilómetros, conectadas mediante 12 fibras oscuras Zayo. DriveNets AI Fabric transporta la red, mientras que WEKA NeuralMesh proporciona la infraestructura de almacenamiento de datos y memoria en todo el clúster. WhiteFiber califica la arquitectura con un ancho de banda agregado de 136 Tbps, que su página de producto desglosa en 170 canales de longitud de onda de 800G, con una latencia de ida y vuelta garantizada de 0.9 milisegundos, que según afirma, se encuentra dentro del 8 % del límite físico para la luz en fibra a esa distancia. El resultado de la I+D de julio midió 111.2 Tbps en parte del espectro de fibra. WhiteFiber afirma que el diseño alcanza los 136 Tbps una vez que se activan longitudes de onda adicionales, y se están realizando pruebas de espectro de fibra completo para confirmar las especificaciones comerciales garantizadas. La empresa ha presentado solicitudes de patente para la implementación subyacente.
“WhiteFiber Continuum es la solución de infraestructura a un problema con el que la industria ha convivido durante años: la distancia geográfica como límite a las capacidades de un clúster”, afirmó Sam Tabar, director ejecutivo de WhiteFiber. “Hoy lo ponemos a disposición de las empresas que necesitan computación de IA a gran escala, que cumpla con los requisitos normativos y que no falle cuando un sitio individual tenga un problema”.
La plataforma de IA de DriveNets se extiende a lo largo del enlace de 83 km.
DriveNets suministra la infraestructura de IA basada en Ethernet que conecta ambos sitios, el mismo papel que desempeñó en el trabajo de I+D de julio. «La infraestructura de IA basada en Ethernet de DriveNets ofrece el máximo rendimiento incluso en los entornos más exigentes, de alto ancho de banda y baja latencia, lo que garantiza que los superclústeres escalables muevan los datos de manera eficiente, maximicen la utilización de la GPU y optimicen la eficiencia energética», dijo Yossi Kikozashvili, vicepresidente de Producto y Estrategia de Comercialización de Infraestructura de IA en DriveNets. La página del producto de WhiteFiber indica que ambos sitios manejan tráfico en vivo al mismo tiempo y que solo los gradientes del modelo cruzan el enlace entre sitios, por lo que un solo trabajo puede ejecutarse en todo el clúster o dividirse en cargas de trabajo independientes que se extienden entre sitios según cambie la demanda.
WEKA NeuralMesh como capa de datos compartida
WEKA proporciona la capa de almacenamiento y memoria con NeuralMesh , lo que brinda a Continuum una base única de almacenamiento y memoria que abarca ambas instalaciones. Liran Zvibel, cofundador y director ejecutivo de WEKA, afirmó que "un superclúster solo es tan unificado como sus datos", y agregó que "NeuralMesh de WEKA proporciona a Continuum una base única de almacenamiento y memoria de alto rendimiento en todos los sitios, de modo que las GPU que se encuentran a muchos kilómetros de distancia operan como si los datos fueran locales".
Agregación de energía y control de límites de datos regulatorios
Continuum permite que las instalaciones de telecomunicaciones y metro con capacidad de fibra y energía disponible contribuyan a un único superclúster lógico de GPU, que WhiteFiber presenta como una forma de convertir los activos de telecomunicaciones y metro inactivos en capacidad para cargas de trabajo de inferencia y agentes de última milla. Las empresas pueden usar la misma arquitectura para agrupar GPU en diferentes ubicaciones y superar el límite de energía y espacio de un solo campus, agregando capacidad de entrenamiento e inferencia adicional sin necesidad de una implementación nueva. Para las industrias reguladas, WhiteFiber afirma que Continuum mantiene las cargas de trabajo sensibles dentro de su jurisdicción de origen, mientras que la conmutación por error y la computación agrupada se realizan en diferentes ubicaciones. Además, dado que ninguna ubicación es un punto único de fallo, está diseñado para que las ejecuciones de entrenamiento continúen cuando una ubicación falla.
WhiteFiber afirma que, con el tiempo, se podrán añadir sitios adicionales al mismo clúster lógico utilizando el mismo enfoque de red, y que el 14 de octubre organizará una demostración técnica de la arquitectura con DriveNets y WEKA.


 Amazon