

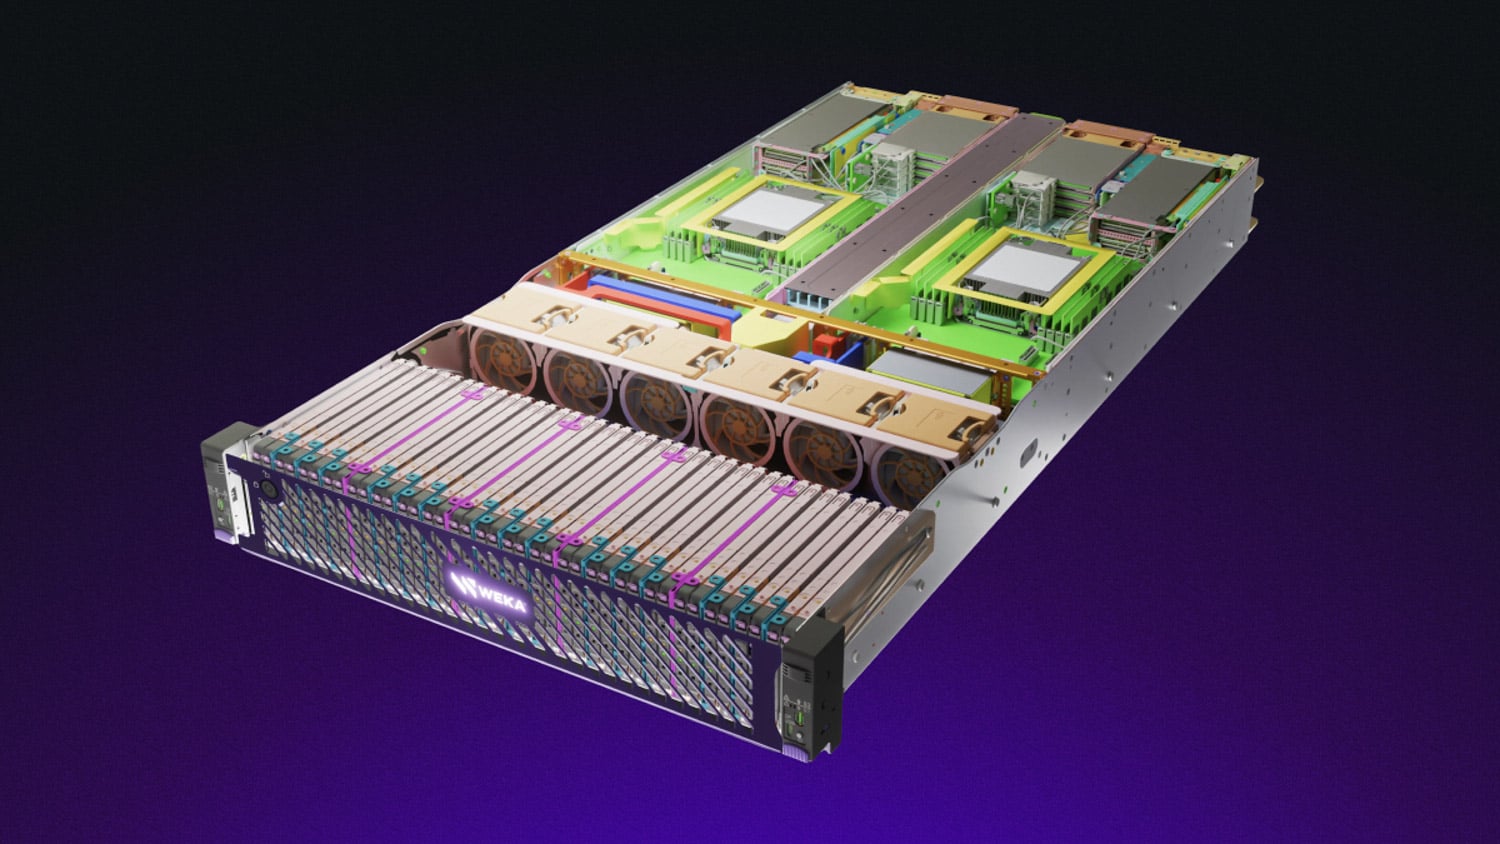
WEKA ha lanzado dos productos conectados: NeuralMesh 6, su versión de software más importante hasta la fecha, y WEKApod 3, una nueva generación de dispositivos de almacenamiento diseñados y desarrollados por WEKA para ejecutarlo. NeuralMesh 6 se puede implementar en el hardware que elija el cliente, mientras que WEKApod ofrece una solución integral, con el software preinstalado. NeuralMesh 6 introduce multitenencia nativa, una pila de protocolos combinada de archivos y objetos, movilidad de datos basada en metadatos, reducción de datos continua con garantías contractuales, operaciones nativas de Kubernetes y observabilidad integrada. WEKApod 3 es un hardware diseñado a medida para ejecutar este software con la mayor capacidad y densidad de rendimiento disponibles en un solo rack, según la empresa, y cuenta con tres configuraciones: Nitro, Prime y Prime Max, orientadas al máximo rendimiento, capacidad equilibrada y máxima densidad, respectivamente.
Ambos anuncios enmarcan el lanzamiento en torno a un cambio común en el mercado: a medida que las cargas de trabajo de IA pasan del entrenamiento a la inferencia basada en contextos extensos, agentes y recuperación a escala de producción, la infraestructura de almacenamiento y memoria, y no solo la cantidad de GPU, determina cada vez más el costo por token y el rendimiento alcanzable.
NeuralMesh 6: Multitenencia, protocolos unificados y movilidad de datos
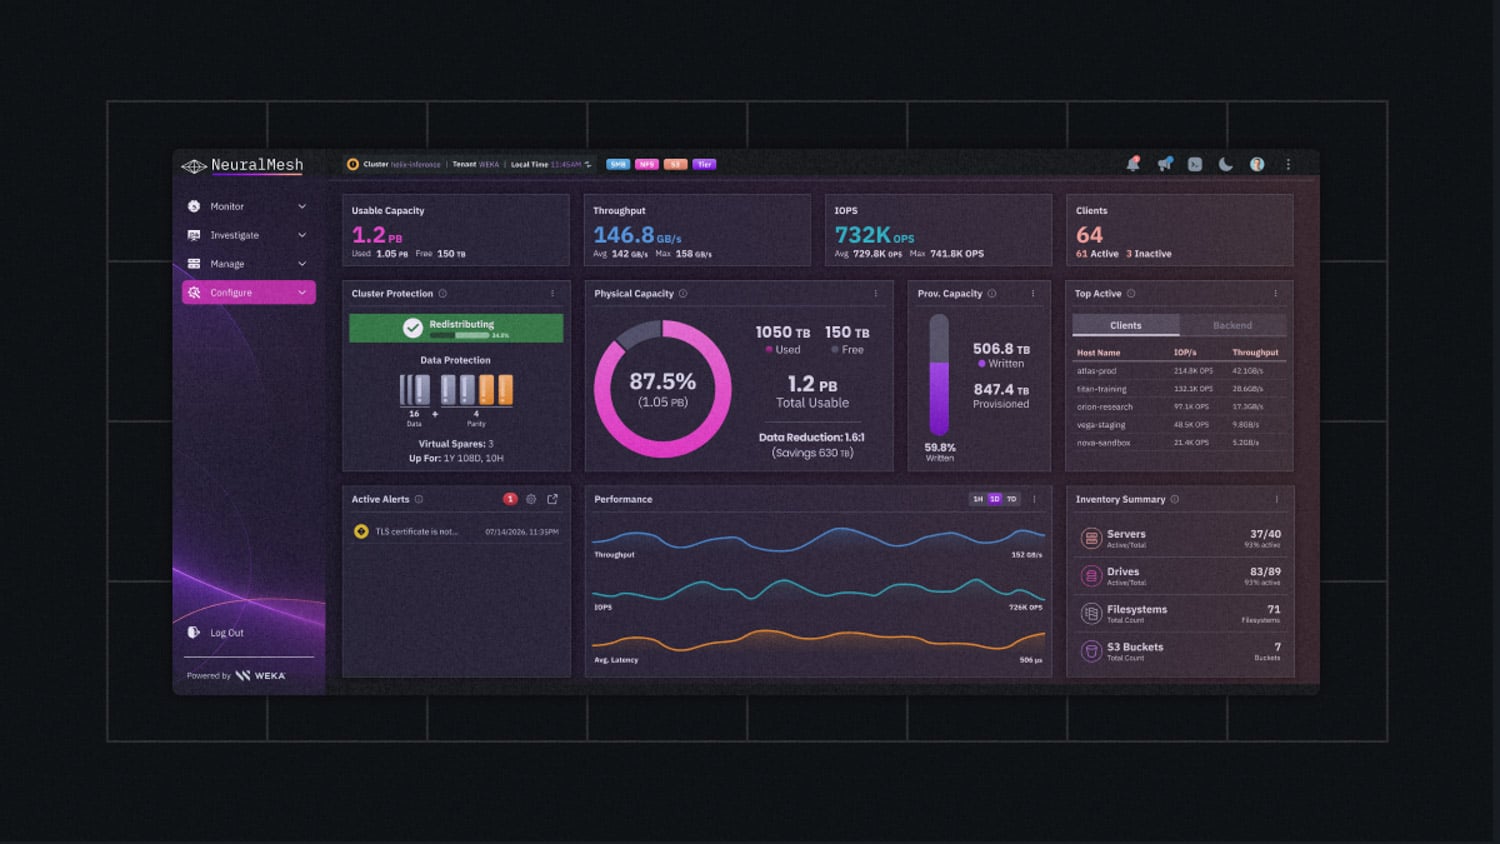
NeuralMesh 6 combina características que, según WEKA, los operadores de infraestructura de IA tradicionalmente han tenido que reunir de varios proveedores: multitenencia, una pila de protocolos unificada para archivos y objetos, movilidad de datos entre sitios, reducción continua de datos, gestión nativa de Kubernetes y observabilidad integrada, todo ello integrado en una única pila de software en lugar de ensamblado a partir de partes separadas.
La arquitectura multiusuario se divide en dos niveles que se pueden combinar. Los clústeres componibles proporcionan aislamiento a nivel de hardware, con CPU, memoria y unidades de almacenamiento dedicadas por usuario, pensados para usuarios clave que necesitan recursos garantizados y un rendimiento predecible. La arquitectura multiusuario virtual añade aislamiento de red al estilo VPC mediante la estructura de datos RDMA virtualizada de WEKA, compatible con VLAN privadas, espacios de direcciones IP superpuestos, calidad de servicio y cifrado por usuario con gestión de claves independiente, y autenticación LDAP o Active Directory independiente por usuario. La arquitectura multiusuario virtual se escala a más de 1,000 usuarios lógicos aislados por clúster, con aprovisionamiento de nuevos usuarios en menos de 30 minutos. Los dos niveles se combinan, de modo que un único clúster de hardware WEKA con 50 clústeres componibles puede admitir hasta 50 000 usuarios lógicamente aislados en la misma infraestructura física, lo que permite un crecimiento de decenas a decenas de miles sin necesidad de rediseñar la arquitectura del sistema.
En cuanto al protocolo, NeuralMesh 6 implementa una pila S3 nativa en la que los mismos bloques de datos físicos son accesibles simultáneamente a través de S3 y POSIX, en lugar de mediante una puerta de enlace que realice la traducción entre ellos. Un archivo escrito a través de NFS o POSIX se puede leer inmediatamente desde S3, y viceversa, lo que elimina las copias duplicadas de conjuntos de datos completos que normalmente se acumulan a medida que los datos se mueven entre las etapas de entrenamiento, ajuste fino e inferencia. WEKA diseñó la implementación de S3 específicamente para patrones de acceso de IA, admitiendo de 2,000 a 5,000 conexiones S3 concurrentes por nodo, aproximadamente cinco veces la concurrencia de las arquitecturas S3 convencionales, con S3 sobre RDMA que permite la transferencia sin copia directamente a la memoria de la GPU.
La movilidad de datos se gestiona mediante la replicación con prioridad a los metadatos, lo que permite acceder inmediatamente al entorno de destino sin necesidad de una copia completa de los datos antes de que pueda iniciarse una carga de trabajo. Los datos se actualizan bajo demanda, lo que reduce el tráfico de la WAN y permite a las organizaciones ubicar las cargas de trabajo donde haya capacidad de GPU disponible, en lugar de donde se escribieron originalmente los datos. Esta versión incorpora la replicación asíncrona y el almacenamiento en caché remoto como primer paso hacia una federación más amplia y un espacio de nombres global en sitios y nubes.
Esa capacidad de replicación ya está sirviendo de base para implementaciones reales: Sam Tabar, director ejecutivo de WhiteFiber, afirmó que la replicación inteligente de NeuralMesh permite a la empresa hacer visibles los conjuntos de datos en diferentes ubicaciones y extraer exactamente los datos que cada trabajo necesita para la siguiente asignación de GPU, la misma arquitectura que hay detrás de Project Redwood , el supercluster entre centros de datos de 111.2 Tbps del que hablamos a principios de este mes.
Reducción de datos: ahorro de capacidad de hasta 6 veces.
NeuralMesh 6 también permite la reducción de datos, incluyendo huella digital, hash de similitud, deduplicación y compresión, de forma predeterminada en cada implementación, con una sobrecarga de escritura inferior al 5%, ahorros de capacidad de hasta 6 veces en datos de entrenamiento de IA y una garantía contractual que cubre tanto la tasa de reducción como el impacto en el rendimiento. Un nuevo operador de Kubernetes automatiza la implementación de clústeres y la gestión del ciclo de vida para organizaciones que utilizan Kubernetes como su modelo operativo estándar, lo que, según WEKA, reduce el tiempo de implementación de semanas a horas. NeuralMesh Observe, incluido sin coste adicional con cada implementación, proporciona paneles de control multiclúster basados en SaaS, diagnósticos a nivel de cliente y alertas dirigidas a Slack, PagerDuty o correo electrónico.
WEKA informa que está utilizando su función Augmented Memory Grid en producción, la cual expande la memoria de la GPU al acelerar el acceso persistente a la caché KV en el almacenamiento NVMe administrado por NeuralMesh en Oracle Cloud Infrastructure. Las pruebas de rendimiento en la infraestructura OCI H100 demostraron un rendimiento de tokens 10 veces mayor, 10 veces más usuarios concurrentes atendidos y 7 veces más tokens por GPU, lo que, según WEKA, se compara con alternativas basadas en DRAM. Pablo Selem, director sénior de desarrollo de software en OCI, describió este enfoque como la eliminación de cuellos de botella de memoria para que los clientes puedan lograr un mayor rendimiento y más usuarios con la misma capacidad de GPU.
WEKApod 3: Hardware personalizado construido en torno al software
WEKApod 3 es un diseño de hardware propio de WEKA, no una arquitectura de referencia basada en chasis OEM de terceros. La compañía afirma que un solo rack WEKApod ofrece 1.1 exabytes de capacidad efectiva sobre una base de hardware de 441.5 PB de capacidad bruta, lo que lo convierte en el primer sistema de un solo rack en superar un exabyte de capacidad efectiva. El rendimiento por rack es de 10.2 TB/s con 210 millones de IOPS. WEKA reporta una densidad de capacidad efectiva un 267 % mayor y una densidad de rendimiento un 114 % mayor por unidad de rack que la siguiente mejor alternativa disponible públicamente en cada categoría.
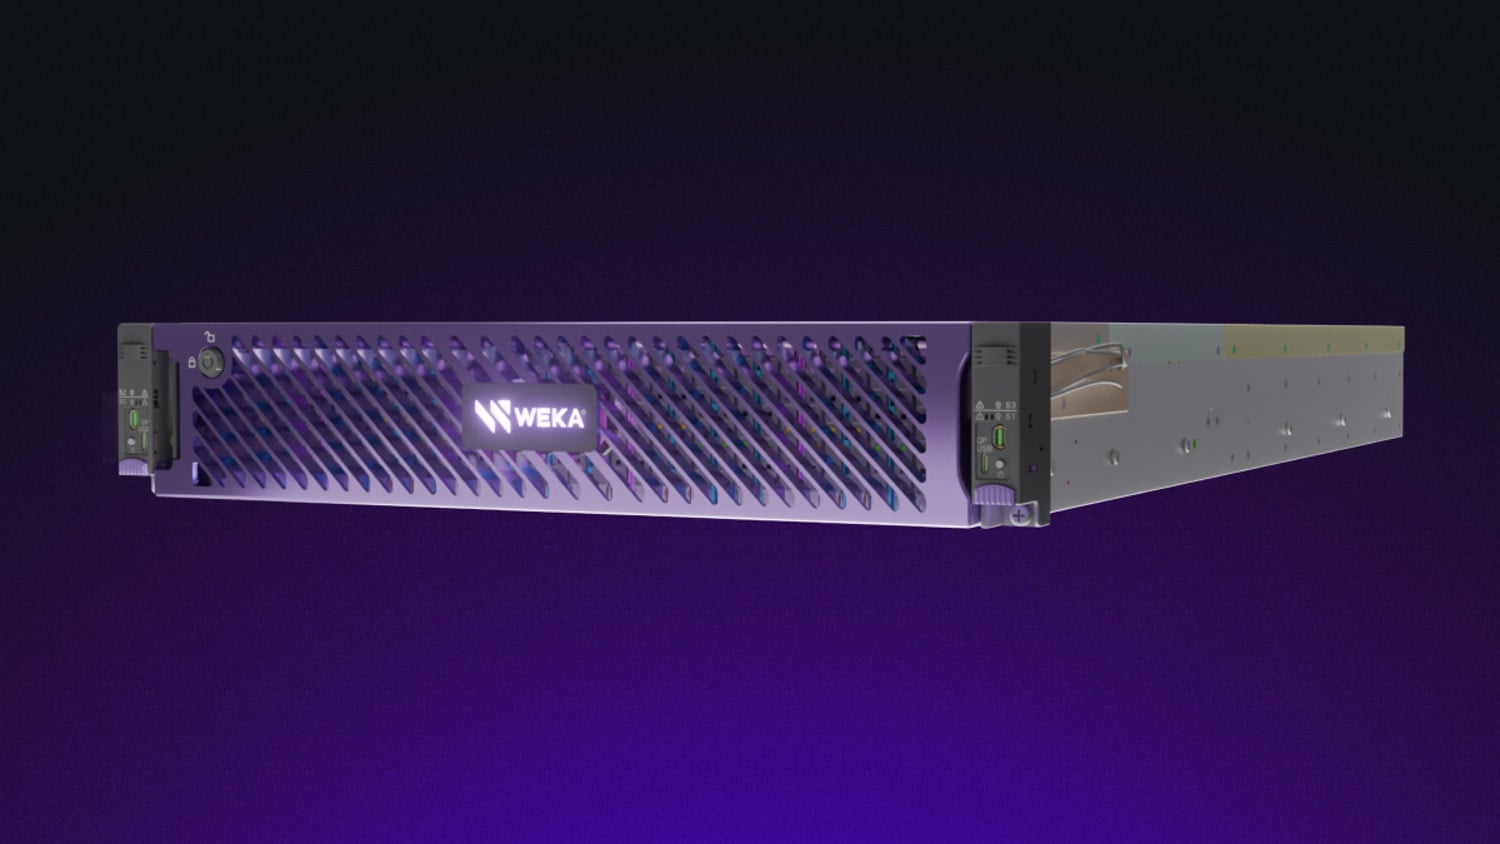
El diseño se basa en una estructura interna PCIe Gen 6, una interconexión de unidades mediante cable en lugar de un backplane, conectividad Ethernet Spectrum-X mediante la red NVIDIA ConnectX SuperNIC y una arquitectura térmica gestionada por software, diseñada para funcionar a 35 °C de temperatura ambiente, que limita la potencia NVMe en caso de estrés térmico en lugar de apagar el sistema. WEKA cuenta con varias patentes pendientes para el chasis, la interconexión de unidades, la gestión térmica y el diseño de facilidad de mantenimiento. Entre las características de facilidad de mantenimiento se incluyen unidades de arranque de conexión en caliente con un proceso de reemplazo guiado por interfaz gráfica de usuario que, según WEKA, tarda unos 10 minutos en lugar de varias horas de mantenimiento, además de una implementación a escala de rack sin monitor y basada en la nube a través de NeuralMesh Home.
Tres configuraciones para diferentes prioridades de carga de trabajo.
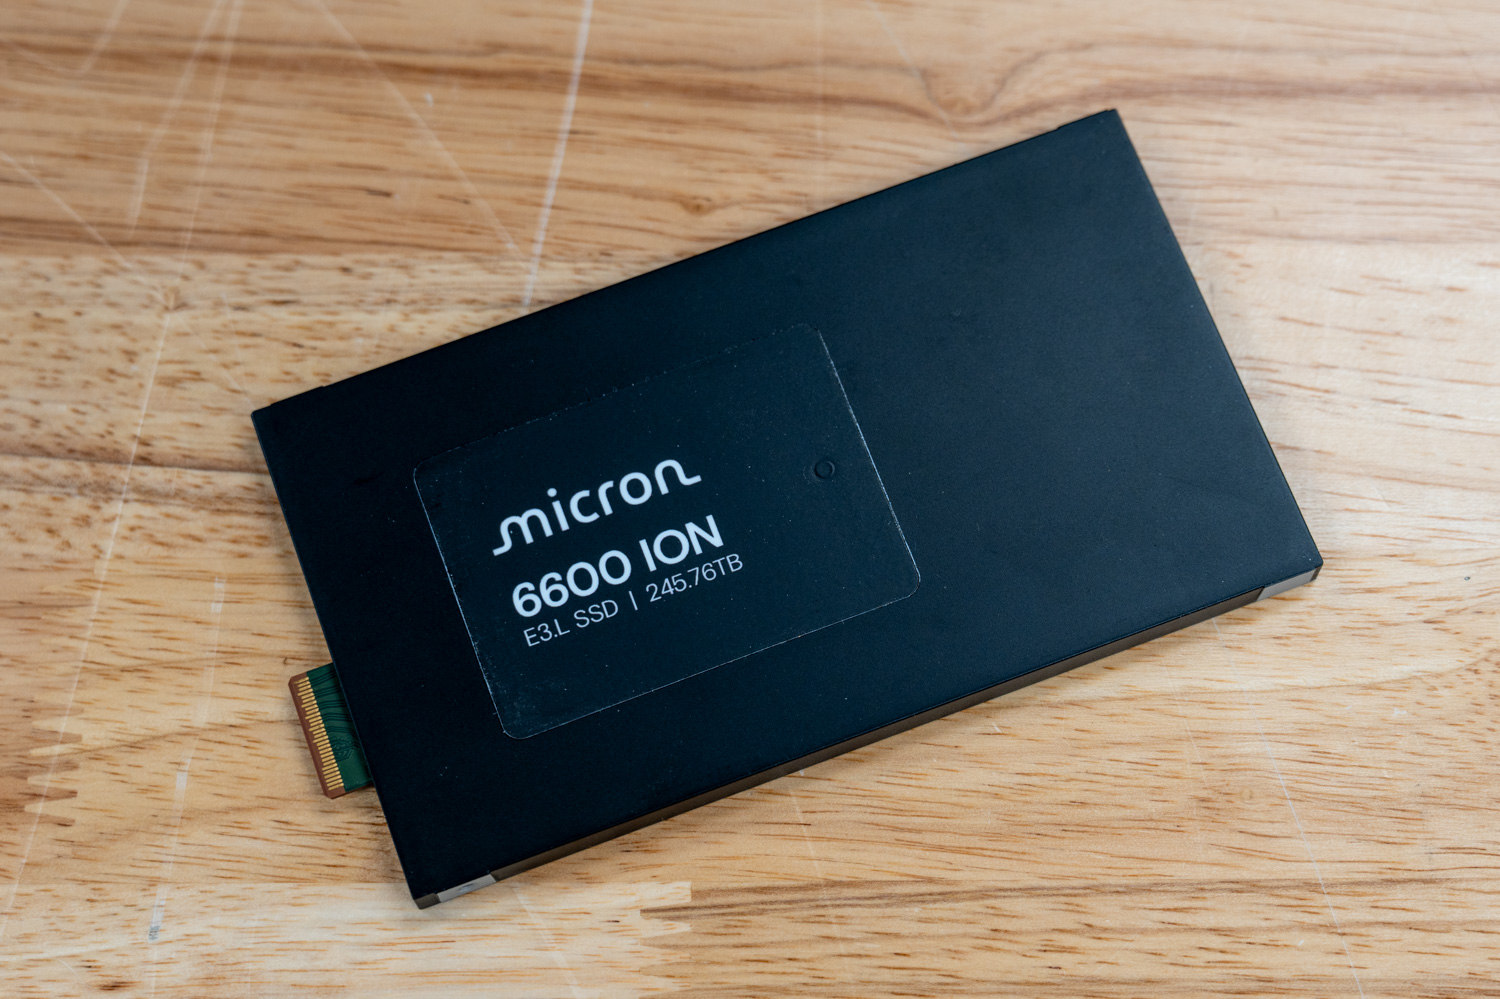
WEKApod Nitro está diseñado para cargas de trabajo donde el ancho de banda de almacenamiento es crítico, asegurando que las GPU permanezcan saturadas. Cuenta con un chasis de dos unidades de rack y cuatro nodos con cuatro dominios de fallo independientes y 56 unidades TLC, compatible con la red NVIDIA ConnectX de doble puerto que ofrece un rendimiento de 800 Gb/s. WEKApod Prime enfatiza la capacidad y el rendimiento equilibrados con una combinación AlloyFlash de unidades TLC y QLC, alojada en un chasis similar de cuatro nodos y dos unidades de rack que admite 56 unidades. WEKApod Prime Max maximiza la capacidad en un formato compacto: un chasis de dos unidades de rack y dos nodos que contiene 70 unidades NVMe, utilizando SSD 6600 ION de 245.76 TB de Micron , combinado con las técnicas de almacenamiento de objetos y reducción de datos de NeuralMesh, para lograr una capacidad efectiva de 1.1 exabytes en un solo rack de 56U. Para que se hagan una idea de cómo afecta esa unidad a las operaciones en rack, nuestro informe sobre potencia y densidad del 6600 ION calcula que un exabyte cabe en seis racks en lugar de 22.
AlloyFlash, la función de estratificación que hace viables las configuraciones Prime y Prime Max, enruta automáticamente las operaciones sensibles a la latencia a la memoria flash TLC, mientras que dirige los datos de gran capacidad a la memoria QLC, que resulta entre un 30 % y un 40 % más económica por terabyte, sin necesidad de configuración por parte del cliente. Este es el punto más claro en el que la versión de software NeuralMesh 6 y la versión de hardware WEKApod 3 constituyen un solo producto: la lógica de estratificación del software permite utilizar las configuraciones de hardware de mayor densidad con niveles de rendimiento de producción, en lugar de simplemente aumentar la capacidad en las especificaciones técnicas.
WEKA basa su decisión sobre hardware en las limitaciones actuales de los centros de datos: la construcción de centros de datos en EE. UU. disminuyó en 2025 por primera vez desde 2020, las listas de espera para la conexión a la red eléctrica en los principales mercados ahora duran entre cuatro y siete años, y Morgan Stanley pronostica un déficit de energía de 49 gigavatios en EE. UU. hasta 2028. Esto se suma a los problemas de suministro de memoria NAND y a los plazos de entrega más largos de los fabricantes de equipos originales (OEM). WEKA argumenta que el almacenamiento ineficiente en cuanto a espacio en rack y energía compite directamente con las GPU por los recursos físicos limitados. Al gestionar su propia cadena de suministro de hardware en lugar de depender de los canales de los OEM, cree que puede ofrecer precios y plazos de entrega más predecibles para los clientes que planifican proyectos de infraestructura a gran escala.
Jason Hardy, vicepresidente de tecnología de almacenamiento en NVIDIA, dijo que la red Ethernet Spectrum-X le da a WEKApod 3 el tejido de alto ancho de banda y baja latencia necesario para mantener despejada la ruta de datos del almacenamiento a la GPU a gran escala. Steve McDowell, analista jefe de NAND Research, argumentó que la inferencia a escala de producción es un problema de infraestructura diferente al del entrenamiento, donde los tokens por rack, los tokens por vatio y el costo por inferencia bajo carga sostenida se convierten en las métricas que importan, un cuadro de puntuación que, según él, los compradores deberían usar para evaluar a cada proveedor. Jeremy Werner, vicepresidente sénior y gerente general de la unidad de negocio de centros de datos principales de Micron, agregó que la nueva arquitectura WEKApod con las SSD de 245 TB de Micron ofrece 15.8 petabytes en un espacio de 2U, lo que preserva energía y espacio para computación adicional.
Disponibilidad
Se prevé que NeuralMesh 6 esté disponible para el público en general en la segunda mitad de 2026. Los clientes actuales de WEKA pueden actualizar sin coste adicional a través de los canales habituales. WEKApod Nitro, Prime y Prime Max ya están disponibles para pedidos a través de la red de distribuidores y revendedores de WEKA, con entregas a partir del otoño de 2026 y NeuralMesh 6 preinstalado. Además, por primera vez en esta generación, WEKApod se ofrece en versiones configurables, lo que permite a los clientes elegir el tipo de chasis, la memoria, la capacidad de almacenamiento y el número de discos, admitiendo sistemas desde menos de 1 PB hasta 100 PB o más en una sola configuración.


 Amazon