

Los sistemas de IA de escritorio basados en la GPU GB10 de NVIDIA tienen una función específica, y la cumplen a la perfección: ofrecer 128 GB de memoria unificada y un petaflop de capacidad de procesamiento en un escritorio lo suficientemente cerca del usuario como para que la iteración sea instantánea. Sin embargo, carecen de conexión con el almacenamiento que la organización ya utiliza. Cada DGX Spark y sus variantes OEM incluyen una única ranura M.2 de corta capacidad, lo que limita la capacidad local a unos 4 TB y deja cada conjunto de datos, modelo y punto de control de esa máquina fuera del control de gobernanza, los controles de acceso, las copias de seguridad y el registro de auditoría del centro de datos. Si multiplicamos esto por un laboratorio, un departamento o un campus, el resultado son docenas de islas aisladas de 4 TB, cada una con su propia copia de los mismos modelos y conjuntos de datos, y cuya seguridad depende únicamente del escritorio en el que se encuentra.
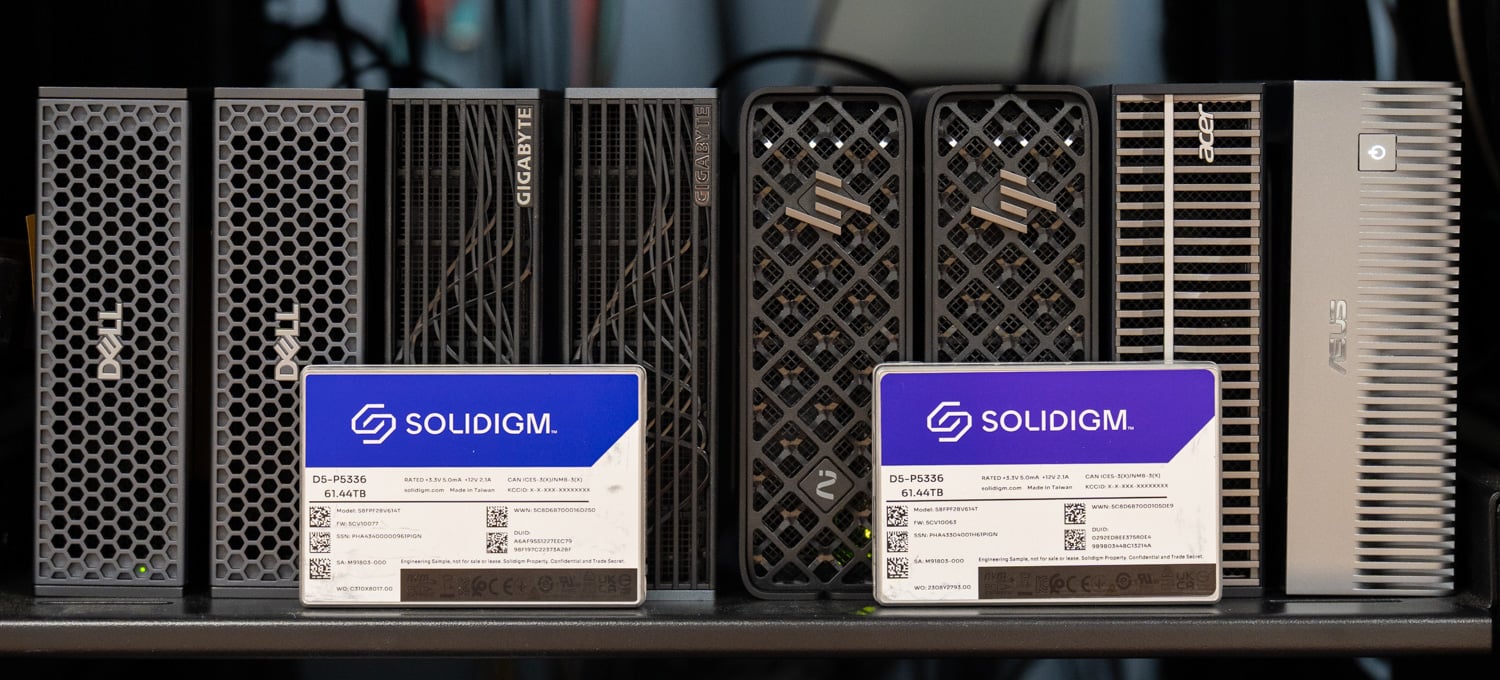
Este proyecto traslada el problema del almacenamiento al centro de datos. Construimos un host de almacenamiento compartido DGX Spark a partir de un Dell PowerEdge R770AP, ocho SSD Solidigm D5-P5336 QLC en Graid SupremeRAID RAID 5, red Broadcom de 400 GbE y Tuxera Fusion que sirve NFS sobre RDMA, y luego conectamos ocho Sparks a sus puertos de 100 GbE. Cada Spark en la estructura monta el mismo grupo de almacenamiento gobernado y protegido por paridad con una sola línea; una sola copia de cada modelo y conjunto de datos les sirve a todos, ninguna estación de trabajo necesita más almacenamiento del que viene incluido, y los propios Sparks pueden estar en el rack junto al array, donde son más fáciles de proteger, refrigerar y compartir. El objetivo de esta construcción es dónde residen los datos, y cualquier servidor NVMe con NIC rápidas podría desempeñar ese papel. La Universidad Estatal de Oregón, que está explorando la posibilidad de crear un laboratorio Spark a gran escala para el aprendizaje de IA y quiere dar a los estudiantes acceso a conjuntos de datos de investigación que se miden en decenas de terabytes, compartió su visión con nosotros mientras diseñábamos la implementación, y para datos de esa magnitud, el almacenamiento compartido fue el enfoque que mejor se ajustaba a esta evaluación.
Puntos Clave
- Un único array, ocho Sparks, sin software cliente: Ocho unidades DGX Spark de cinco fabricantes diferentes montan recursos compartidos NFS/RDMA desde una única matriz Solidigm D5-P5336 QLC detrás de Graid SupremeRAID y Tuxera Fusion, a través de los puertos 100GbE que ya tienen, con un montaje de una sola línea en Ubuntu estándar.
- Los modelos alojados se cargan como si fueran locales: Un modelo Qwen3.5-122B-A10B-NVFP4 de 78 GB se cargó desde la matriz compartida en 269.6 segundos en un Spark, lo que representa un 13 % menos que los 239.6 segundos que necesitó el mismo Spark desde su NVMe interno, y ocho Sparks que cargaron la misma copia simultáneamente tardaron entre 232.8 y 326.5 segundos.
- Una sola copia reemplaza un silo en cada escritorio: Los modelos y conjuntos de datos almacenados en centros de datos con gestión de red y protección de paridad reemplazan las copias por estación de trabajo en unidades M.2 de 4 TB. Esto aumenta la utilización, reduce la cantidad de datos copiados y evita que Spark necesite una actualización de almacenamiento o espacio físico. Para un laboratorio de aprendizaje de IA a gran escala como el que está explorando la Universidad Estatal de Oregón, donde los conjuntos de datos de investigación alcanzan decenas de terabytes, este enfoque se ajusta al caso de uso evaluado.
- Las unidades de disco establecen el límite superior, y la red tiene margen de maniobra: Con los ocho Sparks leyendo simultáneamente, la matriz RAID 5 de ocho discos alcanzó una velocidad máxima cercana a los 25 GiB/s, aproximadamente 214 Gb/s, lo que representa el 27 % de los 800 Gb/s que pueden transmitir las dos tarjetas de red Broadcom BCM57608 del host. Una lectura de un Spark desde la matriz a 10.8 GiB/s iguala la velocidad de la unidad M.2 interna más rápida que hemos medido en un sistema GB10.
- La gobernanza viene con el protocolo: NFS con RDMA coloca las carpetas por usuario, los conjuntos de datos compartidos y los modelos alojados en un único espacio de nombres con integraciones con Active Directory, Kerberos y LDAP, lo que permite que los datos permanezcan bajo el control del centro de datos mientras los Sparks se trasladan al rack.
El problema de tener una isla de IA en cada escritorio
El DGX Spark y sus variantes OEM de Dell, GIGABYTE, HP, Acer y ASUS comparten la plataforma GB10 y el mismo límite de almacenamiento. En nuestro análisis original del DGX Spark , el almacenamiento fue la limitación más evidente de la plataforma. La ranura interna admite unidades M.2 cortas, por lo que las unidades SSD de cliente de 8 TB que vienen en el formato 2280 no caben físicamente. El Luisuantech GP Spark que analizamos en agosto resuelve este problema con una carcasa M.2 de cuatro bahías conectada a un puerto 100GbE, lo que supone una solución limpia para un Spark en un escritorio y, a escala de laboratorio, un silo más grande en cada escritorio.
La capacidad es solo la mitad del problema; la otra mitad es qué sucede con los datos una vez que llegan a una máquina de escritorio. Un modelo de 78 GB descargado a un Spark es una copia que nadie en TI puede ver. Un conjunto de datos de investigación almacenado en memoria flash local es una copia fuera del programa de copias de seguridad, fuera de la política de acceso y fuera de las auditorías institucionales. Diez Sparks en un laboratorio significan diez copias de los mismos pesos que consumen 780 GB de memoria flash que podría usarse para otra cosa, y diez lugares donde un conjunto de datos puede salir de la oficina con la máquina. El problema se agrava a medida que aumenta el número, ya sean sistemas GB10 o cualquier infraestructura de IA de escritorio. Toda organización que haya administrado una flota de portátiles conoce este patrón, y la solución fue la misma entonces: mantener los datos en almacenamiento compartido en el centro de datos y dejar que el punto final sea un punto final.
Afortunadamente, NVIDIA diseñó el Spark con puertos para que esto funcione. Cada unidad lleva dos jaulas QSFP56 en un ConnectX-7 integrado, con un límite de plataforma de 200 Gb de ancho de banda utilizable detrás de un par de enlaces PCIe Gen5 x4. En nuestra revisión del clúster DGX Spark , describimos la configuración de rol dividido en la que una jaula se conecta a un Spark par y la otra al almacenamiento. Este proyecto usa una jaula por Spark para almacenamiento a 100 GbE, dejando la segunda libre para clúster o ancho de banda adicional. A 100 GbE, cada Spark tiene aproximadamente 12.5 GB/s de ancho de banda teórico hacia el host de almacenamiento, lo que supera el ancho de banda proporcionado por la ranura M.2 interna en la mayoría de estos sistemas.
Una vez que los datos se encuentran en el otro extremo de ese enlace, el rol del Spark cambia. Se convierte en un punto final de computación con una unidad de arranque y una unidad de caché local, y la capacidad ya no se adquiere por estación de trabajo. Un modelo o conjunto de datos se escribe una sola vez y lo lee cada cliente, por lo que la utilización del almacenamiento aumenta y la cantidad de copias disminuye. La protección de datos se traslada a una matriz con protección de paridad en un chasis de servidor, y el control de acceso, el cifrado en reposo, la copia de seguridad y la auditoría se realizan donde ya se realizan para todo lo demás. Y como el Spark ahora solo necesita alimentación y un enlace de 100 GbE, no hay razón para que esté en un escritorio. Instalado en un rack junto al host de almacenamiento, es más fresco, más silencioso, está físicamente seguro y disponible para quien lo necesite.
El host de almacenamiento
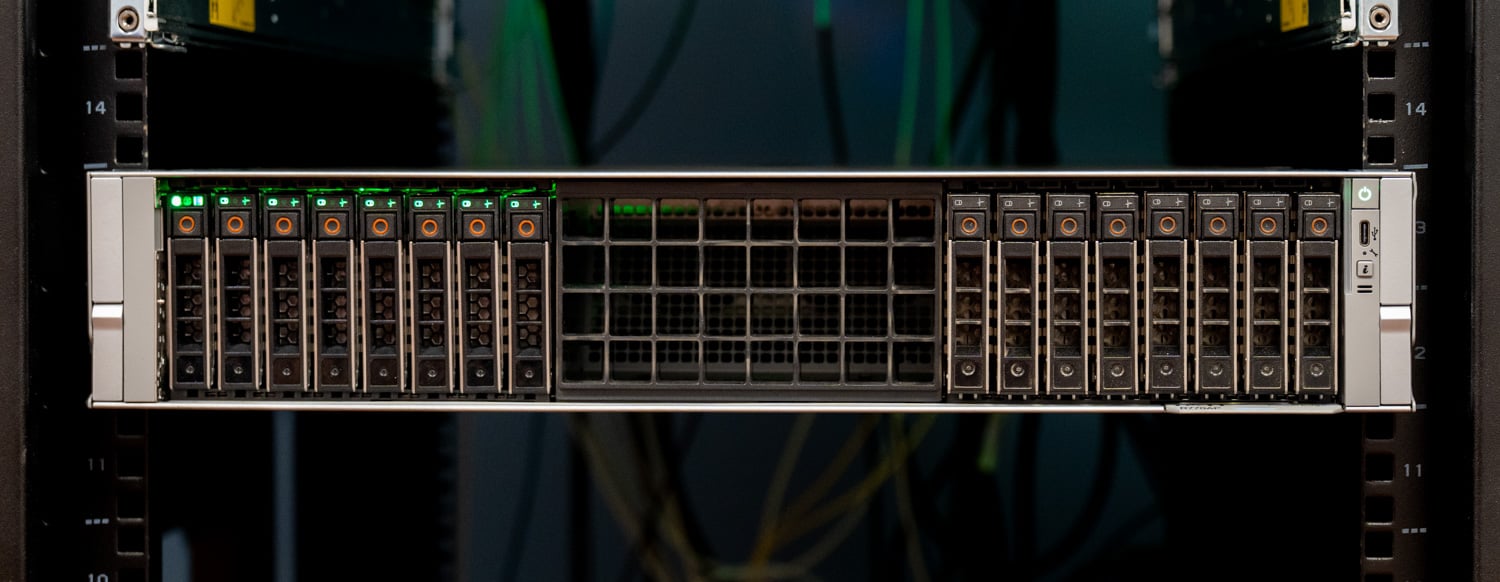
El host de almacenamiento es un Dell PowerEdge R770AP , la misma plataforma 2U Xeon 6 que analizamos a principios de este año, y lo usamos porque estaba disponible en el laboratorio cuando comenzó el proyecto. Cualquier servidor NVMe con espacio para NIC rápidas y una GPU pequeña podría cumplir la función, y el R770AP es una opción para configurarlo, aunque quizás un poco sobredimensionado. El nuestro utiliza dos procesadores Xeon 6 6978P con 1.5 TB de DDR5 distribuidos en 24 DIMM, usa uno de sus dos bancos de ocho bahías NVMe Gen5 y conecta las unidades y la GPU Graid a la CPU 0, con los dos adaptadores 400GbE a la CPU 1. El servidor ejecuta Ubuntu 24.04.
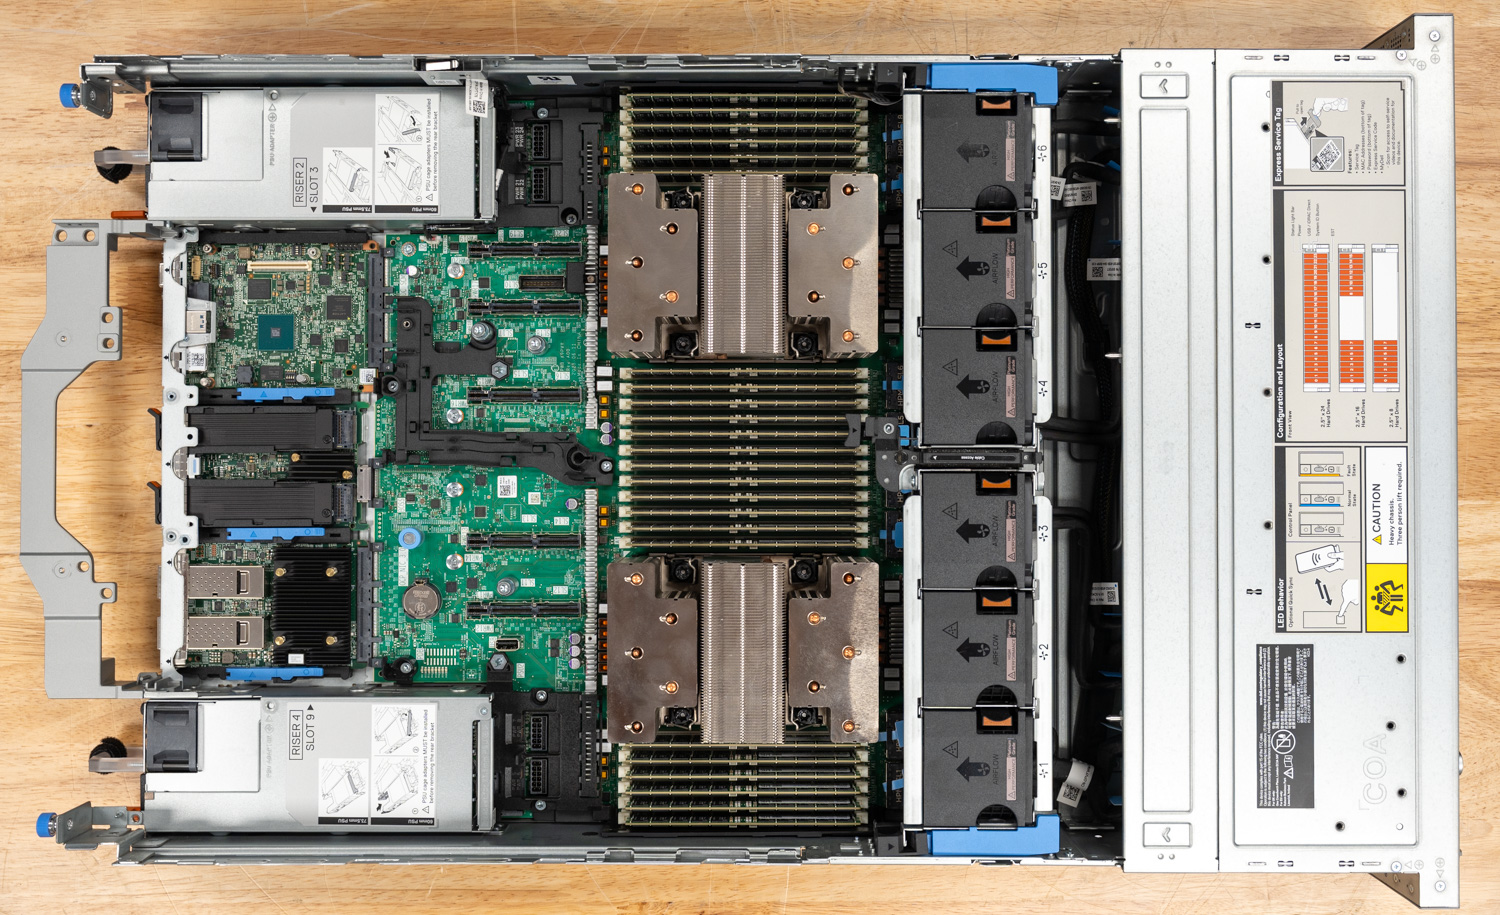
| Componente | Configuración del host de almacenamiento |
|---|---|
| Server | Servidor Dell PowerEdge R770AP, 2U, 16 bahías NVMe Gen5 de 2.5 pulgadas |
| CPU | 2 procesadores Intel Xeon 6 6978P |
| Salud Cerebral | 1.5 TB DDR5 (24 x 64 GB) |
| Almacenaje | 8x Solidigm D5-P5336 61.44 TB U.2 PCIe 4.0 QLC (491.52 TB sin formato) |
| RAID | Graid SupremeRAID, RAID 5 en las ocho unidades, GPU NVIDIA RTX A2000 en la CPU 0 |
| Sistema de archivos | XFS en la unidad virtual SupremeRAID |
| servidor de archivos | Tuxera Fusion (Fusion NFS, compilación de vista previa privada), NFS 4.1 sobre RDMA (RPC-RDMA en el puerto 20049), modo de usuario |
| Networking | 2x Broadcom BCM57608 (Thor 2) de un solo puerto 400GbE, PCIe Gen5 x16 en la CPU 1, RoCEv2 |
| Interruptor | Dell PowerSwitch Z9864F-ON, 64 puertos 800 GbE OSFP112, Enterprise SONiC |
| Enlaces de clientes | Óptica de 800G dividida en 8x100GbE, un enlace por Spark, cuatro Sparks por NIC de almacenamiento en VLAN separadas. |
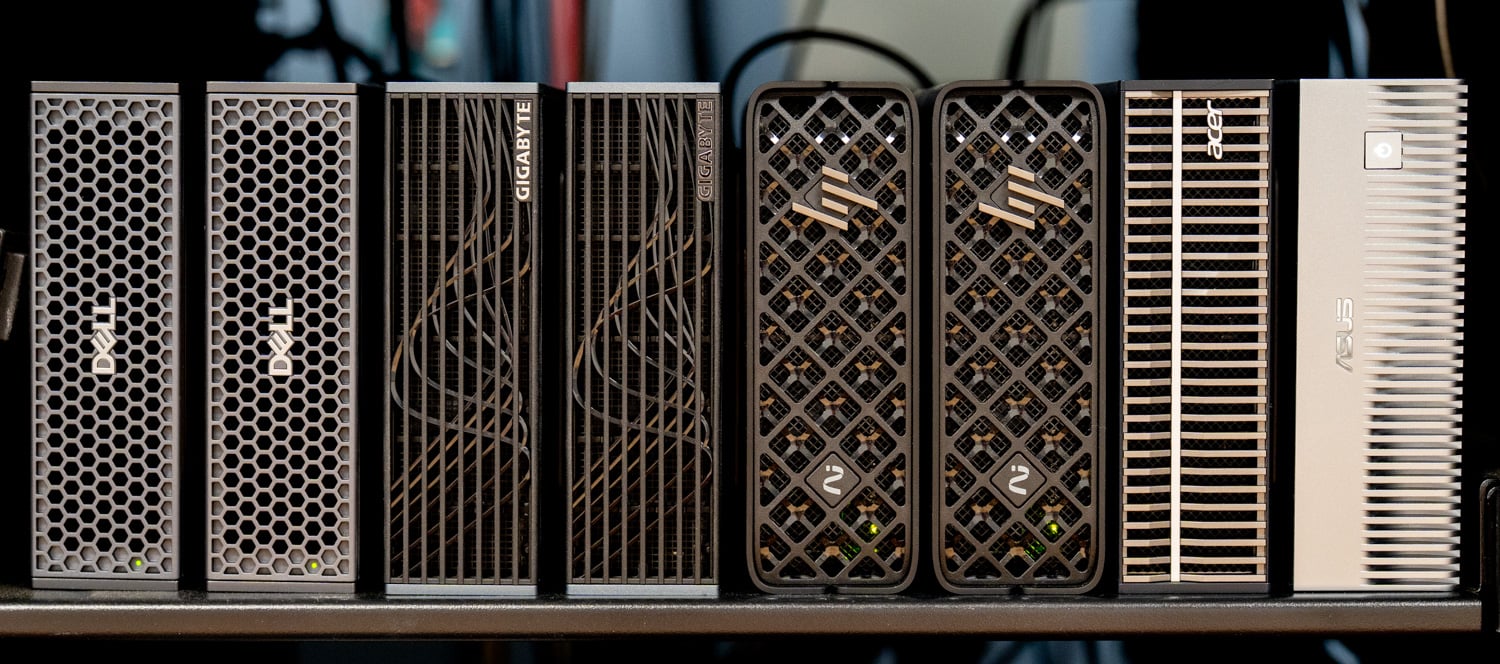
| Nuestros Clientes | 2x Dell Pro Max con GB10, 2x GIGABYTE AI TOP ATOM, 2x HP ZGX Nano G1n, Acer Veriton GN100, ASUS Ascent GX10 |
| OS | Ubuntu LTS 24.04 |
¿Por qué QLC y por qué el D5-P5336?
En nuestras conversaciones con la Universidad Estatal de Oregón sobre el concepto del laboratorio Spark, la capacidad fue el primer requisito, ya que los conjuntos de datos de investigación involucrados son grandes. La función de este servidor es almacenar todo lo que una sala llena de Sparks pueda necesitar y servirlo en un formato que pueda ser leído por muchos clientes a la vez. Ese es un perfil de alta capacidad, con gran cantidad de lecturas, y es el perfil para el que se diseñó QLC. La familia D5-P5336 abarca desde 7.68 TB hasta 122.88 TB; las unidades U.2 de 61.44 TB utilizadas aquí están clasificadas por Solidigm con hasta 7,000 MB/s de lectura secuencial, 3,000 MB/s de escritura secuencial, 1.005 M de IOPS de lectura aleatoria de 4K y 65.2 PBW de resistencia, o 0.58 escrituras de unidad por día durante cinco años, en NAND QLC de 192 capas con una unidad de indirección de 16 KB.
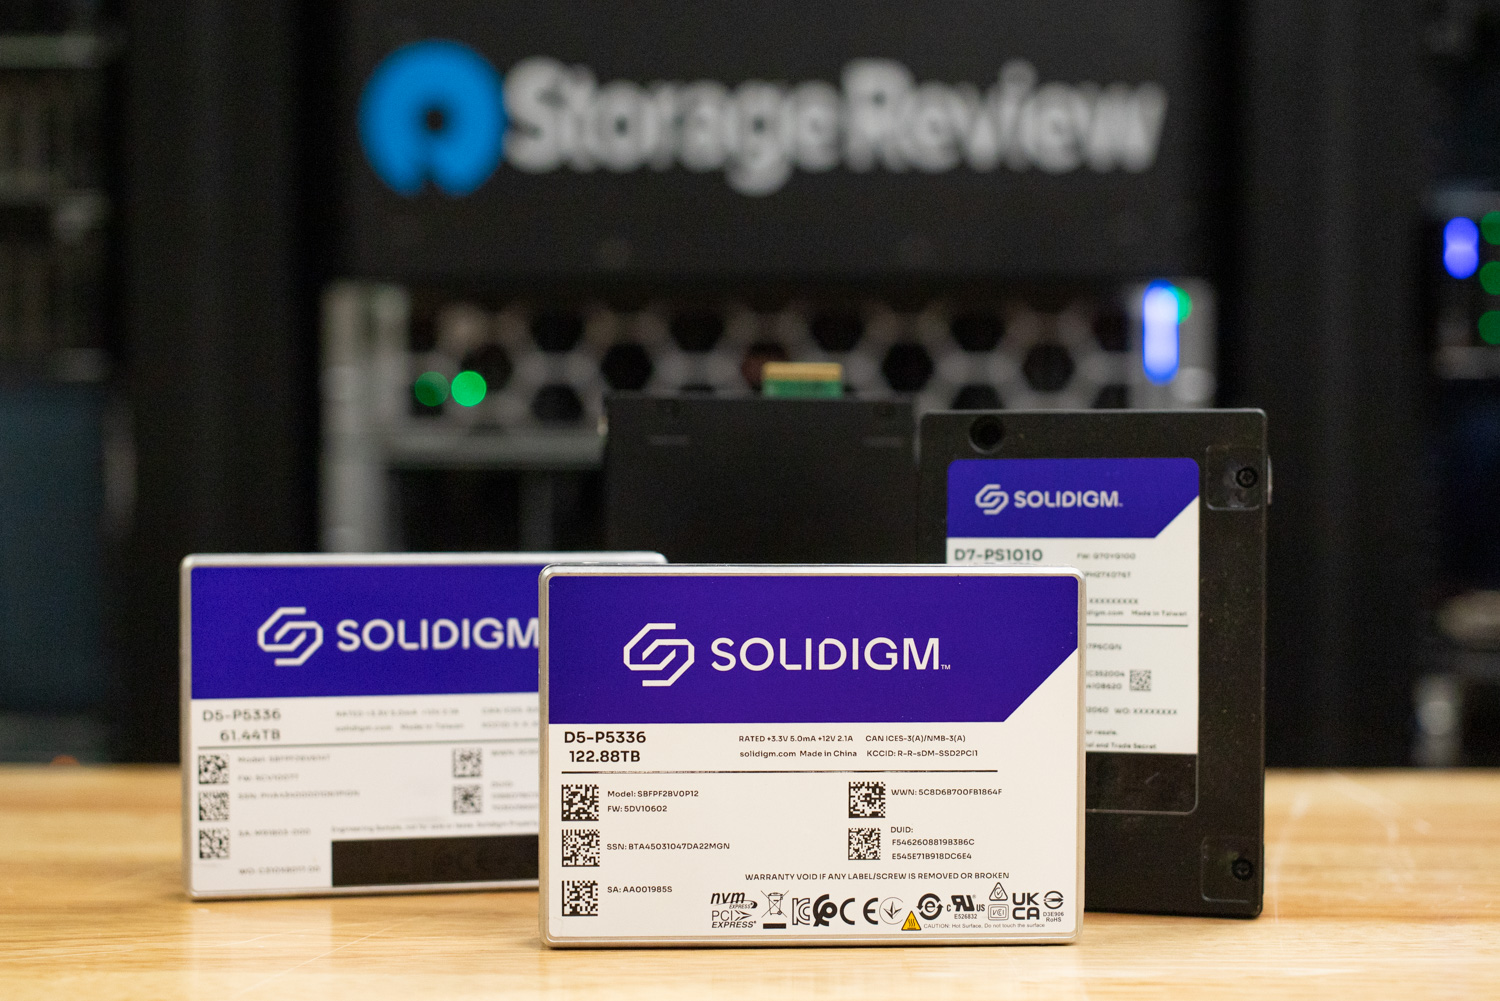
Las ocho unidades de 61.44 TB ocupan la mitad de las bahías frontales del R770AP, y en una configuración de producción se podría elegir cualquier capacidad dentro de la gama y cualquier número de bahías. Aun así, ocho unidades en RAID 5 proporcionan aproximadamente 430 TB de espacio útil con tolerancia a fallos de una sola unidad. Esto es más de 100 veces la capacidad de una ranura M.2 de Spark y suficiente para la biblioteca de modelos de un departamento, los conjuntos de datos compartidos con los que trabajan los estudiantes y los directorios personales de cada usuario. Ocupar las otras ocho bahías duplica esa capacidad sin modificar el diseño de la red, y las especificaciones de dimensionamiento que se muestran más adelante en este análisis demuestran por qué las unidades son el componente clave para el crecimiento.
La unidad de indirección de 16 KB es importante para esta carga de trabajo porque la IU más grande de Solidigm sacrifica la eficiencia de escritura aleatoria pequeña a cambio de densidad y costo, y para una partición que sirve modelos y conjuntos de datos, las escrituras aleatorias pequeñas son el caso minoritario. La carga de modelos son lecturas secuenciales grandes. La transmisión de conjuntos de datos son lecturas secuenciales grandes. Los puntos de control y los archivos de los estudiantes se escriben una vez y se leen con frecuencia. La división del trabajo resultante es la adecuada para un laboratorio Spark: la matriz QLC compartida almacena todo lo que es leído por muchos, y el M.2 propio de Spark maneja el tráfico de escritura temporal y de intercambio que es escrito por uno.
RAID en una GPU: Graid SupremeRAID
El RAID NVMe en ocho unidades Gen4, cada una capaz de leer a 7,000 MB/s, es el punto en el que una tarjeta RAID de hardware convencional se convierte en el cuello de botella porque cada byte debe pasar por la ranura PCIe de la tarjeta. El RAID por software se enfrenta a un conjunto diferente de desafíos de recursos. Graid SupremeRAID descarga los cálculos de paridad a una GPU y mantiene la ruta de datos en los carriles PCIe del host, razón por la cual hemos visto que escala a más de 180 GB/s en nuestras pruebas SupremeRAID AE con 16 unidades. Para este host, ejecutamos SupremeRAID en una NVIDIA RTX A2000, una GPU de estación de trabajo pequeña.
Las ocho unidades D5-P5336 se borraron de forma segura y se llenaron secuencialmente antes de entregarlas a Graid, donde se configuraron como una única matriz RAID 5. La unidad virtual resultante se formateó con XFS y se administró mediante Tuxera. RAID 5 es el nivel adecuado para un recurso compartido de este tipo: un fallo en una unidad mantiene la matriz en línea, las reconstrucciones se realizan sin desconectar los datos del usuario y la pérdida de capacidad es de una unidad por cada ocho. RAID 6 o RAID 10 serían opciones razonables para una implementación en producción que priorice la protección durante el período de reconstrucción sobre la capacidad, y SupremeRAID admite ambas.
La red: Broadcom 400GbE y un núcleo de 800G.
El lado de almacenamiento de la estructura son dos adaptadores Broadcom BCM57608 Thor 2 en el R770AP, cada uno una NIC de 400 GbE de un solo puerto en una interfaz PCIe Gen5 x16. Broadcom posiciona el BCM57608 como la NIC de 400 G de menor consumo de energía de la industria, y su conjunto de características lo hace una buena opción: RoCEv2 con control de congestión DCQCN mejorado, enrutamiento adaptativo, arranque seguro con una raíz de confianza de silicio y descarga de cifrado kTLS en línea. RoCEv2 transmite NFS sobre RDMA en este diseño, y el control de congestión evita que varios clientes interfieran entre sí cuando todos comienzan a extraer datos simultáneamente. Durante la compilación, el controlador bnxt_en informó que los módulos ópticos en los puertos de 400 G alcanzaban su umbral de advertencia de 70 °C bajo carga sostenida. Solucionamos esto con un pequeño ajuste del perfil del ventilador en el R770AP, y las NIC funcionaron sin problemas a partir de entonces.
Ambas NIC se conectan a un Dell PowerSwitch Z9864F-ON , el switch central de 800G de nuestro laboratorio, que ejecuta Enterprise SONiC. El Z9864F-ON cuenta con 64 puertos OSFP112 a 800 GbE y puede dividirlos en 2x400G, 4x200G u 8x100G. Un módulo óptico de 800G dividido en 8x100G conecta los ocho Sparks, un enlace cada uno, al mismo switch que termina los dos enlaces de almacenamiento de 400G. Cada NIC de 400G se encuentra en su propia VLAN y da servicio a cuatro Sparks, por lo que el host de almacenamiento presenta dos destinos RDMA y la carga se divide equitativamente entre ellos por diseño. En la práctica, se trata de una topología de velocidad completa: 8 x 100 G de ancho de banda para clientes en un lado, 2 x 400 G de ancho de banda para almacenamiento en el otro, y un conmutador con una capacidad de 102.4 Tbps en el medio.
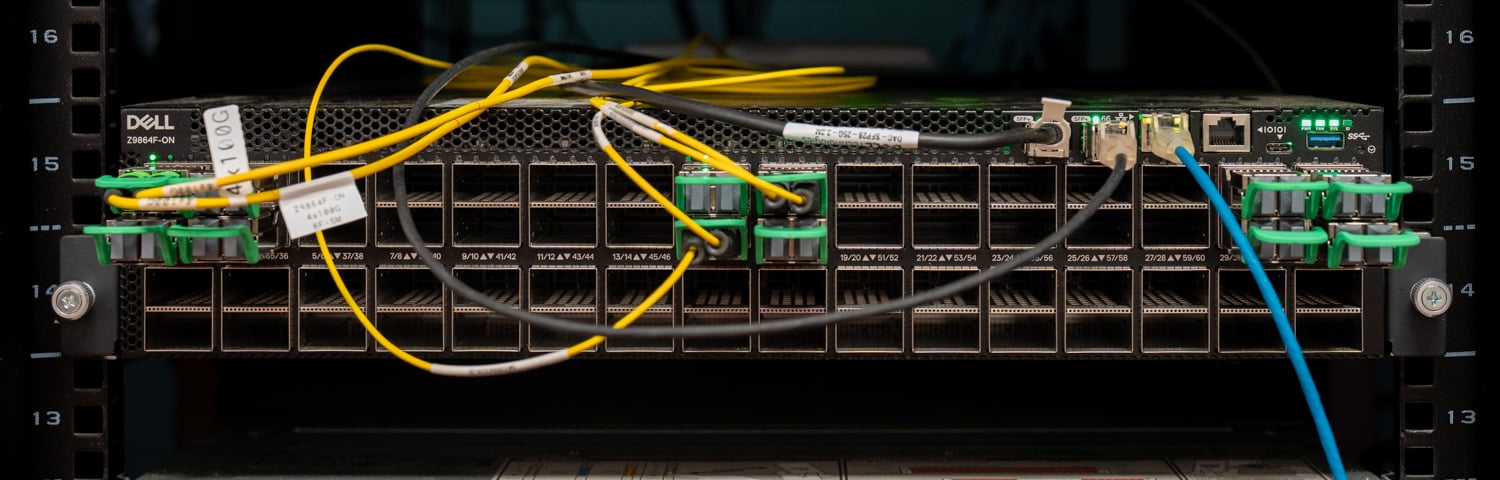
Validamos la estructura antes de que cualquier software de almacenamiento la utilizara. Las pruebas de servidor a servidor entre el R770AP y un segundo host a través de los enlaces de 400G se ejecutaron a velocidad de línea en ambas direcciones, y el tráfico RDMA de los Sparks confirmó que los puertos de salida de 100G funcionaban a máxima velocidad. Una vez que los ingenieros de Tuxera configuraron los recursos compartidos NFS, iperf3 desde los Sparks a sus respectivas NIC mostró una velocidad sostenida de 99 Gbps con cuatro flujos paralelos y cero retransmisiones.
¿Por qué NFS y por qué Tuxera?
Con Graid presentando un dispositivo de bloques rápido, el host de almacenamiento podría servir a los Sparks como destinos de bloques NVMe-oF o recursos compartidos de archivos. Probamos la ruta de bloques en la revisión de GP Spark y funciona bien para un cliente. Para un laboratorio con muchos Sparks, buscábamos otra solución. Los volúmenes de bloques son uno a uno; cada usuario necesitaría una LUN, y en el momento en que dos usuarios quieran el mismo conjunto de datos, se copia, que es el problema que este diseño busca eliminar. NFS es el punto medio del diagrama de Venn: un único espacio de nombres contiene conjuntos de datos compartidos, modelos alojados y carpetas por usuario. Cada montaje de Spark utiliza el cliente NFS ya integrado en Ubuntu, y las herramientas de Kubernetes y Slurm que una universidad implementaría en un laboratorio de Spark también utilizan NFS.
Fusion NFS es la parte NFS de Tuxera Fusion, el servidor de archivos multiprotocolo que cubre SMB y NFS en un núcleo multihilo en modo usuario; analizamos por primera vez Fusion SMB en un proyecto de flujo de trabajo multimedia de Solidigm y Tuxera en 2024. Tuxera afirma alcanzar hasta 22.7 GB/s a través de una única conexión 200 GbE con RDMA, superando a NFSD y Ganesha del kernel en las pruebas de la propia compañía, y el producto es compatible con NFS 4.1, clúster escalable activo-activo, conmutación por error transparente e integración con Active Directory, Kerberos y LDAP. Este último conjunto es el gancho de gobernanza: el mismo directorio que controla quién puede iniciar sesión en Spark también controla lo que pueden ver en el recurso compartido. Una advertencia se aplica a cada cifra de Tuxera en este artículo: la compilación que ejecutamos es una vista previa privada de Fusion NFS que, según Tuxera, no se ha optimizado completamente para el rendimiento, y el software aún no está disponible para la venta comercial. Su disponibilidad general está prevista para noviembre, después de SC'26.
Tuxera instaló Fusion en el R770AP, formateó el volumen Graid con XFS y configuró el servidor con NFS en el puerto estándar y RPC-RDMA en el puerto 20049, omitiendo los oyentes SMB ya que este proyecto solo utiliza NFS. La configuración inicial de subprocesos fue de cuatro subprocesos de protocolo, cada uno con ocho subprocesos para transmisión y recepción de transporte, datos VFS y metadatos VFS, lo que Tuxera describe como un punto de partida para la optimización. Los servicios de directorio se omitieron deliberadamente en la configuración de laboratorio; una implementación universitaria añadiría sus propios servicios de identidad. En el lado de Spark, montar el recurso compartido es un solo comando:
sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs
Esa única línea de código representa toda la integración del cliente, sin controlador, sin configuración del iniciador y sin software del proveedor en el Spark. Un usuario que inicie sesión en un Spark diferente mañana ejecutará la misma línea y verá los mismos archivos.
Prueba de configuración: Ocho Sparks en un conjunto de datos
Antes de cualquier trabajo de modelado, realizamos una verificación de cordura en cada Spark individualmente: una lectura fio secuencial de 1M con 16 trabajos y una profundidad de cola de 16 contra su propia carpeta en el array. Las ocho unidades devolvieron entre 10.0 y 11.2 GiB/s, saturando el enlace de 100 GbE en cada una. Luego realizamos un barrido para demostrar que las ocho podían soportar su parte de la carga. Cada ejecución mantiene un fijo de 16 hilos con una profundidad de cola de 16 en agregado y los distribuye entre uno, dos, cuatro y ocho Sparks, sobre cargas de trabajo secuenciales de 1M, aleatorias de 64K, secuenciales de 16K y aleatorias de 4K, con lectura y escritura, E/S directa, 60 segundos por prueba. Cada Spark escribe en su propia carpeta en el array, cuatro por NIC de almacenamiento, y no hay QoS en ninguna parte de la pila. Con los ocho módulos cargados simultáneamente, las lecturas secuenciales de 1M por unidad oscilaron entre 3.09 y 3.13 GiB/s, las lecturas aleatorias de 64K entre 6,648 y 6,779 IOPS, y las escrituras aleatorias de 4K entre 2,136 y 2,155 IOPS, en cinco fabricantes de equipos originales (OEM) en dos VLAN sin aplicación de equidad. Cada Spark llegó al array, cada Spark obtuvo una participación equitativa y la configuración estaba lista para la carga de trabajo importante.
| Spark (ocho clientes, 2 hilos x QD16 cada uno) | NIC de almacenamiento | Lectura secuencial de 1 millón | IOPS de lectura aleatoria 64K | IOPS de lectura aleatoria 4K | IOPS de escritura aleatoria 4K |
|---|---|---|---|---|---|
| Dell Pro Max con GB10 (1) | 1 | 3,176 MiB / s | 6,648 | 10,000 | 2,150 |
| ÁTOMO SUPERIOR DE IA DE GIGABYTE (1) | 1 | 3,195 MiB / s | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | 3,201 MiB / s | 6,696 | 10,100 | 2,136 |
| Acer Veriton GN100 | 1 | 3,194 MiB / s | 6,670 | 10,100 | 2,149 |
| Dell Pro Max con GB10 (2) | 2 | 3,184 MiB / s | 6,694 | 10,200 | 2,155 |
| ÁTOMO SUPERIOR DE IA DE GIGABYTE (2) | 2 | 3,187 MiB / s | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | 3,189 MiB / s | 6,678 | 10,100 | 2,151 |
| ASUS Ascent GX10 | 2 | 3,163 MiB / s | 6,734 | 10,300 | 2,145 |
Dimensionamiento del host: Dos tarjetas de red y amplio margen de capacidad.
El mismo análisis responde a la pregunta que un laboratorio o una empresa debe plantearse antes de comprar: ¿cuál es el límite y qué parte del host lo determina? Los cuatro paneles siguientes muestran el rendimiento de lectura en las cuatro cargas de trabajo a medida que la carga fija aumenta de un Spark a ocho; el análisis de escritura se explica en el texto y la tabla más abajo.
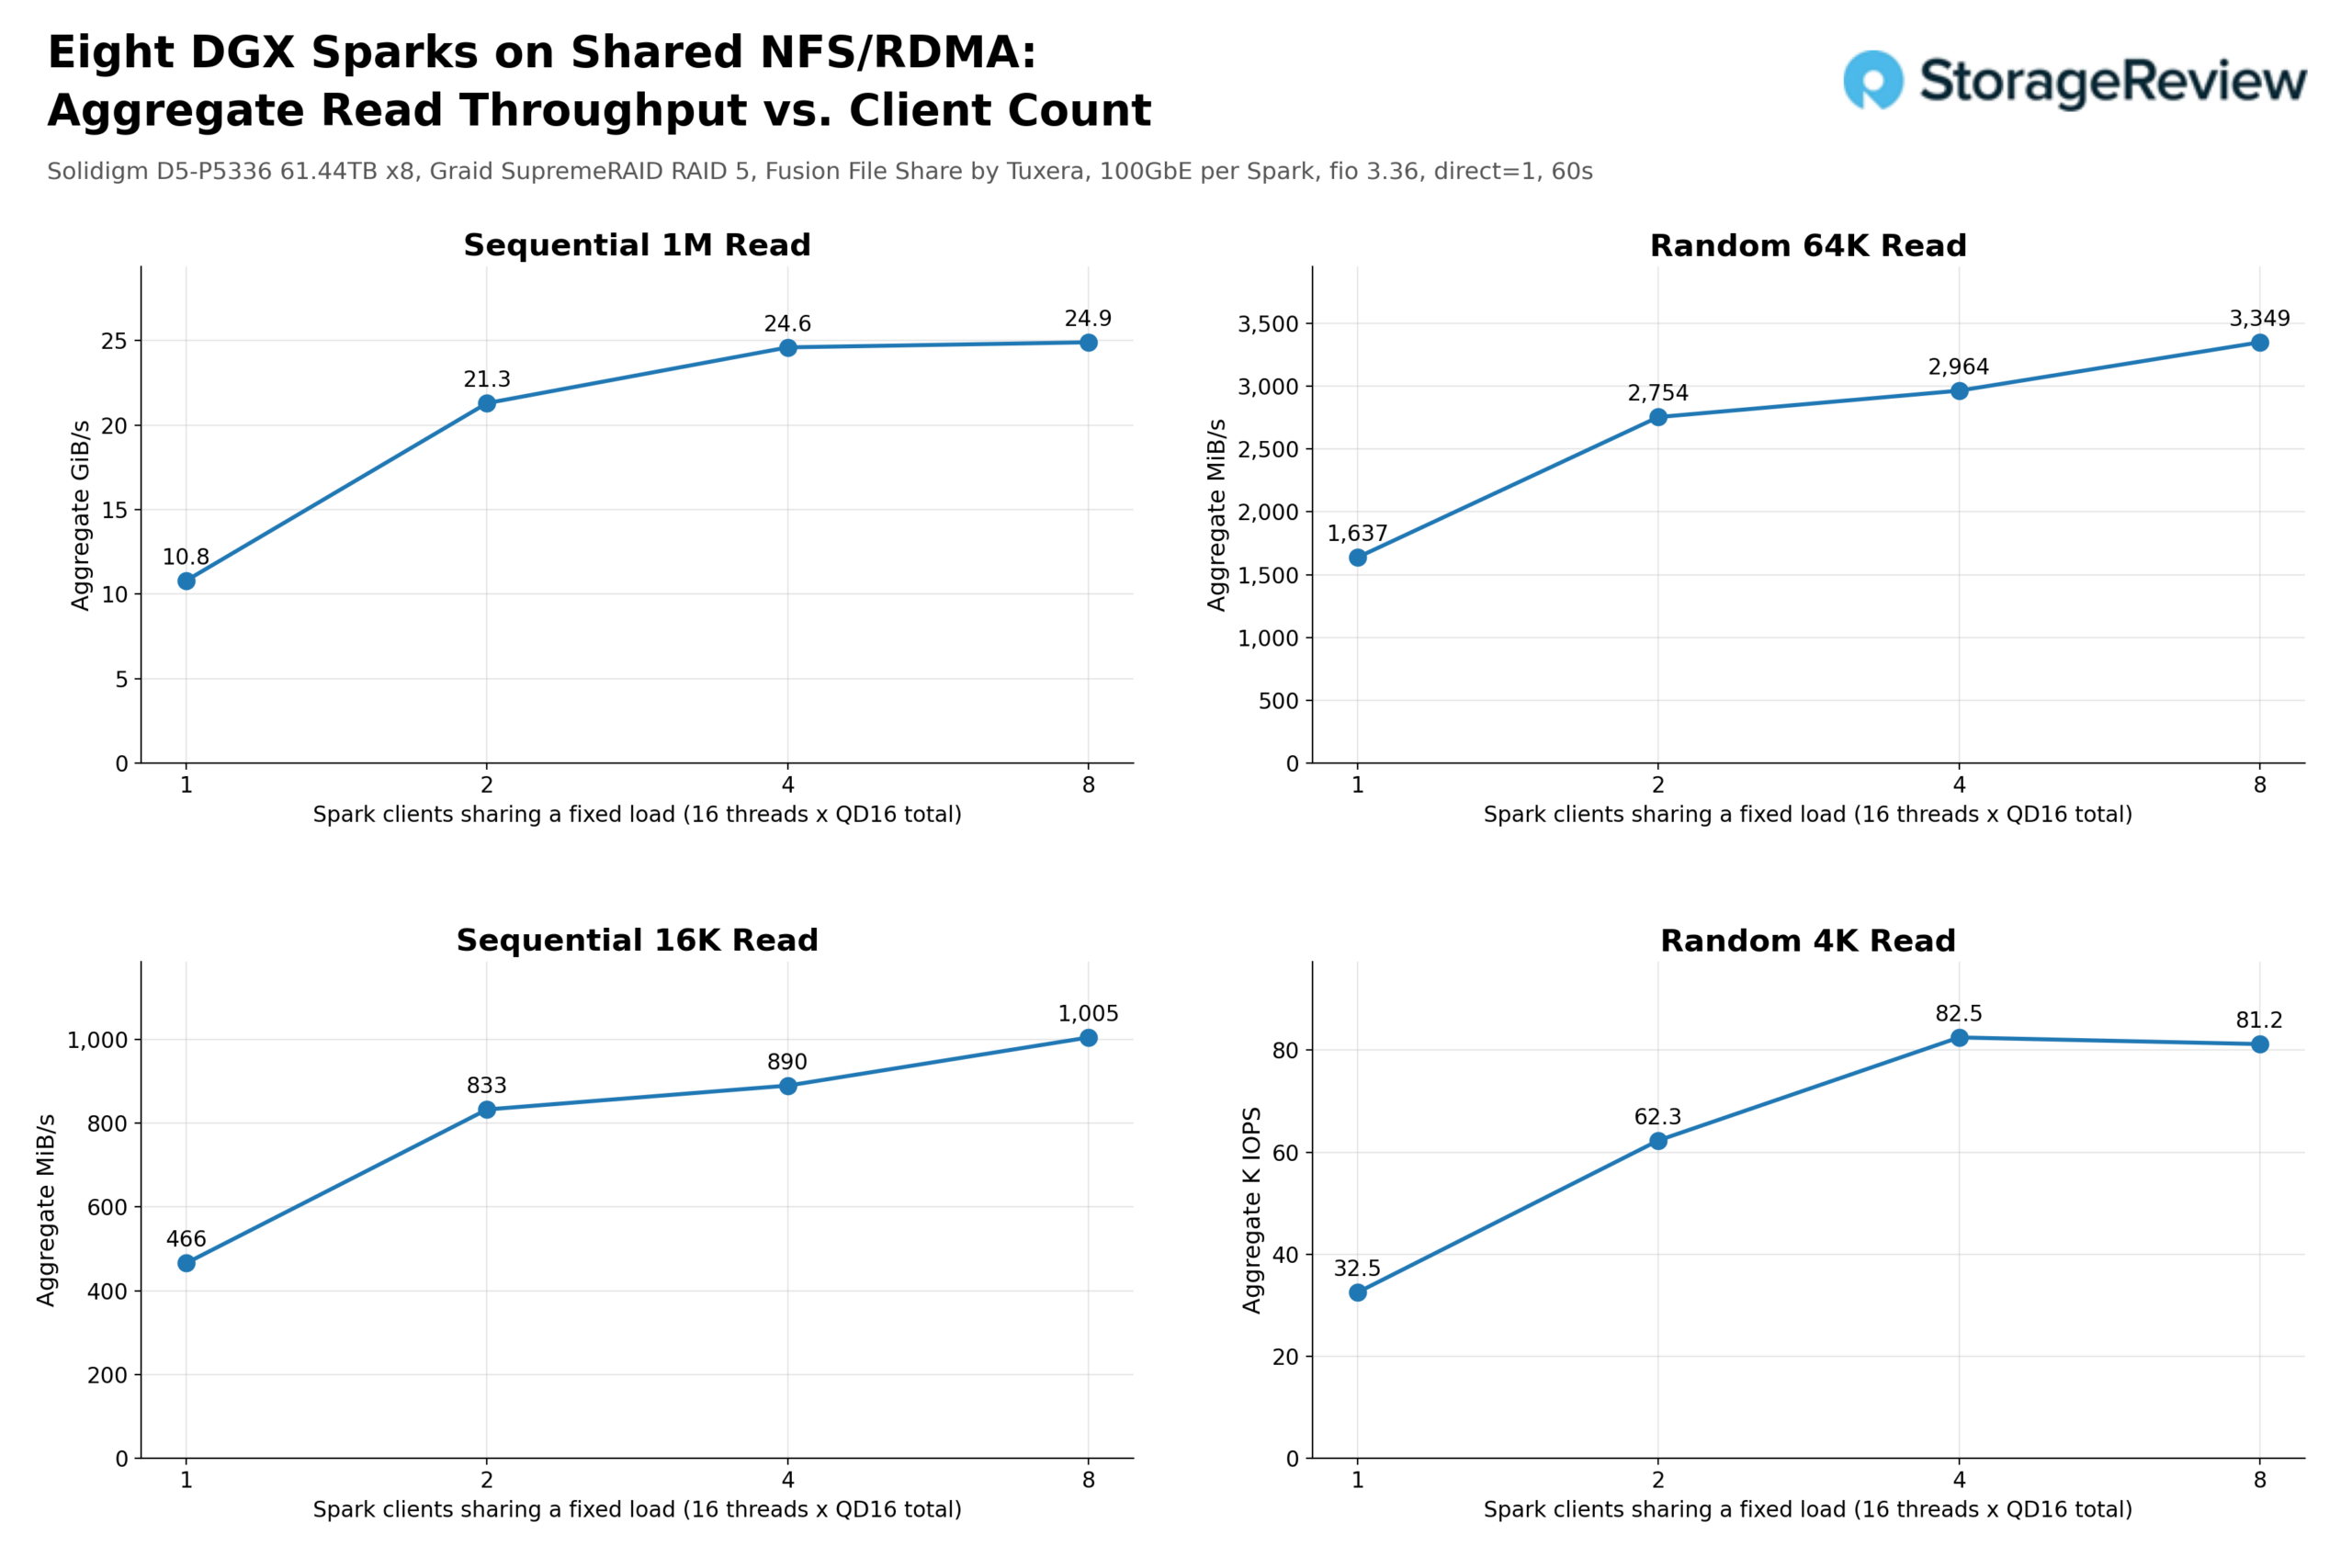
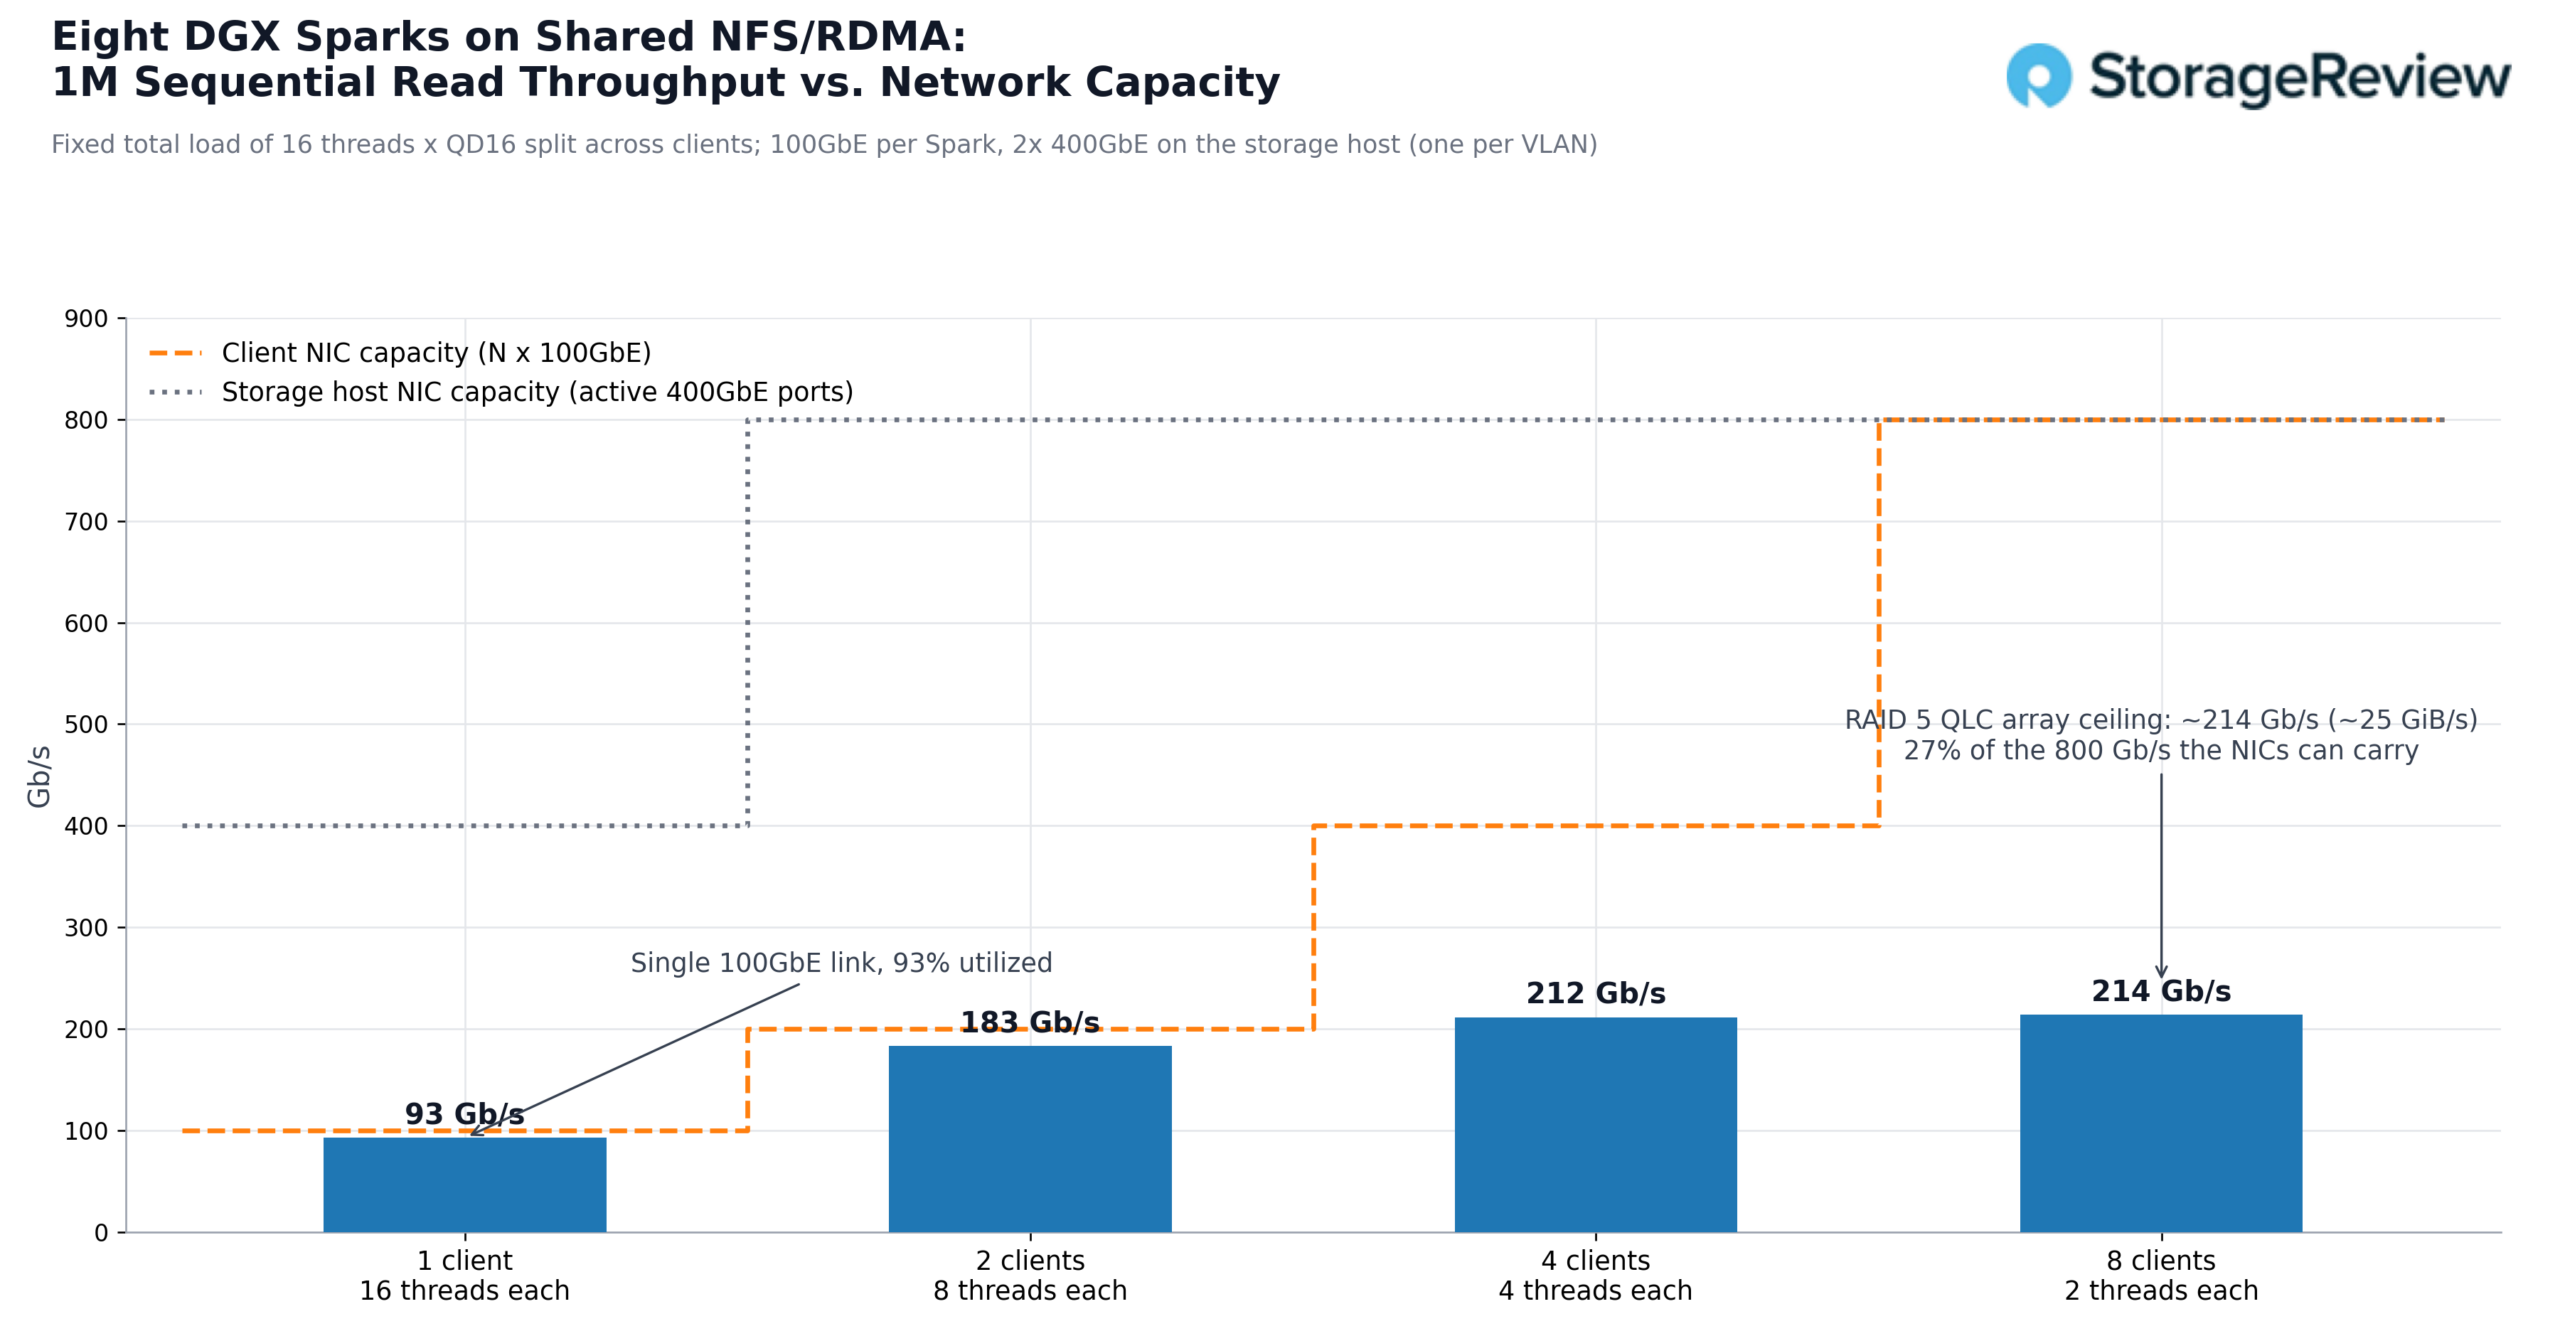
La lectura secuencial agregada de 1M aumentó de 10.8 GiB/s en un Spark a 21.3 GiB/s en dos, 24.6 GiB/s en cuatro y 24.9 GiB/s en ocho. En términos de red, esto equivale a 93 Gb/s, 183 Gb/s, 212 Gb/s y 214 Gb/s frente a los 800 Gb/s que pueden transmitir las dos tarjetas de red Broadcom 400GbE, por lo que con una carga completa de ocho clientes, el array utilizó el 27 % de la capacidad de red del host. La meseta cercana a los 25 GiB/s corresponde al array RAID 5 QLC de ocho discos; las tarjetas de red, el conmutador y los propios enlaces de 100 GbE de los Sparks nunca alcanzaron el límite.
Dos tarjetas de red del servidor ya cubren ocho Sparks a velocidad de línea, y también cubrirían las otras ocho bahías del R770AP: duplicar la cantidad de unidades, ya sea como una segunda matriz o un conjunto RAID más amplio, proporciona más ancho de banda de lectura a los mismos dos puertos, con espacio de sobra. Lo mismo ocurre con las E/S. Las lecturas aleatorias de 4K escalaron de 32.5K IOPS en un cliente a una meseta de aproximadamente 81K IOPS en cuatro clientes y más, con una latencia por E/S que disminuyó de 7.9 ms a 3.1 ms a medida que la cola de cada cliente se volvía menos profunda, y las lecturas aleatorias de 64K pasaron de 1,637 a 3,349 MiB/s, con la red muy por debajo de su límite en ambos casos.
La otra comparación importante es con el almacenamiento que ya tiene un Spark. En nuestras reseñas individuales de GB10, las lecturas GDSIO 1M desde el M.2 interno alcanzaron cerca de 11.2 GiB/s en el Acer Veriton GN100 y GIGABYTE AI TOP ATOM. El Dell Pro Max con GB10 y HP ZGX Nano G1n alcanzaron alrededor de 5.5 GiB/s, mientras que el ASUS Ascent GX10 se acercó a 5 GiB/s. En comparación, la caja NVMe-oF externa del Luisuantech GP Spark entregó 9.5 GB/s a través del mismo puerto 100GbE. Una sola lectura de Spark desde la matriz QLC compartida a 10.8 GiB/s iguala a las unidades internas más rápidas de ese grupo y aproximadamente duplica a la más lenta, a través de un cable, de los datos que cualquier otro Spark también puede leer. Las herramientas difieren: GDSIO en las unidades internas y fio sobre NFS aquí, por lo que esta es una comparación de rango.
A continuación se muestra el análisis completo, con cifras agregadas para las cuatro cargas de trabajo en cada número de clientes. Cada fila de lectura aumenta con el número de clientes hasta que el array se queda sin capacidad, y cada fila de escritura se mantiene constante desde un Spark hasta ocho, porque la ruta de paridad RAID 5 mantiene el array con un límite de escritura fijo, independientemente de cuántos clientes lo compartan. Para un recurso compartido diseñado para ser leído por muchos y escrito una sola vez durante la ingesta, ese es el perfil para el que se diseñó.
| Agregado (16 hilos en total) | 1 Spark | 2 Chispas | 4 Chispas | 8 Chispas |
|---|---|---|---|---|
| Lectura secuencial de 1 millón | 10.8 GiB/s | 21.3 GiB/s | 24.6 GiB/s | 24.9 GiB/s |
| Escritura secuencial de 1M | 2.4 GiB/s | 2.4 GiB/s | 2.4 GiB/s | 2.4 GiB/s |
| Lectura aleatoria 64K | 1,637 MiB / s | 2,754 MiB / s | 2,964 MiB / s | 3,349 MiB / s |
| Escritura aleatoria 64K | 722 MiB / s | 719 MiB / s | 723 MiB / s | 703 MiB / s |
| Lectura secuencial de 16K | 466 MiB / s | 833 MiB / s | 890 MiB / s | 1,005 MiB / s |
| Escritura secuencial de 16K | 57 MiB / s | 60 MiB / s | 62 MiB / s | 28 MiB / s |
| Lectura aleatoria 4K | 32.5K IOPS | 62.3K IOPS | 82.5K IOPS | 81.2K IOPS |
| Escritura aleatoria 4K | 17.8K IOPS | 17.7K IOPS | 17.5K IOPS | 17.2K IOPS |
Modelos de alojamiento en almacenamiento compartido
El análisis de Fio demuestra que la matriz y la red son más que capaces. La siguiente prueba importante para el caso de uso es si un modelo que reside en la matriz compartida se carga tan bien como un modelo que reside en el NVMe propio de Spark, porque ese es el flujo de trabajo del que depende todo el diseño: una copia, alojada centralmente, cargada por cualquier usuario. Elegimos Qwen3.5-122B-A10B en NVFP4, un modelo de mezcla de expertos con 122 mil millones de parámetros que ocupa 78 GB en disco y cabe en los 128 GB de memoria unificada de un solo Spark. Medimos el tiempo desde el lanzamiento del servidor de inferencia hasta que el servidor informó que estaba en buen estado, junto con el ancho de banda de almacenamiento promedio durante ese lapso, en tres escenarios: un Spark cargando desde su NVMe interno, el mismo Spark cargando a través de NFS/RDMA desde la matriz compartida, y los ocho Sparks cargando la misma copia única desde la matriz al mismo tiempo.
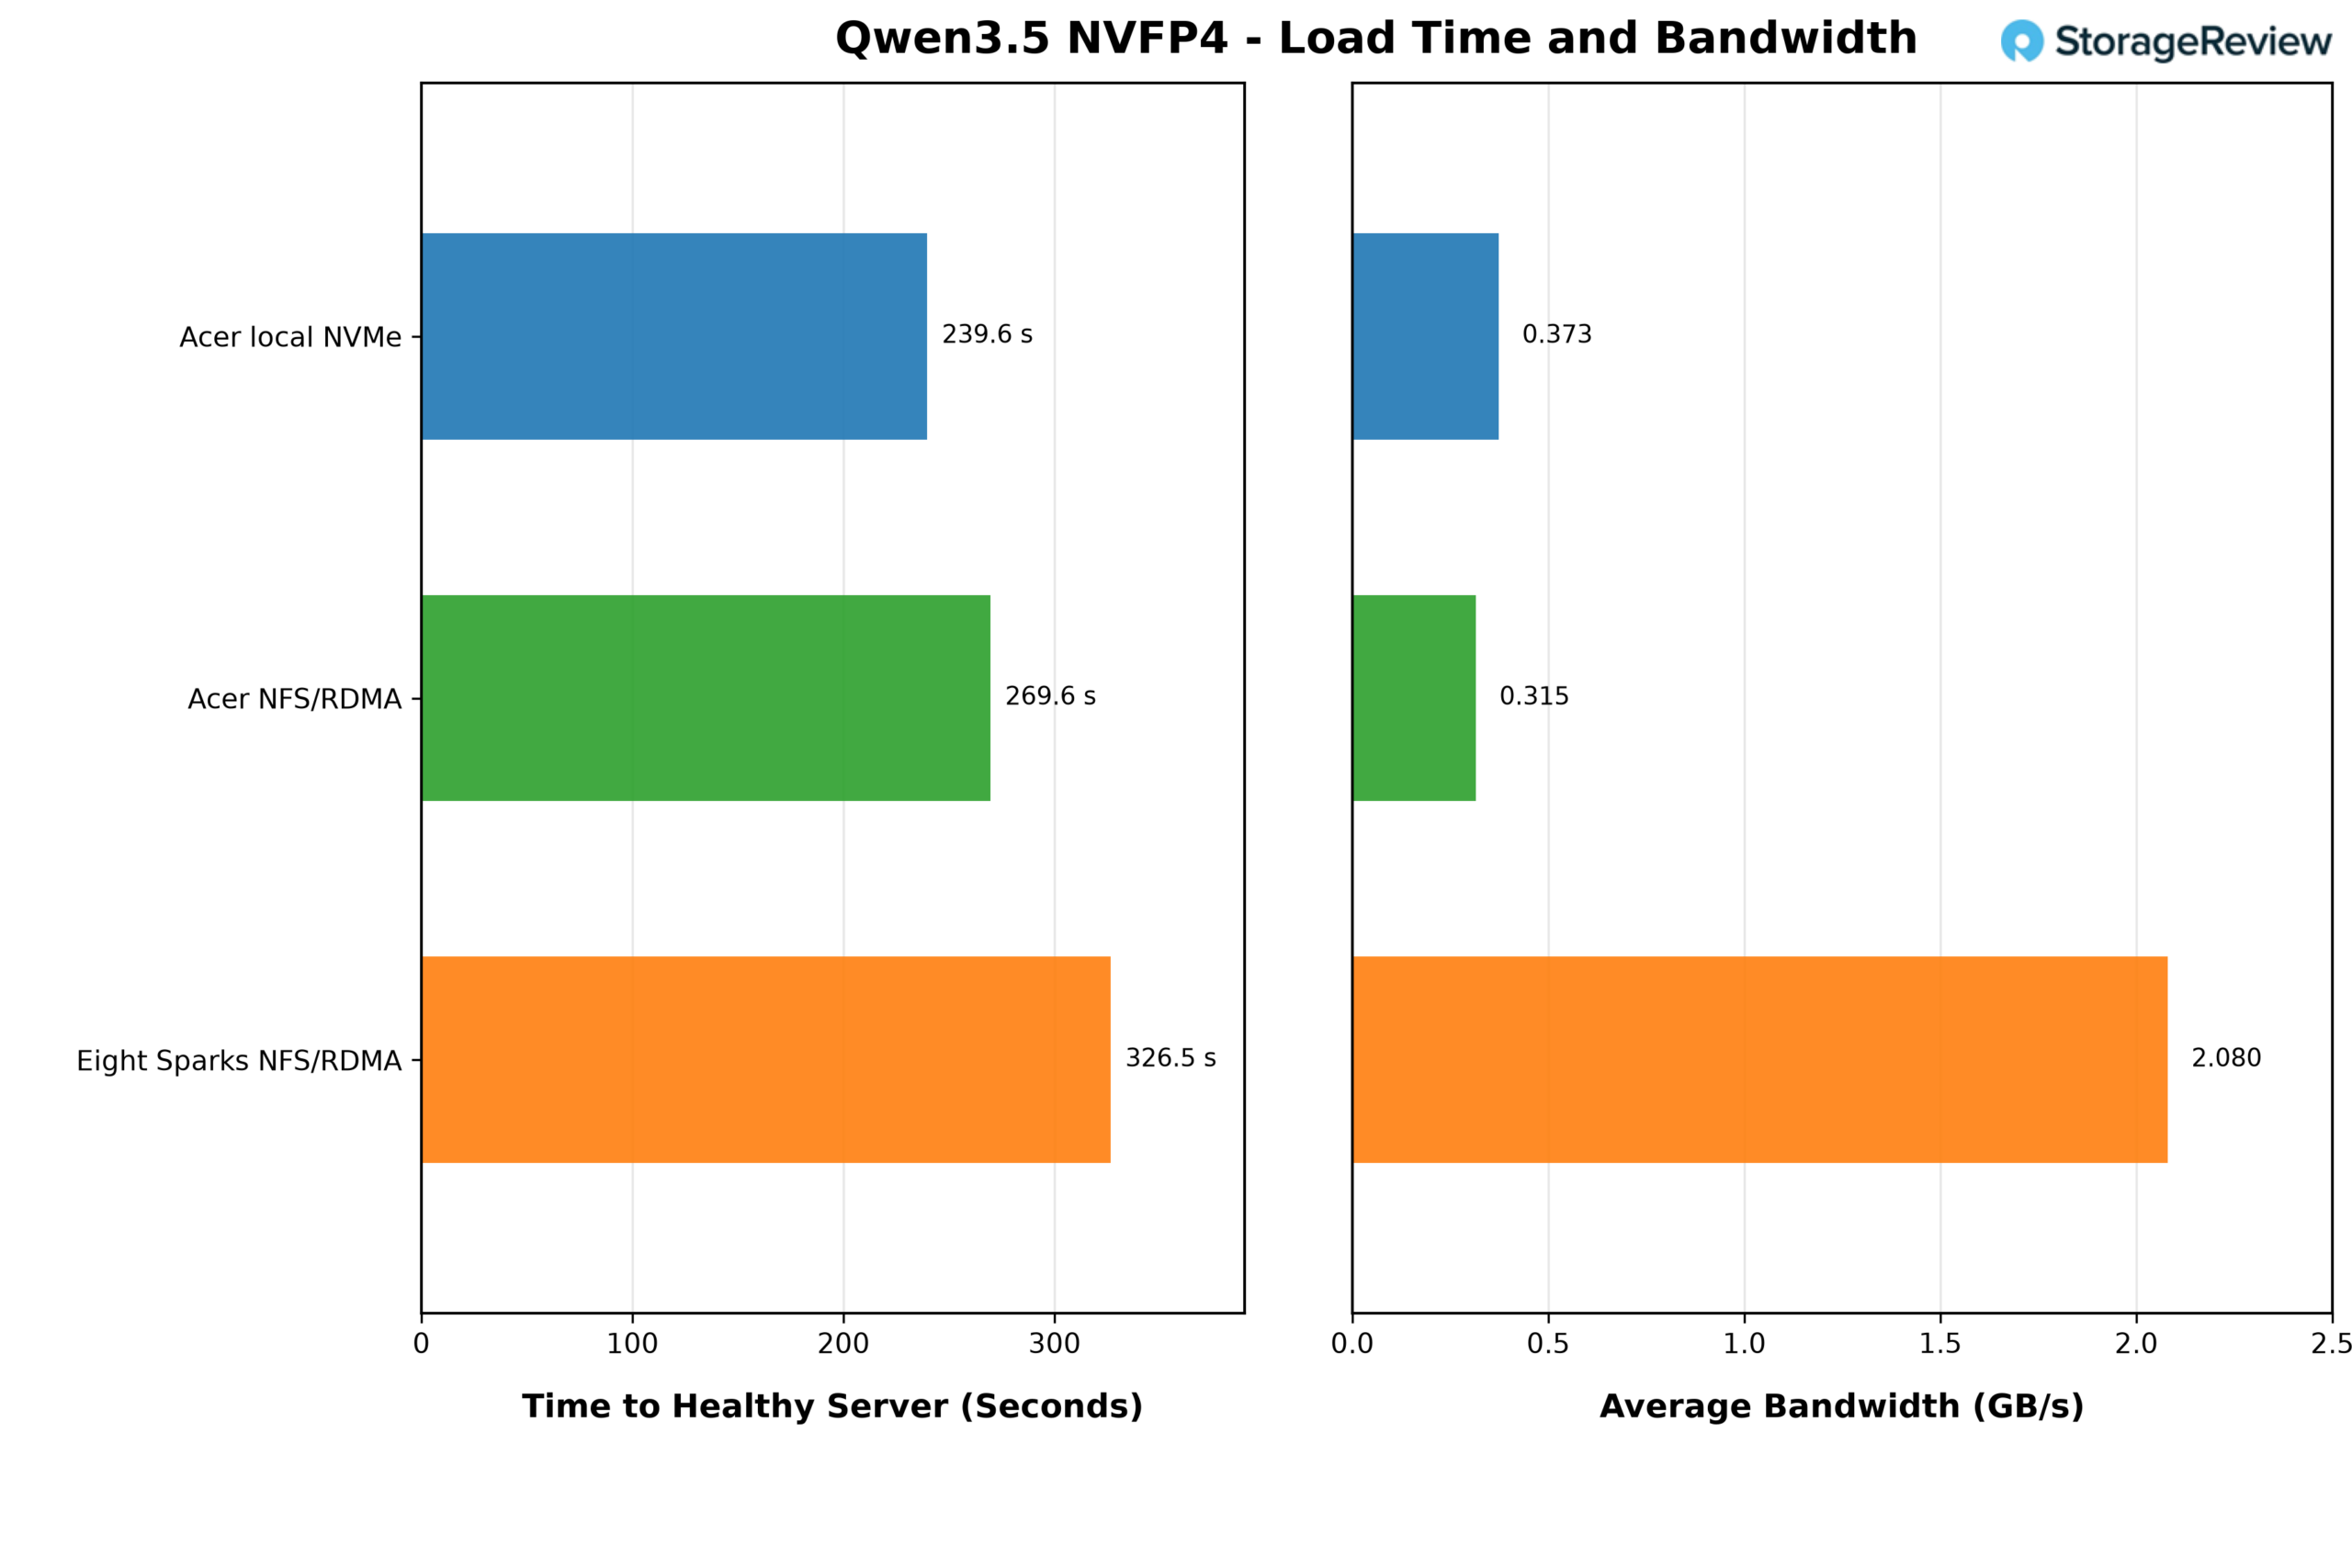
Desde la unidad NVMe interna, el Acer Veriton GN100 alcanzó un estado óptimo del servidor en 239.6 segundos a una velocidad media de 0.373 GB/s. Desde la matriz compartida a través de NFS/RDMA, el mismo Spark tardó 269.6 segundos a 0.315 GB/s, unos 30 segundos (un 13 %) más. Los promedios muestran que, con 78 GB en cuatro minutos, la carga del modelo en un Spark no está limitada por el almacenamiento en ninguno de los casos. El propio procesamiento de los pesos por parte del GB10 marca el ritmo, y el almacenamiento pasa la mayor parte del tiempo esperando.
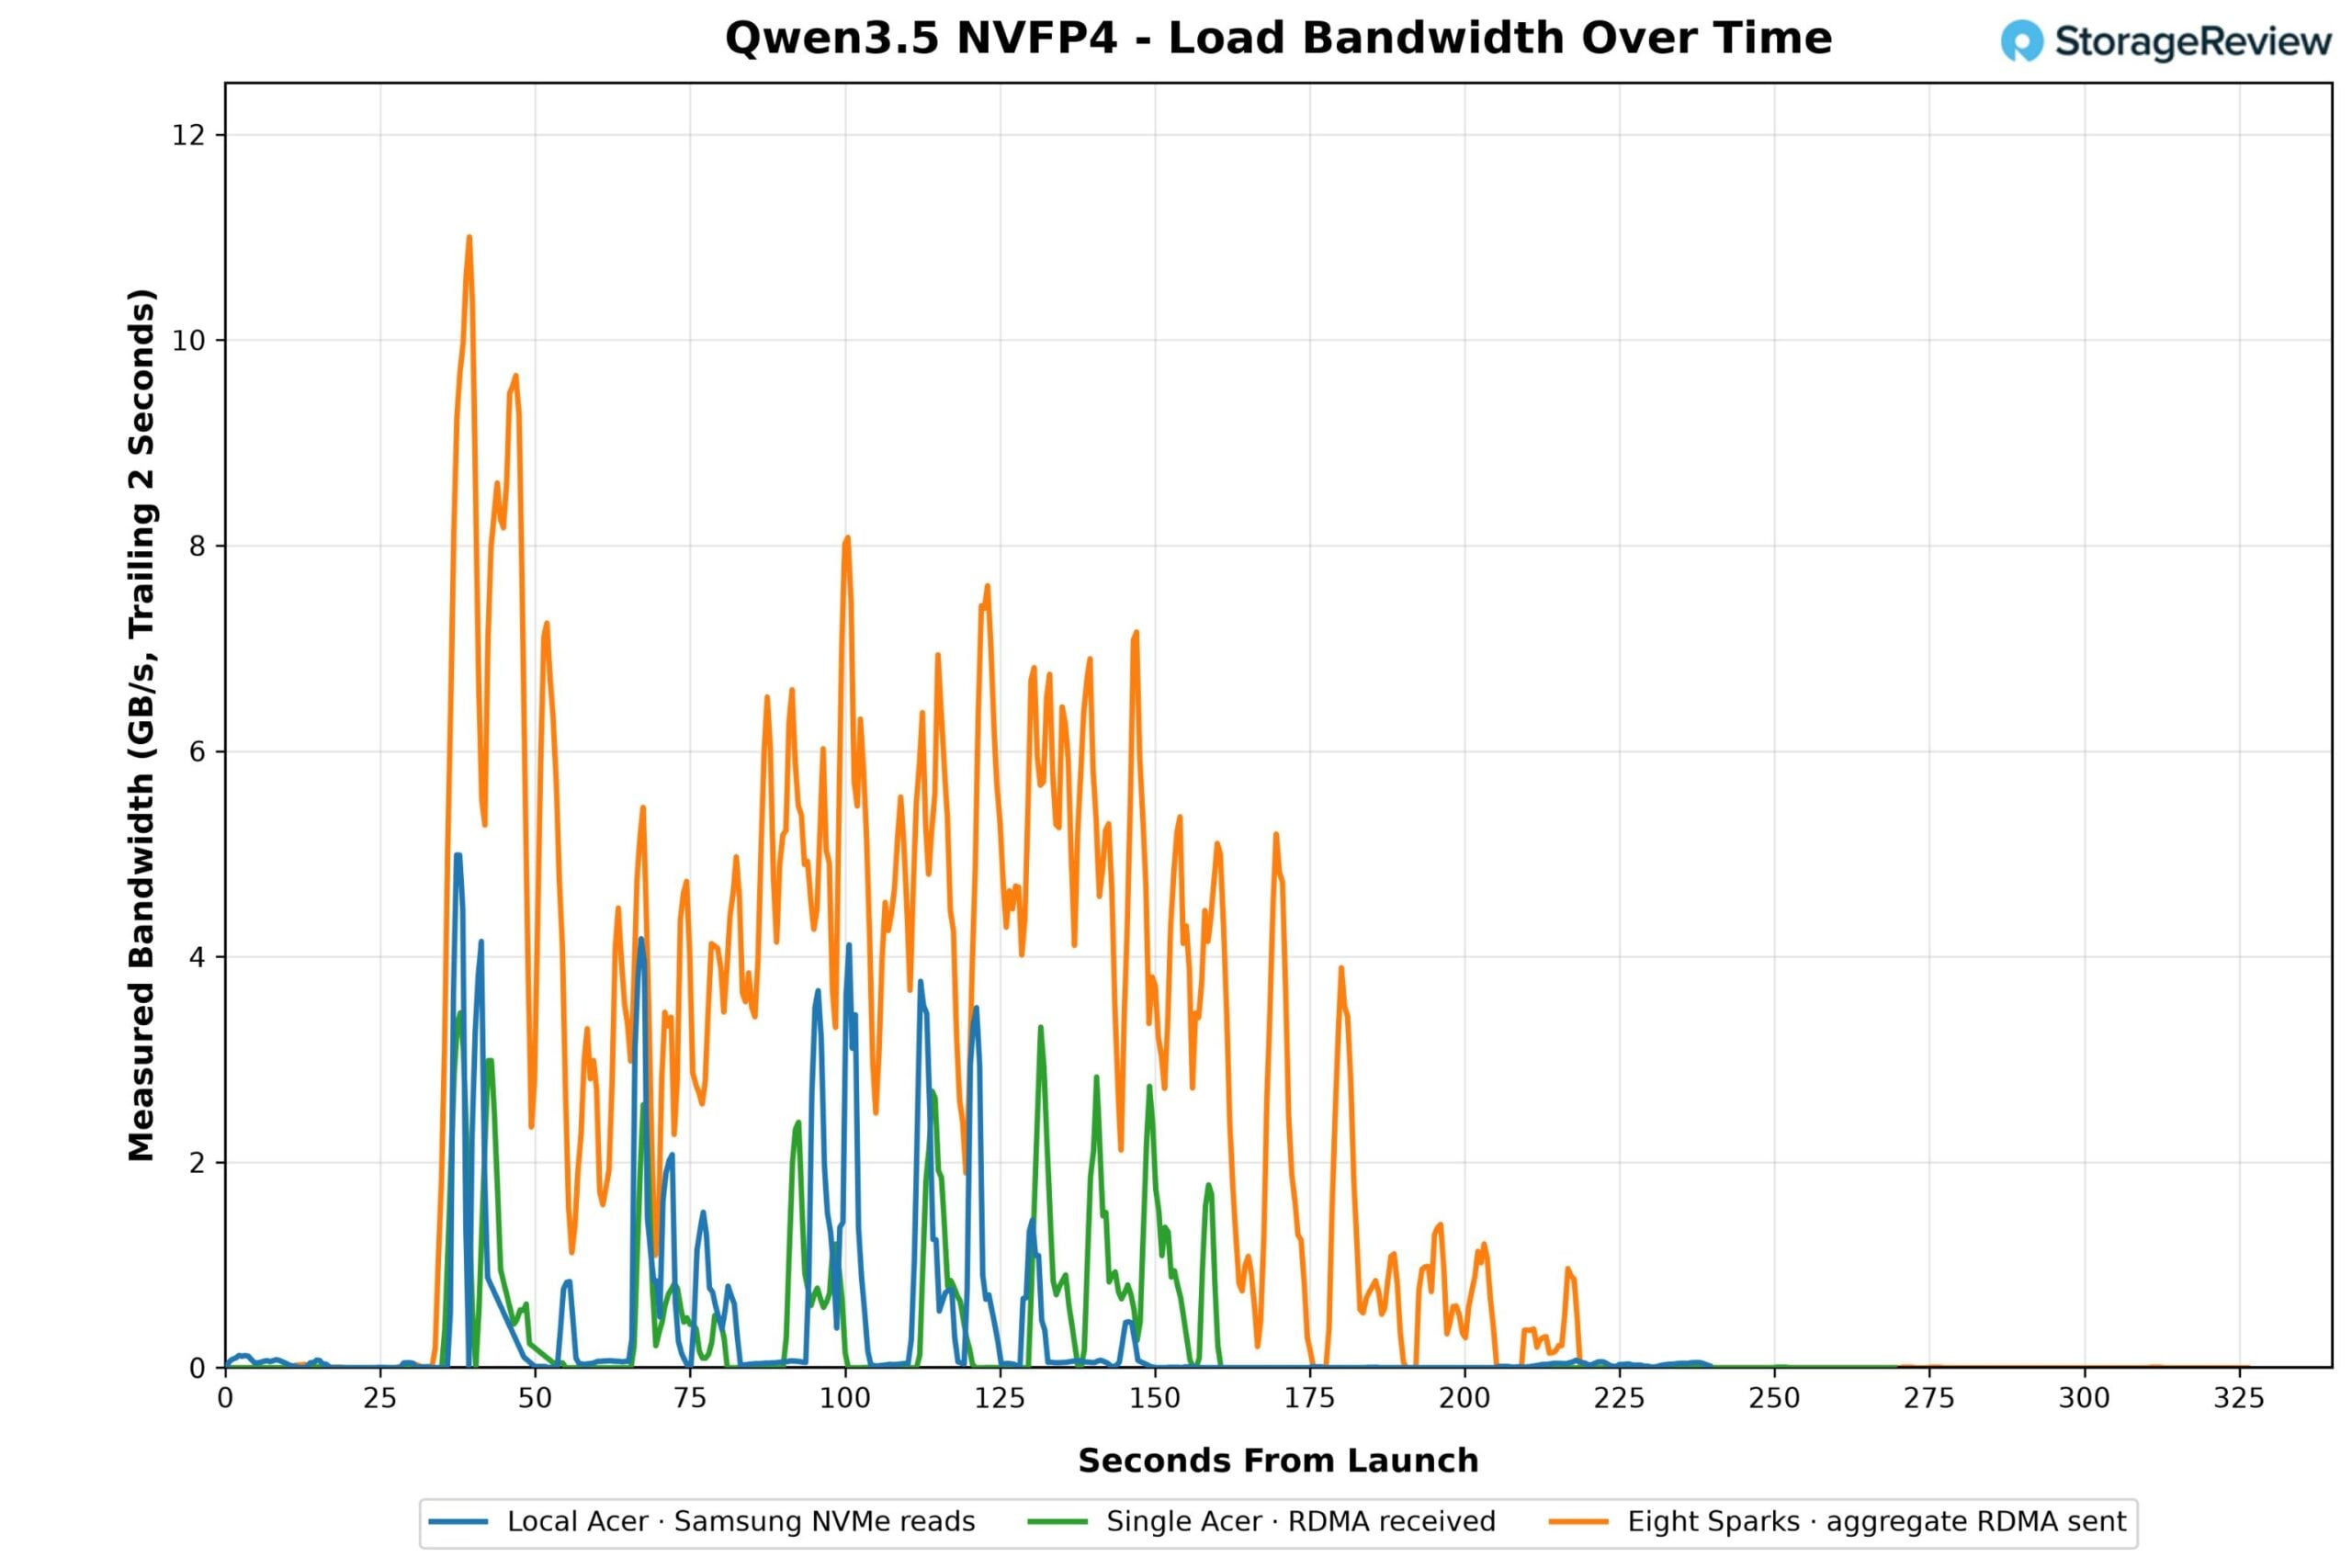
El registro de ancho de banda muestra ese patrón: las lecturas NVMe locales llegan en ráfagas que alcanzan picos cercanos a 5 GB/s con largos intervalos entre ellas; el único cliente NFS muestra la misma forma de ráfaga con picos ligeramente inferiores. La línea agregada de ocho Sparks muestra el array bajo demanda concurrente. Con los ocho extrayendo los mismos 78 GB a la vez, el array entregó un pico agregado de 11 GB/s en el primer minuto, luego se estabilizó entre aproximadamente 4 y 8 GB/s durante los siguientes dos minutos mientras los Sparks procesaban sus pesos, con un promedio de 2.08 GB/s en toda la ventana. Frente a los 25 GiB/s que el barrido fio mostró que el array puede entregar, ocho Sparks cargando un modelo a la vez utilizaron una fracción de lo que está disponible.
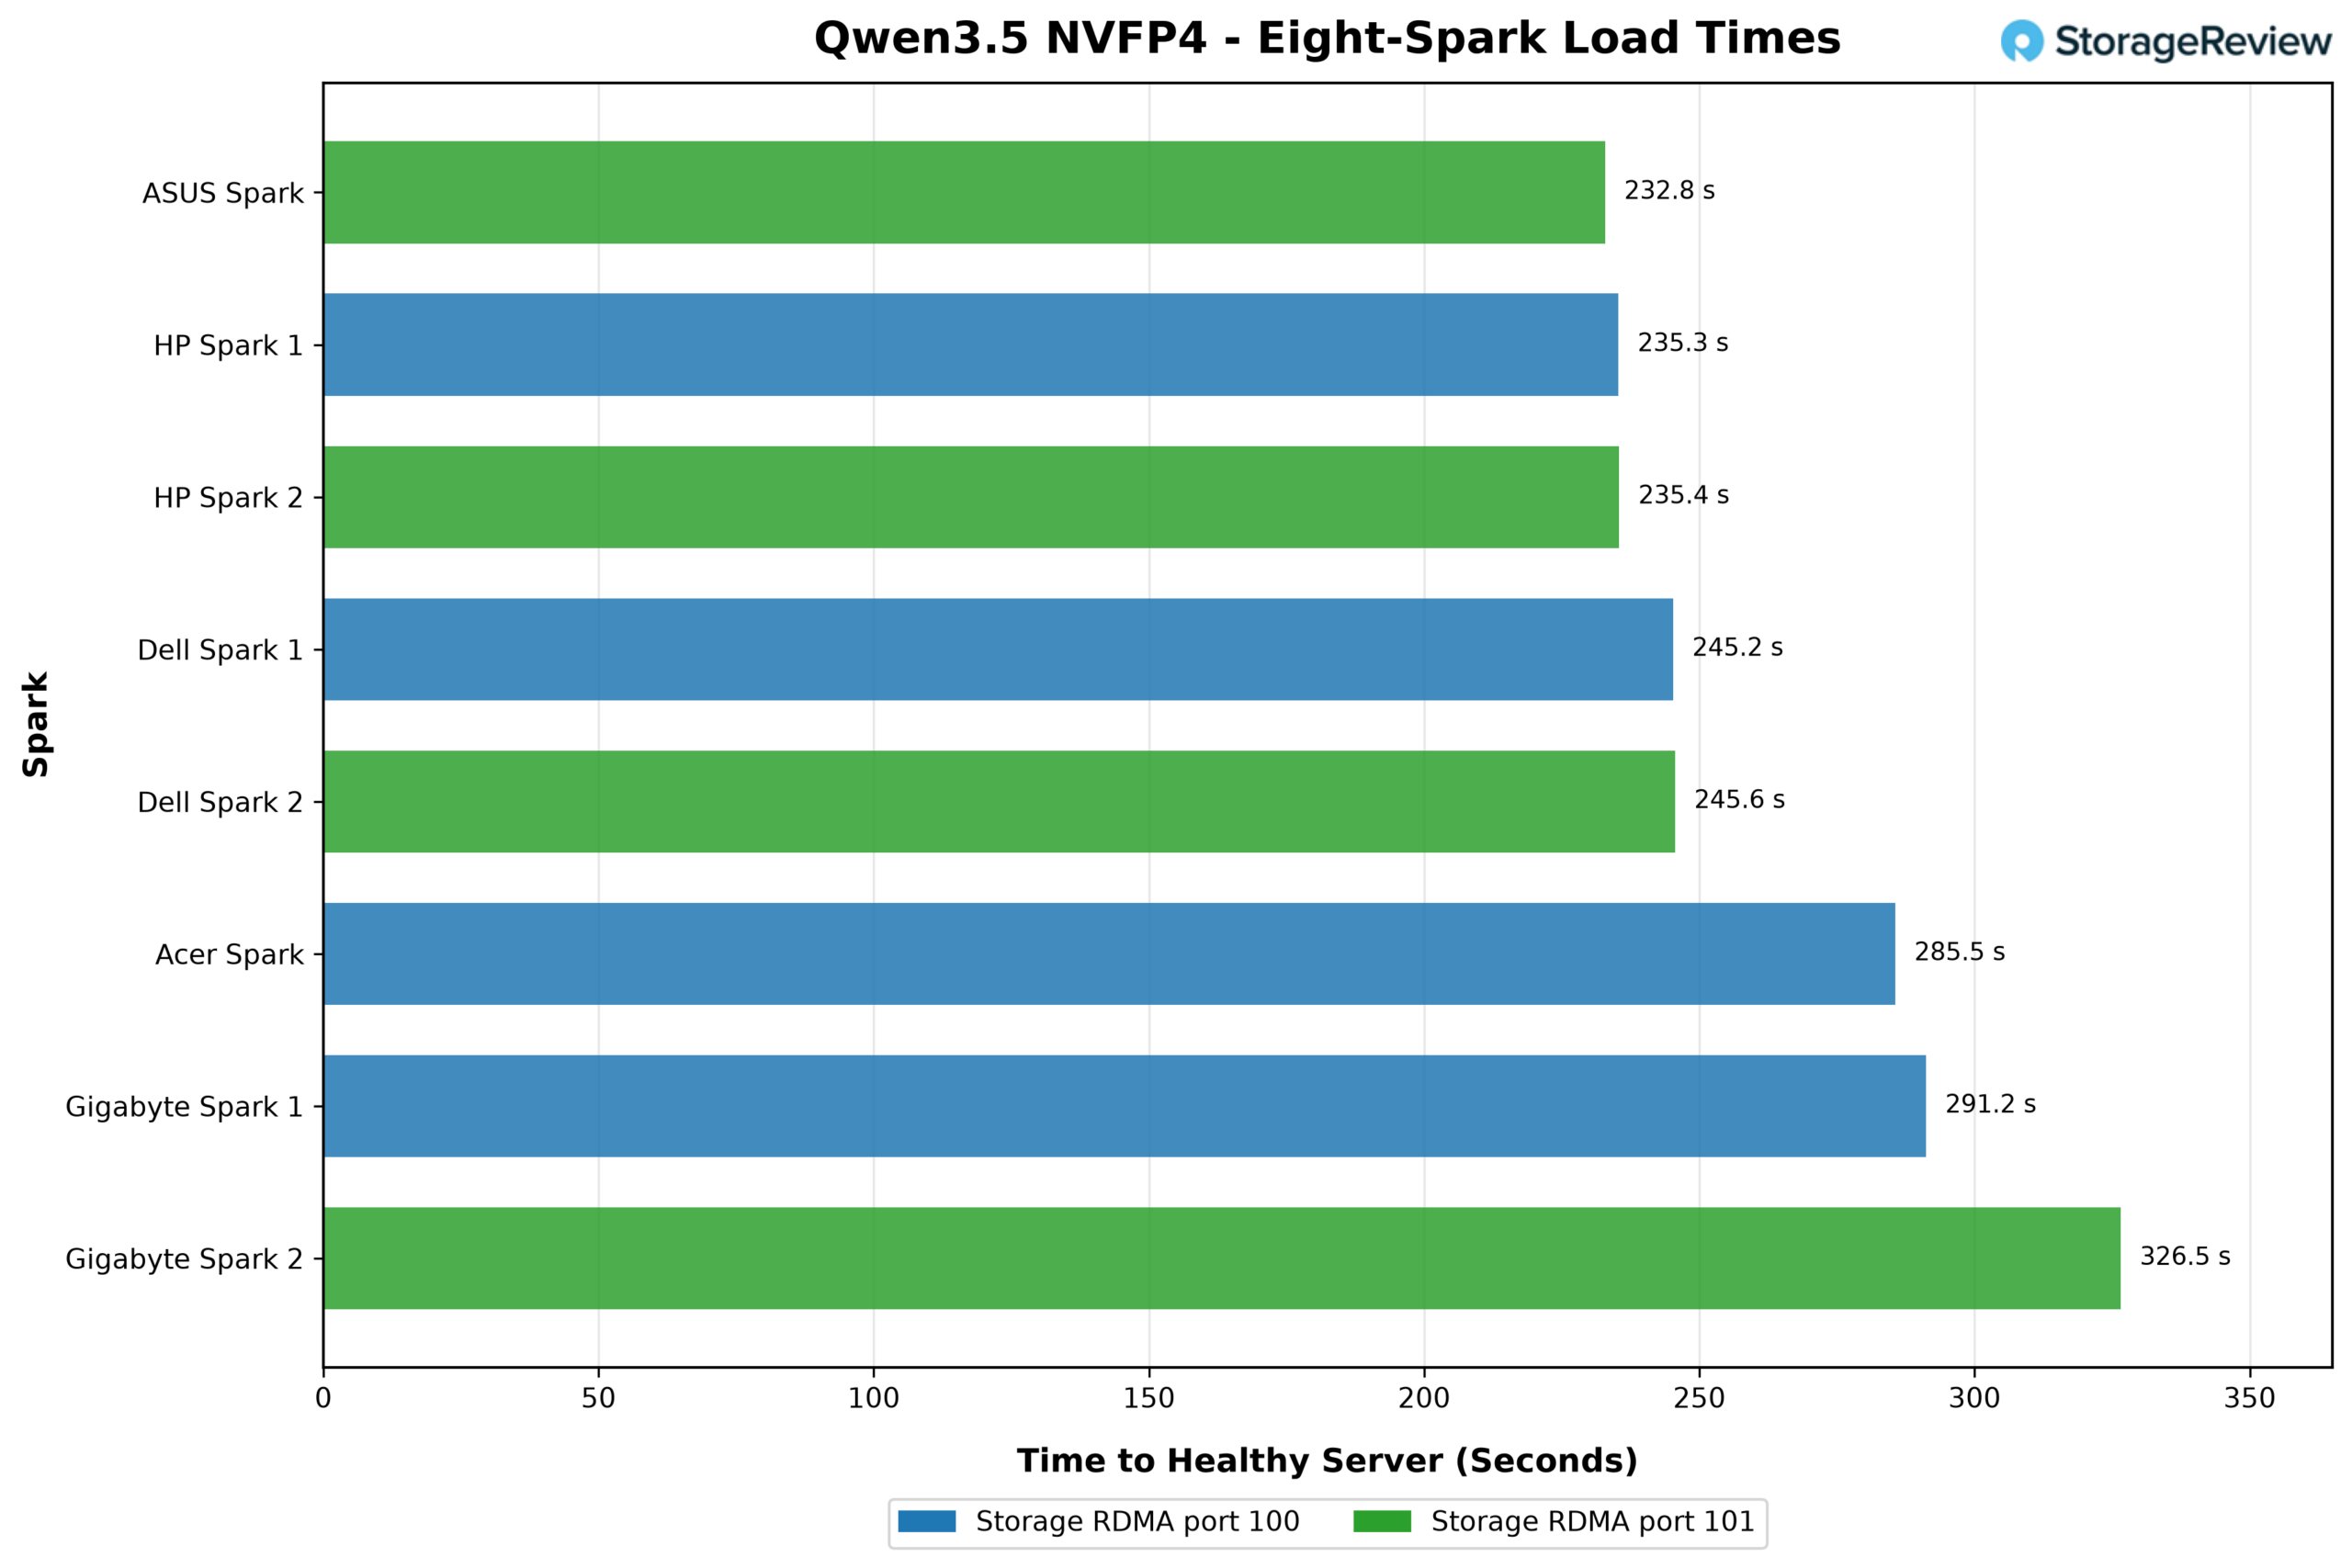
Los tiempos de carga por unidad en la prueba de ocho vías variaron desde 232.8 segundos en el ASUS Ascent GX10 hasta 326.5 segundos en una de las unidades GIGABYTE AI TOP ATOM, con los dos sistemas HP ZGX Nano G1n en 235.3 y 235.4 segundos y las dos unidades Dell Pro Max con GB10 en 245.2 y 245.6 segundos. Cinco de los ocho Sparks cargando simultáneamente desde la matriz compartida superaron al único Spark cargando solo a través de NFS/RDMA, y tres de ellos superaron la ejecución local NVMe. La dispersión no es una historia del fabricante; sin QoS en la pila, qué unidad termina esperando en la matriz en cualquier momento cambia de una ejecución a otra, y las dos unidades en cada NIC de almacenamiento se dividen equitativamente entre los extremos rápidos y lentos de la tabla.
Para un laboratorio, el resultado es que puede mantener una copia de cada modelo en el array, y cualquier Spark, o todos los Spark, lo carga en aproximadamente el tiempo que tardaría en cargar una copia local, sin paso de descarga, sin consumo de capacidad local y sin copia de los pesos sobre un escritorio.
Caso de uso del estado de Oregón
La Facultad de Ciencias de la Tierra, el Océano y la Atmósfera de la Universidad Estatal de Oregón ha colaborado repetidamente en nuestro trabajo de infraestructura de IA, desde la investigación oceánica en tiempo real a bordo de un buque de investigación hasta la evaluación académica asistida por IA con Metrum AI . Chris Sullivan, director de Investigación e Informática Académica de la OSU, y su arquitecto, Thomas Olson, están explorando un laboratorio Spark a gran escala para el aprendizaje de IA que podría escalar hasta 100 unidades, y su visión sobre el almacenamiento influyó en nuestro diseño de dos maneras específicas.
En primer lugar, el almacenamiento debe ser independiente de los Sparks. La OSU consideró un sistema de archivos distribuido entre los propios Sparks, pero lo descartó para un aula porque añadir o quitar un solo nodo interrumpiría el servicio de almacenamiento para todos. Un arreglo central que cualquier Spark pueda montar significa que un Spark se puede añadir, quitar, reinstalar o asignar a otro estudiante sin afectar los datos de nadie más. En segundo lugar, el almacenamiento debe seguir al usuario. Describimos el requisito de la OSU como una versión mejorada de los recursos compartidos de archivos para fines de IA, donde los estudiantes almacenan información persistente a medida que se mueven entre sistemas. Con NFS, eso significa una carpeta por estudiante; inicie sesión en cualquier Spark, monte el recurso compartido y su trabajo estará allí.
Los conjuntos de datos son la razón por la que esto es más importante para la OSU que para un servidor de directorio personal. La Facultad de Ciencias de la Tierra, el Océano y la Atmósfera quiere poner sus datos de investigación, colecciones oceanográficas y atmosféricas que se miden en decenas de terabytes, a disposición de los estudiantes para sus propias investigaciones. No existe una versión de esto en el almacenamiento de escritorio: una ranura M.2 de 4 TB no puede albergar ni una sola de esas colecciones, e incluso un laboratorio lleno de gabinetes externos implicaría comprar y llenar una copia para cada escritorio y luego mantener cada copia actualizada, lo que ningún departamento podría permitirse. Alojar los datos una sola vez en el array y montarlos a través de 100 GbE es el enfoque que se ajusta a ese requisito en nuestra evaluación. El mismo array aloja la biblioteca de modelos, por lo que los estudiantes pasan su sesión ejecutando Qwen, Llama o cualquier otro modelo, sin necesidad de descargar nada. El mismo principio se aplica a las empresas que implementan sistemas de IA de escritorio como estaciones de trabajo para desarrolladores: se monta el conjunto de datos de producción a través de una red rápida y se deja que el sistema trabaje con él directamente, lo que elimina la necesidad de crear un segundo repositorio de datos para que los equipos de escritorio tengan algo que leer. Los datos permanecen en el centro de datos, bajo los controles de acceso, el cifrado y el sistema de copias de seguridad ya existentes, y Spark no almacena información relevante cuando sale de la red.
Conclusión
El hardware de IA de escritorio es bueno en muchas cosas, pero no es ideal para integrarse en el entorno de datos de una organización, y la única ranura M.2 en cada sistema GB10 lo garantiza: todo lo que un usuario necesita termina copiado en la memoria flash local, invisible para el departamento de TI, desprotegido y duplicado en todos los demás escritorios que necesitan lo mismo. Para un solo Spark, una unidad de almacenamiento local externa es una solución razonable. Para un laboratorio, un departamento o una empresa que implementa estos dispositivos por docenas, cada escritorio con sus propios datos es un silo, y la solución es la que los centros de datos encontraron hace años: conectar la capacidad a una red rápida, gestionarla una sola vez y compartirla. Los Spark ya cuentan con redes de alta velocidad; este proyecto muestra qué sucede cuando se les proporciona una plataforma, y demuestra que los propios Spark deberían estar en el rack contiguo.
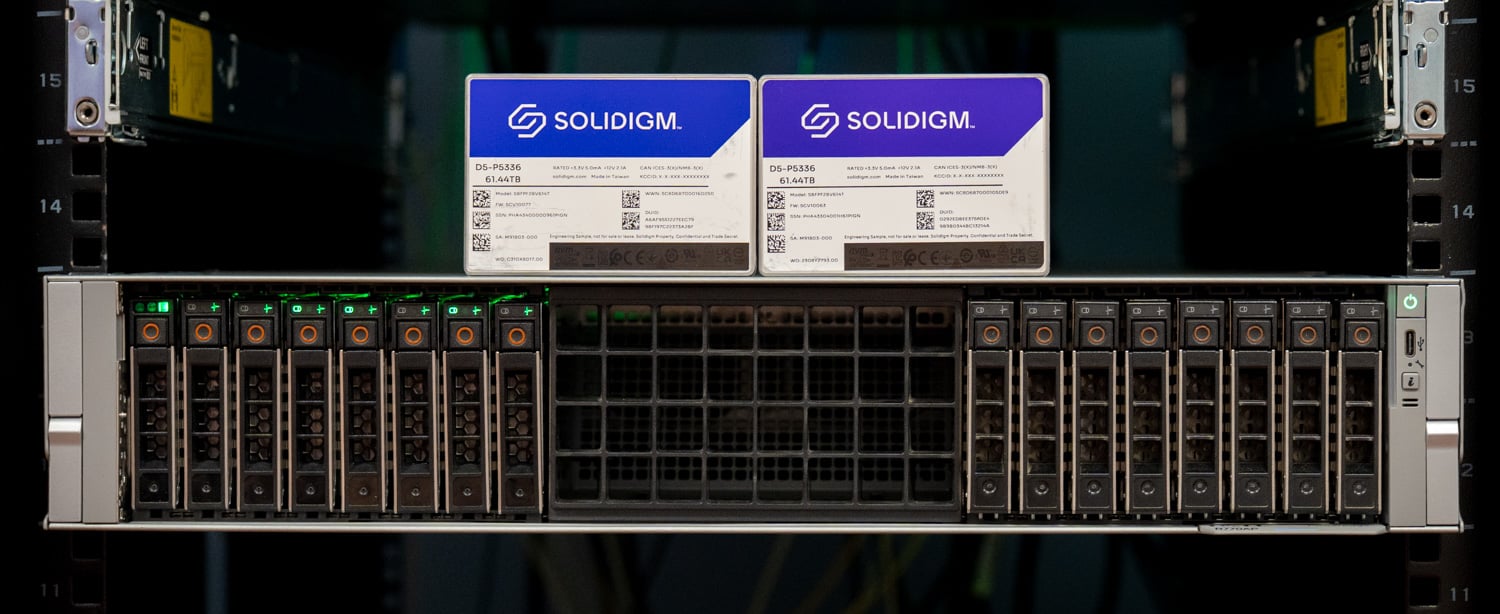
Ocho discos Solidigm D5-P5336 QLC en Graid RAID 5 en un servidor Dell proporcionaron a ocho Sparks un único conjunto de datos protegido por paridad. Dos tarjetas de red Broadcom de 400 GbE y una placa base Dell Z9864F-ON con un adaptador de 800 G proporcionaron a cada uno de los ocho Sparks 100 GbE. Fusion NFS de Tuxera sobre RDMA convirtió esa capacidad en un montaje de una sola línea en Ubuntu estándar con ganchos de servicio de directorio para el control de acceso. Bajo una carga fija distribuida entre los ocho, la matriz entregó 24.9 GiB/s de lectura secuencial agregada, dividida equitativamente sin QoS, y un solo Spark saturó su enlace a 10.8 GiB/s, tan rápido como el mejor disco interno en cualquier sistema GB10 que hayamos probado; ese límite utilizó el 27 % de lo que pueden transmitir las dos tarjetas de red del servidor, por lo que la red está dimensionada para un servidor más completo que este. La prueba del modelo confirmó el flujo de trabajo: un modelo de 78 GB alojado una vez en la matriz compartida se carga en un Spark con una diferencia del 13 % respecto al NVMe local, y en ocho Sparks a la vez, con cinco de los ocho finalizando más rápido que la ejecución NFS individual.
La memoria flash QLC hace que esta economía funcione porque la carga de trabajo es intensiva en capacidad y lectura, el punto fuerte del D5-P5336, y un solo servidor puede almacenar lo que cien Sparks nunca podrían almacenar localmente, con una copia de todo y cada copia bajo el control del centro de datos. La Universidad Estatal de Oregón tiene almacenamiento de investigación de producción para el trabajo que no puede esperar. El concepto que Chris Sullivan y Thomas Olson están explorando es un nivel educativo que la universidad no tiene actualmente: un pool compartido y gobernado del tamaño de un rack o más de Sparks, construido a partir de un servidor y un puñado de unidades de alta capacidad, que podría poner decenas de terabytes de datos oceanográficos y atmosféricos reales frente a un laboratorio de aprendizaje de IA a gran escala en la misma infraestructura que usan sus Sparks.
Este informe está patrocinado por Solidigm. Todos los puntos de vista y opiniones expresados en este informe se basan en nuestra visión imparcial de los productos bajo consideración.
Las referencias a productos comerciales en este artículo tienen fines informativos y no constituyen un respaldo por parte de la Universidad Estatal de Oregón.



 Amazon