

La decisión más importante que muchas empresas tomarán el próximo año en materia de infraestructura de IA no será una inversión en GPU, sino una actualización de la base de datos. Oracle AI Database 26ai es la versión con soporte a largo plazo que Oracle está orientando hacia su base instalada de 19c. 26ai integra la búsqueda vectorial en el mismo motor que almacena las transacciones. Cuando el índice vectorial reside en la base de datos, la matriz de bloques y la red SAN subyacente se convierten en infraestructura de IA, gestionando el tráfico de recuperación junto con las transacciones que ya atienden.
Puntos Clave
- OLTP y la búsqueda vectorial comparten una matriz: Con una limitación de 45,000 IOPS en cada volumen vectorial, FlashSystem mantuvo 870,000 IOPS a 377 microsegundos y 6.9 GB/s con un 25 por ciento de uso de CPU, mientras que Swingbench mantuvo aproximadamente 19,500 TPS constantes durante toda la ejecución; sin la limitación, la carga de trabajo vectorial consumió un 37 por ciento de OLTP.
- El Fibre Channel de 64G prácticamente duplica el rendimiento de la búsqueda vectorial: El mismo host, matriz y adaptadores Emulex LPe38102 SecureHBA ofrecieron 85.0 consultas por segundo a 64 GB frente a 43.7 a 32 GB, un 95 por ciento más, con una latencia p99 a 80 subprocesos que se redujo de 4.08 segundos a 1.14 y la creación del índice IVF_FLAT finalizó un 28.8 por ciento antes.
- El ransomware dirigido al sistema de copias de seguridad RMAN fue detectado en menos de 60 segundos: FlashSystem marcó los 31 volúmenes del grupo, tomó una instantánea de copia protegida inmutable por sí mismo y extendió la retención en la última copia válida conocida, sin ningún agente host en la ruta.
- La capacidad vectorial es un elemento presupuestario desde el primer día: Un millón de incrustaciones de 1,024 dimensiones transformaron 0.90 GB de texto fuente en 16.24 GB en la SAN, 18 veces el tamaño original, con entre 15 y 23 GB de datos temporales necesarios durante la creación del índice y un multiplicador que oscila entre 4.8x y 32.5x dependiendo del modelo de incrustación.
- Las operaciones del segundo día permanecen en el array: La función AutoZoning con zonificación basada en objetivos de Brocade agrega un host sin necesidad de un ticket de zonificación, las particiones de almacenamiento proporcionan a los equipos de DBA e IA inquilinos separados en un mismo sistema, y los adaptadores Emulex SecureHBA cifran el tráfico entre el host y la matriz en tránsito a través de una estructura Brocade Gen 8 con criptografía postcuántica.
La base de datos cambió bajo la IA
Oracle desarrolló 26ai en torno a esta idea: un tipo de datos VECTOR nativo, funciones de búsqueda vectorial SQL, ejecución de modelos en la base de datos mediante ONNX y SELECT AI para consultas en lenguaje natural, todo ello en una versión LTS que, según la compañía, incluye más de 300 nuevas funcionalidades. En la práctica, un administrador de bases de datos puede generar incrustaciones, almacenarlas junto a las filas que describen y realizar una búsqueda de similitud dentro del mismo ámbito de transacción que una consulta de pedido. No es necesario ejecutar un almacén vectorial independiente, mantener una canalización de sincronización ni almacenar una segunda copia de los datos regulados fuera del registro de auditoría.
IBM cita a IDC sobre esta tendencia: “Las bases de datos vectoriales integradas son la plataforma preferida para almacenar y consultar incrustaciones vectoriales, ya que las organizaciones prefieren entornos unificados y controlados para la IA con agentes”. Los clientes de IBM y Broadcom desean ampliar la base de datos en la que ya confían antes de implementar una nueva junto a ella.
Oracle no está sola en esta dirección. El ranking de popularidad de DB-Engines de octubre de 2026 enumera los cuatro principales motores relacionales y multimodelo: Oracle, MySQL, Microsoft SQL Server y PostgreSQL. Los cuatro han incorporado tipos vectoriales o búsqueda vectorial, de forma nativa o mediante extensiones como pgvector. IBM optó por comenzar su trabajo de validación con Oracle principalmente debido a su liderazgo en el mercado, aunque el argumento sobre el almacenamiento que se menciona en este artículo también se aplica a los demás.

Los argumentos para mantener el almacenamiento en bloques en las instalaciones no han cambiado con la llegada de la IA: los datos que hacen útil una implementación de IA, como los historiales de pacientes, las reclamaciones, los pedidos y las transacciones, no pueden salir de la plataforma. Copiarlos a una plataforma de IA dedicada implica pagar dos veces por el almacenamiento, aceptar que la copia se desvíe del clúster de producción y perder los controles de gobernanza que hacían que el original fuera legalmente defendible. Mantener la recuperación dentro de la base de datos evita estos tres problemas. El sistema que permite una búsqueda de filas en fracciones de milisegundo ahora también permite un análisis de similitud vectorial para un médico y una transmisión de respaldo simultáneamente.
IBM Storage y el grupo Fibre Channel (FC) de Broadcom se propusieron validar ese caso de carga de trabajo mixta y crearon un entorno en torno a Oracle AI Database 26ai en IBM FlashSystem con la estructura SAN Brocade Gen 8 de Broadcom y los SecureHBA Emulex 64G . Luego, abordaron las preguntas que un equipo de infraestructura se había estado haciendo: ¿cuál es el impacto en la latencia transaccional cuando una carga de trabajo vectorial se inicia junto a ella?, ¿cuál es el efecto de la velocidad de la estructura en el rendimiento de la búsqueda vectorial?, ¿cuál es la capacidad consumida por las incrustaciones?, ¿cuál es la efectividad de la detección de ransomware cuando se apunta a un volumen de copia de seguridad de RMAN?, ¿cuáles son los requisitos para agregar un host a la SAN sin un ticket de zonificación?
Los datos ya residen en el almacenamiento en bloques, y ahora llega la IA.
Nada de esto implica que las cargas de trabajo de IA en general deban almacenarse en bloques. Las empresas conservarán matrices de archivos y objetos para los datos no estructurados: documentos, imágenes, vídeos, conjuntos de entrenamiento y puntos de control de modelos que nunca se almacenaron en una base de datos y probablemente nunca lo harán. En la demostración para el sector sanitario que se presenta a continuación, IBM almacena las imágenes de rayos X sin procesar en un sistema de almacenamiento de objetos, mientras que solo guarda las incrustaciones y los metadatos de los casos en Oracle. Lo que cambia es la carga sobre la matriz, que ahora soporta simultáneamente varias cargas de trabajo con perfiles de E/S muy diferentes.
La capa relacional es la más conocida: millones de operaciones de E/S aleatorias de 4 KB a 16 KB por segundo, búsquedas de filas y confirmaciones que deben completarse en microsegundos, alta concurrencia de escrituras por tráfico de rehacer, deshacer y puntos de control, y una latencia de cola que se mantiene predecible porque una aplicación de cara al usuario está esperando. RMAN, la utilidad de copia de seguridad de Oracle, es lo opuesto: un flujo secuencial que necesita margen para finalizar dentro de su ventana sin interrumpir la primera carga de trabajo. Ambas son bien conocidas y los sistemas de almacenamiento de IBM están optimizados para ellas.
La capa vectorial es más difícil de caracterizar porque las tablas grandes de incrustaciones vectoriales pueden hacer que la búsqueda vectorial parezca una carga de trabajo que consume mucho ancho de banda: un escaneo secuencial extenso. La caracterización que hace IBM de la ruta vectorial de Oracle 26ai se asemeja más a OLTP. Cada salto a través del índice es una lectura aleatoria de aproximadamente 4 KB; la ruta de consulta está limitada por las IOPS y es sensible a la latencia, y las lecturas predominan porque las escrituras se realizan en una fase separada de ingesta y creación de índices.
El ancho de banda es crucial en momentos puntuales, como cuando se crea un índice o se vuelve a insertar un corpus, y estos momentos suelen ser bastante intensos. Esta división es la raíz del problema de E/S mixta: en la ruta de consulta, la carga de trabajo vectorial compite con las transacciones por las mismas colas, lo que convierte el aislamiento en un factor crítico para la calidad del servicio. Y es precisamente en estas fases de alta demanda donde el ancho de banda de la red se convierte en el límite, como demuestran los resultados de 32G frente a 64G que se presentan más adelante en este artículo.
La arquitectura validada
IBM y Broadcom crearon un entorno para esta validación en el laboratorio de IA de Broadcom en Colorado. El almacenamiento es una matriz IBM FlashSystem serie 9000 que ejecuta IBM Storage Virtualize 9.1.3 con 24 módulos FlashCore, que presenta puertos Fibre Channel de 64G a un par de conmutadores SAN Brocade Gen 8 G820. El host de la base de datos es un servidor Intel Xeon 6767P de doble socket con dos adaptadores Emulex LPe38102 SecureHBA de 64G y 2 puertos, que ejecuta Oracle AI Database 26ai en ASM sin GPU en la ruta de almacenamiento; IBM Storage Insights supervisa la matriz.

Ejecutamos los resultados de la estructura y la capacidad, la comparación de búsqueda vectorial de 32G frente a 64G y las mediciones de huella utilizando VectorDBBench contra el conjunto de datos BioASQ 1M solo en ese host. La misma configuración también admite la carga de trabajo de la aplicación. Un Supermicro 821GE-TNHR con dos procesadores Xeon Platinum 8470 y ocho GPU NVIDIA H100 de 80 GB aloja la aplicación de atención médica y su modelo de lenguaje. La pila de software incluye la incrustación ONNX en la base de datos de Oracle, Ollama sirviendo Llama 3 y NVIDIA cuVS. Un conmutador Broadcom Tomahawk 5 y NIC Thor 2 de 400 GbE conectan los dos servidores. Las demostraciones de QoS de E/S, multitenencia, detección de ransomware y atención médica se ejecutaron en este entorno.

Según IBM, la familia FlashSystem (los modelos 5300 y 5600, 7300 y 7600, y 9500 y 9600) utiliza el mismo software Storage Virtualize, y las funciones que se muestran aquí, como la limitación de E/S, la zonificación automática, la detección de ransomware, la alta disponibilidad basada en políticas y la migración de particiones de almacenamiento, funcionan de la misma manera con Oracle AI Database 26ai en cualquiera de esos sistemas, con el mismo nivel de código. El rendimiento y la densidad varían según el modelo y la generación del módulo FlashCore, por lo que cada cifra de este artículo corresponde al sistema en el que se midió.
Garantizar un rendimiento óptimo de las cargas de trabajo OLTP y vectoriales con QoS de E/S.
La primera pregunta que IBM y Broadcom se propusieron responder es la que todo administrador de bases de datos se hace cuando se propone una carga de trabajo vectorial para el sistema de producción: ¿qué sucede con las transacciones principales? IBM realizó dos demostraciones en el sistema FlashSystem serie 9000 utilizando limitaciones de E/S a nivel de volumen, el mecanismo que respalda lo que IBM denomina QoS de E/S. La base de datos se distribuyó en 30 volúmenes: 15 para los espacios de tablas OLTP (ORCL16 a ORCL30) con Swingbench Order Entry para 192 usuarios, y 15 para las tablas vectoriales (ORCL31 a ORCL45) con un generador sintético de 200 subprocesos que ejecutaba consultas de similitud top-k 500, con Storage Insights registrando cada grupo de volúmenes.
Con OLTP funcionando solo, cada volumen OLTP mantenía una tasa constante de 20 500 operaciones/s. Cuando se inició el generador de vectores, los volúmenes de vectores aumentaron a aproximadamente 73 000 operaciones/s cada uno en un minuto, y los volúmenes OLTP cayeron a aproximadamente 13 000, una disminución del 37 % sin que se produjeran cambios en el lado transaccional. La ruta de búsqueda de vectores consiste en lecturas aleatorias de 4 KB con el mismo tamaño de bloque que las transacciones, por lo que accede a las mismas colas y toma lo que el array le proporcione.

Un límite de 45,000 IOPS en cada volumen vectorial, una línea de mkthrottle En la interfaz de línea de comandos (CLI), se optimizaron los volúmenes vectoriales hasta el límite y se recuperó el rendimiento de OLTP hasta aproximadamente 17 000 operaciones por segundo. Al eliminar el límite, se revirtió la situación y, al finalizar la ejecución del vector, el rendimiento de OLTP volvió a 20 500. El panel de control registró el mismo resultado en conjunto: 1.28 millones de IOPS sin limitación y aproximadamente 950 000 por debajo del límite, lo que, con un margen de error de unos pocos puntos porcentuales, equivale a la tasa por volumen multiplicada por 30 volúmenes.

La segunda demostración corresponde a la configuración que IBM prevé implementar en producción: primero se establecen los límites, 45 000 IOPS por volumen vectorial y 20 000 por volumen OLTP, y luego se ejecutan ambas cargas de trabajo simultáneamente. Los volúmenes vectoriales alcanzaron su límite máximo, los volúmenes OLTP se estabilizaron en aproximadamente 12 200 ops/s y se mantuvieron estables durante toda la ejecución, y el array mantuvo 870 000 IOPS (800 000 de lectura y 70 000 de escritura) a 377 microsegundos y 6.9 GB/s con un 25 % de uso de CPU. El límite de OLTP se mantuvo por encima de la demanda de la carga de trabajo y nunca se activó; su función es evitar que un exceso de cargas en cualquiera de los lados afecte negativamente al otro.
Swingbench mantuvo a sus 192 usuarios a aproximadamente 1.19 millones de transacciones por minuto, unas 19 500 TPS, durante toda la prueba. El generador se configuró para saturar su volumen, por lo que su latencia por consulta no es un indicador de rendimiento de la aplicación. Durante la prueba de 30 minutos, completó 35 672 consultas a 19.8 por segundo, con una latencia media de unos 10 segundos y un p99 de 14.3 segundos frente a un tiempo de espera de la aplicación de 15 segundos; 99 consultas (0.28 %) alcanzaron ese tiempo de espera, y las transacciones no se vieron afectadas.


Un límite de FlashSystem es un tope de volumen que se aplica en el array independientemente del host o la ruta, con un límite de ancho de banda opcional junto con el límite de IOPS; limita al vecino y no reserva nada. El tope es un ejercicio de dimensionamiento: 15 volúmenes vectoriales a 45 000 IOPS son 675 000 IOPS de capacidad vectorial, lo que dejó a los volúmenes OLTP de este array lo que necesitaban. Un array o combinación diferente modifica el número. Establezca el tope vectorial donde las transacciones mantienen su latencia, y la carga de trabajo vectorial obtiene todo lo que esté por encima.
Detección de ransomware en volúmenes Oracle en producción
La encuesta realizada por Sophos en 2024 a 2,974 organizaciones afectadas por ransomware reveló que el 94 % de ellas vieron cómo los atacantes intentaban acceder a sus copias de seguridad, que el intento tuvo éxito en el 57 % de los casos y que los costes medios de recuperación fueron ocho veces superiores cuando se produjo el ataque. IBM diseñó la prueba basándose en la misma premisa: priorizar las copias de seguridad y luego la producción. Dirigió el ataque al objetivo de copia de seguridad de RMAN, dejando intactos los volúmenes de la base de datos. RMAN escribió sus conjuntos de copias de seguridad en volúmenes de FlashSystem, se ejecutó un simulador de ransomware contra ellos y se dejó que el sistema detectara el problema por sí solo, sin ningún agente host en la ruta.
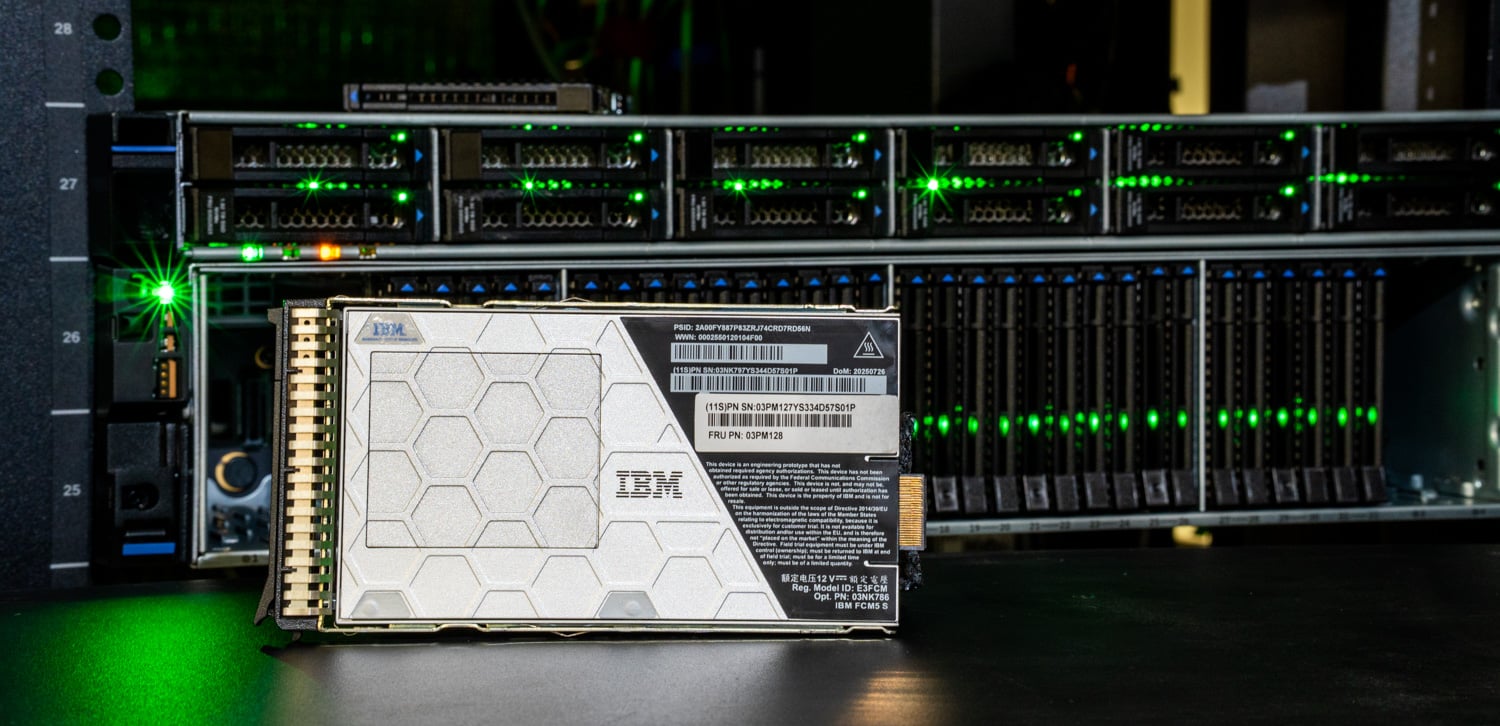
La detección se produce dentro de las unidades: los módulos FlashCore FCM4 y FCM5 calculan la entropía y la compresibilidad de cada escritura al momento de su llegada, junto con el tamaño del bloque, la dirección y los patrones de reescritura. Cada dos segundos, envían un resumen por volumen a un motor de inferencia dentro de Storage Virtualize (versión 8.6.3 o posterior con firmware FCM 4.1 o posterior). El modelo genera alertas en la interfaz gráfica de usuario de FlashSystem e IBM Storage Insights Pro, las reenvía a Storage Defender o a un SIEM y se puede parchear por sí mismo, por lo que un modelo reentrenado se distribuye como una pequeña actualización de seguridad sin necesidad de actualizar el firmware.
Dado que el análisis se ejecuta en el módulo, sigue funcionando incluso cuando el sistema anfitrión está comprometido. La salida cifrada tiene una alta entropía y deja de comprimirse, lo que se refleja en las estadísticas, tanto si el atacante cambia las extensiones de archivo, como si cifra solo un bloque sí y otro no, o si reduce la velocidad para ocultarse del agente del punto final.
Durante la validación, RMAN escribió la copia de seguridad en 16 canales paralelos, con cada conjunto de copias de seguridad limitado a 150 GB, y la base de datos se encontraba en 15 discos de 200 GB por grupo de discos ASM para datos OLTP y vectoriales. IBM ejecutó el ataque contra ese objetivo de copia de seguridad, y la alerta llegó a Storage Insights en menos de 60 segundos, dentro del tiempo de detección que IBM publica para esta función. Storage Insights marcó los 31 volúmenes del grupo de volúmenes, ya que una alerta en un volumen marca a todo el grupo como una amenaza.
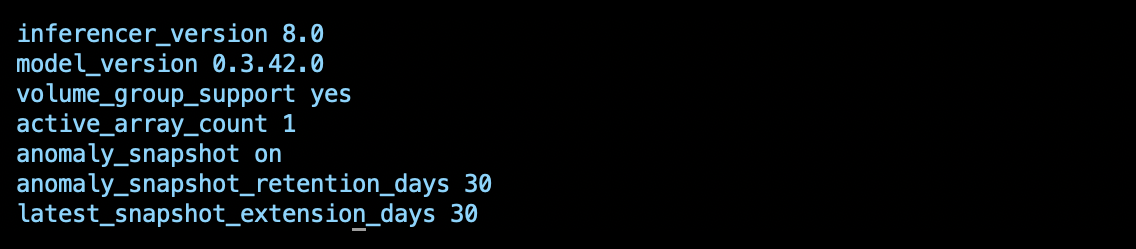
La respuesta es Copia protegida, y la matriz la manejó sin un operador: FlashSystem tomó una instantánea inmutable del grupo de volúmenes afectado en el momento en que se detectó la amenaza y extendió la retención de la última instantánea válida conocida al mismo tiempo. lsanomalydetection La salida del array muestra la configuración subyacente: motor de inferencia 8.0 con modelo 0.3.42.0, anomaly_snapshot activado, 30 días de retención en la nueva instantánea y 30 días añadidos a la última instantánea válida. Storage Virtualize también marca la instantánea sospechosa para que nadie pueda restaurarla, dejando un punto de restauración limpio anterior al inicio del cifrado.
La estructura también incorpora una capa de seguridad. Broadcom integra criptografía post-cuántica en las plataformas Brocade Gen 8, los adaptadores Emulex SecureHBA cifran los datos en tránsito desde el host hasta la matriz de almacenamiento a través de dicha estructura, y el nuevo estándar FC-SP-3 de FCIA establece la base de seguridad preparada para la computación cuántica para Fibre Channel en su conjunto.
Crecimiento de SAN sin tickets de zonificación: AutoZoning de IBM FlashSystem mediante zonificación basada en objetivos de Broadcom
Agregar un host a una SAN Fibre Channel generalmente requiere una solicitud y dos equipos: el administrador del servidor recopila los WWPN de la HBA, el administrador de la SAN crea las zonas manualmente en ambas redes y el administrador de almacenamiento asigna el host a los puertos de destino correctos. Un WWPN mal escrito deja un nuevo nodo Oracle RAC sin sus rutas. AutoZoning traslada ese trabajo al array: FlashSystem se comunica directamente con la red, identifica los WWPN iniciadores, selecciona los puertos de destino y crea las zonas automáticamente, sin que nadie inicie sesión en un switch.

Esta función se basa en Brocade Target Driven Zoning (TDZ) y se incluyó en el software FlashSystem 9.1.2. Requiere switches Brocade con Fabric OS 9.1.1 o posterior, y que el administrador de la estructura habilite TDZ en los puertos del switch que dan a los puertos de destino de FlashSystem. Esta habilitación es el único paso que queda a cargo del equipo de SAN, y AutoZoning no realiza ninguna acción en un puerto hasta que se complete. A partir de ahí, FlashSystem crea zonas de pares, lo que permite que los iniciadores de host alcancen el puerto de destino, pero no entre sí, bajo un nombre IBM_SV_ predecible que los identifica como administrados por la matriz.
La configuración comienza en la vista de puertos Fibre Channel, que ahora muestra el switch al que se conecta cada puerto, si el puerto es compatible con AutoZone y si su conectividad es simétrica (es decir, que el mismo ID de puerto en cada nodo se conecta a la misma red). Una vista de topología representa esta información mediante colores, y solo los puertos verdes que están activos, son compatibles con AutoZone y simétricos admiten esta función. Los puertos asimétricos no se muestran, incluso si son compatibles, ya que la interfaz gráfica advierte que pueden comprometer la redundancia y la conmutación por error.

La creación de hosts comienza con una lista de hosts no configurados, que se completa mediante FDMI, el cual informa a la red el nombre de host, el sistema operativo y los puertos de cada HBA. En el tutorial de IBM, el cuadro de diálogo Agregar host se abrió con el nombre del servidor, el sistema operativo y ambos puertos HBA de un host que aún no tenía zonas configuradas; el administrador seleccionó un conjunto de puertos habilitado para AutoZone, que define los puertos de destino a los que puede acceder el host, y hizo clic en Agregar. FlashSystem emparejó sus puertos de destino con los iniciadores del host, envió las zonas a ambos conmutadores y el host se conectó con cuatro rutas a través de dos redes.

Para Oracle, IBM posiciona AutoZoning para agregar nodos RAC y reemplazar HBA, ya que la función rastrea los cambios en la conectividad del host o del almacenamiento y adapta las definiciones de zona para que coincidan, por lo que un HBA reemplazado no requiere una rezonificación manual. La misma automatización se aplica cuando los hosts necesitan rutas a una segunda matriz para la migración de particiones de almacenamiento o HA basada en políticas (PBHA). El equipo de SAN sigue controlando qué puertos de destino participan, ya que no ocurre nada en un puerto hasta que se habilita TDZ. En consecuencia, agregar un host ya no depende de un cambio de zonificación.
Ámbito operativo: PBHA, migración a la red, multitenencia y ubicación.
La alta disponibilidad basada en políticas (PBHA) replica de forma síncrona una partición de almacenamiento entre dos matrices FlashSystem ubicadas a distancia metropolitana, con acceso activo-activo en ambos sitios. IBM afirma que esta función está diseñada para lograr un RPO cero y para una conmutación por error de almacenamiento que una implementación de Oracle en clúster correctamente configurada puede gestionar sin pérdida de datos. Cuando el sitio que falló vuelve a estar operativo, los datos se resincronizan y la carga de trabajo se reanuda sin interrupciones.
La función FlashSystem Grid federa hasta 32 matrices FlashSystem bajo una única vista de administración, y la migración de particiones de almacenamiento traslada una partición, con sus volúmenes, grupos de volúmenes y hosts, de una matriz a otra sin tiempo de inactividad de la aplicación. Para Oracle, IBM recomienda la actualización del hardware, vaciando un sistema antes de una actualización de firmware y trasladando una partición vectorial a un sistema con mayor capacidad a medida que crece el conjunto de incrustación. Un sistema migra una partición a la vez a través de Fibre Channel o Ethernet de alta velocidad; los hosts pueden conectarse a través de Fibre Channel, iSCSI o NVMe/TCP, y una partición ya configurada para PBHA no es apta para la migración.
El asesor de ubicación de Storage Insights gestiona la planificación para la misma cuadrícula. En función de la capacidad, la tasa de crecimiento, el perfil de E/S y el objetivo de latencia de una carga de trabajo, evalúa cada sistema de la cuadrícula, clasifica el que mejor se ajusta antes de aprovisionar nada y también puede recomendar una migración si detecta un desequilibrio en la CPU o las IOPS. Tanto la migración como la ubicación utilizan Storage Insights Pro, y todos los sistemas de la cuadrícula están registrados en el mismo inquilino de Storage Insights.

La arquitectura multiusuario permite que un equipo de administradores de bases de datos y un equipo de IA compartan la cuadrícula sin compartir la administración. En el tutorial de IBM, un administrador creó dos inquilinos en el mismo array (Tenant_Scale y Tenant_oracle_ai) y asignó a cada uno un sistema, un grupo de usuarios con un rol de inquilino y un primer usuario. A continuación, creó una partición de almacenamiento para cada uno con un grupo de volúmenes, volúmenes y asignaciones de host independientes. La interfaz gráfica de usuario (GUI) ofrece configurar la replicación en cuanto existe una nueva partición. Al iniciar sesión como el usuario Tenant_Scale, la GUI solo mostraba la partición y los recursos de ese inquilino, sin nada perteneciente a Tenant_oracle_ai, y la misma comprobación desde el lado de Tenant_oracle_ai devolvió el mismo resultado.
El dividendo del tejido: Fibre Channel de 32G frente a 64G bajo búsqueda vectorial
La única variable que IBM y Broadcom modificaron intencionadamente en estas pruebas fue la estructura de red. El mismo array, host y adaptadores Emulex LPe38102 SecureHBA ejecutaron VectorDBBench con el conjunto de datos BioASQ 1M (un millón de vectores de 1,024 dimensiones del corpus de preguntas y respuestas biomédicas) dos veces: una vez con los dos puertos HBA a 32G y otra a 64G, a través de los mismos conmutadores Brocade G820. Todo lo demás, desde los 16 volúmenes ASM hasta la SGA de 4 GB, se mantuvo sin cambios, por lo que la diferencia entre las dos ejecuciones radica únicamente en la generación de Fibre Channel.

La fase de búsqueda de esta prueba comparativa es un escaneo de solo lectura: el índice IVF_FLAT de Oracle dirige cada consulta a un clúster de particiones y las lee por completo, y con vectores FLOAT32 de 1,024 dimensiones, esto representa una carga de trabajo de ancho de banda. En dos puertos de 32G, las lecturas del host se estabilizaron en 6.3 GB/s, la velocidad de línea del par, y la curva de búsqueda se estabilizó en 43.7 consultas por segundo con 20 subprocesos. En dos puertos de 64G, el mismo host leyó a 12.5 GB/s y continuó escalando hasta 85.0 QPS con 80 subprocesos, un 95 % más de rendimiento con el mismo almacenamiento.

La latencia revela la otra cara de la moneda de 64G: con un solo hilo, las dos arquitecturas están dentro del 8% de diferencia, 0.107 segundos frente a 0.099, porque una sola consulta nunca llena ninguna de las dos vías. Sin embargo, a partir de cinco hilos, la arquitectura de 32G genera colas: la latencia promedio duplica la cifra de 64G en cada paso, y con 80 hilos, p99 alcanza los 4.08 segundos frente a 1.14. Una arquitectura FC saturada no falla; simplemente pone en cola cada consulta, y esa espera se manifiesta como latencia de cola.

La fase de carga también cambió; la ingesta del millón de vectores tardó 94.1 segundos en 32G y 84.5 en 64G, y la creación del índice IVF_FLAT tardó 139.6 segundos frente a 108.4, un 28.8 % más en la estructura más lenta, para una carga total de 233.7 segundos frente a 193.0. La recuperación y el NDCG estuvieron dentro del 0.1 % en las dos ejecuciones (83.81 % y 84.42 % en 32G, 83.95 % y 84.56 % en 64G), por lo que la estructura cambió la velocidad con la que llegaron las respuestas. Para una base de datos que ha estado en 32G desde su implementación, la actualización del HBA y el conmutador es una oportunidad obvia para ofrecer un mayor rendimiento.
Planificación para el crecimiento de la capacidad vectorial
La búsqueda vectorial modifica las métricas de capacidad antes de afectar el rendimiento. Una incrustación es una copia numérica de ancho fijo de un fragmento de datos de origen, y en el caso del texto, esta copia suele ser mayor que el fragmento que describe: un pasaje de 1,000 bytes se convierte en un vector FLOAT32 de 1,024 dimensiones y 4,096 bytes antes de que la base de datos añada una fila para almacenarlo. El equipo denomina a esto amplificación de almacenamiento vectorial y lo midió en el mismo conjunto de datos BioASQ 1M utilizado en la comparación de la arquitectura.
El texto fuente que contiene el millón de vectores ocupa 0.90 GB. En Oracle 26ai, se convirtió en una tabla de vectores de 7.67 GB, incluyendo aproximadamente 0.3 GB de sobrecarga de filas, y el índice IVF_FLAT añadió 8.57 GB adicionales, ya que mantiene una segunda copia agrupada de cada vector, además de aproximadamente 4 MB de centroides. El espacio persistente en la SAN es de 16.24 GB, 18 veces el tamaño del texto fuente, antes de considerar el espacio operativo que Oracle necesita a su alrededor: de 15 a 23 GB de TEMP mientras se crea el índice, y de 4 a 8 GB de UNDO y aproximadamente 15 GB de REDO durante la ingesta.

El multiplicador se escala con el modelo de incrustación: Broadcom extrapola a partir del mismo método, situando un modelo Cohere v3 de 768 dimensiones (también medido) en 4.8 veces la fuente, un MiniLM de 384 dimensiones en 9.6 veces y un modelo Mistral de 4,096 dimensiones en 32.5 veces. El tamaño del fragmento es tan importante como el ancho, ya que un vector ancho sobre un pasaje largo se amplifica menos que el mismo vector sobre uno corto, y los índices cuantizados reducen la proporción del índice.
Nada de esto es específico de FlashSystem ni de Oracle. La amplificación se produce dentro de la base de datos antes de que el array procese un byte, y cada índice vectorial en cada plataforma contiene una copia de los vectores, por lo que debe incluirse en el presupuesto de capacidad el día en que se aprueba un proyecto vectorial, junto con las GPU. Lo que decide el array es cuánto de ese crecimiento puede soportar: el módulo FlashCore de quinta generación de IBM alcanza los 105.6 TB por módulo, lo que supone 3.3 PB brutos en una carcasa de 2U en los modelos FlashSystem más grandes, 11.8 PB efectivos según las cifras de IBM, por lo que una capa vectorial puede crecer in situ durante años antes de que sea necesario mover una partición.
El modelo de dimensionamiento de IBM para la aplicación de atención médica que se describe a continuación funciona de manera inversa para las imágenes: 100 GB de radiografías generan aproximadamente 2 GB dentro de la base de datos, ya que solo las incrustaciones y los metadatos del caso residen allí. El texto es el caso costoso: 100 GB de texto clínico fragmentado ocupan entre 860 GB y 1.2 TB, la mayor parte del cual corresponde al índice HNSW. La entrada de dimensionamiento es el número de fragmentos y el ancho del modelo; el corpus de origen no es una guía adecuada. Las incrustaciones también se comprimen menos que las filas, de 1.2x a 2x frente a 2x a 4x para los datos relacionales, según la experiencia de IBM, por lo que la reducción de datos del módulo FlashCore recupera menos del crecimiento, y cada reincrustación necesita nuevamente el espacio TEMP.
La regla práctica de IBM es medir antes de comprometerse. Cargue entre el 1 y el 5 por ciento del corpus real con el modelo de incrustación de producción y la configuración de segmentación, mida los bytes reales por vector, luego escale linealmente y repita el ejercicio cada vez que cambie el modelo, el número de dimensiones o la política de segmentación.
Inferencia de IA de extremo a extremo: la aplicación en el sector sanitario
IBM desarrolló la aplicación para esta validación como un asistente de radiología y gastroenterología llamado RAD-AI. Se trata de una aplicación de ejemplo con requisitos de producción, y en este artículo se demuestra un proceso de inferencia completo en la misma matriz y arquitectura que se midieron en las secciones anteriores. Un médico ingresa la edad, el sexo y el motivo de consulta del paciente, carga una radiografía de tórax o una imagen de endoscopia y recibe un informe estructurado elaborado a partir de los casos previos más similares en el archivo.
El archivo contiene 112 120 radiografías de tórax del conjunto de datos NIH ChestX-ray14 y más de 10 000 imágenes de endoscopia gastrointestinal de HyperKvasir, incluyendo vectores por fotograma de 367 vídeos de endoscopia completos, para más de 172 000 casos preincrustados. Cada imagen se convierte en un vector de 768 dimensiones a partir de un modelo CLIP ViT-L/14 que se ejecuta dentro de Oracle AI Database 26ai mediante su entorno de ejecución ONNX, por lo que la incrustación se realiza en la misma transacción que la fila que la contiene. Las imágenes originales permanecen en el almacenamiento de objetos; los vectores y los metadatos de los casos se almacenan en Oracle.

En el momento de la consulta, Oracle realiza una búsqueda aproximada del vecino más cercano mediante la distancia coseno en todo el archivo y devuelve los casos más similares, junto con sus hallazgos originales, diagnósticos y resultados. Este conjunto recuperado constituye el contexto para Llama 3, ejecutado por Ollama en una de las GPU H100 del servidor Supermicro, que genera el informe: una prioridad clínica, un resumen de los hallazgos, un diagnóstico diferencial clasificado y acciones recomendadas, con los casos coincidentes listados debajo. La endoscopia sigue el mismo proceso y añade una nota clínica; para el vídeo, el sistema inserta fotograma a fotograma para poder rastrear una lesión a lo largo del tracto gastrointestinal.
La aplicación ejecuta dos cargas de trabajo en los mismos volúmenes de FlashSystem. La carga de trabajo transaccional abarca inicios de sesión, almacenamiento de informes, registro de auditoría y sesiones; la carga de trabajo vectorial realiza lecturas aleatorias de alta distribución en las tablas de incrustación y los metadatos de los casos, coincidiendo con el perfil del generador en la demostración de QoS de E/S. La implementación de IBM establece las limitaciones de volumen descritas anteriormente para que un trabajo de reincrustación por lotes no ralentice la entrada de un médico a un caso, y la detección de ransomware y la migración de particiones mostradas anteriormente se aplican a estos volúmenes sin cambios.

El paso que consume más recursos es la creación del archivo, que IBM midió insertando el conjunto completo de 112 120 imágenes de radiografías de tórax dos veces con el mismo modelo y el mismo destino VECTOR(768, FLOAT32). Con el modelo ONNX ejecutándose dentro de la base de datos en las CPU del host, la canalización mantuvo 3.41 imágenes por segundo a 0.272 segundos por inserción, y el conjunto completo tardó 9.1 horas. Al trasladar el modelo al contenedor de Oracle Private AI Services en el segundo servidor, el rendimiento aumentó a 8.55 imágenes por segundo (0.097 segundos por imagen), y la misma ingesta finalizó en 3.6 horas.

El preprocesamiento (aproximadamente 0.019 segundos por imagen) y la inserción en Oracle (menos de un milisegundo) fueron idénticos en ambas ejecuciones, por lo que la mejora de 2.5x proviene exclusivamente del lugar donde se ejecuta el modelo. El servicio de incrustación de Private AI Services se ejecuta en un entorno de ejecución ONNX con CPU, por lo que las H100 de ese servidor no participaron en esta prueba; la mejora provino de trasladar el modelo fuera del host de la base de datos, y la parte de la GPU en la canalización es la creación del índice que se describe a continuación.
IBM midió estas cifras en el laboratorio de Colorado; nosotros no realizamos ni auditamos la prueba. La conclusión práctica es que la primera inserción de un archivo, y cada reinserción después de un cambio de modelo, es un proceso por lotes que se mide en horas, mientras que la recuperación posterior es un proceso de CPU y almacenamiento que se mide en milisegundos.
El mismo contenedor también gestiona la construcción de índices. Oracle 26ai puede enviar una compilación HNSW al servicio de índices vectoriales del contenedor, que utiliza NVIDIA cuVS en la GPU para construir el grafo de vecinos antes de devolver el índice completo a la base de datos. Las búsquedas se ejecutan sin la intervención de la GPU. En la grabación de IBM, la compilación HNSW de referencia (32 vecinos, efConstruction 200) tardó 8.47 segundos en la base de datos y 2.26 segundos con la descarga, una reducción de 3.7 veces. Esta ejecución utilizó una tabla de demostración pequeña, lo que confirma que la ruta funciona en esta configuración; aún necesitamos medir el rendimiento a escala clínica.
La aplicación demuestra la división del trabajo que constituye la base de este artículo. El servidor GPU aloja el modelo de lenguaje y, durante la creación o reconstrucción de archivos, los servicios de incrustación e indexación. La base de datos almacena los vectores junto con los registros que describen, mientras que el sistema de almacenamiento gestiona las lecturas y transacciones de recuperación. Ningún paso del proceso de recuperación utiliza una API externa, y los datos de los pacientes nunca salen del centro de datos.
IBM eligió el sector sanitario como ámbito de aplicación para demostrar el concepto, y ningún elemento del patrón es específico de este sector. Si se sustituye el archivo de radiografías por historiales de reclamaciones, registros de mantenimiento o un catálogo de productos, se mantienen los mismos tres elementos: vectores almacenados junto a los registros que describen, generación en el servidor GPU y recuperación y transacciones en una única matriz. Cualquier sector que realice inferencias sobre datos que ya posee se basa en la misma arquitectura.
Que viene despues
La validación continúa en el mismo hardware: la fase 2 traslada la caché KV del motor de inferencia de la memoria de la GPU a FlashSystem a través de la misma estructura Fibre Channel, de modo que un modelo de contexto extenso mantiene más acceso a su conjunto de trabajo; el siguiente artículo de esta serie describe este trabajo. IBM también está desarrollando una canalización de actualización con reconocimiento de contenido, donde IBM Storage Scale AFM y Kafka alimentan los nuevos documentos a la vectorización ONNX en la base de datos a medida que llegan, de manera que el índice vectorial rastrea sus fuentes sin una reinserción por lotes. IBM también planea extender la misma validación de almacenamiento a las demás bases de datos multimodelo que han incorporado la búsqueda vectorial.
La fase 2 también aplica la capa de seguridad a los nuevos datos. Cuando la caché KV se traslada a FlashSystem, el contexto de trabajo de un modelo de atención médica (incluido el historial del paciente) atraviesa los mismos enlaces Fibre Channel que el índice vectorial y los registros transaccionales. Los adaptadores Emulex SecureHBA cifran los datos de extremo a extremo durante la transmisión, desde el adaptador del host hasta la matriz de almacenamiento. La estructura Brocade Gen 8 transporta el tráfico cifrado de forma transparente y, además, ofrece criptografía postcuántica para el enlace entre conmutadores (ISL) y el tráfico de larga distancia. Cada fase añade una carga de trabajo a la estructura sin añadir una ruta por donde los datos viajen sin cifrar.
Clasificación: El perfil de IBM en nuestra página de Mejores Sistemas de Almacenamiento ahora incluye el almacenamiento en bloques FlashSystem junto con Storage Scale.
Este informe está patrocinado por Broadcom. Todas las opiniones y puntos de vista expresados en este informe se basan en nuestra opinión imparcial sobre el producto o productos en cuestión.


 Amazon