

Ollama 0.40.11 ofrece a los usuarios de Windows una aplicación de chat de escritorio y un entorno de ejecución local para otros programas. Ollama también ha evolucionado más allá de su interfaz de línea de comandos original, añadiendo un selector de modelos con función de búsqueda, la posibilidad de adjuntar imágenes y enlaces a herramientas de codificación. Algunos controles necesarios para las pruebas aún se encuentran en PowerShell y en los archivos de configuración del modelo.
Instalamos Ollama en nuestro HP Z4 Rack G5 con Windows 11 Pro para estaciones de trabajo, 128 GB de RAM y una GPU NVIDIA RTX 5000 Ada Generation. Utilizando nuestros GGUF Jan V3.5 4B y Jan V2 VL High existentes, probamos la velocidad de generación, el chat, las imágenes, la búsqueda en línea y la API local. Ollama ejecutó bien nuestros modelos locales, aunque la importación de los GGUF y la recopilación de datos de rendimiento nos sacaron del chat de escritorio. Es la tercera aplicación de nuestra serie LLM local, después de Jan y Open WebUI , y los resultados alimentan nuestra página de Mejores herramientas LLM locales.
Sistema de prueba
| Componente | Configuration |
|---|---|
| Sistema operativo | Windows 11 Pro para estaciones de trabajo |
| CPU | Intel Xeon w5-2465X, 16 núcleos |
| Salud Cerebral | 128GB |
| GPU | NVIDIA RTX 5000 Generación Ada |
| VRAM | 32 GB (32,760 MiB reportados) |
| NVIDIA controlador | 597.06 |
| Compatibilidad con CUDA | 13.2 (informado por nvidia-smi) |
| Ollama | 0.40.11 |
| Tiempo de ejecución de inferencia | Ejecutor Ollama llama.cpp (número de compilación no registrado) |
Instalación de Ollama y primeros pasos
Instalar Ollama en nuestra estación de trabajo Windows fue un alivio comparado con los problemas de configuración que habíamos tenido con otras aplicaciones de esta serie. Descargamos el instalador estándar de Windows, ejecutamos la aplicación y no tuvimos que instalar un entorno de ejecución de inferencia aparte ni buscar paquetes CUDA. Una rápida comprobación con PowerShell confirmó que Ollama 0.40.11 estaba en funcionamiento y que su servicio local ya respondía en http://127.0.0.1:11434.
La pantalla de bienvenida de Ollama presenta sus funciones de IA locales y las conexiones con herramientas de codificación antes de abrir la interfaz principal.
Tras superar la pantalla de bienvenida, Ollama mostró una interfaz de chat familiar con las conversaciones recientes, las aplicaciones y la configuración en la barra lateral izquierda. El campo de mensajes integra el botón de adjuntar archivos, la búsqueda web y el selector de modelos. Pudimos empezar a chatear con nuestros modelos locales importados sin crear una cuenta, aunque Ollama nos pidió que iniciáramos sesión cuando intentamos activar la búsqueda web durante las pruebas.
Explorar y agregar modelos
Ollama simplifica bastante la selección de modelos, con un menú desplegable que muestra tanto los modelos instalados como otros disponibles para descargar. Pudimos ver nuestros modelos Jan importados y Qwen3-VL junto con varias opciones en la nube, identificadas por un pequeño icono de nube. También hay un campo de búsqueda para encontrar otros modelos, aunque nos hubiera gustado ver más información, como el tamaño, la cuantización y los requisitos de hardware. Jan proporciona esos detalles a través de su centro de modelos, mientras que Ollama no muestra la mayor parte de esa información en la interfaz principal de chat.
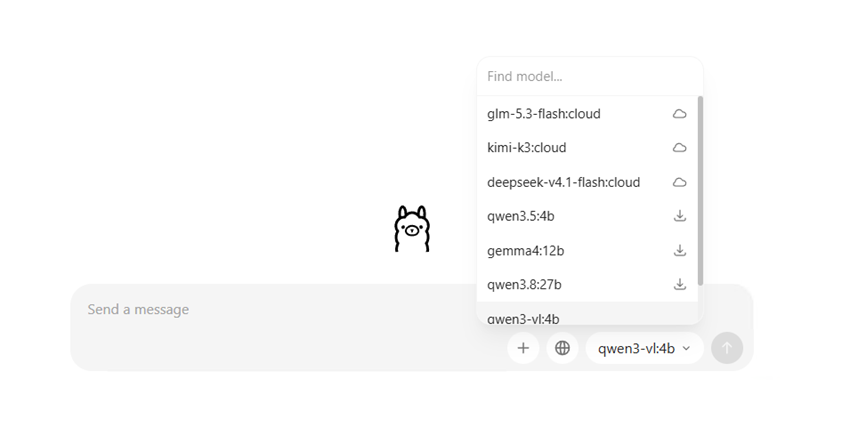
El selector de modelos combina los modelos descargables y los modelos en la nube con los modelos locales instalados.
Introducir nuestros dos modelos de referencia en Ollama requirió más trabajo porque queríamos usar exactamente los mismos archivos GGUF de nuestras revisiones anteriores, manteniendo las pruebas de rendimiento lo más comparables posible. Si bien Ollama permite descargar modelos directamente a través de su interfaz de escritorio, no pudimos encontrar una opción para importar archivos GGUF ya almacenados en la estación de trabajo. Tuvimos que usar PowerShell en su lugar, creando un Modelfile para cada modelo que apuntaba a su GGUF existente e incluía los parámetros de muestreo utilizados en nuestras pruebas anteriores. Luego usamos el ollama create comando para agregarlos a la biblioteca de modelos de Ollama.
Ambas importaciones funcionaron sin problemas, y Jan V3.5 aparece como jan-v35-sr y enero V2 VL Alto como jan-v2-srTambién descargamos Qwen3-VL 4B directamente a través de Ollama para realizar una prueba de análisis de imágenes independiente.
Después de importar los modelos, comprobamos cómo los identificaba Ollama y si su configuración se había transferido correctamente. Jan V2 VL High fue reconocido como un modelo Qwen3-VL de 8.2 mil millones de parámetros que utiliza cuantización Q4_K_M, lo que coincidía con nuestro archivo original. Jan V3.5 fue la excepción, ya que el GGUF que importamos se llamaba Jan-v3.5-4B-Q4_K_XL.gguf, pero Ollama informó su cuantización como Q4_K_M. Dejamos el archivo original sin cambios; la razón probable es que Q4_K_XL es la cuantización dinámica de Unsloth, construida principalmente a partir de capas Q4_K_M, y los metadatos del archivo registran ese tipo base.
Configuración del modelo y uso de la GPU
La página de configuración de Ollama incluye acceso a la nube, actualizaciones automáticas, acceso a la red, una ruta de almacenamiento del modelo y un control deslizante para la longitud del contexto, que mostraba 32 KB cuando la inspeccionamos por primera vez. Nuestras pruebas de rendimiento solicitaron explícitamente 8,192 tokens a través de la API, por lo que los resultados de la prueba comparativa que se muestran a continuación utilizaron ese contexto, no el predeterminado de escritorio.
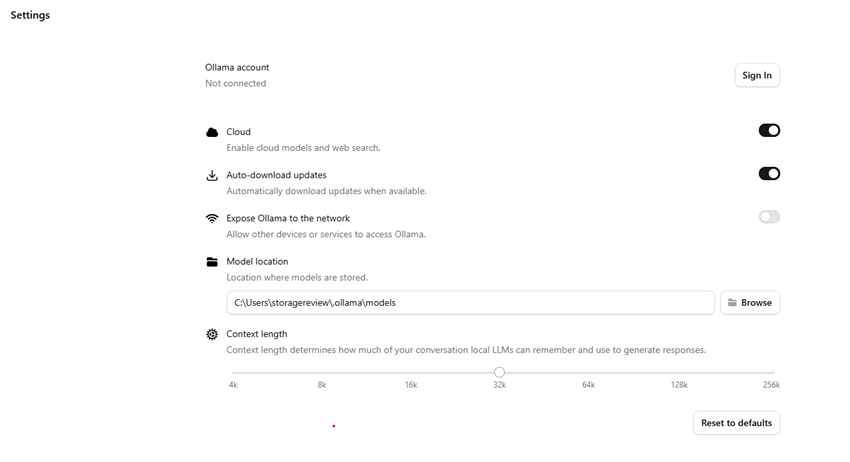
La página de Configuración ofrece opciones de nube, actualización, red, almacenamiento del modelo y longitud del contexto. La configuración inicial del contexto que se muestra aquí era de 32 KB.
Dado que Ollama no ofrece el mismo nivel de configuración de modelos a través de su interfaz de escritorio que Jan, realizamos la mayoría de los ajustes mediante Modelfiles y solicitudes a la API. Para mantener la comparabilidad de nuestros resultados, utilizamos la misma configuración que en nuestras pruebas anteriores: temperatura 0.8, K superior 40, P superior 0.95, P mínima 0.05 y una penalización por repetición de 1.0. También solicitamos un tamaño de lote de 2,048, aunque no pudimos verificar de forma independiente si Ollama lo aplicó durante la generación.
La configuración de la GPU también fue diferente, ya que no había una configuración de escritorio equivalente a las 100 capas de GPU que usamos en enero. Ollama manejó la descarga de GPU automáticamente y una comprobación rápida usando ollama ps Se confirmó que ambos modelos importados funcionaban completamente con la RTX 5000 Ada.
Verificamos ese informe con las lecturas de NVIDIA. La versión Jan V3.5 aumentó la asignación de VRAM en varios gigabytes después de la carga, y una lectura en tiempo real alcanzó el 93 % de utilización de la GPU durante la generación. La versión Jan V2 también informó de una residencia completa de la GPU y mostró un 96 % de utilización en nuestra prueba de diagnóstico. Al menos en esta estación de trabajo, no tuvimos que recurrir a una variante de CUDA o configuración de capa de GPU independiente para obtener una generación acelerada.
Rendimiento de la generación local
Para las pruebas de generación, utilizamos la misma consigna de nuestra guía práctica publicada en enero : «Explique RAID 5 y RAID 6 a alguien que esté configurando su primer NAS. Incluya las principales ventajas y desventajas de cada uno, en aproximadamente 400 palabras». Deshabilitamos la búsqueda web, establecimos el contexto en 8,192 tokens e incluimos solo ese mensaje de usuario en cada solicitud de API. Descartamos una respuesta de calentamiento por modelo y luego recopilamos tres ejecuciones medidas.
Ambos modelos completaron las tres ejecuciones medidas sin fallos de generación, y la utilización de la GPU se mantuvo alta durante todas las pruebas. Ollama no requirió ninguna configuración adicional de CUDA ni ajustes manuales en la capa de GPU para que ambos modelos funcionaran con aceleración completa de GPU, lo cual no ocurrió en Open WebUI, donde añadimos manualmente las DLL de tiempo de ejecución de CUDA.
| Modelo | Cuantización | Fichas de salida | Velocidad de decodificación | Memoria de la GPU |
|---|---|---|---|---|
| Enero V3.5 4B | Archivo Q4_K_XL* | 529 | 145.48 tok/s | 5,082 MiB |
| Enero V2 VL Alto | Q4_K_M | 1,696 | 92.87 tok/s | 7,124 MiB |
Nota: Los recuentos de tokens de salida, las velocidades de decodificación y las cifras de memoria de la GPU son la mediana de tres ejecuciones medidas tras descartar una ejecución de calentamiento. La memoria de la GPU es la mediana del uso máximo de memoria de la GPU registrado durante cada ejecución medida.
*El nombre de archivo GGUF de enero V3.5 identifica Q4_K_XL, mientras que la información del modelo de Ollama indica Q4_K_M; consulte las notas de importación anteriores.
Jan V3.5 registró 145.48, 145.73 y 145.44 tokens/seg en sus ejecuciones medidas, mientras que Jan V2 registró 92.87, 92.22 y 92.97 tokens/seg. Ambos conjuntos se mantuvieron similares de una ejecución a otra, y los picos de memoria de la GPU medidos no variaron dentro de cada conjunto. Jan V2 produjo una cantidad considerablemente mayor de tokens de salida reportados, aparentemente incluyendo la actividad de razonamiento, por lo que esos totales no son una comparación directa de la longitud visible de las respuestas.
En la misma estación de trabajo y con los mismos archivos de modelo, estos son los resultados más rápidos de esta serie hasta el momento. Jan V3.5 decodificó un 18 % más rápido que en Jan mismo (123 tokens/seg) y un 26 % más rápido que en Open WebUI Desktop (115.32), y Jan V2 superó a Jan en un 13 % (82) y a Open WebUI en un 24 % (75.06). Cada aplicación ejecuta su propia compilación llama.cpp y gestiona la descarga de GPU a su manera, por lo que la comparación refleja el paquete completo que cada una incluye, no solo el modelo.
No publicamos las medianas de procesamiento inmediato porque las solicitudes repetidas producían tiempos muy cortos que podrían haber sido afectados por el almacenamiento en caché. Tampoco es posible que la configuración de tiempo de ejecución sea idéntica en todos los aspectos: Jan exponía las capas de la GPU directamente, mientras que Ollama gestionaba la descarga automáticamente.
Uso de Ollama para chat local
Una vez instalados los modelos, seleccionamos Jan V3.5 o Jan V2 en el menú desplegable e ingresamos la solicitud RAID. Las respuestas aparecieron con encabezados y listas, mientras que las conversaciones recientes permanecieron en la barra lateral. Ollama no mostraba la tasa de generación ni el número de tokens debajo de las respuestas, por lo que recopilamos esos datos a través de su API.
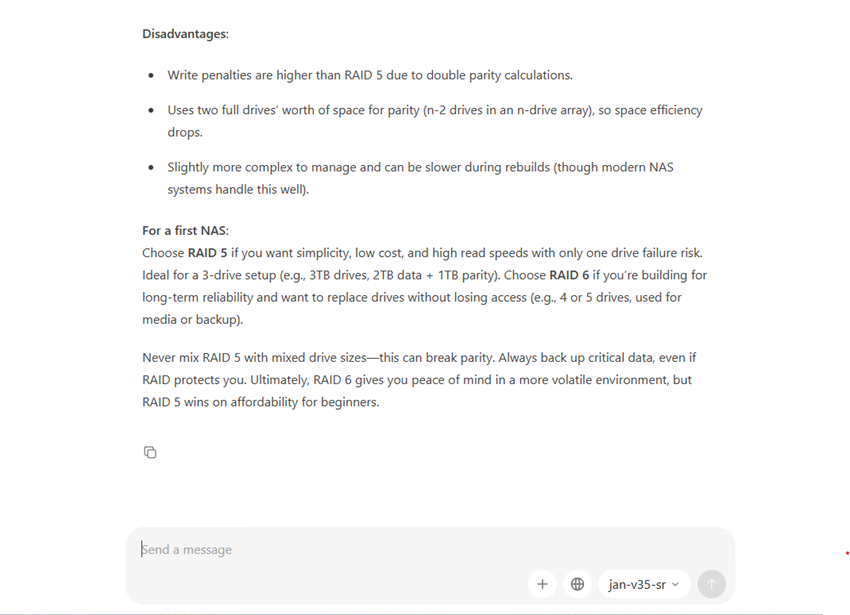
La versión 3.5 de enero responde a la pregunta sobre RAID 5 frente a RAID 6 en el chat de escritorio de Ollama, sin mostrar la tasa de tokens debajo de la respuesta.
Gestionar las conversaciones en Ollama era bastante sencillo, ya que al hacer clic derecho en una conversación anterior aparecían opciones para renombrarla o eliminarla, con la opción Compartir disponible en Más herramientas. También podíamos volver atrás y editar las preguntas que ya habíamos enviado, aunque no había tantas opciones para las respuestas del modelo. El único botón que encontramos fue Copiar, que permanece visible debajo de cada respuesta incluso cuando no se pasa el cursor sobre ella. No pudimos encontrar la manera de regenerar una respuesta ni ver sus estadísticas de generación desde la ventana de chat, al menos en la versión que probamos.
Ollama también cuenta con una sección de aplicaciones con asistentes de codificación, como Codex CLI, Claude Code, OpenCode y Cline. Queríamos ver cómo funcionaban estas integraciones, así que hicimos clic en Codex CLI para ver qué configuración requería. Ollama no abrió una pantalla de configuración; simplemente copió un comando de inicio al portapapeles y nos indicó que lo pegáramos en una terminal. No completamos la instalación ni ejecutamos Codex, pero nos dio una mejor idea de cómo Ollama conecta los modelos locales con aplicaciones externas.
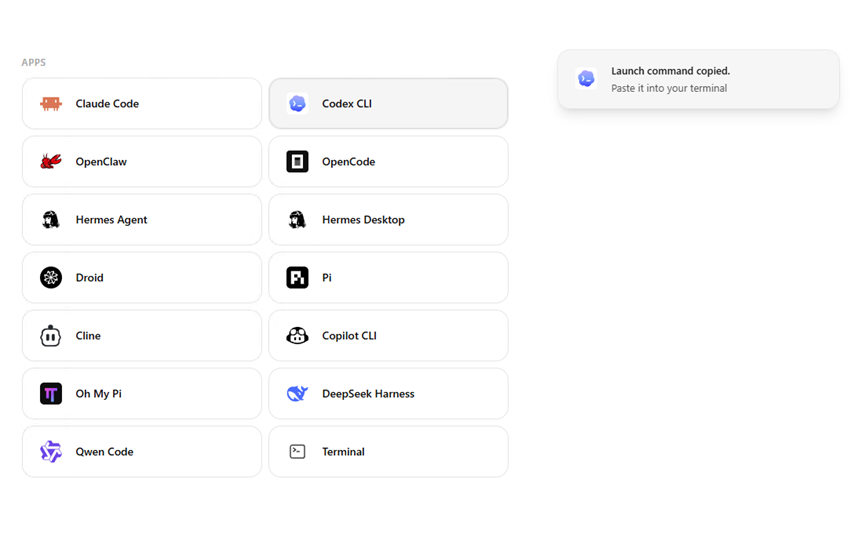
Al seleccionar Codex CLI en la página de Aplicaciones, se copió un comando de inicio para la terminal; no ejecutamos la integración en sí.
Búsqueda e internet
Ollama coloca un botón con forma de globo terráqueo junto al control de archivos adjuntos en el chat, pero al seleccionarlo aparecía un mensaje que indicaba que la búsqueda web requería una cuenta de Ollama. Tras crear una cuenta gratuita y activar la función, utilizamos nuestra pregunta de prueba habitual, que solicitaba la última versión estable de Open WebUI, con fecha del 15 de octubre de 2026, junto con una cita de la fuente.
Nos topamos con otro problema al probar la función de búsqueda web de Ollama: la aplicación intentó recuperar resultados, pero devolvió un mensaje de "error de API de búsqueda (estado 402)". El código HTTP 402 indica que se requiere un pago, lo que sugiere que el servicio de búsqueda necesita un plan de pago, aunque Ollama no lo especificó. El modelo sugirió que el problema podría estar relacionado con el precio de la cuenta o los límites de uso, pero no pudimos determinar la causa exacta. Dado que nuestros modelos locales funcionaban correctamente, decidimos no dedicar más tiempo a solucionar el problema del servicio de búsqueda. Aun así, fue decepcionante no poder completar la misma prueba de búsqueda web que habíamos intentado con las otras aplicaciones de esta serie.
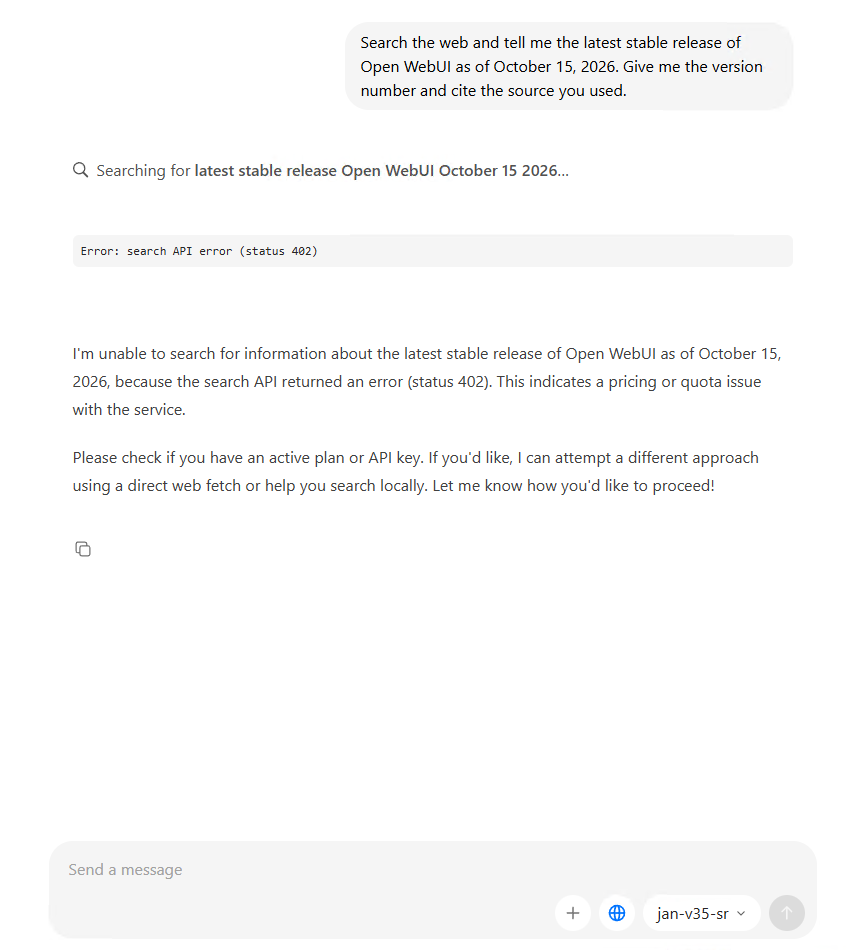
Ollama intentó realizar la consulta en nuestra versión en línea, pero la API de búsqueda devolvió un error HTTP 402.
Entrada multimodal
Nuestra primera prueba de imagen utilizó el mismo Jan V2 VL High GGUF que funcionaba con un proyector de visión independiente en Jan. Ollama aceptó el archivo del modelo de lenguaje, pero nuestro procedimiento de importación no asoció el archivo mmproj correspondiente. Cuando intentamos adjuntar la captura de pantalla de NVIDIA a una conversación de Jan V2, la aplicación de escritorio mostró el mensaje "Este modelo no admite imágenes" antes de que pudiéramos enviar la solicitud.
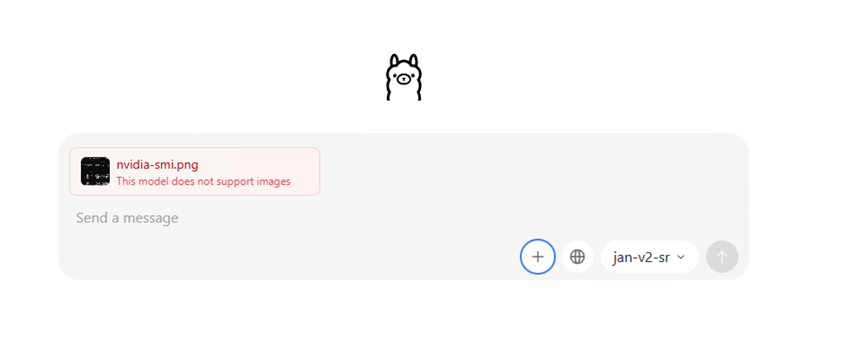
Nuestro modelo Jan V2 VL High importado rechazó la captura de pantalla de NVIDIA, indicando que no admitía imágenes en esta configuración.
Luego probamos Qwen3-VL 4B, descargado a través de Ollama, usando la misma solicitud para el modelo de GPU, la versión del controlador, la VRAM, la utilización, la temperatura y el consumo de energía. Ese modelo aceptó la captura de pantalla y finalizó con los seis valores correctos: RTX 5000 Ada Generation, controlador 597.06, 32,760 MiB, 0 por ciento de utilización, 39 °C y 40 W. Su respuesta no fue perfecta en todo momento, ya que brevemente mostró una lectura incorrecta de 8 por ciento de utilización antes de corregir ese valor en el resumen final.
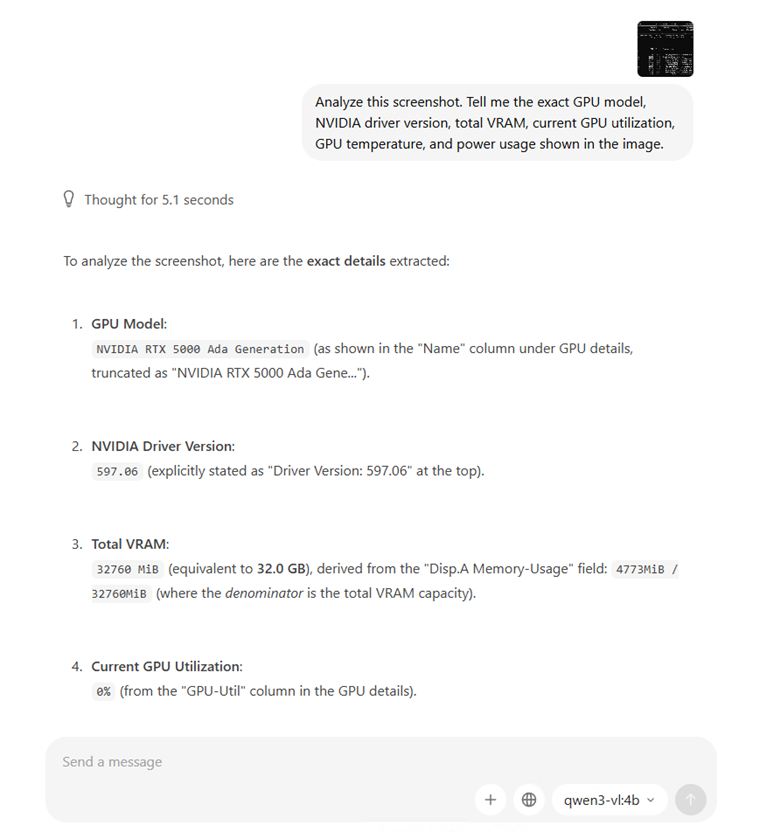
El analizador Qwen3-VL 4B de Ollama procesó la captura de pantalla de NVIDIA adjunta e identificó los detalles del hardware; su resumen final proporcionó las seis lecturas correctamente.
En Ollama, no pudimos pegar una imagen directamente desde la herramienta Recortes de Windows en la ventana de chat como en las demás aplicaciones. En su lugar, tuvimos que guardar primero la captura de pantalla y luego subirla usando el botón "+" junto al campo de mensaje. Esto funcionó sin problemas y el modelo Qwen3-VL de Ollama analizó la imagen correctamente. Nuestro modelo Jan V2 importado no pudo aceptar el mismo archivo adjunto, lo que limitó nuestra capacidad para repetir la prueba multimodal original.
Servidor API local
La API local de Ollama estuvo disponible tan pronto como se inició su servicio de Windows, sin necesidad de iniciar un servidor separado desde la interfaz de escritorio. Una solicitud a http://127.0.0.1:11434/v1/models Devolvimos nuestros modelos Jan V3.5 y Qwen3-VL instalados, y una solicitud para /v1/chat/completions Utilizando Jan V3.5 se generó una explicación de RAID 6 en una sola frase.
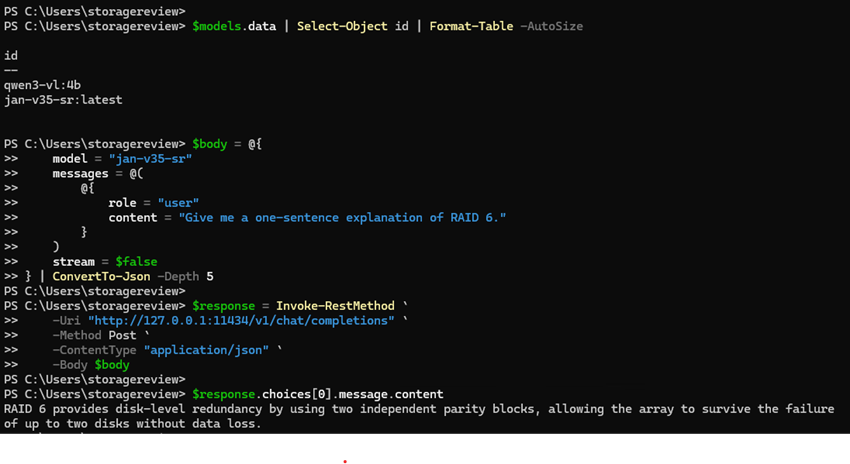
La API local compatible con OpenAI devolvió la lista de modelos instalados de Ollama y una respuesta de chat RAID 6 a través de PowerShell.
La respuesta utilizó una terminología de paridad RAID 6 ligeramente imprecisa, lo cual fue un problema de salida del modelo, no un fallo de la API. El punto final que funcionó nos permitió consultar los modelos locales directamente desde PowerShell sin usar el chat de escritorio.
Qué salió mal
El problema más frustrante que encontramos fue lograr que nuestro modelo Jan V2 VL High importado funcionara con imágenes. No tuvimos problemas al importar el archivo GGUF ni al ejecutar mensajes de texto con aceleración GPU completa, pero la situación cambió cuando intentamos adjuntar nuestra captura de pantalla de NVIDIA. Ollama nos indicó que el modelo no admitía imágenes porque nuestra importación no incluía el proyector de visión independiente que requiere Jan V2. Aun así, pudimos completar la prueba de análisis de imágenes utilizando la descarga de Qwen3-VL de Ollama, que funcionó sin problemas. Esto demostró que Ollama podía procesar imágenes, pero lograr que nuestro modelo Jan V2 existente hiciera lo mismo no fue tan sencillo como importar su archivo GGUF.
Para usar la función de búsqueda web, tuvimos que crear una cuenta de Ollama antes de poder activarla. Tras iniciar sesión y enviar nuestra pregunta de prueba, el servicio devolvió un error HTTP 402 y ningún resultado de búsqueda. No pudimos determinar la causa del error, y no tenía mucho sentido seguir cambiando la configuración de la cuenta o probando diferentes planes sin saber si eso solucionaría el problema.
También notamos la frecuencia con la que teníamos que recurrir a PowerShell para tareas como importar nuestros modelos existentes, ajustar su configuración y recopilar mediciones de rendimiento. La aplicación de escritorio era fácil de usar para la comunicación diaria, pero no ofrecía el mismo nivel de control que la interfaz de Jan. Aparte de estos inconvenientes, Ollama no nos dio mayores problemas durante las pruebas: ambos modelos se importaron correctamente, se completaron las seis pruebas de rendimiento y la API local funcionó según lo previsto.
Conclusión
Nuestras pruebas con Ollama 0.40.11 fueron en general bien, especialmente al lograr que los modelos locales se ejecutaran en la RTX 5000 Ada. Ambos GGUF importados funcionaron con aceleración completa de GPU sin necesidad de configuración adicional de CUDA, y el rendimiento lideró la serie, con Jan V3.5 alcanzando una mediana de 145.48 tokens/seg y Jan V2 VL High alcanzando 92.87 tokens/seg, los resultados más rápidos de esta serie y entre un 13 y un 18 por ciento por encima de Jan en la misma estación de trabajo. Una vez que todo estuvo configurado, no tuvimos problemas para alternar entre la interfaz de chat de escritorio y la API local, y todas las ejecuciones de benchmark medidas se completaron sin problemas.
Si bien nos gustó la sencillez de Ollama para el chat cotidiano, hubiéramos preferido un mayor control sobre los modelos individuales en la aplicación de escritorio. Tener que usar PowerShell y crear archivos de modelo para importar nuestros GGUF existentes añadió algunos pasos adicionales, especialmente en comparación con Jan, donde la mayoría de esas configuraciones están disponibles directamente en la interfaz. Esto no necesariamente molestará a alguien que ya esté familiarizado con la ejecución de modelos locales, pero los nuevos usuarios que deseen administrar todo a través de una interfaz gráfica podrían encontrar Ollama limitado. También tuvimos algunos problemas con la búsqueda web y nuestro modelo de visión importado, aunque ninguno afectó la generación normal de texto.
Lo que más nos gustó de Ollama fue la facilidad con la que podía servir modelos locales a otras aplicaciones sin necesidad de configurar un servidor aparte. El chat de escritorio es muy fácil de usar, mientras que la API local y la compatibilidad con herramientas de codificación externas permiten a los usuarios hacer mucho más que simplemente chatear con modelos locales. Si bien nos gustaría ver mejores controles de gestión de modelos en la interfaz de escritorio, Ollama tuvo un buen rendimiento en nuestra estación de trabajo y nos proporcionó una forma fiable de ejecutar nuestros dos modelos de prueba con aceleración por GPU.
Clasificación: Ollama ostenta el título de Mejor Tiempo de Ejecución Local de LLM en nuestra página de Mejores Herramientas Locales de LLM , donde estos resultados aparecen ahora junto a nuestras cifras de enero y Open WebUI.


 Amazon