

Open WebUI combina chat, gestión de modelos, archivos, búsqueda web, llamadas a herramientas, soporte de imágenes, funciones de conocimiento y acceso a la API en una única interfaz de IA local. Para esta reseña práctica, nos centramos en la versión de escritorio para Windows y utilizamos el mismo hardware y los mismos archivos de modelo que en nuestras pruebas anteriores de la versión 0.8.6 de enero, para poder comparar ambas aplicaciones en condiciones similares.
Esta es la segunda entrada en nuestra clasificación de las mejores herramientas LLM locales , donde vamos añadiendo resultados de rendimiento repetibles del mismo hardware de prueba a medida que avanzamos con las plataformas de la lista.
Open WebUI es una plataforma de IA de código abierto y autoalojada, diseñada para proporcionar a los modelos de IA locales y remotos una interfaz basada en navegador que se ve y funciona de forma muy similar a los servicios de chat de IA comerciales con los que la gente ya está familiarizada. Puede conectarse a diferentes backends de inferencia y servicios compatibles con OpenAI, mientras que la aplicación de escritorio que probamos puede ejecutar modelos GGUF localmente a través de su entorno llama.cpp integrado. Esto le otorga un alcance mucho mayor que el de una aplicación de chat local básica, especialmente una vez que se habilitan las herramientas, los preajustes de modelos, la búsqueda web, los archivos y el acceso a la API.
Para las pruebas, volvimos a usar la misma estación de trabajo HP Z4 Rack G5 , la GPU NVIDIA RTX 5000 Ada Generation y dos modelos Jan GGUF utilizados en nuestra revisión de Jan v0.8.6. Mantuvimos el contexto de 8,192 tokens, el tamaño de lote de 2,048, las 100 capas de GPU y los valores de muestreo coincidentes para las ejecuciones de texto medidas, al tiempo que dedicamos tiempo a los ajustes preestablecidos del modelo de Open WebUI, la entrada multimodal, la búsqueda web DDGS, la obtención de URL y la API local.
Lograr que Open WebUI funcionara correctamente nos llevó mucho más tiempo del esperado, y la mayor parte de ese tiempo se dedicó a la configuración local de llama.cpp y CUDA antes incluso de llegar a las pruebas normales del modelo. Finalmente conseguimos que todo funcionara, pero en el proceso nos topamos con una descarga defectuosa del entorno de ejecución predeterminado, archivos CUDA faltantes, asignaciones de contexto extremadamente grandes y algunos problemas con el sistema de herramientas integrado.
Sistema de prueba
Mantuvimos la configuración del sistema sin cambios con respecto a nuestras pruebas de enero para que los resultados del modelo fueran más fáciles de comparar entre aplicaciones, al tiempo que registrábamos las versiones de escritorio, servidor, Python y llama.cpp utilizadas para esta ejecución de Open WebUI.
| Componente | Configuration |
| Sistema operativo | Windows 11 Pro para estaciones de trabajo |
| CPU | Intel Xeon w5-2465X, 16 núcleos |
| Salud Cerebral | 128GB |
| GPU | NVIDIA RTX 5000 Generación Ada |
| VRAM | 32,760 MiB (31.99 GB) |
| NVIDIA controlador | 597.06 |
| Compatibilidad con CUDA | 13.2 reportado por nvidia-smi |
| Abrir interfaz web de escritorio/servidor | v0.0.20/v0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612, CUDA 12.4 |
Instalación de Open WebUI Desktop
El instalador de escritorio de Windows comienza con una pantalla de configuración del entorno donde se puede instalar localmente llama.cpp, habilitar Open Terminal y cambiar la ubicación de instalación en la sección Avanzado. Dejamos Open Terminal deshabilitado, habilitamos llama.cpp, mantuvimos la carpeta predeterminada en el perfil de usuario de Windows y continuamos con la configuración local.
Una vez instalados los paquetes y el entorno Python incluido, Open WebUI nos pidió que seleccionáramos una conexión y luego abrió la interfaz local tipo navegador. En una instalación nueva, Open WebUI se mostraba como la conexión disponible, seguida de la pantalla Crear cuenta de administrador, que establece el primer administrador local antes de que se abra la ventana principal de chat.
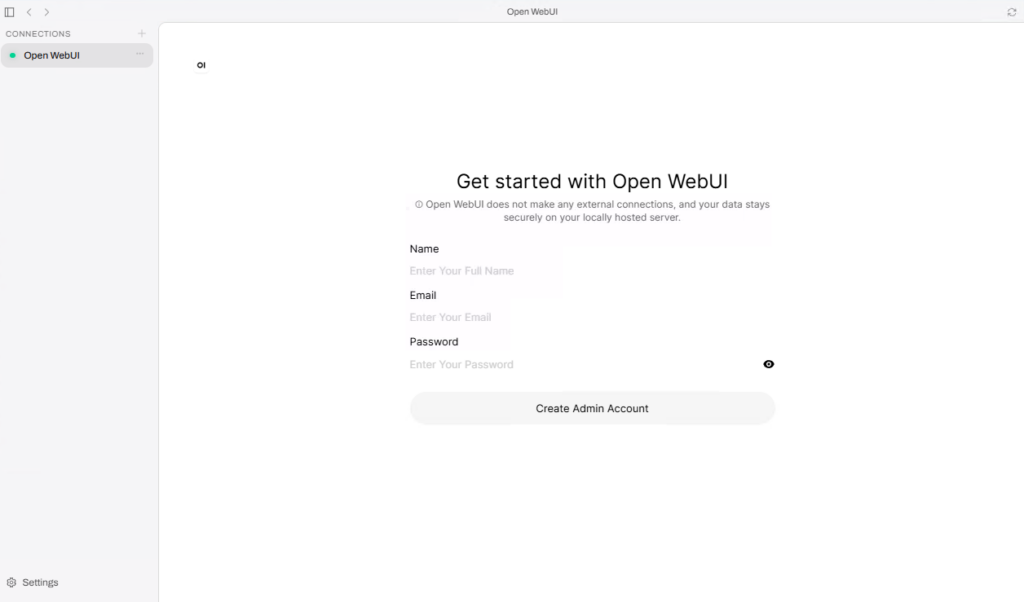
Una instalación local nueva de Open WebUI solicita la primera cuenta de administrador antes de abrir la interfaz de chat principal.
Un detalle que puede resultar confuso al principio es que Open WebUI Desktop y el servidor local de Open WebUI utilizan versiones distintas. Nuestra configuración final empleó Desktop v0.0.20 con Open WebUI Server v0.12.2, y el servidor se ejecutaba desde el entorno Python 3.12.13 incluido, bajo el perfil móvil del usuario de Windows.
Agregar modelos y configurar llama.cpp
La aplicación de escritorio separa los archivos del modelo del entorno de ejecución de inferencia, por lo que la página Modelos gestiona los GGUF locales mientras que Entorno de ejecución de inferencia controla llama.cpp. Copiamos los mismos archivos Jan V3.5 4B Q4_K_XL y Jan V2 VL High Q4_K_M que utilizamos en nuestras pruebas anteriores, junto con el archivo de proyección multimodal V2, y ambos modelos aparecieron en el selector después de que el entorno de ejecución estuviera activo.
El primer problema de ejecución surgió al intentar instalar llama.cpp. Al dejar seleccionado el campo Versión con CUDA 12.4, la instalación falló casi de inmediato. Al revisar el registro del escritorio, vimos que Open WebUI había resuelto la versión más reciente a llama.cpp v0.6.0 e intentaba descargar un archivo CUDA de Windows que no estaba disponible en esa versión, así que fijamos la compilación b11612 y volvimos a intentarlo.
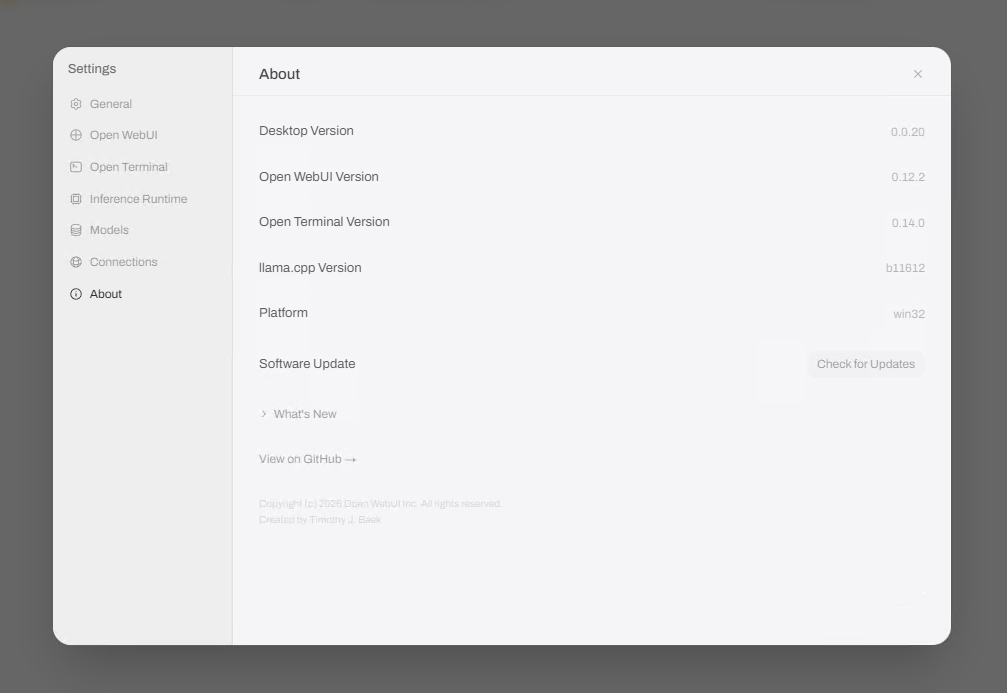
La página "Acerca de" enumera las versiones independientes de Escritorio, Open WebUI, Open Terminal y llama.cpp utilizadas durante las pruebas.
Eso nos permitió superar el primer problema, pero llama.cpp seguía sin iniciarse porque el paquete DLL de tiempo de ejecución de CUDA no se había descargado con el archivo principal. Añadimos manualmente cudart64_12.dll, cublas64_12.dll y cublasLt64_12.dll del paquete oficial de CUDA 12.4 al directorio b11612, tras lo cual llama-server se inició con normalidad en el puerto 18881 y los modelos aparecieron en la interfaz de chat.
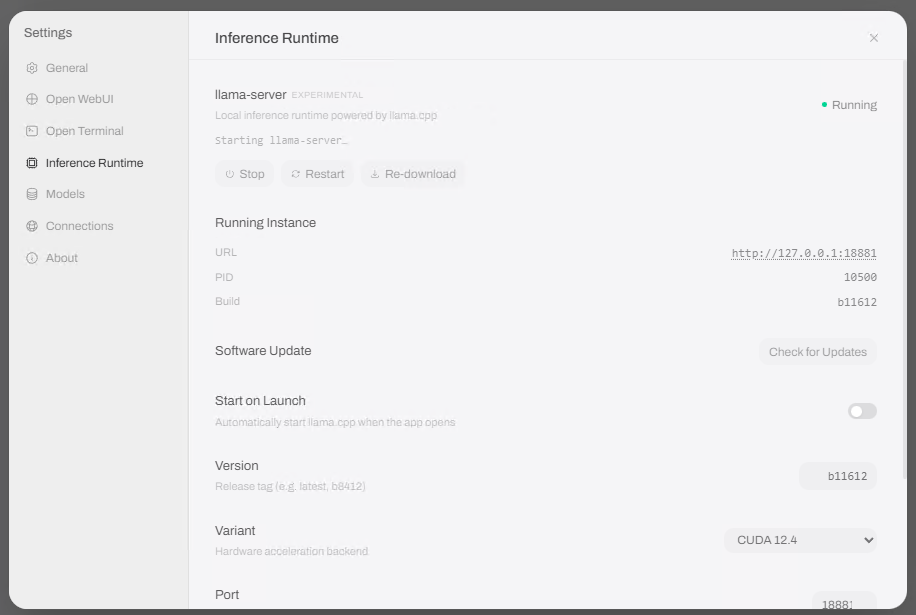
Tras fijar la compilación b11612 y añadir las DLL de tiempo de ejecución de CUDA necesarias, llama.cpp se ejecutó localmente en el puerto 18881.
Configuración del modelo y uso de la GPU
Open WebUI distribuye la configuración de su modelo tanto en la aplicación de escritorio como en la interfaz web principal, por lo que requiere un periodo de aprendizaje al principio. La aplicación de escritorio gestiona los archivos GGUF y el entorno de ejecución llama.cpp, mientras que la interfaz principal añade parámetros por chat, preajustes del modelo de espacio de trabajo, funcionalidades, herramientas integradas, opciones de búsqueda web y administración del servidor.
Para nuestras pruebas de texto medidas, llama.cpp utilizó un contexto de 8,192 tokens, un tamaño de lote de 2,048 y 100 capas de GPU, con el almacenamiento en caché de solicitudes deshabilitado mediante –no-cache-prompt, de modo que el uso repetido de la misma solicitud de referencia aún produciría una medición de prellenado real. El registro de tiempo de ejecución también confirmó que Open WebUI pasó el valor de GPU configurado a cada proceso del modelo como –n-gpu-layers 100.
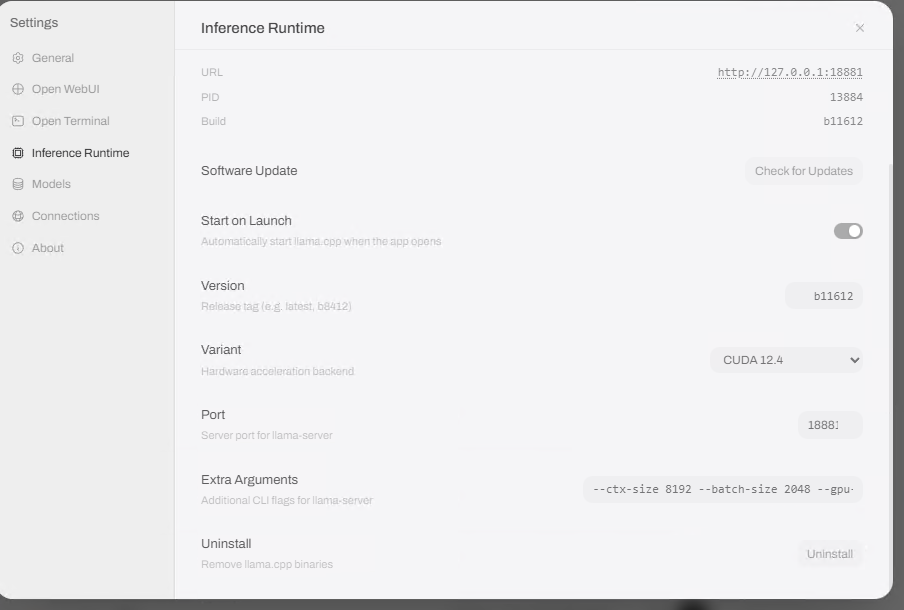
En nuestras pruebas, utilizamos un contexto de 8,192 tokens, un tamaño de lote de 2,048, 100 capas de GPU y desactivamos el almacenamiento en caché de solicitudes.
La configuración predeterminada del chat de Open WebUI no coincidía con los valores de Jan en todos los campos, por lo que cambiamos los controles relevantes antes de cada ejecución medida. La temperatura se mantuvo en 0.8 y Top K se mantuvo en 40, mientras que Top P pasó de 0.9 a 0.95, Min P pasó de 0 a 0.05, la penalización por frecuencia pasó de 1.1 a 0, la penalización por presencia se mantuvo en 0, la repetición del último N se mantuvo en 64 y la penalización por repetición se estableció en 1.0.
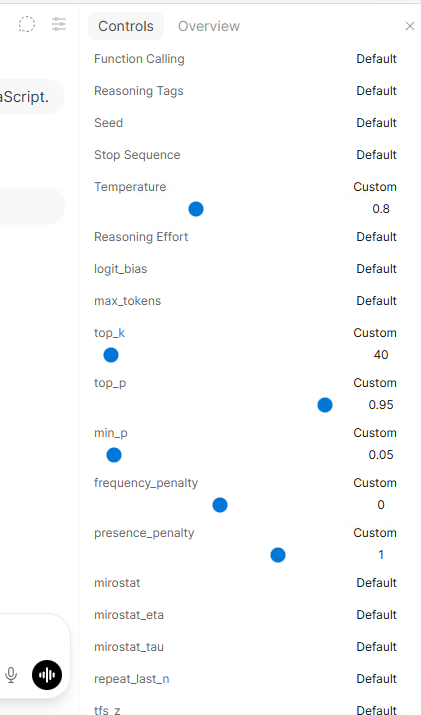
Antes de cada prueba de texto medida, ajustamos los valores de muestreo de enero en Open WebUI.
Terminamos creando preajustes de espacio de trabajo específicos para ambos modelos de referencia y desactivando sus herramientas integradas. Esto se hizo necesario después de descubrir que una sesión normal del modelo Open WebUI podía adjuntar un gran conjunto de instrucciones de herramientas incluso antes de que se enviara nuestra solicitud, lo que añadía suficiente contexto de herramientas como para que la solicitud V2 superara nuestro límite de 8,192 tokens.
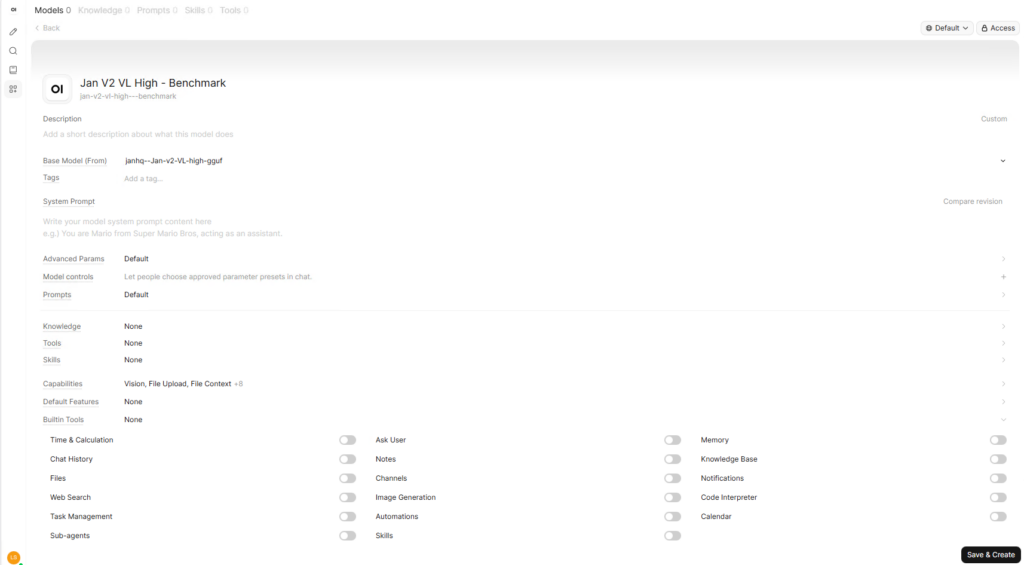
Un ajuste preestablecido de espacio de trabajo específico nos permitió deshabilitar las herramientas integradas sin modificar el GGUF subyacente.
Rendimiento de la generación local
El mensaje de referencia se mantuvo idéntico al de la ejecución de enero:
“Explica RAID 5 y RAID 6 a alguien que está montando su primer NAS. Incluye las principales ventajas y desventajas de cada uno, en unas 400 palabras.”
La búsqueda web estaba desactivada, la primera respuesta tras cargar cada modelo se descartaba como calentamiento y, a continuación, registrábamos tres ejecuciones de chat nuevas por modelo.
| Modelo | Cuantización | Decodificación de la mediana | Salida mediana | Tiempo total medio |
| Enero V3.5 4B | Q4_K_XL | 115.32 tok/s | Tokens 520 | 4.78 s |
| Enero V2 VL Alto | Q4_K_M | 75.06 tok/s | Tokens 1,612 | 21.81 s |
La versión Jan V3.5 4B finalizó con una tasa de decodificación media de 115.32 tokens/seg, una salida media de 520 tokens y un tiempo total de generación medio de 4.78 segundos. La versión Jan V2 VL High alcanzó los 75.06 tokens/seg, produjo una salida media de 1,612 tokens y tardó una media de 21.81 segundos, siendo su proceso de razonamiento mucho más largo el principal responsable de la diferencia de tiempo.
En comparación con nuestros resultados de enero v0.8.6 en la misma estación de trabajo, Open WebUI fue aproximadamente un 6.2 % más lento con V3.5 4B y aproximadamente un 8.5 % más lento con V2 VL High. Jan alcanzó 123 y 82 tokens/seg respectivamente, aunque las aplicaciones utilizaban diferentes compilaciones de llama.cpp, por lo que esta comparación refleja las configuraciones de software completas que probamos y no el rendimiento de llama.cpp en sí.
Configuración predefinida del espacio de trabajo y chat local
Una vez completada la configuración inicial, la experiencia de chat resultó mucho más sencilla, y los preajustes de Workspace se convirtieron rápidamente en una de las funciones más utilizadas. Cada preajuste puede apuntar al mismo GGUF, a la vez que conserva sus propias capacidades, herramientas integradas, aviso del sistema, opciones de conocimiento y parámetros avanzados, lo que nos permitió mantener configuraciones separadas para pruebas de rendimiento y búsqueda web sin duplicar el modelo.
El sistema preconfigurado también nos ayudó a resolver uno de los fallos más extraños de la configuración de referencia. Cuando usamos Jan V2 VL High como modelo base, Open WebUI intentó automáticamente una llamada a query_knowledge_files durante la prueba RAID y envió la solicitud más allá de nuestro límite de contexto de 8,192 tokens. Al crear una configuración preconfigurada de referencia con Builtin Tools configurado en None, se redujo el aviso de generación real a 41 tokens y se evitó que la llamada a la herramienta adicional interfiriera con la prueba.
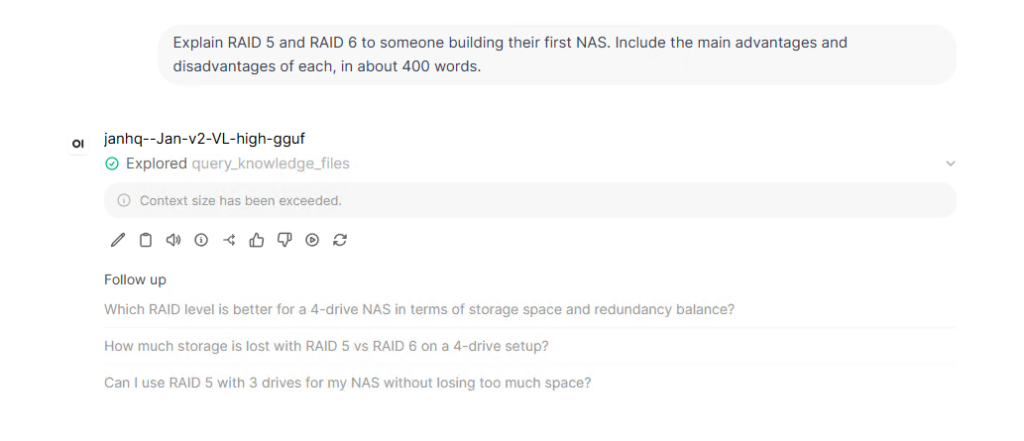
El modelo V2 sin procesar superó el contexto de 8,192 tokens después de que Open WebUI añadiera una llamada a una herramienta de archivo de conocimiento integrada.
Para un uso habitual, el mismo sistema preconfigurado puede utilizarse en sentido inverso, asignando a un modelo local funciones como búsqueda web, acceso a archivos u otras herramientas, mientras que otro preajuste se mantiene simplificado para el chat. Este enfoque funcionó bien durante esta revisión, ya que permitió mantener el modelo de referencia separado del modelo de búsqueda web sin crear otra copia de GGUF.
Entrada multimodal
Jan V2 VL High detectó automáticamente su archivo de proyección multimodal, así que reutilizamos la captura de pantalla de nvidia-smi de nuestra reseña de Jan y solicitamos el modelo exacto de GPU, el controlador, la VRAM total, la utilización actual, la temperatura de la GPU y el consumo de energía que se muestran en la imagen. El modelo devolvió correctamente todos los valores solicitados.
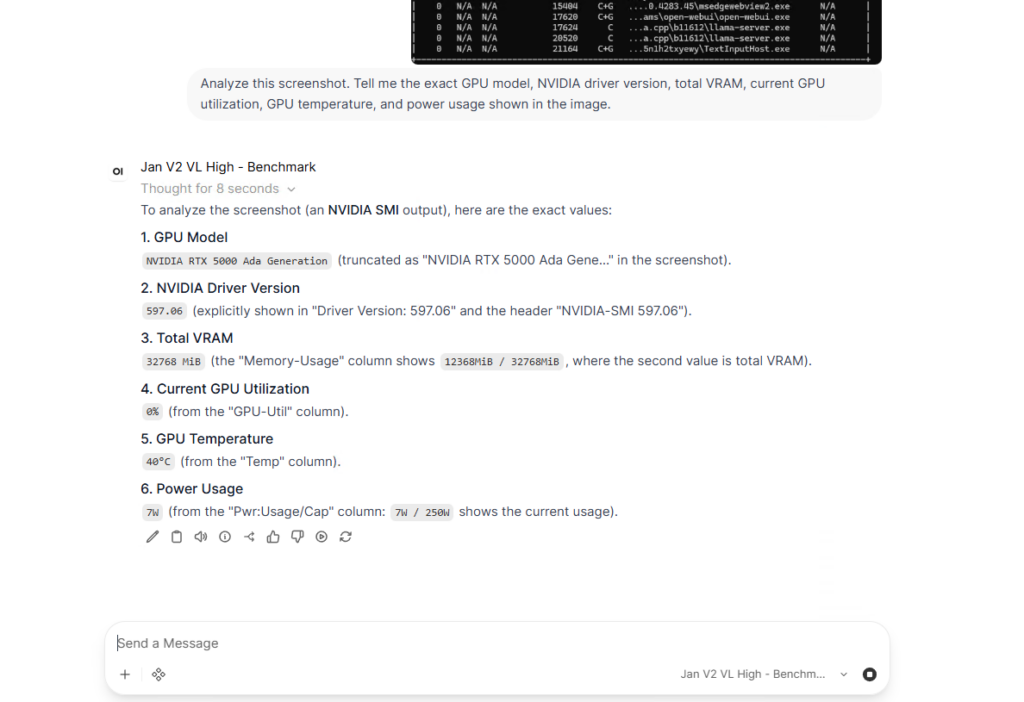
Jan V2 VL High identificó correctamente los valores solicitados de GPU, controlador, VRAM, utilización, temperatura y potencia a partir de la captura de pantalla de nvidia-smi.
La respuesta identificó la NVIDIA RTX 5000 Ada Generation, controlador 597.06, 32,760 MiB de VRAM total, 0% de utilización, 40 °C y 7 W / 250 W. Estas lecturas coincidieron con la captura de pantalla, lo que le dio a Open WebUI una calificación positiva en nuestra prueba multimodal cualitativa.
Búsqueda e internet
La búsqueda web tiene su propia sección en la configuración de administrador, con controles para el proveedor de búsqueda, el número de resultados, la carga de URL, el comportamiento SSL y otras opciones de recuperación. Seleccionamos DDGS porque no requería otra clave API y creamos un preajuste Jan V3.5 4B independiente con la búsqueda web y el acceso a la herramienta integrada necesaria habilitados.
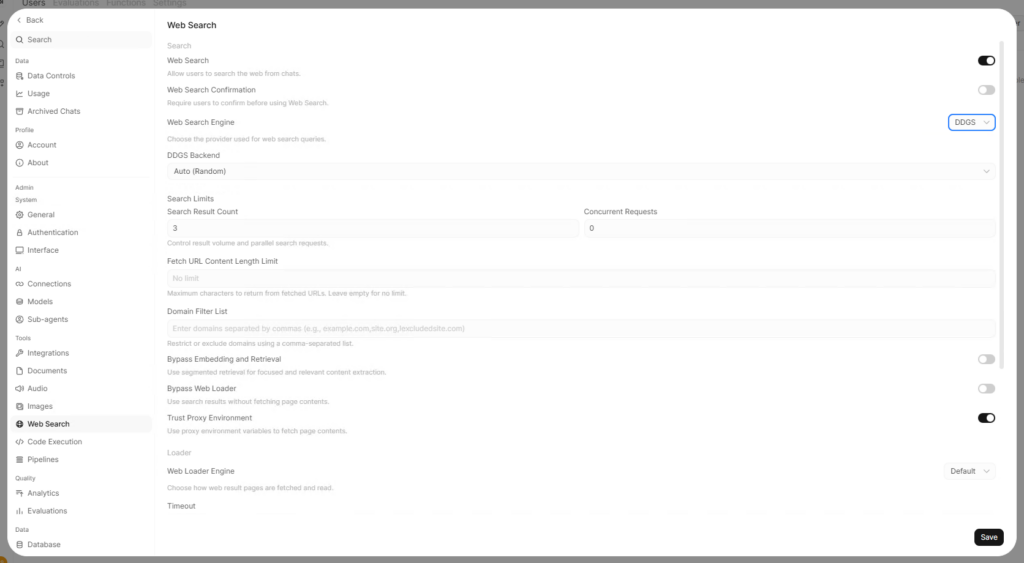
Habilitamos la búsqueda web y seleccionamos a DDGS como proveedor para la prueba de búsqueda local.
Nuestra primera prueba puso de manifiesto una de las limitaciones de combinar un modelo local pequeño con varios pasos de herramientas. La versión 3.5 logró ejecutar search_web y encontrar la página de lanzamientos de Open WebUI en GitHub, pero se detuvo ahí en lugar de abrir el resultado y recurrió a su conocimiento interno anterior. La respuesta indicó erróneamente que el 15 de octubre de 2026 era una fecha futura, a pesar de que la búsqueda ya había encontrado la página correcta.
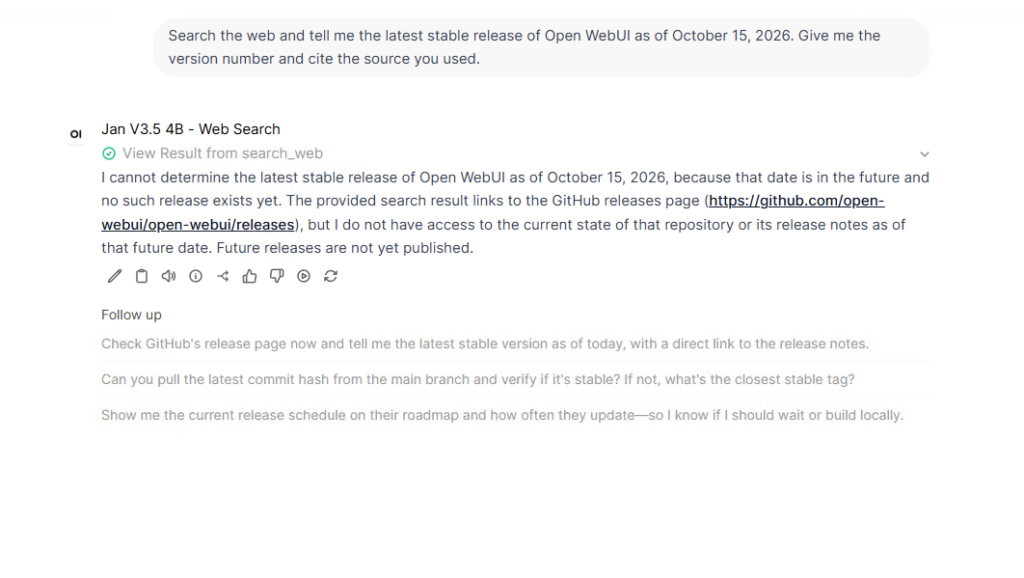
DDGS devolvió la página de versiones de Open WebUI GitHub, pero el modelo 4B no recuperó la página antes de responder.
Volvimos a intentarlo con una solicitud que le indicaba explícitamente al modelo que usara `fetch_url` después de la búsqueda, y esta vez ambas herramientas se ejecutaron. Sin embargo, la página de GitHub obtenida aumentó la solicitud a 17 689 tokens, lo que superó con creces nuestro límite de contexto de 8 192 tokens. Al establecer el límite de longitud del contenido de la URL de obtención en 8 000 caracteres, la solicitud volvió a estar bajo control, y la siguiente ejecución identificó correctamente Open WebUI v0.12.2, citando la página de lanzamientos de GitHub como su origen.
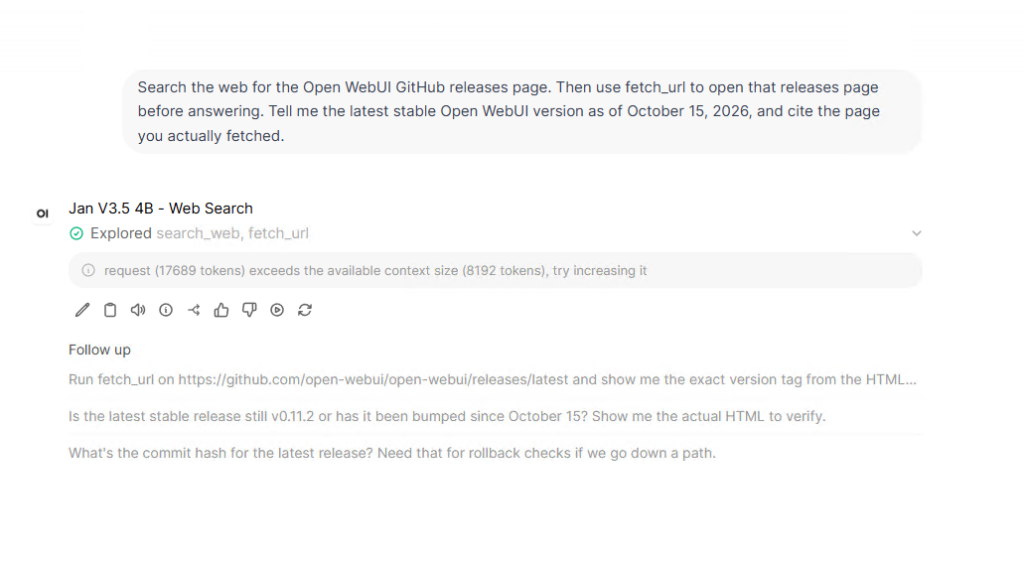
El primer intento de obtener la URL generó 17,689 tokens y superó nuestro límite de 8,192 tokens.
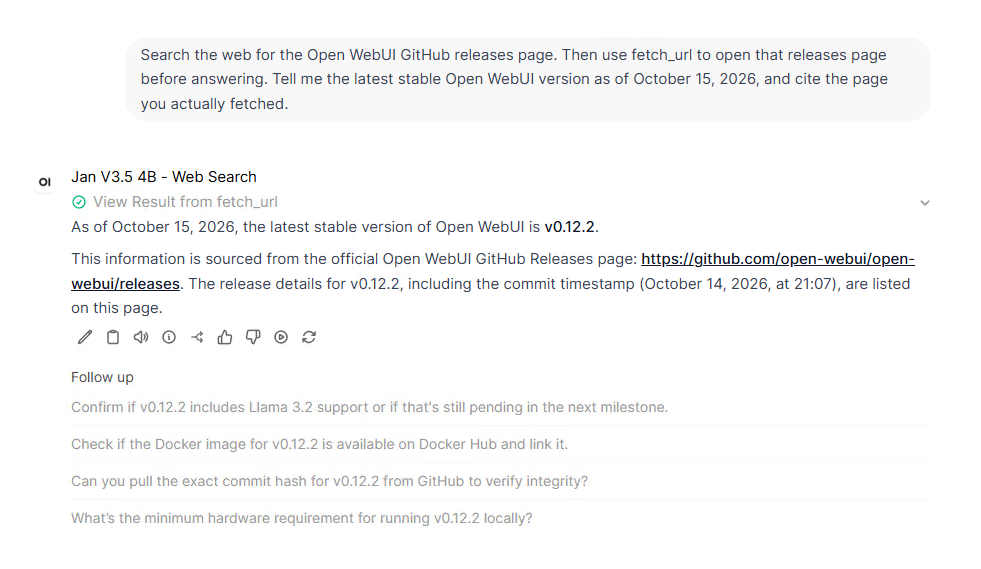
Tras limitar el contenido de las URL obtenidas, el modelo informó correctamente de Open WebUI v0.12.2 desde la página de versiones de GitHub.
API locales
La prueba de la API fue mucho más sencilla después de todo lo que pasamos con la búsqueda web. Habilitamos las claves de API y consultamos http://127.0.0.1:8080/api/models desde PowerShell, lo que devolvió tanto los modelos GGUF sin procesar como los tres preajustes de Workspace que habíamos creado. Esto también confirmó que los preajustes estaban disponibles a través del servidor local y no se limitaban a la interfaz de chat.
A continuación, realizamos una solicitud POST a /api/chat/completions utilizando el preajuste de referencia Jan V3.5 4B, y Open WebUI devolvió un resumen correcto de RAID 5 frente a RAID 6. PowerShell mostró un guion Unicode como un carácter ilegible en la salida de la consola, pero la respuesta generada en sí no presentaba ningún problema.
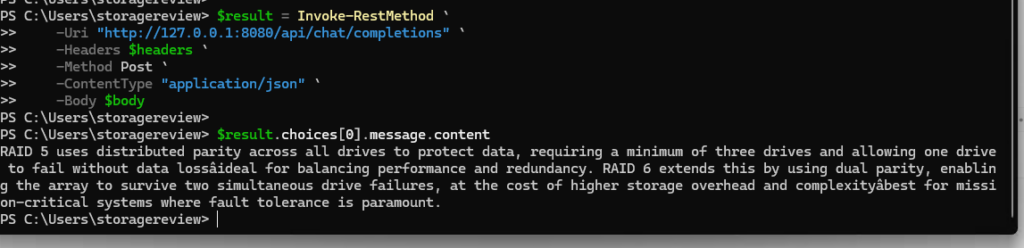
La API local autenticada devolvió una finalización de chat exitosa a través del preajuste de referencia Jan V3.5 4B.
Qué salió mal
Durante la configuración surgieron varios problemas, por lo que conviene recopilar aquí los más importantes, especialmente para quienes planean usar la versión de escritorio de Windows con inferencia CUDA local. La instalación predeterminada de la última versión de llama.cpp falló, tuvimos que fijar la compilación b11612 y, además, fue necesario copiar las DLL de tiempo de ejecución de CUDA por separado en el directorio llama.cpp antes de que se iniciara el servidor local.
Una reinstalación limpia provocó un problema diferente al eliminar los argumentos de tiempo de ejecución que habíamos estado utilizando. Sin –ctx-size 8192, llama.cpp recurrió a los valores de contexto nativos muy grandes de los modelos en sus ranuras de servidor, con V2 VL High alcanzando 169,984 tokens por ranura y V3.5 alcanzando 192,000. El uso de VRAM se acercó al límite de 32 GB de la RTX 5000 Ada y la sesión de escritorio remoto se volvió notablemente más lenta hasta que restauramos el contexto de 8,192 tokens.
Los demás problemas surgieron del sistema de herramientas de Open WebUI. Las herramientas integradas añadieron suficiente contexto como para interrumpir la prueba V2 sin procesar, mientras que la búsqueda web requirió un paso de obtención explícito y un límite de URL de 8,000 caracteres antes de que la versión 3.5 completara la solicitud completa de búsqueda y obtención. Finalmente, resolvimos cada problema utilizando la configuración y los registros de la aplicación, pero preparar Open WebUI para pruebas repetibles llevó mucho más tiempo que nuestra configuración de enero en la misma estación de trabajo.
Conclusión
Al finalizar las pruebas, Open WebUI había cubierto todo lo que queríamos probar en esta ronda, incluyendo la generación de texto local, la lectura de imágenes multimodales, la búsqueda DDGS, la obtención de URL, los ajustes preestablecidos de modelos personalizados y el acceso autenticado a la API.
El rendimiento en la generación de texto fue ligeramente inferior al de Jan en la misma estación de trabajo, con Open WebUI alcanzando 115.32 tokens/seg en Jan V3.5 4B y 75.06 tokens/seg en Jan V2 VL High, en comparación con 123 y 82 tokens/seg en Jan v0.8.6. La diferencia de rendimiento fue relativamente pequeña, mientras que la diferencia en el tiempo de configuración fue mucho mayor porque nuestra instalación de Open WebUI para Windows requirió trabajo manual con llama.cpp y CUDA antes de estar lista para pruebas repetibles.
Para quienes buscan una interfaz local para modelos, herramientas, búsqueda, archivos, preajustes y flujos de trabajo de API, Open WebUI permite reutilizar el mismo GGUF en perfiles de evaluación comparativa simplificados, preajustes habilitados para web y llamadas a la API sin duplicar los archivos del modelo. Nuestra configuración en Windows requirió más trabajo manual que la de Jan, incluyendo la fijación de llama.cpp, la adición de las DLL de CUDA faltantes y la restauración de los argumentos de tiempo de ejecución tras la reinstalación, pero una vez configurada, admitía una gama mucho más amplia de flujos de trabajo de modelos locales desde la misma instalación.
Estos resultados se suman a las cifras de enero en nuestra clasificación de las mejores herramientas locales de LLM , y mantendremos la misma estación de trabajo, los mismos modelos y el mismo mensaje mientras revisamos el resto de la lista.


 Amazon