

AMD, Spectro Cloud et Supermicro ont annoncé AMD Instinct Coder, une plateforme d'inférence d'entreprise validée, conçue pour les charges de travail de programmation IA. Cette solution combine les accélérateurs GPU AMD Instinct, l'infrastructure IA de Supermicro et PaletteAI Inference Launchpad de Spectro Cloud afin de proposer une solution clé en main pour le déploiement d'environnements d'inférence IA privés et hybrides.
L'architecture est conçue pour les entreprises, les fournisseurs de cloud et les opérateurs d'IA souverains qui doivent optimiser le traitement local, l'accès aux modèles de pointe, la gouvernance opérationnelle et la consommation de jetons. Au lieu d'acheminer toutes les requêtes de l'agent de codage vers des modèles de langage externes volumineux, AMD Instinct Coder utilise un routage basé sur des politiques pour déterminer si une requête doit être traitée par un modèle déployé localement ou transmise à un point de terminaison de modèle de pointe externe.
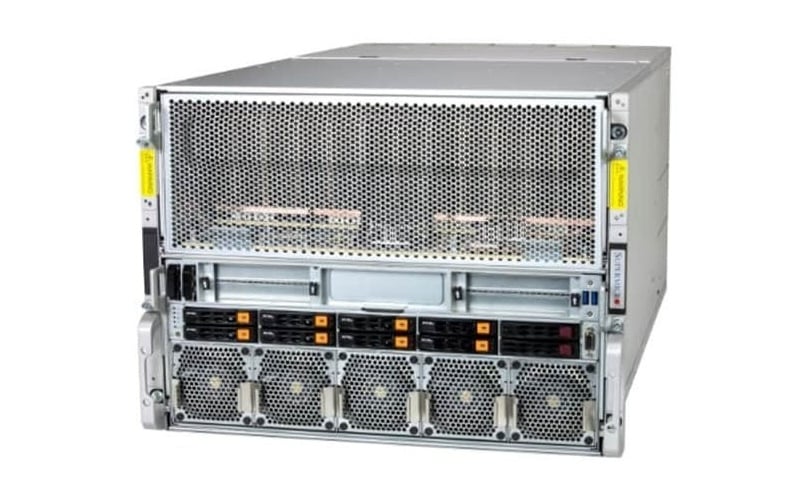
Cette approche cible les charges de travail où le codage de routine, la génération de code, la synthèse et les tâches similaires peuvent être gérés localement, tandis que les raisonnements plus complexes ou les fonctionnalités spécialisées restent accessibles via des modèles externes. La plateforme vise à réduire la dépendance à un fournisseur de modèle unique tout en préservant, le cas échéant, le code sensible, les invites et les données contextuelles au sein d'une infrastructure contrôlée. Les partenaires affirment que cet accord peut réduire les coûts des jetons de codage IA jusqu'à 70 %, AMD présentant ce même chiffre comme coût total de possession et évoquant un retour sur investissement en seulement six mois. Ces chiffres n'ont pas été vérifiés de manière indépendante.
Cette annonce intervient alors que les entreprises déploient massivement des outils de codage IA au sein de leurs équipes de développement et de leurs flux de travail automatisés. Dans son rapport du 24 juin 2026, intitulé « Gartner prévoit que les coûts du codage IA dépasseront le salaire moyen d'un développeur d'ici 2028 en raison de l'explosion de la consommation de jetons » , Gartner indique que les coûts des jetons pourraient dépasser les gains de productivité en l'absence d'un modèle opérationnel structuré. AMD Instinct Coder répond à cette problématique grâce au routage des modèles, à la mesure de la charge de travail, aux quotas et aux politiques de gestion de la charge.
La configuration initiale devrait utiliser des GPU AMD Instinct MI325X. Chaque accélérateur MI325X intègre 256 Go de mémoire HBM3E et une bande passante mémoire maximale de 6 To/s, ciblant les charges de travail d'inférence d'IA générative gourmandes en mémoire. AMD positionne la plateforme autour de son portefeuille d'accélérateurs Instinct et de son écosystème logiciel ROCm, afin de prendre en charge l'inférence locale sans que les organisations aient à assembler et valider l'ensemble de la pile matérielle et logicielle de manière indépendante. L'inférence locale exécute un modèle GLM-5.2 optimisé par les microservices d'inférence AMD, et la plateforme expose les quotas de jetons, les journaux d'audit et la visibilité des coûts via les tableaux de bord Grafana et Prometheus.
Spécifications techniques
| Spécifications | Configuration de référence d'AMD Instinct Coder |
|---|---|
| Hardware | |
| Server | Supermicro AS-8126GS-TNMR |
| CPU | 2 processeurs AMD EPYC 9575F, 64 cœurs, 3.3 GHz |
| GPU | 8 x AMD Instinct MI325X |
| Mémoire | 3 To (24 x 128 Go) DDR5 RDIMM 6400 ECC |
| Stockage de démarrage | 2 x 960 Go NVMe PCIe Gen4 V6 M.2 |
| Stockage de données | 8 SSD PCIe Gen5 TLC U.2 de 7.68 To |
| Networking | 2 x AMD Pensando Pollara 400 HHHL PCIe NIC, 400 GbE |
| Tuning Moteur | 6 alimentations haute efficacité redondantes de 5250 W (configuration 3+3) de niveau titane |
| Logiciels | |
| Plateforme complète | Plateforme de lancement d'inférence PaletteAI de Spectro Cloud |
| Gestion complète du cycle de vie de l'IA Gouvernance d'entreprise à grande échelle Routage intelligent privilégiant le local, contournement des frontières lorsque cela est justifié Visibilité et contrôle complets de l'utilisation et du coût de l'IA |
|
| Modèles d'IA | |
| Fournisseurs | Modèle de microservices d'inférence AMD GLM-5.2 |
| Frontière (lorsque justifié) | Anthropique Claude GPT OpenAI Google Gémeaux |
| Outils de développement | |
| IDE/outils pris en charge | Claude Code Curseur Visual Studio Code |
| Assistance | |
| Logiciels | Assistance logicielle complète de Spectro Cloud |
| Hardware | Intervention sur site le jour ouvrable suivant pendant 3 ans avec Supermicro |
| Scale | |
| Capacités | Jusqu'à 50 développeurs par nœud, 30 simultanés |
Supermicro fournit l'infrastructure d'IA d'entreprise sous-jacente. Ses systèmes compatibles incluent des plateformes à huit GPU refroidies par air ou par liquide, avec les accélérateurs AMD Instinct séries MI325X et MI350 . L'expertise de Supermicro comprend la prévalidation, l'intégration en rack et la qualification du système, afin de simplifier le déploiement et d'accélérer la transition entre l'infrastructure livrée et la production.
Spectro Cloud PaletteAI Inference Launchpad fournit la couche logicielle opérationnelle. La plateforme prend en charge le routage entre les modèles locaux et distants, l'application de politiques spécifiques aux charges de travail, la mesure des jetons, les quotas de consommation et la séparation multi-tenant pour les équipes et les utilisateurs. Le logiciel est conçu pour maintenir l'exécution locale des charges de travail appropriées tout en conservant une connectivité de secours vers les modèles distants hébergés en externe.
L'architecture qui en résulte utilise une inférence hiérarchisée, attribuant les points de terminaison du modèle en fonction des performances requises, de la sensibilité, des capacités du modèle, des objectifs de coût et de la capacité d'infrastructure disponible. Pour les équipes de plateforme, cela permet de standardiser la manière dont la demande de codage IA est provisionnée et gérée pour l'ensemble des utilisateurs et applications internes. Dan McNamara, vice-président senior et directeur général de la division Calcul et IA d'entreprise chez AMD, a décrit ce changement comme le passage du codage IA d'un outil de développement individuel à une décision de plateforme d'entreprise. BMC compte parmi les premiers utilisateurs ; Tom Davies, vice-président des opérations SaaS, décrit AMD Instinct Coder comme une couche d'inférence performante et économique pour les travaux d'ingénierie des agents Helix de l'entreprise.
La configuration initiale d'AMD Instinct Coder devrait être livrée sur des systèmes Supermicro équipés de GPU AMD Instinct MI325X. Les partenaires présentent la plateforme à l'événement Ai4 de Las Vegas cette semaine. Les configurations finales, la disponibilité, le support régional et les prix restent soumis à la validation et à l'approbation des partenaires. Les spécifications ci-dessus décrivent donc la configuration de référence et non une référence commerciale avec un prix public. Les organisations souhaitant procéder à une évaluation peuvent contacter Spectro Cloud via sa page « Premiers pas ».


 Amazon