

AMD a publié les résultats de son test MLPerf Inference v6.0, positionnant le GPU Instinct MI355X comme une plateforme d'inférence évolutive pour les déploiements mono-nœud, multi-nœuds et hétérogènes. Au-delà des gains de performance habituels, l'ajout de nouvelles charges de travail a permis de démontrer un débit à l'échelle du cluster supérieur à 1 million de jetons par seconde et de valider la reproductibilité des résultats au sein d'un écosystème de partenaires en pleine expansion.
L'architecture CDNA 4 vise une inférence à haute capacité
Le GPU Instinct MI355X repose sur l'architecture CDNA 4 d'AMD , gravée en 3 nm | 6 nm FinFET par TSMC (elle utilise une conception à double processus : les puces de calcul (XCD) sont gravées en 3 nm, tandis que les puces d'E/S le sont en 6 nm). Intégrant 185 milliards de transistors, il prend en charge les formats de données FP4 et FP6. Il est important de noter que cette densité de transistors est répartie sur l'ensemble du boîtier multi-chiplets, et non sur une puce monolithique. Chaque GPU embarque jusqu'à 288 Go de mémoire HBM3E, permettant la prise en charge de modèles jusqu'à 520 milliards de paramètres sur un seul appareil. AMD considère cette combinaison de densité de calcul et de capacité mémoire comme essentielle à l'inférence de modèles complexes sans partitionnement excessif de ces derniers.
La plateforme est disponible en configurations UBB8 avec des options de refroidissement par air et par liquide direct, répondant ainsi aux exigences de déploiement des centres de données.
Le débit multinœud dépasse 1 million de jetons par seconde
L'un des principaux résultats de ce tour de table est le dépassement par AMD du million de jetons par seconde à l'échelle du cluster. Grâce aux GPU Instinct MI355X, AMD a atteint ce seuil sur Llama 2 70B en mode serveur et hors ligne, et sur GPT-OSS-120B en mode hors ligne.
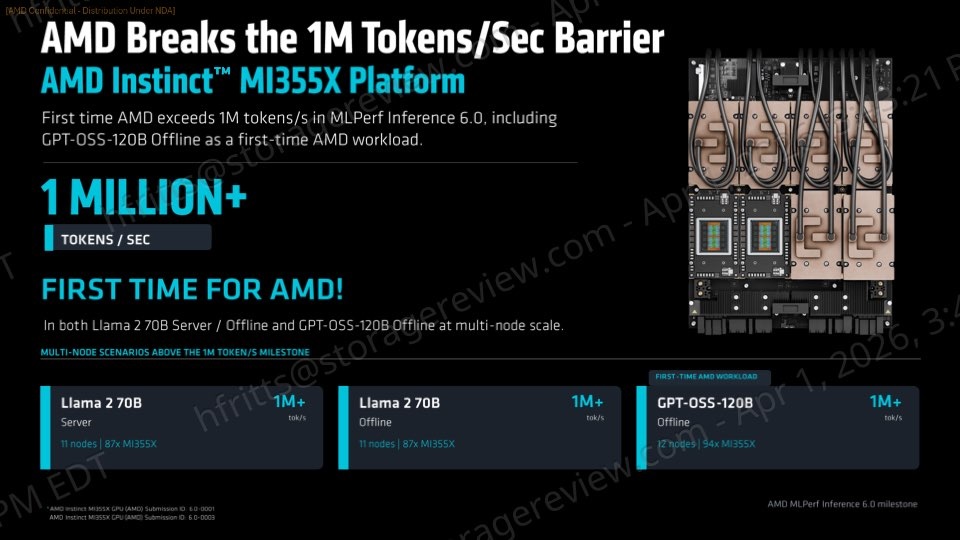
Ces résultats témoignent d'une évolution vers une évaluation des performances d'inférence au niveau du cluster plutôt que par accélérateur. Le débit agrégé et le temps de réponse sont de plus en plus utilisés pour déterminer l'état de préparation à la production des déploiements d'IA à grande échelle.
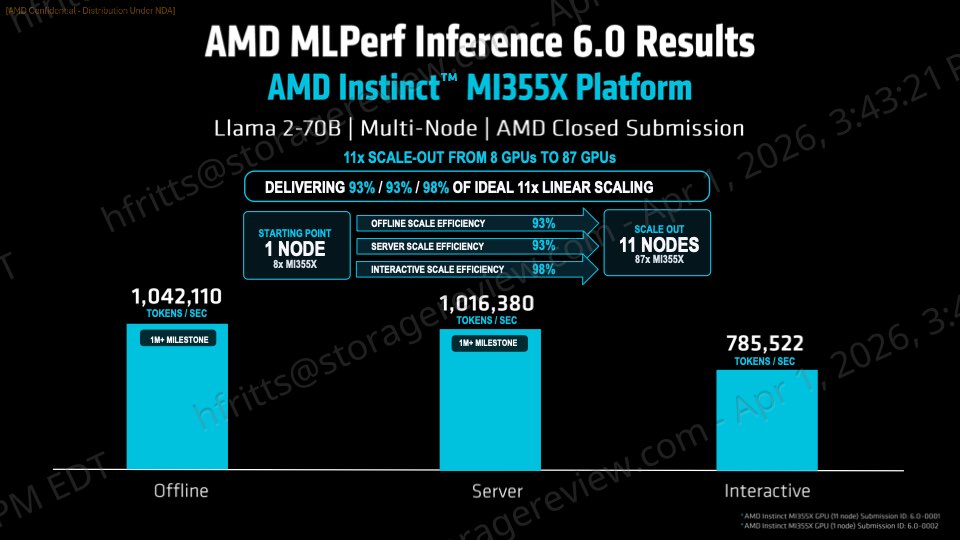
AMD a également démontré une mise à l'échelle efficace. Sur Llama 2 70B, une configuration de 11 nœuds et 87 GPU a atteint plus d'un million de jetons par seconde dans les scénarios hors ligne, serveur et interactif, avec une efficacité de mise à l'échelle horizontale comprise entre 93 % et 98 %. Sur GPT-OSS-120B, un cluster de 12 nœuds et 94 GPU a atteint un débit similaire avec une efficacité de mise à l'échelle supérieure à 90 %. Ces résultats indiquent que les gains de performance se traduisent efficacement par des déploiements s'étendant au-delà d'un seul système.
Gains générationnels et performances compétitives sur un seul nœud
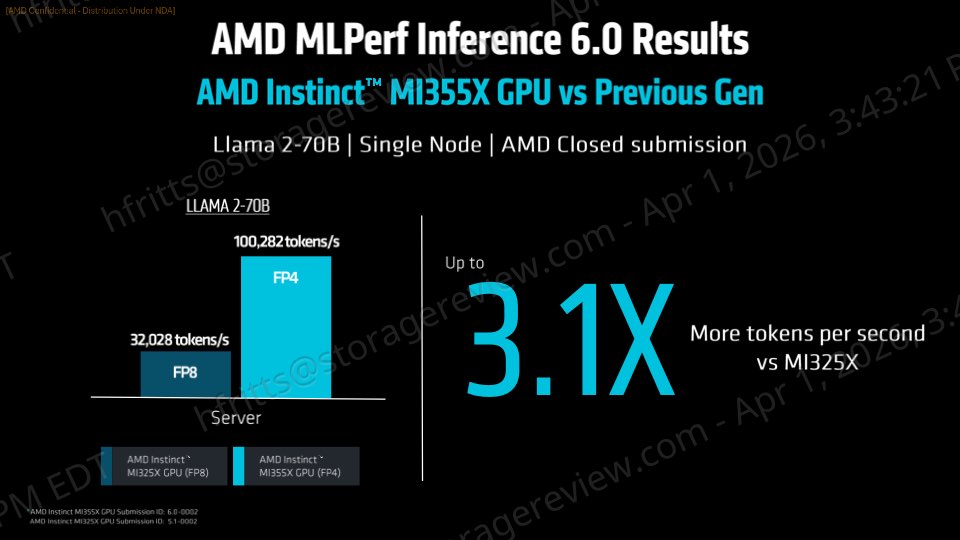
AMD a annoncé une augmentation des performances de 3.1x sur le serveur Llama 2 70B par rapport à la génération précédente Instinct MI325X, atteignant 100 282 jetons par seconde. Cette amélioration est due à la fois aux modifications architecturales et aux optimisations logicielles ROCm. Les scores hors ligne ont été multipliés par 4.4 et les scores serveur par 4.8 par rapport aux versions précédentes. Ces gains sont principalement attribuables à la quantification FP4.
Lors de comparaisons sur un seul nœud, le MI355X a démontré sa compétitivité face aux plateformes NVIDIA. Sur Llama 2 70B, AMD a égalé le NVIDIA B200 en termes de débit hors ligne, a atteint des performances quasi équivalentes en mode serveur et a surpassé les performances en mode interactif. Face au B300 de Nvidia, le GPU d'AMD affiche 92 % de performances en mode hors ligne, 93 % en mode serveur et le surpasse de 104 % en mode interactif.
L'activation du modèle pour la première fois étend la couverture
MLPerf Inference v6.0 intègre plusieurs nouvelles charges de travail, et AMD a profité de cette session pour démontrer la rapidité d'activation des modèles. GPT-OSS-120B, un modèle de type « mix of experts », a été introduit pour la première fois et a obtenu des résultats compétitifs par rapport aux systèmes NVIDIA, aussi bien en mode hors ligne qu'en mode serveur.
AMD a également soumis des résultats concernant la génération de texte en vidéo sur WAN 2.2, marquant ainsi son entrée dans le domaine de l'inférence vidéo multimodale et générative. Bien que la soumission officielle se soit concentrée sur la latence du flux unique, les résultats se sont avérés compétitifs par rapport à ceux des plateformes existantes. Un réglage ultérieur a permis d'améliorer encore les performances, ce qui indique un potentiel d'optimisation à mesure que le logiciel évolue.
Ces ajouts soulignent la volonté d'AMD d'aller au-delà des benchmarks LLM traditionnels pour prendre en charge les charges de travail d'IA émergentes.
Le logiciel ROCm permet la mise à l'échelle et l'inférence hétérogène
AMD attribue une grande partie des performances et de l'évolutivité à sa pile logicielle ROCm. Parmi les améliorations, on note l'optimisation de l'exécution FP4, l'amélioration de la communication entre GPU pour l'inférence distribuée et la prise en charge de la répartition dynamique de la charge de travail dans des environnements hétérogènes.
La première configuration hétérogène soumise à MLPerf a été développée à l'aide de trois modèles de GPU AMD Instinct : MI300X, MI325X et MI355X. Soumise par Dell et MangoBoost, cette configuration a atteint 141 521 jetons par seconde sur un serveur Llama 2 70B et 151 843 jetons par seconde sur un serveur Llama 2 70B hors ligne.
Il est à noter que la plateforme AMD Instinct MI355X était hébergée dans le laboratoire de Dell aux États-Unis, tandis que les plateformes Instinct MI300X et MI325X se trouvaient en Corée. Ceci démontre la capacité de coordonner des systèmes situés dans des zones géographiques différentes.
Croissance et reproductibilité des écosystèmes
L'écosystème de partenaires d'AMD s'est étoffé lors de cette session MLPerf, avec la soumission de résultats par neuf entreprises sur plusieurs générations de GPU Instinct. Parmi les fournisseurs participants figuraient Cisco, Dell, Giga Computing, HPE, MangoBoost, MiTAC, Oracle, Supermicro et Red Hat.
Les résultats obtenus par les partenaires correspondent étroitement aux résultats internes d'AMD, généralement à 4 % près et, dans certains cas, à 1 % près. Cette cohérence indique que les performances sont reproductibles sur les plateformes OEM et cloud, ce qui réduit les risques liés au déploiement et renforce la confiance dans les résultats concrets.


 Amazon