

Cloudera lance Cloudera Anywhere Cloud , une plateforme hybride de données et d'IA conçue pour créer, déployer et faire évoluer des charges de travail de production sur des clouds publics, des environnements souverains et des infrastructures privées sur site. La plateforme peut fonctionner de manière autonome ou s'intégrer directement aux lacs de données d'entreprise existants. Elle offre un plan de contrôle centralisé qui assure une gestion automatisée, un provisionnement de services modulaire et une gouvernance des données uniforme, sans nécessiter de migration des données hors des niveaux de stockage locaux.
Aperçu architectural et mobilité des charges de travail
Cloudera Anywhere Cloud utilise une architecture modulaire et découplée qui sépare les services de calcul de l'infrastructure de stockage sous-jacente. Cette conception permet aux équipes techniques de déployer des moteurs analytiques indépendants, tels qu'Apache Spark, Apache Kafka et Trino, ainsi que des moteurs personnalisés open source ou tiers, via des modèles disponibles sur une place de marché en libre-service. Le système connecte ces moteurs de calcul distribués au sein d'infrastructures hétérogènes grâce à des API standard, aux formats de table ouverts d'Apache Iceberg et au catalogue Polaris, éliminant ainsi les formats de données propriétaires et les coûts d'intégration spécifiques.
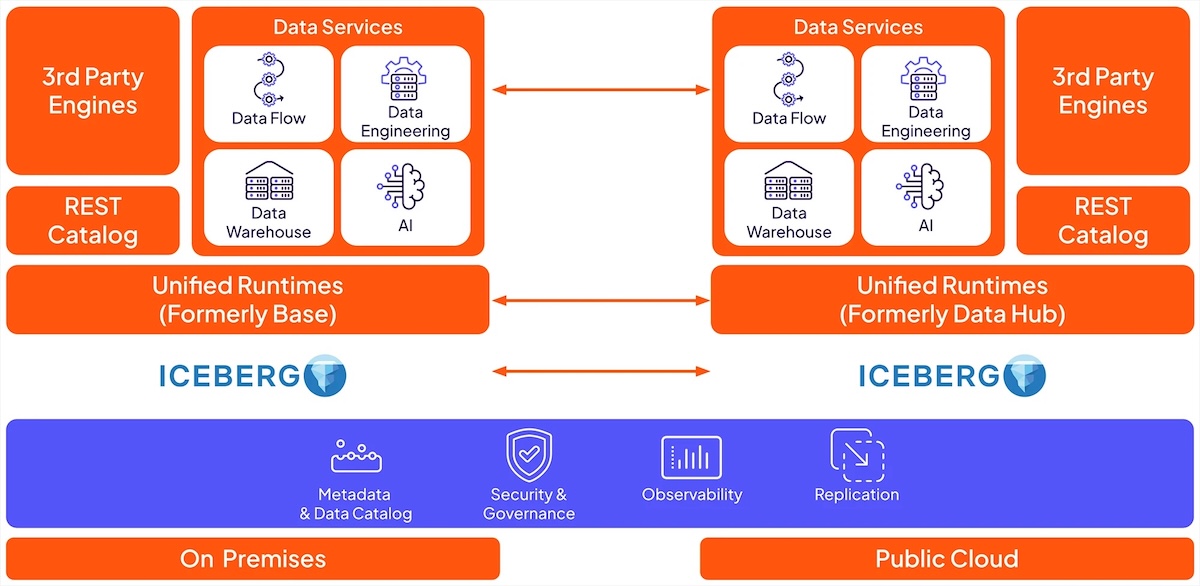
Les limitations de performance de l'infrastructure et les exigences complexes en matière de résidence des données freinent fréquemment les pipelines d'IA d'entreprise lors de leur passage des phases pilotes à la production. Cloudera cite une étude récente révélant que 73 % des responsables informatiques estiment que les contraintes de performance de l'infrastructure ont entravé les initiatives opérationnelles. Cloudera Anywhere Cloud remédie à cette latence opérationnelle en facilitant le placement localisé des charges de travail. Les applications s'exécutent là où les exigences métier, réglementaires ou matérielles l'imposent, éliminant ainsi la nécessité de répliquer ou de transférer de grands ensembles de données entre des environnements disparates.
Gouvernance, automatisation par agents et contrôle
La plateforme intègre des contrôles de sécurité Zero Trust natifs sur l'ensemble des nœuds de stockage et de calcul distribués. Ce cadre garantit la traçabilité des données, les limites d'accès et la conformité continue sur les différents niveaux de cloud (souverain, privé et public). Les déploiements héritent automatiquement des politiques de gouvernance d'entreprise existantes afin de préserver la souveraineté des données et les droits de propriété intellectuelle.
Pour simplifier les opérations quotidiennes, Cloudera a intégré un copilote interactif à l'interface de contrôle. Ce copilote traduit les instructions en langage naturel en tâches opérationnelles exécutables, telles que le lancement de moteurs de calcul, la configuration des ressources d'infrastructure et l'orchestration de pipelines de données de bout en bout entre les environnements connectés.
« L’IA d’entreprise a dépassé le modèle du cloud public uniquement », a déclaré Leo Brunnick, directeur des produits chez Cloudera. « Les entreprises ne devraient pas avoir à choisir entre innovation et contrôle. Cloudera Anywhere Cloud apporte la vitesse et la flexibilité du cloud directement aux données d’entreprise. Cela leur permet d’accélérer leurs initiatives d’IA tout en conservant la pleine propriété de leurs données et de leur propriété intellectuelle, et en optimisant les coûts de leur infrastructure, de leurs jetons et de leurs modèles commerciaux. »
Ce lancement s'inscrit dans la continuité des efforts récents de Cloudera en matière d'infrastructure, notamment avec sa plateforme commune d'IA développée en partenariat avec VAST Data . Cloudera présente Cloudera Anywhere Cloud cette semaine lors de son événement EVOLVE à Singapour.
Spark accéléré par GPU via NVIDIA cuDF
Parallèlement au lancement de sa plateforme, Cloudera a annoncé l'accélération GPU native pour Apache Spark 4.1 dans Cloudera Data Engineering, basée sur la bibliothèque cuDF CUDA-X de NVIDIA. Le plug-in cuDF accélère les pipelines Spark existants sans modifier le code PySpark ni SQL. Cloudera présente cette solution comme un moyen de préparer plus rapidement les données pour l'IA tout en réduisant les dépenses de calcul dans le cloud. Cette accélération est intégrée à Cloudera Data Engineering dans le cadre d'Anywhere Cloud.


 Amazon