

Couchbase annonce la disponibilité générale de son AI Data Plane, une infrastructure de données unifiée pour les agents d'IA d'entreprise. Cette version s'adresse aux organisations souhaitant déployer leurs projets d'IA multi-agents au-delà des phases pilotes, en combinant mémoire persistante, récupération de contexte en temps réel et accès cohérent aux données dans les environnements cloud, edge et lakehouse, au sein d'une architecture unique.
De manière générale, Couchbase répond à un problème courant en entreprise : les agents d’IA en production qui dépendent de multiples services non connectés pour la recherche vectorielle, la mise en cache, le stockage de documents et la logique d’intégration. L’approche de Couchbase consiste à consolider ces fonctions dans une couche opérationnelle gouvernée qui s’étend des déploiements Capella aux déploiements autogérés, offrant ainsi aux équipes de la plateforme un plan de contrôle unique pour les services de données qui prennent en charge les agents d’IA.
La plateforme AI Data Plane réunit Couchbase Agent Memory, un catalogue d'agents facilitant la recherche d'outils et un serveur MCP autogéré et pris en charge par l'entreprise, afin de standardiser l'intégration des protocoles de contexte de modèle. Couchbase précise que la plateforme bénéficie du soutien de son équipe d'ingénierie et d'assistance et vise à remplacer les solutions ponctuelles qui complexifient les opérations.
Concentrez-vous sur la mémoire persistante des agents
Un élément clé de ce lancement est Agent Memory, que Couchbase présente comme une couche de persistance unifiée pour l'état, le contexte et la récupération des agents. Plutôt que d'obliger les équipes à assembler des systèmes de stockage vectoriel, de cache et de documents distincts, l'entreprise intègre ces exigences à sa plateforme de données opérationnelles globale.
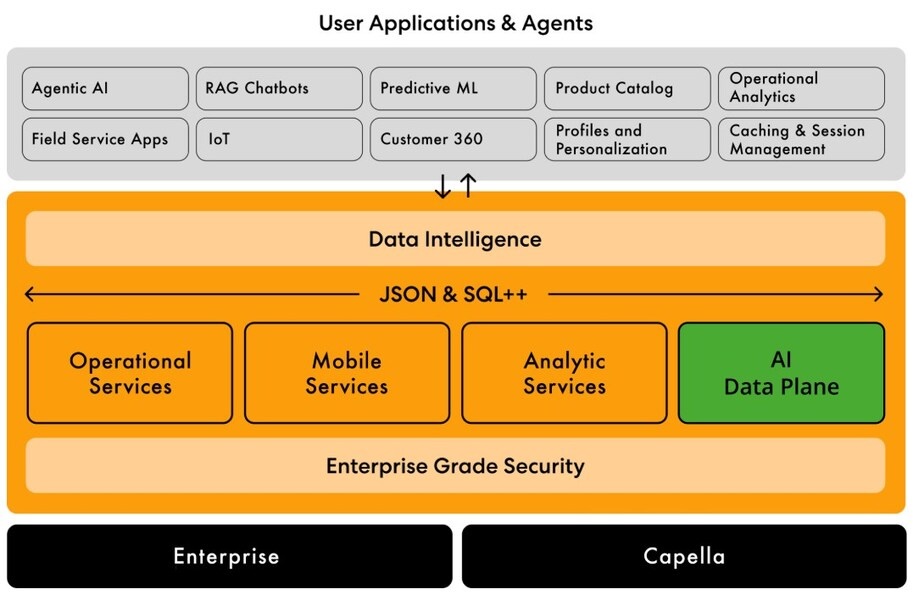
Le plan de données d'IA de Couchbase offre aux entreprises une mémoire d'agent persistante, une récupération de contexte en temps réel et un accès cohérent aux données, du cloud à la périphérie et jusqu'à leurs architectures de lac de données.
C'est important car les déploiements d'agents d'entreprise nécessitent bien plus qu'une simple recherche de similarité vectorielle. Les systèmes de production exigent de plus en plus la capacité de préserver le contexte conversationnel et de flux de travail entre les sessions, de récupérer des données opérationnelles structurées parallèlement aux données non structurées, et de maintenir l'état lors des redémarrages et de l'exécution distribuée. Couchbase affirme que sa plateforme est conçue pour répondre à ces exigences avec un accès à faible latence au moment de la décision.
L'entreprise a également précisé que la couche mémoire est indépendante de tout framework et a été validée avec LangGraph, CrewAI et LlamaIndex. Concrètement, cela devrait faciliter le travail des équipes d'ingénierie qui souhaitent changer de framework d'orchestration ou prendre en charge plusieurs frameworks sans avoir à reconstruire la couche de persistance sous-jacente à leurs agents.
Agora, qui utilise Couchbase comme partenaire pour sa couche de données, a déclaré qu'une récupération rapide et cohérente des données demeure essentielle à l'IA conversationnelle d'entreprise. L'entreprise a décrit la couche de données backend comme cruciale pour garantir des interactions réactives. Elle a ajouté que sa collaboration avec Couchbase s'est intensifiée à mesure que les déploiements s'orientent vers des cas d'utilisation plus complexes pour les agents, notamment dans les domaines des ventes, du service client et des flux de travail associés.
Conçu pour les charges de travail d'agents distribuées et centrées sur la périphérie
Couchbase s'adapte également aux réalités opérationnelles de l'IA agentielle en périphérie. Les agents multi-étapes opèrent de plus en plus sur plusieurs sessions, appareils, environnements de terrain et infrastructures distribuées, créant ainsi une inadéquation avec les plateformes de données centralisées classiques. Selon Couchbase, le plan de données IA est conçu pour prendre en charge les données structurées, les représentations non structurées, la synchronisation et la récupération locale dans les environnements cloud, périphérie et terminaux.
Le débit est un argument de poids. Les charges de travail automatisées peuvent déclencher des recherches de contexte répétées, des mises à jour de mémoire et des synchronisations d'état sur de nombreuses sessions simultanées, ce qui met à rude épreuve la plateforme de données sous-jacente. Couchbase affirme que son AI Data Plane s'appuie sur son architecture évolutive et privilégiant la mémoire, déjà utilisée pour des charges de travail d'entreprise à très haut débit transactionnel.
Techniquement, la plateforme repose sur l'architecture distribuée et multi-modèles de Couchbase, qui prend en charge les documents JSON, l'accès par clé-valeur, les requêtes SQL++, la recherche plein texte, la gestion des événements et la recherche vectorielle au sein d'un système unique. Le plan de données IA étend cette infrastructure grâce à la persistance des sessions des agents et à la récupération du contexte, tandis que le serveur MCP et le catalogue d'agents ajoutent des fonctionnalités d'intégration et d'observabilité pour les déploiements en production.
Enterprise Analytics 2.2 ajoute la fédération Iceberg
Parallèlement à l'IA Data Plane, Couchbase a lancé Enterprise Analytics 2.2, enrichissant ainsi sa suite analytique pour une meilleure connexion des données opérationnelles aux environnements de lac de données. La principale nouveauté est la fédération Apache Iceberg, qui permet aux équipes d'interroger les données opérationnelles Couchbase et les tables Iceberg sans avoir à déplacer ni dupliquer les données via des pipelines ETL.
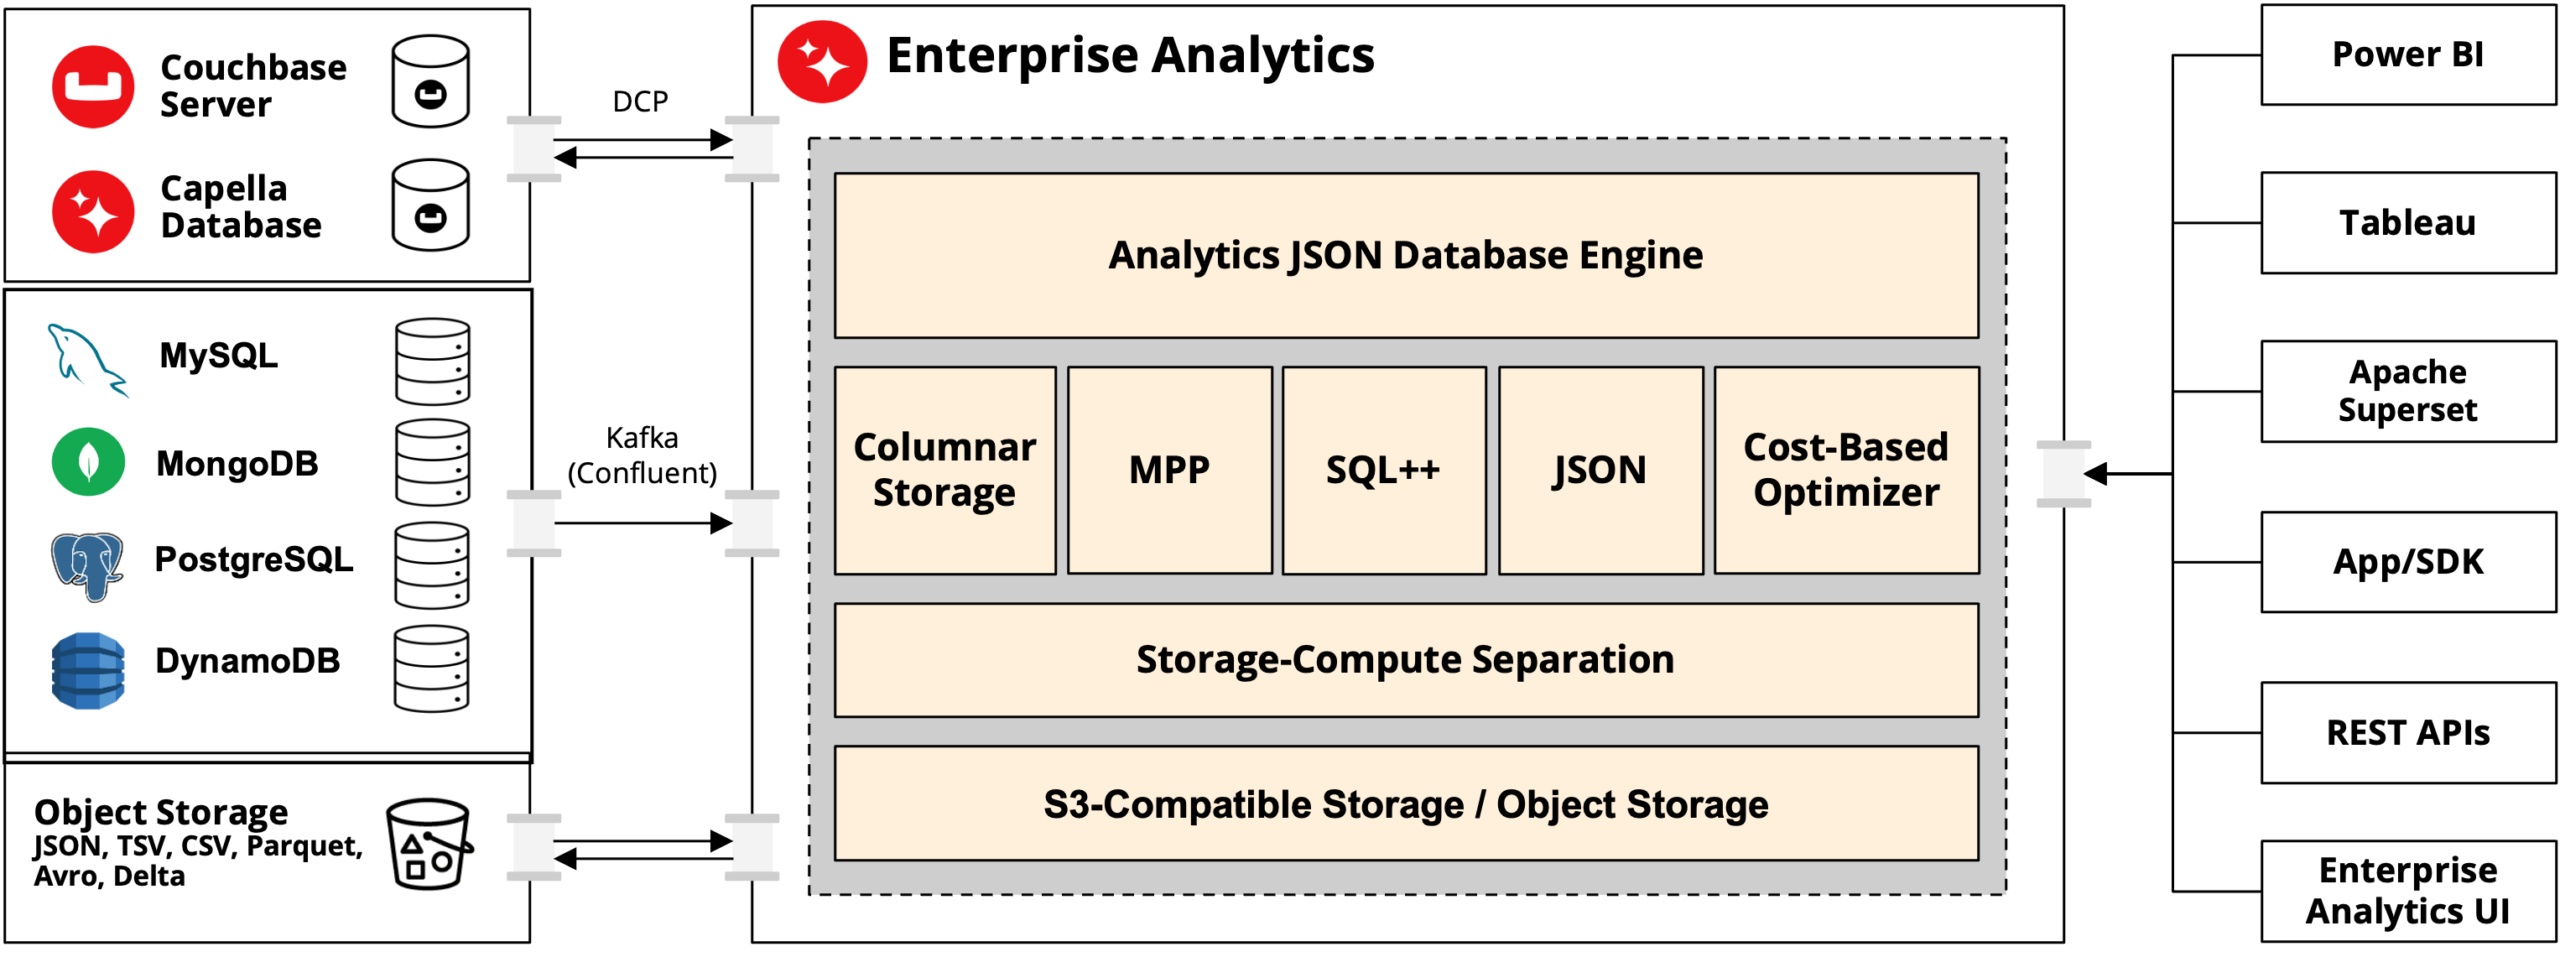
Pour les entreprises qui adoptent Iceberg comme solution standard, cela devrait simplifier l'intégration des données opérationnelles en temps réel avec les tables de données du lac gouverné au sein d'un même flux de travail analytique. Concrètement, cela se traduit par une réduction des transferts de données et un accès plus rapide aux ensembles de données mixtes, opérationnels et analytiques, pour les cas d'usage liés à l'IA et à l'analyse de données.
Couchbase a également intégré des améliorations à son moteur d'analyse, notamment la prise en charge de Google Cloud Storage, l'authentification JWT, la capture des données modifiées (CDC) pour Oracle et SQL Server, les requêtes asynchrones de longue durée, un outil d'aide à l'indexation, les plans de requêtes indexés uniquement et la prise en charge de SQL++ UPDATE. Des mises à jour du SDK sont disponibles pour Java, .NET, Python, JavaScript et Go.
Par ailleurs, la société a annoncé le lancement d'un adaptateur Trino prévu pour le troisième trimestre 2026. Une fois disponible, cet adaptateur devrait permettre un accès SQL direct aux données opérationnelles Couchbase depuis des environnements basés sur Trino tels qu'AWS Athena, Amazon EMR, Google Dataproc et Starburst. Ceci réduirait encore davantage la nécessité de répliquer les données opérationnelles en temps réel dans des systèmes analytiques distincts avant de les interroger.
Mises à jour de Capella iQ et Edge Stack
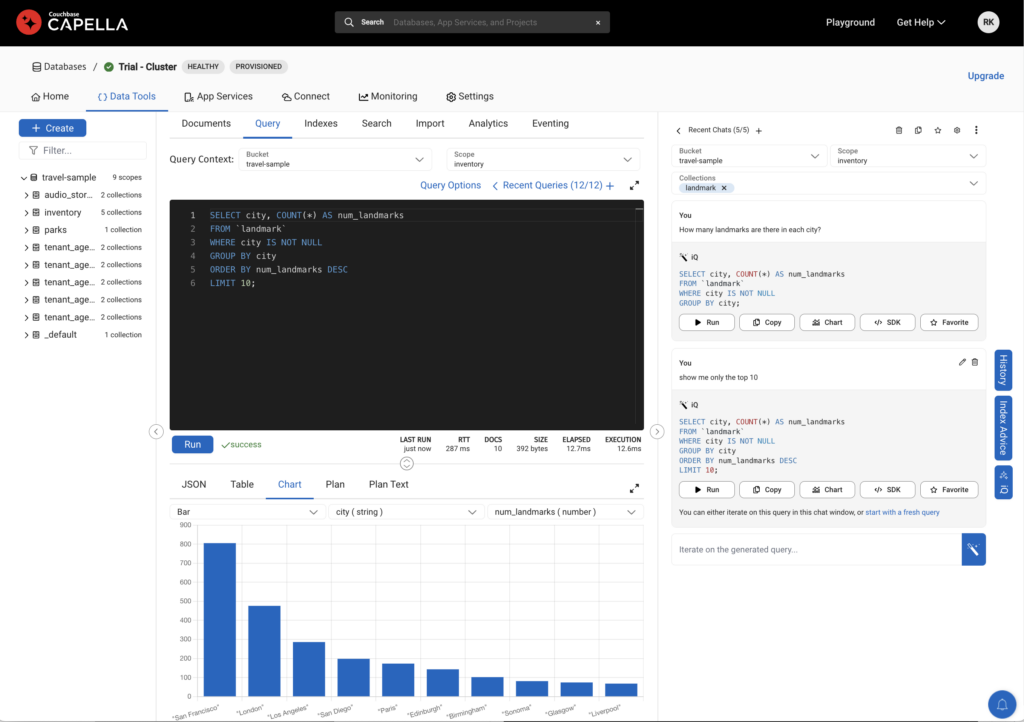
Couchbase a également mis à jour Capella iQ, son assistant de requêtes en langage naturel. La plateforme prend désormais en charge la sélection de modèles via AWS Bedrock et OpenAI, avec un contrôle d'accès par le biais de paramètres de stratégie au niveau de l'organisation. L'objectif est de permettre aux administrateurs de restreindre l'accès aux modèles par équipe tout en gérant de manière centralisée la conformité, la résidence et les coûts d'inférence.
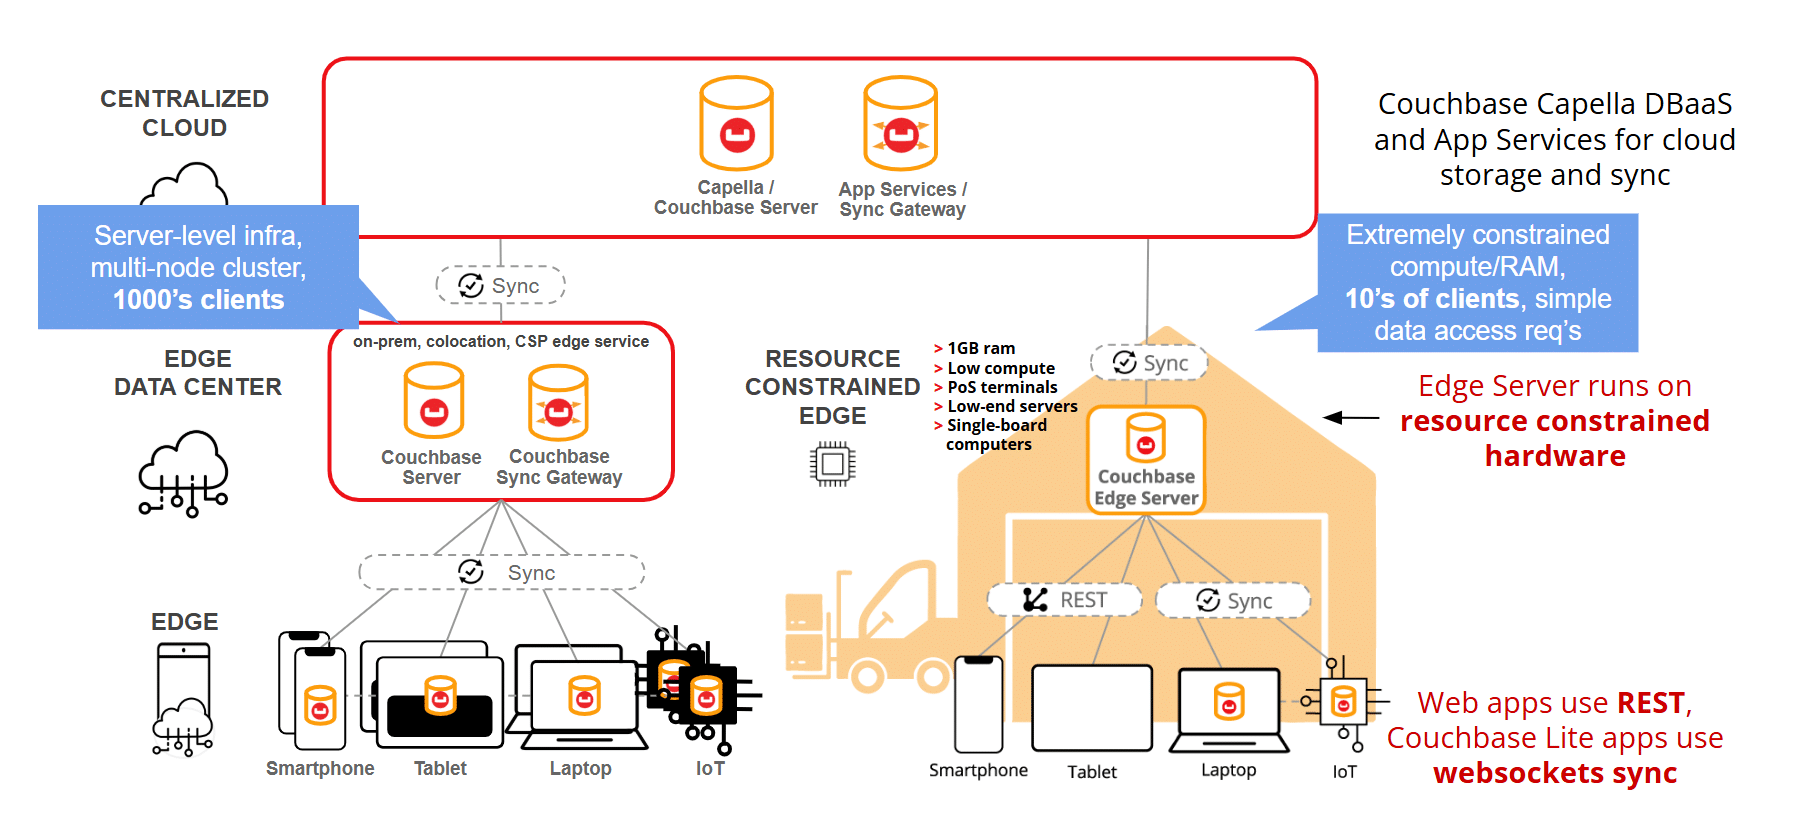
Côté edge et mobile, Couchbase a étendu sa pile d'applications distribuées pour prendre en charge une IA et un traitement des données plus localisés. Couchbase Lite 4.1 intègre la synchronisation peer-to-peer native via Bluetooth avec basculement automatique vers le Wi-Fi, une API Android modernisée avec prise en charge de l'annotation Kotlin @Serializable (simplifiant la sérialisation et la désérialisation des classes et objets de données), la détection des modifications delta et de nouvelles liaisons API C++ pour le développement d'applications embarquées hautes performances. Edge Server 1.1 ajoute un contrôle d'accès côté client pour une gestion fine des permissions locales, la prise en charge de CORS pour les applications edge web, une rotation simplifiée des identifiants pour les parcs d'appareils distribués et une prise en charge étendue des architectures Windows et ARM. React Native 1.1 offre une prise en charge de niveau entreprise grâce à l'intégration de Turbo Module, permettant aux équipes mobiles multiplateformes d'accéder directement aux performances de Couchbase Lite sans surcharge liée aux ponts. Sync Gateway 4.1 propose des mises à niveau progressives non perturbatrices et une resynchronisation distribuée simultanée pour les environnements à fort volume, disponible en tant que service géré via App Services.
Edge Server 1.1 introduit le contrôle d'accès côté client, la prise en charge de CORS pour les applications Edge basées sur navigateur, une rotation simplifiée des identifiants et une compatibilité étendue avec les déploiements Windows et ARM. React Native 1.1 ajoute la prise en charge des environnements d'entreprise, notamment l'intégration de Turbo Module, afin d'améliorer l'accès direct aux performances de Couchbase Lite. Sync Gateway 4.1 prend en charge les mises à niveau progressives et la resynchronisation distribuée simultanée pour les environnements à fort volume et est disponible en tant que service géré via App Services.
Positionnement sur le marché
Le message principal de Couchbase est que la couche de base de données devient essentielle à l'IA agentielle en production, notamment parce que les entreprises reconnaissent que la gestion de la mémoire et du contexte, ainsi que la récupération à faible latence, ne peuvent être considérées comme des fonctionnalités ajoutées ponctuellement. L'entreprise affirme que de nombreux déploiements actuels sont ralentis par la nécessité d'intégrer des systèmes vectoriels, de cache et de documents distincts, et qu'une couche unifiée de persistance et de récupération est de plus en plus indispensable pour les agents déployés à grande échelle.
Du point de vue de l'infrastructure, ce lancement vise moins à ajouter une nouvelle fonctionnalité d'IA qu'à renforcer l'intégration entre les bases de données opérationnelles, la mémoire des agents, les déploiements en périphérie et l'analyse du lac de données. Pour les entreprises et leurs équipes techniques, l'importance du plan de données IA dépendra probablement de la capacité de la consolidation de ces services sur une plateforme unique à réduire significativement les coûts d'intégration, tout en préservant les performances et la gouvernance nécessaires aux déploiements d'agents en production.


 Amazon