

MLPerf Inference v5.1 propose des benchmarks rigoureux pour l'inférence IA dans les domaines LLM, la vision et les tâches multimodales. Voici l'analyse technique des résultats Blackwell Ultra de NVIDIA et des soumissions Instinct MI300X/MI325X/MI355X d'AMD. Elle comprend des données de benchmark détaillées, des optimisations logicielles, des stratégies architecturales et des implications pour les hyperscalers et les entreprises.
Cadre d'analyse comparative MLPerf
Les benchmarks d'inférence MLPerf servent de tableau de bord aux accélérateurs d'IA, offrant une méthode standardisée et comparable pour mesurer les performances de la classification d'images, des modèles de langage et des systèmes de recommandation. Pour les entreprises déployant des GPU à grande échelle, ces chiffres guident souvent les décisions d'achat importantes.
L'inférence MLPerf est régie par MLCommons et définit les règles de division fermée et ouverte. Les scénarios incluent :
- Hors ligne: Centré sur le débit (regrouper autant de requêtes que possible).
- Server:Inférence multi-flux compatible avec la latence.
- Apprentissage: TTFT (Time-to-First-Token) et TPS (jetons par seconde au 99e percentile) stricts.
La suite de charges de travail v5.1 comprenait :
- DeepSeek-R1 : Un modèle mixte d'experts 671B (test de stress pour l'inférence du raisonnement).
- Llama-3.1-405B et 8B:Les LLM les plus récents dans plusieurs modes d'inférence.
- Whisper :ASR remplaçant RNN-T.
- Diffusion stable XL (SD-XL):IA génératrice de texte en image.
- Mixtral, DLRMv2, ainsi que des charges de travail héritées comme ResNet-50.
Les graphiques de débit (jetons/s ou échantillons/s) mettent généralement en évidence la domination persistante de NVIDIA en chiffres absolus, notamment par GPU. Cependant, les progrès d'AMD en matière d'efficacité relative et de fluidité de la montée en charge montrent qu'ils réduisent progressivement l'écart, en particulier dans les environnements serveurs et les déploiements multi-nœuds.
Résultats NVIDIA Blackwell Ultra
Les systèmes Blackwell Ultra ont atteint un débit record sur toutes les nouvelles charges de travail. Principaux facteurs :
- Précision NVFP4 : flottant 4 bits personnalisé, accélérant DeepSeek et Llama.
- FP8 KV-cache : économies de mémoire pour les couches d'attention.
- Service désagrégé : contexte divisé par rapport aux étapes de génération sur 72 GPU via NVLink 1,800 XNUMX Go/s.
- Logiciels : CUDA Graphs, TensorRT-LLM, ADP Balance.
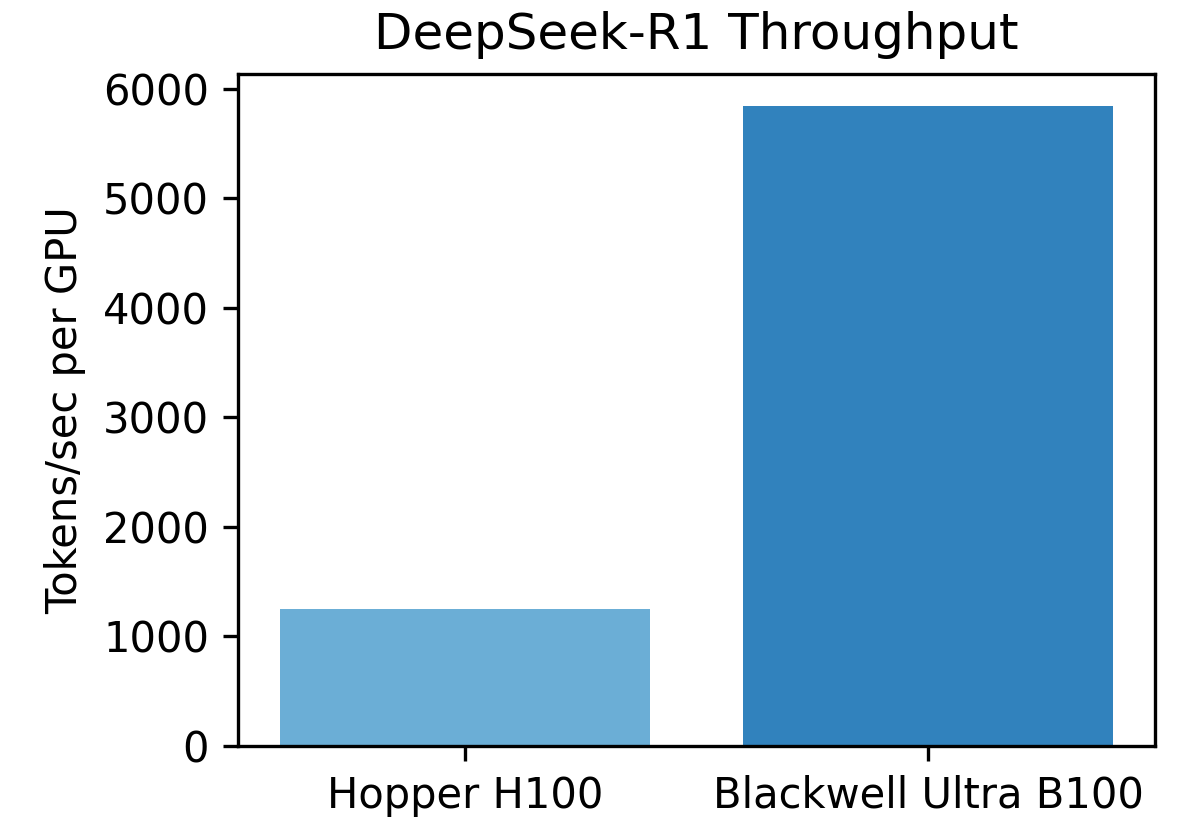
Le graphique à barres ci-dessous, comparant Hopper et Blackwell Ultra par GPU, montre une augmentation du débit près de 5 fois supérieure sur DeepSeek-R1, confirmant que les formats de données à granularité fine (NVFP4) et la bande passante à l'échelle du rack évoluent linéairement pour les charges de travail d'inférence massives. Une autre figure, illustrée par les résultats records du Llama-405B interactif, montre comment NVIDIA utilise la structure NVLink et le service désagrégé pour maintenir les SLA de latence tout en dépassant les limites de débit précédentes. En conclusion : NVIDIA reste le leader du secteur en matière de vitesse brute et de charges de travail sensibles à la latence.
Résultats des tests AMD Instinct MI300X/MI325X/MI355X
Efficacité et flexibilité ciblées par AMD :
- FP4 sur MI355X: offrant un débit Llama-2.7-2B 70 fois supérieur à celui du MI325X FP8.
- Taille structurée:Sur Llama-405B, l'élagage de 21 à 33 % a réduit les FLOP sans impacter la précision, augmentant le débit d'environ 82 à 90 %.
- écaillage: Mise à l'échelle linéaire fluide prouvée jusqu'à 8 nœuds ; le premier cluster hétérogène (4 × MI300X + 2 × MI325X) a atteint une efficacité de mise à l'échelle de 94 %.
- Reproductibilité de l'écosystème ROCm:Les soumissions des partenaires se situent systématiquement entre 1 et 3 % des propres résultats d'AMD.
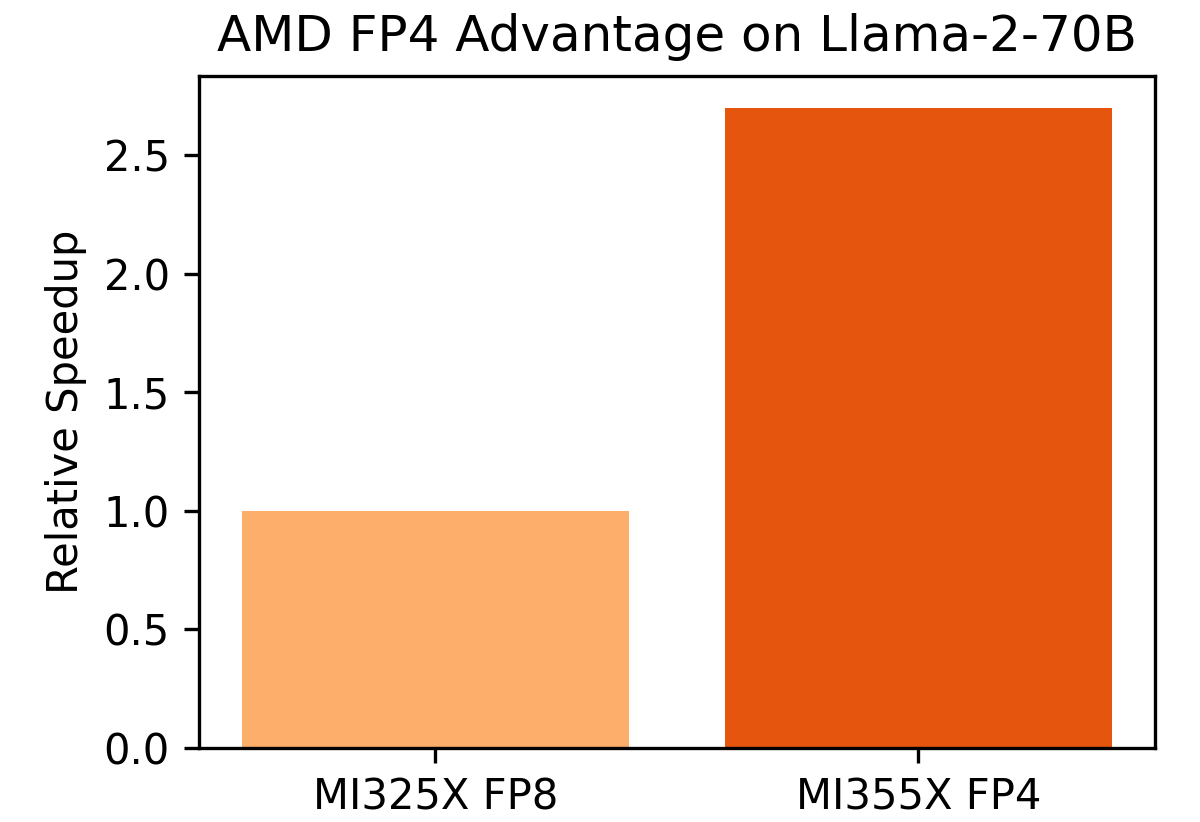
Le graphique ci-dessus montrant MI325X FP8 par rapport à MI355X FP4 illustre les avantages révolutionnaires de FP4, des jetons/sec plus élevés avec une perte de précision minimale, prouvant que FP4 n'est pas expérimental mais prêt à être déployé.
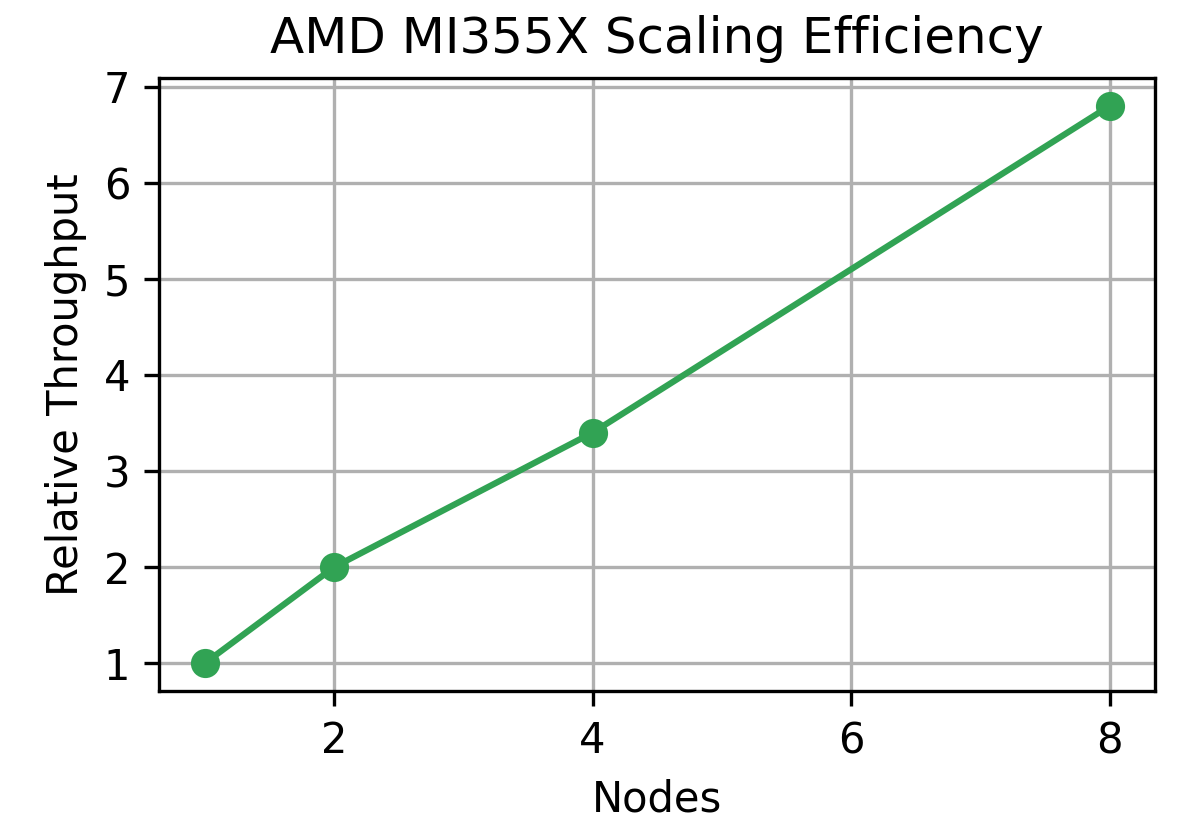
Ce graphique de la courbe de mise à l'échelle (1 → 8 nœuds) met en évidence une mise à l'échelle quasi linéaire, un atout précieux pour les hyperscalers car elle se traduit par des coûts d'extension prévisibles. Parallèlement, le schéma d'élagage structuré montre qu'AMD ne se concentre pas uniquement sur la puissance brute matérielle, mais aussi sur l'efficacité algorithmique, cruciale pour les clusters d'inférence réels, soumis à des contraintes de puissance et d'espace.
Comparaison directe AMD-NVIDIA
|
Métrique |
NVIDIA Blackwell Ultra |
AMD MI355X |
Remarques |
Gagnant |
|
Jetons/sec par GPU |
5842 (DeepSeek-R1) |
~2200 (à l'échelle FP4) |
Performances brutes NVIDIA supérieures |
NVIDIA |
|
Mémoire par GPU |
192 Go HBM3e |
288 Go HBM3e |
AMD adapte le modèle 520B à un seul GPU |
AMD |
|
Support de précision |
FP16, FP8, NVFP4 |
FP16, FP8, FP4 |
Les deux fils 4 bits |
Cravate |
|
Tissu de mise à l'échelle |
NVLink 72 GPU |
Mise à l'échelle du nœud linéaire jusqu'à 8 |
Différentes stratégies d'échelle |
Cravate |
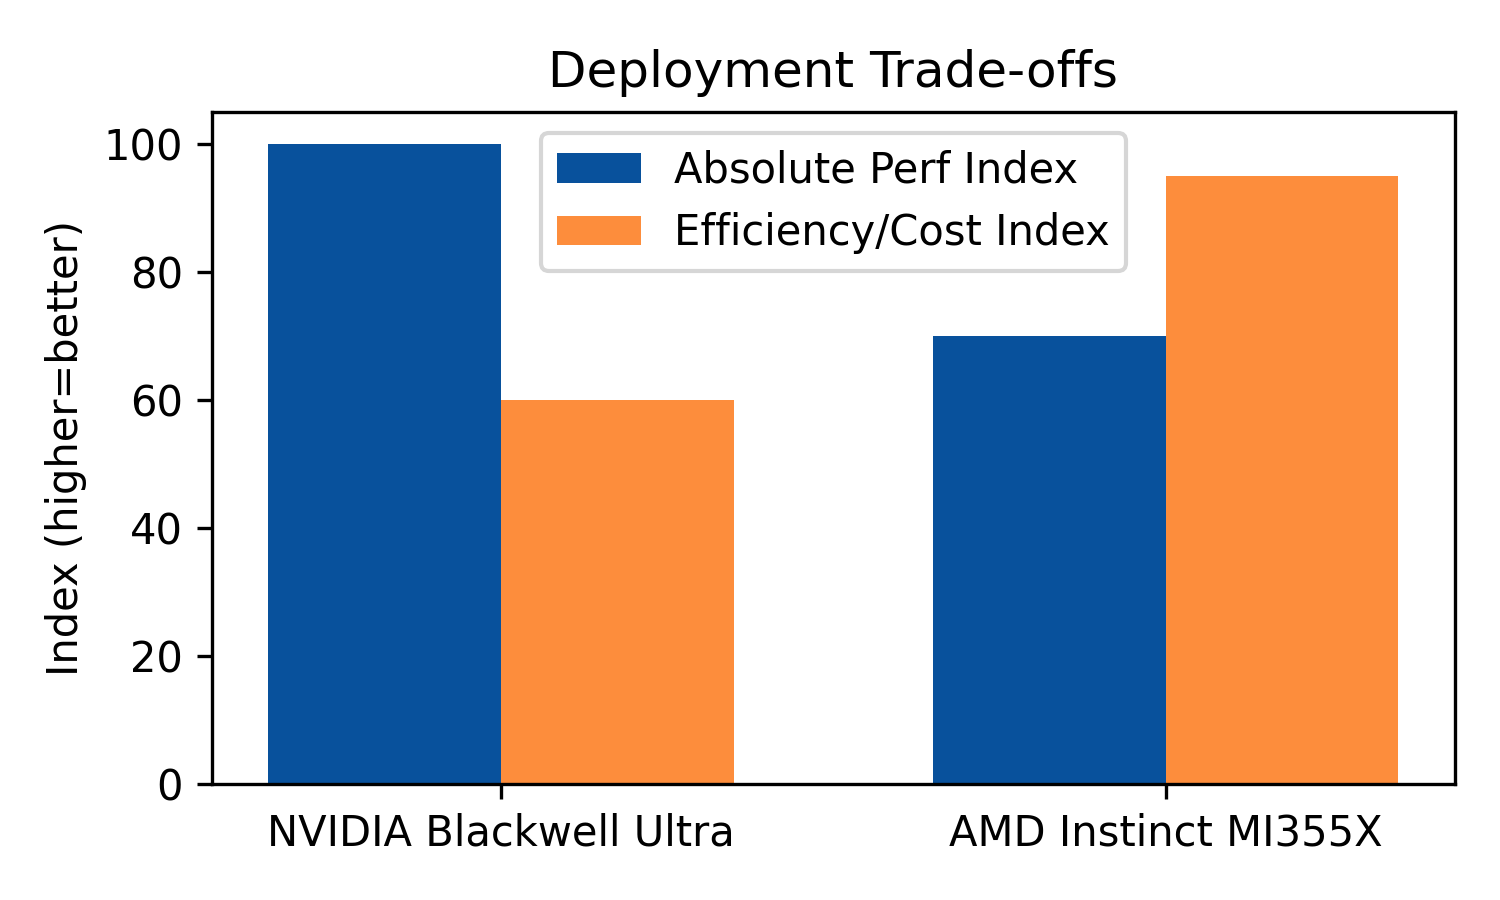
Les visualisations côte à côte mettent l’accent sur les compromis.
- NVIDIA domine le débit par GPU, ce qui le rend idéal pour les usines d'IA où la densité de flop est importante.
- AMD, avec une mémoire plus importante (288 Go) et un élagage FP4, brille là où le coût par jeton et la flexibilité de déploiement sont primordiaux.
Implications pour l'industrie
- hyperscalersNVIDIA reste l'outil de choix des usines d'IA en quête de performances optimales. Les innovations croissantes d'AMD en matière d'efficacité permettent toutefois une évolutivité optimisée en termes de coûts, ce qui facilite l'équilibrage des charges de travail entre les différents niveaux.
- Fournisseurs de cloud:Attendez-vous à des offres hétérogènes, des niveaux NVIDIA hautes performances par rapport aux pods AMD Kubernetes rentables.
- Entreprises: L'élagage structuré, FP4 et la prise en charge des clusters hétérogènes permettent à AMD de fournir une inférence de modèle de plus de 405 B à un coût total de possession réduit. Les innovations de NVIDIA (diffusion désagrégée et Dynamo) restent bénéfiques pour les applications sensibles à la latence (par exemple, les chatbots LLM en temps réel).
- Perspectives d'avenir: Attendez-vous à une adoption universelle de l'inférence 4 bits comme base de référence, à une utilisation plus large de pools de GPU hétérogènes et à de nouvelles conceptions de systèmes, notamment Rubin CPX de NVIDIA pour les longues séquences et l'extension ROCm d'AMD pour couvrir davantage de frameworks.
NVIDIA continue de dominer le marché du débit brut, les GPU H200 étant en tête de l'inférence dans ResNet-50 et BERT sur les benchmarks en division fermée. Cela dit, le MI300 d'AMD n'est pas loin derrière, affichant des performances compétitives sur serveur et hors ligne, tout en affichant de solides gains en efficacité énergétique. En réalité, non seulement NVIDIA reste en tête, mais AMD a considérablement réduit son retard par rapport à la dernière édition de MLPerf. Pour les acheteurs, cela signifie que l'époque où l'on se concentrait uniquement sur les GPU écologiques est peut-être révolue : ROCm arrive à maturité et le MI300 est viable dans les déploiements d'inférence réels.


 Amazon