

Qumulo a annoncé Cloud AI Accelerator, une nouvelle architecture conçue pour améliorer l'efficacité des infrastructures d'IA d'entreprise en éliminant les goulots d'étranglement liés au déplacement des données. La plateforme présente des ensembles de données distribués aux ressources GPU en temps réel, à travers différentes régions, clouds et environnements hybrides, sans nécessiter de réplication ni de mise en transit.
Cette mise à jour s'appuie sur une inefficacité bien documentée des infrastructures d'IA en entreprise. Citant le rapport « State of Kubernetes Optimization Report 2026 » de Cast AI, Qumulo souligne que le taux d'utilisation moyen des GPU en entreprise est d'environ 5 %, les 95 % restants de la puissance de calcul accélérée restant inactifs car les données doivent être préparées, répliquées et déplacées avant le démarrage des charges de travail. Doug Gourlay, PDG de Qumulo, a résumé le problème dans l'annonce : « Toutes les entreprises avec lesquelles nous échangeons se concentrent sur la disponibilité des GPU, mais la disponibilité ne représente que la moitié du problème. Le problème de fond réside dans l'utilisation, et le coupable est la gravité des données. »
Repenser le placement des données pour les charges de travail d'IA
Les approches traditionnelles d'infrastructure d'IA consistent à colocaliser le stockage avec les clusters de GPU, souvent à l'aide de systèmes flash haute performance étroitement couplés au calcul. Bien qu'efficace pendant l'entraînement ou l'inférence, ce modèle ne gère pas les périodes d'inactivité liées à la préparation des données. Il crée également des silos de stockage fragmentés, les entreprises répliquant leurs jeux de données entre environnements pour les maintenir à proximité du calcul.
L'approche de Qumulo révolutionne le modèle en dissociant l'emplacement des données de celui des calculs. Au lieu de déplacer les données vers les GPU, l'accélérateur d'IA dans le cloud permet aux GPU d'accéder aux données directement sur place. Ceci est rendu possible grâce à une infrastructure de données distribuée qui garantit un accès cohérent et en temps réel aux ensembles de données, indépendamment de leur emplacement physique.
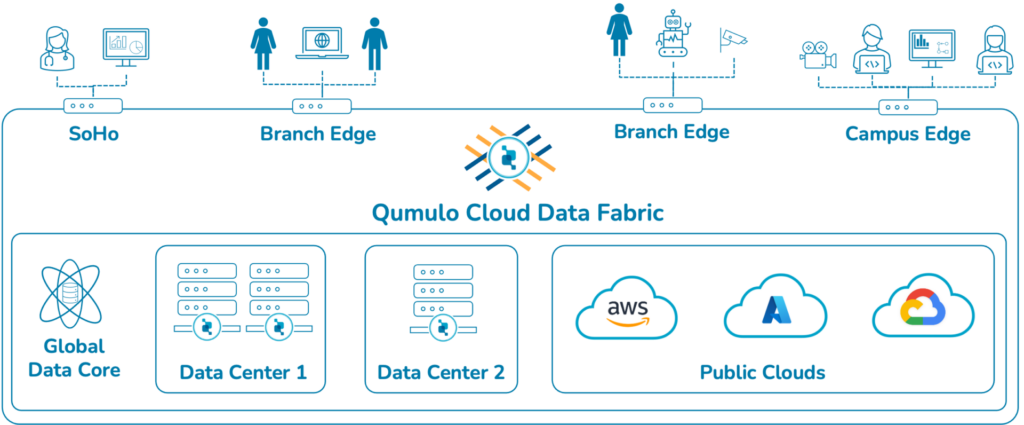
L'entreprise présente cette fonctionnalité comme un moyen de « fluidifier les GPU », permettant de planifier les charges de travail en fonction de la capacité de calcul disponible plutôt que des contraintes de localisation des données. Concrètement, cela permet aux entreprises d'utiliser les ressources GPU sur plusieurs clouds ou régions sans avoir à prépositionner les données.
Architecture : Couche de données et de mise en cache
Cloud AI Accelerator intègre trois produits Qumulo auparavant commercialisés séparément. Cloud Native Qumulo (CNQ) est le système de fichiers de Qumulo fonctionnant nativement sur AWS, Azure, Google Cloud et Oracle Cloud Infrastructure. Cloud Data Fabric (CDF), lancé en février 2025, fournit un référentiel centralisé de fichiers et d'objets avec des caches cohérents en périphérie. NeuralCache, ajouté à CDF en avril 2025, applique l'apprentissage automatique à la mise en cache prédictive en lecture et en écriture, et Qumulo affirme qu'il réduit les temps de chargement des données GPU jusqu'à 64 %. Cloud AI Accelerator a été initialement lancé en novembre 2025 ; la version du 26 mai ajoute une connectivité directe à Microsoft AI Foundry, AWS Bedrock et Google Vertex AI, officialise le positionnement de « liquidité GPU » et associe le produit à Cisco pour les déploiements hybrides.
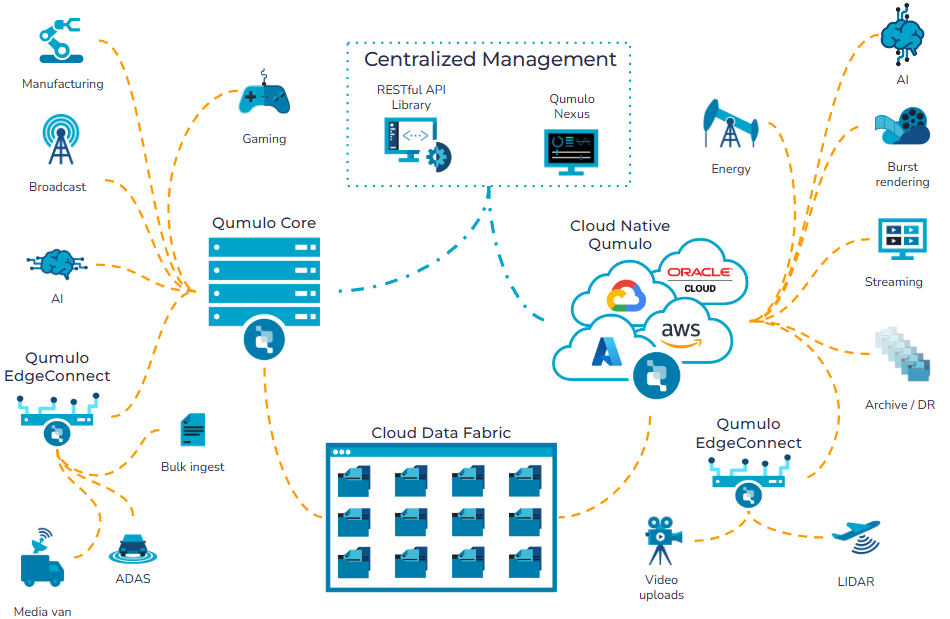
Le chemin des données s'effectue au niveau bloc depuis les sites sources (clusters sur site, régions cloud, réplicas interrégionaux ou stockage CNQ S3) vers le cache DRAM du processeur de l'accélérateur, puis directement vers les GPU. Cette architecture garantit une source unique de données fiables pour les environnements sur site, en périphérie et multicloud, et évite la réplication massive, réduisant ainsi la surcharge de stockage et la complexité de la synchronisation.
Cette conception prend également en charge l'intégration avec les services d'IA gérés. Les entreprises peuvent connecter directement leurs ensembles de données existants à des plateformes telles que Microsoft AI Foundry, AWS Bedrock et Google Vertex AI sans avoir à copier les données dans ces environnements.
Impact opérationnel : Réduction des temps d'inactivité et de la complexité
Le principal avantage opérationnel réside dans l'élimination des délais de préparation des données. Dans de nombreux flux de travail d'IA, cette préparation peut prendre des jours, voire des semaines, retardant ainsi l'entraînement des modèles et réduisant l'utilisation effective du GPU. En permettant un accès immédiat aux jeux de données, l'accélérateur d'IA dans le cloud permet aux charges de travail de démarrer dès que la puissance de calcul est disponible.
Cela réduit également la nécessité de gérer plusieurs environnements de stockage. Au lieu de créer des silos de données distincts pour chaque cluster GPU ou région cloud, les entreprises peuvent exploiter un seul ensemble de données logiques. La gestion des données s'en trouve simplifiée, et l'infrastructure est moins tentante.
Du point de vue des coûts, ce modèle cible les dépenses liées à l'inactivité des GPU. En éliminant la nécessité de précharger les données dans le stockage connecté aux GPU, les entreprises peuvent réduire le temps d'attente des GPU pour les données, améliorant ainsi le retour sur investissement global du calcul accéléré.
Intégration Cisco pour l'infrastructure d'IA hybride
Cisco est le partenaire commercial conjoint pour cette solution de déploiement hybride. Cisco UCS fournit l'infrastructure de calcul sur site, tandis que les solutions réseau et de sécurité Cisco protègent le réseau de données. Qumulo et Cisco présentent ensemble cette offre comme une infrastructure qui s'adapte en quelques minutes aux variations de disponibilité des GPU, ce qui, selon eux, rend la liquidité des GPU concrète à l'échelle de l'entreprise.
Cette association est essentielle dans les deux sens. Elle offre à Qumulo une intégration validée aux environnements Cisco UCS et fournit à Cisco une solution de stockage pour les clients d'IA hybride qui souhaitent conserver leurs données sur site tandis que la puissance de calcul est répartie entre les hyperscalers. Un réseau à haut débit et faible latence est ici l'élément clé, car l'accès aux données dépend d'un transport constant entre les sites.
Modèle de disponibilité et de déploiement
Qumulo Cloud AI Accelerator est désormais disponible sur AWS, Microsoft Azure, Google Cloud et Oracle Cloud Infrastructure, avec prise en charge des déploiements hybrides dans les environnements Cisco UCS. Qumulo et Cisco seront présents à Cisco Live 2026 à Las Vegas, sur le stand n° 4018, du 31 mai au 4 juin, où leur offre conjointe sera présentée.
Cette annonce témoigne d'une évolution plus large dans la conception des infrastructures d'IA, qui privilégient désormais les architectures centrées sur les données. Face à l'augmentation constante de la capacité de calcul accélérée, supérieure à celle des infrastructures qui la prennent en charge, l'amélioration de leur utilisation dépendra de la réduction du temps d'attente des GPU pour les données. Qumulo mise sur un accès universel aux données, plutôt que sur une solution mobile, comme approche plus durable que l'ajout de mémoire flash à chaque cluster de GPU.


 Amazon