

Les serveurs de périphérie facilitent la prise de décision en temps réel en fournissant des ressources de calcul hors des centres de données et du cloud. Dans cet article, nous présentons plusieurs tests de performance réalisés sur un SuperMicro IoT SuperServer SYS-210SE-31A, un serveur de périphérie multinœuds polyvalent. De toute évidence, les ingénieurs ont pensé à l'inférence en périphérie dès sa conception, car ce serveur est conçu pour l'inférence.
SuperMicro IoT SuperServer SYS-210SE-31A Présentation
Notre analyse complète du SuperMicro IoT SuperServer SYS-210SE-31A révèle son potentiel non seulement pour la 5G et l'IoT, mais aussi pour le commerce de détail et même le stockage s'il est associé à une carte de stockage PCIe et à une carte réseau haut débit.
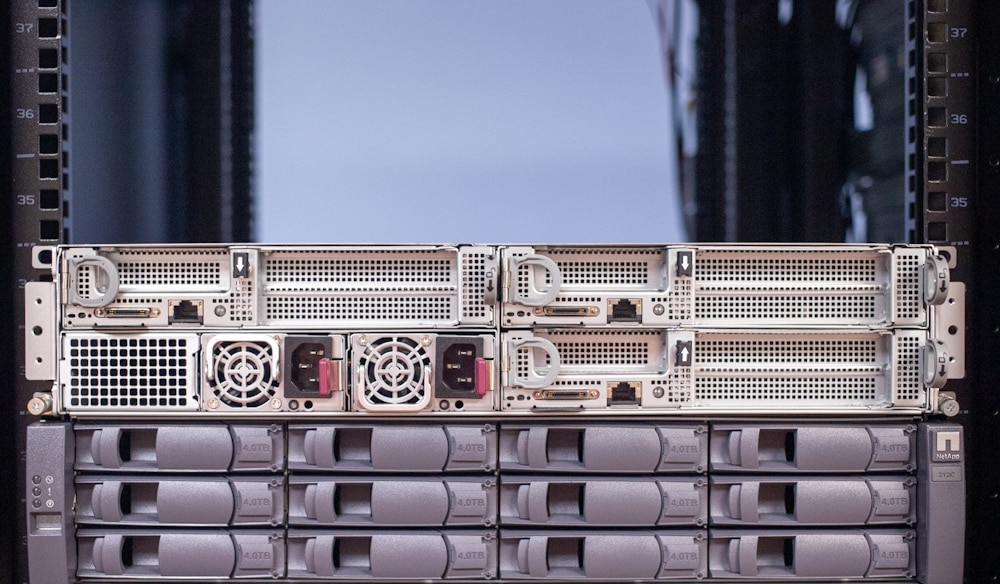
La nature multi-nœuds de ce serveur le rend très polyvalent. Il s'adapte à trois nœuds CPU, chacun avec les éléments suivants :
- Un processeur Intel Xeon Scalable de troisième génération ("Ice Lake") jusqu'à 32C/64T et 205W, avec des options pour les puces 270W avec une configuration spéciale.
- Quatre modules de ventilation.
- Huit emplacements DIMM ; le plafond de mémoire est de 2 To avec des modules DIMM 256DS de 3 Go.
- Deux emplacements M.2 2280/22110 PCIe Gen4.
- Deux PCIe Gen4 x16 pleine hauteur/demi-longueur et un PCIe Gen4 x16 demi-hauteur/demi-longueur.
- Un GbE pour IMPI 2.0 et un dongle KVM.
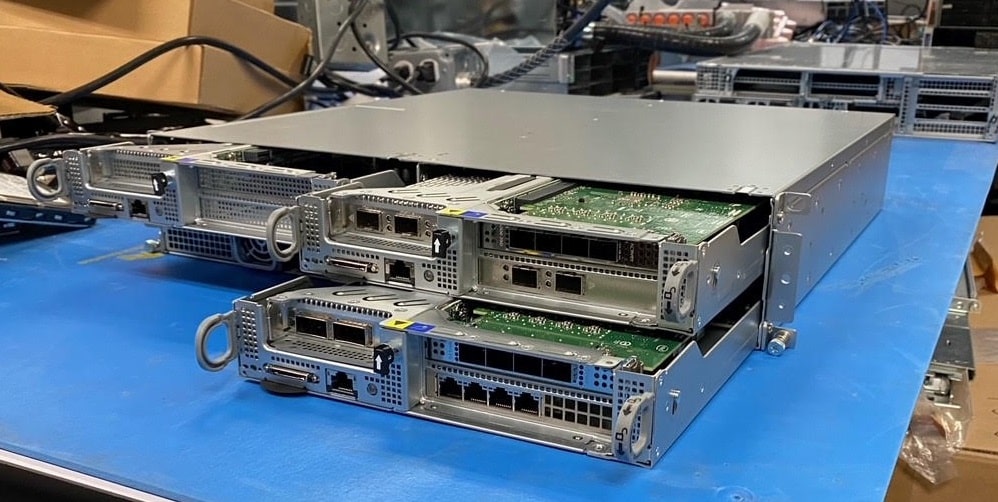
Ici, vous pouvez voir les nœuds retirés, comme leurs propres mini serveurs montés en rack.
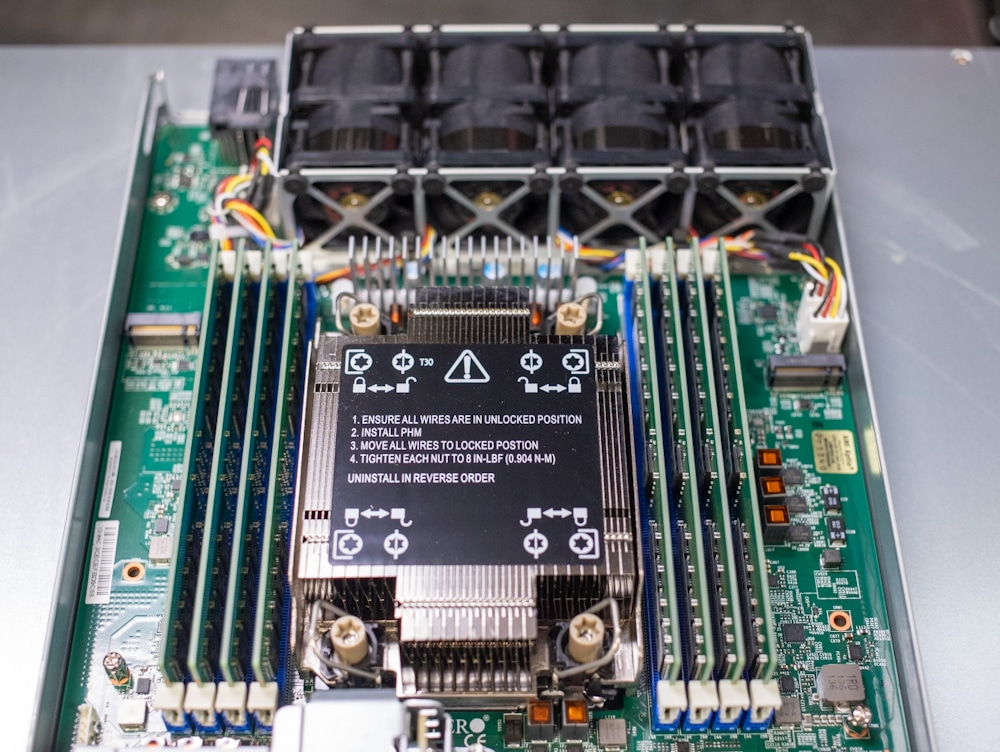
C'est l'intérieur d'un nœud. Remarquez à quel point tout s'emboîte.
La principale faiblesse de ce serveur est le stockage, avec un stockage en nœud limité à deux emplacements de lecteur de démarrage M.2 et aucune baie native de 2.5 pouces ou 3.5 pouces. Comme indiqué, vous pouvez ajouter assez facilement du stockage PCIe. Le stockage réseau est également une option ; sa connectivité au-delà de 1GbE dépend des cartes d'extension.
L'accent mis sur la périphérie de ce serveur est sa capacité à fonctionner dans des environnements jusqu'à 45 degrés C, avec de brefs passages à 55 degrés C, et son filtre à poussière disponible.
Inférence Edge : le cas des serveurs Edge
Notre article, « L'inférence en périphérie prend une nouvelle dimension grâce aux nouveaux matériels » , explique l'état actuel du calcul en périphérie. Le passage actuel au calcul en périphérie aurait semblé un retour en arrière à l'époque des anciennes architectures, où l'approche hiérarchique « hub and spoke » consistait à centraliser les données. Aujourd'hui, c'est la prise de décision en temps réel qui motive ce passage au calcul en périphérie, permettant des analyses et des temps de réponse plus rapides, ainsi qu'une moindre dépendance à la connectivité réseau.
L'inférence Edge peut être effectuée dans le cloud, mais généralement uniquement pour les applications non urgentes et non critiques. Bien sûr, le manque de connectivité réseau signifie que le cloud est interdit.
Test de la périphérie sur le SuperMicro IoT SuperServer SYS-210SE-31A
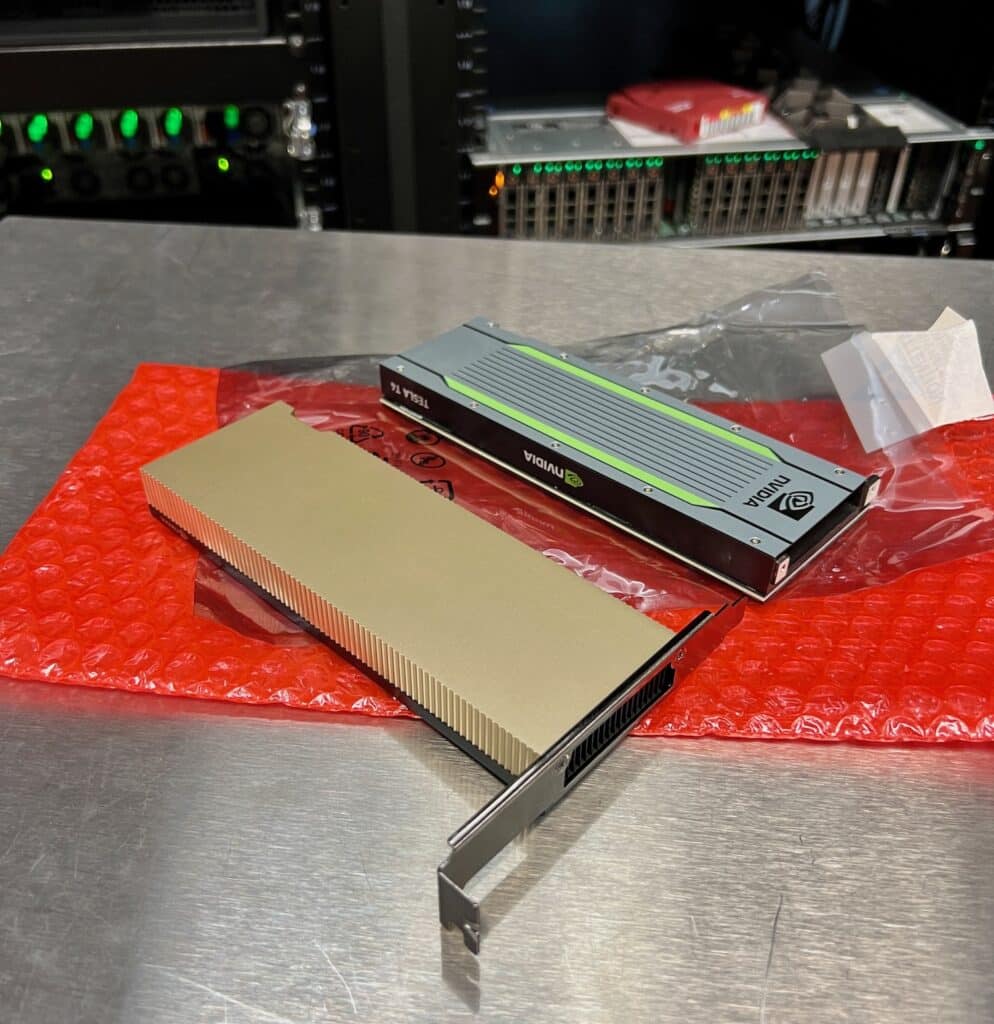
Et maintenant, passons à nos tests. La capacité d'un GPU à traiter les données entraîne l'inférence de périphérie, et les serveurs de périphérie s'en tiennent généralement à des cartes à un seul emplacement et à profil bas comme NVIDIA A2 et l'ancien mais populaire T4. Le SuperMicro IoT SuperServer SYS-210SE-31A que nous évaluons a le T4. Ci-dessous se trouvent les deux cartes, la T4 à droite et la A2 à gauche. La configuration matérielle de chaque nœud comprenait un processeur Intel Xeon Gold 6330 et 128 Go de RAM DDR4.
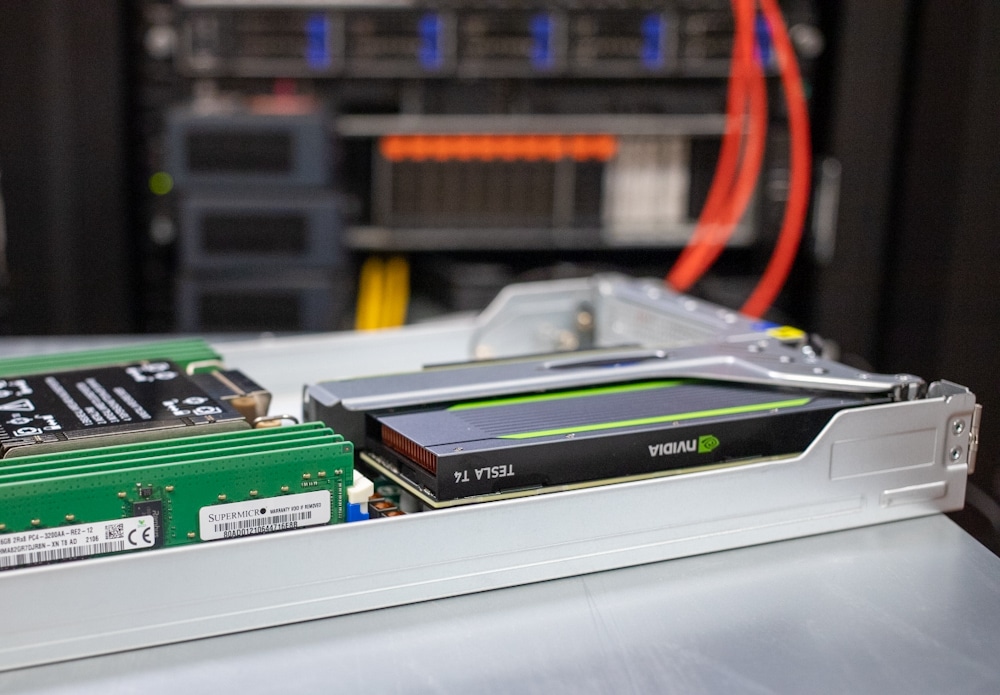
Et voici le T4 installé dans l'un des nœuds SuperMicro.
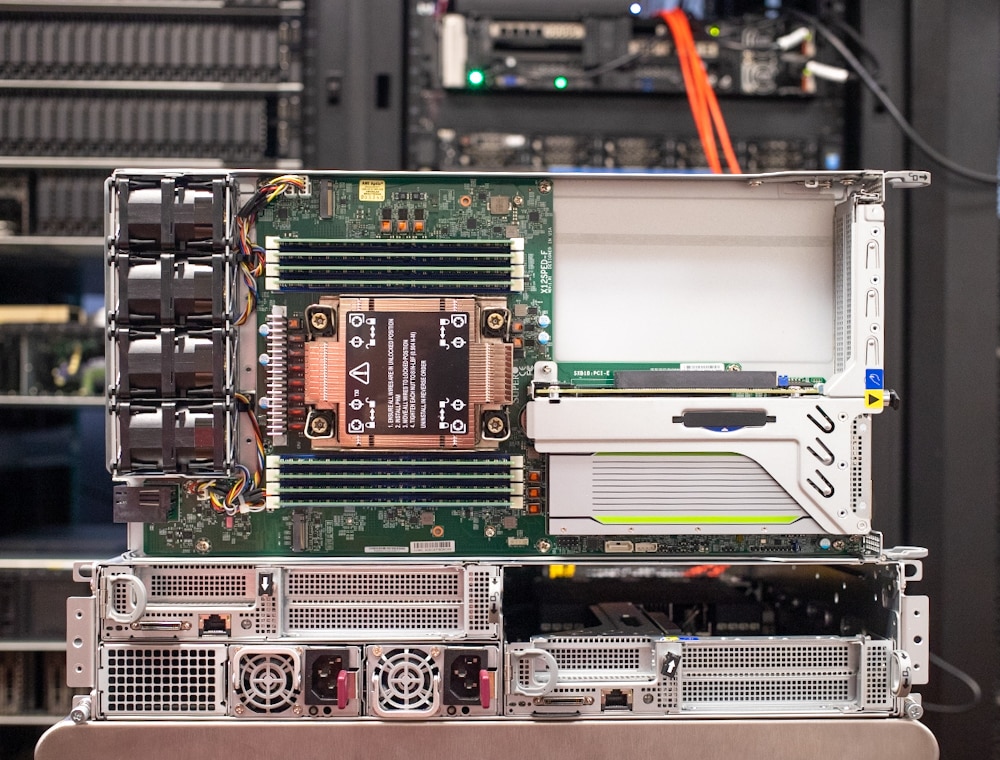
La carte graphique T4, avec sa consommation de 70 watts, tire toute son énergie du port PCIe. Son architecture Turing intègre des cœurs Tensor offrant des performances de précision FP32, FP16, INT8 et INT4 bien supérieures à celles d'un processeur. La NVIDIA A2, quant à elle, affiche une consommation légèrement inférieure (40 à 60 W) mais bénéficie d'une architecture plus récente et plus efficace. Consultez notre article sur l'inférence en périphérie pour une comparaison détaillée des deux cartes , testées sur un Lenovo ThinkEdge SE450.
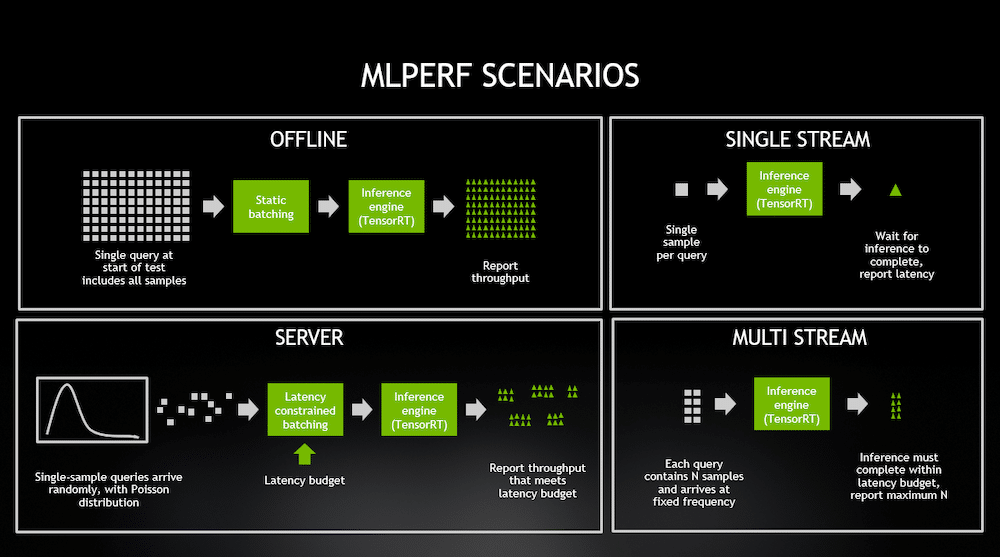
Nous travaillons avec la suite de benchmarks MLPerf Inference: Edge, qui compare les performances d'inférence pour les modèles DL populaires dans divers scénarios de bord réels. Lors de nos tests, nous avons des chiffres pour le modèle de classification d'images ResNet50 et le modèle BERT-Large NLP pour les tâches de questions-réponses. Les deux sont exécutés dans des configurations hors ligne et SingleStream.
Le scénario hors ligne évalue les performances d'inférence en « mode batch », lorsque toutes les données de test sont immédiatement disponibles et que la latence n'est pas prise en compte. Dans cette tâche, le script d'inférence peut traiter les données de test dans n'importe quel ordre, et l'objectif est de maximiser le nombre de requêtes par seconde (RPS=débit). Plus le nombre de QPS est élevé, mieux c'est.
En revanche, la configuration à flux unique traite un échantillon de test à la fois. Une fois l'inférence effectuée sur une seule entrée (dans le cas de ResNet50, l'entrée est une image unique), la latence est mesurée et l'échantillon suivant est mis à la disposition de l'outil d'inférence. L'objectif est de minimiser la latence pour le traitement de chaque requête ; plus la latence est faible, mieux c'est. La latence au 90e centile du flux de requête est capturée en tant que métrique cible pour la brièveté.
L'image ci-dessous provient d'un article de blog NVIDIA concernant l'inférence MLPerf 0.5 et illustre parfaitement les différents scénarios. Vous trouverez plus d'informations à ce sujet dans l' article original sur l'inférence MLPerf, disponible ici.
Nous avons testé la charge de travail fonctionnant sur deux nœuds à l'intérieur du SuperMicro IoT SuperServer SYS-210SE-31A. Le troisième nœud a été défini comme réserve.
| référence | Nœud 1 (NVIDIA T4) | Nœud 3 (NVIDIA T4) |
| RestNet50 hors ligne | 5,587 XNUMX échantillons/s | 5,492 XNUMX échantillons/s |
| BERT flux unique | 6.8 millisecondes (90th PCT) | 7.0 millisecondes (90th PCT) |
| BERT hors ligne | 397 XNUMX échantillons/s | 396 XNUMX échantillons/s |
Le NVIDIA T4 a globalement impressionné. Le nœud 1 a montré des performances légèrement meilleures. Cela dit, la T4 est une carte plus ancienne avec un profil de puissance plus élevé que la nouvelle A2. Nous avons vu en testant l'A2 dans le ThinkEdge SE450 qu'il a également une latence inférieure à celle du T4 à certains endroits, tout en utilisant beaucoup moins d'énergie. Les applications et les considérations de puissance doivent déterminer le choix entre les deux. Pour l'instant cependant, nous sommes satisfaits de la densité que le châssis Supermicro peut fournir pour ces types de charges de travail.
Réflexions finales
La course à la périphérie apporte des progrès rapides dans l'informatique de pointe. Cela n'est nulle part plus évident que les GPU, en particulier les options à profil bas et à faible consommation d'énergie comme le NVIDIA T4 et le plus récent A2. Nous avons testé le T4 dans le SuperMicro IoT SuperServer SYS-210SE-31A, un serveur de périphérie à trois nœuds très polyvalent.
Le T4 a montré d'excellentes performances, ce qui est encore plus impressionnant compte tenu de son âge. Cependant, il consomme un peu plus de puissance que l'A2, alors choisissez judicieusement en fonction de vos besoins d'inférence de bord. Nous nous attendons à ce que le vénérable GPU ait encore une grande partie de sa vie devant lui, car les entreprises axées sur la pointe continuent d'optimiser l'utilisation du GPU.
De plus, le serveur Supermicro IoT est très bien équipé pour gérer ces cartes, offrant des performances d'inférence très denses à la périphérie.


 Amazon