

Pendant des années, la hiérarchisation automatisée du stockage a été une solution essentielle pour les entreprises cherchant à gérer efficacement l'empreinte de leur centre de données tout en réduisant le coût total de possession (TCO). La stratégie est simple : utilisez des algorithmes et des politiques de hiérarchisation automatique et conservez les données actives sur le stockage principal tout en déplaçant les données inactives vers des catégories de stockage peu coûteuses. Ces dernières années, la hiérarchisation du cloud est devenue une solution robuste et rentable qui gère le déplacement des données inactives vers le stockage d'objets à faible coût dans le cloud. Avec la série ThinkSystem DM, Lenovo permet aux entreprises de gérer les alternatives de données et de cloud avec une solution de stockage intelligente. Cette stratégie cloud répond avec succès à la capacité, à l'agilité et à la sécurité dans les environnements de cloud hybride, sans compromettre la gérabilité, la sécurité ou les performances.
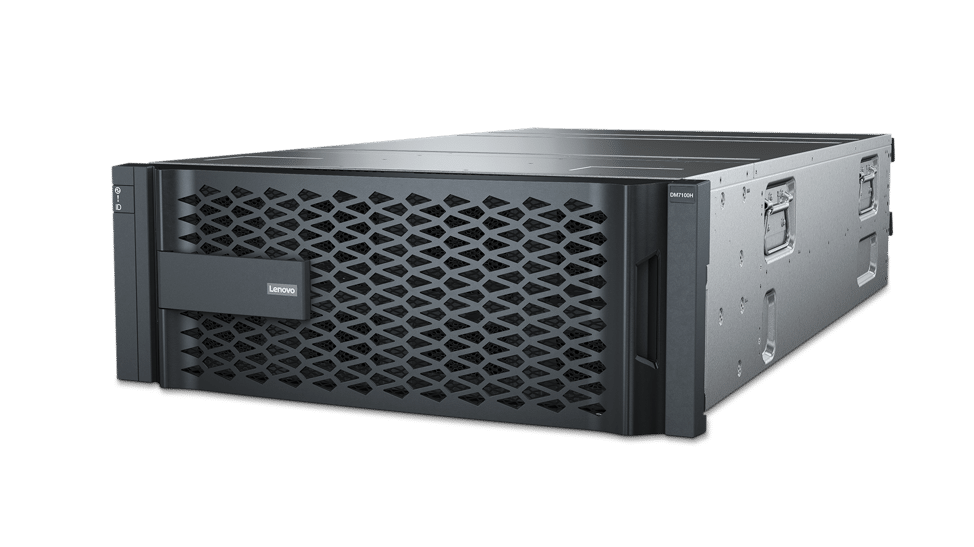
Cet article explique comment les solutions de stockage Lenovo ThinkSystem et la gamme DM offrent une stratégie de centre de données complète, de l'infrastructure sur site au cloud. Nous aborderons d'abord les concepts fondamentaux du stockage de données, du stockage hiérarchisé dans le cloud et des nouveaux défis liés à la gestion du stockage. Nous examinerons l'écosystème de gestion des données de Lenovo et la manière dont l'entreprise se distingue sur le marché du stockage grâce à la gamme DM. Nous analyserons également en détail le logiciel ONTAP et les politiques de hiérarchisation du stockage FabricPool. Enfin, nous présenterons, depuis notre laboratoire, la configuration et la validation de la solution de stockage hiérarchisée dans le cloud de Lenovo.
Dans un modèle de centre de données traditionnel, à mesure qu'une entreprise se développe, elle commence à collecter des données et des fichiers critiques dans ses locaux. Cependant, ces données finissent par devenir obsolètes et sont rarement consultées, s'appropriant des performances et une capacité précieuses du stockage principal et secondaire, ce qui a un impact sur les charges de travail critiques. L'archivage de ces données dans le passé était une solution pratique pour les entreprises ; cependant, en procédant ainsi, les données ne sont pas immédiatement disponibles au cas où elles seraient soudainement requises.
Ce problème a amené les organisations informatiques à prendre en compte les niveaux de stockage avec des caractéristiques de capacité, de coût et de performances différentes. Ils doivent également reconnaître et être prêts à répondre aux exigences de croissance des données dans des environnements multiples et cloud. La hiérarchisation cloud est la réponse, et elle doit être prise en compte dans les architectures de stockage modernes. Dans le cas contraire, une empreinte de données croissante submergera l'investissement que l'entreprise a réalisé dans le stockage primaire hautes performances de son centre de données.
Le cloud comme niveau de stockage
Au fur et à mesure que des technologies plus avancées deviennent accessibles, les niveaux de stockage existants peuvent être transformés selon les besoins, et des niveaux supplémentaires peuvent être ajoutés pour diversifier davantage l'architecture de stockage hiérarchisée. Le cloud a ouvert de nouvelles possibilités aux organisations informatiques, permettant aux solutions de stockage des fournisseurs de cloud public de constituer un niveau supplémentaire (inférieur). S'il est bien conçu et mené, le cloud sera une solution excellente et moins coûteuse qu'un niveau inférieur sur site.
Dans les niveaux de stockage principaux qui utilisent le flash pour des performances extrêmement élevées, environ 50 % des données froides pourraient être allouées au cloud. Les copies instantanées et les données non structurées font souvent partie de cette catégorie, y compris les applications critiques. Dans les niveaux secondaires, les données froides stockées dans le stockage peuvent provenir jusqu'à 90 % de copies de sauvegarde. Toutes ces données précieuses, mais seulement consultées occasionnellement, pourraient également être déplacées vers le cloud. Les fournisseurs et services cloud populaires prêts à hiérarchiser les données inactives incluent Azure Blob Storage, AWS S3 et Google Cloud Storage.
Comme pour la hiérarchisation du stockage automatisé sur site, nous pouvons créer des politiques et des règles pour administrer les données pour le cloud. Les conditions nous permettent de transférer des fichiers directement du local vers le cloud public. Les politiques sont appliquées de plusieurs façons. Par exemple, les données peuvent être déplacées en fonction de l'extension du fichier, des modèles inclus dans le nom du fichier ou de la fréquence d'accès au fichier au cours d'une période donnée. Cette dernière option est probablement le meilleur scénario, où les fichiers et les blocs de stockage reçoivent des valeurs de température, étiquetant les données nouvellement écrites comme chaudes et les inactives comme froides. En mettant en œuvre un ensemble de politiques de hiérarchisation du stockage, les données froides peuvent être rapidement déplacées vers le cloud en exécutant des règles à la demande ou selon un calendrier.
Nouveaux défis de gestion du stockage
Les principaux défis observés sur le marché aujourd'hui concernant la gestion des données de cloud hybride consistent en le volume et la variété, la vitesse des données et l'intégrité des données.
Les volumes de données augmentent à un rythme quasi exponentiel. Les organisations informatiques doivent maîtriser non seulement la croissance des données, mais aussi la croissance et la gestion des données dans plusieurs environnements. Le volume et la variété des données générées continuent d'être écrasants. Sans les capacités de stockage, de catégorisation et de traitement de ces données dans une solution de cloud hybride, les organisations passent à côté d'informations essentielles sur leurs clients et leurs activités. De plus, il est prévu que les volumes de données soient multipliés par 10 d'ici 2025 (environ 163 ZB), grâce à l'IoT et à la technologie de pointe. Si les données sont l'atout le plus précieux, elles doivent être traitées avec soin et doivent pouvoir fournir des informations sur des décisions ciblées, tout en permettant de se projeter dans l'avenir. De plus, trouver des moyens plus efficaces de traiter ces données pour en faire une valeur est vital pour les décisions d'achat des clients.
Les menaces informatiques évoluent également et la sécurisation de l'infrastructure est une bataille permanente. Une bonne stratégie de sécurité consiste à établir une base solide en sachant exactement quand, où et comment les données sont stockées. Ce type de stratégie aide les entreprises à éviter les coûts croissants associés aux violations de données, ainsi que les nouveaux logiciels malveillants, les catastrophes et les réglementations qui présentent des risques importants pour les opérations. La sécurité des données est d'une importance absolue pour les entreprises, qu'il s'agisse de se protéger contre la perte de données ou d'assurer l'intégrité des données. C'est ici que Lenovo couvre toutes les options et garantit que les données de ses clients seront toujours protégées.
Solutions de stockage Lenovo ThinkSystem
Anticiper les nouveaux développements est également un défi, tout comme se tenir au courant de la meilleure stratégie de stockage et de cloud. Cependant, l'industrie a déjà fait d'énormes investissements dans les écosystèmes et les plateformes de recherche qui offrent de la valeur et des opportunités pour l'entreprise. Passant à la prochaine étape stratégique pour l'industrie du stockage, Lenovo a adapté sa solution pour répondre aux principaux défis observés dans la gestion des données. Cette décision intelligente de Lenovo vise à fournir la solution ultime à ses clients et offre un mélange unique de produits et de services pour permettre aux entreprises d'utiliser au mieux le cloud hybride.
Lenovo est l'une des sociétés technologiques uniques sur le marché qui fournit une solution de centre de données de bout en bout par le biais du Lenovo Data Center Group (DCG). De plus, Lenovo fournit une sécurité et une gestion logicielle de bout en bout avec son écosystème Intelligent Device Group (IDG). Grâce à ces offres et à la série ThinkSystem DM de Lenovo, les entreprises peuvent améliorer leur infrastructure et gérer toute charge de travail exécutée dans leurs environnements.
La gamme ThinkSystem DM est la solution de stockage phare de Lenovo. Elle offre une suite de gestion de données polyvalente pour les données structurées et non structurées. Couvrant l'entrée de gamme jusqu'au milieu de gamme supérieur, elle propose des fonctionnalités avancées telles que la réduction, la protection et la sécurité des données intégrées. Chaque système de la gamme DM peut intégrer des capacités de cloud hybride pour les solutions des fournisseurs de cloud public. Parallèlement, Lenovo développe son offre NVMe de bout en bout avec sa récente gamme DM7100F et prévoit d'étendre cette offre à un plus grand nombre de charges de travail d'entrée de gamme, permettant ainsi aux clients de créer une infrastructure NVMe d'entreprise à l'échelle de l'entreprise.
Piscines en tissu
La suite de gestion des données de la série DM unifie la gestion des données sur le flash, le disque et le cloud pour simplifier les environnements de stockage. Ce logiciel complet est simple à utiliser et très flexible, conçu pour un stockage efficace et dispose de fonctionnalités de gestion de données robustes ainsi que d'une intégration cloud transparente. Dans l'ensemble, la série DM vise à simplifier le déploiement et la gestion des données et à dynamiser les applications d'entreprise ; c'est-à-dire qu'il est prêt pour l'avenir pour les infrastructures de données.
Parallèlement à la capacité de gestion des données intégrée, la technologie FabricPool Cloud Tiering. Il permet une hiérarchisation automatisée des données vers des niveaux de stockage d'objets S3 à faible coût, situés sur site ou dans le cloud public. Contrairement aux solutions de hiérarchisation manuelle, FabricPool automatise la hiérarchisation des données pour réduire le coût du stockage. Les données actives restent sur des disques hautes performances et les données inactives sont hiérarchisées vers le stockage d'objets tout en préservant les fonctionnalités et l'efficacité des données de la série DM.
FabricPool prend en charge un large éventail de fournisseurs de cloud public et leurs services de stockage. Il s'agit notamment d'Amazon S3, d'Alibaba Cloud Object Storage Service, de Microsoft Azure Blob Storage, de Google Cloud Storage, d'IBM Cloud Object Storage et de clouds privés. Les clients bénéficieront également de la conservation des fonctionnalités de réduction de données intégrées lors du déplacement de données vers et depuis le cloud. Cela permet d'économiser sur les coûts de transport lorsque les données doivent être renvoyées du cloud. De plus, le chiffrement des données intégré protège les deux données lors du déplacement vers le cloud et se poursuit une fois dans le cloud. Cela garantit qu'il n'y a pas de vulnérabilités tout au long du processus de hiérarchisation du cloud.
Politiques FabricPool
FabricPool a deux cas d'utilisation principaux : récupérer de la capacité sur le stockage principal ou réduire l'empreinte du stockage secondaire. Dans cet article, nous nous concentrons sur la possibilité de récupérer de la capacité sur le stockage principal. Il existe trois politiques différentes et uniques pour la hiérarchisation cloud du stockage principal : hiérarchisation automatique, instantanés uniquement et hiérarchisation complète.
La conservation des données rarement consultées associées aux logiciels de productivité, aux projets terminés et aux anciens ensembles de données sur le stockage principal est une utilisation inefficace du stockage flash hautes performances. La hiérarchisation de ces données dans un magasin d'objets est un moyen simple de récupérer la capacité flash existante et de réduire la quantité de capacité requise à l'avenir. La politique de hiérarchisation automatique déplace tous les blocs froids du volume vers le niveau cloud. S'ils sont lus par des lectures aléatoires, les blocs de données froids sur le niveau cloud deviennent chauds et sont transférés au niveau local. S'ils sont lus par des lectures séquentielles telles que celles associées aux analyses d'index et antivirus, les blocs de données froids sur le niveau cloud restent froids et ne sont pas écrits au niveau local.
Les copies instantanées peuvent fréquemment consommer plus de 10 % d'un environnement de stockage typique. Bien qu'essentielles pour la protection des données et la reprise après sinistre, ces copies ponctuelles sont rarement utilisées et constituent une utilisation inefficace de la mémoire flash hautes performances. La politique de hiérarchisation des instantanés uniquement pour FabricPool est un moyen simple de récupérer de l'espace de stockage sur le stockage flash. Lors de nos tests, Snapshot-Only était la stratégie utilisée pour tester les opérations de hiérarchisation cloud. Les blocs Cold Snapshot du volume qui ne sont pas partagés avec le système de fichiers actif sont déplacés vers le niveau Cloud. S'ils sont lus, les blocs de données froids sur le niveau cloud deviennent chauds et sont transférés au niveau local.
L'une des utilisations les plus courantes de FabricPool consiste à déplacer des volumes entiers de données vers des nuages. Les projets terminés, les rapports hérités ou les enregistrements historiques sont des candidats idéaux pour être hiérarchisés vers un stockage d'objets à faible coût. Le déplacement de volumes entiers s'effectue en définissant la politique de hiérarchisation de tous sur un volume. Cette stratégie est principalement utilisée avec les données secondaires et les volumes de protection des données. Néanmoins, il peut également être utilisé pour hiérarchiser toutes les données dans des volumes de lecture/écriture.
Les données des volumes utilisant la politique de hiérarchisation complète sont immédiatement étiquetées comme froides et hiérarchisées vers le cloud dès que possible. Il n'est pas nécessaire d'attendre qu'un nombre minimum de jours s'écoule avant que les données soient refroidies et hiérarchisées. S'ils sont lus, les blocs de données froids sur le niveau cloud restent froids et ne sont pas réécrits au niveau local.
Une quatrième option de politique de hiérarchisation est également disponible avec Lenovo et porte à juste titre le nom de politique de hiérarchisation "Aucune". Avec cette politique, aucune donnée n'est hiérarchisée, ce qui permet de tout conserver en flash. Un bon exemple de son utilisation sont les instantanés dans les environnements DevOps, où les copies ponctuelles précédentes sont fréquemment utilisées.
Configuration de la hiérarchisation du cloud de stockage Lenovo
Pour tester les capacités et certaines fonctionnalités de la solution de stockage Lenovo pour le cloud, nous avons configuré un modèle DM7000F dans notre laboratoire.
Tout d'abord, nous avons créé un conteneur de stockage à l'aide d'Azure Blob Storage, notre solution cloud pour ce test. Encore une fois, il est bon de noter le large éventail d'options disponibles auprès de Lenovo, notamment Alibaba Cloud, Amazon S3, Google Cloud, IBM Cloud et autres. Lors du test, l'objectif était d'utiliser Microsoft Azure Blob Storage pour le cloud comme niveau cloud pour FabricPool. Une fois la configuration du stockage en nuage terminée, il était temps de se connecter à l'interface graphique du DM7000.
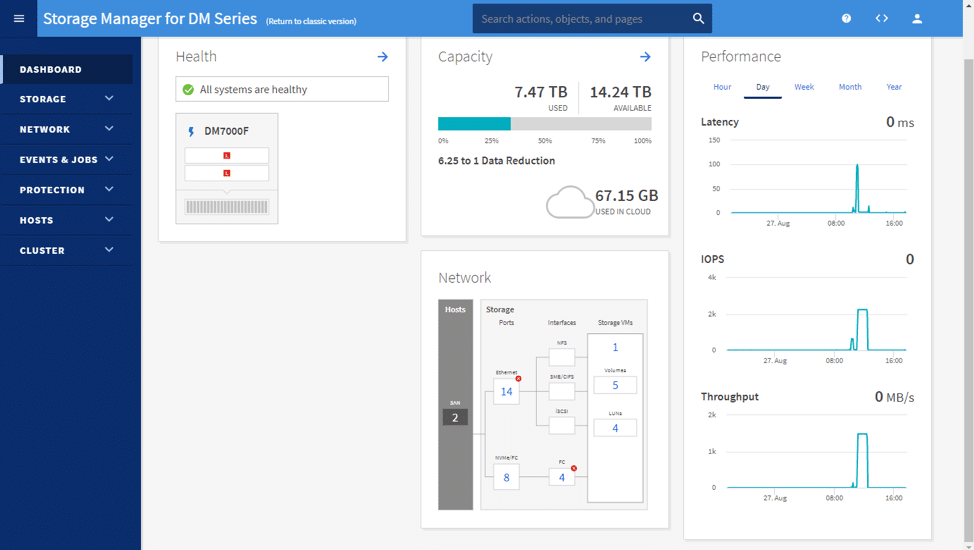
Une fois connecté, la page du tableau de bord par défaut apparaît. Le tableau de bord affiche l'intégrité, la capacité, les performances et les informations réseau de la baie en question.
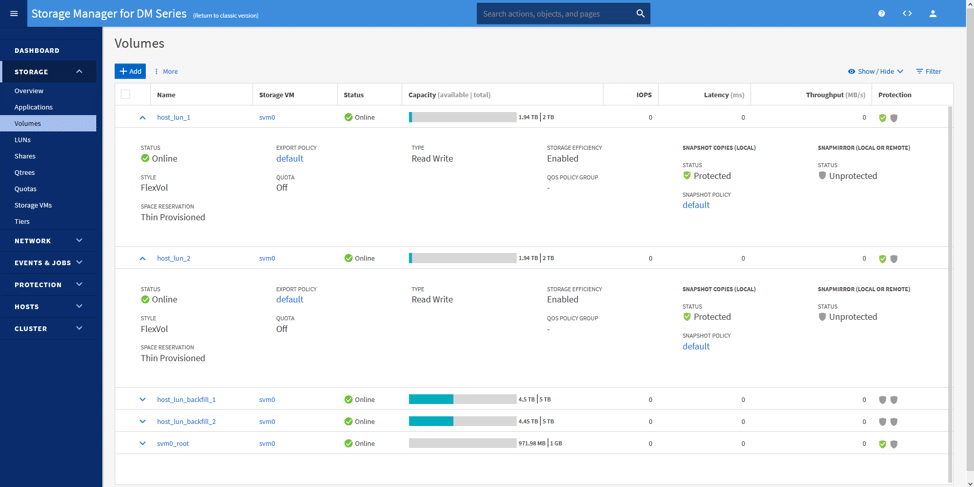
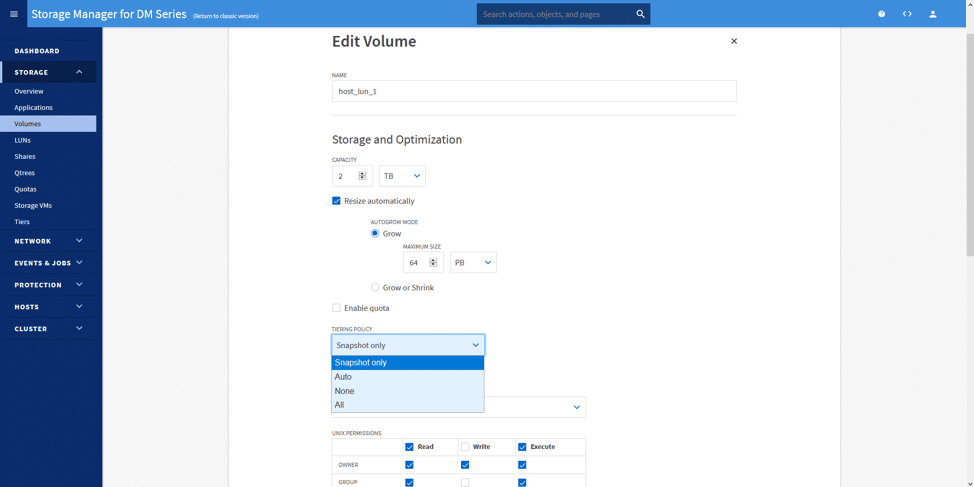
Nous avons ensuite créé deux volumes (un par contrôleur) et deux VM (une pour chaque volume). Le plan était de laisser ces machines virtuelles fonctionner, puis de les laisser inactives pendant un certain temps. L'image ci-dessous montre les volumes utilisés : host_lun_1 et host_lun_2.
Lors de la modification ou de la création du volume, nous pouvons sélectionner la politique de hiérarchisation souhaitée. Ici, nous avons sélectionné Snapshot uniquement. En sélectionnant cette stratégie de hiérarchisation, nos données (considérées comme froides après chaque instantané) sont transférées vers le stockage Azure Blob créé sur un intervalle d'arrière-plan. L'intervalle s'exécute à son propre rythme, prédisant à quel moment les charges de travail seront le moins impactées.
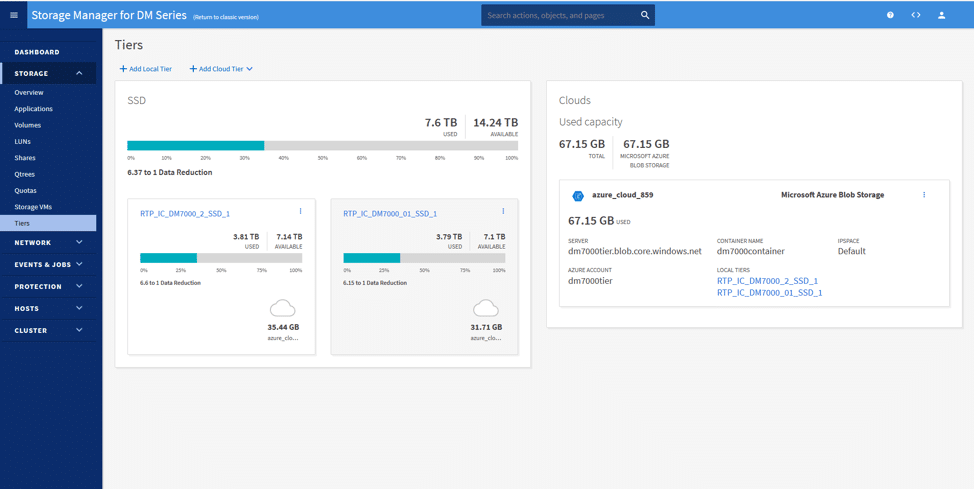
Sous la page Tiers se trouve l'endroit où nous pouvons ajouter notre niveau cloud à partir des clouds publics. Ici, nous avons attaché la ressource Azure Blob Storage et l'avons connectée aux deux niveaux de stockage locaux. Sous l'image ci-dessous, vous pouvez voir deux ressources attachées à Azure.
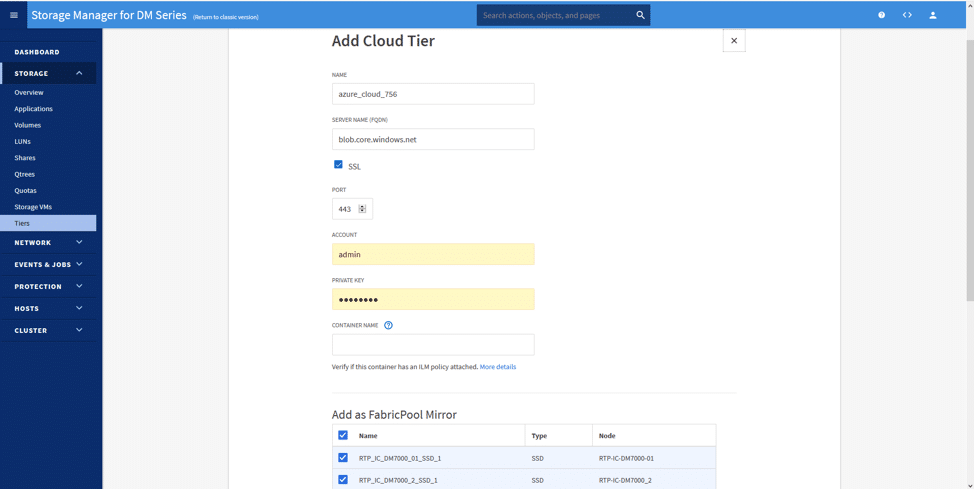
La configuration est simple ; en cliquant sur Ajouter un niveau cloud et en sélectionnant le cloud souhaité (Azure, dans ce scénario), nous pourrions immédiatement configurer le niveau cloud.
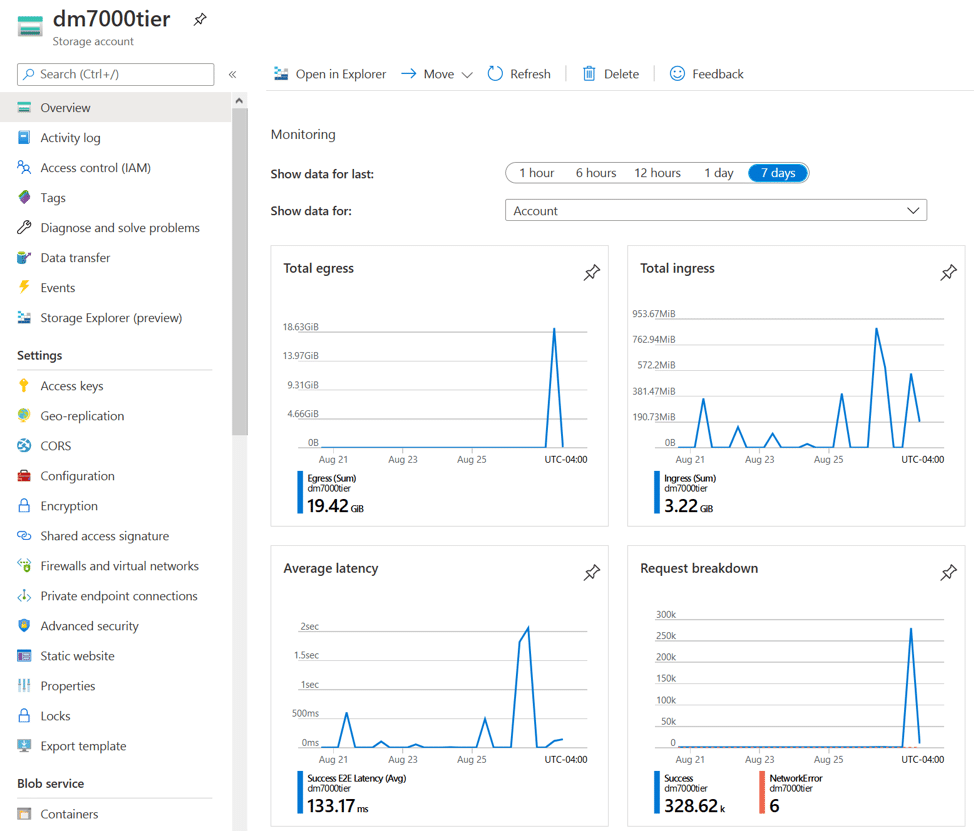
Enfin, à partir de notre tableau de bord de compte de stockage Azure, nous voulions afficher à la fois les données entrant dans Azure (entrée) et les données sortant (sortie). Les petits pics affichés chaque jour sont de nouveaux instantanés de données transférées vers Azure. D'autre part, les pics de sortie montrent des données sortantes, illustrant une restauration d'instantané à partir d'un volume à restaurer.
Réflexions finales
En général, le cloud et la gestion des données sont un sujet vaste et évolutif parmi les entreprises. Lenovo souhaite fournir des solutions qui préparent les clients à l'évolution des besoins, que ce soit dans le centre de données ou via des environnements de cloud hybride. Chez StorageReview, nous sommes très impressionnés par l'approche de Lenovo vis-à-vis de leurs baies de stockage. Grâce à cette évaluation, nous avons découvert comment la hiérarchisation des données vers le cloud fonctionne à partir de Storage Manager pour la série DM, et comment la précieuse capacité flash est récupérée ou étendue dans le cloud. Surtout, le système de stockage DM7000F offre cette flexibilité sans apporter de modifications à l'infrastructure. De plus, la fonctionnalité est facile à mettre en œuvre.
Soutenu par DCG et IDG, nous voyons Lenovo en position de force sur le marché du stockage de données. Leurs solutions de stockage permettent aux clients d'acheter ce dont ils ont besoin aujourd'hui tout en tirant parti du cloud pour répondre aux exigences de croissance des données de demain. Le résultat net est que la hiérarchisation cloud de Lenovo réduira les coûts et permettra aux entreprises d'avoir la flexibilité qu'elles souhaitent lorsqu'elles envisagent un investissement dans le stockage.
Matrices de stockage Lenovo ThinkSystem série DM
Ce rapport est parrainé par Lenovo. Tous les points de vue et opinions exprimés dans ce rapport sont basés sur notre vision impartiale du ou des produits à l'étude.


 Amazon