

CoreWeave ha implementato un cluster multi-rack NVIDIA Vera Rubin NVL72 su CoreWeave Cloud, collegando centinaia di GPU Rubin in un unico ambiente scalabile, pensato per carichi di lavoro di intelligenza artificiale agentiva. Ogni rack, realizzato da Dell, ospita 72 GPU Rubin, 36 CPU Vera, NVLink 6 come fabric di scalabilità verticale, DPU BlueField-4 e due SuperNIC ConnectX-9 per GPU. I rack sono collegati tramite Ethernet NVIDIA Spectrum-X in un fabric a due livelli non bloccante che, secondo CoreWeave, è scalabile fino a circa 128,000 GPU. CoreWeave è il primo fornitore di servizi cloud ad aver validato e implementato un singolo Vera Rubin NVL72 e il primo a pubblicare le prestazioni misurate da tale sistema; i primi dati sottoposti a revisione paritaria sono apparsi la scorsa settimana su MLPerf Inference v6.1 , dove la performance di CoreWeave è stata eseguita su un GB300 NVL72. Oltre alla potenza di calcolo, CoreWeave AI Object Storage introduce l'accelerazione della scrittura tra regioni e un nuovo livello di archiviazione.
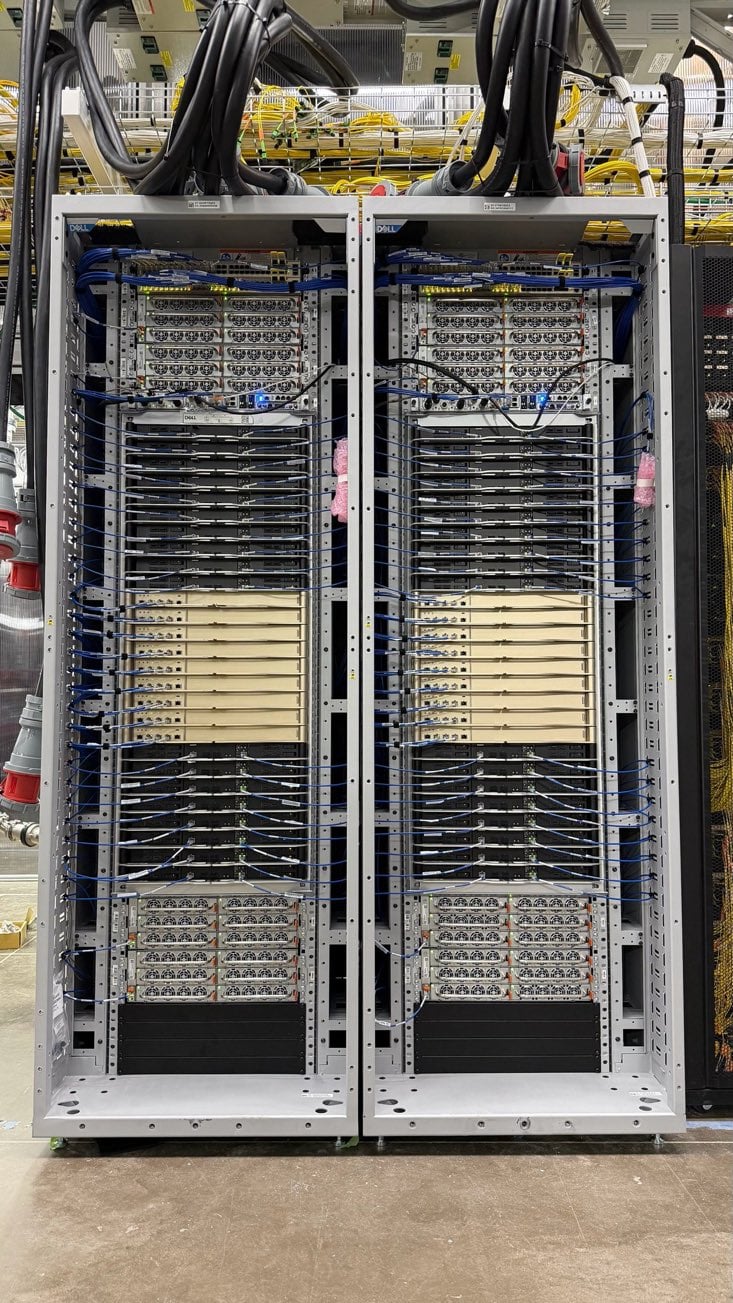
Architettura multi-rack NVIDIA Vera Rubin NVL72
La configurazione multi-rack è pensata per percorsi di esecuzione agentici, dove i cicli di ragionamento seriali e le chiamate a strumenti esterni aumentano la latenza di accesso ai dati attraverso l'infrastruttura distribuita. Le due SuperNIC ConnectX-9 su ciascuna GPU Rubin forniscono fino a 1.6 Tb/s di connettività di rete backend per GPU su percorsi multi-rail e multi-piano, e CoreWeave descrive la struttura come modulare, in modo che ulteriori rack NVL72 si uniscano alla stessa topologia non bloccante man mano che la capacità aumenta. I rack funzionano con raffreddamento a liquido a 45 °C.
CoreWeave collega i rack tramite il suo software Mission Control. Un Rack LifeCycle Controller gestisce il provisioning e il ciclo di vita di ciascun rack, il rilevamento dell'hardware tramite flashing del firmware, la convalida, l'alimentazione e i circuiti termici; un livello di gestione dei rack chiamato Racky controlla l'alimentazione e l'infrastruttura; e un controller di raffreddamento programmabile chiamato Valvey fornisce visibilità e controllo definiti via software sui circuiti di raffreddamento a liquido e sui sensori ambientali.
I rack entrano in produzione solo dopo una fase di validazione a tappe. A livello di nodo, ciò significa ore di diagnostica ripetuta delle GPU, controlli di trasferimento CPU-GPU, validazione dell'interconnessione e termica sotto carico e simulazioni di training realistiche. A livello di rack, i job sincronizzati su tutte le 72 GPU verificano le prestazioni NVLink GPU-to-GPU e qualsiasi sistema che si trovi al di sotto dell'intervallo previsto viene sottoposto a risoluzione dei problemi. Su tutti i rack, CoreWeave esegue carichi di lavoro distribuiti, disabilita deliberatamente i percorsi NVLink per forzare il traffico sulla rete di backend e monitora l'infrastruttura fisica per individuare collegamenti instabili, tassi di errore crescenti, surriscaldamento dell'hardware e traffico irregolare, con modelli di carico che simulano applicazioni agentiche: picchi di domanda improvvisi, concorrenza variabile e raffiche di comunicazione. La documentazione di CoreWeave sull'avvio multi-rack descrive in dettaglio ogni fase ed è una lettura interessante.
Aggiornamenti di AI Object Storage: scritture tra regioni e livello di archiviazione
La parte di storage si basa su CoreWeave AI Object Storage e sul suo Local Object Transport Accelerator (LOTA), un proxy di caching che viene eseguito su ogni nodo GPU e CPU in CoreWeave Kubernetes Service e memorizza gli oggetti su NVMe locale al nodo. CoreWeave dichiara velocità di lettura in cache fino a 7 GB/s per GPU con una latenza di lettura p99 inferiore di oltre 8 volte rispetto alla lettura dal bucket, e cita un fornitore di servizi all'avanguardia che utilizza LOTA su oltre 15,000 GPU e 20 PB di cache con un tasso di successo del 99.7%. LOTA non prevede costi aggiuntivi.
L'accelerazione della scrittura tra regioni consente a un'applicazione di scrivere in un bucket in una regione remota con la stessa latenza locale, senza modifiche alle API o all'SDK. L'applicazione esegue una scrittura S3 standard sull'endpoint LOTA; i dati dell'oggetto vengono memorizzati in modo permanente nella regione locale mentre i metadati vengono salvati in quella remota; l'oggetto è immediatamente leggibile, anche dal processo che lo ha scritto; e i dati migrano nella regione remota in background. Le applicazioni vedono un unico spazio dei nomi del bucket in tutte le regioni con policy IAM, regole del ciclo di vita e controlli di accesso uniformi, eliminando così i fork per regione e le pipeline di replica solitamente richiesti dalla distribuzione dei checkpoint tra i siti.
"I nostri set di dati si estendono su più regioni e non possiamo permetterci che la nostra pianificazione dell'addestramento sia condizionata dai ritardi di recupero tra regioni diverse", ha affermato Cécile Robert-Michon, direttrice dell'infrastruttura interna di Cohere. "CoreWeave AI Object Storage ci offre un'impronta unificata dei set di dati tra le regioni, con le letture memorizzate nella cache locale, in modo che nulla rimanga in attesa sulla rete."
Il livello Archive è una quarta classe di storage, che si affianca a Hot, Warm e Cold, pensata per i dati che vengono scritti una sola volta e letti raramente, come i checkpoint di training meno recenti e i dataset grezzi. Offre prezzi di base inferiori e non prevede costi di recupero, cache, per richiesta, cancellazione anticipata, tiering e uscita. Il modello consigliato da CoreWeave prevede di mantenere i checkpoint più recenti nei livelli più veloci per riavvii immediati e di spostarli automaticamente nel livello Archive dopo 60 giorni senza alcuna lettura. Sia le scritture tra regioni che il livello Archive sono già disponibili; i dettagli di configurazione sono disponibili nel post di CoreWeave dedicato allo storage.


 Amazon