

MLCommons ha pubblicato oggi i risultati di MLPerf Storage v3.0, che cambiano non solo la natura del benchmark, ma anche la classifica. Per la prima volta, l'unico benchmark di storage per l'IA con certificazione ufficiale copre l'intera pipeline: throughput di training, checkpointing e due nuovi carichi di lavoro di inferenza, un test di database vettoriale e un test di cache KV. Diciannove organizzazioni hanno inviato 143 risultati, undici delle quali alla loro prima partecipazione, tra cui Microsoft Azure, NVIDIA, Everpure e una serie di startup specializzate in storage per l'IA che la maggior parte dei lettori non conoscerà. Altrettanto degno di nota è il fatto che DDN, Huawei, Hammerspace e Lightbits, i nomi che hanno definito la classifica della v2.0, non abbiano partecipato a questa edizione.
Una nota preliminare sulla comparabilità. La versione 3.0 ha spostato gli acceleratori simulati da H100 a B200, il che innalza il livello di larghezza di banda per singolo acceleratore; pertanto, i valori della versione 3.0 non sono confrontabili con i risultati della versione 2.0. Si tratta di dati forniti dai fornitori e verificati da MLCommons; StorageReview non ha condotto né verificato in modo indipendente questi test.
Il checkpointing è l'evento principale.
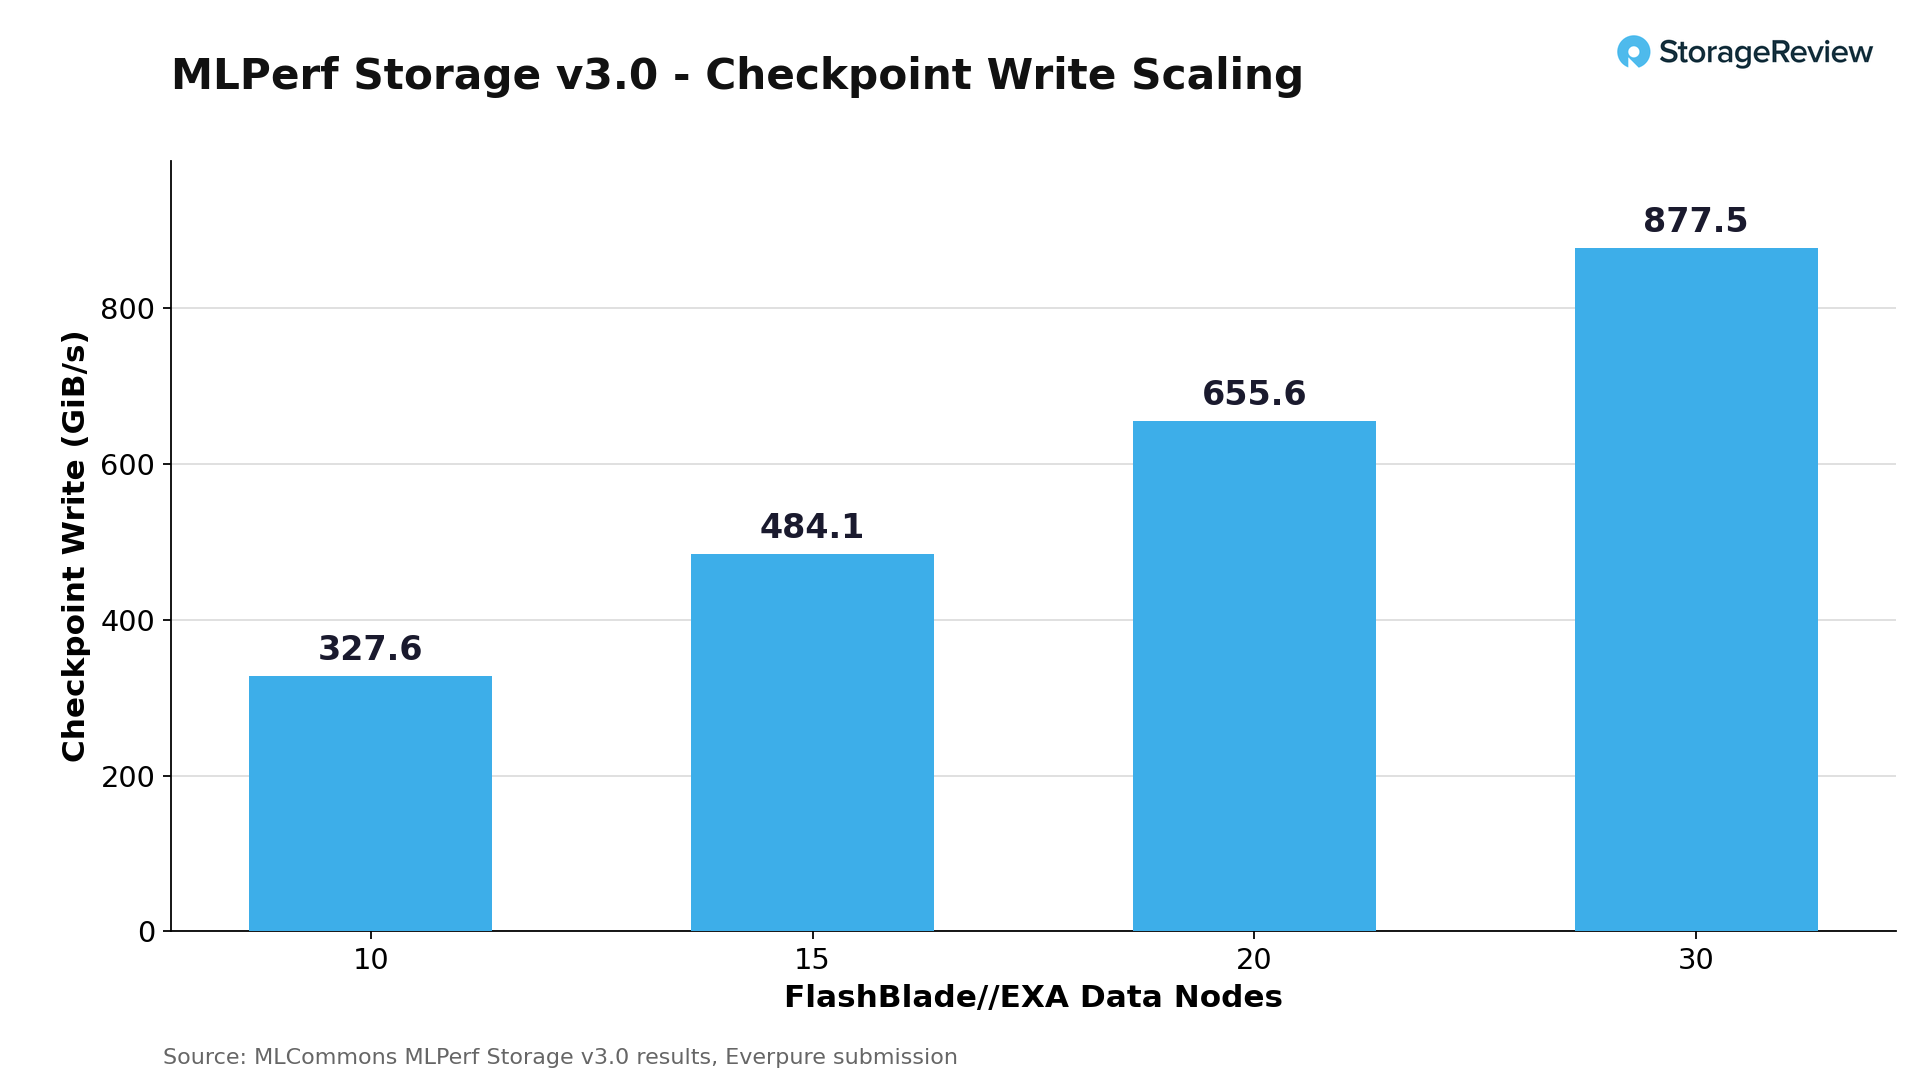
MLCommons ha aggiunto il checkpointing come carico di lavoro prioritario perché è diventato un collo di bottiglia accertato: i job di training su scala di frontiera scrivono enormi quantità di stato a intervalli regolari e ogni secondo impiegato per svuotare un checkpoint è un secondo di tempo di inattività dell'acceleratore. Il valore più alto del round appartiene a questa categoria. Everpure (precedentemente Pure Storage), alla sua prima apparizione a MLPerf Storage, ha presentato risultati per FlashBlade//EXA che scalano quasi linearmente con il numero di nodi dati: 327.6 GiB/s di scrittura del checkpoint con 10 nodi dati, 484.1 GiB/s con 15, 655.6 GiB/s con 20 e 877.5 GiB/s di scrittura con 833.0 GiB/s di lettura con 30 nodi dati. Everpure ha trascorso l'ultimo anno a fare grandi affermazioni sul throughput per //EXA; questa è la prima volta che un risultato verificato conferma la direzione di tali affermazioni.
Il secondo valore più alto in termini di checkpoint è probabilmente la notizia più rilevante per il settore. Azure Managed Lustre, il primo servizio di storage cloud hyperscale mai sottoposto al benchmark, ha registrato 642.2 GiB/s di scrittura checkpoint da un'implementazione di 4,096 TiB con 128 client. Un servizio di file cloud gestito in grado di raggiungere risultati paragonabili a quelli di array di storage per intelligenza artificiale progettati appositamente sarebbe stato difficile da immaginare solo due round fa.
| Checkpointing (Migliori proposte) | Sistema | Scrittura in bianco e nero (GiB/s) |
|---|---|---|
| Sempre puro | FlashBlade//EXA, 30 nodi dati | 877.5 |
| azzurro | Lustre gestito, 4,096 TiB, 128 client | 642.2 |
| YanRongTech | F9000X, 8 client | 313.7 |
| Suzhou Zishan Longlin | Configurazioni multiple | 313.7 |
| Dati Turing | F9200, 8 client | 307.1 |
| UBIX | UbiPower18000, 3 nodi di archiviazione | 293.8 |
Formazione: nomi che probabilmente non conoscete
La classifica del training 3D U-Net è dominata dai nuovi arrivati. L'F9000X di YanRongTech ha mantenuto una larghezza di banda di lettura di 543.9 GiB/s alimentando 99 acceleratori B200 simulati, il throughput di training più alto del round. TuringData, un'azienda di infrastrutture AI di Singapore al suo debutto, si è piazzata a 4 GiB/s di distanza con 541.5 GiB/s, alimentando 96 B200 simulati da soli tre nodi di storage. Lo stesso cluster F9200 a tre nodi ha anche inviato Checkpoint-70B con 539.9 GiB/s in lettura e 307.1 GiB/s in scrittura. L'UbiPower18000 di UBIX, con tre nodi di storage dotati di 16 unità NVMe da 15.36 TB e quattro interfacce di rete NDR400, ha raggiunto i 454.1 GiB/s. HPE è stato l'unico fornitore affermato di array per aziende a presentare i risultati dei test, con il modello K3000 a 345.8 GiB/s.
| Formazione su U-Net 3D (Migliori proposte) | Lettura in bianco e nero (GiB/s) | Acceleratori B200 simulati |
|---|---|---|
| YanRongTech F9000X | 543.9 | 99 |
| TuringData F9200 | 541.5 | 96 |
| UBIX UbiPower18000 | 454.1 | 80 |
| Suzhou Zishan Longlin | 433.4 | 80 |
| FarmGPU | 406.7 | 75 |
| Lustro gestito da Azure | 379.1 | 70 |
L'inferenza si unisce al benchmark
I due nuovi carichi di lavoro riconoscono dove sta effettivamente crescendo la domanda di storage. Il test della cache KV misura la velocità con cui un sistema di storage può caricare e scaricare lo stato di attenzione per la gestione di LLM a contesto lungo, un modello che abbiamo esaminato in dettaglio nel nostro lavoro di offload della cache KV di Dell e Solidigm . Everpure ha nuovamente registrato il valore più alto del round, 1,623.4 GiB/s di lettura della cache KV su una configurazione FlashBlade//EXA a 51 host, con UBIX (443.7 GiB/s) e FarmGPU (443.6 GiB/s) in testa alle prestazioni su scala standard. Per quanto riguarda i database vettoriali, il sistema Seahorse di TTA ha dominato la classifica del throughput delle query con 57,620 query al secondo.
L'altro cambiamento strutturale riguarda il protocollo. La versione 3.0 ha aggiunto il supporto per l'archiviazione a oggetti S3 e circa un sesto delle implementazioni lo ha utilizzato. NVIDIA ha rappresentato la maggior parte di queste, con 20 implementazioni AIStore che coprono configurazioni bare-metal su OCI, AWS e GCP, raggiungendo un picco di 133.3 GiB/s di scrittura checkpoint. I numeri assoluti sono inferiori a quelli dei file system paralleli, ma l'archiviazione a oggetti che esegue carichi di lavoro di training e checkpoint all'interno del benchmark segna un territorio che i file system POSIX detenevano in esclusiva fino a poco tempo fa.
In questa tornata, MLCommons ha anche iniziato a monitorare l'efficienza energetica e l'utilizzo dello spazio rack come parametri di primaria importanza.
Everpure FlashBlade//EXA
Il sistema Everpure FlashBlade//EXA si è classificato al primo posto nelle categorie di checkpointing dei modelli di parametri da 405B e 1.25T, nonché nei benchmark di recupero della cache chiave-valore (KV), evidenziando la capacità della piattaforma di mantenere un throughput elevato durante i carichi di lavoro di addestramento e inferenza dell'intelligenza artificiale ad alta intensità di dati.
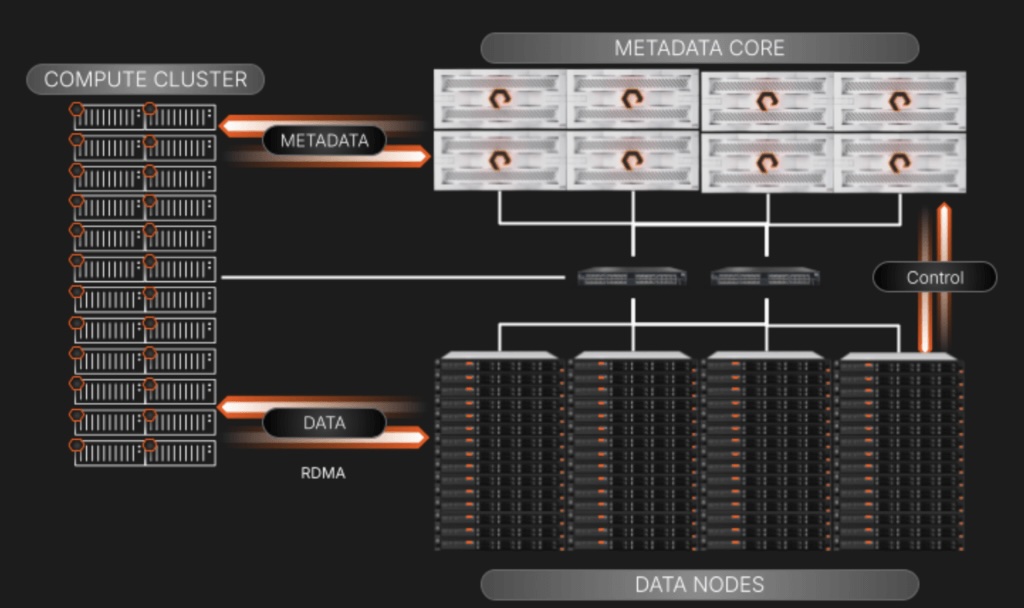
La configurazione presentata da Everpure prevedeva l'abbinamento di 30 blade FlashBlade//EXA (120 moduli DirectFlash per la gestione dei metadati) con 30 nodi dati Linux/NVMe per una capacità utilizzabile di circa 866 TB in un singolo file system, suddividendo i metadati su pNFS/TCP e i dati di massa su NFSv3 su RDMA. Nella simulazione di checkpointing dei parametri a 1.25 T con 1,024 acceleratori client, la configurazione a 30 nodi ha mantenuto una larghezza di banda di scrittura di 877.52 GiB/s in un'operazione di 17.74 secondi, insieme a una larghezza di banda di lettura di 588.28 GiB/s completata in 28.99 secondi. Nel test di inferenza della cache KV, sono stati riportati 85,736 token/sec su un'esecuzione Llama 3.1 da 8 byte con solo storage, 67,642 token/sec su un'esecuzione da 8 byte che combina storage e memoria di sistema e 33,403 token/sec su un'esecuzione da 70 byte con solo storage.
Cosa significano le assenze ingiustificate
Un round di benchmark è la prova di due cose: ciò che i partecipanti sono in grado di fare e ciò che gli assenti hanno scelto di non mostrare. VAST Data, WEKA e DDN, i fornitori che si sono aggiudicati le implementazioni più importanti per neocloud e AI factory, non hanno partecipato alla versione 3.0, così come Huawei, Hammerspace e Lightbits, che avevano partecipato alla versione 2.0. I fornitori saltano i round per motivi banali, cicli di sviluppo, tempistiche di rilascio e dinamiche interne al benchmark; saltare un round non significa che un sistema sia lento. Significa però che i dati verificati e quelli relativi alle implementazioni ora indicano elenchi di fornitori diversi, e gli acquirenti devono valutare entrambi. La nostra pagina "Best Storage Arrays" tiene traccia proprio di questa distinzione, indicando cosa è verificato e cosa è dimostrato dalle implementazioni, ed è stata aggiornata con i risultati completi della versione 3.0.
I risultati della versione 3.0 sono disponibili da oggi sulla pagina del benchmark di storage di MLCommons.



 Amazon