

NVIDIA ha annunciato una nuova GPU per il calcolo scientifico in occasione di SC26. Rubin HPC fa parte della piattaforma Vera Rubin, che integra oltre 50,000 core CUDA su una singola GPU, e NVIDIA prevede che sarà disponibile nel 2028. Il resto delle novità presentate da NVIDIA a SC26 comprende un rack Vera da 192 CPU per simulazioni, previsto per l'inizio del 2027, il pacchetto di modelli aperti Nemotron for Science, nuove librerie CUDA-X, una piattaforma di codesign quantistico con IBM e Fermilab e l'implementazione da parte di Lambda di switch ottici co-confezionati.
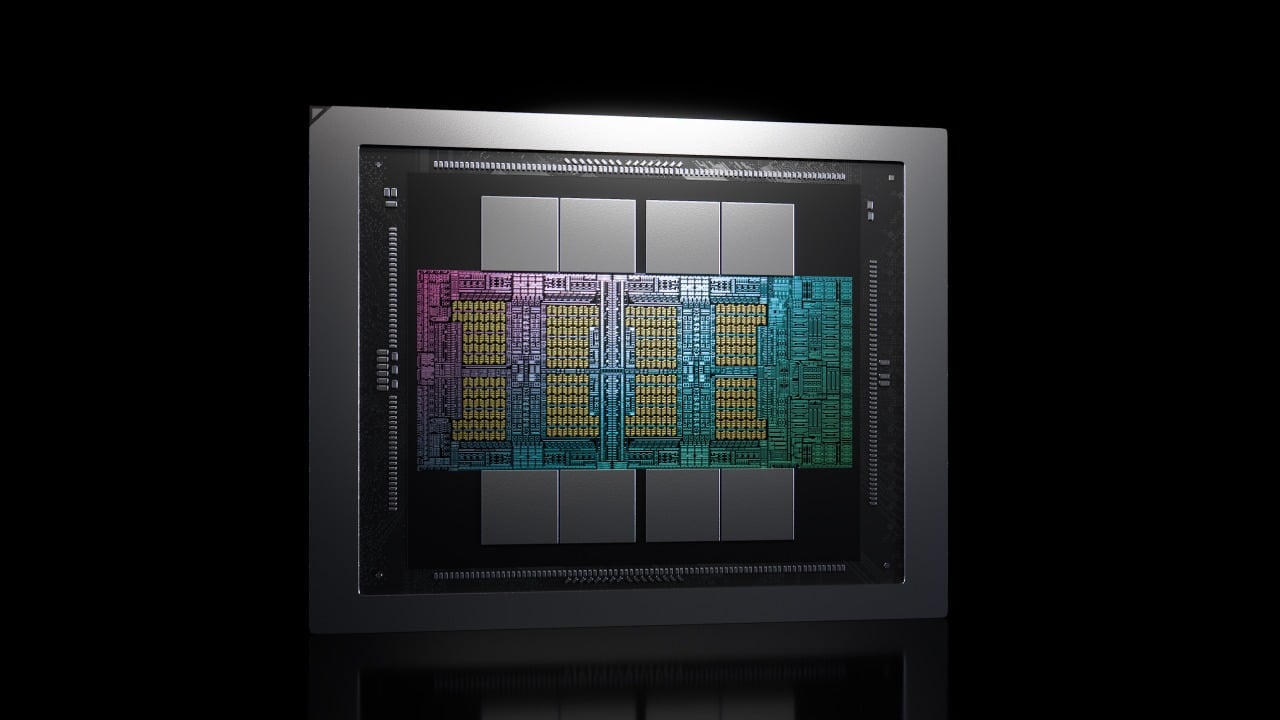
GPU Rubin HPC
NVIDIA descrive Rubin HPC come una GPU per la simulazione e l'elaborazione dati in ambito scientifico, ingegneristico e analitico, progettata per scalare il trasferimento dei dati insieme alla potenza di calcolo. Oltre al numero di core, che NVIDIA definisce un record, l'azienda elenca una capacità di accelerazione dei dati sparsi che alimenta costantemente i core con i dati e i collegamenti GPU-to-GPU tramite NVLink di settima generazione. I carichi di lavoro target includono operazioni su matrici sparse, calcoli stencil, ordinamento e riduzione, modelli climatici, simulazioni ingegneristiche, analisi genomiche e valutazione del rischio finanziario.

Sul palco dell'SC26, NVIDIA ha dichiarato che Rubin HPC triplica le prestazioni di simulazione e analisi e supporta ogni precisione, da FP64 a FP4. L'azienda non ha specificato il valore di riferimento per il triplo, né ha pubblicato dati relativi alla capacità di memoria, al throughput FP64, al consumo energetico o alle configurazioni di sistema. Ian Buck, vicepresidente di hyperscale e high-performance computing di NVIDIA, ha collegato la tecnologia alla ricerca sugli agenti, affermando che "una simulazione più veloce significa una scoperta più rapida" per gli agenti che lavorano su problemi scientifici e ingegneristici. Intel sta proponendo la sua GPU D270 , compatibile con FP64, per gli stessi carichi di lavoro di simulazione presenti alla fiera.
Rack per CPU Vera per HPC
La piattaforma CPU Vera per HPC è un rack NVIDIA MGX raffreddato a liquido che ospita 192 CPU Vera collegate tramite Quantum-X800 InfiniBand, con circa 300 TB di memoria, 1 PB di storage e una larghezza di banda di memoria di picco aggregata superiore a 200 TB/s. Ogni vassoio 1U contiene otto CPU insieme allo storage NVMe e alla gestione, e il rack riutilizza lo chassis, la distribuzione dell'alimentazione e il raffreddamento dei sistemi NVL72. Ogni CPU dispone di 88 core Olympus, 176 thread e memoria SOCAMM2 LPDDR5X con una velocità nominale fino a 1.2 TB/s.

Si tratta di una configurazione diversa dai rack Vera a 256 CPU annunciati da Dell e Supermicro per le sandbox degli agenti al GTC di Berlino, con l'aggiunta di InfiniBand e del calcolo in rete SHARP per simulazioni strettamente accoppiate. NVIDIA afferma che Dell Technologies, HPE, Lenovo e Supermicro offriranno i rack HPC a partire dai primi mesi del 2027. DKRZ, il Centro tedesco per il calcolo climatico, ha scelto le CPU Vera per il suo supercomputer HLRE-5, costruito da Bull, che include anche sistemi GB200 e Quantum-2 InfiniBand e il cui lancio è previsto per i primi mesi del 2028.
NVIDIA dichiara che Vera offre un'efficienza energetica doppia rispetto alle CPU x86. Nei suoi test, Vera ha fornito prestazioni 1.9 volte superiori e un consumo energetico 2.4 volte maggiore rispetto ai sistemi x86 sul case OpenFOAM motorBike Large, e prevede prestazioni 1.6 volte superiori e un'efficienza doppia sul modello Weather Research and Forecasting. Si tratta di risultati forniti dal produttore, che non abbiamo eseguito né verificato, e NVIDIA non ha specificato i processori x86 utilizzati. Nella nostra recensione della CPU Vera , un sistema Vera a due socket ha completato una mesh OpenFOAM di grandi dimensioni 1.44 volte più velocemente di un sistema con EPYC 9965 a 384 core e 1.20 volte più velocemente di un sistema con Xeon 6978P a 240 core.
Sul fronte software, NVIDIA HPC SDK 26.11 è ora disponibile con compilatori e librerie ottimizzati per Vera, e un compilatore Fortran di nuova generazione, sviluppato in collaborazione con centri HPC e laboratori nazionali, è in fase di beta pubblica. NVIDIA afferma che il compilatore esegue i programmi Fortran esistenti più velocemente sulle sue piattaforme senza necessità di riscrivere il codice.
Nemotron per le librerie scientifiche e CUDA-X
Nemotron for Science offre il modello open source Nemotron 3.5 Super VL con valutazioni scientifiche, ricette post-addestramento e LitmusBench v0.2, un dataset open source di quasi 50,000 domande di ragionamento chimico. Il modello e il dataset sono ora disponibili su Hugging Face e NVIDIA afferma che il modello è stato ottimizzato per essere eseguito localmente su un DGX Spark da 128 GB. L'Argonne National Laboratory lo sta integrando nel suo sistema multi-agente StructBioReasoner per terapie a base di proteine e RIKEN lo ha reso disponibile sulla sua piattaforma di supercalcolo AI RIKYU.
Tra i clienti che hanno addestrato il modello, Lila Sciences ha quasi raddoppiato l'accuratezza della sintesi di punti quantici, raggiungendo il 61%, un risultato che, secondo NVIDIA, supera il 54% di GPT-6 Astra con un costo di inferenza da 10 a 20 volte inferiore. Terray Therapeutics ha recuperato circa il 76% delle reazioni annotate nel test RxnScribe per la lettura di diagrammi di reazioni chimiche. Un tecnico del KTH Royal Institute of Technology ha riparato l'81% delle configurazioni di dinamica molecolare GROMACS danneggiate in una singola sessione notturna su un DGX Spark.
Tra le novità di CUDA-X, il toolkit cuPhoton correla le osservazioni dell'Event Horizon Telescope in otto minuti, laddove in precedenza l'analisi richiedeva più di un mese. cuPotential velocizza i software di simulazione molecolare esistenti fino a 3 volte, e Daviator, un insieme di kernel GPU batch per il Vienna Ab initio Simulation Package, esegue calcoli di meccanica quantistica fino a 22 volte più velocemente e con un costo inferiore fino al 75%. NVIDIA non ha specificato i valori di riferimento per cuPotential e Daviator.
cuSpa e una libreria HMMER accelerata da GPU sono ora open source. cuSpa ha fornito un'accelerazione di 900 volte rispetto alle CPU nei calcoli dei poligoni cellulari presso il Memorial Sloan Kettering Cancer Center, e la libreria HMMER ha eseguito ricerche di benchmark fino a 84 volte più velocemente rispetto all'HMMER standard presso Basecamp Research. La libreria rapids-singlecell, sviluppata in collaborazione con scverse, è ora disponibile in un singolo container progettato per gli agenti e 10x Genomics l'ha integrata nella sua piattaforma Sentira.
Progettazione quantistica congiunta con IBM e Fermilab
Nel campo della fisica quantistica, NVIDIA e IBM stanno collocando in co-locazione sistemi NVIDIA DGX B200 insieme a computer quantistici IBM, inclusi sistemi che utilizzano il processore IBM Quantum Nighthawk, per supportare una piattaforma modulare di co-progettazione quantistica sviluppata con Fermilab. I ricercatori la utilizzeranno per valutare codici di correzione degli errori, algoritmi di decodifica e applicazioni quantistiche-classiche per la fisica delle alte energie e nucleare. IBM ha stipulato un accordo simile con AMD e l'Oak Ridge National Laboratory , abbinando Nighthawk a un cluster Instinct MI355X. NVIDIA non ha fornito dati sul numero di sistemi, sulla loro ubicazione o sulla tempistica.
Separatamente, NVIDIA ha rilasciato TCBP-JOBS, un algoritmo di decodifica nella libreria CUDA-Q QEC 0.9.0 che, a detta dell'azienda, decodifica fino a 13,000 volte più velocemente rispetto ai principali algoritmi esistenti e riduce i tempi di calcolo per la progettazione di nuovi computer quantistici da 12 settimane a 45 minuti. La piattaforma CUDA-Q si arricchisce inoltre di un server di decodifica, un set ampliato di primitive tolleranti ai guasti, una libreria di algoritmi CUDA-Q con componenti applicativi riutilizzabili e CUDA-Q Pulse per la modellazione degli impulsi di controllo che pilotano i qubit.
Secondo NVIDIA, le implementazioni di processori quantistici nei centri di supercalcolo sono cresciute di quasi sette volte in cinque anni, con quasi 30 centri che ora utilizzano più di 50 processori. Slurm 26.11, previsto per la fine di novembre, aggiunge un'interfaccia quantistica che consente a chi sviluppa QPU di descrivere il proprio hardware una sola volta, in un singolo file, e di riutilizzare tale integrazione in ogni centro. Supporta le interfacce quantum-HPC QRMI e QDMI, con il contributo di IBM tramite la sua Quantum Resource Management Interface, in modo che i centri possano pianificare i processori quantistici insieme a CPU e GPU. Alice & Bob, IBM, IQM, Pasqal, Quantinuum e MQSC lo stanno adottando e NVIDIA ha acquisito SchedMD, lo sviluppatore di Slurm, alla fine del 2025.
NVIDIA ha inoltre citato il lavoro di chimica quantistica-classica svolto da IBM e RIKEN, finalista per il premio ACM Gordon Bell 2026, che ha calcolato le energie di legame per complessi proteina-ligando fino a 12,635 atomi. Si tratta di un valore oltre 40 volte superiore al precedente benchmark quantistico-classico di 303 atomi. La parte classica del calcolo è stata eseguita sul supercomputer ROQUO di RIKEN, basato su sistemi NVIDIA GB200 e Quantum-X800 InfiniBand.
Tra i progetti dell'ecosistema sulla piattaforma, Altera e Oxford Quantum Circuits hanno realizzato un controller quantistico basato su FPGA che collega il controllo e la lettura dei qubit alle GPU tramite NVQLink, mentre Quantum Motion ha integrato il suo framework di chimica QUICHE con CUDA-Q. QunaSys ha utilizzato cuQuantum e 1,024 GPU NVIDIA di generazione Hopper su ABCI-Q per simulare oltre 300 milioni di operazioni quantistiche, raggiungendo l'accuratezza chimica per un modello a quattro atomi di idrogeno. I ricercatori di NVIDIA hanno utilizzato il supercomputer JUPITER per simulare 104 qubit in condizioni di rumore realistiche.
Lambda implementa ottiche co-confezionate
Lambda utilizza switch con ottiche co-confezionate (CPO) di NVIDIA Photonics per connettere rack GB300 NVL72 in un'implementazione con oltre 10,000 GPU. Ogni switch dispone di 144 porte a 800 Gb/s e 18 sorgenti luminose esterne che i tecnici possono sostituire sul campo, laddove un laser guasto in un'ottica pluggable richiede la sostituzione dell'intero modulo. I test citati da NVIDIA hanno mostrato una latenza di rete inferiore di circa il 4% a livello di rack e fino al 10% a livello di pod, con la stessa velocità di trasmissione delle ottiche pluggable.

La temperatura media delle ottiche nell'implementazione è stata di 36 °C, contro i 51 °C delle ottiche plug-in convenzionali. NVIDIA dichiara che i suoi switch fotonici offrono un'efficienza energetica fino a 5 volte superiore, un'affidabilità fino a 15 volte maggiore e un numero di laser 4 volte inferiore rispetto ai design plug-in. NVIDIA ha inoltre sfruttato la fiera per celebrare i 20 anni di CUDA, che, a detta dell'azienda, conta ora oltre 11 milioni di sviluppatori e più di 1,000 librerie CUDA-X.


 Amazon