

Storicamente, ogni operazione di lettura effettuata da una GPU attraversava la CPU host, che gestiva il file system, inviava i comandi e restituiva i dati. Questo overhead è trascurabile per trasferimenti sequenziali di grandi dimensioni, ma diventa un fattore limitante quando si gestiscono milioni di operazioni da 512 byte al secondo. Alla conferenza FMS 2026 di Santa Clara, NVIDIA ha annunciato un nuovo software e un'iniziativa di settore per eliminare questo collo di bottiglia.
L'annuncio principale riguarda cuFile, un'API che consente alle GPU di leggere e scrivere direttamente sui dispositivi di archiviazione. NVIDIA ha reso open source cuFile e l'intero stack software di supporto, con il codice ospitato nella nuova organizzazione XIO-SIG su GitHub. Tra i fondatori e manutentori figurano Google, Intel, Meta e NVIDIA. Inoltre, NVIDIA ha lanciato ufficialmente Storage-Next, un'iniziativa di cui si discute pubblicamente almeno dal GTC 2025. Storage-Next include ora oltre 40 fornitori di storage e memorie flash, come DDN, KIOXIA e Micron, nonché produttori di controller, specialisti del raffreddamento e organizzazioni di standardizzazione. Questi partecipanti stanno definendo in modo collaborativo il comportamento dei dispositivi di storage quando una GPU, anziché una CPU, funge da client.
Il problema: I/O mediato dall'host
I sistemi GPU hanno tradizionalmente operato secondo un modello I/O incentrato sull'host. La CPU pianifica le attività della GPU, prepara i dati e avvia tutti i trasferimenti tra la GPU e la rete o lo storage. Ogni operazione segue una sequenza: il kernel della GPU viene completato, il controllo ritorna alla CPU, la CPU imposta il trasferimento e viene avviato il kernel successivo. Il costo per operazione, principalmente dovuto all'avvio del kernel e al sovraccarico di sincronizzazione CPU-GPU, si misura in microsecondi. Sebbene trascurabile per i trasferimenti di grandi quantità di dati, questo sovraccarico diventa significativo per le operazioni a grana fine.
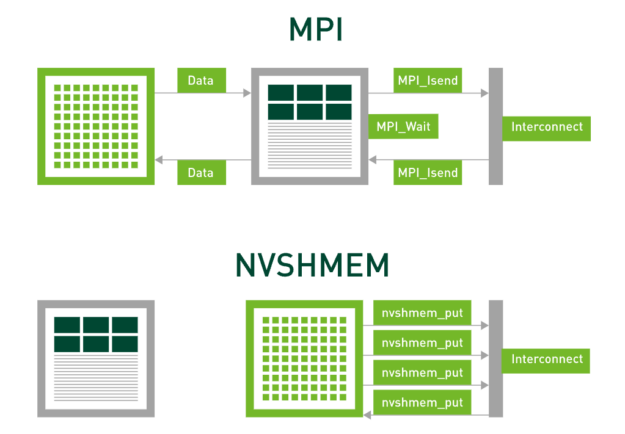
Per la comunicazione tra GPU, NVIDIA ha eliminato il coinvolgimento dell'host tramite NVSHMEM, che consente al codice del dispositivo di avviare direttamente i trasferimenti e di sovrapporli all'elaborazione. L'impatto è sostanziale: quando GROMACS ha migrato la sua comunicazione di scambio di risorse da MPI a NVSHMEM, la comunicazione è stata rimossa dal percorso critico ed è diventata completamente sovrapponibile all'elaborazione.
L'archiviazione ha mantenuto il modello mediato dall'host. Una lettura da un'unità NVMe restituisce comunque il controllo alla CPU, esegue il file system e attende il completamento. L'addestramento tollera questo comportamento perché le sue letture sono di grandi dimensioni e poco frequenti. L'inferenza no. La gestione delle voci della cache KV, degli embedding e dei risultati della ricerca vettoriale genera milioni di piccole letture casuali al secondo, con la CPU nel percorso di ognuna di esse.
I/O e SCADA avviati dalla GPU
SCADA (accesso ai dati scalabile e accelerato) applica il modello NVSHMEM allo storage, consentendo alla GPU di avviare e gestire le proprie operazioni di I/O di storage.
La ricerca alla base di questo studio è BaM, o Big Accelerator Memory, presentata all'ASPLOS 2023 da NVIDIA, IBM, l'Università dell'Illinois e l'Università di Buffalo. BaM ha dimostrato che una GPU è in grado di gestire direttamente le unità NVMe, aggregando e memorizzando nella cache le piccole richieste generate dai suoi thread per sostenere code di richieste che saturano le unità, senza l'intervento dell'host. Su hardware identico, BaM ha eseguito carichi di lavoro di analisi dati 5.3 volte più velocemente rispetto all'accesso avviato dalla CPU e ha eseguito carichi di lavoro grafici da memoria flash con un costo hardware fino a 21.7 volte inferiore rispetto all'archiviazione degli stessi dati nella memoria host.
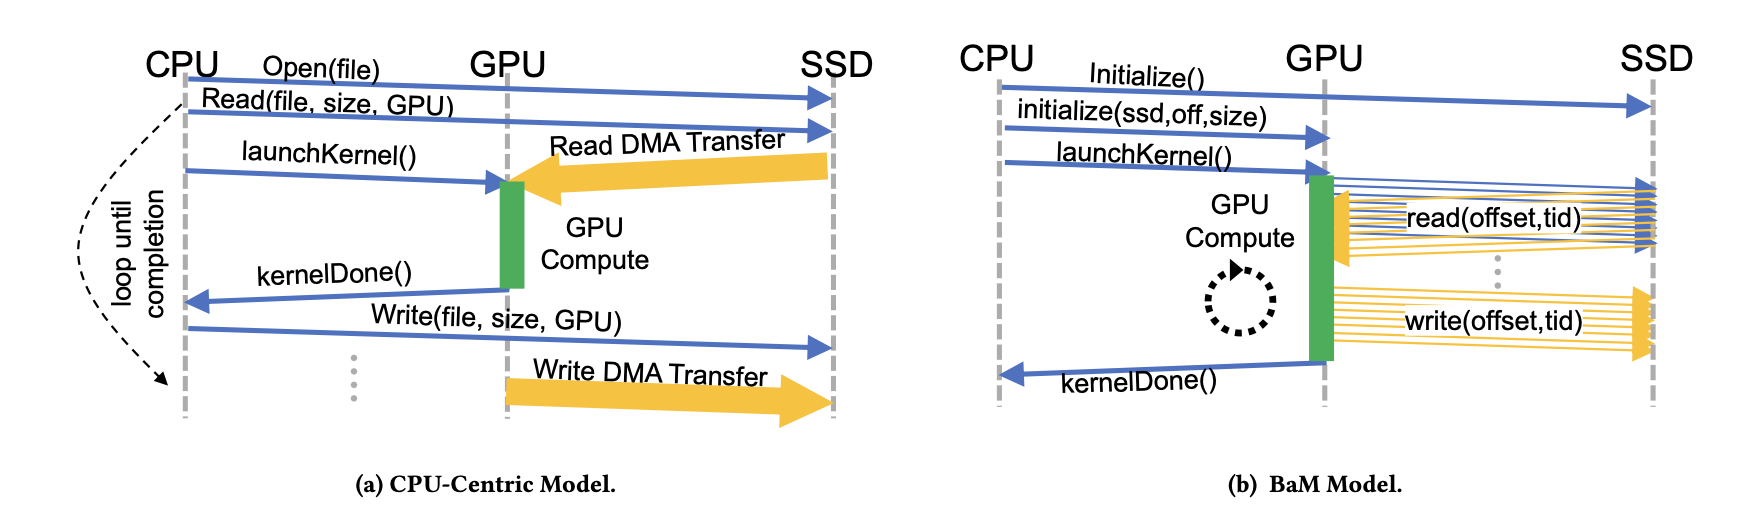
SCADA è la sua forma commercializzata. Un runtime sulla GPU si interpone tra i thread del kernel e la memoria di archiviazione. Aggrega piccole richieste sparse in letture gestite da una cache sulla GPU o indirizzate a unità di archiviazione, che possono essere NVMe locali o server di archiviazione remoti.
L'accesso diretto al dispositivo deve essere controllato, poiché l'accesso diretto a un'unità condivisa potrebbe consentire a un'applicazione di leggere o danneggiare i dati di un'altra. La progettazione di NVIDIA separa i livelli di privilegio. Le parti di un'applicazione critiche per le prestazioni vengono eseguite senza privilegi, al di fuori della base di calcolo affidabile. Un componente privilegiato configura l'accesso protetto tra ciascuna applicazione e solo la memoria approvata in fase di installazione, utilizzando i meccanismi di sicurezza standard di Linux. NVIDIA cita questa separazione e l'interoperabilità basata su Linux come motivo per cui lo stack è rilasciato come open source anziché come componente CUDA proprietario.
In che modo SCADA si differenzia da GPUDirect Storage?
Ogni operazione di archiviazione ha un percorso dati (i byte trasferiti) e un percorso di controllo (costruzione, invio e gestione del completamento della richiesta). GPUDirect Storage (GDS), introdotto nel 2019 e disponibile dal 2021, ha rimosso la CPU dal percorso dati: tramite cuFile, i dati vengono trasferiti tramite DMA tra l'unità e la memoria GPU senza alcun buffer di rimbalzo nella RAM host. I materiali di lancio di NVIDIA indicavano un limite massimo di 50 GB/s per il percorso CPU su un DGX-2, con GDS in grado di combinare i percorsi per raggiungere un limite massimo di quasi 200 GB/s, e DDN, VAST, WEKA, Pure Storage e gli altri principali fornitori di storage AI lo hanno certificato. Il percorso di controllo è rimasto sulla CPU: il software host decide ancora cosa recuperare ed emette ogni richiesta, e la GPU è il target DMA anziché l'iniziatore.
Con trasferimenti di grandi dimensioni, questa suddivisione va bene. Una lettura da 1 MB ammortizza il costo del percorso di controllo fino a renderlo nullo. A 512 byte, il rapporto si inverte. Il costo fisso per richiesta diventa dominante e la CPU si satura ben prima delle unità. Il sistema SCADA sposta il percorso di controllo sulla GPU, che assorbe la latenza per operazione nello stesso modo in cui assorbe la latenza della memoria, mantenendo in corso centinaia di migliaia di operazioni.
I due sistemi coesistono: cuFile per i trasferimenti di grandi quantità di dati, SCADA per volumi elevati di piccole letture casuali.
Storage-Next e il problema dei 512 byte
SCADA si occupa del lato GPU. Storage-Next si occupa del lato unità, che al momento è ottimizzato per un carico di lavoro diverso.
Da un decennio, gli SSD aziendali sono ottimizzati per letture casuali da 4 KB, in linea con i modelli di accesso ai database e alla virtualizzazione. La maggior parte dei controller esegue all'incirca lo stesso lavoro per gestire una lettura da 512 byte e una da 4 KB, quindi le richieste inferiori a 4 KB vengono eseguite con le stesse prestazioni di quelle da 4 KB. I modelli di accesso per l'inferenza sono più piccoli: gli embedding occupano poche centinaia di byte e i blocchi della cache KV sono ben al di sotto di un kilobyte. Gestirli da unità ottimizzate per 4 KB impone un'amplificazione di lettura di 8 volte, sprecando larghezza di banda e cache del controller. Con decine di terabyte di piccoli oggetti, tale amplificazione determina se la memoria flash è una soluzione praticabile come livello di memoria.
Storage-Next è l'iniziativa volta a riprogettare unità, controller e sistemi attorno a unità di dimensioni ridotte. È stata presentata pubblicamente al GTC 2025, già in corso, con l'obiettivo dichiarato di massimizzare le IOPS a 512 byte per GPU, nel rispetto dei vincoli di potenza e latenza di coda. Al FMS, NVIDIA ha annunciato un numero di adesione, oltre 40 fornitori di storage e memorie flash, e ha indicato SCADA come framework di riferimento.
Il risultato di riferimento è la dimostrazione SC25 di Micron di 230 milioni di IOPS in lettura casuale da 512 byte da un singolo server secondo il modello di programmazione SCADA: 44 SSD Micron 9650 PCIe Gen6 dietro tre switch Broadcom PEX90000 Gen6, gestiti da tre H100 in uno chassis Falcon 6048 con piattaforma H3. La cifra corrisponde a circa il 95% della potenza nominale combinata di 5.5 milioni di IOPS delle 44 unità.
La composizione di quel numero è fondamentale. 230 milioni di letture da 512 byte equivalgono a circa 118 GB/s di carico utile, che quattro o cinque di quelle unità potrebbero erogare in sequenza. Il risultato sta nel numero di operazioni. Sostenerlo tramite il software host consumerebbe decine di core della CPU solo per la gestione dell'invio e del completamento, eppure la singola CPU della demo era sostanzialmente inattiva. Distribuito sugli oltre centomila thread di una GPU, il carico si riduce a poche migliaia di operazioni per thread al secondo.
La capacità degli SSD è ora il fattore determinante. Il Micron 9650, il primo SSD PCIe Gen6, vanta una velocità sequenziale di 28 GB/s e un record di 5.5 milioni di IOPS in lettura casuale. Micron dichiara una scalabilità lineare da 1 a 44 unità nella demo. La serie GP di Kioxia, un SSD XL-Flash progettato per accessi a 512 byte , è in fase di sviluppo nell'ambito di Storage-Next. La roadmap Storage-Next di NVIDIA prevede SSD PCIe Gen7 in grado di supportare 100 milioni di IOPS ciascuno, un obiettivo verso cui i produttori di controller, tra cui Marvell, stanno ora puntando. Raggiungere questi numeri richiede una riprogettazione del controller, una correzione degli errori dimensionata per payload ridotti e standard che definiscano il comportamento nativo delle unità per le GPU.
Mappatura per l'addestramento e l'inferenza
I due percorsi corrispondono a due modelli di accesso. L'addestramento è limitato dalla larghezza di banda. Trasmette in streaming grandi frammenti sequenziali e scrive periodicamente checkpoint multi-terabyte durante i quali le GPU rimangono inattive. Il sovraccarico della CPU è trascurabile a queste dimensioni di trasferimento, quindi GDS e il nuovo stack cuFile open source rimangono l'interfaccia corretta, misurata in GB/s per GPU e durata del checkpoint.
L'inferenza è limitata dagli IOPS. La cache KV, ovvero lo stato di attenzione per ogni token già elaborato in una conversazione, cresce con la lunghezza del contesto. Le implementazioni basate su agenti gestiscono migliaia di conversazioni simultanee. La memoria della GPU viene rapidamente superata e il ricalcolo delle voci eliminate richiede più tempo GPU rispetto alla loro lettura. Il design standard prevede una cache a livelli che si espande dalla memoria della GPU alla memoria di sistema e alla memoria flash, riempita tramite un elevato volume di piccole letture casuali. La ricerca vettoriale e le ricerche di embedding producono lo stesso schema. Questa è la struttura di accesso a cui puntano i sistemi SCADA e il motivo per cui NVIDIA indica IOPS a 512 byte anziché la larghezza di banda. Servire la cache KV dalla memoria flash anziché dalla memoria RAM aumenta il numero di contesti e utenti simultanei supportati da ciascuna GPU, il che determina il costo di servizio per utente.
Hardware: Vera BlueField-4 STX e CMX
La piattaforma di base è NVIDIA Vera BlueField-4 STX , l'architettura di storage su scala rack presentata al GTC 2026 e ampliata questa settimana. STX combina la piattaforma Vera Rubin con i processori di storage BlueField-4, ciascuno dei quali unisce core Vera Arm a 800 Gb/s di rete integrata e circa 6 volte la potenza di calcolo di BlueField-3.
Al FMS, NVIDIA ha pubblicato un benchmark per questi core. Una pipeline di compressione e crittografia a due stadi, rappresentativa dei sistemi di storage per servizi dati inline applicati a tutto il traffico, ha raggiunto una velocità di trasmissione fino a 3.21 volte superiore a quella di una CPU x86 su Vera. L'affermazione implicita è che la crittografia, la compressione e la verifica, che attualmente consumano core x86 nei controller di storage, possono essere spostate sul silicio Vera con un consumo energetico inferiore. DOCA, il framework software di NVIDIA per BlueField, applica le policy di sicurezza nel percorso dati. CMX Context Memory Storage , basato su STX, raggruppa la memoria flash dietro BlueField-4 come livello di cache KV condiviso per l'inferenza di contesto a lungo termine. I sistemi dei partner di DDN, Dell, HPE, IBM, VAST Data, WEKA e altri sono previsti per la seconda metà del 2026.
Pensieri di chiusura
La struttura strategica è chiara: NVIDIA sta pubblicando l'interfaccia che le GPU utilizzeranno per accedere allo storage, rendendo open source l'implementazione e organizzando oltre 40 fornitori per standardizzare il comportamento hardware sottostante. L'apertura di cuFile si discosta dalla prassi di NVIDIA di mantenere questo livello all'interno di CUDA. Tuttavia, un'interfaccia di storage avviata dalla GPU è vantaggiosa solo se i fornitori di unità, controller e array la utilizzano. L'adesione di Intel come manutentore è un segnale significativo. Un fornitore leader di chip x86 negli attuali sistemi di storage sta supportando un software progettato per rimuovere tali chip dal percorso di I/O.
La dimostrazione di Micron ne stabilisce la fattibilità. Tre GPU hanno spinto 44 unità Gen6 a circa il 95% del loro limite nominale combinato, con una dimensione di blocco che il settore ha finora considerato un aspetto secondario. Ciò che resta da fare è l'implementazione: il codice deve essere pubblicato su GitHub, i sistemi SCADA devono maturare da framework a componenti CUDA supportati e i produttori devono commercializzare in massa SSD ottimizzati per le operazioni di lettura di piccole dimensioni. I dati sopra riportati provengono da NVIDIA e dai suoi partner, non da misurazioni indipendenti. Li testeremo quando i sistemi STX arriveranno in laboratorio nella seconda metà dell'anno.


 Amazon