

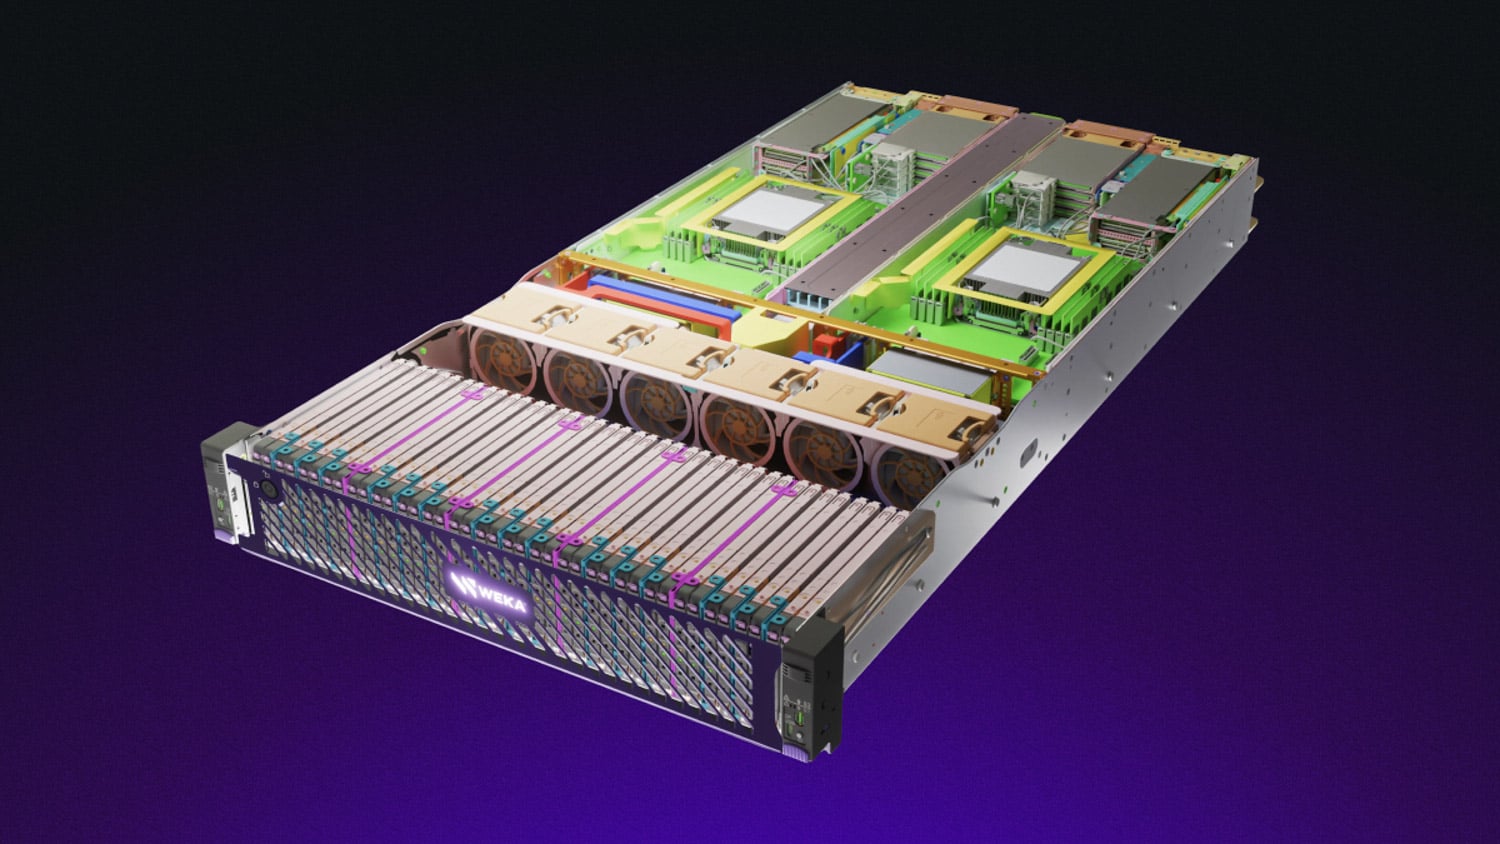
WEKA ha lanciato due prodotti interconnessi: NeuralMesh 6, la sua release software più significativa fino ad oggi, e WEKApod 3, una nuova generazione di appliance di storage progettate e realizzate da WEKA per eseguirlo. NeuralMesh 6 rimane implementabile su hardware scelto dal cliente, mentre WEKApod offre una soluzione chiavi in mano, con il software preinstallato. NeuralMesh 6 introduce il multi-tenancy nativo, uno stack di protocolli combinato file-oggetto, la mobilità dei dati basata sui metadati, la riduzione dei dati always-on con garanzie contrattuali, operazioni native di Kubernetes e osservabilità integrata. WEKApod 3 è un hardware progettato su misura per eseguire questo software con quella che l'azienda definisce la massima densità di capacità e prestazioni disponibile in un singolo rack, con tre configurazioni, Nitro, Prime e Prime Max, pensate rispettivamente per massime prestazioni, capacità bilanciata e massima densità.
Entrambi gli annunci inquadrano il rilascio attorno a un cambiamento comune del mercato: con il passaggio dei carichi di lavoro di IA dall'addestramento all'inferenza basata su contesti lunghi, agenti e recupero su scala di produzione, l'infrastruttura di archiviazione e memoria, e non solo il numero di GPU, determina sempre più il costo per token e la velocità di trasmissione raggiungibile.
NeuralMesh 6: Multi-tenancy, protocolli unificati e mobilità dei dati
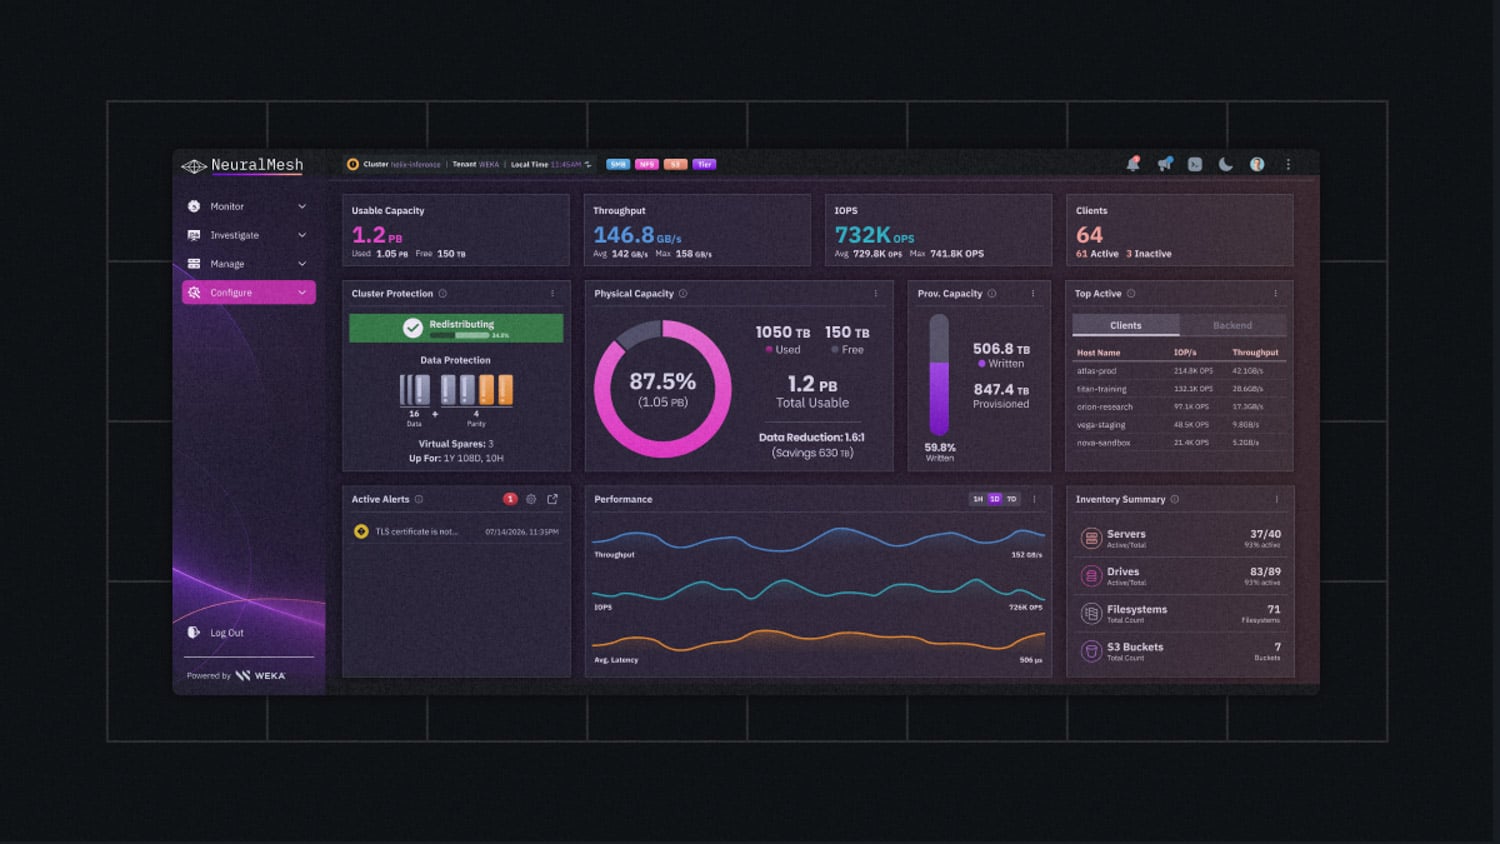
NeuralMesh 6 combina funzionalità che, secondo WEKA, gli operatori di infrastrutture AI hanno tradizionalmente dovuto assemblare da diversi fornitori: multi-tenancy, uno stack di protocolli unificato per file e oggetti, mobilità dei dati tra siti, riduzione continua dei dati, gestione nativa di Kubernetes e osservabilità integrata, il tutto integrato in un unico stack software anziché assemblato da parti separate.
La multi-tenancy è suddivisa in due livelli combinabili. I cluster componibili offrono isolamento a livello hardware, con CPU, memoria e unità di archiviazione dedicate per ogni tenant, pensati per i tenant principali che necessitano di risorse garantite e prestazioni prevedibili. La multi-tenancy virtuale aggiunge isolamento di rete in stile VPC tramite la Virtualized RDMA Data Fabric di WEKA, supportando VLAN private, spazi di indirizzi IP sovrapposti, qualità del servizio e crittografia per ogni tenant con gestione indipendente delle chiavi e autenticazione LDAP o Active Directory indipendente per ogni tenant. La multi-tenancy virtuale è scalabile fino a oltre 1,000 tenant logici isolati per cluster, con provisioning di nuovi tenant in meno di 30 minuti. I due livelli sono componibili, pertanto un singolo cluster hardware WEKA con 50 cluster componibili può supportare fino a 50,000 tenant logicamente isolati sulla stessa infrastruttura fisica, consentendo una crescita da poche decine a decine di migliaia di tenant senza dover riprogettare il sistema.
Dal punto di vista del protocollo, NeuralMesh 6 implementa uno stack S3 nativo in cui gli stessi blocchi di dati fisici sono indirizzabili simultaneamente tramite S3 e POSIX, anziché tramite un gateway che funge da traduttore. Un file scritto tramite NFS o POSIX è immediatamente leggibile da S3 e viceversa, eliminando le copie duplicate dell'intero dataset che in genere si accumulano durante il passaggio dei dati tra le fasi di training, fine-tuning e inferenza. WEKA ha sviluppato l'implementazione S3 specificamente per i modelli di accesso dell'IA, supportando da 2,000 a 5,000 connessioni S3 simultanee per nodo, circa cinque volte la concorrenza delle architetture S3 convenzionali, con S3 su RDMA che consente il trasferimento senza copia direttamente nella memoria della GPU.
La mobilità dei dati viene gestita tramite la replica basata sui metadati, rendendo l'ambiente di destinazione immediatamente accessibile, senza richiedere una copia completa dei dati prima dell'avvio di un carico di lavoro. I dati vengono caricati su richiesta, riducendo il traffico WAN e consentendo alle organizzazioni di posizionare i carichi di lavoro ovunque sia disponibile capacità GPU, anziché nella posizione in cui i dati sono stati originariamente scritti. Questa versione introduce la replica asincrona e la memorizzazione nella cache remota come primo passo verso una federazione più ampia e uno spazio dei nomi globale tra siti e cloud.
Questa capacità di replica è già alla base di implementazioni reali: Sam Tabar, CEO di WhiteFiber, ha affermato che la replica intelligente di NeuralMesh consente all'azienda di rendere i set di dati visibili tra i siti e di prelevare esattamente i dati necessari a ciascun job per l'allocazione GPU successiva, la stessa architettura alla base di Project Redwood , il supercluster inter-datacenter da 111.2 Tbps di cui abbiamo parlato all'inizio di questo mese.
Riduzione dei dati con un risparmio di capacità fino a 6 volte superiore.
NeuralMesh 6 abilita anche la riduzione dei dati, inclusi fingerprinting, hashing di similarità, deduplicazione e compressione, di default in ogni implementazione, con un overhead di scrittura inferiore al 5%, un risparmio di capacità fino a 6 volte superiore sui dati di training dell'IA e una garanzia contrattuale che copre sia il rapporto di riduzione che l'impatto sulle prestazioni. Un nuovo Kubernetes Operator automatizza l'implementazione del cluster e la gestione del ciclo di vita per le organizzazioni che utilizzano Kubernetes come modello operativo standard, riducendo, secondo WEKA, i tempi di implementazione da settimane a ore. NeuralMesh Observe, incluso senza costi aggiuntivi in ogni implementazione, fornisce dashboard multi-cluster basate su SaaS, diagnostica a livello client e avvisi instradati a Slack, PagerDuty o e-mail.
WEKA riferisce di utilizzare in produzione la sua funzionalità Augmented Memory Grid , che espande la memoria GPU velocizzando l'accesso alla cache KV persistente allo storage NVMe gestito da NeuralMesh su Oracle Cloud Infrastructure. I benchmark sull'infrastruttura OCI H100 hanno dimostrato un throughput dei token 10 volte superiore, 10 volte più utenti simultanei serviti e 7 volte più token per GPU, risultati che, secondo WEKA, sono stati misurati rispetto alle alternative basate su DRAM. Pablo Selem, direttore senior dello sviluppo software presso OCI, ha descritto l'approccio come un modo per eliminare i colli di bottiglia della memoria, consentendo ai clienti di ottenere un throughput maggiore e più utenti dalla stessa infrastruttura GPU.
WEKApod 3: Hardware personalizzato progettato attorno al software
WEKApod 3 è un progetto hardware proprietario di WEKA, non un'architettura di riferimento basata su chassis OEM di terze parti. L'azienda afferma che un singolo rack WEKApod offre 1.1 exabyte di capacità effettiva su una base hardware di 441.5 PB di capacità grezza, diventando così il primo sistema a singolo rack a superare un exabyte di capacità effettiva. Il throughput per rack è pari a 10.2 TB/s con 210 milioni di IOPS. WEKA dichiara una densità di capacità effettiva superiore del 267% e una densità di throughput per unità rack superiore del 114% rispetto alla migliore alternativa disponibile sul mercato in ciascuna categoria.
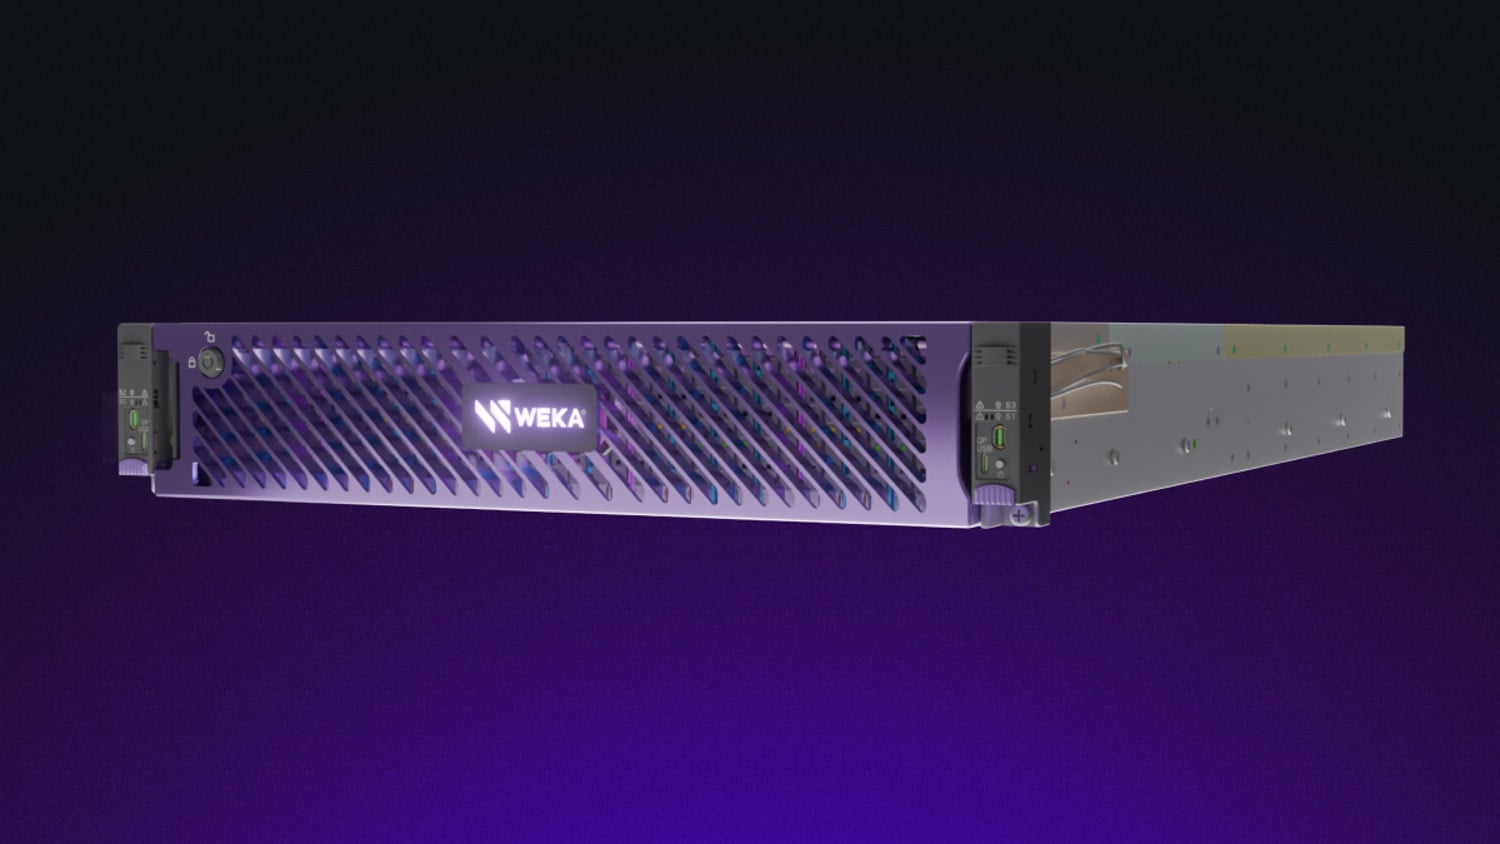
Il design si basa su un'architettura interna PCIe Gen 6, un'interconnessione delle unità tramite cavo anziché un backplane, la rete NVIDIA ConnectX SuperNIC per la connettività Ethernet Spectrum-X e un'architettura termica gestita via software, progettata per funzionare a temperature ambiente di 35 °C, che limita la potenza degli NVMe in caso di stress termico anziché spegnerli. WEKA ha depositato diversi brevetti relativi al telaio, all'interconnessione delle unità, alla gestione termica e al design per la manutenzione. Tra le funzionalità di manutenzione figurano unità di avvio hot-plug con una procedura di sostituzione guidata da interfaccia grafica che, secondo WEKA, richiede circa 10 minuti anziché diverse ore di manutenzione, oltre alla distribuzione su scala rack senza interfaccia grafica e basata su cloud tramite NeuralMesh Home.
Tre configurazioni per diverse priorità di carico di lavoro
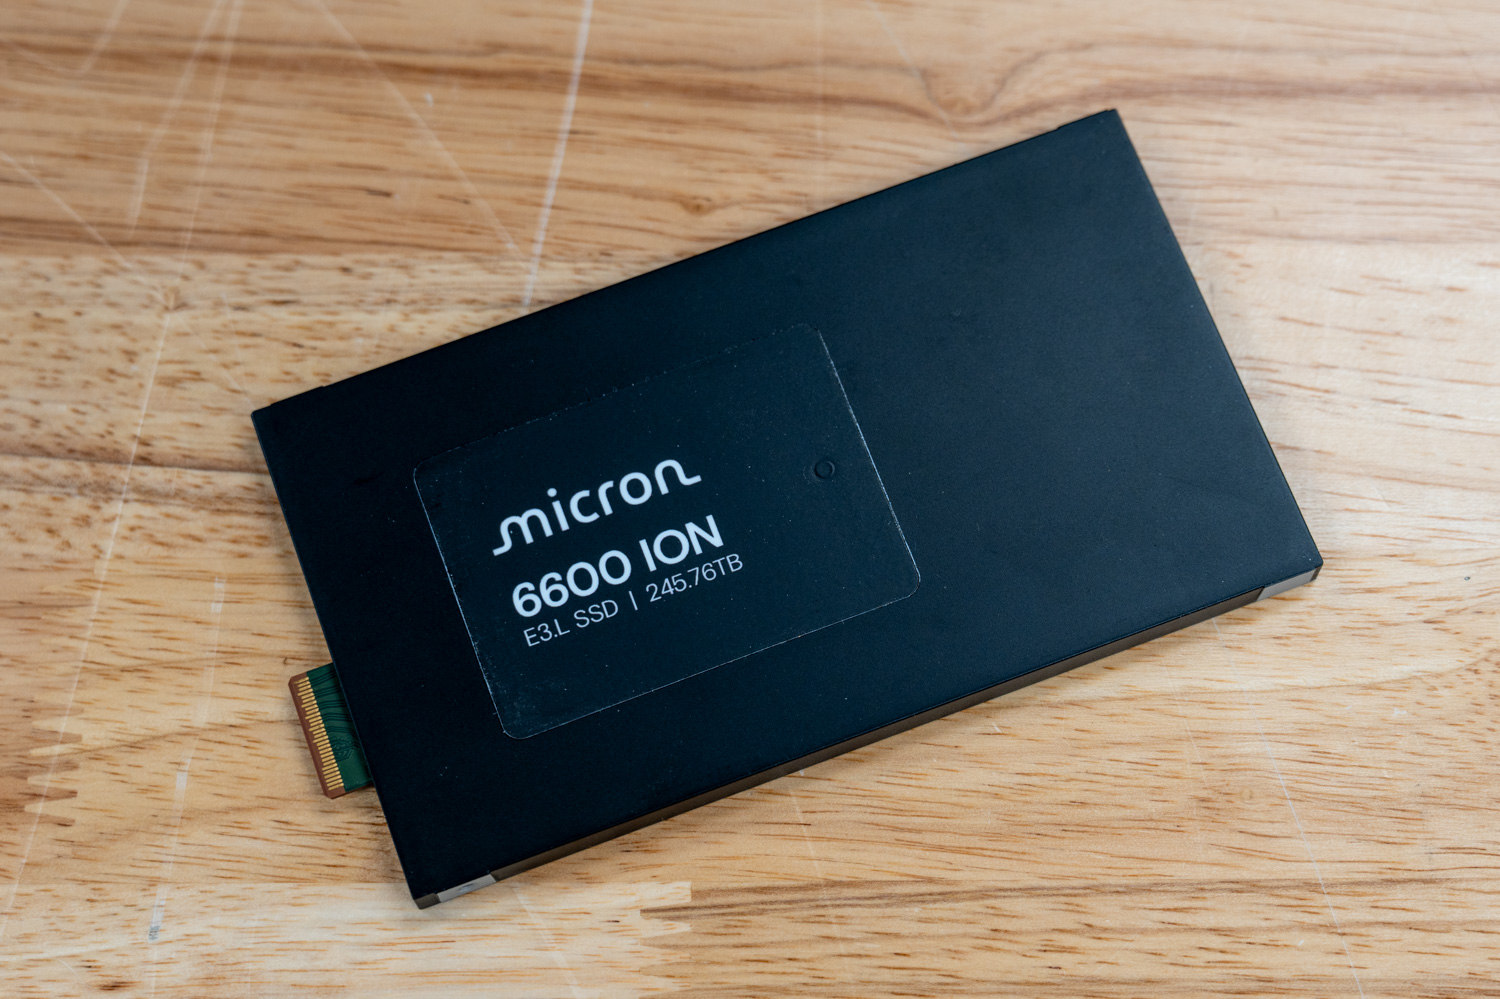
WEKApod Nitro è progettato per carichi di lavoro in cui la larghezza di banda di archiviazione è fondamentale, garantendo che le GPU rimangano sature. È dotato di uno chassis a due unità rack e quattro nodi con quattro domini di errore indipendenti e 56 unità TLC, supportato dalla rete NVIDIA ConnectX a doppia porta che offre una velocità di trasmissione di 800 Gb/s. WEKApod Prime privilegia un equilibrio tra capacità e prestazioni con una combinazione AlloyFlash di unità TLC e QLC, alloggiata in uno chassis simile a quattro nodi e due unità rack che supporta 56 unità. WEKApod Prime Max massimizza la capacità in un formato compatto: uno chassis a due unità rack e due nodi contenente 70 unità NVMe, utilizzando SSD Micron 6600 ION da 245.76 TB , combinati con le tecniche di archiviazione a oggetti e riduzione dei dati di NeuralMesh, per raggiungere una capacità effettiva di 1.1 exabyte in un singolo rack 56U. Per capire l'impatto di questa unità sui calcoli di spazio nei rack, il nostro report su potenza e densità del 6600 ION calcola un exabyte in sei rack anziché in 22.
AlloyFlash, la funzionalità di tiering che rende utilizzabili le configurazioni Prime e Prime Max, instrada automaticamente le operazioni sensibili alla latenza verso la memoria flash TLC, indirizzando al contempo i dati ad alta capacità verso la QLC, che risulta circa il 30-40% più economica per terabyte, senza richiedere alcuna configurazione da parte dell'utente. Questo è il punto cruciale in cui la versione software NeuralMesh 6 e la versione hardware WEKApod 3 si fondono in un unico prodotto: la logica di tiering del software rende le configurazioni hardware ad alta densità utilizzabili a livelli di prestazioni di produzione, anziché limitarsi a un valore di capacità maggiore sulla scheda tecnica.
WEKA basa le sue decisioni in materia di hardware sui vincoli attuali dei data center: la costruzione di data center negli Stati Uniti è diminuita nel 2025 per la prima volta dal 2020, le code per la connessione alla rete elettrica nei principali mercati ora richiedono dai quattro ai sette anni e Morgan Stanley prevede un deficit di energia di 49 gigawatt negli Stati Uniti entro il 2028. A ciò si aggiungono i continui problemi di approvvigionamento di memorie NAND e i tempi di consegna più lunghi degli OEM. WEKA sostiene che lo storage inefficiente in termini di spazio rack e consumo energetico compete direttamente con le GPU per le limitate risorse fisiche. Gestendo la propria catena di fornitura hardware anziché affidarsi ai canali OEM, ritiene di poter offrire prezzi e tempi di consegna più prevedibili ai clienti che pianificano progetti infrastrutturali su larga scala.
Jason Hardy, vicepresidente della tecnologia di storage di NVIDIA, ha affermato che la rete Ethernet Spectrum-X fornisce a WEKApod 3 l'infrastruttura ad alta larghezza di banda e bassa latenza necessaria per mantenere libero il percorso dati dallo storage alla GPU su larga scala. Steve McDowell, analista capo di NAND Research, ha sostenuto che l'inferenza su scala di produzione è un problema infrastrutturale diverso rispetto all'addestramento, con token per rack, token per watt e costo per inferenza a carico sostenuto che diventano le metriche rilevanti, un parametro di valutazione che, a suo dire, gli acquirenti dovrebbero utilizzare per valutare ogni fornitore. Jeremy Werner, vicepresidente senior e direttore generale della Core Data Center Business Unit di Micron, ha aggiunto che la nuova architettura WEKApod con gli SSD da 245 TB di Micron offre 15.8 petabyte in un formato 2U, preservando potenza e spazio per ulteriori capacità di calcolo.
Disponibilità
Si prevede che NeuralMesh 6 sarà disponibile a livello generale nella seconda metà del 2026. I clienti WEKA esistenti possono effettuare l'aggiornamento senza costi aggiuntivi tramite i canali standard. WEKApod Nitro, Prime e Prime Max sono ora disponibili per l'ordine tramite la rete di distributori e VAR di WEKA, con consegne a partire dall'autunno 2026 e NeuralMesh 6 preinstallato. Inoltre, per la prima volta in questa generazione, WEKApod è ora offerto in SKU configurabili, consentendo ai clienti di scegliere il tipo di chassis, la memoria, la capacità delle unità e il numero di unità, supportando sistemi da meno di 1 PB fino a 100 PB o più in un'unica configurazione.


 Amazon