

Si potrebbe dire che AMD sia arrivata prima: i mini PC e i laptop Strix Halo erano già disponibili con 128 GB di memoria unificata ben prima che NVIDIA entrasse in scena. Ma la categoria dei desktop AI locali è stata di fatto creata da NVIDIA quando ha racchiuso un superchip Grace Blackwell in un case da un litro e lo ha chiamato DGX Spark . L'idea era semplice: una macchina di classe sviluppatore con memoria unificata sufficiente a supportare modelli performanti, da posizionare su una scrivania anziché essere utilizzata nel cloud. AMD Ryzen AI Halo è la risposta di AMD a questa esigenza. AMD lo ha annunciato insieme alla serie Ryzen AI Max PRO 400 a maggio 2026; i preordini sono stati aperti a giugno esclusivamente tramite Micro Center , con disponibilità nei negozi a partire dal 10 luglio. Ryzen AI Halo si presenta con dimensioni simili, 128 GB di memoria unificata, un prezzo di 3,999 dollari e una serie di scelte che lo rendono una proposta significativamente diversa da Spark.
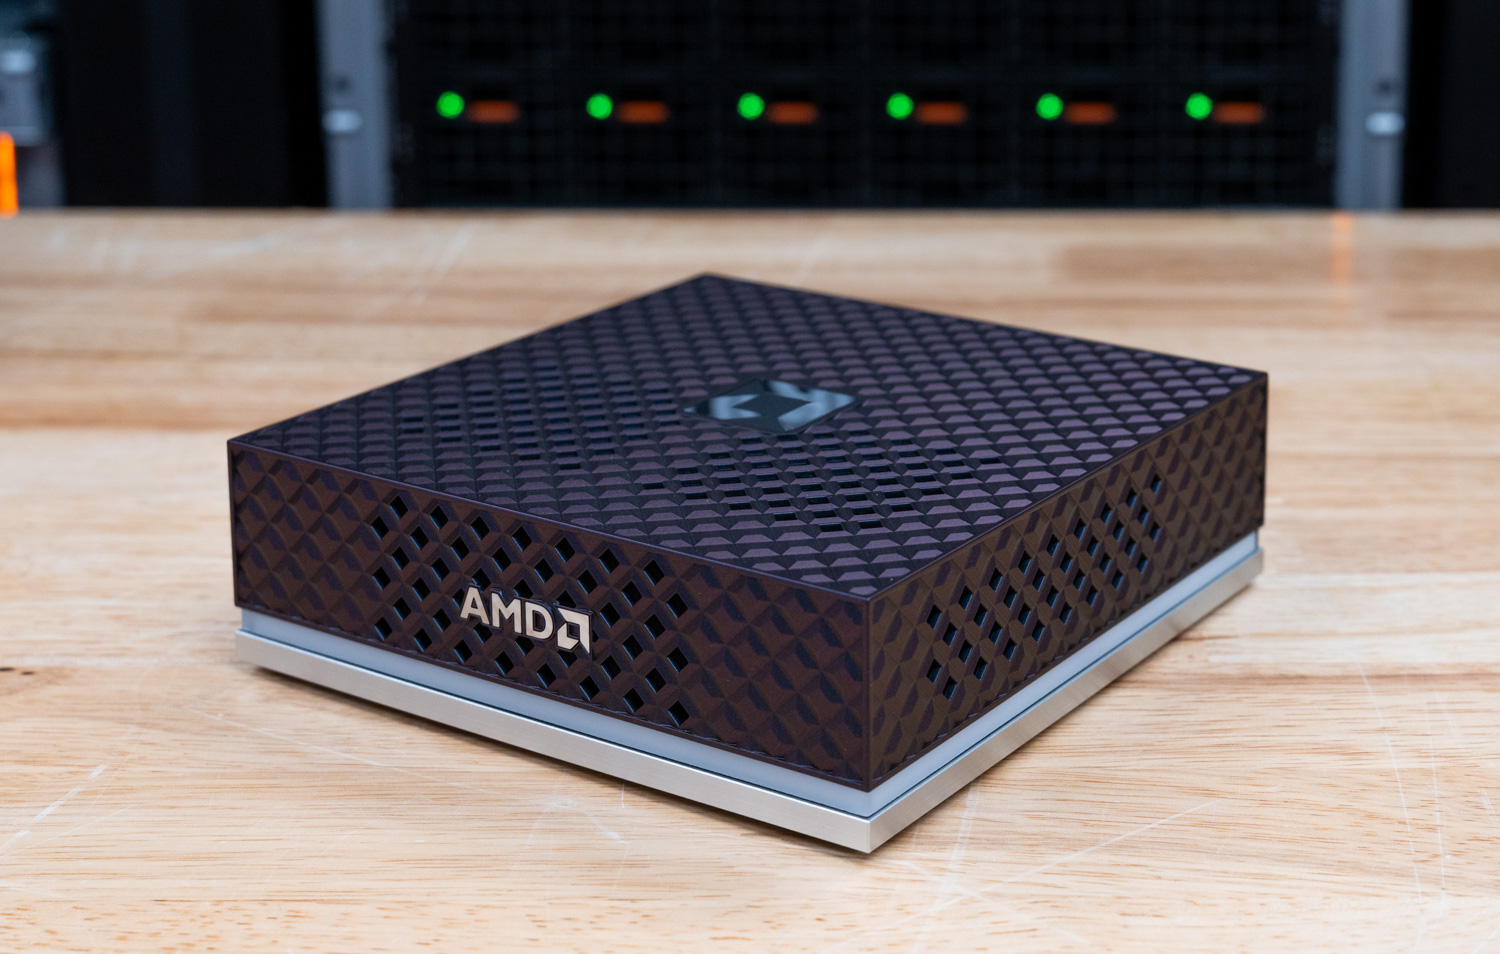
AMD presenta Halo come la sua prima piattaforma di sviluppo per l'IA, offrendo agli sviluppatori un percorso rapido e semplice per creare ed eseguire IA in locale. Sotto la scocca si trova il Ryzen AI Max+ 395, un processore "Zen 5" a 16 core e 32 thread con grafica integrata Radeon 8060S (40 unità di calcolo RDNA 3.5) e una NPU XDNA 2 con una velocità di 50 TOPS, il tutto all'interno di una piattaforma che AMD pubblicizza con una velocità di elaborazione IA combinata fino a 126 TOPS. I 128 GB di LPDDR5x operano a 8000 MT/s, offrendo una larghezza di banda di 256 GB/s, e l'intera piattaforma si alimenta tramite un singolo ingresso USB-C da 120 W. AMD afferma che la memoria è sufficiente per contenere modelli con fino a 200 miliardi di parametri nella memoria del dispositivo. Si tratta di una mini-workstation x86 completa, ed è proprio questa la differenza fondamentale.
La differenza sta in Windows. Spark esegue DGX OS, il sistema operativo basato su Linux di NVIDIA, e nient'altro; Halo, invece, avvia Windows 11 o l'immagine di sviluppo Linux di AMD sullo stesso hardware. Il supporto nativo per Windows è stata la richiesta più frequente da parte di chi era interessato a Spark, e questo ridefinisce il target di riferimento del dispositivo. Anche il posizionamento di AMD sottolinea lo stesso concetto: Windows e Linux contro Spark, che supporta solo Linux ( almeno per ora ).
Altre tre scelte distinguono Halo da Spark, e ognuna di esse risponde a una critica che abbiamo sentito riguardo al modello precedente. Halo utilizza un SSD M.2 2280 standard anziché il meno comune 2242 montato su Spark, il che apre a una gamma molto più ampia di opzioni aftermarket, comprese capacità fino a 8 TB, per chiunque voglia sostituire l'unità. Viene fornito con la memoria grafica variabile (VGM) preimpostata al suo valore massimo su entrambi i sistemi operativi, quindi i modelli più complessi vengono caricati senza necessità di regolazioni manuali. Inoltre, il case è dotato di un anello luminoso di stato, una piccola correzione rispetto alle unità Spark scure e prive di illuminazione che alcuni acquirenti hanno ricevuto, a seconda dell'OEM. Il costo dell'approccio di AMD si manifesta sul retro del case, dove non è presente una rete ad alta velocità, ma solo una porta 10GbE, che limita le possibilità di clustering multi-nodo. Questi sono i compromessi, e definiscono i carichi di lavoro per cui questa macchina è stata progettata prima ancora di eseguire qualsiasi benchmark.
Sul prezzo, le sfumature contano. L'Halo è in listino a 3,999 dollari con un SSD da 2 TB, posizionandosi esattamente al prezzo di mercato per un sistema base di classe Spark. Il confronto dipende da quale Spark si intende. La stessa DGX Spark di NVIDIA con l'unità più capiente ora si aggira intorno ai 4,700 dollari, un aumento legato alla carenza di LPDDR5X e NAND. I sistemi base Grace Blackwell di ASUS e altri produttori si vendono ancora intorno ai 4,000 dollari e sono attualmente disponibili su Amazon (link di affiliazione). Misurato rispetto al punto di riferimento della categoria, l'Halo è in parità e la sua validità si basa sulle considerazioni di cui sopra, piuttosto che su un prezzo inferiore rispetto alla concorrenza.
Abbiamo testato Halo con la suite di intelligenza artificiale locale di StorageReview sia su Windows che su Linux, e i risultati sono presentati insieme all'analisi del design e del software nel corso di questa recensione.
Punti chiave
- L'alternativa a doppio sistema operativo per sistemi x86: Ryzen AI Halo è l'unico box nella categoria Spark in grado di avviare Windows 11 o Linux su una piattaforma x86 completa, al prezzo di 3,999 dollari con un SSD da 2 TB contro i 4,699 dollari del DGX Spark Founders Edition.
- Memoria sufficiente per contenere modelli di grandi dimensioni: 128 GB di memoria unificata LPDDR5x-8000 a 256 GB/s supportano modelli fino a 200 miliardi di parametri localmente, con memoria grafica variabile pre-ottimizzata in modo che i modelli di grandi dimensioni vengano caricati senza configurazione manuale.
- La Ryzen AI Max+ 395 più potente che abbiamo testato: Halo ha superato HP Z2 Mini G1a e ZBook Ultra G1a in quasi tutti i test di carico di lavoro Windows, ottenendo 37,316 punti in Cinebench R23 multi-core, 184.2 GIPS in 7-Zip e i migliori punteggi nei test di generazione di testo (Phi 1,192) e di generazione di immagini (SD 1.5 FP16 937) di Procyon AI.
- La CPU vince, ma l'inferenza perde contro Spark: Su Linux, Halo ha superato nettamente DGX Spark nel lavoro sulla CPU, comprimendo l'11% più velocemente e decomprimendo il 38% più velocemente in 7-Zip e terminando la compilazione LLVM il 14% prima, ma è rimasto indietro da 2 a 4 volte nella maggior parte degli scenari di servizio vLLM ad alta concorrenza, arrivando a 8.8 volte nel lavoro GPT OSS 120B con pre-riempimento intensivo.
- Spazio di archiviazione funzionale, rete modesta: Uno slot M.2 2280 standard consente aggiornamenti aftermarket fino a 8 TB, sebbene la piattaforma negozia per impostazione predefinita le prestazioni del Micron 4600 Gen5 incluso, portandolo a Gen4, e la singola porta 10GbE senza fabric ad alta velocità escluda il clustering multi-nodo reso possibile dalla ConnectX-7 a 200G dello Spark.
Specifiche
| Specificazione | Sistema AMD Ryzen AI Halo |
|---|---|
| Processore | |
| CPU | Processore AMD Ryzen™ AI Max+ 395 16 core / 32 thread (architettura Zen 5) |
| GPU | Grafica integrata AMD Radeon™ 8060S 40 unità di calcolo (architettura RDNA™ 3.5) |
| NPU | NPU AMD XDNA™ 2 |
| Memorie | |
| Tipo di memoria | LPDDR5x |
| Capacità di memoria | 128GB |
| Velocità memoria | 8000 MT / s |
| Banda di memoria | 256GB / s |
| Archiviazione | |
| Archiviazione | SSD M.2 NVMe da 2 TB (SED) |
| Rete e connettività | |
| Ethernet | 1 × 10GbE |
| Wi-Fi | Wi-Fi 7 |
| Bluetooth | Bluetooth 5.4 |
| I / O | |
| USB | 3 porte USB-C, 1 porta USB-C (ingresso alimentazione) |
| Uscita di visualizzazione | 1 × HDMI 2.1b |
| Sistema | |
| TDP | 120W |
| Sistema operativo | Linux o Windows 11 |
| Dimensioni | 150 × 150 × 45.4 mm (5.9 × 5.9 × 1.79 pollici) |
| Peso | Meno di 1.2 kg (2.65 lbs) |
Progettazione e realizzazione di AMD Ryzen AI Halo
Il sistema AMD Ryzen AI Halo utilizza un fattore di forma compatto, simile a quello di "NVIDIA Spark", con dimensioni di soli 150 × 150 × 45.4 mm e un peso inferiore a 1.2 kg. Lo chassis in alluminio presenta un'aggressiva griglia di ventilazione geometrica sulla parte superiore e frontale, che conferisce al sistema un aspetto distintivo e massimizza il flusso d'aria verso il sistema di raffreddamento. Nonostante le dimensioni ridotte, la piattaforma è progettata come una workstation AI desktop completa, in grado di gestire applicazioni workstation, inferenza LLM locale e carichi di lavoro di sviluppo AI.
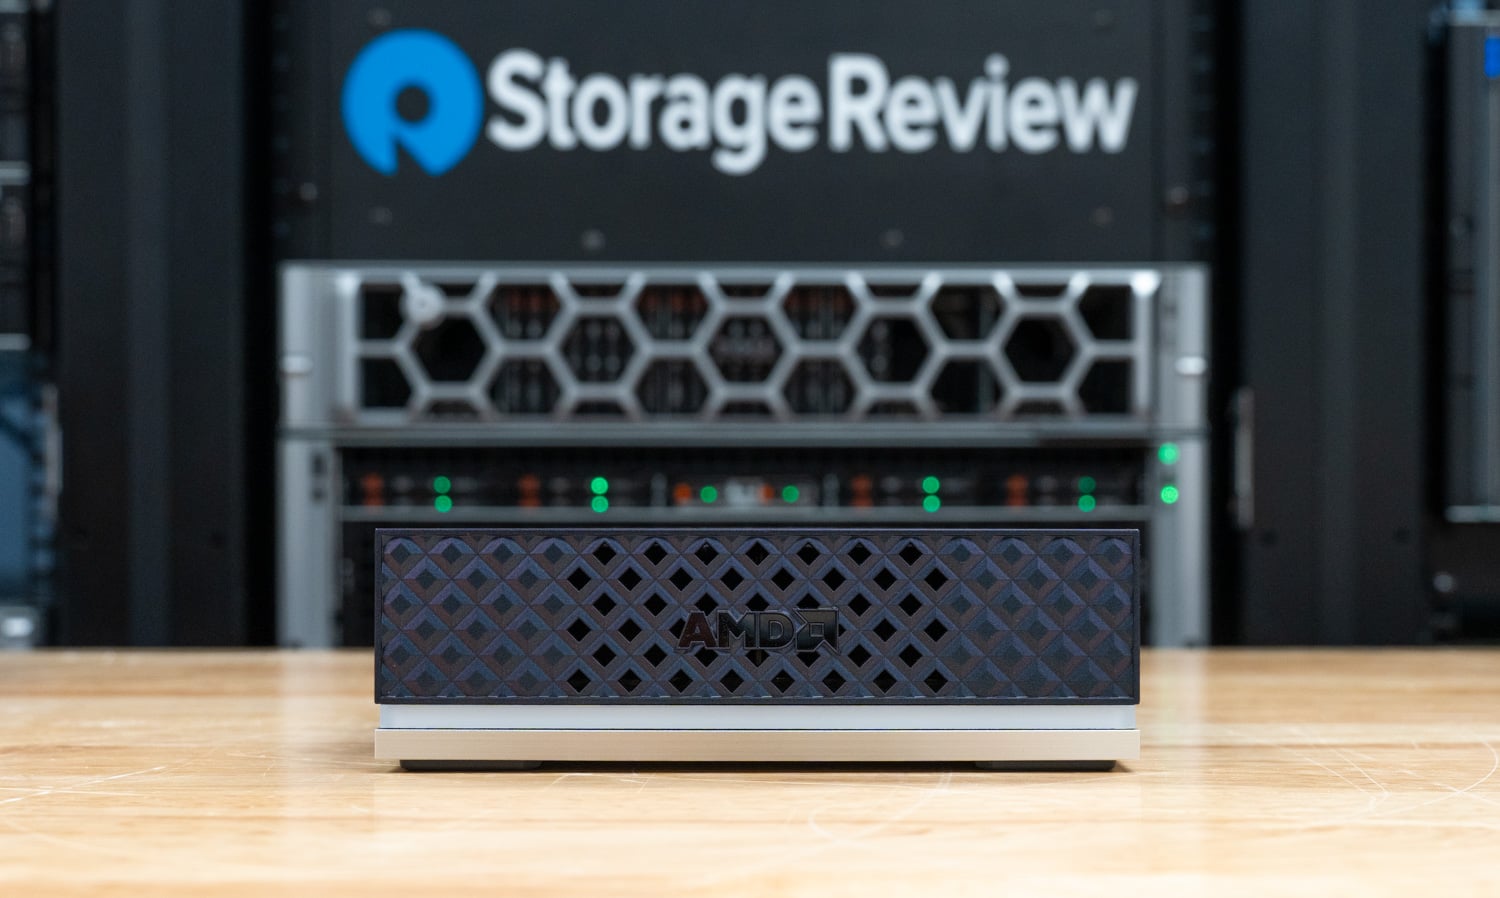
Anteriore
La parte frontale del sistema è volutamente pulita, costituita quasi interamente da un'ampia griglia di ventilazione a rete che si estende per tutta la larghezza dello chassis. Invece di posizionare porte sul frontale, AMD dedica quest'area al flusso d'aria, consentendo all'aria fresca di entrare nel sistema attraverso l'ampia presa d'aria con motivo a griglia, mantenendo al contempo il frontale libero da ingombri. Un dettaglio argentato lungo la parte inferiore dello chassis offre un sottile contrasto visivo con il resto del case nero opaco.
I / O posteriori
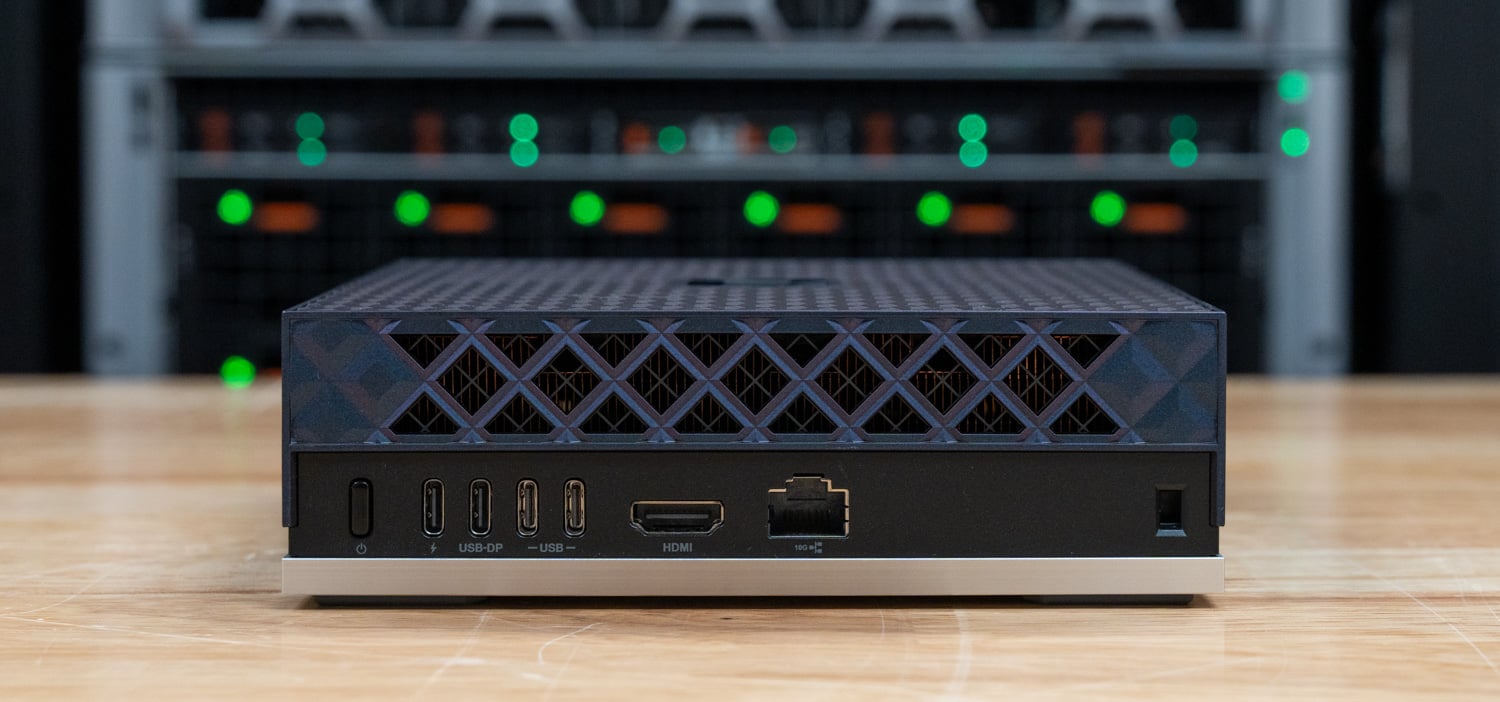
Tutte le connessioni esterne si trovano sul retro del sistema. Da sinistra a destra, il pannello posteriore comprende i seguenti elementi:
- Ingresso di alimentazione USB-C
- Porta USB-C con DisplayPort Alt Mode
- Due porte USB-C aggiuntive
- Uscita HDMI 2.1b
- Connettore Ethernet RJ45 da 10 GbE
- Slot per blocco di sicurezza Kensington
Il sistema offre tre porte dati USB-C e un connettore di alimentazione USB-C dedicato, consentendo la connessione simultanea di più periferiche e display ad alta velocità. L'uscita video nativa HDMI 2.1b, mentre l'interfaccia Ethernet 10GbE integrata, rende la piattaforma ideale per la connettività NAS ad alta velocità, il trasferimento di set di dati per l'intelligenza artificiale e gli ambienti di sviluppo locali.
Design interno
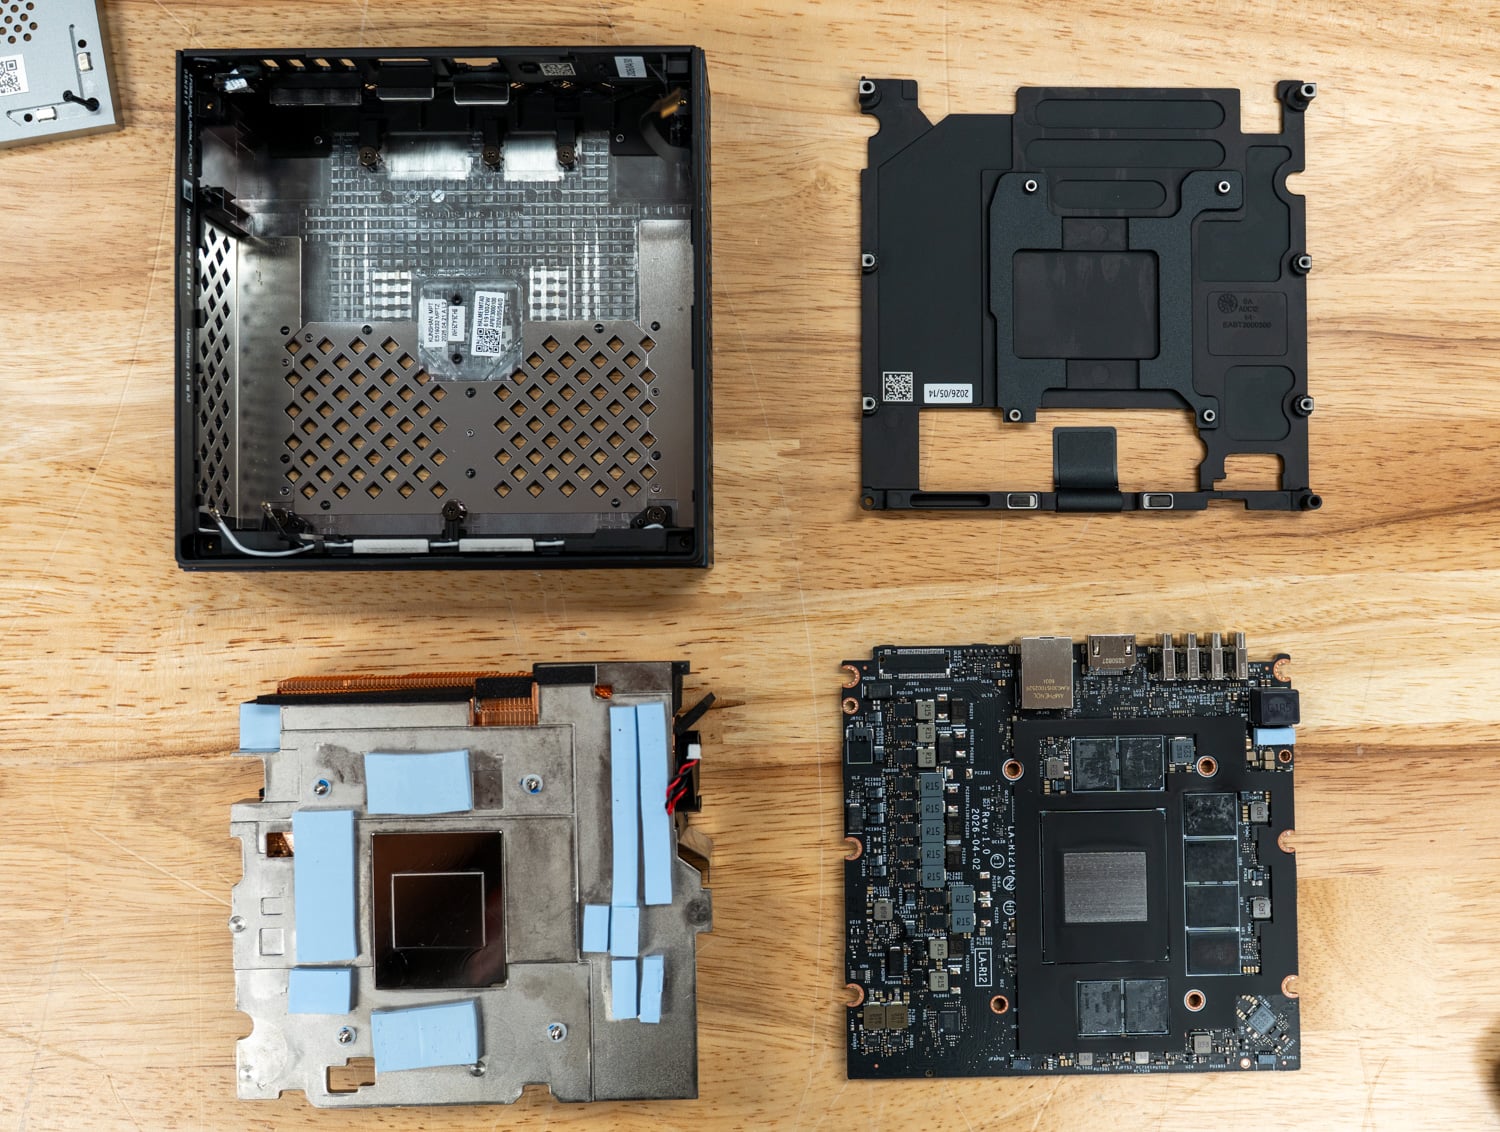
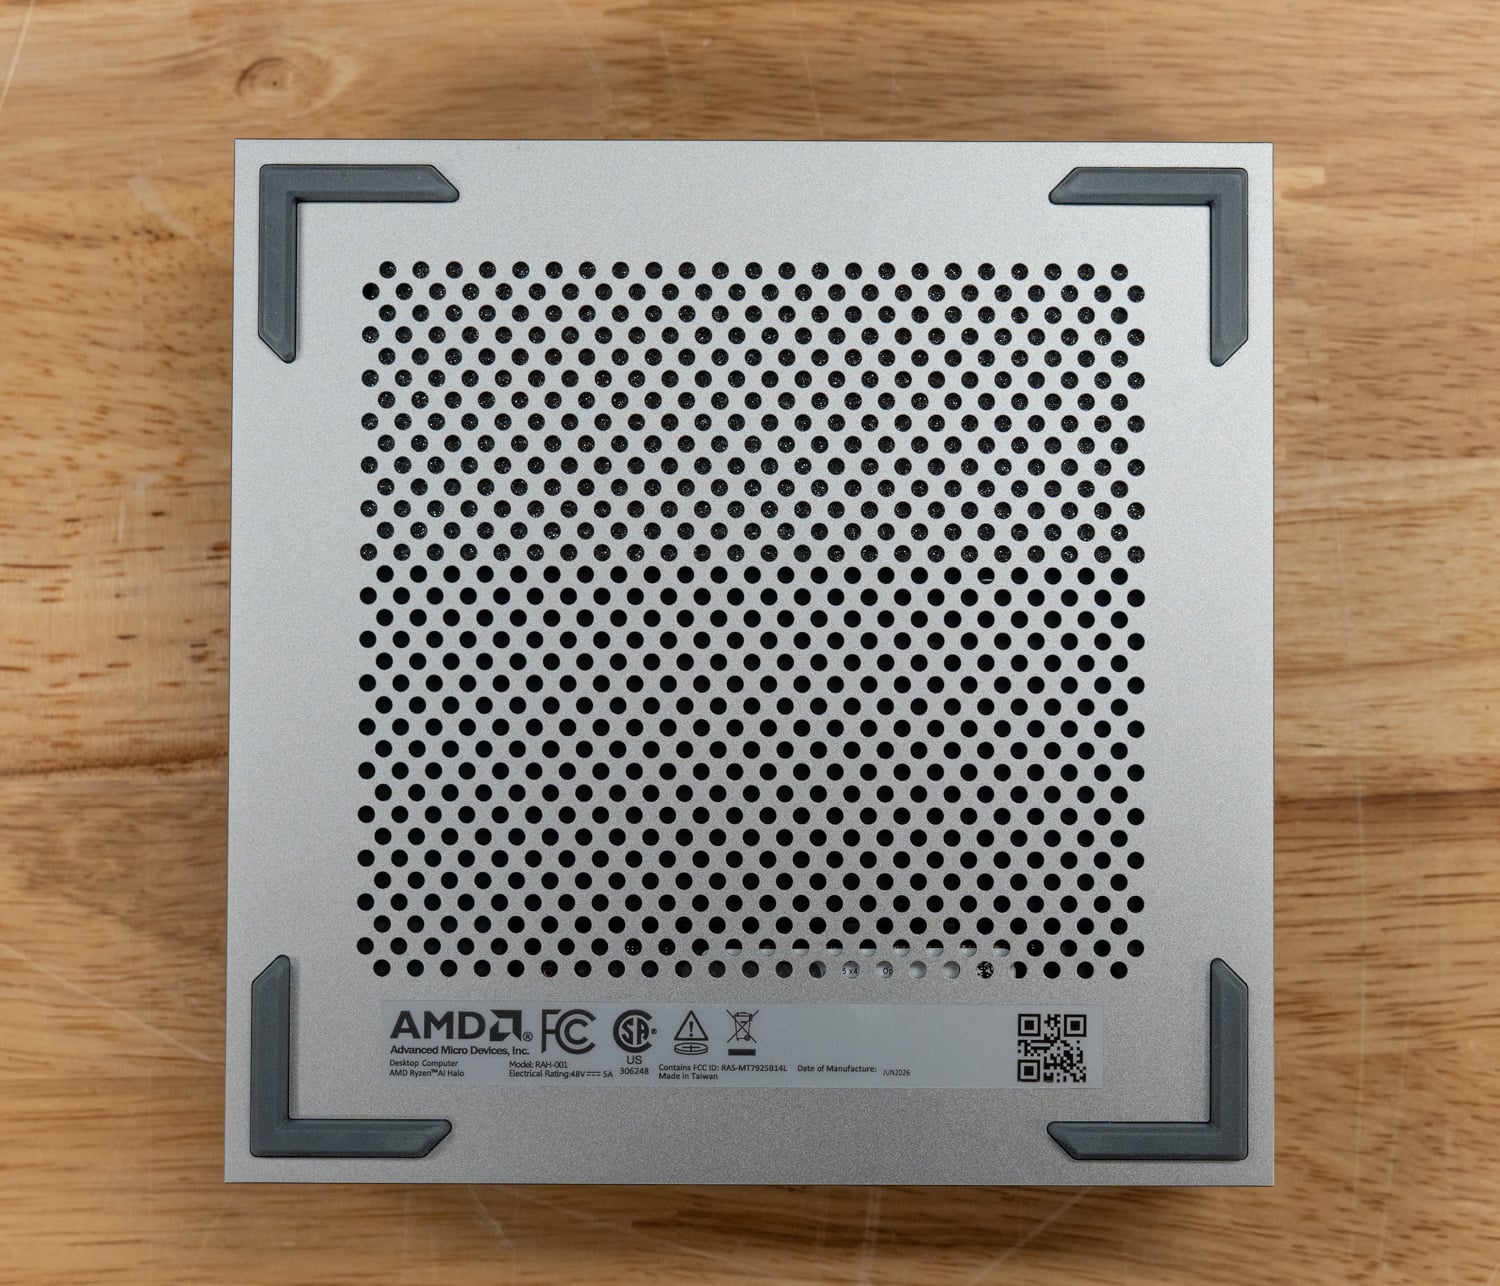
La parte inferiore del Ryzen AI Halo presenta un'ampia griglia di ventilazione perforata che aspira aria per raffreddare i componenti montati lungo il bordo inferiore della scheda, mentre quattro piedini in gomma agli angoli garantiscono la stabilità dell'unità su una scrivania o uno scaffale.
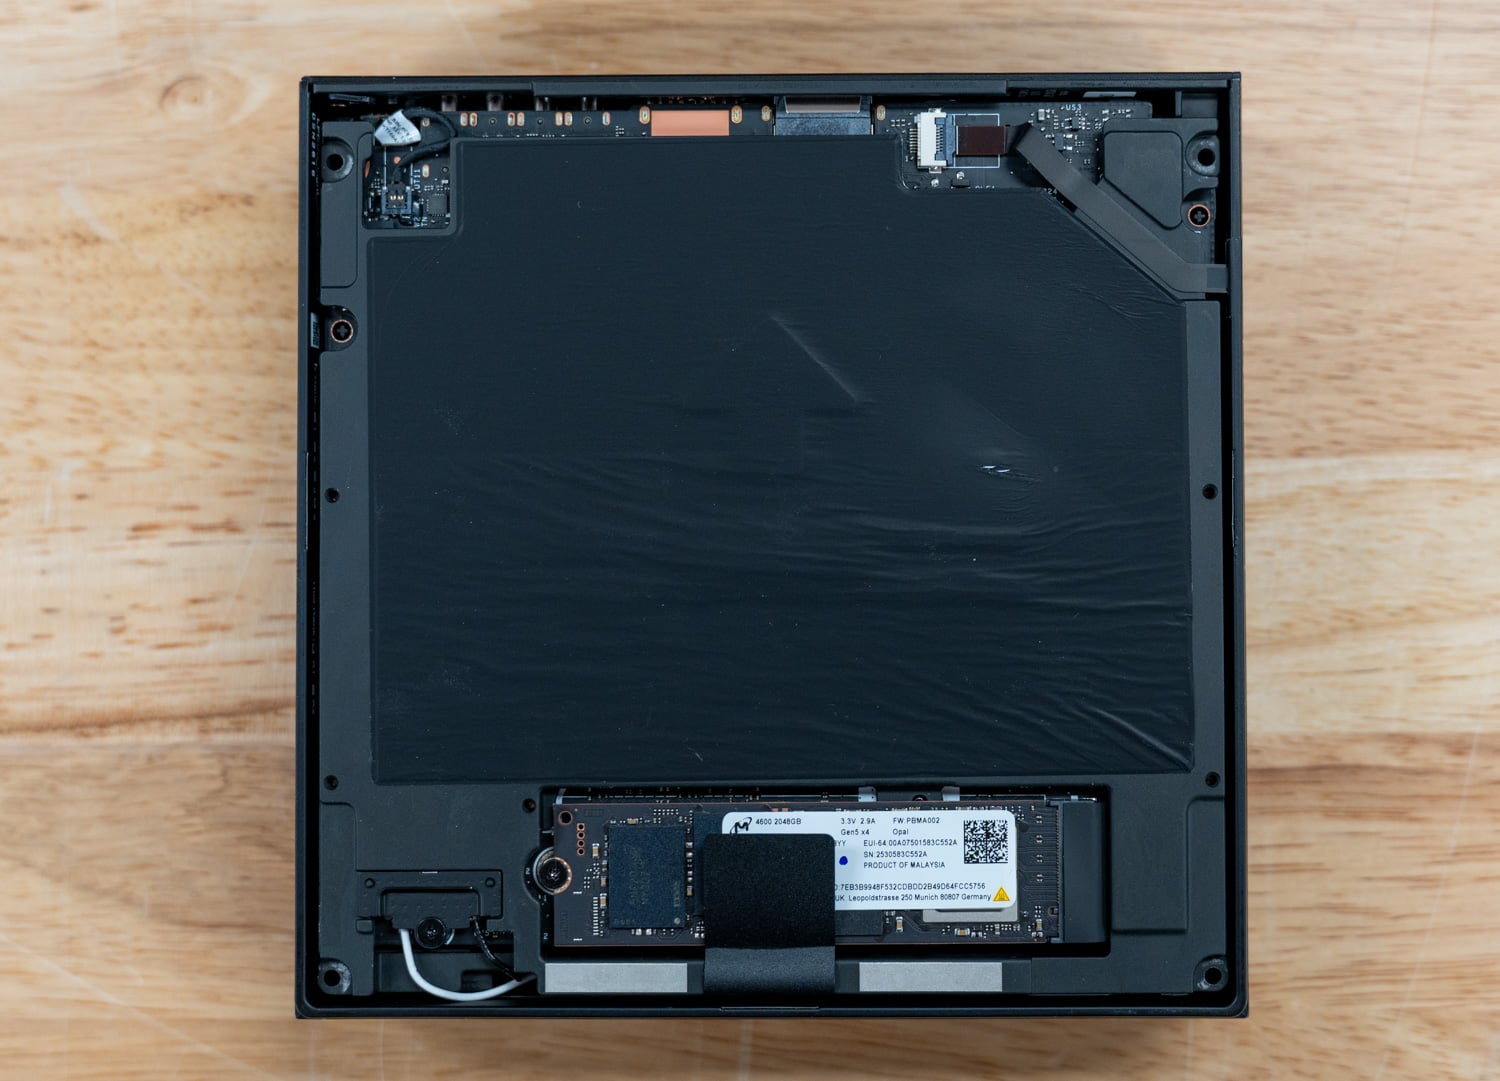
Rimuovendo le quattro viti che fissano il pannello inferiore si accede allo slot per SSD M.2 e ad alcuni componenti della scheda madre inferiore, tra cui il connettore per la scheda Wi-Fi. Nell'unità che abbiamo testato, questo slot ospita un SSD Micron 4600 Gen5 x4 da 2 TB, mentre un foglio adesivo nero protegge il resto della scheda dalla parte inferiore esposta.
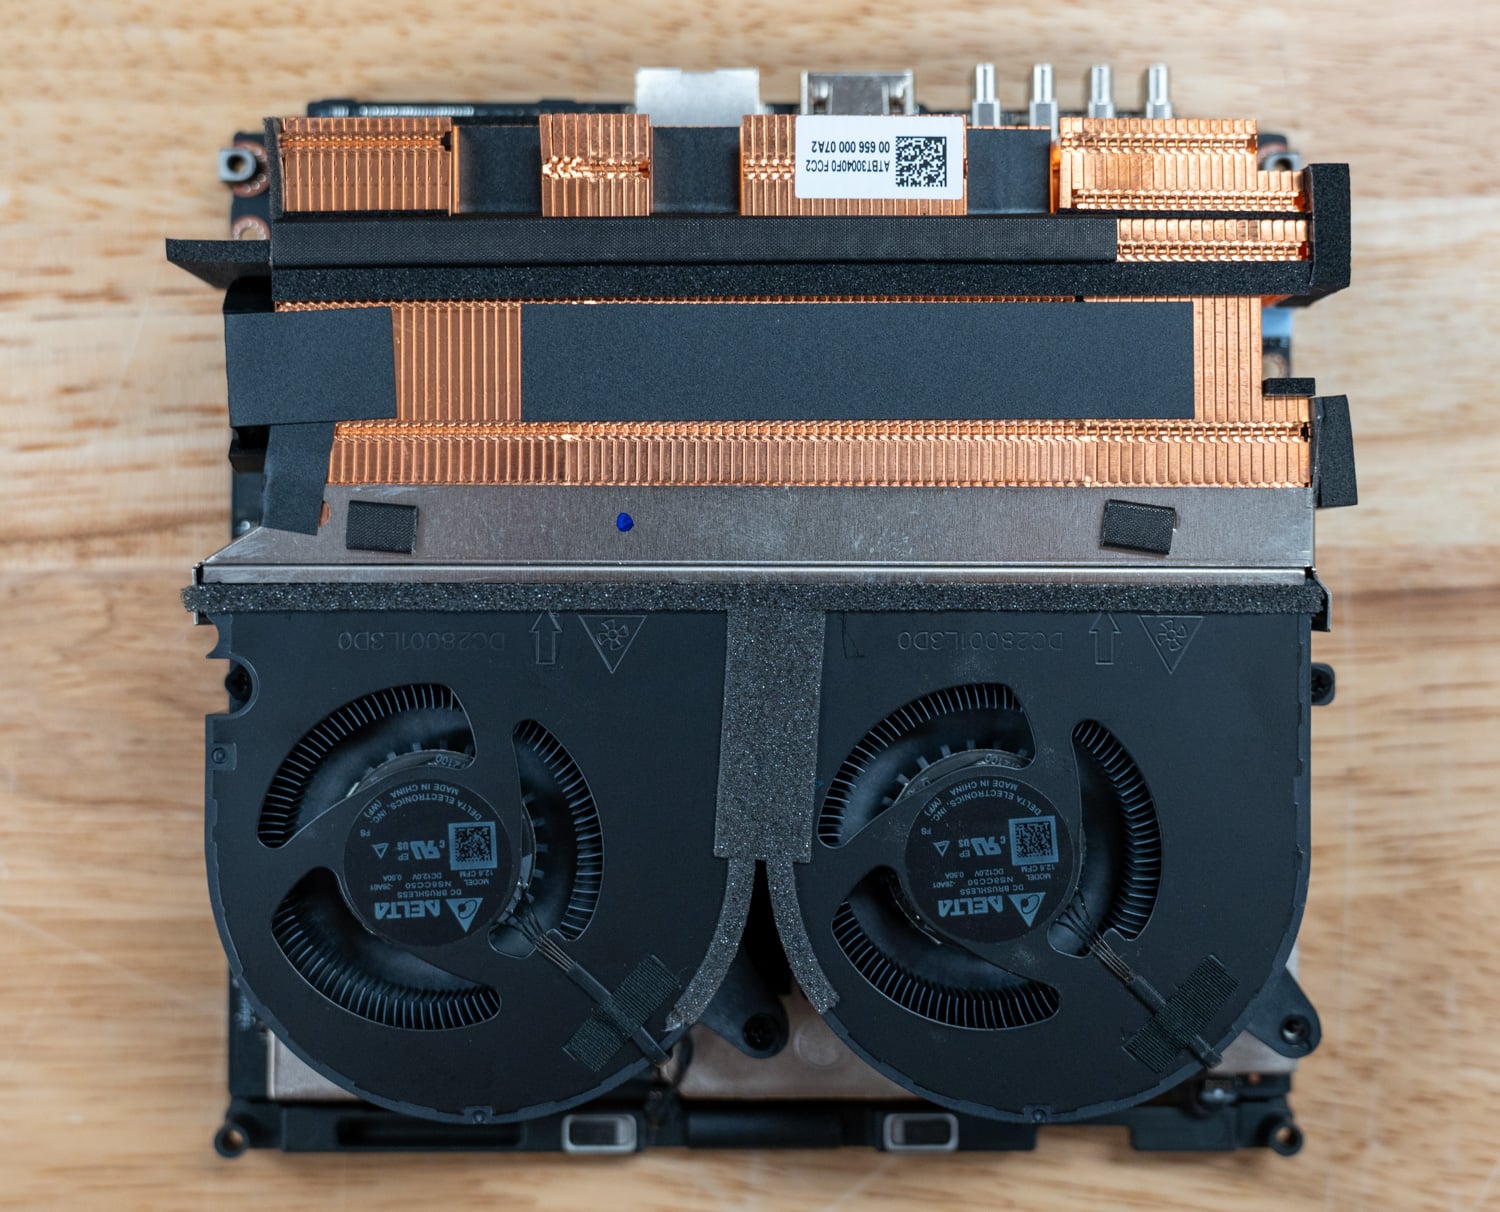
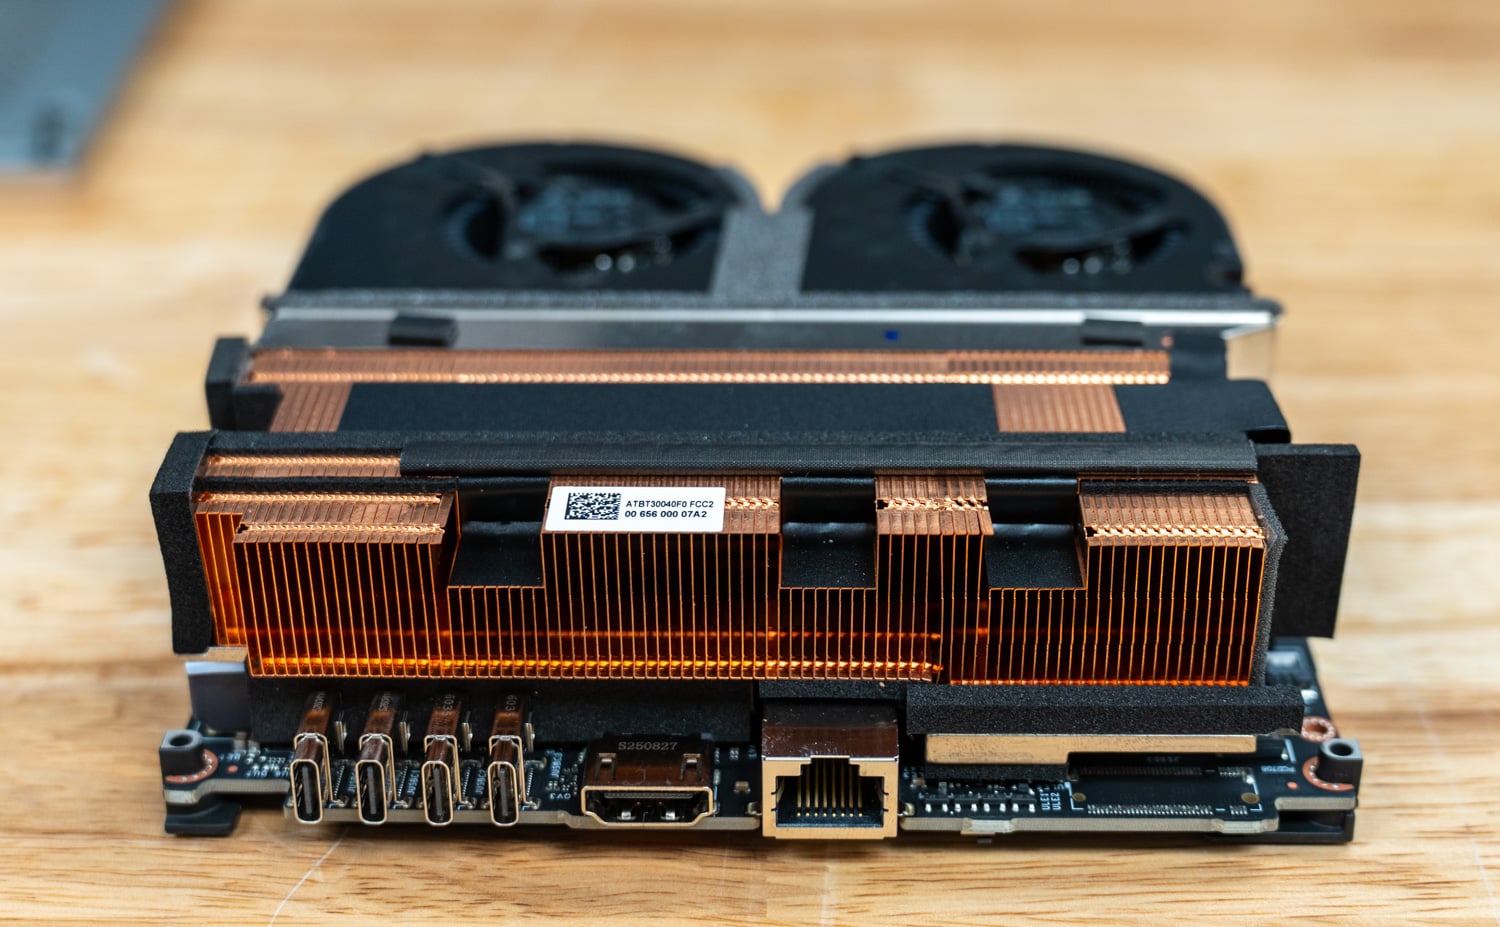
Per il raffreddamento, AMD ha adottato un approccio simile a quello della DGX Spark di NVIDIA, utilizzando due ventole che aspirano aria attraverso un dissipatore alettato e la espellono dalla parte posteriore del case.
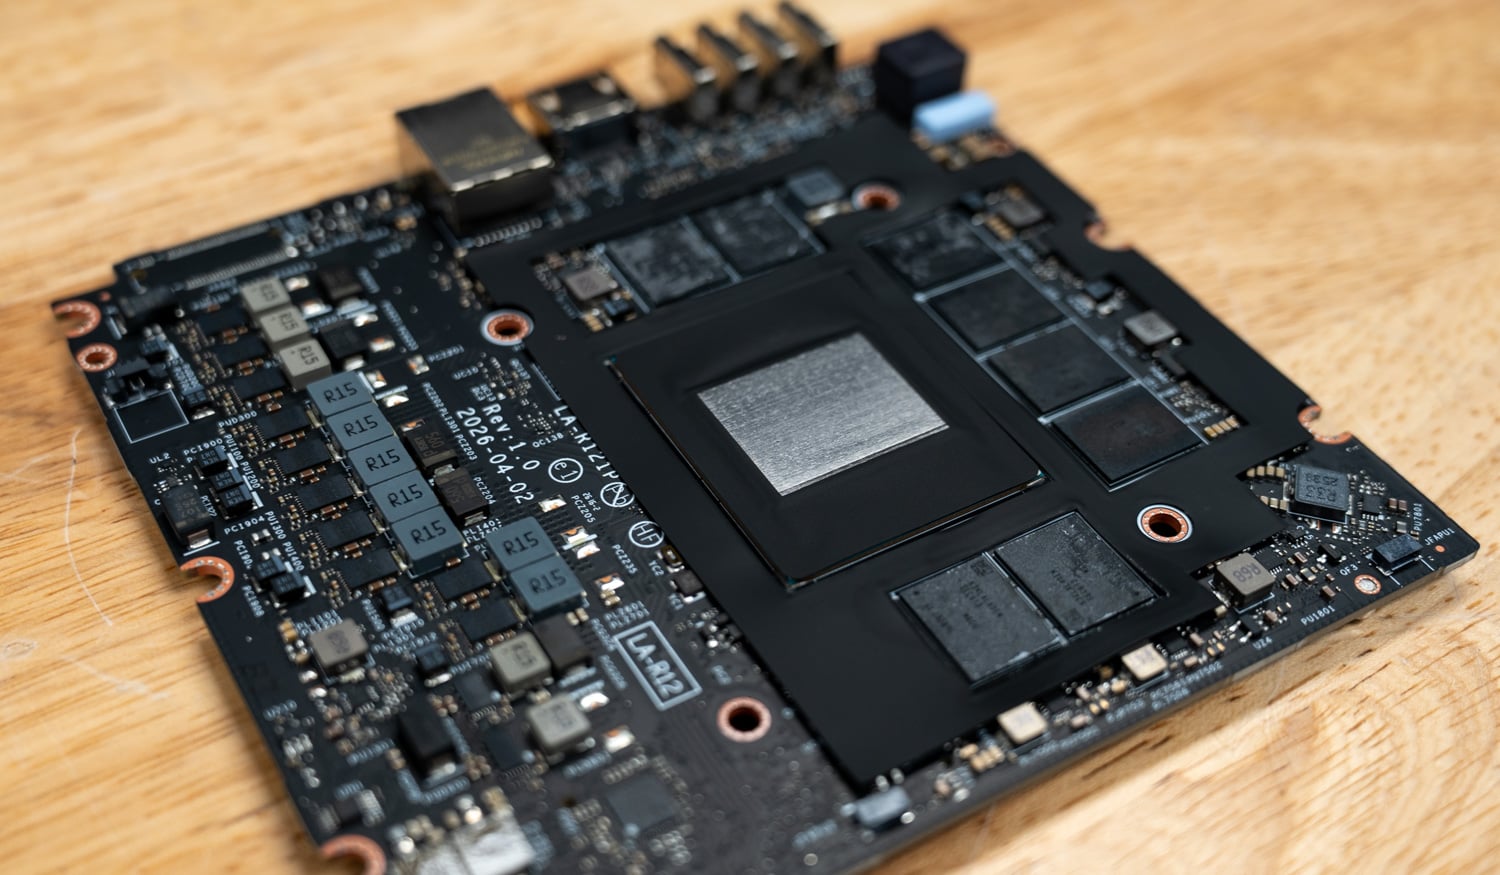
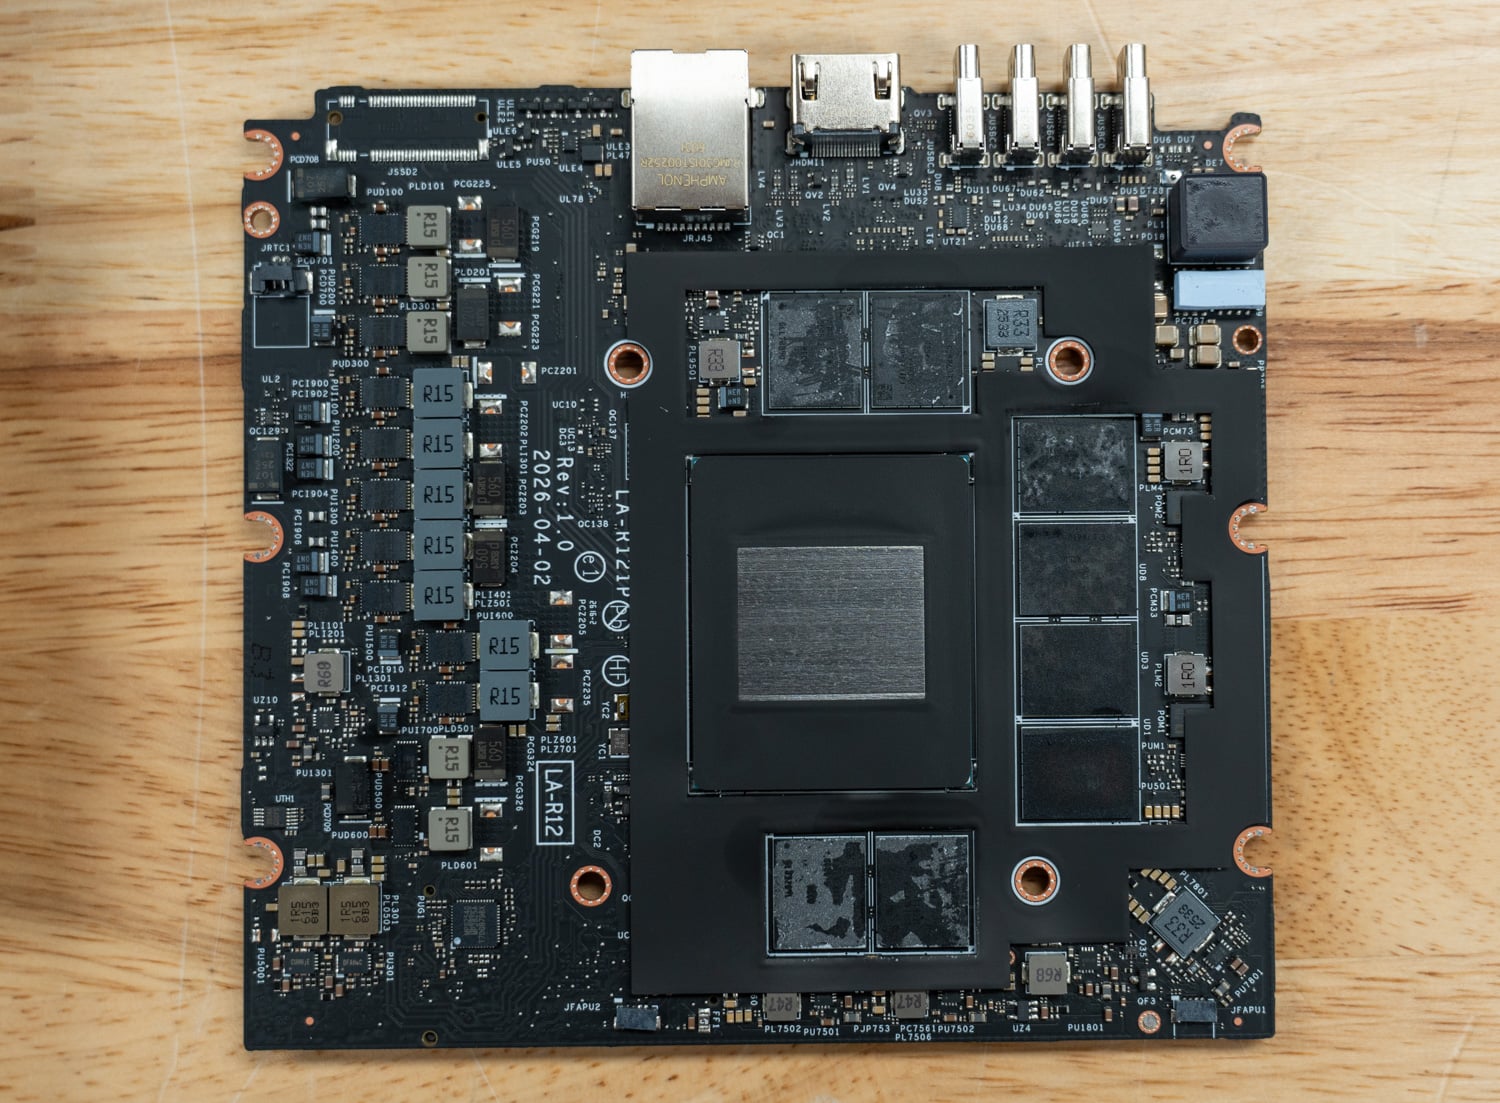
Una volta rimosso il gruppo di raffreddamento, la scheda madre diventa visibile, rivelando il die dell'APU al centro, affiancato dai moduli di memoria su entrambi i lati e dai circuiti VRM che corrono lungo il bordo sinistro. Il quadrato argentato visibile sul die non è metallo liquido o una pasta termica; si tratta del residuo di un pad termico solido o di un rivestimento applicato da AMD come interfaccia tra il die e il dissipatore, il che spiega il suo aspetto uniforme e asciutto, anziché l'aspetto umido e spalmato che la pasta o il metallo liquido lasciano tipicamente.
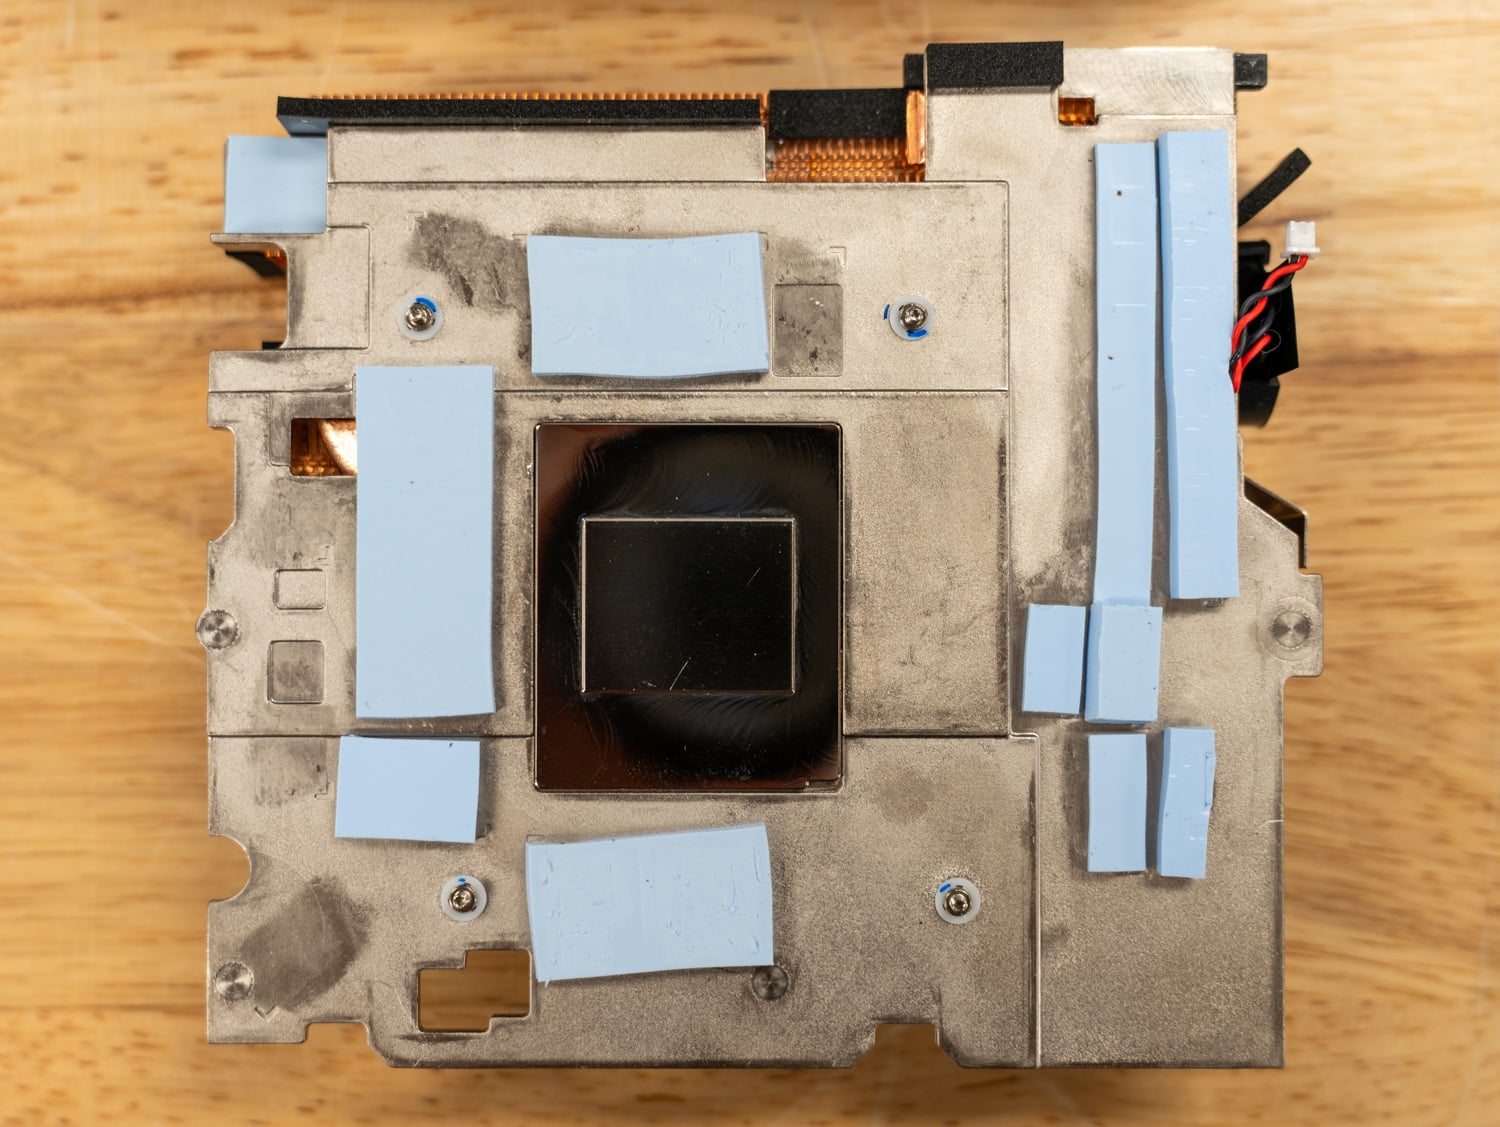
Capovolgendo il dissipatore si può osservare la parte inferiore della sua piastra di raffreddamento, dove una sezione lucidata a specchio è a diretto contatto con il die. Allo stesso tempo, le zone circostanti dedicate alla memoria e all'alimentazione sono ricoperte da pad termici preapplicati di diverso spessore.
Test delle prestazioni di AMD Ryzen AI Halo
Abbiamo valutato la piattaforma AMD Ryzen AI Halo su Windows e Linux per analizzarne le prestazioni in applicazioni workstation e carichi di lavoro incentrati sull'intelligenza artificiale. Per i test su Windows, il sistema AMD Ryzen AI Halo è stato confrontato con due sistemi commerciali basati sul Ryzen AI Max+ PRO 395: l'HP Z2 Mini G1a, una workstation desktop compatta, e l'HP ZBook Ultra G1a da 14 pollici, una workstation mobile. Poiché tutti e tre i sistemi condividono la stessa architettura del processore e la stessa scheda grafica integrata Radeon 8060S, questi confronti evidenziano le prestazioni della piattaforma Halo in diversi scenari termici e configurazioni di sistema.
Per i test su Linux, ci siamo concentrati sullo sviluppo di IA e sui carichi di lavoro di archiviazione, confrontando il sistema Ryzen AI Halo con NVIDIA DGX Spark. Questi test si sono focalizzati sul benchmarking dello storage FIO e sulle prestazioni di inferenza vLLM, confrontando la piattaforma di sviluppo basata su Ryzen AI Halo di AMD con il sistema di sviluppo IA di NVIDIA, progettato specificamente per l'inferenza locale di modelli linguistici di grandi dimensioni.
Unità testate
UL Procyon: visione artificiale
Il benchmark Procyon AI Computer Vision fornisce informazioni dettagliate sulle prestazioni dei motori di inferenza AI a livello professionale. Integrando motori di diversi fornitori, offre punteggi di prestazione che riflettono accuratamente le capacità di un dispositivo. Il benchmark valuta i modelli di reti neurali all'avanguardia confrontando le loro prestazioni di accelerazione AI su diversi tipi di hardware, tra cui CPU, GPU e NPU, consentendo agli utenti di valutare l'efficienza relativa in una vasta gamma di carichi di lavoro e condizioni.
Per rispecchiare i carichi di lavoro reali dell'IA, il benchmark utilizza sei diversi modelli di reti neurali, ciascuno selezionato per la sua rilevanza nei moderni compiti di visione artificiale. MobileNet V3 è un modello compatto, focalizzato sui dispositivi mobili e progettato per l'identificazione di soggetti nelle immagini, mentre Inception V4 svolge lo stesso compito con un'architettura più profonda e complessa.
YOLO V3 (You Only Look Once) è specializzato nel rilevamento di oggetti in tempo reale tramite la stima delle probabilità di presenza degli oggetti. DeepLab V3, basato su MobileNet V2, si concentra sulla segmentazione semantica delle immagini e sul clustering dei pixel. Real-ESRGAN, il test più impegnativo dal punto di vista computazionale, ingrandisce le immagini da una risoluzione di 250×250 a 1,000×1,000. Infine, ResNet 50 è un robusto modello di classificazione che consente un addestramento più efficace delle reti neurali profonde.
La piattaforma Ryzen AI Halo ha offerto prestazioni di inferenza AI costantemente elevate sia su CPU che su GPU. Nei test CPU, ha ottenuto un punteggio complessivo di 216, di poco inferiore ai 227 dell'HP Z2 Mini e nettamente superiore ai 186 dell'HP ZBook Ultra. L'inferenza GPU è stata ancora più impressionante, con il sistema Halo che ha raggiunto il punteggio complessivo più alto, pari a 553, davanti allo ZBook Ultra (528) e allo Z2 Mini (528). Ha inoltre registrato l'inferenza MobileNet V3 più veloce, con un tempo di 0.38 ms, e ha completato l'impegnativo carico di lavoro REAL-ESRGAN in 185.08 ms, rispetto ai 211.76 ms dello Z2 Mini e ai 200.40 ms dello ZBook Ultra.
| UL Procyon: Inferenza della visione artificiale tramite intelligenza artificiale (più basso è meglio) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Tempi di CPU | |||
| Punteggio complessivo della visione artificiale (più alto è meglio è) | 216 | 227 | 186 |
| Rete Mobile V3 | ms 0.73 | ms 0.75 | ms 1.09 |
| Res Net 50 | ms 6.02 | ms 5.99 | ms 6.84 |
| Inizio V4 | ms 17.18 | ms 17.12 | ms 19.80 |
| Deep Lab V3 | ms 29.21 | ms 21.20 | ms 28.27 |
| YOLO V3 | ms 35.60 | ms 36.58 | ms 41.64 |
| REAL-ESRGAN | ms 1,931.13 | ms 1,892.10 | ms 2,138.97 |
| Tempi GPU | |||
| Punteggio complessivo della visione artificiale (più alto è meglio è) | 553 | 528 | 583 |
| Rete Mobile V3 | ms 0.38 | ms 0.42 | ms 0.46 |
| Res Net 50 | ms 4.04 | ms 3.85 | ms 3.27 |
| Inizio V4 | ms 13.26 | ms 15.15 | ms 11.62 |
| Deep Lab V3 | ms 12.72 | ms 10.98 | ms 10.72 |
| YOLO V3 | ms 11.17 | ms 12.64 | ms 10.57 |
| REAL-ESRGAN | ms 185.08 | ms 211.76 | ms 200.40 |
UL Procyon: generazione di testo AI
Il benchmark Procyon AI Text Generation semplifica i test delle prestazioni dei modelli LLM basati sull'IA, fornendo un metodo di valutazione conciso e coerente. Consente di ripetere i test su più modelli LLM, riducendo al minimo la complessità derivante da modelli di grandi dimensioni e fattori variabili. Sviluppato in collaborazione con i leader nel settore dell'hardware per l'IA, ottimizza l'utilizzo degli acceleratori AI locali per valutazioni delle prestazioni più affidabili ed efficienti. I risultati riportati di seguito sono stati misurati utilizzando TensorRT.
La piattaforma di riferimento Ryzen AI Halo ha primeggiato tra tutti i modelli linguistici testati in Procyon AI Text Generation. Ha ottenuto il punteggio Phi complessivo più alto, pari a 1,192, rispetto ai 965 dell'HP Z2 Mini e ai 922 dell'HP ZBook Ultra. Mistral ha seguito un andamento simile con un punteggio di 998, davanti a 850 e 829, mentre Llama3 ha chiuso a 847, superando i sistemi concorrenti che si attestavano rispettivamente a 766 e 756. La piattaforma Halo ha inoltre ridotto il tempo di generazione del primo token su tutti i modelli, producendo il primo token Phi in soli 0.996 secondi, quasi la metà della latenza dei sistemi HP. Sebbene la velocità di generazione dei token abbia occasionalmente favorito lo Z2 Mini, la latenza di avvio significativamente inferiore della piattaforma Halo ha portato ai migliori punteggi complessivi del benchmark.
| UL Procyon: generazione di testo AI | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Punteggio complessivo Phi | 1,192 | 965 | 922 |
| Tempo di output Phi per il primo token | 0.996 secondi | 1.898 secondi | 1.956 secondi |
| Token di output Phi al secondo | 55.271 token/s | 68.967 token/s | 64.986 token/s |
| Durata complessiva Phi | 56.237 secondi | 52.666 secondi | 55.501 secondi |
| Punteggio complessivo Mistral | 998 | 850 | 829 |
| Tempo di output di Mistral per il primo token | 1.603 secondi | 2.734 secondi | 2.783 secondi |
| Gettoni di output Mistral al secondo | 35.027 token/s | 43.358 token/s | 41.992 token/s |
| Durata complessiva del Mistral | 88.582 secondi | 81.716 secondi | 84.065 secondi |
| Punteggio complessivo di Llama3 | 847 | 766 | 756 |
| Tempo di output di Llama3 per il primo token | 1.963 secondi | 2.545 secondi | 2.578 secondi |
| Token di output Llama3 al secondo | 34.630 token/s | 36.752 token/s | 36.243 token/s |
| Llama3 Durata complessiva | 92.026 secondi | 91.987 secondi | 93.200 secondi |
| Punteggio complessivo di Llama2 | N/A | 936 | 929 |
| Tempo di output di Llama2 per il primo token | secondi non disponibili | 3.813 secondi | 3.860 secondi |
| Token di output Llama2 al secondo | N/D token/s | 24.685 token/s | 24.619 token/s |
| Llama2 Durata complessiva | secondi non disponibili | 136.077 secondi | 136.720 secondi |
Procione UL: Generazione di immagini AI
Il benchmark Procyon AI Image Generation offre un metodo coerente e preciso per misurare le prestazioni dell'inferenza AI su hardware che spazia dalle NPU a basso consumo alle GPU di fascia alta. Include tre test: Stable Diffusion XL (FP16) per GPU di fascia alta, Stable Diffusion 1.5 (FP16) per GPU di potenza media e Stable Diffusion 1.5 (INT8) per dispositivi a basso consumo. Il benchmark utilizza il motore di inferenza ottimale per ciascun sistema, garantendo risultati equi e comparabili.
La generazione di immagini si è dimostrata uno dei carichi di lavoro più performanti per Ryzen AI Halo. Nel benchmark Stable Diffusion 1.5 FP16, la piattaforma Halo ha ottenuto un punteggio complessivo di 937, contro i 725 dello Z2 Mini e i 648 dello ZBook Ultra, riducendo al contempo il tempo di generazione a 106.7 secondi, rispetto ai 137.8 e 154.2 secondi rispettivamente. Stable Diffusion XL ha mostrato un vantaggio altrettanto netto, con il sistema Halo che ha completato il test in 878.5 secondi, circa 174 secondi più veloce dello Z2 Mini e oltre 450 secondi più veloce dello ZBook Ultra. La piattaforma ha inoltre completato il benchmark Stable Diffusion 1.5 INT8 con un punteggio complessivo di 9,158, un carico di lavoro non disponibile su nessuno dei due sistemi di confronto HP.
| UL Procyon: generazione di immagini AI | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Diffusione stabile 1.5 (FP16) – Punteggio complessivo | 937 | 725 | 648 |
| Diffusione stabile 1.5 (FP16) – Tempo complessivo | 106.7 secondi | 137.815 secondi | 154.203 secondi |
| Diffusione stabile 1.5 (FP16) – Velocità di generazione delle immagini | 6.670 s/immagine | 8.613 s/immagine | 9.638 s/immagine |
| Diffusione stabile 1.5 (INT8) – Punteggio complessivo | 9,158 | N/A | N/A |
| Diffusione stabile 1.5 (INT8) – Tempo complessivo | 27.298 secondi | N/A | N/A |
| Diffusione stabile 1.5 (INT8) – Velocità di generazione delle immagini | 3.412 s/immagine | N/A | N/A |
| Stable Diffusion XL (FP16) – Punteggio complessivo | 682 | 570 | 451 |
| Diffusione stabile XL (FP16) – Tempo complessivo | 878.493 secondi | 1,052.468 secondi | 1,329.592 secondi |
| Stable Diffusion XL (FP16) – Velocità di generazione delle immagini | 54.906 s/immagine | 65.779 s/immagine | 83.100 s/immagine |
SPECworkstation 4
Il benchmark SPECworkstation 4.0 è uno strumento completo per valutare tutti gli aspetti chiave delle prestazioni delle workstation. Fornisce una misurazione reale delle prestazioni di CPU, grafica, acceleratore e disco, offrendo ai professionisti i dati necessari per prendere decisioni informate sui propri investimenti hardware. Il benchmark include una serie di test specifici per i carichi di lavoro di IA e ML, come attività di data science e test di inferenza basati su ONNX Runtime, a testimonianza della crescente importanza dell'IA/ML negli ambienti workstation. Copre sette settori verticali e quattro sottosistemi hardware, fornendo una misurazione dettagliata e pertinente delle prestazioni delle workstation odierne.
SPECworkstation 4 ha evidenziato le capacità di workstation bilanciate della piattaforma Ryzen AI Halo. Ha ottenuto i punteggi più alti nei settori Servizi finanziari (2.92), Media e intrattenimento (2.97), Progettazione di prodotti (2.22) e Produttività e sviluppo (1.27), superando sia l'HP Z2 Mini che l'HP ZBook Ultra in queste categorie. Lo Z2 Mini ha mantenuto un leggero vantaggio nei settori Energia (2.50 contro 2.35) e Scienze della vita (2.60 contro 2.33). Nel complesso, la piattaforma di riferimento Halo ha dimostrato prestazioni elevate in tutti i carichi di lavoro professionali del benchmark ed è rimasta competitiva in ogni categoria testata.
| SPECworkstation 4.0.0 (più alto è meglio) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S)
|
HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Energy | 2.35 | 2.50 | 2.20 |
| Servizi finanziari | 2.92 | 2.35 | 1.60 |
| Life Sciences | 2.33 | 2.60 | 2.20 |
| Media e intrattenimento | 2.97 | 2.22 | 1.90 |
| Product Design | 2.22 | 2.00 | 1.74 |
| Produttività e sviluppo | 1.27 | 1.00 | 1.03 |
Luxmark
Luxmark è un benchmark per GPU che utilizza LuxRender, un renderer ray-tracing open-source, per valutare le prestazioni di un sistema con scene 3D altamente dettagliate. Questo benchmark è utile per valutare le capacità di rendering grafico di server e workstation, soprattutto per applicazioni di effetti visivi e visualizzazione architettonica, dove una simulazione accurata dell'illuminazione è fondamentale.
I risultati di Luxmark hanno mostrato una separazione minima tra le tre piattaforme Ryzen AI Max+ 395. Il sistema di riferimento Halo ha ottenuto il punteggio Food più alto con 4,158, superando di poco lo Z2 Mini (3,943) e lo ZBook Ultra (3,915). Nel carico di lavoro Hallbench, ha ottenuto un punteggio di 8,014, leggermente inferiore agli 8,477 dello Z2 Mini ma superiore ai 7,833 dello ZBook Ultra. Nel complesso, i risultati suggeriscono che i sistemi basati sulla Radeon 8060S offrono prestazioni di ray-tracing molto simili indipendentemente dal fattore di forma.
| Luxmark (più alto è meglio) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Panchina | 8,014 | 8,477 | 7,833 |
| Alimentare - Food | 4,158 | 3,943 | 3,915 |
Compressione a 7 zip
Il benchmark di compressione 7-Zip valuta le prestazioni della CPU durante la compressione e la decompressione, misurandole in GIPS (Giga Istruzioni al Secondo) e in termini di utilizzo della CPU. Un valore di GIPS più elevato e un utilizzo efficiente della CPU indicano prestazioni superiori.
La piattaforma Ryzen AI Halo ha primeggiato in tutte le principali categorie del benchmark 7-Zip. Ha raggiunto un punteggio di compressione di 176.7 GIPS, rispetto ai 139.3 GIPS dell'HP Z2 Mini e ai 139.6 GIPS dello ZBook Ultra. Le prestazioni di decompressione sono rimaste altrettanto elevate, con 191.6 GIPS, superando i 164.0 GIPS dello Z2 Mini e i 174.0 GIPS dello ZBook Ultra. Complessivamente, la piattaforma Halo ha ottenuto il punteggio complessivo più alto, pari a 184.2 GIPS, superando i sistemi concorrenti di circa il 20% e dimostrando un'eccellente velocità di elaborazione di dati interi per i carichi di lavoro di creazione ed estrazione di archivi.
| Benchmark di compressione 7-Zip (più alto è, meglio è) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) | |||
|---|---|---|---|---|---|---|
| Compressione | ||||||
| Utilizzo attuale della CPU | 2,741% | 2,734% | 2,868% | |||
| Valutazione/utilizzo corrente | 6.370 GIPS | 5.136 GIPS | 4.883 GIPS | |||
| Corrente nominale | 174.589 GIPS | 140.405 GIPS | 140.061 GIPS | |||
| Utilizzo della CPU risultante | 2,751% | 2,718% | 2,855% | |||
| Valutazione/Utilizzo risultante | 6.424 GIPS | 5.126 GIPS | 4.890 GIPS | |||
| Valutazione risultante | 176.742 GIPS | 139.298 GIPS | 139.617 GIPS | |||
| decompressione | ||||||
| Utilizzo attuale della CPU | 2,568% | 2,343% | 2,904% | |||
| Valutazione/utilizzo corrente | 7.670 GIPS | 6.805 GIPS | 6.029 GIPS | |||
| Corrente nominale | 196.986 GIPS | 159.451 GIPS | 175.104 GIPS | |||
| Utilizzo della CPU risultante | 2,469% | 2,414% | 2,887% | |||
| Valutazione/Utilizzo risultante | 7.766 GIPS | 6.793 GIPS | 6.028 GIPS | |||
| Valutazione risultante | 191.645 GIPS | 163.969 GIPS | 174.046 GIPS | |||
| Valutazione totale | ||||||
| Utilizzo totale della CPU | 2,610% | 2,566% | 2,871% | |||
| Valutazione/utilizzo totale | 7.095 GIPS | 5.959 GIPS | 5.459 GIPS | |||
| Valutazione totale | 184.194 GIPS | 151.634 GIPS | 156.832 GIPS | |||
Benchmark del frullatore
Blender è un'applicazione open-source per la modellazione 3D. Questo benchmark è stato eseguito con l'utility Blender Benchmark. Il punteggio è misurato in campioni al minuto, dove valori più alti indicano prestazioni migliori.
Il rendering tramite CPU è stato un altro ambito in cui Ryzen AI Halo ha eccelso. Nella scena "Monster", ha raggiunto 244.7 campioni al minuto, superando HP Z2 Mini (224.3) e HP ZBook Ultra (189.3). Junkshop ha seguito con 159.4 campioni al minuto, contro 149.5 e 129.4, mentre Classroom ha completato con 131.6 campioni al minuto, superando Z2 Mini (116.3) di circa il 13% e ZBook Ultra (94.1) di quasi il 40%. Questi risultati dimostrano che Ryzen AI Max+ 395 offre eccellenti prestazioni di rendering multithread nonostante le sue dimensioni compatte da workstation.
| Blender Benchmark CPU (campioni al minuto, più alto è meglio è) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Mostro - Monster | 244.7 campioni/m | 224.3 campioni/m | 189.29 campioni/m |
| Rigattiere | 159.4 campioni/m | 149.5 campioni/m | 129.42 campioni/m |
| Aula | 131.6 campioni/m | 116.3 campioni/m | 94.14 campioni/m |
I risultati del rendering GPU sono stati molto simili tra i vari sistemi. La piattaforma di riferimento Halo ha renderizzato la scena del Mostro a 704.2 campioni al minuto, inferiore a quella dello Z2 Mini (745.6) ma superiore a quella dello ZBook Ultra (661.5). Per quanto riguarda Junkshop, le prestazioni sono risultate sostanzialmente identiche tra la piattaforma Halo (366.6) e lo Z2 Mini (366.5). Allo stesso tempo, il sistema Halo ha ottenuto il punteggio più alto in Classroom con 361.5 campioni al minuto, superando di poco lo Z2 Mini (359.0) e lo ZBook Ultra (333.3). I risultati indicano che la Radeon 8060S offre prestazioni di rendering GPU notevolmente costanti tra le diverse implementazioni.
| Blender Benchmark GPU (campioni al minuto, più alto è meglio è) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Mostro - Monster | 704.2 campioni/m | 745.55 campioni/m | 661.50 campioni/m |
| Rigattiere | 366.6 campioni/m | 366.54 campioni/m | 341.92 campioni/m |
| Aula | 361.51 campioni/m | 359.01 campioni/m | 333.26 campioni/m |
y-cruncher
y-cruncher è un programma multithread e scalabile in grado di calcolare Pi e altre costanti matematiche fino a trilioni di cifre decimali. Dal suo lancio nel 2009, è diventato un popolare strumento di benchmarking e stress test per overclocker e appassionati di hardware.
I risultati di y-cruncher si sono divisi in base alla dimensione del calcolo. Nei test da 1 miliardo e 2.5 miliardi di cifre, tutti e tre i sistemi hanno terminato con una differenza di pochi decimi di secondo, con i sistemi HP leggermente in vantaggio. Con l'aumentare del carico di lavoro, Halo ha preso il largo, completando il calcolo da 5 miliardi di cifre in 71.948 secondi, rispetto ai 75.021 secondi dello Z2 Mini e ai 78.19 secondi dello ZBook Ultra. Con 10 miliardi di cifre, Halo ha terminato in 151.409 secondi, circa il 6% in meno dello Z2 Mini e il 12% in meno dello ZBook Ultra, il che suggerisce che lo chassis desktop gestisce meglio carichi di lavoro multithread pesanti con tempi di esecuzione prolungati.
| Y-Cruncher (tempo di calcolo totale) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 1 Billion | 13.193 secondi | 12.965 secondi | 12.93 secondi |
| 2.5 Billion | 34.578 secondi | 34.533 secondi | 34.91 secondi |
| 5 Billion | 71.948 secondi | 75.021 secondi | 78.19 secondi |
| 10 Billion | 151.409 secondi | 160.252 secondi | 171.72 secondi |
Geekbench 6
Geekbench 6 è un benchmark multipiattaforma che misura le prestazioni complessive del sistema.
Geekbench 6 ha confermato il profilo prestazionale equilibrato della piattaforma Halo. Ha ottenuto il punteggio single-core più alto, pari a 2,986, superando HP Z2 Mini (2,862) e ZBook Ultra (2,825). Anche le prestazioni multi-core si sono posizionate al primo posto con 18,068. La Radeon 8060S ha registrato il punteggio OpenCL GPU più alto, pari a 92,883, superando di poco Z2 Mini (91,591) e nettamente ZBook Ultra (85,337). I costanti primati nei test di CPU e GPU dimostrano le prestazioni complete della piattaforma Ryzen AI Max+ 395.
| Geekbench 6 (più alto è meglio) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| CPU single-core | 2,986 | 2,862 | 2,825 |
| CPU multicore | 18,068 | 17,210 | 17,562 |
| OpenCL GPU | 92,883 | 91,591 | 85,337 |
Cinebench R23
Cinebench R23 è un benchmark ampiamente riconosciuto per la valutazione delle prestazioni delle CPU nei carichi di lavoro di rendering 3D. Basato sul motore Cinema 4D, misura l'efficienza di un processore nella gestione di attività single-thread e multi-thread, offrendo informazioni sulla reattività complessiva e sulle capacità di elaborazione parallela.
Cinebench R23 ha mostrato una competizione molto serrata tra le due implementazioni desktop del Ryzen AI Max+ 395. La piattaforma di riferimento Halo ha registrato un punteggio multi-core di 37,316, superando di poco i 37,156 dell'HP Z2 Mini, mentre entrambe hanno nettamente surclassato i 29,112 dell'HP ZBook Ultra. Le prestazioni single-core hanno seguito lo stesso andamento, con la piattaforma Halo che ha ottenuto un punteggio di 2,047, contro i 2,020 dello Z2 Mini e i 1,984 dello ZBook Ultra. Sebbene i margini rispetto allo Z2 Mini fossero minimi, il sistema Halo si è costantemente posizionato ai vertici del benchmark.
| Cinebench R23 (Più alto è meglio è) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Multi-Core | 37,316 | 37,156 | 29,112 |
| Single core | 2,047 | 2,020 | 1,984 |
Cinebench 2024
Cinebench 2024 si basa sulle fondamenta gettate da R23, introducendo test di rendering basati sulla GPU pur mantenendo la sua attenzione sulle prestazioni della CPU. In questa sezione, esaminiamo solo i punteggi della CPU, che offrono informazioni aggiornate su come ciascun sistema gestisce le moderne attività di rendering 3D.
Il più recente benchmark Cinebench 2024 ha rispecchiato i risultati di R23. Ryzen AI Halo ha registrato il punteggio multi-core più alto con 1,916, leggermente superiore all'HP Z2 Mini (1,906) e mantenendo un vantaggio considerevole sull'HP ZBook Ultra (1,579). Anche le prestazioni single-core hanno favorito la piattaforma Halo, con 116 punti rispetto ai 112 dello Z2 Mini e ai 111 dello ZBook Ultra. Sebbene le differenze tra i sistemi desktop siano rimaste minime, i risultati confermano la capacità del Ryzen AI Max+ 395 di offrire costantemente prestazioni di rendering della CPU di altissimo livello.
| Cinebench 2024 (Più alto è, meglio è) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Multi-Core | 1,916 | 1,906 | 1,579 |
| Single core | 116 | 112 | 111 |
Benchmark Phoronix
Phoronix Test Suite è una piattaforma di benchmarking automatizzata open-source che supporta oltre 450 profili di test e più di 100 suite di test tramite OpenBenchmarking.org. Gestisce ogni fase, dall'installazione delle dipendenze all'esecuzione dei test e alla raccolta dei risultati, risultando ideale per confronti di prestazioni, validazione hardware e integrazione continua. Analizzeremo le prestazioni nei test Stream, 7-Zip e LLVM.
Analizzando la suite di benchmark Phoronix, abbiamo osservato una divisione abbastanza equilibrata tra la piattaforma AMD Ryzen AI Halo e NVIDIA DGX Spark. Il sistema Ryzen AI Halo ha costantemente primeggiato nei carichi di lavoro incentrati sulla CPU, superando DGX Spark dell'11% nella compressione 7-Zip, del 38% nella decompressione 7-Zip e completando il test di compilazione LLVM il 14% più velocemente. DGX Spark, d'altro canto, ha mostrato una maggiore larghezza di banda di memoria sostenuta, superando i test STREAM Scale, Triad e Add rispettivamente del 17%, 13% e 15%. Halo ha mantenuto un vantaggio del 18% nel benchmark STREAM Copy, a dimostrazione del fatto che, sebbene entrambi i sistemi siano altamente performanti, la piattaforma Ryzen AI Halo privilegia le prestazioni di calcolo generiche, mentre DGX Spark dimostra un throughput superiore nei carichi di lavoro focalizzati sulla larghezza di banda di memoria.
| Test | AMD Ryzen AI Halo | Scheda grafica NVIDIA DGX Spark | Vincitore |
|---|---|---|---|
| Compressione 7-Zip (MIPS) | 186,921 | 169,052 | Halo (+11%) |
| Decompressione 7-Zip (MIPS) | 146,109 | 106,084 | Halo (+38%) |
| Copia STREAM (MB/s) | 145,363 | 123,730 | Halo (+18%) |
| Scala STREAM (MB/s) | 110,611 | 128,970 | Scintilla (+17%) |
| Triade STREAM (MB/s) | 107,105 | 121,433 | Scintilla (+13%) |
| STREAM Aggiungi (MB/s) | 107,022 | 122,815 | Scintilla (+15%) |
| Compilazione LLVM (tempo impiegato, secondi) | 431.8 | 504.3 | Halo (14% più veloce) |
Benchmark delle prestazioni FIO
Per misurare le prestazioni di archiviazione in base ai parametri standard del settore, utilizziamo fio. Il nostro test SSD tradizionale precondiziona ciascuna unità con due cicli di riempimento completi come unità secondaria; in questo caso, abbiamo testato ciascuna unità direttamente nel sistema, tramite il filesystem. In precedenza, abbiamo testato i sistemi NVIDIA con GDSIO, ma AMD non offre un test di archiviazione diretto alla GPU paragonabile, quindi l'esecuzione di fio a livello di filesystem su entrambe le piattaforme le pone sullo stesso piano, il che è più importante rispetto al benchmarking delle singole unità.
Sia la NVIDIA DGX Spark (Founders Edition) che l'AMD Ryzen AI Halo sono dotati di un'unità PCIe Gen5, quindi sulla carta le due piattaforme hanno limiti identici per la larghezza di banda grezza dell'unità. In pratica, tuttavia, l'unità dell'Halo funziona a velocità di collegamento PCIe Gen4 in questo sistema, il che limita la larghezza di banda disponibile ben al di sotto di quella di cui l'unità stessa è capace. È importante tenere presente questa limitazione della velocità di collegamento nel corso di questa sezione, poiché rappresenta una parte significativa del divario di larghezza di banda tra le due piattaforme.
In questa sezione ci concentreremo sui seguenti benchmark FIO:
- Sequenziale 128K
- 64K casuale
- Sequenziale 16K
- 16K casuale
- 4K casuale
Lettura sequenziale 128K
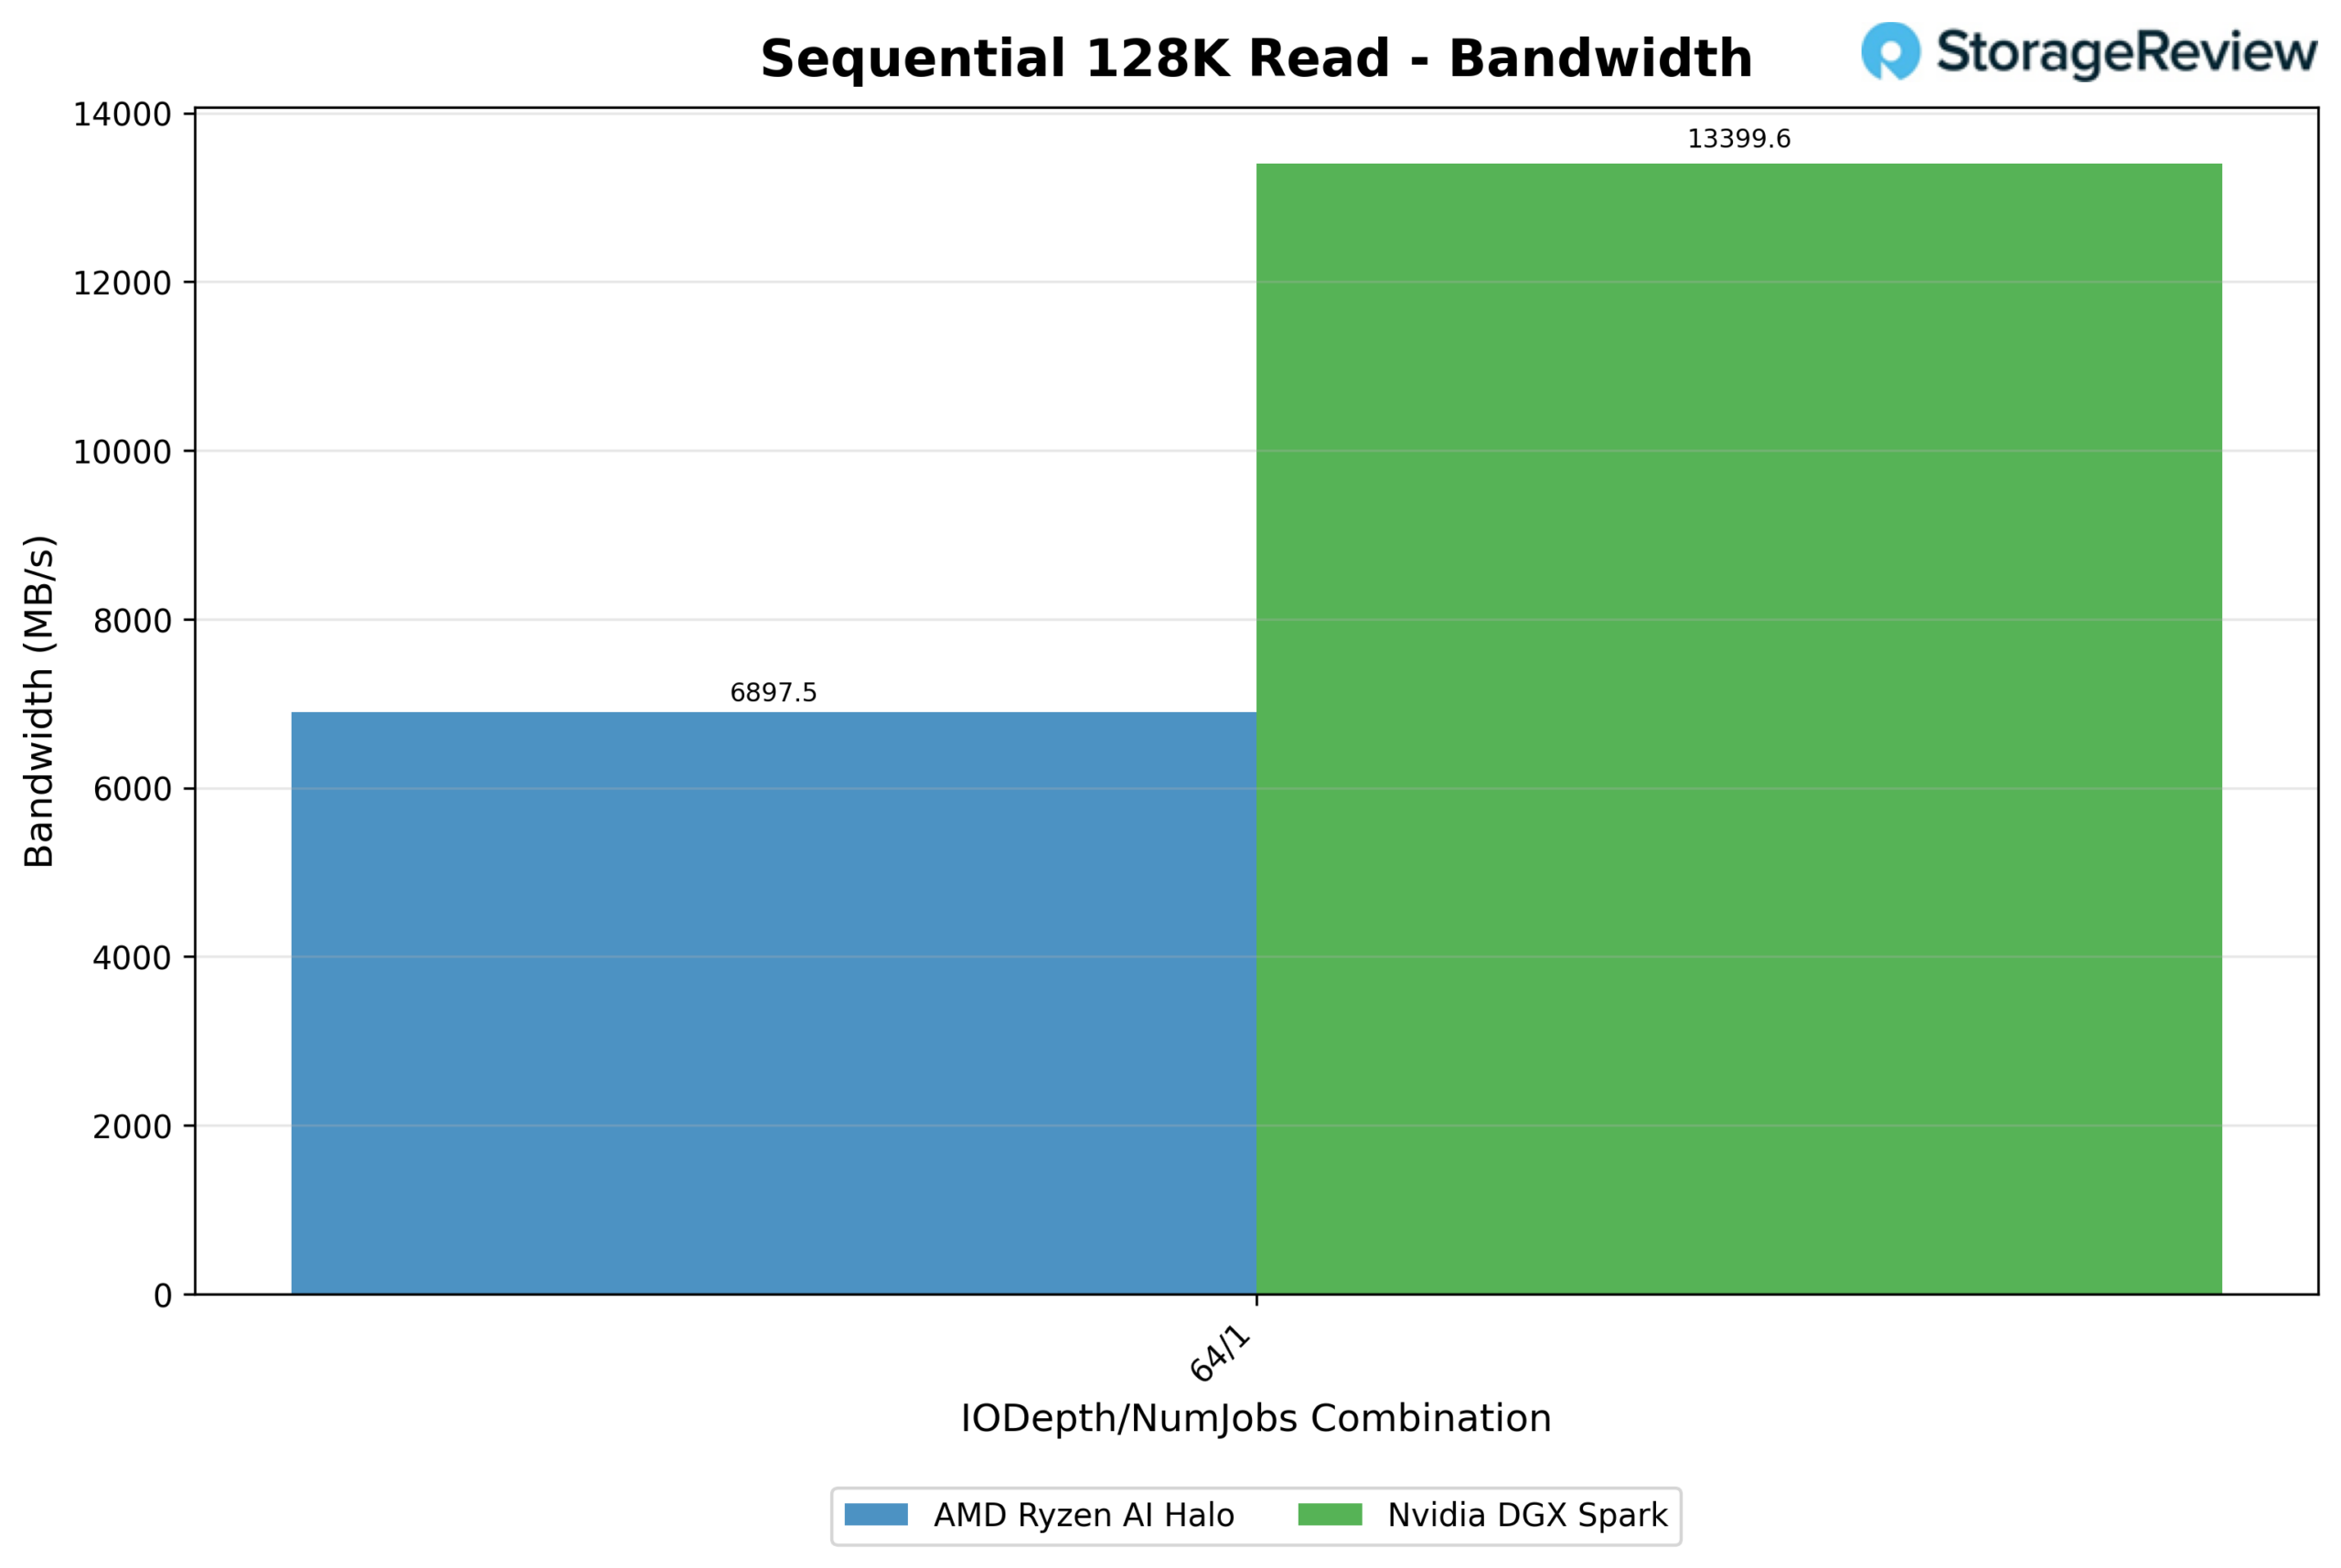
In una lettura sequenziale a singolo thread con coda profonda da 128K (64/1), NVIDIA DGX Spark ha registrato 13,399.6 MB/s, quasi il doppio dei 6,897.5 MB/s di AMD Ryzen AI Halo. La latenza ha seguito lo stesso andamento: la latenza media di Spark a questa profondità era di 0.597 ms, mentre Halo era indietro con 1.159 ms, quasi il doppio più lento per richiesta nonostante spostasse la metà dei dati. Questo è il divario più evidente nell'intero test, il che suggerisce che lo stack di storage di Spark è progettato per una maggiore velocità di trasmissione sequenziale sostenuta a questa dimensione di blocco.
Scrittura sequenziale 128K
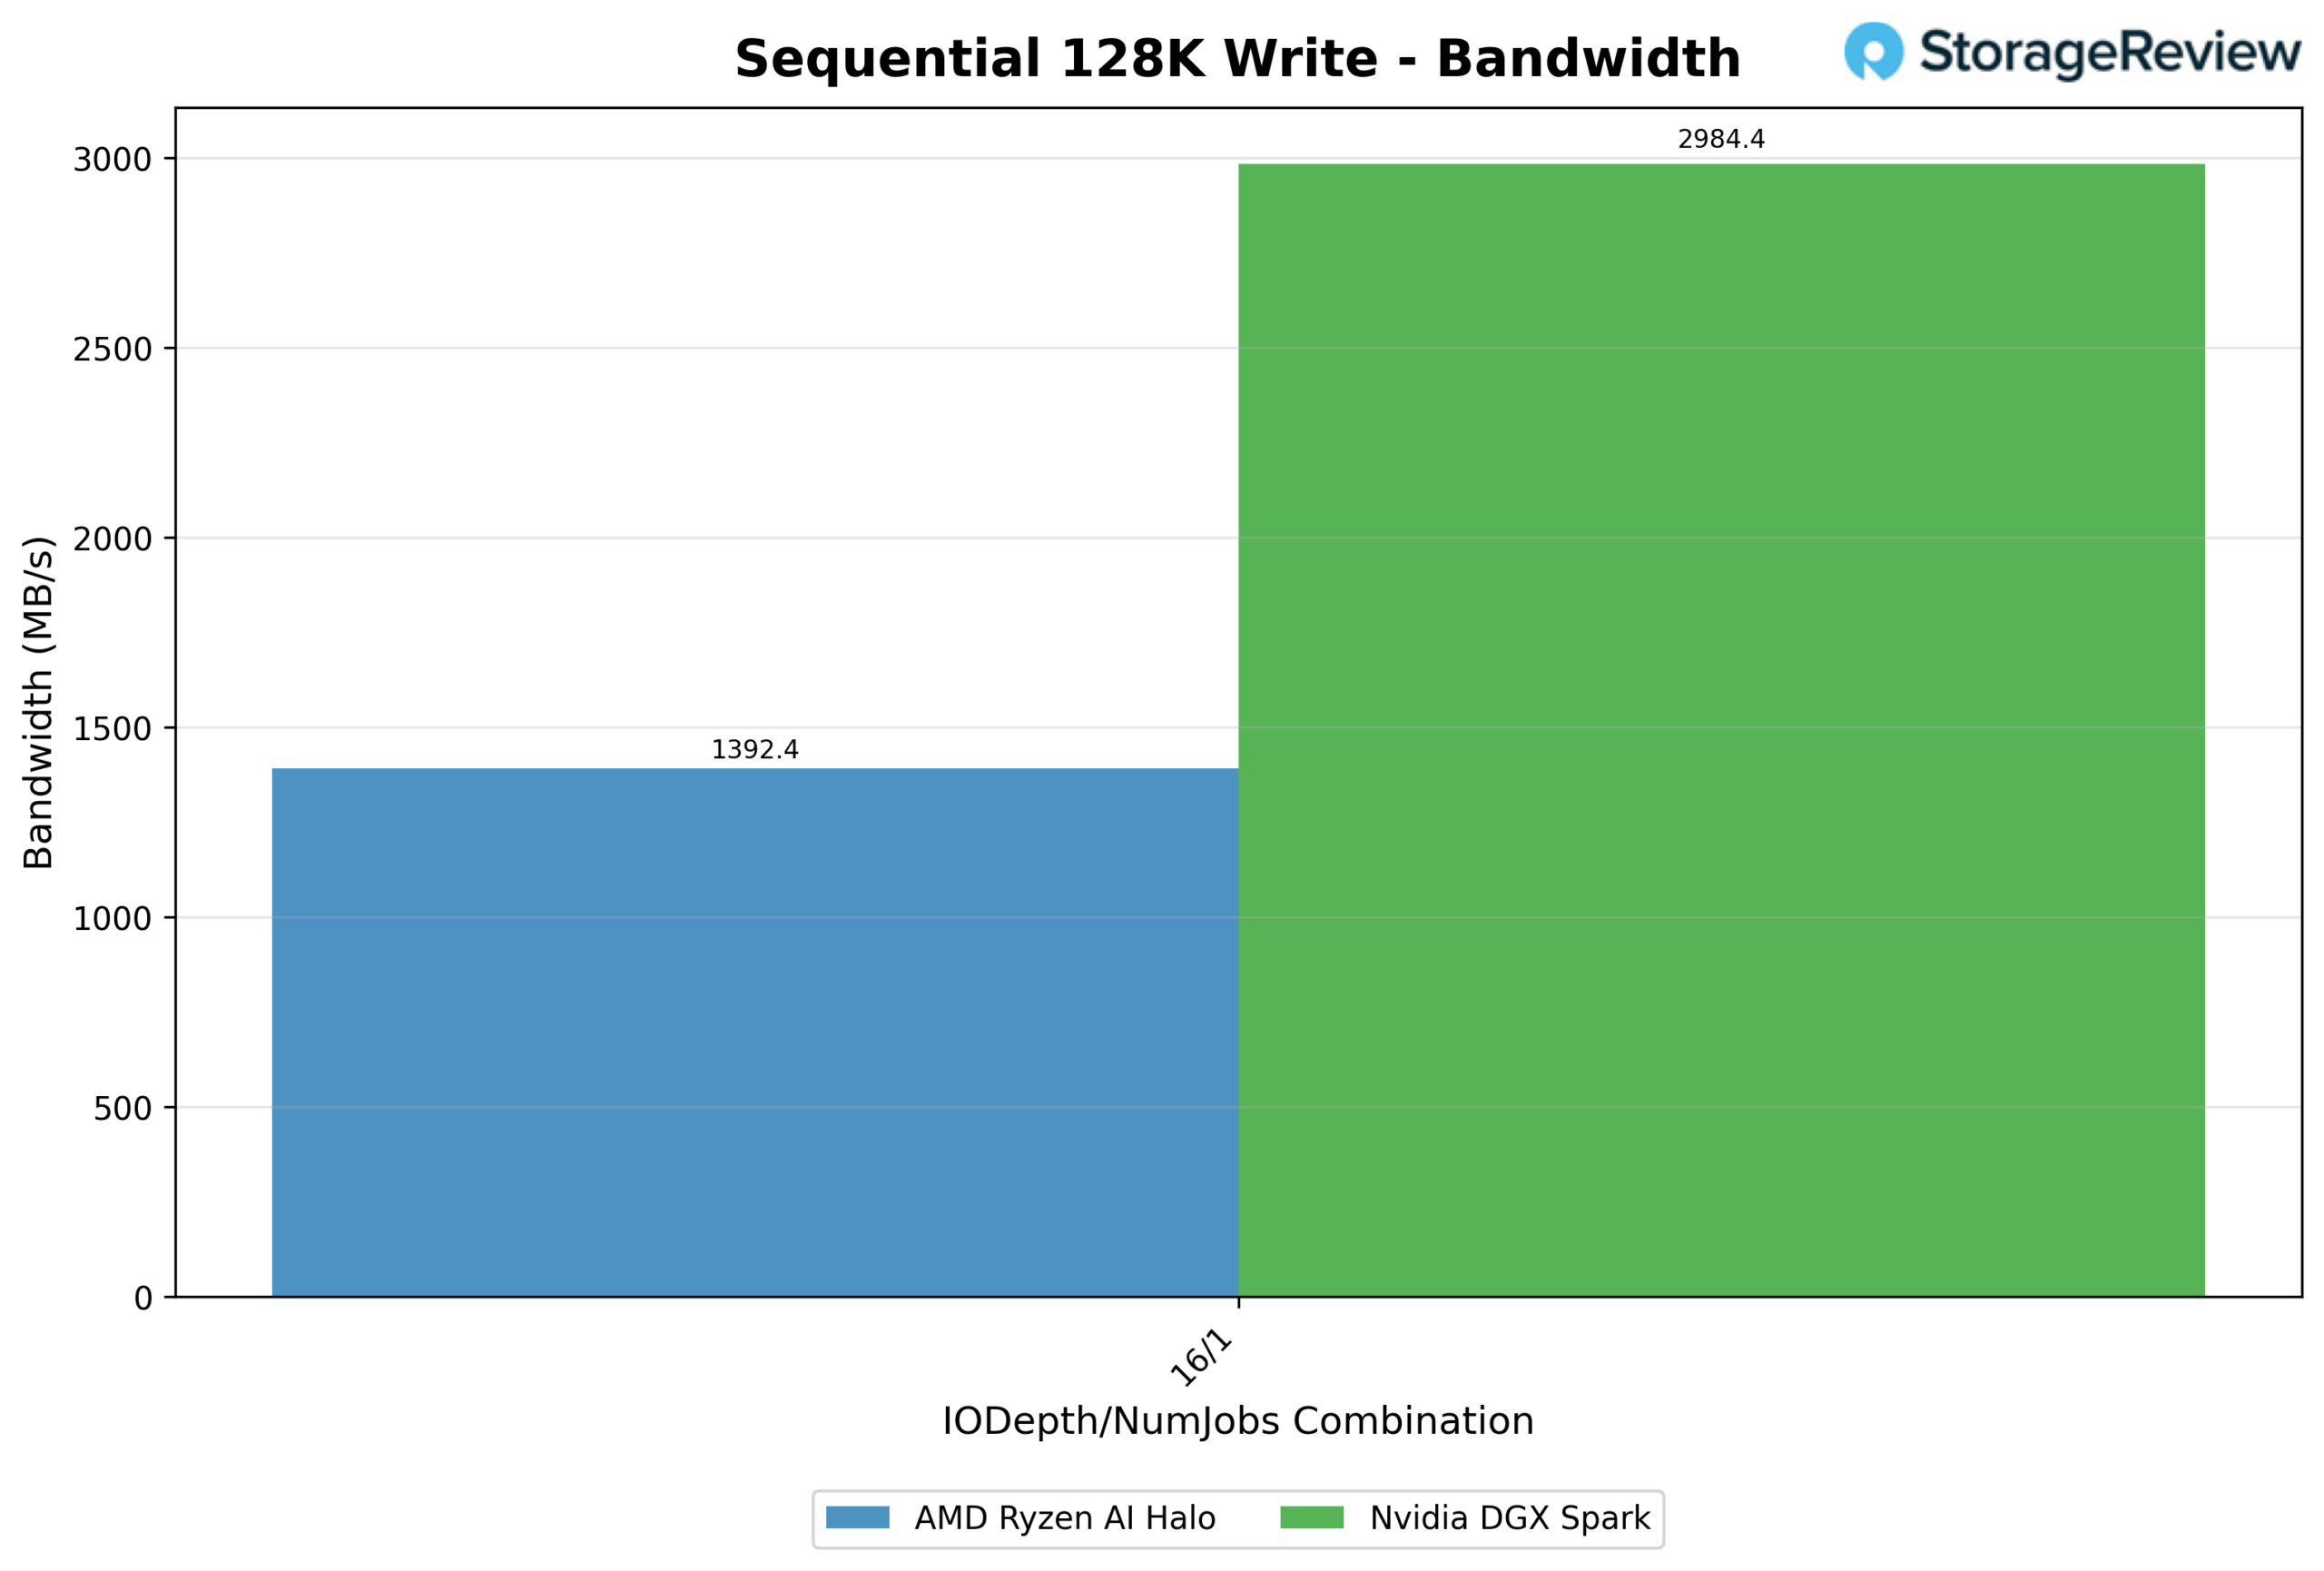
Anche i risultati in scrittura sono simili. Con IODepth 16/1, Spark ha raggiunto 2,984.4 MB/s, contro i 1,392.4 MB/s di Halo, con un vantaggio del 114% per NVIDIA. Anche la latenza ha favorito Spark, con 0.67 ms contro gli 1.436 ms di Halo. Considerando anche i risultati in lettura, la velocità sequenziale di 128K rappresenta di gran lunga la migliore prestazione di Spark rispetto a Halo.
Lettura casuale 64K
È qui che emerge il vantaggio di Halo in termini di latenza a bassa profondità di coda. Con un rapporto 1/1, Halo ha risposto in soli 0.051 ms, contro gli 0.275 ms di Spark, oltre 5 volte più velocemente per una singola richiesta in sospeso. Questo divario si mantiene anche con profondità di coda da basse a medie, con Halo che si attesta ben al di sotto di 0.2 ms mentre Spark si mantiene nell'intervallo 0.2-0.45 ms per la maggior parte del test.
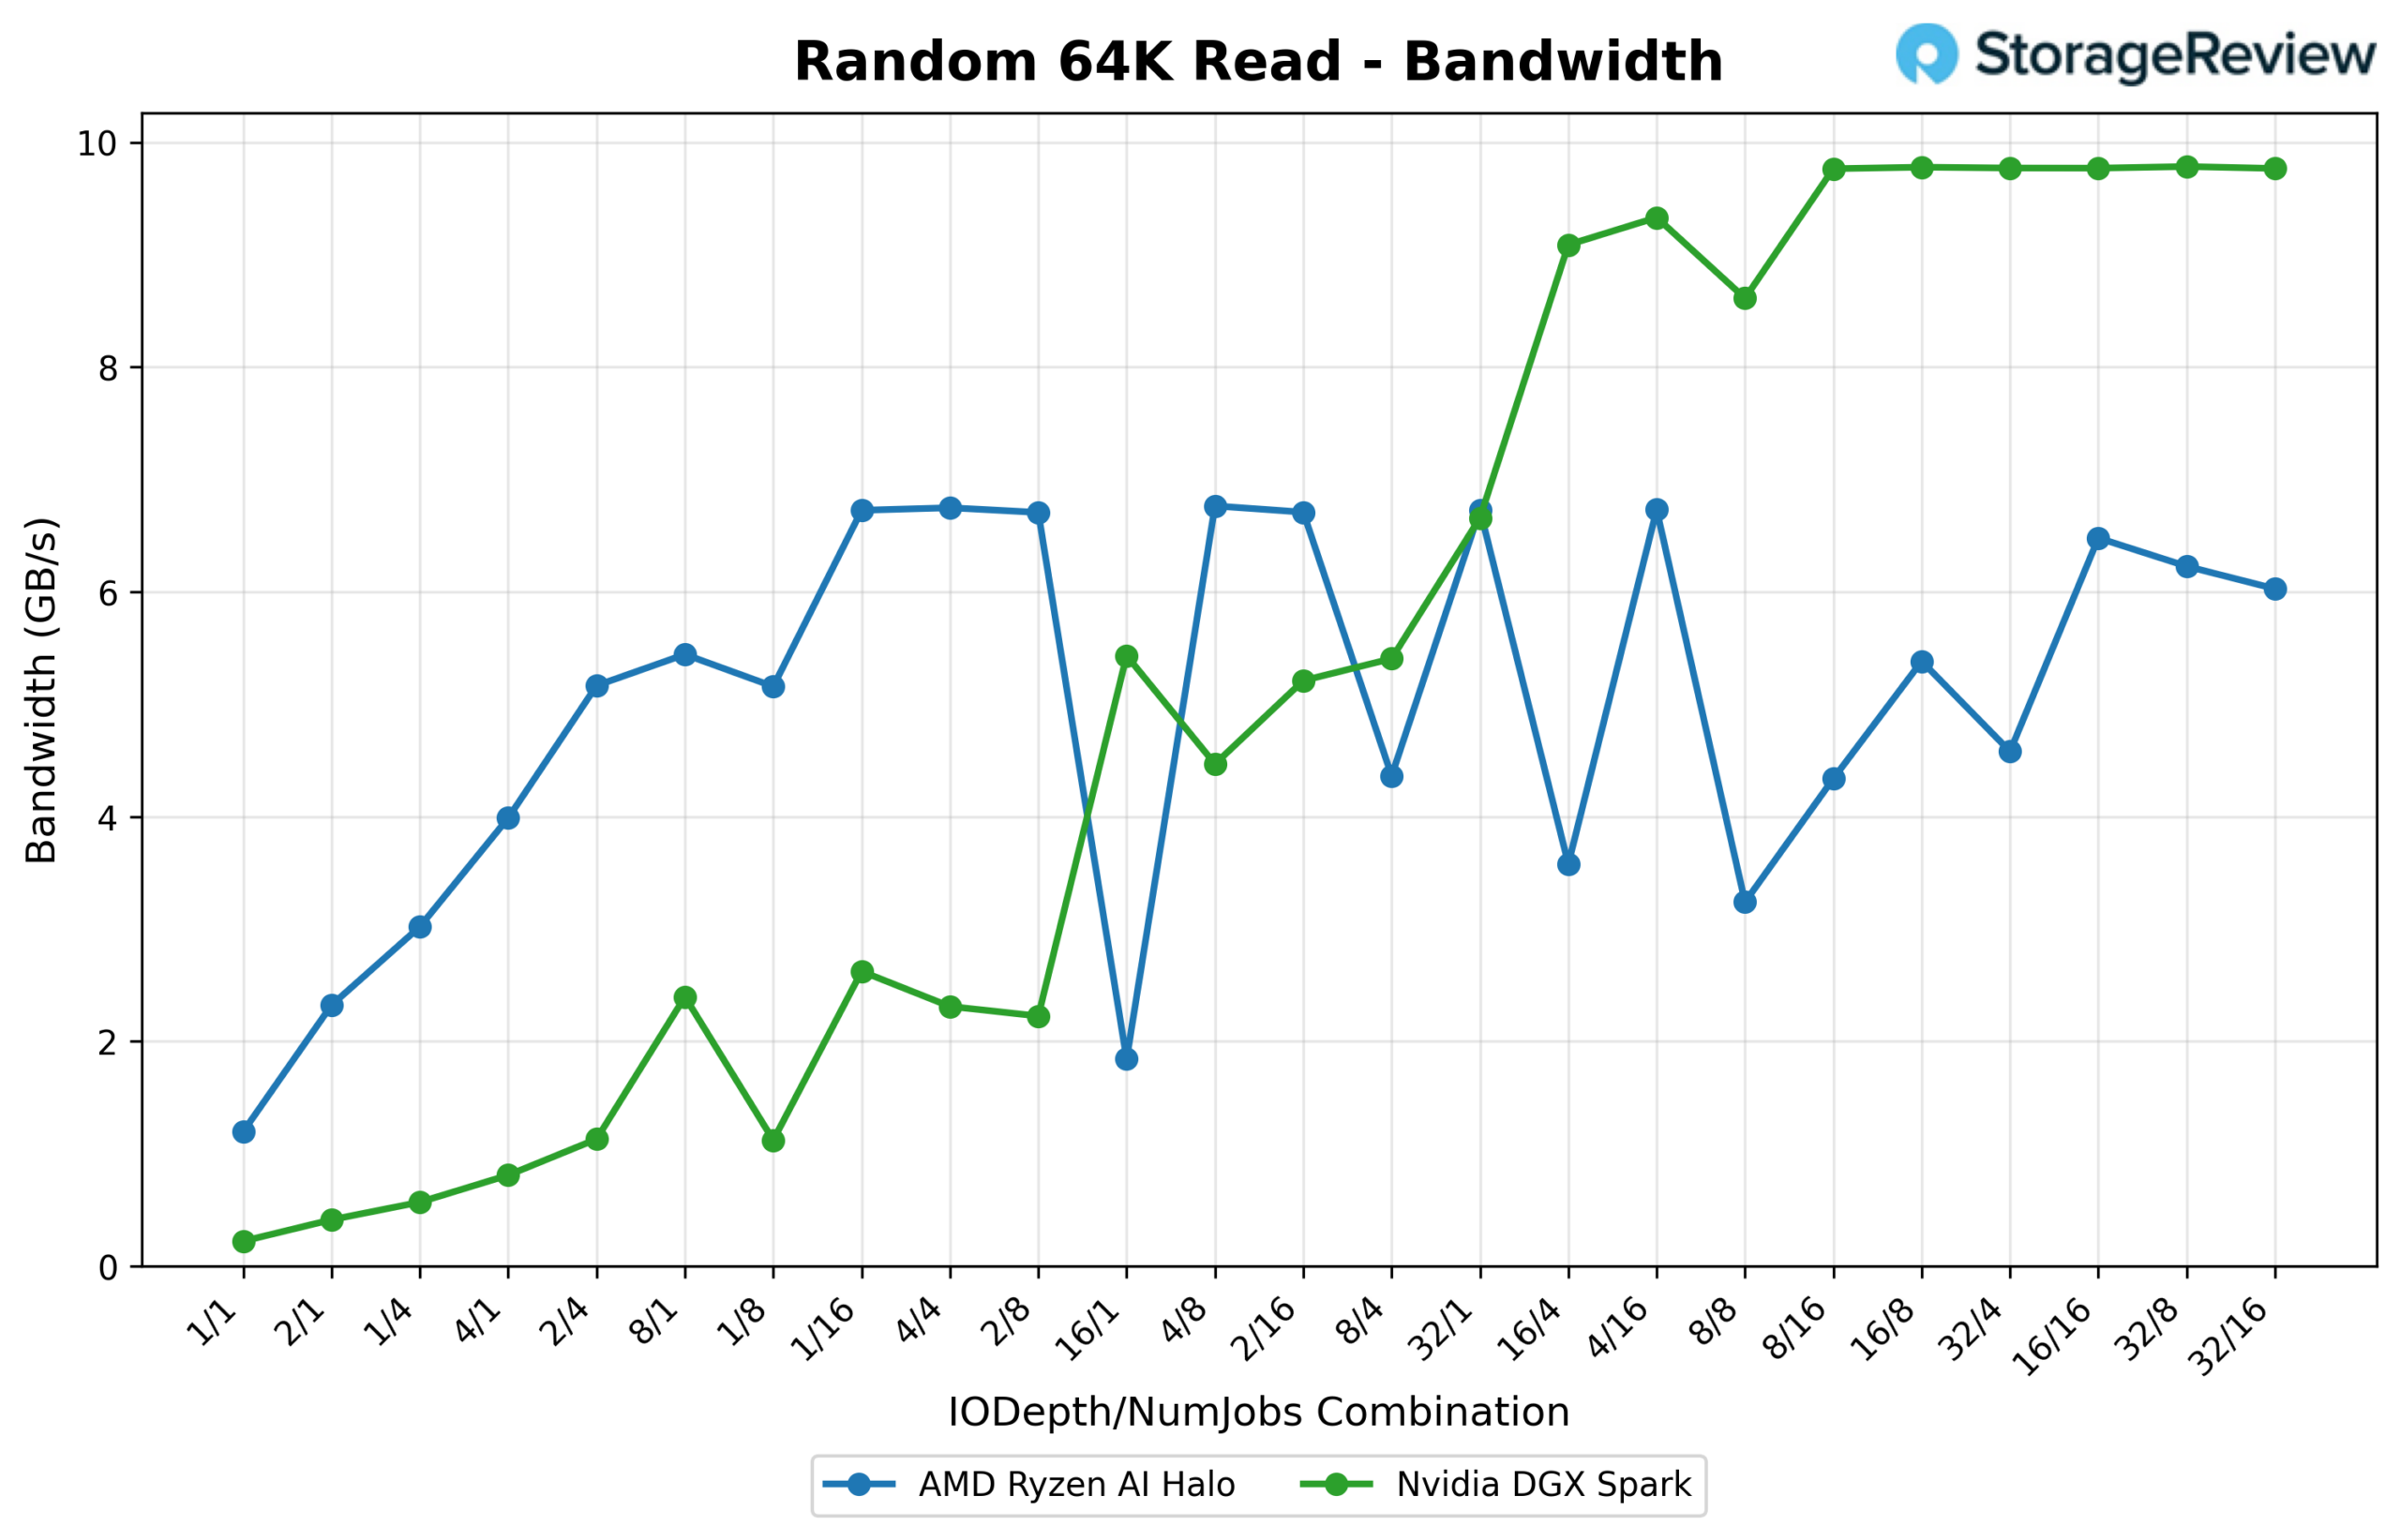
La situazione si ribalta però quando si aumenta la scala. Quando la profondità della coda e il numero di thread superano all'incirca 16/4, la larghezza di banda di Spark si discosta e si stabilizza intorno ai 9.8 GB/s da 8/16 in poi, raggiungendo un picco di 10,019.1 MB/s (160.3 IOPS) a 32/8. Halo non raggiunge mai quel limite: si satura nell'intervallo 6.0-6.9 GB/s, con un picco di 6,926.5 MB/s (110.8 IOPS) a 4/8. La sua curva di larghezza di banda è notevolmente più irregolare, con un andamento a dente di sega tra circa 2 e 6.8 GB/s a seconda della combinazione profondità/thread, anziché crescere in modo uniforme.
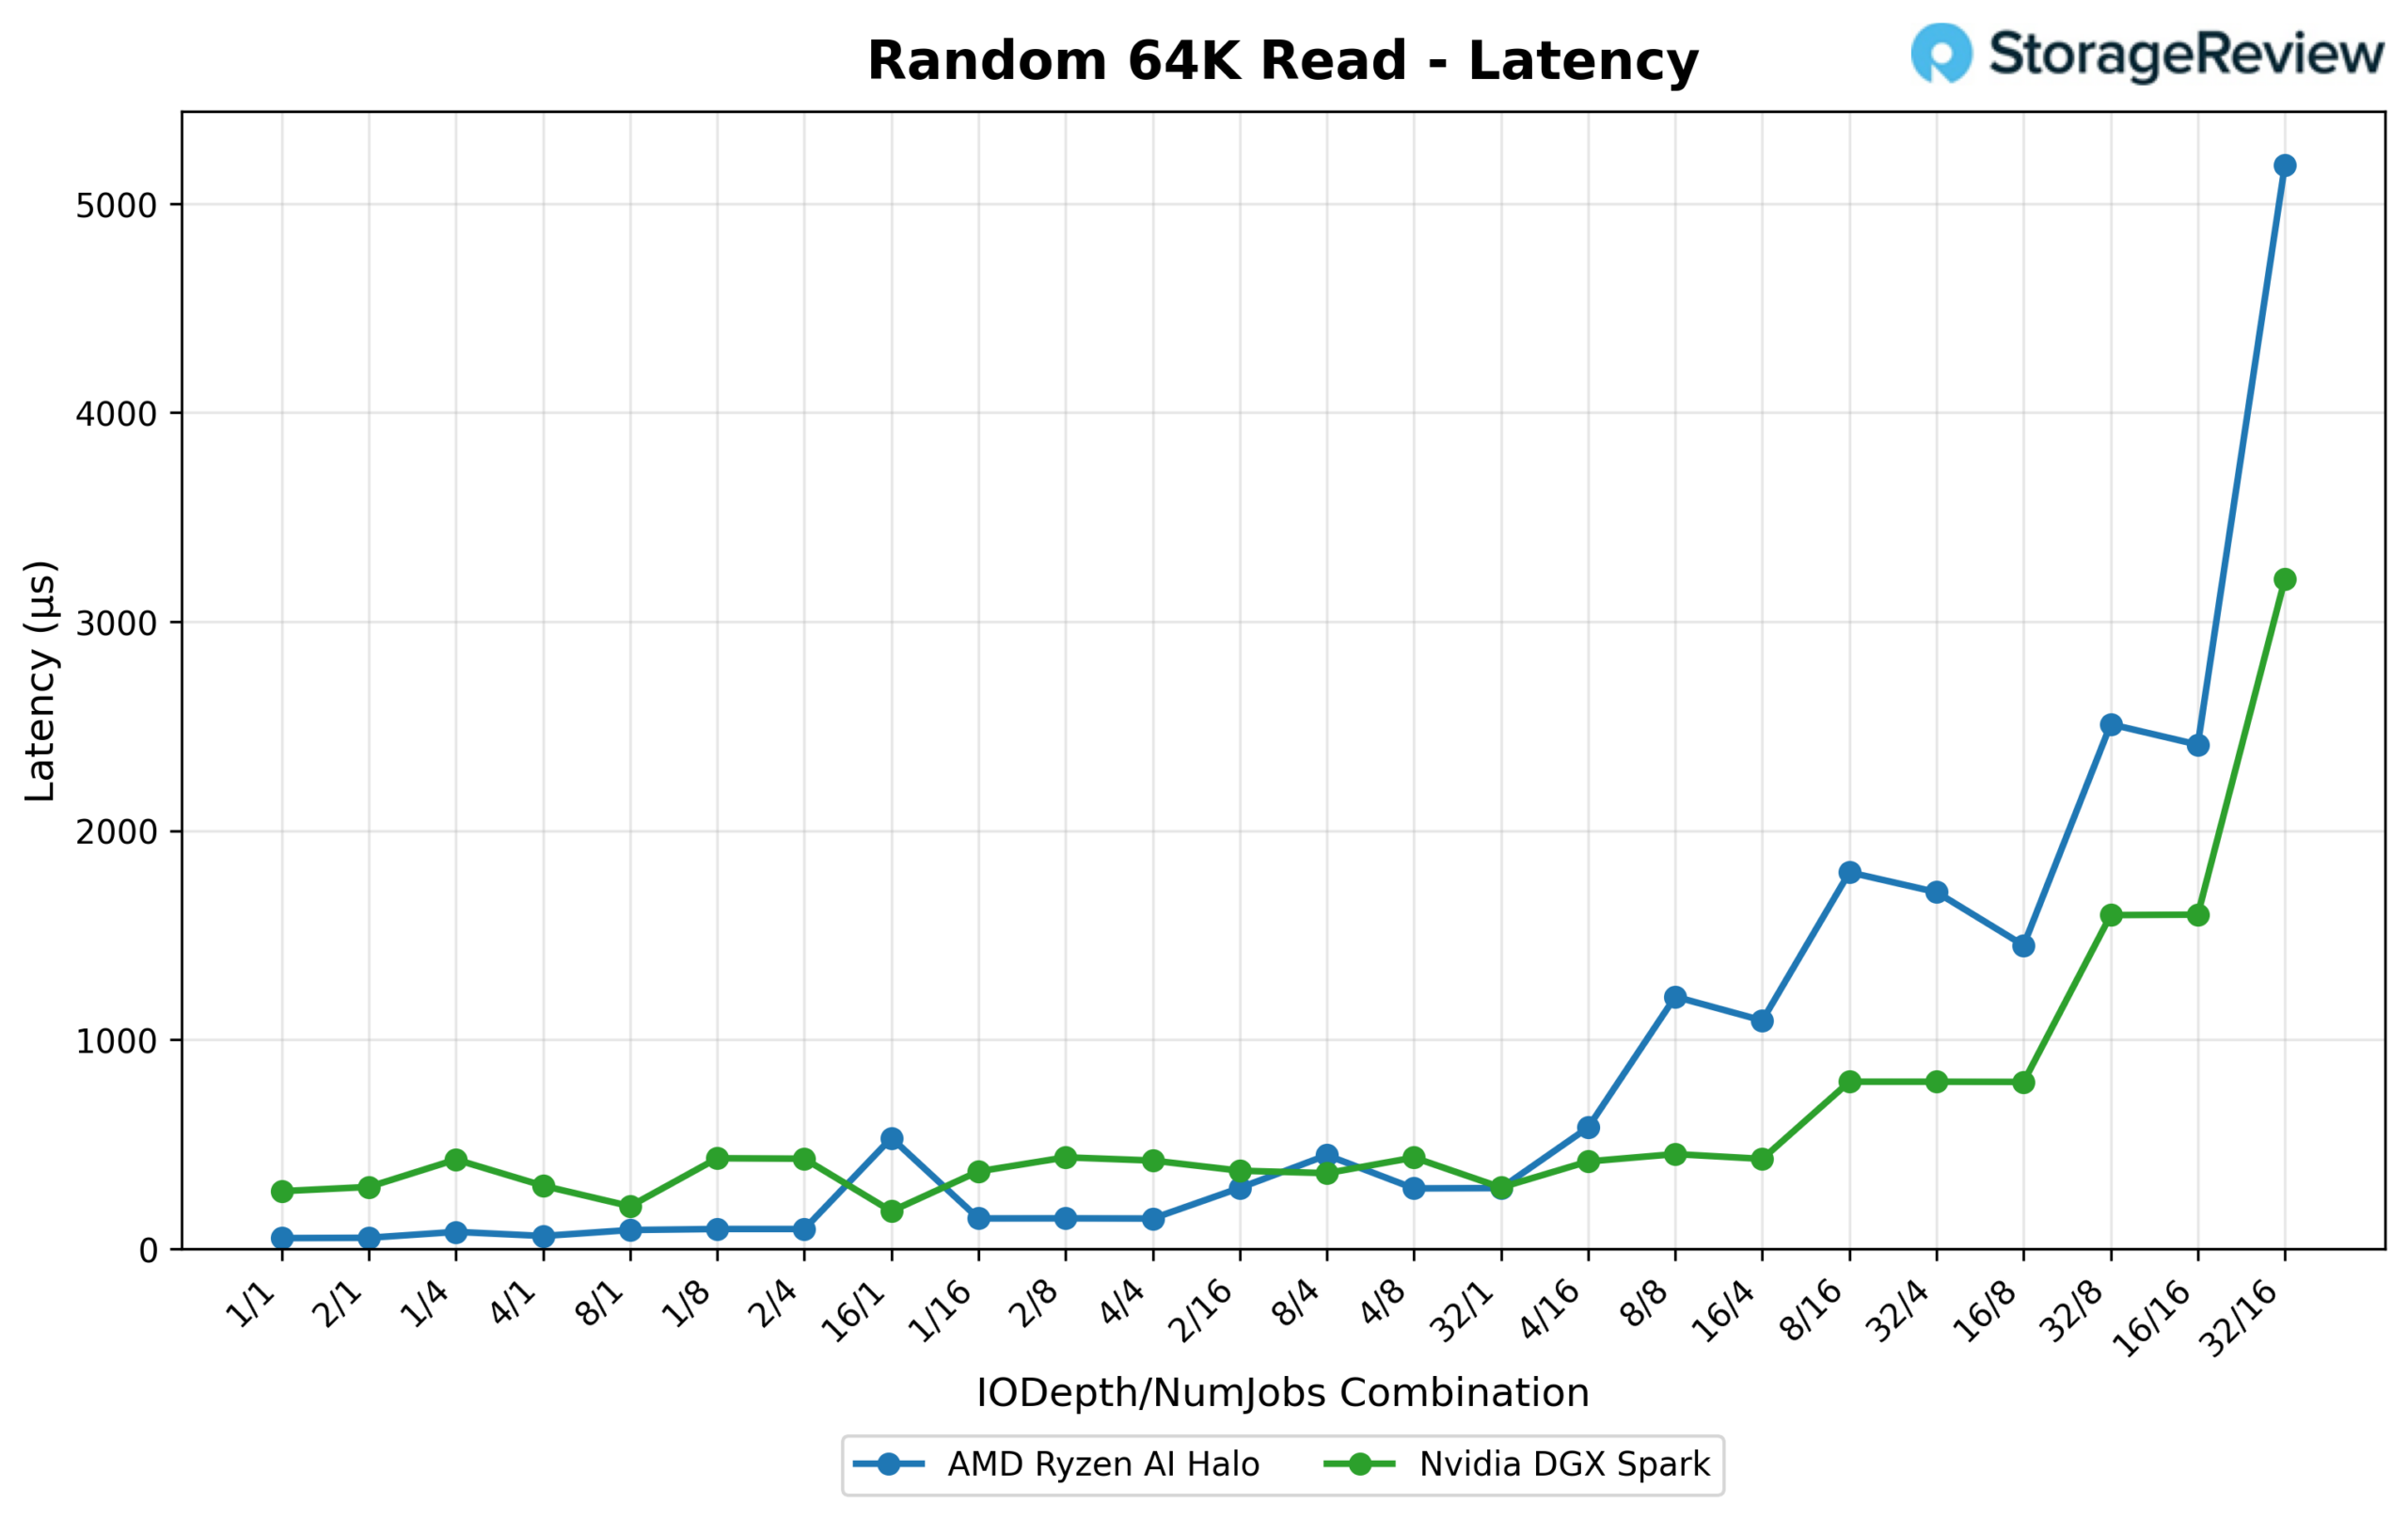
Anche la latenza a piena saturazione gioca a favore di Spark: a 32/16, la latenza media di Halo sale a 5.185 ms, rispetto ai 3.204 ms di Spark, il che significa che Halo paga la sua reattività a bassa profondità di coda con un comportamento peggiore una volta che la coda è completamente carica.
Scrittura casuale 64K
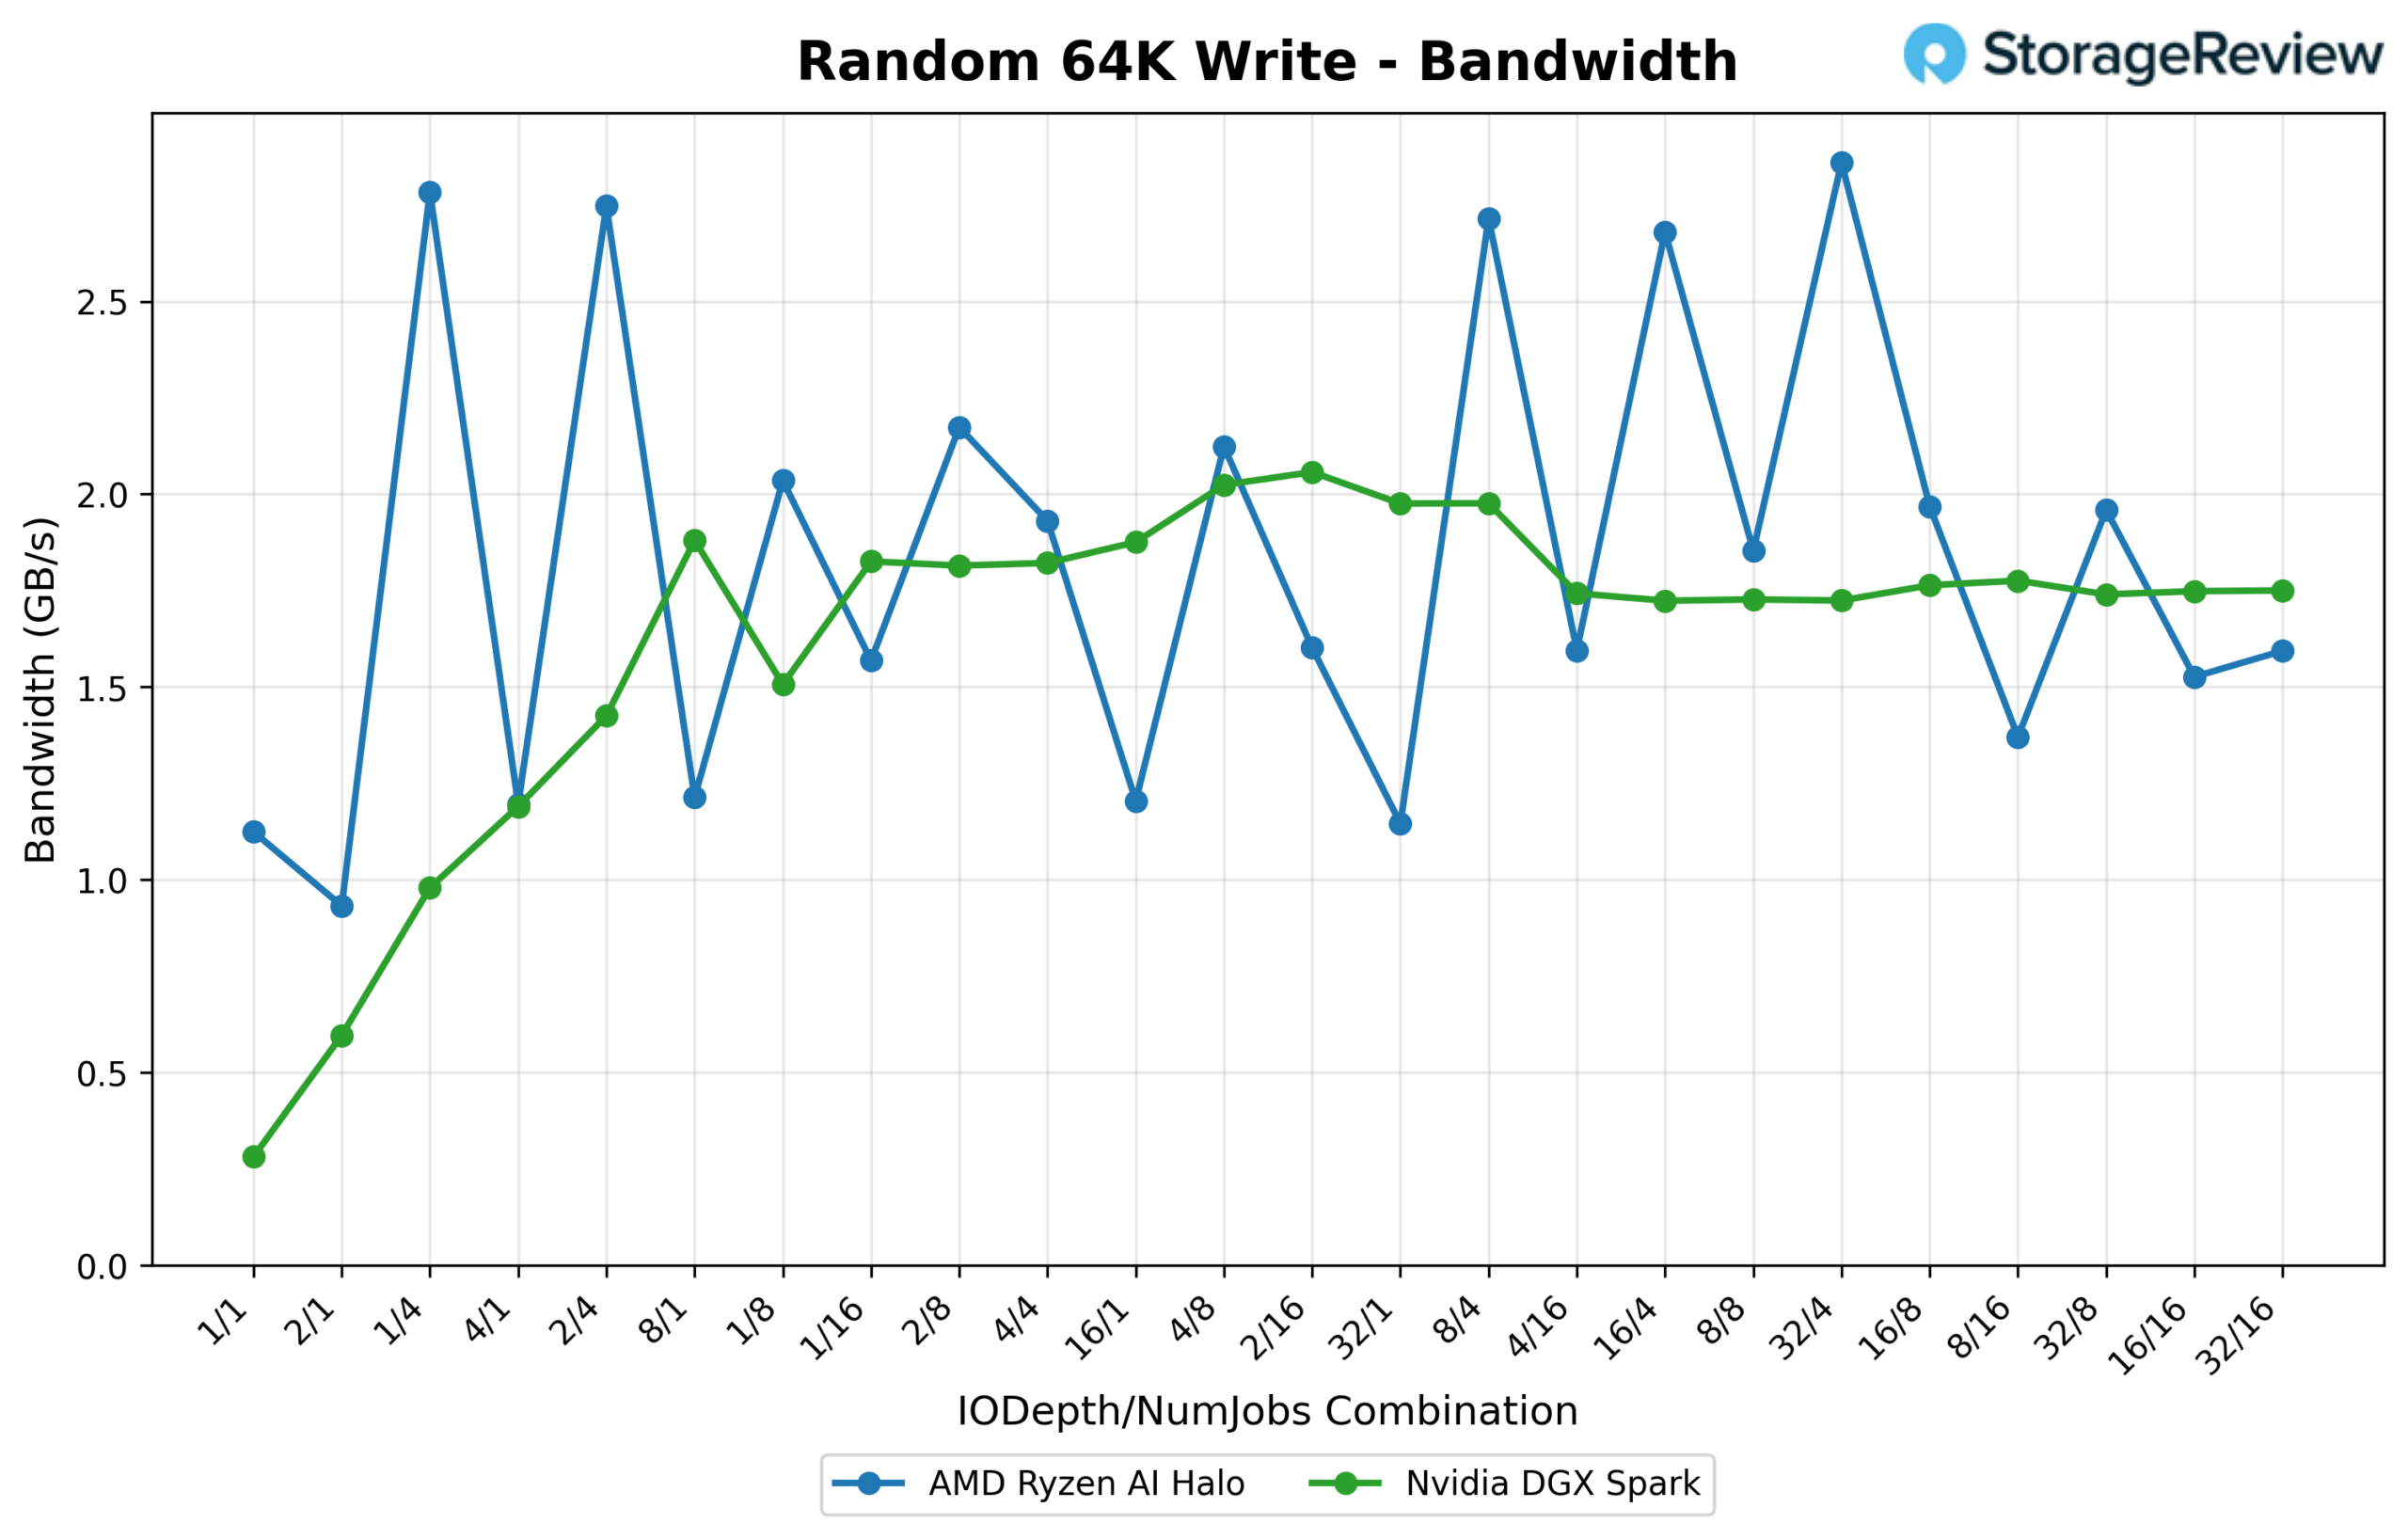
La larghezza di banda di scrittura casuale a 64K è più simile tra le due piattaforme rispetto alla larghezza di banda di lettura, sebbene la forma delle curve sia molto diversa. La larghezza di banda di Halo è più irregolare: salta ripetutamente sopra i 2.5 GB/s (con un picco di 2,929.1 MB/s / 46.9 IOPS a 32/4) prima di ridiscendere nell'intervallo 1.1-1.5 GB/s nelle combinazioni adiacenti. Spark è relativamente più stabile, assestandosi in una fascia 1.7-2.0 GB/s per la maggior parte della scansione e raggiungendo un picco di 2,106.6 MB/s (33.7 IOPS) a 2/16.
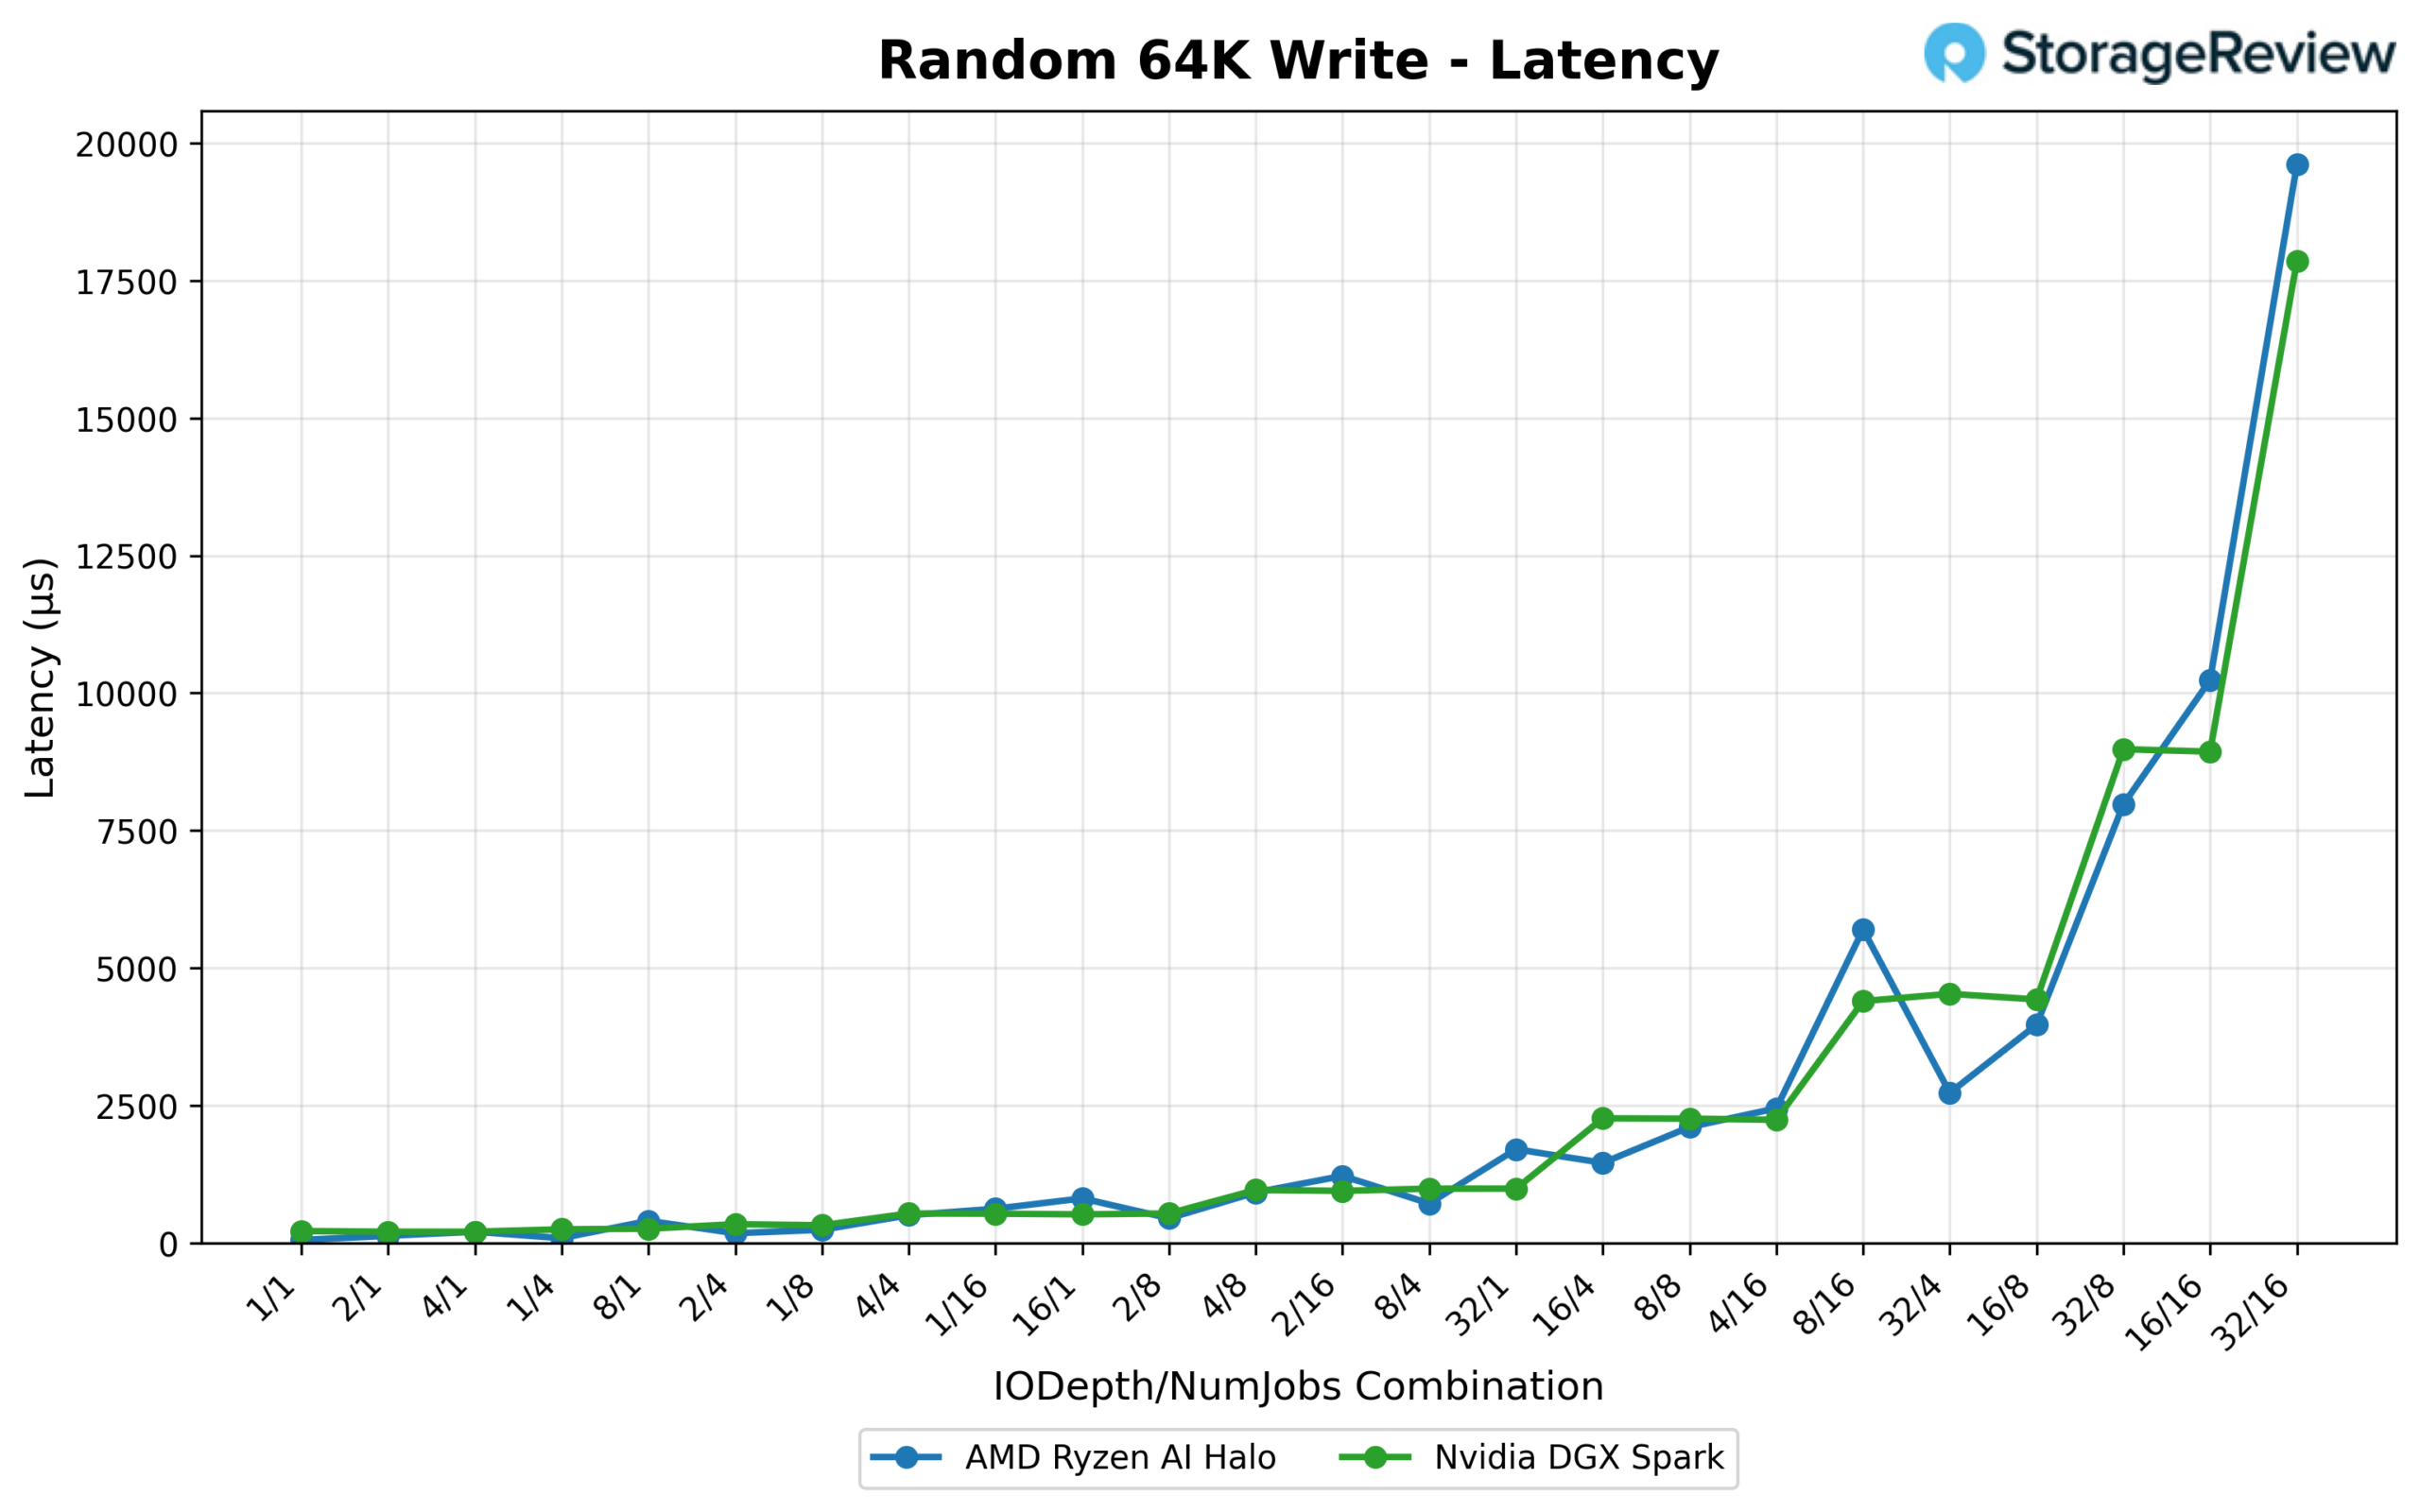
La latenza rispecchia il modello di lettura a 64K: l'Halo è nettamente più veloce a bassa profondità di coda (0.054 ms a 1/1 contro 0.217 ms per lo Spark), ed entrambe le unità subiscono un brusco calo di prestazioni all'aumentare della profondità di coda e del numero di thread, che raggiungono valori a due cifre. A piena saturazione (32/16), la latenza dell'Halo raggiunge i 19.611 ms, rispetto ai 17.857 ms dello Spark. Entrambe le unità sono chiaramente sottoposte a un forte stress di amplificazione della scrittura a questo punto, con l'Halo leggermente peggiore nella parte più alta della curva.
Lettura sequenziale 16K
La larghezza di banda rimane elevata per la maggior parte del test, con entrambe le unità che oscillano tra circa 1 e 8 GB/s a seconda della combinazione profondità/thread. Spark raggiunge il picco più alto, toccando 8,069.3 MB/s (516.4 IOPS) a 32/1, mentre Halo arriva a 6,715.8 MB/s (429.8 IOPS) a 8/4.
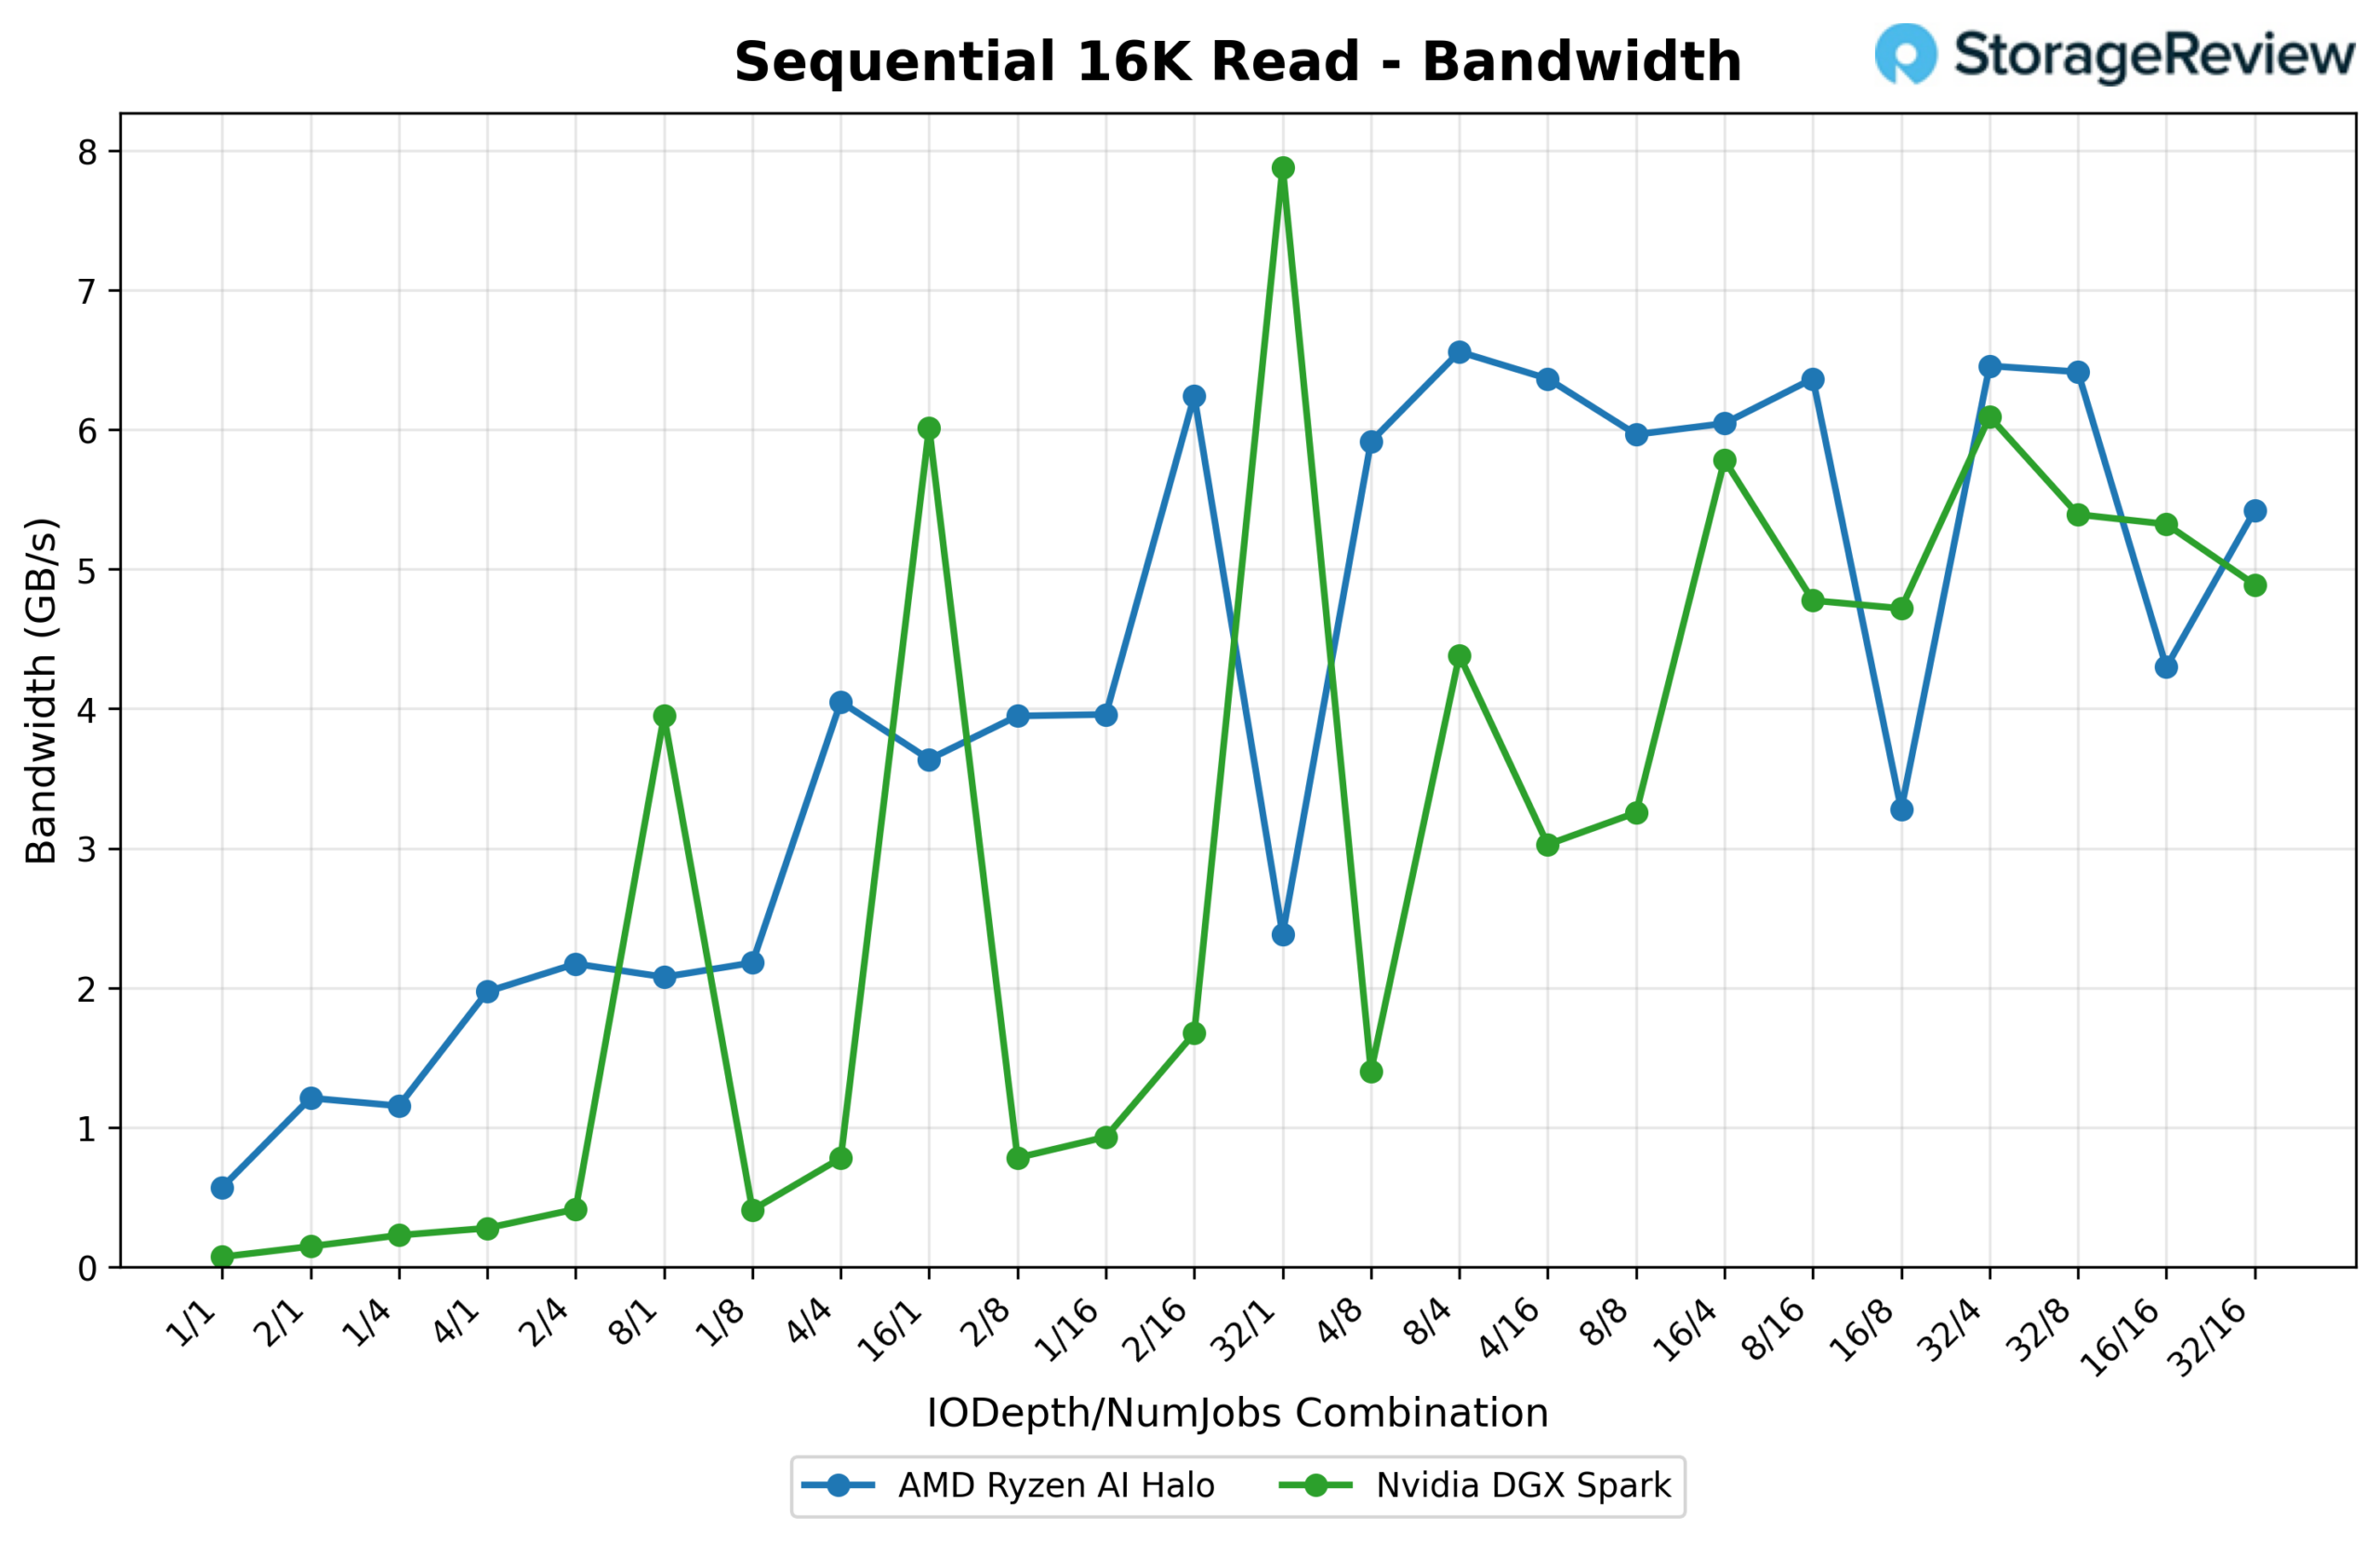
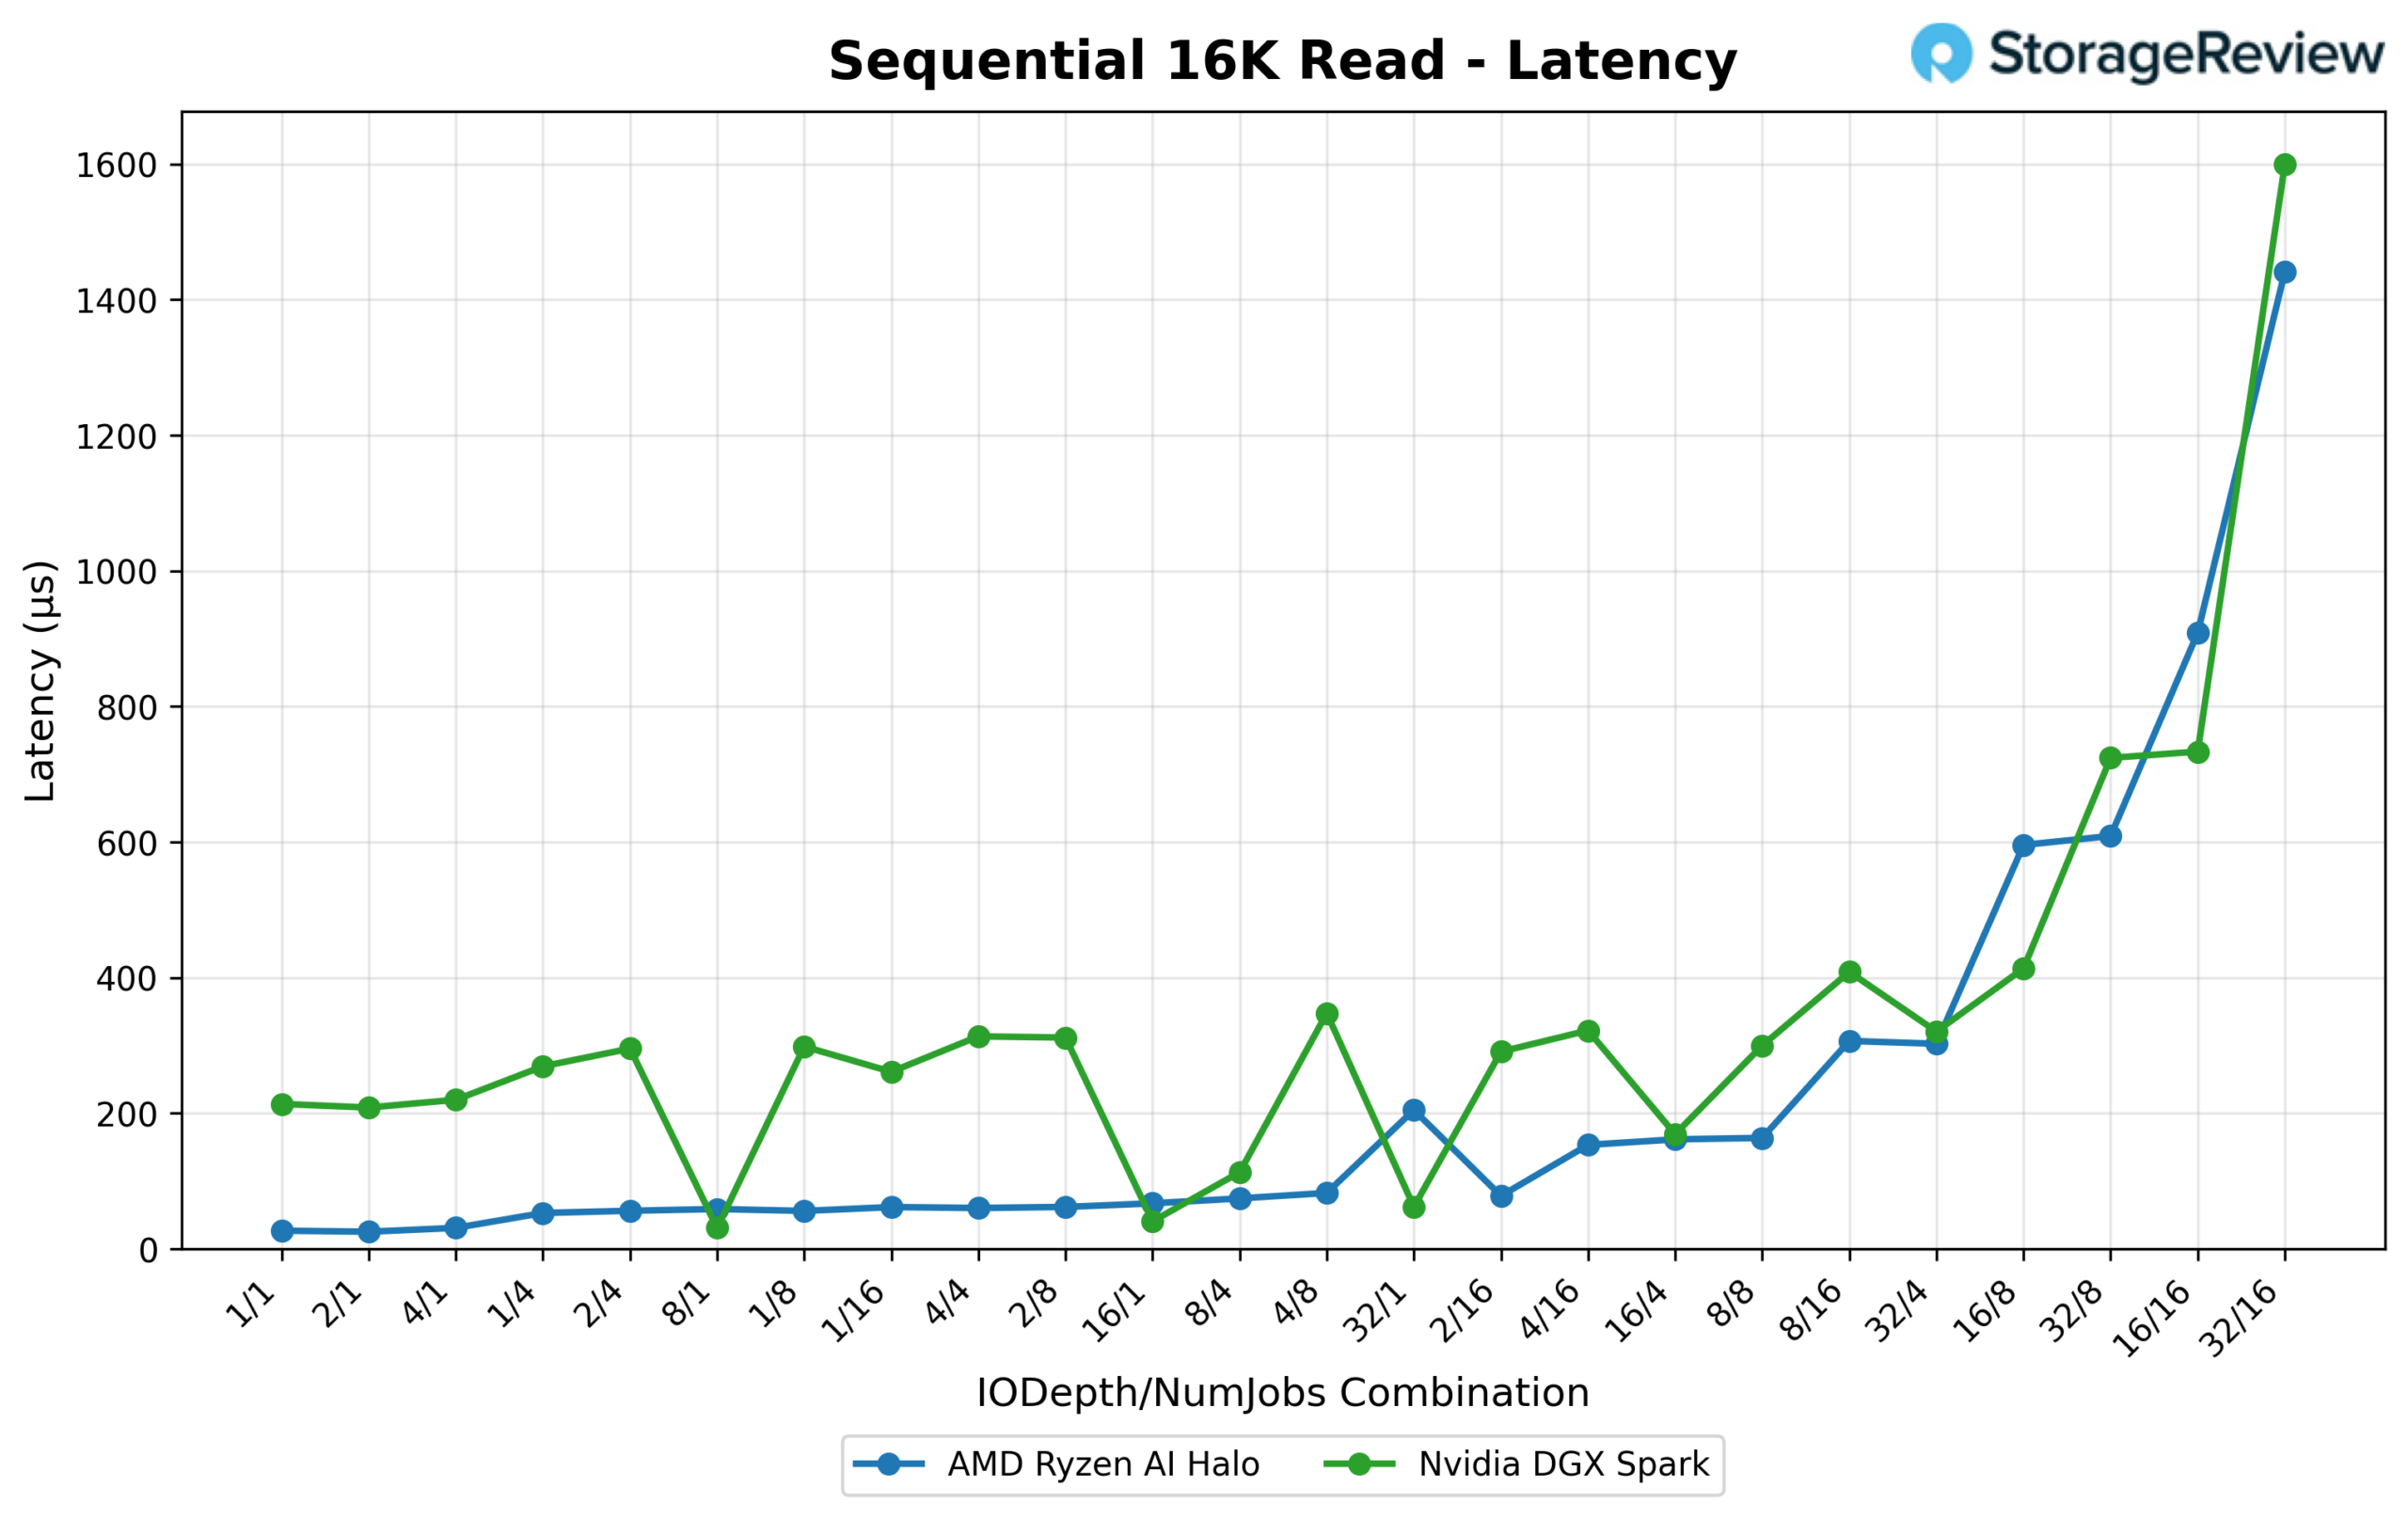
La latenza favorisce nuovamente Halo ovunque, tranne che in cima alla coda. Con un rapporto di 1/1, Halo risponde in 0.027 ms contro gli 0.214 ms di Spark, e Halo mantiene una latenza inferiore per la maggior parte della scansione. Solo con le combinazioni più profonde il divario si riduce. Con un rapporto di 32/16, la latenza media di Halo di 1.441 ms si attesta appena al di sotto degli 1.599 ms di Spark, rendendo questo uno dei pochi punti in cui la curva di latenza di Halo non supera quella di Spark a saturazione.
Scrittura sequenziale 16K
Anche la larghezza di banda è simile: Spark raggiunge un picco di 2,141.6 MB/s (137.1 IOPS) a 16/1, e Halo non è molto indietro con 1,970.9 MB/s (126.1 IOPS) a 1/8.
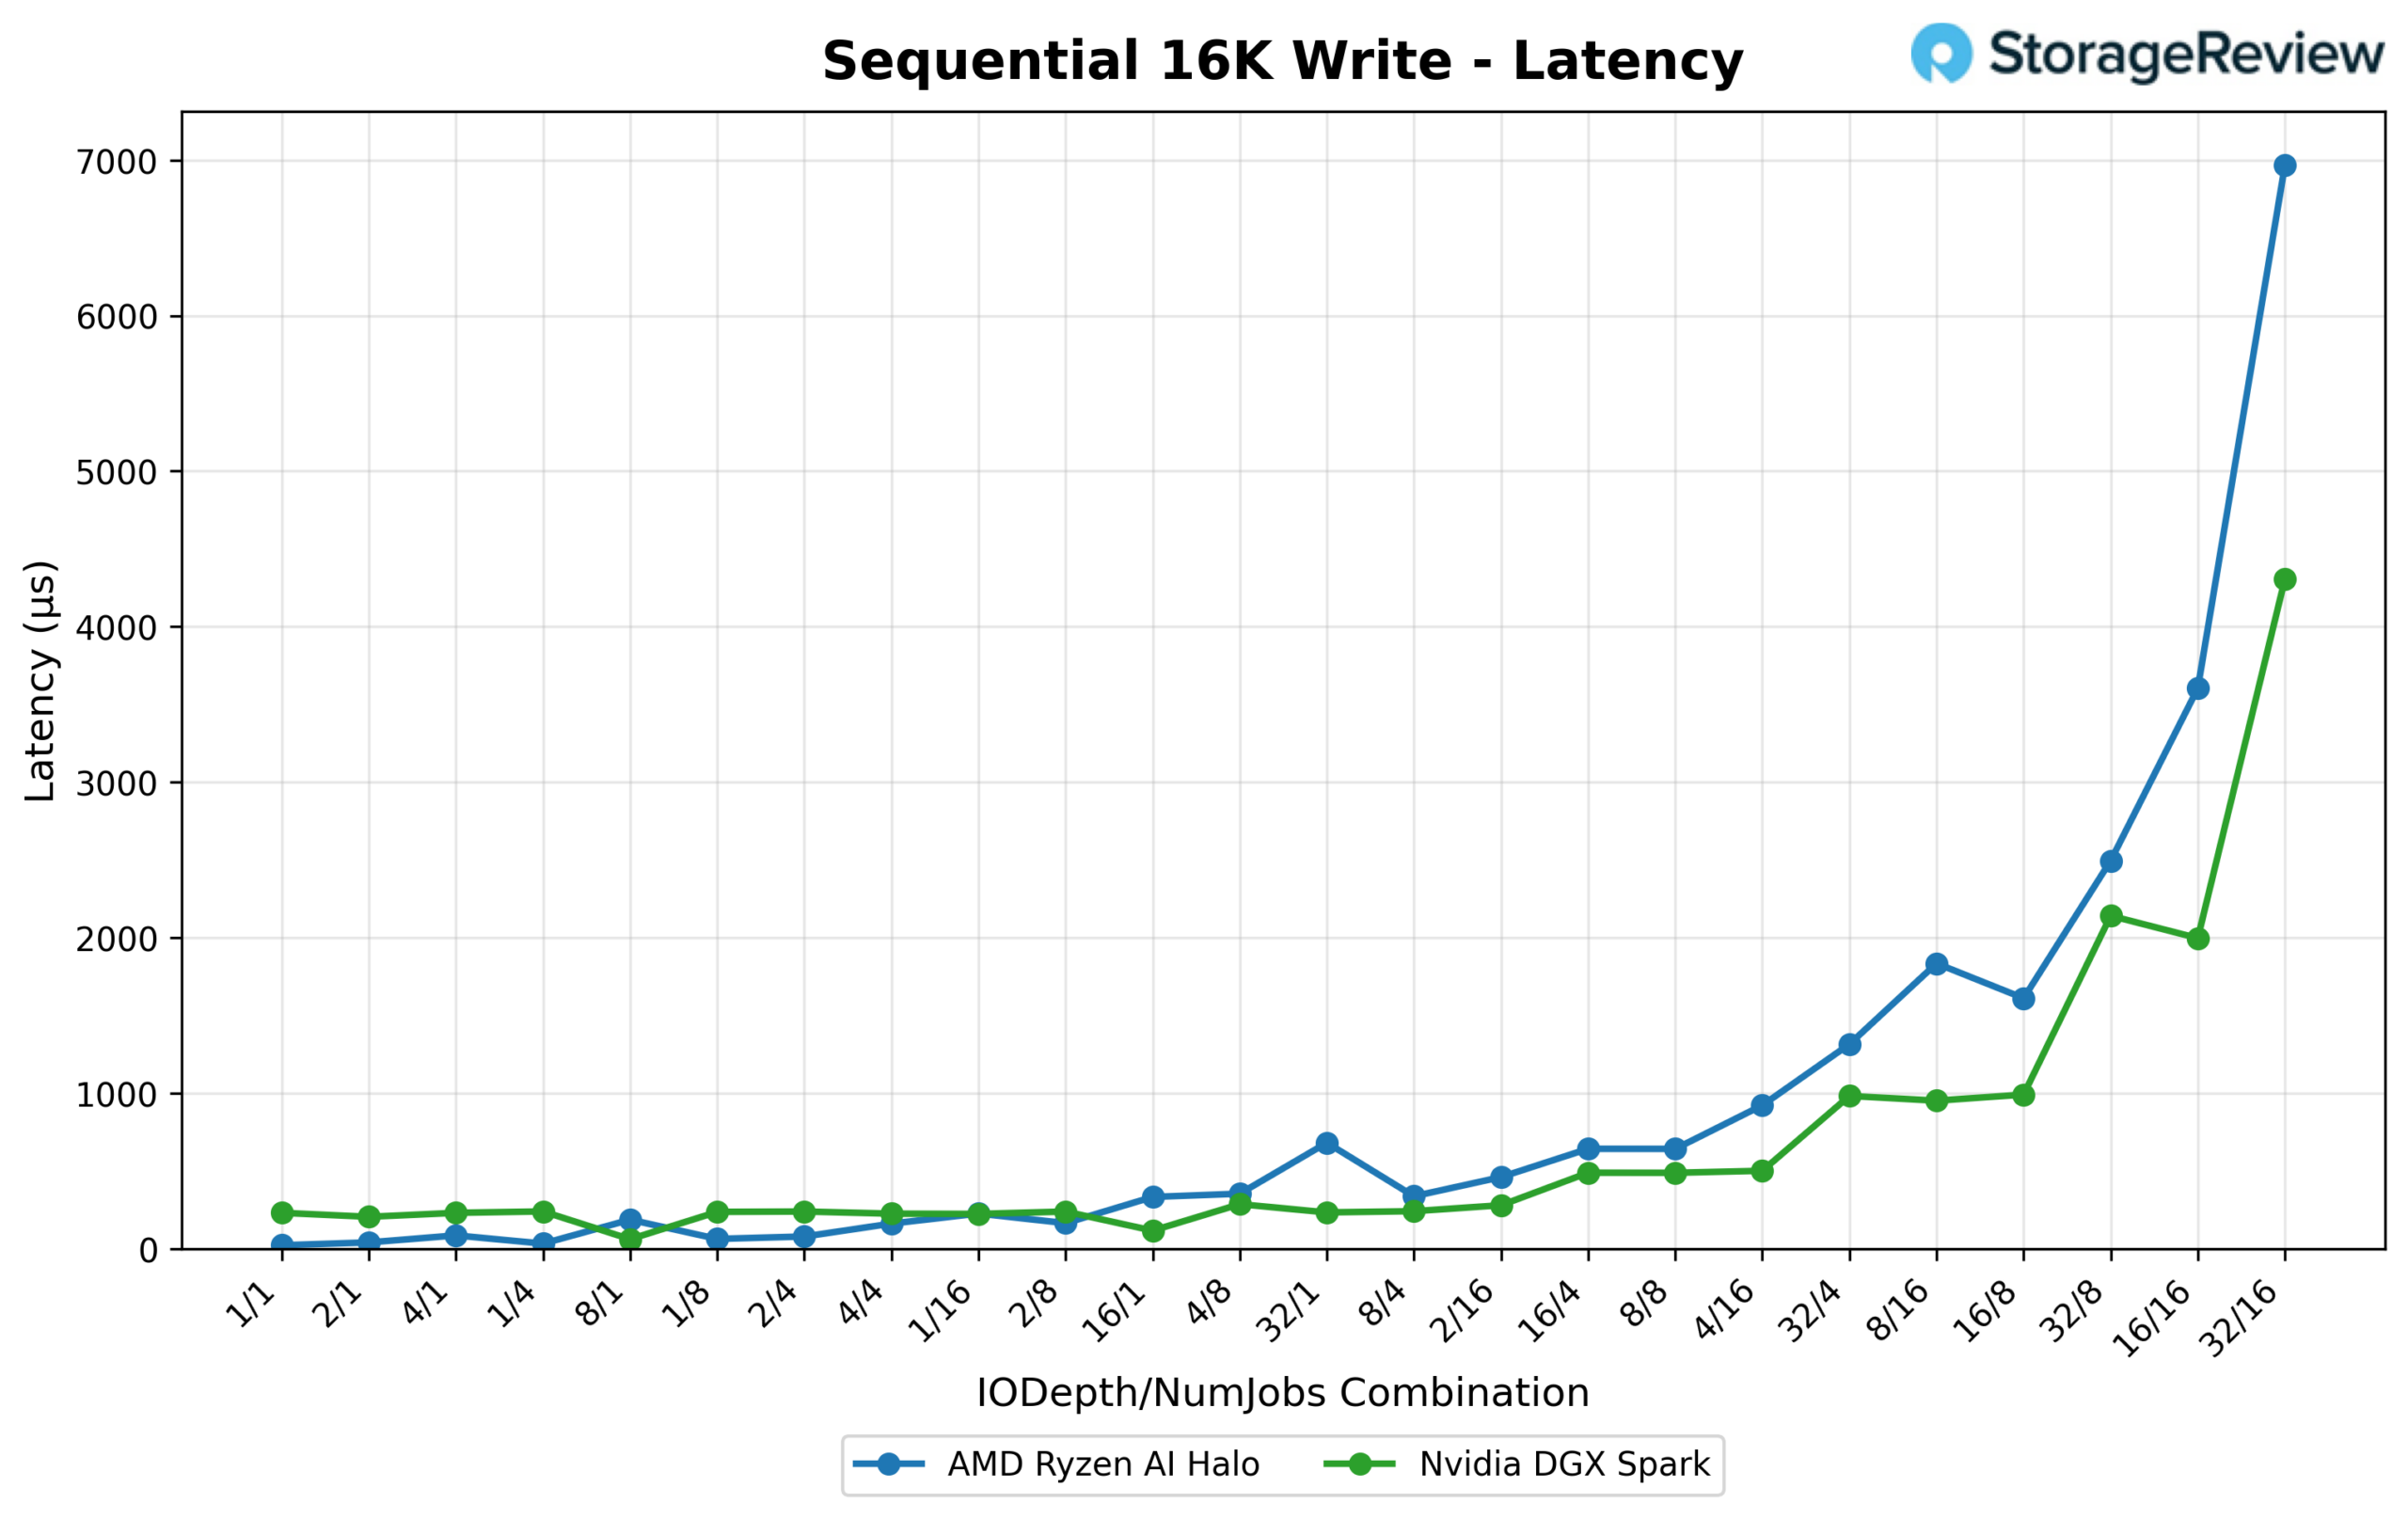
La latenza è il punto in cui i due sistemi divergono nettamente. Halo parte nettamente in vantaggio a bassi livelli di profondità della coda (0.022 ms a 1/1 contro gli 0.231 ms di Spark), ma la sua curva di latenza subisce un'impennata violenta man mano che la coda si riempie. A 32/16, la latenza media di Halo raggiunge i 6.967 ms, ben oltre i 4.306 ms di Spark allo stesso punto. La curva di Halo è inoltre molto meno prevedibile lungo il percorso, con picchi improvvisi in diverse combinazioni intermedie, mentre Spark rimane relativamente piatta.
Lettura casuale 16K
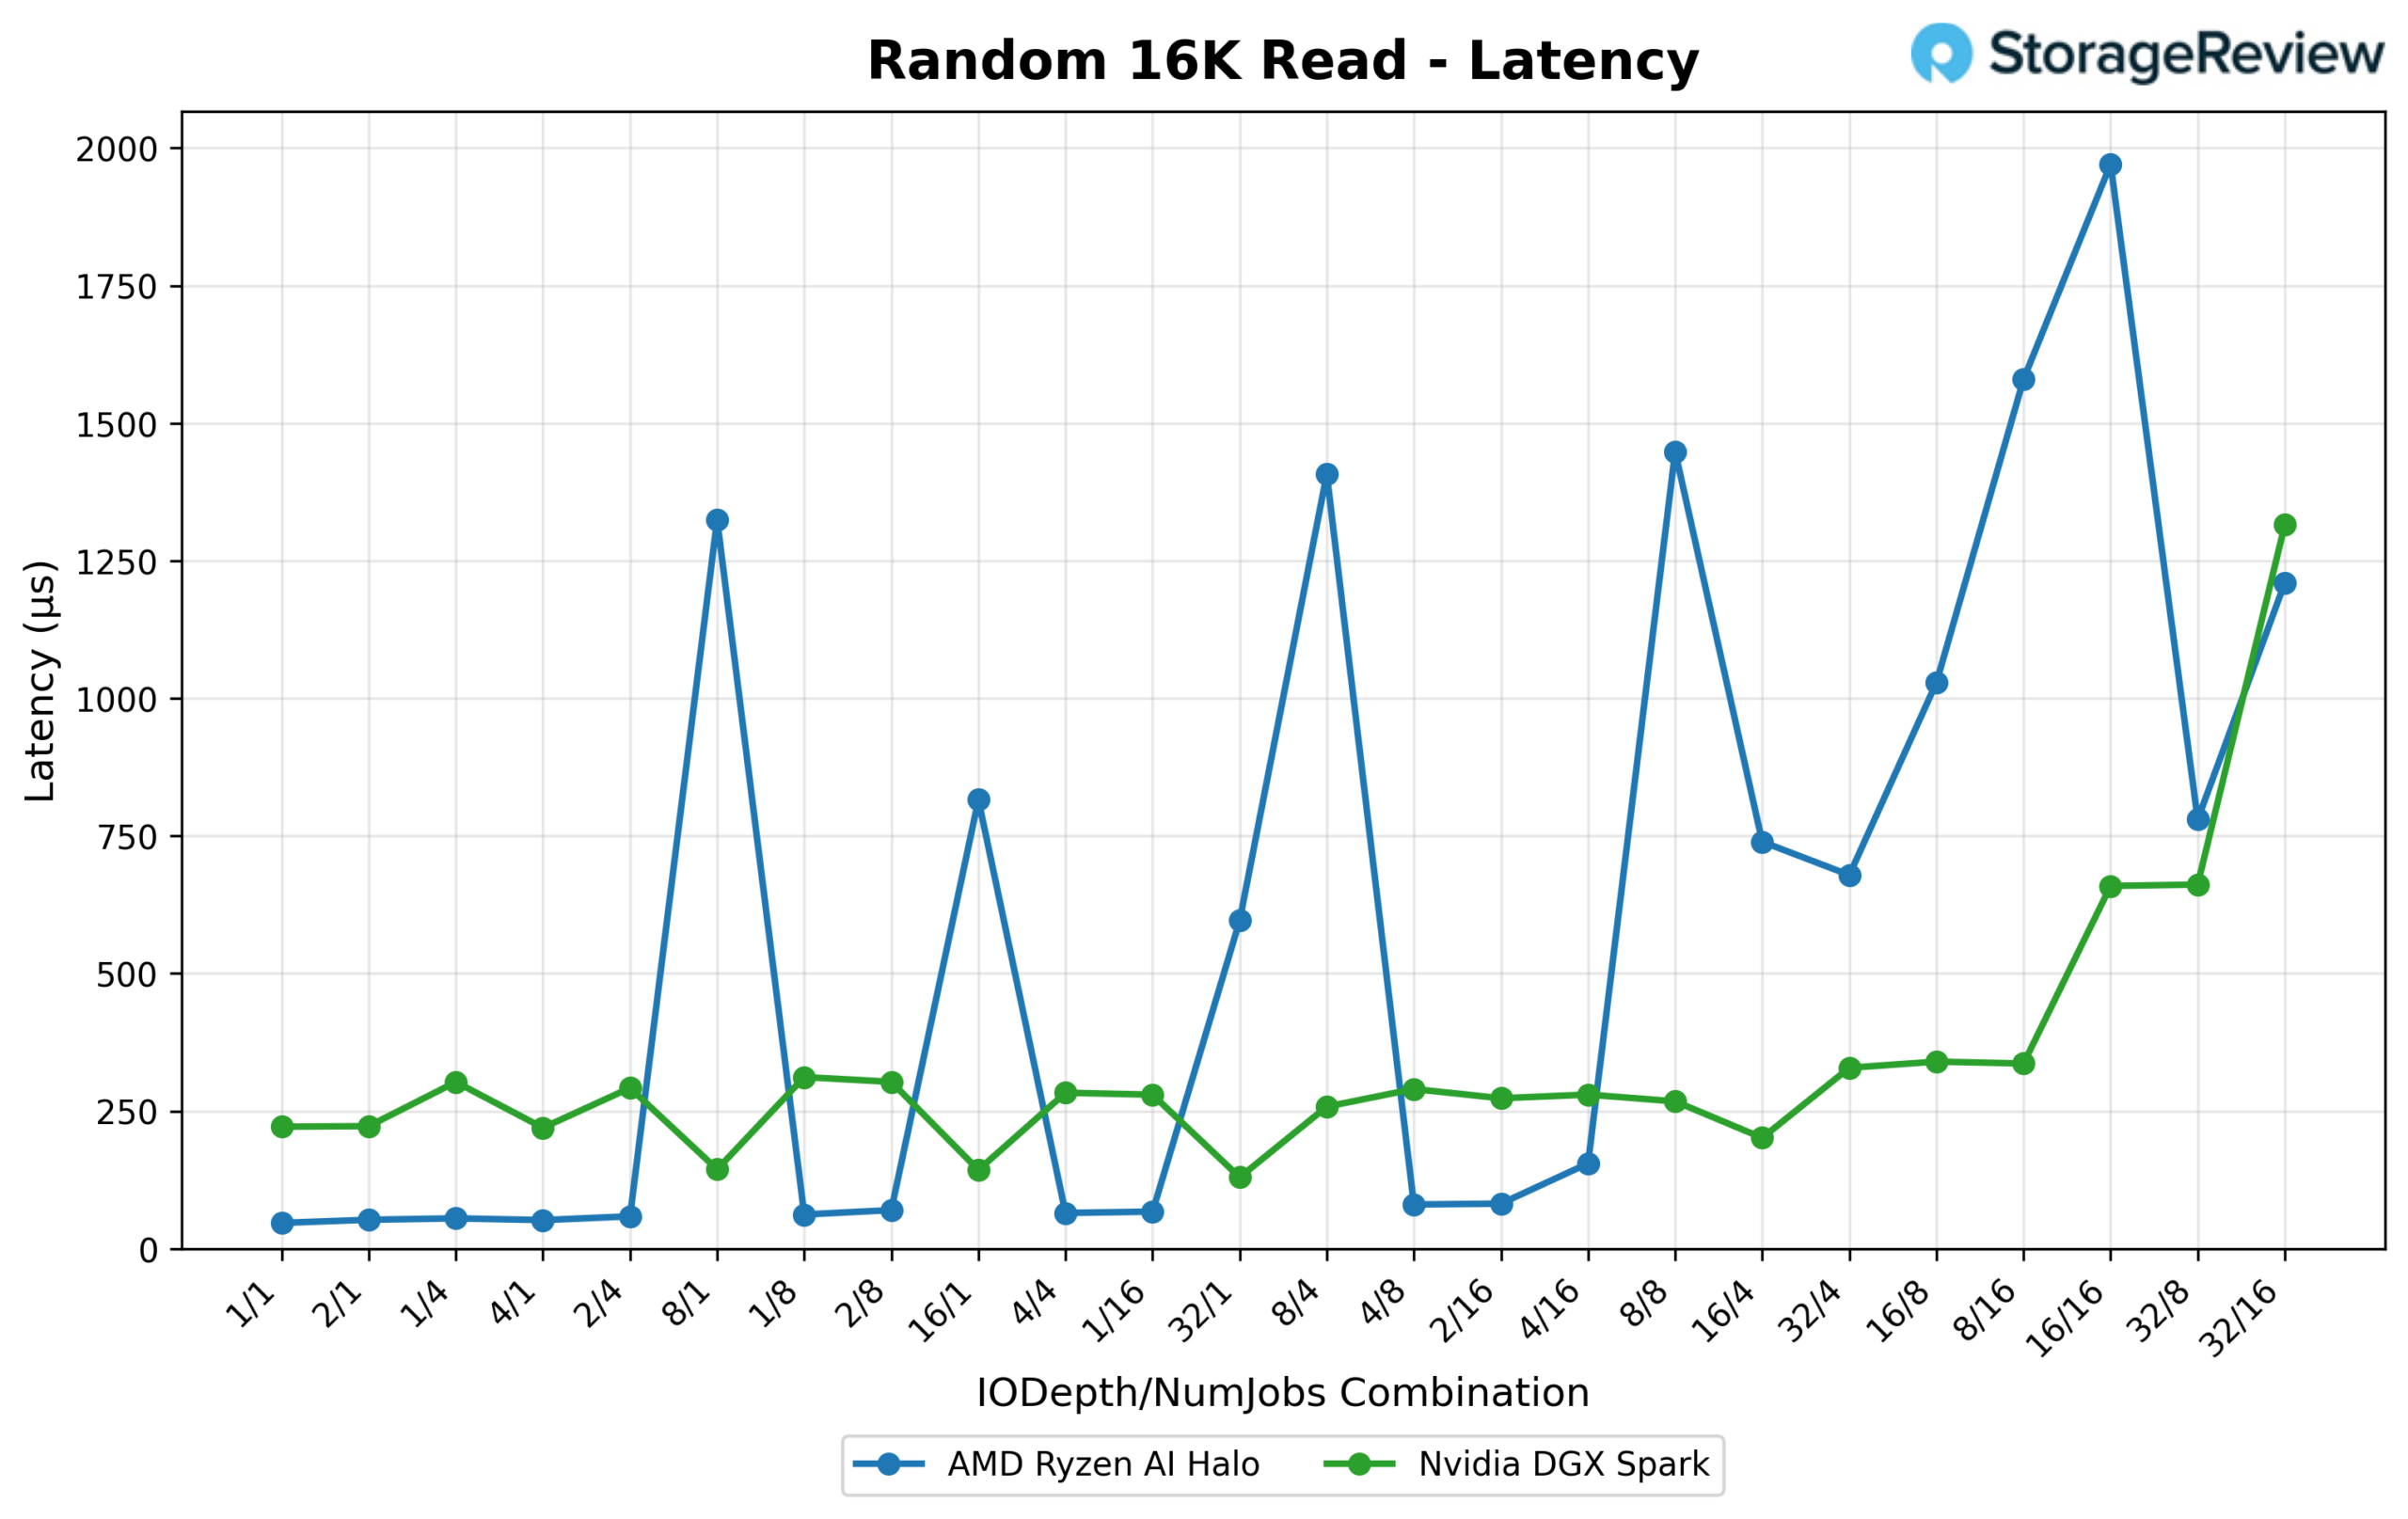
Questa è una delle migliori prestazioni di Halo. In realtà, registra una larghezza di banda di picco superiore di 6,609.4 MB/s (423.0 IOPS) a 32/16, contro i 6,082.6 MB/s (389.3 IOPS) dello Spark con la stessa configurazione.
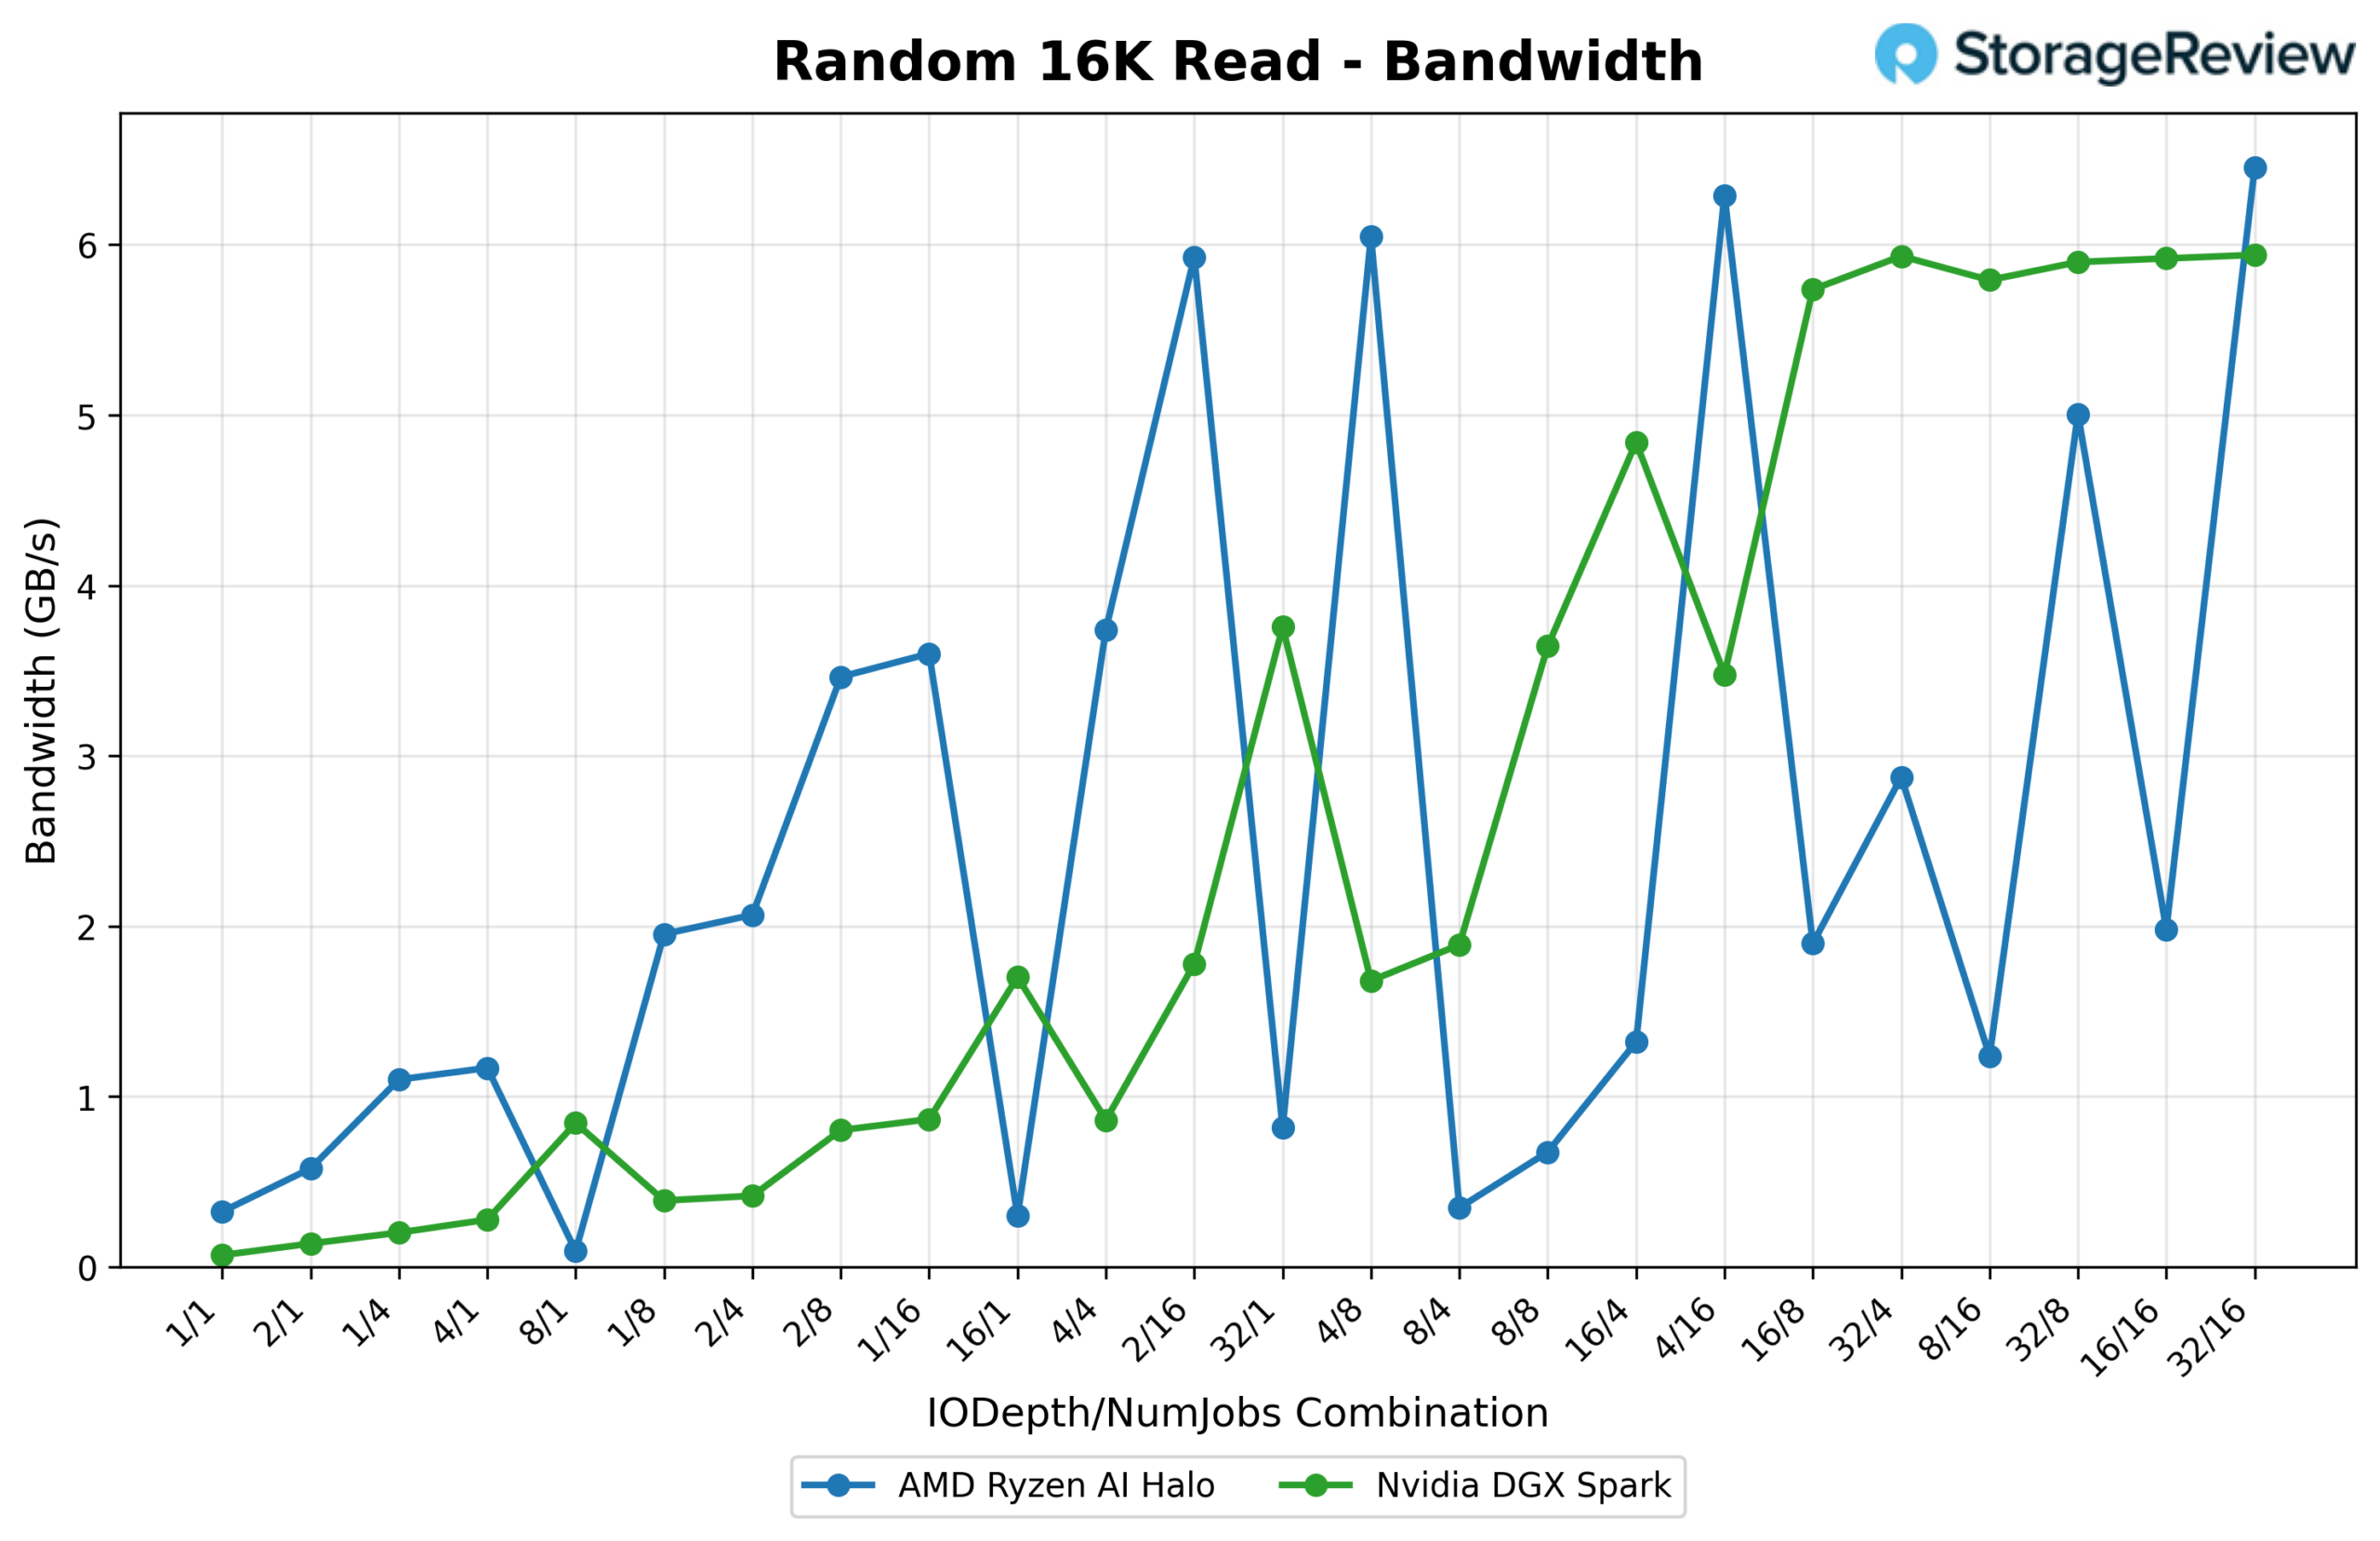
Anche in questo caso, la latenza è nettamente a favore di Halo (0.047 ms a 1/1 contro 0.222 ms per Spark). Tuttavia, la curva di latenza di Halo è molto più volatile lungo tutto il percorso, con picchi netti a 8/1, 16/1, 8/4 e 8/8 che superano di gran lunga la curva di Spark, relativamente più uniforme (sebbene con una base di partenza più elevata). In cima alla coda, la latenza di picco di Halo di 1.971 ms (a 16/16) supera il picco di Spark di 1.315 ms (a 32/16), quindi Halo sacrifica la coerenza in favore della velocità pura a bassa profondità di coda.
Scrittura casuale 16K
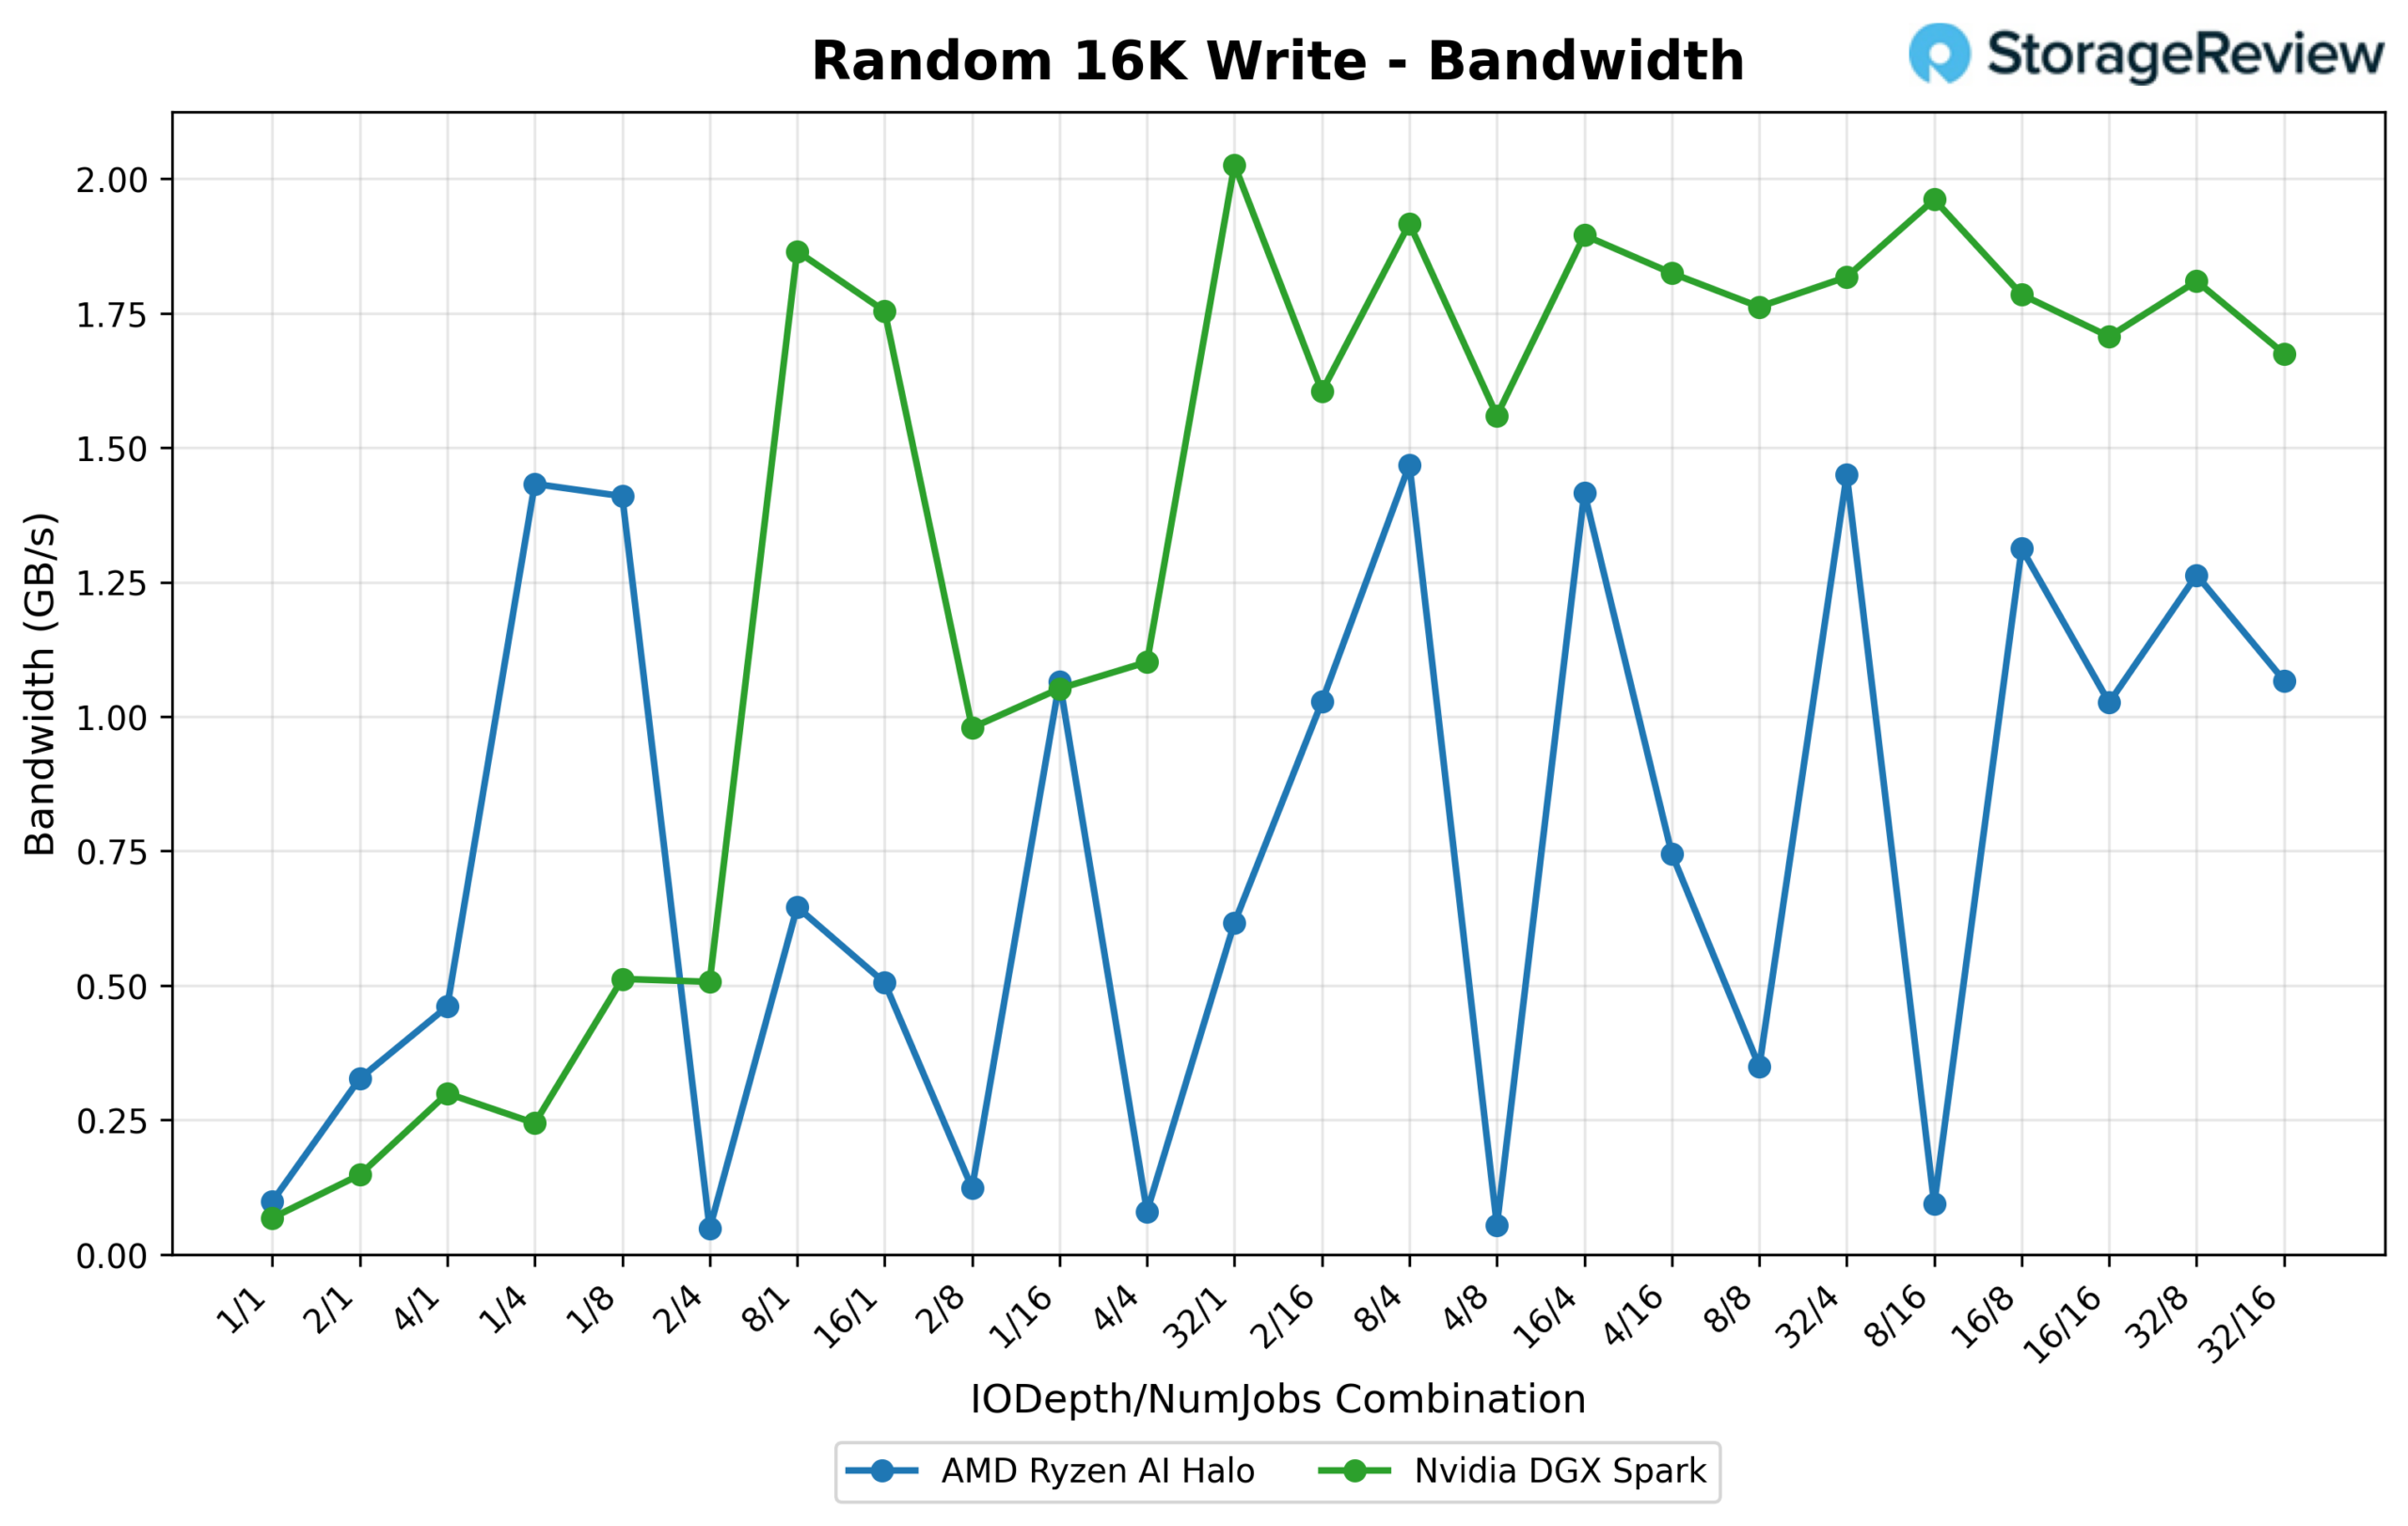
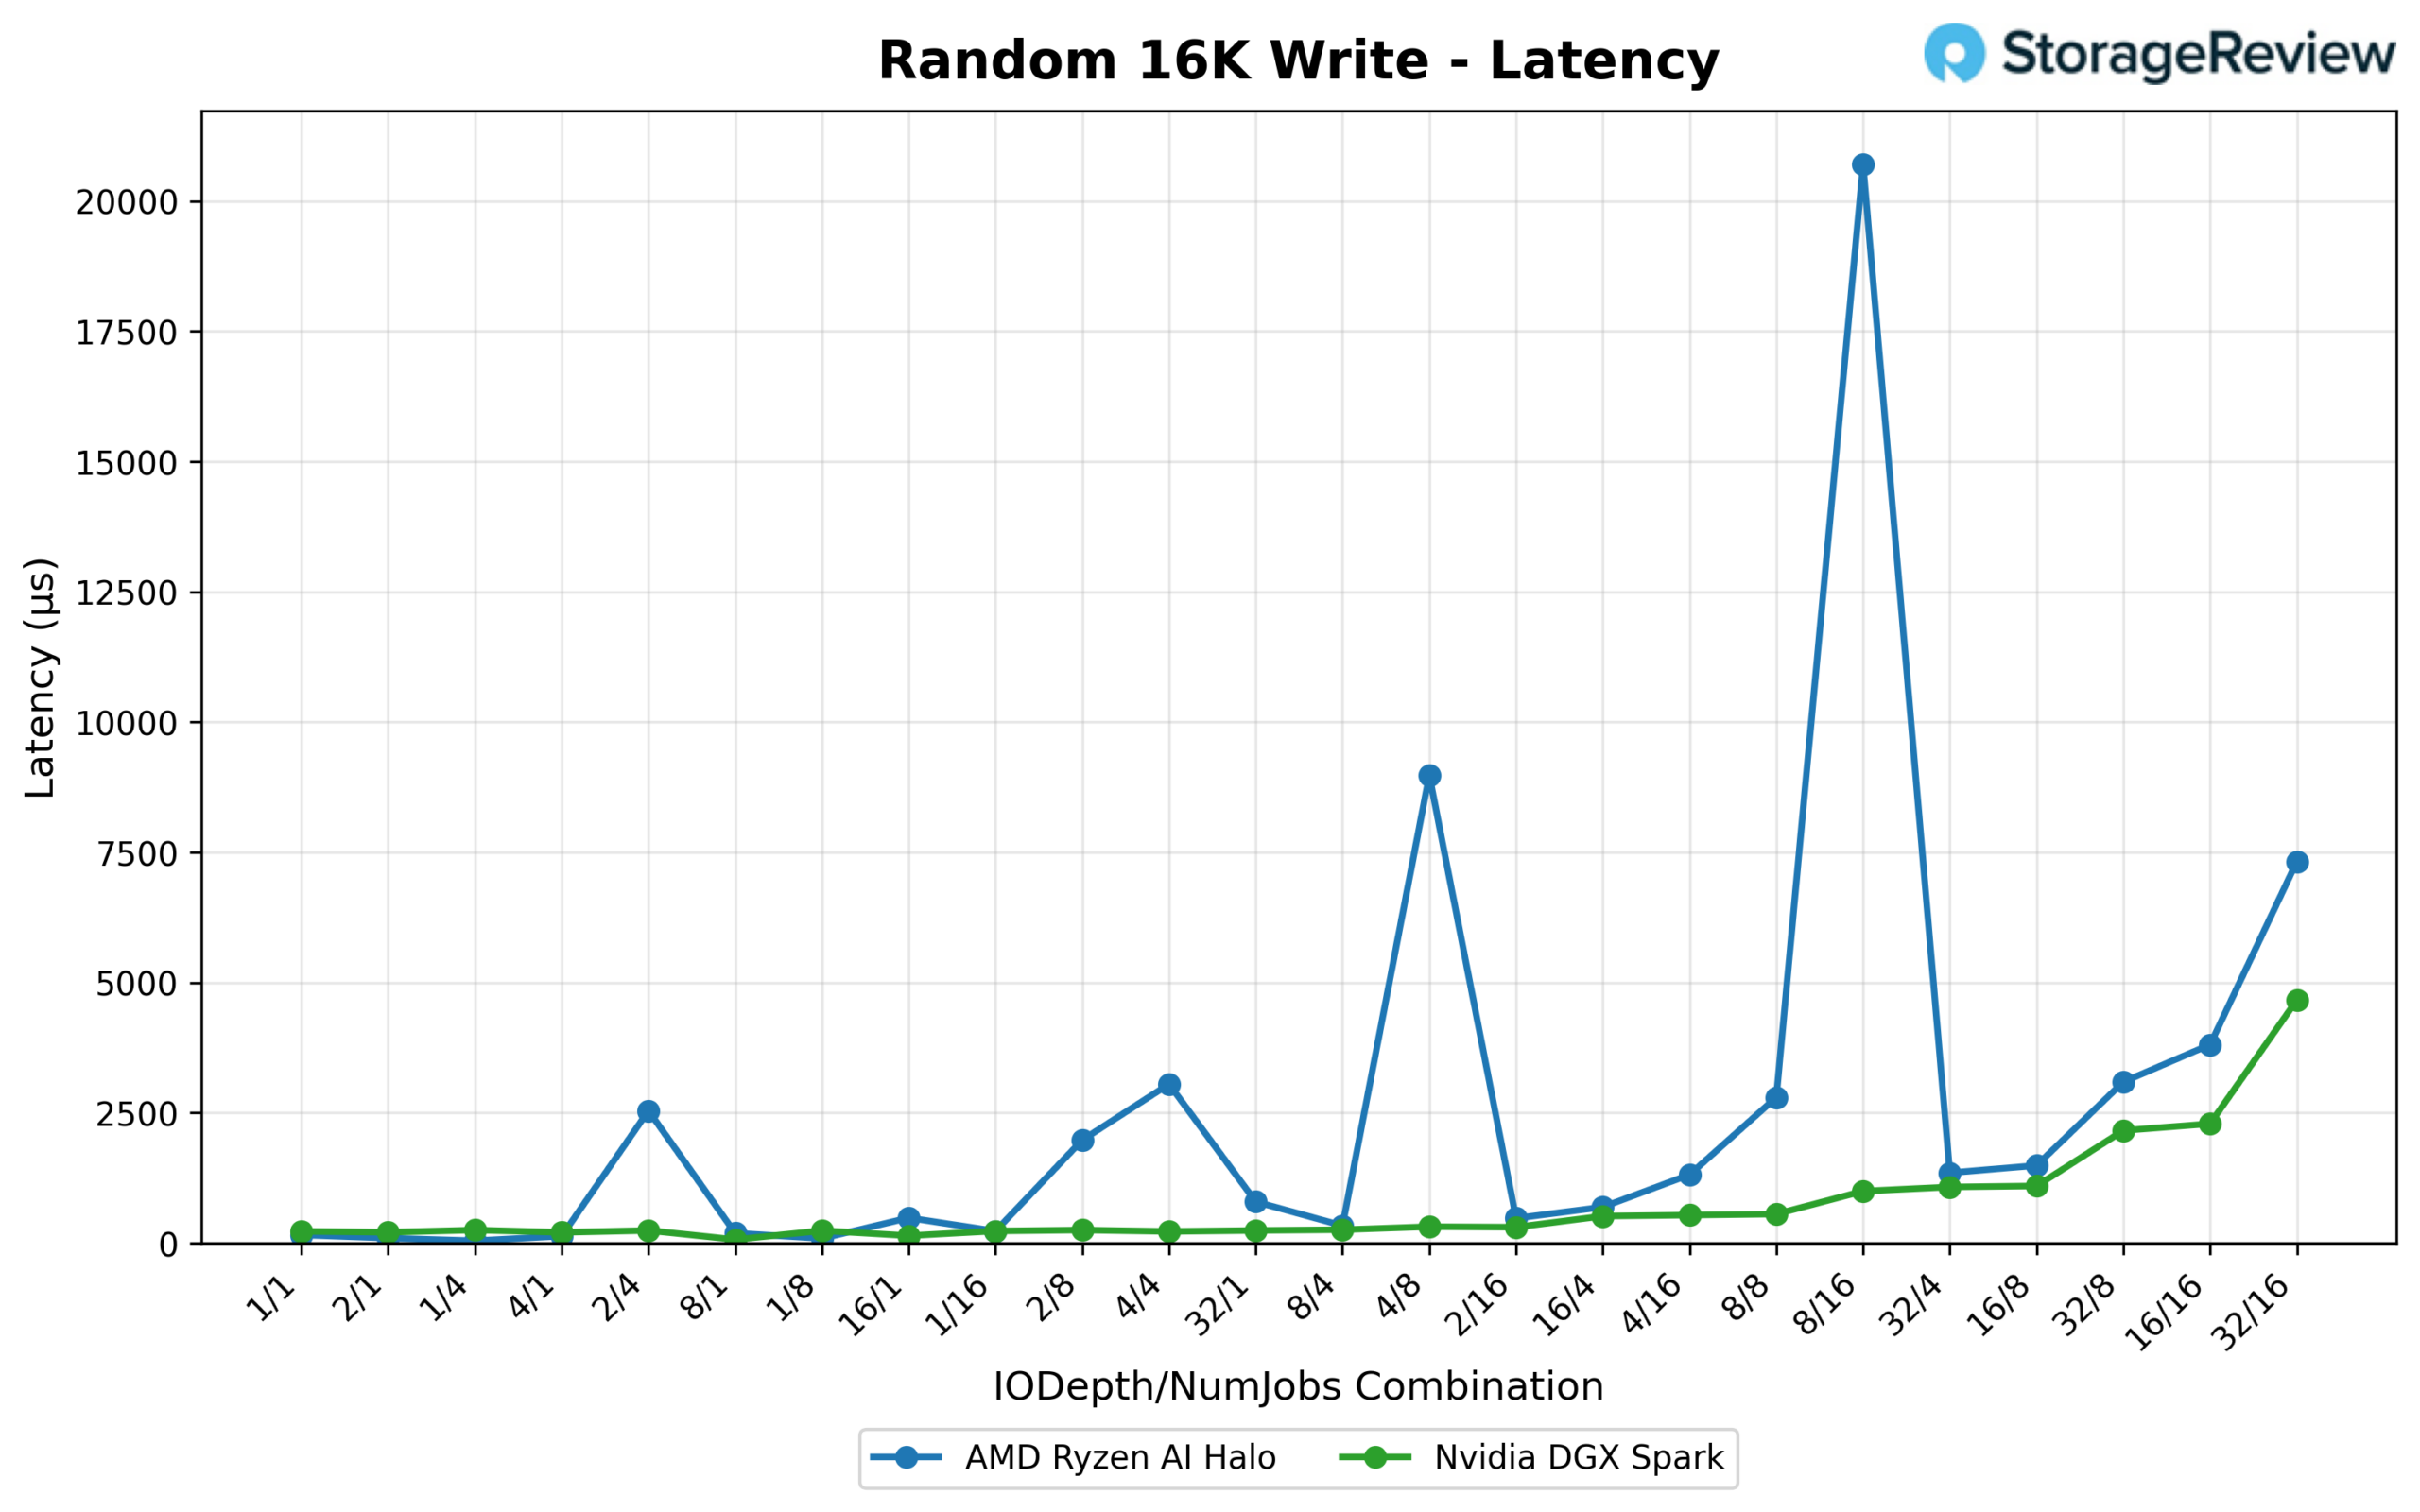
In questo caso, la larghezza di banda è a favore dello Spark, che raggiunge 2,074.1 MB/s (132.7 IOPS) con un rapporto di 32/1, rispetto ai 1,503.5 MB/s (96.2 IOPS) dell'Halo con un rapporto di 8/4. La curva di larghezza di banda dello Spark è inoltre considerevolmente più costante, mantenendosi nell'intervallo 1.6-2.0 GB/s per la maggior parte della scansione dopo la rampa iniziale. Al contrario, l'Halo oscilla selvaggiamente tra circa 0.1 e 1.5 GB/s da una combinazione all'altra.
La latenza è l'aspetto in cui questo test si distingue: Halo parte con un valore inferiore a 1/1 (0.154 ms contro 0.224 ms), ma a 8/16 la sua latenza media raggiunge un picco estremo di 20.698 ms, quasi 4.5 volte superiore al valore peggiore di Spark (4.664 ms) registrato in qualsiasi punto del test. A parte questo singolo picco, la latenza di Halo è altrimenti accettabile, ma si tratta di un valore anomalo significativo che merita di essere segnalato per qualsiasi carico di lavoro che potrebbe essere eseguito su quella specifica combinazione di profondità/thread.
Lettura casuale 4K
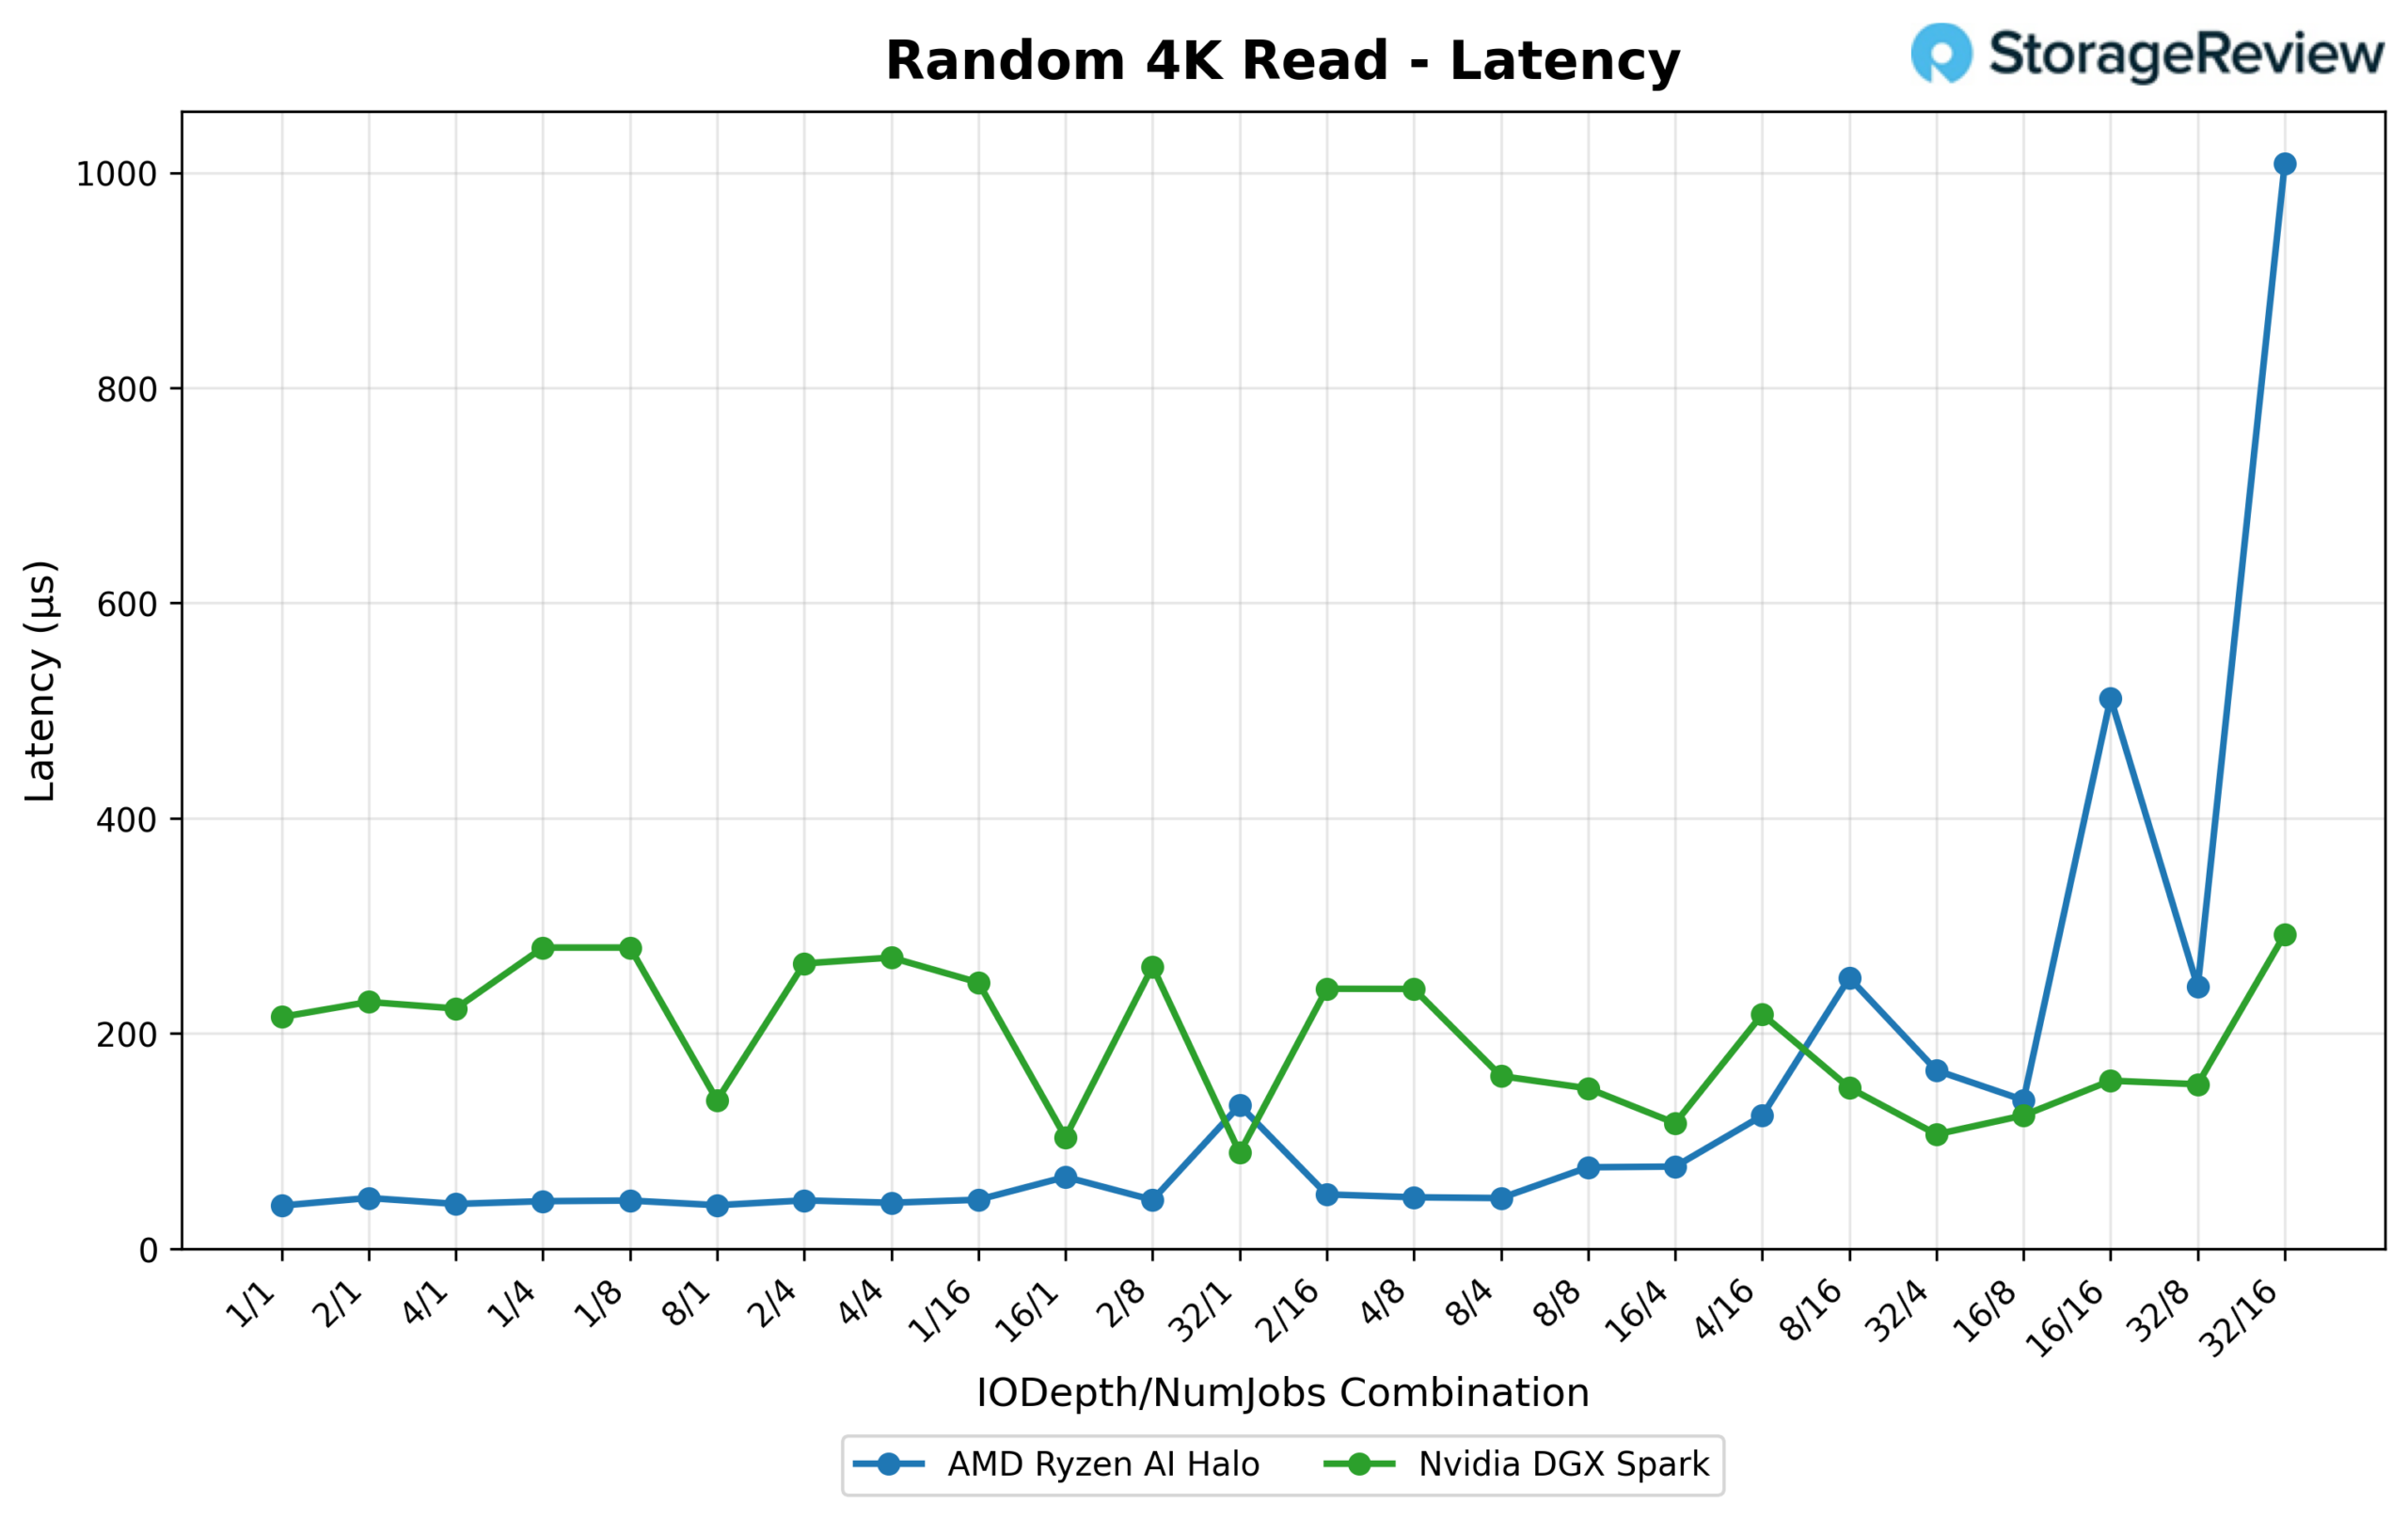
A basse profondità di coda, Halo risponde in modo nettamente più rapido (0.04 ms a 1/1 contro gli 0.215 ms di Spark) e mantiene un vantaggio in termini di latenza per gran parte della gamma medio-bassa del test. Tuttavia, Spark si impone nettamente in termini di throughput su larga scala: il suo picco di IOPS raggiunge 1,750.7K (6,838.8 MB/s) a 32/16, ben al di sopra del picco di Halo di 1,050.4K IOPS (4,103.2 MB/s) a 32/8.
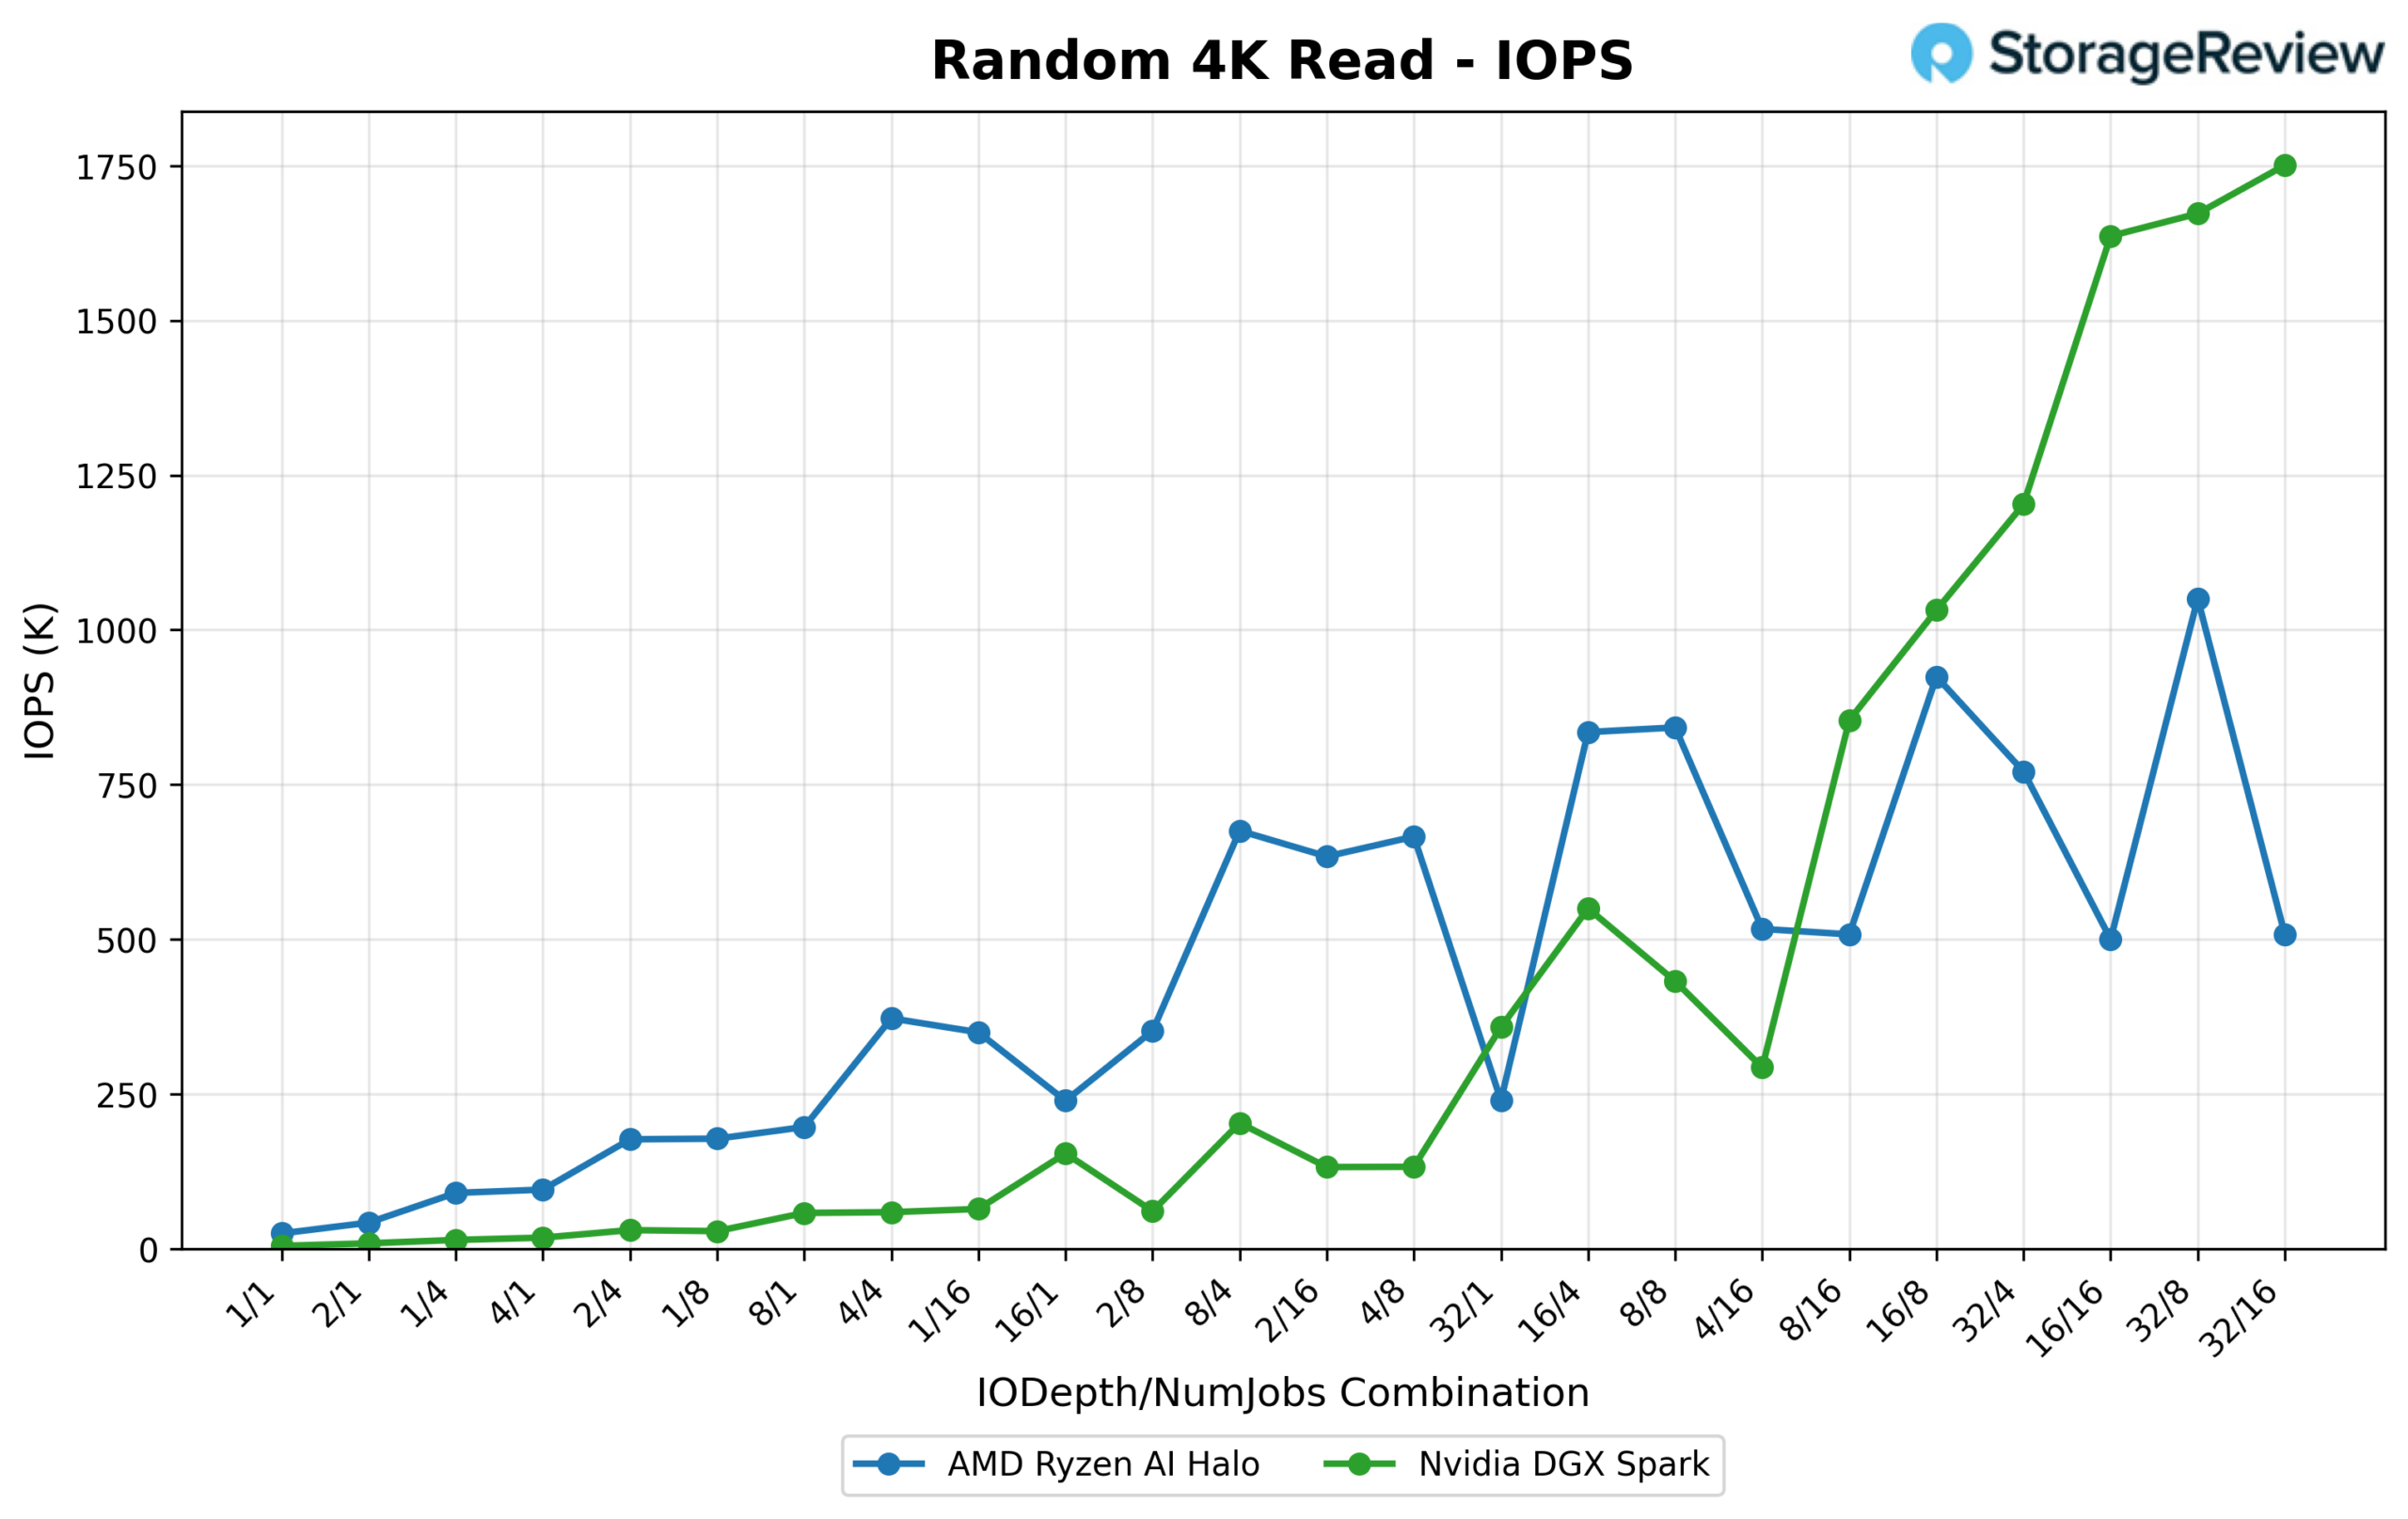
È interessante notare che la curva di latenza si inverte ad alti livelli di profondità della coda. La curva di latenza di Spark rimane relativamente contenuta anche all'aumentare della profondità e del numero di thread, raggiungendo un picco di soli 0.292 ms. Halo, al contrario, presenta un picco pronunciato a 16/16 (0.513 ms) e di nuovo a 32/16 (1.009 ms), superando di oltre 3 volte il suo valore di riferimento a regime, il che significa che la sua eccellente reattività a bassa profondità di coda non si mantiene fino alla saturazione completa.
Scrittura casuale 4K
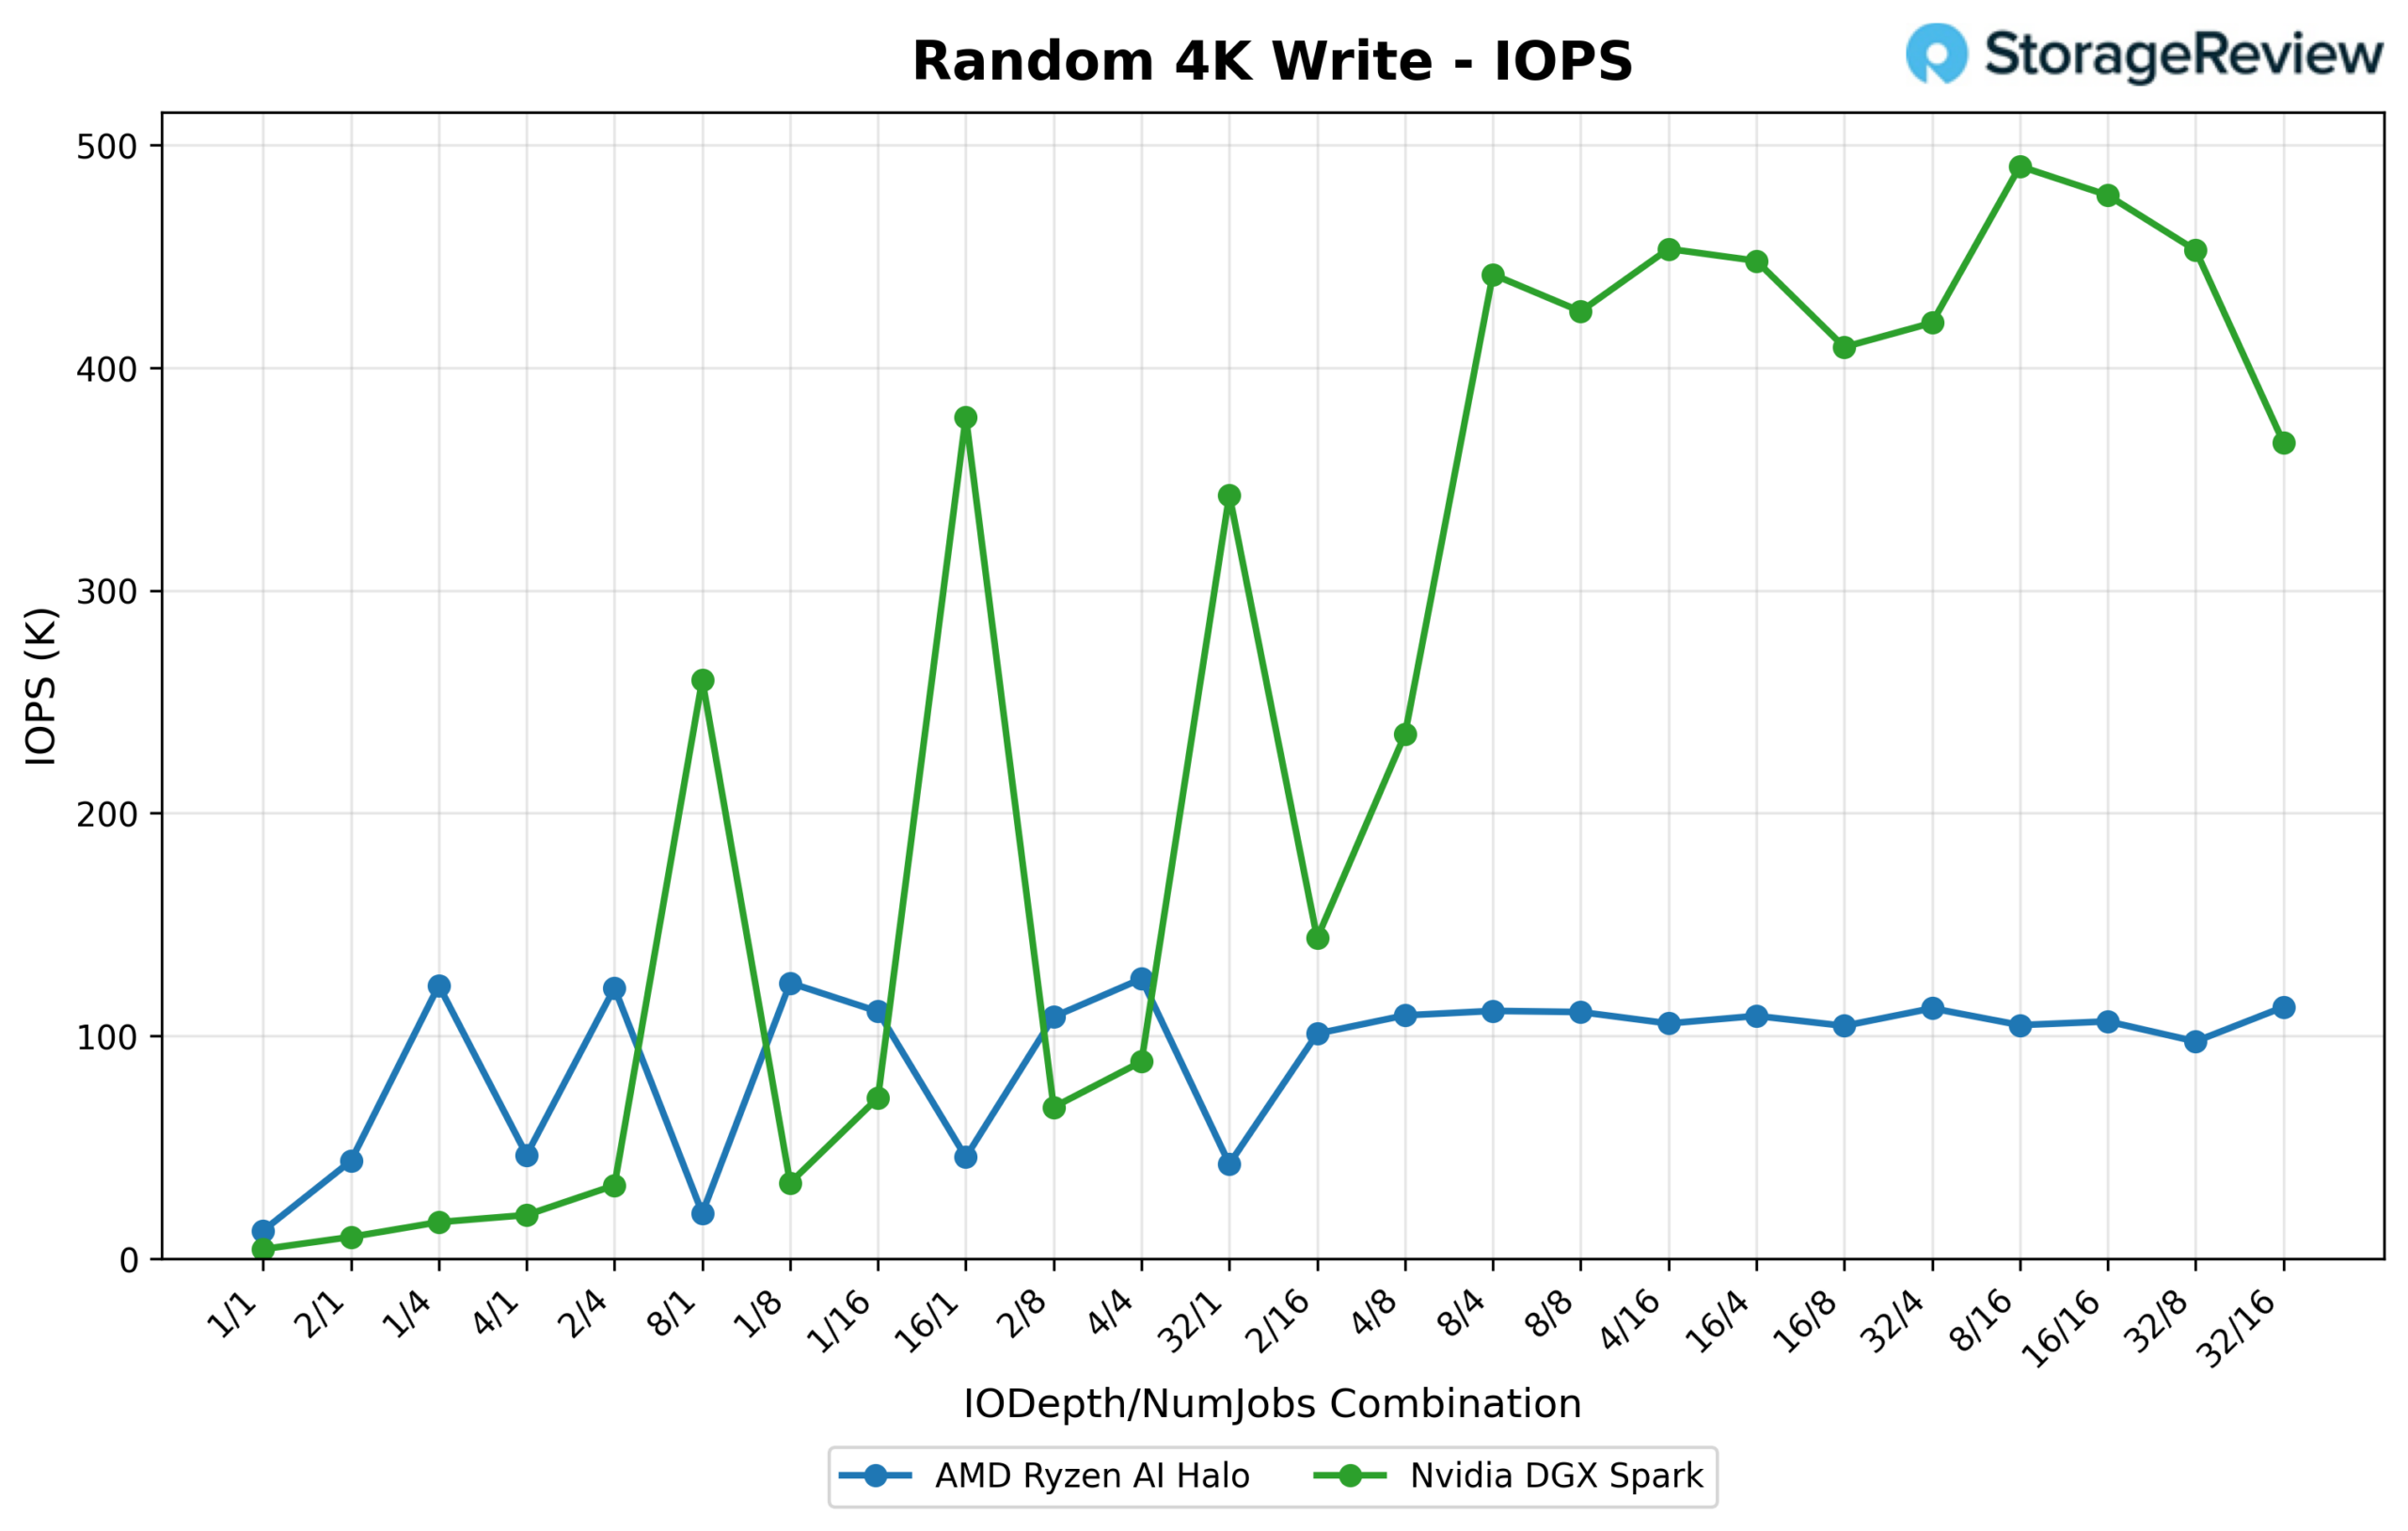
Questo è il divario IOPS più ampio durante il test. Le prestazioni di scrittura casuale 4K dello Spark aumentano vertiginosamente con l'aumentare della profondità della coda e del numero di thread, raggiungendo 490.4 IOPS (1,915.6 MB/s) a 8/16. L'Halo, invece, si stabilizza molto prima e a un livello molto più basso, raggiungendo un picco di 125.6 IOPS (490.7 MB/s) a 4/4 e non superando mai circa 110-115 IOPS per il resto del test. In questo caso, lo Spark sta operando a quasi 4 volte il limite massimo dell'Halo.
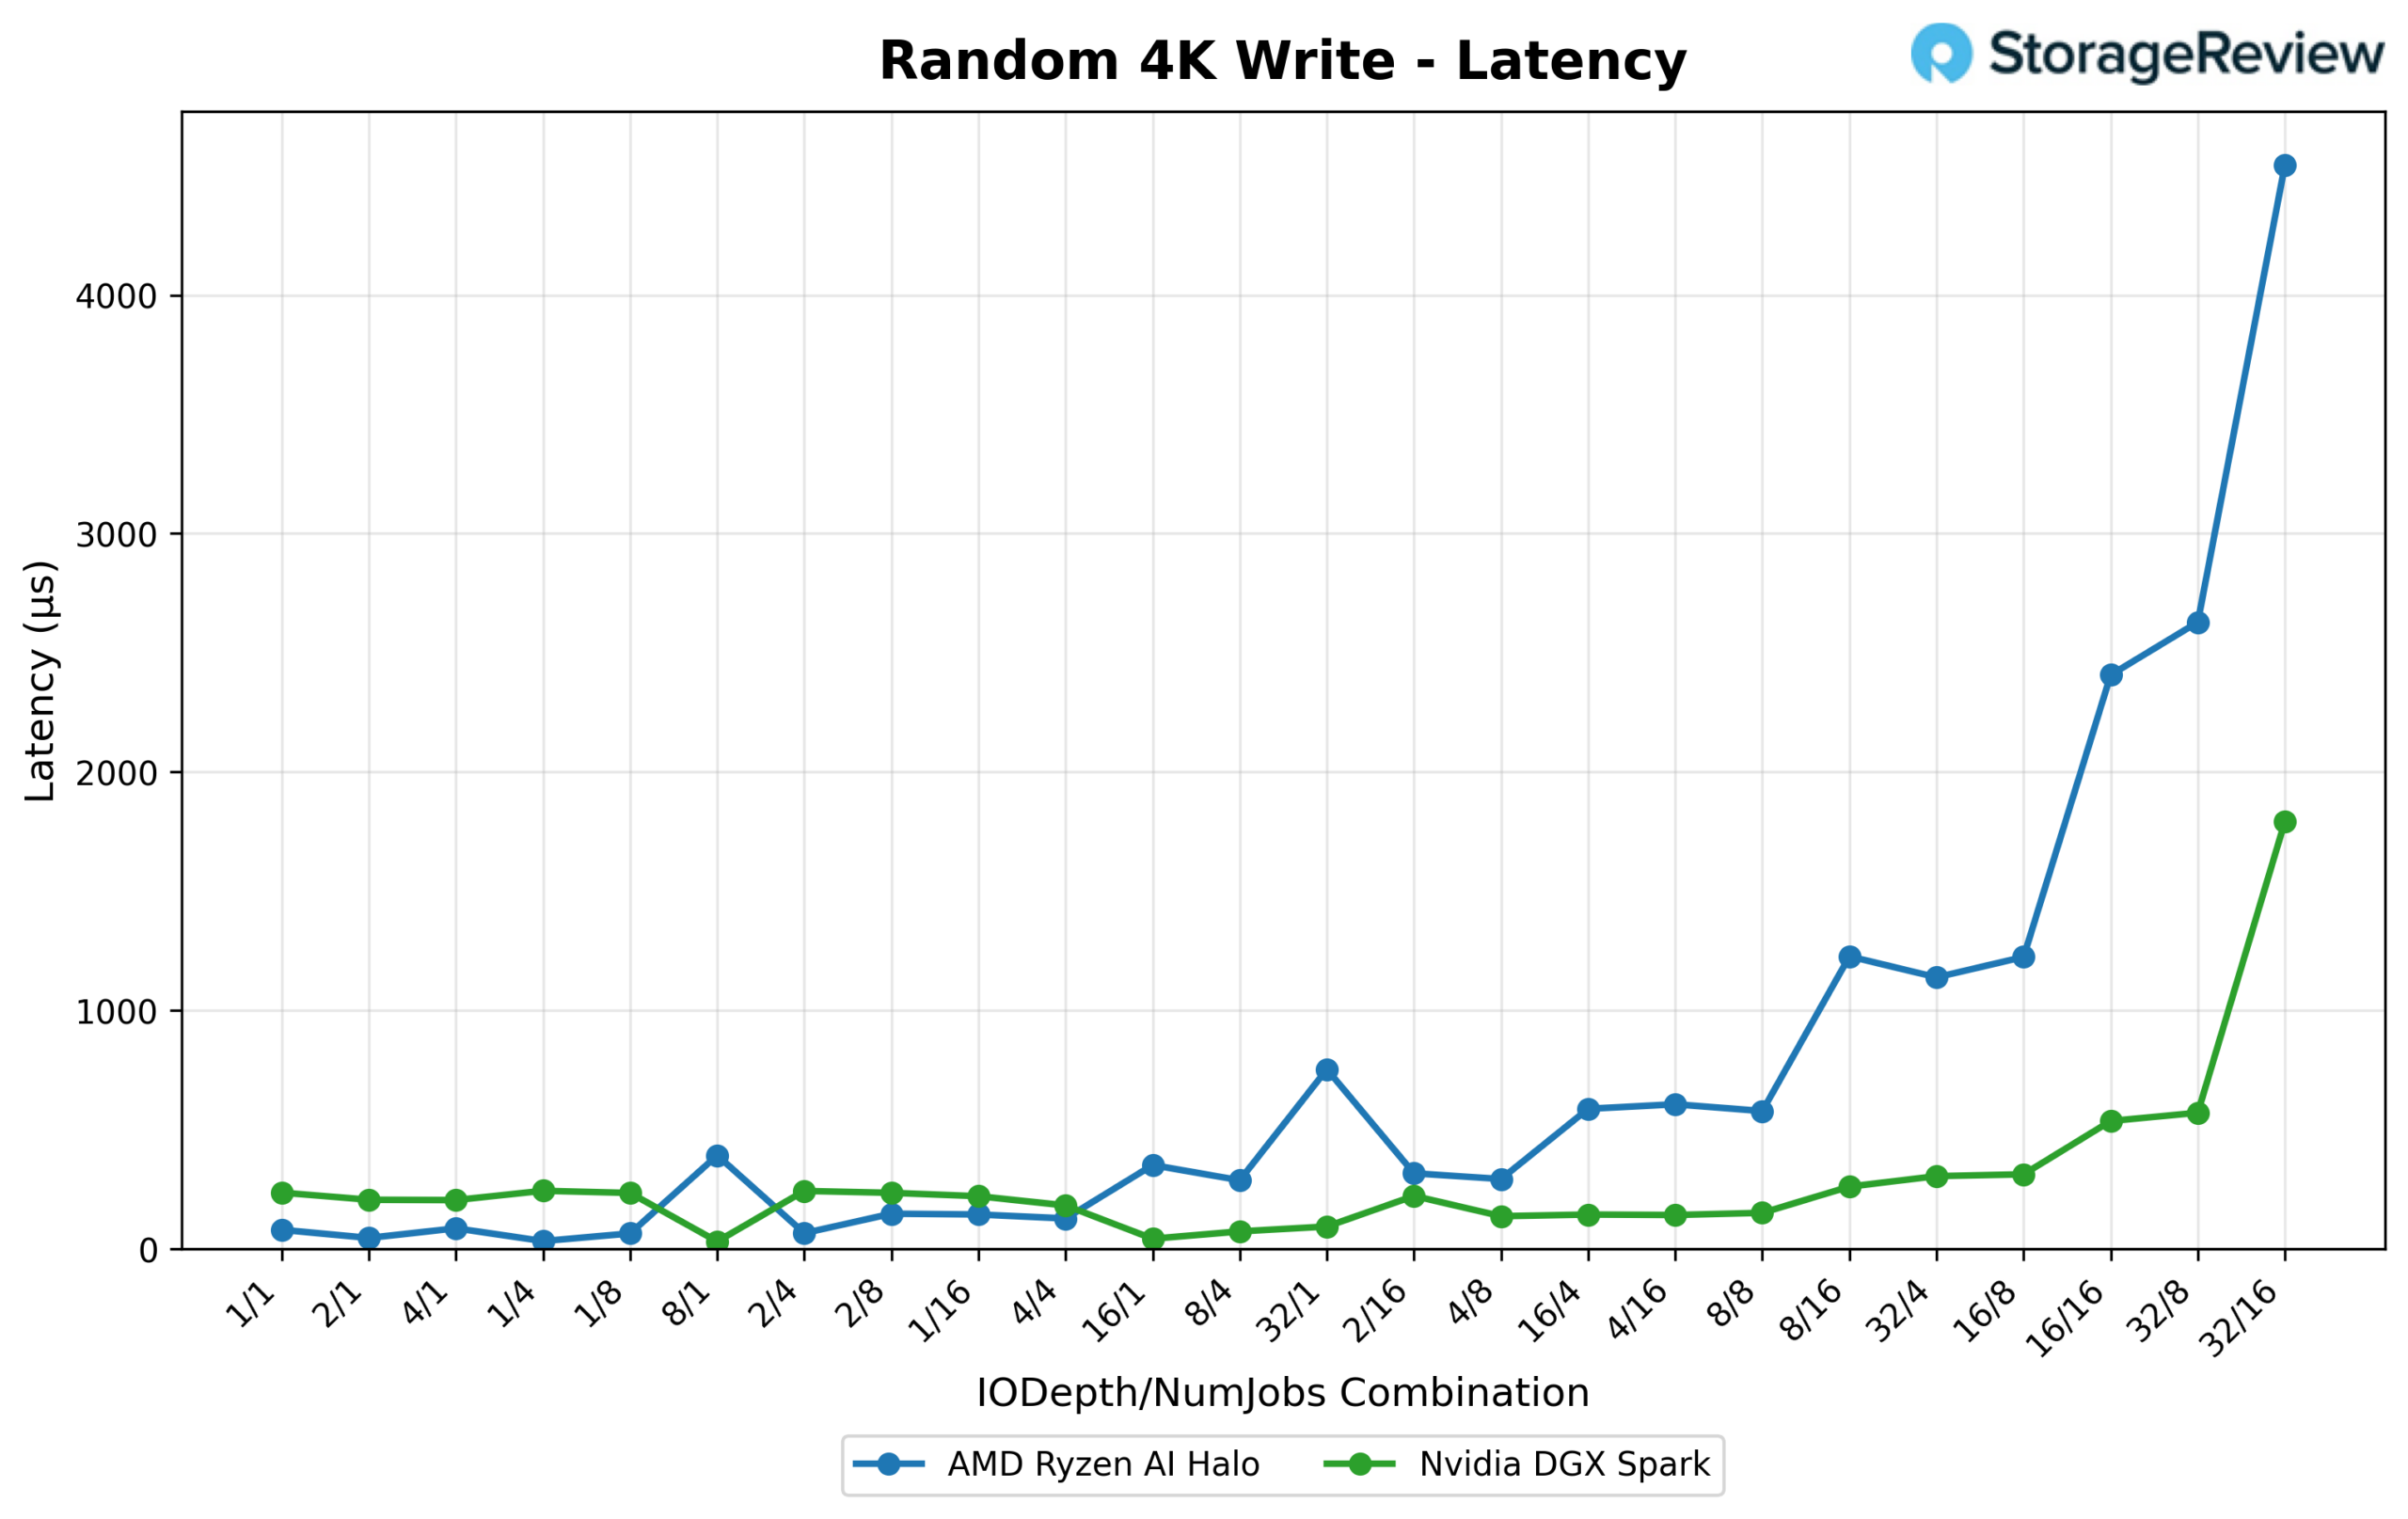
Anche in questo caso, la latenza è a favore di Halo a bassa profondità di coda (0.079 ms contro 0.235 ms a 1/1). A 32/16, la latenza media di Halo è salita a 4.546 ms, mentre quella di Spark rimane relativamente contenuta a 1.792 ms. Insieme al divario di IOPS, questo è il test in cui il vantaggio di Spark è più pronunciato e più costante sull'intera gamma di profondità/thread.
vLLM Online Serving – Prestazioni di inferenza LLM
vLLM è uno dei motori di inferenza e di erogazione ad alto throughput più diffusi per i LLM. Il benchmark di erogazione online di vLLM valuta le prestazioni di questo motore di inferenza in condizioni di carico reale, con richieste simultanee. Simula carichi di lavoro di produzione inviando richieste a un server vLLM in esecuzione, con parametri configurabili come la frequenza delle richieste, la lunghezza degli input e degli output e il numero di client simultanei. Il benchmark misura metriche chiave, tra cui il throughput (token al secondo), il tempo al primo token e il tempo per token di output (TPOT), aiutando gli utenti a comprendere le prestazioni di vLLM in diverse condizioni di carico.
Abbiamo testato le prestazioni di inferenza su una suite completa di modelli che comprendono diverse architetture, scale di parametri e strategie di quantizzazione per valutare il throughput in diversi profili di concorrenza.
GPT OSS 120B
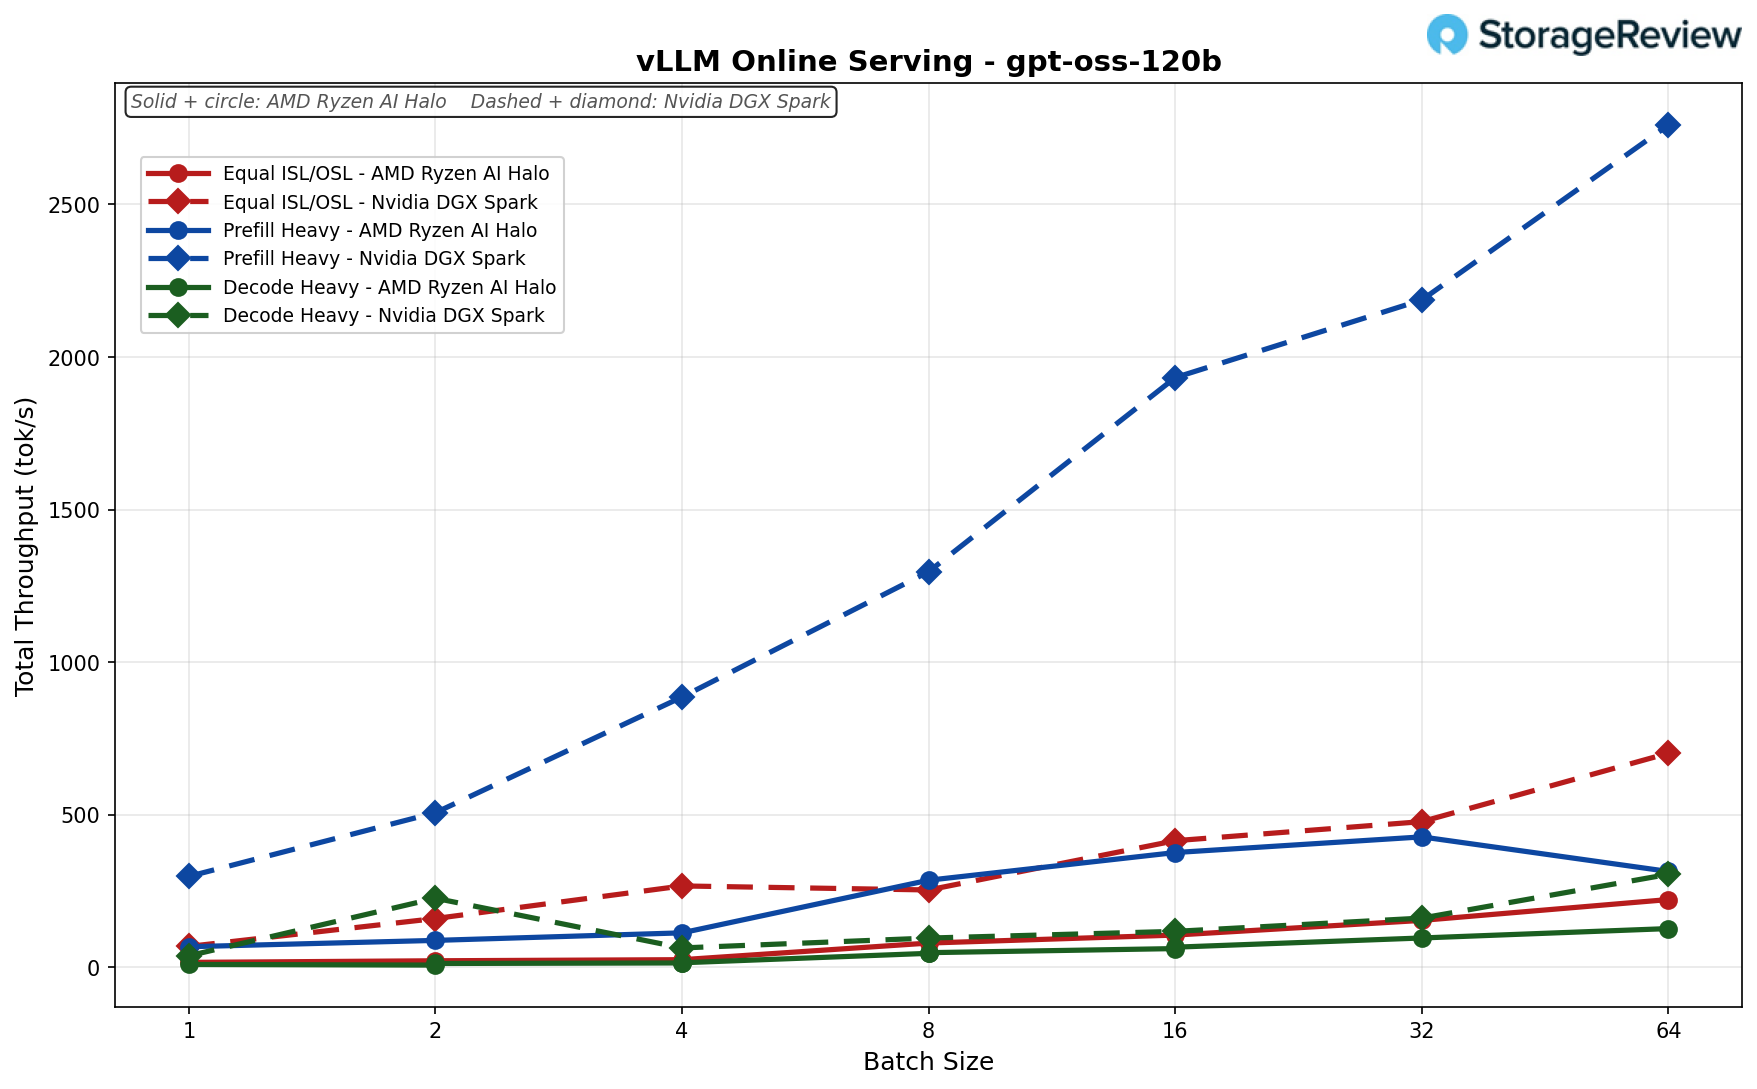
ISL/OSL uguali (256/256): Halo ha raggiunto 222 tok/s con una dimensione del batch di 64, mentre Spark ha raggiunto 701 (circa 3.2 volte inferiore).
Prefill Heavy (8k/1k): la velocità di elaborazione di Halo ha raggiunto il picco al batch 32 (427 tok/s), per poi scendere a 314 al batch 64, mentre Spark è schizzata a 2,760 (circa 8.8 volte) — il divario più ampio del set.
Decodifica pesante (1k/8k): Halo ha raggiunto 127 tok/s, rispetto ai 305 di Spark con dimensione batch 64 (circa 2.4 volte).
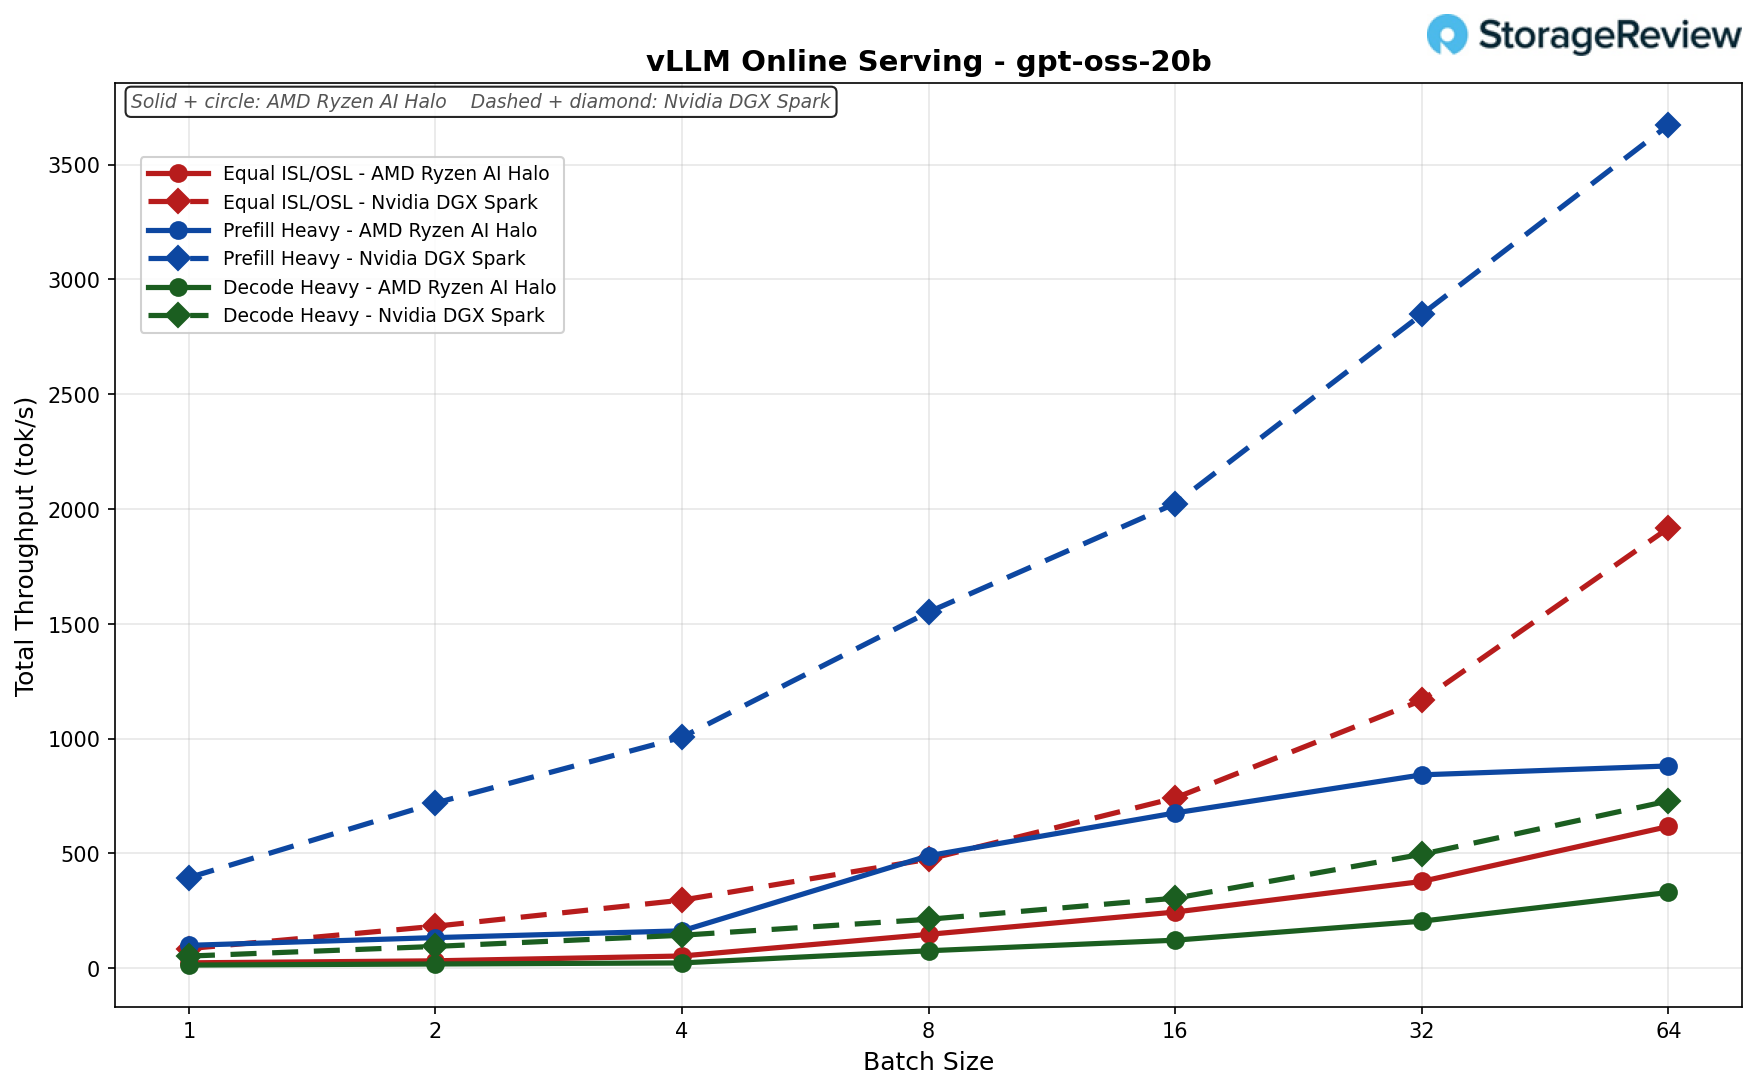
GPT OSS 20B
ISL/OSL uguali (256/256): Spark ha guidato in ogni batch, scalando a 1,917 contro 617 tok/s nel batch 64 (Spark circa 3.1 volte avanti).
Prefill Heavy (8k/1k): il vantaggio più forte di Spark, che sale a 3,672 contro 881 tok/s con una dimensione del lotto di 64 (Spark circa 4.2 volte più avanti).
Decodifica pesante (1k/8k): Spark è in vantaggio su tutta la linea, raggiungendo 728 contro 330 tok/s al batch 64 (Spark è circa 2.2 volte più veloce).
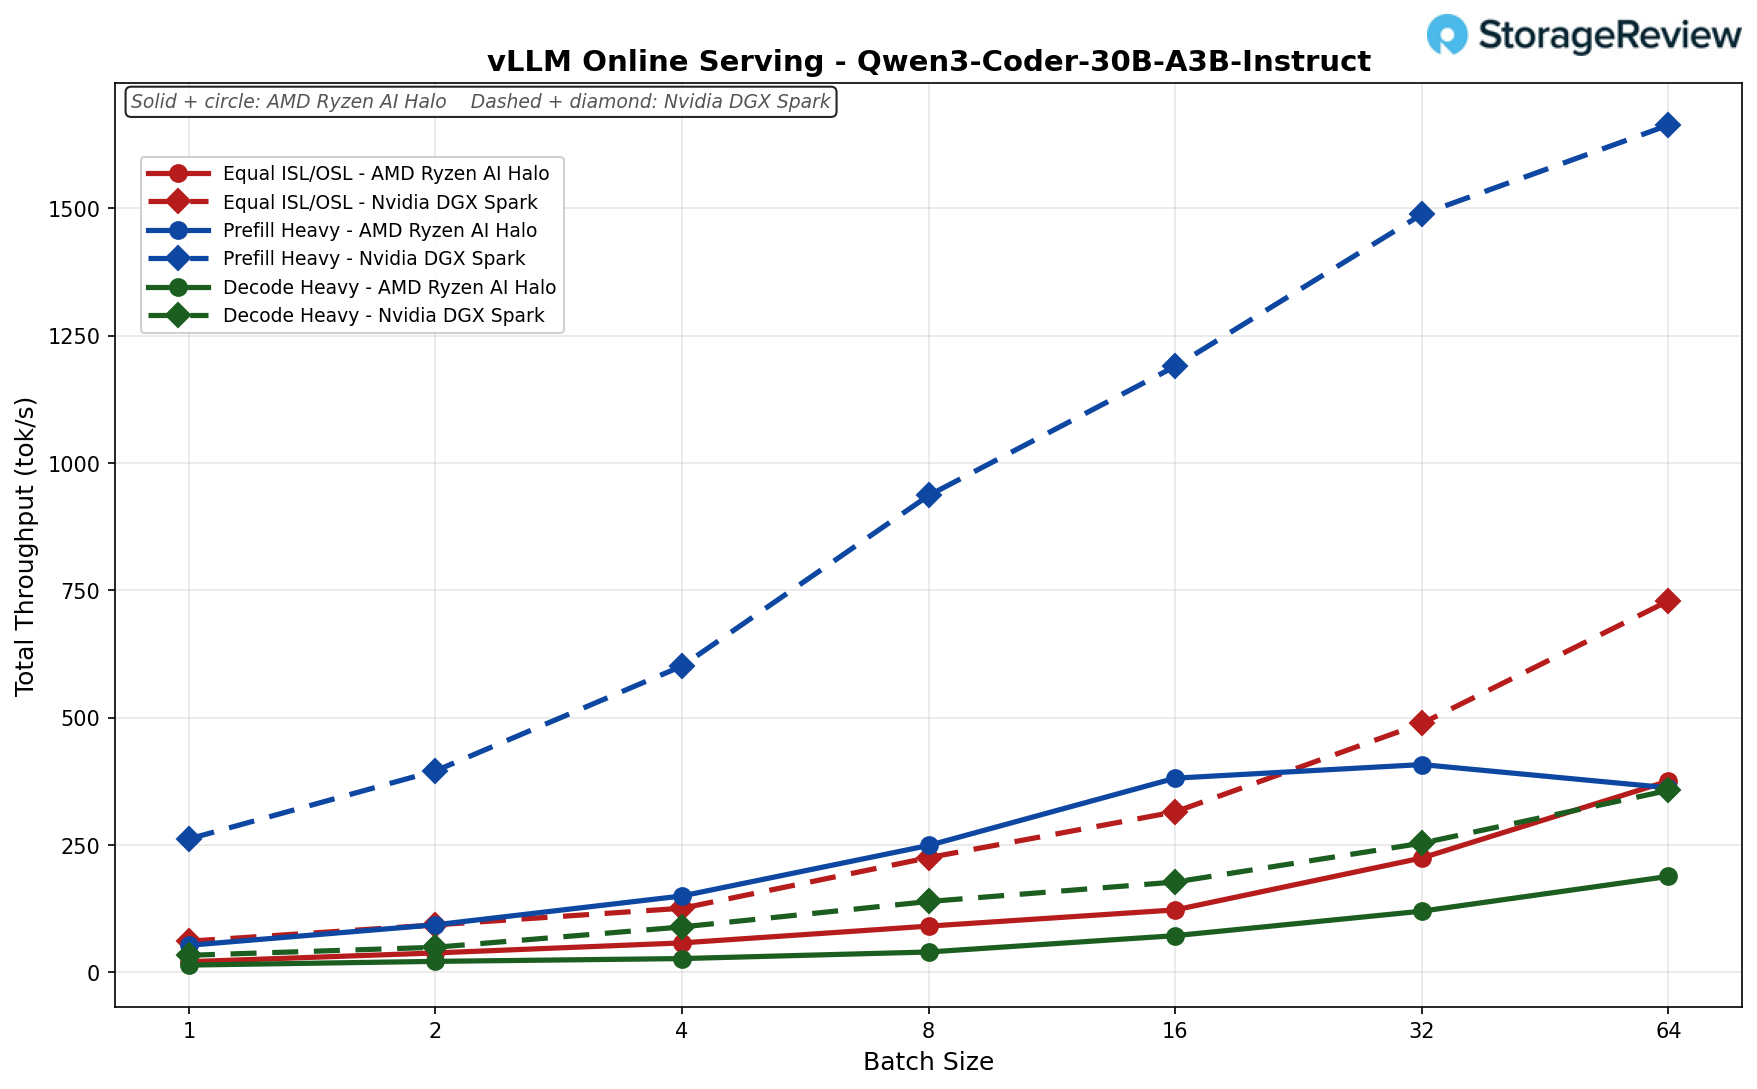
Qwen3 Coder 30B A3B Istruzione
ISL/OSL uguali (256/256): Halo ha raggiunto 376 tok/s con una dimensione del batch di 64, circa la metà dei 729 di Spark (circa 1.9 volte) — uno dei risultati ISL/OSL uguali più stretti.
Prefill Heavy (8k/1k): Halo ha raggiunto il picco al lotto 32 (408 tok/s), poi è sceso a 362 al lotto 64, rimanendo indietro rispetto ai 1,663 di Spark (circa 4.6 volte).
Decodifica pesante (1k/8k): Halo ha raggiunto 188 tok/s, rispetto ai 357 di Spark con dimensione batch 64 (circa 1.9 volte).
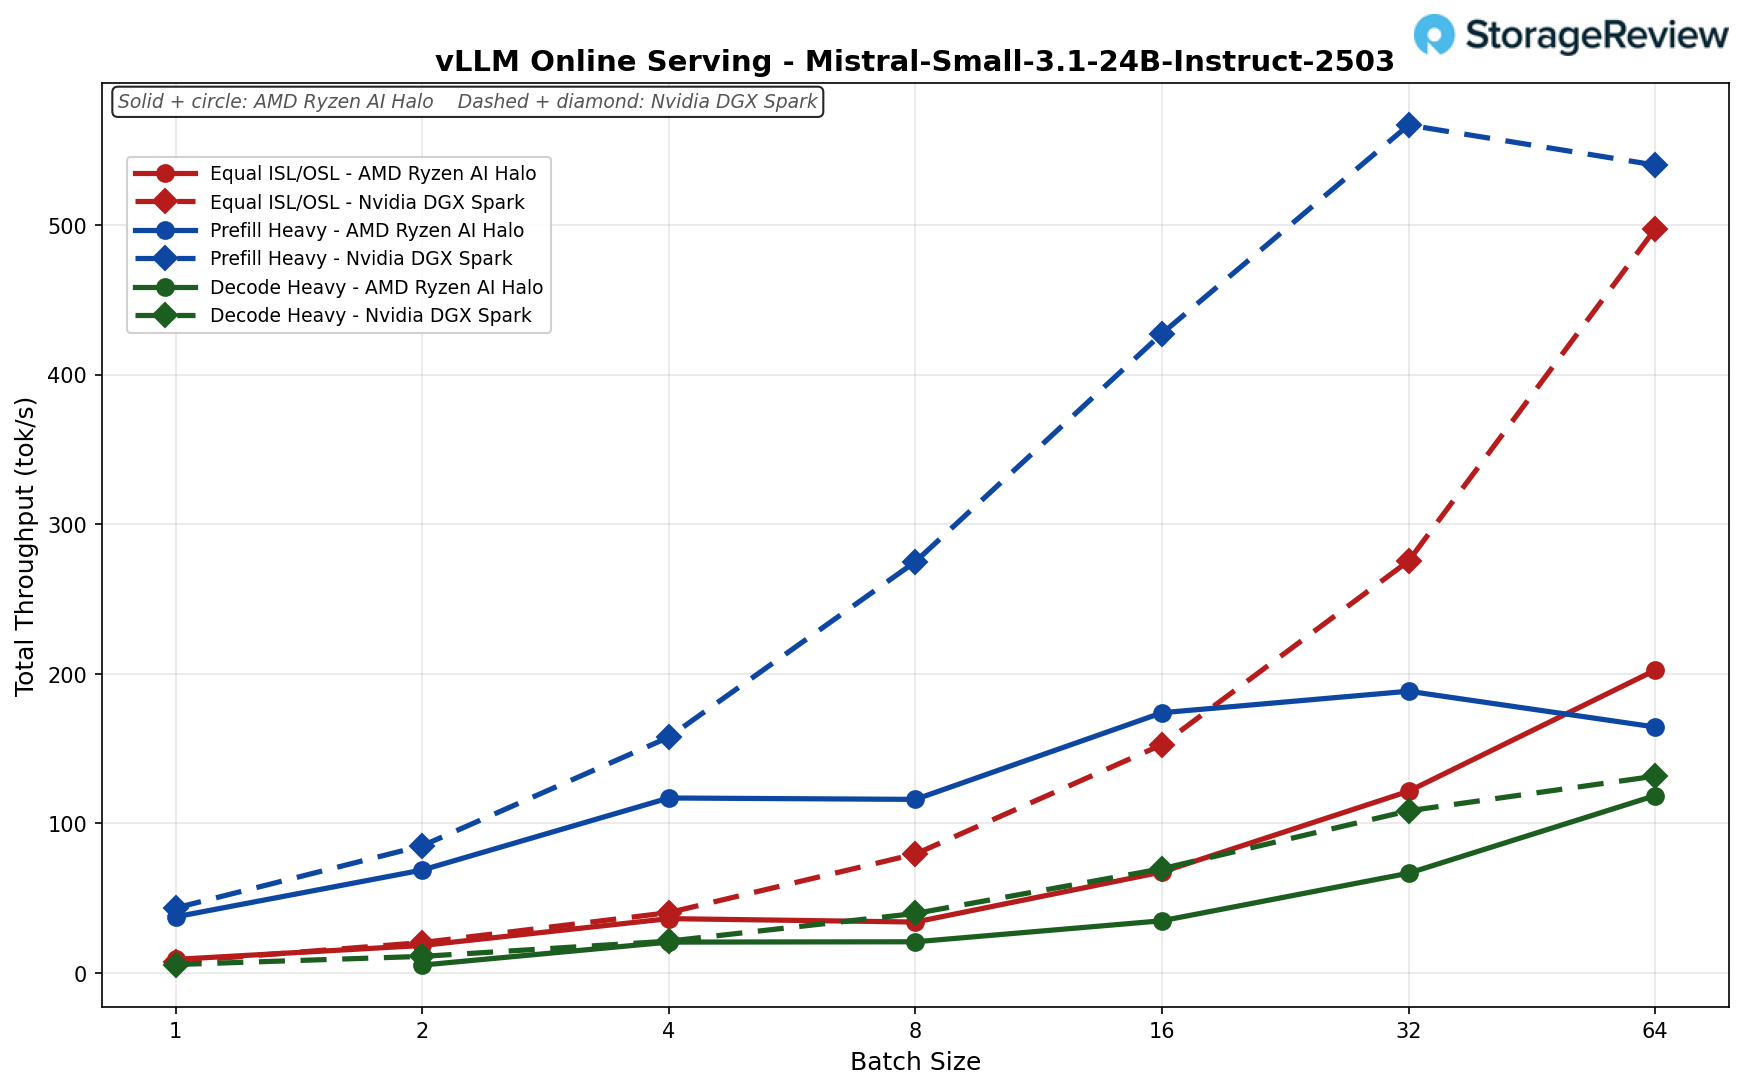
Istruzioni Mistral Small 3.1 24B
ISL/OSL uguali (256/256): Halo era effettivamente in vantaggio nel batch 1 (9 contro 8 tok/s), poi si è stabilizzato a 202 tok/s nel batch 64, mentre Spark era a 498 (circa 2.5 volte indietro).
Preriempimento pesante (8k/1k): Halo ha raggiunto il picco al lotto 32 (188 tok/s) ed è sceso leggermente a 164 al lotto 64, rimanendo indietro rispetto ai 540 di Spark (circa 3.3 volte).
Decodifica pesante (1k/8k): Quasi alla pari per tutta la durata, Halo ha raggiunto 119 tok/s contro i 132 di Spark al batch 64 (entro circa l'11%).
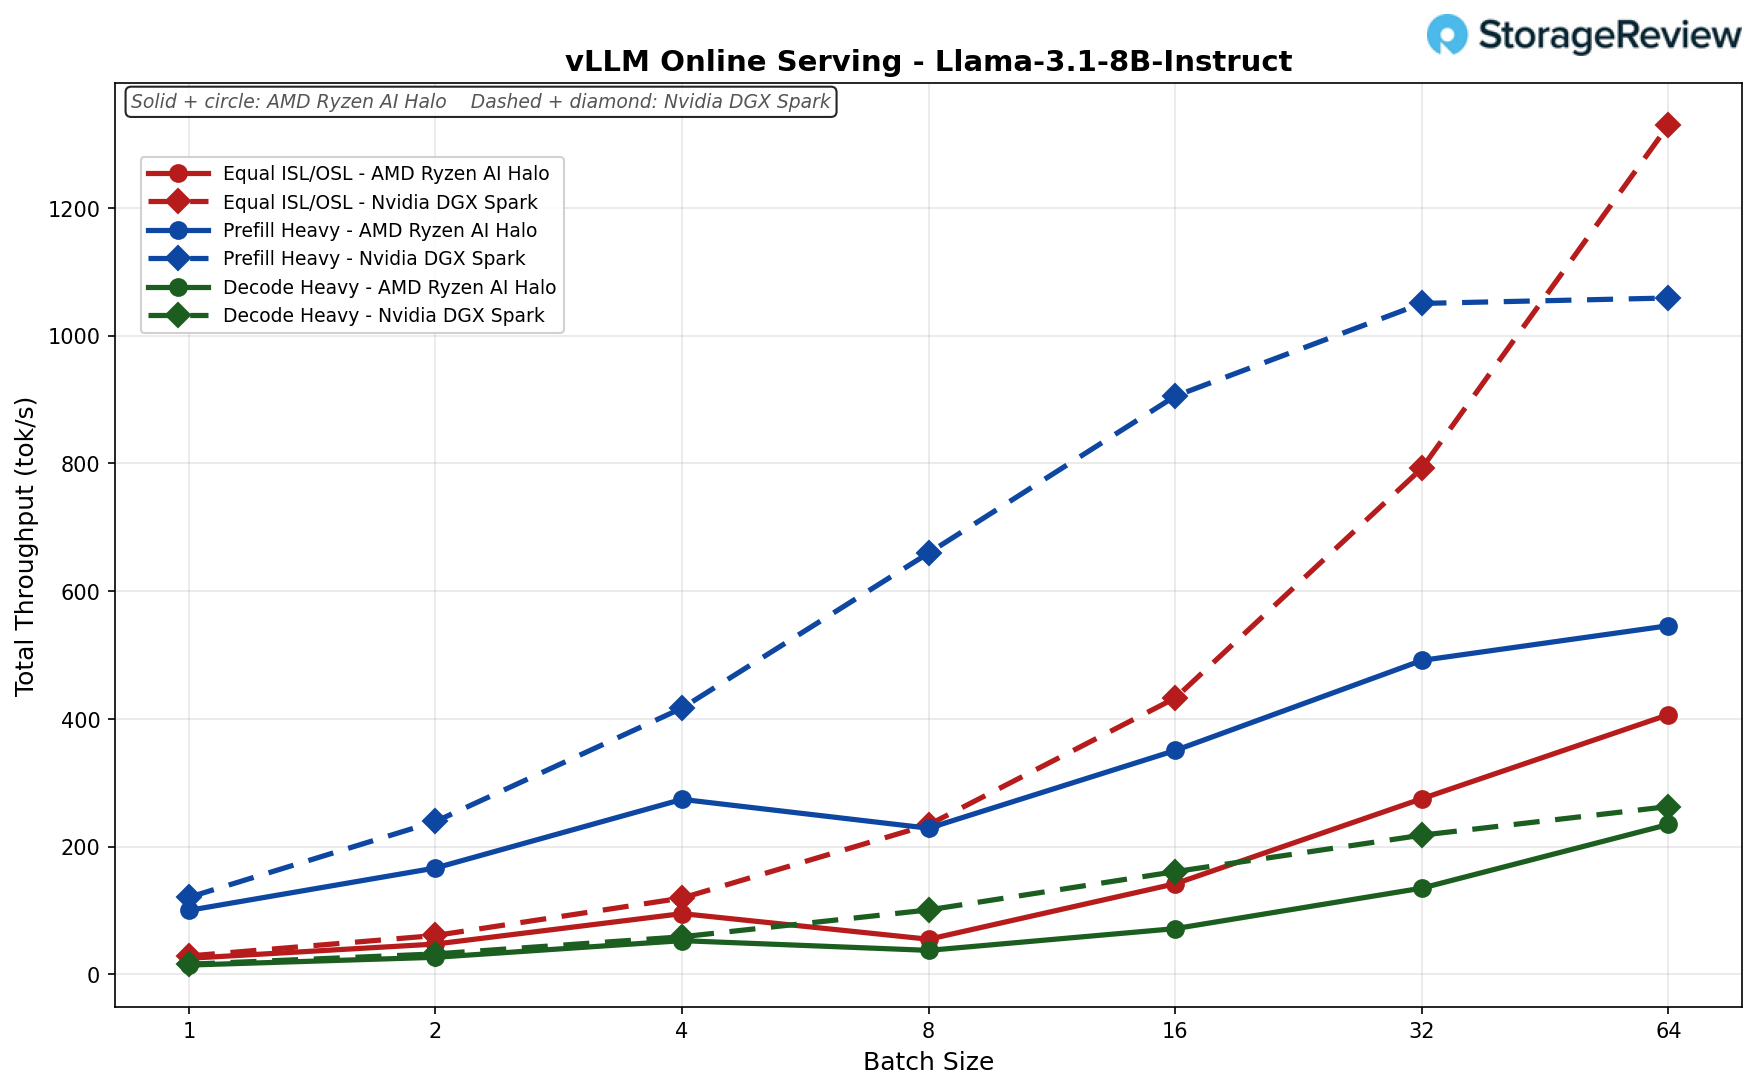
Lama 3.1 8B Istruzioni
ISL/OSL uguali (256/256): Halo è passato in modo pulito da 25 tok/s al batch 1 a 407 tok/s al batch 64, seguendo da vicino Spark fino al batch 4, dopodiché Spark ha preso il sopravvento fino a 1,330 (Halo era indietro di circa 3.3 volte al picco).
Preriempimento pesante (8k/1k): Halo ha raggiunto 546 tok/s con una dimensione del lotto di 64, contenendo circa la metà dei 1,059 di Spark.
Decodifica pesante (1k/8k): Lo scenario più competitivo di Halo, che raggiunge 235 tok/s contro i 263 di Spark con una dimensione del batch di 64 (entro circa il 12%).
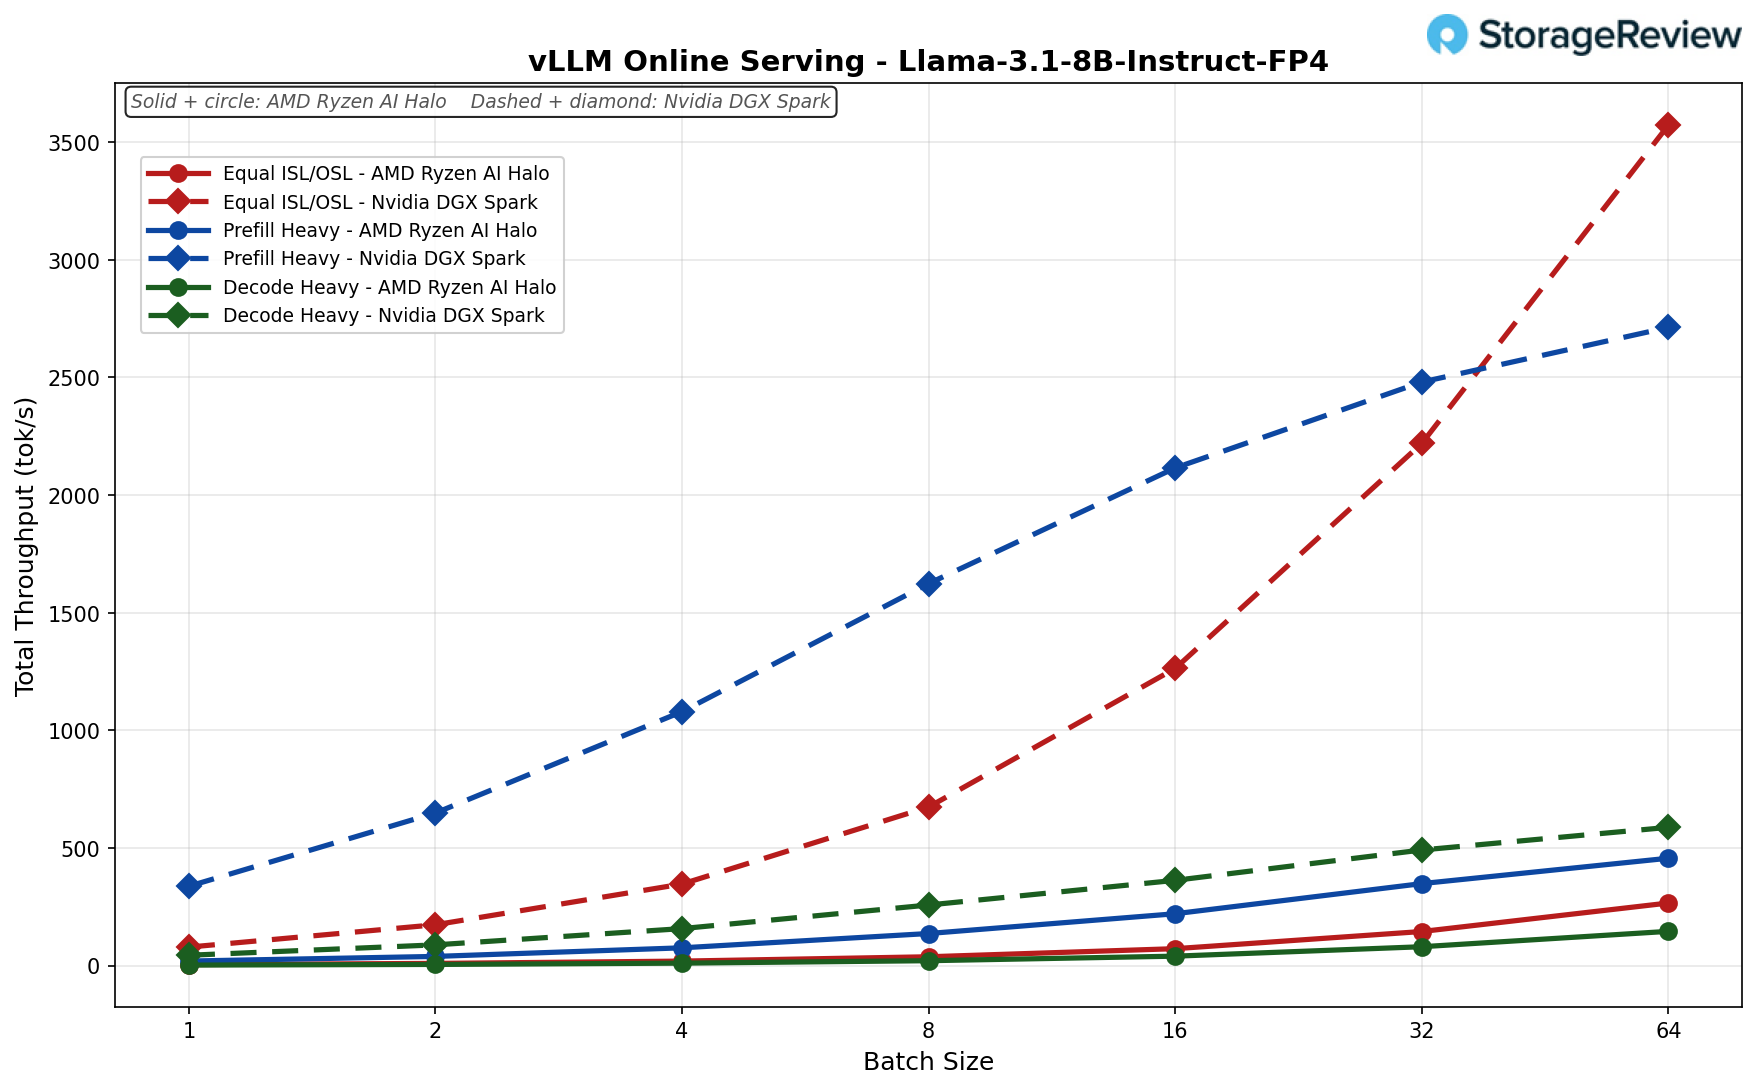
Llama 3.1 8B Istruzione FP4
ISL/OSL uguali (256/256): Halo ha raggiunto un picco di 267 tok/s con una dimensione del batch di 64, molto inferiore ai 3,573 di Spark: FP4 mostra il divario più ampio (circa 13.4 volte).
Preriempimento pesante (8k/1k): Halo ha raggiunto 457 tok/s con una dimensione del lotto di 64, rispetto ai 2,713 di Spark (circa 5.9 volte).
Decodifica pesante (1k/8k): Halo ha raggiunto una velocità di 146 tok/s, rispetto ai 588 tok/s di Spark con una dimensione del batch di 64 (circa 4 volte).
Conclusione
L'AMD Ryzen AI Halo entra in una categoria che NVIDIA ha di fatto creato con il DGX Spark, e non cerca di battere lo Spark sul suo stesso terreno. Nei nostri test vLLM, lo Spark ha mantenuto un vantaggio di throughput da 2 a 4 volte superiore nella maggior parte degli scenari con maggiore concorrenza, arrivando a 8.8 volte nei lavori GPT OSS 120B con pre-riempimento intensivo e riducendosi a circa il 10% solo in un paio di test con forte decodifica, e il suo sottosistema di storage ha vinto quasi tutti i test fio a saturazione. Ciò che l'Halo offre invece sono gli stessi 128 GB di memoria unificata e un limite di 200 miliardi di parametri in un ingombro simile, a 3,999 dollari contro i 4,699 dollari dello Spark Founders Edition (anche se alcuni OEM lo offrono a meno di 4,000 dollari), in una macchina x86 completa che avvia Windows 11 o Linux anziché solo DGX OS.
Mettendo da parte lo Spark, l'Halo si conferma la migliore implementazione di Ryzen AI Max+ 395 che abbiamo testato. Ha ottenuto i punteggi più alti contro HP Z2 Mini G1a e ZBook Ultra G1a in quasi tutti i carichi di lavoro Windows che abbiamo eseguito: 37,316 in Cinebench R23 multi-core, 184.2 GIPS in 7-Zip contro 151.6 e 156.8 per gli HP, i punteggi più alti nella generazione di testo e immagini con Procyon AI e i tempi più rapidi con y-cruncher a 5 e 10 miliardi di cifre. Su Linux, contro lo Spark, ha vinto nettamente i test Phoronix, limitati dalla CPU, comprimendo l'11% più velocemente in 7-Zip e completando la compilazione LLVM il 14% prima. Si tratta di una workstation compatta, la prima nel suo genere, con il ruolo di sviluppatore AI sovrapposto anziché sostituirlo.
Gli sviluppatori che necessitano del massimo numero di token locali al secondo, o che intendono raggruppare i nodi su una rete ad alta velocità, dovrebbero comunque acquistare Spark; le prestazioni di Halo, con la sua connettività 10GbE e i limiti di vLLM, sono nettamente inferiori. Per gli sviluppatori che lavorano con ROCm, per i team che necessitano di Windows o per chiunque desideri un unico dispositivo in grado di gestire carichi di lavoro professionali e modelli locali, Halo rappresenta la soluzione migliore. Inoltre, lo slot M.2 2280 standard e la memoria grafica variabile preconfigurata risolvono due dei problemi più comuni lamentati dai possessori di Spark. AMD ha anche annunciato che la piattaforma integrerà i processori Ryzen AI Max PRO serie 400 con fino a 192 GB di memoria unificata nel terzo trimestre, offrendo così agli acquirenti che puntano a modelli più performanti una valida alternativa senza dover cambiare piattaforma.
Pagina del prodotto – AMD Ryzen AI Halo
Classifica: AMD Ryzen AI Halo si aggiudica il primo posto nella nostra classifica dei migliori desktop per l'intelligenza artificiale locale come alternativa x86.



 Amazon