

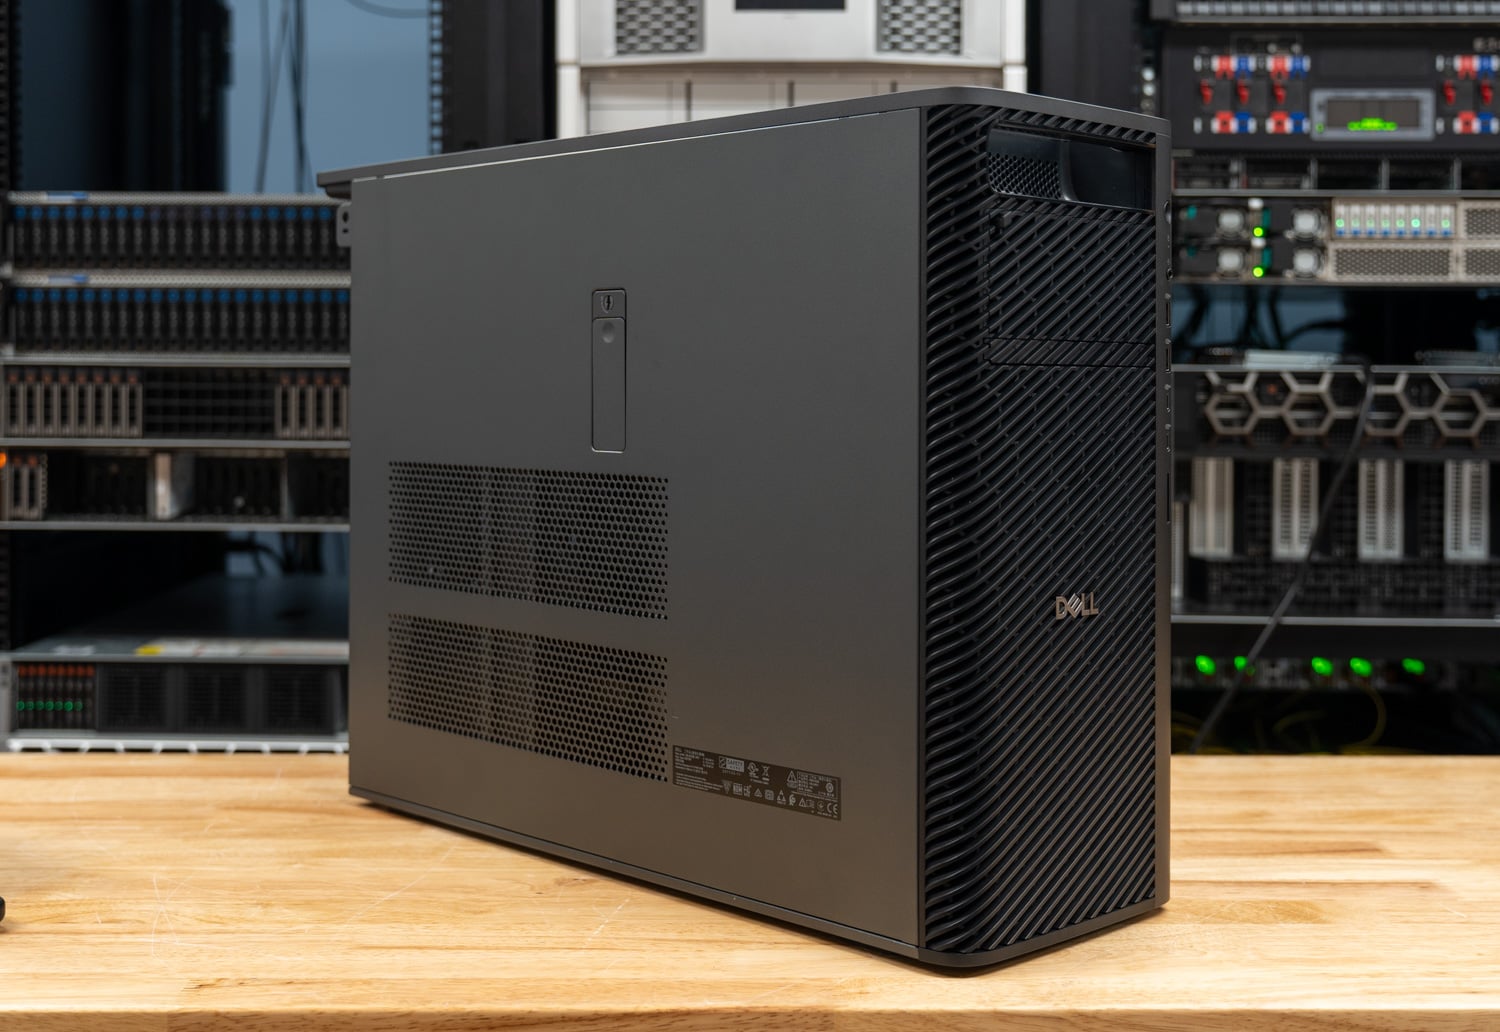
Il Dell Pro Precision 9 T4 è il tower a singolo socket di punta della linea Pro Precision di Dell e l'unità che abbiamo testato è configurata per l'intelligenza artificiale locale su una scala che la maggior parte delle workstation non può raggiungere. È dotato di un processore Intel Xeon 698X a 86 core con 256 GB di memoria DDR5-6400 ECC, due schede NVIDIA RTX PRO 6000 Blackwell Max-Q da 300 W con 96 GB di GDDR7 ciascuna, due SSD Gen5 da 2 TB e un adattatore dual-port da 25 GbE, alimentato da un alimentatore da 2400 W. Con la stessa configurazione, il prezzo di listino su Dell.com si aggira intorno ai 66,600 dollari.
Punti chiave
- Due GPU permettono di trasformare un modello che non entra in una singola scheda in un modello utilizzabile. MiniMax M2.7 da 129.3 GB ha generato 83.7 token al secondo per un utente quando suddivisi tra entrambe le schede RTX PRO 6000, 2.8 volte i 30.3 token al secondo ottenuti con una sola scheda e il resto del modello nella memoria di sistema.
- La seconda GPU ha scalato le prestazioni di servizio da 1.85 a 2.02 volte e quelle di embedding di 1.92 volte. La produzione di picco di llama.cpp è aumentata da 582.5 a 1,176.1 token al secondo su Ministral 3 3B e da 424.8 a 787.9 su gpt-oss 120B con un server per GPU, e l'incorporamento di un milione di passaggi di Wikipedia è sceso da 890 a 464 secondi.
- Una seconda GPU ha ridotto del 37% la durata di un'epoca LoRA. Un'epoca di LoRA su Ministral 3 8B ha richiesto 31.5 minuti su una GPU e 19.7 minuti su due, terminando con perdite di 1.169 e 1.167.
- La larghezza di banda della memoria è il punto di forza dello Xeon del T4. STREAM Triad ha raggiunto 328 GB/s, il 53% in più rispetto al Threadripper PRO 9995WX nel Precision 7875, e il T4 ha completato la risoluzione di OpenFOAM drivAer in 293 secondi contro 556 e un'esecuzione di y-cruncher da 10 miliardi di cifre in 53.9 secondi contro 83.7.
- Il Precision 7875 eccelle nelle elaborazioni CPU ad alto carico di lavoro. Il Threadripper a 96 core ha ottenuto un risultato migliore del 37% in 7-Zip e del 30% in Blender Monster, completando la compilazione LLVM in 43.7 secondi contro i 58.4 dell'altro processore.
Dove si trova il Pro Precision 9 T4
Dell posiziona la T4 come workstation tower a singolo socket di punta per le organizzazioni che necessitano della massima densità di calcolo ed espandibilità, con lo sviluppo di intelligenza artificiale, la simulazione ingegneristica e il calcolo scientifico in cima alla lista dei carichi di lavoro. Si colloca al di sopra della Dell Pro Precision 9 T2 , che utilizza la stessa piattaforma workstation Granite Rapids-WS Xeon 6 in uno chassis più piccolo con una sola GPU. La T4 aggiunge i processori a otto canali di punta della gamma, fino a 86 core, e spazio per un massimo di quattro schede grafiche, a seconda del modello.
Le opzioni di processore su Dell.com partono dallo Xeon 634 a 12 core e arrivano allo Xeon 696X a 64 core fino allo Xeon 698X a 86 core presente nella nostra unità, che dispone di 336 MB di cache, una frequenza base di 2.0 GHz, una frequenza massima di 4.8 GHz e un consumo di 350 W. La memoria arriva fino a 4 TB di DDR5 RDIMM distribuiti su 16 slot, e la nostra unità ne occupa otto con moduli da 32 GB a 6400 MT/s. La scheda grafica parte da una singola RTX A400, e il numero di schede dipende dal modello: il configuratore Dell elenca quattro schede RTX A1000, tre schede RTX PRO 4000 Blackwell, due schede RTX PRO 6000 Max-Q da 300 W o una RTX PRO 6000 da 600 W.
La configurazione base è quotata a 5,925 dollari su Dell.com. La nostra configurazione aggiunge 8,300 dollari per lo Xeon 698X, 15,000 dollari per i 256 GB di memoria e 30,820 dollari per la coppia di schede RTX PRO 6000 Max-Q, prima di considerare storage, rete e l'aggiornamento ProSupport di 36 mesi che Dell aggiunge automaticamente a una configurazione di questo livello.
Costruire e disegnare
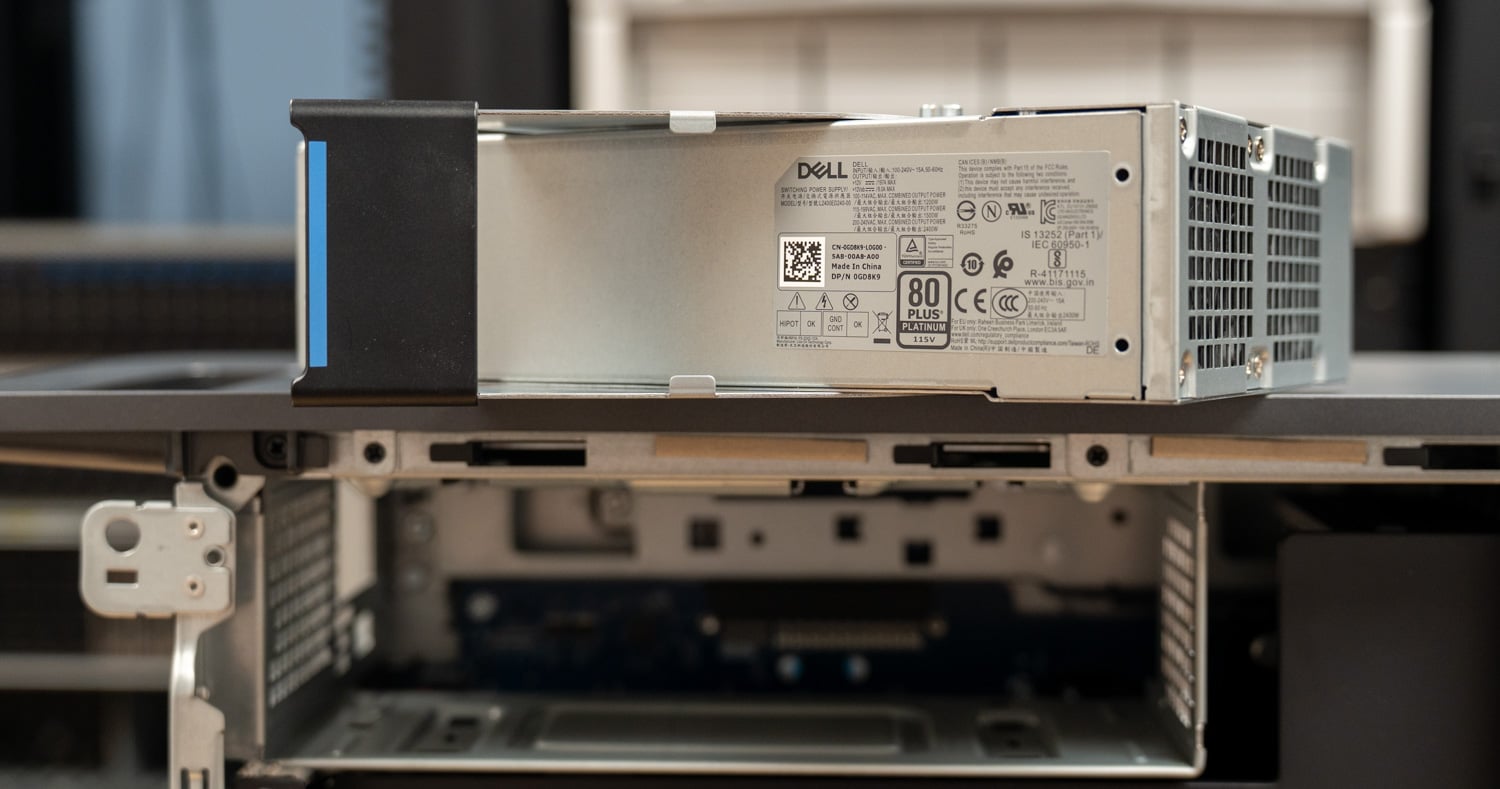
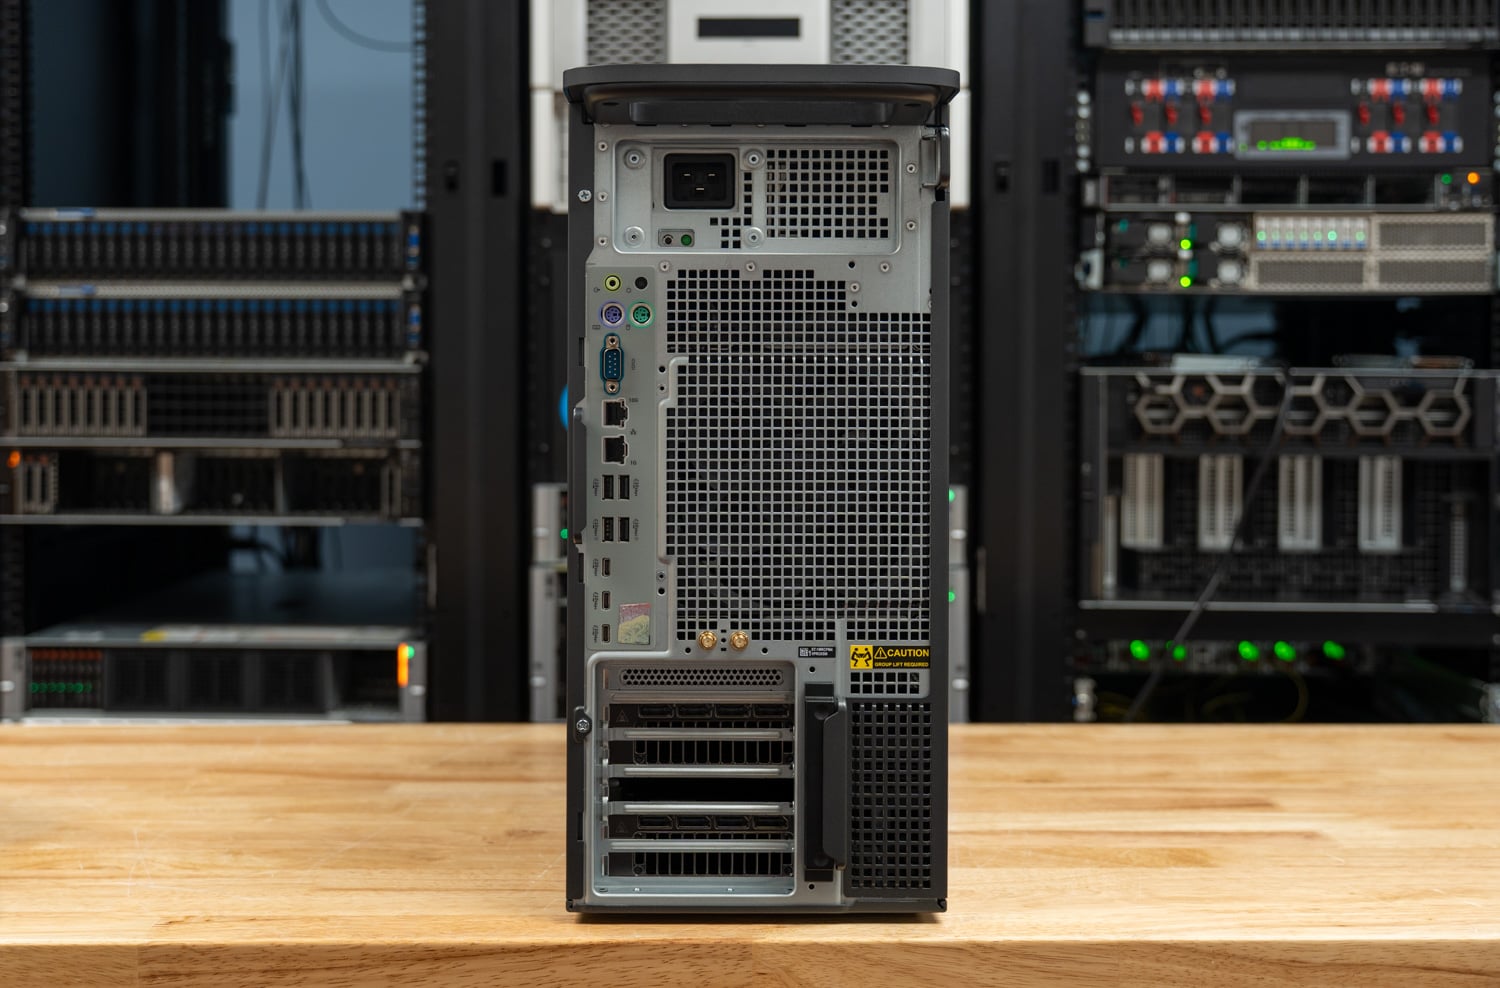
Il T4 è un case full tower con dimensioni di 449.8 mm di altezza, 203.7 mm di larghezza e 617.5 mm di profondità. Dell dichiara un peso minimo di 24.1 kg e un peso massimo di 33.6 kg a seconda della configurazione. La nostra unità utilizza l'alimentatore Platinum da 2400 W, che il configuratore Dell seleziona per la configurazione con due RTX PRO 6000, mentre per le configurazioni più leggere viene utilizzato di default un alimentatore da 1500 W.
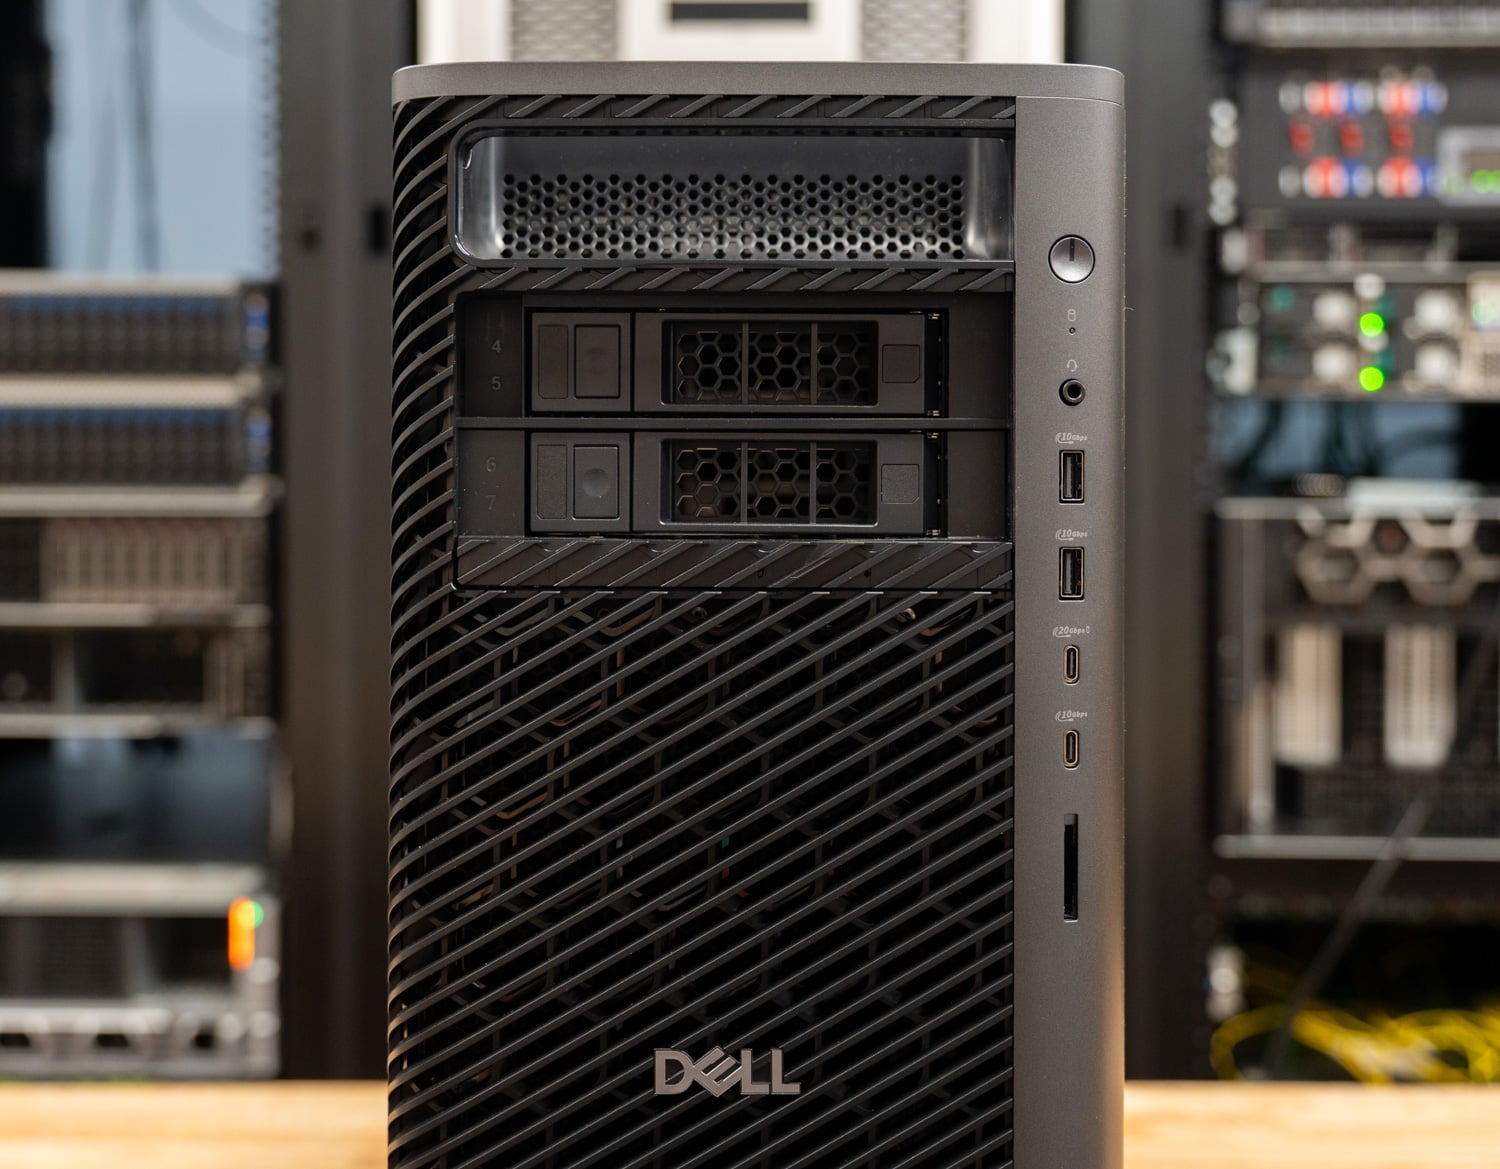
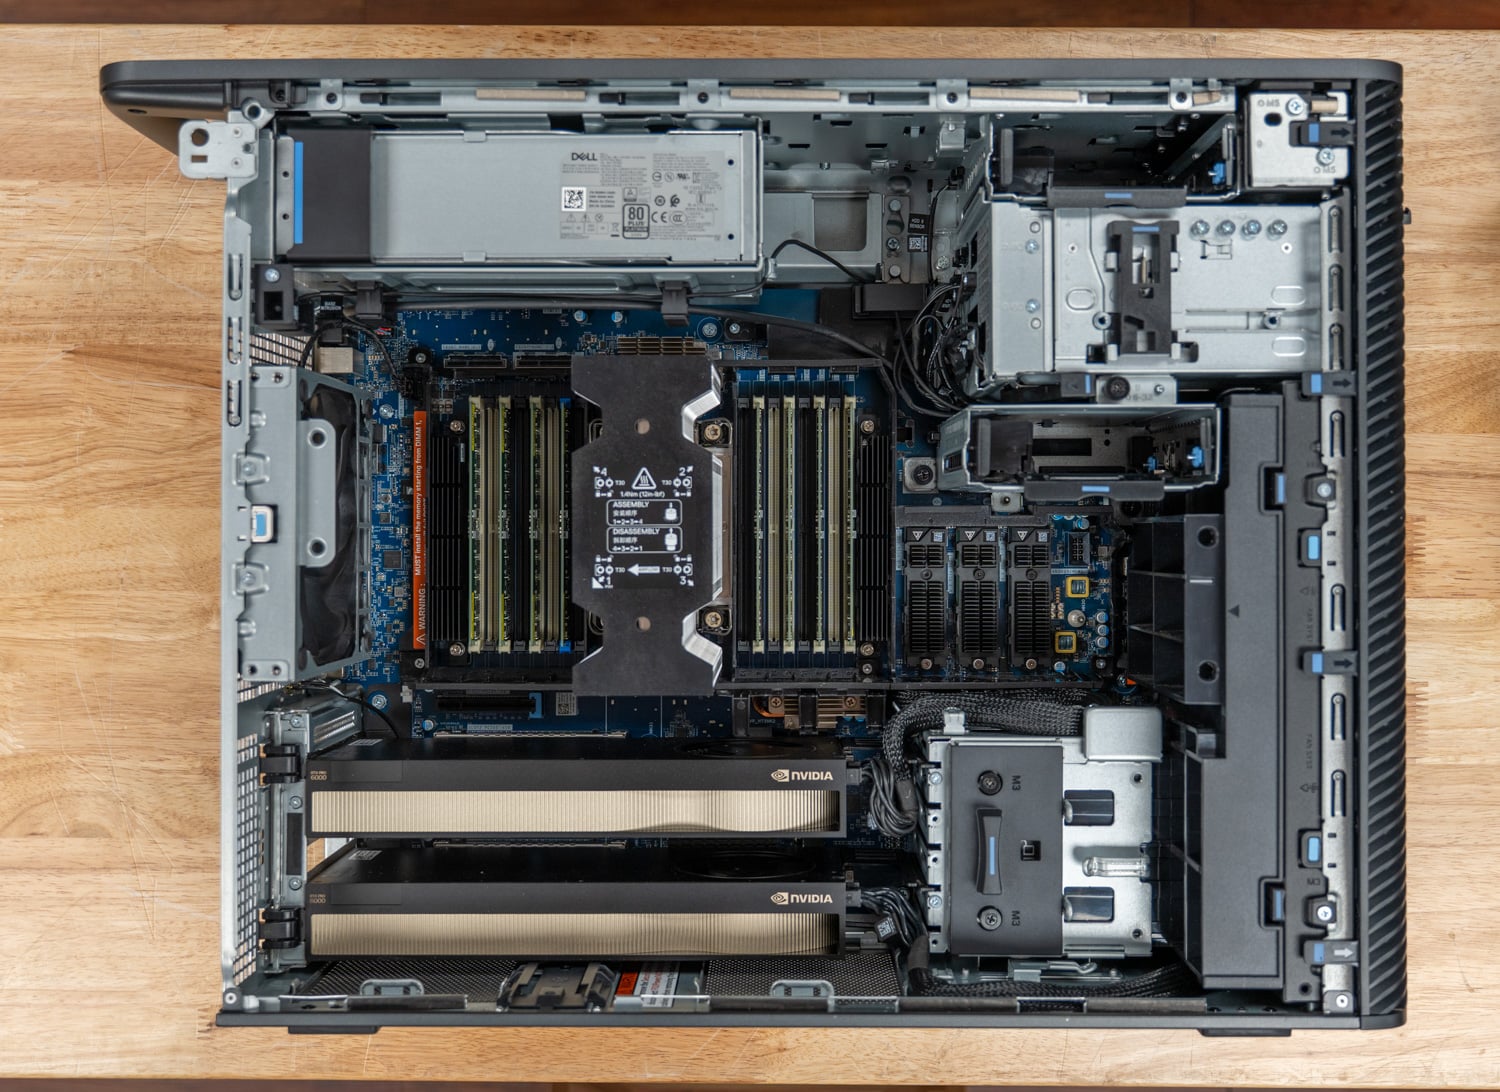
La facilità di manutenzione è un punto di forza del T4, a partire dall'accesso senza attrezzi tramite un fermo sul pannello laterale e dall'alimentatore da 2400 W che scorre manualmente fuori dalla parte superiore posteriore dello chassis. Tutto il resto, comprese le schede grafiche e gli SSD, si rimuove con un cacciavite a croce, e i punti di contatto blu di Dell contrassegnano i componenti che si estraggono manualmente. Il laboratorio ha riscontrato che la piattaforma è facile da riparare sul campo, un aspetto importante per una workstation di questo prezzo.
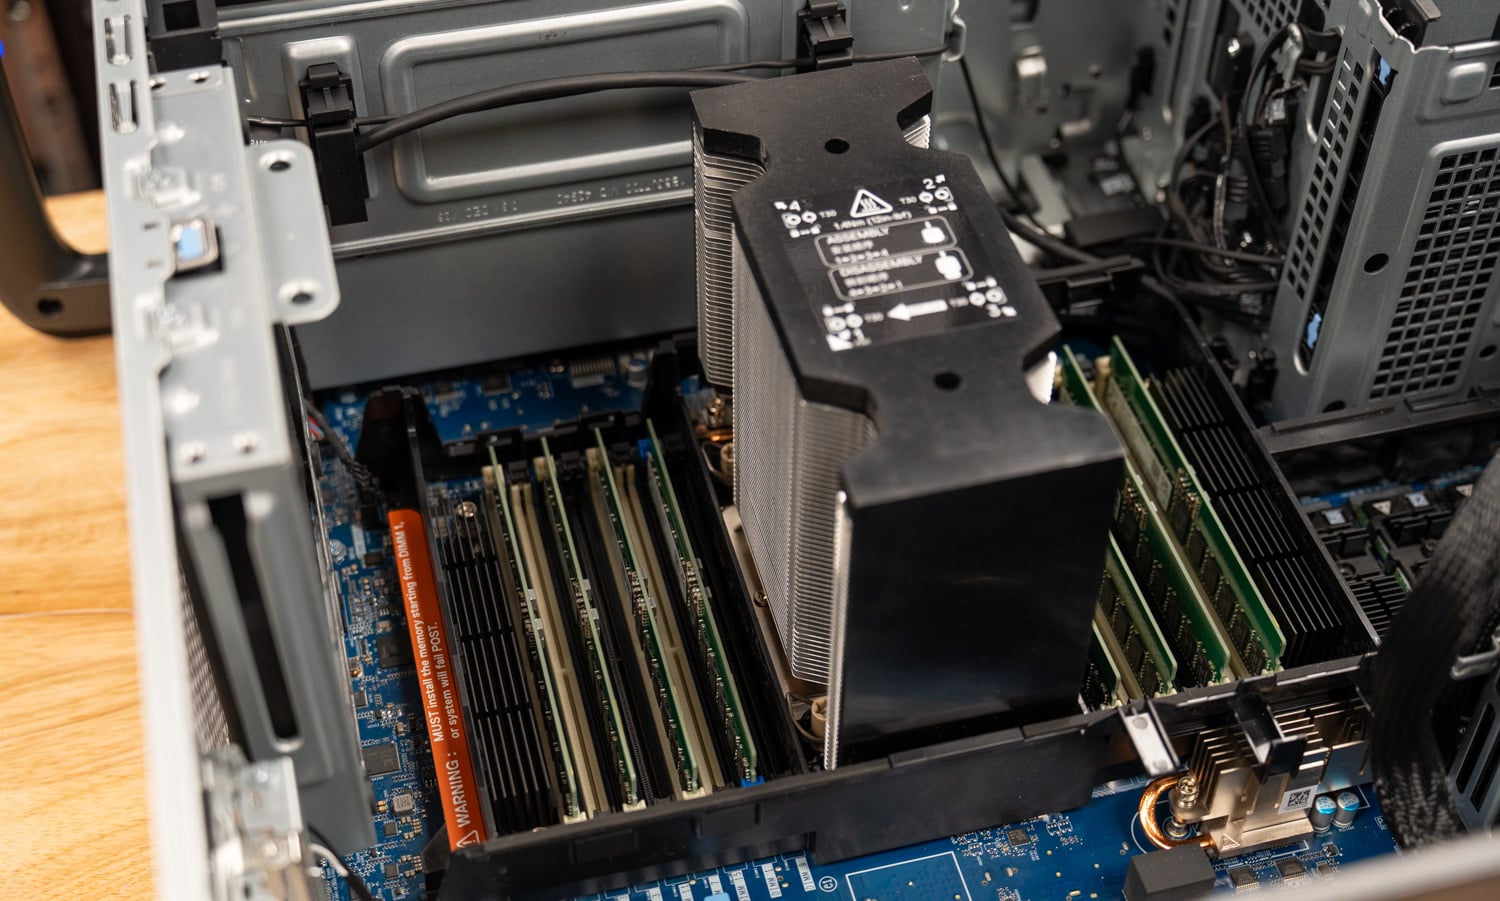
Il sistema di raffreddamento è il migliore che abbiamo visto da Dell in questa categoria di case tower. L'aria si muove dalla parte anteriore a quella posteriore e ampie prese d'aria sagomate la convogliano verso il basso e attraverso il processore e la memoria, mantenendo questo canale separato dall'area PCIe. Le due schede grafiche da 300 W aspirano quindi da un flusso d'aria separato e non ereditano il calore dallo Xeon da 350 W. Con le prese d'aria in posizione, due ventole si trovano tra la zona del processore e il vano schede, e l'assemblaggio presenta gli stessi punti di contatto blu e si solleva per accedere alla memoria.
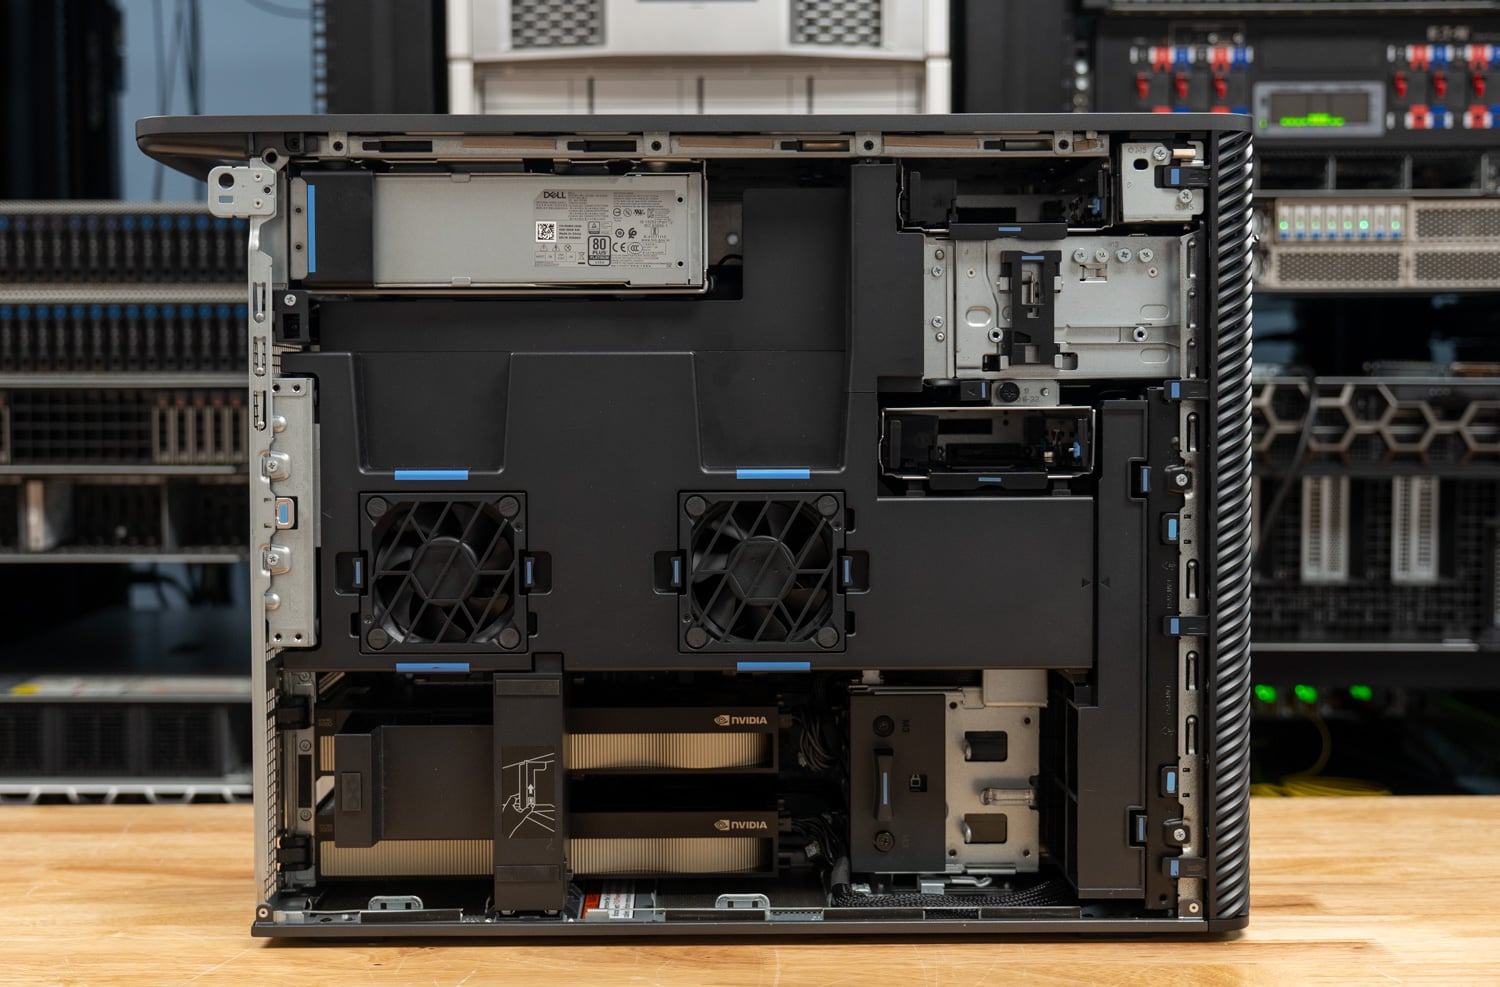
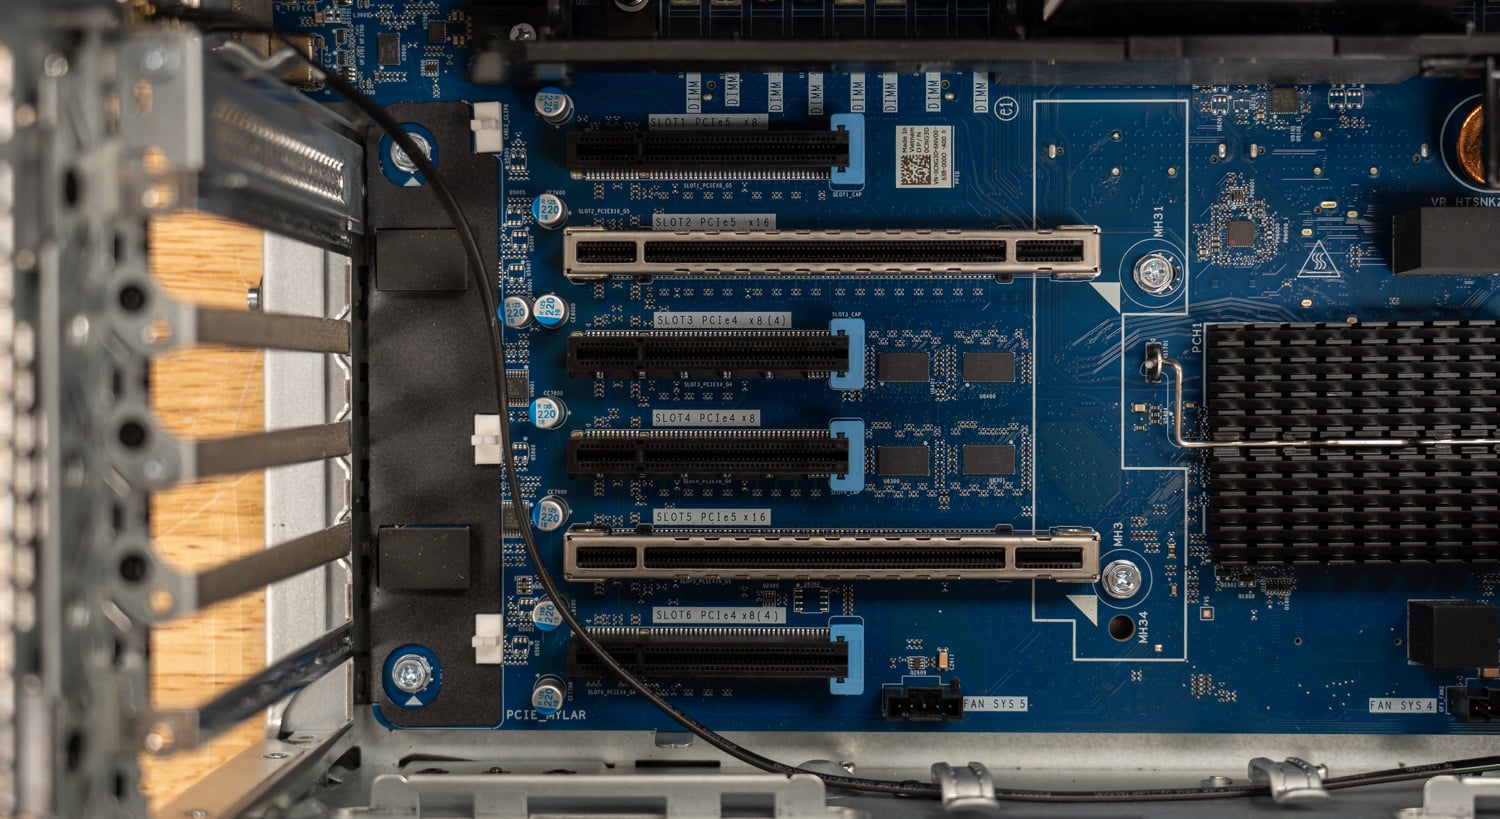
L'espansione avviene tramite sei slot PCIe a tutta altezza: due slot Gen5 x16 che ospitano le GPU, uno slot Gen5 x8, uno slot Gen4 x8 e due slot Gen4 con connettori x8 e cablaggio x4. Lo storage comprende tre slot M.2 Gen5 interni e uno slot Gen4, due alloggiamenti SATA da 3.5 pollici interni e un FlexBay frontale che può ospitare fino a quattro unità NVMe o due unità da 3.5 pollici, con un'unità ottica slim opzionale. La nostra unità si avvia da un'unità Gen5 interna da 2 TB e ospita un'altra unità Gen5 da 2 TB in uno slot M.2 interno.
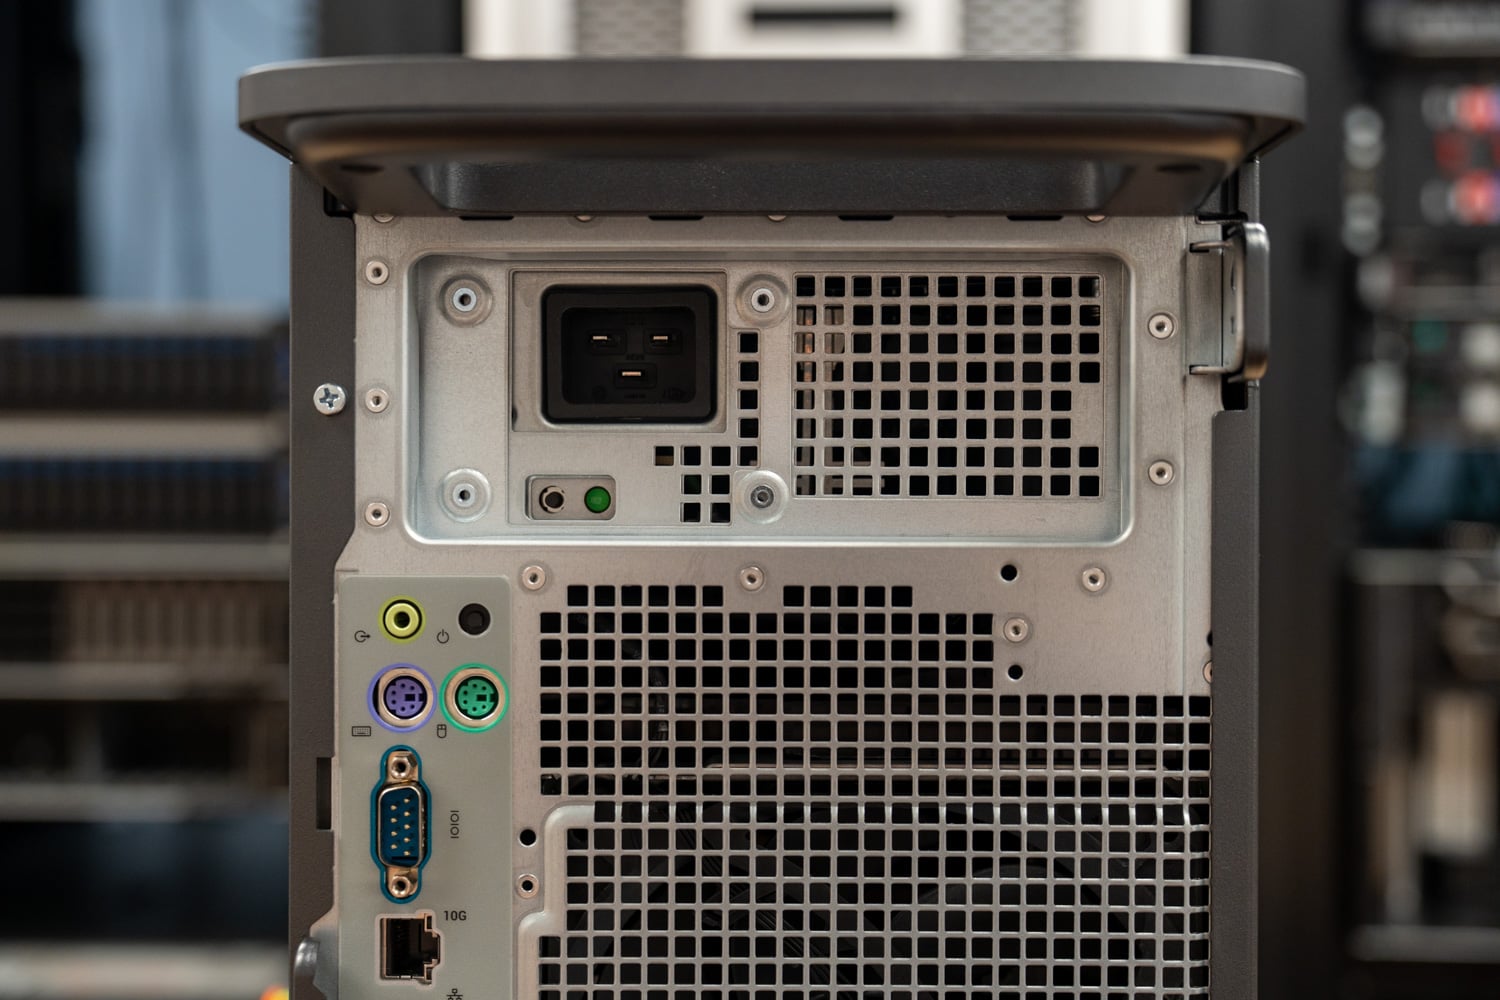
Il pannello frontale ospita un jack per cuffie, due porte USB-A da 10 Gbps, una porta USB-C da 20 Gbps con PowerShare, una porta USB-C da 10 Gbps e uno slot per schede SD opzionale. Sul retro sono presenti porte RJ-45 da 10 GbE e 1 GbE, quattro porte USB-A da 10 Gbps, due porte USB-C da 10 Gbps, una porta USB-C da 20 Gbps, una porta seriale, due porte PS/2 e un'uscita audio. La nostra unità include l'adattatore Intel E810-XXV dual-port 25 GbE SFP28, il modulo Wi-Fi 7 MediaTek MT7925 con Bluetooth 5.4, un lettore di schede di memoria e la scheda di espansione dual USB-C di Dell.
La sicurezza e la gestione includono TPM 2.0, Dell SafeBIOS, rilevamento dell'intrusione nello chassis, supporto per unità a crittografia automatica, cancellazione sicura del BIOS e Intel vPro Enterprise. Dell dichiara che il T4 è realizzato con fino all'85% di plastica riciclata nei componenti chiave, il 90% di alluminio riciclato nelle maniglie e l'11% di acciaio riciclato nello chassis, e la configurazione è certificata ENERGY STAR.
Specifiche del Dell Pro Precision 9 T4
| Specificazione | Dell Pro Precision 9 T4 (modello testato) |
|---|---|
| Piattaforma | |
| Modello | Dell Pro Precision 9 T4 (PW9T4260) |
| Processore | Intel Xeon 698X, 86 core, 172 thread, 336 MB di cache, 2.0 GHz di base, fino a 4.8 GHz, 350 W |
| Opzioni del processore | Da Xeon 634 (12 core) a Xeon 698X (86 core) |
| Memorie | DDR5-6400 RDIMM ECC da 256 GB (8x 32 GB). 16 slot, fino a 4 TB |
| Grafica | 2 schede grafiche NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96 GB GDDR7 ciascuna, 300 W ciascuna. |
| Sistema operativo | Windows 11 Pro per workstation (testato su Ubuntu 26.04.1 LTS) |
| Archiviazione | |
| Come configurato | 2x SSD M.2 2280 Gen5 x4 TLC SED da 2 TB (entrambi negli slot M.2 interni) |
| Slot interni | 3x M.2 2230/2280 Gen5 NVMe 1x M.2 2230/2280 Gen4 NVMe 2 SATA da 3.5 pollici |
| FlexBay | Fino a 4 unità NVMe più un'unità ottica slim opzionale, oppure 2 unità SATA da 3.5 pollici |
| Espansione e connettività | |
| Slot PCIe | 2x Gen5 x16 1x Gen5 x8 1x Gen4 x8 2x Gen4 x8 (x4 elettrici) |
| Networking | Scheda di espansione Intel E810-XXV a doppia porta 25GbE SFP28 Connettori RJ-45 10GbE e 1GbE integrati MediaTek Wi-Fi 7 MT7925, Bluetooth 5.4 |
| Porte anteriori | 1 porta USB-C da 20 Gbps con PowerShare 1 porte USB-C da 10 Gbps 2x USB-A 10 Gbps Headset jack Slot per scheda SD opzionale |
| Porte posteriori | 1 porte USB-C da 20 Gbps 2 porte USB-C da 10 Gbps 4x USB-A 10 Gbps Seriale, 2x PS/2, uscita di linea |
| Potenza e Fisico | |
| Alimentazione di laboratorio | 2400W Platinum (opzione 1500W) |
| Dimensioni | 449.8 x 203.7 x 617.5mm (17.70 x 8.01 x 24.31in) |
| Peso | Da 24.1 kg a 33.6 kg (da 53.1 a 74.1 libbre) a seconda della configurazione |
| Garanzia | ProSupport con assistenza in loco dopo diagnosi a distanza, 36 mesi |
| Prezzo | $ 5,925 di base Circa 66,600 dollari nella configurazione (Dell.com) |
Test Setup e Metodologia
Testiamo workstation di fascia alta su Linux e tutti e quattro i sistemi recensiti utilizzavano Ubuntu 26.04.1 LTS con kernel 7.0.0-43, driver NVIDIA 595.99.02, CUDA 13, build b11716 di llama.cpp e Ollama 0.40.3, con profilo di potenza Linux Performance. I risultati provengono da tre strumenti: sr-client per carichi di lavoro AI e client locali, sr-harness per compilazione, compressione, crittografia, web serving e y-cruncher, e sr-suite r5.28 per GROMACS, OpenFOAM, ClickHouse, Valkey e larghezza di banda della memoria. Ogni risultato rappresenta la mediana di passaggi ripetuti.
Tutti e quattro i sistemi sono stati eseguiti con la modalità termica del BIOS impostata su Ultra Performance e il T4 utilizzava il BIOS 1.2.0. Il test del T4 ha utilizzato sr-harness 3.3, il Precision 7875 ha utilizzato la versione 3.5 ed entrambi i T2 hanno utilizzato la versione 3.6, con la stessa configurazione di test per tutte le versioni.
Ogni sistema di confronto è un computer desktop Dell con scheda grafica RTX PRO 6000 Blackwell. Il Dell Precision 7875 abbina il Threadripper PRO 9995WX a 96 core con le stesse due schede RTX PRO 6000 Max-Q e 512 GB di RAM DDR5-5600, risultando quindi il più simile. Il Dell Pro Precision 9 T2 monta uno Xeon 658X a 24 core con una scheda Max-Q, mentre il Dell Pro Max Tower T2 utilizza un Core Ultra 9 285K a 24 core con la RTX PRO 6000 da 600 W, a dimostrazione dell'incremento di potenza per GPU dovuto al limite di consumo più elevato.
| Configurazione | CPU | Memorie | GPU | Test Drive | Modalità termica |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T4 | Xeon 698X, 86 core | 256 GB DDR5-6400 (8 canali) | 2x RTX PRO 6000 Max-Q (300W) | SSD SK Hynix PCB01 Gen5 da 2 TB | Ultra prestazioni |
| Dell Precision 7875 | Threadripper PRO 9995WX, 96 core | 512 GB DDR5-5600 (8 canali) | 2x RTX PRO 6000 Max-Q (300W) | Samsung Gen4 da 2 TB | Ultra prestazioni |
| Dell Pro Precision 9 T2 | Xeon 658X, 24 core | 128 GB DDR5-6400 (4 canali) | 1x RTX PRO 6000 Max-Q (300W) | Unità Samsung PM9E1 Gen5 da 2 TB in configurazione striping. | Ultra prestazioni |
| Dell Pro Max Torre T2 | Core Ultra 9 285K, 24 core | 128 GB DDR5-4400 (2 canali) | 1x RTX PRO 6000 (600W) | Samsung PM9F1 Gen4 da 2 TB | Ultra prestazioni |
Prestazioni locali dell'IA
Ogni sistema qui presente include almeno una RTX PRO 6000 Blackwell con 96 GB di GDDR7, quindi i risultati con una singola GPU misurano la scheda, il suo limite di potenza e la velocità con cui la piattaforma la alimenta. La presenza di due schede nel T4 è ciò che lo distingue, e i nostri test con due GPU eseguono ciascun modello in tre modi diversi, laddove applicabile: due server indipendenti, uno per GPU, per la velocità di elaborazione; un modello suddiviso per livello su entrambe le schede; e, per MiniMax M2.7, una scheda con il resto del modello nella memoria di sistema.
LLM in esecuzione su una GPU
| Server llama.cpp, una GPU (output token/s, maggiore è il numero, migliore è il risultato) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Torre T2 |
|---|---|---|---|---|
| Ministral 3 3B, una richiesta | 240.5 | 252.6 | 243.8 | 261.6 |
| Ministral 3 3B, picco | 582.5 | 637.6 | 602.6 | 658.8 |
| Ministral 3 8B, una richiesta | 166.8 | 171.1 | 167.3 | 194.5 |
| Ministral 3 8B, picco | 383.6 | 398.9 | 384.9 | 477.5 |
| Qwen3.8 27B, una richiesta | 54.9 | 55.4 | 53.8 | 64.5 |
| Qwen3.8 27B, picco | 158.1 | 162.8 | 155.8 | 194.7 |
| gpt-oss 120B, una richiesta | 166.9 | 171.2 | 164.5 | 193.0 |
| gpt-oss 120B, picco | 424.8 | 458.4 | 413.1 | 520.7 |
| gpt-oss 120B, una richiesta, tempo per il primo token (ms, minore è meglio) | 1,189 | 1,181 | 1,213 | 844 |
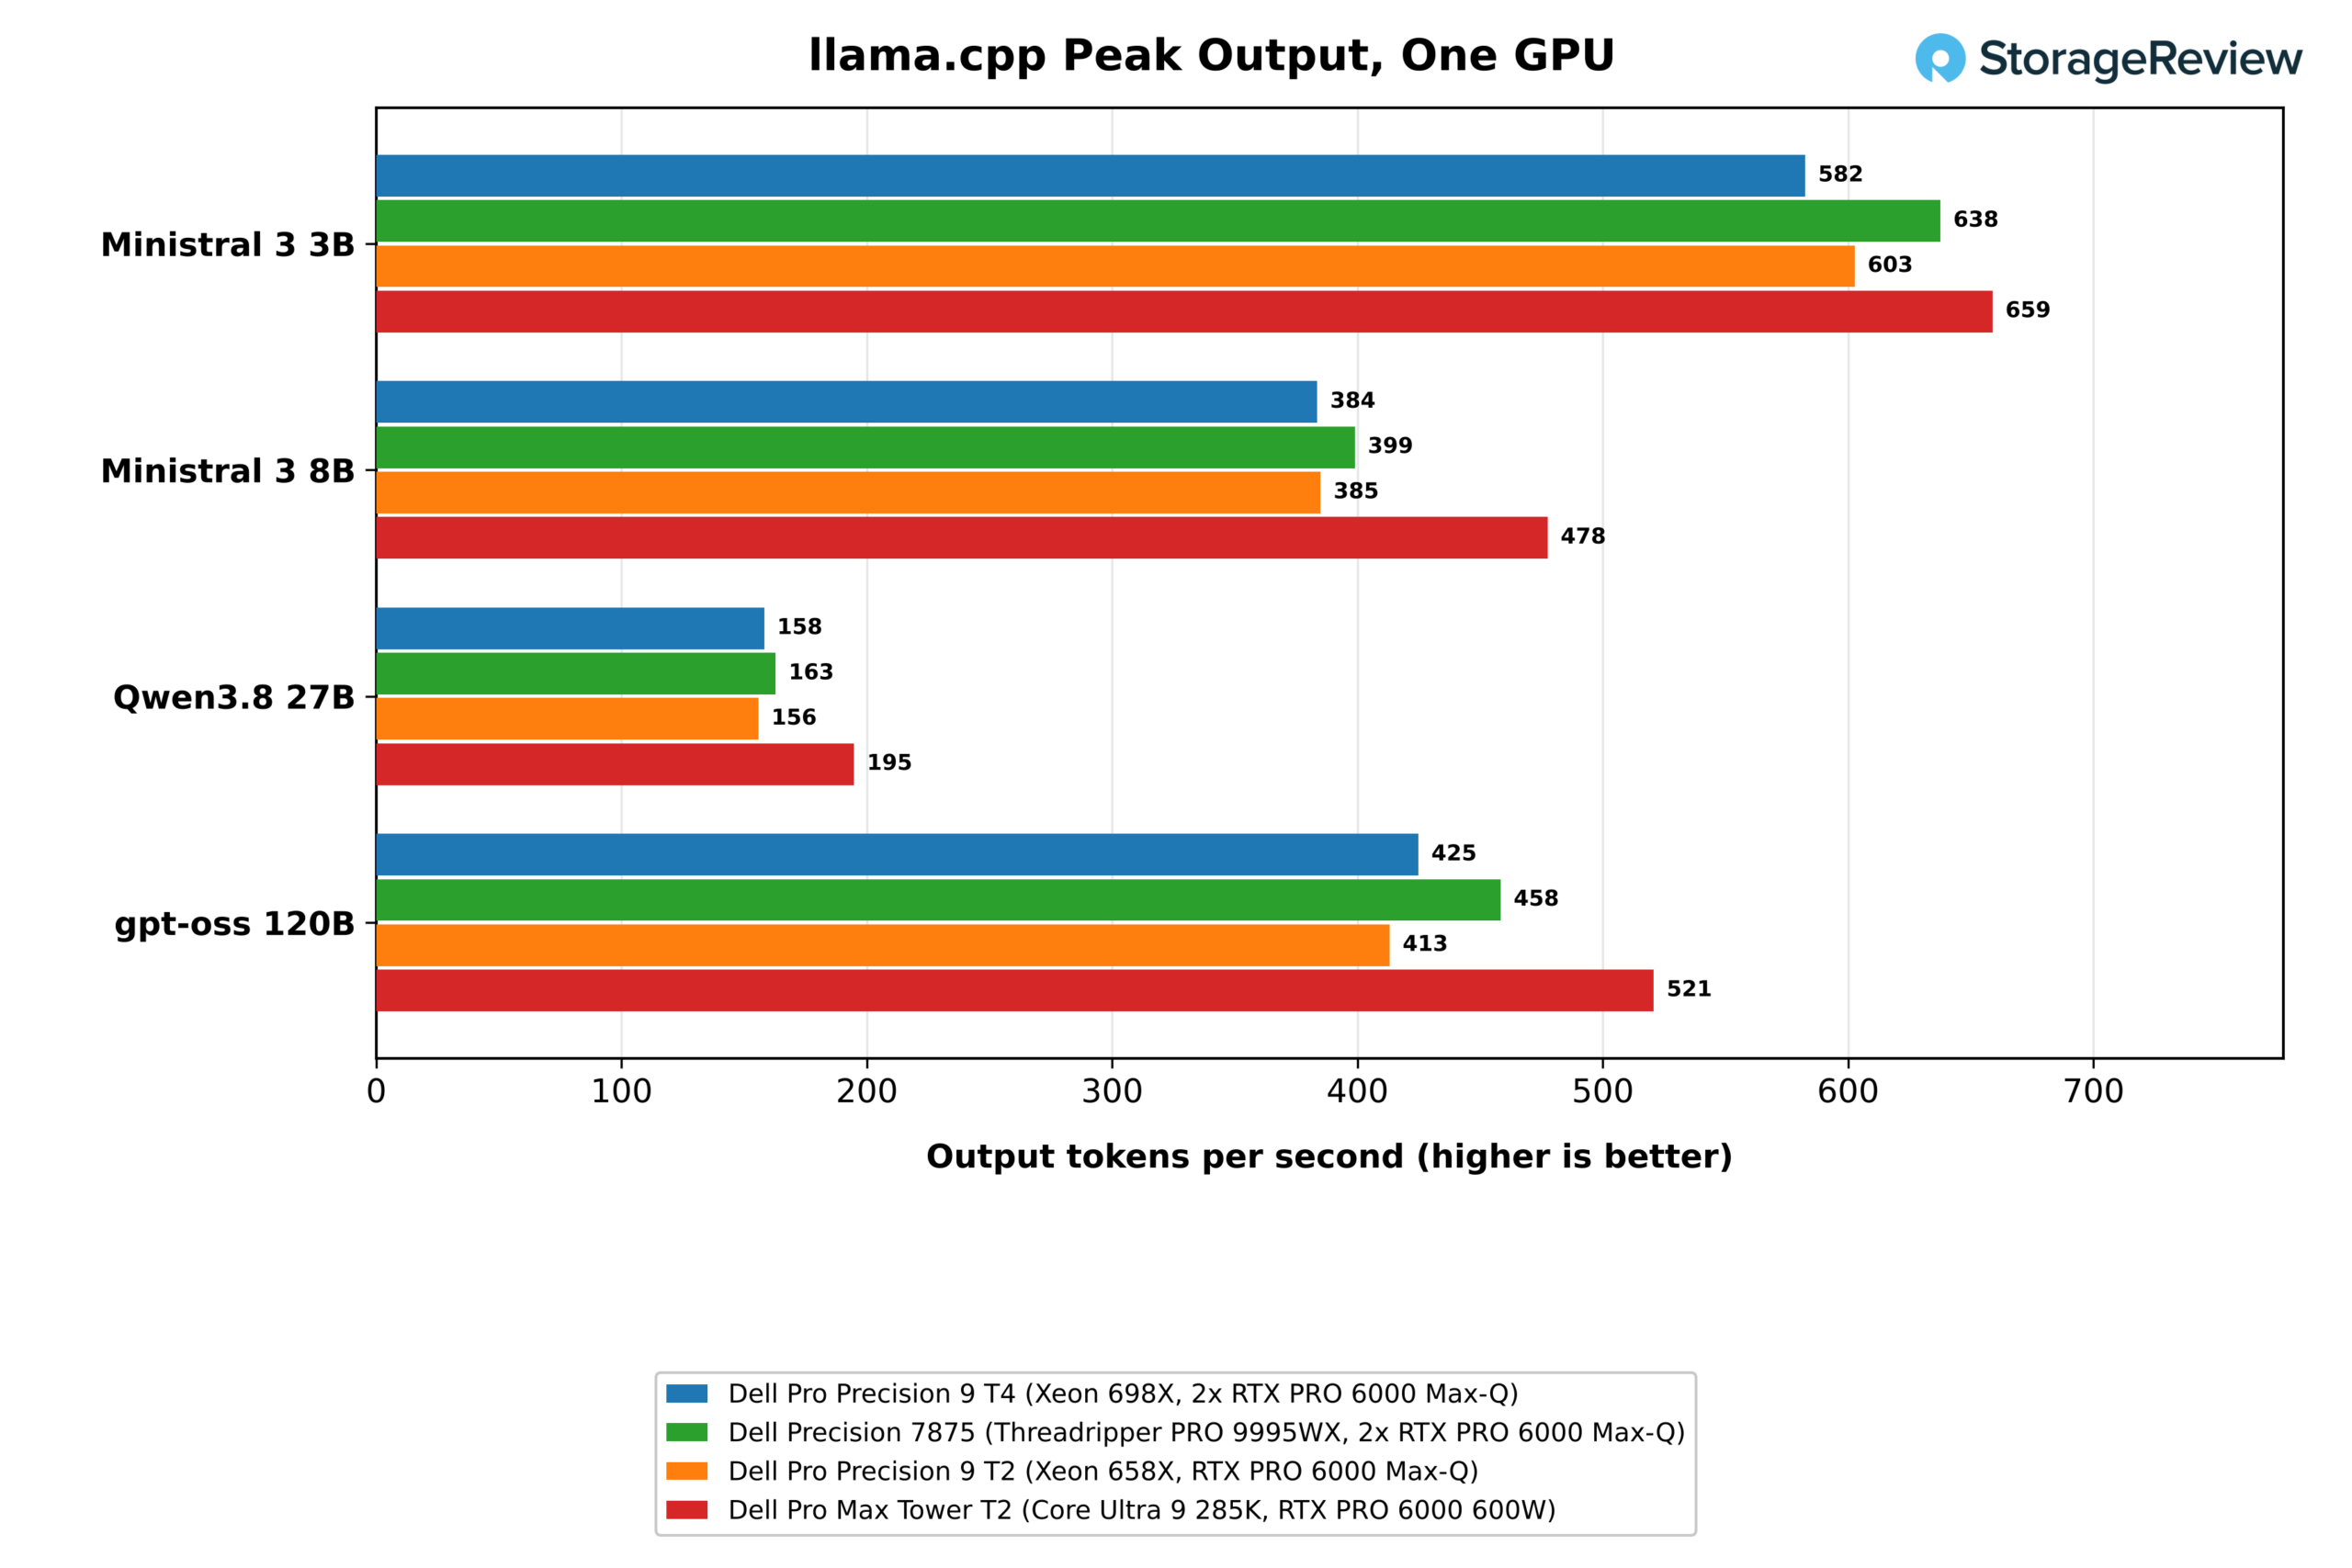
Su una GPU, la T4 si posiziona dove la pone il limite di 300 W della scheda. Ha generato 166.9 token al secondo per un utente su gpt-oss 120B e ha raggiunto un picco di 424.8 su 64 richieste simultanee, entro l'1-9% dalla scheda Max-Q identica del Precision 7875 su tutti e quattro i modelli e allo stesso livello del Pro Precision 9 T2. La scheda da 600 W nel Pro Max Tower T2 è dal 13 al 25% più veloce al picco su ogni modello, raggiungendo 520.7 token al secondo su gpt-oss 120B.
Due GPU: repliche e modelli divisi
| Server llama.cpp, due GPU (output token/s, maggiore è il valore, migliore è il risultato) | Dell Pro Precision 9 T4 | Dell Precision 7875 |
|---|---|---|
| Ministral 3 3B, picco, un server per GPU | 1,176.1 | 1,260.2 |
| Ministral 3 8B, picco, un server per GPU | 765.7 | 796.4 |
| Qwen3.8 27B, picco, un server per GPU | 310.8 | 323.2 |
| gpt-oss 120B, picco, un server per GPU | 787.9 | 905.8 |
| gpt-oss 120B, una richiesta, suddivisa per livello | 170.6 | 182.4 |
| gpt-oss 120B, picco, suddivisione per strato | 539.2 | 619.4 |
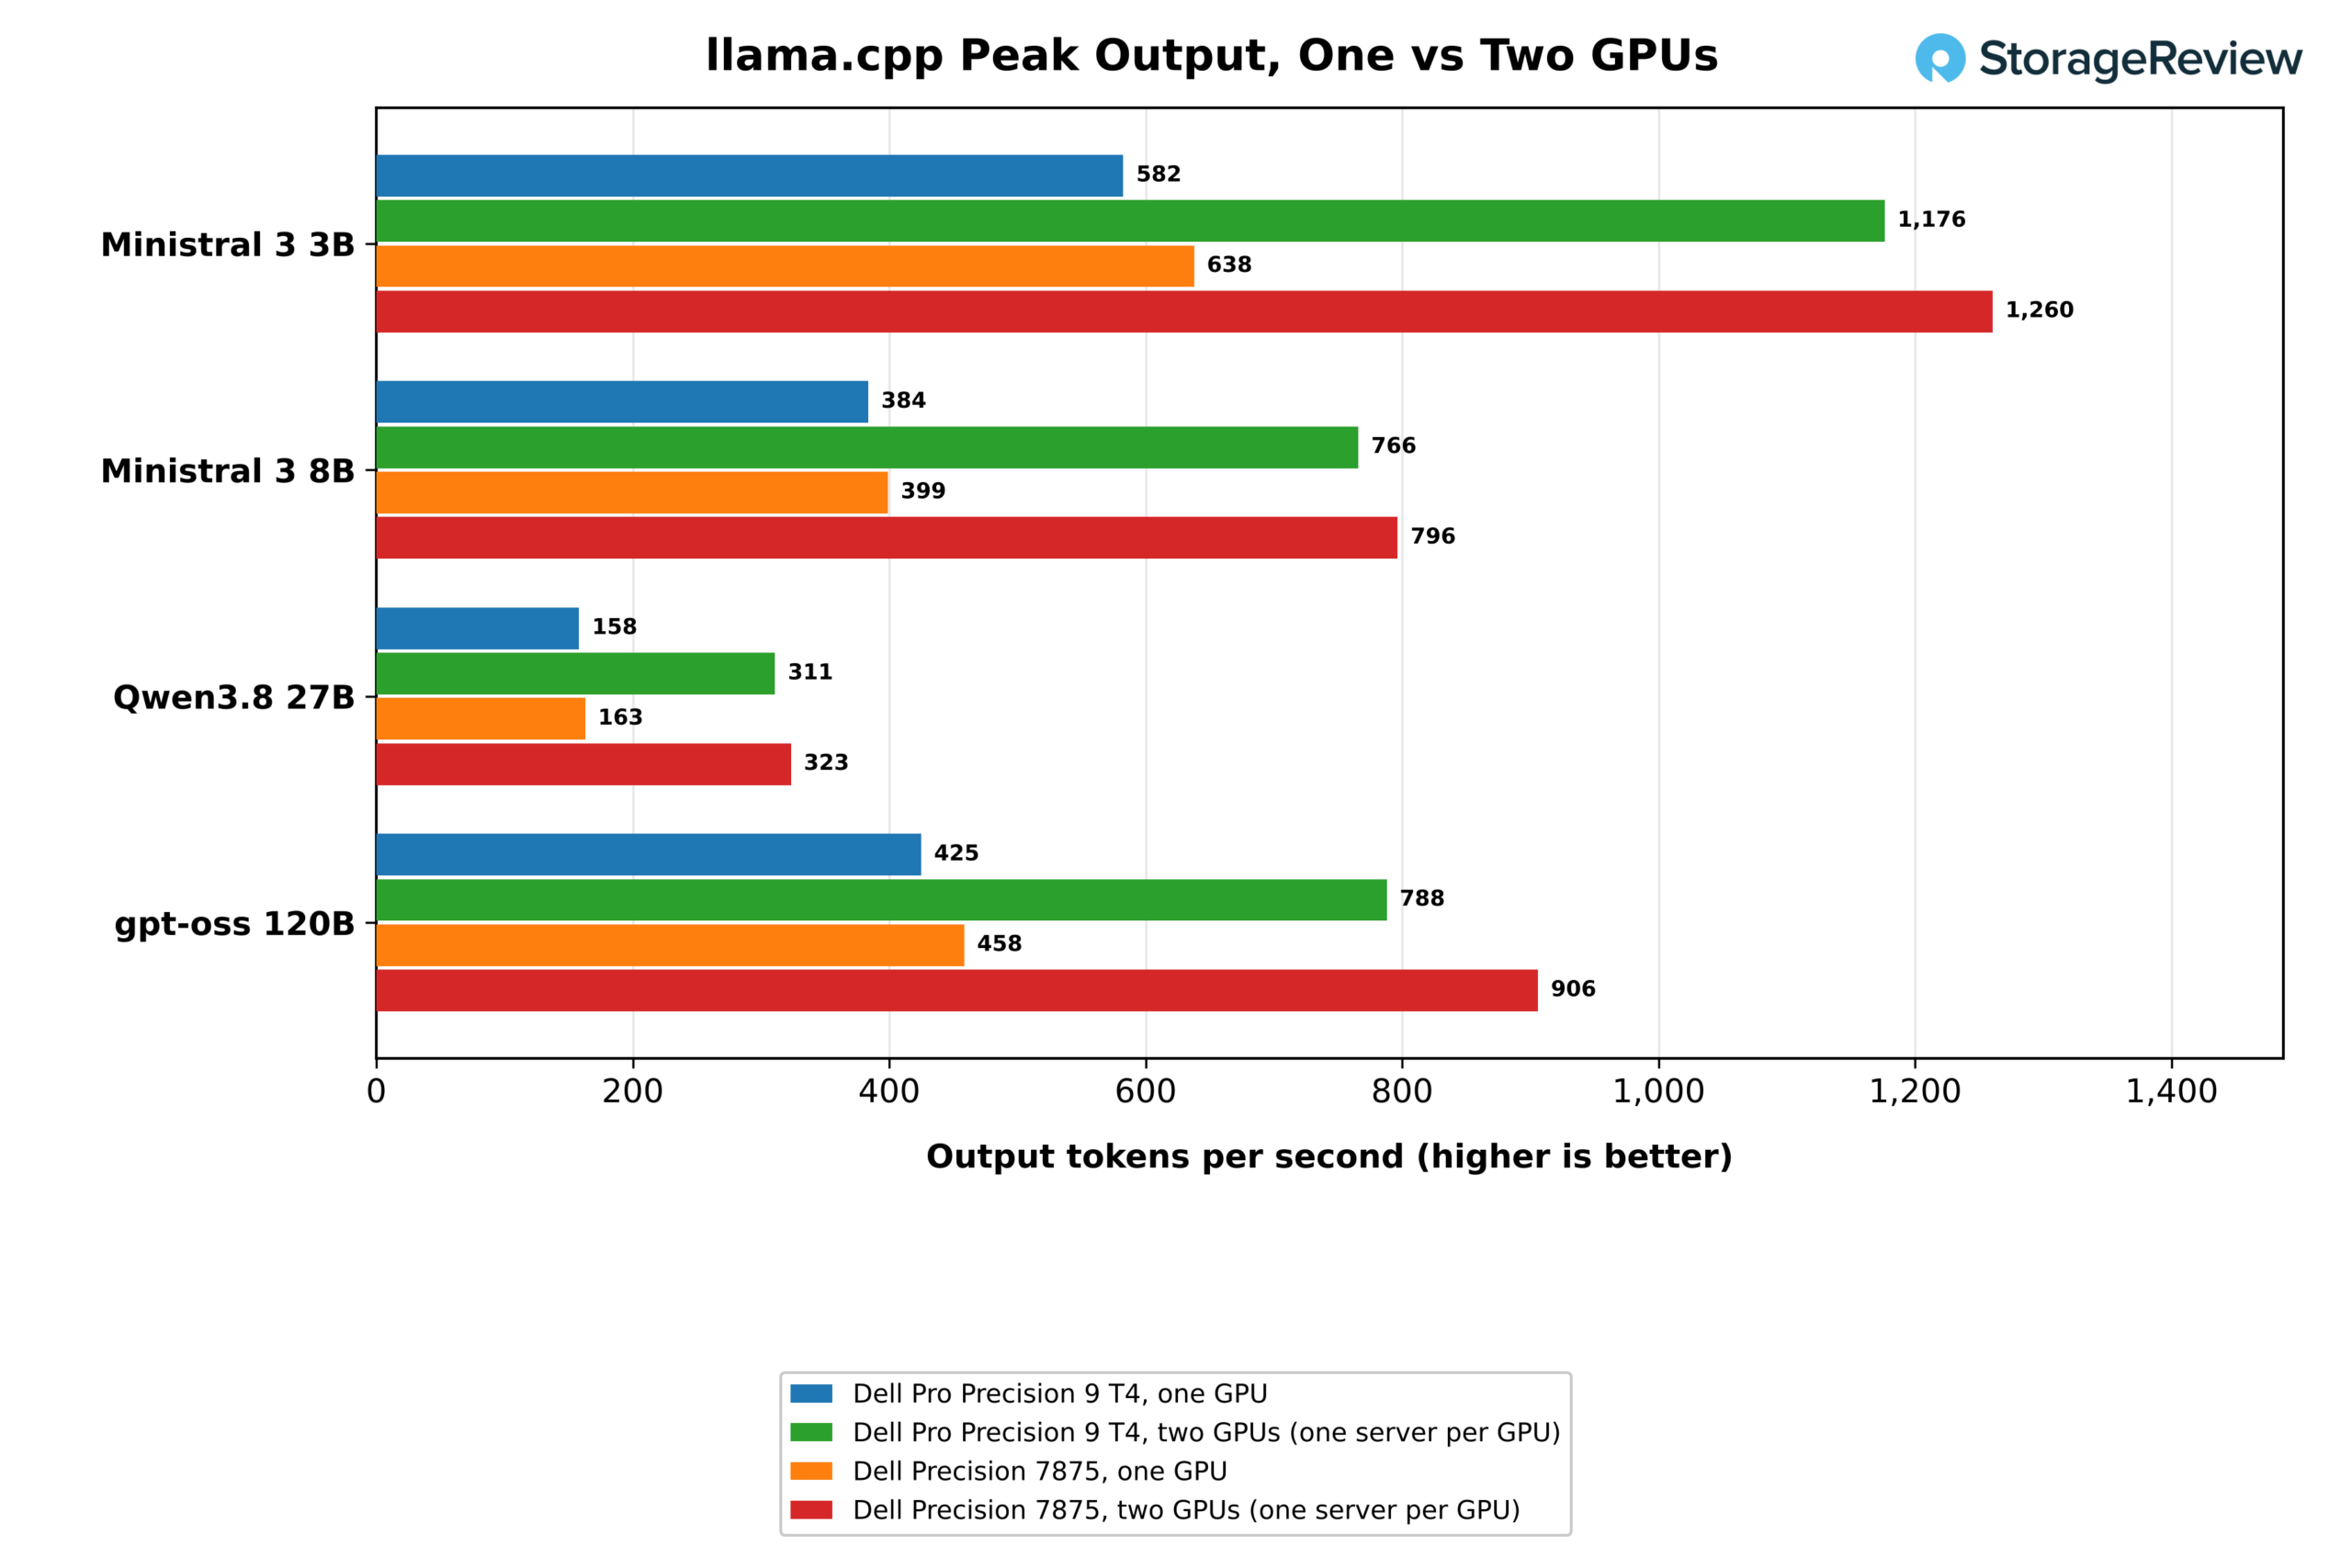
L'esecuzione di un server per GPU ha aumentato la produzione di picco del T4 da 1.85 a 2.02 volte su tutti e quattro i modelli. La produzione di picco è passata da 582.5 a 1,176.1 token al secondo su Ministral 3 3B, da 383.6 a 765.7 sul modello 8B e da 158.1 a 310.8 su Qwen3.8 27B, con un incremento da 1.97 a 2.02 volte. gpt-oss 120B ha scalato 1.85 volte fino a 787.9 token al secondo sul T4 e 1.98 volte fino a 905.8 sul Precision 7875, che ha raggiunto il suo picco a 128 richieste simultanee, mentre il T4 ha raggiunto un picco di 64.
Suddividere i 120 byte di gpt-oss per layer su entrambe le schede è il metodo più lento per utilizzare la seconda GPU quando il modello è già compatibile con una singola scheda. Ha servito un utente a 170.6 token al secondo, entro il 3% rispetto a una singola scheda, e ha raggiunto un picco di 539.2, il 27% in più rispetto a una singola GPU e ben al di sotto dei 787.9 ottenuti con due repliche. La configurazione a suddivisione si rivela adatta per i modelli che non rientrano in una singola scheda, ed è qui che entra in gioco MiniMax M2.7.
| Server llama.cpp, gpt-oss 120B, 8,192 richieste di token, 1,024 output di token | T4, una GPU | T4, due GPU, un server per GPU | T4, due GPU, suddivise per strato | Precision 7875, due GPU, un server per GPU |
|---|---|---|---|---|
| 1 simultanei: throughput totale (token/s) | 1,502 | 1,504 | 1,536 | 1,530 |
| 1 concorrenti: tempo al primo token, mediana (ms, valore inferiore è migliore) | 1,189 | 1,180 | 719 | 1,189 |
| 8 simultanei: throughput totale (token/s) | 2,760 | 4,820 | 3,300 | 4,949 |
| 8 concorrenti: output per utente (token/s) | 38.3 | 66.9 | 45.8 | 68.7 |
| 8 concorrenti: tempo al primo token, mediana (ms, valore inferiore è migliore) | 2,654 | 2,523 | 1,622 | 2,472 |
| 64 simultanei: throughput totale (token/s) | 3,823 | 7,091 | 4,853 | 7,557 |
| 64 concorrenti: output per utente (token/s) | 6.6 | 12.3 | 8.4 | 13.1 |
| 64 concorrenti: tempo al primo token, mediana (ms, valore inferiore è migliore) | 3,874 | 3,226 | 2,852 | 2,867 |
L'analisi completa su gpt-oss 120B mostra come la seconda scheda modifichi la curva, con il throughput totale che include sia i token di prompt che quelli di output. Con una GPU, il throughput è passato da 1,502 token al secondo per una singola richiesta a 2,760 con otto GPU e 3,823 con 64 GPU, dove ogni utente ha ricevuto 6.6 token di output al secondo. Con un server per GPU, otto richieste hanno raggiunto 4,820 e 64 richieste hanno toccato quota 7,091, 1.85 volte una scheda, con una media di 12.3 token al secondo per utente. La suddivisione del modello ha raggiunto un picco inferiore, pari a 4,853, ma ha restituito il primo token di un singolo utente in 719 ms contro 1,189 ms.

MiniMax M2.7: un modello troppo grande per una sola scheda
| MiniMax M2.7 Q4_K_M, 129.3 GB (maggiore è meglio se non diversamente specificato) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Torre T2 |
|---|---|---|---|---|
| Una GPU più RAM di sistema, una richiesta (token/s) | 30.3 | 32.8 | 22.6 | 15.8 |
| Una GPU più RAM di sistema, picco (token/s) | 35.5 | 39.1 | 27.7 | 18.0 |
| Una GPU più la RAM di sistema, tempo per il primo token (ms, minore è il valore, migliore è) | 16,224 | 16,143 | 16,216 | 18,522 |
| Due GPU suddivise per livello, una richiesta (token/s) | 83.7 | 85.0 | GPU singola | GPU singola |
| Due GPU suddivise per strato, picco (token/s) | 127.3 | 129.5 | GPU singola | GPU singola |
| Due GPU suddivise per livello, tempo al primo token (ms, minore è il valore, migliore è il risultato) | 3,138 | 3,162 | GPU singola | GPU singola |
| Caricamento a freddo, una GPU più RAM (s, meno è meglio) | 40.5 | 65.8 | 37.6 | 81.1 |
| Carico a freddo, suddivisione in due GPU (s, valore inferiore è migliore) | 27.6 | 50.7 | GPU singola | GPU singola |
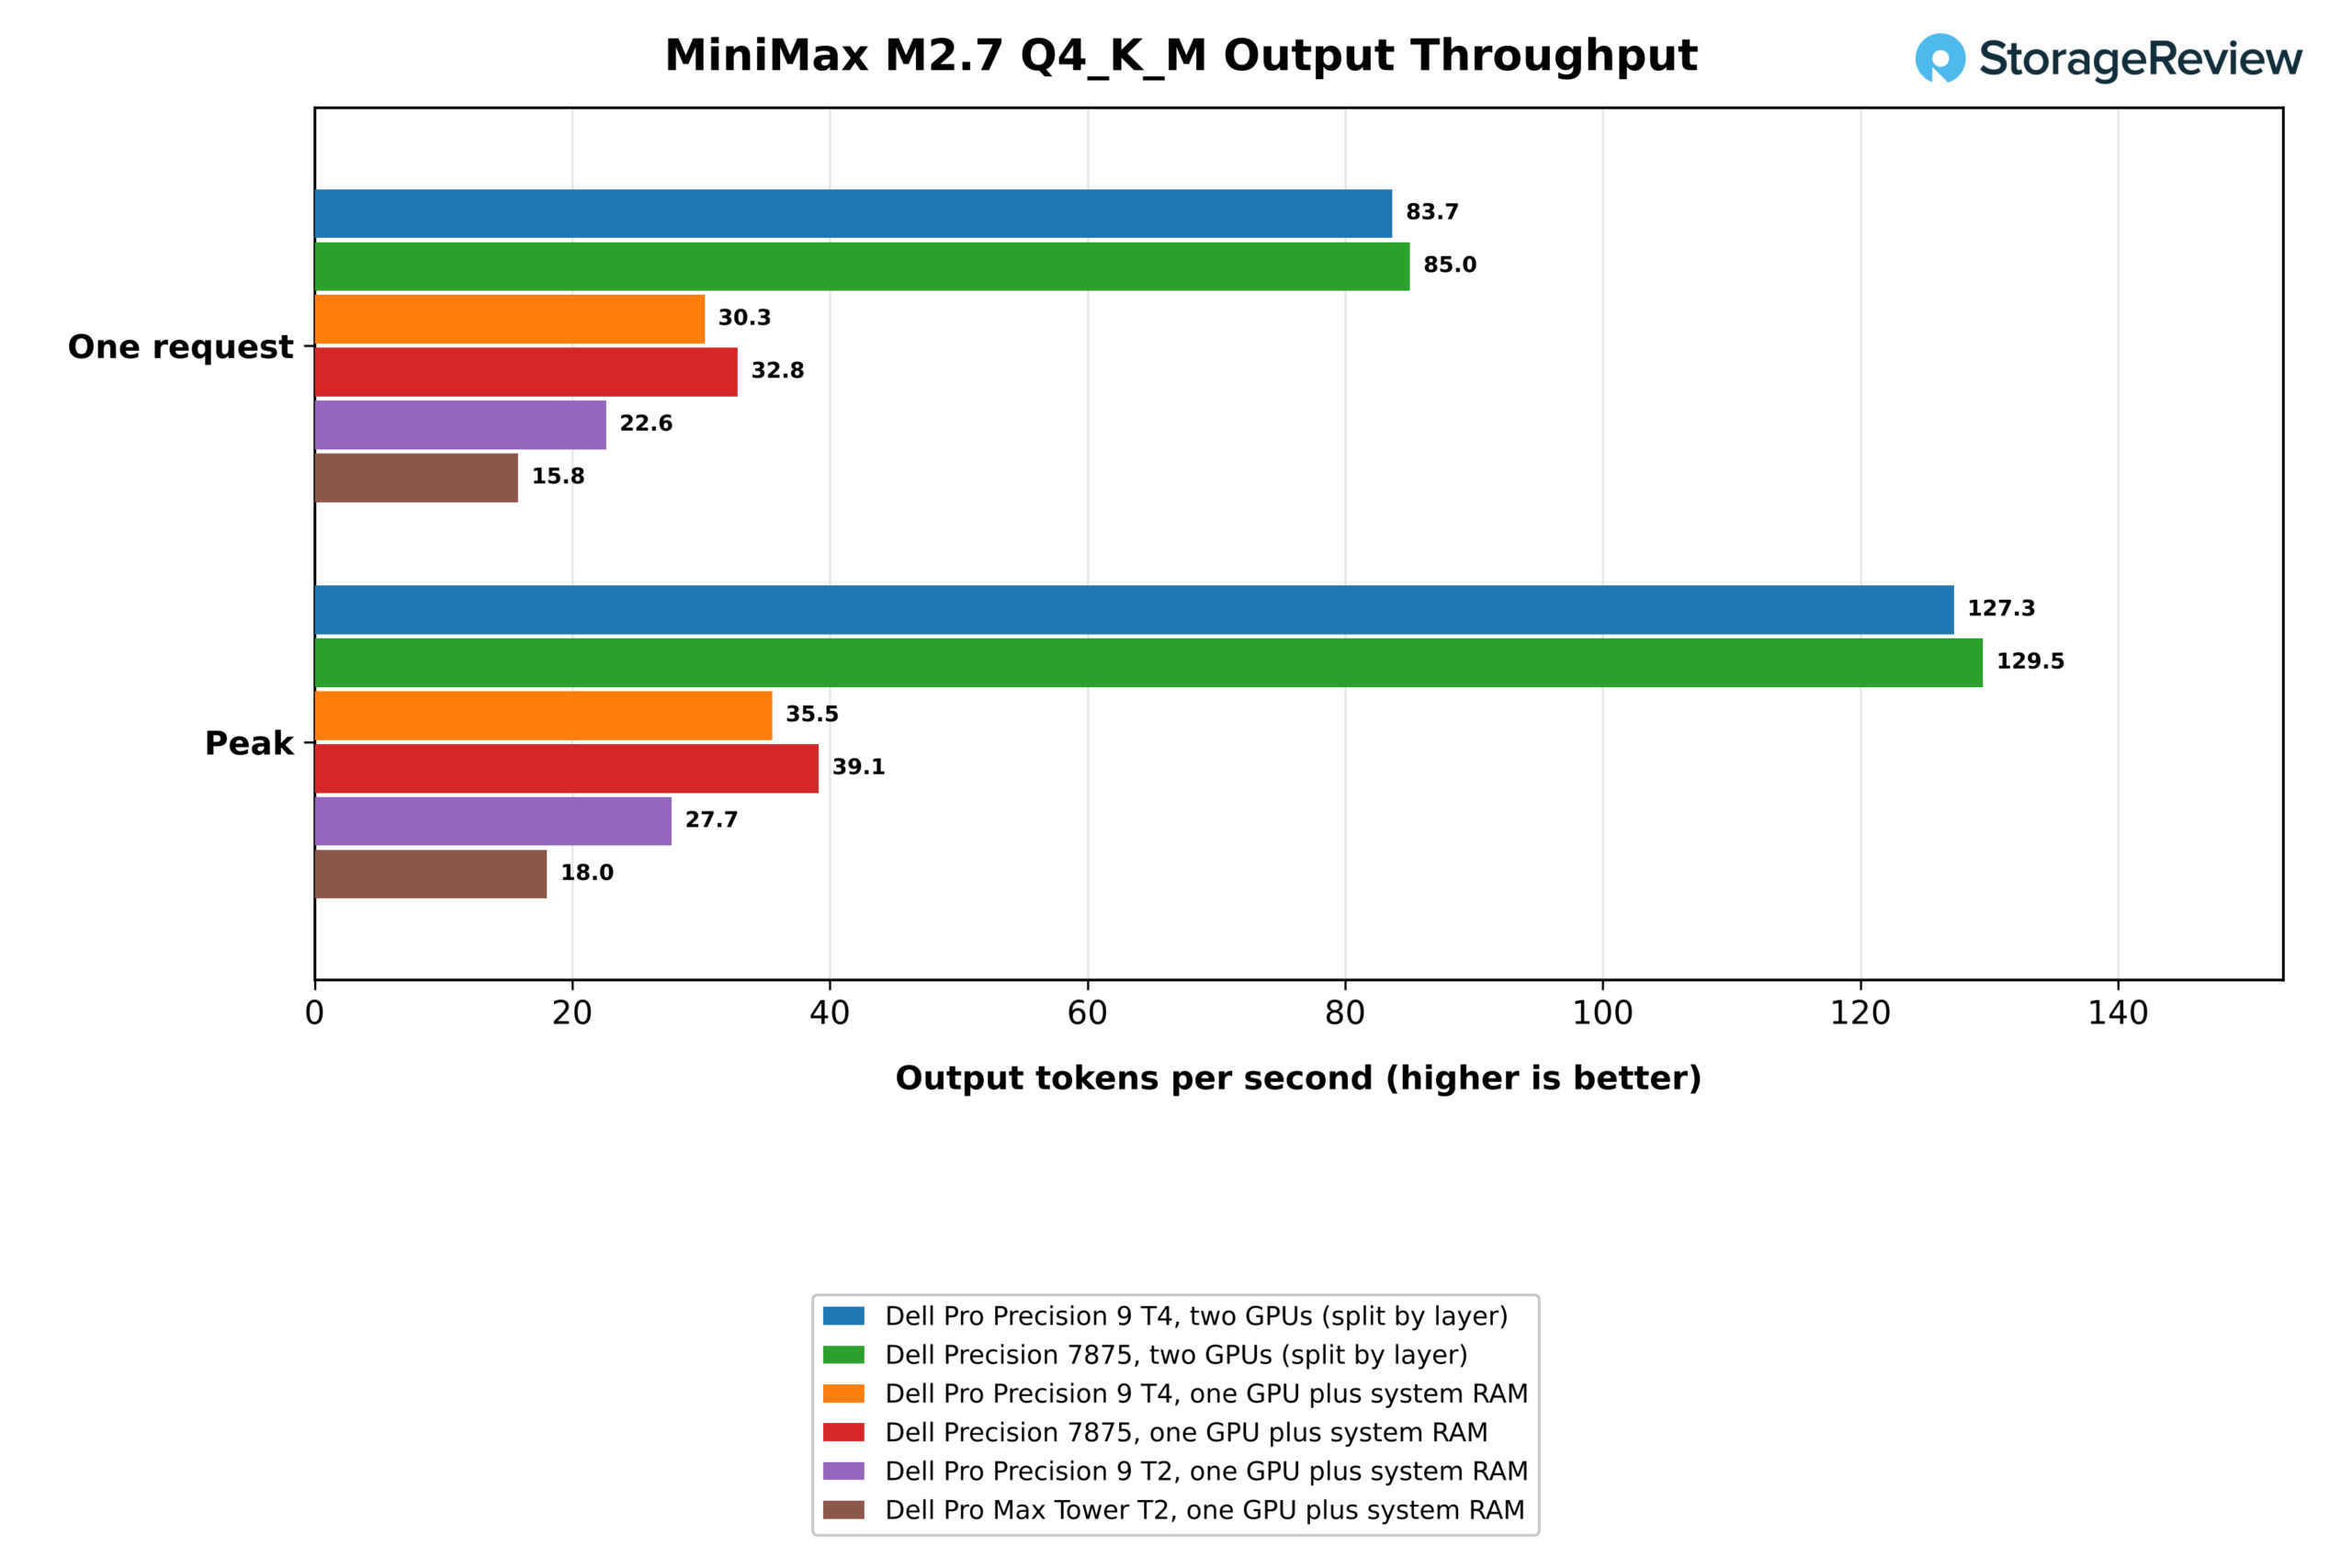
MiniMax M2.7 è un modello di esperti con 230 miliardi di parametri e la nostra quantizzazione a 4 bit occupa 129.3 GB, più dei 96 GB di una singola RTX PRO 6000. Su una scheda, con la parte restante nella memoria di sistema, il T4 ha generato 30.3 token al secondo per un utente e ha impiegato 16.2 secondi per restituire il primo token. Suddividendo il tempo tra le due schede, ha generato 83.7 token al secondo, 2.8 volte più velocemente, ha restituito il primo token in 3.1 secondi e ha raggiunto un picco di 127.3 token al secondo contro i 35.5 dell'altra scheda.
I risultati con una sola GPU mostrano quanto la piattaforma host sia importante una volta che un modello si estende alla memoria di sistema. Gli otto canali DDR5-6400 del T4 lo pongono il 34% avanti rispetto al Pro Precision 9 T2 a quattro canali con 22.6 token al secondo e 1.9 volte avanti rispetto al Pro Max Tower T2 a doppio canale con 15.8, anche se la scheda da 600 W del Pro Max Tower T2 è più veloce su ogni modello compatibile. Il Precision 7875 ha superato il T4 con 32.8 token al secondo con il 35% in meno di larghezza di banda della memoria, quindi la larghezza di banda da sola non determina questo risultato. Riportiamo il vantaggio del 7875 così come misurato e non ne abbiamo isolato la causa.
Caricamento del modello
| Caricamento del modello Ollama 0.40.3 e llama.cpp (s, un valore inferiore è migliore) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Torre T2 |
|---|---|---|---|---|
| gpt-oss:20b (12.8GB), freddo | 5.79 | 7.61 | 5.57 | 7.95 |
| gpt-oss:20b, caldo | 3.45 | 2.50 | 3.47 | 3.05 |
| gpt-oss:120b (60.9GB), freddo | 15.16 | 25.80 | 15.16 | 28.18 |
| gpt-oss:120b, caldo | 7.49 | 5.01 | 7.87 | 6.81 |
| gpt-oss:120b, a freddo, una copia su ciascuna GPU | 26.47 | 35.55 | GPU singola | GPU singola |
| MiniMax M2.7 (129.3 GB), freddo, una GPU più RAM | 40.5 | 65.8 | 37.6 | 81.1 |
| MiniMax M2.7, caldo, una GPU più RAM | 28.6 | 15.2 | 36.7 | 80.5 |
Nei test a freddo, le unità Gen5 risultano più performanti: il T4 carica gpt-oss:120b dal suo SSD SK hynix Gen5 in 15.2 secondi, eguagliando il Pro Precision 9 T2 e superando nettamente i 25.8 e 28.2 secondi del Precision 7875 e del Pro Max Tower T2, entrambi dotati di unità Gen4. Nei test a caldo, invece, l'ordine si inverte: il 7875 impiega 5.0 secondi contro i 7.5 del T4, mentre il caricamento simultaneo di una copia su ciascuna GPU richiede 26.5 secondi sul T4.
Generazione potenziata dal recupero su larga scala
| RAG oltre 1,002,067 passaggi di Wikipedia | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Torre T2 |
|---|---|---|---|---|
| Incorporamento, una GPU (passaggi/s) | 1,126 | 1,196 | 1,141 | 1,388 |
| Tempo di integrazione, una GPU (s, minore è meglio) | 890 | 838 | 878 | 722 |
| Incorporamento, due GPU (passaggi/s) | 2,162 | 2,371 | GPU singola | GPU singola |
| Tempo di integrazione, due GPU (s, minore è meglio) | 464 | 423 | GPU singola | GPU singola |
| Costruzione dell'indice HNSW (s, un valore inferiore è migliore) | 27.3 | 34.8 | 46.3 | 118.6 |
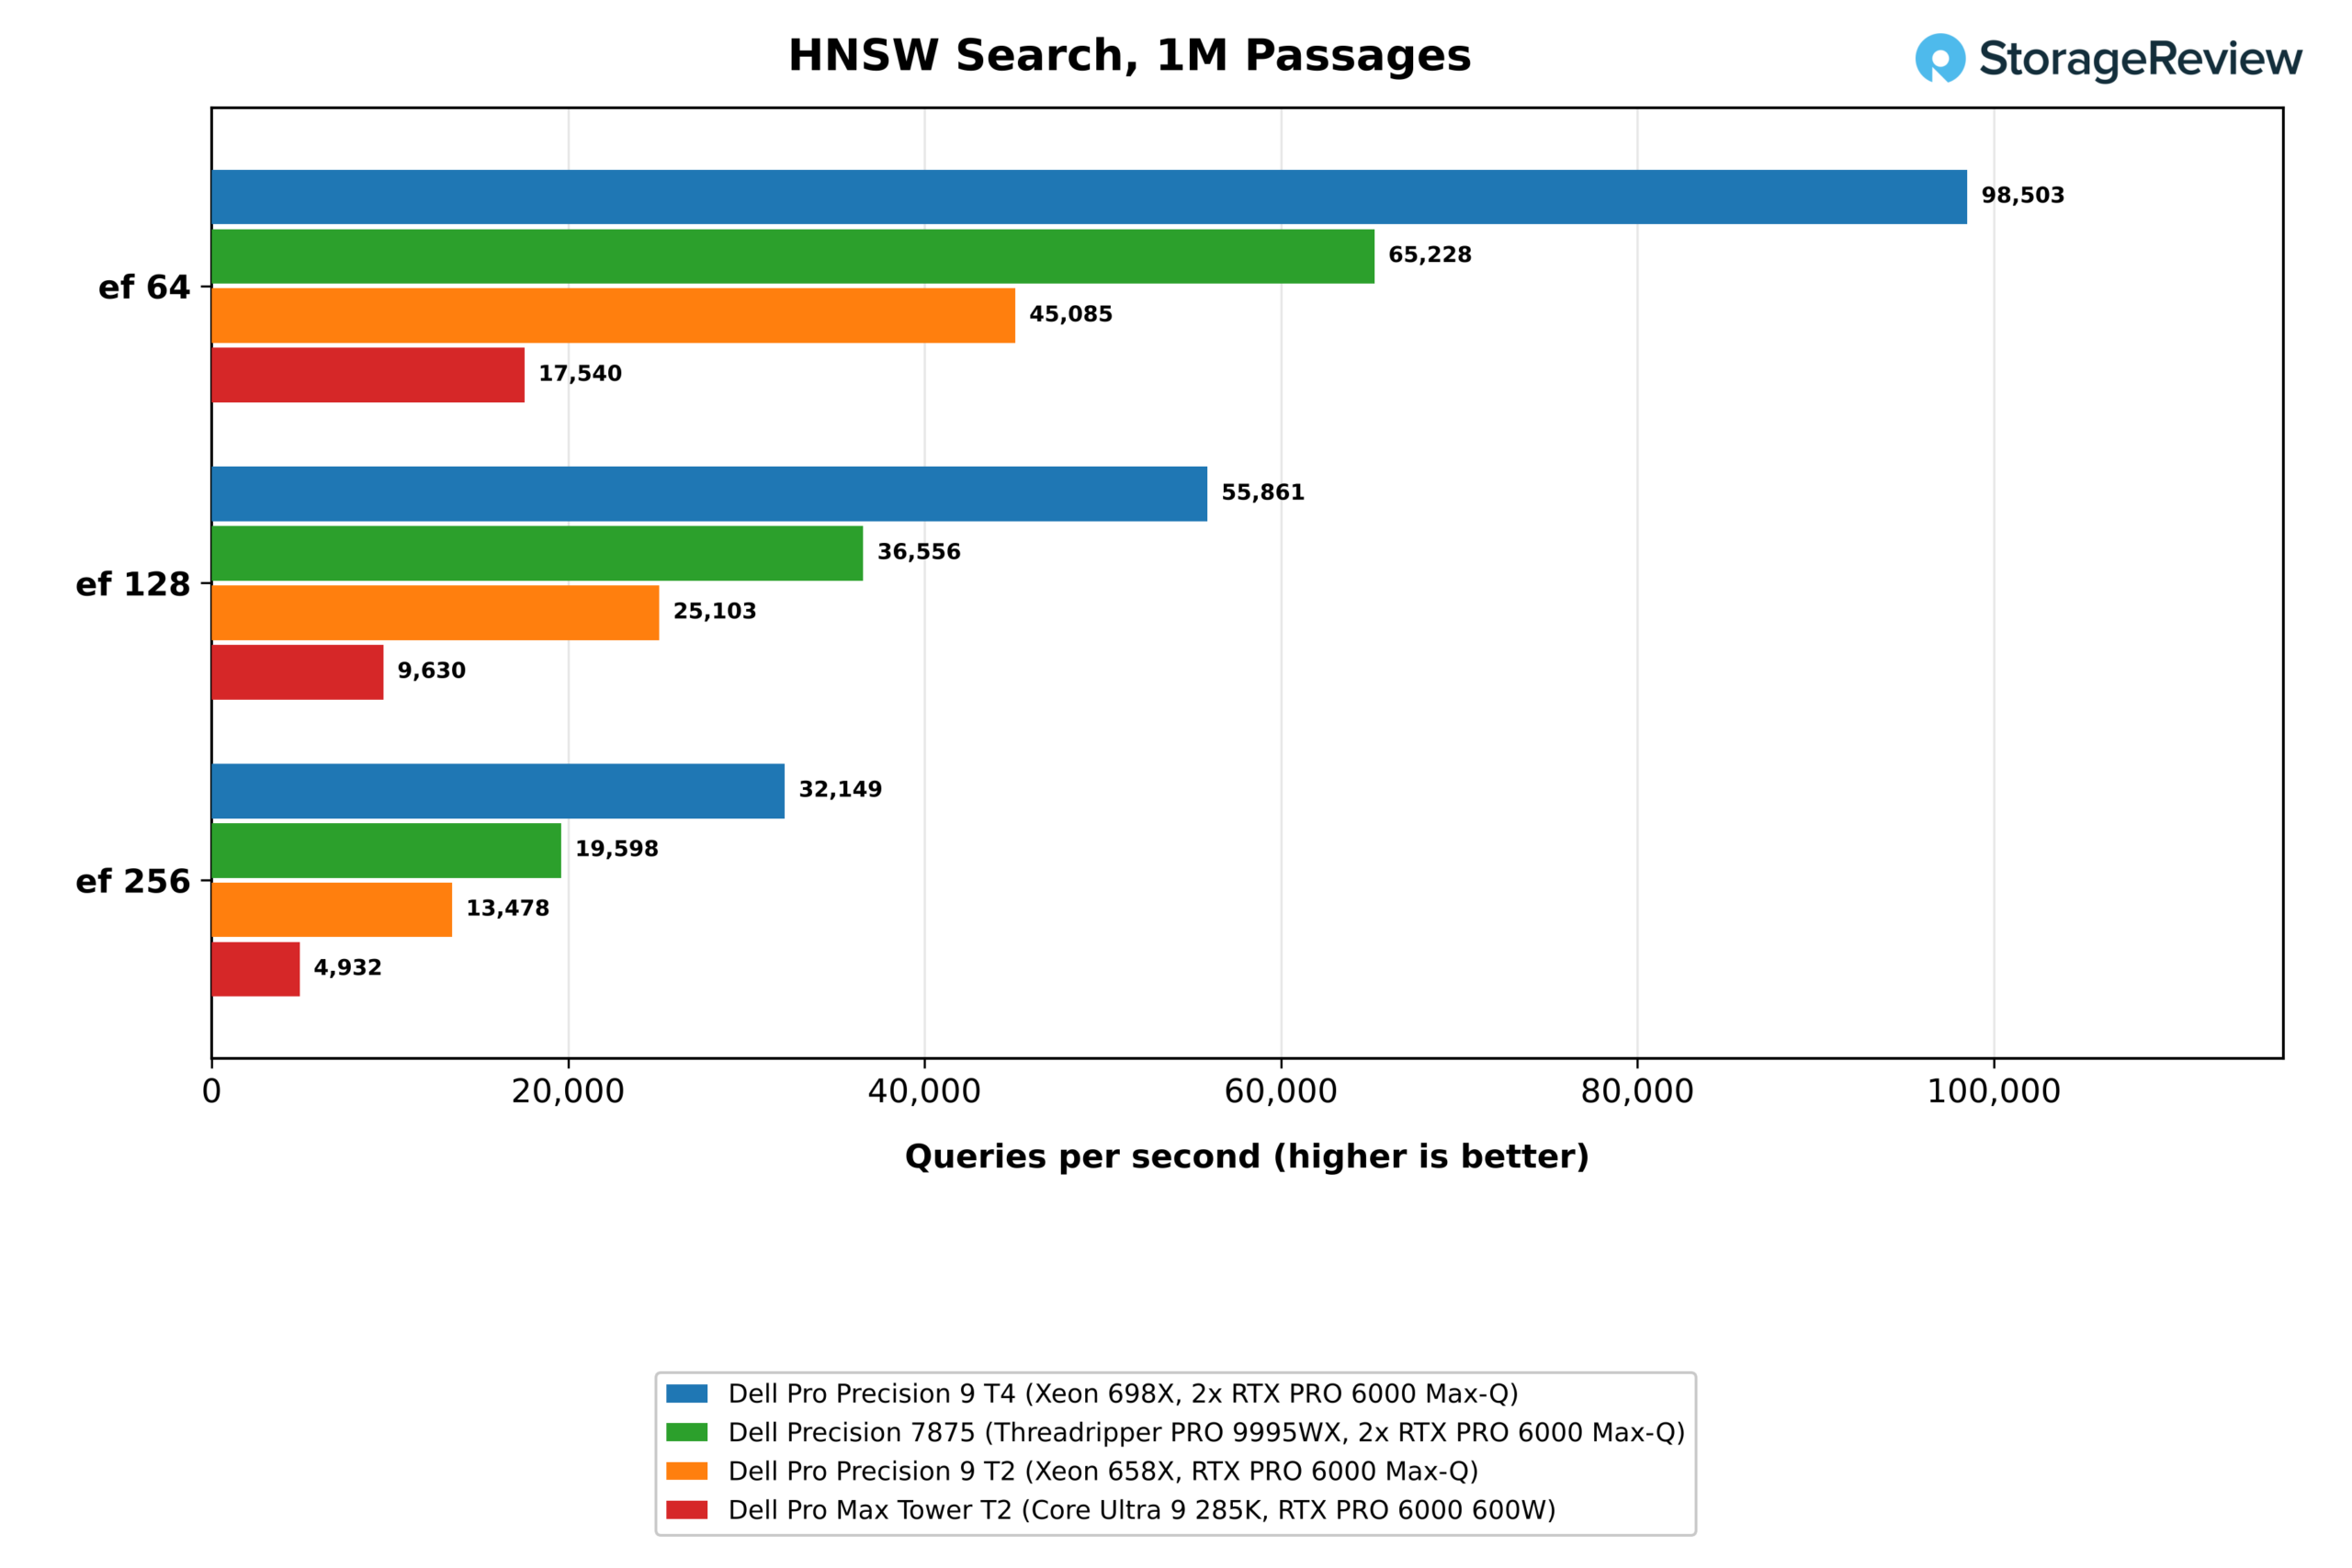
| Ricerca HNSW, ef 64 (query/s) | 98,503 | 65,228 | 45,085 | 17,540 |
| Ricerca HNSW, ef 256 (query/s) | 32,149 | 19,598 | 13,478 | 4,932 |
| Richiamo@5 vs ricerca esatta, ef 256 (%) | 97.59 | 97.67 | 97.26 | 97.70 |
| Domanda a cui rispondere p50 (s, un valore inferiore è migliore) | 0.123 | 0.082 | 0.117 | 0.095 |
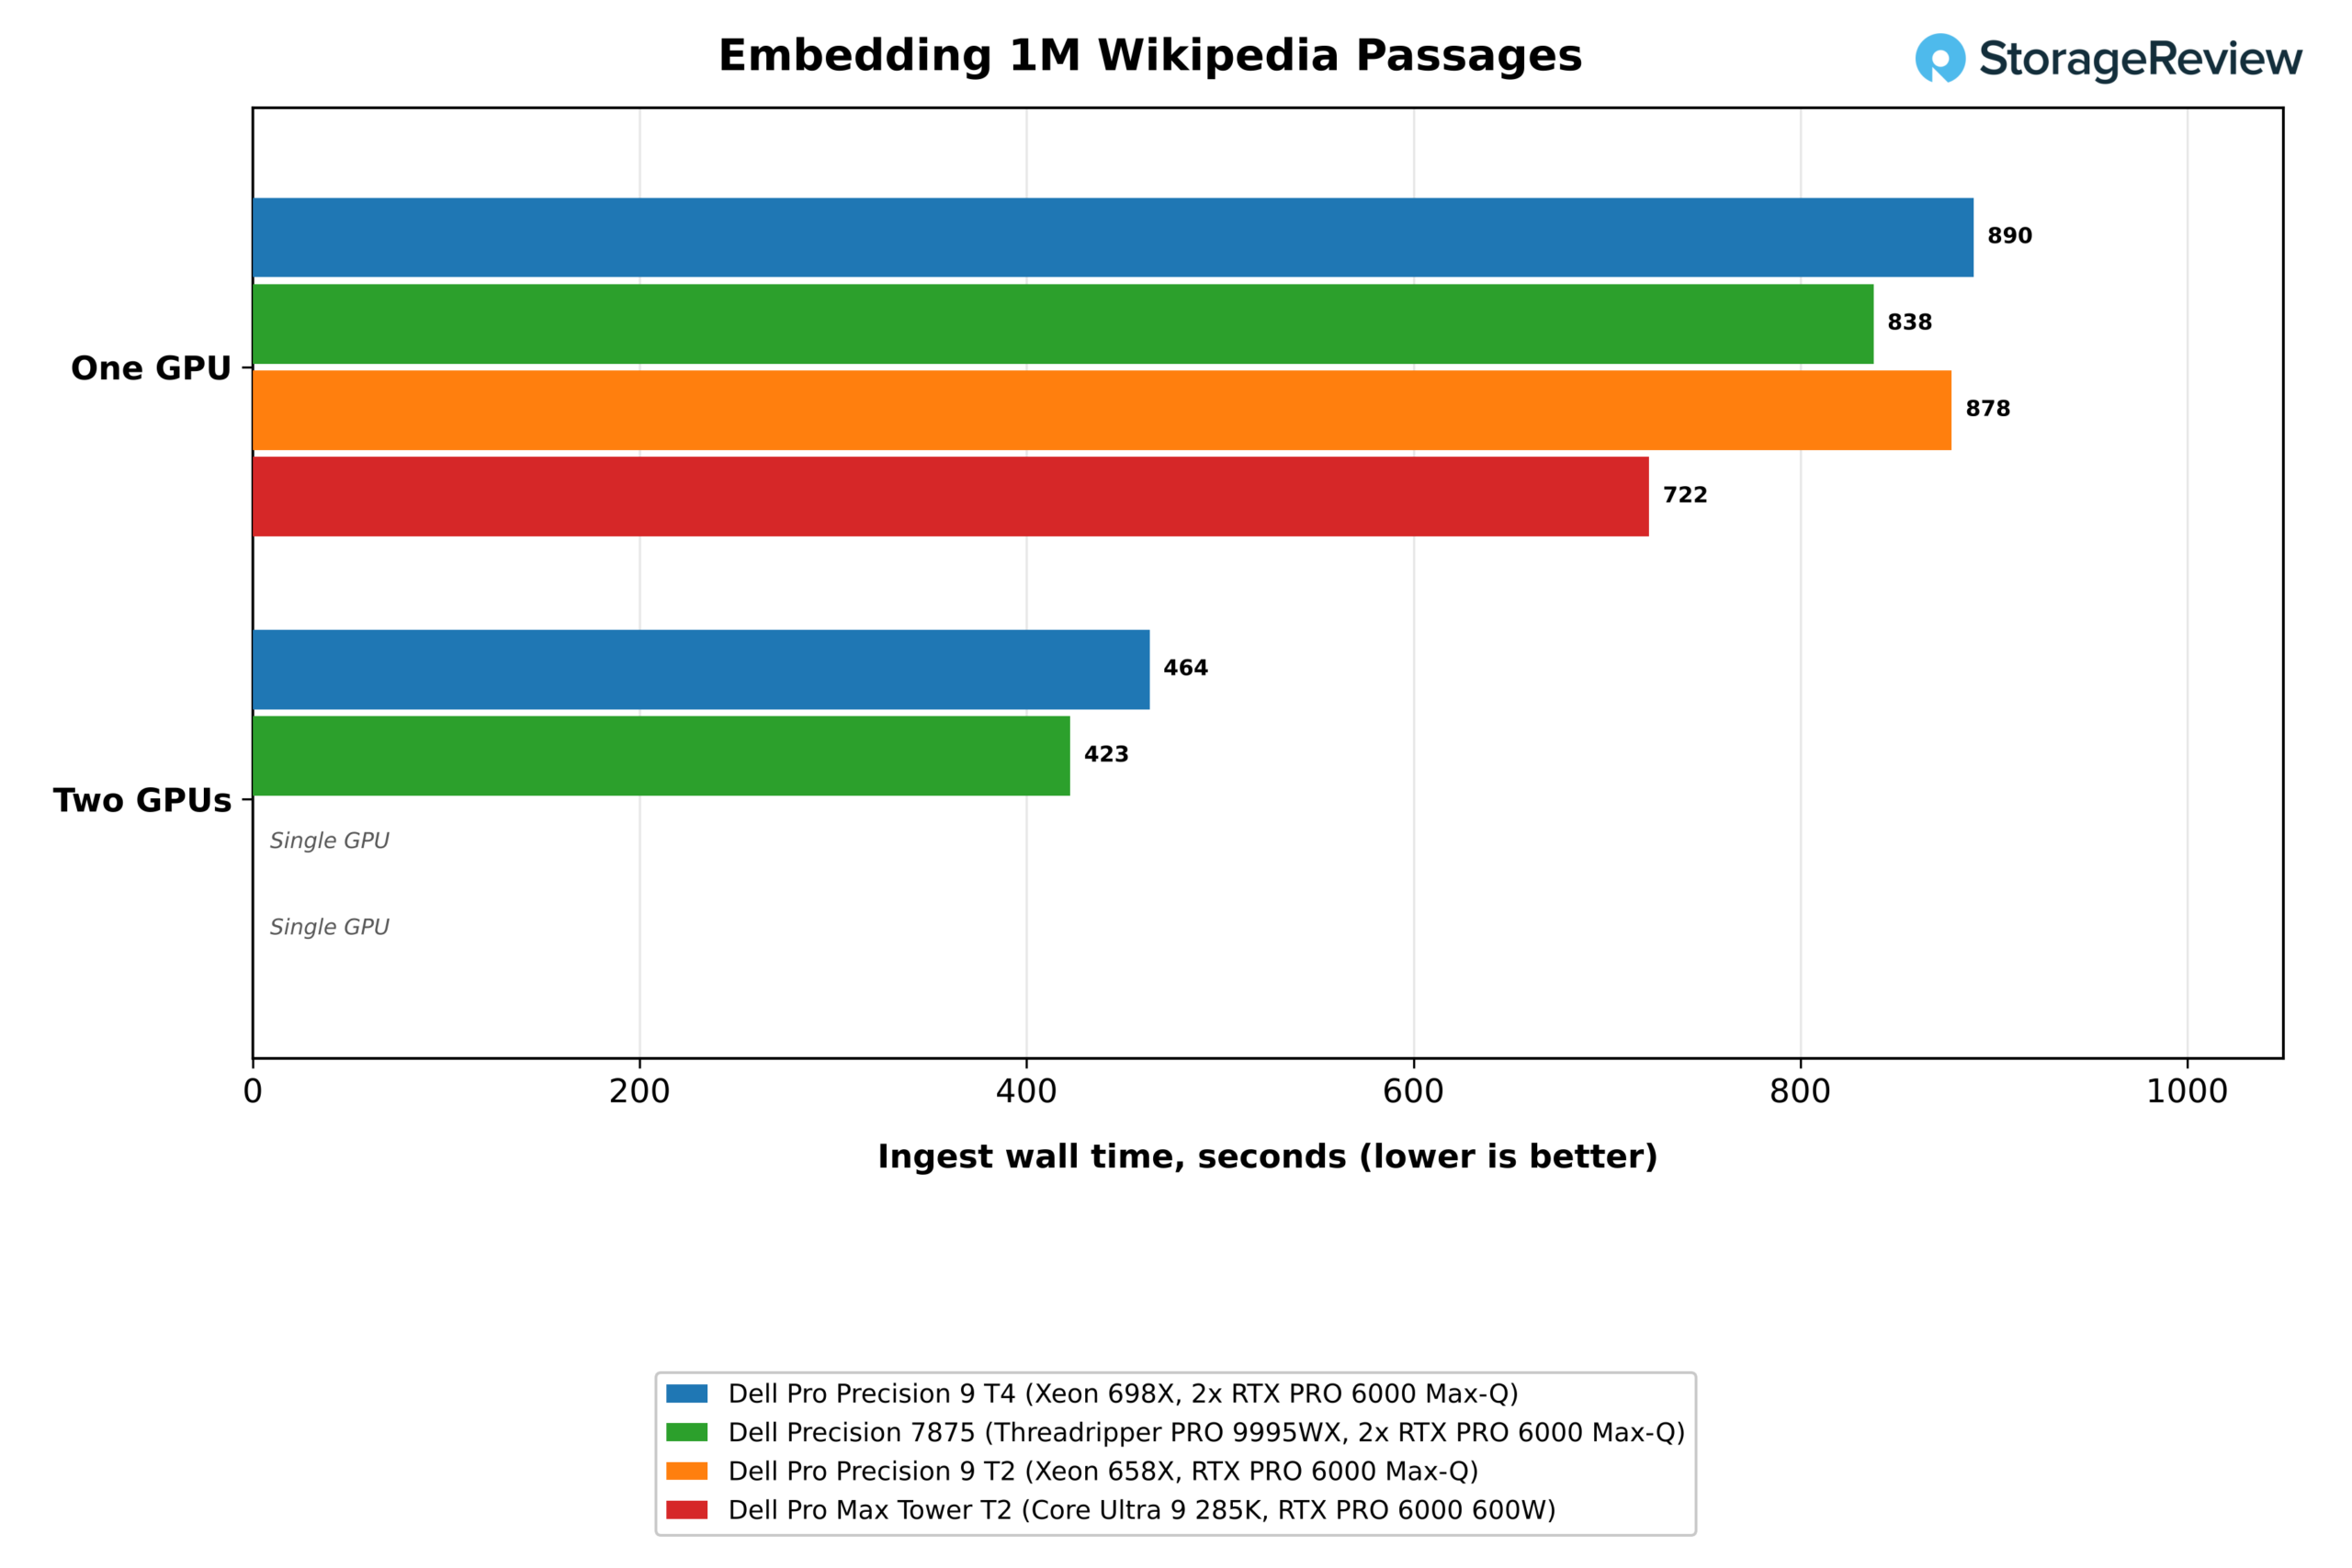
Il test RAG-at-scale nasconde le domande SQuAD tra un milione di passaggi di Wikipedia, le incorpora con nomic-embed-text, crea un indice HNSW e risponde con Phi-4-mini. L'incorporamento ha richiesto 890 secondi su una GPU T4 e 464 secondi su due, con un'accelerazione di 1.92 volte, mentre la Precision 7875 ha completato il test in 423 secondi con due schede. La scheda da 600 W nel Pro Max Tower T2 è la GPU singola più veloce in questo test, con 722 secondi.
La creazione dell'indice e la ricerca vettoriale vengono eseguite sulla CPU, ed è in questo che il T4 eccelle. Ha creato l'indice HNSW in 27.3 secondi contro i 34.8 del Precision 7875 e i 118.6 del Pro Max Tower T2, e ha effettuato ricerche a 98,503 query al secondo con un fattore di efficienza (EF) di 64, 1.51 volte il 7875 e 5.6 volte il sistema Core Ultra. Con un EF di 256, ha gestito 32,149 query al secondo con un recall del 97.6% rispetto alla ricerca esatta e le risposte sono arrivate in una mediana di 0.12 secondi.
Ritocchi
| Ministral 3 8B LoRA, BF16, un'epoca di Dolly 15k | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Torre T2 |
|---|---|---|---|---|
| Tempo di addestramento per epoca, una GPU (minuti, un valore inferiore è migliore) | 31.5 | 27.2 | 30.6 | 22.3 |
| Throughput, una GPU (token/s) | 1,584 | 1,834 | 1,631 | 2,236 |
| Perdita mantenuta prima e dopo l'addestramento, una GPU | 1.534 a 1.169 | 1.534 a 1.172 | 1.534 a 1.167 | 1.534 a 1.167 |
| Tempo di addestramento per epoca, due GPU (minuti, minore è il valore, migliore è il risultato) | 19.7 | 18.1 | GPU singola | GPU singola |
| Throughput, due GPU (token/s) | 2,528 | 2,754 | GPU singola | GPU singola |
| Accelerazione grazie alla seconda GPU | 1.60x | 1.50x | GPU singola | GPU singola |
| Perdita mantenuta dopo l'addestramento, due GPU | 1.167 | 1.168 | GPU singola | GPU singola |
Il test LoRA a singola epoca ottimizza Ministral 3 8B in BF16 su Dolly 15k attraverso 1,849 passaggi e valuta 200 esempi di test ogni 100 passaggi. Ogni sistema è partito da una perdita di 1.534 e ha terminato tra 1.167 e 1.172, quindi il risultato che li separa è il tempo impiegato per l'epoca. Una GPU T4 ha completato il test in 31.5 minuti a 1,584 token al secondo, entro il 3% dal Pro Precision 9 T2 sulla stessa scheda Max-Q. Il Precision 7875 ha impiegato 27.2 minuti e la scheda da 600 W nel Pro Max Tower T2 ha impiegato 22.3 minuti.
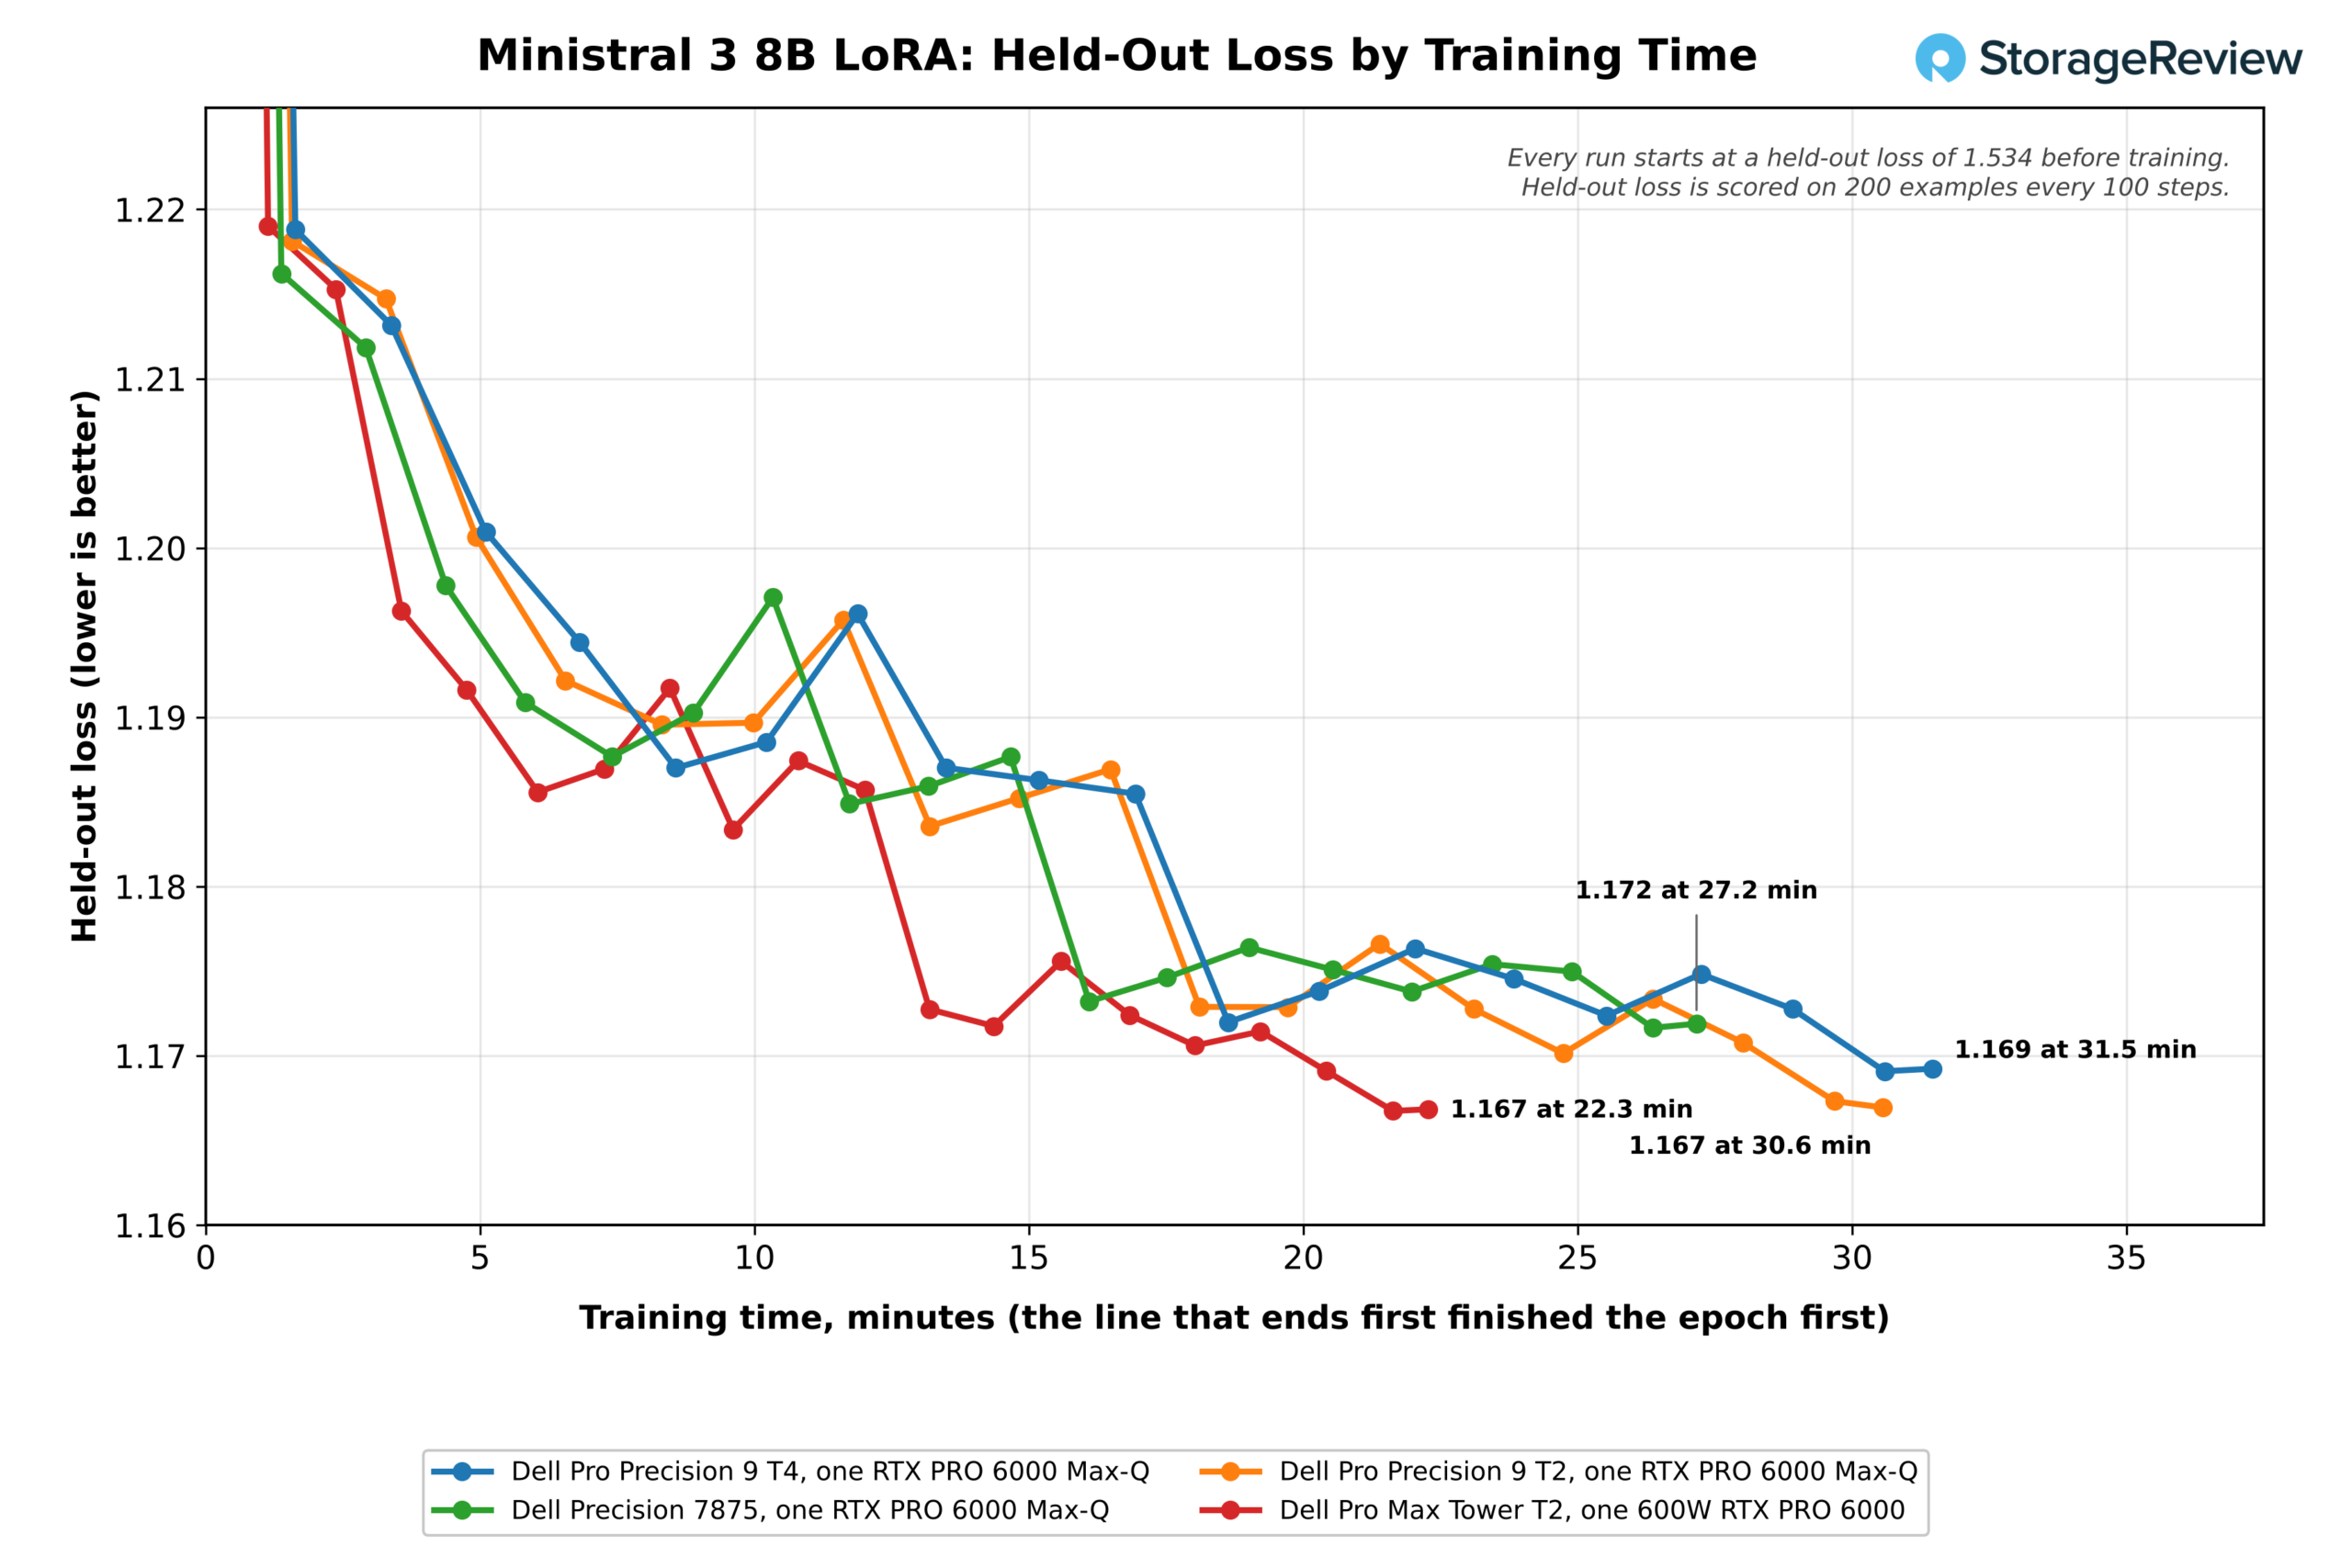
La perdita con dati di test sul T4 è scesa da 1.534 a 1.219 nei primi 100 passaggi, dopo 1.6 minuti di addestramento, per poi stabilizzarsi a 1.169 nel resto dell'epoca. L'aggiunta della seconda GPU ha ridotto l'epoca del T4 a 19.7 minuti a 2,528 token al secondo, con un'accelerazione di 1.60x, terminando prima dei 22.3 minuti della singola scheda da 600W. Il Precision 7875 ha completato la sua epoca con due GPU in 18.1 minuti, con un'accelerazione di 1.50x, e le esecuzioni con due GPU si sono concluse con perdite con dati di test di 1.167 e 1.168.
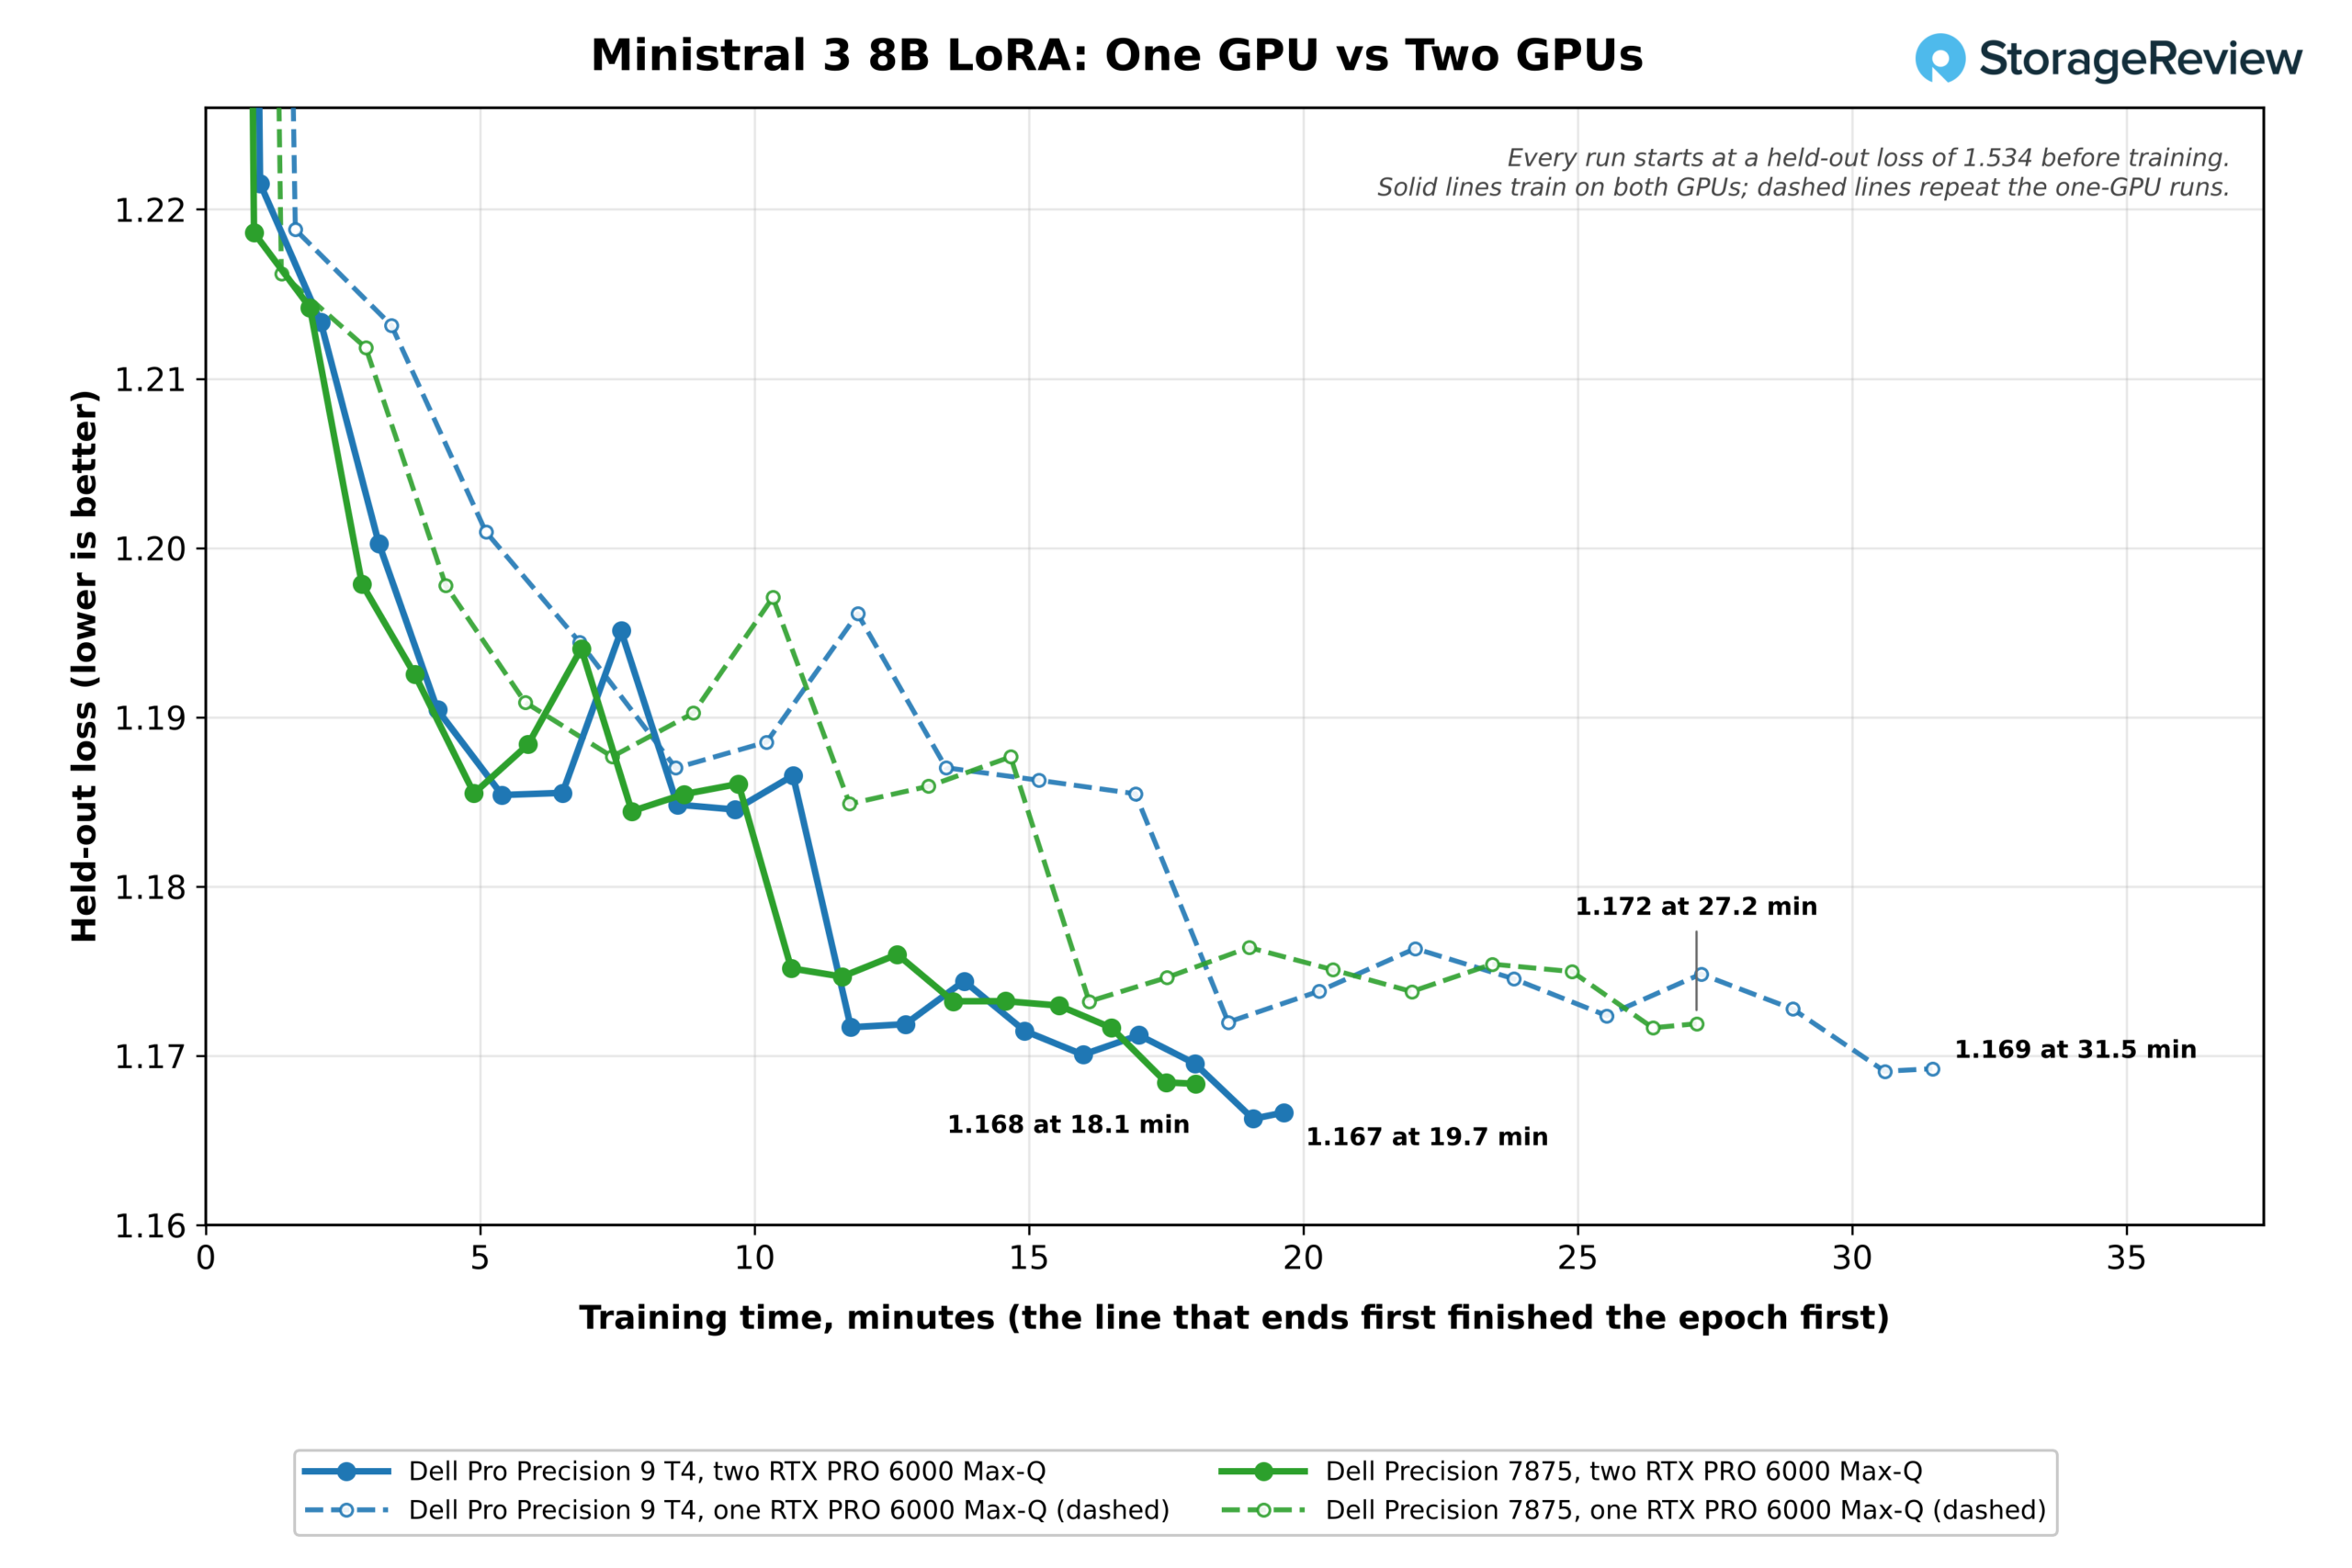
Entrambe le schede eseguono i dati in parallelo con due esempi per GPU e i gradienti accumulati nello stesso batch globale di otto, su quattro passaggi su una GPU e due passaggi su una coppia, quindi l'esecuzione con due GPU vede gli stessi esempi a ogni passaggio e arriva alla stessa perdita. Con due brevi esempi per GPU in ogni passaggio, la seconda scheda ha poco lavoro da assorbire e lo scambio dei gradienti occupa una quota maggiore di ogni passaggio. L'epoca ha raggiunto un picco di 19.5 GiB di memoria GPU su una scheda e 19.7 GiB per scheda su due, una frazione dei 96 GB su ciascuna RTX PRO 6000.
Agente di codifica, RAG su piccola scala e generazione di immagini
| Agente di codifica, RAG e generazione dell'immagine (valori più alti sono migliori, salvo diversa indicazione) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Torre T2 |
|---|---|---|---|---|
| Agente di codifica, gpt-oss:20b 64K, esecuzioni riuscite (su 3) | 3 | 2* | 2* | 2* |
| Agente di codifica, gpt-oss:120b 128K, esecuzioni riuscite (su 3) | 3 | 3 | 3 | 3 |
| Agente di codifica, gpt-oss:120b, velocità di generazione (token/s) | 161.5 | 167.9 | 166.7 | 183.2 |
| RAG, 20,963 passaggi, ingestione (passaggi/s) | 304.6 | 433.8 | 392.1 | 371.6 |
| Generazione di risposte RAG, Phi-4-mini (token/s) | 372.5 | 410.0 | 402.8 | 415.8 |
| FLUX.2 klein 4B BF16, 1024×1024 (immagini/min) | 40.96 | 43.03 | 41.32 | 54.25 |
| Z-Image Turbo 6B BF16 (immagini/min) | 17.29 | 17.67 | 17.27 | 23.83 |
| Qwen-Image 20B BF16 (immagini/min) | 2.43 | 2.45 | 2.39 | 3.20 |
*Segnalato dalla suite: una delle tre esecuzioni dell'agente su questo sistema non ha superato tutti gli 11 test.
Il T4 ha superato tutti i test di codifica a ogni livello di modello, inclusi tutti e tre i test gpt-oss:20b in un contesto 64K, dove gli altri tre sistemi ne hanno superati due su tre, e ha generato 161.5 token al secondo su gpt-oss:120b. La generazione delle immagini avviene su una GPU, quindi le 40.96 immagini al minuto del T4 su FLUX.2 klein in BF16 si collocano in linea con gli altri sistemi Max-Q e dietro alla scheda da 600W a 54.25.
Prestazioni della CPU
I risultati relativi alla CPU mettono a confronto gli 86 core Xeon del T4 con i 96 core Threadripper del Precision 7875, utilizzando come punti di riferimento i due T2 a 24 core. Il Threadripper ha dieci core in più e offre 192 thread contro i 172 dello Xeon. Il T4 risulta superiore laddove la larghezza di banda della memoria è determinante, mentre il 7875 prevale laddove lo sono il numero di core e la frequenza di clock.
Compressione, rendering e compilazione
| Test | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Torre T2 |
|---|---|---|---|---|
| 7-Zip, tutti i thread (GIPS) | 619.8 | 850.0 | 285.1 | 172.7 |
| 7-Zip, un filo (GIPS) | 8.85 | 10.58 | 9.27 | 11.04 |
| Blender 4.5 Monster (campioni/min) | 961.8 | 1,253.8 | 400.7 | 303.0 |
| Blender 4.5 Junkshop (campioni/min) | 641.9 | 849.7 | 266.9 | 191.9 |
| Blender 4.5 Classroom (campioni/min) | 442.8 | 612.2 | 187.2 | 147.1 |
| HandBrake x265 (fps) | 31.4 | 41.7 | 41.5 | 40.0 |
| HandBrake SVT-AV1 (fps) | 159.4 | 255.8 | 198.5 | 122.6 |
| LLVM 21 build (s, un valore inferiore è migliore) | 58.4 | 43.7 | 106.4 | 155.9 |
| Kernel Linux allmodconfig (s, un valore inferiore è migliore) | 312 | 264 | 537 | 843 |
| OpenSSL AES-256-GCM, tutti i thread (GB/s) | 882.6 | 1,139.1 | 371.2 | 137.0 |
| nginx, 1,000 connessioni (richieste/s) | 414,468 | 467,128 | 323,567 | 153,732 |
Il T4 ha ottenuto un punteggio di 619.8 GIPS in 7-Zip e 961.8 campioni al minuto in Blender Monster, rispettivamente 2.2 e 2.4 volte superiore al Pro Precision 9 T2 a 24 core. Il Precision 7875 ha registrato prestazioni superiori del 37% in 7-Zip e del 30% in Blender, completando la compilazione di LLVM in 43.7 secondi contro i 58.4 del T4 e la compilazione del kernel Linux con allmodconfig in 264 secondi contro i 312 del T4. La velocità per core è il punto debole del T4, con il punteggio più basso in 7-Zip a singolo thread in questo gruppo, pari a 8.85 GIPS.
La codifica x265 di HandBrake rappresenta un'eccezione in questa tabella, e la causa risiede più nel codificatore che nel processore. Gli altri tre sistemi hanno tutti raggiunto valori compresi tra 40.0 e 41.7 fps con 24 o 96 core, quindi x265 con questo preset non scala con il numero di core, e i 31.4 fps del T4 sono coerenti con la sua minore velocità per core sui thread utilizzati da x265. Durante la codifica, il T4 ha mantenuto una media di circa 1 GHz sui suoi 172 thread a temperature comprese tra 51°C e 64°C, il che indica che la maggior parte del chip era inattiva. SVT-AV1 ha scalato meglio, raggiungendo 159.4 fps sul T4 contro i 255.8 del 7875.


Larghezza di banda della memoria, simulazione e matematica
| Test | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Torre T2 |
|---|---|---|---|---|
| Triade STREAM (MB/s) | 328,329 | 215,177 | 141,832 | 45,102 |
| OpenFOAM 13 driver, 3 milioni di celle, risoluzione (s, valore inferiore è migliore) | 293 | 556 | 826 | Non finito |
| GROMACS benchPEP, tutti i core (ns/giorno) | 1.243 | 1.034 | Non correre | Non correre |
| GROMACS benchMEM, 16 core (ns/giorno) | 68.09 | 84.94 | 78.03 | 54.26 |
| OpenBLAS DGEMM, tutti i core (GFLOPS) | 3,664 | 4,745 | 2,319 | 1,063 |
| OpenBLAS LU risolve N=20000 (GFLOPS) | 1,660 | 1,172 | 1,616 | 858 |
| y-cruncher Pi, 1 miliardi di cifre (s, minore è il valore, migliore è il risultato) | 4.01 | 7.45 | 8.51 | 24.61 |
| y-cruncher Pi, 10 miliardi di cifre (s, minore è il valore, migliore è il risultato) | 53.9 | 83.7 | 119.2 | 347.9 |
| y-cruncher Pi, 25 miliardi di cifre (s, minore è il valore, migliore è il risultato) | 155.6 | 259.6 | Non correre | Non correre |
Otto canali DDR5-6400 offrono al T4 328 GB/s in STREAM Triad, il 53% in più rispetto al DDR5-5600 del Precision 7875 e 2.3 volte di più rispetto al Pro Precision 9 T2 a quattro canali. Seguono i test limitati dalla larghezza di banda: il T4 ha risolto il caso OpenFOAM driver da 3 milioni di celle in 293 secondi contro i 556 del 7875 e gli 826 del Pro Precision 9 T2, mentre il Pro Max Tower T2 non è riuscito a terminare entro il limite di 150 minuti della suite. Il T4 ha anche eseguito il caso da 22.6 milioni di celle in 6,851 secondi.

GROMACS benchPEP, il caso di dinamica molecolare su tutti i core di grandi dimensioni, è stato eseguito a 1.243 ns/giorno sul T4 contro 1.034 sul 7875, e la risoluzione LU ha raggiunto 1,660 GFLOPS contro 1,172. y-cruncher ha calcolato 10 miliardi di cifre di Pi in 53.9 secondi contro 83.7 sul 7875 e 25 miliardi in 155.6 secondi contro 259.6. I calcoli densi che rimangono nella cache favoriscono Threadripper, che ha superato OpenBLAS DGEMM con 4,745 GFLOPS contro 3,664.


Database e servizi
| Test | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Torre T2 |
|---|---|---|---|---|
| Esecuzione a caldo di ClickBench, 43 query (s, un valore inferiore è migliore) | 3.21 | 2.88 | 4.80 | 10.44 |
| Esecuzione a freddo di ClickBench, 43 query (s, un valore inferiore è migliore) | 6.45 | 7.09 | 6.92 | 14.22 |
| Cache Valkey, SET (richieste/s) | 666,714 | 1,138,696 | 914,832 | 1,719,108 |
| Cache Valkey, GET (richieste/s) | 865,353 | 1,279,429 | 991,576 | 1,648,278 |
| Stoccafisso, tutti i thread (Mnps) | 68.21 | 168.27 | 45.44 | 37.42 |
| PyPerformance go (ms, un valore inferiore è migliore) | 74.3 | 66.0 | 72.1 | 56.7 |
ClickHouse ha eseguito le 43 query ClickBench in 3.21 secondi a caldo e 6.45 secondi a freddo sul T4, 0.33 secondi in più rispetto al 7875 nel test a caldo e 0.64 secondi in più nel test a freddo. Valkey privilegia i core veloci rispetto ai core numerosi, e le 666,714 richieste SET al secondo del T4 sono inferiori a quelle di tutti e tre i sistemi di confronto, con il Core Ultra 9 285K del Pro Max Tower T2 in testa con 1.72 milioni. Questo andamento corrisponde ai risultati single-thread del T4 ed è un fattore da tenere in considerazione per i servizi in cui la latenza è un fattore limitante.
Con tutti i 172 thread caricati e il processore a una temperatura media di 87°C, il T4 ha cercato 68.21 milioni di nodi al secondo in Stockfish, 1.5 volte il Pro Precision 9 T2 a 48 thread e ben meno della metà dei 168.27 milioni di nodi al secondo del 7875 su 192 thread. Il test è inoltre andato in timeout durante la prima esecuzione completa del T4, prima che un nuovo test autonomo producesse questo risultato. Riportiamo il risultato così come misurato e non abbiamo individuato la causa della scarsa scalabilità.
Prestazioni di archiviazione
| fio, ingombro di 25 GiB (maggiore è, meglio è) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Dell Pro Max Torre T2 |
|---|---|---|---|---|
| Lettura sequenziale 128K (MB/s) | 14,152 | 7,089 | 20,914 | 7,234 |
| Scrittura sequenziale 128K (MB/s) | 10,078 | 5,265 | 12,564 | 6,772 |
| Lettura casuale 4K, picco (IOPS) | 2,306,346 | 993,569 | 3,214,066 | 1,538,387 |
| Scrittura casuale 4K, picco (IOPS) | 1,830,776 | 787,388 | 2,353,766 | 1,326,030 |
*Segnalato dalla suite per varianza tra le esecuzioni dopo una nuova esecuzione.
L'unità di avvio SK hynix Gen5 da 2 TB del T4 ha raggiunto una velocità di lettura di 14,152 MB/s e di scrittura di 10,078 MB/s, circa il doppio della velocità di lettura sequenziale delle unità Gen4 presenti nel Precision 7875 e nel Pro Max Tower T2, con picchi di 2.31 milioni di IOPS in lettura casuale e 1.83 milioni di IOPS in scrittura casuale. La velocità di lettura sequenziale di 20,914 MB/s del Pro Precision 9 T2 supera quella di un singolo collegamento Gen5 x4, che rientra nel volume di test di quel sistema, un array striping di unità Samsung PM9E1 Gen5. Abbiamo testato solo l'unità di avvio del T4, escludendo la seconda unità da 2 TB.

Temperature e clock sotto carico
| Dell Pro Precision 9 T4 | CPU Max (C) | CPU media (C) | Frequenza media della CPU (MHz) |
|---|---|---|---|
| 7-Zip | 93 | 80.6 | 1,967 |
| Frullatore | 91 | 85.7 | 2,587 |
| GROMACS | 96 | 81.3 | 1,313 |
| LLVM build | 83 | 74.5 | 2,127 |
| ApriBLAS | 80 | 62.9 | 1,325 |
| Servizio LLM | 84 | 65.0 | 924 |
| Ritocchi | 71 | 61.2 | 854 |
| RAG su larga scala | 74 | 64.4 | 987 |
| Archiviazione | 64 | 55.4 | 942 |
Con il BIOS in modalità Ultra Performance, lo Xeon 698X ha raggiunto un picco di 93°C in 7-Zip e 96°C in GROMACS, e i valori di clock nella tabella sono medie su tutte le 172 CPU logiche. Blender e Stockfish hanno caricato tutti i thread e si sono mantenuti tra 2.5 GHz e 2.6 GHz, al di sopra della frequenza base del chip di 2.0 GHz. GROMACS e OpenBLAS hanno caricato rispettivamente 64 e 86 core fisici e hanno lasciato i thread rimanenti inattivi a circa 0.8 GHz, motivo per cui le loro medie si aggirano intorno a 1.3 GHz. I carichi di lavoro gestiti dalla GPU hanno mantenuto il processore più fresco, con una media tra 61°C e 65°C durante la gestione di LLM, il fine-tuning e RAG, poiché questi test sfruttano intensamente le schede grafiche.

Conclusione
Il Dell Pro Precision 9 T4 è progettato per il lavoro locale con l'IA, e la seconda RTX PRO 6000 è dove questo si vede. Due schede Max-Q hanno aumentato il throughput di servizio di picco da 1.85 a 2.02 volte su quattro modelli e il throughput di embedding di 1.92 volte, hanno ridotto un'epoca LoRA su Ministral 3 8B da 31.5 a 19.7 minuti e hanno portato MiniMax M2.7, un modello troppo grande per una singola scheda, da 30.3 a 83.7 token al secondo per un singolo utente. Su gpt-oss 120B, un server per GPU ha raggiunto 7,091 token totali al secondo con 64 richieste, mentre suddividendo il modello su entrambe le schede, il primo token di un singolo utente è stato restituito in 719 ms contro 1,189 ms.

Otto canali DDR5-6400 hanno conferito allo Xeon 698X un vantaggio del 53% in termini di larghezza di banda della memoria rispetto al Threadripper PRO 9995WX. Tale larghezza di banda ha permesso al T4 di ottenere risultati più rapidi nei test OpenFOAM, GROMACS benchPEP, y-cruncher e HNSW rispetto al Precision 7875, e lo storage Gen5 del T4 ha caricato modelli di grandi dimensioni più velocemente. Anche lo chassis merita un plauso, con il miglior sistema di raffreddamento che abbiamo visto da Dell in questa categoria e l'accesso senza attrezzi all'alimentatore.
Il 7875 rimane in vantaggio nel rendering, nella compressione e nella compilazione, con un margine dal 18 al 38%, e del 60% in SVT-AV1. La velocità per core dello Xeon è risultata inferiore a quella di tutti gli altri sistemi del gruppo, come dimostrato da Valkey e altri servizi con un utilizzo limitato del multithreading. Anche il fine-tuning su una singola GPU è risultato più lento sul T4, dove l'epoca LoRA ha richiesto 31.5 minuti contro i 27.2 del 7875 e i 22.3 della scheda da 600W nel Pro Max Tower T2, con ogni sistema che ha terminato con una differenza di soli 0.005 secondi rispetto alla stessa perdita di riferimento.
Con un prezzo di circa 66,600 dollari nella configurazione disponibile su Dell.com, il T4 è ideale per i team che desiderano gestire, integrare e ottimizzare modelli in locale, inclusi modelli che richiedono più di 96 GB di memoria GPU, oltre a simulazioni e analisi che dipendono dalla memoria, il tutto sulla stessa macchina. Gli acquirenti il cui lavoro consiste principalmente in rendering e compilazione troveranno la piattaforma Threadripper più veloce, mentre chi necessita di una sola GPU può optare per la stessa scheda nel modello più compatto Pro Precision 9 T2.

Classifica: Il Dell Pro Precision 9 T4 si conferma il miglior desktop tower con processore Xeon per l'intelligenza artificiale locale nella nostra classifica dei migliori desktop per l'intelligenza artificiale locale.


 Amazon