

Lenovo ThinkPad P1 Gen 9は、Lenovoの薄型フラッグシップモバイルワークステーションです。この16インチマシンは、ThinkPad Pシリーズの他のモデルが重量と価格の目標を満たすために省略しているプレミアム機能を搭載しています。前面エッジの厚さが9.87mm、重量が1.8kg未満のアルミニウム製シャーシ、140W充電に対応した90Whバッテリー、2つのThunderbolt 5ポート、Gen5 x4ベイを備えたデュアルM.2スロット、そして800nitの3840×2400 IPSパネルまたは120Hz Tandem OLEDパネルのいずれかを選択できます。
今回レビューしたユニットは、Core Ultra 9 386H、LPCAMM2モジュールに搭載された64GBのLPDDR5X-8533メモリ、2TBのSK hynix Gen5 SSD、RTX PRO 2000 Blackwell、そして4K IPSディスプレイを搭載しています。Lenovo.comでは、同じ構成のOLEDパネル搭載モデルが2026年10月24日時点で7,719ドルで販売されており、その2日前には5,399ドルで販売されていました。LenovoはPシリーズを頻繁に値引き販売しているため、セール価格の方が評価の基準として適切であり、結論でもその価格を使用しています。
このサイトには、このプロセッサとGPUを搭載した4K IPSパネルは掲載されておらず、最も近いIPS構成であるCore Ultra 7 356H(RTX PRO 2000、32GB、1TB搭載)は、10月22日に3,449ドルで販売された後、現在は5,099ドルとなっており、16GBと512GBを搭載したカスタマイズ構成は3,734ドルからとなっている。
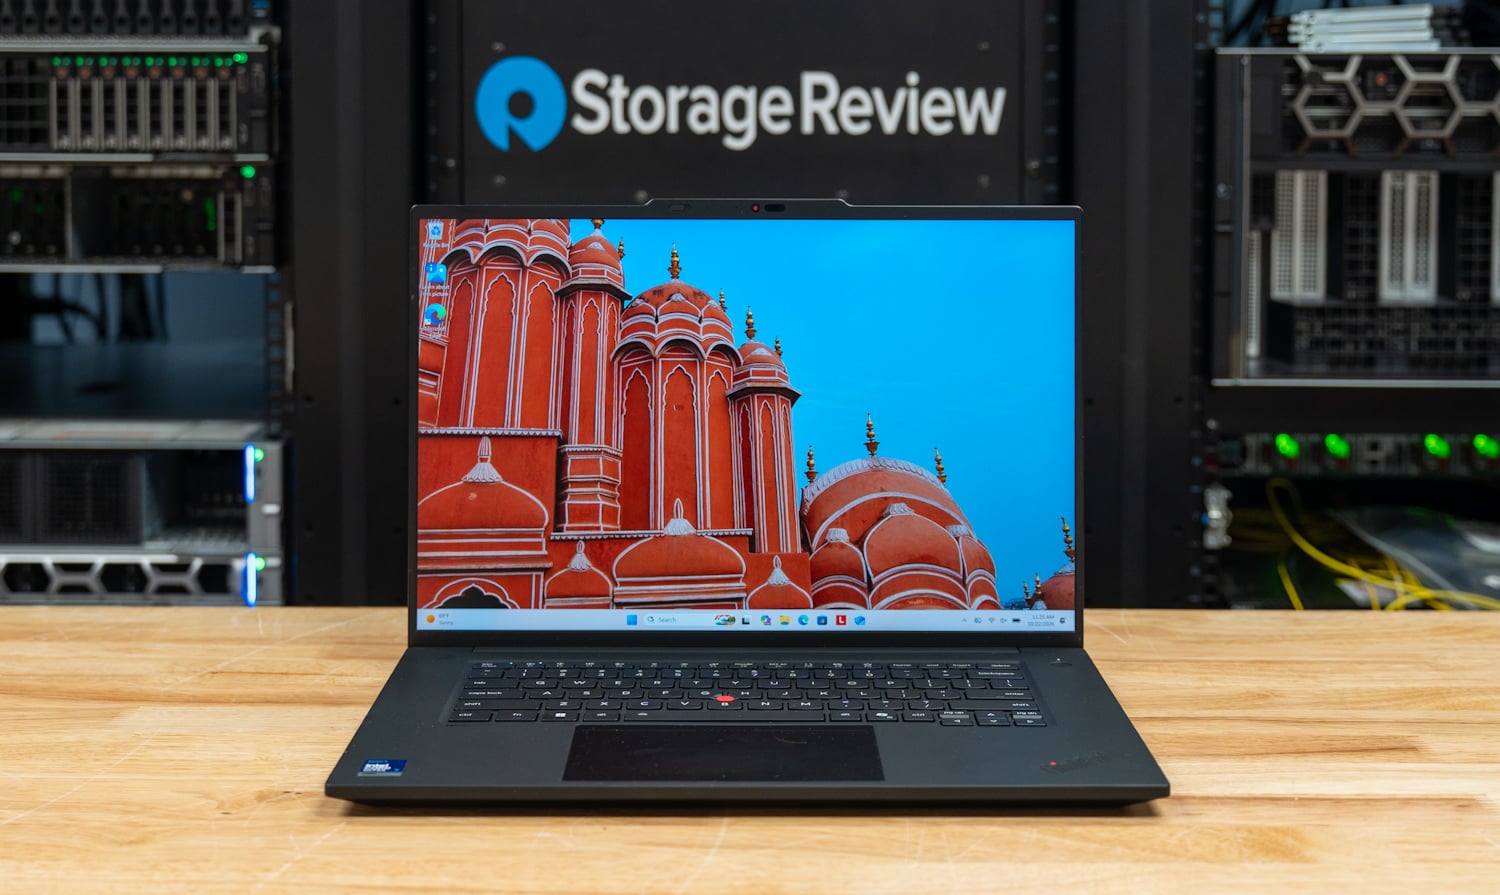
Lenovoは、P16クラスのシャーシなしでISV認証グラフィックスを求めるクリエイティブプロフェッショナル、エンジニア、AI開発者をターゲットにしています。第9世代は、第8世代と同じ筐体にシリコンアップデートが施されています。IntelのCore Ultra Series 3(50 TOPS NPU搭載)がSeries 2に取って代わり、LPCAMM2メモリは64GBから96GBに増加、GPUの上限は8GBのGDDR7を搭載したRTX PRO 2000 Blackwellのままです。
Dell Pro Precision 9 T2およびRTX Sparkノートブックで使用したのと同じスクリプトスイートを使用してテストを実施しました。その後、その結果を、前世代のCore Ultra 9 285HとRTX PRO 2000を搭載したDell Pro Max 14 Premium、Core Ultra X9 388Hを搭載しディスクリートGPUを搭載していないDell Pro Precision 5 16S、およびNVIDIAのRTX Spark N1Xを搭載したHP OmniBook Ultra 16と比較しました。
Panther Lake はマルチスレッド処理でその地位を確立しました。P1 は Cinebench 2026 のマルチコアで 5,083 を記録し、285H の 4,292 を上回りました。LLVM のビルド時間は 309.1 秒で、285H の 393.9 を上回りました。STREAM Triad の読み込み速度は 81,712MB/s で、285H の 62,255 を上回りました。シングルコア Cinebench のスコアは 519.9 で 7% 上回り、Speedometer は 40.6 対 41.5 で互角でした。GPU では、P1 の 50W RTX PRO 2000 は、MLPerf Client トークンレートで Dell の 47W カードよりも 19 ~ 27% 高速に動作し、8GB の GDDR7 により、20B 以上のモデル ティアと 3B を超えるすべてのサービス ティアが手の届かないものとなりました。
主要なポイント(要点)
- マルチスレッドCPU処理が世代を先取りする: Cinebench 2026マルチコアで5,083、同じGPUを搭載したCore Ultra 9 285Hより18%上回り、7-Zipで93.4 GIPSに対し109.2 GIPS、Blenderで3つのシーン全体で18~23%向上、LLVMビルドは309.1秒で22%短縮。
- シングルスレッド処理とブラウザ処理は移動しませんでした。 Cinebenchのシングルコアスコアは519.9対486.0、Speedometerは40.6対41.5、シングルスレッドPythonは285Hと2~5%程度の差です。一方、386HはDell Pro Precision 5 16Sに搭載されている5.1GHz Core Ultra X9 388Hに対して、シングルコアスコアで3%劣ります。
- メモリシステムのアップグレードは、静かに進められてきたものです。 STREAM TriadはLPDDR5X-8533から81,712MB/sの読み出し速度を実現し、285Hの62,255MB/sを上回ります。メモリレイテンシは173.1nsから116.1nsに低下し、DGEMMは391GFLOPSから519GFLOPSに向上します。
- 8GBのGDDR7がAI性能の限界を定める。 MLPerf Client は、Llama 3.1 8B を毎秒 64.8 トークン、Phi-4-mini を毎秒 111.9 トークン生成し、小型モデルでは Dell の 47W RTX PRO 2000 と RTX Spark N1X の両方を上回りましたが、モデル負荷とコーディングエージェントのテストでは 20B 以上、サービング ティアでは 3B 以上が基準を満たしませんでした。128GB N1X ノートブックと 64GB Arc Pro B390 Dell は、すべてのモデル負荷とコーディングエージェント ティアを実行しました。
- 価格が市場を混乱させている。 定価7,719ドルのOLED版は、6,229.99ドルの128GB HP OmniBook Ultra 16よりも高価です。10月22日にLenovoが実施した5,399ドルのセール価格では、この機種と4,999.99ドルの64GB OmniBookの中間の価格帯になります。128GB版は、P1では実行できなかったすべてのローカルAIティアを実行しました。Ryzen AI Max統合メモリワークステーションも同じ価格帯に位置付けられます。P1のケースは、ローカルAIの容量ではなく、ISV認証、Thunderbolt 5、およびグループ内で最速の小型モデルGPUです。
- スコアを維持するのに十分なほどクール: 30分間のCinebenchループは、平均クロック3,505MHzで最初のパスの0.983である4,811で安定し、CPU温度は94.1℃に固定されました。2TBのPCB01は、シーケンシャル読み取りで10,012MB/s、4Kランダム読み取りで756.5K IOPSのピークを記録しました。
P1 Gen 9の位置づけ
レノボは3月にThinkPad P14s Gen 7およびP16s Gen 5と同時にP1 Gen 9を発表し、6月に発売予定としている。同社はこれを、これまで製造した中で最も高性能なThinkPadであり、Pシリーズの薄型フラッグシップモデルだと謳っている。P16s Gen 5は、同じCore Ultra Series 3プロセッサ、同じ96GB LPCAMM2ストレージ容量、同じRTX PRO 2000オプションを提供しているため、GPUはもはや両者の違いではない。P1は、その筐体とレノボがそこに詰め込んだものによって、プレミアム価格に見合う価値を提供している。
P16sと比較すると、60Whバッテリーの代わりに90Whバッテリー、100Wアダプターの代わりに140Wアダプター、2つのThunderbolt 4ポートの代わりに2つのThunderbolt 5ポートと1つのThunderbolt 4ポート、1つのM.2スロットの代わりに2つのM.2スロット、SD Express 7.0リーダー、オプションの5G、オールアルミニウム製の筐体、2つのプレミアムパネルを搭載し、重量はP16sの1.79kgに対し1.77kgとなっています。
その上位機種として、ThinkPad P16 Gen 3はHXシリコンと最大RTX PRO 5000を搭載したフルパワーの16インチモデルであり、ThinkPad P16v Gen 3は285HとRTX PRO 2000を搭載した2.1kgのバリューモデルです。どちらもまだシリーズ3には移行していません。
P1の最上位GPUはRTX PRO 2000で、その下位には第8世代から変更のないRTX PRO 1000があり、ディスクリートGPUによってプロセッサが決まります。LenovoはdGPUをArc Pro B390統合グラフィックスと組み合わせないため、RTX PRO 2000構成では、4つのXeコア統合GPUを搭載し最大4.9GHzのCore Ultra 7 356HまたはCore Ultra 9 386Hが出荷されます。一方、12のXeコアB390を搭載し5.1GHzのCore Ultra X7 368HおよびX9 388Hは、統合グラフィックスのみの構成です。
そのため、X9 388HとB390を搭載したDell Pro Precision 5 16Sがこの比較に含まれているのです。これはPanther Lakeワークステーションを構成するもう一つの方法であり、これら2つの構成によってRTX PRO 2000がもたらす効果と、より高速なCPUがもたらす見返りが明らかになります。
世代ごとに、第 9 世代は新しいシリコンを搭載した第 8 世代のシャーシです。フットプリントは 354.4 x 241.2mm 対 354.3 x 241.0mm。ポートセット、3 つのディスプレイオプション、および 2 つの GPU オプションは変更されておらず、重量は 1.84 kg から 1.77 kg に減少しています。変更点は、13 TOPS NPU と最大 64GB の LPDDR5X-7467 を搭載した Series 2 Arrow Lake-H から、50 TOPS NPU と最大 96GB の LPCAMM2 を搭載した Series 3 Panther Lake です。Lenovo はメモリを 8533 MT/s と記載していますが、当社のユニットは 8533 MT/s で動作する 9600 定格のモジュールを使用しています。
ビルドとデザイン
P1 Gen 9は、354.4 x 241.2mmのアルミニウム製クラムシェル型で、前面の端の厚さは9.87mm、背面は15.8mm、脚部の最大厚さは20.6mmです。Lenovoによると、重量は1.77kgです。天板とベースはどちらもアルミニウム製で、Lenovoによると、天板は75%、底部は55%がリサイクルアルミニウムで、他のPシリーズと同様にMIL-STD-810H規格に準拠しています。今回レビューしたモデルはブラック仕上げで、カラーバリエーションはブラックのみです。

ディスプレイは、800 nit の 16 インチ 3840×2400 IPS パネル、16:10 アンチグレアスクリーン、100% DCI-P3 カバー率、DisplayHDR 400、Dolby Vision、および 60Hz での X-Rite 工場出荷時キャリブレーションです。Lenovo は、エントリーモデルに 1920×1200 500 nit IPS パネル、ペン対応、600 nit SDR および 1,500 nit HDR ピーク、40~120Hz 可変リフレッシュレートの 3200×2000 Tandem OLED タッチパネルも提供しています。このセグメントの購入者のほとんどがカラー作業用に選択する IPS パネルが、この解像度では Windows のデフォルト設定で 250% スケーリングになります。

キーボードはThinkPadの6列レイアウトで、Copilotキー、バックライト、防滴機能を備え、その下にはTrackPointとガラス製の触覚フィードバック付きタッチパッド(85 x 135mm)が配置されています。電源ボタンにはチップ内蔵型の指紋認証リーダーが搭載され、ディスプレイ上部の5MPカメラは、Windows Hello用の赤外線センサーと物理的なプライバシーシャッター、コンピュータービジョンによる存在検知機能を組み合わせています。Wi-FiモデルにはDolby Atmos対応の2Wスピーカーが2基搭載され、WWANモデルにはさらに1Wスピーカーが2基追加されています。

ポートは両側に配置されており、左側には DisplayPort 2.1 と 140W の電源入力を備えた Thunderbolt 5 ポートが 2 つ、HDMI 2.1 ポート、オーディオ ジャックがあります。右側には、Lenovo が交換可能なモジュールとして構築した Thunderbolt 4 ポート、常時充電対応の 10Gbps USB-A ポート、SD Express 7.0 リーダー、Kensington Nano スロット、および 5G モデルには Nano-SIM トレイがあります。オンボード Ethernet はありません。Lenovo は、一部の構成では USB-C から 2.5GbE へのアダプタを同梱し、他の構成ではオプションとしてリストしています。3 つの USB-C ポートは、それぞれ最大 5120×3200 の外部ディスプレイを 3 台、または 8K60 パネルを 1 台駆動できます。


底面カバーはサービスのために取り外すことができ、BIOSに改ざん検出機能が搭載されています。LPCAMM2メモリモジュールは最大96GBまでユーザー自身で交換可能で、2つのM.2 2280スロットはGen5 x4とGen4 x4がそれぞれ1つずつ搭載されており、RAID 0と1に対応しています。90Whバッテリーはユーザー自身で交換可能で、140W USB-C GaNアダプタを使用すれば1時間で80%まで急速充電できます。WWAN構成では5GモジュールがGen4スロットを占有するため、2ドライブ構成と5Gは排他的に使用できます。

Lenovo ThinkPad P1 Gen 9 仕様
| 製品仕様 | Lenovo ThinkPad P1 Gen 9(テスト機:21UE000XUS) |
|---|---|
| Platform | |
| プロセッサ | Intel Core Ultra 9 386H (シリーズ 3)、16コア/16スレッド (4P + 8E + 4LPE)、Pコア 2.1~4.9GHz、18MB Intel Smart Cache、Intel vPro Enterprise オプション:Core Ultra 7 356H、Core Ultra 7 366H、Core Ultra X7 368H、Core Ultra X9 388H(XシリーズはArc Pro B390搭載、統合グラフィックスのみ) |
| NPU | Intel NPU、最大50 TOPS |
| メモリ | 64GB LPDDR5X-8533(LPCAMM2モジュール1枚、デュアルチャネル)、お客様による交換可能。16GB、32GB、64GB、または96GB |
| グラフィック | NVIDIA RTX PRO 2000 Blackwell世代ノートPC用GPU、8GB GDDR7、50W TGP(構成済み) オプション:RTX PRO 1000 Blackwell 8GB、Intel Arc Pro B390統合型(XシリーズCPU搭載モデル) |
| Storage | 2TB SK hynix PCB01 (HFS002TFM9X179N)、M.2 2280 PCIe 5.0 x4、Opal 2.0 スロット:M.2 2280 PCIe 5.0 x4 x1、M.2 2280 PCIe 4.0 x4 x1;最大8TB(4TB x 2);RAID 0/1 |
| ディスプレイ | |
| 試験済みのパネル | 16インチ WQUXGA (3840×2400) IPS、800ニット、100% DCI-P3、60Hz、1500:1、アンチグレア、DisplayHDR 400、Dolby Vision、X-Rite工場キャリブレーション済み |
| パネルオプション | 16インチ WUXGA (1920×1200) IPS液晶、輝度500nits、sRGBカバー率100%、リフレッシュレート60Hz 16インチ 3.2K (3200×2000) Tandem OLEDタッチスクリーン、600ニトSDR / 1,500ニトHDR、100% DCI-P3、40~120Hz VRR、ペン対応 |
| 接続性 | |
| ポート | Thunderbolt 5ポート×2(USB PD 3.1、DisplayPort 2.1、入力140W/出力15W) Thunderbolt 4ポート(モジュール式)×1 USB-Aポート×1(10Gbps、常時オン) HDMI 2.1 (8K60) x 1 SD Express 7.0 x 1 3.5mmヘッドホン/マイク端子×1 ケンジントンナノスロット |
| 無線 | Intel Wi-Fi 7 BE211 2×2、Bluetooth 5.4 (6.0 ハードウェア対応)、vPro オプションでSnapdragon X61 5G sub-6(eSIM対応、Gen4 M.2スロット使用)、オプションでNFC |
| イーサネット | オンボードなし。Lenovo USB-C - 2.5GbEアダプター |
| カメラと音声 | 5MP RGB + IRカメラ(プライバシーシャッターおよび存在検知機能付き)、デュアル遠距離マイク、ドルビーボイス、2Wスピーカー×2、ドルビーアトモス(WWANモデルはクアッドスピーカー) |
| 物理的な | |
| バッテリーと電源 | 90Whバッテリー、ユーザー交換可能、1時間で80%まで急速充電可能。140W USB-C GaNアダプター、PD 3.1対応。 |
| 寸法 | 354.4 x 241.2 x 9.87 / 15.8mm(前面/背面)、最大20.6mm |
| 重量 | 1.77kg(3.90ポンド)から |
| セキュリティ | ディスクリートTPM 2.0、電源ボタン内蔵のチップ内指紋認証リーダー、自己修復BIOS、底面カバーの改ざん検出機能、Windows Hello対応IRカメラ |
| 認定 | MIL-STD-810H準拠、Altair、AVID、Autodesk、ANSYS、Barco、Bentley、Dassault、Esri、Nemetschek、PTC、SiemensのISV認証取得済み、EPEAT Gold、ENERGY STAR 9.0、TCO 10 |
| オペレーティングシステム | Windows 11 Pro(テスト済み)、Windows 11 Home、Ubuntu、Fedora、Red Hat Enterprise Linux 10.2(認証済み) |
| 価格 | 2026年10月24日現在、Tandem OLEDパネル搭載の対応構成(21UE0014US)はlenovo.comで7,719ドル、同週初めには5,399ドルで販売されていた。RTX PRO 2000、16GBメモリ、512GBストレージ、WUXGAパネルを搭載したCore Ultra 7 356Hのカスタマイズ構成は3,734ドルから。 |
テストのセットアップと方法論
今回レビューしたユニットは、Core Ultra 9 386Hプロセッサ、RTX PRO 2000 Blackwellグラフィックス、64GBのLPDDR5X-8533メモリ、そしてWindows 11 Pro 25H2が動作する2TB Gen5 SSDを搭載しています。ベンチマークテストは電源に接続した状態で実行し、Windowsのパフォーマンス設定は「最高」、Lenovoのウルトラパフォーマンスモードを有効にしました。バッテリー駆動時間については、後日改めてレビュー記事を掲載します。
結果は、スクリプト化されたクライアントベンチマークスイートであるsr-clientのフル実行とピークプロファイル実行によるものです。P1とDell Pro Max 14ではバージョン1.3を、Pro Precision 5 16SとOmniBookではバージョン1.2を使用しました。バージョン1.3は、テスト内容を変更せずに実行条件を修正するメンテナンスリリースです。各システムは、OEMのドライバとユーティリティを含む工場出荷時のWindowsイメージを実行し、P1ではNVIDIAドライバ597.16を実行しました。
このテストスイートでは、すべての箇所で同じ設定が適用されます。Windowsの電源モードは「最高のパフォーマンス」、ディスプレイの明るさは50%、スリープタイマーとディスプレイタイマーはすべてオフ、WindowsファイアウォールとUACプロンプトはオフ、VBSとメモリ整合性は出荷時の設定のままオンになっています。各結果は複数回のテストの中央値であり、ばらつきが2%を超える場合は、テストスイートは結果を受け入れる前に再実行します。
Dell Pro Max 14 Premiumは、同じRTX PRO 2000を搭載した前世代のIntel製CPUなので、この2機種はCPUプラットフォームが分離されています。Dellは47Wで動作するのに対し、Lenovoは50Wで動作しており、これがGPU側の唯一のハードウェアの違いです。Dell Pro Precision 5 16Sは、Core Ultra X9 388HとArc Pro B390統合グラフィックスを搭載した16インチワークステーションで、ディスクリートGPUは搭載されていません。HP OmniBook Ultra 16は、 128GBの統合メモリを搭載したNVIDIAのRTX Spark N1Xを搭載しており、現在、ノートブックの中でローカルAIテストでトップの成績を収めているシステムです。
| CPU | メモリ | GPU | ブートドライブ | OSと電源モード | |
|---|---|---|---|---|---|
| Lenovo ThinkPad P1 Gen 9 (21UE000XUS) | Intel Core Ultra 9 386H、16コア/16スレッド(4P + 8E + 4LPE) | 64GB LPDDR5X-8533 LPCAMM2 | NVIDIA RTX PRO 2000 Blackwell ノートパソコン用GPU、8GB GDDR7、50W | SK ハイニックス PCB01 2TB (HFS002TFM9X179N)、Gen5 x4 | Windows 11 Pro 25H2 (x64)、Lenovo Ultra Performance、最高のパフォーマンス |
| Dell Pro Max 14 Premium (MA14250) | Intel Core Ultra 9 285H、16コア/16スレッド(6P + 8E + 2LPE) | 64GB LPDDR5X-8400 | NVIDIA RTX PRO 2000 Blackwell ノートパソコン用GPU、8GB GDDR7、47W | SKハイニックス PC811 2TB | Windows 11 Pro 25H2 (x64)、Dell Optimizer Ultra Performance |
| Dell Pro Precision 5 16S (PW516260) | Intel Core Ultra X9 388H、16コア/16スレッド(4P + 8E + 4LPE) | 64GB LPDDR5X-8533 LPCAMM2 | Intel Arc Pro B390(統合型、12個のXeコア) | SK hynix PCB01 1TB、Gen5 x4 | Windows 11 Pro 25H2 (x64)、Dell Optimizer Ultra Performance |
| HP OmniBook Ultra 16 (16-bk0xxx) | NVIDIA RTX Spark N1X、20コア/20スレッド(Arm) | 128GB LPDDR5X-9400 (64/64分割) | 6,144コアのBlackwell RTX(統合型、使用可能メモリ62.5GB) | サンディスク PC SN8050S 2TB、Gen5 x4 | Windows 11 Pro 26H1 (Arm64)、HPパフォーマンス |
表には 2 つのラベルが繰り返し表示されます。N/A は、SMT 非対応のチップでの Cinebench SMT シングルコア テストなど、テストがハードウェアに適用されないことを意味します。Not run は、ハードウェアが要件を満たしていない (モデル ロード、コーディング エージェント、およびより大きなサービング ティアとイメージ ティアには、少なくとも 16GB の GPU 使用可能なメモリが必要ですが、両方の RTX PRO 2000 マシンは 7.7GB です) か、2 台の RTX PRO 2000 システムでの NVENC エンコードの場合、ドライバが起動を拒否したため、テストが実行されなかったことを意味します。少数の fio セルは再実行後も 2 パーセントを超えるばらつきが残ったため、測定値として報告されています。
P1はCPU温度をテストスイートに公開しましたが、Dellは公開しませんでした。そのため、熱に関するセクションでは、P1とOmniBookの4つのシステムすべての平均クロック周波数を報告しています。P1のメイン実行はSmart App Controlをオンにした状態で完了し、GROMACSとLLMのサービステストは、Smart App Controlが2つのバイナリをブロックした後にオフにして再実行しました。比較対象のシステムはオフにして実行しました。
ローカルAIパフォーマンス
このセクションでは、RTX PRO 2000の8GBのGDDR7メモリが主な要因です。搭載可能な小型モデルでは、P1はグループ内で最速のシステムであり、Dellの47Wの同GPUやRTX Spark N1Xを上回ります。それより大きなモデルでは、128GBのN1Xノートブックや、統合GPUに64GBのシステムメモリの大部分を割り当てることができるDell Arc Pro B390は、P1では起動できないティアを実行します。7B以上のパラメータを持つローカルモデル向けのモバイルワークステーションを求める購入者は、このマシンとは異なる市場セグメントで買い物をしていることになります。
MLPerfクライアントv2.0
MLPerf Client は、Llama 3.1 8B と Phi-4-mini を 5 つのプロンプト カテゴリで実行し、最初のトークンまでの時間と、その後のトークン レートをカテゴリ全体の幾何平均として報告します。エンジンは、3 つの NVIDIA GPU 上の CUDA 上の llama.cpp と、Arc Pro B390 上の Intel のネイティブ OpenVINO パスであるため、Dell Pro Precision 5 16S の列は、異なるシリコン上の異なるランタイムであり、その構成で得られる結果であり、同等のエンジンの比較ではありません。エージェント シナリオでは、Llama 3.1 8B をデータ アナリスト エージェントおよびソフトウェア エンジニアリング エージェントとして実行し、複数のターンにわたってツールを呼び出します。


| MLPerfクライアントv2.0 | Lenovo ThinkPad P1 Gen 9 (386H、RTX PRO 2000) | Dell Pro Max 14 Premium (285H、RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H、Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| Llama 3.1 8B、最初のトークン取得までの時間、幾何平均(秒、値が小さいほど良い) | 0.345 | 0.441 | 0.214 | 0.274 |
| Llama 3.1 8B、トークンレート、幾何平均(トークン/秒) | 64.8 | 54.7 | 26.9 | 56.5 |
| Phi-4-mini、最初のトークンまでの時間、幾何平均(s、値が小さいほど良い) | 0.161 | 0.214 | 0.181 | 0.130 |
| Phi-4-mini、トークンレート、幾何平均(トークン/秒) | 111.9 | 88.0 | 41.4 | 96.8 |
| データアナリストエージェント、エンドツーエンド(s、数値が低いほど良い) | 49.7 | 61.0 | 84.7 | 53.0 |
| データアナリストエージェント、トークンレート(tok/秒) | 58.0 | 45.9 | 25.6 | 48.5 |
| SWEエージェント、エンドツーエンド(s、数値が小さいほど良い) | 43.4 | 52.7 | 65.6 | 45.3 |
| SWEエージェント、トークンレート(tok/秒) | 54.0 | 42.5 | 25.0 | 46.6 |
| エンジンおよび装置 | llama.cpp、CUDA、NVIDIA RTX PRO 2000 | llama.cpp、CUDA、NVIDIA RTX PRO 2000 | OpenVINO、Intel Arc Pro B390 GPU | llama.cpp、CUDA、NVIDIA RTX Spark N1X |
P1は、Llama 3.1 8Bを毎秒64.8トークン、Phi-4-miniを毎秒111.9トークン生成しました。これは、Dellの47W RTX PRO 2000での54.7と88.0と比較して、トークン生成率が19%と27%向上し、最初のトークン生成までの時間が22~25%短縮されました。
TGPの3Wはその一部であり、残りはシャーシです。Dellは、同じカードを冷却する14インチのマシンで、CPUクラスは同じですが、体積は小さく、スイートではどちらのGPUのクロックや温度も読み取れなかったため、ギャップのどれだけが熱によるものかはわかりません。OmniBookのN1Xは、トークンレートで2つのRTX PRO 2000システムの間に位置し、56.5と96.8で、NVIDIAグループの中で最初のトークンまでの時間が最速です。
Dell Pro Precision 5 16S に搭載されている Arc Pro B390 は、OpenVINO を介して毎秒 26.9 トークンと 41.4 トークンを生成し、P1 のレートの半分以下となりました。これは、両方の機種で動作する小型モデルに搭載されている統合型のみの構成のコストです。Llama での最初のトークン生成までの時間は 0.214 秒で、表の中で最速です。つまり、デコードが劣る場合でも、OpenVINO パスのプロンプト側は競争力があります。
エージェント実行ではトークンレートが追跡され、P1はデータアナリストエージェントを49.7秒、SWEエージェントを43.4秒で完了した。これはDell Pro Max 14の61.0秒と52.7秒、OmniBookの53.0秒と45.3秒と比較したもので、4つのデバイス間でツールフェーズの所要時間は約2秒以内の差に収まっている。
モデルの読み込みとコーディングエージェント
モデルロードとコーディングエージェントのテストは、gpt-oss:20b から始まります。これは 12.8GB のダウンロードで、コンテキストとともに約 16GB の GPU 使用可能メモリを必要とします。このスイートは、どのティアを実行するかを決定する前に、各システムの GPU 使用可能メモリを測定します。RTX PRO 2000 は 7.7GB を報告するため、P1 も Dell Pro Max 14 もどのティアにも該当せず、両方とも以下で「実行されませんでした」と表示されます。比較対象として実行された 2 つのシステムは、スケールを示すためにここにあります。Arc Pro B390 は Dell の 64GB のシステムメモリの大部分をアドレス指定でき、N1X は OmniBook の 128GB のうち 62.5GB をアドレス指定できます。
| モデルロードとコーディングエージェント | Lenovo ThinkPad P1 Gen 9 (386H、RTX PRO 2000) | Dell Pro Max 14 Premium (285H、RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H、Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| モデルを最初のトークンまでロードします(秒、数値が小さいほど良い) | ||||
| gpt-oss:20b、12.8GB、コールド | 実行しない | 実行しない | 5.98 | 6.23 |
| gpt-oss:20b、ウォーム | 実行しない | 実行しない | 4.14 | 3.59 |
| Qwen3.6-35B-A3B、21.1GB、コールドインストール | 実行しない | 実行しない | 9.41 | 9.04 |
| Qwen3.6-35B-A3B、暖かい | 実行しない | 実行しない | 6.60 | 4.23 |
| Qwen3.6-35B-A3B(モデル交換後) | 実行しない | 実行しない | 13.38 | 4.77 |
| クラッシュコーディングエージェント | ||||
| gpt-oss:20b、64Kコンテキスト、実時間(秒、数値が小さいほど良い) | 実行しない | 実行しない | 584.2 | 115.3 |
| gpt-oss:20b、64Kコンテキスト、生成レート(tok/秒) | 実行しない | 実行しない | 17.9 | 58.0 |
| Qwen3.6-35B-A3B、64Kコンテキスト、実行時間(秒、数値が小さいほど良い) | 実行しない | 実行しない | 351.7 | 72.0 |
| Qwen3.6-35B-A3B、64Kコンテキスト、生成レート(tok/秒) | 実行しない | 実行しない | 38.9 | 89.5 |
| スピードメーター横のエージェント、エージェント生成レート(tok/秒) | 実行しない | 実行しない | 17.9 | 55.8 |
| スピードメーター横のエージェント、スピードメーターの減速(x) | 実行しない | 実行しない | 1.60 | 1.73 |
OmniBook は gpt-oss:20b コーディング タスクを 115.3 秒で 58.0 トークン/秒で実行し、Dell Pro Precision 5 16S は 584.2 秒で 17.9 トークン/秒でした。これは、購入者が大規模な統合プールではなく 8GB のディスクリート GPU を選択することで放棄する範囲です。P1 のこのワークロードに対する答えはクラウド、またはより小さなモデルです。以下の 3B サービング ティアは、当社のスイートがこれに収まる最大のものであり、MLPerf の 8B モデルが Q4_0 で実行されるのは、MLPerf がコンテキストをカードに合わせてサイズ調整するためです。
検索拡張生成
RAGテストでは、Ollamaを介してnomic-embed-textを使用して20,963個のSQuADパッセージを埋め込み、2,000の質問に対して上位5つを取得し、4,096トークンのコンテキストでPhi-4-miniを使用して回答します。そして、取り込みスループット、取得レイテンシとリコール、回答の品質と速度を報告します。3.8Bの回答モデルはここにあるすべてのGPUに収まるため、これはグループ全体でエンドツーエンドで実行される唯一のローカルAIテストです。

| RAG(オラマ 0.40.3) | Lenovo ThinkPad P1 Gen 9 (386H、RTX PRO 2000) | Dell Pro Max 14 Premium (285H、RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H、Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| 摂取する | ||||
| 1秒あたりの通過回数 | 165.1 | 151.6 | 80.2 | 119.5 |
| 埋め込み率(tok/秒) | 26,740 | 24,554 | 12,992 | 19,352 |
| 摂取時間(秒、短いほど良い) | 138.8 | 152.2 | 271.7 | 187.0 |
| 検索します | ||||
| 5%リコール率(%) | 82.8 | 82.8 | 82.7 | 82.8 |
| クエリ実行時間 p50 (ミリ秒、数値が低いほど良い) | 19.33 | 22.13 | 22.20 | 23.33 |
| クエリ実行時間 p95 (ミリ秒、数値が低いほど良い) | 22.10 | 25.59 | 23.91 | 26.12 |
| 回答(Phi-4-mini、ctx 4096) | ||||
| 完全一致率(%) | 63.25 | 63.25 | 63.00 | 62.75 |
| F1 (%) | 74.4 | 74.4 | 74.2 | 74.0 |
| 最初のトークンp50に到達するまでの時間(秒、数値が小さいほど良い) | 0.214 | 0.261 | 0.855 | 0.155 |
| 迅速処理(tok/秒) | 4,953 | 4,011 | 2,151 | 7,142 |
| 生成速度(tok/秒) | 103.5 | 92.6 | 48.3 | 104.4 |
| p50に答える質問(数値が低いほど良い) | 0.287 | 0.342 | 0.997 | 0.227 |
P1は1秒あたり165.1パッセージを埋め込み、138.8秒で取り込みを完了しました。これはグループ内で最速で、Dell Pro Max 14の151.6秒、OmniBookの119.5秒を上回りました。Arc Pro B390は271.7秒かかりました。回答品質は4機種すべてで同一で、完全一致率は63.25%、F1スコアは74.4で、数十分の1秒以内の差です。これはモデルと取得パッセージが同じであるためで、異なるのは速度です。
P1は、プロンプト処理が毎秒4,953トークン、生成が毎秒103.5トークンで、平均0.287秒で質問に回答しました。一方、Dell Pro Max 14は0.342秒、OmniBookは0.227秒で、プロンプト処理が毎秒7,142トークンで、グループ内で最速の回答を実現しています。
LLM サービング
このサービステストでは、4,096トークンのプロンプトと1,024トークンの出力でllama-serverを実行し、同時実行数を1つのリクエストからGPUが処理できる最大数まで変化させ、出力スループット、ユーザーごとのスループット、最初のトークンまでの時間、および出力トークンあたりの時間を報告します。
OmniBookとPro Precision 5 16Sのテスト後、 Dell Pro Precision 9 T2のレビューで初めて登場したため、このグループではRTX PRO 2000システム2台のみが動作し、8GBでは、2.13GBのKVキャッシュと4つのスロットを備えたMinistral 3 3B Reasoning at Q8_0という最小モデルのみがテスト対象となりました。8B、27B、120Bの各ティアは、どちらのシステムでも「動作せず」と表示されます。

| llama-server、Ministral 3 3B Reasoning Q8_0、入力4,096 / 出力1,024 | Lenovo ThinkPad P1 Gen 9 (386H、RTX PRO 2000) | Dell Pro Max 14 Premium (285H、RTX PRO 2000) |
|---|---|---|
| 同時リクエスト数:1 | ||
| 出力スループット(tok/秒) | 67.0 | 55.5 |
| 最初のトークン取得までの時間、中央値(ミリ秒、数値が小さいほど良い) | 890 | 1,089 |
| 出力トークンあたりの処理時間、中央値(ミリ秒、数値が低いほど良い) | 14.0 | 17.0 |
| 同時リクエスト数:2 | ||
| 出力スループット(tok/秒) | 68.3 | 65.4 |
| ユーザーあたりのスループット(tok/秒) | 34.1 | 32.7 |
| 最初のトークン取得までの時間、中央値(ミリ秒、数値が小さいほど良い) | 1,417 | 1,738 |
| 同時リクエスト数:4 | ||
| 出力スループット(tok/秒) | 168.3 | 141.0 |
| ユーザーあたりのスループット(tok/秒) | 42.1 | 35.2 |
| 最初のトークン取得までの時間、中央値(ミリ秒、数値が小さいほど良い) | 1,737 | 2,100 |
| 最初のトークン取得までの時間、p99(ミリ秒、数値が低いほど良い) | 3,773 | 4,530 |
1回のリクエストでは、P1は毎秒67.0トークンを生成し、最初のトークン生成までの時間は890msでした。4回の同時リクエストでは、毎秒168.3トークン(ユーザーあたり42.1トークン)の出力に達し、最初のトークン生成までの時間の中央値は1,737msでした。
Dell Pro Max 14はあらゆる段階で劣勢でした。4つのリクエストで毎秒141.0トークン、最初のトークンまで21~23%長くかかり、MLPerfの数値と同じ47W対50Wの差がありました。1つのリクエストから4つにスケーリングすると、P1の出力スループットは2.5倍に向上したため、このカードは小型モデルで数人のユーザーに対応する余裕がありますが、次の上位モデルに対応する余裕はありません。
CPUパフォーマンス
Core Ultra 9 386H は、4 つの Cougar Cove P コア、8 つの Darkmont E コア、および 4 つの低電力 E コアを備えた 16 コアのプロセッサで、ハイパースレッディングはなく、18MB のラスト レベル キャッシュを備えています。 Dell Pro Max 14 の 285H は、16 コアを 6 つの P コア、8 つの E コア、および最大 5.4GHz で動作する 2 つの低電力コアとして使用していますが、Core Ultra 9 386H は、2 つの P コアと 500MHz のピーク クロックを犠牲にして、より新しいマイクロ アーキテクチャとより高速なメモリ パスを採用しています。 Dell Pro Precision 5 16S の X9 388H と比較すると、コア レイアウトは同じですが、P コアの動作速度が 200MHz 遅くなっています。一方、OmniBook の N1X は、すべての全コア テストで 20 個の Arm コアを提供します。
Cinebench 2026と持続負荷
Cinebench 2026は、CPU上でMaxonのRedshiftエンジンを使用してシーンをレンダリングし、シングルコアとマルチコアのスループットを測定します。なお、SMTシングルコアテストは、ここで紹介するどのチップにも適用されません。その後、マルチコア実行を約30分間繰り返す持続ループを実行し、定常状態を最初の実行結果と比較します。

| Cinebench 2026(ポイント、数値が高いほど性能が良い) | Lenovo ThinkPad P1 Gen 9 (386H、RTX PRO 2000) | Dell Pro Max 14 Premium (285H、RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H、Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| シングルコア | 519.9 | 486.0 | 534.8 | 558.6 |
| SMTシングルコア | 該当なし(SMTなし) | 該当なし(SMTなし) | 該当なし(SMTなし) | 該当なし(SMTなし) |
| マルチコア | 5,083 | 4,292 | 4,739 | 7,004 |
| 持続ループ、1回目の通過 | 4,894 | 4,315 | 4,765 | 6,954 |
| 持続ループ、定常状態 | 4,811 | 4,257 | 4,468 | 6,942 |
| 定常状態/初回通過 | 0.983 | 0.987 | 0.938 | 0.998 |
| 持続ループ、定常状態のCPUクロック(MHz) | 3,505 | 3,396 | 3,294 | 3,231 |
P1はマルチコアで5,083点を記録し、同じコア構成を採用しているDell Pro Precision 5 16Sの285Hの4,292点を18%、X9 388Hの4,739点を7%上回りました。OmniBookの20コアN1Xが7,004点でこのグループをリードしています。1コアでは、クロック速度で順位が逆転し、388Hの534.8とN1Xの558.6がP1の519.9を上回り、285Hは486.0で最下位となりました。
30分以上にわたって、P1は平均クロック3,505MHz、CPU上限94.1℃で、最初のパスの0.983にあたる4,811を維持しました。この定常状態の数値は、Pro Precision 5 16Sの最新のマルチコアスコアを2%上回っています。Dell Pro Precision 5 16Sは熱の影響を最も受け、最初のパスの0.938に落ち着き、Dell Pro Max 14は0.987を維持しました。2台のPanther Lakeマシンの差はシャーシにあります。P1の16インチアルミニウムボディに搭載されている同じシリコンは、5 16Sよりも8%多く耐えることができます。
7-Zip
7-Zipに内蔵されているベンチマーク機能は、LZMA圧縮および解凍のスループットをギガ命令/秒単位で報告します。この数値は、各スレッドで1回、単一コアに固定して1回測定されます。LZMAは整数スループット、分岐予測、キャッシュおよびメモリのレイテンシに依存するため、ベクトル幅よりもコア数と高速なメモリパスが有利に働きます。

| 7-Zip(GIPS値、数値が高いほど良い) | Lenovo ThinkPad P1 Gen 9 (386H、RTX PRO 2000) | Dell Pro Max 14 Premium (285H、RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H、Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| すべてのスレッド | ||||
| トータル | 109.2 | 93.4 | 108.4 | 151.2 |
| 圧縮する | 116.6 | 97.0 | 116.1 | 157.9 |
| 圧縮解除する | 101.7 | 89.4 | 101.0 | 144.5 |
| 1本の糸 | ||||
| トータル | 9.49 | 9.13 | 9.80 | 9.09 |
| 圧縮する | 8.55 | 7.28 | 8.71 | 7.31 |
| 圧縮解除する | 10.43 | 10.98 | 10.88 | 10.87 |
16スレッドでは、P1は285Hの93.4 GIPSに対し109.2 GIPSを記録し、17%のリードを獲得。圧縮性能では20%上回り、X9 388Hの108.4と1ポイント以内の差で一致した。20スレッドのN1Xは151.2でトップ。1スレッドでは、4つのシステムは8%以内の差に収まり、P1のシングルスレッド圧縮性能8.55 GIPSは285Hの7.28 GIPSを上回り、Panther Lakeが示すコアあたりの性能向上は、このスイートの中で最も明確である。
Blender、HandBrake、およびLLVM
Blender 4.5 は、CPU 上で Cycles を使用して Monster、Junkshop、および Classroom シーンをレンダリングします。HandBrake は、4K60 クリップの 60 秒を、x265 (HEVC、中程度のプリセット、品質 22) と SVT-AV1 (プリセット 8、品質 30) を使用してソフトウェアでエンコードします。LLVM テストは、Clang と Ninja を使用して LLVM 21.1.4 ツリー全体をコンパイルします。これは、スイートの中で最も長い全コアワークロードです。


| ホイール試乗 | Lenovo ThinkPad P1 Gen 9 (386H、RTX PRO 2000) | Dell Pro Max 14 Premium (285H、RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H、Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| Blender 4.5 モンスター(サンプル数/分、数値が高いほど良い) | 135.4 | 112.7 | 129.6 | 210.5 |
| Blender 4.5 Junkshop (サンプル/分) | 92.8 | 75.4 | 89.8 | 128.0 |
| Blender 4.5 Classroom(サンプル/分) | 66.8 | 56.6 | 63.2 | 92.8 |
| HandBrake x265、中設定、q22(フレームレート、数値が高いほど良い) | 30.3 | 28.9 | 29.5 | 41.2 |
| HandBrake SVT-AV1、プリセット8、q30(fps) | 84.5 | 79.8 | 80.8 | 15.4 |
| LLVM 21.1.4 ビルド (s、数値が低いほど良い) | 309.1 | 393.9 | 340.1 | 206.6 |
P1はMonsterを1分あたり135.4サンプルでレンダリングし、285Hの112.7サンプル/分、388Hの129.6サンプル/分を上回り、JunkshopとClassroomの両方でそれぞれ20%と4%のリードを維持しました。また、LLVMのビルド時間は309.1秒で、393.9秒と340.1秒を上回り、前世代より22%短縮されました。N1Xはさらに高速で、4つのコアを追加し、レンダリングとコンパイルは1分あたり210.5サンプル/分、206.6秒となっています。
HandBrake では、x86 マシンは一致し、Arm マシンは分かれます。x265 は P1 で 30.3 fps、Dell Pro Max 14 で 28.9 fps、Pro Precision 5 16S で 29.5 fps で動作し、SVT-AV1 は 84.5、79.8、80.8 を記録し、P1 は各エンコーダーで 285H より 5 ~ 6 パーセント優位でした。OmniBook の x265 の結果は 41.2 fps でグループ内で最高でしたが、SVT-AV1 の結果は 15.4 で大きく最悪でした。このレビューでは、原因はシリコンではなく SVT-AV1 の Arm64 コード パスにあるとされています。
Stockfish、Primesieve、Python、そしてブラウザ
Stockfish 19 は、内蔵のベンチマークを 1 つのスレッドとすべてのスレッドで実行します。primesieve は、すべてのスレッドで 10^12 までの素数をカウントし、1 つのスレッドで 10^11 までの素数をカウントします。PyPerformance は、go、nbody、regex_compile のベンチマークを最速のコアで実行し、Speedometer 3.1 は、ディスクリート GPU が搭載されている場合は、ブラウザをその GPU に固定した Microsoft Edge で実行されます。
| ホイール試乗 | Lenovo ThinkPad P1 Gen 9 (386H、RTX PRO 2000) | Dell Pro Max 14 Premium (285H、RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H、Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| Stockfish、スレッド1つ(Mnps、数値が高いほど良い) | 1.76 | 1.68 | 1.86 | 1.73 |
| Stockfish、全スレッド(Mnps) | 15.30 | 12.53 | 14.81 | 16.28 |
| 素篩を10^12まで、すべてのスレッド(s、数値が小さいほど良い) | 11.10 | 14.20 | 11.31 | 9.57 |
| 素篩を10^11まで、1スレッド(s、数値が小さいほど良い) | 10.15 | 9.88 | 9.56 | 12.03 |
| PyPerformance 実行時間 (ミリ秒、数値が低いほど良い) | 75.5 | 74.2 | 69.2 | 111.2 |
| PyPerformance nbody (ミリ秒、数値が低いほど良い) | 58.7 | 61.6 | 53.1 | 80.4 |
| PyPerformance regex_compile (ミリ秒、数値が小さいほど良い) | 71.0 | 69.8 | 65.1 | 84.6 |
| スピードメーター 3.1(スコア、数値が高いほど良い) | 40.6 | 41.5 | 42.7 | 36.7 |
Stockfishは、P1では全スレッドで毎秒15.30万ノードに達し、285Hの12.53万ノード、388Hの14.81万ノードと比較して向上しました。また、primesieveは全スレッドでのカウントを11.10秒で完了し、Dell Pro Max 14の14.20秒から22%短縮されました。
シングルスレッドの行は前世代とほぼ同等です。P1のPython実行時間は75.5ms、58.7ms、71.0msで、285Hの前後2~5%以内の差です。一方、388Hの200MHzのクロック周波数向上は、同じ3つのテストで8~10%低い実行時間として現れています。スピードメーターのスコアは、P1で40.6、Dell Pro Max 14で41.5、Pro Precision 5 16Sで42.7を記録し、N1XはEdgeのArm64ビルドで36.7と後塵を拝しています。
GROMACS、OpenBLAS、およびメモリ
GROMACS 2025.3 は、16 コアで benchMEM 分子動力学システムを実行し、1 日あたりのシミュレーションのナノ秒数で、4 つのランクとスレッドのレイアウトのベスト値を報告します。OpenBLAS 0.3.34 は、N=20,000 と N=40,000 で密な LU システムを解き、すべての物理コアで 8,000 平方の DGEMM を実行し、さらに最上位のコア クラスのみで再度実行します。STREAM は、物理コアごとに 1 つのスレッドを使用してメモリ帯域幅を測定し、メモリ遅延テストでは 4KiB ページを持つ 1GiB バッファを読み取り、コア間テストでは、すべてのコア ペア間でキャッシュ ラインのハンドオフ遅延を測定します。
OpenBLASのN=10,000のサイズを表から削除しました。再実行後も、4つのシステムのうち2つでそのスプレッドがスイートの制限を超えていたためです。


| ホイール試乗 | Lenovo ThinkPad P1 Gen 9 (386H、RTX PRO 2000) | Dell Pro Max 14 Premium (285H、RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H、Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| GROMACS benchMEM、最適なレイアウト(ns/日、数値が大きいほど良い) | 24.07 | 22.93 | 24.87 | 17.47 |
| OpenBLASによるLU分解、N=20000、全コア使用(GFLOPS値が高いほど性能が良い) | 474 | 321 | 504 | 330 |
| OpenBLAS LU ソルブ、N=40000、すべてのコア (GFLOPS) | 492 | 397 | 460 | 349 |
| OpenBLAS DGEMM、M=8000、全コア(GFLOPS) | 519 | 391 | 527 | 398 |
| OpenBLAS DGEMM、M=8000、トップコアクラス(GFLOPS) | 250 | 266 | 262 | 489 |
| ストリームコピー(MB/秒、数値が高いほど良い) | 72,548 | 59,090 | 73,595 | 130,790 |
| ストリームトライアド(MB/秒) | 81,712 | 62,255 | 82,706 | 122,260 |
| メモリレイテンシ、1GiB、4KiBページ(ナノ秒、数値が小さいほど良い) | 116.1 | 173.1 | 115.5 | 143.1 |
| コア間レイテンシ、平均値(ns、数値が低いほど良好) | 92.0 | 59.2 | 88.2 | 156.8 |
| コア間レイテンシ、最小値/最大値(ナノ秒) | 27.6 / 135.5 | 19.0 / 163.9 | 24.2 / 129.4 | 54.1 / 273.6 |
P1はGROMACSを24.07 ns/日で実行し、285Hの22.93 ns/日を上回りました。また、OpenBLAS DGEMMは519 GFLOPSに達し、391 GFLOPSから33%向上し、LUソルブは24~48%向上しました。2つのPanther Lakeチップは、OpenBLASのすべての行で数パーセント以内の差に収まり、N1Xは全コアDGEMMで398 GFLOPSとなり、285Hと同等ですが、最上位コアクラスのみではリードしています。これは、コアあたりのベクトルユニットが狭いが数が多いチップのパターンです。
メモリの結果は、マルチコアセクションの大部分を説明しています。STREAM Triadは、LPDDR5X-8533でP1で81,712MB/s、Pro Precision 5 16Sで82,706MB/sを読み取り、285HのLPDDR5X-8400で62,255MB/sを読み取りました。これは、ほぼ同じ転送速度で新しいメモリコントローラにより31%向上しています。N1XのLPDDR5X-9400からの122,260MB/sは、異なるクラスのメモリシステムです。メモリレイテンシは、285Hの173.1 nsからP1の116.1 nsに低下し、コア間レイテンシは平均で59.2 nsから92.0 nsに上昇しました。これは、Panther Lakeのタイルレイアウトの代償であり、実行したどのテストにも現れませんでした。
ゲームおよびGPUエンコーディング
SuperTuxKart 1.5は、このテストスイートに含まれるクロスプラットフォームのOpenGLゲームテストで、1080pの最高プリセットで垂直同期をオフにして実行され、平均、標準、および安定したフレームレートとして報告されます。
FFmpeg NVENC テストでは、GPU の固定機能エンコーダで 4K60 クリップを 8Mbps の HEVC にエンコードします。Arc Pro B390 では Quick Sync が代用されます。RTX PRO 2000 システムの両方で、NVIDIA が RTX PRO カード用に出荷しているワークステーション ドライバ ブランチでは NVENC パスが起動しませんでした。このブランチは、他のノートブックが使用する GeForce ブランチよりも遅れています。これらのセルには、ドライバが追いつくまで実行しないというマークが付いています。Media Foundation パスはアダプタ自体を選択しますが、ハイブリッド グラフィックス マシンでは設計上除外されています。

| ホイール試乗 | Lenovo ThinkPad P1 Gen 9 (386H、RTX PRO 2000) | Dell Pro Max 14 Premium (285H、RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H、Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| SuperTuxKart 1080p Ultra、平均FPS(高いほど良い) | 179.2 | 150.9 | 166.8 | 225.9 |
| SuperTuxKart 1080p Ultra、典型的な FPS | 178 | 150 | 165 | 227 |
| SuperTuxKart 1080p 超安定した FPS | 67 | 46 | 98 | 143 |
| FFmpeg NVENC HEVC、4K60fps、8Mbps(フレームレートが高いほど良い) | 実行しない(ドライバー) | 実行しない(ドライバー) | 128 (QSV) | 138 (NVENC) |
P1は平均179.2fpsを記録し、Dell Pro Max 14の150.9fpsを上回り、同じGPUで19%のリードを獲得しました。これはAIの結果と一致しています。また、Arc Pro B390では166.8fpsを記録し、AIの数値が示唆するよりもディスクリートカードに近い結果となりました。N1Xは225.9fpsでトップでした。
RTX PRO 2000 はゲーミング カードではなく、SuperTuxKart は負荷の高いゲームではないため、この行は GPU の健全性チェックであり、結論ではありません。欠落している NVENC の結果は、ラボで埋めることができなかった P1 の GPU ストーリーの唯一のギャップであり、ハードウェアの問題ではなくドライバの問題です。Dell Pro Precision 5 16S は Quick Sync で 128 fps の HEVC をエンコードし、OmniBook は NVENC で 138 fps でした。
負荷時の熱とクロック
このテストスイートは、各テスト中にCPUの温度とクロック周波数をサンプリングします。P1は両方を報告しましたが、2台のDell製システムはクロック周波数は報告したものの温度は報告せず、グループ内のどのシステムもGPUの温度や電力を報告しなかったため、以下の表にはP1とOmniBookのCPUの最高温度と、4つのシステムすべてのテストごとの平均クロック周波数が記載されています。P1はテスト実行前に44℃でアイドル状態でした。

| テスト中のCPU最高温度/平均CPUクロック周波数(MHz) | Lenovo ThinkPad P1 Gen 9 (386H、RTX PRO 2000) | Dell Pro Max 14 Premium (285H、RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H、Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| Cinebench 2026 | 94C/3,853 | 3,818 | 3,792 | 98C/2,962 |
| 持続ループ | 94C/3,503 | 3,409 | 3,397 | 98C/3,239 |
| 7-Zip | 94C/3,854 | 3,768 | 3,936 | 98C/2,838 |
| 干し魚 | 95C/3,712 | 3,142 | 3,345 | 98C/3,269 |
| ブレンダー | 94C/3,779 | 3,506 | 3,665 | 98C/3,123 |
| ハンドブレーキ | 94C/3,764 | 3,469 | 3,718 | 98C/2,756 |
| LLVMビルド | 94C/3,754 | 3,477 | 3,631 | 98C/3,151 |
| GROMACS | 94C/3,601 | 3,483 | 3,525 | 98C/3,308 |
| OpenBLAS | 95C/3,696 | 3,471 | 3,701 | 98C/3,024 |
| STREAM | 76C/3,844 | 4,347 | 4,014 | 98C/3,258 |
| プライムシーブ | 95C/3,792 | 3,716 | 3,894 | 98C/2,930 |
| MLPerfクライアント | 89C/3,544 | 3,980 | 2,632 | 93C/2,114 |
| RAG | 91C/3,661 | 3,684 | 3,838 | 94C/2,749 |
| LLM(法学修士)として勤務 | 82C/3,810 | 4,156 | 実行しない | 実行しない |
| スーパータックスカート | 86C/3,612 | 3,912 | 3,653 | 95C/1,957 |
| fioストレージ | 84C/3,680 | 3,437 | 3,366 | 94C/2,359 |
すべての全コアCPUテストでP1のプロセッサは94℃または95℃に達しました。これはIntelがPanther Lakeを動作させている温度であり、その上限でチップが保持したクロック周波数が重要な数値です。Cinebenchでは3,853MHz、Blenderでは3,779MHz、LLVMビルドでは3,754MHz、30分間のループでは3,503MHzでした。これに対し、Dell Pro Max 14の285Hでは3,818MHz、3,506MHz、3,477MHz、3,409MHz、Pro Precision 5 16Sの388Hでは3,792MHz、3,665MHz、3,631MHz、3,397MHzでした。
P1は、レンダリング、ビルド、30分間のループにおいて、3つのx86システムの中で最も高いクロック周波数を記録し、7-Zip、primesieve、OpenBLASでは388Hの3%以内の差に収まっており、シャーシがその役割を果たしていることを示しています。メモリ、サービング、ストレージのテストでは、全コアCPUテストの94~95℃に対し、76~84℃で動作しました。
貯蔵性能
P1には、Surface Laptop Ultraにも搭載されているOEM Gen5 x4ドライブである2TBのSK hynix PCB01がGen5スロットに搭載されています。Dell Pro Precision 5 16Sには同じドライブの1TBバージョン、Dell Pro Max 14には2TBのSK hynix PC811、OmniBookには2TBのSandisk SN8050Sが搭載されています。
このスイートは、ファイルシステムを介してブートドライブに対して4つのコーナーで実行され、読み取りの場合は、5GiBと25GiBのフットプリントで生のデバイスに対して実行されます。25GiBの結果は以下のとおりです。シーケンシャルテストでは、1つのジョブでキュー深度32で128K転送を使用し、ランダムテストでは、4、8、16のジョブでキュー深度32で4K転送を使用し、ピーク値を報告します。


| fio、25GiBのフットプリント | Lenovo ThinkPad P1 Gen 9 (386H、RTX PRO 2000) | Dell Pro Max 14 Premium (285H、RTX PRO 2000) | Dell Pro Precision 5 16S (X9 388H、Arc Pro B390) | HP OmniBook Ultra 16 (RTX Spark N1X) |
|---|---|---|---|---|
| シーケンシャル128K、QD32、1ジョブ | ||||
| 読み込み速度、ファイルシステム(MB/秒、数値が高いほど良い) | 10,012 | 7,014 | 9,216 | 13,833 |
| 読み取り、生デバイス(MB/秒) | 9,830 | 7,127 | 9,009 | 12,480 |
| 書き込み、ファイルシステム(MB/秒) | 9,203 | 6,709 | 9,009 | 11,720 |
| 読み取りレイテンシ、平均値(米国、数値が低いほど良い) | 403.9 | 590.7 | 448.6 | 297.1 |
| 書き込み遅延、平均値(米国、数値が低いほど良い) | 255.5 | 605.9 | 278.6 | 327.0 |
| ランダム4K、QD32、ピークジョブ | ||||
| 読み取り、ファイルシステム(IOPS、数値が高いほど良い) | 756,484 | 762,412 | 780,147 | 437,833 |
| 読み取り、生デバイス(IOPS) | 1,413,311 | 1,472,760 | 1,224,270 | 1,888,501 |
| 書き込み、ファイルシステム(IOPS) | 682,019 | 668,194 | 679,108 | 228,354 |
| ランダム4K読み取り、ファイルシステム別、ジョブ数別 | ||||
| 4件の求人(IOPS) | 501,165 | 395,583 | 525,514 | 437,833 |
| 4ジョブ、p99レイテンシ(us) | 281 | 379 | 253 | 643 |
| 8件の求人(IOPS) | 672,837 | 665,195 | 736,789 | 426,433 |
| 8ジョブ、p99レイテンシ(us) | 578 | 733 | 436 | 815 |
| 16件の求人(IOPS) | 756,484 | 762,412 | 780,147 | 377,545 |
| 16ジョブ、p99レイテンシ(us) | 963 | 864 | 995 | 1,122 |
| ランダム4K書き込み、ファイルシステム別、ジョブ数別 | ||||
| 4件の求人(IOPS) | 444,243 | 466,372 | 442,234 | 228,354 |
| 4ジョブ、p99レイテンシ(us) | 362 | 342 | 358 | 586 |
| 16件の求人(IOPS) | 682,019 | 668,194 | 679,108 | 221,647 |
| 16ジョブ、p99レイテンシ(us) | 963 | 1,876 | 1,012 | 2,638 |
PCB01は、ファイルシステムを介して10,012MB/sのシーケンシャル読み取りと、生デバイスから9,830MB/sの読み取りを行い、9,203MB/sの書き込みを行い、ファイルシステムを介して4Kランダム読み取りで756.5K IOPS、生デバイスで1.41M IOPSのピーク性能を示し、ランダム書き込みでは682.0K IOPSを記録しました。
これらの数値は、Pro Precision 5 16S の同じドライブの数パーセント以内の差に収まり、シーケンシャル処理では Dell Pro Max 14 の PC811 を大きく上回り、読み取り速度は 7,014MB/s、書き込み速度は 6,709MB/s です。また、Dell の 1TB ドライブは、最大ジョブ数でのランダム読み取りで数パーセント上回っています。OmniBook の SN8050S は、シーケンシャル読み取りで 13,833MB/s、生のランダム読み取りでトップですが、ランダム書き込みでは 228.4K IOPS と大きく劣り、16 ジョブでの読み取りと書き込みの両方で 99.99 パーセンタイルのレイテンシが 3 秒を超えており、このレビューでは Windows on Arm ストレージ パスが原因であるとされています。
P1のドライブがGen5の称号にふさわしいのは、レイテンシの面です。4ジョブの場合、ランダム読み取りの99パーセンタイルは281マイクロ秒で、PC811の379マイクロ秒と比べて優れています。16ジョブの場合、99パーセンタイルではPC811が864マイクロ秒でP1の963マイクロ秒を上回りますが、P1の99.99パーセンタイルは12,648マイクロ秒で、Dell Pro Max 14の83,362マイクロ秒のほんの一部に過ぎません。
ランダム書き込みでも16ジョブで同様の結果が得られました。P1のp99では963マイクロ秒に対し、P1では1,876マイクロ秒、99.99パーセンタイルでは4,882マイクロ秒に対し、P1では102,236マイクロ秒でした。モデルキャッシュ、レンダリング用のスクラッチボリューム、または大規模なプロジェクトツリーをホストするワークステーションでは、ピークよりもテール部分でその差がより顕著に現れます。
結論
ThinkPad P1 Gen 9 は、Panther Lake を搭載した P1 Gen 8 です。Panther Lake は、すべての全コア テストで Dell Pro Max 14 の 285H を上回り、HandBrake エンコードと GROMACS では約 5%、その他のすべてのテストでは 13 ~ 48% 上回ります。メモリ システムは 31% 広く、レイテンシは 33% 低く、シャーシは Dell Pro Precision 5 16S で同じ Panther Lake シリコンが実現するよりも高いクロックでチップを保持するため、P1 は他の 16 インチ Panther Lake ワークステーションよりも 30 分以上 8% 長く動作します。
シングルスレッド性能は変化しておらず、レンダリングやビルドよりもブラウザやオフィスの応答性を重視する購入者にとっては、前世代モデル、あるいは統合グラフィックスのみの構成のX9 388Hの方が、同等の速度で、しかも若干安価であることがわかるだろう。

50W の RTX PRO 2000 は、これまでレビューした RTX PRO 2000 の中で最速であり、同じカードの 47W 版を MLPerf トークンレートで 19 ~ 27%、サービング スループットで 19% 上回っています。また、P ラインが設計されている ISV 認証を取得しています。8GB の GDDR7 により、ローカル AI は数十億パラメータのモデルに制限されます。モデル ロード、コーディング エージェント、およびより大きなサービング ティアは実行されませんでしたが、128GB の RTX Spark ノートブックと 64GB の Arc Pro B390 はすべてのモデル ロードとコーディング エージェント ティアを実行しました。
LenovoがdGPUを386Hと組み合わせるという決定を下したことで、P1の購入者はArc Pro B390と5.1GHzのX9 388Hも諦めなければならなくなった。これは認定グラフィックスにとっては妥当なトレードオフだが、ローカル推論を主な業務とする開発者にとっては不利なトレードオフとなる。
今回使用した構成のOLEDバージョンの定価は7,719ドル、10月22日にLenovoが実施したセール価格は5,399ドルで、P1 Gen 9はフラッグシップモデルにふさわしい価格設定となっています。LenovoはPシリーズを頻繁に値引きするため、セール価格を基準価格としていますが、同じプロセッサとGPUを搭載したP16s Gen 5との価格差は、90Whバッテリー、Thunderbolt 5、2つ目のM.2スロット、アルミニウム製シャーシ、そして800nitの4KおよびTandem OLEDパネルオプションによるものです。
どちらの価格設定も、P1 Gen 8 が出荷された時点では存在しなかった分野に位置づけられる。なぜなら、RTX Spark N1X プラットフォームが今月出荷開始されたからだ。このグループで P1 に最も近いHP OmniBook Ultra 16は、64GB で 4,999.99 ドル、128GB で 6,229.99 ドルとなっている。Surface Laptop Ultraシリーズの最高価格は 5,899.99 ドルで、HP のZBook Ultra G3a 16は、同じセグメントに最大 192GB の Ryzen AI Max 統合メモリをもたらし、米国での注文は 3,149 ドルから開始されている。
Lenovoは、コンシューマー向け製品にもRTX Sparkを搭載しています。レビューしたYoga 9n 2-in-1 16は、 20コアのN1Xと64GBのメモリを搭載し、価格は3,749.99ドルです。Lenovo Pro 9n 15は、18コアのN1Xと32GBのメモリを搭載しています。どちらも認定ワークステーションではないため、ここではOmniBookが比較対象となりますが、P1に欠けているGPUアドレス指定可能なメモリは、すでにLenovoのカタログに掲載されています。128GBのOmniBookとSurfaceは、P1では起動できないモデルロードとコーディングエージェントの階層を実行でき、価格も近いため、購入者は選択肢を真剣に検討することになります。
この変更によって影響を受けるのは、ワークロードによって5,000ドル台半ばのノートPCに128GBのGPUアドレス指定可能なメモリが搭載されるようになったユーザーです。そのようなユーザーにとって、この価格帯で8GBの専用カードは不適切な購入であり、P1の役割は、より大型のマシンの前に設置される高速で持ち運び可能なクライアントです。Lenovoの回答は、Arc Pro B390を搭載したX9 388H構成で、このレビューでDell Pro Precision 5 16Sの代わりとなる構成であり、すべてのモデル負荷とコーディングエージェントの階層で動作しました。
1.8kg以下の認証済みモバイルワークステーションを必要とし、ローカルAIを8B以下の便利な機能として捉えるエンジニアやカラーリストにとって、P1は依然として購入すべきThinkPadであり、統合メモリ搭載機種の中で、Thunderbolt 5ポート、LPCAMM2およびデュアルM.2の保守性、ISVリストの点でP1に匹敵するものはありません。
リーダーボード: Lenovo ThinkPad P1 Gen 9は、当社の「ベストモバイルワークステーション」リーダーボードにおいて「ベストプレミアム薄型軽量」の座を獲得しており、ローカルAIの性能結果は「ローカルAI向けベストノートパソコン」ランキングの「テスト済み」にも掲載されています。



 Amazon