

NVIDIA와 Cisco는 오늘 AI 패브릭에서 레인당 400Gb/s 이더넷을 지원하는 광 모듈 포맷인 USFP(Ultra-Dense Small Form Factor Pluggable) 개발 계획을 발표했습니다. 초기 트랜시버는 OSFP 모듈과 비슷한 크기에 16개의 전이중 레인을 탑재하여 모듈당 6.4Tb/s의 대역폭을 제공하며, 향후 32개 레인과 12.8Tb/s까지 확장될 예정입니다. NVIDIA와 Cisco는 USFP가 200Gb/s 레인당 플러그형 모듈 대비 4배 높은 대역폭과 높은 전면 패널 밀도를 제공하면서 전력 효율은 약 1.3배 낮춘다고 밝혔습니다.
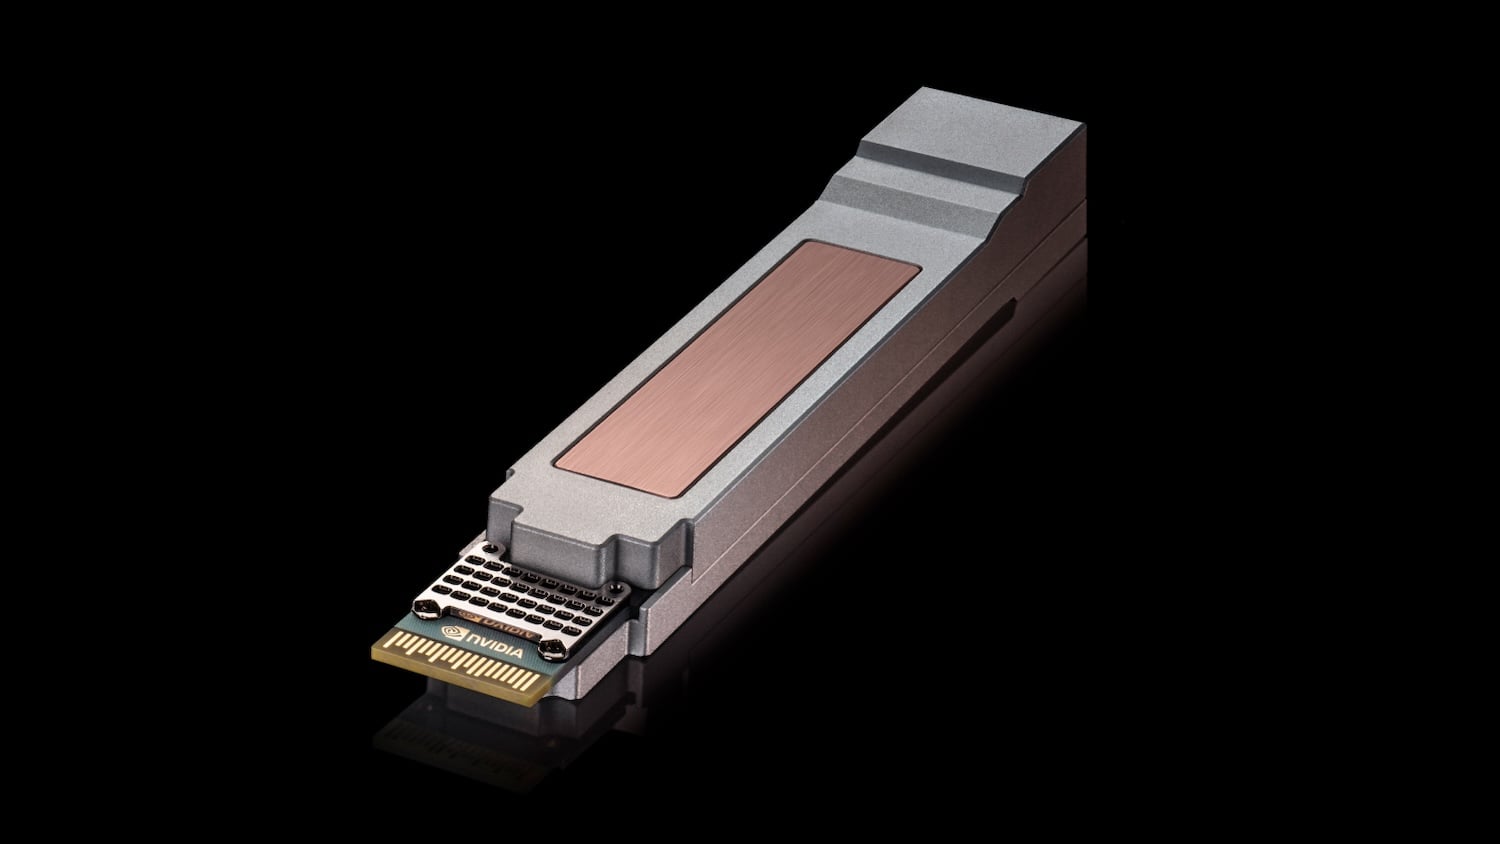
USFP는 샘플링 일정이나 출시일이 정해지지 않은 계획이며, NVIDIA와 Cisco는 커뮤니티 주도의 다중 공급업체 계약을 통해 이 설계를 개방형 산업 표준으로 전환할 예정입니다. 이는 Vera Rubin 랙 설계, DSX AI 팩토리 소프트웨어, 시설 및 전력망 사양, 800VDC 전원, Meta 및 Google과의 이더넷 협력 등 NVIDIA가 OCP 글로벌 서밋에 기여하는 더 큰 규모의 프로젝트 중 하나입니다.
USFP는 레인 수와 전면 패널 대역폭 밀도를 높였습니다.
USFP는 현재 모듈의 레인 수와 레인당 전송 속도를 두 배로 늘려 NVIDIA와 Cisco가 네트워크 계층을 추가하지 않고도 스위치가 더 많은 1.6Tb/s 엔드포인트를 연결할 수 있도록 한다고 밝혔습니다. 이 모듈은 스위치와 SuperNIC 모두에 사용할 수 있습니다. 두 회사는 AI 패브릭 성장의 제한 요소로 전면 패널 밀도를 꼽았습니다. 스위치의 포트가 부족해지면 다음 단계는 더 많은 광 모듈을 사용하는 추가 스위치 계층을 구축하는 것인데, 이는 지연 시간, 전력 소모 및 비용을 증가시킵니다. USFP는 플러그형 모델을 유지하므로 모듈은 현장에서 교체 및 유지보수가 가능합니다.
엔비디아의 수석 부사장인 길라드 샤이너는 "세계 최대 규모의 AI 공장을 구축하려면 가장 작은 연결부터 다시 생각해봐야 한다"고 말했습니다. 시스코의 광 시스템 및 광학 부문 수석 부사장 겸 총괄 매니저인 빌 가트너는 플러그형 광학 모듈의 레인당 400Gb/s 속도를 달성하려면 기존 모듈 설계를 단순히 확장하는 것 이상의 노력이 필요하다고 강조했습니다.
새로운 커넥터는 400Gb/s 신호 전송을 지원합니다.
이 커넥터는 2단계 삽입 방식을 사용하는 2차원 접점 배열 구조로, 고속 접점은 모듈이 제자리에 장착된 후에만 접촉합니다. NVIDIA와 Cisco는 이러한 방식이 접점 마모를 줄이고 신호 무결성을 향상시키며 삽입력을 더욱 예측 가능하게 한다고 밝혔습니다. 이 커넥터는 레인당 400Gb/s 속도를 지원하도록 설계되었으며, 양사에 따르면 레인당 200Gb/s 속도에서도 성능 향상을 제공합니다.
USFP 모듈은 트랜시버 내부에 별도의 냉각 회로 없이 최대 100W의 열을 방출할 수 있어 스위치 설계가 간소화되고 신뢰성이 향상된다고 제조사 측은 설명합니다. 모든 USFP 구성은 신호 처리를 간소화하여 지연 시간과 전력 소비를 줄이는 광학 설계를 지원하며, 다양한 광학 기술과 도달 거리 등급을 수용합니다. NVIDIA와 Cisco는 TE Connectivity 및 Amphenol과 협력하여 케이지, 커넥터 및 모듈을 개발 중이며, NVIDIA Spectrum-X와 Cisco Silicon One 기반 이더넷 네트워크 간의 기존 상호 운용성 작업을 기반으로 더 많은 파트너와의 협력이 예상됩니다.
MGX 1.2는 Vera Rubin 랙 인프라를 확장합니다.
NVIDIA는 개방형 MGX 아키텍처를 통해 OCP에 Vera Rubin 랙 및 컴퓨팅 트레이 설계를 제공했으며, 이는 OCP의 Open DC Initiative의 3세대 MGX 레퍼런스 디자인의 일부로 MQD 및 MQDB 개방형 액체 냉각 설계와 함께 제공됩니다. MGX 1.2 사양은 랙 규모의 블라인드 메이트 액체 냉각, 상호 운용 가능한 랙 규모 상호 연결 인프라, 액체 냉각 방식의 5,000A 버스바를 추가했으며, 19인치 장비 및 최대 250kW의 랙 배포를 기본적으로 지원합니다.
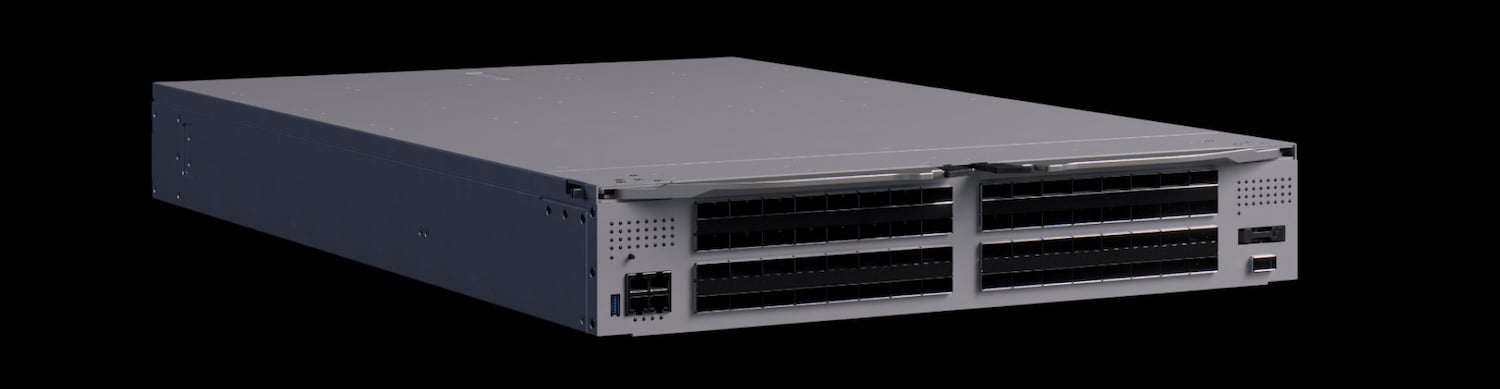
구성 가능한 I/O 베이, 팬리스 액체 냉각 컴퓨팅 트레이, 표준화된 전원 및 냉각 인터페이스가 사양을 완성하며, NVIDIA는 공통 인터페이스를 통해 파트너의 조립, 테스트 및 서비스 시간을 단축할 수 있다고 밝혔습니다. 별도의 Vera CPU 랙 설계 사양은 MGX를 가속 컴퓨팅을 넘어 확장합니다. NVIDIA는 Vera Rubin NVL72를 대규모 학습 및 추론 플랫폼으로, Vera CPU 랙을 에이전트 워크로드에 필요한 도구 호출, 오케스트레이션 및 샌드박스 실행을 위한 플랫폼으로 포지셔닝합니다.
DSX OS에 네트워크, 랙 및 클러스터 관리 구성 요소가 추가되었습니다.
NVIDIA는 DSX AI 팩토리 플랫폼 의 개방형 운영 체제인 DSX OS에 4개의 오픈 소스 구성 요소를 추가했습니다. NVIDIA Config Manager는 AI 패브릭 전반에 걸쳐 스위치 구성, 유효성 검사 및 유지 관리를 자동화합니다. NVIDIA Cluster Readiness Engine은 학습 시작 전에 워크로드 시뮬레이션을 통해 GPU 클러스터에 스트레스 테스트를 수행하여, 그렇지 않으면 작업 실패로 이어질 수 있는 하드웨어 문제를 감지한다고 NVIDIA는 밝혔습니다.

NVIDIA 랙 관리 서비스는 랙을 운영 단위로 간주하며, 하드웨어 추상화 및 펌웨어 관리를 해당 수준에서 수행합니다. NVIDIA 인프라 컨트롤러용 클러스터 API 공급자는 베어메탈 배포 및 테넌트 온보딩을 처리하며, NVIDIA는 이를 통해 원시 하드웨어를 몇 시간 만에 프로덕션 환경에 적합한 클러스터로 전환할 수 있다고 주장합니다. 이러한 구성 요소는 NVIDIA가 DGX 클라우드를 운영하면서 얻은 경험을 바탕으로 개발되었으며, 클라우드 제공업체와 소프트웨어 파트너가 AI 팩토리 운영을 멀티테넌트 플랫폼에 통합할 수 있도록 설계되었습니다.
공개 사양은 시설 설계 및 전력망 복구를 포함합니다.
NVIDIA, AMD, Google, 그리고 Meta는 전력 아키텍처, 냉각, 물리적 레이아웃을 포괄하는 공유 시설 청사진인 OCP(Open Data Center Specification) v0.7을 발표했습니다. 이 사양은 장비 제조업체, 코로케이션 제공업체, 그리고 운영자가 설계에 활용할 수 있습니다. 또한 Google, Meta, Microsoft, 그리고 NVIDIA는 대규모 AI 시설이 전력망 장애에 어떻게 대응해야 하는지를 정의하는 OCP 그리드 복원력 사양(OCP Grid Resilience Specification)도 발표했습니다. 이 사양은 연결 상태를 유지하고, 자동으로 대응하며, 2초 이내에 거의 최대 부하로 복귀하는 것을 목표로 합니다. NVIDIA는 두 사양 모두 자사의 DSX 레퍼런스 디자인과 일치한다고 밝혔습니다.
비전베이는 향후 베라 루빈(Vera Rubin) 구축을 위해 NVIDIA의 800VDC 레퍼런스 아키텍처와 버티브(Vertiv)의 전력 및 열 관리 장비를 결합한 AI 팩토리 플랫폼인 K-1 계획을 발표했습니다. K-1은 AC-DC 변환을 클러스터 수준의 전력 센터로 이동시키고 800VDC 전원을 컴퓨팅 장치에 더 가깝게 공급하며, 800VDC, 액체 냉각, 모듈식 확장을 단계적으로 도입할 예정입니다. 비전베이는 아직 출시 일정을 밝히지 않았습니다.
Meta, Spectrum-6 및 멀티플레인 네트워킹 도입
Meta는 자사의 Vera Rubin AI 팩토리에 NVIDIA Spectrum-6 102.4Tb/s 이더넷을 도입할 예정입니다. NVIDIA에 따르면 Spectrum-6는 Spectrum-4 대비 스위칭 용량과 레인당 대역폭을 두 배로 늘려 레인당 200G의 속도로 작동하며, 작업 간 성능 격리 기능을 제공합니다. Meta의 Spectrum-6 기반 N-IceCube 스위치는 IcePack 100T 액체 냉각 랙에 설치되며, Meta의 오픈 스위치 소프트웨어인 FBOSS를 실행합니다. FBOSS는 OCP(Switch Abstraction Interface)를 사용하여 벤더에 구애받지 않고 하드웨어를 제어할 수 있습니다.
Spectrum-X Multiplane은 Spectrum-6 스위치와 ConnectX-9 SuperNIC을 결합하여 GPU 트래픽을 최대 8개의 독립적인 네트워크 평면에 하드웨어적으로 분산합니다. NVIDIA는 이 설계가 더 적은 스위치 계층으로 10만 개 이상의 GPU를 지원할 수 있으며, 구성 요소에 장애가 발생하더라도 트래픽이 나머지 평면으로 전환되어 대역폭이 감소하더라도 작업이 계속 실행될 수 있다고 밝혔습니다. Meta와 NVIDIA는 온프레미스와 클라우드 환경 모두에서 복원력 향상을 검증했다고 밝혔지만, 구체적인 수치는 공개하지 않았습니다.
구글 팔콘 트랜스포트, 향후 NVIDIA 네트워킹 하드웨어 목표 설정
NVIDIA와 Google은 향후 NVIDIA ConnectX-10 SuperNIC 및 BlueField DPU에 Falcon Transport 지원을 발표했습니다. Falcon은 멀티패스 로드 밸런싱, 프로그래밍 가능한 혼잡 제어, 하드웨어 기반 손실 복구 및 연결별 보안을 통해 이더넷을 통해 안정적인 데이터 전송을 제공합니다. NVIDIA는 하드웨어 가속 및 DOCA 소프트웨어를 통해 Falcon Transport를 구현하므로 NVIDIA와 Google의 NIC는 공통 전송 프로토콜을 사용하는 반면 애플리케이션은 표준 RDMA 인터페이스를 유지합니다. 양사는 이를 통해 이더넷 패브릭이 확장됨에 따라 AI 및 스토리지 트래픽의 대역폭 활용도와 성능 예측 가능성이 향상된다고 밝혔습니다.
시스코, 실리콘 원 G300 시스템 출시 및 51.2T 용량의 랙 상단 장착형 부품 추가
시스코는 OCP 발표를 통해 자사의 실리콘 라인업도 업데이트했습니다. 102.4Tb/s급 Silicon One G300은 현재 샘플링 중이며, G300 기반 시스템은 이미 고객에게 배송되고 있습니다. 또한 시스코는 1.6T 광학 모듈과 직접 액체 냉각 방식을 적용한 200G SerDes를 탑재한 51.2Tb/s급 스위치 ASIC인 G302를 추가했으며, 2026년 말 이전에 출시될 예정입니다. 시스코는 51.2Tb/s급 P200 딥 버퍼 라우팅 실리콘이 하이퍼스케일러 기업에서 생산되고 있다고 밝혔습니다. 마이크로소프트는 P200 시스템을 상용 환경에 도입했으며, 알리바바 클라우드는 SONiC 기반의 eCORE 백본에 P200 기반의 자체 개발 Quantum Cat 라우터를 구축했습니다.
나머지 시스코 제품들은 모두 정상적으로 작동하고 있습니다. 시스코 8001은 10G 및 1G 버전의 실리콘 원 A100 기반 관리 스위치로, SONiC 기술을 대역 외 네트워크에 적용하여 운영자가 네트워크 패브릭에서 랙까지 단일 API 및 자동화 기능을 사용할 수 있도록 지원합니다. 시스코에서 검증한 SONiC 기술은 넥서스 원 아키텍처와 함께 제공되며, 영구적인 수정 패치가 적용되기 전에 런타임에 취약점을 패치하는 라이브 프로텍트(Live Protect) 옵션은 2027년 중반에 출시될 예정입니다. 시스코는 ESUN 회원사이며, 확장형 네트워킹을 위한 1.0 사양을 개발 중이라고 밝혔습니다.


 아마존