

AMD သည် ၎င်း၏ MLPerf Inference v6.0 ရလဒ်များကို ထုတ်ပြန်ခဲ့ပြီး Instinct MI355X GPU ကို single-node၊ multinode နှင့် heterogeneous deployments များတွင် scalable inference platform အဖြစ် ထားရှိခဲ့သည်။ ဤတင်ပြချက်သည် workloads အသစ်များထပ်ထည့်ခြင်းဖြင့် incremental gains များထက် ကျော်လွန်၍ cluster-scale throughput တစ်စက္ကန့်လျှင် tokens ၁ သန်းကျော်ကို ပြသပြီး ကြီးထွားလာနေသော partner ecosystem တစ်လျှောက်တွင် reproducibility ကို အတည်ပြုသည်။
CDNA 4 ဗိသုကာသည် စွမ်းရည်မြင့် ကောက်ချက်ချမှုကို ပစ်မှတ်ထားသည်
Instinct MI355X GPU သည် TSMC 3nm | 6nm FinFET လုပ်ငန်းစဉ် (၎င်းသည် dual-process chiplet ဒီဇိုင်းကို အသုံးပြုသည်- compute dies (XCDs) များသည် TSMC ၏ 3nm node ကို အသုံးပြုပြီး I/O dies များသည် 6nm ကို အသုံးပြုသည်) ပေါ်တွင် တည်ဆောက်ထားသော AMD ၏ CDNA 4 ဗိသုကာပေါ်တွင် အခြေခံထားပြီး transistor ၁၈၅ ဘီလီယံကို ပေါင်းစပ်ထားပြီး FP4 နှင့် FP6 data format များကို ပံ့ပိုးပေးသည်။ ၎င်းသည် monolithic die မဟုတ်ဘဲ multi-chiplet package တစ်ခုလုံးတွင် ဖြစ်သည်ကို သတိပြုသင့်သည်။ GPU တစ်ခုစီတွင် HBM3E memory 288GB အထိ ပါဝင်ပြီး device တစ်ခုတည်းတွင် parameters ၅၂၀ ဘီလီယံအထိ မော်ဒယ်များကို ပံ့ပိုးပေးနိုင်သည်။ AMD သည် compute density နှင့် memory capacity ပေါင်းစပ်မှုကို မော်ဒယ်ခွဲခြင်းမရှိဘဲ မော်ဒယ်ကြီးများ၏ ကောက်ချက်ချမှုအတွက် အရေးကြီးသည်ဟု သတ်မှတ်သည်။
ပလက်ဖောင်းကို UBB8 ဖွဲ့စည်းပုံများဖြင့် ရရှိနိုင်ပြီး ဒေတာစင်တာ ဖြန့်ကျက်မှု လိုအပ်ချက်များနှင့် ကိုက်ညီစေရန် လေအေးပေးစနစ်နှင့် တိုက်ရိုက်အရည်အေးပေးစနစ် နှစ်မျိုးလုံး ရွေးချယ်စရာများ ရှိပါသည်။
တစ်စက္ကန့်လျှင် တိုကင် ၁ သန်းကျော် များပြားသော multinode throughput
ယခုအချီမှ အဓိကရလဒ်တစ်ခုမှာ AMD သည် cluster scale တွင် တစ်စက္ကန့်လျှင် token ၁ သန်းကျော်ရရှိခဲ့သည်။ Instinct MI355X GPU များကို အသုံးပြုခြင်းဖြင့် AMD သည် Server နှင့် Offline scenarios နှစ်ခုလုံးတွင် Llama 2 70B တွင်နှင့် Offline ရှိ GPT-OSS-120B တွင် ဤ threshold ကို ရရှိခဲ့သည်။
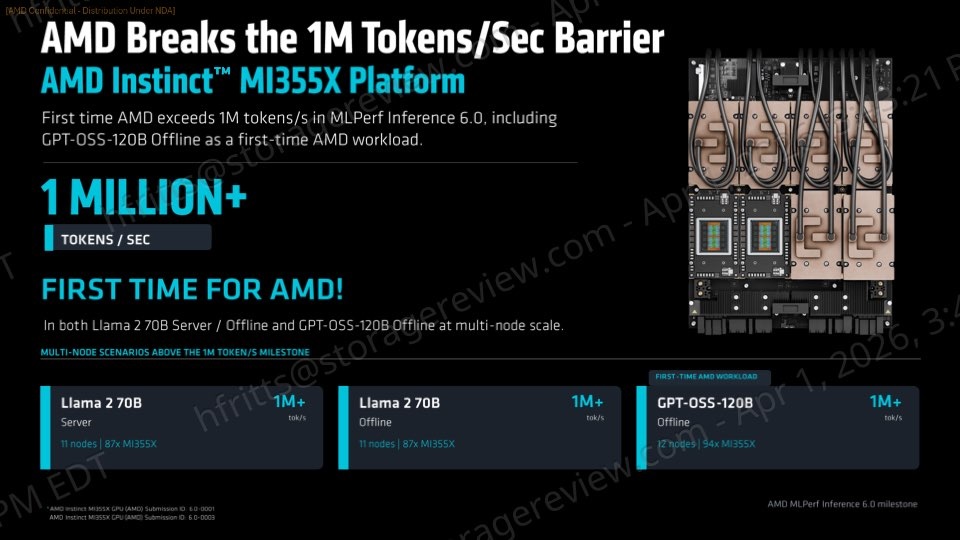
ဤရလဒ်များသည် accelerator တစ်ခုချင်းစီထက် cluster အဆင့်တွင် inference performance ကို အကဲဖြတ်ခြင်းသို့ ပြောင်းလဲလာမှုကို ထင်ဟပ်စေသည်။ စုစုပေါင်း throughput နှင့် time-to-serve ကို ကြီးမားသော AI ဖြန့်ကျက်မှုများအတွက် ထုတ်လုပ်မှု အသင့်ဖြစ်မှုကို ဆုံးဖြတ်ရန် ပိုမိုအသုံးပြုလာကြသည်။
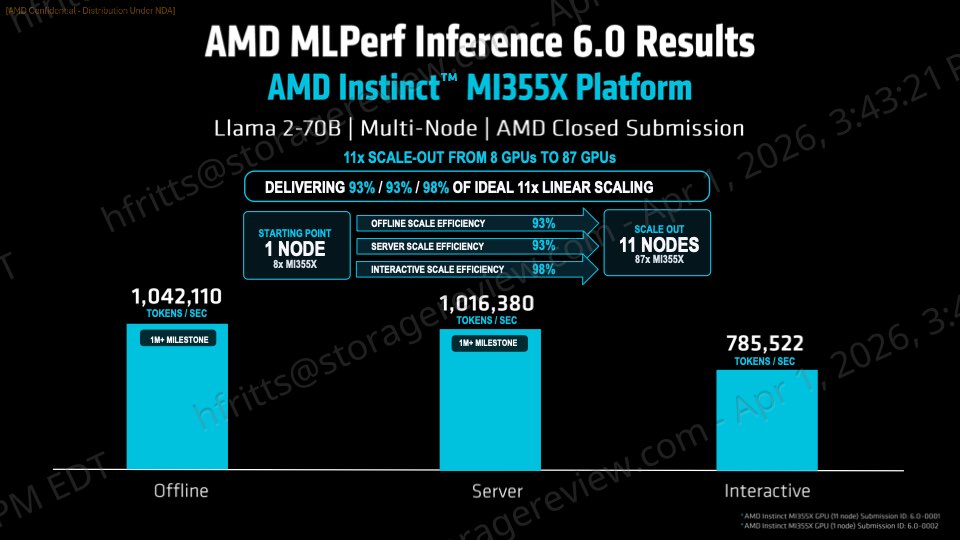
AMD သည် ထိရောက်သော scaling ကိုလည်း သရုပ်ပြခဲ့သည်။ Llama 2 70B တွင် node ၁၁ ခုနှင့် GPU ၈၇ ခုပါဝင်သော configuration သည် Offline၊ Server နှင့် Interactive scenarios များတွင် တစ်စက္ကန့်လျှင် token ၁ သန်းကျော်သို့ ရောက်ရှိခဲ့ပြီး scale-out efficiency မှာ ၉၃% မှ ၉၈% အထိ ရှိသည်။ GPT-OSS-120B တွင် node ၁၂ ခု၊ ၉၄-GPU cluster သည် scaling efficiency မှာ ၉၀% ကျော်ဖြင့် အလားတူ throughput ကို ရရှိခဲ့သည်။ ဤရလဒ်များသည် တစ်ခုတည်းသော system ထက်ကျော်လွန်၍ ဖြန့်ကျက်မှုများ တိုးချဲ့လာသည်နှင့်အမျှ စွမ်းဆောင်ရည်တိုးတက်မှုများသည် ထိရောက်စွာ အဓိပ္ပာယ်သက်ရောက်ကြောင်း ညွှန်ပြနေသည်။
မျိုးဆက်အလိုက် အကျိုးအမြတ်များနှင့် ယှဉ်ပြိုင်နိုင်သော Single-Node စွမ်းဆောင်ရည်
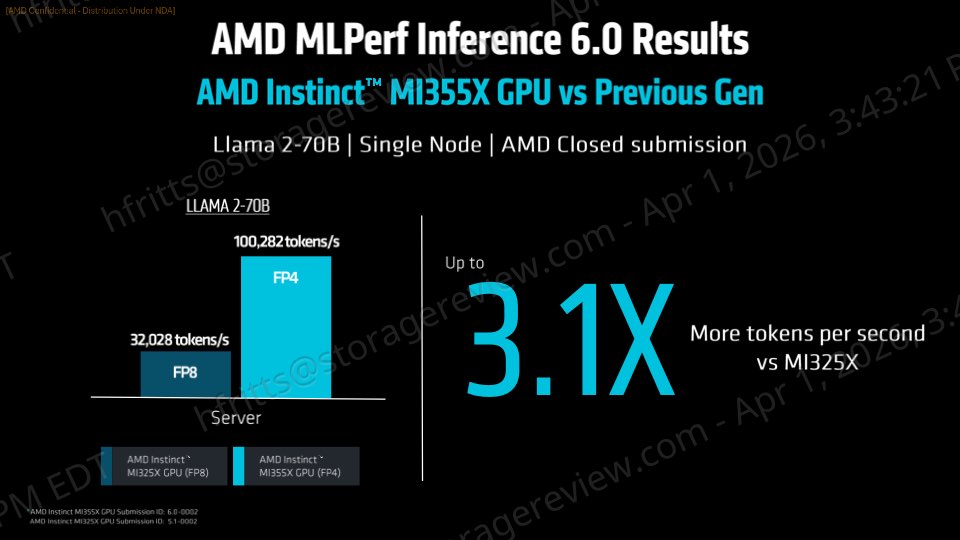
AMD သည် Llama 2 70B Server တွင် ယခင် Instinct MI325X မျိုးဆက်နှင့် နှိုင်းယှဉ်ပါက စွမ်းဆောင်ရည် ၃.၁ ဆ တိုးလာပြီး တစ်စက္ကန့်လျှင် တိုကင် ၁၀၀,၂၈၂ ခု ရောက်ရှိကြောင်း အစီရင်ခံခဲ့သည်။ ဤတိုးတက်မှုသည် ဗိသုကာပြောင်းလဲမှုများနှင့် ROCm software optimization နှစ်ခုလုံးကို ထင်ဟပ်စေသည်။ အော့ဖ်လိုင်းရမှတ်များသည် ယခင်အဆင့်များနှင့် နှိုင်းယှဉ်ပါက ၄.၄ ဆ တိုးတက်လာပြီး Server ရမှတ်များသည် ၄.၈ ဆ တိုးတက်လာခဲ့သည်။ ဤတိုးတက်မှုများသည် အဓိကအားဖြင့် FP4 quantization ကြောင့်ဖြစ်သည်။
single-node နှိုင်းယှဉ်မှုများတွင် MI355X သည် NVIDIA ပလက်ဖောင်းများနှင့် ယှဉ်ပြိုင်နိုင်သော အနေအထားကို ပြသခဲ့သည်။ Llama 2 70B တွင် AMD သည် Offline throughput တွင် NVIDIA B200 နှင့် တူညီခဲ့ပြီး Server စွမ်းဆောင်ရည်တွင် parity နီးပါးရောက်ရှိခဲ့ပြီး Interactive စွမ်းဆောင်ရည်ထက် သာလွန်ခဲ့သည်။ Nvidia ၏ B300 ကို နှိုင်းယှဉ်ပါက AMD ၏ GPU သည် offline mode တွင် 92%၊ server mode တွင် 93% နှင့် interactive mode တွင် 104% ဖြင့် သာလွန်ခဲ့သည်။
ပထမဆုံးအကြိမ် မော်ဒယ်ဖွင့်ပေးခြင်းသည် လွှမ်းခြုံမှုကို တိုးချဲ့ပေးသည်
MLPerf Inference v6.0 တွင် workload အသစ်များစွာပါဝင်ပြီး AMD သည် ဤအချီကို အသုံးပြု၍ မော်ဒယ်ကို လျင်မြန်စွာ enable လုပ်နိုင်ကြောင်း သရုပ်ပြခဲ့သည်။ ကျွမ်းကျင်သူများ ရောနှောထားသော မော်ဒယ် GPT-OSS-120B ကို ပထမဆုံးအကြိမ် မိတ်ဆက်ခဲ့ပြီး Offline နှင့် Server အခြေအနေနှစ်ခုလုံးတွင် NVIDIA စနစ်များနှင့် နှိုင်းယှဉ်ပါက ယှဉ်ပြိုင်နိုင်သော ရလဒ်များ ရရှိခဲ့သည်။
AMD သည် Wan-2.2 text-to-video ထုတ်လုပ်မှုအတွက် ရလဒ်များကိုလည်း တင်သွင်းခဲ့ပြီး multimodal နှင့် generative video inference ထဲသို့ ဝင်ရောက်လာခဲ့သည်။ တရားဝင်တင်သွင်းမှုသည် Single Stream latency ကို အာရုံစိုက်ခဲ့သော်လည်း ရလဒ်များသည် ရှိပြီးသားပလက်ဖောင်းများနှင့် ယှဉ်ပြိုင်နိုင်ခဲ့သည်။ Post-submission tuning သည် စွမ်းဆောင်ရည်ကို ပိုမိုတိုးတက်စေပြီး software ရင့်ကျက်လာသည်နှင့်အမျှ optimization အတွက် နေရာလွတ်ရှိကြောင်း ညွှန်ပြသည်။
ဤထပ်လောင်းမှုများသည် AMD ၏ ရိုးရာ LLM စံနှုန်းများထက် ကျော်လွန်၍ ပေါ်ပေါက်လာသော AI workloads များကို ပံ့ပိုးရန် အာရုံစိုက်မှုကို မီးမောင်းထိုးပြသည်။
ROCm ဆော့ဖ်ဝဲသည် Scaling နှင့် Heterogeneous Inference ကိုဖွင့်ပေးသည်
AMD က စွမ်းဆောင်ရည်နဲ့ တိုးချဲ့နိုင်စွမ်းအများစုကို သူ့ရဲ့ ROCm software stack ကြောင့်လို့ ဆိုပါတယ်။ မြှင့်တင်မှုတွေမှာ optimized FP4 execution၊ distributed inference အတွက် GPU-to-GPU communication တိုးတက်ကောင်းမွန်လာခြင်းနဲ့ heterogeneous environments တွေမှာ dynamic workload distribution အတွက် support တို့ ပါဝင်ပါတယ်။
ကနဦး MLPerf ကွဲပြားသော တင်သွင်းမှုကို AMD Instinct GPU မော်ဒယ်သုံးမျိုးဖြစ်သည့် MI300X၊ MI325X နှင့် MI355X တို့ကို အသုံးပြု၍ တီထွင်ခဲ့သည်။ Dell နှင့် MangoBoost မှ တင်သွင်းခဲ့သော configuration သည် Llama 2 70B Server တွင် တစ်စက္ကန့်လျှင် တိုကင် ၁၄၁,၅၂၁ ခုနှင့် Llama 2 70B Offline တွင် တစ်စက္ကန့်လျှင် တိုကင် ၁၅၁,၈၄၃ ခု ရရှိခဲ့သည်။
မှတ်သားထားသင့်သည်မှာ AMD Instinct MI355X ပလက်ဖောင်းသည် အမေရိကန်ပြည်ထောင်စုရှိ Dell ၏ဓာတ်ခွဲခန်းတွင် တည်ရှိပြီး Instinct MI300X နှင့် MI325X ပလက်ဖောင်းများသည် ကိုရီးယားတွင် ရှိသည်။ ၎င်းသည် မတူညီသော ပထဝီဝင်တည်နေရာများတစ်လျှောက် စနစ်များကို ညှိနှိုင်းဆောင်ရွက်နိုင်စွမ်းကို ပြသနေသည်။
ဂေဟစနစ် ကြီးထွားမှုနှင့် မျိုးပွားနိုင်စွမ်း
AMD ရဲ့ မိတ်ဖက်ဂေဟစနစ်ဟာ ဒီ MLPerf round မှာ တိုးချဲ့လာခဲ့ပြီး ကုမ္ပဏီကိုးခုက Instinct GPU မျိုးဆက်များစွာမှာ ရလဒ်တွေကို တင်သွင်းခဲ့ကြပါတယ်။ ပါဝင်တဲ့ ရောင်းချသူတွေထဲမှာ Cisco, Dell, Giga Computing, HPE, MangoBoost, MiTAC, Oracle, Supermicro နဲ့ Red Hat တို့ ပါဝင်ပါတယ်။
မိတ်ဖက်တင်သွင်းမှုများသည် AMD ၏ အတွင်းပိုင်းရလဒ်များနှင့် အနီးကပ်ကိုက်ညီပြီး ပုံမှန်အားဖြင့် ၄% အတွင်းနှင့် အချို့ကိစ္စများတွင် ၁% အတွင်းဖြစ်သည်။ ဤတသမတ်တည်းရှိမှုသည် OEM နှင့် cloud platform များတွင် စွမ်းဆောင်ရည်ကို ပြန်လည်ထုတ်လုပ်နိုင်ကြောင်း ညွှန်ပြနေပြီး ဖြန့်ကျက်မှုအန္တရာယ်ကို လျှော့ချပေးပြီး လက်တွေ့ကမ္ဘာရလဒ်များအပေါ် ယုံကြည်မှုကို မြှင့်တင်ပေးပါသည်။


 အမေဇုံ