

ဆန်ဟိုဆေးမှာကျင်းပတဲ့ Advancing AI ပွဲမှာ AMD ဟာ သူ့ရဲ့နောက်ဆုံးပေါ် GPU မျိုးဆက်ဖြစ်တဲ့ Instinct MI350 စီးရီးကို မိတ်ဆက်ခဲ့ပြီး အနာဂတ် AI accelerator platform တွေအတွက် တက်ကြွတဲ့ roadmap တစ်ခုလည်း ပါဝင်ပါတယ်။ အဆင့်မြင့် CDNA4 architecture ပေါ်မှာတည်ဆောက်ထားတဲ့ MI350 စီးရီးဟာ တောင်းဆိုမှုများတဲ့ AI workloads တွေအတွက် သိသာထင်ရှားတဲ့ စွမ်းဆောင်ရည်မြှင့်တင်မှုတွေကို ကတိပြုထားပါတယ်။ ဒီကြေငြာချက်မှာ အနာဂတ် Instinct lineup ရဲ့ preview လည်းပါဝင်ပြီး AI hardware မှာ စဉ်ဆက်မပြတ်ဆန်းသစ်တီထွင်မှုအတွက် AMD ရဲ့ ကတိကဝတ်ကို အလေးပေးဖော်ပြနေပါတယ်။
AMD Instinct MI350 စီးရီး
AMD Instinct MI350 စီးရီး သည် CDNA4 ဗိသုကာပုံစံအသစ်ဖြင့် စွမ်းအားပေးထားပြီး AI တွက်ချက်မှုတွင် သိသာထင်ရှားသော ခုန်ပျံကျော်လွှားမှုကို ကိုယ်စားပြုသည်။ AI workloads များအတွက် အထူးဒီဇိုင်းထုတ်ထားသော CDNA4 ဗိသုကာပုံစံသည် ပိုမိုကောင်းမွန်သော matrix engine များ၊ data format အသစ်များအတွက် ပံ့ပိုးမှုနှင့် စွမ်းအင်ထိရောက်မှုတွင် အရေးကြီးသော တိုးတက်မှုများ မိတ်ဆက်ပေးသည်။
အဆင့်မြင့်ထုပ်ပိုးမှုနှင့် Chiplet ဗိသုကာ- MI350 ၏ အခြေခံအုတ်မြစ်
MI350 စီးရီးကို AMD ၏ အဆင့်မြင့် 3D chiplet packaging နည်းပညာပေါ်တွင် တည်ဆောက်ထားပြီး၊ အဓိက မြှင့်တင်မှုများဖြင့် MI300 စီးရီးမှ တိုးတက်ပြောင်းလဲလာပါသည်။
ချစ်ပ်လက် ဒီဇိုင်းနှင့် ထုတ်လုပ်ခြင်း
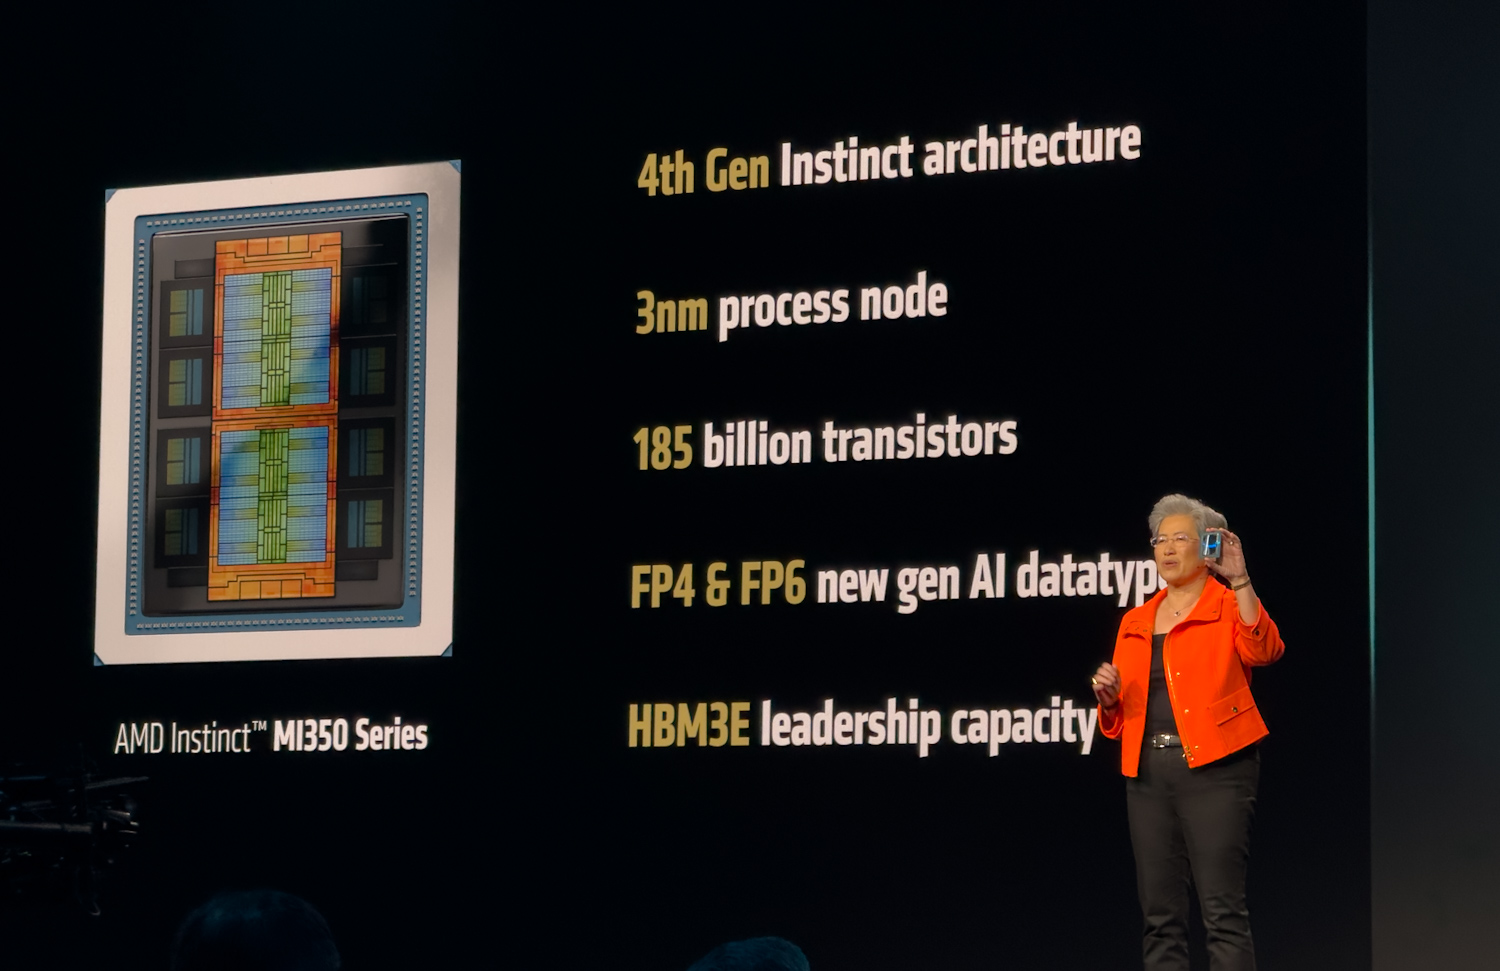
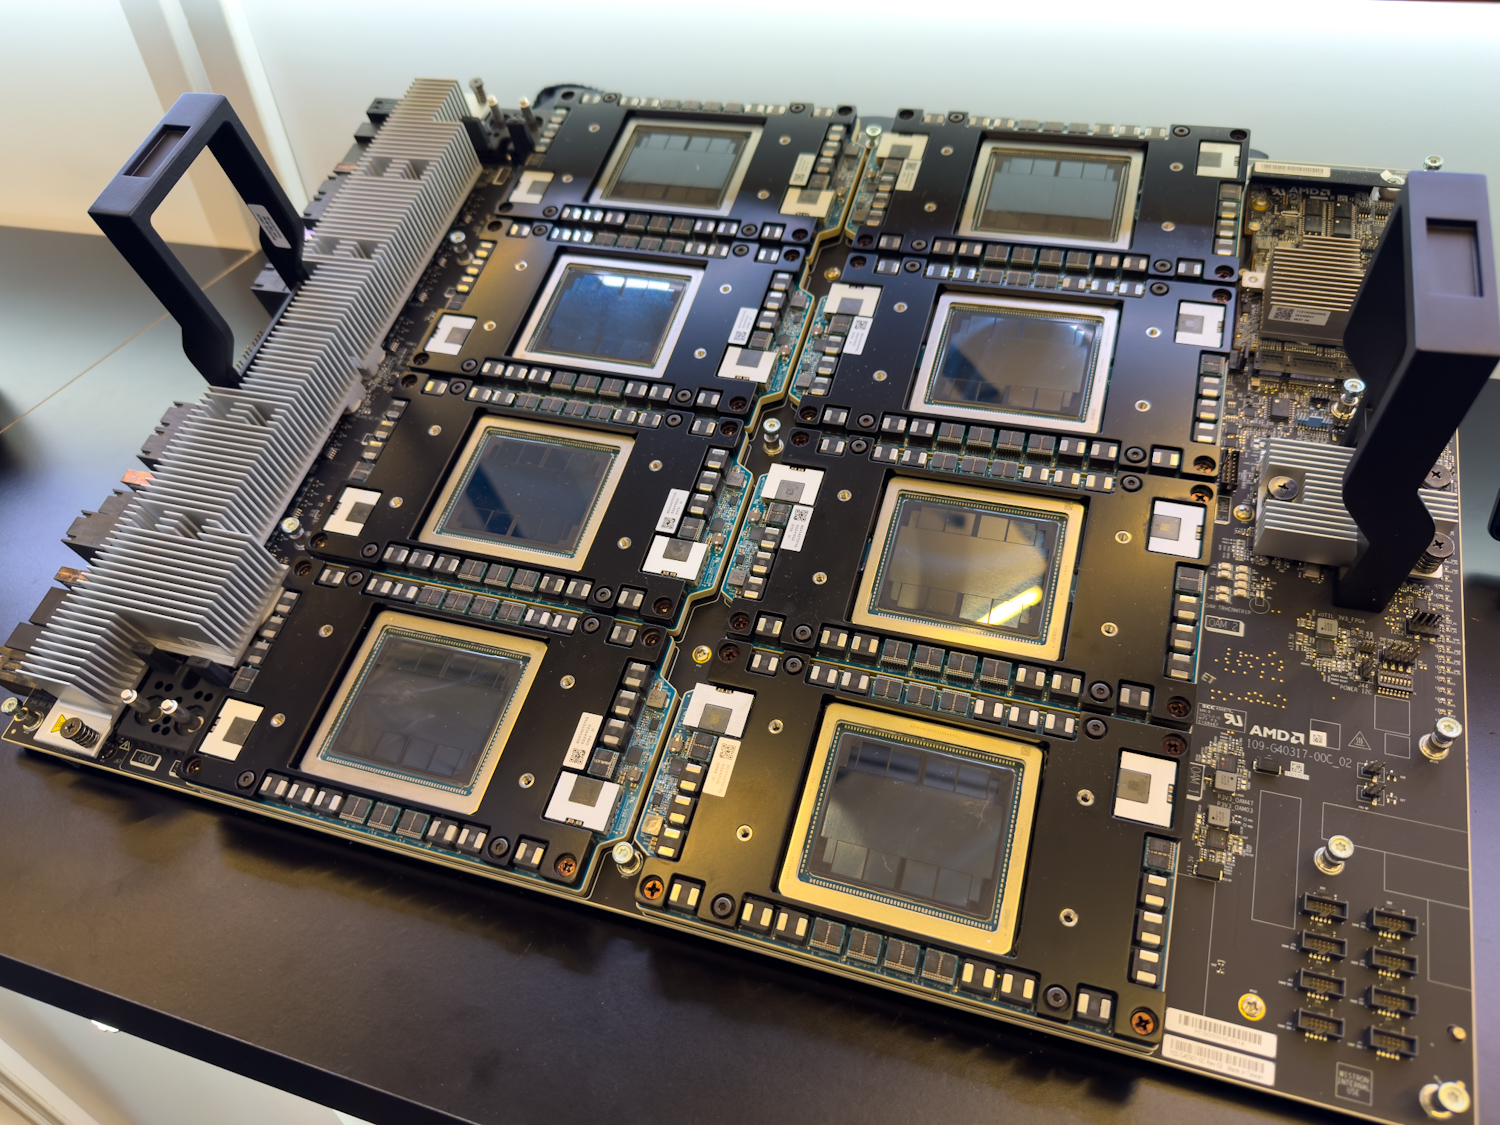
၎င်း၏အဓိကအချက်အနေဖြင့် GPU package တွင် အဓိကတွက်ချက်မှုအင်ဂျင်များဖြစ်သည့် Accelerator Compute Chiplets (XCDs) ရှစ်ခုပါဝင်သည်။ ဤ XCD များကို MI300 စီးရီးတွင်အသုံးပြုသည့် 5nm နည်းပညာမှ အဆင့်မြှင့်တင်မှုတစ်ခုဖြစ်သည့် အဆင့်မြင့် 3nm Node 3+ node လုပ်ငန်းစဉ်တွင် တည်ဆောက်ထားပြီး စွမ်းအင်ထိရောက်မှုကို သိသိသာသာတိုးတက်စေသည်။ XCD တစ်ခုစီတွင် shader အင်ဂျင်လေးခုပါဝင်ပြီး အင်ဂျင်တစ်ခုစီတွင် active CDNA4 compute unit ရှစ်ခုပါဝင်ပြီး XCD တစ်ခုလျှင် CU ၃၂ ခုနှင့် accelerator အတွက် CU စုစုပေါင်း ၂၅၆ ခုရှိသည်။

XCD များကို ဖြည့်စွက်ပေးသည့်အနေဖြင့် MI300 စီးရီးရှိ IOD လေးခုထက် လျော့နည်းသော IO Dies (IOD) နှစ်ခုပါရှိသည်။ 6nm-class လုပ်ငန်းစဉ်တွင် ထုတ်လုပ်ထားသော ဤ IOD များသည် မှတ်ဉာဏ်ဝင်ရောက်ခွင့်၊ I/O လုပ်ဆောင်ချက်များနှင့် ချစ်ပ်လက်အချင်းချင်း ဆက်သွယ်မှုများကို ကိုင်တွယ်သည်။ ဤချောမွေ့သော two-IOD ဒီဇိုင်းကို ပိုမိုကျယ်ပြန့်သော အတွင်းပိုင်းချိတ်ဆက်မှုများနှင့် ပေါင်းစပ်ထားပြီး bandwidth target များကို ထိန်းသိမ်းထားပြီး ပါဝါသုံးစွဲမှုကို လျှော့ချပေးသည်။
ရုပ်ပိုင်းဆိုင်ရာ ပေါင်းစည်းမှုနှင့် ယုတ္တိဗေဒဆိုင်ရာ စည်းလုံးညီညွတ်မှု
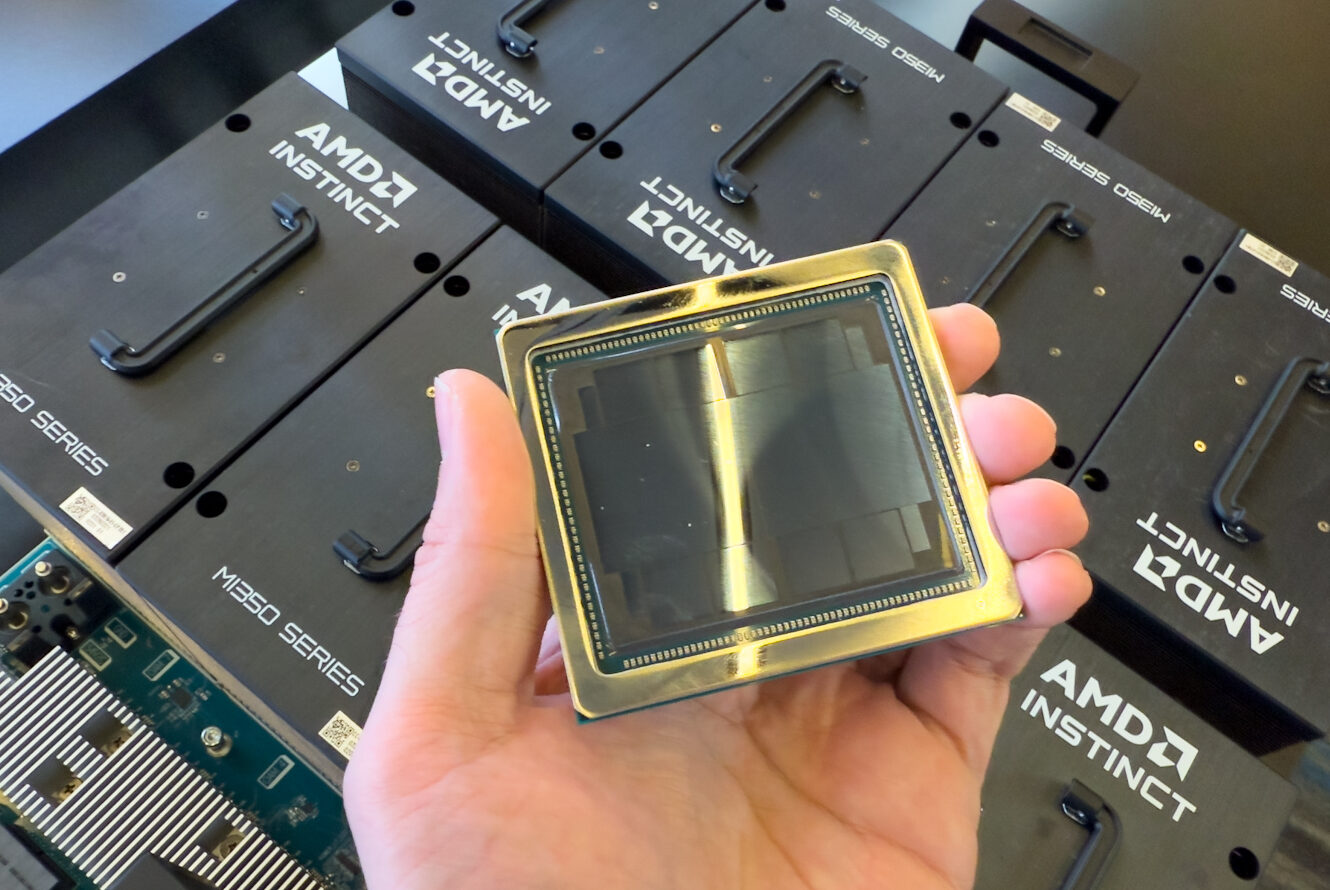
ရုပ်ပိုင်းဆိုင်ရာ တပ်ဆင်မှုတွင် XCD များနှင့် HBM3E မှတ်ဉာဏ် stack များကို Chip-on-Wafer-on-Substrate (COOS) interposer ပေါ်တွင် တပ်ဆင်ခြင်း ပါဝင်သည်။ ဤဒီဇိုင်း၏ အရေးကြီးသော ရှုထောင့်တစ်ခုမှာ XCD များကို ၎င်းတို့အောက်တွင်ရှိသော IOD များနှင့် hybrid bonding ဖြစ်သည်။ ဤ 3D hybrid bonding နည်းပညာသည် compute နှင့် I/O chiplets များအကြား အလွန်သိပ်သည်းပြီး bandwidth မြင့်မားသော ချိတ်ဆက်မှုများကို ဖန်တီးပေးပြီး ရိုးရာ 2.5D တည်ဆောက်ပုံများထက် များစွာကျော်လွန်ပြီး ပါဝါသုံးစွဲမှု မြင့်မားသော XCD များသို့ ဒေတာကို ထိရောက်စွာ ထောက်ပံ့ပေးရာတွင် အရေးကြီးပါသည်။ ထို့အပြင်၊ ဤအဆင့်မြင့် 3D ပေါင်းစပ်မှုသည် GPU footprint ကို သေးငယ်စေပြီး ထုတ်လုပ်မှုအထွက်နှုန်းနှင့် လုပ်ငန်းလည်ပတ်မှု ယုံကြည်စိတ်ချရမှုကို မြှင့်တင်ပေးနိုင်ပါသည်။
၎င်း၏ ရှုပ်ထွေးသော chiplet တည်ဆောက်ပုံရှိသော်လည်း MI350 သည် တစ်ခုတည်းသော ပေါင်းစည်းထားသော GPU အဖြစ် ယုတ္တိဗေဒအရ လုပ်ဆောင်သည်။ XCD တစ်ခုစီသည် command processor နှင့် 4MB L2 cache အပါအဝင် ကမ္ဘာလုံးဆိုင်ရာ အရင်းအမြစ်များ တပ်ဆင်ထားသော Accelerator Compute Complex တစ်ခုကို ဖွဲ့စည်းထားသည်။
မြှင့်တင်ထားသော မှတ်ဉာဏ် ဆပ်စနစ်
အစွမ်းထက်သော CDNA4 cores များကို လုံလောက်စွာ ထောက်ပံ့ပေးနိုင်ရန်အတွက် MI350 စီးရီးတွင် သိသိသာသာ အဆင့်မြှင့်တင်ထားသော memory subsystem ပါရှိသည်။ ၎င်းတွင် HBM3E memory stack ရှစ်ခု တပ်ဆင်ထားပြီး GPU တစ်ခုလျှင် စုစုပေါင်း 288GB စွမ်းရည်ကို ပေးစွမ်းနိုင်သည်။ 12-high 24Gbit devices များဖြင့် ဖွဲ့စည်းထားသော 36 GB stack တစ်ခုစီသည် pin တစ်ခုလျှင် 8Gbps ၏ အပြည့်အဝ HBM3E pin speed ဖြင့် လည်ပတ်သည်။
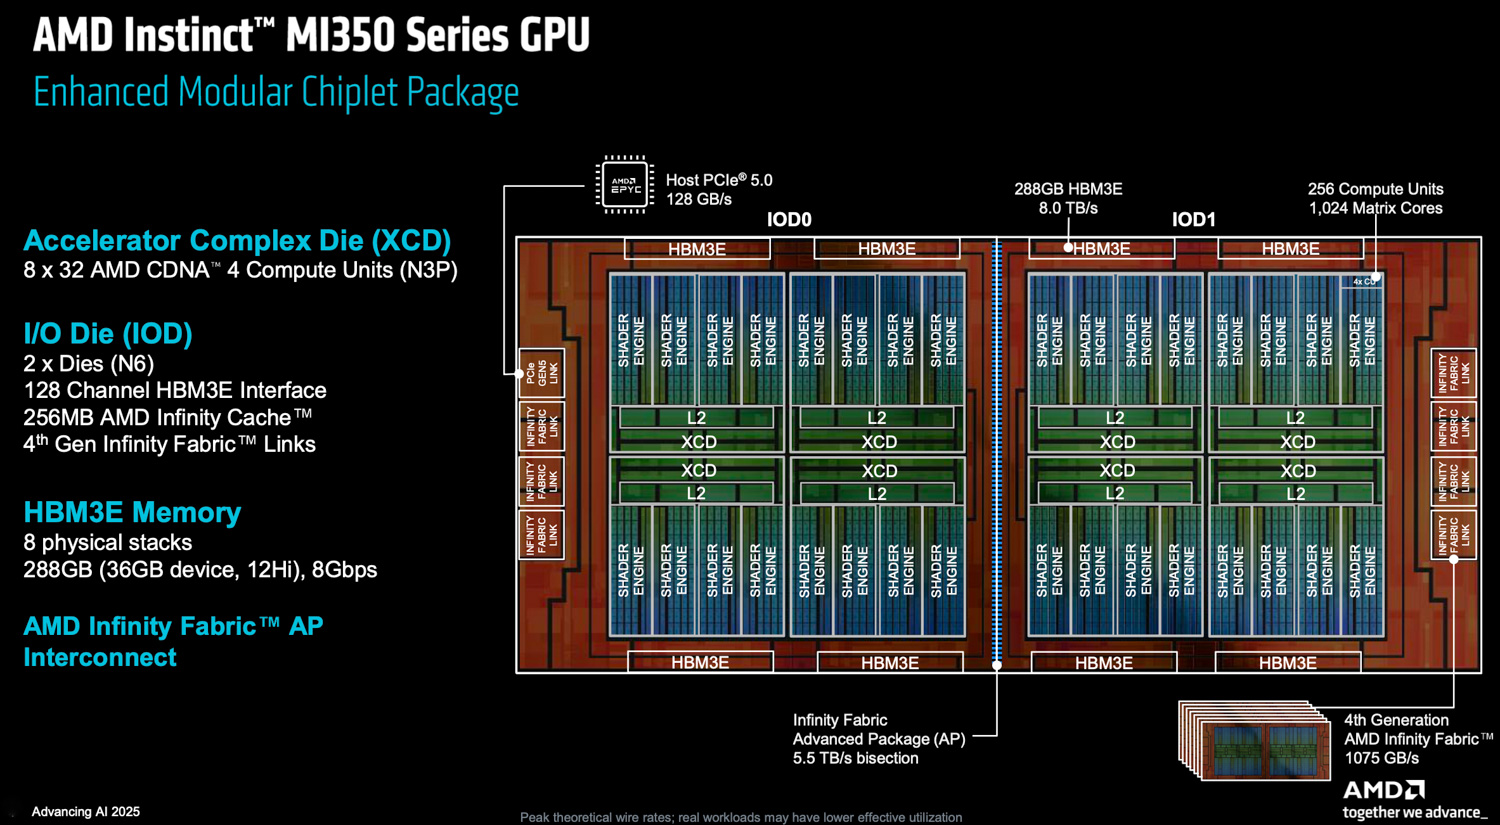
ဗိသုကာလက်ရာတွင် HBM နှင့် Infinity Fabric/L2 cache များကြားတွင်တည်ရှိသော အရေးကြီးသော memory-side cache ဖြစ်သည့် AMD ၏ Infinity Cache ကိုလည်း ထိန်းသိမ်းထားသည်။ ဤ cache တွင် channel ၁၂၈ ခုပါဝင်ပြီး တစ်ခုစီတွင် 2MB cache ဖြင့် ကျောထောက်နောက်ခံပြုထားပြီး GPU အတွက် စုစုပေါင်း 256MB ရှိသည်။ ပါဝါနည်းချိန်တွင် bandwidth ပို့ဆောင်မှုထိရောက်မှုကို မြှင့်တင်ရန်အတွက် AMD သည် IOD များအတွင်းရှိ on-die network bus များကို ချဲ့ထွင်ပြီး ဗို့အားလျှော့ချခြင်းဖြင့် လည်ပတ်သည်။ ဤ optimization သည် bit တစ်ခုလျှင် စွမ်းအင်ကို လျှော့ချပေးပြီး MI350 စီးရီးသည် ၎င်း၏ရှေ့ပြေးဖြစ်သော MI300 စီးရီးထက် watt တစ်ခုလျှင် memory bandwidth ၁.၃ ဆခန့် မြင့်မားစွာရရှိစေသည်။
ထို့အပြင်၊ ကျယ်ပြန့်သော 288GB ရုပ်ပိုင်းဆိုင်ရာ မှတ်ဉာဏ်ကို ထိရောက်စွာ စီမံခန့်ခွဲနိုင်ရန်အတွက် CPU Translation Lookaside Buffers (TLBs) နှင့် ဆင်တူသည့် Universal Translation Caches (UTCs) များကို သိသိသာသာ မြှင့်တင်ထားပါသည်။ MI350 စီးရီးသည် စွမ်းရည်များ တိုးမြှင့်ခြင်းနှင့်အတူ UTC L1 နှင့် L2 နှစ်ခုလုံးတွင် ပိုမိုအသေးစိတ်ကျသော စာမျက်နှာအရွယ်အစား ထိန်းချုပ်မှုများကို မိတ်ဆက်ပေးပါသည်။ ဤတိုးတက်မှုများသည် TLB လက်လှမ်းမီမှု ပိုမိုကောင်းမွန်လာစေပြီး virtual memory စီမံခန့်ခွဲမှုကို ပိုမိုထိရောက်စေပါသည်။
Infinity အထည်အလိပ် မြှင့်တင်မှုများ
AMD ရဲ့ Infinity Fabric နည်းပညာဟာ MI350 ရဲ့ တိုးချဲ့နိုင်စွမ်းနဲ့ GPU အချင်းချင်း ဆက်သွယ်နိုင်စွမ်း စွမ်းဆောင်ရည်အတွက် အဓိကကျနေဆဲပါ။ IOD နှစ်ခုကို ချိတ်ဆက်ပေးတဲ့ Infinity Fabric AP link ရဲ့ bisectional bandwidth ကို 5.5TB/s အထိ သိသိသာသာ တိုးမြှင့်ထားပြီး GPU ရဲ့ တစ်ဝက်စီကြား ဒေတာ ထိရောက်စွာ ရွှေ့ပြောင်းနိုင်အောင် လွယ်ကူချောမွေ့စေပါတယ်။
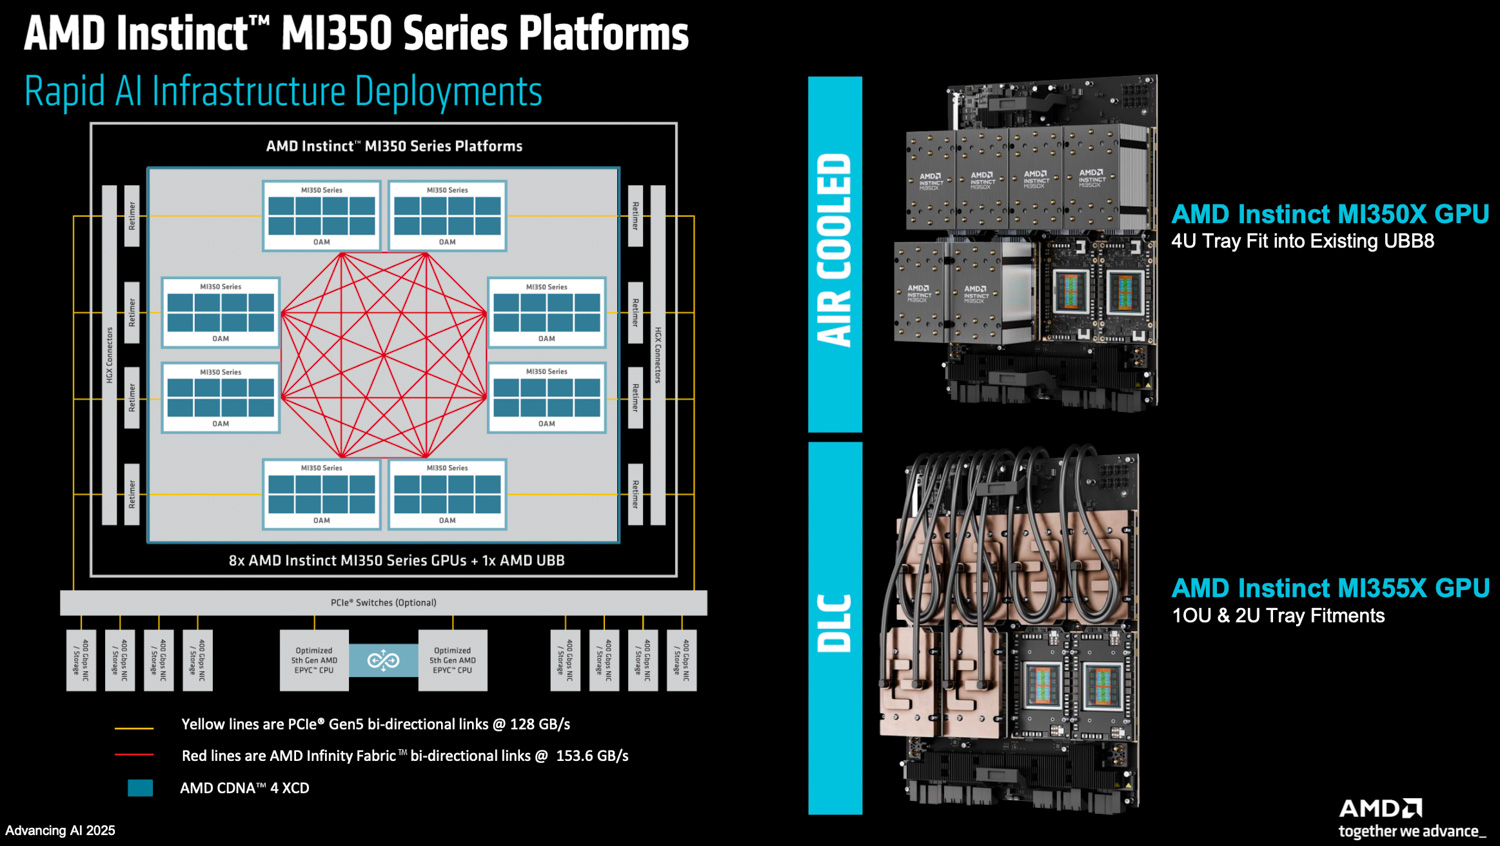
ပြင်ပဆက်သွယ်ရေးအတွက် MI350 GPU တစ်ခုစီတွင် Infinity Fabric link ခုနစ်ခုပါရှိပြီး 8-GPU UBB 2.0 platform ကဲ့သို့သော configuration များတွင် GPU-to-GPU ချိတ်ဆက်မှုကို တိုက်ရိုက်ဖြစ်စေသည်။ ဤ link များသည် pin တစ်ခုလျှင် 38.4Gbps ဖြင့် လုပ်ဆောင်သည်။ 8-GPU OAM setup တွင်၊ ဤ configuration သည် link တစ်ခုလျှင် ဦးတည်ချက်တစ်ခုစီတွင် bisectional bandwidth 153.6 GB/s ခန့်ကို ပေးဆောင်သည်။ AMD သည် ထိရောက်သော ပေးပို့ထားသော bandwidth ကို မြှင့်တင်ရန်အတွက် ဤပြင်ပ link များပေါ်တွင် data packing နှင့် compression နည်းပညာများကိုလည်း ပြန်လည်ပြုပြင်ထားသည်။ အတွင်းပိုင်းတွင်၊ Infinity Fabric သည် XCD အားလုံးသည် IOD နှစ်ခုလုံးရှိ HBM3E memory space တစ်ခုလုံးသို့ full, fine-grained interleaved access ရှိကြောင်း သေချာစေပြီး memory ကို compute unit များသို့ single, flat, unified resource အဖြစ် တင်ပြသည်။
CDNA4 တွက်ချက်မှု အဓိက ဗိသုကာ
MI350 ၏ ပရိုဆက်ဆာစွမ်းအား၏ အဓိကအချက်ဖြစ်သော CDNA4 တွက်ချက်ယူနစ်ကို AI အတွက် သီးသန့်ပြုလုပ်ထားသော သိသာထင်ရှားသော ပြန်လည်တည်ဆောက်မှုကို ပြုလုပ်ခဲ့သည်။
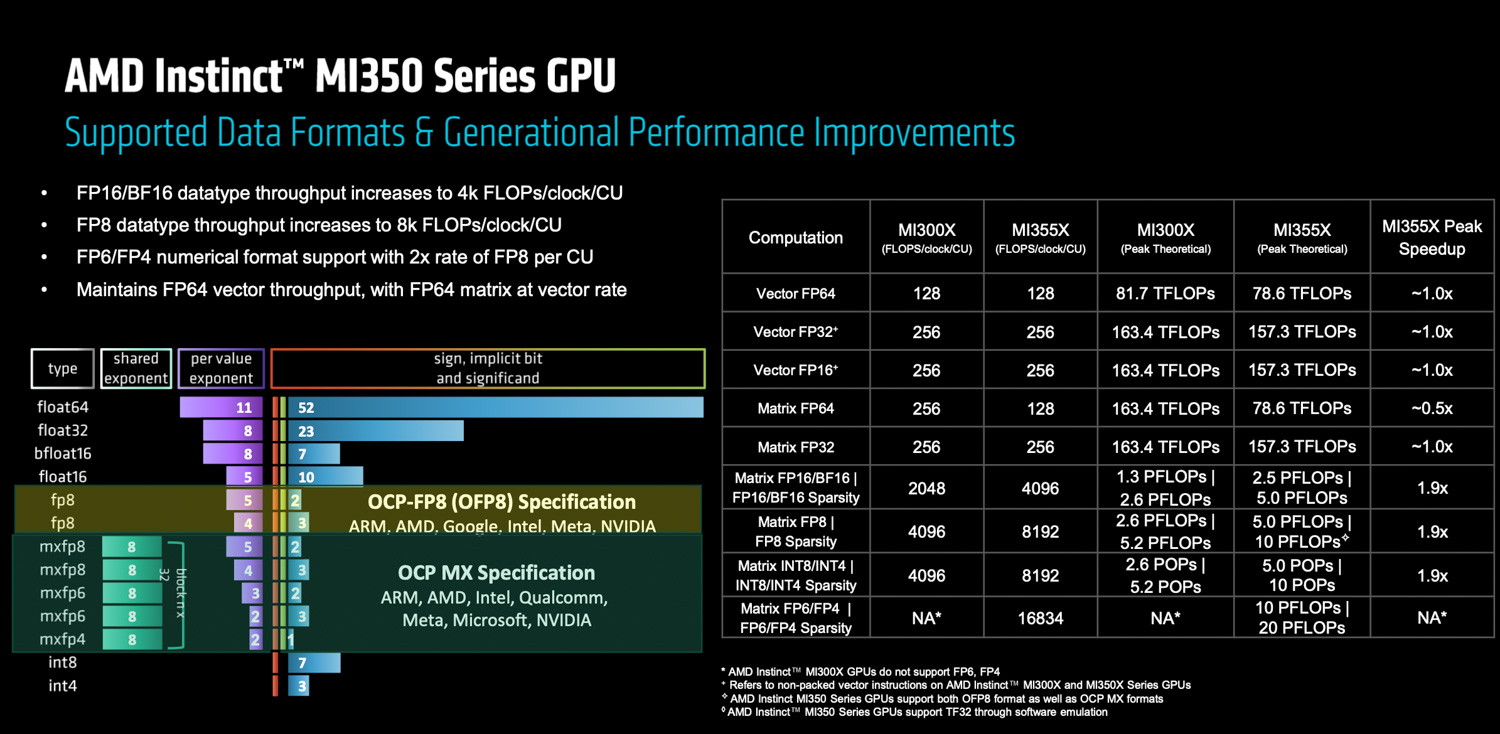
Matrix သင်္ချာစွမ်းရည်များ သိသိသာသာ တိုးတက်လာသည်ကို တွေ့မြင်ရသည်- MI350 CU များသည် MI300 ၏ မိတ်ဖက်များနှင့် နှိုင်းယှဉ်ပါက 16-bit (BF16၊ FP16) နှင့် 8-bit (FP8၊ INT8) လုပ်ဆောင်ချက်များအတွက် CU တစ်ခုလျှင် throughput ၂ ဆ တိုးလာစေပါသည်။ MI350 စီးရီးသည် OCP MX-သတ်မှတ်ထားသော micro-scale format များ၊ အထူးသဖြင့် FP6 နှင့် FP4 အတွက် hardware support ကိုလည်း မိတ်ဆက်ပေးထားပြီး၊ ၎င်းတို့သည် FP8 မှ အချိုးကျ scale လုပ်ကြသည်။ မှတ်သားစရာကောင်းသည်မှာ AMD ၏ အကောင်အထည်ဖော်မှုသည် FP6 ကို FP4 နှင့် တူညီသော computational rate ဖြင့် လုပ်ဆောင်နိုင်စေပါသည်။ ဤမဟာဗျူဟာမြောက် ဆုံးဖြတ်ချက်သည် AMD ကို AI လေ့ကျင့်မှုအတွက် အလားအလာရှိသော ပေါ်ထွက်လာသော format တစ်ခုဖြစ်သည့် FP6 တွင် ဦးဆောင်မှုနေရာပေးထားသည်။ ထို့အပြင်၊ 2-bit လုပ်ဆောင်ချက်များကို ပံ့ပိုးပေးပြီး BF16 ရလဒ်များကို FP32 သို့ စုဆောင်းနိုင်သည့် vector ALU အသစ်တစ်ခုကို ထည့်သွင်းထားပြီး၊ ထို့ကြောင့် အချို့သော low-precision vector လုပ်ဆောင်ချက်များအတွက် throughput ကို မြှင့်တင်ပေးပါသည်။
ဤတိုးမြှင့်ထားသော tensor throughput များကို ပံ့ပိုးပေးရန်အတွက် CU တစ်ခုလျှင် Local Data Share (LDS) အရွယ်အစားကို တိုးမြှင့်ထားပြီး global memory မှ LDS ထဲသို့ data များကို load လုပ်ရန်အတွက် bandwidth ကို မြှင့်တင်ပေးသည့် စွမ်းရည်အသစ်များ ရှိပါသည်။ softmax နှင့် attention mechanisms ကဲ့သို့သော လုပ်ဆောင်ချက်များတွင် ဖြစ်နိုင်ချေရှိသော bottleneck များကို သိရှိခြင်းဖြင့် transcendental functions များအတွက် throughput ကိုလည်း tensor core တိုးတက်မှုများနှင့်အတူ တိုးမြှင့်ထားပါသည်။
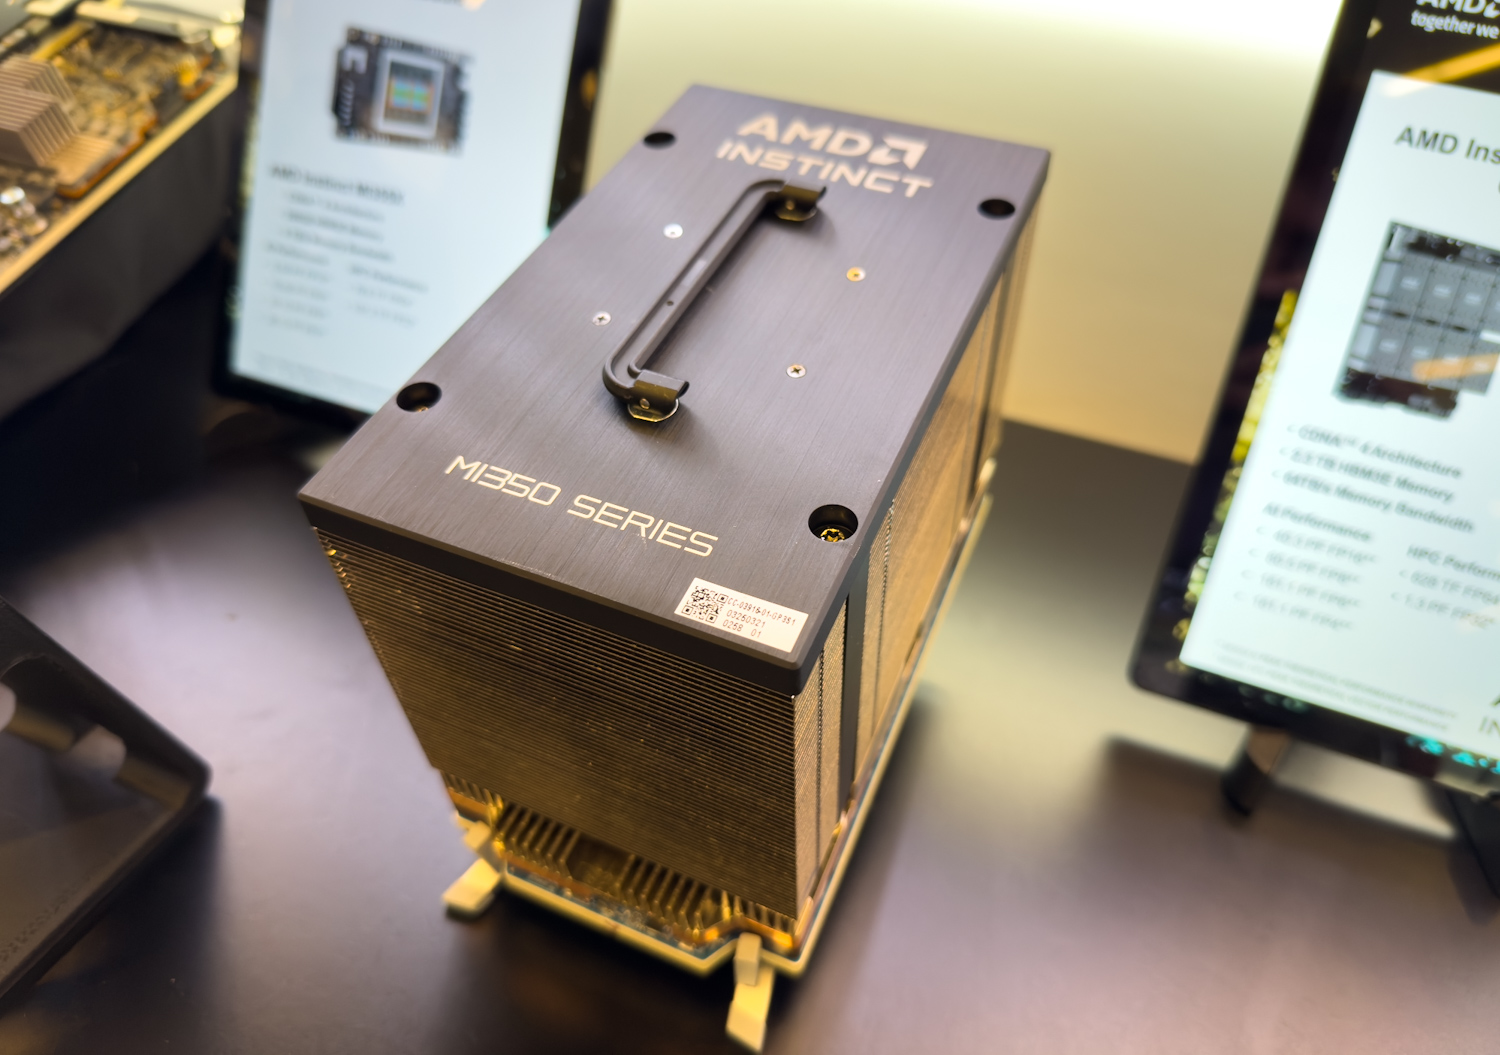
အခြားသော ဗိသုကာဆိုင်ရာ မြှင့်တင်မှုများစွာသည် စွမ်းဆောင်ရည်နှင့် ပြောင်းလွယ်ပြင်လွယ်ရှိမှုကို အထောက်အကူပြုသည်-
- Hardware-Supported Stochastic Rounding: entropy ထိုးသွင်းခြင်းဖြင့် FP32 မှ တိကျမှုနိမ့်သော formats များသို့ downcast လုပ်သည့်အခါ bias ကို လျော့ပါးစေသည်။
- Logical Operator 3 (LUT3) ညွှန်ကြားချက်- ပရိုဂရမ်မာများအား custom three-input logical operations များကို အကောင်အထည်ဖော်ရာတွင် ပိုမိုပြောင်းလွယ်ပြင်လွယ်ရှိစေပါသည်။
- Min-Max Operator အသစ်များ- ပရိုဂရမ်မာများအား နှိုင်းယှဉ်မှုများအတွင်း NaN ပျံ့နှံ့မှုကို ထိန်းချုပ်နိုင်စေပြီး NaN တန်ဖိုးများကို ပျံ့နှံ့စေခြင်း သို့မဟုတ် NaN မဟုတ်သော floating-point နံပါတ်ကို ရွေးချယ်ခွင့်ပြုကာ ခိုင်မာသော AI data စီမံခန့်ခွဲမှုတွင် အထောက်အကူဖြစ်စေပါသည်။
AI ကို အဓိကထားအသုံးပြုထားသော်လည်း MI350 စီးရီးသည် vector နှင့် matrix unit နှစ်မျိုးလုံးတွင် 64-bit floating-point (FP64) လုပ်ဆောင်ချက်များအတွက် ပံ့ပိုးမှုကို ဆက်လက်ထိန်းသိမ်းထားသည်။ သို့သော် MI300 နှင့် အဓိကကွာခြားချက်မှာ MI350 တွင် matrix FP64 လုပ်ဆောင်ချက်များသည် vector FP64 unit များနှင့် တူညီသောနှုန်းဖြင့် လည်ပတ်ပြီး MI300 ၏ FP64 matrix rate ၏ ထက်ဝက်ခန့်သာရှိသည်။
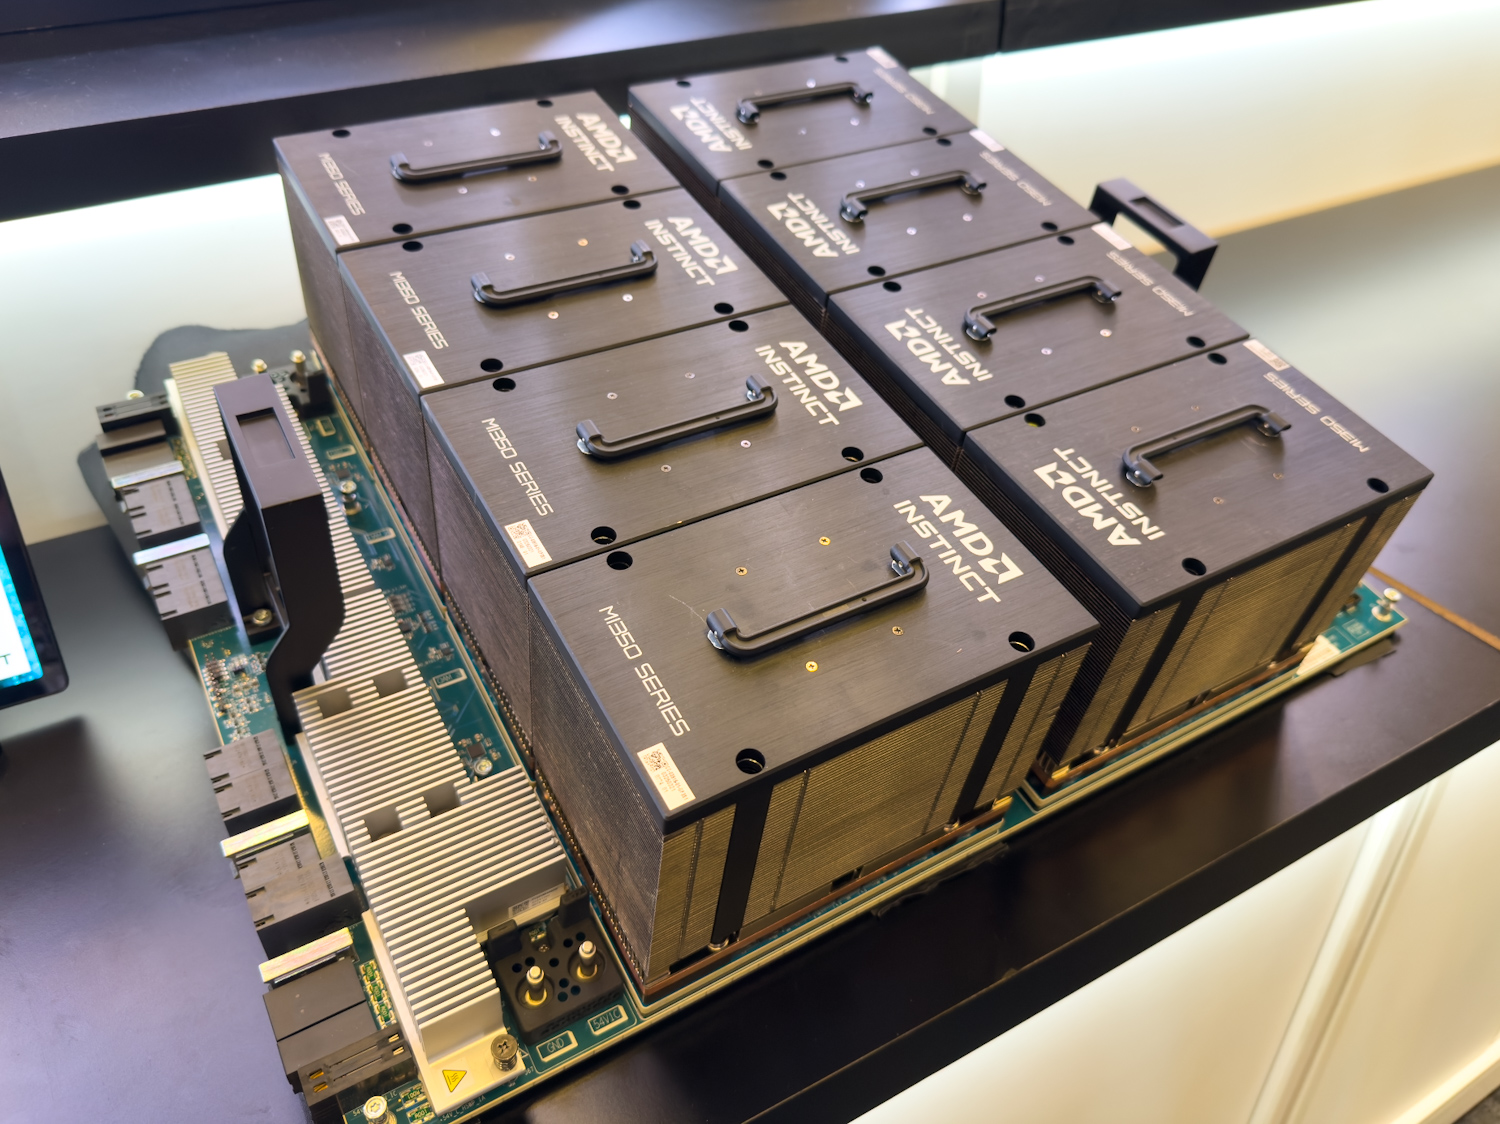
နောက်ဆုံးအနေနဲ့ HBM3E bandwidth မြင့်မားခြင်းနဲ့ CU အရေအတွက် အနည်းငယ်လျော့နည်းခြင်း (MI350X/355X မှာ 256 နဲ့ MI300X မှာ 304) ပေါင်းစပ်မှုက MI350 စီးရီးရှိ CU တစ်ခုစီဟာ clock တစ်ခုချင်းစီအတွက် global memory bandwidth တိုးလာခြင်းကနေ အကျိုးကျေးဇူးရရှိတယ်လို့ ဆိုလိုပါတယ်။ ဒါဟာ GEMM-heavy (General Matrix Multiply) လုပ်ဆောင်ချက်တွေနဲ့ bandwidth-bound vector arithmetic နှစ်ခုလုံးကို အရှိန်မြှင့်ဖို့အတွက် အလွန်အရေးကြီးပါတယ်။
ပြောင်းလွယ်ပြင်လွယ်ရှိစေရန်အတွက် ပိုင်းခြားခြင်း- NPS နှင့် Compute Partitioning
AMD MI350 စီးရီးတွင် ပိုမိုကောင်းမွန်သော ပိုင်းခြားနိုင်စွမ်းများ ပါဝင်ပြီး မတူညီသော workloads များတွင် အသုံးချမှုနှင့် ထိရောက်မှုကို အမြင့်ဆုံးဖြစ်စေရန် ၎င်း၏ များပြားလှသော အရင်းအမြစ်များကို အလွန်ပြောင်းလွယ်ပြင်လွယ်ရှိသော ခွဲဝေမှုကို ပေးဆောင်ပါသည်။
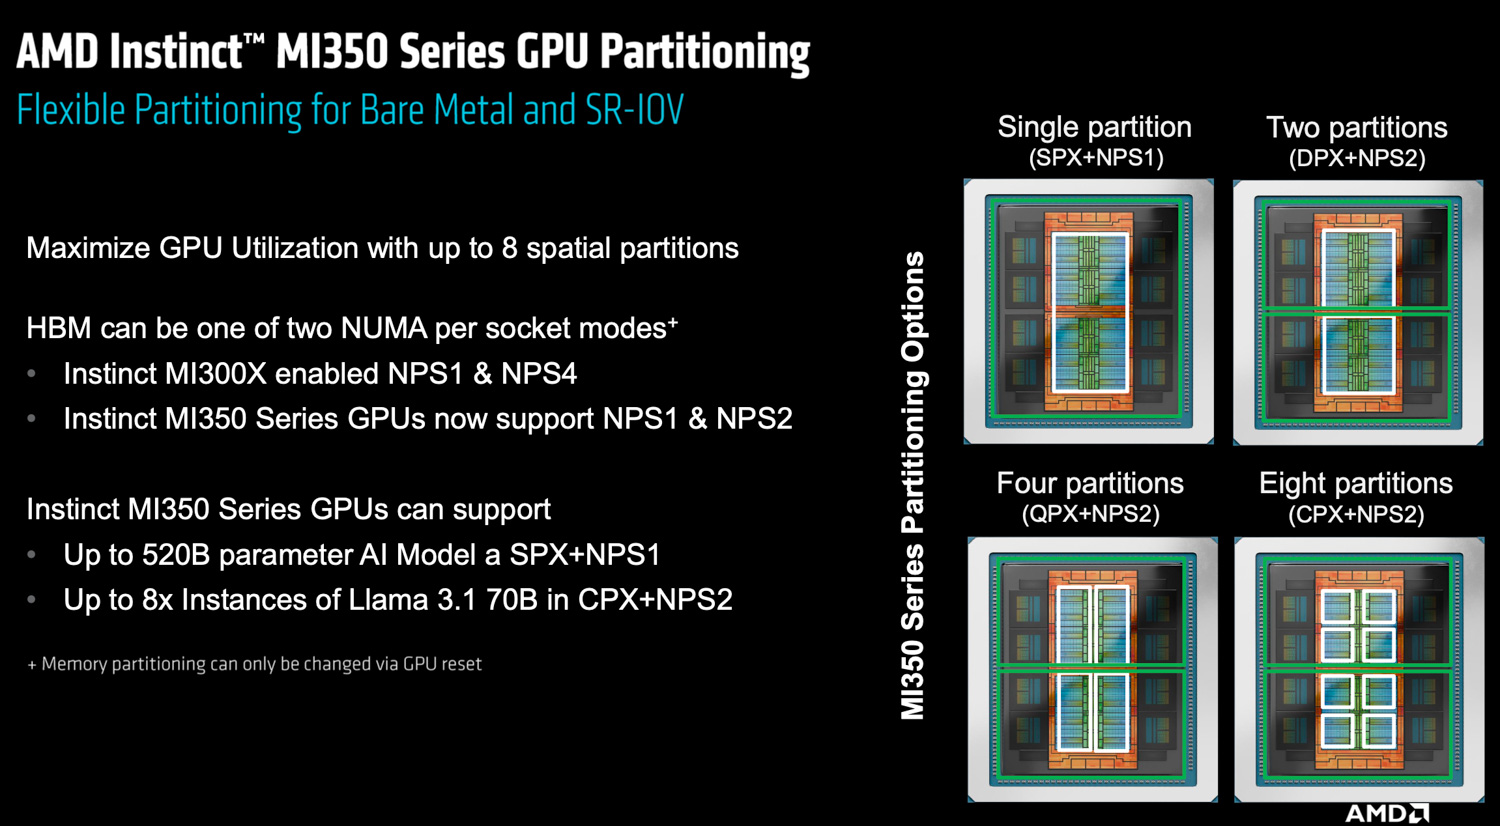
မှတ်ဉာဏ်စီမံခန့်ခွဲမှုအတွက် MI350 သည် အဓိက NUMA (Non-Uniform Memory Access) မုဒ်နှစ်ခုကို ပံ့ပိုးပေးသည်-
- NPS1: HBM stack ရှစ်ခုလုံးတွင် data access ကို interleaved လုပ်ခြင်းဖြင့် 288GB HBM3E memory တစ်ခုလုံးကို တစ်ခုတည်းသော၊ စုစည်းထားသော NUMA domain အဖြစ် ဆက်ဆံသည်။
- NPS2: မှတ်ဉာဏ်ကို သီးခြား NUMA ဒိုမိန်းနှစ်ခုအဖြစ် ပိုင်းခြားပြီး တစ်ခုချင်းစီသည် IOD နှစ်ခုအနက် တစ်ခုနှင့် ၎င်း၏ဆက်စပ် HBM stack လေးခုနှင့် ကိုက်ညီသည်။ NPS2 မုဒ်တွင် IOD တစ်ခုစီအတွင်း မှတ်ဉာဏ်ဝင်ရောက်ခွင့်သည် fine-grained interleaved အဖြစ် ဆက်လက်တည်ရှိနေသော်လည်း IOD များတစ်လျှောက်တွင် coarse-grained ဖြစ်လာသည်။ ဤမုဒ်သည် အထူးသဖြင့် compute partitioning နှင့် ပေါင်းစပ်လိုက်သောအခါ spatial locality အတွက် optimization များကို ဖွင့်ပေးနိုင်သည်။
ထူးခြားသည်မှာ AMD သည် MI350 (MI300 တွင် ရရှိနိုင်ပါသည်) တွင် NPS4 မုဒ်ကို မထောက်ပံ့ရန် ရွေးချယ်ခဲ့သည်။ ယင်းဆုံးဖြတ်ချက်သည် ဗိသုကာပုံစံအသစ်ရှိ IOD နှစ်ခုစီအတွင်း မှတ်ဉာဏ်ချိတ်ဆက်မှု ပိုမိုတင်းကျပ်လာခြင်းကြောင့်ဖြစ်ပြီး၊ ၎င်းသည် နောက်ထပ်မှတ်ဉာဏ်ခွဲဝေမှု၏ အလားအလာရှိသော စွမ်းဆောင်ရည်အကျိုးကျေးဇူးများကို လျော့နည်းစေသည်။
ကွန်ပျူတာဘက်ခြမ်းတွင်၊ GPU ကို အောက်ပါပုံစံအမျိုးမျိုးဖြင့် လုပ်ဆောင်ရန် ပြင်ဆင်သတ်မှတ်နိုင်သည်-
- SPX (Single Partition Execution): GPU သည် တစ်ခုတည်းသော အစွမ်းထက်သော အင်ဂျင်တစ်ခုအဖြစ် လုပ်ဆောင်ပြီး NPS1 မှတ်ဉာဏ်မုဒ်ဖြင့် အသုံးပြုလေ့ရှိသည်။
- DPX၊ QPX၊ OPX (Dual၊ Quad၊ Octal Partition Execution): GPU ကို သီးခြား compute partition နှစ်ခု၊ လေးခု သို့မဟုတ် ရှစ်ခုအဖြစ် အသီးသီး ပိုင်းခြားနိုင်သည်။
ဤ compute partitions များကို NPS1 သို့မဟုတ် NPS2 မှတ်ဉာဏ် configuration များနှင့် တွဲဖက်နိုင်ပြီး၊ compute partition ၏ အသေးစိတ်မှုသည် အနည်းဆုံး မှတ်ဉာဏ် partition ကဲ့သို့ သေးငယ်ရမည် သို့မဟုတ် ပိုမိုကောင်းမွန်ရမည်ဟူသော ကန့်သတ်ချက်ဖြင့်ဖြစ်သည် (ဥပမာ၊ SPX မုဒ်သည် NPS2 မှတ်ဉာဏ် partitioning နှင့် သဟဇာတမဖြစ်ပါ)။
ဤစွယ်စုံရ partitioning option များကို bare-metal deployments များနှင့် SR-IOV (Single Root I/O Virtualization) နှစ်မျိုးလုံးတွင် ပံ့ပိုးပေးထားပြီး virtualized၊ multi-tenant environment များအတွက် အသင့်တော်ဆုံးဖြစ်သည်။ ဥပမာအားဖြင့် cloud သို့မဟုတ် data center setting များတွင် MI350 GPU တစ်ခုတည်းကို user အများအပြား သို့မဟုတ် application များကို တစ်ပြိုင်နက်တည်း ဝန်ဆောင်မှုပေးရန် ယုတ္တိဗေဒအရ segment လုပ်နိုင်သည်။ tenant တစ်ဦးချင်းစီသည် memory နှင့် compute resource များ၏ dedicated slice ကို ရရှိပြီး ဝန်ဆောင်မှုအရည်အသွေးနှင့် လုံခြုံရေးကို သေချာစေပြီး virtual machine အမျိုးမျိုးတွင် GPU hardware ကို သီးခြားဝင်ရောက်ခွင့် လိုအပ်သည့် scenario များအတွက် အထူးတန်ဖိုးရှိသည်။
MI350X နှင့် MI355X: ကွဲပြားသော ဖြန့်ကျက်မှုများအတွက် စိတ်ကြိုက်ပြင်ဆင်ထားသည်
MI350 စီးရီးကို ကွဲပြားသော ဖြန့်ကျက်လိုအပ်ချက်များနှင့် အပူချိန်အလွှာများကို ဖြည့်ဆည်းပေးသည့် အဓိကမျိုးကွဲနှစ်ခုဖြင့် မိတ်ဆက်ထားသည်-
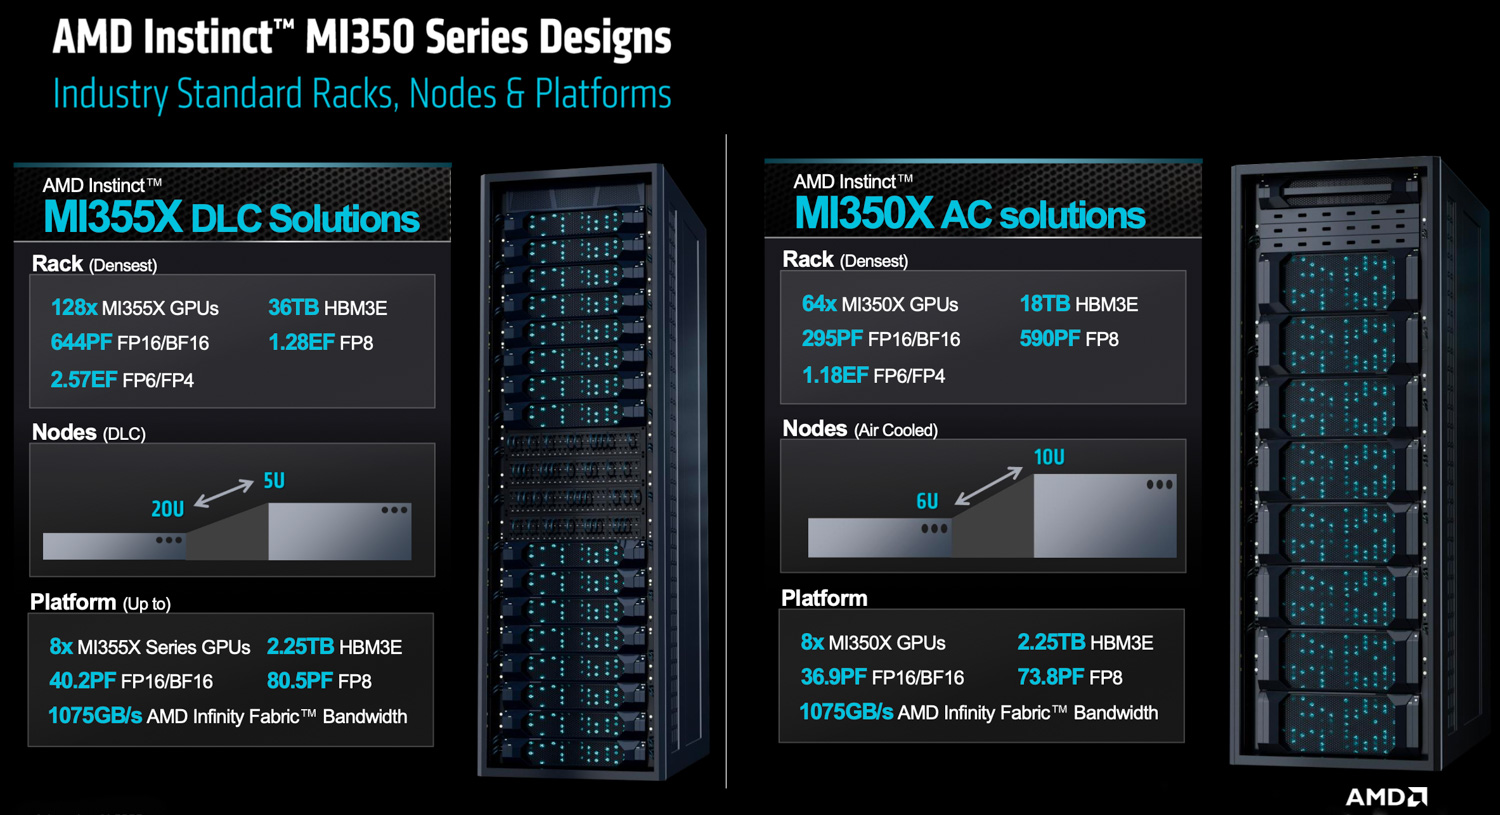
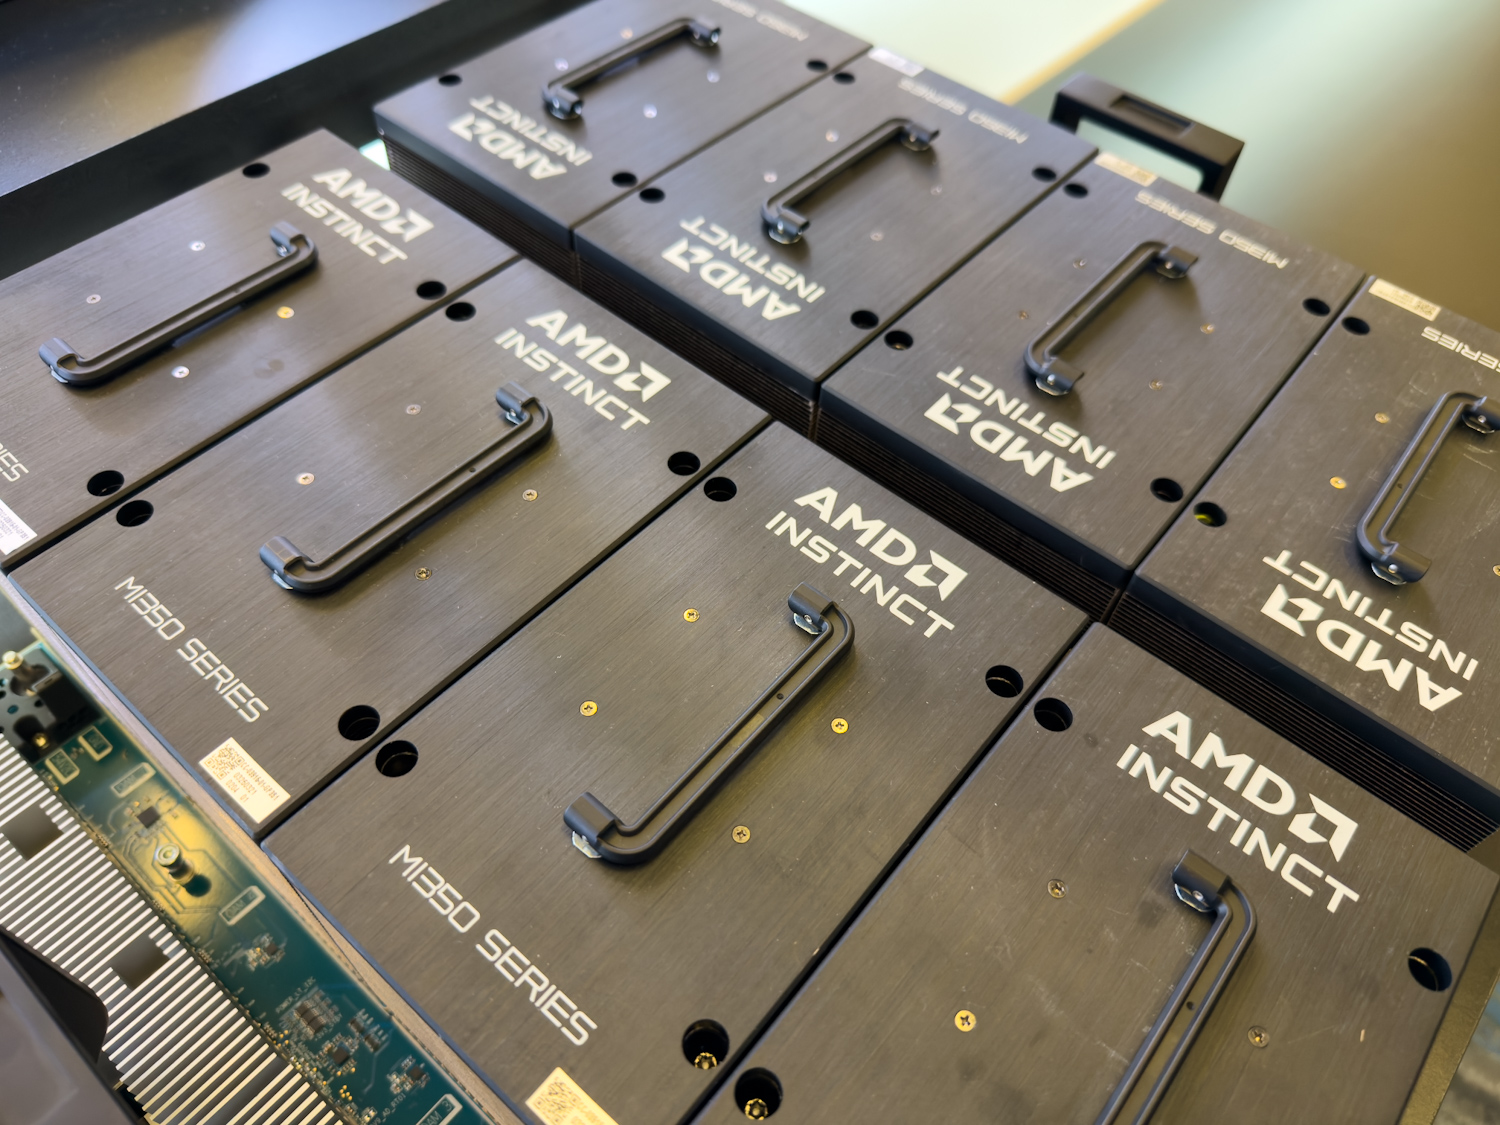
- MI350X: ဤဗားရှင်းကို ပါဝါသုံးစွဲမှု နည်းပါးစေရန် ဒီဇိုင်းထုတ်ထားပြီး တစ်ကီလိုဝပ်အထိ Thermal Design Power (TDP) ရှိသည်။ ၎င်းသည် လေအေးပေးစနစ်ဖြင့် ဖြန့်ကျက်မှုများကို ပံ့ပိုးပေးပြီး ရှိပြီးသားဒေတာစင်တာ အခြေခံအဆောက်အအုံများအတွင်း ပိုမိုကျယ်ပြန့်သော တွဲဖက်အသုံးပြုနိုင်မှုကို ပေးဆောင်သည်။
- MI355X: 1.4 kilowatts TDP အထိ မြင့်မားသော စနစ်ပါဝါဖြင့် လည်ပတ်သည့် MI355X သည် အဓိကအားဖြင့် အရည်ဖြင့်အအေးပေးစနစ် ဖြန့်ကျက်မှုများကို ရည်ရွယ်ပြီး အမြင့်ဆုံးစွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်သည်။
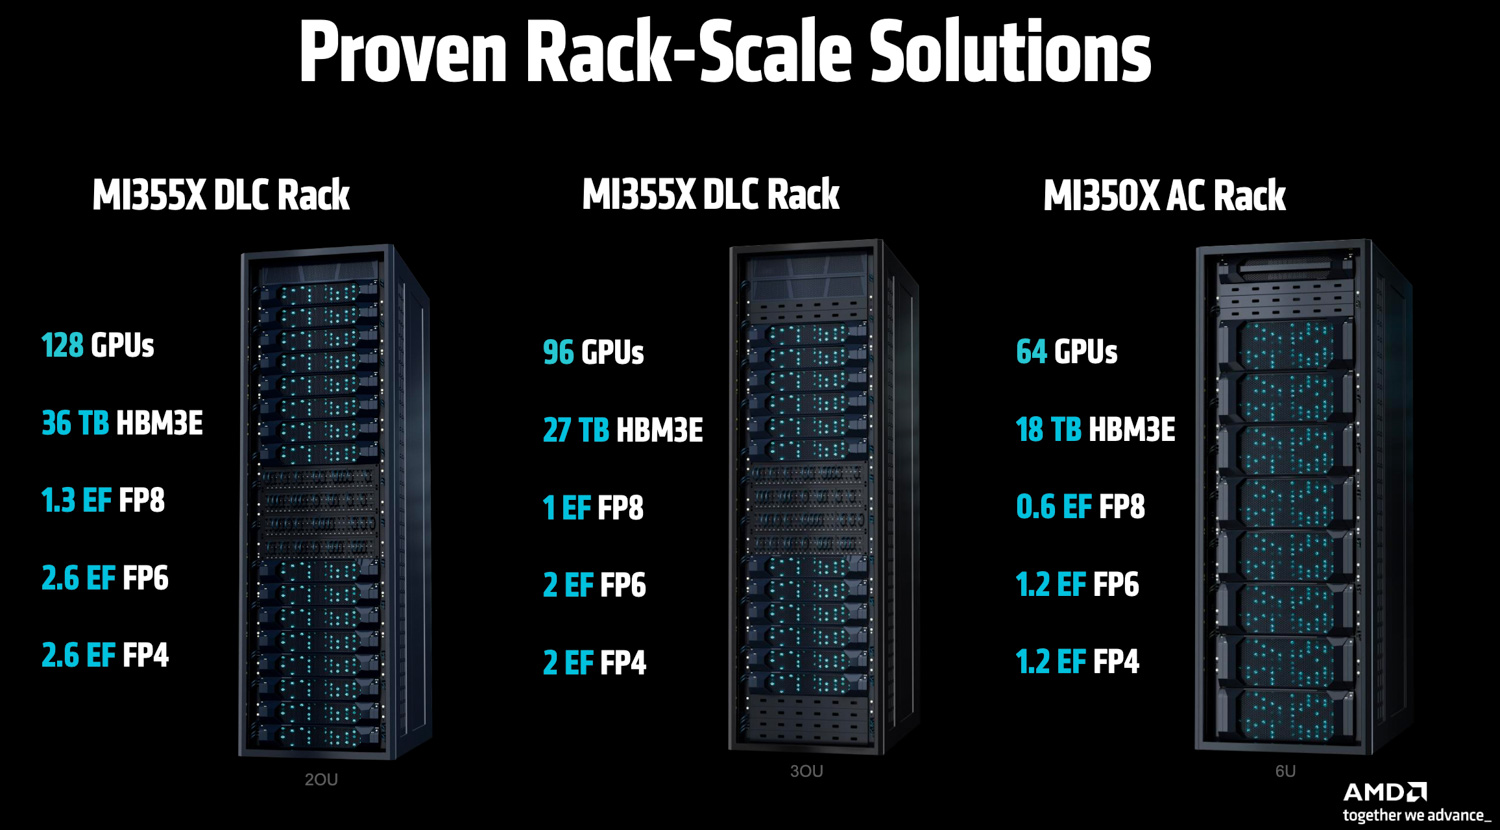
ဗားရှင်းနှစ်မျိုးလုံးကို အခြေခံဟာ့ဒ်ဝဲတစ်ခုတည်းပေါ်တွင် တည်ဆောက်ထားသော်လည်း MI355X ၏ မြင့်မားသောလည်ပတ်မှုပါဝါအဖုံးသည် ပိုမိုမြင့်မားသော clock frequencies များကို ခွင့်ပြုသည်။ ၎င်းသည် MI350X နှင့်နှိုင်းယှဉ်ပါက လက်တွေ့ကမ္ဘာ၊ end-to-end workloads များတွင် ခန့်မှန်းခြေအားဖြင့် 20% စွမ်းဆောင်ရည်အားသာချက်ကို ဘာသာပြန်ပေးသည်။ ၎င်းတို့ကို အတည်ပြုထားသော rack configuration သုံးမျိုးဖြင့် ရရှိနိုင်ပါသည်။
AMD Pensando Pollara ကွန်ရက်ချိတ်ဆက်ခြင်း။
GPU အသစ်များအပြင်၊ AMD သည် ၎င်း၏ Pollara Networking ဖြေရှင်းချက်များကို နက်နက်နဲနဲ လေ့လာခဲ့ပြီး ကြီးမားသော ဉာဏ်ရည်တုစနစ်များ၏ တိုးပွားလာသော လိုအပ်ချက်များကို ဖြည့်ဆည်းရန် ဒီဇိုင်းထုတ်ထားသော သိသာထင်ရှားသော ဗိသုကာဆိုင်ရာ တိုးတက်မှုများကို ပြသခဲ့သည်။ AMD ၏ Pensando ဝယ်ယူမှုမှ နည်းပညာပေါ်တွင် တည်ဆောက်ထားသော Pollara 400 AI NIC သည် AI ကွန်ရက်အထည်အလိပ်များအတွက် ပရိုဂရမ်ရေးသားနိုင်စွမ်းနှင့် ဉာဏ်ရည်ဉာဏ်သွေး အဆင့်သစ်တစ်ခုကို မိတ်ဆက်ပေးခဲ့သည်။

Pollara ရဲ့ ဆန်းသစ်တီထွင်မှုရဲ့ အဓိကအချက်ကတော့ programmable architecture မှာ တည်ရှိပါတယ်။ fixed-function hardware နဲ့ မတူဘဲ၊ Pollara NIC မှာ P4-programmable MPU core ပါရှိပါတယ်။ AI networking လိုအပ်ချက်တွေဟာ အဆက်မပြတ်ပြောင်းလဲနေပြီး protocol အသစ်တွေ၊ transport mechanism တွေနဲ့ telemetry လိုအပ်ချက်တွေ အလျင်အမြန် ပေါ်ပေါက်လာနေတာကြောင့် ဒီဒီဇိုင်းက အရေးကြီးပါတယ်။ Programmability က Pollara NIC ကို software update တွေကနေတစ်ဆင့် လိုက်လျောညီထွေဖြစ်အောင် လုပ်ဆောင်နိုင်စေပြီး custom traffic management schemes တွေ၊ novel load balancing algorithms တွေနဲ့ hardware အစားထိုးစရာမလိုဘဲ congestion control mechanism တွေကို ဖြန့်ကျက်နိုင်အောင် ခွင့်ပြုပေးပါတယ်။ ဒီပြောင်းလွယ်ပြင်လွယ်ရှိမှုဟာ အနာဂတ်အတွက် သင့်တော်တဲ့ AI data center တွေနဲ့ workload တွေရဲ့ ပြောင်းလဲနေတဲ့ ဝိသေသလက္ခဏာတွေကို လျင်မြန်စွာ တုံ့ပြန်နိုင်ဖို့ အရေးကြီးပါတယ်။
အဖြစ်များသော ကွန်ရက်ပိတ်ဆို့မှုများကို ဖြေရှင်းရန်အတွက် Pollara သည် multicast ကို မိတ်ဆက်ပေးသည်။ GPU-to-GPU ဆက်သွယ်မှုအတွက် တစ်ခုတည်းသော ချိတ်ဆက်မှုမှ ဒေတာကို ရုပ်ပိုင်းဆိုင်ရာ ကွန်ရက်လင့်ခ်များစွာတွင် တစ်ပြိုင်နက်တည်း ဖြန့်ဝေနိုင်သည်။ ဤချဉ်းကပ်မှုသည် မည်သည့်လမ်းကြောင်းတစ်ခုတည်းတွင်မဆို ပိတ်ဆို့မှုကို ကာကွယ်ခြင်းဖြင့် ကွန်ရက်အသုံးပြုမှုနှင့် throughput အလုံးစုံကို မြှင့်တင်ပေးသည်။ NIC ကိုယ်တိုင်က ဤဖြန့်ဝေမှု၏ ရှုပ်ထွေးမှုများကို စီမံခန့်ခွဲပြီး ဦးတည်ရာသို့ အစီအစဉ်မကျ ရောက်ရှိနိုင်သော packet များကို ပြန်လည်စီစဉ်ခြင်း အပါအဝင်ဖြစ်သည်။
ပြန်လည်ထုတ်လွှင့်မှုများအတွက် ရွေးချယ်ထားသော အသိအမှတ်ပြုမှုမှတစ်ဆင့် ကွန်ရက်ထိရောက်မှုကို မြှင့်တင်ပေးသည်။ ရိုးရာကွန်ရက်များတွင် တစ်ခုတည်းသော packet ဆုံးရှုံးခြင်းသည် ကျယ်ပြန့်သောဒေတာအစီအစဉ်၏ ပြန်လည်ထုတ်လွှင့်မှုကို ဖြစ်ပေါ်စေနိုင်သည်။ Pollara သည် ပျောက်ဆုံးသွားသော packet များကိုသာ ပြန်လည်ထုတ်လွှင့်သည့် ပိုမိုတိကျသောနည်းလမ်းကိုလည်း အကောင်အထည်ဖော်သည်။ ၎င်းသည် ကွန်ရက်ပေါ်ရှိ မလိုအပ်သောဒေတာကို သိသိသာသာလျှော့ချပေးပြီး ထိရောက်သော bandwidth ကို တိုးတက်စေသည်။ Pollara ကွန်ရက်ဖြေရှင်းချက်ကို lossy ချိတ်ဆက်မှုများပါ၀င်သည့် မတူညီသောကွန်ရက်ပတ်ဝန်းကျင်များတွင် ခိုင်မာသောလည်ပတ်မှုအတွက်လည်း ဒီဇိုင်းထုတ်ထားသည်။ ၎င်းတွင် ခေတ်မီပြီး ပရိုဂရမ်ရေးသားနိုင်သော နှင့် လမ်းကြောင်းကို သိရှိနိုင်သော ပိတ်ဆို့မှုထိန်းချုပ်မှုတို့ ပါဝင်သည်။ ဤစွမ်းရည်သည် ခေတ်မီ AI cluster များမှ လိုအပ်သော ကြီးမားသောစကေးများတွင် အကောင်အထည်ဖော်ရန်နှင့် ထိန်းသိမ်းရန် ရှုပ်ထွေးပြီး ကုန်ကျစရိတ်များနိုင်သည့် ပြီးပြည့်စုံသော lossless ကွန်ရက် fabrics များအပေါ် မှီခိုမှုကို လျှော့ချပေးသည်။

AMD သည် Ultra Ethernet Consortium တွင် တက်ကြွစွာပါဝင်သူတစ်ဦးဖြစ်ပြီး ၎င်း၏စံနှုန်းများတွင် ပါဝင်ကူညီအကောင်အထည်ဖော်လျက်ရှိသည်။ UEC သည် ထိရောက်သော load balancing၊ မြှင့်တင်ထားသောယုံကြည်စိတ်ချရမှုနှင့် AI-specific congestion control တို့ကို အဓိကထား၍ AI အတွက် အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ထားသော နောက်မျိုးဆက် Ethernet ကို သတ်မှတ်ရန် ရည်ရွယ်သည်။ ဤပွင့်လင်းသောစံနှုန်းများကို လိုက်နာခြင်းသည် အပြန်အလှန်လုပ်ဆောင်နိုင်မှုကို မြှင့်တင်ပေးပြီး ပိုမိုကျယ်ပြန့်သောဂေဟစနစ်ကို မြှင့်တင်ပေးသည်။
နောက်ဆုံးအနေနဲ့ Pollara နည်းပညာကို AMD ရဲ့ ပိုမိုကျယ်ပြန့်တဲ့ ပလက်ဖောင်းအတွင်း ပေါင်းစပ်လုပ်ဆောင်မှုအတွက် ဒီဇိုင်းထုတ်ထားပြီး CPU၊ GPU နဲ့ NIC အစိတ်အပိုင်းတွေမှာ ပူးတွဲတီထွင်ဆန်းသစ်မှုကို ဖြစ်စေပါတယ်။ ၎င်းမှာ NIC က သတ်မှတ်ထားတဲ့ ကွန်ရက်-အလေးပေး ဆက်သွယ်ရေးတာဝန်တွေ (GPU တွက်ချက်မှု မလိုအပ်တဲ့ တာဝန်တွေကို) ကိုင်တွယ်တဲ့ collective operation offload လိုမျိုး စွမ်းရည်တွေ ပါဝင်ပါတယ်။ ဒါက သူတို့ရဲ့ အဓိက processing တာဝန်တွေအတွက် GPU အရင်းအမြစ်တွေကို လွတ်လပ်စေပါတယ်။
ROCm 7: အဆင့်မြင့် AI အတွက် ပွင့်လင်းသော ဆော့ဖ်ဝဲ ဂေဟစနစ်
ဤဟာ့ဒ်ဝဲဆန်းသစ်တီထွင်မှုများကို အခြေခံထားသည်မှာ AMD ၏ open software platform ၏ နောက်ဆုံးပေါ်ဆင့်ကဲဖြစ်စဉ်ဖြစ်သည့် ROCm 7 ၏ကြေငြာချက်ဖြစ်သည်။ သြဂုတ်လတွင် အပြည့်အဝထွက်ရှိမည့် ROCm 7 မတိုင်မီ ယနေ့တွင် အများပြည်သူအတွက် ကြိုတင်ကြည့်ရှုရန် စီစဉ်ထားပြီး ROCm 7 သည် ၎င်း၏ယခင်ဟာ့ဒ်ဝဲနှင့် နှိုင်းယှဉ်ပါက ရှိပြီးသားဟာ့ဒ်ဝဲပေါ်တွင် inference နှင့် training စွမ်းဆောင်ရည်တွင် အံ့မခန်း ၃ ဆ မှ ၃.၅ ဆ အထိ တိုးတက်မှုရှိကြောင်း AMD က သတင်းပို့ထားသည်။
Enterprise client များအတွက် AMD သည် ROCm AI Enterprise ကို မိတ်ဆက်လိုက်ပါသည်။ ၎င်းသည် cluster management၊ MLOps နှင့် application-building tools များကို ကြီးမားသော deployment များအတွက် ပေးဆောင်သည့် ပြီးပြည့်စုံသော suite တစ်ခုဖြစ်ပါသည်။ တစ်ချိန်တည်းမှာပင်၊ AMD သည် developer များအတွက် developer cloud အသစ်ဖြင့် အခမဲ့ GPU credit များဖြင့် access ကို ပေးဆောင်နေပါသည်။ ဤ accessibility အတွက် ဤတွန်းအားပေးမှုသည် ပိုမိုကျယ်ပြန့်လာပြီး ROCm 7 သည် Windows ကိုအသုံးပြုသော laptop များနှင့် workstation များအပါအဝင် client device များအတွက် support ကို တရားဝင်တိုးချဲ့ပေးခြင်းဖြင့် developer များသည် AMD ecosystem တစ်ခုလုံးတွင် AI application များကို ချောမွေ့စွာတည်ဆောက်ပြီး စမ်းသပ်နိုင်ကြောင်း သေချာစေပါသည်။
ရှေ့ကိုအဆိုပါလမ်းမ
AMD သည် ၎င်း၏ MI350 စီးရီးထက်ကျော်လွန်သော ထုတ်ကုန်လမ်းပြမြေပုံဖြင့် နှစ်စဉ် မြန်ဆန်သော ဆန်းသစ်တီထွင်မှု သံသရာအတွက် ရည်စူးထားသည်။

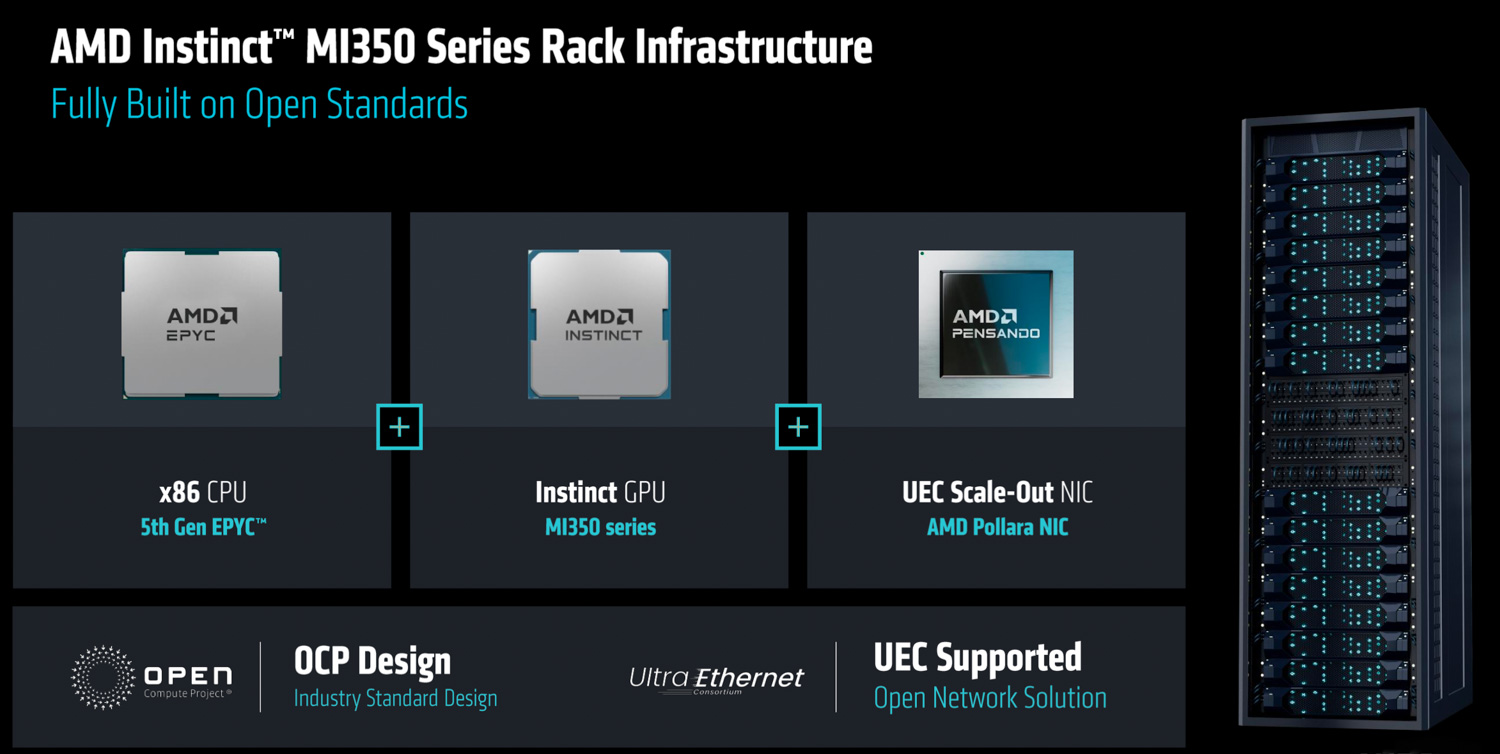
၂၀၂၆ ခုနှစ်တွင် ပစ်မှတ်ထား မိတ်ဆက်ရန် မျှော်မှန်းထားသည့် AMD သည် MI400 စီးရီးကို တီထွင်နေပြီး ၎င်းသည် Helios ဟု ကုဒ်ဝှက်ထားသော အပြည့်အဝပေါင်းစပ်ထားသော၊ rack-scale ဖြေရှင်းချက်၏ အဓိကအချက်ဖြစ်လာမည်ဖြစ်သည်။ ဤပလက်ဖောင်းကို ခေတ်မီ AI မော်ဒယ်များကို လေ့ကျင့်ပေးရန်နှင့် ကြီးမားသော ဖြန့်ဝေထားသော ကောက်ချက်ချမှုတာဝန်များကို စီမံခန့်ခွဲရန် အထူးဒီဇိုင်းထုတ်ထားသည်။ Helios စနစ်သည် ပေါင်းစပ်ထားသော AMD ပလက်ဖောင်းတစ်ခုဖြစ်မည်ဖြစ်ပြီး Venice ဟု ကုဒ်ဝှက်ထားသော အနာဂတ် EPYC CPU များ၊ Instinct MI400 GPU များနှင့် နောက်မျိုးဆက် Pensando ကွန်ရက်၊ အထူးသဖြင့် Vulcano 800G AI NIC တို့ ပါဝင်သည်။ အလိုအလျောက် ဖြန့်ကျက်မှုနှင့် စီမံခန့်ခွဲမှုအတွက် သီးသန့် Fabric Manager အပါအဝင် ပြည့်စုံသော ROCm software stack သည်လည်း ဤဖြေရှင်းချက်၏ တစ်စိတ်တစ်ပိုင်းဖြစ်လိမ့်မည်။ open standard များကို အလေးပေးဖော်ပြထားသည့် Helios rack သည် OCP သတ်မှတ်ချက်များနှင့် ကိုက်ညီမည်ဖြစ်သည်။ ၎င်းသည် rack များအကြား ကွန်ရက်ချိတ်ဆက်မှုကို ချဲ့ထွင်ရန်အတွက် Ultra Ethernet (UEC) ကို အသုံးပြုမည်ဖြစ်ပြီး rack တစ်ခုတည်းအတွင်း ဆက်သွယ်ရေးကို ချဲ့ထွင်ရန်အတွက် Ultra Accelerator Link (UAL 1.0) ကို မိတ်ဆက်ပေးမည်ဖြစ်သည်။

Instinct MI400 GPU ကိုယ်တိုင်က အလွန်ကြီးမားတဲ့ AI အပလီကေးရှင်းတွေအတွက် ရည်ရွယ်ချက်ရှိရှိ တည်ဆောက်ထားတာပါ။ ကနဦး သတ်မှတ်ချက်များအရ FP4 စွမ်းဆောင်ရည် 40 PetaFLOPS နှင့် FP8 စွမ်းဆောင်ရည် 20 PetaFLOPS အပါအဝင် အထင်ကြီးလောက်စရာ စွမ်းရည်တွေကို ဖော်ပြထားပါတယ်။ GPU တစ်ခုစီမှာ HBM မှတ်ဉာဏ် 432 gigabytes ပါဝင်ပြီး HBM မှတ်ဉာဏ် bandwidth 20TB/s ခန့်ကို ပေးစွမ်းနိုင်ပြီး scale-out bandwidth 300 Gigabits per Second ကို ပေးစွမ်းနိုင်ပါတယ်။ GPU ကို ဖြည့်စွက်ပေးတဲ့အပြင် Vulcano 800G AI NIC ဟာ UEC-ready ဖြစ်ပြီး PCIe Gen6 နဲ့အတူ UAL ကို ပံ့ပိုးပေးမှာဖြစ်ပြီး UAL ဟာ PCIe Gen6 ထက် bandwidth နှစ်ဆပိုပေးစွမ်းမှာပါ။ ဒီ NIC ဟာ ယခင် Polara မျိုးဆက်နဲ့ နှိုင်းယှဉ်ရင် GPU တစ်ခုလျှင် scale-out bandwidth ရှစ်ဆအထိ ပေးစွမ်းနိုင်မယ်လို့ မျှော်လင့်ရပါတယ်။ AMD မှာ Helios rack solution အတွက် ရည်မှန်းချက်ကြီးကြီးမားမား ရှိပြီး MI355 နဲ့ နှိုင်းယှဉ်ရင် အဆင့်မြင့်ဆုံး frontier မော်ဒယ်တွေမှာ AI စွမ်းဆောင်ရည် ဆယ်ဆအထိ ပေးစွမ်းနိုင်မယ်လို့ ခန့်မှန်းထားပါတယ်။ ၂၀၂၆ ခုနှစ်တွင် Vera Rubin နှင့် ယှဉ်ပြိုင်ရာတွင် Helios သည် ယှဉ်ပြိုင်နိုင်သော raw FLOPS များ၊ HBM စွမ်းရည် ၅၀% ပိုများခြင်း၊ HBM မှတ်ဉာဏ် bandwidth ၅၀% ပိုများခြင်းနှင့် scale-out bandwidth ၅၀% အထိ ပေးဆောင်ရန် ရည်ရွယ်ထားသည်။
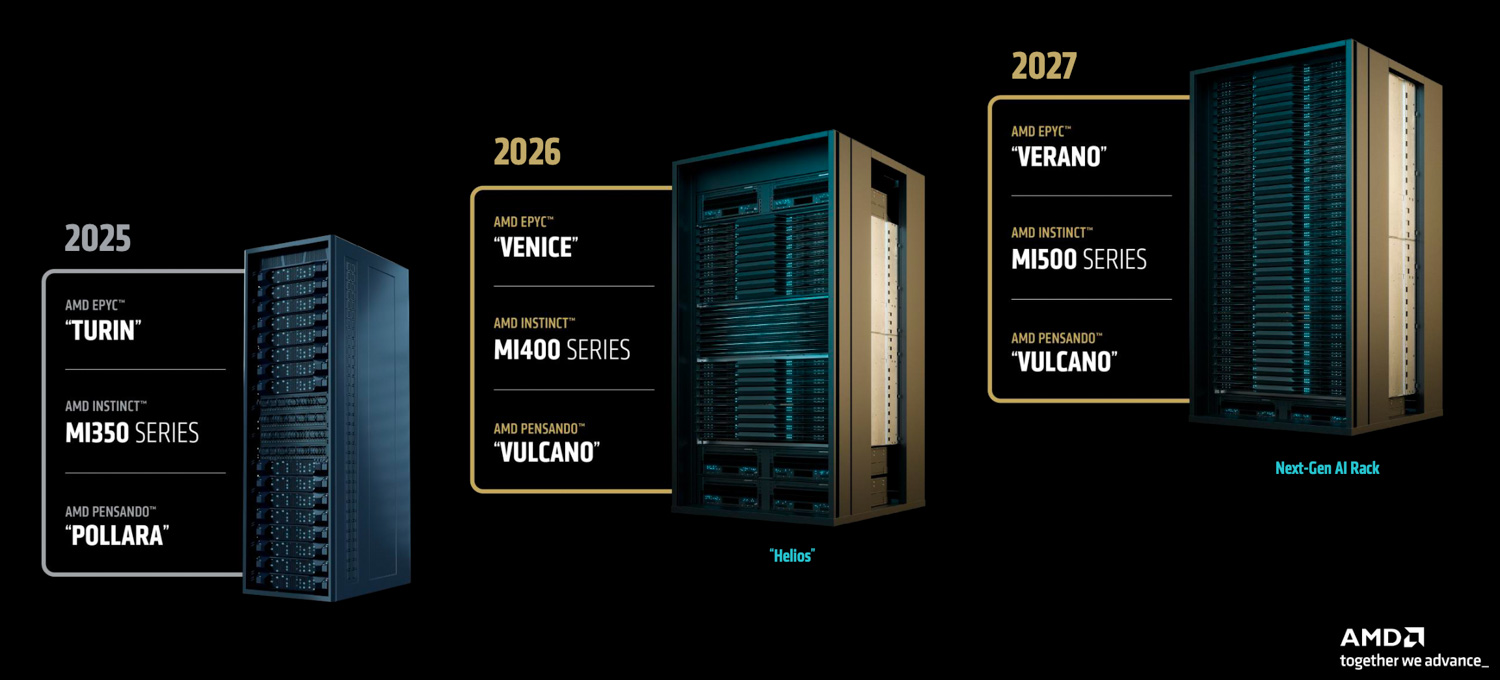
AMD ရဲ့ လမ်းပြမြေပုံဟာ ပိုပြီး ကျယ်ပြန့်လာပြီး MI500 စီးရီးနဲ့ နောက်ဆက်တွဲ rack-scale architectures တွေအတွက် ဖွံ့ဖြိုးတိုးတက်မှုကို ကောင်းကောင်း လုပ်ဆောင်နေပြီဖြစ်ပြီး ၂၀၂၇ ခုနှစ်နဲ့ နောက်ပိုင်းမှာလည်း လုပ်ဆောင်သွားဖို့ စီစဉ်ထားပါတယ်။ ဒီအနာဂတ်ပလက်ဖောင်းတွေဟာ MI500 စီးရီးကို Verano လို့ ကုဒ်ဝှက်ထားတဲ့ နောက်မျိုးဆက် EPYC CPU တွေနဲ့ Pensando ကွန်ရက်နည်းပညာမှာ နောက်ထပ်တိုးတက်မှုတွေနဲ့အတူ ပေါင်းစပ်သွားမှာပါ။ ဒါပေမယ့် အပိုဆောင်းအချက်အလက်တွေကိုတော့ ပွဲမှာ ထုတ်ဖော်ပြောကြားခြင်း မရှိပါဘူး။


 အမေဇုံ