

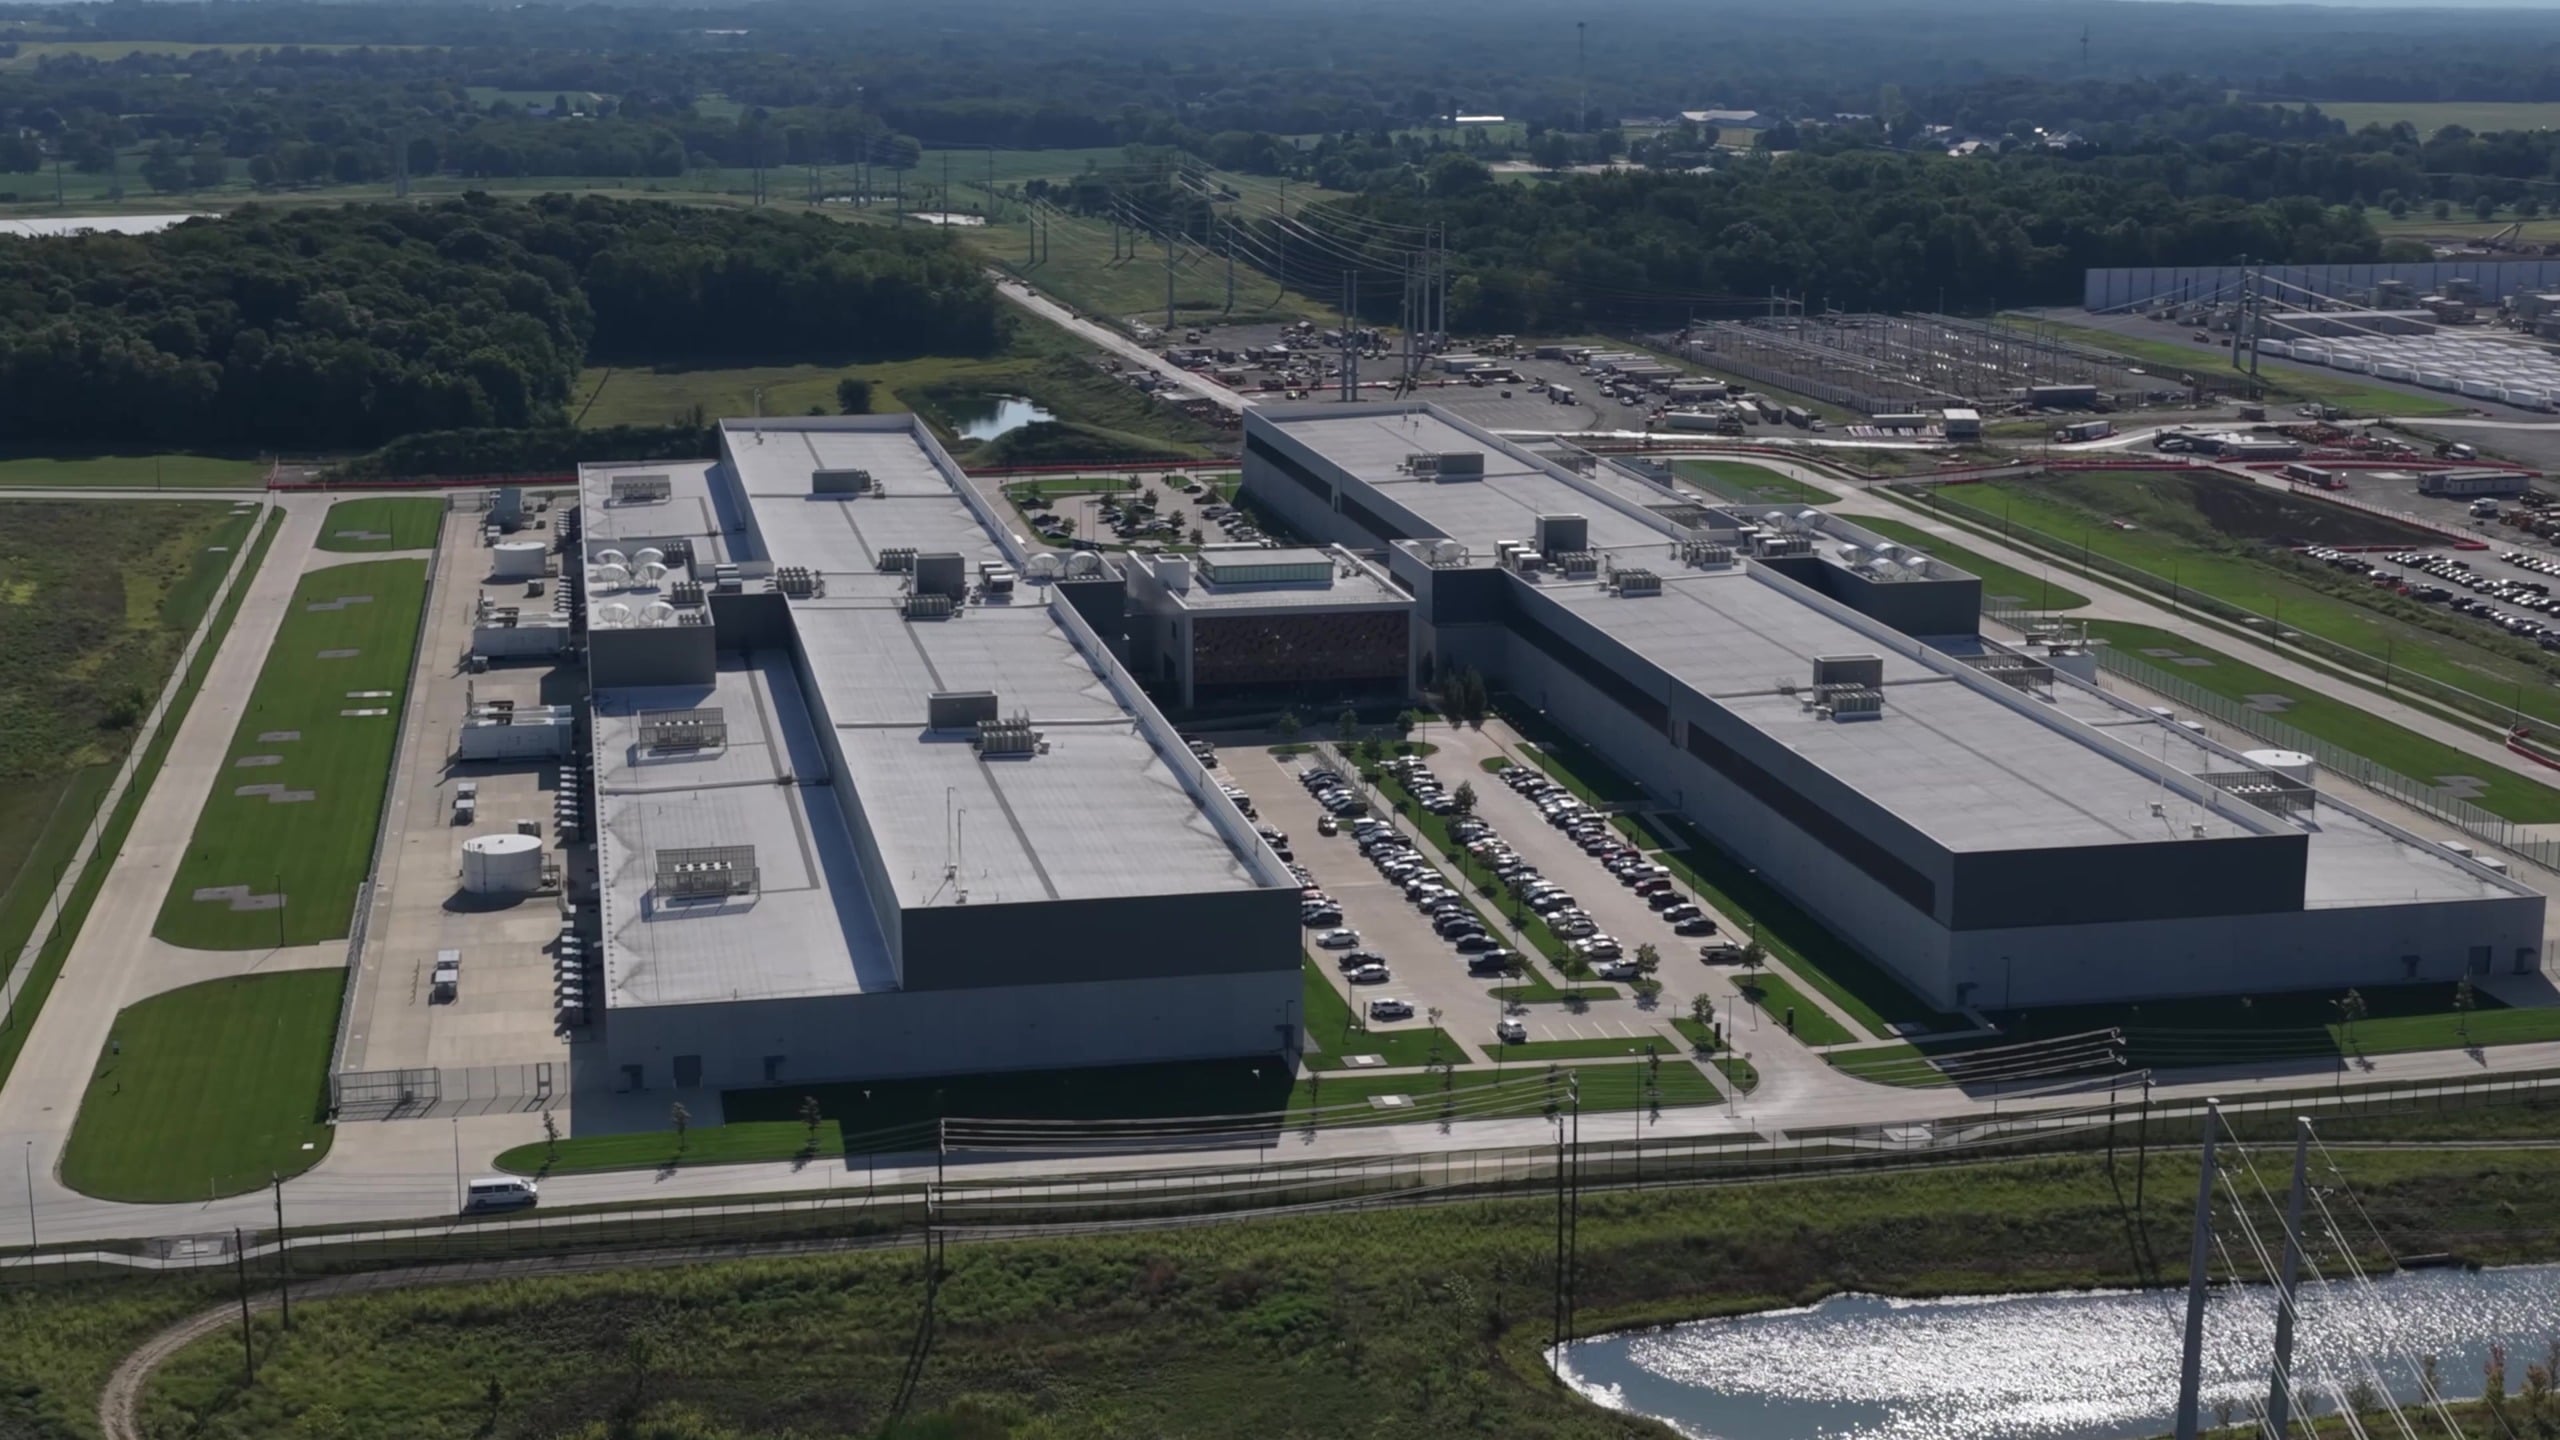
Meta သည် အိုဟိုင်းယိုးပြည်နယ်၊ နယူးအယ်လ်ဘာနီတွင် တည်ဆောက်နေသော gigawatt-scale AI supercluster ၏ Prometheus အတွင်းပိုင်း အသေးစိတ်အချက်အလက်များကို ယနေ့ထုတ်ပြန်ခဲ့သည်။ ပထမအဆင့်ပြီးစီးသွားပြီဖြစ်ပြီး Muse Wonder မော်ဒယ်များအပါအဝင် Muse မိသားစု၏ foundation မော်ဒယ်များကို လေ့ကျင့်ပေးခဲ့ပြီးဖြစ်ပြီး Meta သည် ထိုဆိုက်ကို GPU ၁ သန်းခန့်အထိ တိုးချဲ့နေကြောင်း ပြောကြားခဲ့သည်။ လွန်ခဲ့သော နှစ်နှစ်က ထိုကျောင်းဝင်းသည် ဝဘ်အသွားအလာကို ဝန်ဆောင်မှုပေးသော ရိုးရာဒေတာစင်တာတစ်ခုဖြစ်သည်။ Meta အင်ဂျင်နီယာများဖြစ်သည့် Kevin Lee၊ Yashar Bayani၊ Ahmed Sharif နှင့် Yee Jiun Song တို့၏ ပို့စ်တွင် လေ့ကျင့်ရေးအလုပ်များကို ဆက်လက်လည်ပတ်စေသည့် hardware၊ network နှင့် ယုံကြည်စိတ်ချရမှုဆိုင်ရာလုပ်ငန်းတို့ကို လွှမ်းခြုံထားသည်။
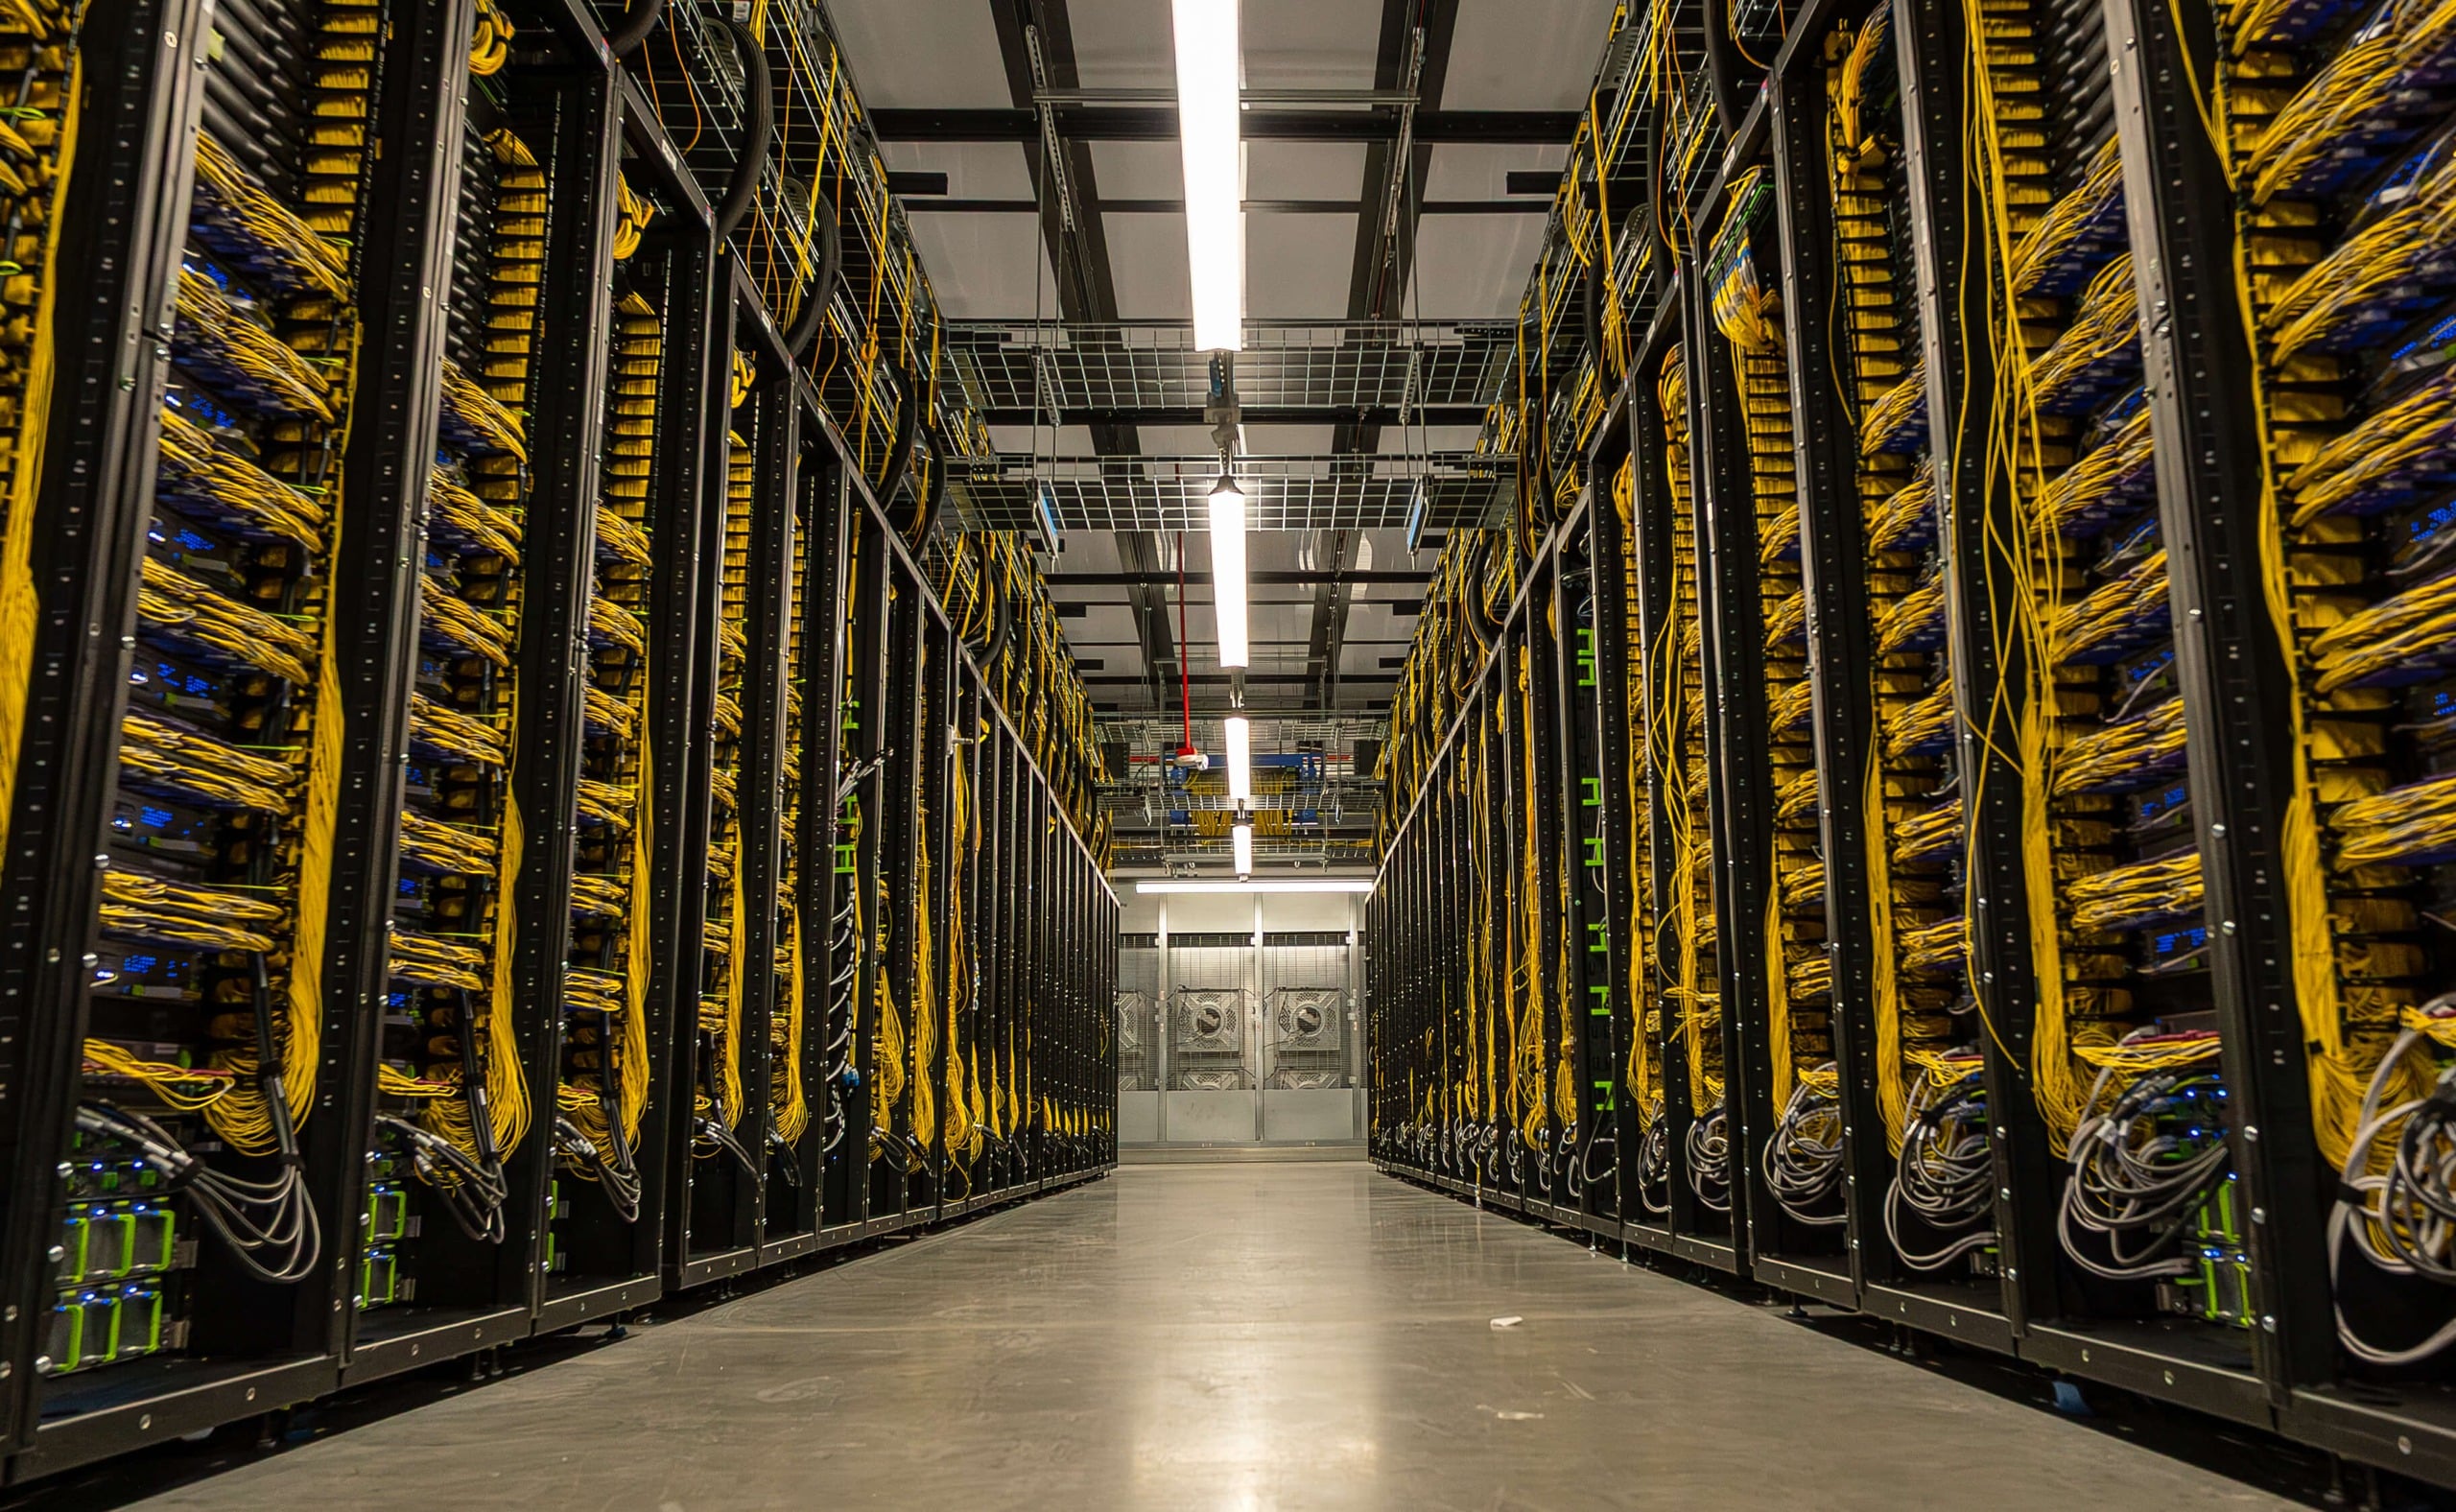
Meta သည် လေ့ကျင့်ရေးအလုပ်ကြီးများကို လုပ်ဆောင်ခြင်းနှင့်ပတ်သက်သည့် စိတ်ဝင်စားဖွယ်အကောင်းဆုံးဒေတာအချို့ကိုလည်း ထုတ်ဖော်ပြသခဲ့သည်- ယုံကြည်စိတ်ချရမှုကိန်းဂဏန်းများ။ Meta သည် Muse Wonder လေ့ကျင့်မှုမတိုင်မီ လုပ်ဆောင်မှုများတွင် ၈၅ ရာခိုင်နှုန်းကျော်နှင့် reinforcement learning လုပ်ဆောင်မှုများတွင် ၉၀ ရာခိုင်နှုန်းကျော် goodput ကို အစီရင်ခံထားပြီး၊ ထိုလုပ်ဆောင်မှုများအတွင်း GPU နာရီ ၄၇,၀၀၀ ခန့် အနှောင့်အယှက်များကြားတွင် wall-clock ပျမ်းမျှအချိန်ရှိသည်။ ထိုအချိန်မှစ၍ Firmware ပြင်ဆင်မှုများ စတင်လိုက်သောကြောင့် MTBI ကို GPU နာရီ ၅၄,၀၀၀ ကျော်သို့ တွန်းပို့ခဲ့သည်။ Meta ၏ ဖော်ပြထားသောပစ်မှတ်မှာ တစ်နေ့လျှင် GPU ၈,၀၀၀ လျှင် အနှောင့်အယှက်နှစ်ခုဖြစ်ပြီး အနှောင့်အယှက်များကြားတွင် GPU နာရီ ၁၀၀,၀၀၀ ခန့်ရှိသည်။
NVL72 မျိုးဆက်နှစ်ခု ထုတ်လုပ်နေပြီး၊ နောက်တစ်ခုကတော့ Vera Rubin ပါ။
Prometheus သည် ယနေ့ NVIDIA GPU ပလက်ဖောင်းနှစ်ခုကို လုပ်ဆောင်နေပြီး နှစ်ခုစလုံးသည် NVL72 rack architecture ပေါ်တွင် တည်ဆောက်ထားပြီး GPU ၇၂ ခုသည် NVLink domain တစ်ခုကို မျှဝေအသုံးပြုထားပြီး တတိယတစ်ခုသည် Vera Rubin NVL72 ကို အခြေခံထားသည့် မကြာမီ ရောက်ရှိလာတော့မည်ဖြစ်သည်။ Meta ဟုခေါ်သော ပထမတစ်ခုသည် Catalina ဟုခေါ်ပြီး Ariel ဗားရှင်းတွင် GB200 NVL72 ကို အသုံးပြုထားသည်- Meta ၏ Open Rack V3 ပါဝါမြင့် rack ဒီဇိုင်းပေါ်တွင် တည်ဆောက်ထားသော rack တစ်ခုလျှင် GPU ၃၆ ခုပါသည့် two-rack configuration သည် Open Compute Project ကို အထောက်အကူပြုခဲ့သည်။ Blackwell GPU တစ်ခုစီသည် Grace CPU တစ်ခုနှင့် ConnectX-7 400G NIC နှစ်ခုနှင့် တွဲဖက်အသုံးပြုထားပြီး 1:1 CPU-to-GPU အချိုးသည် GPU တစ်ခုစီကို scale-out bandwidth 800G ပေးသည်။
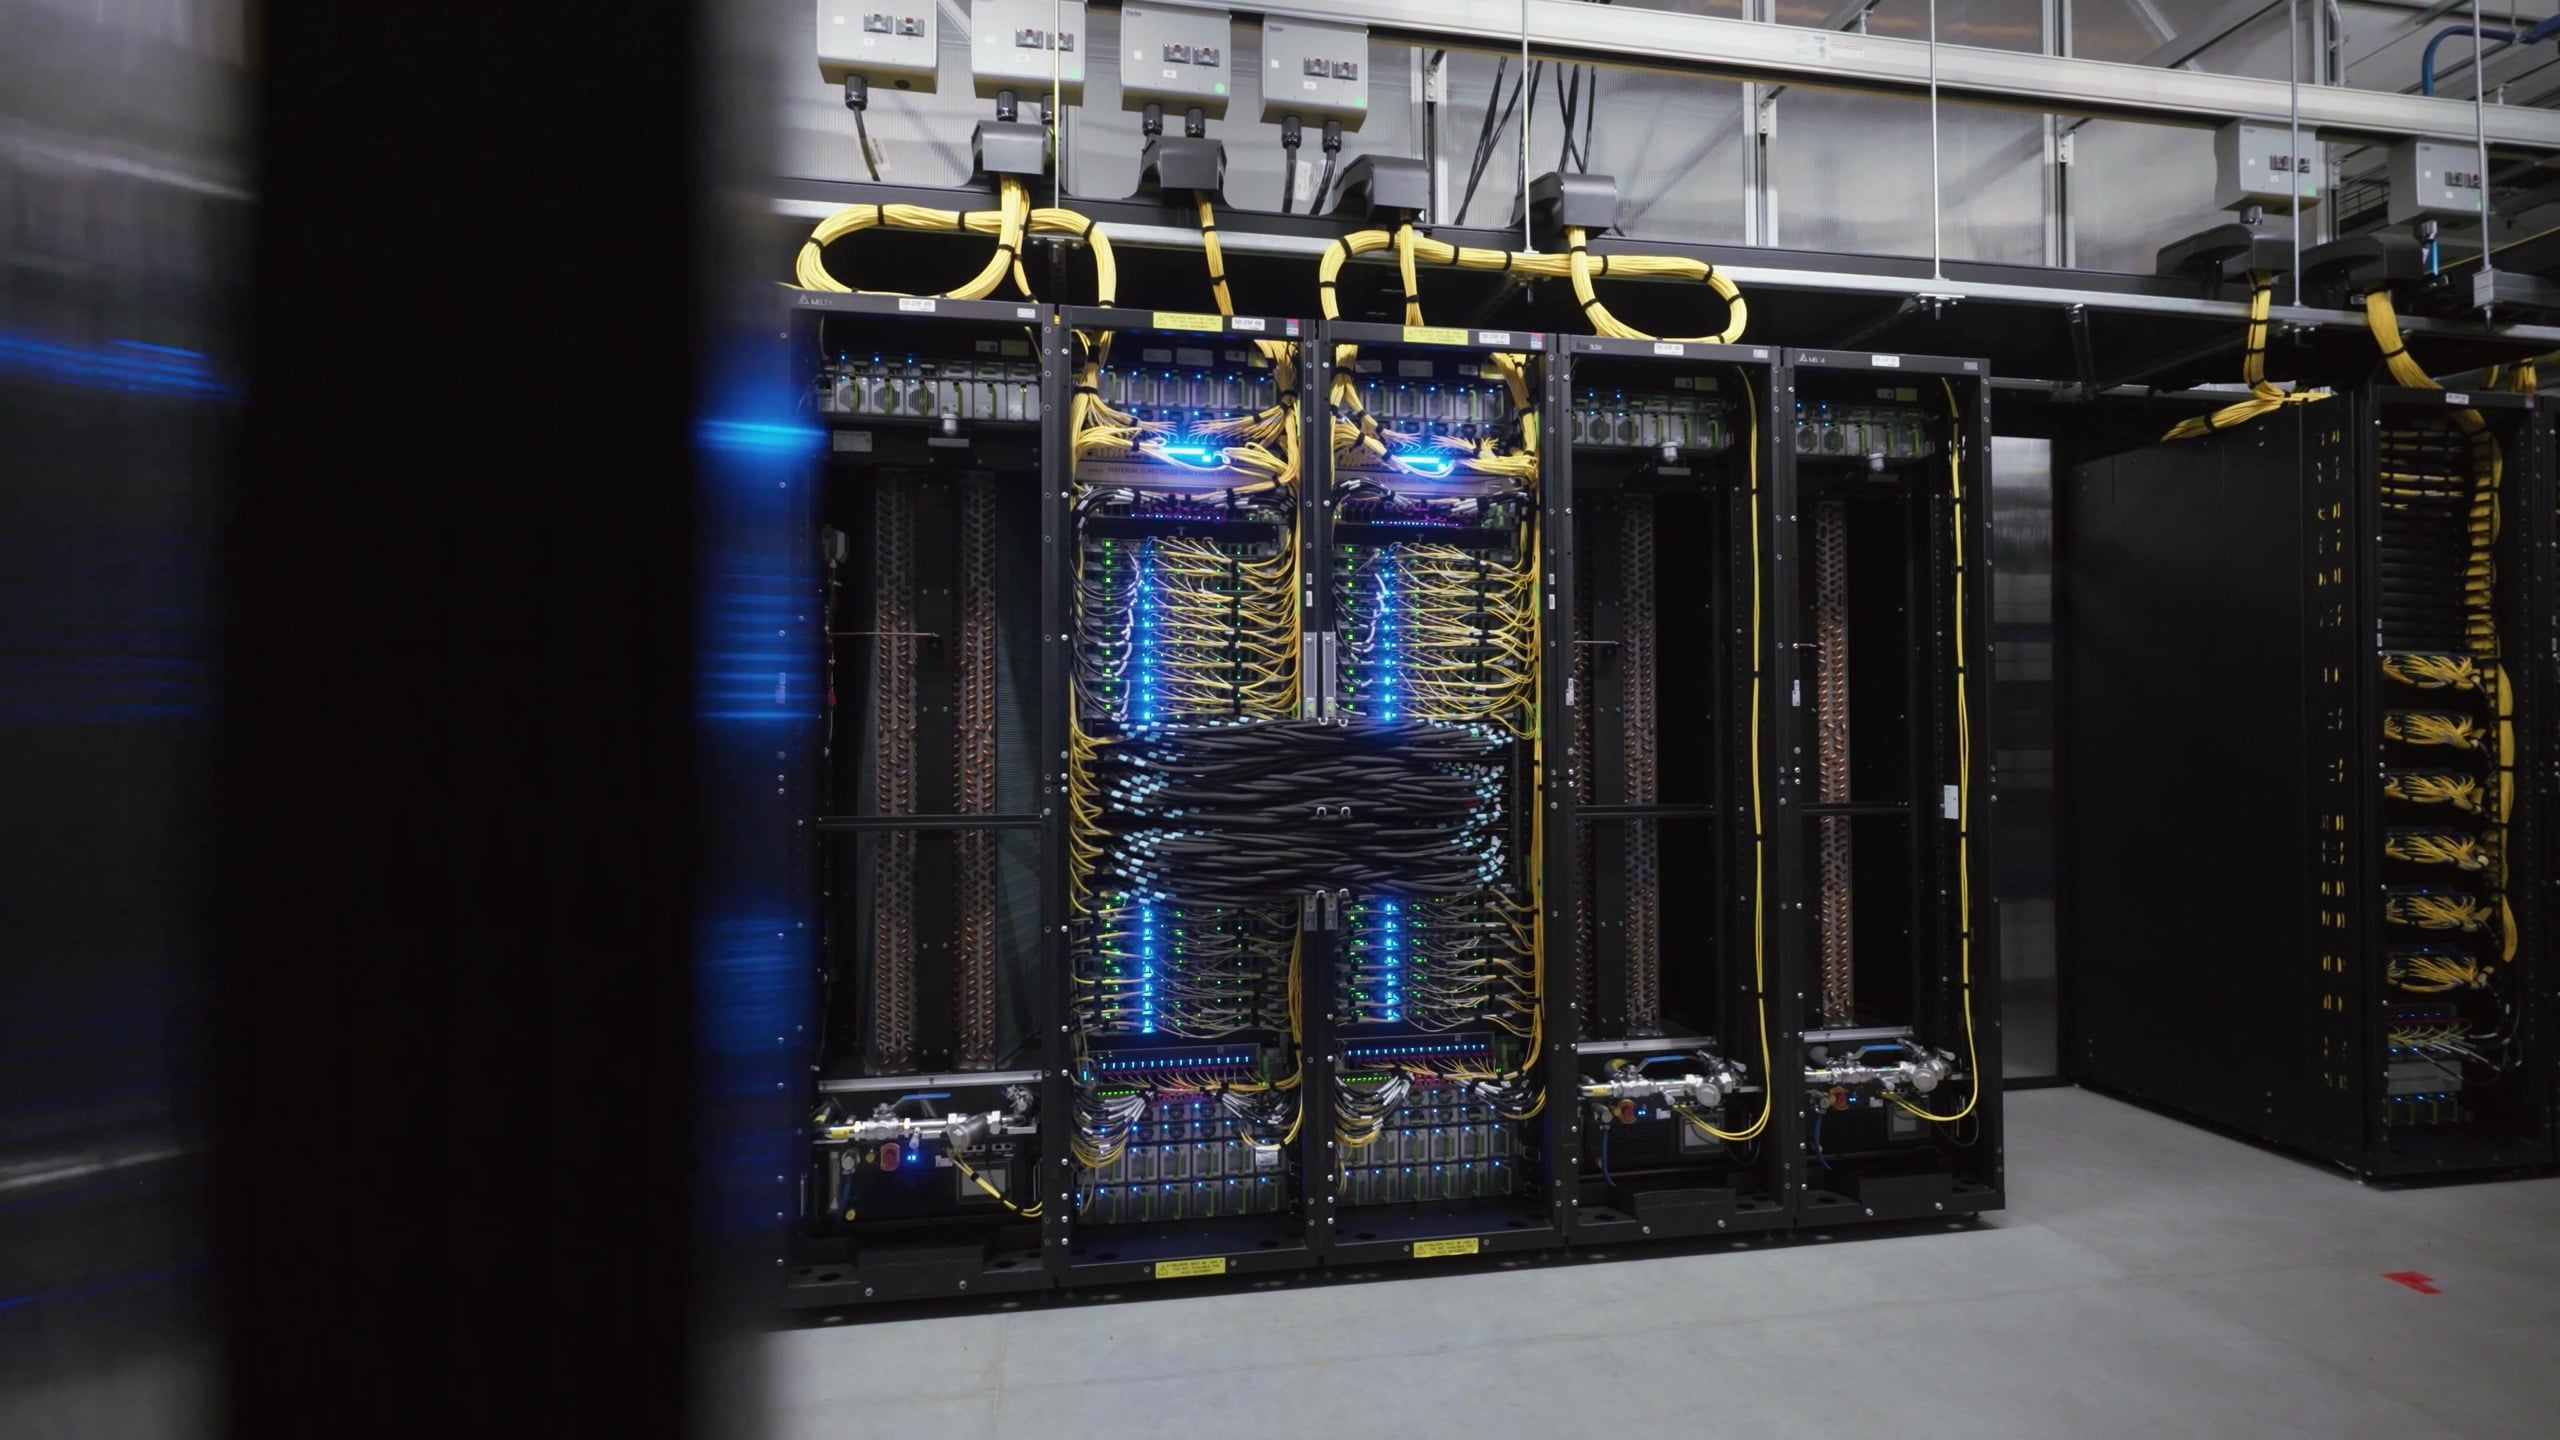
Meta က GB200 NVL72 က FLOPS၊ HBM bandwidth၊ scale-up bandwidth နဲ့ domain size တွေကို H100 ထက် အများကြီးကျော်လွန်အောင် scale လုပ်ခဲ့တာကြောင့် Ariel ကို ရွေးချယ်ခဲ့တာလို့ ပြောပါတယ်။ standard scale-out ကတော့ GPU တစ်ခုကို 400G မှာပဲ ရှိနေမှာဖြစ်ပြီး အဲဒီမညီမျှမှုက ကုန်ကျစရိတ်စွမ်းဆောင်ရည်ကို ထိခိုက်နိုင်တယ်လို့ မျှော်လင့်ထားပါတယ်။ Meta အရ Catalina တစ်စုံမှာ Blackwell GPU ၇၂ ခုပါဝင်ပြီး HBM3e 13.4TB (GPU တစ်ခုကို 192GB)၊ peak FP8 training compute 720 PFLOPS (FP4 မှာ 1,440 PFLOPS)၊ domain အတွင်းမှာ NVLink bandwidth 130TB/s၊ aggregate memory bandwidth 576TB/s ပါဝင်ပြီး rack နှစ်ခုမှာ 120kW လောက် အသုံးပြုပါတယ်။
ဒုတိယပလက်ဖောင်း Clemente သည် GB300 NVL72 သို့ ရွေ့လျားသွားသည်။ GPU တစ်ခုလျှင် HBM သည် 1.5x အထိ မြင့်တက်လာပြီး dense FP4 throughput သည် အလားတူအချက်ဖြင့် မြင့်တက်လာကာ attention acceleration သည် နှစ်ဆခန့် မြင့်တက်လာသည်။ ConnectX-8 SuperNICs များသည် GPU တစ်ခုလျှင် 800G ကို မူရင်းအတိုင်း ပေးစွမ်းနိုင်သောကြောင့် Ariel တွင် ဒီဇိုင်းထုတ်ထားသော scale-out headroom Meta သည် အခြေခံဖြစ်လာပြီး 2:1 GPU-to-CPU အချိုးသည် 72-GPU domain တစ်ခုလုံးကို single rack တွင် အံဝင်ခွင်ကျဖြစ်စေသည်။ Meta တွင် HBM3e 20.7TB ပါဝင်ပြီး peak FP4 compute ၏ exaFLOP ထက် ပိုများကာ NVLink bandwidth 130TB/s (GPU တစ်ခုလျှင် bidirectional 1.8TB/s)၊ rack တစ်ခုလျှင် 135kW ခန့်နှင့် GB200 NVL72 ထက် 5 မှ 10 ရာခိုင်နှုန်းအထိ စွမ်းဆောင်ရည်တိုးတက်မှုရှိကြောင်း ဖော်ပြထားသည်။
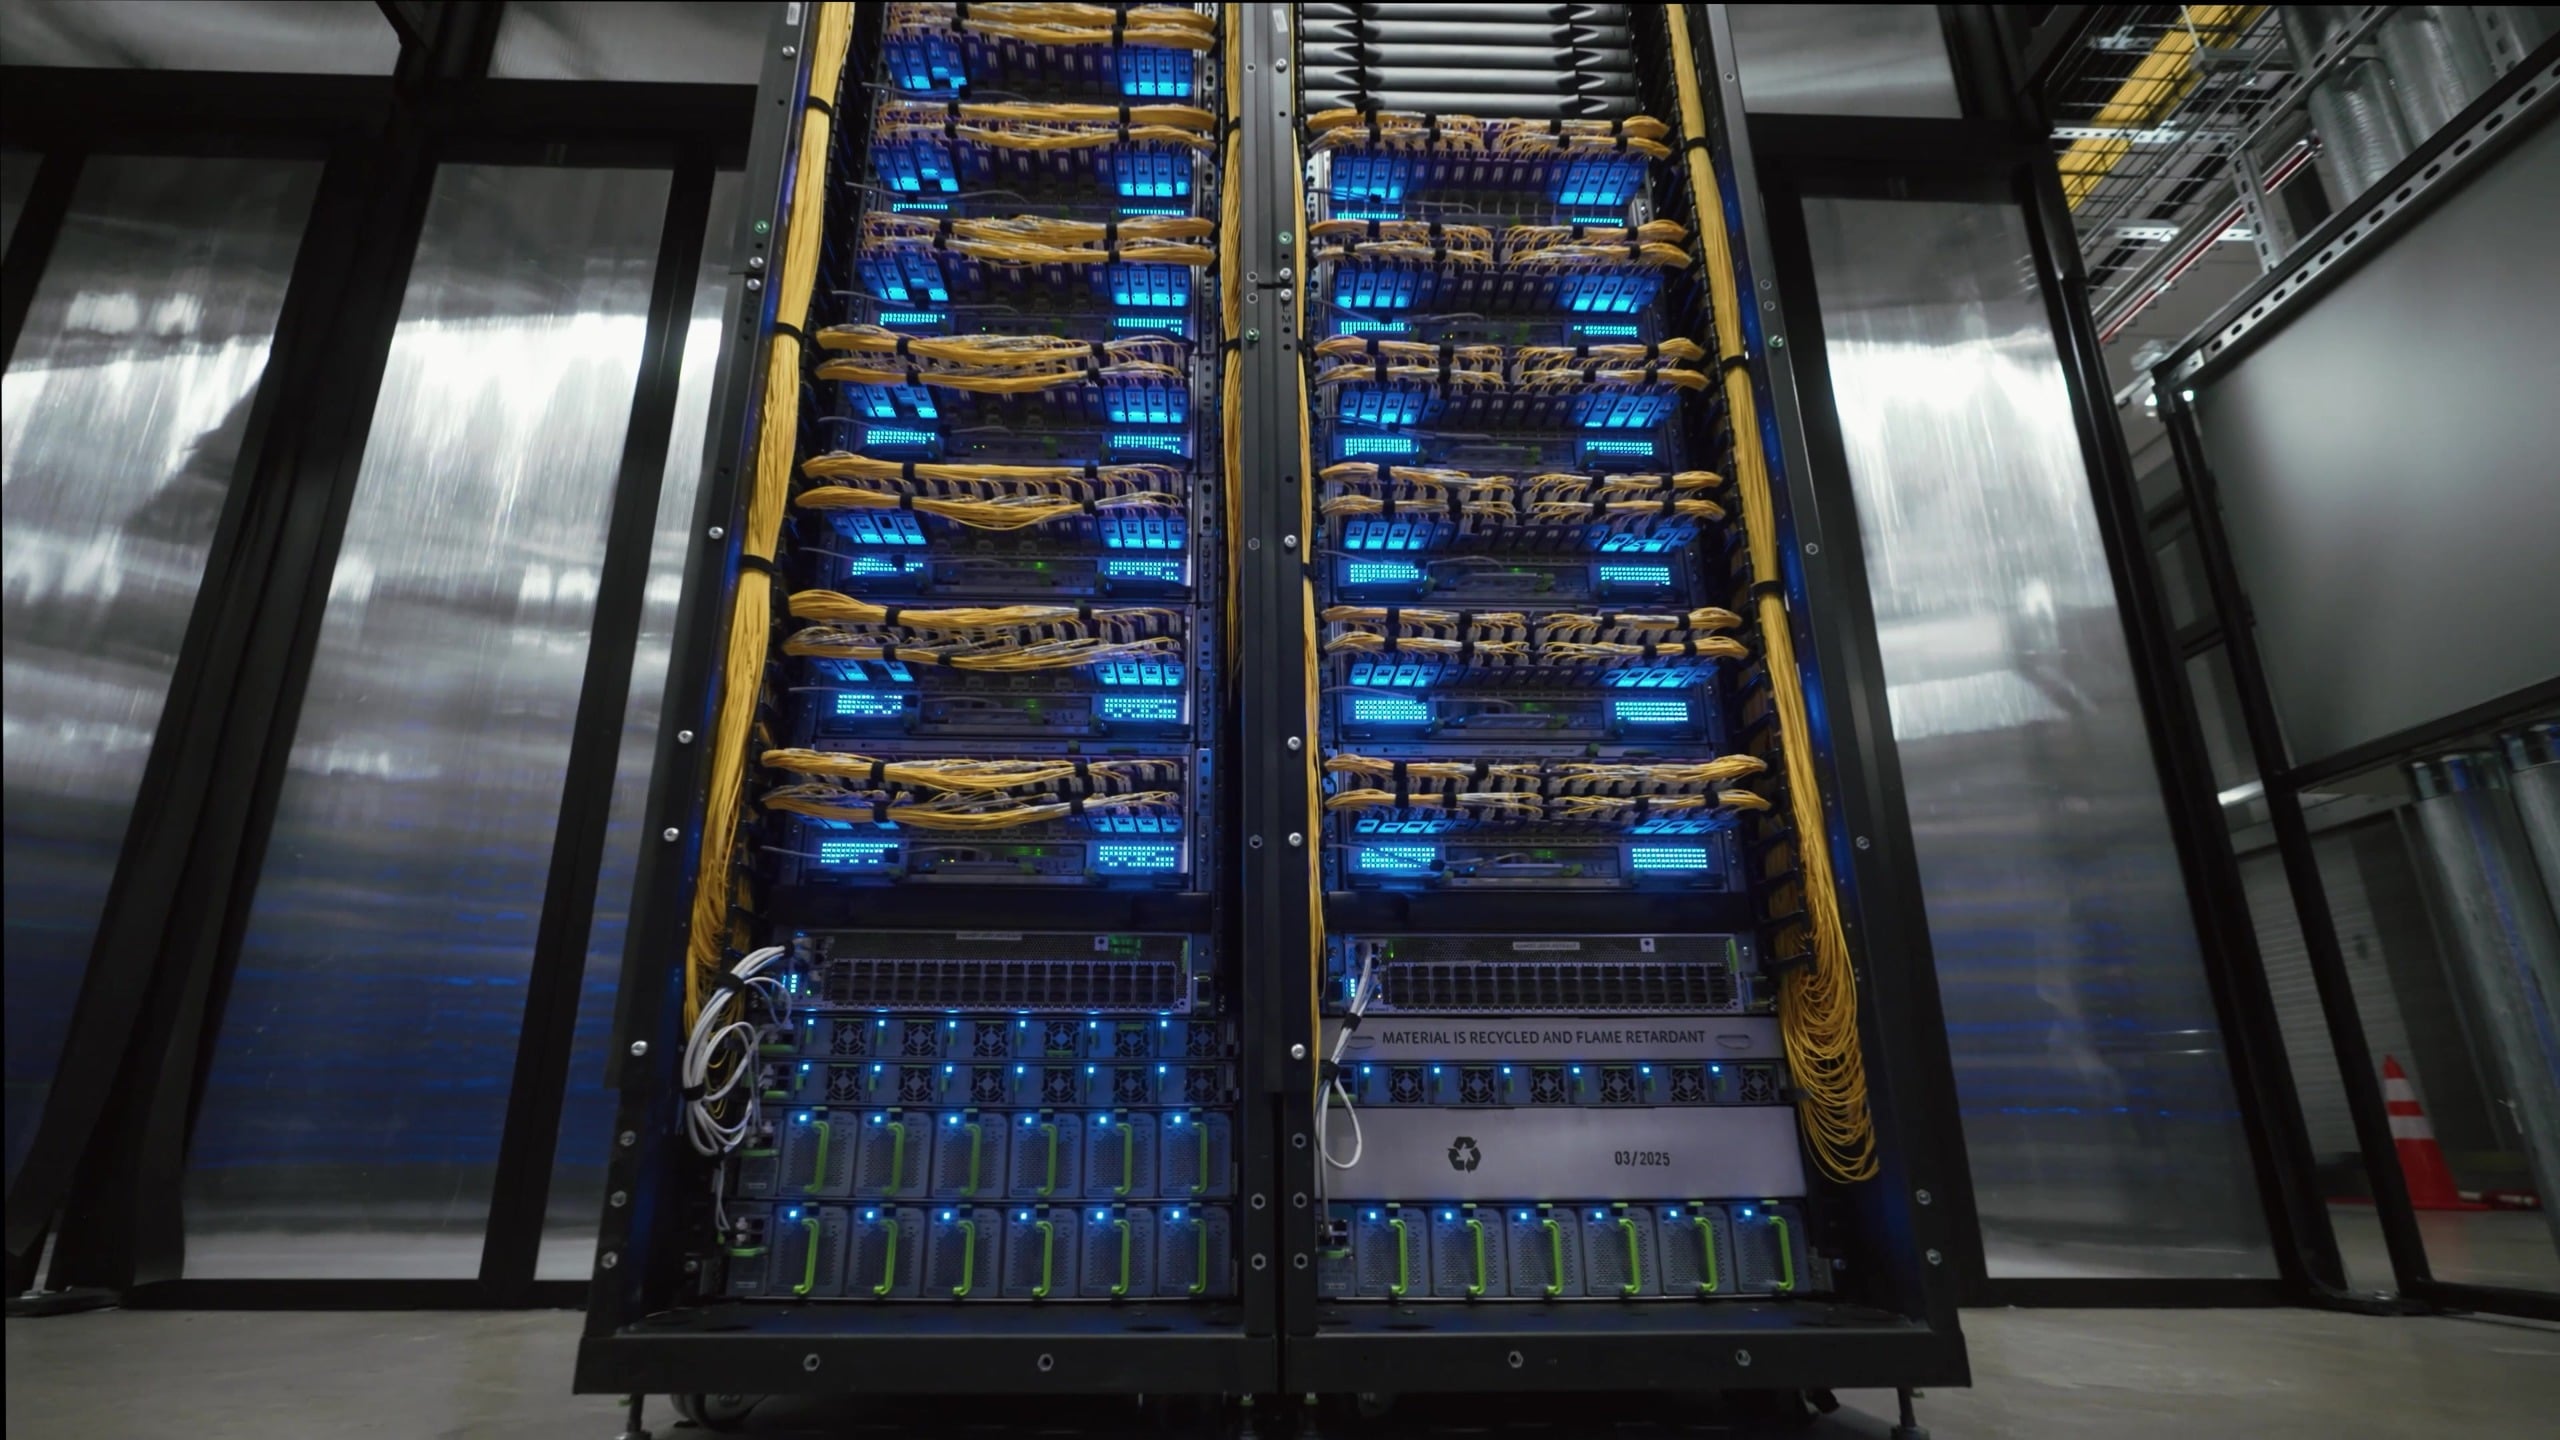
Clemente ကို ၎င်း၏ AI-optimized အဆောက်အအုံအသစ်များတွင် Meta ၏ modular air-assisted liquid cooling သို့မဟုတ် facility liquid cooling ဖြင့် ဖြန့်ကျက်ထားပြီး ကေဘယ်ကြိုးနည်းပါးလာသည်နှင့်အမျှ ဝန်ဆောင်မှုပေးနိုင်မှု တိုးတက်လာသည်ဟု Meta က ပြောကြားခဲ့သည်။
Meta ရဲ့ နောက်ထပ် platform ဖြစ်တဲ့ San Miguel ဟာ Vera Rubin NVL72 ကို network fabric တစ်ခုတည်းထဲကို ယူဆောင်လာမှာပါ။ အဲဒီ rack အတွက် Meta ရဲ့ ကိန်းဂဏန်းတွေကတော့ GPU တစ်ခုကို 19.2TB/s မှာ HBM4 288GB၊ peak FP4 training compute 2.52 exaFLOPS နဲ့ FP8 မှာ exaFLOPS 1.26၊ NVLink bandwidth 216TB/s (GPU တစ်ခုကို 3TB/s)၊ စုစုပေါင်း memory bandwidth 1,500TB/s ခန့်၊ rack တစ်ခုကို 170kW ကျော်နဲ့ အရည်အအေးပေးစနစ်နဲ့ compute trays တွေ အပြည့်အဝရှိခြင်း၊ GB300 NVL72 ထက် watt တစ်ခုချင်းစီရဲ့ စွမ်းဆောင်ရည်မှာ ၁၀ ရာခိုင်နှုန်းကနေ ၂၀ ရာခိုင်နှုန်းအထိ တိုးတက်လာခြင်းတို့ပဲ ဖြစ်ပါတယ်။ CoreWeave က Vera Rubin NVL72 ကို ဒီလအစောပိုင်းမှာ ထုတ်လုပ်ခဲ့ပါတယ် ။
အဆောက်အဦများတစ်လျှောက် ಉಪನ್ಯಾನು Ethernet Back End တစ်ခု
လေ့ကျင့်ရေးအသွားအလာသည် သာမန်ဝန်ဆောင်မှုအသွားအလာကို သယ်ဆောင်သည့် front-end ကွန်ရက်နှင့် သီးခြားဖြစ်သော Ethernet မှတစ်ဆင့် ဒုတိယဒေတာစင်တာကွန်ရက်တွင် လည်ပတ်သည်။ ဒီဇိုင်းသည် လေ့ကျင့်ရေးအလုပ်၏ပုံသဏ္ဍာန်ကို လိုက်နာသည်- data-parallel replicas များသည် ၎င်းတို့၏ latency-sensitive၊ bandwidth-heavy collective များကို building fabric အတွင်းတွင် သိမ်းဆည်းထားပြီး replicas များအကြား ပိုမိုသည်းခံနိုင်သော traffic သည် building များကို ချိတ်ဆက်ပေးသည့် aggregation layer ကို ဖြတ်ကျော်သည်။ Meta သည် ၎င်း၏ ယခင် 24,000-GPU building-scale clusters များနှင့် ၎င်း၏ 100,000-plus GPU regional cluster တွင် တူညီသော hierarchy ကို တည်ဆောက်ခဲ့ပြီး Prometheus သို့ တိုးချဲ့ခဲ့သည်။
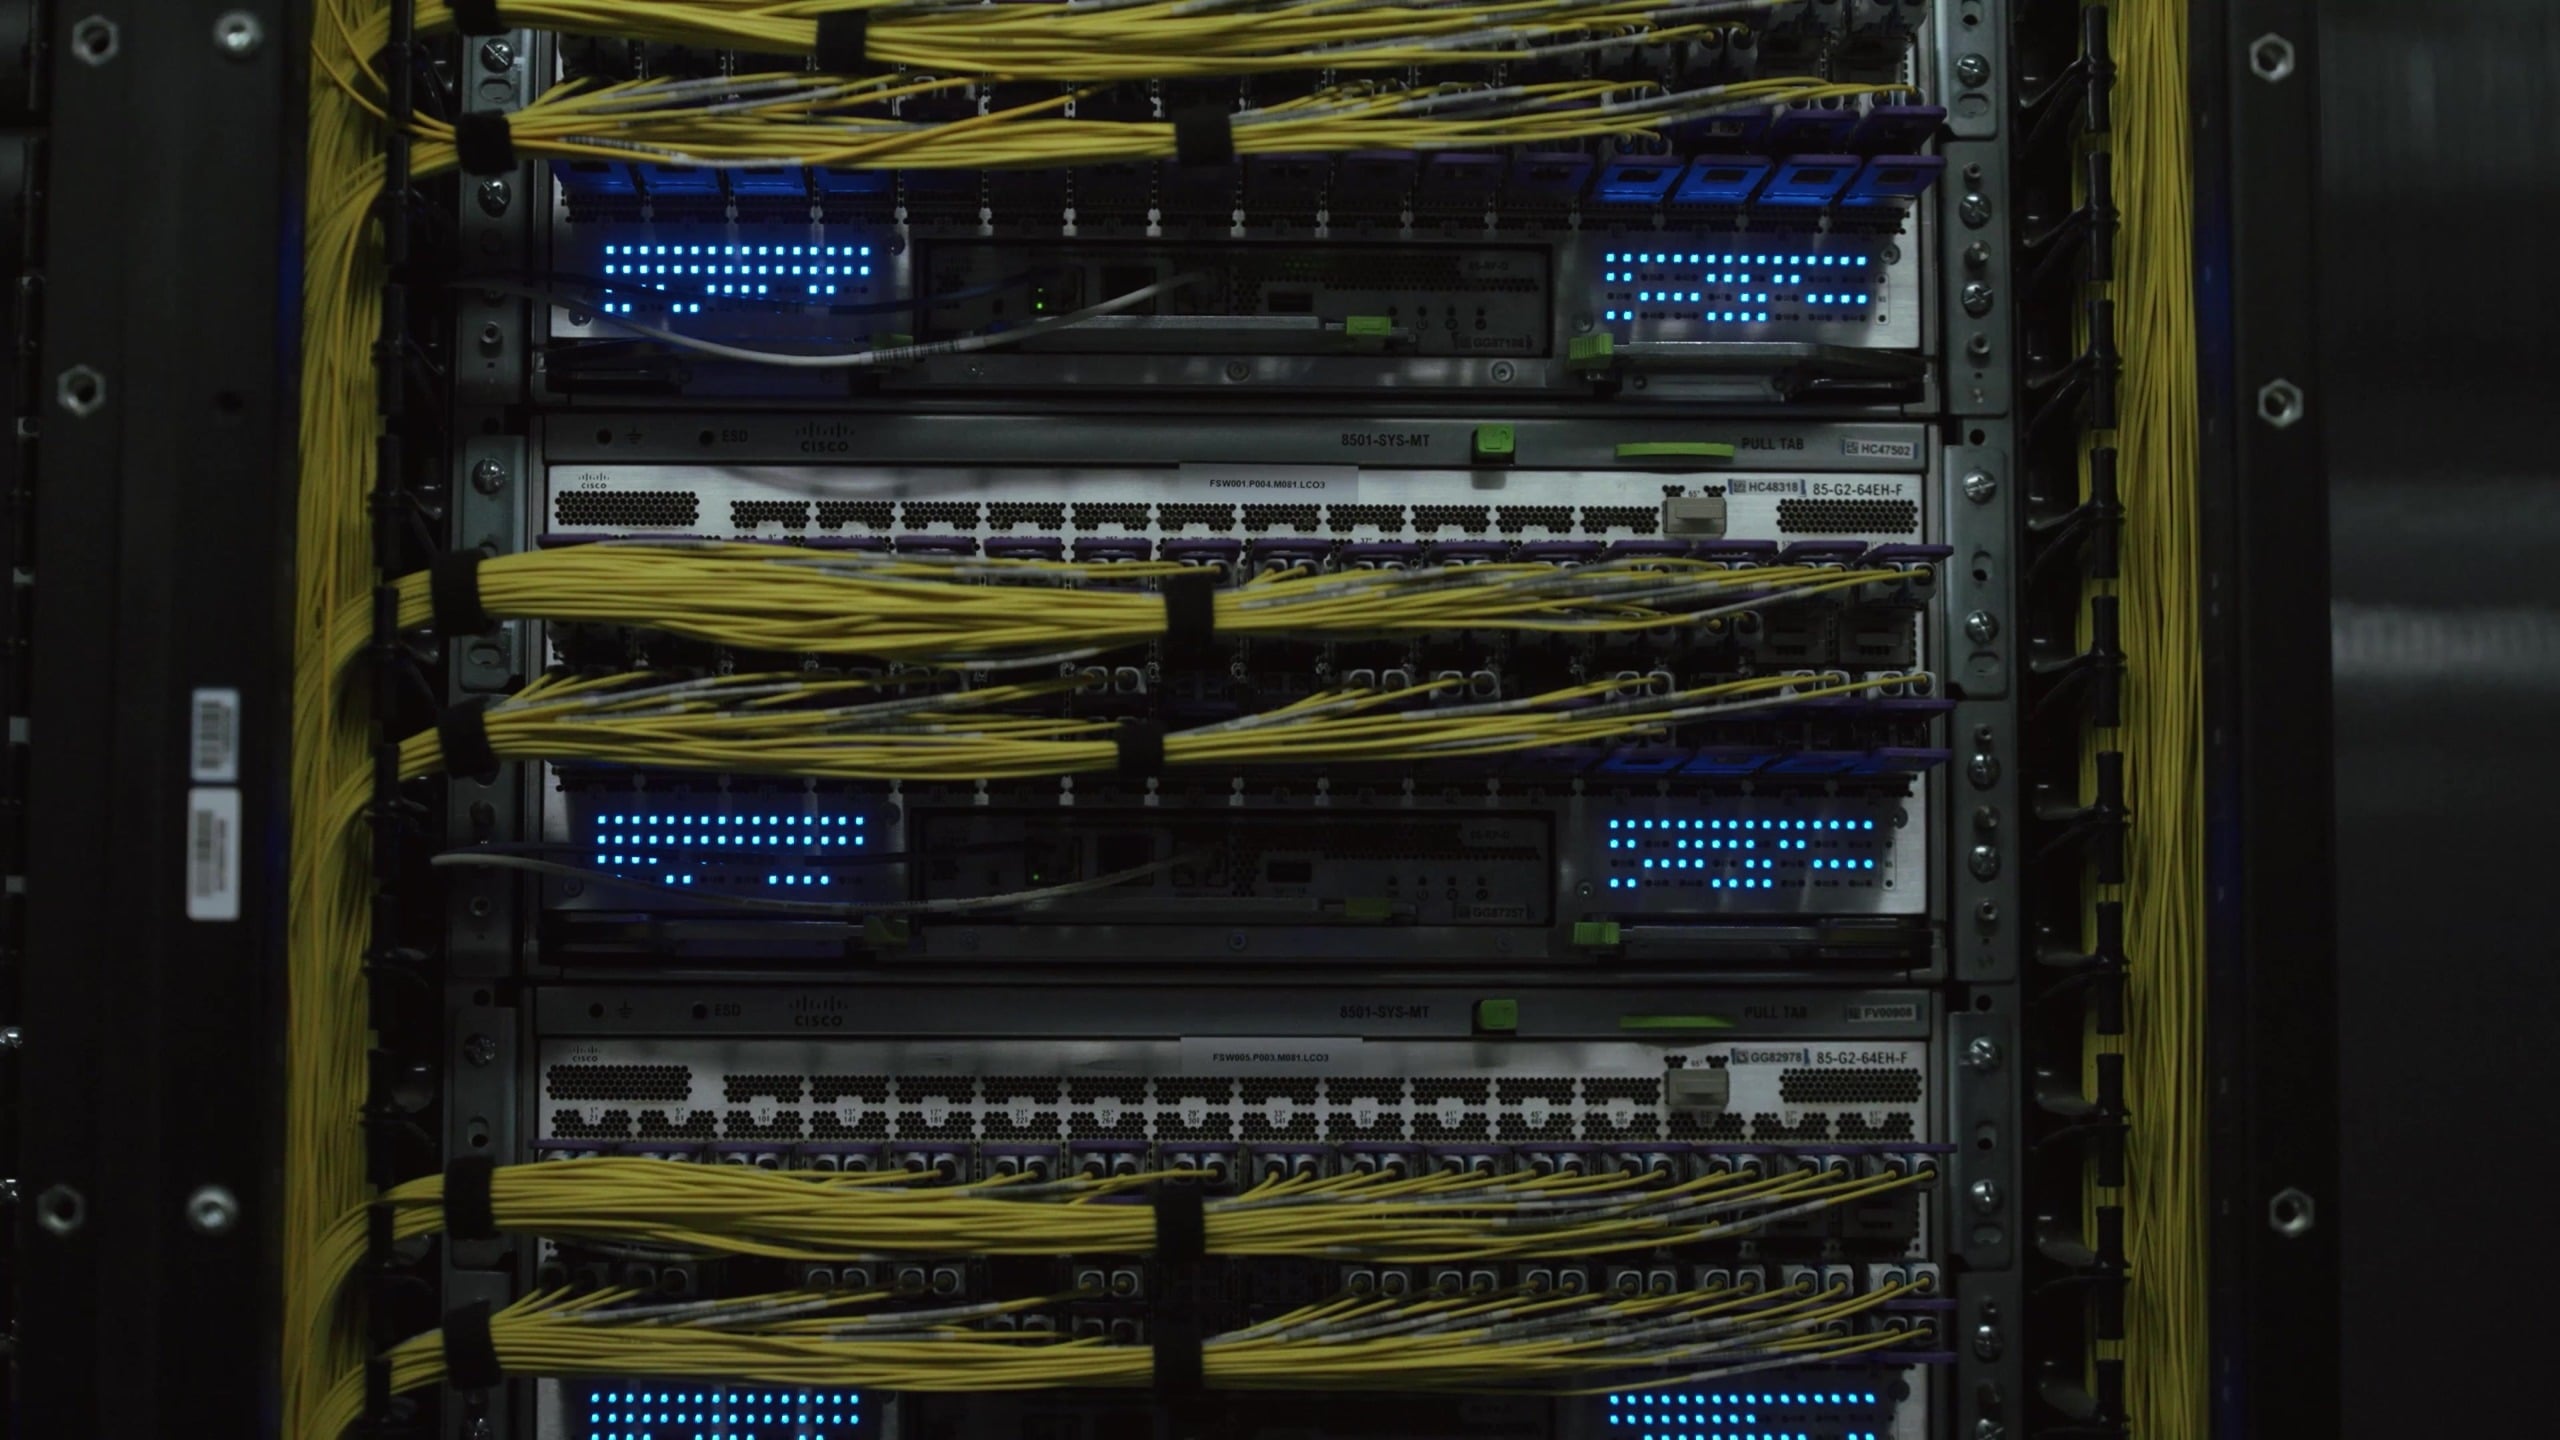
building fabric တစ်ခုစီသည် GPU ၂၀,၇၃၆ ခုအထိ ချိတ်ဆက်ထားသည်။ Meta ၏ ပထမဆုံးဒီဇိုင်းသည် Disaggregated Scheduled Fabric ဖြစ်ပြီး လေ့ကျင့်ရေး collective ၏ ကြီးမားသော၊ ကြာရှည်ခံသော flow အနည်းငယ်ကို တိုက်မိခြင်းမှ ကာကွယ်ရန် sub-packet multipath routing၊ in-fabric reordering၊ virtual output queues နှင့် credit-based flow control တို့ကို အသုံးပြုထားသည်။ NIC များသည် endpoint တွင် packets များကို ပြန်လည်စီစဉ်နိုင်စွမ်း ရရှိလာသည်နှင့်အမျှ Meta သည် shallow-buffer 51.2T switches များတွင် တည်ဆောက်ထားသော Non-Scheduled Fabric သို့ ပြောင်းရွှေ့ခဲ့သည်- dynamic load balancing ပါသော Minipack3 နှင့် ConnectX NICs များတွင် Adaptive Routing ပါသော NVIDIA Spectrum-4 ASIC ကိုအသုံးပြုသည့် Minipack3N နှစ်ခုစလုံးသည် Meta ၏ FBOSS network stack ကို လည်ပတ်သည်။
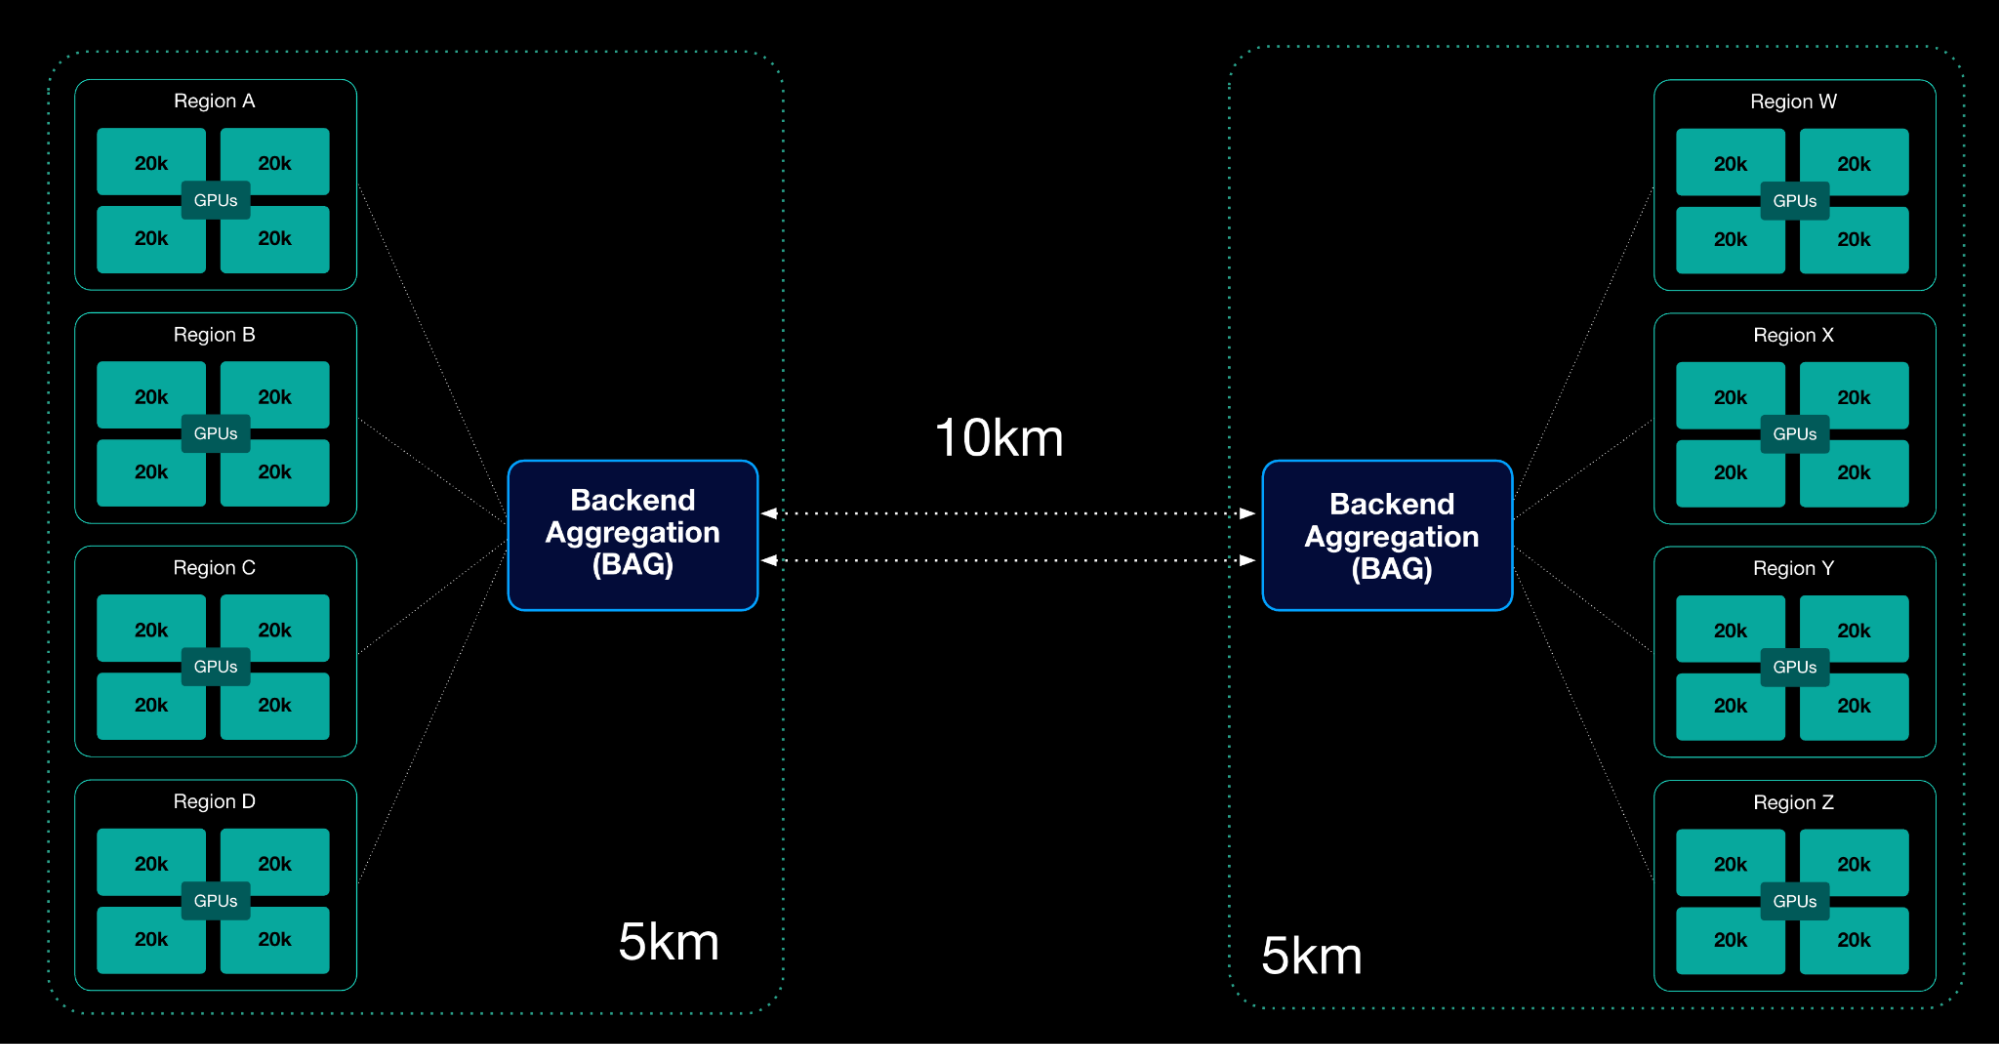
အဆောက်အအုံများ၏အထက်တွင် Backend Aggregation ကွန်ရက်ရှိပြီး ၎င်းသည် Arista 7800-series chassis ပေါ်တွင် deep-buffered Broadcom Jericho3 silicon ဖြင့်တည်ဆောက်ထားသော multi-layer hub-and-spoke ဒီဇိုင်းတစ်ခုဖြစ်သည်။ ၎င်းသည် ၂ ကီလိုမီတာမှ ၁၀၀ ကီလိုမီတာထက်ပို၍ ကျယ်ပြန့်ပြီး ဒေသအတွဲများအကြား တစ်စက္ကန့်လျှင် petabits အများအပြားကို ပေးပို့သည်။ Meta က ထိုအကွာအဝေးများတွင် pre-training ကို လုပ်ဆောင်ခြင်းသည် အလင်းအလျင် latency ကြောင့် Meta Superintelligence Labs နှင့် အထူးပြု optimization ကြိုးပမ်းအားထုတ်မှုတစ်ခု လိုအပ်ကြောင်း ပြောကြားခဲ့သည်။ ၎င်းနောက်ကွယ်ရှိ စက်ရုံတွင် အဆောက်အအုံများအတွင်းရှိ 2x400G FR4 LITE pluggables များမှ ၁၀ ကီလိုမီတာခန့်ထက်ကျော်လွန်သော link များအတွက် 800G-ZR coherent optics အထိ မိုင်သန်းပေါင်းများစွာရှည်လျားသော fiber strand၊ သောင်းနှင့်ချီသော switches များနှင့် optics သန်းပေါင်းများစွာ ပါဝင်သည်။
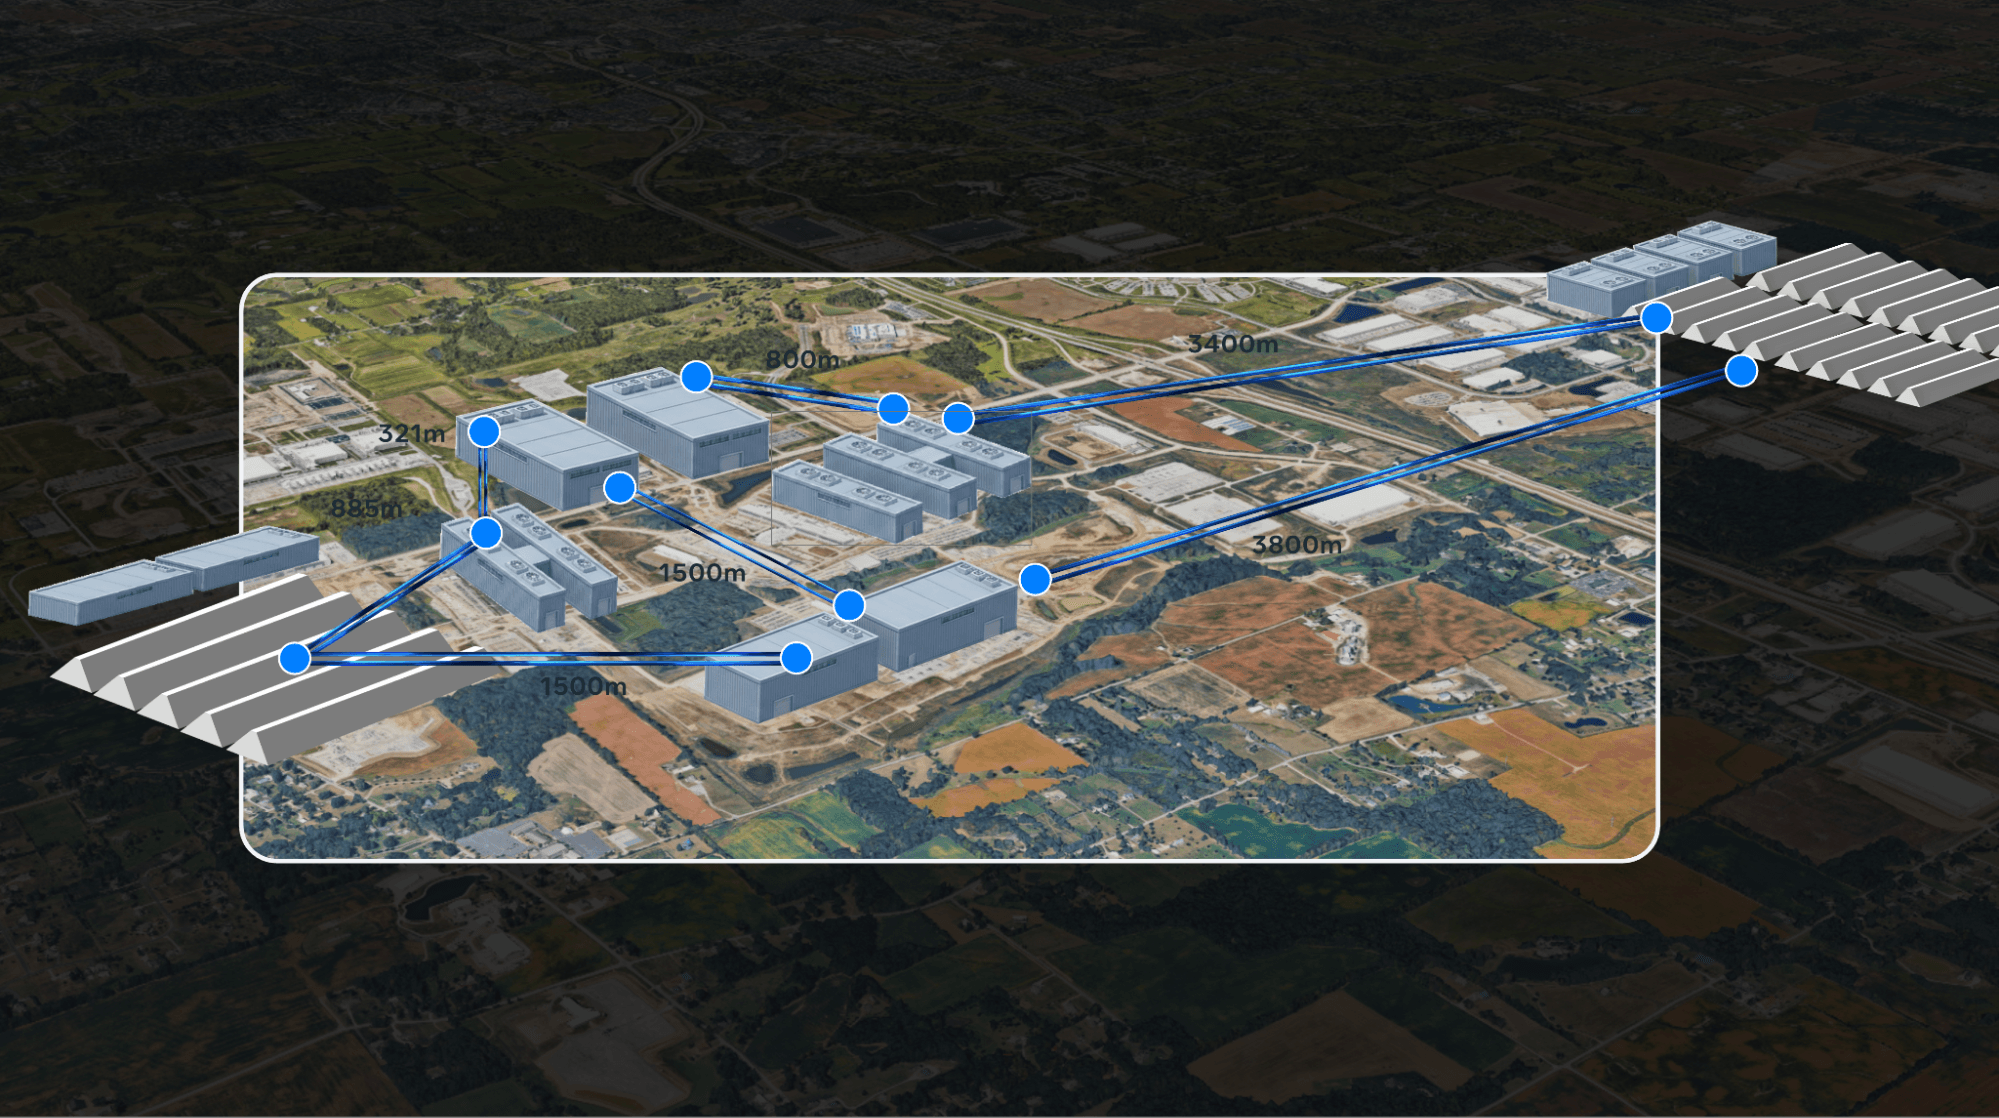
GPU ၇၂ ခုမှာ ၆၄ ခုက အလုပ်လုပ်ပါတယ်
H100 မျိုးဆက်ရဲ့ ရှစ်ခုပါ GPU NVLink domain ကနေ NVL72 ကို ရွှေ့လိုက်တဲ့အခါ failure blast radius ကို ကိုးနဲ့မြှောက်လိုက်တာကြောင့် Meta ဟာ 72-GPU rack ပတ်လည်မှာ capacity ကို စီစဉ်ပေးလိုက်ပါတယ်။ training parallelism ဟာ power-of-two group size တွေပေါ်မှာ အကောင်းဆုံး map လုပ်ထားတဲ့အတွက် NVL72 domain တစ်ခုစီဟာ 64-GPU slice တစ်ခုကို run ပြီး ကျန် GPU ရှစ်လုံးကို in-rack spares အဖြစ် သိမ်းဆည်းထားပါတယ်။ GPU တစ်ခု ပျက်ကွက်သွားရင် spare က အစားထိုးဝင်ရောက်ပြီး ပြုပြင်မှုကို မစောင့်ဘဲ နောက်ဆုံး checkpoint ကနေ အလုပ်ပြန်စပါတယ်။ whole-rack fault တွေအတွက် Meta ဟာ နောက်ထပ် rack ၂ ရာခိုင်နှုန်းလောက်ကို reserve ထဲမှာ သိမ်းဆည်းထားပါတယ်။
၃၂,၇၆၈-GPU လေ့ကျင့်မှုအတွက်- NVL72 rack ၅၂၃ ခု သို့မဟုတ် GPU ၃၇,၆၅၆ ခု၊ active footprint အထက် ၁၃ ရာခိုင်နှုန်းခန့်ရှိပြီး ၎င်းအနက် ၁၁ မှတ်သည် ၇၂ slice geometry မှ လာပါသည်။ ထိုယုံကြည်စိတ်ချရမှုနောက်ကွယ်ရှိ signal integrity ဝန်ထုပ်ဝန်ပိုးမှာ များပြားလှသည်။ NVL72 domain တစ်ခုတည်းတွင် 200Gbps ဖြင့် tuned differential-pair link ၅,၁၈၄ ခု ပါဝင်ပြီး တစ်ခုစီသည် GPU SerDes၊ compute tray PCB များ၊ cable cartridge များနှင့် switch tray interface များကို ဖြတ်ကျော်သည်။
recovery path နှစ်ခုက ဖြစ်ပွားတဲ့ fault တွေကို ကိုင်တွယ်ပါတယ်။ failure တစ်ခုကို data-parallel replica တစ်ခုတည်းမှာ ခွဲထုတ်နိုင်တဲ့အခါ Meta ရဲ့ parallelism-aware fault tolerance က အဲဒီ replica ကို offline လုပ်နေချိန်မှာ cluster ရဲ့ ကျန်တဲ့အပိုင်းက အဲဒီအဆင့်ကို ပြန်လုပ်ပြီး training ဆက်လုပ်ပါတယ်၊ ပြီးတော့ slice က spare host တွေမှာ restart လုပ်ပြီး resynchronize လုပ်ပါတယ်။ fault ကြီးတွေက job တစ်ခုလုံးကို သူ့ရဲ့နောက်ဆုံး checkpoint ကို ပြန်ပို့ပါတယ်၊ ဒါကြောင့် Meta checkpoints တွေက မကြာခဏဆိုသလို model state ကို gradient တွေနဲ့ optimizer data asynchronously နဲ့ multi-tier storage မှာ သိမ်းဆည်းပါတယ်၊ throughput မှာ hit ကို ကန့်သတ်ဖို့ delta checkpointing နဲ့ in-memory staging တွေ ပါဝင်ပါတယ်။
အနှောင့်အယှက်များ ၉၉ ရာခိုင်နှုန်း ကျဆင်းခြင်း
ထိုကိန်းဂဏန်းများကပြသသည့် တိုးတက်မှုအားလုံးအတွက် Prometheus သည် တည်ငြိမ်စွာစတင်ခဲ့ခြင်းမရှိပါ။ ၂၀၂၅ ခုနှစ်လယ်ပိုင်းတွင်၊ ကနဦးအဆင့်တွင် အနှောင့်အယှက်နှုန်းသည် တစ်နေ့လျှင် GPU ၈၀၀၀ လျှင် အဖြစ်အပျက် ၁၀၀၀ နီးပါးအထိ အမြင့်ဆုံးရောက်ရှိခဲ့သည်။ တစ်နှစ်တာလုပ်ငန်းဆောင်တာများ ဖြတ်ကျော်လုပ်ဆောင်ခြင်းသည် ယင်းကို ၉၉ ရာခိုင်နှုန်း လျှော့ချပေးနိုင်ခဲ့ပြီး ယခုအခါ cluster သည် GPU ထောင်ပေါင်းများစွာ၏ လေ့ကျင့်ရေးအလုပ်များစွာကို တစ်ပြိုင်နက်တည်း ထိန်းသိမ်းထားနိုင်ပြီဖြစ်သည်။ Meta သည် NVIDIA နှင့် ပူးတွဲအင်ဂျင်နီယာပုံစံကို ဂုဏ်ပြုပြီး NVIDIA အဖွဲ့များသည် New Albany ဆိုက်တွင်ထိုင်ကာ telemetry ကိုမျှဝေပြီး ပူးတွဲ triage session များကို လုပ်ဆောင်ကာ ရပ်တန့်မှုတိုင်းကို အကြောင်းရင်းအလိုက် ခွဲခြမ်းစိတ်ဖြာကာ Meta သည် အချိန်ဇယားဆွဲခြင်းနှင့် အခြေခံအဆောက်အအုံပြင်ဆင်မှုများကို ပိုင်ဆိုင်ပြီး NVIDIA သည် firmware၊ signal diagnostics နှင့် memory handling တို့ကို တာဝန်ယူထားသည်။
GB200 မှာ NVLink signal integrity က ပထမဆုံး bottleneck ပါ။ cluster ထဲမှာ NVLink connection ၆၀၀,၀၀၀ ကျော်ရှိတာကြောင့် marginal link တွေက recovery cycle တွေကို မကြာခဏ ဖြစ်ပေါ်စေတာကြောင့် Meta က production မလုပ်ခင် weak link တွေကို ရှာဖွေဖို့ continuous telemetry၊ automated flagging နဲ့ L11 diagnostic burns တွေကို ထည့်သွင်းခဲ့ပါတယ်။ GB300 မှာ memory ပိုကြီးလာတာနဲ့အမျှ HBM နဲ့ LPDDR မှာရှိတဲ့ memory fault တွေက အဓိကအကြောင်းရင်းအဖြစ် ရောက်ရှိလာခဲ့ပြီး၊ အဲဒီမှာ refined HBM firmware setting တွေ၊ memory scrubbing၊ တိုးတက်လာတဲ့ LPDDR error correction algorithm နဲ့ degrading device တွေရဲ့ predictive retirement တွေ ဖြစ်ပေါ်လာပါတယ်။ Switch health ကို millisecond resolution မှာ စောင့်ကြည့်ပြီး aggregation layer မှာရှိတဲ့ link events တွေကို hardware မှာ GPU traffic ကို မနှောင့်ယှက်ဘဲ reroute လုပ်ပါတယ်။
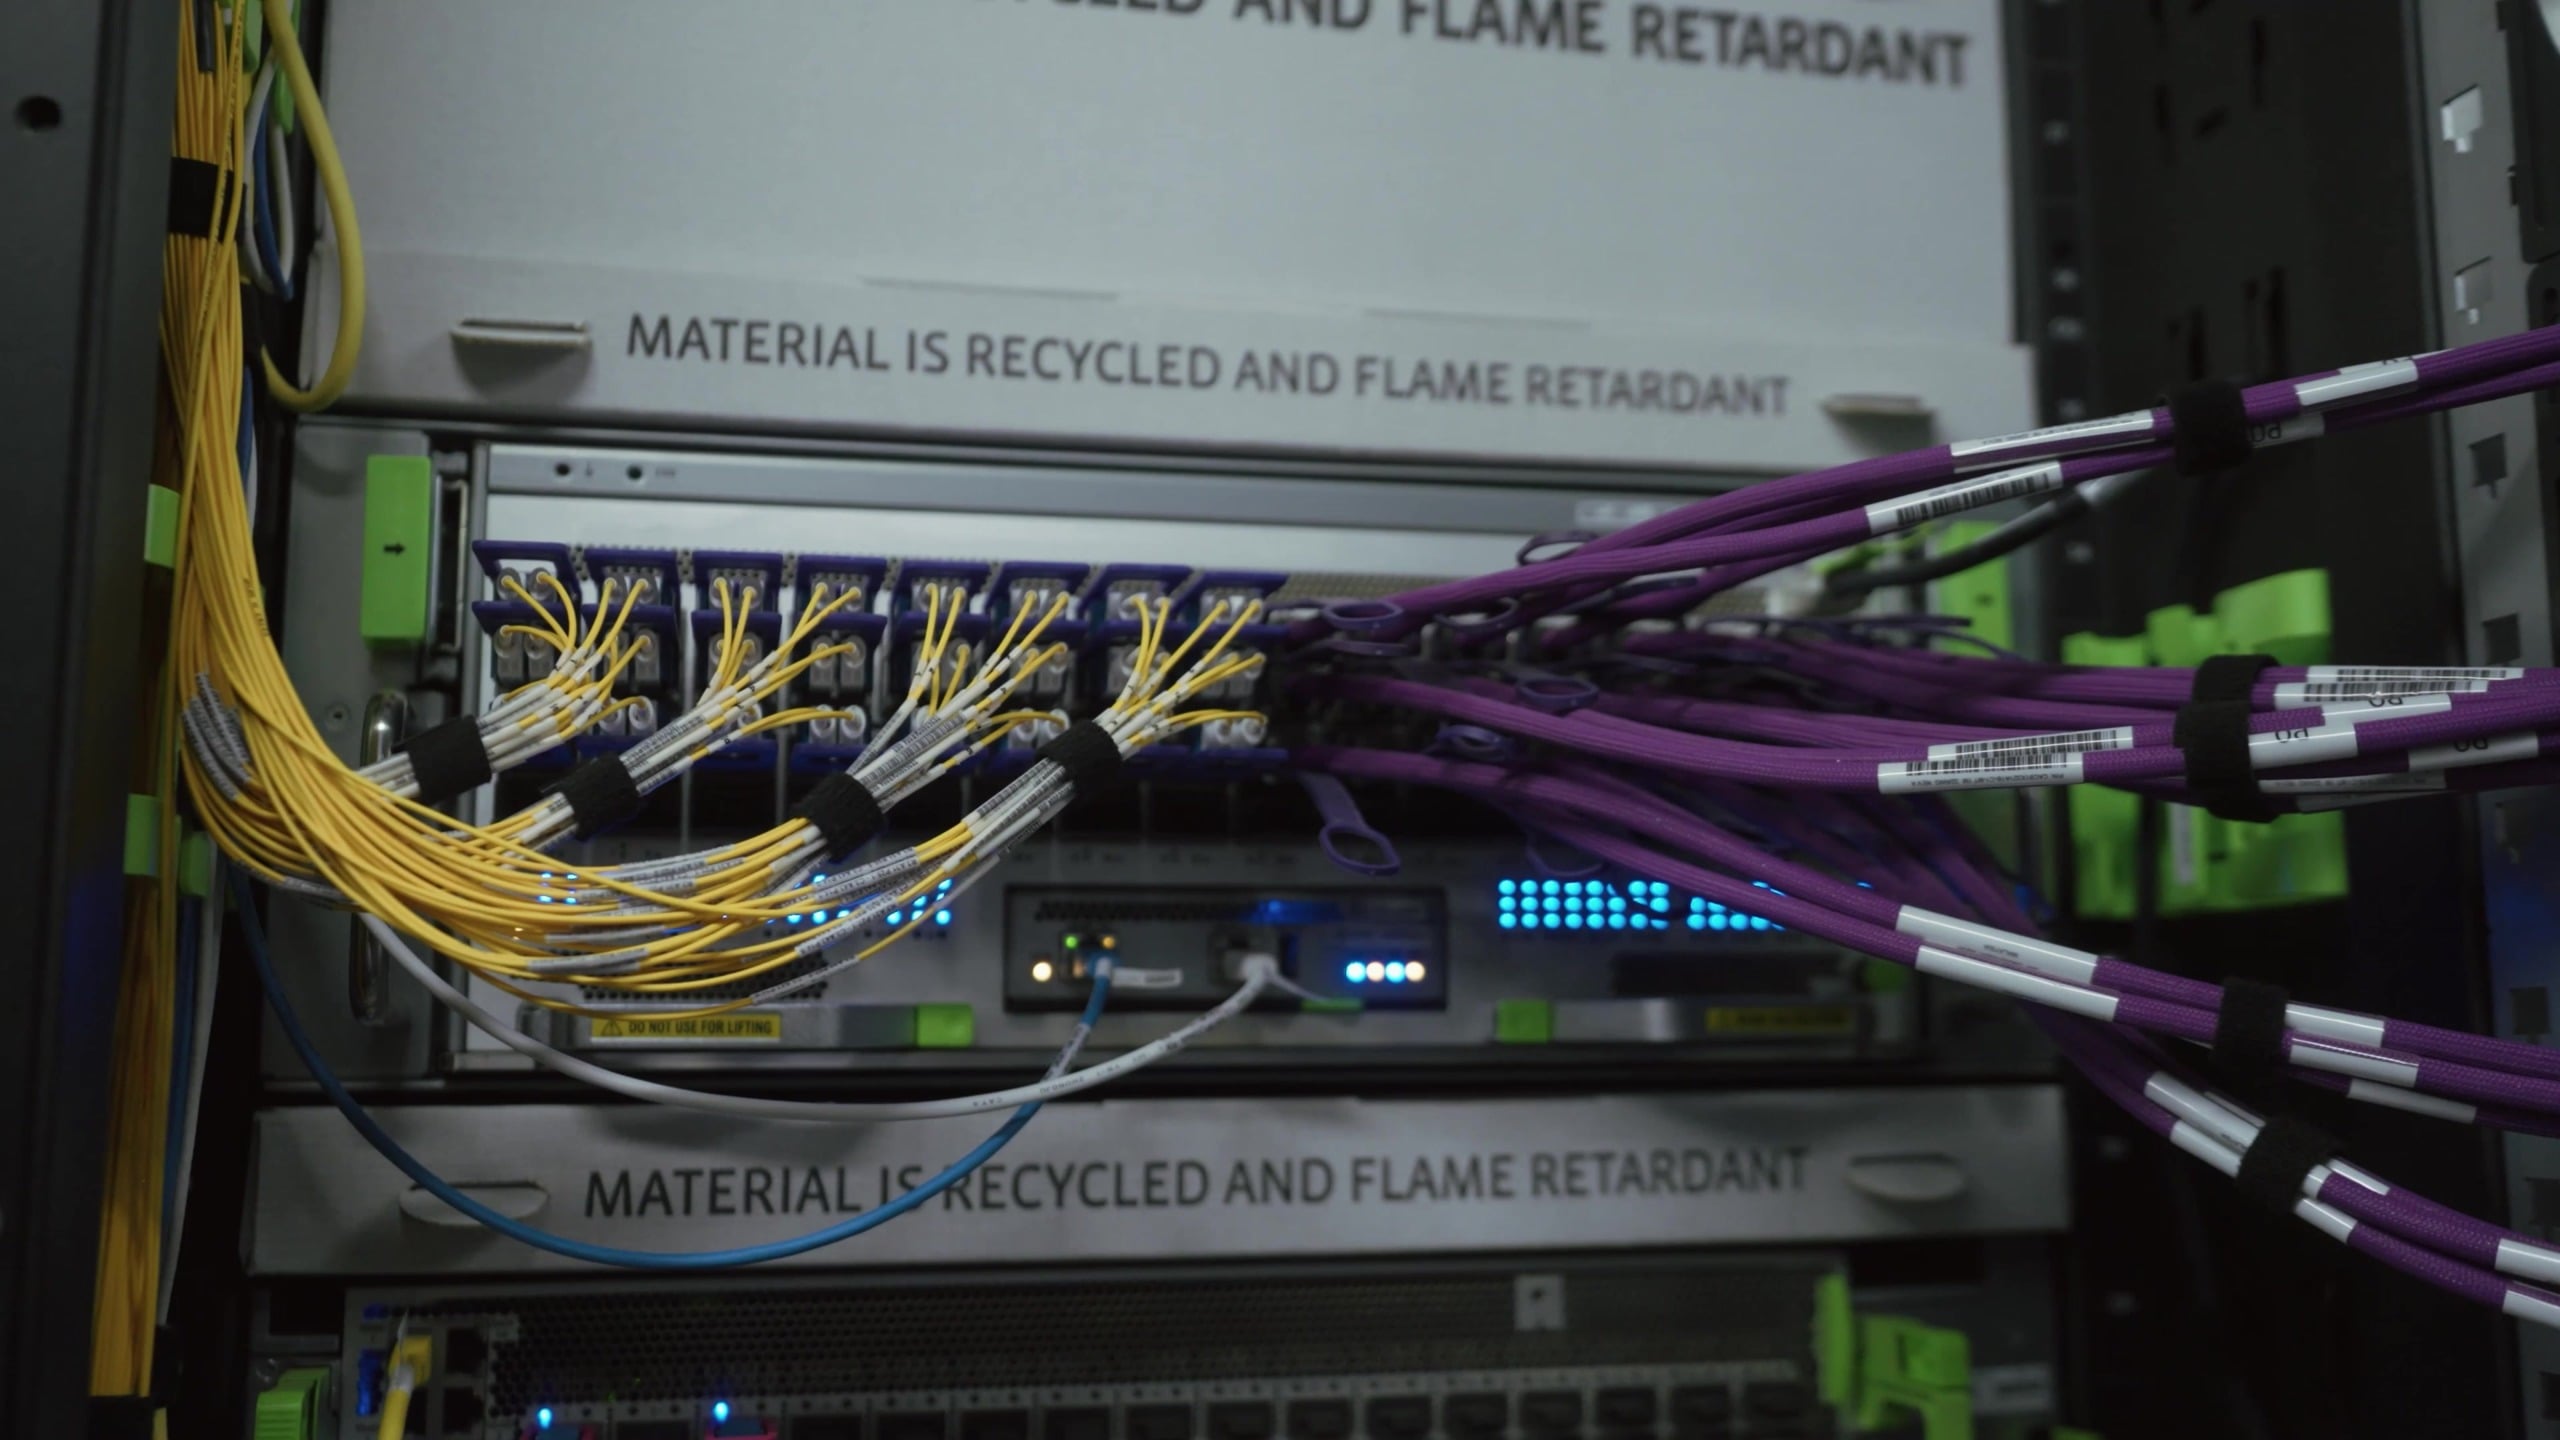
ပထမမျိုးဆက် accelerator ရာပေါင်းများစွာကို လည်ပတ်ခြင်းဖြင့် hardware ရင့်ကျက်မှုကို ၎င်း၏ကိုယ်ပိုင်ဘာသာရပ်အဖြစ်သို့ ပြောင်းလဲပေးခဲ့သည်။ Meta ၏ firmware အလိုအလျောက်စနစ်သည် driver နှင့် firmware ပြင်ဆင်မှုများကို GPU ၁၀၀,၀၀၀ ကျော်သို့ နာရီအနည်းငယ်အတွင်း တွန်းပို့နိုင်ပြီး pod တစ်ခုတည်းကို အဆင့်မြှင့်တင်ရန် P90 အချိန်သည် GB200 မိတ်ဆက်မှုတွင် ခုနစ်နာရီကျော်စောနေရာမှ နှစ်နာရီအထိ ကျဆင်းသွားခဲ့သည်။ Power delivery stress testing သည် GPU တစ်ခုတည်း၏ 1,400W load အောက်တွင် PSU module များနှင့် voltage regulator များ မည်သို့ပြုမူသည်ကို ကြည့်ရှုပြီး ပြုပြင်ထားသော system တိုင်းသည် validation အောင်မြင်သည်အထိ quarantine တွင် ရှိနေပါသည်။ မတ်လတွင် Meta ၏ stability sprint သည် stack တစ်လျှောက် ပြင်ဆင်မှုများကို တစ်ပြိုင်နက်တည်း လုပ်ဆောင်ခဲ့သည်။
ပါဝါအကူးအပြောင်းများနှင့် ရောနှောအအေးပေးစနစ်
တစ်ပြိုင်နက်တည်း လေ့ကျင့်မှုသည် ပါဝါကို lockstep ဖြင့် ရွေ့လျားစေပြီး compute phase သို့မဟုတ် communication phase ထဲသို့ ဝင်ရောက်နေသော GPU ထောင်ပေါင်းများစွာသည် cluster load ကို ၃၀ မှ ၄၀ ရာခိုင်နှုန်းအထိ လွှဲပေးပြီး အလုပ်ကြီးတစ်ခုကို စတင်ခြင်း သို့မဟုတ် ခေတ္တရပ်ခြင်းသည် စက္ကန့်ပိုင်းအတွင်း မဂ္ဂါဝပ် ဆယ်ဂဏန်းကို ရွှေ့ပေးနိုင်သည်။ Meta ၏ cluster-wide power management framework ဖြစ်သော Dynamo Dimmer သည် cluster သည် ၎င်း၏ electrical ceiling သို့ နီးကပ်လာသည်နှင့်အမျှ GPU ပါဝါကို တဖြည်းဖြည်း ကန့်သတ်ပေးသောကြောင့် အလုပ်များ ဆက်လက်လည်ပတ်နေပါသည်။ Rack-level battery backup module များသည် spikes များကို စုပ်ယူပြီး capacitor trays များသည် ချောမွေ့သော peaks များကို ရရှိကာ facility-scale battery energy storage သည် ၎င်းတို့နောက်တွင် ရှိနေပြီး Meta သည် load profile ရှိ utilities များနှင့် ညှိနှိုင်းဆောင်ရွက်ပါသည်။
Prometheus ကို free-air data center များ၊ rapid-deployment structure များ၊ leased capacity နှင့် purpose-built AI building တို့တွင် လျင်မြန်စွာ တည်ဆောက်ထားသောကြောင့် အအေးပေးစနစ်သည် အဆောက်အဦးအလိုက် ကွဲပြားပါသည်။ အဟောင်းနေရာများတွင် modular air-assisted liquid cooling ကို အသုံးပြုထားပြီး AI-optimized building တွင် closed loop ဖြင့် facility liquid cooling ကို အသုံးပြုထားပြီး Meta က GPU server များကို အအေးပေးရန် အထိရောက်ဆုံးနည်းလမ်းနှင့် ရေအသက်သာဆုံးနည်းလမ်းအဖြစ် ဖော်ပြထားသည်။ Meta သည် OCP မှတစ်ဆင့် ၎င်း၏ liquid-cooled network rack ဖြစ်သော IcePack ကဲ့သို့သော ဒီဇိုင်းများကို မျှဝေထားသည်။ အလွန်သေးငယ်သော GB300 NVL72 liquid-cooled deployment တွင် မည်သည့်အရာများ ပါဝင်သည်ကို ကြည့်ရှုရန် Giga Computing ၏ GAIFA test bed ကို ကြည့်ပါ ။
ဟိုက်ပါရီယွန် နောက်ကလိုက်လာ
Meta သည် GB300 NVL72 နှင့် Vera Rubin NVL72 racks များ ရောနှော၍ Prometheus ကို ဆက်လက်တိုးချဲ့သွားမည်ဖြစ်ပြီး Vera Rubin သည် လက်ရှိ network fabric ပေါ်တွင် San Miguel platform မှတစ်ဆင့် ရောက်ရှိလာမည်ဖြစ်သည်။ New Albany မှ သင်ခန်းစာများသည် Hyperion ကို ထောက်ပံ့ပေးနေပြီး supercluster Meta သည် လူဝီစီယားနားပြည်နယ်၊ Richland Parish တွင် closed-loop liquid cooling၊ Entergy မှတစ်ဆင့် full grid ချိတ်ဆက်မှုနှင့် next generation network ဒီဇိုင်းများဖြင့် သုညမှ ဒီဇိုင်းထုတ်နေသည်။ Meta သည် နေရာနှစ်ခုလုံးတွင် စွမ်းအင်ကုန်ကျစရိတ်အပြည့်အဝကို ပေးဆောင်ပြီး ၎င်း၏အသုံးပြုမှုကို သန့်ရှင်းပြီး ပြန်လည်ပြည့်ဖြိုးမြဲစွမ်းအင်အသစ်များဖြင့် ကိုက်ညီစေကြောင်း ပြောကြားခဲ့သည်။
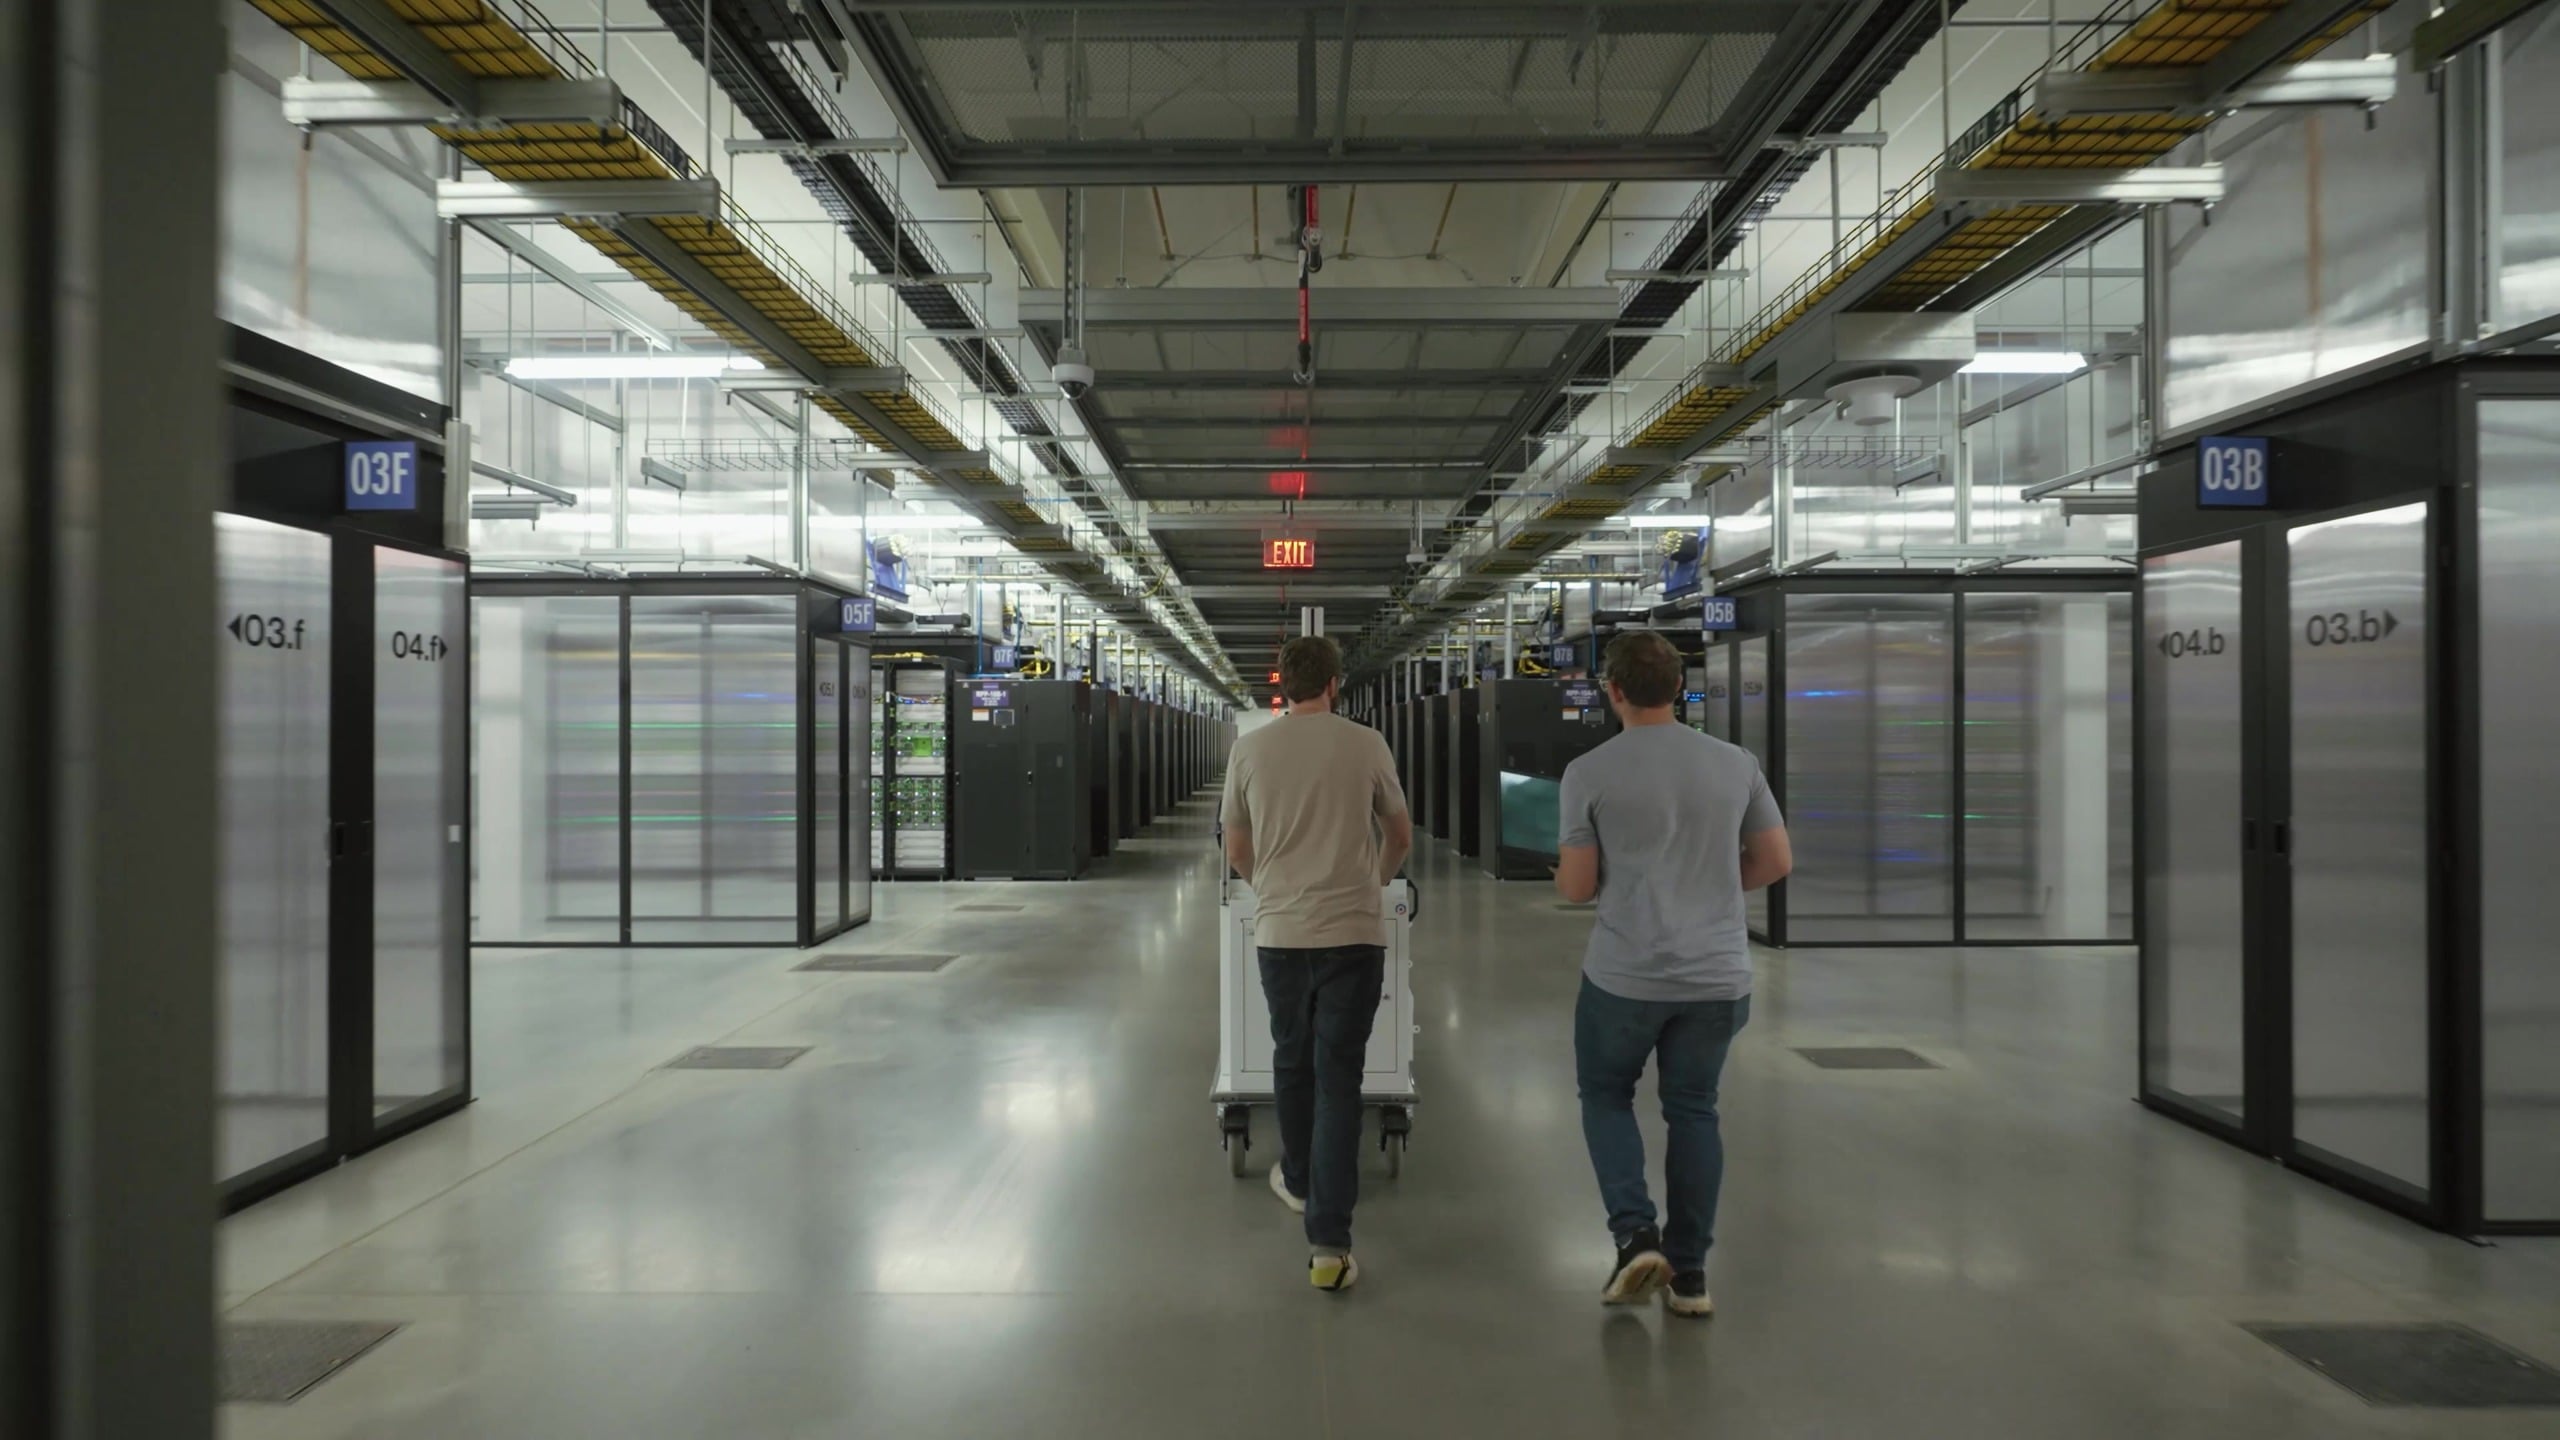
Meta ထုတ်ဝေခဲ့တာအများစုဟာ hyperscaler တွေ သူတို့ဘာသာသူတို့ သိမ်းထားလေ့ရှိတဲ့ လည်ပတ်မှုဆိုင်ရာ အသေးစိတ်အချက်အလက်တွေဖြစ်ပါတယ်- spare-GPU configuration၊ interruption rates၊ firmware rollout အချိန်နဲ့ Ariel configuration ရွေးချယ်မှုရဲ့ အကြောင်းရင်းတွေပါ။ အဓိကအချက်ကတော့ ဒီ scale မှာ hardware က အစပဲရှိပြီး GPU ထောင်ပေါင်းများစွာကို အသုံးပြုနိုင်တဲ့ training capacity အဖြစ် ပြောင်းလဲပေးတဲ့ အလုပ်က network၊ fault tolerance နဲ့ telemetry တွေမှာ ရှိပါတယ်။ AI ကို scale မှာ ဖြန့်ကျက်ဖို့ ရှာဖွေနေတဲ့ enterprise တွေအတွက် ဒီ Meta deep dive ဟာ ပြဿနာတွေ ဘယ်နေရာမှာ ပေါ်ပေါက်လာနိုင်လဲဆိုတာကို အနည်းဆုံး နားလည်ဖို့အတွက် ကောင်းမွန်တဲ့ အစပြုချက်တစ်ခုဖြစ်ပြီး အဖွဲ့အစည်းတွေဟာ သူတို့ရဲ့ data center estate တစ်ခုလုံးကို ကြိုတင်စီစဉ်နိုင်ပါတယ်။



 အမေဇုံ