

NVIDIA သည် GTC Berlin တွင် Minerva ကို ကြေငြာခဲ့ပြီး ၎င်းသည် GPU များ၊ ကွန်ရက်ချိတ်ဆက်မှု၊ သိုလှောင်မှု၊ အချိန်ဇယားဆွဲသူများနှင့် ၎င်းတို့ပေါ်တွင် လည်ပတ်နေသော AI workloads များမှ telemetry ကို ရယူပြီးနောက် လေ့ကျင့်ရေးအလုပ်တစ်ခုကို နှေးကွေးစေမည့် အစိတ်အပိုင်းတစ်ခုကို ရှာဖွေရန် machine learning ကို အသုံးပြုသည်။ Dell Technologies၊ Lenovo နှင့် Supermicro တို့သည် ၎င်းတို့၏ AI factory operations portfolios များတွင် ၎င်းကို ကမ်းလှမ်းမည်ဖြစ်ပြီး IREN သည် ၎င်းကို လည်ပတ်နေပြီဖြစ်ပြီး IBM၊ Jio၊ Lambda၊ Quake AI၊ Tesla၊ Aolani နှင့် Bitdeer AI တို့သည် ၎င်းကို ဖြန့်ကျက်ရန် စီစဉ်ထားသည်။ NVIDIA သည် ဈေးနှုန်း သို့မဟုတ် ယေဘုယျရရှိနိုင်မည့်ရက်စွဲကို မထုတ်ပြန်ရသေးပါ။
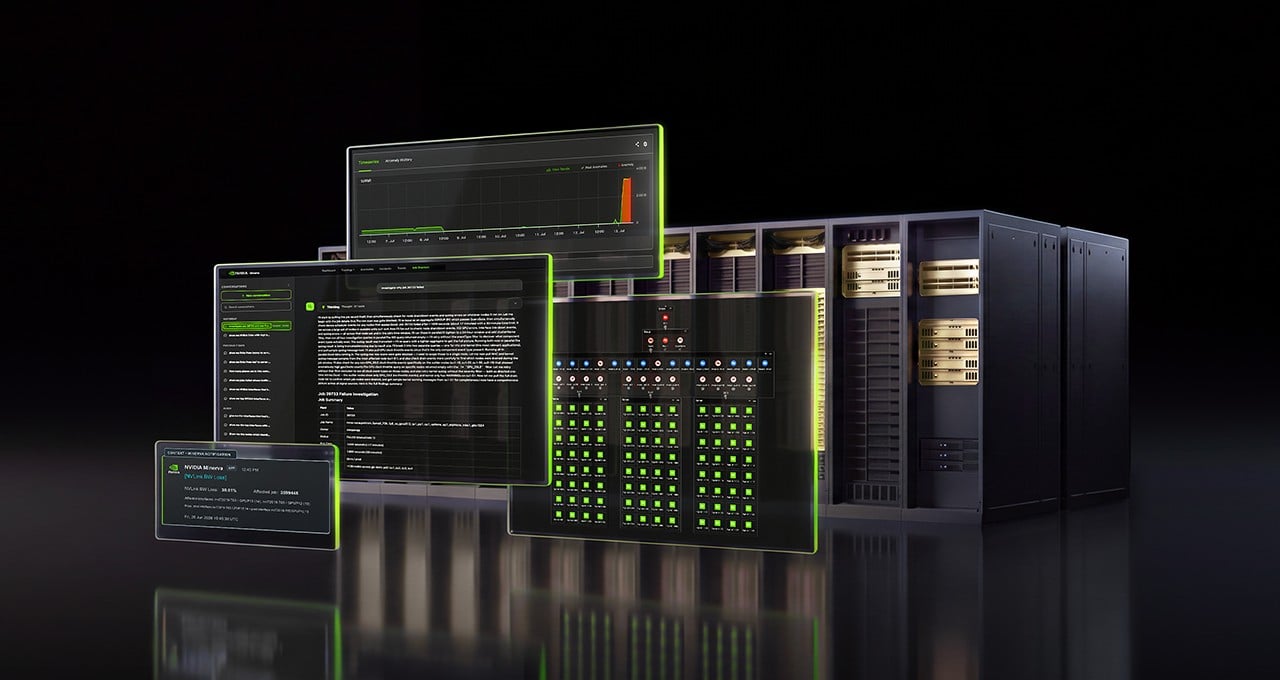
Minerva ပစ်မှတ်ထားတဲ့ပြဿနာက cluster operator ကြီးတိုင်းသိတဲ့ပြဿနာပါ။ မြန်နှုန်းမြင့် fabric ပေါ်က GPU ထောင်ပေါင်းများစွာဟာ စက်တစ်ခုတည်းလို လုပ်ဆောင်တာကြောင့် spec မပြည့်တဲ့ အစိတ်အပိုင်းတစ်ခုတည်းက အလုပ်တစ်ခုလုံးကို ဆွဲယူပါတယ်။ NVIDIA ရဲ့ ဥပမာတွေကတော့ အိမ်နီးချင်း GPU ထက် ပိုပူပြီး လည်ပတ်နေတဲ့နဲ့ NVMe drive က load လုပ်တဲ့အခါ စွမ်းဆောင်ရည် ကျဆင်းသွားတာမျိုးပါ။ ဒီနေ့ခေတ် networking tool၊ compute tool နဲ့ ML team ရဲ့ dashboard တွေမှာ ရှိနေတဲ့ data signal အမျိုးအစားဖြစ်ပြီး cluster တစ်ခုတည်းရဲ့ သီးခြား view ပါရှိပါတယ်။
မီနာဗာ နာရီတွေ
Minerva သည် GPU များ၊ SuperNIC များ၊ switch များ၊ cable များနှင့် ၎င်းတို့အပေါ်တွင် စီစဉ်ထားသော အလုပ်များကို မြေပုံဆွဲသည့် dynamic knowledge graph တစ်ခုကို တည်ဆောက်ပြီးနောက် supervised နှင့် unsupervised machine learning ဖြင့် NVIDIA မှ ဖော်ပြသည့် တစ်နာရီလျှင် ဘီလီယံနှင့်ချီသော data point များကို ခွဲခြမ်းစိတ်ဖြာသည်။ မော်ဒယ်များသည် စက်ရုံအတွက် ပုံမှန်အပြုအမူကို သင်ယူကြပြီး၊ ယခင်က မမြင်ဖူးသော ပုံမှန်မဟုတ်သော အရာများကို flag လုပ်ကြသည်၊ ဖြစ်ပေါ်လာသော failure များကို ခန့်မှန်းကြသည်၊ နှင့် topology ကို အသုံးပြု၍ ဆက်စပ်ဖြစ်ရပ်များကို ဆက်စပ်စေသည်၊ ထို့ကြောင့် NVIDIA သည် GPU ရာပေါင်းများစွာဖြင့် အရွယ်အစားရှိသော စက်ရုံများတစ်လျှောက်တွင် တာဝန်ရှိသော component သို့ နှေးကွေးသော training job တစ်ခုကို ခြေရာခံနိုင်သည်။
အထွက်ကို အဖြစ်အပျက်များအဖြစ် စီစဉ်ထားပြီး ဆက်စပ်ဖြစ်ရပ်များကို တစ်ခုတည်းသော အရာအဖြစ် အုပ်စုဖွဲ့ကာ ဖြစ်နိုင်ခြေရှိသော အရင်းခံအကြောင်းရင်းကို ပူးတွဲထားပြီး NVIDIA က သတိပေးချက်များစွာကို လုပ်ဆောင်နိုင်သော အရာတစ်ခုဖြင့် အစားထိုးပေးသည်ဟု ဆိုသည်။ built-in assistant သည် live telemetry နှင့်ပတ်သက်သည့် natural-language မေးခွန်းများကို ဖြေကြားပေးပြီး ပြင်ဆင်ရန် အကြံပြုပေးကာ platform သည် external agent tools များနှင့် ချိတ်ဆက်ပေးသည်။ Operators များသည် လူတစ်ဦးသည် ပြုပြင်မှုကို အသုံးချမည်လား သို့မဟုတ် Minerva သည် infrastructure APIs များနှင့် external systems များမှတစ်ဆင့် automation သို့ လွှဲပြောင်းပေးမည်လားဆိုသည်ကို ရွေးချယ်ကြသည်။
NVIDIA သည် အကျိုးအမြတ်ကို AI factory yield အဖြစ် ပုံဖော်ထားပြီး GPU နာရီများ၊ goodput၊ cluster uptime နှင့် token ထုတ်လုပ်မှုတို့ဖြင့် တိုင်းတာသည်။ ဖော်ပြထားသော ရလဒ်များမှာ အနှောင့်အယှက်များကြား အချိန်ပိုကြာခြင်း၊ ပြုပြင်မှုများ ပိုမိုမြန်ဆန်ခြင်းနှင့် triage အတွက် သတိပေးချက်များ နည်းပါးခြင်းဖြစ်ပြီး လုပ်ငန်းလည်ပတ်မှုအဖွဲ့သည် reactive မှ proactive maintenance သို့ ရွေ့လျားခြင်းတို့ ဖြစ်သည်။ ၎င်းတို့သည် ပူးတွဲပါ ကိန်းဂဏန်းများမပါဘဲ ရောင်းချသူများ၏ တောင်းဆိုချက်များဖြစ်သည်။ NVIDIA သည် Minerva အတွက် ပြုပြင်ရန် ပျမ်းမျှအချိန် သို့မဟုတ် uptime နံပါတ်များကို မထုတ်ပြန်ရသေးပါ။
၎င်းသည် Stack တွင်တည်ရှိသည့်နေရာ
NVIDIA သည် ၎င်း၏ ရည်ညွှန်းဒီဇိုင်းများအတွက် လုပ်ငန်းလည်ပတ်မှုဆော့ဖ်ဝဲကို ရောင်းချပြီးဖြစ်သည်။ ၂၀၂၅ ခုနှစ် မတ်လတွင် မိတ်ဆက်ခဲ့သော Mission Control သည် Base Command Manager မှတစ်ဆင့် cluster provisioning၊ Run:ai မှတစ်ဆင့် workload management၊ telemetry နှင့် DGX SuperPOD စနစ်များအတွက် autonomous job recovery တို့ကို ကိုင်တွယ်သည်။ Minerva ကဲ့သို့ တစ်ပတ်တည်းတွင် NVIDIA သည် AI factory lifecycle management အတွက် open source DSX OS အစိတ်အပိုင်းသုံးခုကို developer preview တွင် ထည့်သွင်းခဲ့သည်- network configuration အတွက် Config Manager၊ rack-level power၊ inventory၊ firmware နှင့် switch management အတွက် Rack Management Service နှင့် distributed workloads များဖြင့် GPU clusters များကို validation လုပ်ရန် Cluster Readiness Engine။
Minerva ရည်ရွယ်ထားတဲ့ ပြဿနာရဲ့ အတိုင်းအတာကို ပြီးခဲ့တဲ့အပတ်က Meta ရဲ့ Prometheus ရေးသားချက် မှာ ပြသထားပါတယ် ။ Meta ဟာ NVL72 domain တစ်ခုချင်းစီကို 64-GPU slice အနေနဲ့ လည်ပတ်ပြီး ကျန် GPU ရှစ်ခုကို in-rack spares အဖြစ် သိမ်းဆည်းထားပြီး rack ရဲ့ ၂ ရာခိုင်နှုန်းလောက်ကို အရန်အဖြစ် သိမ်းဆည်းထားကာ ပြုပြင်ထားတဲ့ system တိုင်းကို validation အောင်မြင်တဲ့အထိ quarantine လုပ်ထားပါတယ်။ NVIDIA အင်ဂျင်နီယာတွေနဲ့ တစ်နှစ်ကြာ site မှာ root cause work လုပ်ခြင်းအားဖြင့် interruptions တွေကို ၉၉ ရာခိုင်နှုန်း လျှော့ချပေးနိုင်ခဲ့ပြီး interruptions တွေကြားက ပျမ်းမျှအချိန်ကို GPU နာရီ ၅၄၀၀၀ ကျော်အထိ တွန်းအားပေးခဲ့ပြီး ၁၀၀၀၀၀ အထိ ပစ်မှတ်ထားနိုင်ခဲ့ပါတယ်။
အဲဒါက ရည်ရွယ်ချက်ရှိရှိတည်ဆောက်ထားတဲ့ telemetry pipeline နဲ့ NVIDIA နဲ့ ပူးတွဲ triage team ကို လုပ်ဆောင်နေတဲ့ hyperscaler တစ်ခုပါ။ Minerva ဟာ အဲဒီဘာသာရပ်ရဲ့ packaged version တစ်ခုလို့ ထင်ရပြီး GPU၊ fabric နဲ့ storage health တွေကို hyperscaler-grade visibility နဲ့ spare-and-restart workflow တွေကို လိုချင်တဲ့ enterprise ဒါမှမဟုတ် neocloud အတွက် out of the box နဲ့ ပိုနီးစပ်တဲ့ အရာတစ်ခုဖြစ်ပြီး rack တွေကို ရောင်းချတဲ့ OEM တွေကတစ်ဆင့် ပေးပို့ပါတယ်။
NVIDIA က Minerva ဟာ Mission Control ဒါမှမဟုတ် DSX OS နဲ့ ဘယ်လိုဆက်စပ်နေလဲ၊ software အနေနဲ့ပဲဖြစ်ဖြစ်၊ appliance အနေနဲ့ပဲဖြစ်ဖြစ်၊ hosted service အနေနဲ့ပဲဖြစ်ဖြစ်၊ ဒါမှမဟုတ် Dell, Lenovo နဲ့ Supermicro တို့ရဲ့ OEM packaging က ဘယ်လိုပုံစံရှိမလဲဆိုတာကို မပြောသေးပါဘူး။ ထုတ်ကုန်ရဲ့ documentation စာမျက်နှာက user guide အတွက် သူတို့ရဲ့ NVIDIA account team ဆီ customer တွေကို လမ်းညွှန်ပေးပါတယ်။ customer reference က IREN ဖြစ်ပြီး NVIDIA က Minerva ကို ဒီနေ့ AI factories တွေကို optimize လုပ်ဖို့ အသုံးပြုနေတယ်လို့ ပြောပါတယ်။
“NVIDIA Minerva က ကျွန်ုပ်တို့ရဲ့ လုပ်ငန်းလည်ပတ်မှုအဖွဲ့ကို ကွန်ရက်တစ်ခုလုံး၊ GPU တွေနဲ့ သူတို့လုပ်ဆောင်နေတဲ့ အလုပ်တွေကို တစ်ခုတည်းသော အမြင်နဲ့ ပေးပါတယ်” လို့ IREN ရဲ့ နည်းပညာအရာရှိချုပ် Denis Skrinnikoff က ပြောကြားခဲ့ပြီး အဖွဲ့ရဲ့အချိန်ကို ကြိုတင်ပြုပြင်ထိန်းသိမ်းမှုဆီ ပြောင်းလဲပေးခဲ့တယ်လို့ ယုံကြည်ခဲ့ပါတယ်။
အိမ်ရဲ့ storage ဘက်အတွက် စိတ်ဝင်စားစရာကောင်းတဲ့အချက်ကတော့ load လုပ်နေချိန်မှာ drive behavior ဟာ GPU နဲ့ fabric telemetry တွေနဲ့အတူ input တစ်ခုဖြစ်ပါတယ်၊ ဘာလို့လဲဆိုတော့ နှေးကွေးနေတဲ့ NVMe device တစ်ခုဟာ checkpoint ဒါမှမဟုတ် data-loading stage ရပ်တန့်သွားတဲ့အထိ GPU utilization မှာ ရှားရှားပါးပါးပေါ်လာတတ်လို့ပါ။ အဲဒီ storage telemetry ဘယ်လောက်ထိ နက်ရှိုင်းသွားလဲ၊ ဘယ် OEM နဲ့ array platform တွေက feed လုပ်သလဲဆိုတာက ဒီ solution ဈေးကွက်ထဲရောက်လာတာနဲ့အမျှ စိတ်ဝင်စားစရာကောင်းတဲ့ အသေးစိတ်အချက်အလက်တွေပါပဲ။



 အမေဇုံ