

NVIDIA GeForce RTX 5070 Ti edition ကတ်များကို ဖေဖော်ဝါရီလ ၂၀ ရက်နေ့တွင် MSRP $749 ဖြင့် စတင်ရောင်းချပါမည်။ Ti မော်ဒယ်များတွင် Founders Edition ဗားရှင်းများ မပါဝင်သောကြောင့် NVIDIA သည် စမ်းသပ်ရန်အတွက် ASUS Prime GeForce RTX 5070 Ti ကို ပေးဆောင်ထားပါသည်။ ၎င်းသည် entry-level RTX 5070 အထက်တွင် တည်ရှိပြီး RTX 5080 နှင့် နီးစပ်သော စွမ်းဆောင်ရည်ကို ပေးစွမ်းသည် ။ ၎င်းသည် အဆင့်မြှင့်တင်လိုသော ဂိမ်းကစားသူများ သို့မဟုတ် အလွန်အကျွံ သုံးစွဲခြင်းမရှိဘဲ entry-level AI workloads များသို့ ဝင်ရောက်နေသော အသုံးပြုသူများအတွက်လည်း ဆွဲဆောင်မှုရှိသော ရွေးချယ်မှုတစ်ခု ဖြစ်စေသည်။
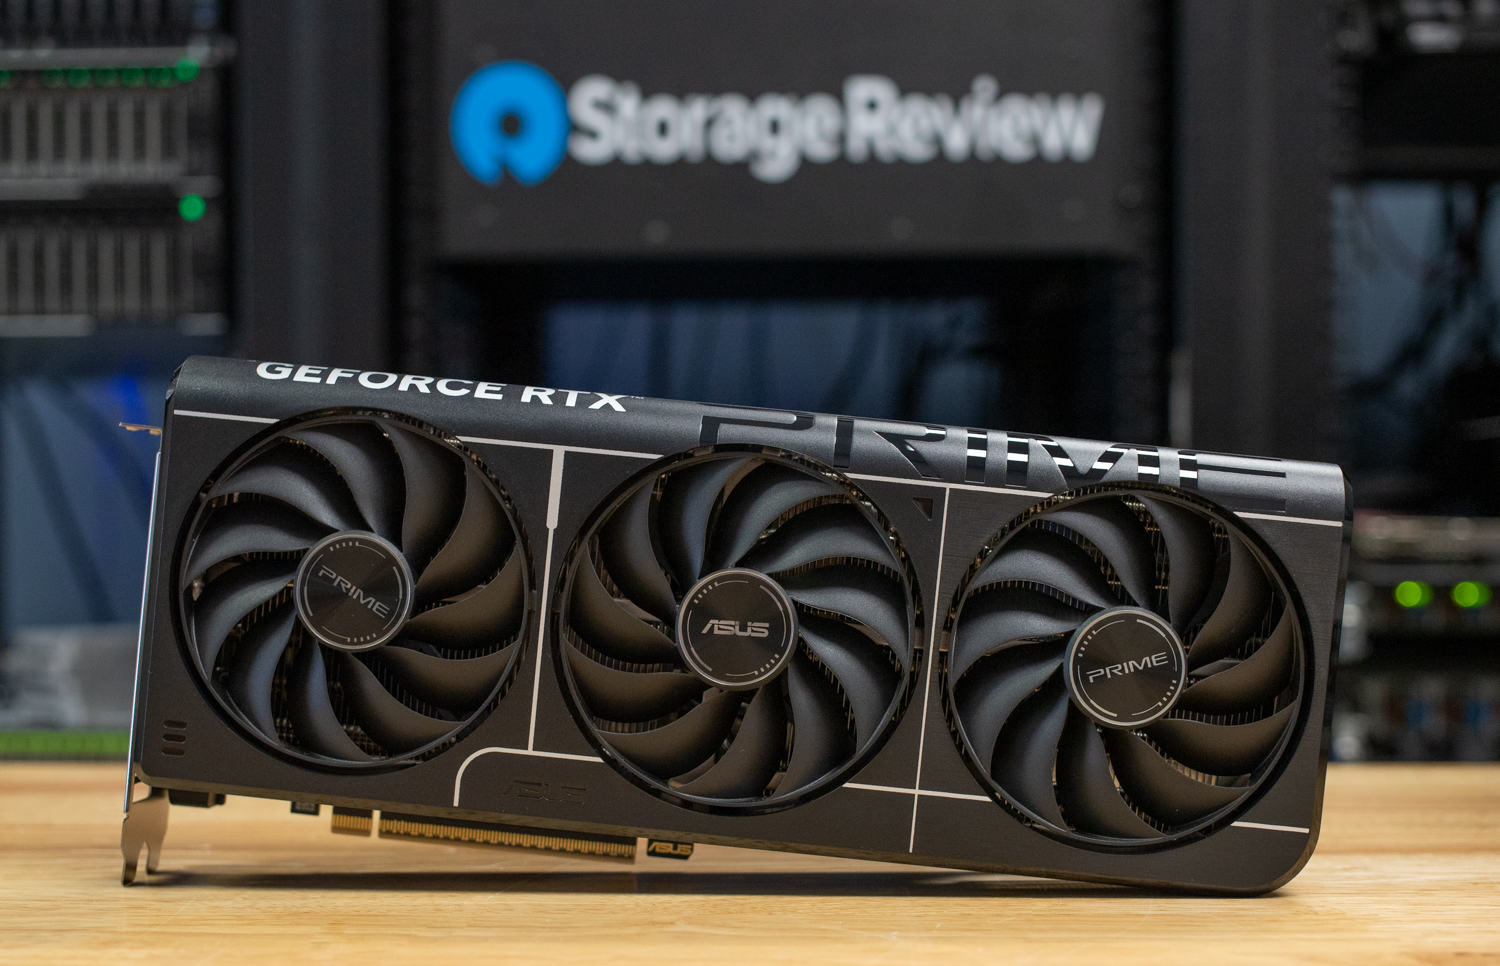
RTX 5090 နှင့် RTX 5080 ကဲ့သို့ အဆင့်မြင့် AI လုပ်ဆောင်ချက်များ တပ်ဆင်ထားသော ASUS Prime RTX 5070 Ti သည် NVIDIA ၏ နောက်ဆုံးပေါ် ဆန်းသစ်တီထွင်မှုများကို သင့်တင့်သော ဈေးနှုန်းဖြင့် ဂိမ်းကစားသူများထံ ယူဆောင်လာပါသည်။ ချောမွေ့သော စွမ်းဆောင်ရည်နှင့် အံ့မခန်း ရုပ်ထွက်များအတွက် Multi-Frame Generation နှင့် Ray Reconstruction ပါ၀င်သည့် DLSS 4 ပါ၀င်သည့် ၎င်းသည် NVIDIA Reflex 2 နှင့် Frame Warp တို့ဖြင့် ဂိမ်းတုံ့ပြန်မှုကို သေချာစေပြီး ယှဉ်ပြိုင်ကစားရန်အတွက် latency နည်းပါးစေပါသည်။ neural rendering ပါ၀င်သည့် ray tracing သည် စစ်မှန်သော ဂရပ်ဖစ်များကို ပေးစွမ်းပြီး ပိုမိုစွဲမက်ဖွယ်ကောင်းသော ဂိမ်းကစားခြင်း အတွေ့အကြုံကို ပေးစွမ်းသည်။
ASUS Prime RTX 5070 Ti GPU သတ်မှတ်ချက်များနှင့် နှိုင်းယှဉ်ချက်
ASUS PRIME RTX 5070 Ti မှာ CUDA cores ၈,၉၆၀ ပါဝင်ပြီး RTX 4070 Ti ရဲ့ ၇,၆၈၀ cores ထက် သိသိသာသာ မြင့်တက်လာပြီး RTX 5080 ရဲ့ ၁၀,၇၅၂ cores ထက် နိမ့်နေပါတယ်။ ဒီ core အရေအတွက် တိုးလာမှုနဲ့အတူ RTX 4070 Ti ရဲ့ 12GB GDDR6 ထက် များစွာ တိုးတက်မှု လိုအပ်တဲ့ 16GB GDDR7 memory ပါရှိပါတယ်။ ခေတ်မီဂိမ်းတွေဟာ သူတို့ရဲ့ high-resolution textures၊ complex geometry နဲ့ ray-traced effect တွေအတွက် VRAM ပိုမိုလိုအပ်လာတာကြောင့် GDDR7 memory 16GB ကို တိုးမြှင့်လိုက်တာက အရေးကြီးပါတယ်။
ထို့အပြင်၊ bandwidth တိုးလာခြင်းသည် VRAM တွင်သိမ်းဆည်းထားသော AI မော်ဒယ်များကို လျင်မြန်စွာဝင်ရောက်ကြည့်ရှုရန် လိုအပ်သည့် DLSS 4 နှင့် neural rendering ကဲ့သို့သော AI-enhanced gaming feature များအတွက် အထူးအကျိုးရှိပါသည်။ NVIDIA ၏ AI-powered NPC များကိုအသုံးပြုသောဂိမ်းများသည်လည်း ၎င်းတို့၏ neural network များကိုသိမ်းဆည်းရန် အပို VRAM လိုအပ်သောကြောင့် ချဲ့ထွင်ထားသော memory capacity မှ အကျိုးကျေးဇူးရရှိကြသည်။ တိုးမြှင့်ထားသော processing power နှင့် ပိုမိုမြန်ဆန်သော memory ပေါင်းစပ်မှုဖြင့် RTX 5070 Ti သည် flagship မော်ဒယ်များ၏ power နှင့် cost လိုအပ်ချက်များမရှိဘဲ gaming နှင့် AI-accelerated application များအတွက် အလွန်ကောင်းမွန်သောစွမ်းဆောင်ရည်ကို ပေးစွမ်းသည်။
ကျွန်တော်တို့ သုံးသပ်ထားတဲ့ မကြာသေးမီက ကတ်တွေရဲ့ အပြည့်အစုံကို ဖော်ပြပေးလိုက်ပါတယ်။
| GPU နှိုင်းယှဉ်ချက် | NVIDIA RTX4090 | NVIDIA RTX5070 | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 | NVIDIA RTX5090 |
| GPU ကိုအမည် | AD102 | GB205 | GB203 | GB203 | GB202 |
| ဗိသုကာအတတ်ပညာ | Ada Lovelace | ဘလက်ဝဲလ် ၂.၀ | ဘလက်ဝဲလ် ၂.၀ | ဘလက်ဝဲလ် ၂.၀ | ဘလက်ဝဲလ် ၂.၀ |
| လုပ်ငန်းစဉ်အရွယ်အစား | 5 nm | 5 nm | 5 nm | 5 nm | 5 nm |
| transistors | 76,300 သန်း | 31,000 သန်း | 45,600 သန်း | 45,600 သန်း | 92,200 သန်း |
| သိပ်သည်းဆ | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း |
| Size ကို Die | 609 mm² | 263 mm² | 378 mm² | 378 mm² | 744 mm² |
| slot အကျယ် | သုံးထပ် slot | Dual- slot | 2.5 ပေါက် | Dual- slot | Dual- slot |
| ရှုထောင့် | 304 137 မီလီမီတာမီလီမီတာမီလီမီတာ x x 61 | 242 မီလီမီတာ 112 မီလီမီတာ x | 304 126 50 မီလီမီတာ | 304 137 မီလီမီတာမီလီမီတာမီလီမီတာ x x 48 | 304 137 မီလီမီတာမီလီမီတာမီလီမီတာ x x 48 |
| TDP | 450 ဒဗလျူ | 250 ဒဗလျူ | 300 ဒဗလျူ | 360 ဒဗလျူ | 575 ဒဗလျူ |
| ဗီဒီယို ချိတ်ဆက်မှုများ | HDMI 2.1 ၁ ပေါက်၊ DisplayPort 1.4a ၃ ပေါက် | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1a ၃ ခု | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1b ၃ ခု | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1b ၃ ခု | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1b ၃ ခု |
| Power က Connectors | 1x 16 pin | 1x 16 pin | 1x 16 pin | 1x 16 pin | 1x 16 pin |
| ဘတ်စ်ကား Interface | PCIe 4.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 |
| base နာရီ | 2235 MHz | 2165 MHz | 2300 MHz | 2295 MHz | 2017 MHz |
| နာရီ Boost | 2520 MHz | 2510 MHz | OC မုဒ်: 2482MHz ပုံသေမုဒ်: 2452MHz (Boost Clock) |
2617 MHz | 2407 MHz |
| မှတ်ဉာဏ်နာရီ | 1313 MHz (21 Gbps ထိရောက်မှု) | 2209 MHz (28 Gbps ထိရောက်မှု) | 1750 MHz (28 Gbps ထိရောက်မှု) | 2366 MHz (30 Gbps ထိရောက်မှု) | 2209 MHz (28 Gbps ထိရောက်မှု) |
| memory အရွယ်အစား | 24 GB ကို | 12 GB ကို | 16 GB ကို | 16 GB ကို | 32 GB ကို |
| memory အမျိုးအစား | GDDR6X | GDDR7 | GDDR7 | GDDR7 | GDDR7 |
| မှတ်ဉာဏ်ဘတ်စ်ကား | 384 bit နဲ့ | 192 bit နဲ့ | 256 bit နဲ့ | 256 bit နဲ့ | 512 bit နဲ့ |
| မှတ်ဉာဏ် Bandwidth | ၁ TB / s | 672.2 GB ကို / s နဲ့ | 896.0 GB ကို / s နဲ့ | 960.0 GB ကို / s နဲ့ | ၁ TB / s |
| CUDA core | 16,384 | 6,144 | 8960 | 10,752 | 21,760 |
| TMU များ | 512 | 192 | 280 | 336 | 680 |
| ROPs | 176 | 64 | 128 | 128 | 192 |
| SM အရေအတွက် | 128 | 48 | 70 | 84 | 170 |
| Tensor core | 512 | 192 | 280 | 336 | 680 |
| RT ကို core | 128 | 48 | 70 | 84 | 170 |
| L1 ကက်ရှ် | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) |
| L2 ကက်ရှ် | 72 ကို MB | 40 ကို MB | 64 ကို MB | 64 ကို MB | 88 ကို MB |
| ပစ်ဇယ်နှုန်း | ၄၆၂.၁ GPixel/s | ၄၆၂.၁ GPixel/s | 313.9 GPixels/s | ၄၆၂.၁ GPixel/s | ၄၆၂.၁ GPixel/s |
| အသွင်အပြင်နှုန်း | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s |
| FP၁၆ (တစ်ဝက်) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) |
| FP32 (float) | 82.58 TFLOPS | 30.84 TFLOPS | 43.94 TFLOPS | 56.28 TFLOPS | 104.8 TFLOPS |
| FP64 (နှစ်ထပ်) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) |
| စတင်ရောင်းချသည့် ဈေးနှုန်း (USD) | $1,599 | $549 | $749 | $999 | $1,999 |
Blackwell ဗိသုကာနှင့် 50-series GPU များကို စွမ်းအားပေးသည့် ဆန်းသစ်တီထွင်မှုများအကြောင်း ပိုမိုနက်ရှိုင်းစွာ လေ့လာလိုပါက RTX 5080 နှင့် RTX 5090 series ကတ်များအကြောင်း ကျွန်ုပ်တို့၏ ယခင်သုံးသပ်ချက်နှစ်ခုကို ကြည့်ရှုပါ။
တည်ဆောက်ခြင်းနှင့်ဒီဇိုင်းဆွဲခြင်း
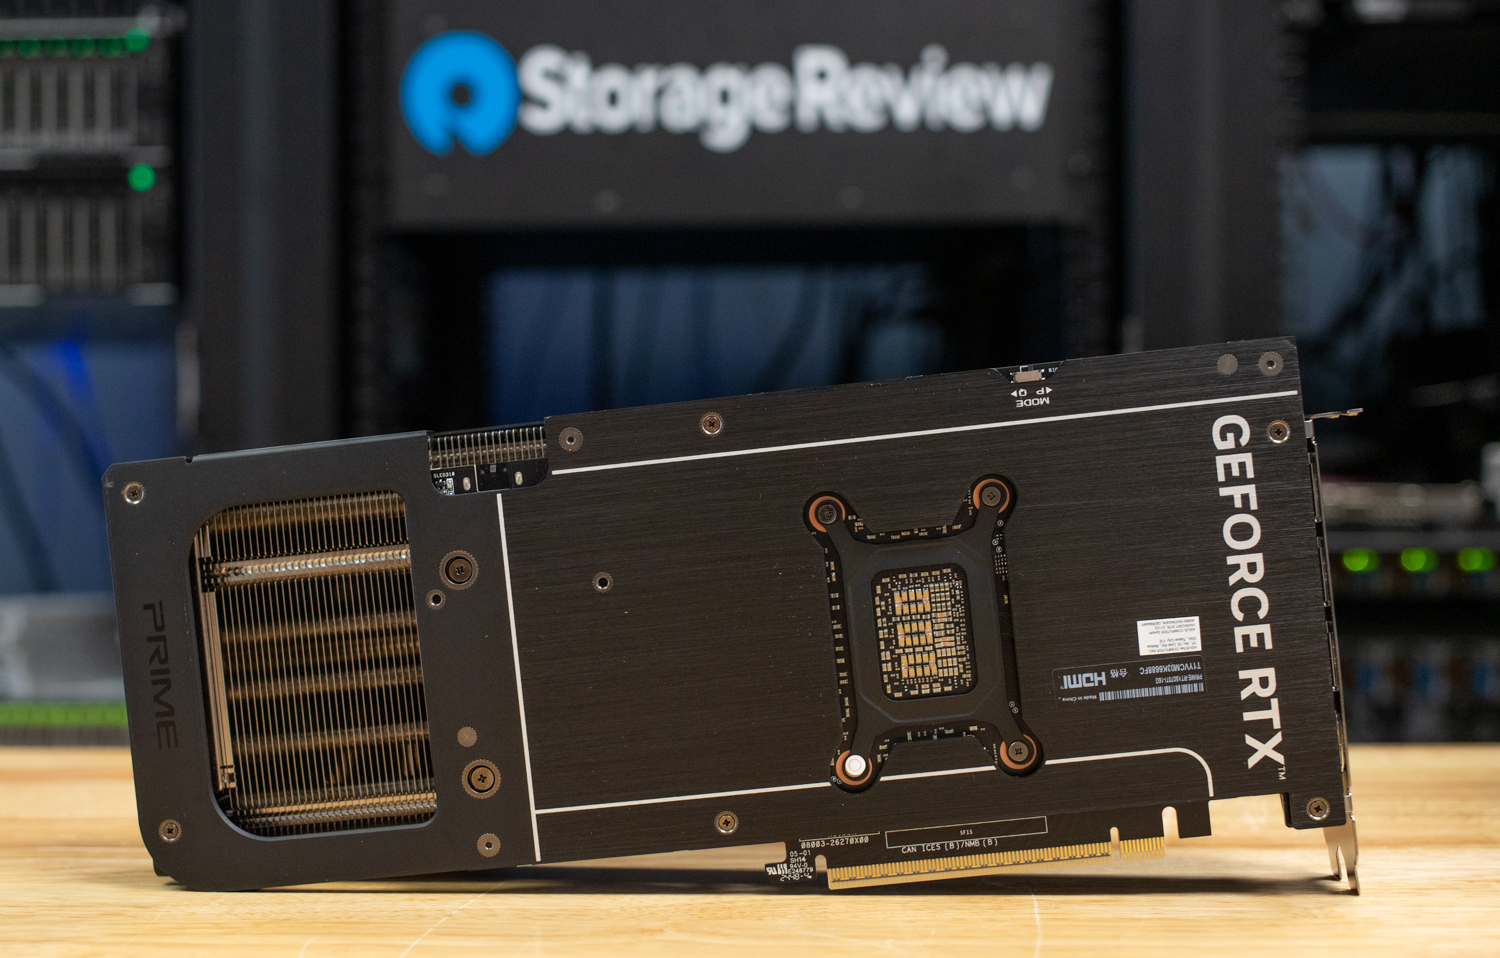
ဒီကတ်ရဲ့ အတိုင်းအတာက 12 x 5 x 2 လက်မ (304 x 126 x 50 mm) ဖြစ်ပြီး Founders Editions RTX 5080 နဲ့ RTX 5090 တို့ရဲ့ အရှည်နဲ့ အတူတူပဲဖြစ်ပေမယ့် ပိုထူတဲ့ 2.5-slot အကျယ်ဒီဇိုင်းနဲ့ ဖြစ်ပါတယ်။
အအေးပေးစနစ်အတွက် ASUS သည် တာရှည်ခံမှုကို မြှင့်တင်ပေးပြီး လေစီးဆင်းမှုကို တည်ငြိမ်စေရန်အတွက် ဘောလ်ဘယ်ရီနှစ်လုံးပါသည့် triple Axial-tech ပန်ကာဒီဇိုင်းကို အသုံးပြုထားသည်။ ဤစနစ်တွင် ကတ်တစ်ခုလုံးကို အပူပိုက်များဖြင့် ဖုံးအုပ်ထားပြီး အပူပျံ့နှံ့မှုကို အများဆုံးဖြစ်စေရန် လေဝင်လေထွက်ကောင်းသော backplate နှင့် ဘေးနှစ်ဖက်ပါရှိသော ကြီးမားသော heatsink ဖြင့် ဖြည့်စွက်ထားသည်။ ထို့အပြင် GPU အပူချိန် ၅၀ ဒီဂရီစင်တီဂရိတ်အောက်ရောက်သောအခါ ပန်ကာသုံးခုစလုံး ရပ်တန့်သွားပြီး လိုအပ်ချက်နည်းသော အလုပ်များ သို့မဟုတ် ဂိမ်းကစားခြင်းအပေါ့စားများတွင် တိတ်ဆိတ်စွာ လည်ပတ်နိုင်စေပါသည်။ အပူချိန် ၅၅ ဒီဂရီစင်တီဂရိတ်ထက်ကျော်လွန်သွားသည်နှင့် ပန်ကာများသည် အလိုအလျောက် ပြန်လည်စတင်ပါသည်။
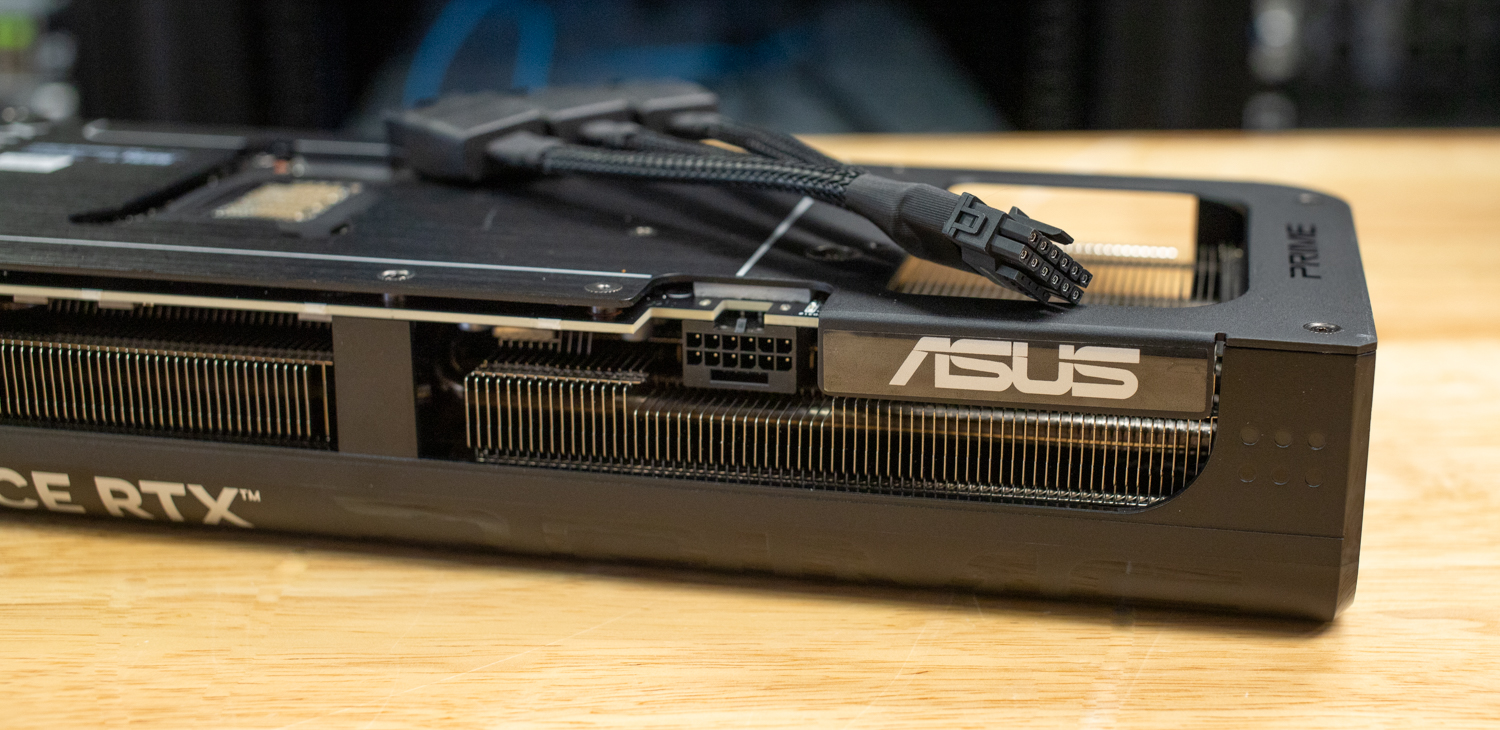 ပါဝါအတွက်၊ ယူနစ်တွင် အသစ်ထွက်ရှိသော ကတ်အများစုကဲ့သို့ပင် ကတ်၏ 300W အဆင့်သတ်မှတ်ထားသော ပါဝါဆွဲအားနှင့် ကိုက်ညီသော 12-pin မှ 3x 8-pin ပါဝါကြိုး ပါဝင်သည်။ အထက်ပါပုံတွင် ယူနစ်၏ အလူမီနီယမ်နောက်ခံပြားကို ပြသထားပြီး ၎င်းသည် ကတ်ကို ကာကွယ်ပေးပြီး နောက်ဘက်အစိတ်အပိုင်းများ၏ အလုံးစုံအအေးပေးစနစ်ကို အထောက်အကူပြုသည်။ နောက်ခံပြားသည် ကတ်၏ မာကျောမှုကိုလည်း မြှင့်တင်ရန် ကူညီပေးသည်။
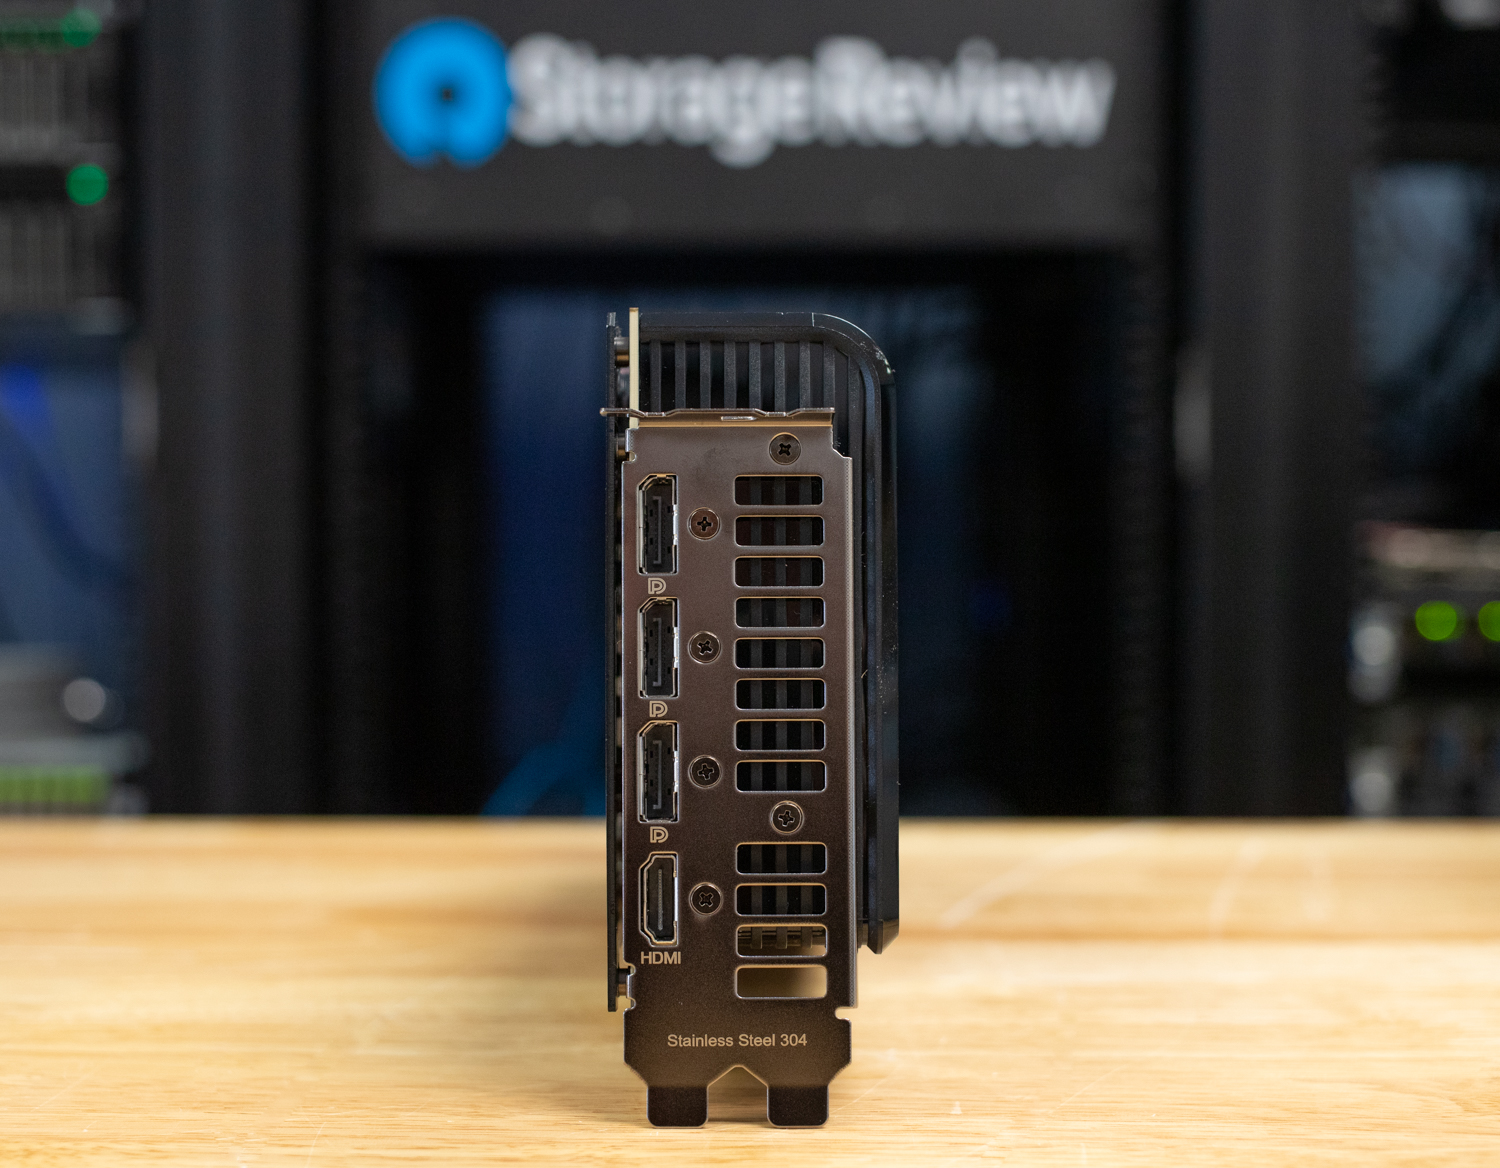
ကတ်ရဲ့နောက်ဘက်မှာ slot နှစ်ခုပါတဲ့ 304 stainless-steel backplate ကိုမြင်ရပေမယ့် cooler ရဲ့ထူထဲမှုကြောင့် ဒီကတ်မှာ slot ၂.၅ ခုနေရာယူထားတာကို သတိပြုဖို့အရေးကြီးပါတယ်။ display ချိတ်ဆက်မှုအတွက် 1x HDMI 2.1b နဲ့ 3x DisplayPort 2.1b တို့ကို ပံ့ပိုးပေးထားတာကြောင့် resolution မြင့်တဲ့ဂိမ်းကစားခြင်း ဒါမှမဟုတ် ပရော်ဖက်ရှင်နယ်အလုပ်တွေအတွက် ခေတ်မီ display အမျိုးမျိုးနဲ့ တွဲဖက်အသုံးပြုနိုင်ပါတယ်။
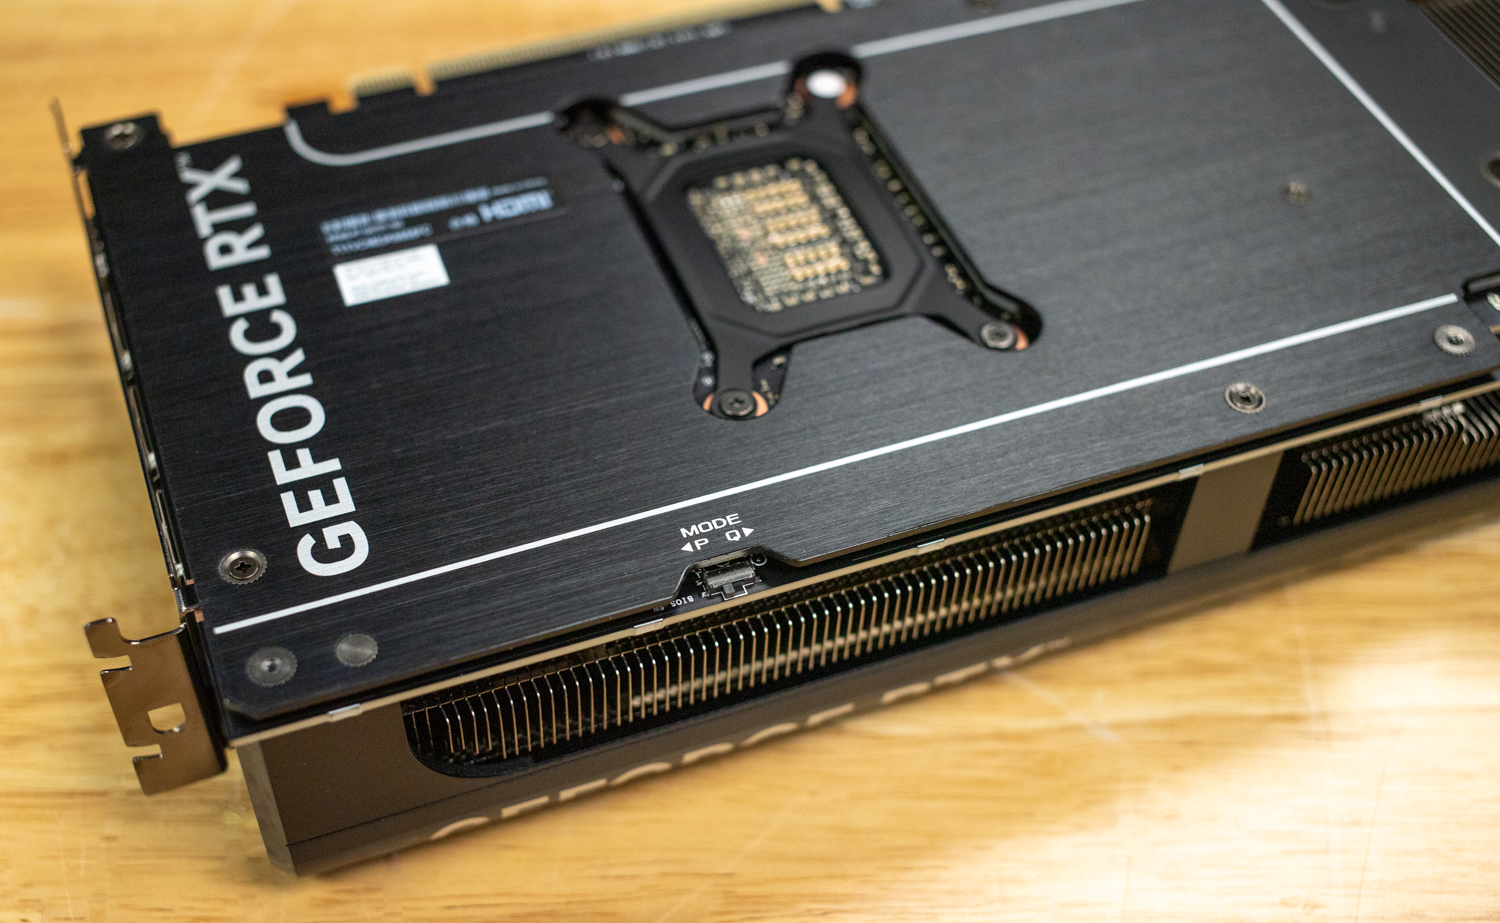
ဒီကတ်ရဲ့ အခြားထင်ရှားတဲ့အင်္ဂါရပ်တွေကတော့ ကတ်ပေါ်က ခလုတ်တစ်ခုကနေတစ်ဆင့် ထိန်းချုပ်နိုင်တဲ့ BIOS ပါဝင်ပြီး “P” (စွမ်းဆောင်ရည်) မုဒ်နဲ့ “Q” (တိတ်ဆိတ်) မုဒ်ကို ပြောင်းလဲပေးပါတယ်။ ဒီယူနစ်မှာ အအေးပေးစွမ်းဆောင်ရည်နဲ့ ချစ်ပ်နဲ့ထိတွေ့နေတဲ့ အပူပစ္စည်းရဲ့ ကြာရှည်ခံမှုကို မြှင့်တင်ပေးဖို့ ဒီဇိုင်းထုတ်ထားတဲ့ phase-change thermal pad တစ်ခုလည်း ပါဝင်ပါတယ်။ နောက်ဆုံးအနေနဲ့ ASUS က ကတ်ရဲ့ စွမ်းဆောင်ရည်ကို သီးခြားလိုအပ်ချက်တွေနဲ့ ကိုက်ညီအောင် ချိန်ညှိပေးနိုင်တဲ့ GPU Tweak III software ကို ပံ့ပိုးပေးပါတယ်။
စံသတ်မှတ်ခြင်း- ASUS Prime RTX 5070 Ti
ASUS Prime GeForce RTX 5070 Ti ကို အကောင်းဆုံးဖြစ်အောင် လုပ်ဆောင်ဖို့အတွက်၊ ကျွန်တော်တို့ရဲ့ မြင့်မားတဲ့စွမ်းဆောင်ရည်ရှိတဲ့ AMD Threadripper platform ကို အသုံးပြုခဲ့ပါတယ်။ 64-core CPU နဲ့ custom water cooling loop ပါဝင်တာကြောင့် ဒီစနစ်က GPU ဟာ CPU bottleneck မရှိဘဲ အပြည့်အဝစွမ်းဆောင်ရည်နဲ့ လည်ပတ်နိုင်စေပါတယ်။ Founders RTX 5080, RTX 5090, နဲ့ RTX 4090 တို့ကို စမ်းသပ်ဖို့အတွက်လည်း အဲဒီ configuration ကို အသုံးပြုခဲ့ပြီး ကတ်အားလုံးမှာ တရားမျှတပြီး တသမတ်တည်း နှိုင်းယှဉ်မှုကို သေချာစေပါတယ်။ မှတ်သားထားရမယ့် သိမ်မွေ့တဲ့အချက်တစ်ခုကတော့ ကျွန်တော်တို့ရဲ့ စမ်းသပ်မှုတွေကို ဒီကတ်မှာ “P” mode မှာ ပြုလုပ်ခဲ့တာပါ။
အောက်တွင် စနစ်ဖွဲ့စည်းပုံ အပြည့်အစုံကို ဖော်ပြထားသည်။
StorageReview AMD Threadripper စမ်းသပ်ပလက်ဖောင်း
- motherboard: ASUS Pro WS TRX50-SAGE WIFI
- CPU ကို: AMD Ryzen Threadripper 7980X 64-Core
- ရမ်: 32GB DDR5 4800MT/s
- သိုလှောင်မှု: 2TB Samsung 980 Pro
- OS ကို: Workstations အတွက် Windows 11 Pro
- ကားမောင်းသူ: NVIDIA 571.86 GameReady ဒရိုက်ဘာ
UL Procyon: AI စာသားထုတ်လုပ်ခြင်း
Procyon AI Text Generation Benchmark သည် ကျစ်လစ်ပြီး တသမတ်တည်းရှိသော အကဲဖြတ်နည်းလမ်းကို ပေးဆောင်ခြင်းဖြင့် AI LLM စွမ်းဆောင်ရည်စမ်းသပ်မှုကို ရိုးရှင်းစေသည်။ ၎င်းသည် မော်ဒယ်အရွယ်အစားကြီးများနှင့် variable factor များ၏ ရှုပ်ထွေးမှုကို လျှော့ချနေစဉ်တွင် LLM မော်ဒယ်များစွာတွင် ထပ်ခါတလဲလဲ စမ်းသပ်နိုင်စေပါသည်။ AI hardware ဦးဆောင်သူများနှင့်အတူ တီထွင်ထားသောကြောင့် ပိုမိုယုံကြည်စိတ်ချရပြီး ထိရောက်သော စွမ်းဆောင်ရည်အကဲဖြတ်မှုများအတွက် ဒေသတွင်း AI accelerator များအသုံးပြုမှုကို အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ပေးပါသည်။ အောက်တွင်တိုင်းတာထားသော ရလဒ်များကို TensorRT ကို အသုံးပြု၍ စမ်းသပ်ခဲ့သည်။
| UL Procyon: AI စာသားထုတ်လုပ်ခြင်း | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 | NVIDIA RTX5090 | NVIDIA RTX4090 |
| Phi ၏ စုစုပေါင်းရမှတ် | 4,179 | 4,400 | 5,749 | 4,958 |
| ပထမဆုံးတိုကင်သို့ Phi ထုတ်ပေးချိန် | 0.290 ့ | 0.277 ့ | 0.244 ့ | 0.255 ့ |
| တစ်စက္ကန့်လျှင် Phi အထွက်တိုကင်များ | 192.487 တိုကင်/s | 209.459 တိုကင်/s | 314.435 တိုကင်/s | 244.343 တိုကင်/s |
| Phi ၏ စုစုပေါင်းကြာချိန် | 15.771 ့ | 14.908 ့ | 10.280 ့ | 12.872 ့ |
| Mistral ၏ စုစုပေါင်းရမှတ် | 4,412 | 4,635 ့ | 6,267 | 5,094 |
| Mistral ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.374 ့ | 0.347 ့ | 0.297 ့ | 0.322 ့ |
| တစ်စက္ကန့်လျှင် Mistral Output Tokens များ | 160.167 တိုကင်/s | 163.598 တိုကင်/s | 255.945 တိုကင်/s | 183.266 တိုကင်/s |
| Mistral ၏ စုစုပေါင်းကြာချိန် | 19.480 ့ | 18.933 ့ | 12.593 ့ | 17.010 ့ |
| Llama3 အလုံးစုံရမှတ် | 4,187 | 4,424 | 6,104 | 4,849 |
| Llama3 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.306 ့ | 0.283 ့ | 0.234 ့ | 0.259 ့ |
| တစ်စက္ကန့်လျှင် Llama3 အထွက်တိုကင်များ | 131.853 တိုကင်/s | 136.177 တိုကင်/s | 214.285 တိုကင်/s | 150.039 တိုကင်/s |
| Llama3 ၏ စုစုပေါင်းကြာချိန် | 22.786 ့ | 21.985 ့ | 14.304 ့ | 19.991 ့ |
| Llama2 အလုံးစုံရမှတ် | 4,284 | 4,790 | 6,591 | 5,013 |
| Llama2 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.560 ့ | 0.493 ့ | 0.419 ့ | 0.500 ့ |
| တစ်စက္ကန့်လျှင် Llama2 အထွက်တိုကင်များ | 75.905 တိုကင်/s | 83.653 တိုကင်/s | 134.502 တိုကင်/s | 92.853 တိုကင်/s |
| Llama2 ၏ စုစုပေါင်းကြာချိန် | 39.545 | 35.703 | 23.018 ့ | 32.448 ့ |
စာသားထုတ်လုပ်ခြင်းစမ်းသပ်မှုတွင်၊ စီးရီးတွင် အသက်သာဆုံးကတ်ဖြစ်သည့် RTX 5070 Ti သည် AI စာသားထုတ်လုပ်ခြင်းတွင် RTX 5080 နှင့် အံ့သြစရာကောင်းလောက်အောင် နီးကပ်သောစွမ်းဆောင်ရည်ကို ပေးစွမ်းသည်။ Phi benchmark သည် ၄,၁၇၉ vs. ၄,၄၀၀ ရရှိခဲ့ပြီး တစ်စက္ကန့်လျှင် တိုကင်များ (၁၉၂.၄၈၇ vs. ၂၀၉.၄၆) နှင့် ಒಟ್ಟಾರೆကြာချိန် (၁၅.၇၇ vs. ၁၄.၉၁) တွင် အနည်းငယ်ကွာခြားသည်။ Mistral နှင့် Llama3 benchmark များသည် အလားတူလမ်းကြောင်းများကို ပြသထားပြီး တိုကင် throughput တွင် မသိမသာကွာခြားမှုရှိသည်။ Llama2 သည် ပိုမိုသိသာထင်ရှားသောကွာဟချက်ကို ပြသပြီး 5070 Ti သည် ၄,၂၈၄ vs. ၄,၇၉၀ ရမှတ်ရရှိခဲ့ပြီး တစ်စက္ကန့်လျှင် တိုကင် ၇၅.၉၁ vs. ၈၃.၆၅ ကို လုပ်ဆောင်ခဲ့သည်။ သို့တိုင်၊ စမ်းသပ်မှုအားလုံးတွင် 5070 Ti သည် 5080 ၏စွမ်းဆောင်ရည်နှင့် နီးစပ်နေဆဲဖြစ်ပြီး ဘတ်ဂျက်နည်းပြီး AI စာသားထုတ်လုပ်ခြင်းအလုပ်များကို လုပ်ဆောင်လိုသူများအတွက် ထူးချွန်သောရွေးချယ်မှုတစ်ခုဖြစ်စေသည်။
UL ပရိုဆိုင်ယွန်- AI ရုပ်ပုံမျိုးဆက်
Procyon AI Image Generation Benchmark သည် ပါဝါနည်း NPU များမှ အဆင့်မြင့် GPU များအထိ မတူညီသော ဟာ့ဒ်ဝဲများတွင် AI inference စွမ်းဆောင်ရည်ကို စဉ်ဆက်မပြတ်နှင့် တိကျစွာ တိုင်းတာပေးသည်။ ၎င်းတွင် စမ်းသပ်မှုသုံးခု ပါဝင်သည်- အဆင့်မြင့် GPU များအတွက် Stable Diffusion XL (FP16)၊ အလယ်အလတ် ပါဝါအားကောင်း GPU များအတွက် Stable Diffusion 1.5 (FP16) နှင့် ပါဝါနည်း စက်ပစ္စည်းများအတွက် Stable Diffusion 1.5 (INT8)။ benchmark သည် စနစ်တစ်ခုစီအတွက် အကောင်းဆုံး inference engine ကိုအသုံးပြုပြီး တရားမျှတပြီး နှိုင်းယှဉ်နိုင်သော ရလဒ်များကို သေချာစေသည်။
| UL Procyon: AI Image Generation (အလုံးစုံရမှတ်- မြင့်လေ ပိုကောင်းလေ) | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 | NVIDIA RTX5090 | NVIDIA RTX4090 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — အလုံးစုံရမှတ် | 3,755 | 4,650 | 8,193 | 5,260 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — ಒಟ್ಟಾರೆအချိန် | 26.625 ့ | 21.503 ့ | 12.204 ့ | 19.011 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) — အလုံးစုံရမှတ် | 46,744 | 55,683 | 79,272 | 62,160 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) — ಒಟ್ಟಾರೆအချိန် | 5.348 ့ | 4.490 ့ | 3.154 ့ | 4.022 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — အလုံးစုံရမှတ် | 3,352 | 4,257 | 7,179 | 5,025 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — ಒಟ್ಟಾರೆအချိန် | 178.946 ့ | 140.928 | 83.573 ့ | 119.379 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) — ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
AI ပုံရိပ်ထုတ်လုပ်မှုတွင် RTX 5070 Ti သည် လေးစားဖွယ်ကောင်းသော စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်သော်လည်း မျှော်လင့်ထားသည့် RTX 5080 ထက် နောက်ကျနေပါသည်။ Stable Diffusion 1.5 (FP16) သည် 5080 ၏ 1.344 စက္ကန့်နှင့် နှိုင်းယှဉ်ပါက 1.664 စက္ကန့်အတွင်း ပုံတစ်ပုံကို ပြီးမြောက်စေပြီး စုစုပေါင်းရမှတ် 3,755 နှင့် 4,650 ရရှိခဲ့သည်။ INT8 ဗားရှင်းသည် ကွာဟချက်ကို အနည်းငယ်ကျဉ်းမြောင်းစေသော်လည်း 5070 Ti သည် 5080 ၏ 0.561 စက္ကန့်နှင့် နှိုင်းယှဉ်ပါက 0.669 စက္ကန့်ဖြင့် ပုံတစ်ပုံစီကို ထုတ်လုပ်ပေးနေဆဲဖြစ်သည်။ အထင်ရှားဆုံး ကွာခြားချက်မှာ Stable Diffusion XL (FP16) တွင် ပေါ်လာပြီး 5070 Ti သည် ပုံတစ်ပုံလျှင် 11.184 စက္ကန့်ကြာပြီး 5080 သည် 8.808 စက္ကန့်ဖြင့် သိသိသာသာ ပိုမြန်သည်။ အဆင့်သတ်မှတ်ချက် နိမ့်သော်လည်း 5070 Ti သည် AI မောင်းနှင်သော ပုံရိပ်ထုတ်လုပ်မှုသို့ ဝင်ရောက်လိုသော ဘတ်ဂျက်ကို သတိထားသော အသုံးပြုသူများအတွက် လက်တွေ့ကျသော ရွေးချယ်မှုတစ်ခု ဖြစ်နေဆဲဖြစ်သည်။
လပ်စ်မာ့ခ်
Luxmark သည် open-source ray tracing renderer ဖြစ်သော LuxRender ကို အသုံးပြု၍ အသေးစိတ်ကျသော 3D မြင်ကွင်းများကို ကိုင်တွယ်ရာတွင် စနစ်၏စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည့် GPU benchmark တစ်ခုဖြစ်သည်။ ဤ benchmark သည် server များနှင့် workstation များ၏ graphical rendering စွမ်းရည်ကို အကဲဖြတ်ရန်အတွက် အထူးသဖြင့် visual effect များနှင့် architectural visualization application များအတွက် တိကျသော အလင်း simulation သည် အရေးကြီးပါသည်။
| Luxmark (မြင့်လေ ပိုကောင်းလေ) | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 | NVIDIA RTX5090 | NVIDIA RTX4090 |
| အစားအသောက်ရမှတ် | 12,073 | 13,637 | 23,141 | 17,171 |
| ခန်းမရမှတ် | 28,635 | 30,815 | 51,725 | 38,887 |
LuxMark မှာ RTX 5070 Ti ဟာ 5080 နဲ့ ယှဉ်ရင် ကွာဟချက် အနည်းဆုံးနဲ့ ခိုင်မာတဲ့ စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ပါတယ်။ “Food” ကဏ္ဍမှာ ရမှတ် ၁၂,၀၇၃ ရရှိပြီး 5080 ရဲ့ ၁၃,၆၃၇ ထက် အနည်းငယ် နောက်ကျနေပြီး “Hall” ကဏ္ဍမှာတော့ ရမှတ် ၂၈,၆၃၅ ရရှိကာ ၃၀,၈၁၅ ရရှိပါတယ်။ ဒီကွာခြားချက်က အတော်လေး သေးငယ်ပြီး 5070 Ti ဟာ ပိုပြီး သင့်တင့်တဲ့ ဈေးနှုန်းနဲ့ ကောင်းမွန်တဲ့ rendering စွမ်းရည်တွေကို ပေးစွမ်းနိုင်ဆဲပါ။
Geekbench 6
Geekbench 6 သည် အလုံးစုံစနစ်စွမ်းဆောင်ရည်ကို တိုင်းတာသည့် cross-platform benchmark တစ်ခုဖြစ်သည်။ Geekbench Browser သည် မည်သည့်စနစ်နှင့်မဆို နှိုင်းယှဉ်နိုင်စေပါသည်။
| Geekbench (မြင့်လေ ပိုကောင်းလေ) | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 | NVIDIA RTX5090 | NVIDIA RTX4090 |
| GPU OpenCL ရမှတ် | 246,875 | 265,397 | 374,807 | 333,384 |
Geekbench မှာ GPU OpenCL ရမှတ် ၂၄၆,၈၇၅ ရရှိထားတဲ့ RTX 5070 Ti ဟာ ဂိမ်းကစားခြင်း၊ ဗီဒီယိုတည်းဖြတ်ခြင်းနဲ့ အကြောင်းအရာဖန်တီးမှုစွမ်းဆောင်ရည်တွေကို ကောင်းမွန်တဲ့စွမ်းဆောင်ရည်နဲ့ ပေးစွမ်းနိုင်ပါတယ်။ 5080 ဒါမှမဟုတ် 5090 လို အဆင့်မြင့်မော်ဒယ်တွေရဲ့ ပရီမီယံဈေးနှုန်းမပါဘဲ ကောင်းမွန်တဲ့ပါဝါကို ပေးစွမ်းနိုင်တဲ့ အလယ်အလတ်တန်းစား ရွေးချယ်မှုကောင်းတစ်ခုဖြစ်ပြီး အလားအလာကောင်းတွေကို ပြသနေဆဲပါ။ မြင့်မားတဲ့ setting တွေမှာ 1440p ဒါမှမဟုတ် 4K ဂိမ်းကစားဖို့အတွက် အလွန်ကောင်းမွန်ပါတယ်။
V Ray
V -Ray Benchmark သည် အဆင့်မြင့် V-Ray 6 အင်ဂျင်များကို အသုံးပြု၍ CPU များ၊ NVIDIA GPU များ သို့မဟုတ် နှစ်မျိုးလုံး၏ rendering စွမ်းဆောင်ရည်ကို တိုင်းတာသည်။ ၎င်းသည် အသုံးပြုသူများ ၎င်းတို့၏စနစ်များ၏ rendering စွမ်းရည်များကို အကဲဖြတ်ရန်နှင့် နှိုင်းယှဉ်နိုင်ရန် မြန်ဆန်သော စမ်းသပ်မှုများနှင့် ရိုးရှင်းသော အမှတ်ပေးစနစ်ကို အသုံးပြုသည်။ ၎င်းသည် ထိရောက်သော စွမ်းဆောင်ရည်ဆိုင်ရာ ထိုးထွင်းသိမြင်မှုများကို ရှာဖွေနေသော ပရော်ဖက်ရှင်နယ်များအတွက် မရှိမဖြစ်ကိရိယာတစ်ခုဖြစ်သည်။
| V-Ray (မြင့်လေ ပိုကောင်းလေ) | ASUS Prime NVIDIA RTX 5070 Ti | NVIDIA RTX5080 | NVIDIA RTX5090 | NVIDIA RTX4090 |
| vpath များ | 8,018 | 9,311 | 14,764 | 10,847 |
နောက်ဆုံးအနေနဲ့ V-Ray မှာ RTX 5070 Ti ဟာ V-Ray ရမှတ် 0,018 vpaths ရှိပြီး 5080 ထက် အနည်းငယ်နောက်ကျပြီး vpaths 9,311၊ vpaths 5090 14,764 နဲ့ vpaths 4090 10,847 တို့နဲ့ အနည်းငယ်သာ ကွာဟနေပါတယ်။ rendering task တွေအတွက် အလားအလာကောင်းတွေ ပြသနေပေမယ့် high-end မော်ဒယ်တွေကတော့ ပိုရှုပ်ထွေးတဲ့ workloads တွေအတွက် သိသိသာသာ ပိုမြန်တဲ့ စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ပါတယ်။
ပါဝါသုံးစွဲမှု စံနှုန်းသတ်မှတ်ခြင်း
ပါဝါသုံးစွဲမှုသည် မည်သည့် high သို့မဟုတ် low-end computing platform တွင်မဆို သိသာထင်ရှားသော အစိတ်အပိုင်းတစ်ခုဖြစ်သည်။ GPU မျိုးဆက်သစ်တစ်ခုစီသည် load အောက်တွင် ပါဝါပိုမိုသုံးစွဲပြီး ဆိုလိုသည်မှာ power supply များ ပိုမိုများပြားပြီး အအေးပေးရန်အတွက် လေစီးဆင်းမှု လုံလောက်ပါသည်။ သို့သော် ပါဝါစွမ်းဆောင်ရည်နှင့်ပတ်သက်သည့် အခြားရှုထောင့်တစ်ခုရှိသည်- ပိုမိုမြန်ဆန်သော GPU များသည် ပိုမိုမြင့်မားစွာ မြင့်တက်လာနိုင်သော်လည်း workload တစ်ခုချင်းစီ၏ ကြာချိန် လျော့ကျသွားသည်။
CES 2025 မှာ NVIDIA ဟာ Blackwell ဗိသုကာရဲ့ ပါဝါထိရောက်မှု တိုးတက်လာမှုကို မီးမောင်းထိုးပြခဲ့ပြီး AI-driven workload အတွင်းမှာ လက်တွေ့လုပ်ဆောင်နေတာကို မြင်တွေ့လိုခဲ့ပါတယ်။ ကျွန်တော်တို့ရဲ့ စမ်းသပ်ဓာတ်ခွဲခန်းမှာ Quarch Mains Analyzer ကို အသုံးပြုပြီး Procyon AI Image Generator Stable Diffusion XL FP16 စမ်းသပ်မှုကို လုပ်ဆောင်နေစဉ်မှာ စုစုပေါင်းစနစ် ပါဝါသုံးစွဲမှုကို တိုင်းတာခဲ့ပါတယ် ။ ဒီ workload က GPU တစ်ခုချင်းစီကို သူ့ရဲ့ ပါဝါကန့်သတ်ချက်တွေအထိ တွန်းပို့ခဲ့ပြီး generated image တစ်ခုချင်းစီအတွက် ရှင်းလင်းတဲ့ စတင်မှုနဲ့ ရပ်တန့်မှုအမှတ်တွေ ပေးခဲ့ပါတယ်။ ဒီအပိုင်းမှာ GeForce RTX 5090 အသစ်ရဲ့ ရလဒ်တွေနဲ့ ယခင်မျိုးဆက် GeForce RTX 4090 နဲ့ RTX 6000 Ada တို့ရဲ့ ရလဒ်တွေကို နှိုင်းယှဉ်ထားပါတယ် ။ GeForce RTX 5080 ရဲ့ ရလဒ်တွေ ကို အသေးစိတ်သုံးသပ်ချက်အတွက် လင့်ခ်က ဒီမှာပါ ။
Asus PRIME RTX 5070 Ti ကို ပါဝါစမ်းသပ်မှုအတွက် 300W ပါဝါသုံးစွဲမှုအဆင့်သတ်မှတ်ချက်နဲ့ စမ်းသပ်ခဲ့ပါတယ်။ Procyon AI image-generating စမ်းသပ်မှုအတွင်းမှာ စနစ်ရဲ့ ပါဝါသုံးစွဲမှုဟာ idle state 231W ကနေ load လုပ်နေချိန်မှာ 601W အထိ တိုးလာပြီး 370W တိုးလာပါတယ်။ load လုပ်နေချိန်မှာ ပျမ်းမျှအားဖြင့် 303W အထိ ကျဆင်းသွားပြီး ကတ်ကို 300W ပါဝါသုံးစွဲမှုအတွက် အဆင့်သတ်မှတ်ထားတာကြောင့် စိတ်ဝင်စားစရာပါပဲ။
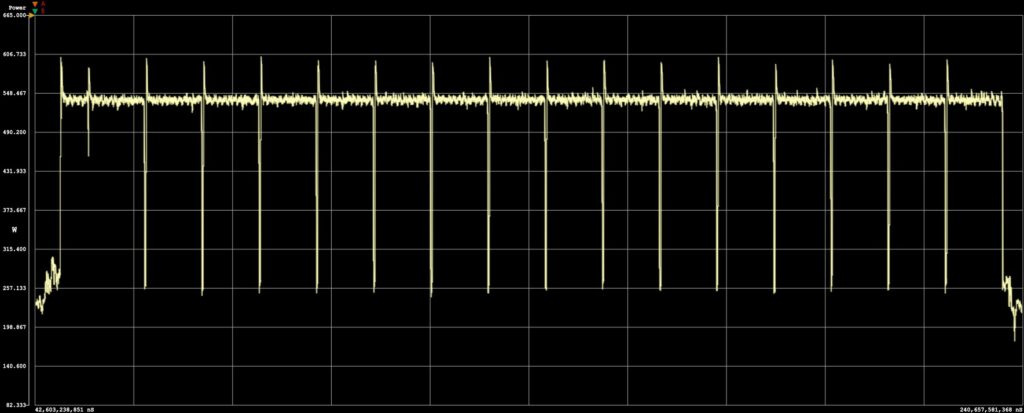
ဒုတိယမြောက် နောက်ဆုံးပုံရိပ်ကို ၁၁.၁ စက္ကန့်အတွင်း ထုတ်လုပ်ခဲ့ပြီး စနစ်သည် ထိုအချိန်ကာလအတွင်း 1.66Wh သုံးစွဲခဲ့သည်။
ကောက်ချက်
GeForce RTX 5070 Ti ရဲ့ အထူးခြားဆုံး ရှုထောင့်တစ်ခုကတော့ စွမ်းဆောင်ရည်ပါပဲ။ AI workloads တွေမှာ ခိုင်မာတဲ့ ရလဒ်တွေကို ပေးစွမ်းနိုင်ပြီး benchmark အများစုမှာ RTX 5080 နဲ့ အံ့သြစရာကောင်းလောက်အောင် နီးစပ်နေပါတယ်။ ဒါကြောင့် အကျိုးအမြတ်အများဆုံး ရရှိလိုသူတွေအတွက် အကောင်းဆုံး ရွေးချယ်မှုတစ်ခု ဖြစ်စေပါတယ်။ အထူးသဖြင့် GeForce RTX 5080 နဲ့ တူညီတဲ့ 16GB GDDR7 ပါရှိတာကြောင့်ပါ။
ဒေါ်လာ ၇၄၉ တန် RTX 5070 Ti ဟာ စွမ်းဆောင်ရည်နဲ့ လုပ်ဆောင်ချက်တွေကို ထူးကဲစွာ ဟန်ချက်ညီအောင် ပံ့ပိုးပေးတာကြောင့် ဘတ်ဂျက်ကို သတိထားတဲ့ အသုံးပြုသူတွေအတွက် ဆွဲဆောင်မှုရှိတဲ့ ရွေးချယ်မှုတစ်ခု ဖြစ်လာပါတယ်။ ဒါပေမယ့် ကတ်ရဲ့ ပါဝါသုံးစွဲမှုက သတ်မှတ်ထားတဲ့ 300W ထက် ကျော်လွန်နိုင်တာကြောင့် ပိုပြီး ခိုင်မာတဲ့ ပါဝါထောက်ပံ့မှုနဲ့ အအေးပေးစနစ် လိုအပ်နိုင်ပါတယ်။ ထို့အပြင်၊ အံ့သြဖွယ်ကောင်းတဲ့ စွမ်းဆောင်ရည်ရှိပေမယ့် ပိုမိုတောင်းဆိုမှုများတဲ့ AI နဲ့ rendering လုပ်ငန်းတွေမှာ RTX 5080 နဲ့ ပိုမြင့်တဲ့ မော်ဒယ်တွေထက် နောက်ကျနေပါတယ်။
ASUS Prime GeForce RTX 5070 Ti ကို အစွမ်းထက်ပြီး ဈေးနှုန်းသင့်တင့်တဲ့ GPU ကို ရှာဖွေနေသူတွေအတွက် အထူးအကြံပြုလိုပါတယ်။ 1440p ဒါမှမဟုတ် 4K ဂိမ်းကစားခြင်းနဲ့ အခြေခံအဆင့် AI workloads တွေအတွက် အသင့်တော်ဆုံးဖြစ်ပြီး၊ အဆင့်မြင့်မော်ဒယ်တွေရဲ့ ပရီမီယံဈေးနှုန်းမပါဘဲ ထူးကဲတဲ့တန်ဖိုးနဲ့ 16GB GDDR7 ကို ပေးစွမ်းနိုင်ပါတယ်။


 အမေဇုံ