

Intel ရဲ့ Project Battlematrix ဟာ အသုံးပြုရလွယ်ကူတဲ့ AI အခြေခံအဆောက်အအုံအတွက် ဆွဲဆောင်မှုရှိတဲ့ ကမ်းလှမ်းချက်တစ်ခုဖြစ်ပြီး multi-GPU ဒီဇိုင်းကတစ်ဆင့် workstation chassis မှာ များပြားလှတဲ့ GPU မှတ်ဉာဏ်စွမ်းရည်ကို ယူဆောင်လာပါတယ်။ ကုဒ်နံပါတ် Battlemage Arc Pro B60 professional GPU ကို အခြေခံပြီး တည်ဆောက်ထားတဲ့ ဒီ platform ဟာ cloud subscription ကုန်ကျစရိတ် ဒါမှမဟုတ် data privacy စိုးရိမ်မှုတွေမရှိဘဲ ဒေသတွင်းမှာ language model ကြီးတွေကို ဖြန့်ကျက်ဖို့ ရှာဖွေနေတဲ့ အဖွဲ့အစည်းတွေကို ပစ်မှတ်ထားပါတယ်။ တစ်ခုတည်းသော system မှာ GPU ရှစ်ခုမှာ 192GB အထိ VRAM ပါဝင်တာကြောင့် Battlematrix ဟာ AI inference workloads တွေအတွက် အခြား professional GPU ecosystem တွေအတွက် ကုန်ကျစရိတ်သက်သာတဲ့ ရွေးချယ်စရာတစ်ခုအဖြစ် ရပ်တည်နေပါတယ်။
Instagram ကိုပေါ်မှာဤ post ကို View
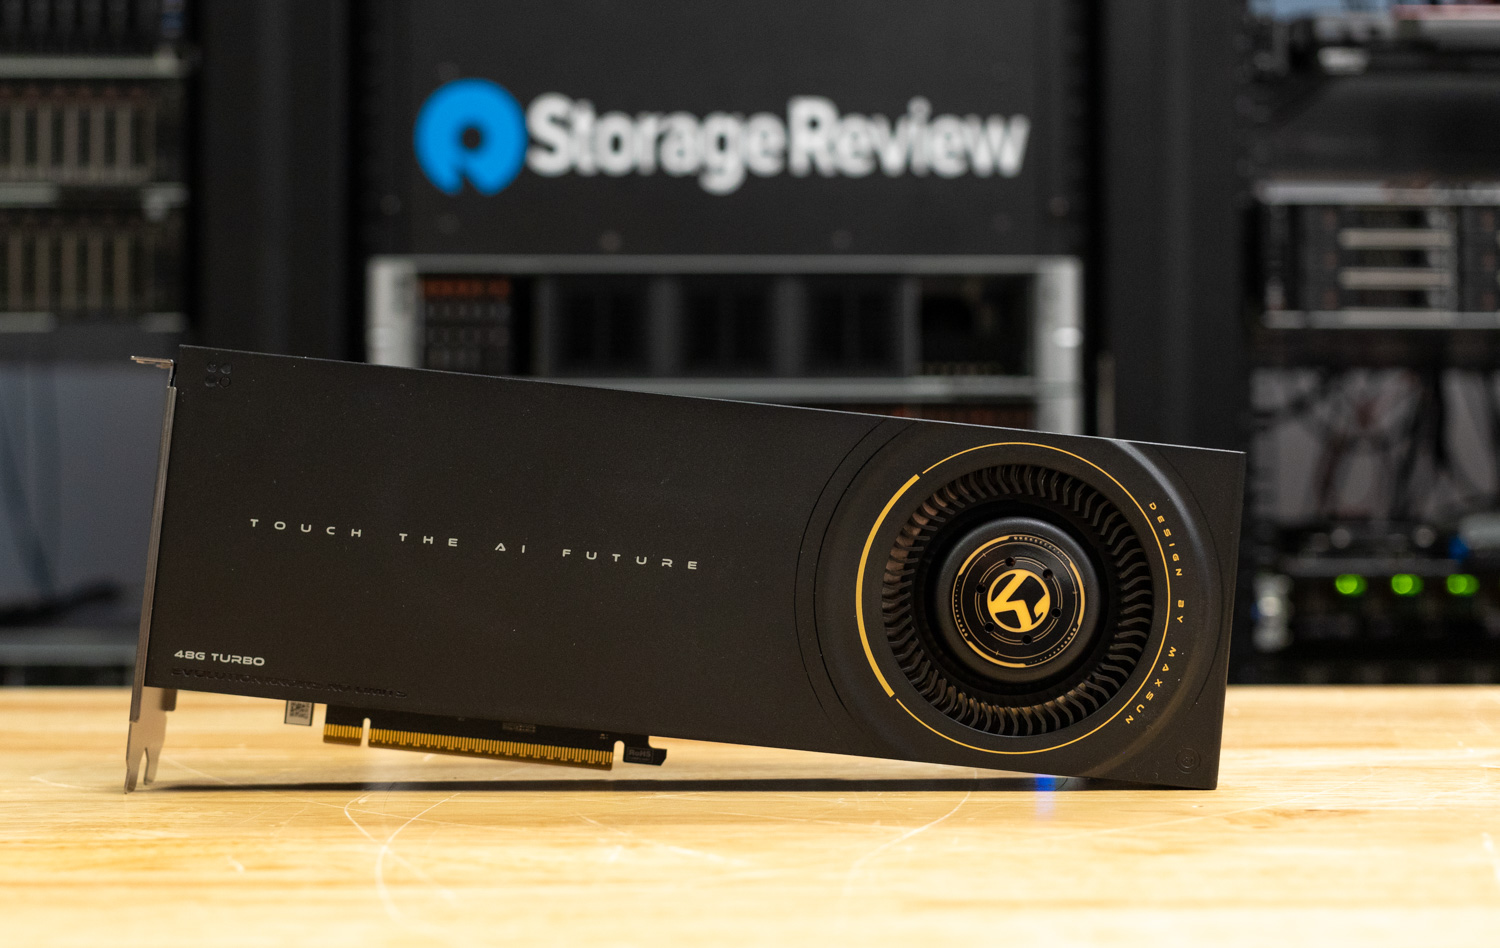
Battlematrix ကို ရိုးရာ workstation configuration များနှင့် ခွဲခြားသိရှိစေသည့်အချက်မှာ Intel ၏ dual-GPU card ဒီဇိုင်းဖြစ်ပြီး PCIe bifurcation support လိုအပ်သော single PCB ပေါ်တွင် full B60 GPU နှစ်ခုကို ထည့်သွင်းထားသည်။ ဤ density-optimized approach သည် server motherboard များ လိုအပ်မည့် configuration များကို လုပ်ဆောင်နိုင်စေပြီး Arc Pro B60 ၏ GPU တစ်ခုလျှင် 24GB GDDR6 သည် memory-intensive transformer မော်ဒယ်များအတွက် အထူးသင့်လျော်စေသည်။ အစောပိုင်းစမ်းသပ်မှုများအရ အလားအလာကောင်းများ ထွက်ပေါ်လာသော်လည်း software optimization သည် hardware ၏စွမ်းရည်များကို နှောင့်နှေးနေဆဲဖြစ်သည်။
ဖွင့်လှစ်ခြင်း
Intel LLM Scaler ၏ ဖွံ့ဖြိုးတိုးတက်ရေးဌာနခွဲများအပါအဝင် အစောပိုင်းဆော့ဖ်ဝဲလ်နှင့် ဒရိုက်ဘာပြင်ဆင်မှုများဖြင့် စမ်းသပ်မှုကို ပြုလုပ်ခဲ့သည်။ ထို့အပြင်၊ ကျွန်ုပ်တို့၏ စမ်းသပ်ပလက်ဖောင်းသည် Intel ၏ Xeon ပလက်ဖောင်းအစား AMD EPYC ပရိုဆက်ဆာများကို အသုံးပြုသည်။ Intel သည် Battlematrix ကို Xeon 6 ပရိုဆက်ဆာများပါရှိသော Intel ၏ ဖြေရှင်းချက်အားလုံးအဖြစ် သတ်မှတ်ပြီး Intel CPU များပါရှိသော ထုတ်လုပ်မှုစနစ်များသည် ကျွန်ုပ်တို့၏ရလဒ်များ အကြံပြုထားသည်ထက် ပိုမိုမြင့်မားသောစွမ်းဆောင်ရည်ကို ပြသနိုင်သည်။ စာဖတ်သူများသည် ဤရလဒ်များကို ကနဦးစဉ်းစားသင့်ပြီး ဆော့ဖ်ဝဲလ်ရင့်ကျက်မှုနှင့် ပလက်ဖောင်းအကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းသည် ၂၀၂၆ ခုနှစ်တစ်လျှောက်လုံး တိုးတက်လာသင့်ကြောင်း နားလည်ပါသည်။
သတ်မှတ်ချက်များနှင့် ဗိသုကာပညာ
| specification | အသေးစိတ် |
|---|---|
| ထုတ်ကုန်စုဆောင်းခြင်း | Intel® Arc™ Pro B-Series ဂရပ်ဖစ်များ |
| ကုဒ်နာမည် | Battlemage |
| GPU ကိုဗိသုကာပညာ | Xe2 (TSMC N5) |
| Xe-core များ | 20 |
| ပုံဖော်ခြင်း အပိုင်းများ | 5 |
| ဓာတ်မှန်ရိုက်ခြင်း ယူနစ်များ | 20 |
| XMX အင်ဂျင်များ | 160 |
| Xe Vector အင်ဂျင်များ | 160 |
| ဂရပ်ဖစ်နာရီ | 2400 MHz |
| ဂရပ်ဖစ်နာရီ (LP မုဒ်) | 2000 MHz |
| GPU FP32 စွမ်းဆောင်ရည် | 12.28 TFLOPS |
| GPU အမြင့်ဆုံး ထိပ်တန်းများ (INT8) | 197 |
| စုစုပေါင်းဘုတ်အဖွဲ့ပါဝါ (TBP) | 200 ဒဗလျူ |
| မှတ်ဉာဏ် | 24 GB ကို GDDR6 |
| မှတ်ဉာဏ် Interface | 192-bit မှာ |
| မှတ်ဉာဏ် Bandwidth | 456 GB ကို / s နဲ့ |
| Memory Speed | 19 Gbps |
| PCIe မျက်နှာပြင် | PCIe 5.0 x8 |
| မျက်နှာပြင်များ ပံ့ပိုးပေးထားသည် | 4 |
| ဂရပ်ဖစ် အထွက် | HDMI 2.1 | DP2.1 (UHBR 13.5) | DP2.1 (UHBR 10) |
| အများဆုံး ရုပ်ထွက်အရည်အသွေး (HDMI) | 120Hz @ 7680 x 4320 |
| အများဆုံး ရုပ်ထွက်အရည်အသွေး (DP) | 60Hz @ 7680 x 4320 |
| HDMI ပြောင်းလဲနိုင်သော Refresh Rate | Yes |
| VESA အလိုက် Sync | Yes |
| H.264 / H.265 / AV1 ကုဒ်ကုဒ်/ကုဒ်ကုဒ်ဖြေခြင်း | Yes |
| Ray Tracing ပံ့ပိုးမှု | Yes |
| oneAPI ပံ့ပိုးမှု | Yes |
| OpenVINO ပံ့ပိုးမှု | Yes |
| Intel IPEX ပံ့ပိုးမှု | Yes |
| Intel XeSS ပံ့ပိုးမှု | Yes |
အဆိုပါ Intel Arc Pro B60 ၎င်း၏ ဆီလီကွန်အခြေခံကို ဂိမ်းကို အဓိကထားသော ကုမ္ပဏီနှင့် မျှဝေသည် Intel Arc B580နှစ်ခုစလုံးသည် TSMC ၏ 5nm လုပ်ငန်းစဉ်တွင် ထုတ်လုပ်ထားသော တူညီသော die ကို အသုံးပြုထားသည်။ ဤ 272mm² ချစ်ပ်တွင် transistors ၁၉.၆ ဘီလီယံ ပါဝင်ပြီး Xe2 cores ၂၀ ကို ပေါင်းစပ်ထားပြီး FP32 compute ၏ 12.28 TFLOPS နှင့် GPU တစ်ခုလျှင် INT8 AI စွမ်းဆောင်ရည်၏ 197 TOPS ပေးစွမ်းနိုင်သည်ဟု ကြော်ငြာထားသည်။ အရေးကြီးသော ခြားနားချက်မှာ မှတ်ဉာဏ်ဖွဲ့စည်းပုံတွင် တည်ရှိသည်။ B580 သည် 12GB GDDR6 ဖြင့် တင်ပို့သော်လည်း B60 သည် စွမ်းရည်ကို 24GB အထိ နှစ်ဆတိုးထားသည်။
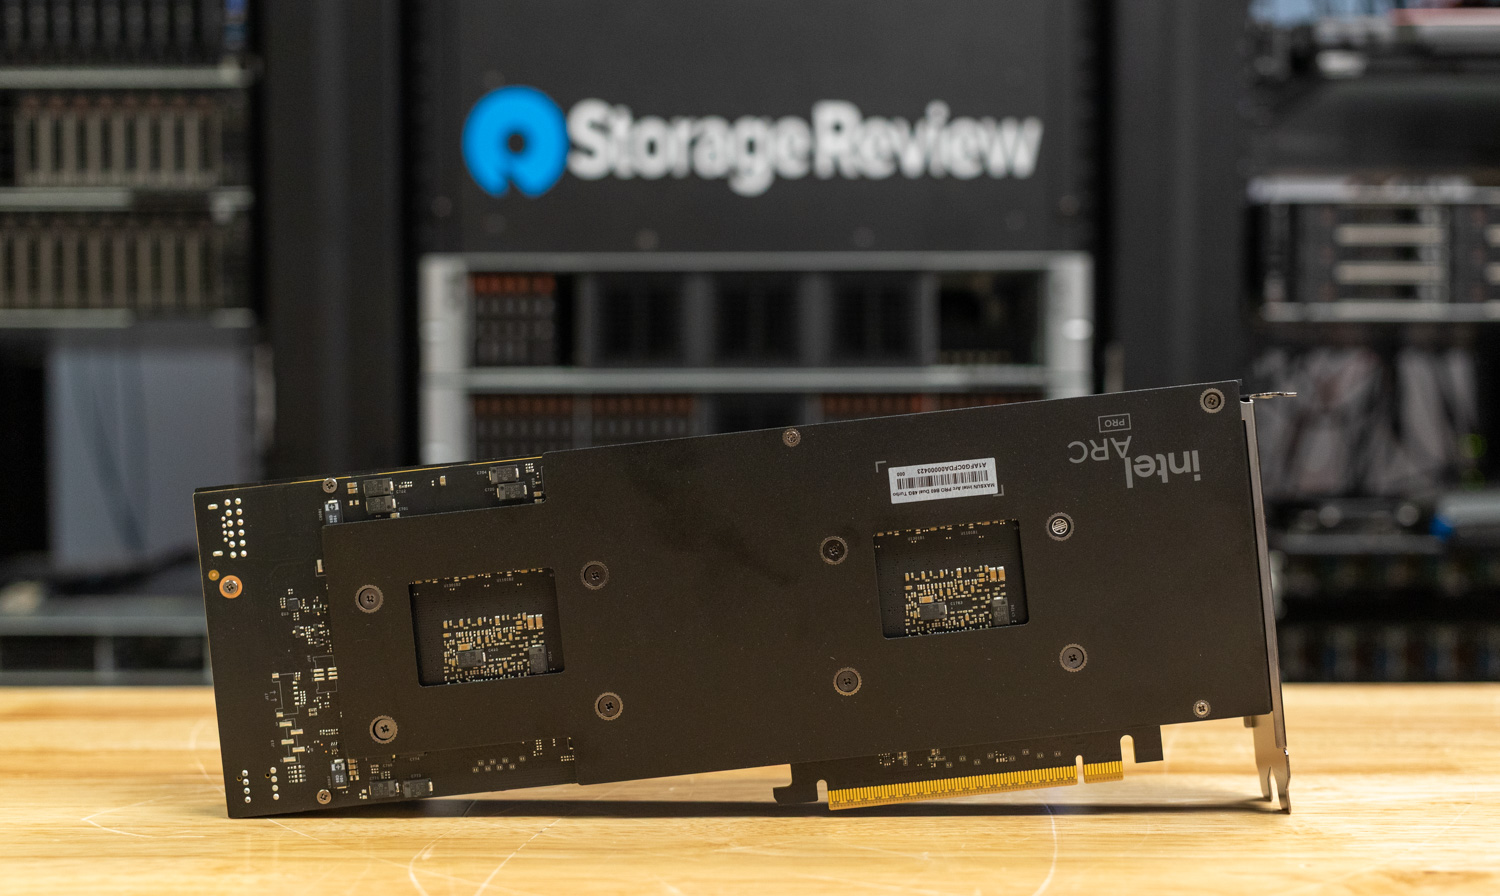
B60 GPU တစ်ခုစီသည် 192-bit memory interface မှတစ်ဆင့် 2,400MHz ဖြင့်လည်ပတ်ပြီး GPU တစ်ခုလျှင် bandwidth 456GB/s ပေးစွမ်းသည်။ ဤဗိသုကာလက်ရာတွင် GPU တစ်ခုလျှင် XMX (Xe Matrix Extensions) AI အင်ဂျင် ၁၆၀ ပါရှိပြီး AI inference တွင် matrix လုပ်ဆောင်ချက်များကို အရှိန်မြှင့်တင်ရန် ရည်ရွယ်ချက်ဖြင့် တည်ဆောက်ထားသည်။
Dual GPU ဒီဇိုင်းနှင့် PCIe Bifurcation
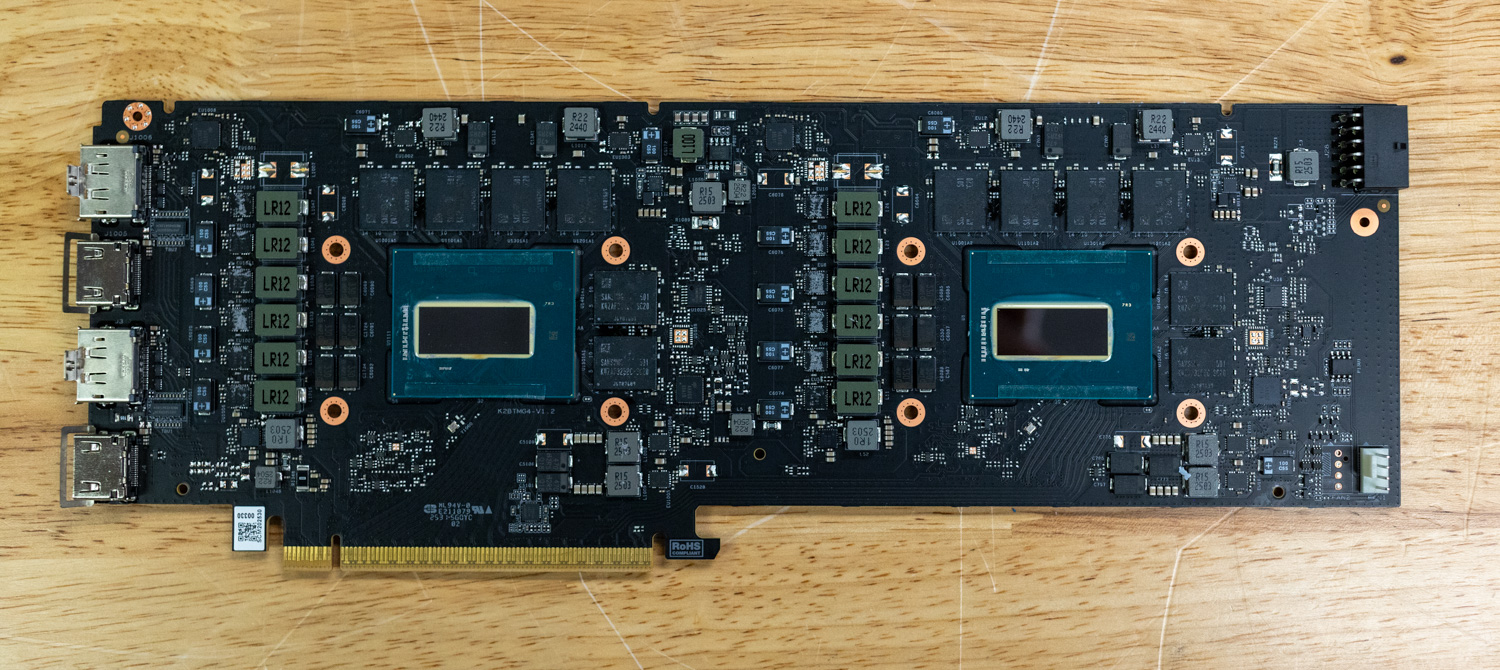
Maxsun Arc Pro B60 Dual 48G Turbo သည် Intel ၏ သိပ်သည်းဆဗျူဟာကို ကိုယ်စားပြုသည်- PCIe 5.0 x8 interfaces များမှတစ်ဆင့် သီးခြားစီချိတ်ဆက်ထားသော dual-slot card တစ်ခုတည်းပေါ်တွင် GPU နှစ်ခုပါရှိသည်။ ချစ်ပ်များကို GPU တစ်ခုတည်းအဖြစ် လုပ်ဆောင်ရန် ပေါင်းကူးပေးသည့် ရိုးရာ dual-GPU ဒီဇိုင်းများနှင့်မတူဘဲ၊ B60 GPU တစ်ခုစီသည် စနစ်အတွက် သီးခြား device အဖြစ် ပေါ်လာပြီး PCIe x8/x8 bifurcation အတွက် motherboard ပံ့ပိုးမှု လိုအပ်ပါသည်။ x16 slot တစ်ခုတည်းသည် x8 ချိတ်ဆက်မှုနှစ်ခုအဖြစ် လျှပ်စစ်အားဖြင့် ပိုင်းခြားထားပြီး GPU တစ်ခုစီသည် သီးသန့် bandwidth ရရှိသည်။
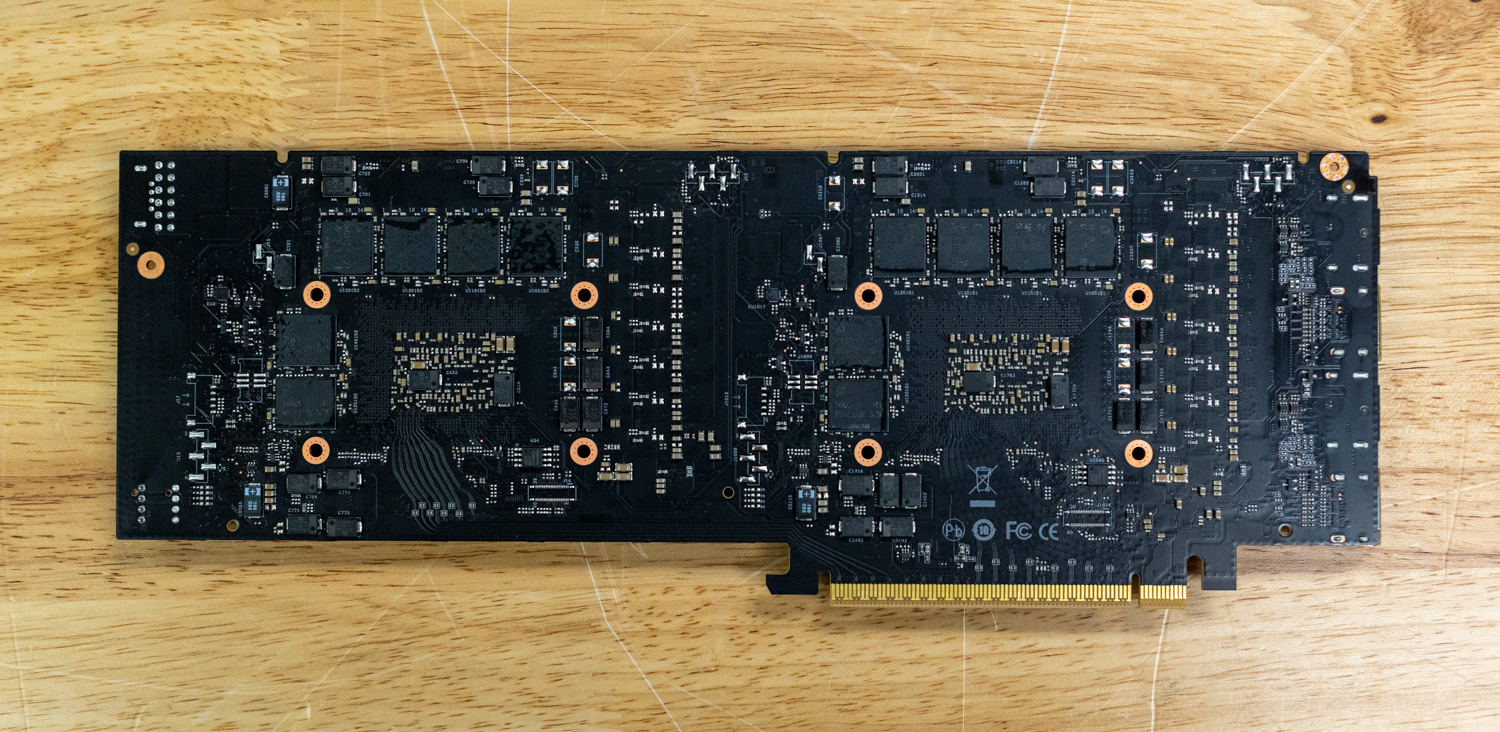
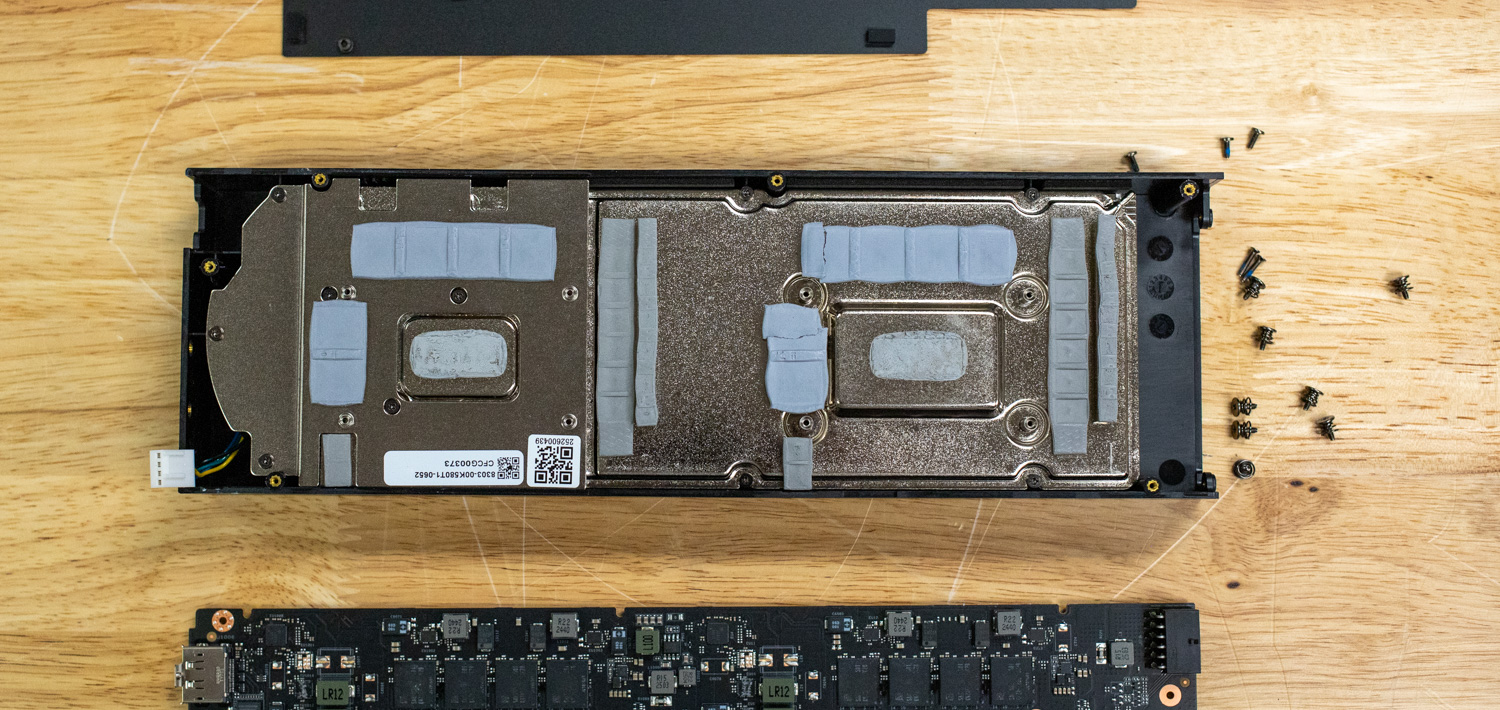
PCIe 5.0 x8 သည် GPU တစ်ခုလျှင် 128GB/s bidirectional bandwidth ကို ပေးစွမ်းပြီး PCIe 4.0 x16 နှင့် ကိုက်ညီပါသည်။ dual-card configuration သည် အလျား 300mm ရှိပြီး blower-style cooling ပါသည့် slot နှစ်ခုတွင် နေရာယူထားပြီး 600W အတွက် အဆင့်သတ်မှတ်ထားသော 12V-2×6 connector တစ်ခုတည်းမှတစ်ဆင့် board ပါဝါ 400W ကို အသုံးပြုပါသည်။
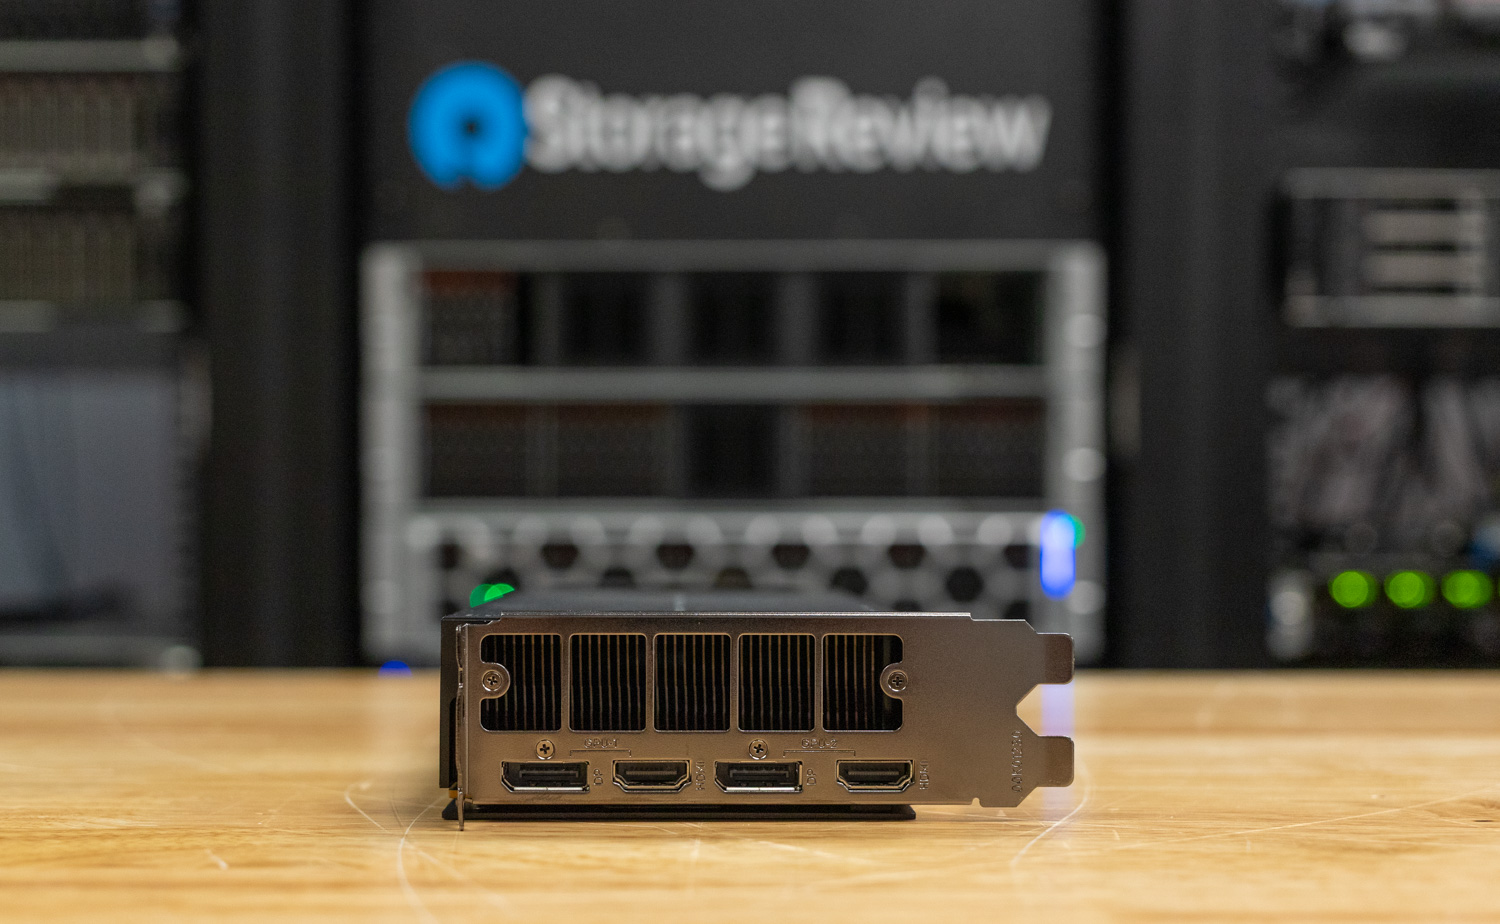
dual card တစ်ခုစီတွင် display output လေးခုပါဝင်သည်- DisplayPort 2.1 UHBR20 နှစ်ခုနှင့် HDMI 2.1a port နှစ်ခု၊ GPU တစ်ခုလျှင် တစ်ခုစီ၊ virtualized desktop environments သို့မဟုတ် multi-user systems များအတွက် discrete video output configuration များကို ပြုလုပ်နိုင်စေပါသည်။ မှတ်သားထားရမည့် အဓိကအချက်မှာ GPU တစ်ခုစီအတွက် display output နှစ်ခုအနက် တစ်ခုကိုသာ တစ်ပြိုင်နက်တည်း အသုံးပြုနိုင်ခြင်းပင်ဖြစ်သည်။
Instagram ကိုပေါ်မှာဤ post ကို View
GPU Battlematrix ရှစ်ခု ဖွဲ့စည်းပုံ
Intel ရဲ့ Battlematrix သတ်မှတ်ချက်က workstation chassis မှာ Arc Pro B60 GPU ရှစ်ခုအထိ ထောက်ပံ့ပေးပြီး dual-GPU ကတ်လေးခုကို အသုံးပြုခြင်းအားဖြင့် ရရှိနိုင်ပါတယ်။ ဒီ configuration က အောက်ပါတို့ကို ပေးစွမ်းပါတယ်-
- စုစုပေါင်း 192GB စနစ် VRAM (၈ × ၂၄GB)
- XMX AI အင်ဂျင် ၁၂၈၀ လုံး
- INT1,576 ထိပ်တန်း 8 ခု စုစုပေါင်းတွက်ချက်မှု
- ၃.၆ TB/s ပေါင်းစပ်ထားသော မှတ်ဉာဏ် bandwidth
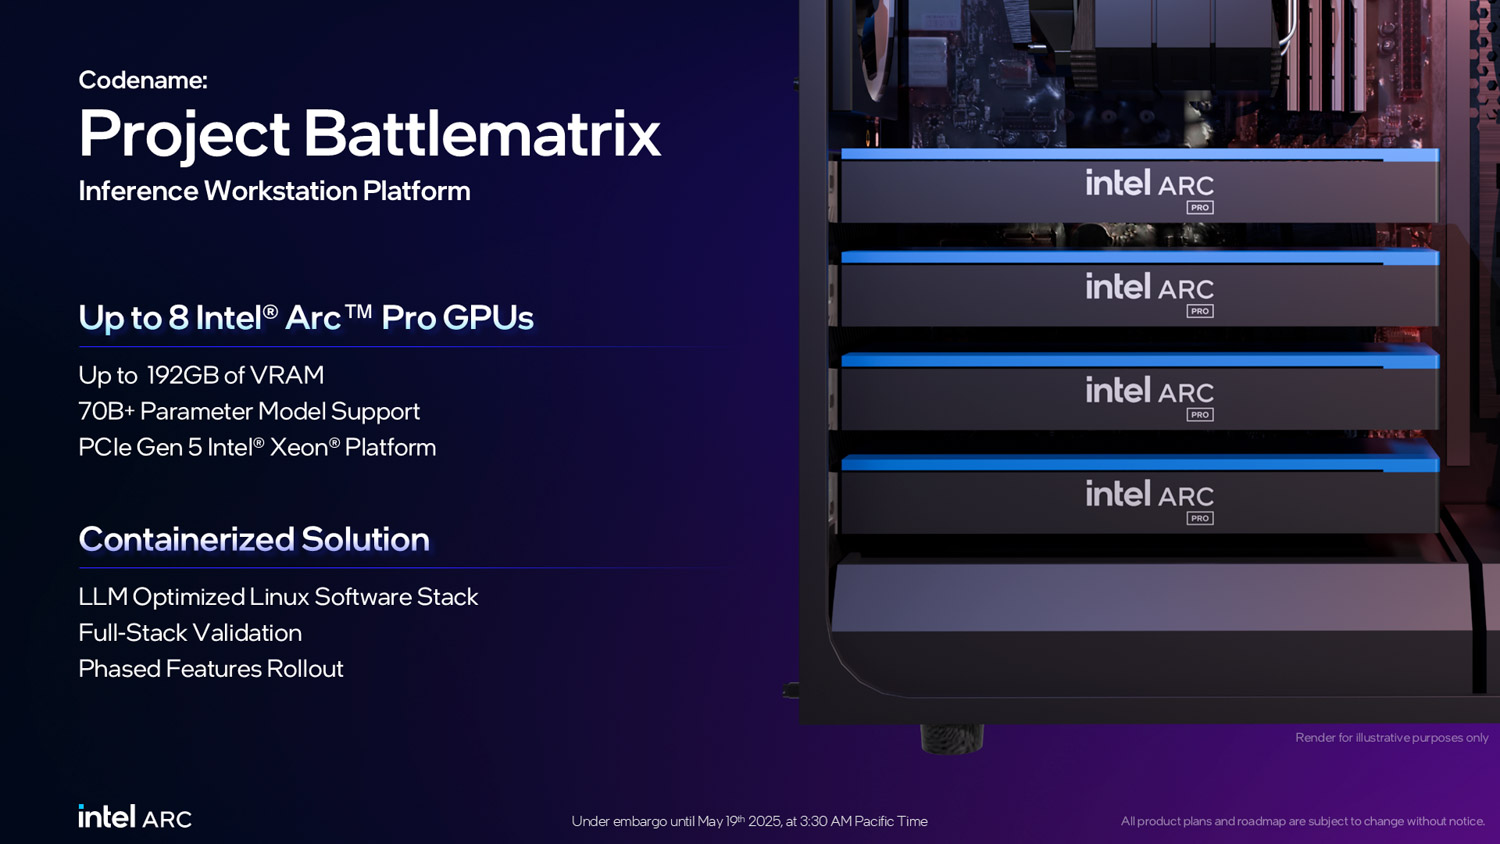
ဒီပလက်ဖောင်းအတွက် bifurcation ကို ပံ့ပိုးပေးတဲ့ PCIe 5.0 x16 slot လေးခုပါတဲ့ motherboard တွေ လိုအပ်ပြီး Battlematrix spec မှာ Xeon 6 processor ပါဝင်ပါတယ်။ ဒါပေမယ့် Battlematrix configuration နဲ့ ပတ်သက်တဲ့ တခြားအချက်အလက်တွေကိုတော့ လောလောဆယ် မရနိုင်သေးပါဘူး။
အသုံးပြုမှုကိစ္စရပ်များနှင့် တန်ဖိုးအဆိုပြုချက်
ပစ်မှတ်ပရိသတ်
Intel ရဲ့ Project Battlematrix ဟာ ဈေးကွက်ကဏ္ဍသုံးခုကို ပစ်မှတ်ထားပါတယ်- on-premise အခြေခံအဆောက်အအုံလိုအပ်တဲ့ AI ဖွံ့ဖြိုးတိုးတက်ရေးအဖွဲ့တွေ၊ sensitive codebase တွေနဲ့ AI-assisted workflows တွေကို အကောင်အထည်ဖော်နေတဲ့ software engineering အဖွဲ့အစည်းတွေနဲ့ cloud-based inference ဝန်ဆောင်မှုတွေအတွက် ကုန်ကျစရိတ်သက်သာတဲ့ အခြားရွေးချယ်စရာတွေကို ရှာဖွေနေတဲ့ အဖွဲ့အစည်းတွေပါ။ ဒီ platform ရဲ့ အဓိကတန်ဖိုးအဆိုပြုချက်က multi-year cloud subscriptions တွေထက် data sovereignty နဲ့ total cost of ownership အားသာချက်တွေကို အခြေခံထားပါတယ်။
ပုဂ္ဂလိက AI နှင့် အေးဂျင့် ဖွံ့ဖြိုးတိုးတက်ရေး
Battlematrix platform ရဲ့ အဓိကအားသာချက်ကတော့ ကျယ်ပြန့်တဲ့ context window တွေနဲ့ သိသာထင်ရှားတဲ့ parameter အရေအတွက်တွေ လိုအပ်တဲ့ ကြီးမားတဲ့ language model တွေအတွက် development workflow တွေကို ပံ့ပိုးပေးနိုင်ခြင်းပဲ ဖြစ်ပါတယ်။
agent စနစ်များတည်ဆောက်သည့် ဖွံ့ဖြိုးတိုးတက်ရေးအဖွဲ့များသည် ရရှိနိုင်သော memory headroom မှ အထူးအကျိုးကျေးဇူးရရှိကြသည်။ RAG agent အကောင်အထည်ဖော်မှုများသည် GPU memory တွင် အစိတ်အပိုင်းများစွာကို တစ်ပြိုင်နက်တည်း ထိန်းသိမ်းထားလေ့ရှိသည်- base language model၊ vector search အတွက် model များကို embed လုပ်ခြင်းနှင့် model များကို reranking လုပ်ခြင်း။ ထို့အပြင်၊ agent workflow များသည် multi-step reasoning၊ tool use နှင့် self-correction တို့ကို လုပ်ဆောင်ပြီး iteration မှတစ်ဆင့် သိသာထင်ရှားသော context window များကို ဖန်တီးပေးသည်။ codebase ကြီးတစ်ခုကို ခွဲခြမ်းစိတ်ဖြာသည့် coding agent သည် ၎င်း၏ operational lifecycle တစ်လျှောက်တွင် 100k+ tokens များကို စုဆောင်းနိုင်သည်။
အနာဂတ် VDI နှင့် Virtualized Gaming
Intel ရဲ့ roadmap မှာ Arc Pro B60 GPU တွေမှာ SR-IOV (Single Root I/O Virtualization) support ကို enable လုပ်နိုင်အောင် လုပ်ဆောင်ပေးမှာဖြစ်ပြီး hardware ကို multi-user graphics platform အဖြစ် ပြောင်းလဲပေးမှာပါ။ SR-IOV က physical GPU တစ်ခုကို virtual GPU များစွာအဖြစ် ပိုင်းခြားနိုင်စေပြီး တစ်ခုချင်းစီကို hardware နဲ့ isolated memory space တွေနဲ့ သီးခြား virtual machine တွေဆီ သတ်မှတ်ပေးနိုင်ပါတယ်။
ဒီစွမ်းရည်က လိုင်စင်မဲ့ Virtual Desktop Infrastructure အခြေအနေတွေကို လော့ခ်ဖွင့်ပေးပါတယ်။ အဲဒီအခြေအနေမှာ single eight-GPU Battlematrix system က CAD application တွေ၊ video editing ဒါမှမဟုတ် moderate gaming တွေအတွက် GPU acceleration နဲ့ user အများအပြားကို ပံ့ပိုးပေးပါတယ်။ ရိုးရာ VDI solution တွေက hardware ကုန်ကျစရိတ်တွေအပြင် လိုင်စင်ကြေးတွေ မြင့်မားဖို့ လိုအပ်ပြီး အဲဒါက ပိုပြီးစျေးကြီးတဲ့ professional ဒါမှမဟုတ် data center GPU တွေကို လိုအပ်စေပါတယ်။ Intel ရဲ့ လိုင်စင်မဲ့ virtualization အတွက် ကတိကဝတ်က ဒီ operational expense ကို ဖယ်ရှားပေးပါတယ်။
စျေးနှုန်းနှင့်တန်ဖိုးတင်ပြချက်
Intel က Arc Pro B60 ရဲ့ ဈေးနှုန်းကို GPU တစ်လုံးကို ဒေါ်လာ ၆၀၀ ဝန်းကျင်နဲ့ ရောင်းချသွားမယ်လို့ ကြေညာခဲ့ပါတယ်။ ကနဦး စမ်းသပ်ခြင်းနဲ့ ဖွံ့ဖြိုးတိုးတက်မှုအတွက် single ဒါမှမဟုတ် dual-card configuration (ဒေါ်လာ ၆၀၀ မှ ၁၂၀၀) အထိက ဝင်ရောက်အသုံးပြုနိုင်တဲ့ entry point တွေကို ပေးစွမ်းနိုင်ပါတယ်။ 48GB VRAM ပါတဲ့ single dual-GPU card တစ်ခုက quantized model တွေအတွက် လုံလောက်တဲ့ capacity ကို ပေးစွမ်းနိုင်ပြီး လူကြိုက်များတဲ့ open-source LLM application တွေရဲ့ များပြားတဲ့ အစိတ်အပိုင်းကို လွှမ်းခြုံထားပါတယ်။
ကျွန်ုပ်တို့စမ်းသပ်ခဲ့သော Maxsun Dual Arc Pro B60 Dual 48G Turbo configuration သည် Intel ၏ မူလကြေငြာချက်နှင့်အညီ Maxsun မှ တိုက်ရိုက် $1,200 ကုန်ကျသည်။ သို့သော် မကြာသေးမီက မှတ်ဉာဏ်ဈေးနှုန်းများ အတက်အကျကြောင့် ယင်းအပေါ် သက်ရောက်မှုရှိနိုင်သည်။
စတင်ဈေးနှုန်းများတွင် ထူးကဲသောတန်ဖိုး
single-card နှင့် dual-card configuration များသည် အဖွဲ့ငယ်များ၊ တစ်ဦးချင်း developer များနှင့် အိမ်တွင်းလက်တွေ့လုပ်ဆောင်သူများအတွက် ဆွဲဆောင်မှုရှိသော စီးပွားရေးများကို ပေးစွမ်းသည်။ 24GB GPU memory အတွက် ဒေါ်လာ ၆၀၀ နှင့် 48GB အတွက် ဒေါ်လာ ၁၂၀၀ ဖြင့် ဤ platform သည် အနည်းဆုံး နှစ်ဆခန့် ကုန်ကျလေ့ရှိသော professional GPU အစားထိုးပစ္စည်းများထက် သိသိသာသာ နိမ့်ကျပါသည်။
ဤတန်ဖိုးအဆိုပြုချက်သည် အထူးသဖြင့် လုပ်ငန်းဘတ်ဂျက်များကို ကတိကဝတ်ပြုခြင်းမရှိဘဲ AI ပေါင်းစပ်မှုကို စူးစမ်းလေ့လာနေသော အဖွဲ့အစည်းများအတွက် ပဲ့တင်ထပ်ပါသည်။
vLLM အွန်လိုင်းဝန်ဆောင်မှုစံနှုန်းစွမ်းဆောင်ရည်
vLLM သည် LLM များအတွက် အလွန်ရေပန်းစားသော high-throughput inference နှင့် serving engine ဖြစ်သည်။ vLLM အွန်လိုင်း serving benchmark သည် concurrent request များအောက်တွင် လက်တွေ့ကမ္ဘာ serving စွမ်းဆောင်ရည်ကို တိုင်းတာသည့် စွမ်းဆောင်ရည်အကဲဖြတ်ကိရိယာတစ်ခုဖြစ်သည်။ ၎င်းသည် request rate၊ input/output အရှည်များနှင့် concurrent client အရေအတွက်ကဲ့သို့သော configure လုပ်နိုင်သော parameter များဖြင့် လည်ပတ်နေသော vLLM server သို့ request များပေးပို့ခြင်းဖြင့် production workloads များကို simulate လုပ်သည်။ benchmark သည် throughput (tokens per second)၊ time to first token (TTFT) နှင့် time per output token (TPOT) အပါအဝင် အဓိက metrics များကို တိုင်းတာပြီး အသုံးပြုသူများ vLLM သည် မတူညီသော load condition များအောက်တွင် မည်သို့လုပ်ဆောင်သည်ကို နားလည်ရန် ကူညီပေးသည်။
စမ်းသပ်ပလက်ဖောင်း-
- ဆာဗာ: စူပါမိုက်ခရို AS-၄၁၂၅GS-TNRT
- ပရိုဆက်ဆာများ AMD EPYC 9374F
- မှတ်ဉာဏ်: 512GB Samsung 4800 MT/s DDR5
- GPU များ: ၄x Maxsun MS-Intel ARC Pro B60 Dual 48G Turbo
ပမာဏပြောင်းလဲမှု ပံ့ပိုးမှုနှင့် ကန့်သတ်ချက်များ
ဤ GPU များသည် အကောင်းဆုံးစွမ်းဆောင်ရည်အတွက် INT4 quantization ကိုပစ်မှတ်ထားသော low-precision inference တွင်ထူးချွန်သင့်သည်။ သို့သော်၊ ကျွန်ုပ်တို့စမ်းသပ်နေသော Intel ၏ LLM Scaler ၏ အလွန်အစောပိုင်းဖွံ့ဖြိုးတိုးတက်မှုဗားရှင်းကြောင့်၊ MXFP4 microscaling format ဖြင့် ကနဦးလေ့ကျင့်ထားသော GPT OSS မော်ဒယ်များသာ မှန်ကန်စွာလုပ်ဆောင်နိုင်သည်။ စံ INT4၊ FP8 နှင့် AWQ အပါအဝင် အခြား quantization format များသည် လုံးဝစတင်ရန်ပျက်ကွက်ခဲ့သည်။ ဤကန့်သတ်ချက်သည် ဤ GPU များကို သေချာစွာစမ်းသပ်နိုင်စွမ်းကို သိသိသာသာကန့်သတ်ထားသော်လည်း၊ software stack ရင့်ကျက်လာသည်နှင့်အမျှ quantization အတွက် ပိုမိုကျယ်ပြန့်သောပံ့ပိုးမှုကို မျှော်လင့်ပါသည်။
ကျွန်ုပ်တို့သည် မော်ဒယ်အများစုကို configuration နှစ်ခုဖြင့် စမ်းသပ်ခဲ့သည်- ရှစ် GPU Battlematrix အပြည့်အစုံ setup နှင့် မော်ဒယ်ကို မှတ်ဉာဏ်တွင် တပ်ဆင်ရန် လိုအပ်သော GPU အနည်းဆုံးအရေအတွက်။ ဤနှိုင်းယှဉ်ချက်သည် အထူးသဖြင့် batch size နိမ့်သော communication overhead နှင့်ပတ်သက်သည့် စိတ်ဝင်စားဖွယ်ကောင်းသော scaling လက္ခဏာများကို ဖော်ပြသည်။
မိုက်ခရိုစကေးလင်းဒေတာအမျိုးအစားများ
Microscaling သည် ကြီးမားသော parameter အုပ်စုများတွင် uniform quantization အစား အလေးချိန်များ၏ သေးငယ်သော block များတွင် fine-grained scaling factor များကို အသုံးချသည့် အဆင့်မြင့် quantization ချဉ်းကပ်မှုကို ကိုယ်စားပြုသည်။ MXFP4 format သည် blocked floating-point representation ကို အသုံးပြု၍ ဤနည်းပညာကို အကောင်အထည်ဖော်ပြီး microscale block တစ်ခုစီတွင် ဘုံ exponent တစ်ခုကို scaling factor အဖြစ် မျှဝေကာ 4-bit precision ကို ရရှိစေပြီး ဂဏန်းသင်္ချာတိကျမှုကို ထိန်းသိမ်းပေးသည်။ MXFP4 data type ၏ အဓိကအကျိုးကျေးဇူးမှာ BF16 ကဲ့သို့သော higher-precision format များမှ quantizing နှင့်မတူဘဲ INT4 သို့ model များကို quantizing လုပ်ခြင်းသည် response quality ကို ပြင်းထန်စွာ ကျဆင်းစေခြင်းမရှိပါ။ GPT OSS model များကို B60s တွင် INT4 quantization ဖြင့် လုပ်ဆောင်သည်၊ အဘယ်ကြောင့်ဆိုသော် ၎င်းတို့သည် MXFP4 ကို natively support မလုပ်သောကြောင့်ဖြစ်သည်။
OpenAI GPT-OSS 20B
20B parameter model သည် ဆက်သွယ်ရေး overhead ဖြစ်စဉ်ကို ရှင်းရှင်းလင်းလင်း သရုပ်ပြသည်။ batch size 1 တွင် GPU တစ်ခုတည်းသည် အသုံးပြုသူတစ်ဦးလျှင် tok/s 49.22 ပေးစွမ်းနိုင်ပြီး GPU ရှစ်ခုလုံးတွင် ဖြန့်ဝေသည့်အခါ tok/s 22.83 သာပေးစွမ်းနိုင်သည်။ single-GPU configuration သည် 2x ကျော် ပိုမိုကောင်းမွန်စွာ လုပ်ဆောင်နိုင်သည်။ သို့သော် eight-GPU setup သည် ပိုမိုမြင့်မားသော concurrency တွင် ထူးချွန်ပြီး batch size 16 တွင် total throughput 511.99 tok/s ရရှိသည်။
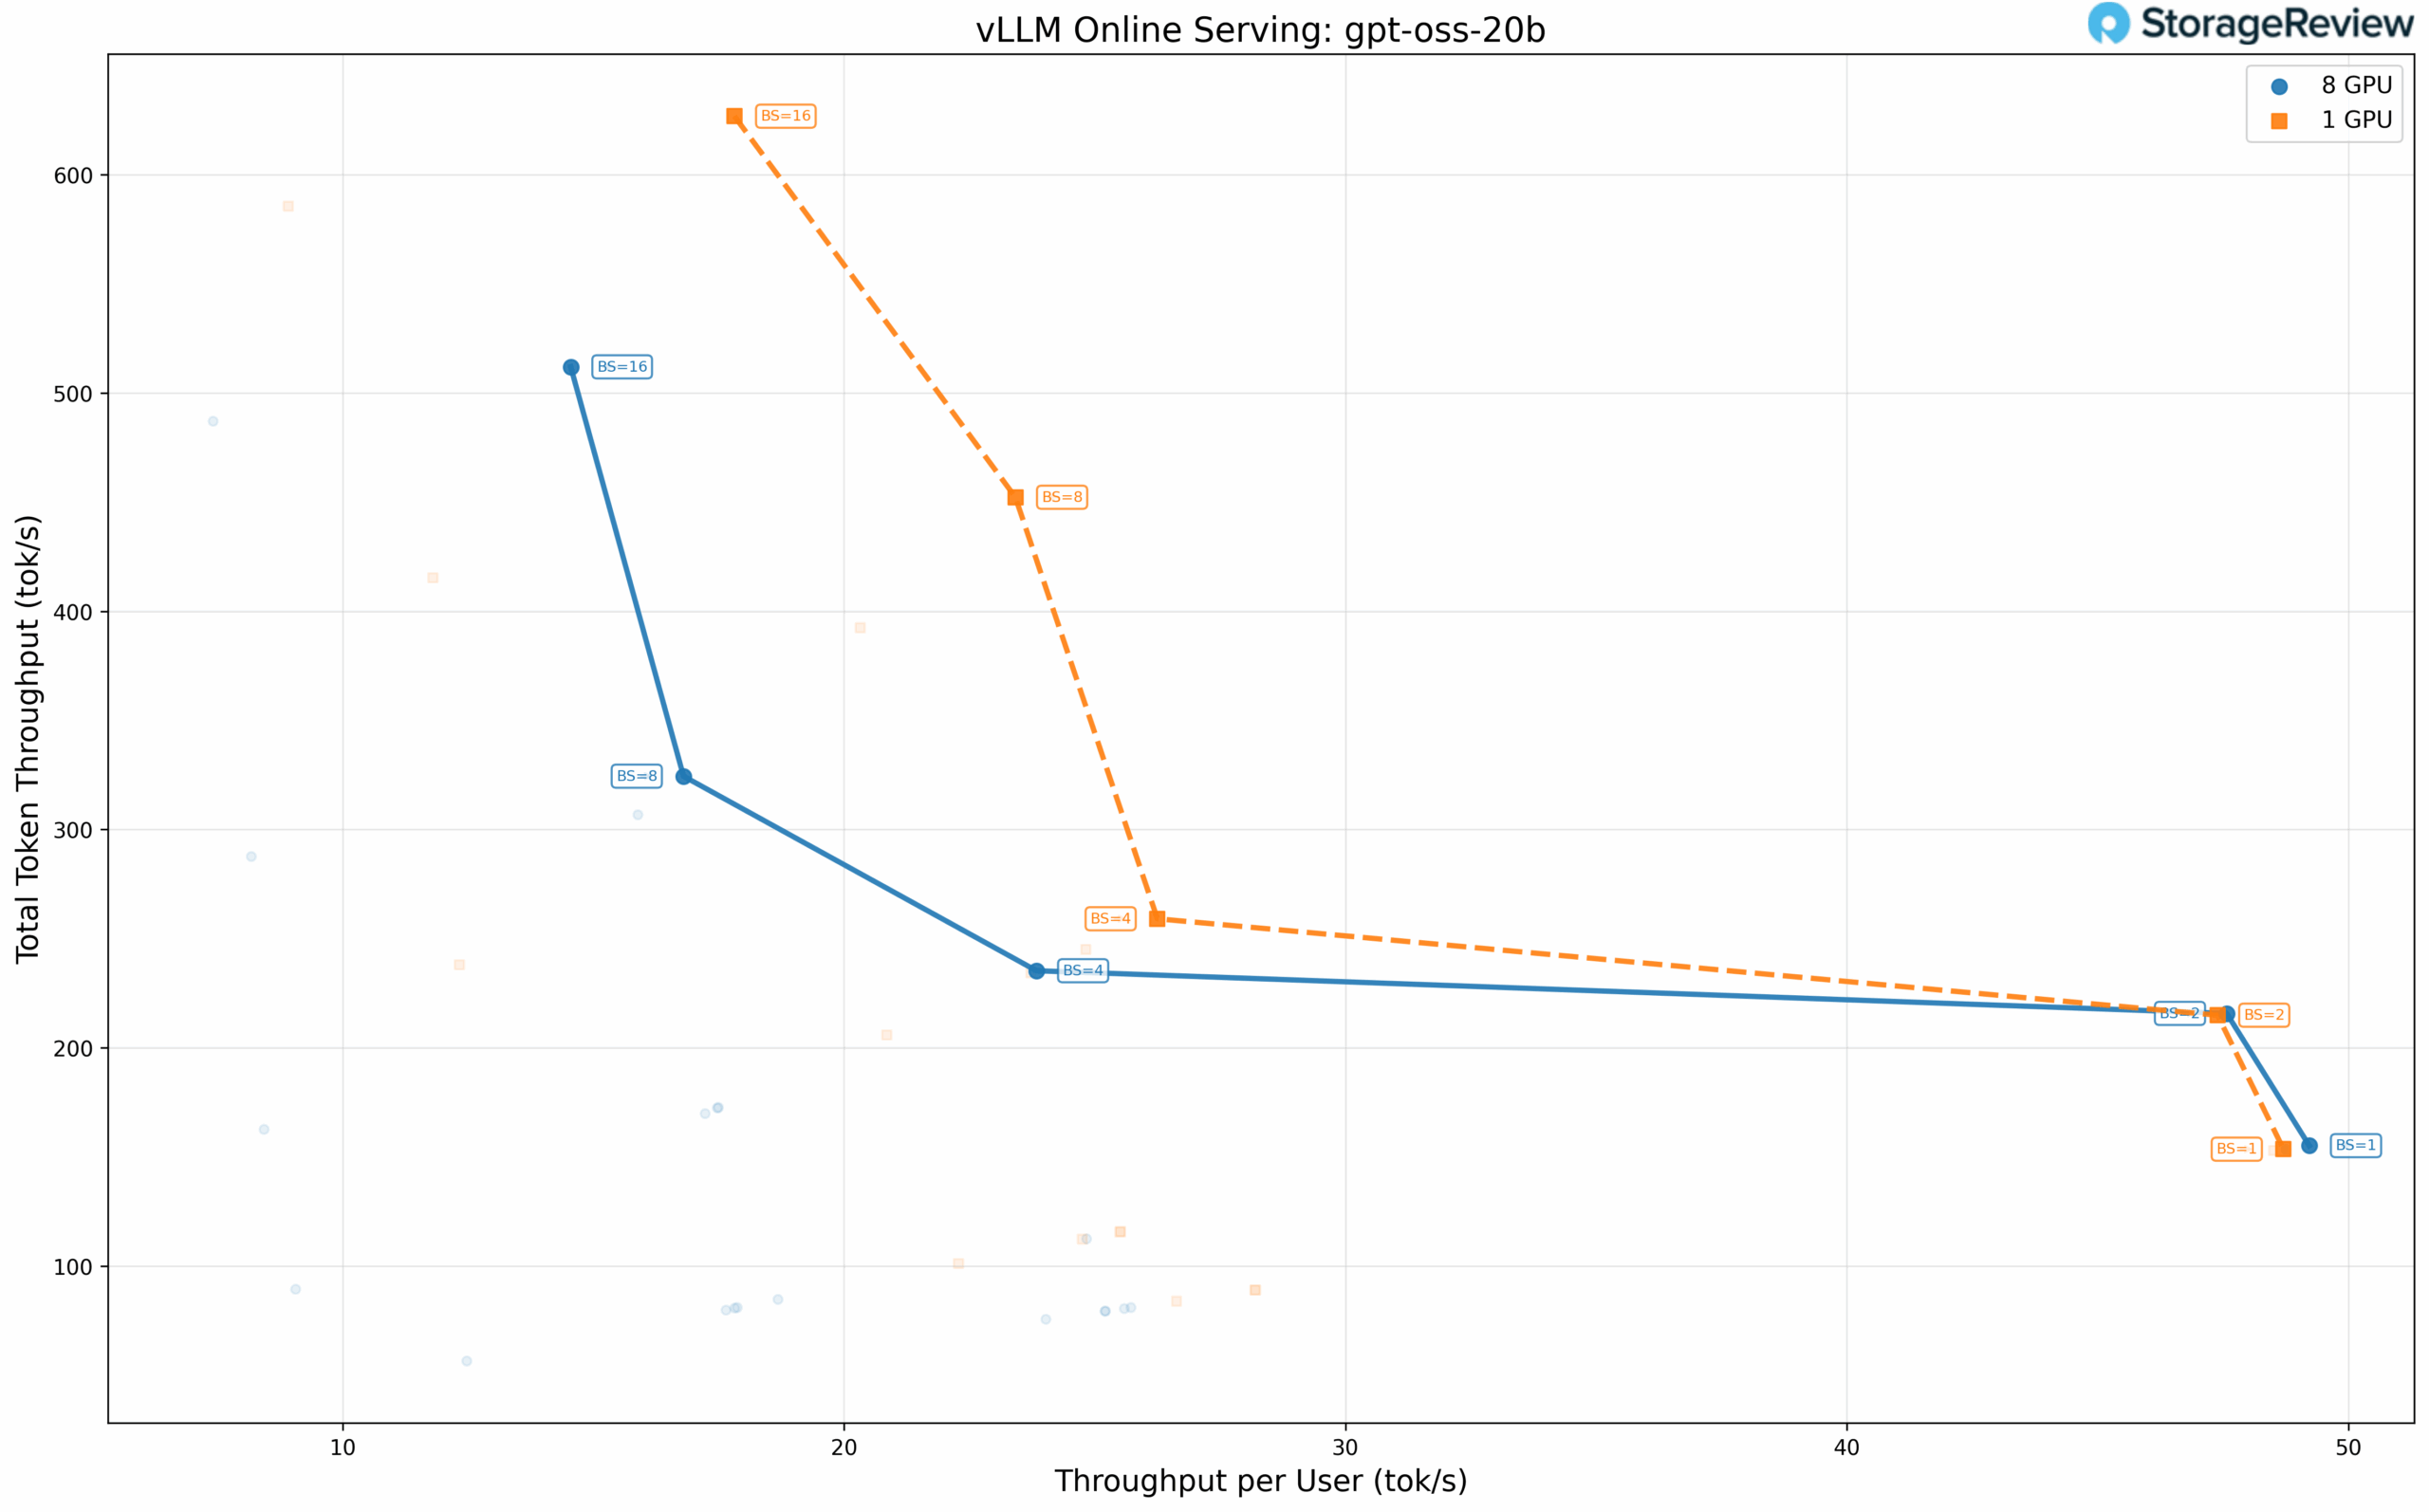 အနည်းဆုံး GPU ဖွဲ့စည်းမှုပုံစံသည် batch size 16 တွင် စုစုပေါင်း throughput ပိုမိုမြင့်မားစေသည်- TP=4 ရှိသော 626.84 tok/s နှင့် TP=8 ရှိသော 511.99 tok/s။ ဤဆန့်ကျင်ဘက်ရလဒ်သည် GPU အနည်းငယ်တွင် အဆင်ပြေစွာ ကိုက်ညီသော မော်ဒယ်များနှင့် context lengths များအတွက်၊ hardware ပိုမိုထည့်သွင်းခြင်းသည် အချိုးကျစွမ်းဆောင်ရည်တိုးတက်မှုမရှိဘဲ ဆက်သွယ်ရေး overhead ကို ဖြစ်ပေါ်စေကြောင်း ပေါ်လွင်စေသည်။
OpenAI GPT-OSS 120B
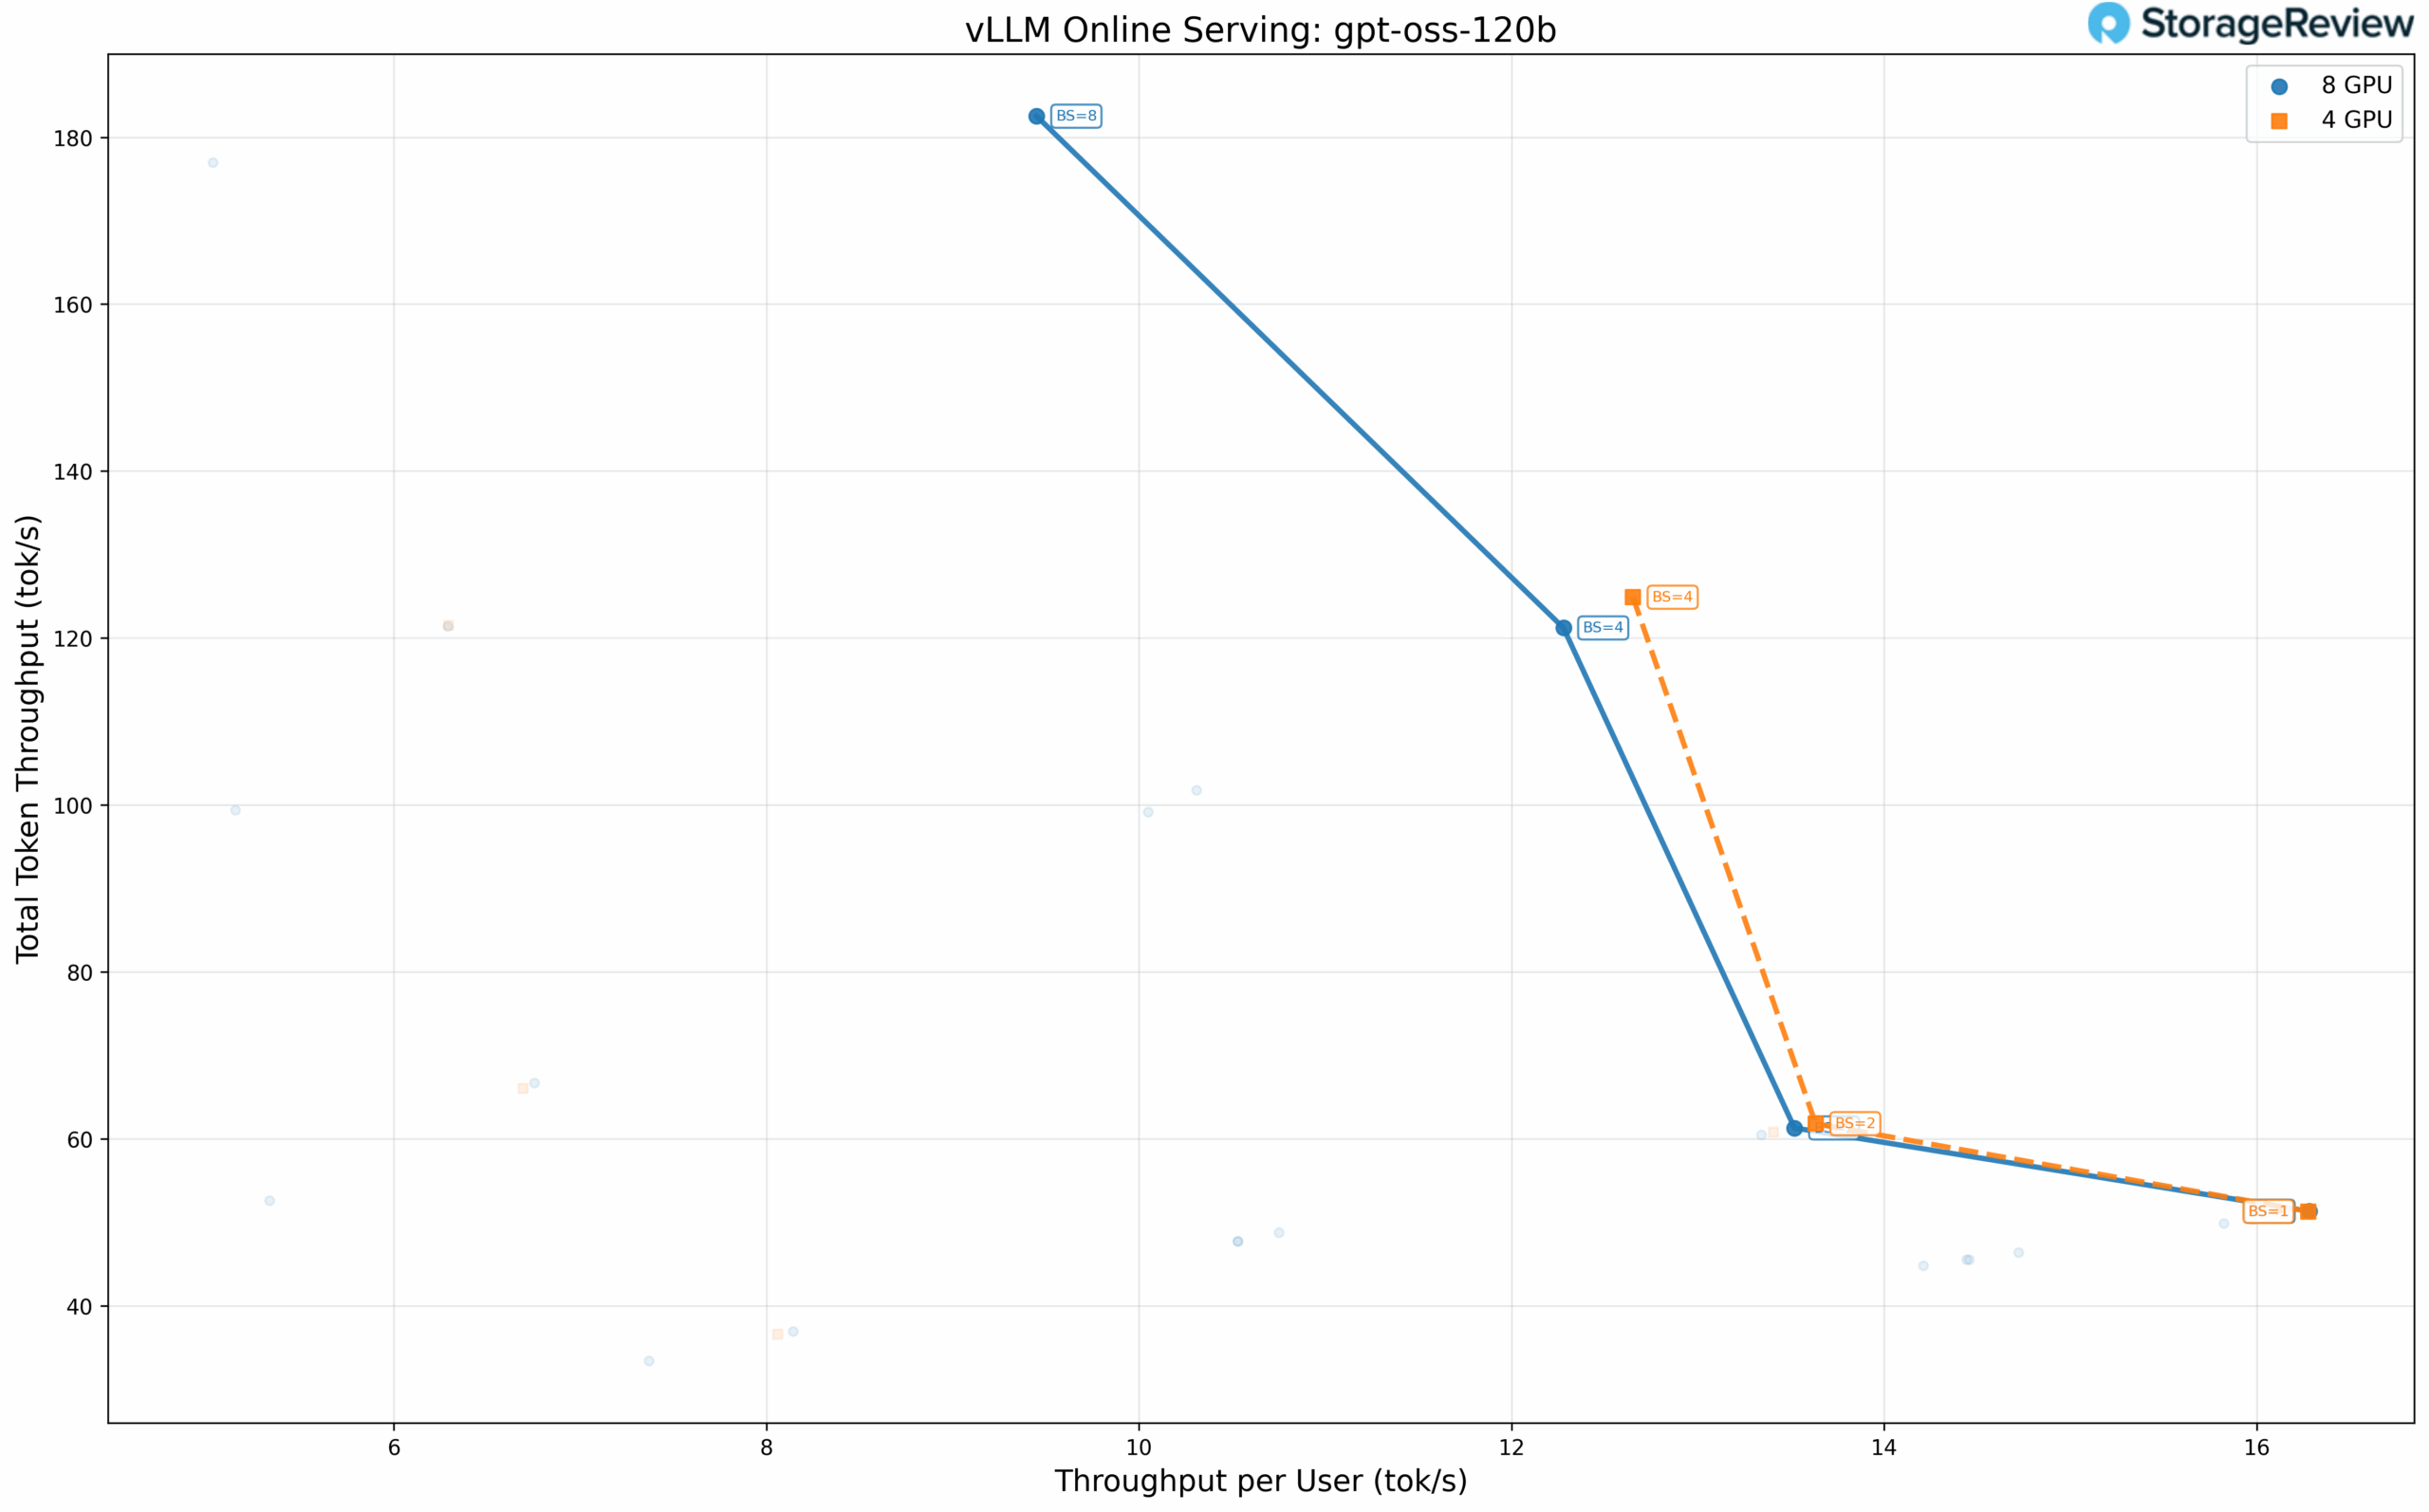
ပိုကြီးတဲ့ 120B မော်ဒယ်မှာ အနည်းဆုံး GPU ၄ ခု လိုအပ်ပြီး single-GPU နှိုင်းယှဉ်မှုကို ဖယ်ရှားပေးပါတယ်။ GPU လေးခုနဲ့ ရှစ်ခုကြားက စွမ်းဆောင်ရည်ဟာ ပိုမိုနီးကပ်စွာ ပေါင်းစပ်သွားပြီး batch size 1 မှာ per-user throughput ဟာ အတူတူနီးပါးပါပဲ (နှစ်ခုလုံးအတွက် 16.28 tok/s)။ eight-GPU configuration ဟာ data parallelism မှတစ်ဆင့် batch size မြင့်တဲ့အခါ အသင့်အတင့် အကျိုးကျေးဇူးတွေကို ပေးစွမ်းပါတယ်။
ကျွမ်းကျင်သူများ ရောနှောပါဝင်မှု- Qwen3 Coder 30B-A3B
နည်းပါးသော MoE ဗိသုကာလက်ရာများသည် inference လုပ်နေစဉ်အတွင်း အစုအဖွဲ့တစ်ခုကိုသာ activate လုပ်နေစဉ်တွင် parameter အရေအတွက်များစွာကို ထိန်းသိမ်းထားသည်။ Qwen3 Coder 30B-A3B သည် ၎င်း၏ 30B parameter pool အပြည့်အစုံမှ token တစ်ခုလျှင် ခန့်မှန်းခြေ 3B parameters များကို activate လုပ်သောကြောင့် local coding assistant ဖြန့်ကျက်မှုများအတွက် ရေပန်းစားသည်။
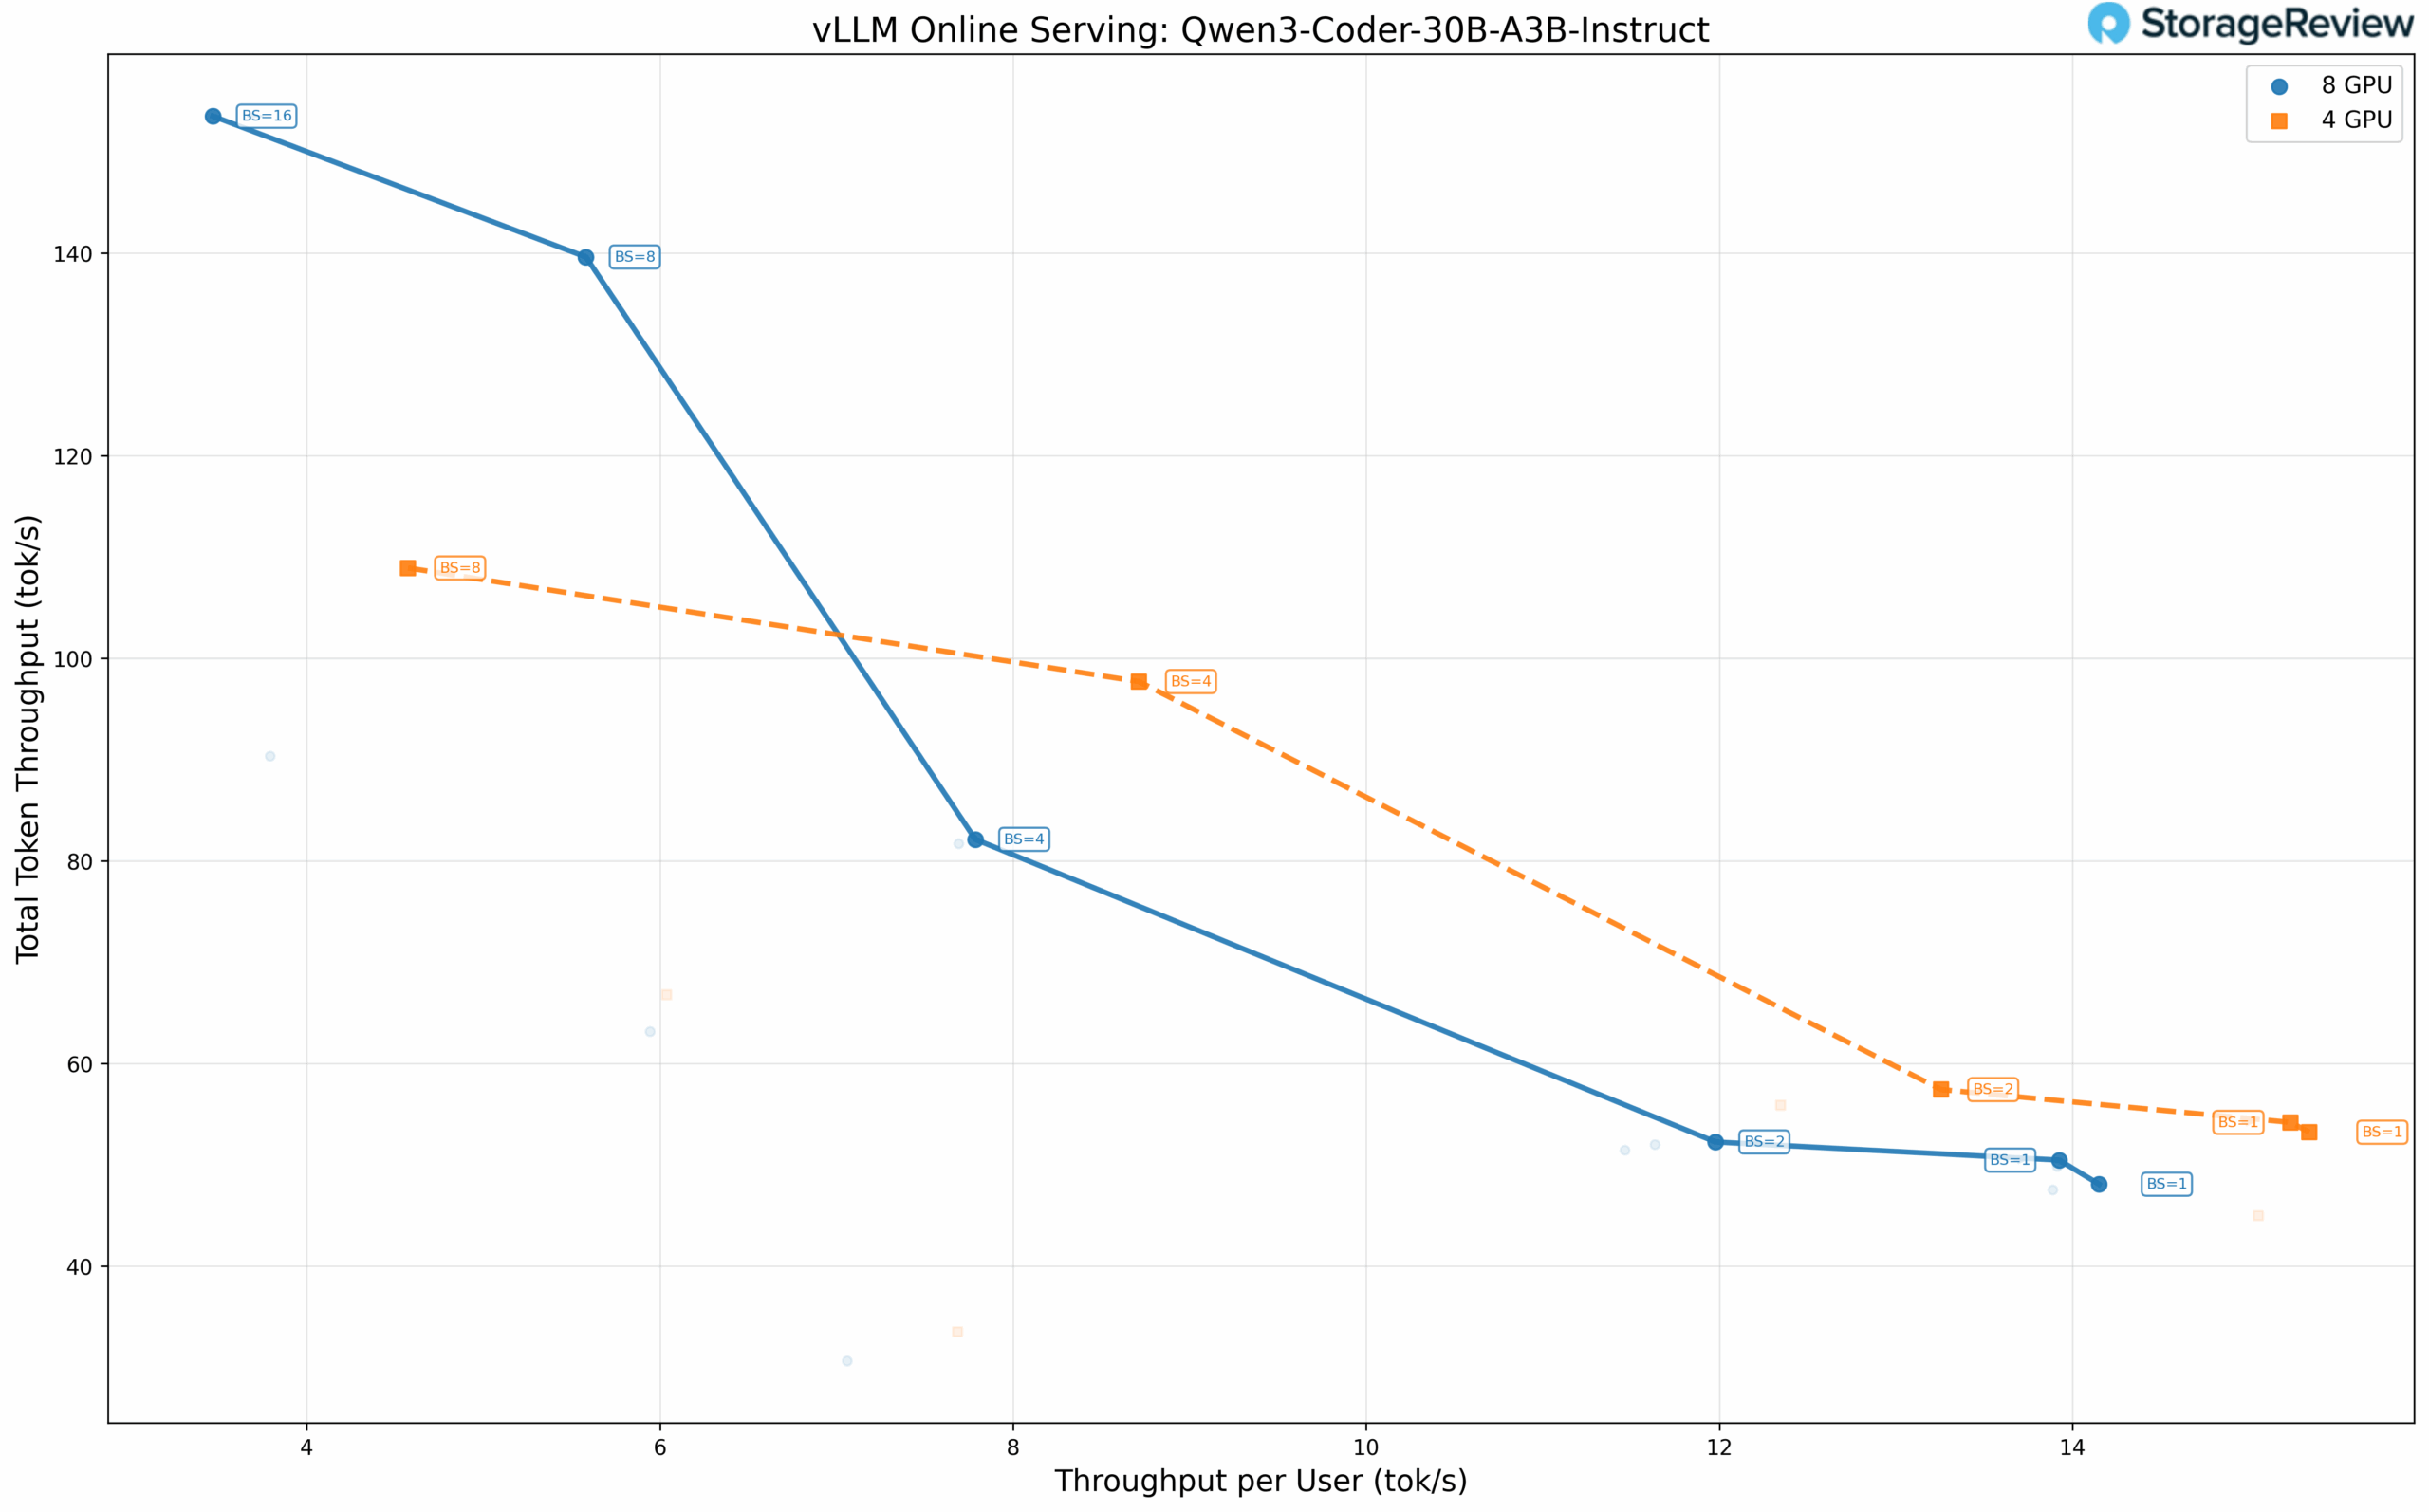
BF16 တိကျမှုဖြင့် စမ်းသပ်ရာတွင်၊ လေး-GPU ဖွဲ့စည်းမှုပုံစံသည် batch အရွယ်အစား နည်းပါးသည့်အခါတွင် အားသာချက်များကို ထပ်မံပြသခဲ့သည်။ TP=4 ဖြင့် per-user throughput 15.34 tok/s ရောက်ရှိပြီး TP=8 ဖြင့် batch အရွယ်အစား 1 တွင် 14.15 tok/s ရောက်ရှိသည်။
သိပ်သည်းသော မော်ဒယ်များ
Dense မော်ဒယ်များသည် ရိုးရာ LLM ဗိသုကာကို လိုက်နာကြပြီး၊ parameters များနှင့် activations အားလုံးကို inference လုပ်စဉ်အတွင်း အသုံးပြုသောကြောင့် ၎င်းတို့၏ sparse counterparts များထက် computationally intensive processing ကို ပိုမိုဖြစ်ပေါ်စေသည်။ ကျွန်ုပ်တို့၏ စမ်းသပ်မှု window အတွင်း INT4 quantization ကို အလုပ်မလုပ်ဘဲ၊ ဤမော်ဒယ်များသည် BF16 precision ဖြင့် လည်ပတ်ခဲ့သည်။
Llama 3.1 8B ညွှန်ကြားချက်
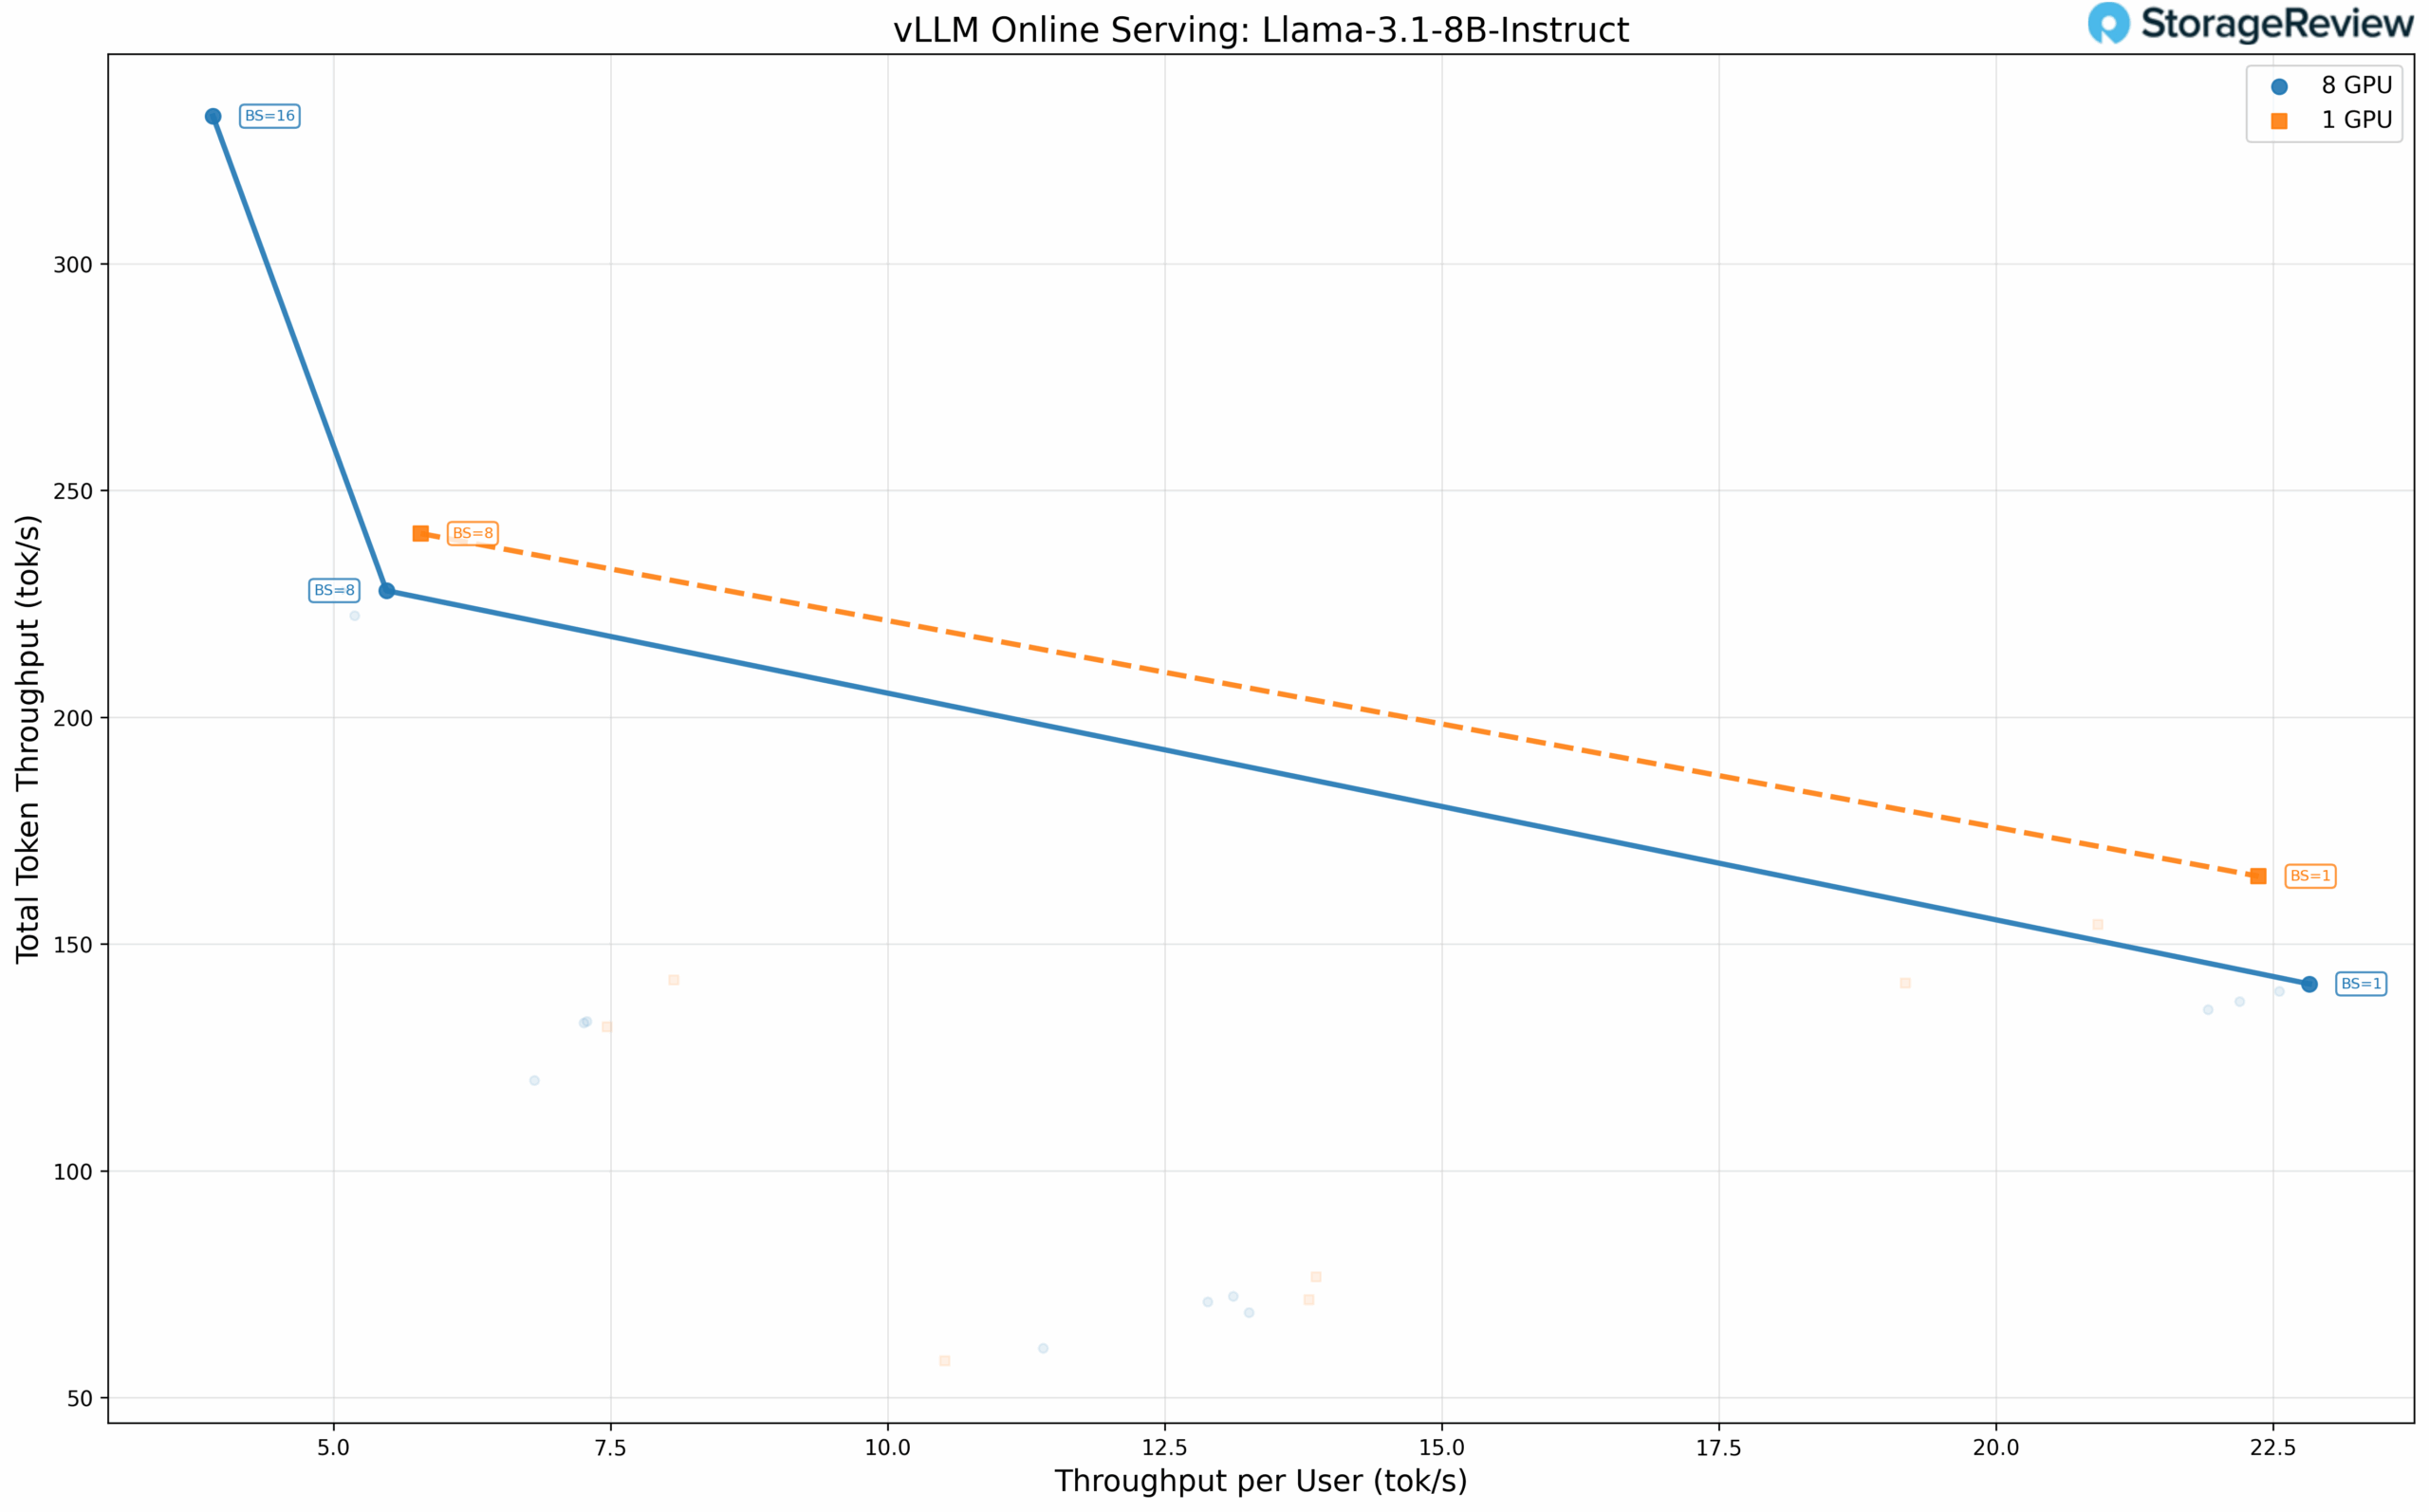
ကျစ်လစ်သိပ်သည်းသော 8B မော်ဒယ်သည် GPU တစ်ခုတည်းတွင် အဆင်ပြေစွာ တပ်ဆင်နိုင်သော်လည်း scaling အပြုအမူကို သွင်ပြင်လက္ခဏာပြရန် configuration များတစ်လျှောက် စမ်းသပ်ခဲ့သည်။ ရလဒ်များက ပုံစံကို အတည်ပြုသည်- GPU လေးခုသည် batch size 8 တွင် စုစုပေါင်း throughput 240.48 tok/s ပေးစွမ်းနိုင်ပြီး တူညီသော batch size တွင် GPU ရှစ်ခုဖြင့် 227.90 tok/s ပေးစွမ်းနိုင်သည်။ batch size 1 တွင် per-user throughput မှာ အတူတူနီးပါးဖြစ်သည် (22.37 tok/s vs. 22.83 tok/s)။
Mistral Small 3.1 24B ညွှန်ကြားချက်
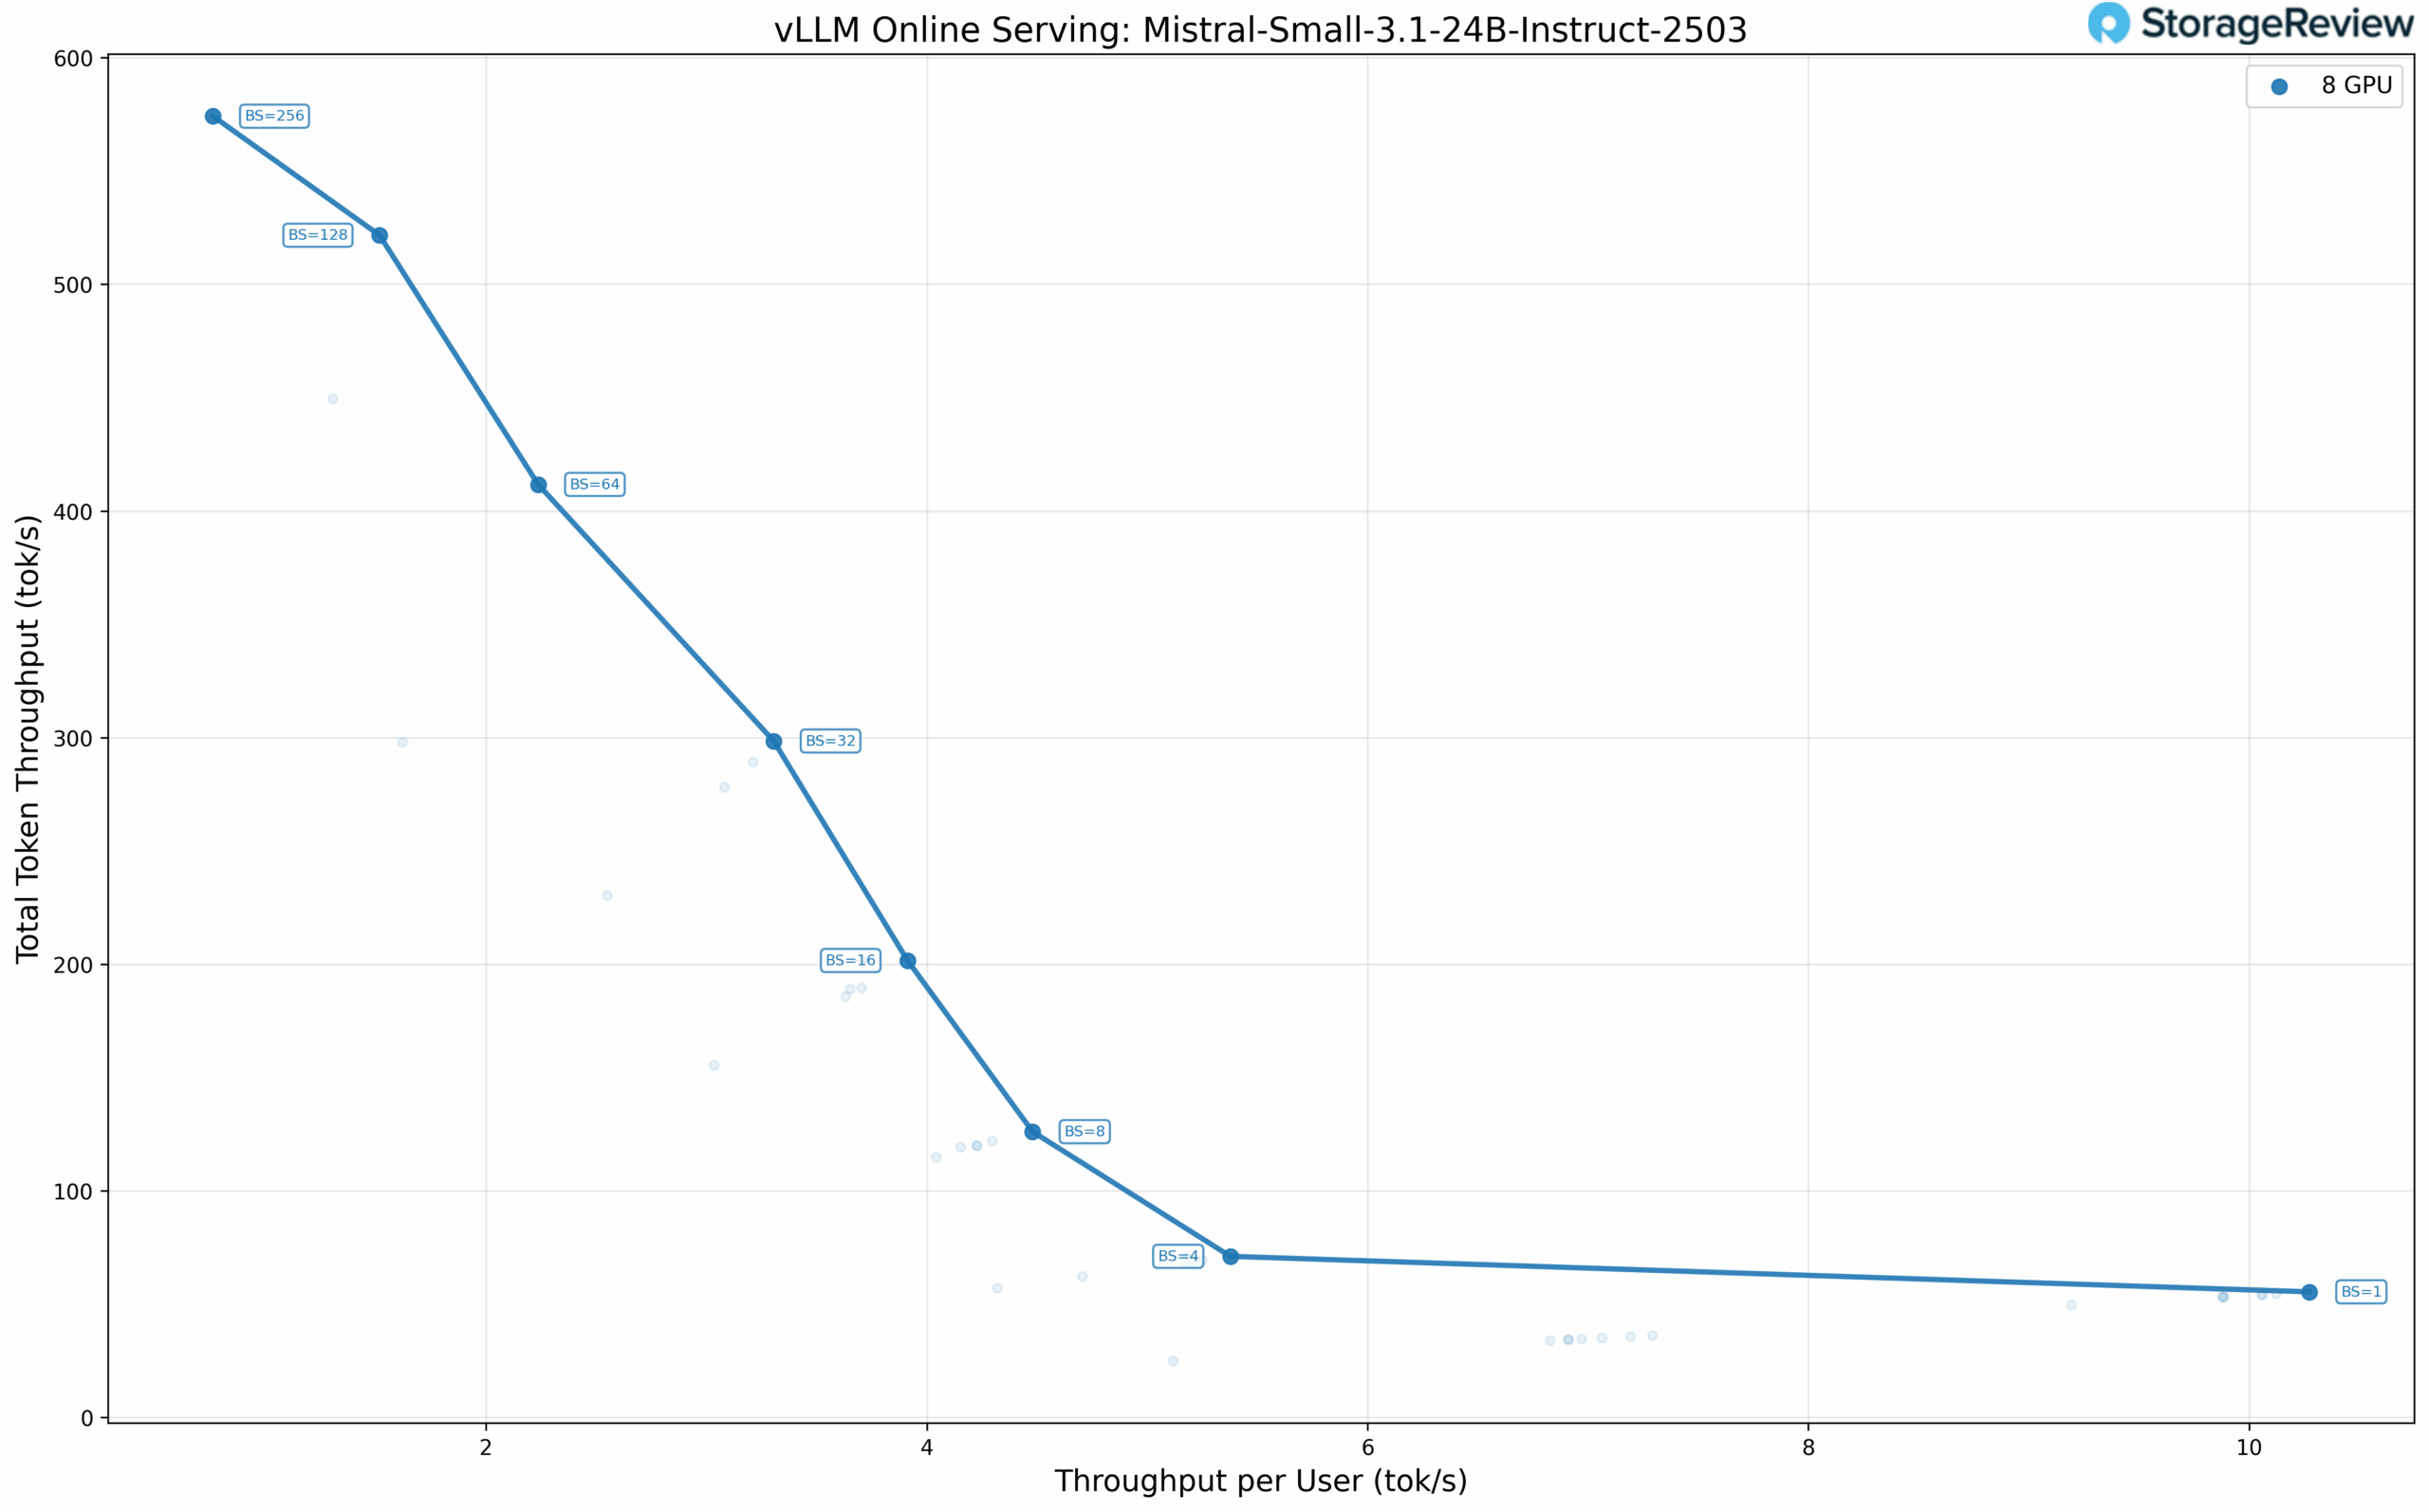
24B parameter Mistral model သည် ပိုမိုတောင်းဆိုမှုများသော workload ကို ကိုယ်စားပြုသည်။ BF16 precision တွင်၊ model သည် ပိုမိုမြင့်မားသော batch size များတွင် ခိုင်မာသော throughput scaling ကို ရရှိပြီး GPU ရှစ်ခုလုံးတွင် batch size 256 တွင် 574.16 tok/s အထိ ရောက်ရှိသည်။
တွေ့ရှိချက်များ
စမ်းသပ်ထားသော မော်ဒယ်အားလုံးတွင် တသမတ်တည်းရှိသော ပုံစံတစ်ခု ပေါ်ပေါက်လာသည်- ကျွန်ုပ်တို့၏ အဝင်/အထွက် တိုကင်ဖွဲ့စည်းပုံ ၂၅၆ ခုဖြင့် အသုတ်အရွယ်အစားနည်းသော အခြေအနေများတွင် မော်ဒယ်နှင့် ကိုက်ညီရန် လိုအပ်သော GPU အနည်းဆုံးအရေအတွက်ကို အသုံးပြုခြင်းသည် GPU ရှစ်ခုလုံးတွင် ဖြန့်ဝေခြင်းထက် အသုံးပြုသူတစ်ဦးချင်းစီ၏ စွမ်းဆောင်ရည်ကို ပိုမိုကောင်းမွန်စေပါသည် ။ PCIe မှတစ်ဆင့် GPU အချင်းချင်း ဆက်သွယ်ရေး overhead သည် PCIe 5.0 မြန်နှုန်းများတွင်ပင် တစ်ဦးတည်းအသုံးပြုသူ သို့မဟုတ် တစ်ပြိုင်နက်တည်းအသုံးပြုမှုနည်းပါးသော အခြေအနေများအတွက် parallelization အကျိုးကျေးဇူးများထက် ကျော်လွန်သော latency ကို ဖြစ်ပေါ်စေပါသည်။
ဤတွေ့ရှိချက်သည် ဖြန့်ကျက်မှုစီမံကိန်းအတွက် လက်တွေ့ကျသော သက်ရောက်မှုများရှိသည်။ single-user coding assistants သို့မဟုတ် low-concurrency agent workflows များကို လုပ်ဆောင်နေသော အဖွဲ့အစည်းများသည် GPU configuration ငယ်များဖြင့် လွတ်မြောက်နိုင်သော်လည်း လက်ခံနိုင်သော စွမ်းဆောင်ရည်ကို ရရှိနိုင်သည်။ ရှစ် GPU Battlematrix အပြည့်အစုံ configuration သည် batch inference workloads၊ synthetic data generation သို့မဟုတ် စုစုပေါင်း throughput သည် per-request latency ထက် ပိုမိုအရေးကြီးသည့် high-concurrency serving scenarios များအတွက် အထူးသဖြင့် memory ပိုမိုလိုအပ်သည့် ပိုကြီးသော မော်ဒယ်များကို အသုံးပြုသည့်အခါတွင် အကျိုးရှိဆုံးဖြစ်သည်။
Arc Pro B60s နှင့် အတွေ့အကြုံ
ကျွန်ုပ်တို့ပြုလုပ်ခဲ့သော အကန့်အသတ်ရှိသော စမ်းသပ်မှုတွင် အတွေ့အကြုံသည် အလွန်နာကျင်မှုမရှိပါ။ ကတ်များကို စတင်လည်ပတ်ရန်မှာ ရိုးရှင်းပြီး Battlemage ပံ့ပိုးမှုဖြင့် vLLM ၏ ဖွံ့ဖြိုးတိုးတက်ရေးဌာနခွဲဖြစ်သော LLM-Scaler ကို စနစ်ထည့်သွင်းခြင်းသည်လည်း အလားတူရိုးရှင်းကြောင်း သက်သေပြခဲ့သည်။ သို့သော် ဆော့ဖ်ဝဲသည် ဖွံ့ဖြိုးတိုးတက်မှုတွင် အလွန်စောလွန်းနေသေးသည်။ ကျွန်ုပ်တို့ စမ်းသပ်စတင်ချိန်တွင် GPU စာရင်းအင်းများကို ပြန်လည်ရယူနိုင်ခြင်း မရှိခဲ့ဘဲ tensor parallelism မှလွဲ၍ အခြား parallelism ဗျူဟာများဖြစ်သည့် expert parallelism သို့မဟုတ် pipeline parallelism တို့ကို multiple systems များတွင် scaling လုပ်ရန် မအောင်မြင်ခဲ့ပါ။ သို့သော် software stack ၏ pre-release state ကို ထည့်သွင်းစဉ်းစားလျှင် ဤကန့်သတ်ချက်များ ရှိလာမည်ဟု ကျွန်ုပ်တို့ မျှော်လင့်ထားပါသည်။
ကျွန်ုပ်တို့ရဲ့ YouTube မှာ ပထမဆုံး တင်ဆက်မှု ပြီးနောက် အအေးပေးစနစ်နဲ့ ပတ်သက်ပြီး ဆွေးနွေးမှုတွေ အများကြီး ပေါ်ပေါက်ခဲ့ပြီး မှတ်ချက်ပေးသူ အများအပြားက ကျွန်ုပ်တို့ရဲ့ ပွင့်လင်းတဲ့ စမ်းသပ်ခန်းမှာ ကတ်တွေ အပူလွန်ကဲသွားနိုင်တယ်ဆိုတဲ့ စိုးရိမ်မှုတွေကို ဖော်ပြခဲ့ကြပါတယ်။ အပူချိန် စောင့်ကြည့်မှု မရှိဘဲ၊ လေစီးဆင်းမှု လုံလောက်စွာ ရှိစေဖို့အတွက် ကတ်တွေကို server chassis ကို ရွှေ့ပြောင်းခဲ့ပါတယ်။ အထက်ဖော်ပြပါ Intel ရဲ့ စျေးကွက်ရှာဖွေရေး render တွေမှာ ပြသထားတဲ့အတိုင်း Battlematrix နောက်ဆုံးတည်ဆောက်ပုံက ဒီကတ်တွေကို workstation chassis ထဲမှာ အနီးကပ် စီထားတာကြောင့် ကျွန်ုပ်တို့ရဲ့ အပြည့်အဝ သုံးသပ်ချက်အတွက် workstation configuration မှာ အအေးပေးစနစ်ရဲ့ စွမ်းဆောင်ရည်ကို စမ်းသပ်ဖို့ ရည်ရွယ်ထားပါတယ်။
ပုံစံအချက်နဲ့ ပတ်သက်ပြီး ဒီကတ်တွေဟာ စံ workstation GPU တွေထက် အနည်းငယ်ပိုရှည်တာကြောင့် case-compatibility ဆိုင်ရာ အခက်အခဲတွေ ဖြစ်ပေါ်စေနိုင်ပါတယ်။ ဒါပေမယ့် server enclosure အများစုဟာ ကတ်ရဲ့ ရှေ့ဘက်အစွန်းကို support brackets တွေအတွက် အပိုနေရာ ပေးစွမ်းတာကြောင့် server chassis မှာ ပြဿနာမရှိဘဲ တပ်ဆင်နိုင်ပါတယ်။
အနာဂတ်စမ်းသပ်မှုအစီအစဉ်များ
B60 များ အပြည့်အဝထွက်ရှိပြီးနောက်နှင့် ယေဘုယျရရှိနိုင်မှုအပြီးတွင် Intel Battlematrix ကို ပြန်လည်လည်ပတ်ပြီး ပိုမိုကျယ်ပြန့်သော ပြန်လည်သုံးသပ်မှုတစ်ခုပြုလုပ်ရန် ကျွန်ုပ်တို့စီစဉ်ထားပါသည်။ မော်ဒယ်အမျိုးမျိုးနှင့် ဖြန့်ကျက်မှုဖွဲ့စည်းပုံအမျိုးမျိုးတွင် vLLM စမ်းသပ်မှုမှတစ်ဆင့် LLM inference စွမ်းဆောင်ရည်ကို ကျွန်ုပ်တို့ အကဲဖြတ်ပါမည်။ ဤ preview တွင် မပြသထားသော်လည်း၊ ဤ GPU များသည် ၎င်းတို့၏ လက်ရှိ software အခြေအနေတွင် decode လုပ်ဆောင်ချက်များထက် prefill တွင် ပိုမိုကောင်းမွန်စွာ လုပ်ဆောင်နိုင်ကြောင်း ကျွန်ုပ်တို့ တွေ့ရှိခဲ့ပါသည်။ အပြည့်အစုံပြန်လည်သုံးသပ်ချက်တွင် ဤအပြုအမူကို လက္ခဏာရပ်ဖော်ပြရန် prefill-heavy နှင့် decode-heavy inference workloads များကို ပိုမိုနက်ရှိုင်းစွာ လေ့လာသွားပါမည်။
homelab အသိုင်းအဝိုင်းက ဒီ GPU တွေကို အသုံးအများဆုံး homelab workloads တစ်ခုဖြစ်တဲ့ media server တွေအတွက် အသုံးပြုဖို့ စိတ်ဝင်စားကြောင်း ဖော်ပြခဲ့ကြပါတယ်။ Discord မှာရှိတဲ့ အဖွဲ့ဝင်တွေနဲ့ Plex နဲ့ Jellyfin တွေနဲ့ စမ်းသပ်ကြည့်ဖို့ ကျွန်တော်တို့ မျှော်လင့်ပါတယ် ။ CAD စွမ်းဆောင်ရည် စမ်းသပ်ဖို့အတွက် SolidWorks နဲ့ Autodesk အပါအဝင် Professional workloads တွေကိုလည်း ကျွန်တော်တို့ စောင့်ကြည့်နေပါတယ်။ Discord အဖွဲ့ဝင်တွေအတွက် concurrent desktop density နဲ့ cloud gaming ကို အကဲဖြတ်ဖို့အတွက် multi-user VDI server တစ်ခုကို ဖြန့်ကျက်ဖို့အတွက် Proxmox နဲ့အတူ SR-IOV ကို ကြည့်ရှုဖို့လည်း စီစဉ်ထားပါတယ်။
ကောက်ချက်
Intel ရဲ့ Arc Pro B60 Battlematrix ဟာ workstation ဈေးနှုန်းတွေနဲ့ မြင့်မားတဲ့ စွမ်းရည်ရှိတဲ့ GPU memory ကို အသုံးပြုနိုင်အောင် ပြုလုပ်ပေးမယ့် စိတ်လှုပ်ရှားစရာကောင်းတဲ့ platform တစ်ခုဖြစ်ပါတယ်။ dual-GPU card ဒီဇိုင်းက သိပ်သည်းဆကန့်သတ်ချက်တွေကို ကိုင်တွယ်ဖြေရှင်းပေးပြီး GPU တစ်လုံးကို 24GB ခွဲဝေပေးထားတာကြောင့် LLM inference workloads တွေနဲ့ ကိုက်ညီပြီး ဈေးနှုန်းဖွဲ့စည်းပုံက တည်ထောင်ထားတဲ့ professional GPU ecosystem တွေအတွက် ဆွဲဆောင်မှုရှိတဲ့ အခြားရွေးချယ်စရာတွေကို ဖန်တီးပေးပါတယ်။ bleeding-edge performance ထက် data sovereignty နဲ့ cost efficiency ကို ဦးစားပေးတဲ့ အဖွဲ့အစည်းတွေအတွက် ဒီ platform ဟာ ထည့်သွင်းစဉ်းစားသင့်တဲ့ platform တစ်ခုဖြစ်ပါတယ်။
ဆော့ဖ်ဝဲလ် ရင့်ကျက်မှုသည် အဓိက အကန့်အသတ်အဖြစ် ရှိနေဆဲဖြစ်သည်။ LLM Scaler မှတစ်ဆင့် framework optimization တွင် Intel ၏ ရင်းနှီးမြှုပ်နှံမှုနှင့် driver refinement ကို ဆက်လက်လုပ်ဆောင်နေခြင်းသည် Arc GPU လိုင်းကို သိသာထင်ရှားသော တန်ဖိုးတစ်ခုအဖြစ် ထိန်းသိမ်းရန် ကတိကဝတ်ပြုထားကြောင်း ညွှန်ပြနေသည်။
NVIDIA DGX Spark မှ ပေးဆောင်သော မယုံနိုင်လောက်အောင် စွမ်းဆောင်ရည်နှင့် ရှစ် GPU battlematrix ဖွဲ့စည်းမှု မည်မျှ ရေပန်းစားမည်ကို မသိရသေးပါ ။ တကယ့်ဇာတ်လမ်းကတော့ single-card နဲ့ dual-card ဖွဲ့စည်းမှု ဖြစ်နိုင်ပါတယ်။ ဒေါ်လာ ၆၀၀ မှ ၁၂၀၀ အတွင်း ဝင်ရောက်ခွင့်က ပုဂ္ဂလိက AI အခြေခံအဆောက်အအုံ စူးစမ်းလေ့လာရေးအတွက် အတားအဆီးတွေကို သိသိသာသာ လျှော့ချပေးပါတယ်။
ဒရိုက်ဘာ အပ်ဒိတ်များ ရောက်ရှိလာပြီး ဆော့ဖ်ဝဲလ် framework များ ရင့်ကျက်လာသည်နှင့်အမျှ ကျွန်ုပ်တို့၏ စမ်းသပ်မှုကို ဆက်လက်တိုးချဲ့သွားပါမည်။ ၎င်းတို့ကို သင်ကိုယ်တိုင် စမ်းကြည့်လိုပါက ကျွန်ုပ်တို့၏ Discord server သို့ ဝင်ရောက်ပါ ၊ ထိုတွင် B60 ဝင်ရောက်ခွင့် ကန့်သတ်ထားသော community server တစ်ခု ရှိပါသည်။


 အမေဇုံ