

NVIDIA DGX Spark သည် အသုံးပြုရလွယ်ကူသော AI အခြေခံအဆောက်အအုံတွင် အရေးပါသော အခိုက်အတန့်တစ်ခုကို ကိုယ်စားပြုသည်။ ၂၀၁၇ ခုနှစ်တွင် Transformer ဗိသုကာကို မိတ်ဆက်ခဲ့သော အထင်ကရ "Attention is All You Need" စာတမ်းသည် ရှစ်-GPU P100 server configuration ကို အားကိုးခဲ့ပြီး ကီလိုဝပ်နာရီ ဆယ်ဂဏန်းခန့် သုံးစွဲကာ data center real estate များစွာကို နေရာယူထားသည်။ ယနေ့ခေတ်တွင် DGX Spark သည် ကျစ်လစ်သော 240-watt desktop form factor ဖြင့် သာလွန်ကောင်းမွန်သော တွက်ချက်မှုစွမ်းဆောင်ရည်ကို ပေးဆောင်သည်။ ပါဝါထိရောက်မှုနှင့် form factor ဖိသိပ်မှုတွင် ဤသိသာထင်ရှားသော တိုးတက်မှုသည် ယခင်က data center-exclusive AI စွမ်းရည်များကို တစ်ဦးချင်းသုတေသီများ၊ အဖွဲ့ငယ်များနှင့် ဖြန့်ဝေထားသော ဖွံ့ဖြိုးတိုးတက်ရေးအဖွဲ့အစည်းများအတွက် အသုံးပြုနိုင်စေသည်။
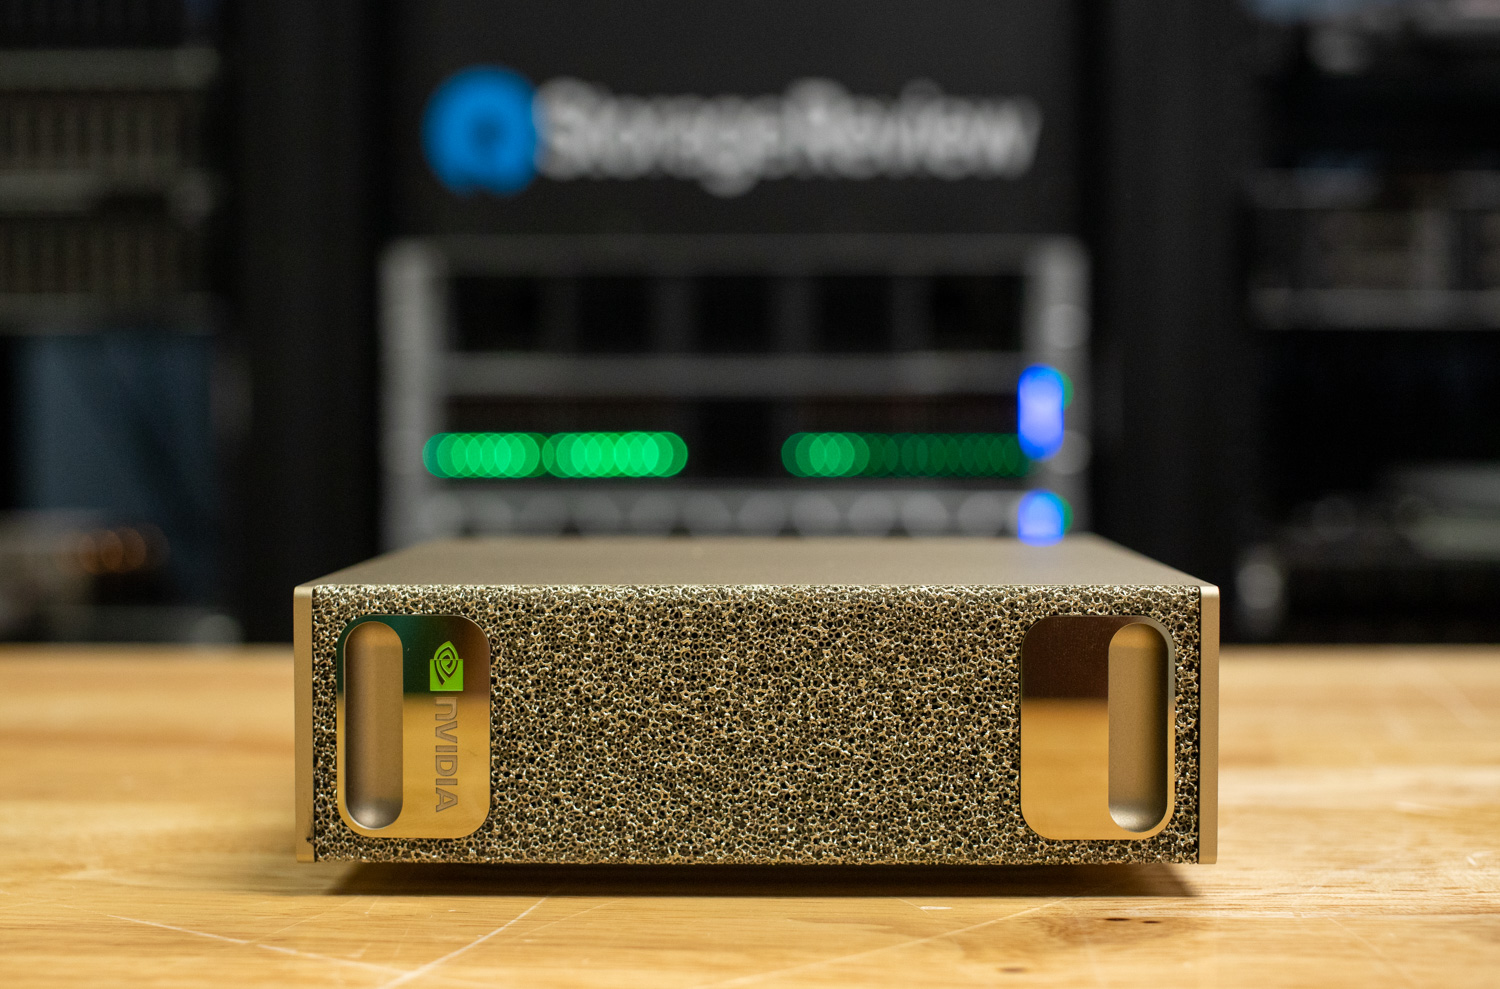
Spark ကို ယခင် desktop AI ဖြေရှင်းချက်များနှင့် ခွဲခြားသိမြင်စေသည့်အချက်မှာ ဖွံ့ဖြိုးတိုးတက်မှု သံသရာတစ်ခုလုံးအတွက် ၎င်း၏ ပြည့်စုံသော ချဉ်းကပ်မှုဖြစ်သည်။ စမ်းသပ်ခြင်း၊ အသေးစိတ်ချိန်ညှိခြင်းနှင့် ဖြန့်ကျက်ခြင်းကြားတွင် အလျှော့ပေးမှုများအစား Spark သည် အဆင့်အားလုံးတွင် စစ်မှန်သောစွမ်းရည်ကို ပေးစွမ်းသည်။ 128 GB ပေါင်းစပ်မှတ်ဉာဏ်ဗိသုကာသည် သမားရိုးကျ workstation များတွင် cloud resource များလိုအပ်မည့် မော်ဒယ်များ၏ အပြည့်အဝ parameter အသေးစိတ်ချိန်ညှိမှုကို ပြုလုပ်နိုင်စေပြီး၊ synthetic data generation အပါအဝင် batch inference workloads များအတွက် သင့်လျော်သော တစ်စက္ကန့်လျှင် tokens ရာပေါင်းများစွာကို ပေးဆောင်သည်။ 200Gb fabric စွမ်းရည်ပါရှိသော ConnectX-7 ကွန်ရက်ပါဝင်ခြင်းသည် အဖွဲ့အစည်းများသည် ပိုမိုကြီးမားသော မော်ဒယ်စူးစမ်းလေ့လာမှုအတွက် Spark စနစ်များစွာကို cluster လုပ်နိုင်သည်၊ သို့သော် ကျွန်ုပ်တို့ပြသမည့်အတိုင်း တစ်ခုတည်းသော unit သည်ပင် အလွန်အံ့သြဖွယ်ကောင်းသော စွမ်းဆောင်ရည်ကို သက်သေပြသည်။
Key ကို Takeaways
ဒက်စ်တော့ပ်ရှိ ဒေတာစင်တာ ပါဝါ - ၁.၁၃ လီတာ၊ ၂၄၀ ဝပ် ဘူးထဲတွင်ပါရှိသော GB10 Grace Blackwell သည် ဒေါ်လာ ၃,၉၉၉ ကျသင့်ပြီး 1 petaFLOP FP4 sparse စွမ်းဆောင်ရည်အထိ ပေးစွမ်းနိုင်သည်။
လုပ်ငန်းစဉ်များကို ပြောင်းလဲစေသော မှတ်ဉာဏ် : 128GB ပေါင်းစည်းမှတ်ဉာဏ်သည် 8B မော်ဒယ်များ၏ ဒေသတွင်းတွင် full-parameter fine-tuning နှင့် high-throughput inference ကို လုပ်ဆောင်နိုင်စေပါသည်။ စမ်းသပ်မှုတွင် Llama 3.1 8B FP4 သည် 128 concurrency တွင် ~924 tok/s ရောက်ရှိခဲ့ပြီး Qwen3 Coder 30B-A3B FP8 သည် batch 64 တွင် ~483 tok/s ရောက်ရှိခဲ့သည်ကို ကျွန်ုပ်တို့တွေ့မြင်ခဲ့ရသည်။
မြန်ဆန်သော သိုလှောင်မှုကို တိုးချဲ့ရန်နှင့် ချိတ်ဆက်ရန် အသင့်ဖြစ်ပါပြီ - Integrated ConnectX-7 သည် clustering သို့မဟုတ် NVMe-oF အတွက် 200G fabric ကို ပေးပါသည်။ internal 2242 Gen5 NVMe သည် အဆင်ပြေသော်လည်း လေးလံသော I/O အတွက် အကန့်အသတ်ရှိသောကြောင့် RDMA ပေါ်ရှိ external NVMe-oF သည် ရေရှည်တည်တံ့သော throughput အတွက် ပိုမိုကောင်းမွန်သော လမ်းကြောင်းဖြစ်သည်။
ဆော့ဖ်ဝဲလ် ရင့်ကျက်မှု ပထမနေ့ : DGX OS၊ CUDA၊ cuDNN၊ TensorRT၊ AI Workbench၊ containers နှင့် workflow playbooks များဖြင့် တင်ပို့ပေးသောကြောင့် အဖွဲ့များသည် အစစ်အမှန် workloads များကို ချက်ချင်း လုပ်ဆောင်နိုင်ပါသည်။
လက်တွေ့ကမ္ဘာစွမ်းဆောင်ရည်ကို သက်သေပြထားသည် - MAMF သည် ~99.8 TFLOPs BF16 နှင့် ~207.7 TFLOPs FP8 ကို တိုင်းတာခဲ့သည်။ GDSIO ဖတ်ရှုမှုများသည် အတွင်းပိုင်းတွင် ~11.4 GiB/s အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး 200G အထည်ထက် အမြင့်ဆုံးပမာဏကို မျှော်လင့်ရသည်။
DGX Spark ဆိုတာဘာလဲ၊ ဘယ်သူတွေ စဉ်းစားသင့်လဲ။
NVIDIA DGX Spark သည် အခြေခံအားဖြင့် GPU အစိတ်အပိုင်းတစ်ခုထက် ပြီးပြည့်စုံသော AI ဖွံ့ဖြိုးတိုးတက်ရေးပလက်ဖောင်းတစ်ခုဖြစ်သည်။ ၎င်း၏အဓိကအချက်မှာ GB10 Grace Blackwell Superchip ဖြစ်ပြီး၊ ၎င်းသည် ပဉ္စမမျိုးဆက် Tensor Cores များပါရှိသော Blackwell ဗိသုကာ GPU ကို NVLink-C2C မှတစ်ဆင့် ချိတ်ဆက်ထားသော 20-core Arm CPU (10× Cortex-X925 + 10× Cortex-A725) နှင့် ပေါင်းစပ်ထားသည်။ NVIDIA ၏ အဆိုအရ ဤပေါင်းစပ်ထားသော interconnect ဗိသုကာသည် PCIe Gen 5 ထက် bandwidth ၅ ဆအထိ ပိုမိုမြင့်မားစေပြီး discrete processing domains များအစား ပေါင်းစည်းထားသော computational fabric ကို ဖန်တီးပေးသည်။
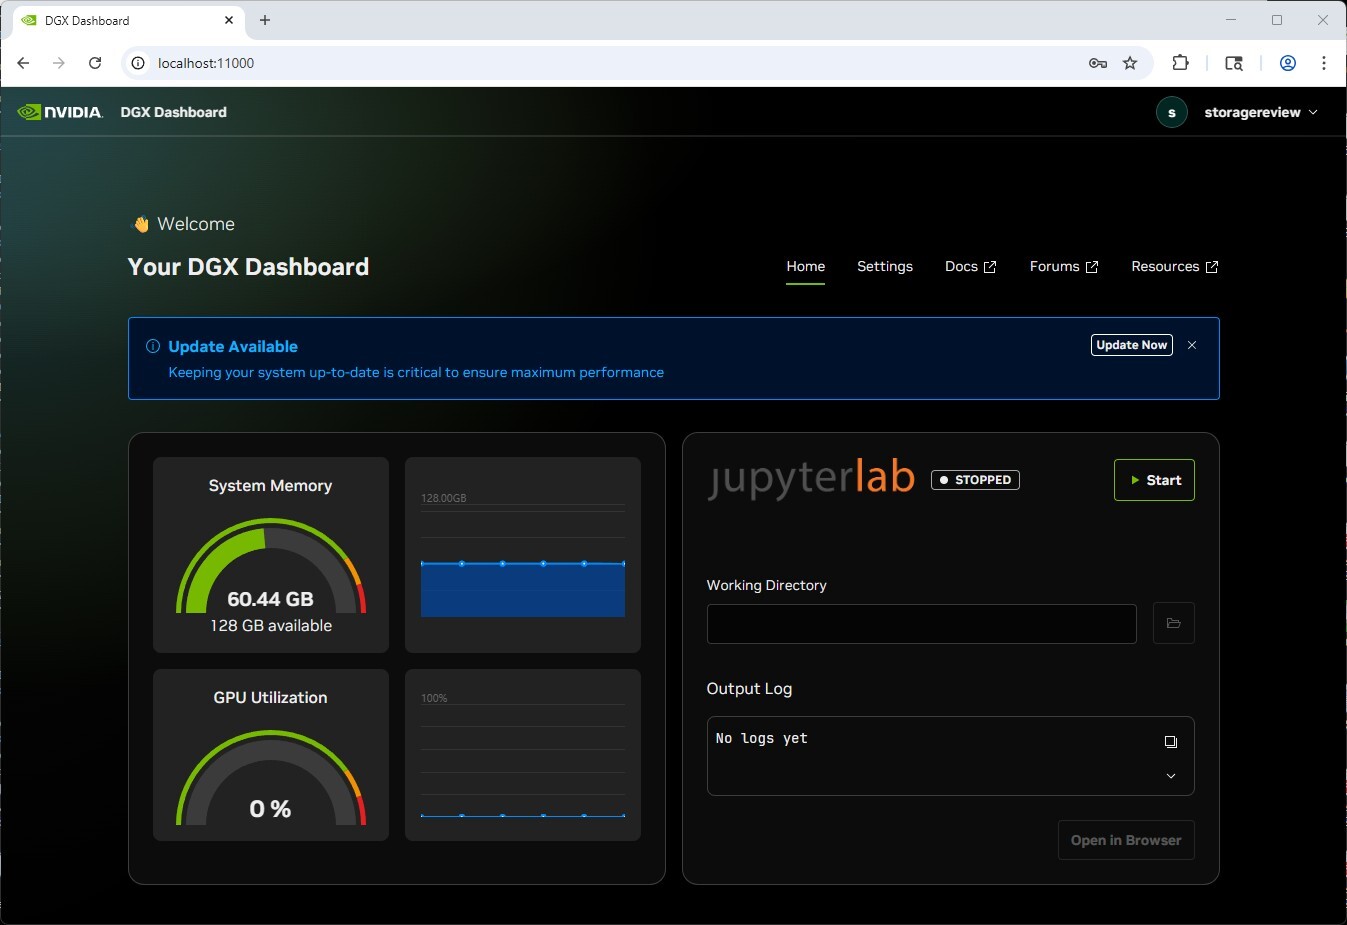
အသုံးပြုသူများအား စတင်အသုံးပြုရန်အတွက် NVIDIA သည် Ubuntu Desktop ပေါ်တွင်တည်ဆောက်ထားသော DGX OS ကို CUDA၊ cuDNN၊ TensorRT၊ NVIDIA Container Runtime နှင့် AI Workbench အပါအဝင် ကြိုတင်ပြင်ဆင်ထားသော AI software stack အပြည့်အစုံဖြင့် ပို့ဆောင်ပေးထားပြီး custom workstation builds များတွင် ကြုံတွေ့ရသော ပုံမှန် driver စိန်ခေါ်မှုများနှင့် environment configuration overhead ကို ဖယ်ရှားပေးပါသည်။ စနစ်သည် ပြောင်းလွယ်ပြင်လွယ်ရှိသော deployment paradigms များကို ပေးဆောင်သည်- peripherals များကို တပ်ဆင်ပြီး Ubuntu desktop အတွေ့အကြုံအပြည့်အစုံပါရှိသော compact workstation အဖြစ် အသုံးပြုပါ သို့မဟုတ် NVIDIA Sync မှတစ်ဆင့် ဝင်ရောက်နိုင်သော headless network appliance အဖြစ် ဖြန့်ကျက်ပါ၊ ၎င်းသည် JupyterLab၊ VS Code၊ Cursor IDE နှင့် SSH terminals များနှင့် ချောမွေ့စွာပေါင်းစပ်ပေးပါသည်။
၎င်းသည် AI ကျွမ်းကျင်ပညာရှင်များ၊ ဘာသာစကားမော်ဒယ်များကို ပိုမိုကောင်းမွန်အောင်ပြုလုပ်နေသော သုတေသီများ၊ RAPIDS လုပ်ငန်းစဉ်များကို အရှိန်မြှင့်တင်နေသော ဒေတာသိပ္ပံပညာရှင်များ၊ အေးဂျင့်စနစ်များကို အကောင်အထည်ဖော်နေသော ဆော့ဖ်ဝဲရေးသားသူများ သို့မဟုတ် ablative မော်ဒယ်များဖြင့် ဗိသုကာလက်ရာများကို အသေးစားအတိုင်းအတာဖြင့် စမ်းသပ်နေသော အဖွဲ့များအတွက် ရည်ရွယ်ချက်ရှိရှိတည်ဆောက်ထားသော အခြေခံအဆောက်အအုံဖြစ်သည်။ Spark သည် ဒေတာစင်တာရှုပ်ထွေးမှုမရှိဘဲ လေးနက်သော AI တွက်ချက်မှုစွမ်းရည် လိုအပ်သော ပညာရှင်များကို ပစ်မှတ်ထားသည်။
NVIDIA DGX Spark နည်းပညာဆိုင်ရာ သတ်မှတ်ချက်များ
| specification | အသေးစိတ် |
|---|---|
| ဗိသုကာအတတ်ပညာ | |
| GPU ကို | NVIDIA Blackwell ဗိသုကာ |
| စီပီယူ | ၂၀-core Arm (၁၀x Cortex-X၉၂၅ + ၁၀x Cortex-A၇၂၅) |
| Tensor core | 5th မျိုးဆက်ကျောင်းသားများ |
| RT ကို core | 4th မျိုးဆက်ကျောင်းသားများ |
| NVENC / NVDEC | ၁× / ၁× |
| မှတ်ဉာဏ် | |
| System ကိုမှတ်ဉာဏ် | 128 GB LPDDR5X (ပေါင်းစည်းထားသော စနစ် မှတ်ဉာဏ်) |
| မှတ်ဉာဏ် Interface | 256-bit မှာ |
| မှတ်ဉာဏ် Bandwidth | 273 GB ကို / s နဲ့ |
| performance | |
| FP4 | 1 petaFLOP အထိ (Sparsity ပါ၀င်သည်) |
| သိုလှောင်ခြင်း | |
| သိုလှောင်ခြင်း | 1 TB သို့မဟုတ် 4 TB NVMe M.2 (ကိုယ်တိုင်ကုဒ်ဝှက်ထားသည်) |
| connectivity | |
| ယူအက်စ်ဘီ | ၄ × Type-C USB 3.2 Gen 2 × 2 (20Gbps) |
| Ethernet | ၁ × 10GbE RJ-45 |
| NIC | ConnectX-7 Smart NIC – 2x 200G QSFP (အများဆုံး 200G bandwidth အထိ ခွင့်ပြုသည်) |
| ကြိုးမဲ့ | Wi-Fi 7၊ Bluetooth ၄.၂ |
| audio Output | HDMI ချန်နယ်ပေါင်းစုံ အသံထွက်ပေါက် |
| Display Connectors များ | ၁ × HDMI 2.1a |
| စက်နှင့်ဆိုင်သော | |
| ရှုထောင့် | ၁၃၅ × ၁၂၉ × ၂၂၃.၇ မီလီမီတာ (၅.၃ × ၅.၁ × ၈.၈ လက်မ) |
| အလေးချိန် | 1.2 ကီလိုဂရမ် |
| Power Consumption | 240 ဒဗလျူ |
NVIDIA DGX Spark ဒီဇိုင်းနှင့် တည်ဆောက်မှု
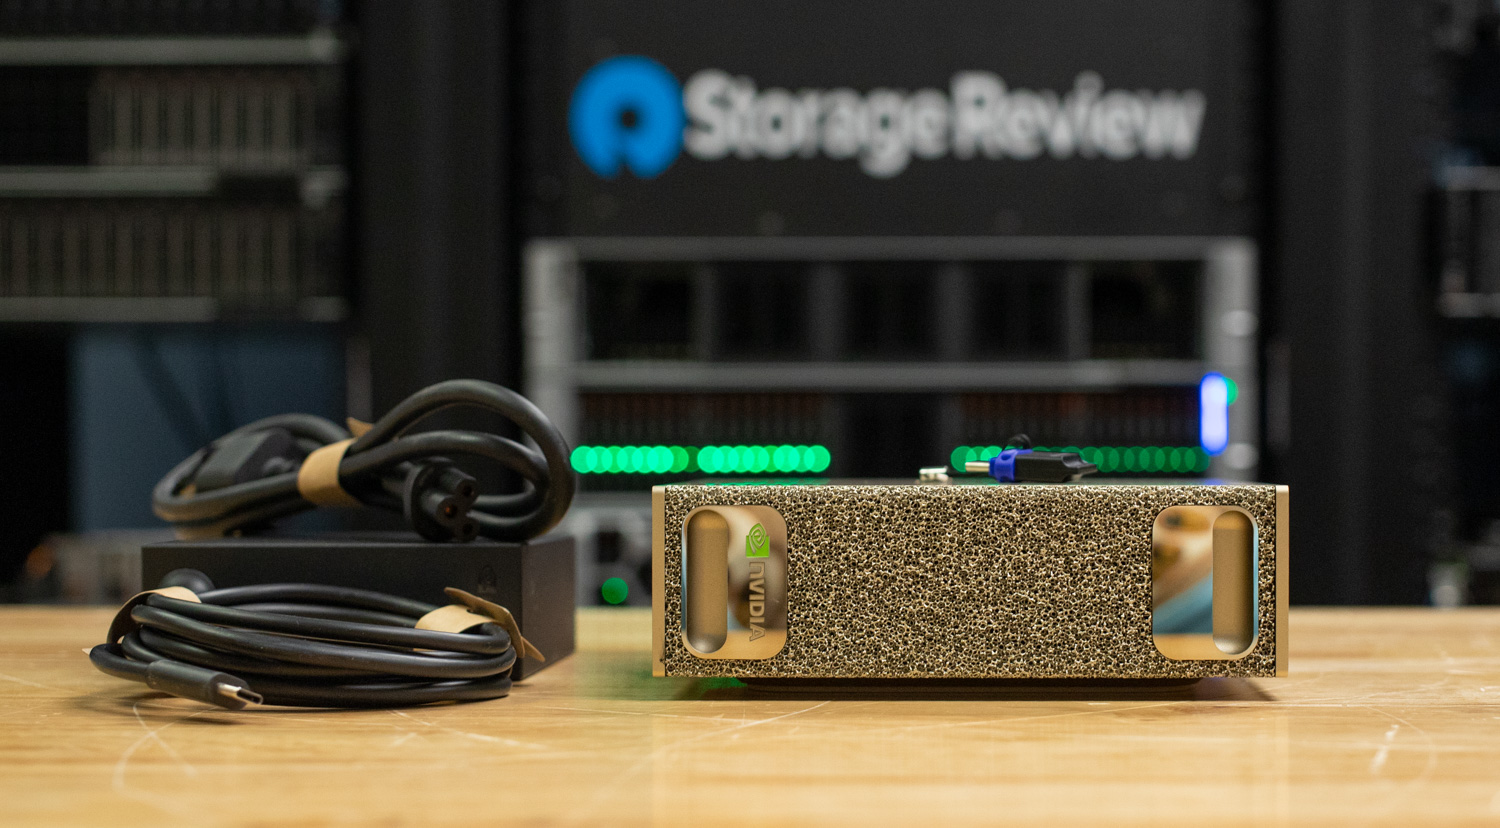
NVIDIA DGX Spark သည် NVIDIA ၏ မှားယွင်းစရာမရှိသော စက်မှုဒီဇိုင်းဘာသာစကားကို ဆက်လက်ထိန်းသိမ်းထားပြီး ၎င်း၏ ပိုကြီးသော DGX စနစ်များ၏ အသွင်အပြင်နှင့် အထိအတွေ့ကို ထင်ဟပ်စေသော ကျစ်လစ်သော ကိုယ်ထည်ပါရှိသည်။ ရှေ့မျက်နှာပြင်တွင် လက်ကိုင်အသေးစား ဖြတ်တောက်မှုများ၊ မူရင်းအရွယ်အစားအပြည့် DGX ယူနစ်များ၏ လက်ကိုင်များနှင့် NVIDIA ၏ အထင်ကရ အစိမ်းရောင် လိုဂိုတံဆိပ်ဖြင့် အသားပေးဖော်ပြထားသော ရွှေရောင်သတ္တုဖြင့် အပြီးသတ်ထားသောကြောင့် သန့်စင်ပြီး ပရီမီယံအသွင်အပြင်ကို ပေးစွမ်းသည်။
ရုပ်ပိုင်းဆိုင်ရာအရ DGX Spark သည် 5.9 × 5.9 × 1.98 လက်မ (150 × 150 × 50.5 mm) အတိုင်းအတာရှိပြီး အလေးချိန် 2.6 ပေါင် (1.2 kg) ရှိကာ စုစုပေါင်း အတွင်းပိုင်း ပမာဏ 1.13 လီတာ ရှိသည်။ ၎င်းသည် 1-liter small-form-factor PC အတန်းအစားအတွင်း ခိုင်မာစွာ ရောက်ရှိစေသည်။ ၎င်း၏ footprint အနည်းငယ်သာရှိသော်လည်း၊ စနစ်သည် passive heat spreader အဖြစ်လည်း ဆောင်ရွက်ပေးသည့် all-metal alloy shell ကြောင့် သိပ်သည်းပြီး ခိုင်ခံ့သည်ဟု ခံစားရပြီး ပုံသဏ္ဍာန်နှင့် လုပ်ဆောင်ချက် နှစ်မျိုးလုံးကို အာရုံစိုက်ထားသည်။
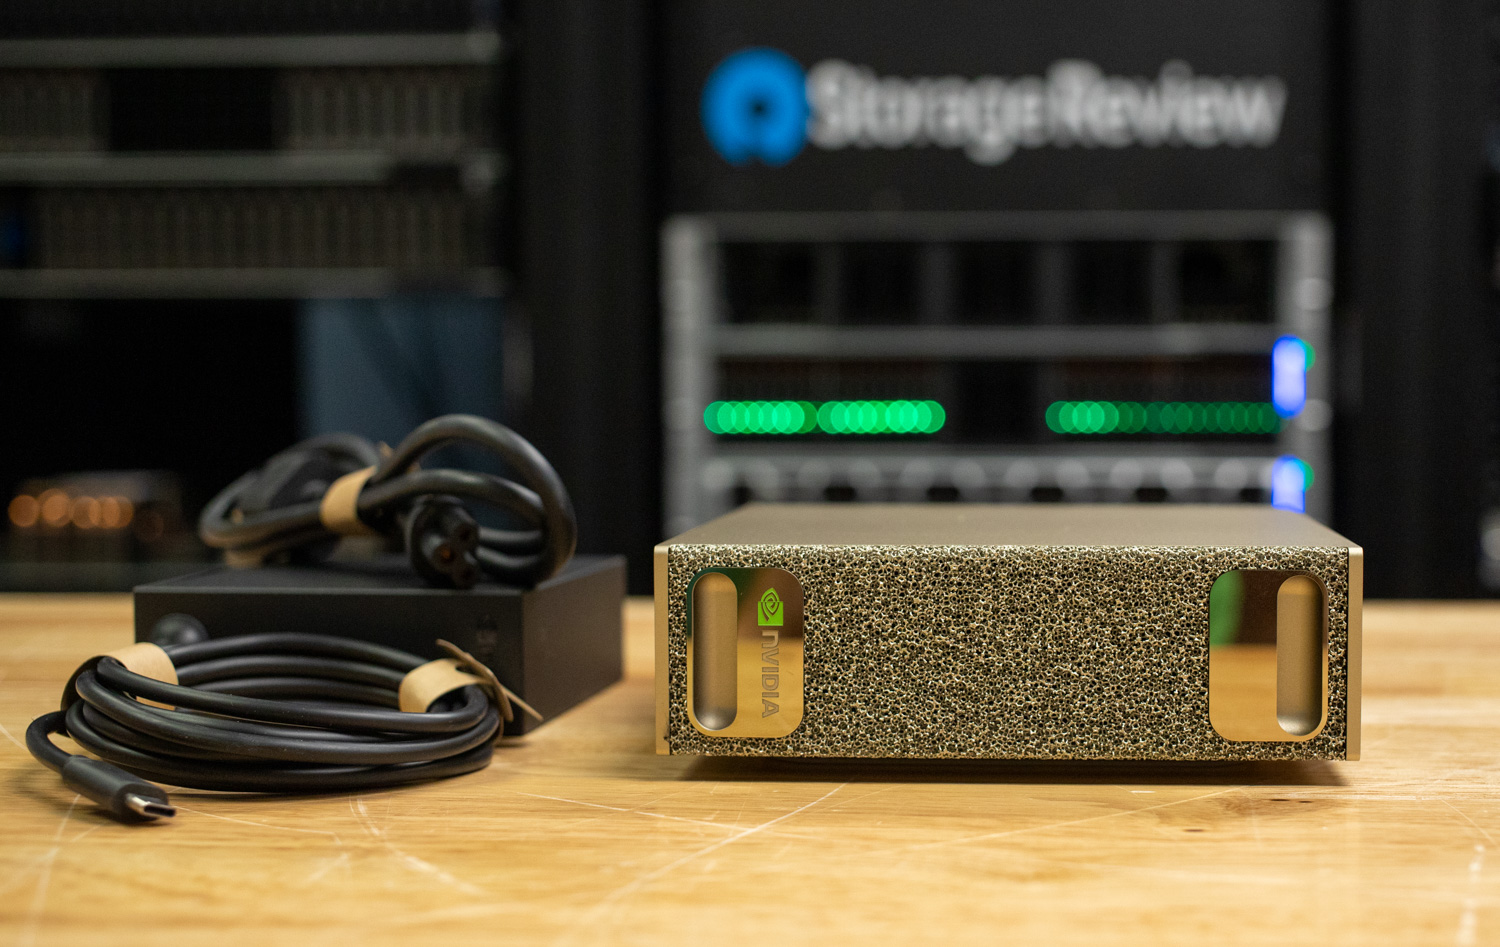
ပုံထဲက အဓိကယူနစ်ဘေးမှာ မြင်တွေ့ရတဲ့ 240 W USB-C external power brick က ပါဝါကို ထောက်ပံ့ပေးပါတယ်။ ဒီ brick က သေးငယ်ပြီး ကောင်းမွန်စွာ တည်ဆောက်ထားပြီး AC input အတွက် standard C5 (cloverleaf) connector ကို အသုံးပြုထားကာ DGX Spark ရဲ့ သန့်ရှင်းပြီး ထိရောက်တဲ့ ဒီဇိုင်းနဲ့ ကိုက်ညီပါတယ်။
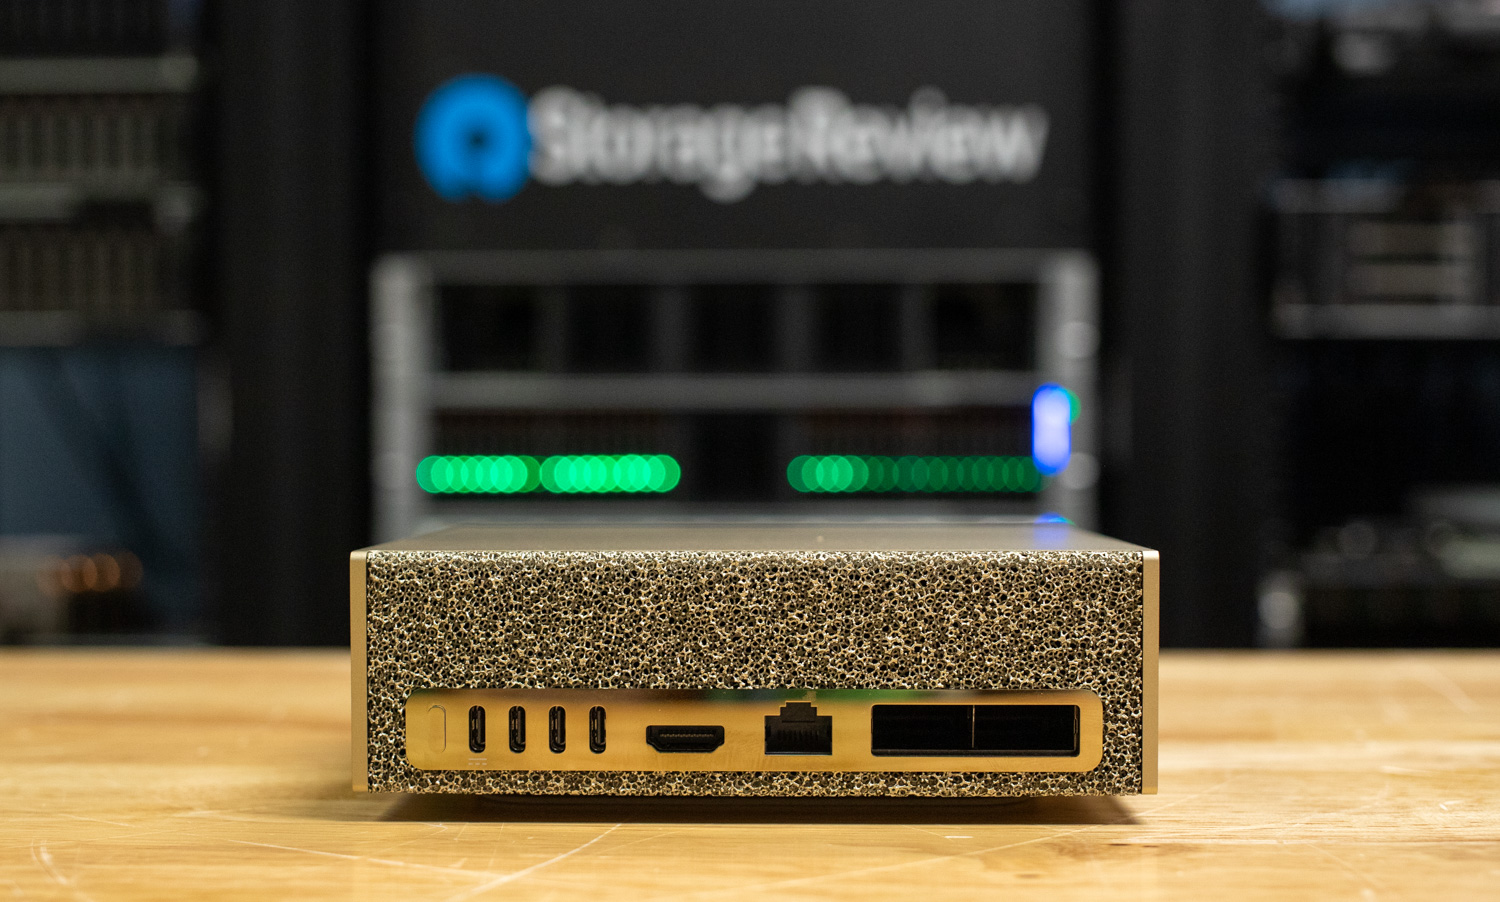
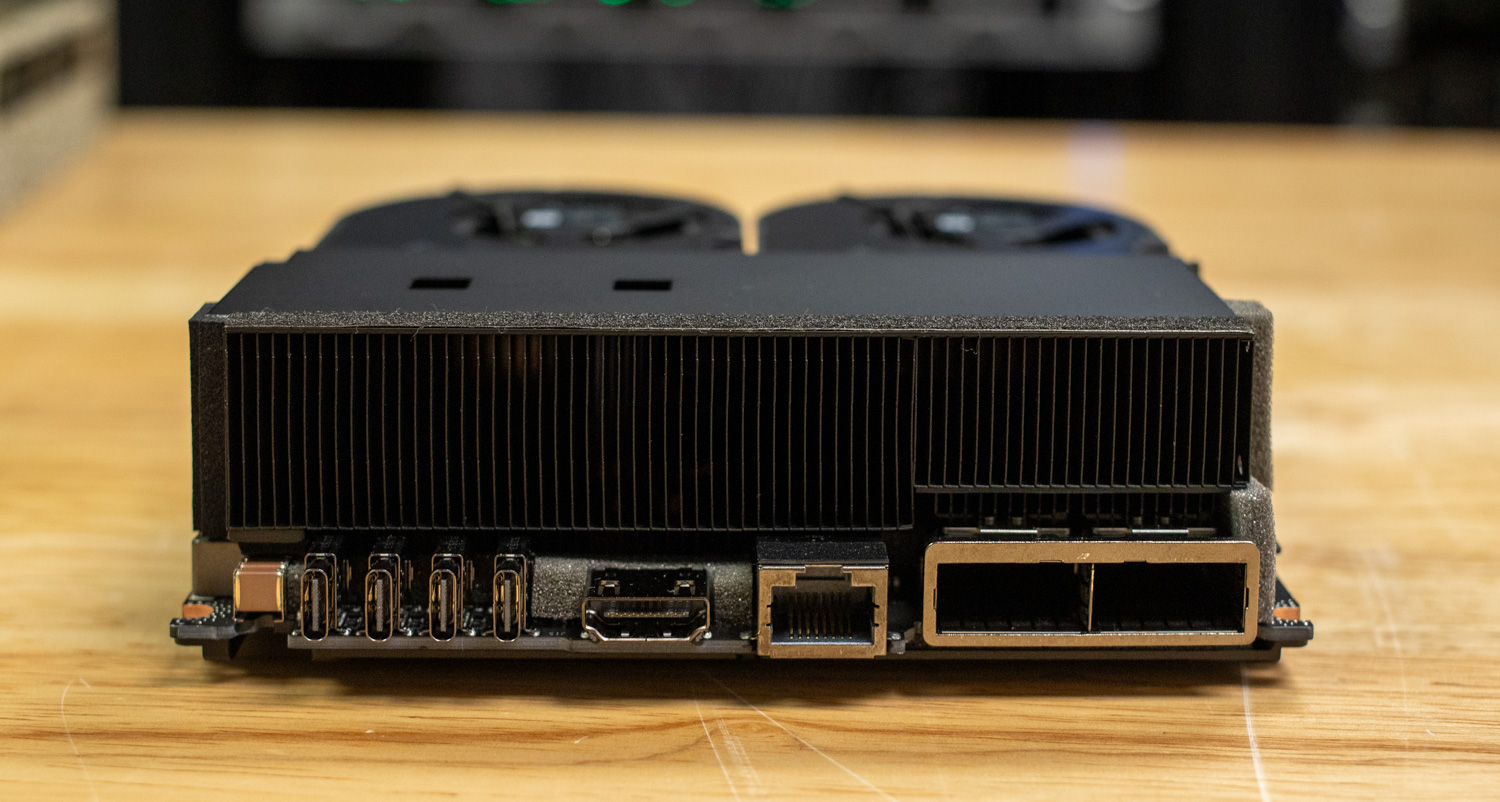
အနောက်ဘက်ကို လှည့်ကြည့်လိုက်ရင် DGX Spark ဟာ ရှေ့ဘက်မှာ မြင်တွေ့ရတဲ့ ရွှေရောင်အစက်အပြောက်တွေနဲ့ texture finish ကို ဆက်လက်အသုံးပြုထားပြီး chassis တစ်လျှောက်လုံးမှာ စည်းလုံးတဲ့ ဒီဇိုင်းကို ထိန်းသိမ်းထားပါတယ်။ ဘယ်ဘက်ကနေစပြီး power button က USB-C port လေးခုဘေးမှာ ရှိပြီး တစ်ခုကတော့ unit အတွက် Power Delivery ကို ပံ့ပိုးပေးပါတယ်။ ဒါတွေနောက်မှာ HDMI 2.1a output တစ်ခု၊ 10 GbE RJ-45 port တစ်ခု ပါဝင်ပြီး ဒီ unit ကို စိတ်ဝင်စားစရာကောင်းစေတာက integrated NVIDIA ConnectX-7 SmartNIC မှ မောင်းနှင်တဲ့ dual 200 GbE QSFP56 interfaces တွေပါ။
ပထမတစ်ချက်ကြည့်လိုက်ရင် Spark က 400G ချိတ်ဆက်မှုကို ခွင့်ပြုတယ်လို့ ကောက်ချက်ချနိုင်ပေမယ့် PCIe ကန့်သတ်ချက်တွေကြောင့် Spark က 200G ပဲ ချိတ်ဆက်နိုင်ပါတယ်။ ပိုသိချင်ရင်တော့ Spark ရဲ့ topology ကို ပိုနက်နက်ရှိုင်းရှိုင်း လေ့လာကြည့်ရအောင်။
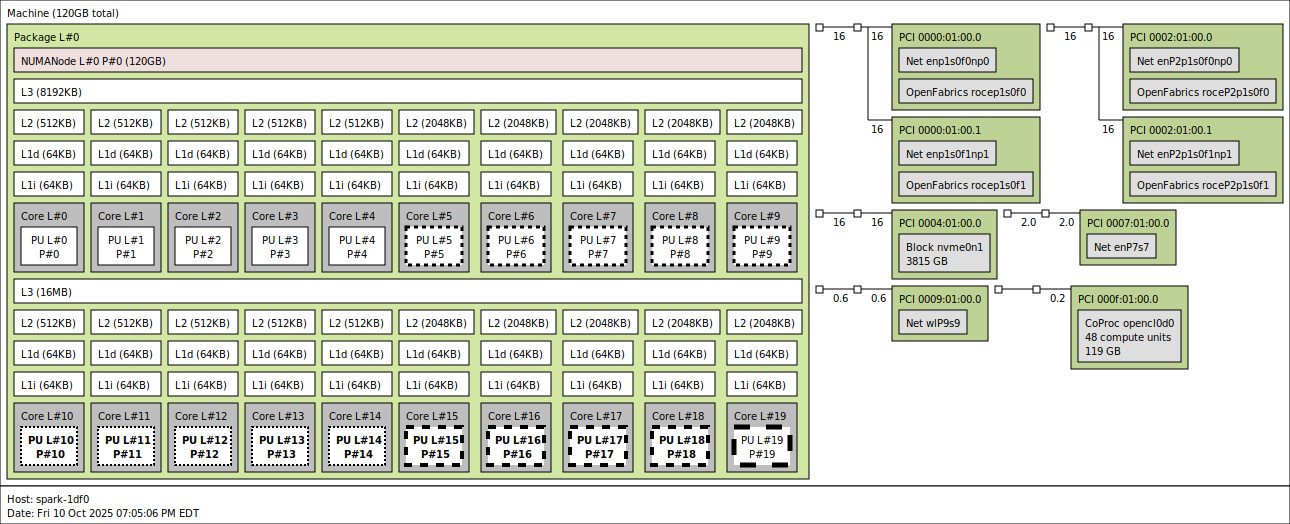
lstopo ကို အသုံးပြုပြီး CX7 NIC မှ ချိတ်ဆက်မှုနှစ်ခုကို ကျွန်ုပ်တို့ တွေ့ရှိရပါသည်။ လျှပ်စစ်အားဖြင့် CX7 ကို Gen5 x4 လင့်ခ်နှစ်ခုမှတစ်ဆင့် ချိတ်ဆက်ထားသည်။ OS အတွင်းတွင် ဤချိတ်ဆက်မှုများသည် interface လေးခုအဖြစ် ပေါ်လာပြီး တစ်ခုစီသည် အများဆုံး bandwidth 200G ကို ပံ့ပိုးပေးသည်။ စမ်းသပ်မှုအချိန် အကန့်အသတ်ရှိသောကြောင့် ဆောင်းပါးတွင် နောက်ပိုင်းတွင် အသေးစိတ်ဖော်ပြထားသည့် ကျွန်ုပ်တို့၏ NVMe-oF စမ်းသပ်မှုများမှအပ ဤ platform ၏ ကွန်ရက်ဆိုင်ရာ ထူးခြားချက်အားလုံးကို ကျွန်ုပ်တို့ မတွေ့ရှိနိုင်ပါ။ သို့သော် ဤ platform ကို ပိုမိုလေ့လာရန် စီစဉ်ထားပြီး ၎င်း၏စွမ်းရည်များကို ပိုမိုနက်ရှိုင်းစွာ လေ့လာသည့် အနာဂတ်ဆောင်းပါးများကို ထုတ်ပြန်ပါမည်။ ဥပမာအားဖြင့် spark များစွာကို mini cluster တစ်ခုအတွက် အတူတကွ clustering လုပ်ခြင်းကဲ့သို့ပင်။
ချိတ်ဆက်ထားတဲ့ တခြား device တွေကို ကြည့်လိုက်ရင် နောက်တစ်ခုကတော့ Gen5 x4 နဲ့ ချိတ်ဆက်ထားတဲ့ သေးငယ်တဲ့ 2242 form factor M.2 SSD ဖြစ်ပြီး နောက်မှာ PCIe Gen4 x1 link နဲ့ ချိတ်ဆက်ထားတဲ့ Realtek RJ45 10GbE controller နဲ့ PCIe Gen3 x1 link နဲ့ ချိတ်ဆက်ထားတဲ့ MediaTek Wi-Fi Controller တို့ ဖြစ်ပါတယ်။
CPU ထဲကို နက်နက်ရှိုင်းရှိုင်း ဝင်ကြည့်ရင် Spark မှာ Intel ရဲ့ နောက်ဆုံးပေါ် processor တွေနဲ့ ဆင်တူတဲ့ ကွဲပြားတဲ့ big little architecture ရှိတဲ့ 20-core Arm processor ပါဝင်ပြီး L3 cache cluster နှစ်ခုမှာ ပိုင်းခြားထားတဲ့ Cortex-A725 efficiency core ၁၀ ခုနဲ့ Cortex-X925 performance core ၁၀ ခု ပါဝင်ပါတယ်။ ပထမ cluster (8MB L3) မှာ CPU 0-4 (Cortex-A725, max 2808 MHz) နဲ့ CPU 5-9 (Cortex-X925, max 3900 MHz) ပါဝင်ပြီး ဒုတိယ cluster (16MB L3) မှာ CPU 10-14 (Cortex-A725, max 2860 MHz) နဲ့ CPU 15-19 (Cortex-X925, max 3978-4004 MHz) တွေ ပါဝင်ပါတယ်။ core တစ်ခုစီတွင် သီးသန့် 64KB L1 data နှင့် 64KB L1 instruction cache များပါရှိသော်လည်း L2 cache သည် core အမျိုးအစားအလိုက် သိသိသာသာကွာခြားပါသည်- စွမ်းဆောင်ရည် Cortex-A725 cores များတွင် 512KB L2 cache များရှိပြီး စွမ်းဆောင်ရည် Cortex-X925 cores များတွင် သိသိသာသာပိုကြီးသော 2MB L2 cache များ (၄ ဆပိုကြီးသည်) ရှိသည်။ အမြန်ဆုံး core များမှာ CPU 15-19 ဖြစ်ပြီး 16MB L3 cache ပိုကြီးသောနှင့် မြင့်မားသောကြိမ်နှုန်းများ နှစ်မျိုးလုံးမှ အကျိုးကျေးဇူးရရှိကာ CPU 19 သည် 4004 MHz တွင် အမြင့်ဆုံးစွမ်းဆောင်ရည် core ဖြစ်သည်။ ဤကွဲပြားသော power/frequency အဆင့်များကို အထက်တွင်ပြထားသည့် topology ရှိ core ပေါ်ရှိ အစက်ချမျဉ်းများဖြင့် ဖော်ပြထားသည်။
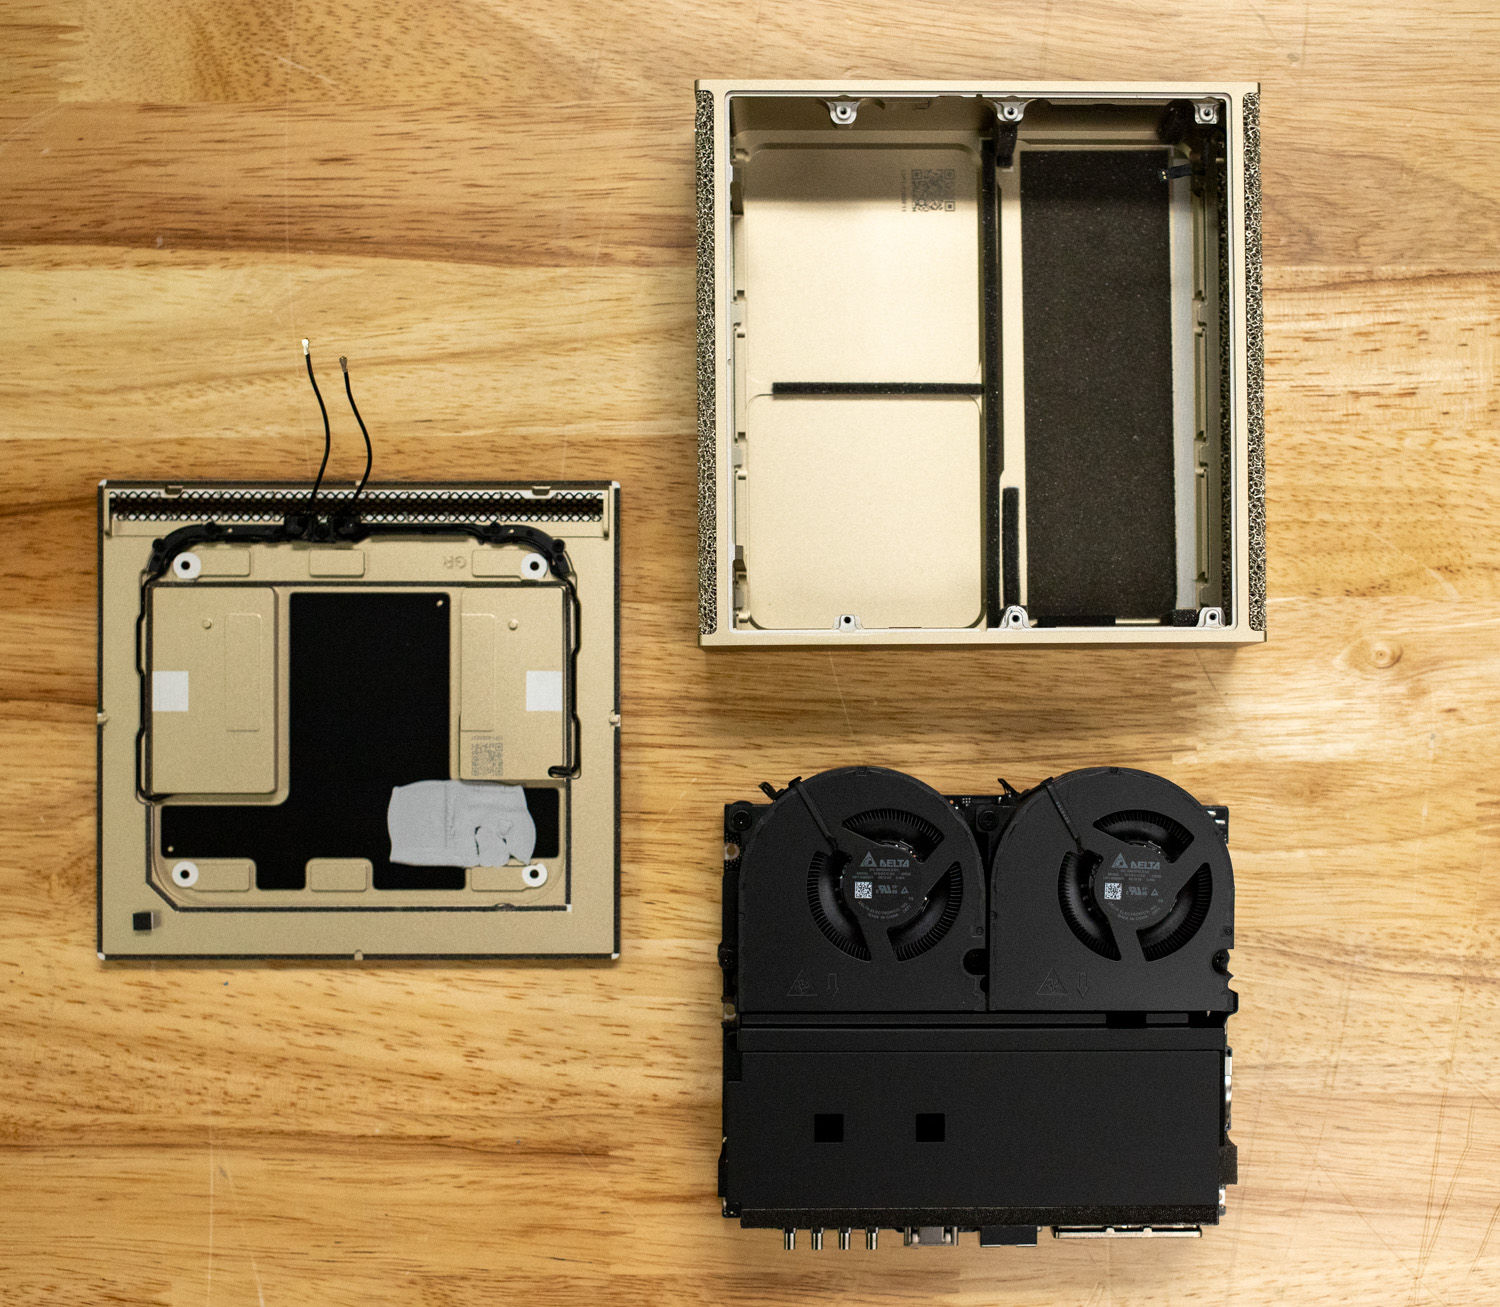
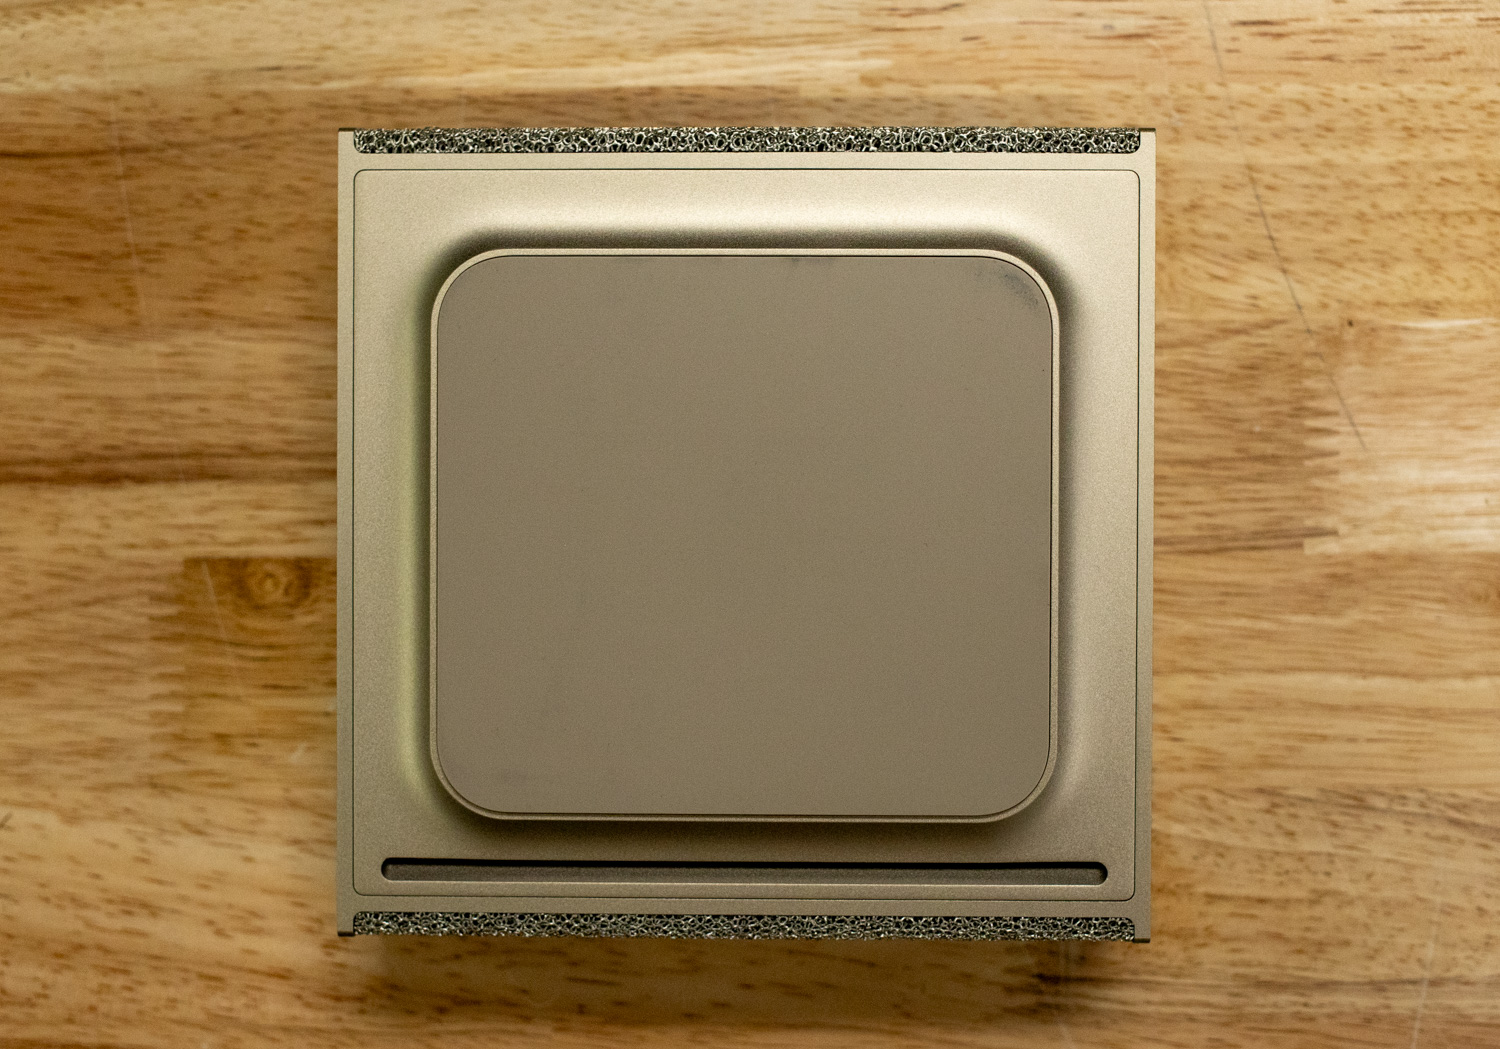
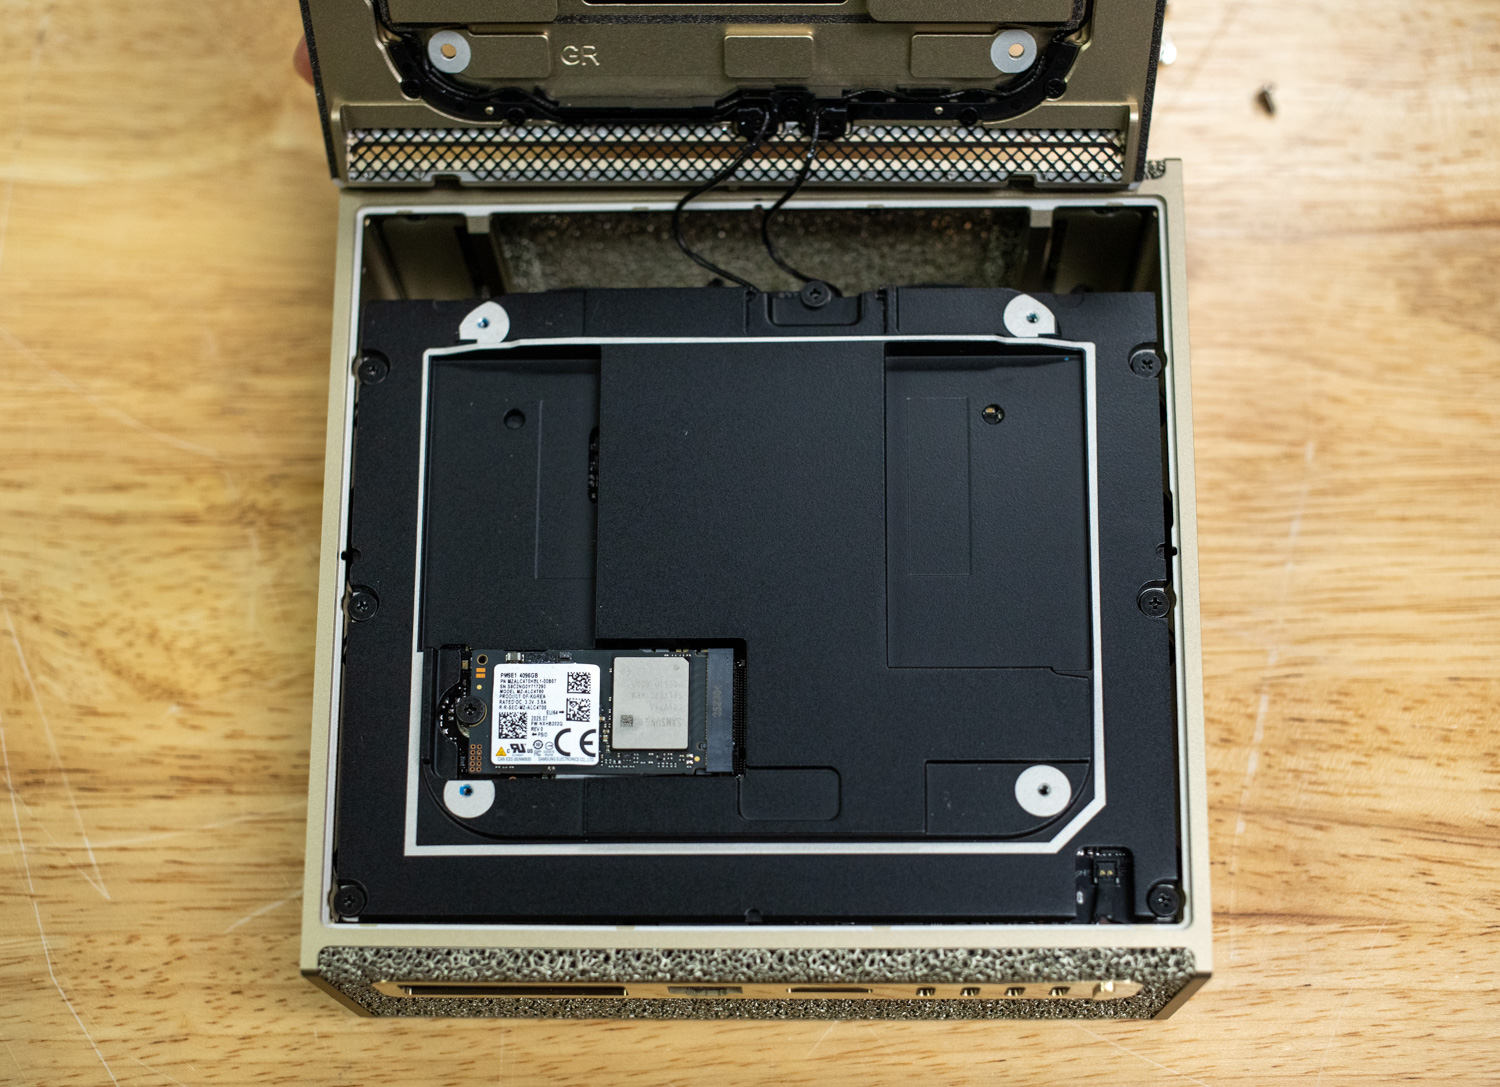
ပြန်ကြည့်မယ်ဆိုရင် DGX Spark ကို လှန်ကြည့်လိုက်ရင် မြင်သာတဲ့ ပလတ်စတစ်အစိတ်အပိုင်းတစ်ခုတည်းကတော့ အောက်ခြေအဖုံးဖြစ်ပြီး သံလိုက်နဲ့ တွဲထားပါတယ်။ ဒီဒီဇိုင်းက အတွင်းပိုင်းပစ္စည်းတွေကို မြန်မြန်ဆန်ဆန် အသုံးပြုနိုင်အောင် အပြင်ဘက်ကို သန့်ရှင်းနေစေပါတယ်။ သံလိုက်အောက်ခံကို ဖြုတ်လိုက်တာနဲ့ ဝက်အူလေးချောင်း ပေါ်လာပြီး အတွင်းပိုင်းအကန့်ကို ဝင်ရောက်နိုင်ပါတယ်။
အတွင်းပိုင်းမှာ ယူနစ်ရဲ့အပေါ်ပိုင်းကို အင်တင်နာဝါယာကြိုးတွေ သွယ်တန်းထားတာကို မြင်တွေ့ရပြီး Wi-Fi 7 နဲ့ Bluetooth 5.3 ချိတ်ဆက်မှုတွေ ပါဝင်တာကို အတည်ပြုပေးပါတယ်။ ဒါက ပြောင်းလွယ်ပြင်လွယ်ရှိတဲ့ ကွန်ရက်ရွေးချယ်မှုတွေကို ပေးစွမ်းနိုင်ပြီး အထူးသဖြင့် ဝါယာကြိုးချိတ်ဆက်မှု မရှိနိုင်တဲ့ မိုဘိုင်း ဒါမှမဟုတ် ဓာတ်ခွဲခန်း ဖြန့်ကျက်မှုများအတွက် အသုံးဝင်ပါတယ်။
ထို့အပြင် ယူနစ်၏ သိုလှောင်မှုဖြေရှင်းချက်ဖြစ်သည့် PCIe Gen5 2242 M.2 SSD သည် မြင်သာပြီး ၎င်းသည် ထိုကဲ့သို့သော မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော ဟာ့ဒ်ဝဲများအတွက် အသုံးနည်းသော ပုံစံတစ်ခုဖြစ်သည်။ ဤနေရာတွင်ပြထားသော ဖွဲ့စည်းမှုတွင် ကျွန်ုပ်တို့၏ ဖွဲ့စည်းမှုတွင် 4TB Samsung NVMe drive ပါဝင်သည်။
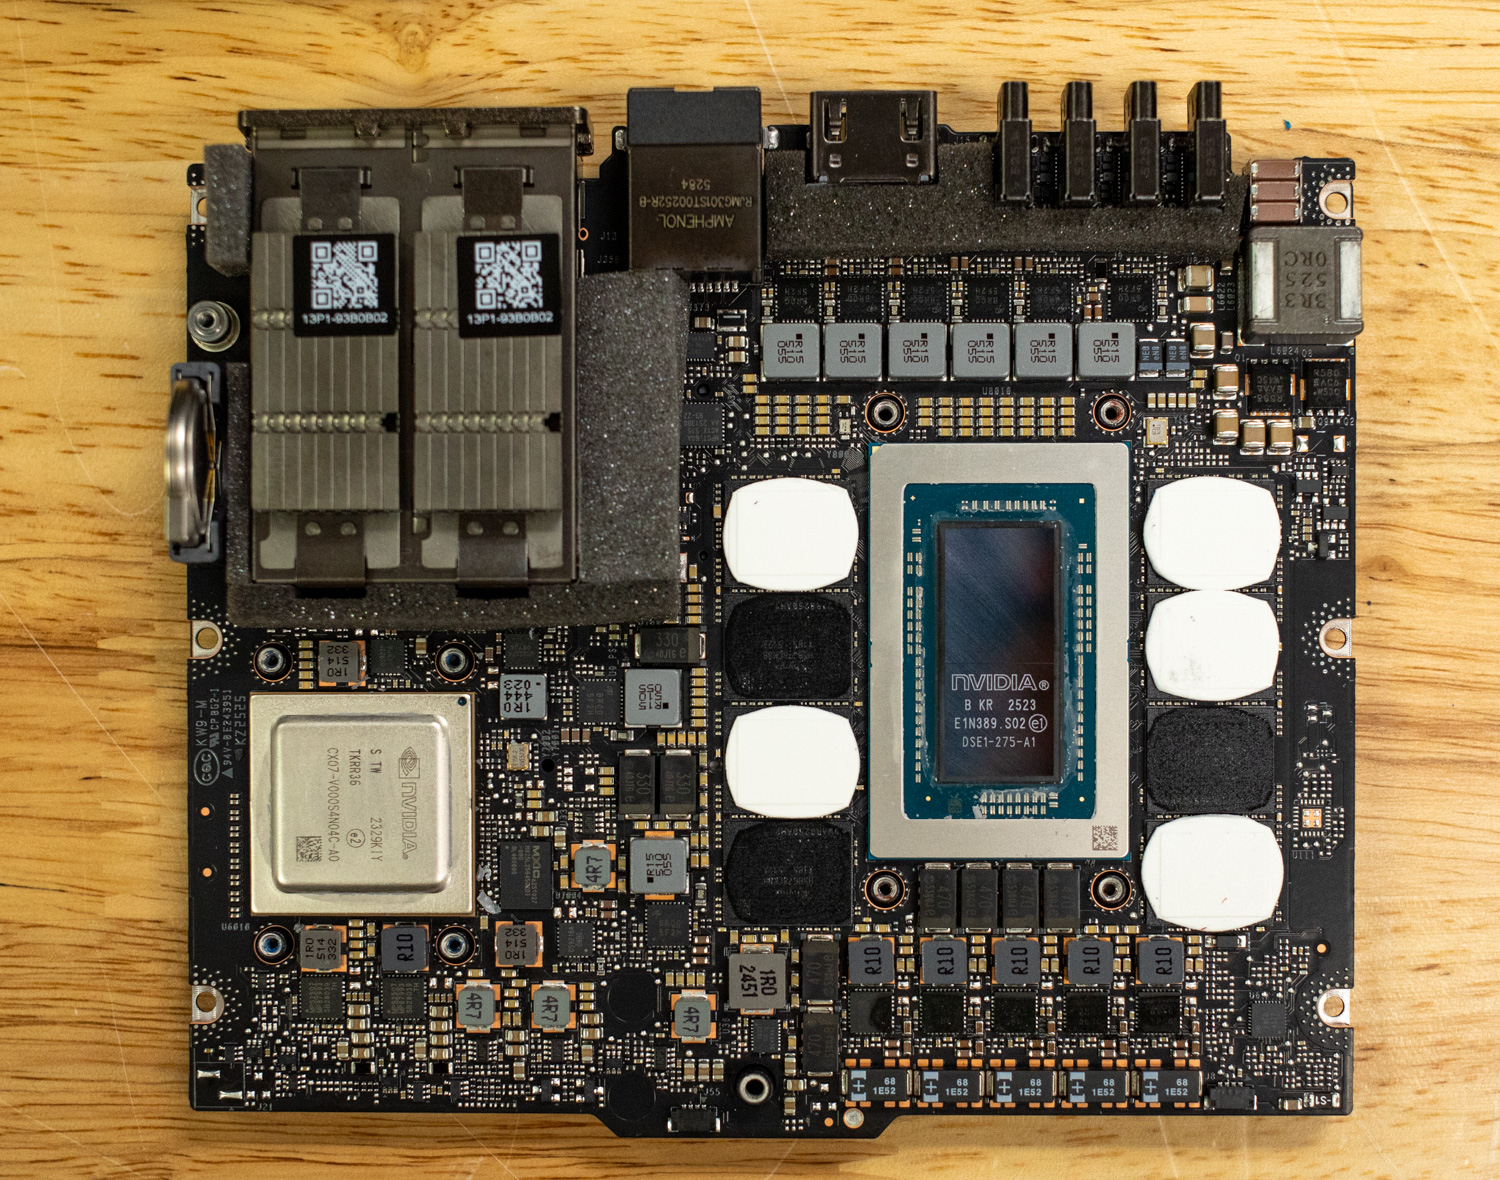
DGX Spark ကို ပိုမိုနက်ရှိုင်းစွာ လေ့လာကြည့်လျှင် စနစ်၏ အဓိကအချက်ဖြစ်သော NVIDIA Grace Blackwell ၏ GB10 Superchip ကို တွေ့ရှိရမည်ဖြစ်သည်။ GB10 Superchip ကို ဘေးတစ်ဖက်တစ်ချက်စီတွင် ဂဟေဆက်ထားသော LPDDR5X ပေါင်းစပ်စနစ်မှတ်ဉာဏ် ၈ ခုရှိပြီး bandwidth 273 GB/s ပေးစွမ်းနိုင်သောကြောင့် CPU နှင့် GPU လုပ်ဆောင်ချက်နှစ်ခုလုံးတွင် ဒေတာများကို မြန်ဆန်စွာ ဝင်ရောက်အသုံးပြုနိုင်စေပါသည်။
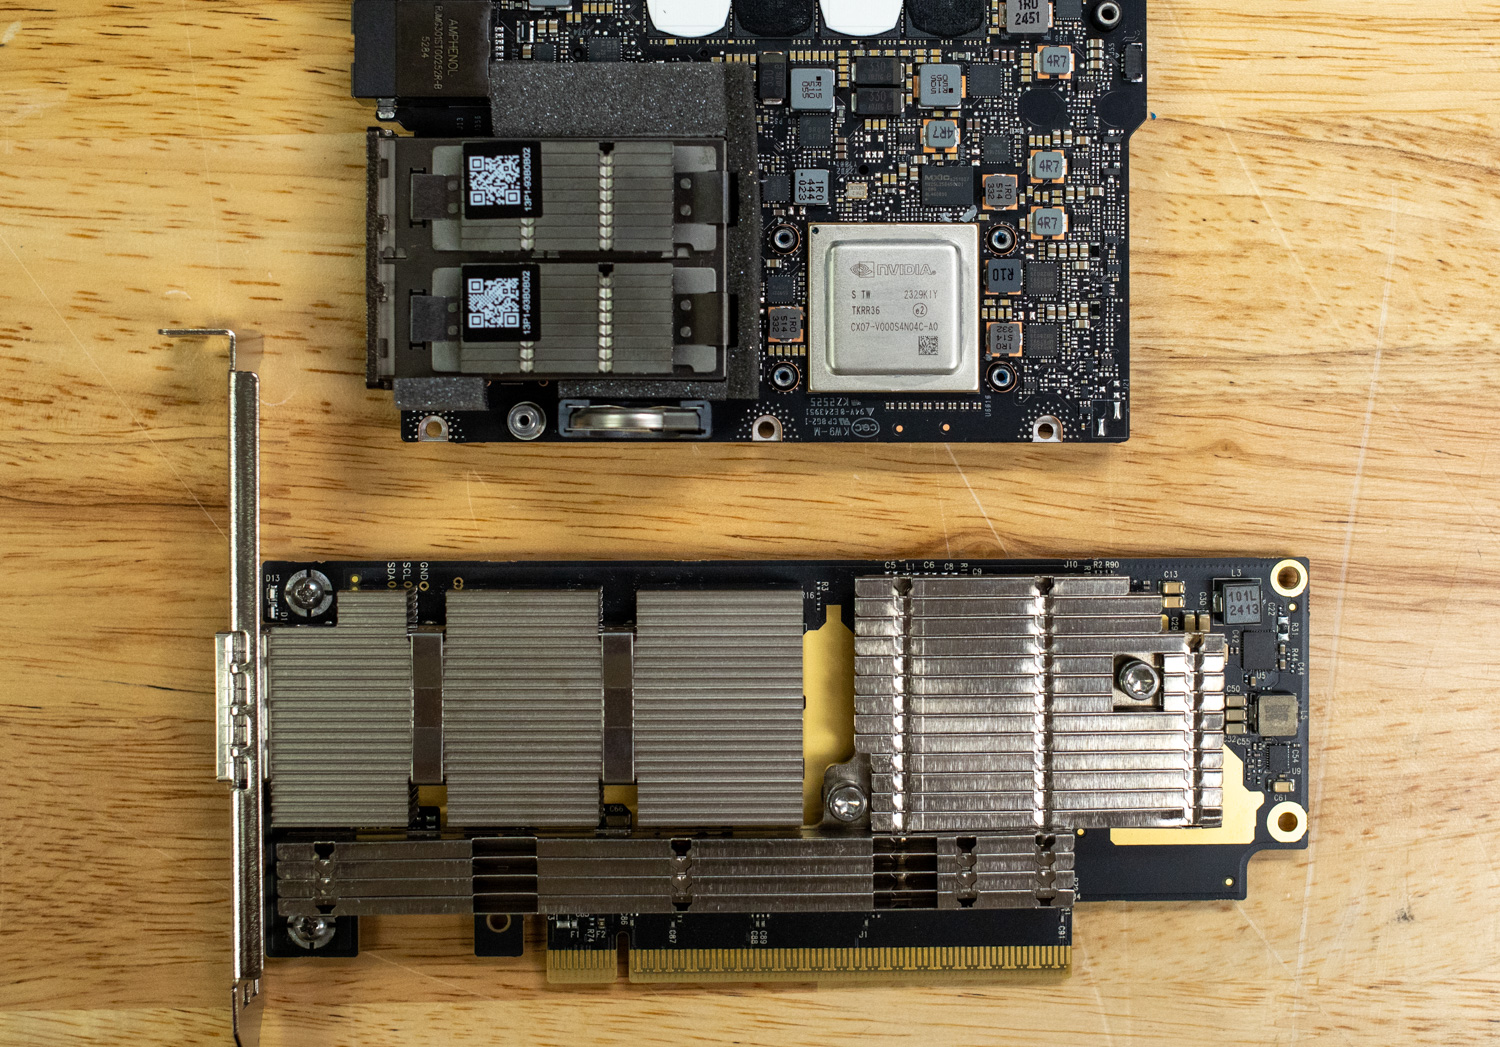
ချစ်ပ်ဘေးမှာ CX7 NIC ရှိပြီး အရင်ကဖော်ပြခဲ့သလိုပဲ 200G ချိတ်ဆက်မှုကို ပေးစွမ်းပါတယ်။ ဒါက အသုံးပြုသူတွေအတွက် Spark ကို မြန်နှုန်းမြင့်သိုလှောင်မှုနဲ့ ချိတ်ဆက်နိုင်သလို Spark ရဲ့ instance အများအပြားကို cluster တစ်ခုတည်းမှာတောင် ချိတ်ဆက်နိုင်ပါတယ်။ NVIDIA က ပိုကြီးတဲ့ AI မော်ဒယ်တွေကိုတောင် ပံ့ပိုးပေးဖို့ တိုက်ရိုက်ချိတ်ဆက်နိုင်တဲ့ Spark ၂ ခုပါဝင်တဲ့ cluster တစ်ခုကို အတည်ပြုပြီး ရောင်းချခဲ့ပါတယ်။
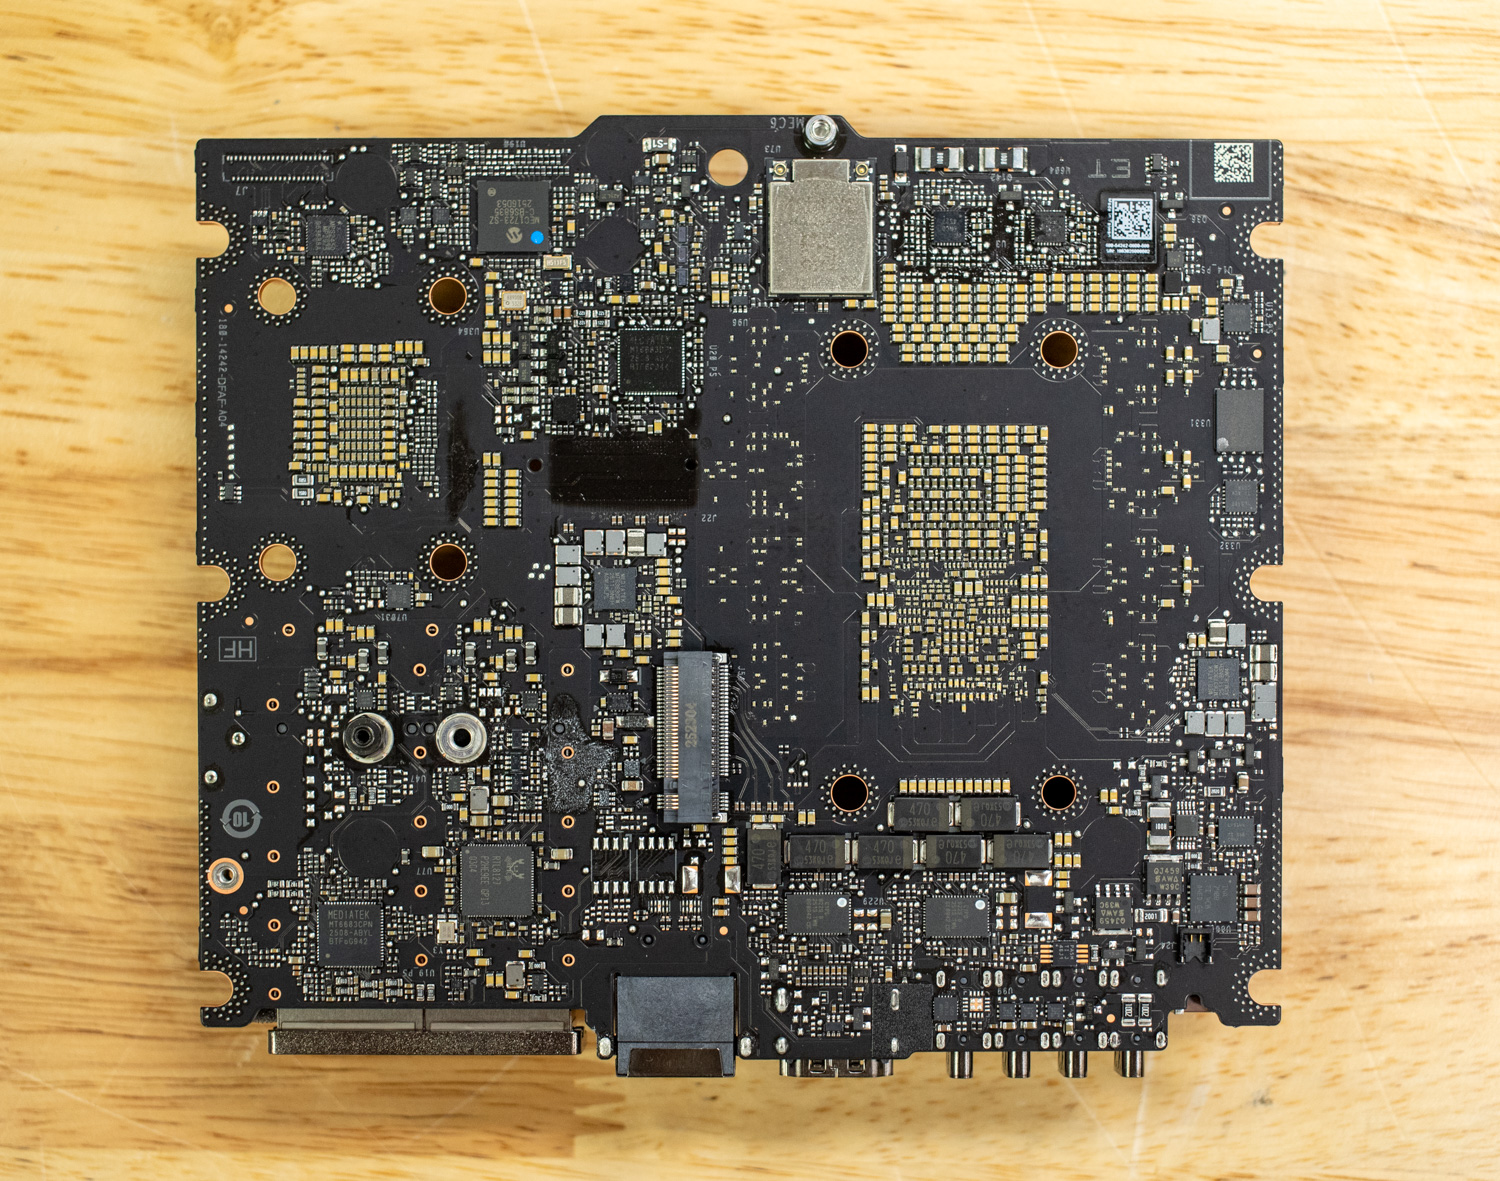
နောက်ဆုံးအနေနဲ့ ဘုတ်ကို လှန်ကြည့်လိုက်ရင် PCIe Gen5 x4 2242 M.2 SSD နဲ့ PCIe Gen3x1 MediaTek Wi-Fi adapter အပါအဝင် PCIe ချိတ်ဆက်မှုအားလုံးကို တွေ့ရမှာပါ။
Spark သည် မရှိမဖြစ်လိုအပ်သောနေရာဖြစ်လာသည့်နေရာ- ခေတ်မီ AI ဖွံ့ဖြိုးတိုးတက်ရေးပစ္စည်း
DGX Spark သည် မတူညီသော ပရော်ဖက်ရှင်နယ် အခြေအနေများစွာတွင် အထူးဆွဲဆောင်မှုရှိကြောင်း သက်သေပြနေပြီး တစ်ခုချင်းစီတွင် ပေါင်းစည်းထားသော မှတ်ဉာဏ်၊ ကျစ်လစ်သော ပုံစံနှင့် ပြည့်စုံသော ဆော့ဖ်ဝဲလ် ပေါင်းစပ်မှုတို့၏ ထူးခြားသော ပေါင်းစပ်မှုမှ အကျိုးကျေးဇူးများ ရရှိထားသည်။
ဒေတာသိပ္ပံအရှိန်မြှင့်တင်မှု- ပန်ဒါများမှ ထုတ်လုပ်မှုအထိ
ဒေတာသိပ္ပံပညာရှင်များအတွက် NVIDIA DGX Spark သည် workflow velocity နှင့် အတွေ့အကြုံတွင် ကြီးမားသောတိုးတက်မှုကို ကိုယ်စားပြုသည်။ 200 Gbps bandwidth ကို ပေးဆောင်သည့် ConnectX-7 networking သည် CUDA X accelerated libraries များနှင့် ပေါင်းစပ်ထားပြီး data preprocessing ကို ပြောင်းလဲပေးသည်။ AI နှင့် Data Science တို့ကို ကောင်းမွန်သော data များထည့်သွင်းခြင်း၊ ကောင်းမွန်သော data များထုတ်ယူခြင်း၏ အခြေခံပေါ်တွင် တည်ဆောက်ထားသည်။ ရိုးရာအစဉ်အလာအရ၊ မည်သည့်ရိုးရာ ML ပရောဂျက်၏ အချိန်အကြာဆုံးအဆင့်မှာ data cleaning နှင့် feature extraction ဖြစ်သည်။ ရိုးရာ workflow များတွင် dataset များကို pandas ကဲ့သို့သော tools များထဲသို့ load လုပ်ခြင်းနှင့် CPU cores များတွင် transformation များလုပ်ဆောင်ခြင်းတို့ ပါဝင်လေ့ရှိပြီး ယေဘုယျအားဖြင့် နှေးကွေးသည်။ Manual exploration နှင့် feature engineering တို့သည်လည်း သိသာထင်ရှားသော blocker တစ်ခု ဖြစ်နိုင်သည်။ Spark သည် RAPIDS မှတစ်ဆင့် end-to-end GPU acceleration ကို ဖွင့်ပေးသည်။
ပုံမှန် enterprise data science scenario တစ်ခုမှာ 40-80GB အတိုင်းအတာရှိတဲ့ dataset တွေမှာ feature engineering ပါဝင်ပါတယ်- table အများအပြားကို ပေါင်းစပ်ခြင်း၊ temporal window များတစ်လျှောက် aggregation များကို တွက်ချက်ခြင်း၊ categorical encoding ကို ကိုင်တွယ်ခြင်းနှင့် distributions များကို normalizing လုပ်ခြင်းတို့ ပါဝင်ပါတယ်။ CPU infrastructure မှာဆိုရင် ဒီ preprocessing က နာရီပေါင်းများစွာ ကြာနိုင်ပါတယ်။ RAPIDS cuDF က dataset တစ်ခုလုံးကို Spark ရဲ့ 128 GB unified memory ထဲကို load လုပ်တဲ့အခါ ဒီလုပ်ဆောင်ချက်တွေဟာ 10× ဒါမှမဟုတ် ပိုမြင့်တဲ့ acceleration မှာ မိနစ်ပိုင်းအတွင်း ပြီးမြောက်ပါတယ်။ နောက်ဆက်တွဲ model training က cuML ပါတဲ့ classical ML ဖြစ်စေ၊ PyTorch နဲ့ deep learning ဖြစ်စေ အကျိုးကျေးဇူးတူညီစွာ ရရှိပြီး data scientists တွေက hypotheses တွေကို iterate လုပ်မယ့်အစား infrastructure ကို စောင့်ဆိုင်းရတဲ့ ရိုးရာ bottleneck ကို ဖယ်ရှားပေးပါတယ်။
ပေါင်းစပ်ဒေတာထုတ်လုပ်ခြင်း- ရိုဘော့တစ်နှင့် သရုပ်သကန်ဖန်တီးမှု
စတုတ္ထမျိုးဆက် RT Cores ပါဝင်ခြင်းက Spark ကို ပေါ်ထွက်လာတဲ့ workflow တစ်ခုအတွက် ထူးခြားစွာ နေရာချထားပေးပါတယ်- ကမ္ဘာ့မော်ဒယ်လေ့ကျင့်မှုအတွက် synthetic data generation။ ခိုင်မာတဲ့ manipulation မူဝါဒတွေကို လေ့ကျင့်ဖို့ ရိုးရာအစဉ်အလာအရ လက်တွေ့ကမ္ဘာ သရုပ်ပြမှု သောင်းနဲ့ချီပြီး လိုအပ်ပြီး ကုန်ကျစရိတ်များပြီး အချိန်ကုန်ပါတယ်။ Isaac Sim သို့မဟုတ် Omniverse ကဲ့သို့သော platform များတွင် Photorealistic simulation သည် အခြားရွေးချယ်စရာတစ်ခုကို ပေးစွမ်းနိုင်သော်လည်း ရုပ်ပိုင်းဆိုင်ရာ တိကျသော အလင်းရောင်၊ ရောင်ပြန်ဟပ်မှုနှင့် ပစ္စည်းများဖြင့် ray-traced imagery ကို rendering လုပ်ခြင်းသည် NVIDIA ၏ L40S နှင့် RTX 6000 Ada ကဲ့သို့သော စျေးကြီးသော workstation GPU များကို ရှေးယခင်ကတည်းက လိုအပ်ခဲ့ပါတယ်။
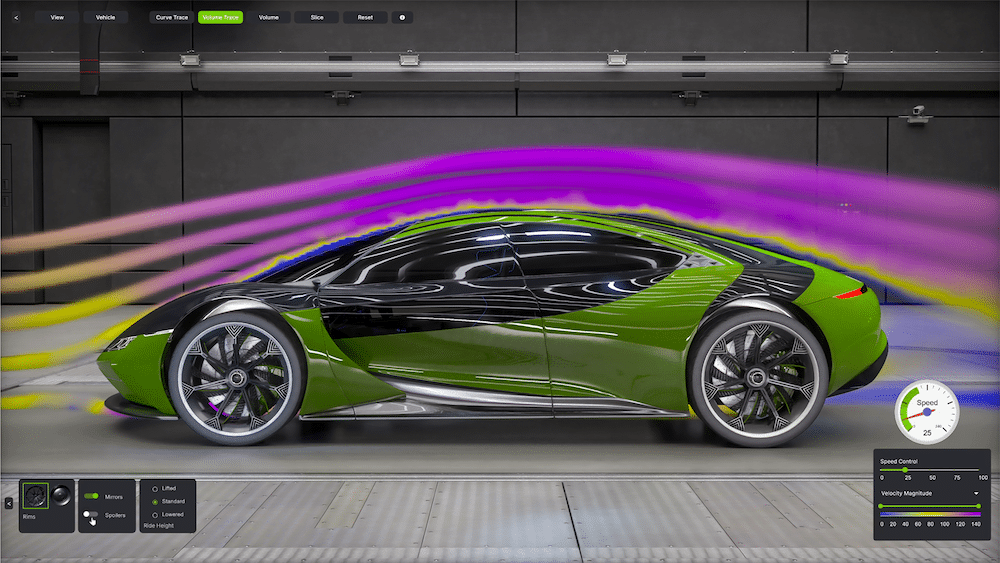
အရင်းအမြစ်: NVIDIA
Spark က ဒီ workflow ကို ပေါင်းစည်းပေးပါတယ်။ RT Cores က OpenUSD workloads တွေကို synthetic data generation ကို ကိုင်တွယ်နိုင်စေပြီး Tensor Cores တွေကို blueprint/workflow မှာ AI inference အတွက် အသုံးပြုပါတယ်။ အရင်က အဖွဲ့အစည်းတွေဟာ rendering အတွက် စက်အများအပြားနဲ့ သီးခြား inference-optimized server တစ်ခုကို ဖြန့်ကျက်အသုံးပြုကြပါတယ်။ အခုတော့ ဒါကို 240W appliance တစ်ခုတည်းမှာ ရရှိနိုင်ပါတယ်။ robotics startups တွေ၊ တက္ကသိုလ်ဓာတ်ခွဲခန်းတွေ ဒါမှမဟုတ် autonomous manipulation ကို စူးစမ်းလေ့လာနေတဲ့ automotive ထုတ်လုပ်သူတွေအတွက် ဒီပေါင်းစပ်မှုက ဖွံ့ဖြိုးတိုးတက်မှုအချိန်ဇယားနဲ့ အရင်းအနှီးအသုံးစရိတ်ကို သိသိသာသာ လျှော့ချပေးပါတယ်။
NVIDIA L40S ၏ ကျွန်ုပ်တို့၏ အစောပိုင်းလွှမ်းခြုံမှုတွင် ကောက်ချက်ချရန်အတွက် H100 နှင့် တွဲဖက်ထားသော သီးသန့် L40S rendering စနစ်များကို အသုံးပြု၍ အလားတူ synthetic data generation pipelines များကို ယခင်က ကျွန်ုပ်တို့ စူးစမ်းလေ့လာခဲ့ပါသည် ။ ဤစွမ်းရည်များကို ပေါင်းစည်းထားသော ဖွံ့ဖြိုးတိုးတက်ရေးကိရိယာတစ်ခုအဖြစ် GB10 ၏ ဗိသုကာပေါင်းစပ်မှုသည် ဤ workflow ၏ ဆွဲဆောင်မှုရှိသော တိုးတက်ပြောင်းလဲမှုကို ကိုယ်စားပြုပါသည်။ ကိုယ်စားပြု robotics ကိုင်တွယ်မှုအခြေအနေများအတွက် rendering နှင့် အခြား workloads များကို စစ်ဆေးခြင်း၊ လာမည့်ခွဲခြမ်းစိတ်ဖြာမှုတွင် ဤ discrete configurations များနှင့် နှိုင်းယှဉ်၍ Spark ၏ RT Core စွမ်းဆောင်ရည်ကို နောက်ထပ်စမ်းသပ်မှုများ ပြုလုပ်ရန် ကျွန်ုပ်တို့ စီစဉ်ထားပါသည်။
Vibe Coding တော်လှန်ရေး
Tesla ရဲ့ AI ဒါရိုက်တာဟောင်းနဲ့ OpenAI ရဲ့ တည်ထောင်သူအဖွဲ့ဝင်ဟောင်း Andrej Karpathy ဟာ AI အကူအညီနဲ့ software ဖွံ့ဖြိုးတိုးတက်ရေးအတွက် အလျင်အမြန်ချဉ်းကပ်မှုတစ်ခုကို ဖော်ပြဖို့ “vibe coding” ဆိုတဲ့ အသုံးအနှုန်းကို တီထွင်ခဲ့ပါတယ်။ ကုဒ်တွေကို တစ်ကြောင်းချင်းစီ သေချာစွာရေးသားမယ့်အစား vibe coding ဟာ LLM တွေကို interactive pair programmer တွေအနေနဲ့ အသုံးပြုပါတယ်- natural language နဲ့ functionality ကို ဖော်ပြခြင်း၊ implementation scaffolding ကို ဖန်တီးခြင်း၊ conversational refinement မှတစ်ဆင့် iterate လုပ်ခြင်းနဲ့ feature တွေကို မြန်မြန်ဆန်ဆန် prototype လုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ခြင်းတွေ ပြုလုပ်ပြီး တစ်ဦးချင်း developer တွေကို အလွန်ခေတ်မီတဲ့ စနစ်တွေကို မကြုံစဖူး အမြန်နှုန်းနဲ့ တည်ဆောက်နိုင်အောင် ပြုလုပ်ပေးပါတယ်။
AI-assisted coding လက်ခံအသုံးပြုမှုပမာဏကို OpenRouter ၏ အသုံးပြုမှုအဆင့်သတ်မှတ်ချက်များ က သက်သေပြ နေပြီး coding-focused model များသည် inference volume ကို အဆက်မပြတ်လွှမ်းမိုးထားသည်။ အဓိက vibe coding လူဦးရေဖြစ်သည့် နည်းပညာပိုင်းဆိုင်ရာကျွမ်းကျင်ပညာရှင်များသည် power user များအဖြစ် ပုံမှန်အားဖြင့် လုပ်ဆောင်ကြပြီး coding agent များစွာကို မတူညီသော context များတွင် တစ်ပြိုင်နက်တည်း လုပ်ဆောင်ကြသည်။ open-weight model များသည် key benchmark များတွင် proprietary alternatives များနှင့် ပိုမိုကိုက်ညီလာသည်နှင့်အမျှ developer များသည် rate ကန့်သတ်ချက်များကို ဖယ်ရှားရန်၊ အရေးကြီးသော development window များအတွင်း ရရှိနိုင်မှုကို သေချာစေရန်နှင့် proprietary project များအတွက် code လျှို့ဝှက်ချက်ကို ထိန်းသိမ်းရန် ဒေသတွင်း inference ဖြန့်ကျက်မှုများကို စူးစမ်းလေ့လာနေကြသည် ။
r/LocalLLaMA အသိုင်းအဝိုင်းသည် multi-GPU workstation များမှသည် local model များကို လည်ပတ်သည့် duct-taped-together server များ၊ consumer hardware များတစ်လျှောက် distributed inference နှင့် စဉ်ဆက်မပြတ် high-throughput generation ကိုဖြစ်ပေါ်စေသည့် ရှုပ်ထွေးသော cooling solution များအထိ အထင်ကြီးလောက်သော custom build များကို ပြသထားသည်။ သို့သော် ဤ configuration များသည် သိသာထင်ရှားသော အတားအဆီးများကို ဖြစ်ပေါ်စေသည်- အရင်းအနှီးအသုံးစရိတ်သည် ဒေါ်လာထောင်ပေါင်းများစွာထက် မကြာခဏကျော်လွန်ခြင်း၊ ပါဝါသုံးစွဲမှုများပြားခြင်း၊ စံရုံးပတ်ဝန်းကျင်များအစား သီးသန့်နေရာများလိုအပ်သော thermal management စိန်ခေါ်မှုများနှင့် configuration၊ optimization နှင့် troubleshooting အတွက် သိသာထင်ရှားသော နည်းပညာကျွမ်းကျင်မှုတို့ဖြစ်သည်။
Spark သည် ဤတန်ဖိုးအဆိုပြုချက်ကို အခြေခံအားဖြင့် ပြောင်းလဲစေပါသည်။ 128 GB unified memory ပါရှိသော $3,999 ဖြင့် ၎င်းသည် တိတ်ဆိတ်ငြိမ်သက်သော၊ ကျစ်လစ်သိပ်သည်းသော၊ ပါဝါသက်သာသော 240W သာ အသုံးပြုသည့် စက်ပစ္စည်းတွင် အထင်ကြီးလောက်သော မော်ဒယ် ကောက်ချက်စွမ်းဆောင်ရည်ကို ပေးစွမ်းပါသည်။ ဒေသတွင်း coding assistant အခြေခံအဆောက်အအုံကို တည်ဆောက်လိုသော အသုံးပြုသူများသည် ကီလိုဝပ်နာရီ စားသုံးပြီး အပူအထွက်များစွာ ထုတ်လုပ်ပေးသည့် ရှုပ်ထွေးသော homelab များ မလိုအပ်တော့ပါ။ ကြိုတင်ပြင်ဆင်ထားသော DGX OS ပါရှိသော အတည်ပြုထားသော စက်ပစ္စည်းချဉ်းကပ်မှုသည် ယခင်က ဒေသတွင်း LLM ဖြန့်ကျက်မှုကို Linux နှင့် CUDA အတွေ့အကြုံရှိသော အသုံးပြုသူများအတွက်သာ ကန့်သတ်ထားသည့် configuration ရှုပ်ထွေးမှုကို ဖယ်ရှားပေးပါသည်။
အခြေခံအဆောက်အအုံ ပွတ်တိုက်မှုများကို ဖယ်ရှားခြင်းအပြင်၊ Spark သည် ကုဒ်လုံခြုံရေးနှင့် မော်ဒယ်စိတ်ကြိုက်ပြင်ဆင်ခြင်းဆိုင်ရာ အရေးကြီးသော စိုးရိမ်မှုများကို ဖြေရှင်းပေးပါသည်။ cloud-based coding assistants များသည် source code ကို remote server များထံ ပေးပို့ရန် လိုအပ်ပြီး ၎င်းသည် proprietary algorithms၊ security-critical infrastructure သို့မဟုတ် regulated data များကို ကိုင်တွယ်သော အဖွဲ့အစည်းများအတွက် non-starter ဖြစ်သည်။ Spark ပေါ်ရှိ local inference သည် ကုဒ်သည် development environment မှ ဘယ်တော့မှ မထွက်ခွာကြောင်း သေချာစေသည်။ ထို့အပြင်၊ 128 GB memory capacity သည် coding model များ၏ full parameter fine-tuning ကို ဖွင့်ပေးပြီး အတွေ့အကြုံရှိ developer များအား internal codebases များပေါ်ရှိ မော်ဒယ်များကို အထူးပြုနိုင်စေပါသည်။ ဤစွမ်းရည်သည် domain-specific languages၊ custom frameworks သို့မဟုတ် public training data တွင် မလုံလောက်စွာ ကိုယ်စားပြုထားသော architectural patterns များရှိသော အဖွဲ့အစည်းများအတွက် အထူးတန်ဖိုးရှိပါသည်။
DGX Spark မှာ NVIDIA NeMo နဲ့ အသေးစိတ်ညှိယူခြင်း
DGX Spark ရဲ့ 128 GB unified memory က ရိုးရာအားဖြင့် ဈေးကြီးတဲ့ multi-GPU cloud setup တွေ လိုအပ်တဲ့ 8B မော်ဒယ်တွေရဲ့ full parameter fine-tuning ကို လုပ်ဆောင်ပေးနိုင်ပါတယ်။ standard Adam optimization ပါတဲ့ Qwen3 8B ဟာ dual H100 80 GB configuration တွေထက် ကျော်လွန်ပြီး 132 GB (16 GB model weights, 96 GB optimizer states, 16 GB gradients, plus activations) ခန့် လိုအပ်ပြီး မှတ်ဉာဏ်ထိရောက်မှုရှိတဲ့ 8-bit Adam ကို အသုံးပြုခြင်းက batch size ပေါ်မူတည်ပြီး လိုအပ်ချက်တွေကို 70 GB လောက်အထိ လျှော့ချပေးပြီး Spark ရဲ့ memory pool ထဲမှာ အဆင်ပြေပြေ တပ်ဆင်နိုင်ပါတယ်။ ရှုပ်ထွေးတဲ့ ကျိုးကြောင်းဆင်ခြင်ခြင်းဆိုင်ရာ အလုပ်တွေမှာ LoRA ထက် full fine-tuning က 4-6% ပိုကောင်းတဲ့ တိကျမှုကို ပေးစွမ်းနိုင်တာကြောင့် ဒါက အရေးကြီးပါတယ်။ cloud-based 2× H100 80 GB setup တွေဟာ distributed training complexity နဲ့ တစ်နာရီကို $5 လောက် ကုန်ကျပေမယ့် Spark က single-system training ကို $3,999 ရင်းနှီးမြှုပ်နှံမှုနဲ့ တစ်ကြိမ်တည်း $3,999 ပေးရပါတယ်။
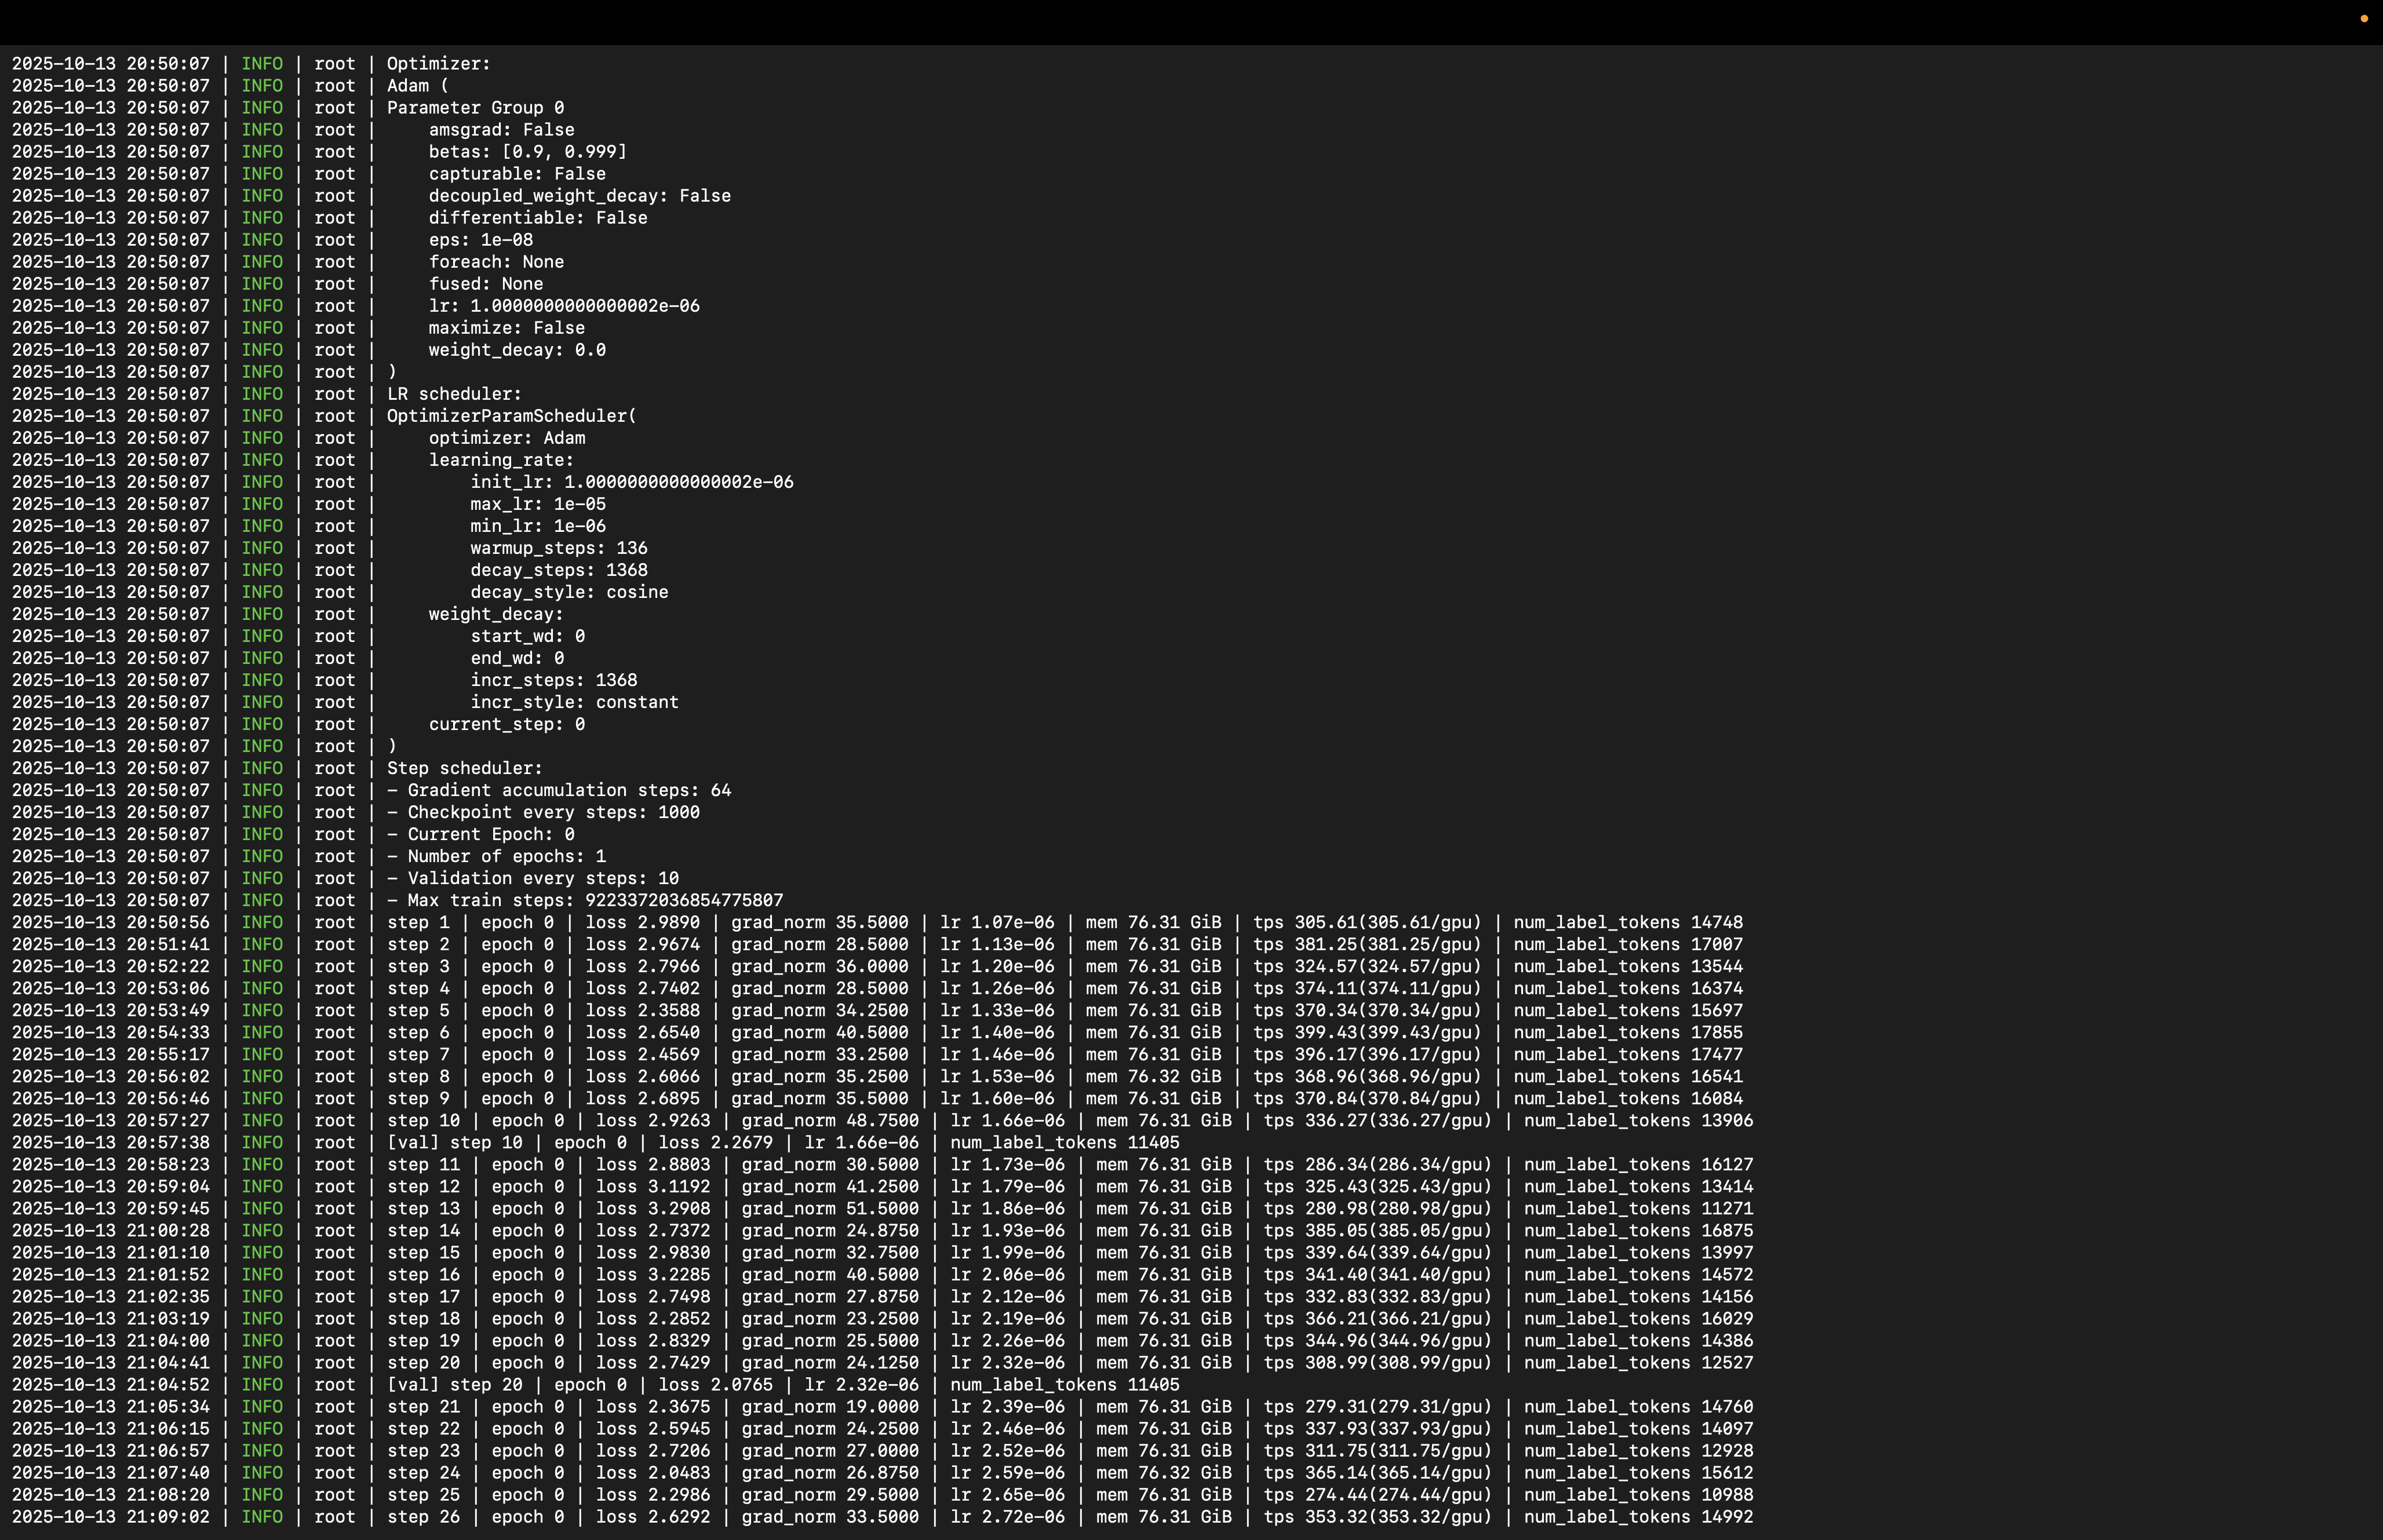
NVIDIA NeMo Automodel သည် checkpoint conversion မပါဘဲ မည်သည့် Hugging Face model အတွက်မဆို Day-0 support ပေးခြင်းဖြင့် enterprise training framework friction ကို ဖယ်ရှားပေးပါသည်။ HuggingFace Hub မှ Qwen3 8B ကို တိုက်ရိုက် load လုပ်ပြီး dataset sources၊ optimizer settings နှင့် LoRA targets များကို သတ်မှတ်သည့် YAML files များမှတစ်ဆင့် fine-tuning ကို configure လုပ်ပါ။ NeMo သည် safetensors compatibility ဖြင့် distributed checkpointing ကို အလိုအလျောက်လုပ်ဆောင်ပြီး 2-5× speedups အတွက် fused CUDA kernels များကို implement လုပ်ကာ gradient accumulation ကို ကိုင်တွယ်ပါသည်။
Comfy UI ဖြင့် ရုပ်ပုံထုတ်လုပ်ခြင်း
ComfyUI သည် Stable Diffusion နှင့် ဆက်စပ် diffusion model များကို အလွန်စိတ်ကြိုက်ပြင်ဆင်နိုင်သော creative pipeline များအဖြစ်သို့ ပြောင်းလဲပေးသည့် node-based graphical interface ကို ပံ့ပိုးပေးပါသည်။ ရိုးရှင်းသော parameter slider များနောက်ကွယ်ရှိ ရှုပ်ထွေးမှုများကို ပေါင်းစပ်ထားသော ရိုးရာ web-based interface များနှင့်မတူဘဲ၊ ComfyUI သည် အသုံးပြုသူများသည် discrete functional node များကို ချိတ်ဆက်ခြင်းဖြင့် workflow များကို တည်ဆောက်သည့် visual graph architecture ကို အသုံးပြုထားပြီး၊ ၎င်း node တစ်ခုချင်းစီသည် model loading၊ prompt encoding၊ latent diffusion sampling၊ VAE decoding သို့မဟုတ် upscaling transformations ကဲ့သို့သော သီးခြားလုပ်ဆောင်ချက်များကို ကိုယ်စားပြုသည်။ ဤ modular ဒီဇိုင်းသည် generation pipeline တစ်ခုလုံးကို granular control လုပ်နိုင်ပြီး computational step တိုင်းကို ပွင့်လင်းမြင်သာပြီး ချိန်ညှိနိုင်စေပါသည်။ ၎င်းသည် အသုံးပြုသူများအား model များစွာကို ချိတ်ဆက်ခြင်း၊ custom sampling schedule များကို အကောင်အထည်ဖော်ခြင်း သို့မဟုတ် ရိုးရှင်းသော interface များတွင် မဖြစ်နိုင်သော ControlNet လမ်းညွှန်မှုကဲ့သို့သော အဆင့်မြင့်နည်းပညာများကို ပေါင်းစပ်ခြင်းတို့ကိုလည်း ခွင့်ပြုပါသည်။
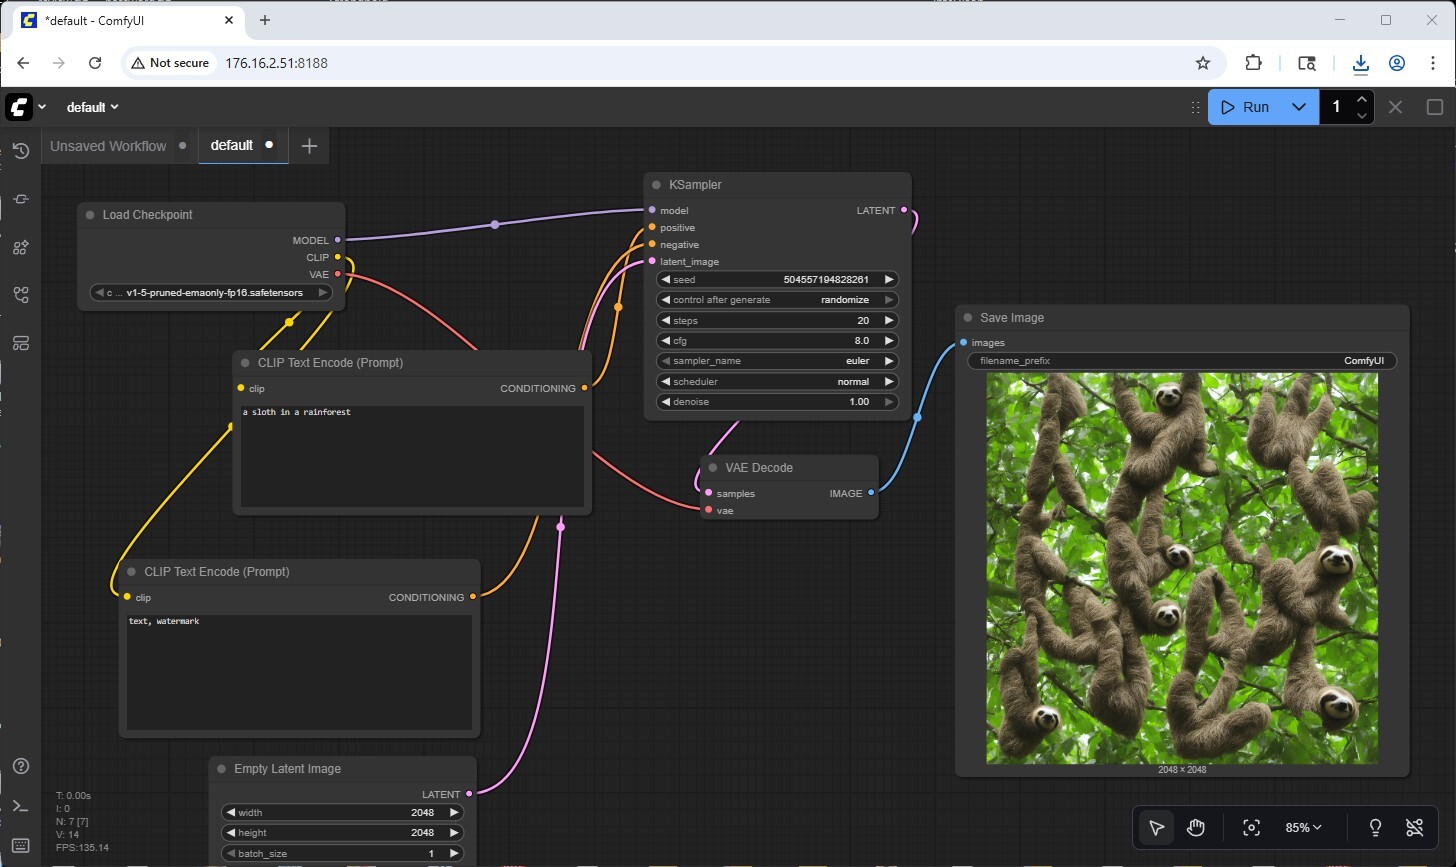
DGX Spark မှာ ComfyUI က Blackwell GPU ရဲ့ Tensor Cores ကို အသုံးပြုပြီး အရှိန်မြှင့် diffusion sampling အတွက် အသုံးပြုပါတယ်။ sampling complexity ပေါ်မူတည်ပြီး ၁၅ စက္ကန့်ကနေ ၃၀ စက္ကန့်အတွင်း generation တွေကို အပြီးသတ်ပါတယ်။ 128GB unified memory architecture က အထူးအကျိုးရှိပြီး checkpoint model တွေ၊ LoRA adapter တွေနဲ့ VAE decoders တွေကို တစ်ပြိုင်နက်တည်း memory ထဲမှာ ထိန်းသိမ်းထားတာကြောင့် VRAM-constrained system တွေကို ဒုက္ခပေးတဲ့ reload overhead ကို ဖယ်ရှားပေးပါတယ်။ အသုံးပြုသူတွေဟာ API rate limit တွေ၊ cloud cost တွေနဲ့ proprietary creative workflow တွေနဲ့ ဆက်စပ်နေတဲ့ privacy စိုးရိမ်မှုတွေကနေ ကင်းဝေးပြီး ဒေသတွင်းမှာ အကန့်အသတ်မရှိ AI artwork ကို ဖန်တီးနိုင်ပါတယ်။ workflow persistence model က operational value ကို ထပ်လောင်းပေးပါတယ်- complete pipelines တွေဟာ version-controlled လုပ်နိုင်တဲ့၊ team တွေကြားမှာ share လုပ်နိုင်တဲ့၊ ဒါမှမဟုတ် generated image တွေထဲကို metadata အနေနဲ့ တိုက်ရိုက် embed လုပ်နိုင်တဲ့ JSON files တွေအဖြစ် serialize လုပ်နိုင်ပြီး synthetic dataset pipelines တွေတည်ဆောက်တဲ့ အဖွဲ့အစည်းတွေအတွက် အရေးကြီးတဲ့ reproducibility ကို ဖြစ်စေပါတယ် ဒါမှမဟုတ် generated assets တွေတစ်လျှောက်မှာ တသမတ်တည်း အနုပညာပုံစံတွေကို ထိန်းသိမ်းပေးပါတယ်။
NVIDIA DGX Spark စွမ်းဆောင်ရည်စမ်းသပ်ခြင်း
vLLM အွန်လိုင်းဝန်ဆောင်မှု – LLM ကောက်ချက်စမ်းသပ်မှု
vLLM သည် LLM များအတွက် အလွန်ရေပန်းစားသော high-throughput inference နှင့် serving engine ဖြစ်သည်။ vLLM အွန်လိုင်း serving benchmark သည် concurrent request များကို ကိုင်တွယ်သည့်အခါ ဤ inference engine ၏ လက်တွေ့ကမ္ဘာ serving စွမ်းရည်များကို တိုင်းတာရန် ဒီဇိုင်းထုတ်ထားသော စွမ်းဆောင်ရည် အကဲဖြတ်ကိရိယာတစ်ခုဖြစ်သည်။ ၎င်းသည် request rate၊ input/output အရှည်များနှင့် concurrent client အရေအတွက်ကဲ့သို့သော configure လုပ်နိုင်သော parameter များဖြင့် လည်ပတ်နေသော vLLM server သို့ request များပေးပို့ခြင်းဖြင့် production workloads များကို simulate လုပ်သည်။ benchmark သည် throughput၊ ဆိုလိုသည်မှာ တစ်စက္ကန့်လျှင် tokens၊ ပထမဆုံး token သို့အချိန်နှင့် output token တစ်ခုလျှင်အချိန် အပါအဝင် အဓိက metrics များကို တိုင်းတာပြီး အသုံးပြုသူများ vLLM သည် မတူညီသော load condition များအောက်တွင် မည်သို့လုပ်ဆောင်သည်ကို နားလည်ရန် ကူညီပေးသည်။
ယနေ့ခေတ် ထုတ်လုပ်မှု ဖြန့်ကျက်မှုများတွင် အလွန်ရေပန်းစားသော ဗိသုကာလက်ရာများနှင့် မော်ဒယ်အမျိုးအစားများကို ကိုယ်စားပြုသည့် မော်ဒယ်အစုံတစ်လျှောက်တွင် inference စွမ်းဆောင်ရည်ကို ကျွန်ုပ်တို့ စမ်းသပ်ခဲ့ပါသည်။
ကျွမ်းကျင်သူ မော်ဒယ်များ ရောနှောပါဝင်မှု
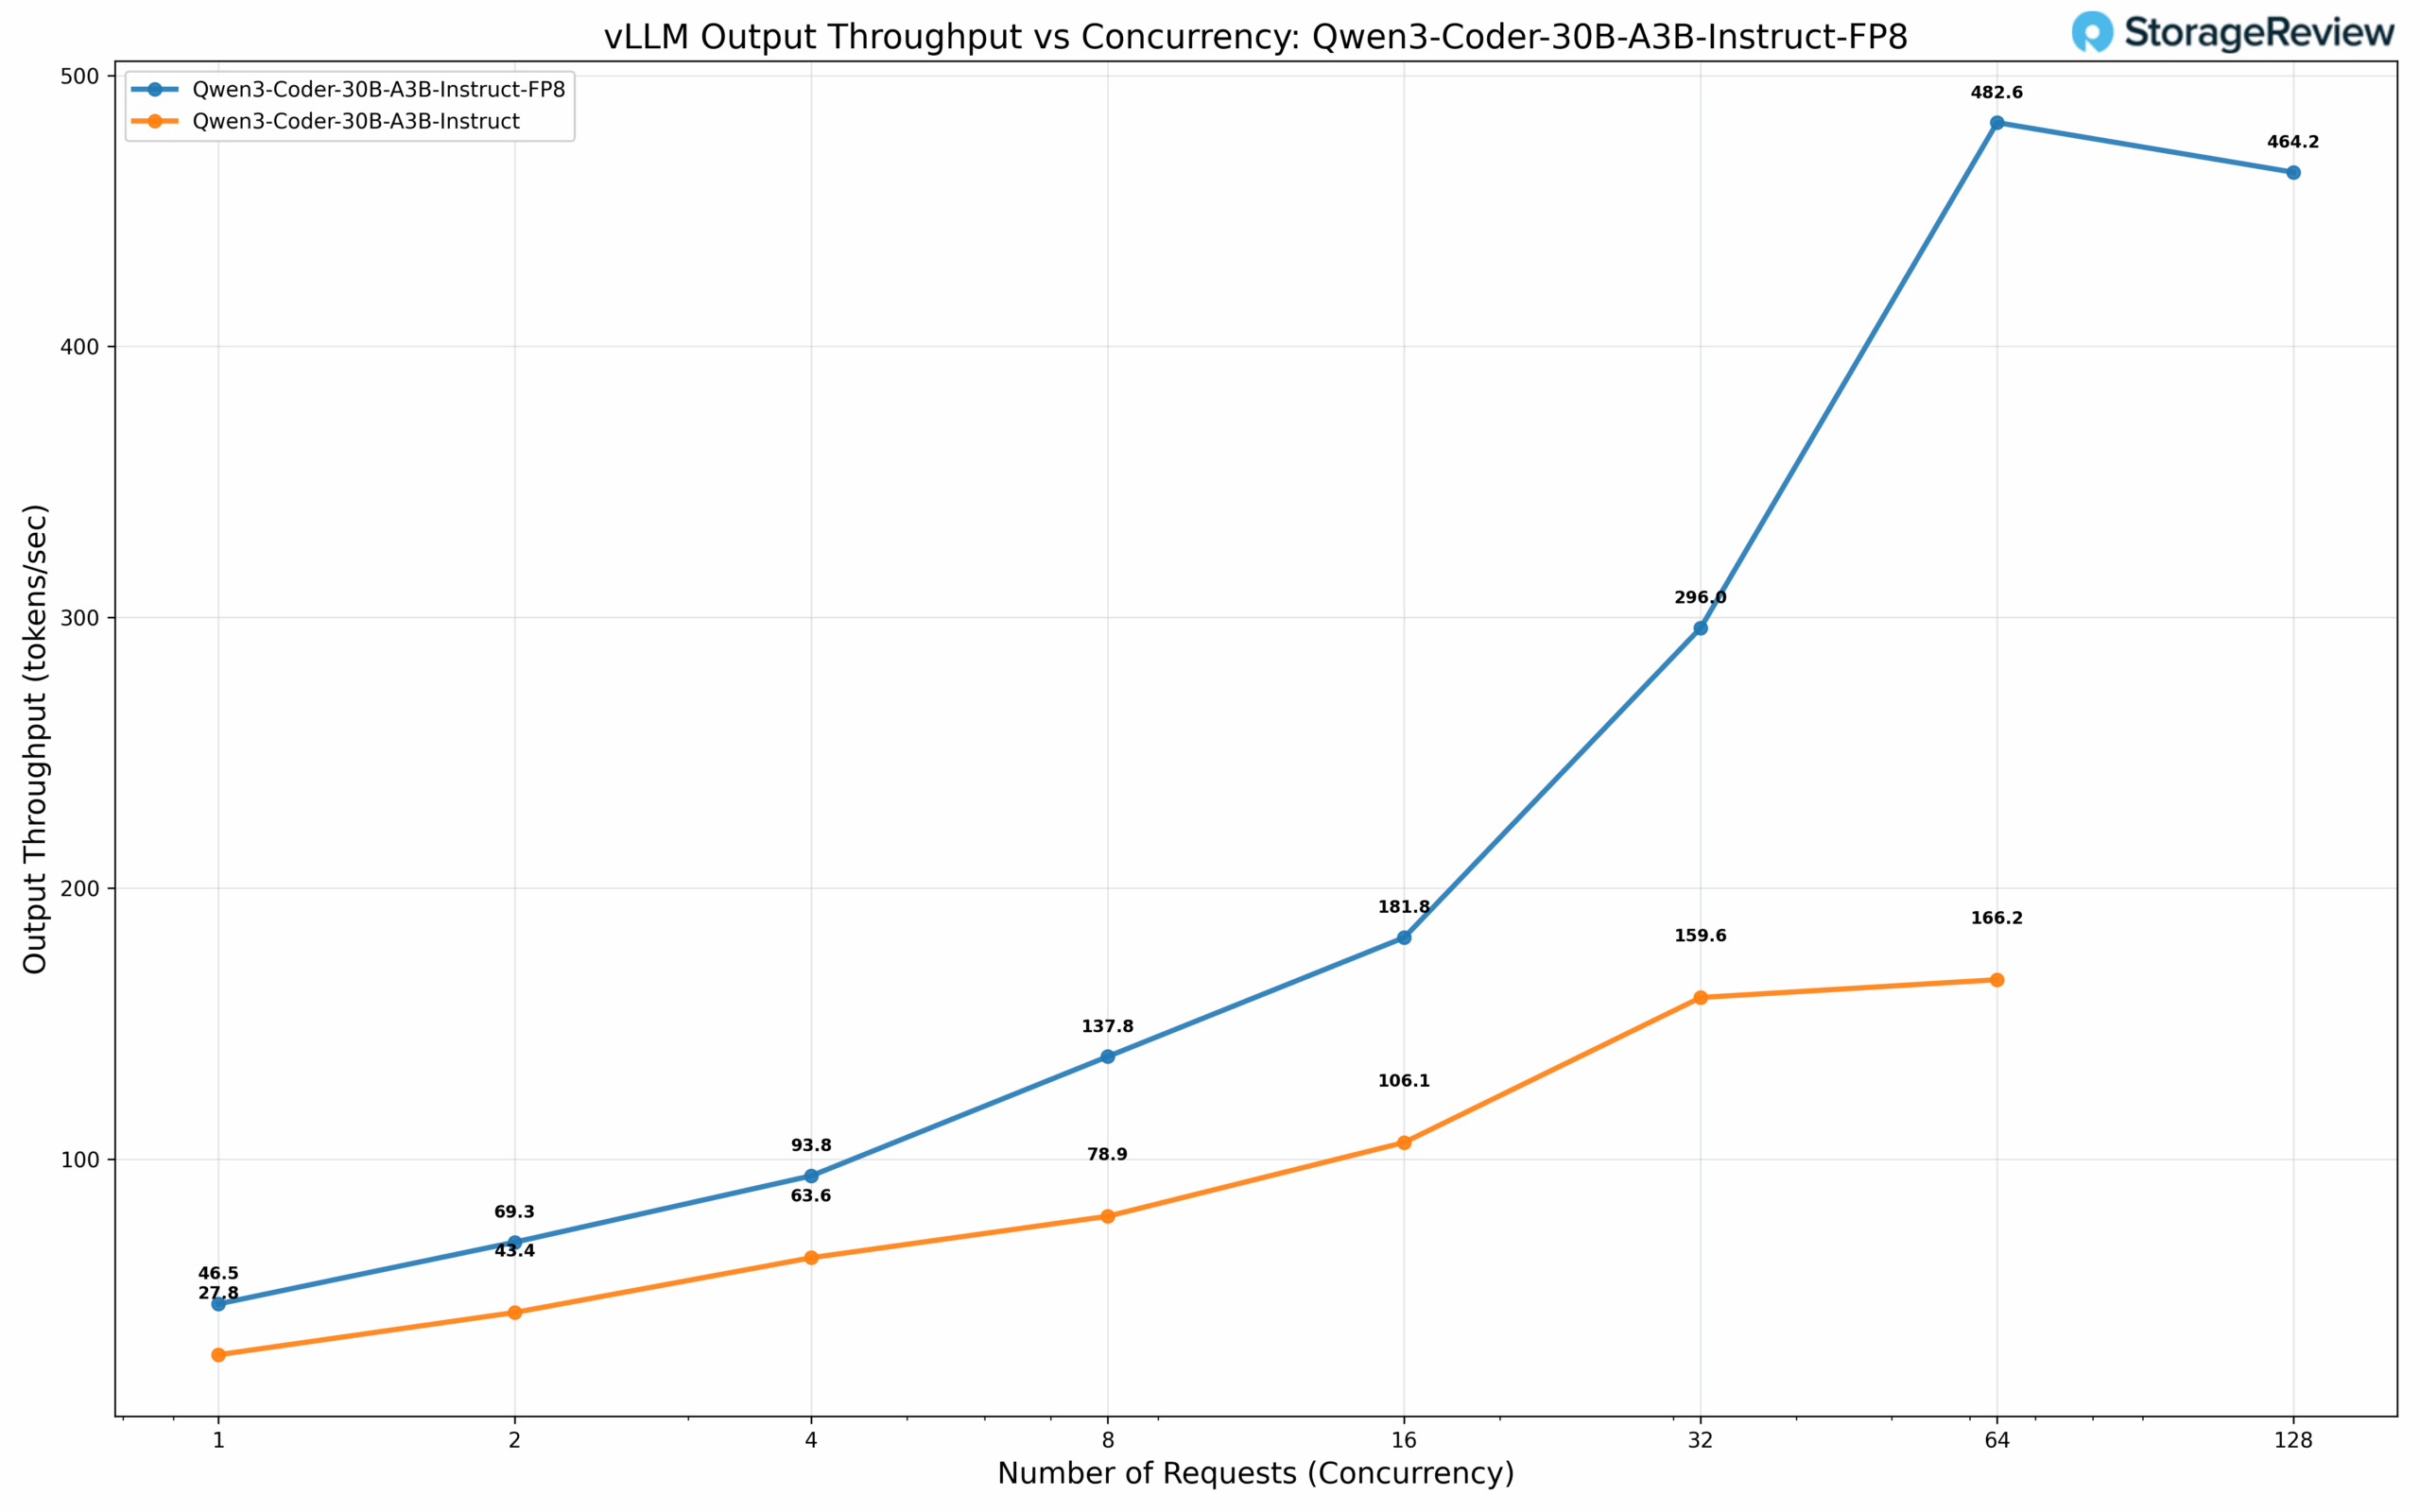
ကျွန်ုပ်တို့သည် ဒေသတွင်း inference ဖြန့်ကျက်မှုများအတွက် အလွန်ရေပန်းစားသော coding model များထဲမှ တစ်ခုဖြစ်သည့် Qwen3 Coder 30B-A3B ကို အကဲဖြတ်ခဲ့ပါသည်။ ဤရှားပါးသောဗိသုကာလက်ရာသည် BF16 တိကျမှုတွင် 30B parameters များ၏ full model size ကို ထိန်းသိမ်းထားပြီး generated token တစ်ခုလျှင် 3B parameters များကိုသာ activate လုပ်ပါသည်။ ကျွန်ုပ်တို့သည် stock model နှင့် Qwen မှ FP8 quantized variant နှစ်ခုလုံးကို benchmark လုပ်ခဲ့ပါသည်။ FP8 quantized model သည် သိသာထင်ရှားသော စွမ်းဆောင်ရည်တိုးတက်မှုများကို ပြသထားသည်- concurrency 1 တွင် 46.5 tok/s ရရှိခဲ့ပြီး batch size 64 တွင် အထင်ကြီးလောက်စရာ 482.6 tok/s အထိ တိုးချဲ့နိုင်ခဲ့သည်။ stock BF16 model သည် concurrency 1 တွင် 27.8 tok/s ရရှိခဲ့ပြီး batch size 64 တွင် 166.2 tok/s ရောက်ရှိခဲ့ပြီး စွမ်းဆောင်ရည်ကွာခြားချက် ၃ ဆနီးပါးရှိသည်။
သိပ်သည်းသော မော်ဒယ်များ
Dense မော်ဒယ်များသည် ရိုးရာ LLM ဗိသုကာကို ကိုယ်စားပြုပြီး တွက်ချက်မှုဆိုင်ရာ လုပ်ဆောင်ချက်များနှင့် ကန့်သတ်ချက်များအားလုံးကို ကောက်ချက်ချစဉ်အတွင်း အသုံးချကာ ၎င်းတို့၏ ရှားပါးသော လုပ်ဆောင်ချက်များနှင့် နှိုင်းယှဉ်ပါက ပိုမိုတွက်ချက်မှုဆိုင်ရာ လုပ်ဆောင်ချက်များကို ဖြစ်ပေါ်စေပါသည်။ မော်ဒယ်စကေးများနှင့် ပမာဏပြောင်းလဲမှု မဟာဗျူဟာများတစ်လျှောက် စွမ်းဆောင်ရည် လက္ခဏာများကို ပြည့်စုံစွာ အကဲဖြတ်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် dense မော်ဒယ် ဖွဲ့စည်းမှု ငါးခုကို စံနှုန်းသတ်မှတ်ခဲ့ပါသည်။
ကျွန်ုပ်တို့၏ စမ်းသပ်မှုအစုံတွင် Mistral AI မှ BF16 တိကျမှုတွင် Mistral Small 3.1 24B နှင့် RedHat AI မှ Mistral Small 3.1 24B FP8 dynamically quantized variant တို့ ပါဝင်သည်။ Dynamic quantization သည် စွမ်းဆောင်ရည်-တိကျမှု လဲလှယ်မှုကို အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ရန်အတွက် selective weight quantization နည်းပညာများကို အသုံးပြုပြီး မော်ဒယ်ယိုယွင်းမှုကို အနည်းဆုံးဖြစ်စေပြီး တိကျမှုကို ဗျူဟာကျကျ လျှော့ချပေးပါသည်။ ကျွန်ုပ်တို့သည် ဤပိုကြီးသော dense မော်ဒယ်များကို တိကျမှုပုံစံသုံးမျိုးဖြင့် Meta Llama 3.1 8B အကဲဖြတ်မှုများဖြင့် ဖြည့်စွက်ခဲ့သည်- stock BF16 configuration နှင့် NVIDIA မှ FP8 နှင့် FP4 quantized ဗားရှင်းများ။ ဤမော်ဒယ်ရွေးချယ်မှုဗျူဟာသည် မော်ဒယ်စကေးများတစ်လျှောက် တိုက်ရိုက်စွမ်းဆောင်ရည်နှိုင်းယှဉ်မှုကို ဖြစ်စေပြီး inference throughput အပေါ် progressive quantization ၏သက်ရောက်မှုကို ခွဲထုတ်နိုင်စေပါသည်။
စွမ်းဆောင်ရည် ခွဲခြမ်းစိတ်ဖြာခြင်း- ကြီးမားသော သိပ်သည်းဆများ မော်ဒယ်များ
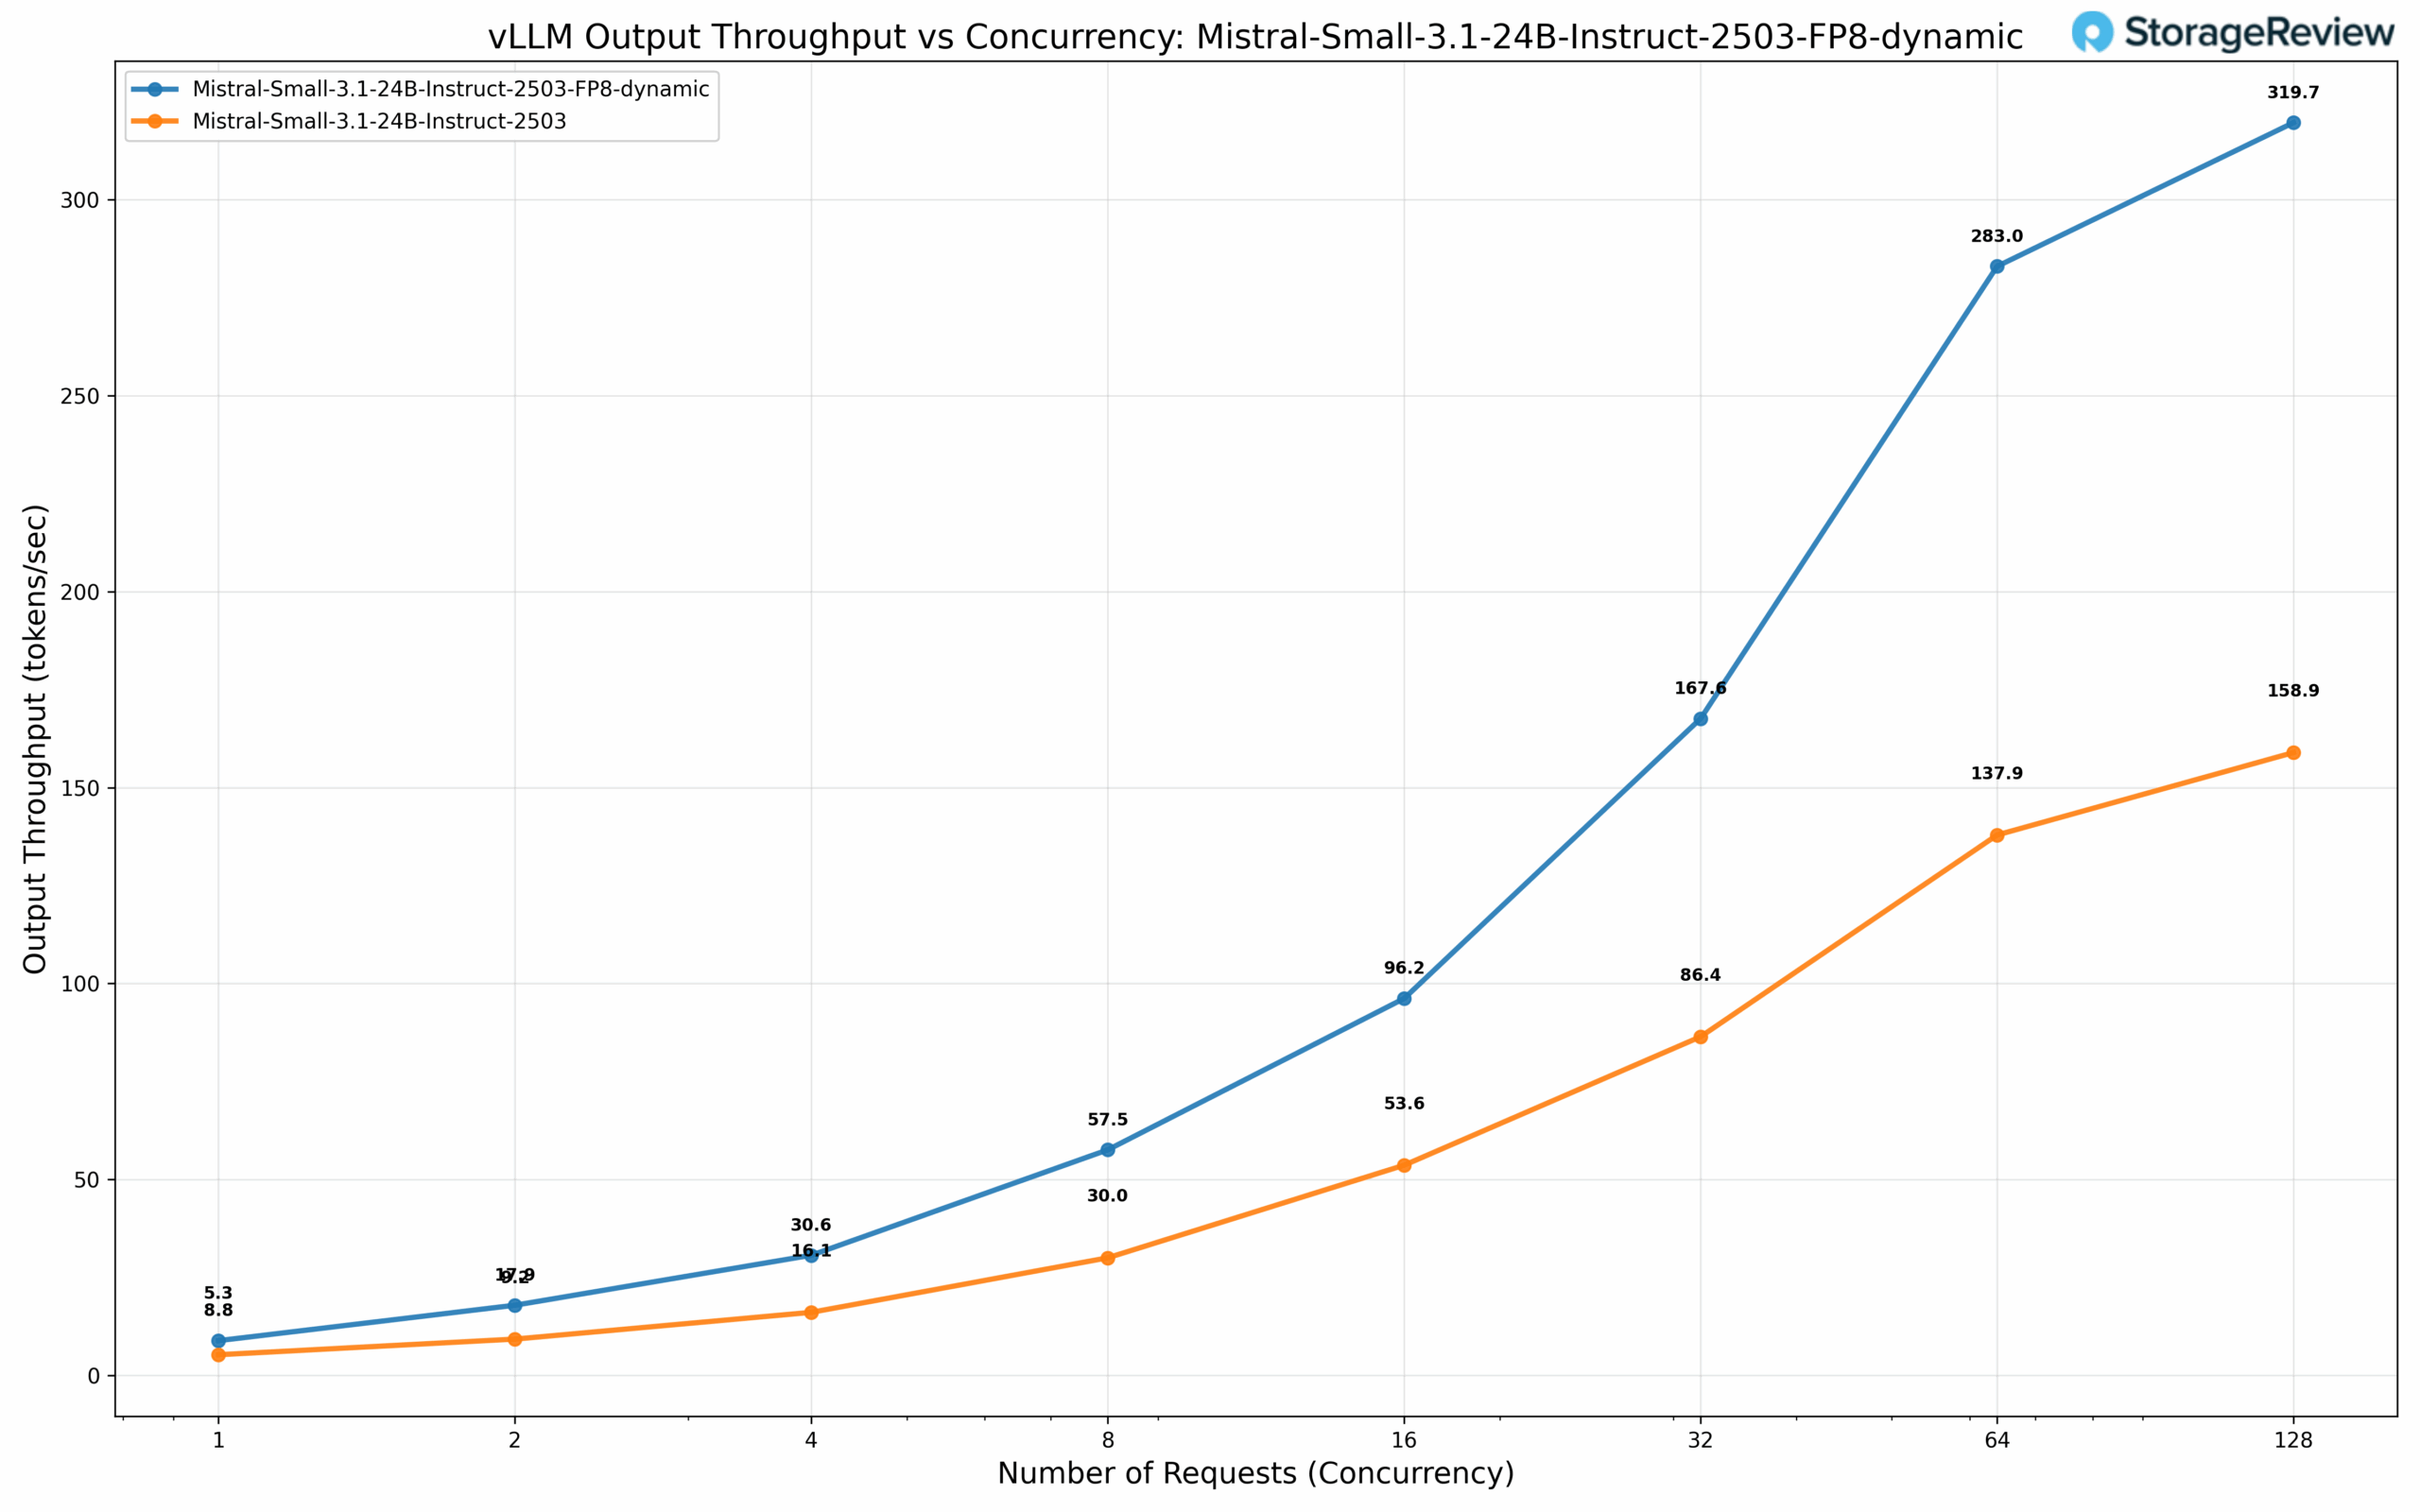
BF16 တိကျမှုတွင် Mistral Small 3.1 24B သည် concurrency 1 တွင် 5.3 tok/s ၏ အခြေခံ throughput ကို ပြသထားပြီး၊ concurrency requests 128 ခုတွင် သိသာထင်ရှားသော 158.9 tok/s အထိ တိုးချဲ့ထားသည်။ FP8 dynamically quantized variant သည် 8.8 tok/s ဖြင့် concurrency နိမ့်သောအခါ အနည်းငယ်သာ တိုးတက်မှုကို ပြသသော်လည်း၊ scale တွင် ဆွဲဆောင်မှုရှိသော 2x performance multiplier ကို ပေးစွမ်းပြီး 128 concurrency တွင် 319.7 tok/s ရရှိစေသည်—၎င်းသည် throughput မြင့်မားသော serving scenarios များအတွက် dynamic quantization ၏ ထိရောက်မှုကို အလေးပေးဖော်ပြသည်။
စွမ်းဆောင်ရည် ခွဲခြမ်းစိတ်ဖြာခြင်း- ကျစ်လစ်သိပ်သည်းသော မော်ဒယ်များ
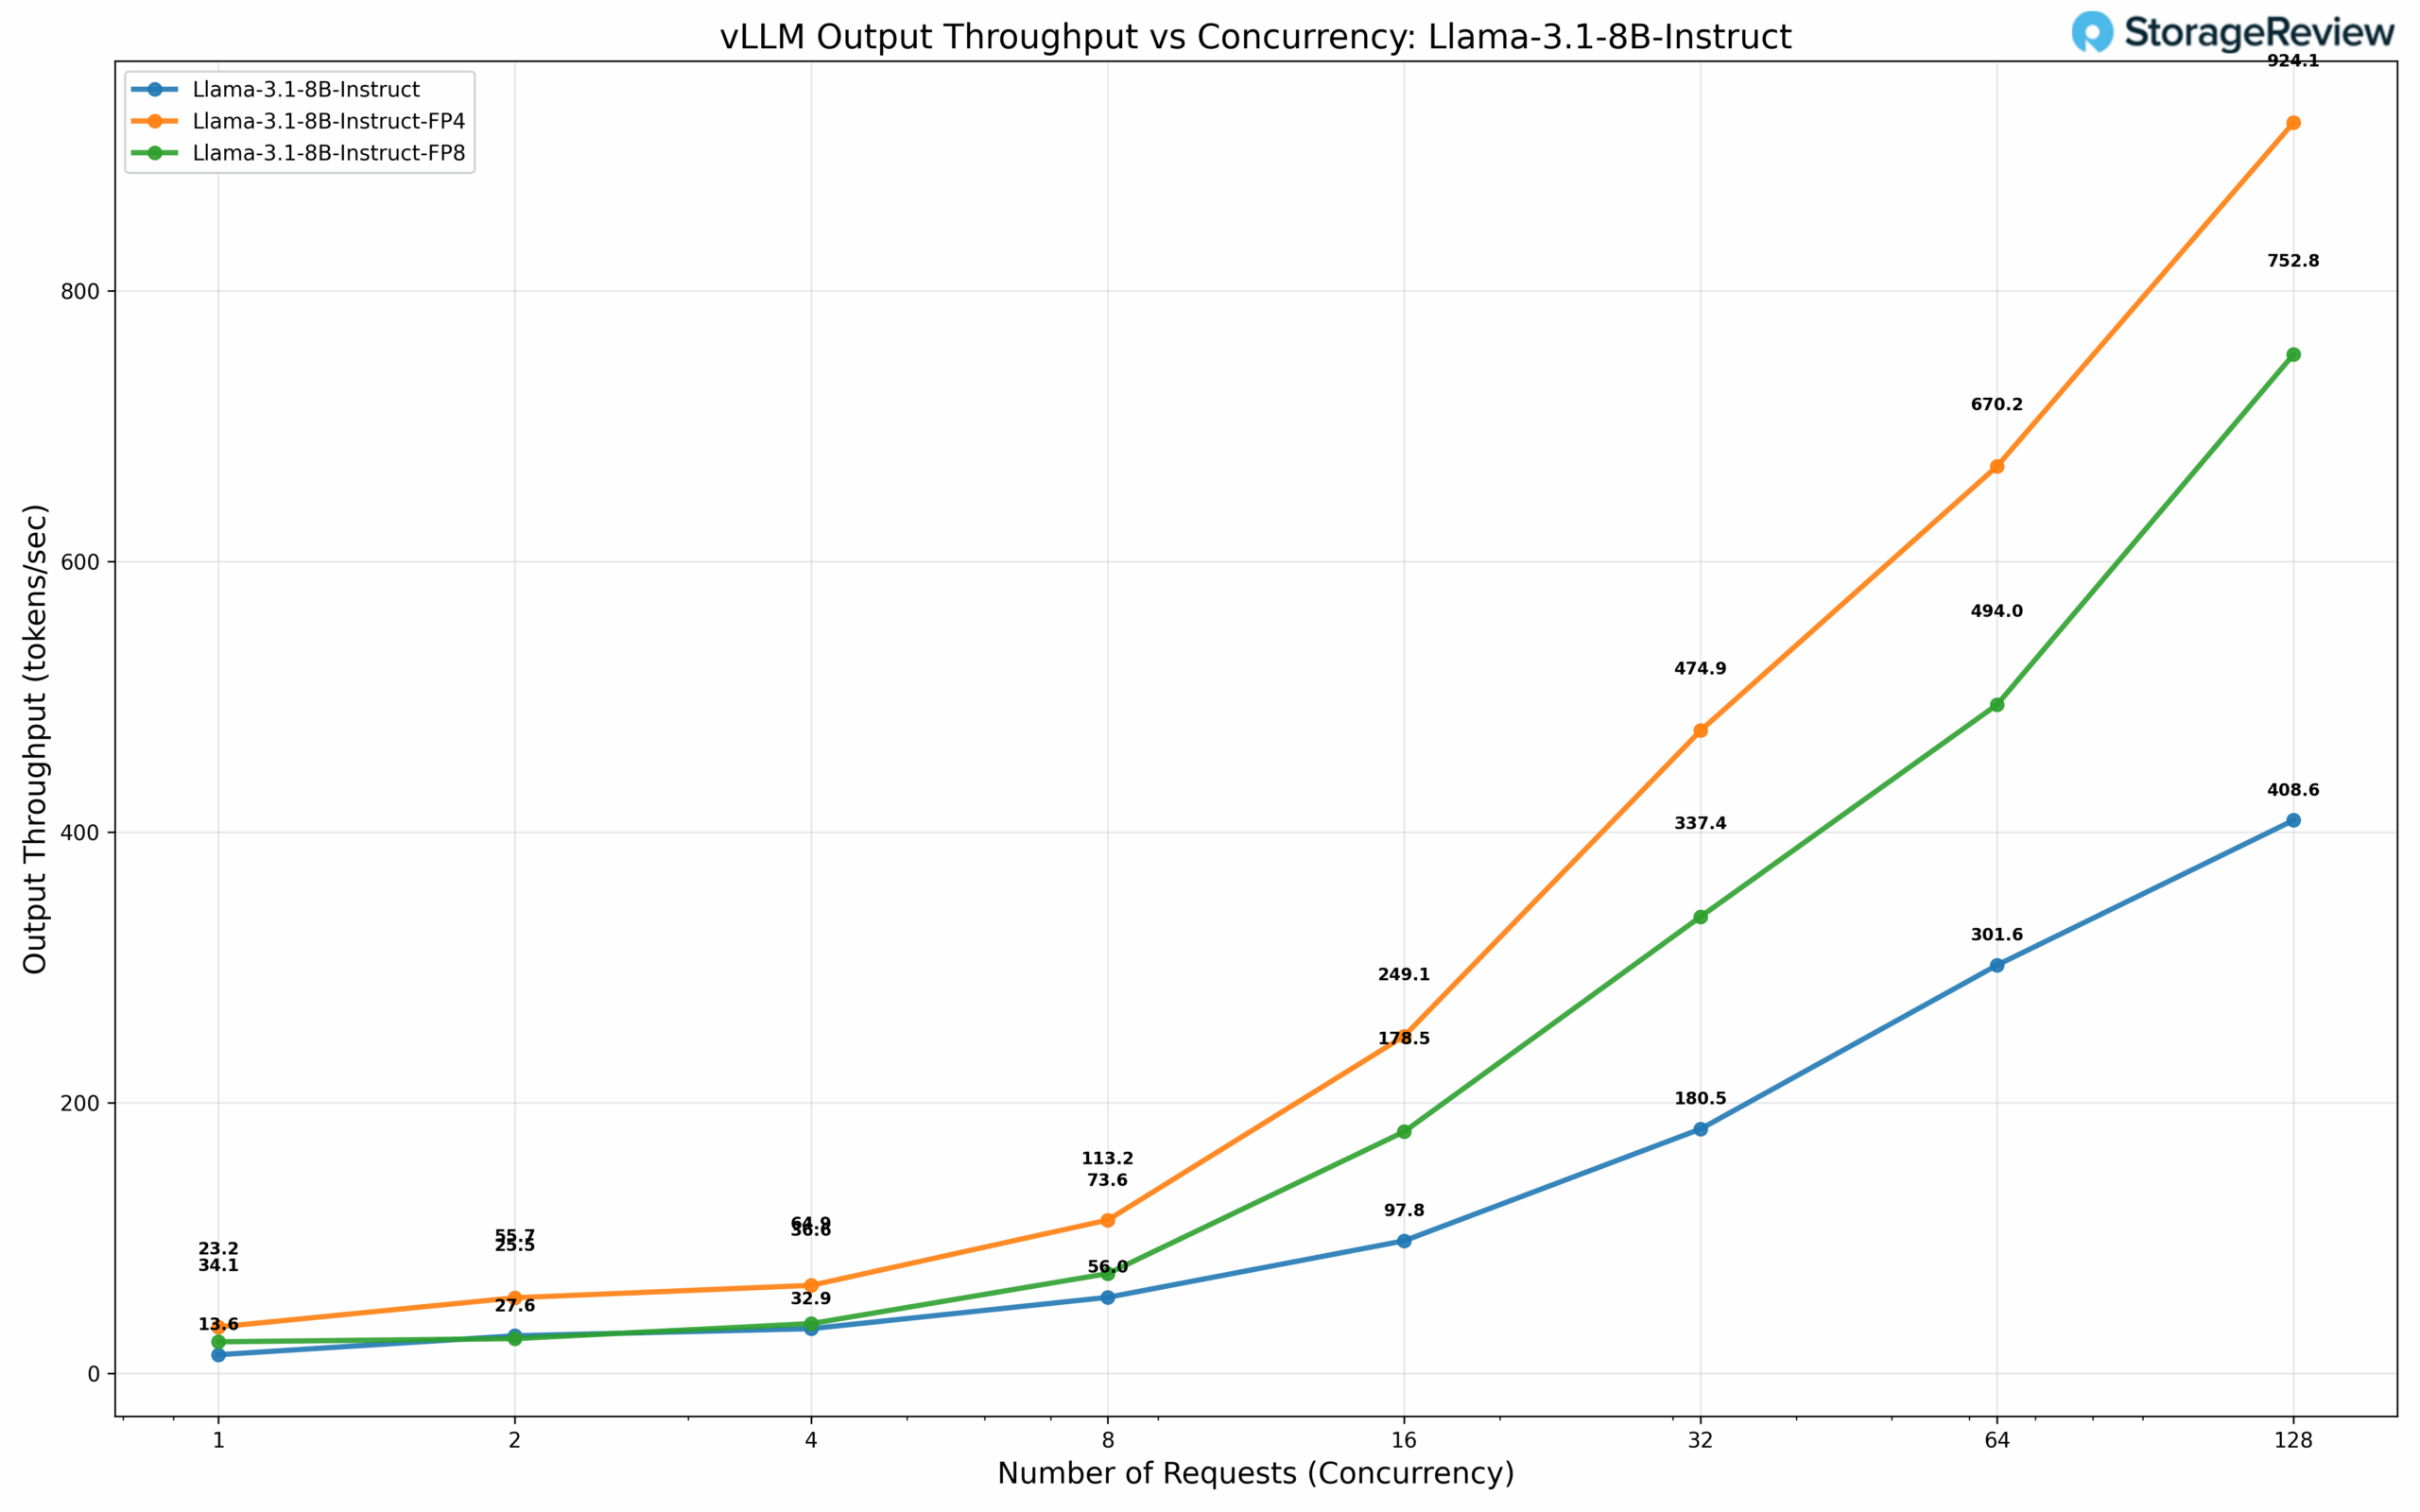
Llama 3.1 8B ဗိသုကာသည် quantization ဗျူဟာများတစ်လျှောက်တွင် သိသိသာသာကွဲပြားသော စွမ်းဆောင်ရည်လက္ခဏာများကို ဖော်ပြပါသည်။ BF16 တိကျမှုတွင်၊ မော်ဒယ်သည် concurrency 1 တွင် 13.6 tok/s ပေးစွမ်းပြီး concurrency requests 128 ခုတွင် 408.6 tok/s အထိ တိုးချဲ့ထားသည်။ FP8 quantization သို့ကူးပြောင်းခြင်းသည် concurrency levels 1 နှင့် 128 တွင် 23.2 tok/s နှင့် 752.8 tok/s အသီးသီးရရှိစေပြီး စကေးတွင် 84% throughput တိုးတက်မှုကိုကိုယ်စားပြုသည်။ FP4 configuration သည် စွမ်းဆောင်ရည်ကို ပိုမိုတွန်းအားပေးပြီး တူညီသော concurrency levels တွင် 34.1 tok/s နှင့် 924.1 tok/s ရရှိကာ ရန်လိုသော quantization ဗျူဟာများသည် ထုတ်လုပ်မှု workloads အများအပြားအတွက် လက်ခံနိုင်သော မော်ဒယ်အရည်အသွေးကို ထိန်းသိမ်းထားစဉ် အခြေခံတိကျမှုထက် 2.3x စွမ်းဆောင်ရည်တိုးတက်မှုကို ပေးစွမ်းနိုင်ကြောင်း ပြသသည်။
မိုက်ခရိုစကေးလင်းဒေတာအမျိုးအစား
Microscaling သည် ကြီးမားသော parameter အုပ်စုများတွင် uniform quantization အစား အလေးချိန်များ၏ သေးငယ်သော block များတွင် fine-grained scaling factor များကို အသုံးချသည့် အဆင့်မြင့် quantization ချဉ်းကပ်မှုကို ကိုယ်စားပြုသည်။ NVIDIA ၏ NVFP4 format သည် ဤနည်းပညာကို 8-32 တန်ဖိုးများရှိသော microscale block တစ်ခုစီတွင် scaling factor အဖြစ် ဘုံ exponent တစ်ခုကို မျှဝေသည့် blocked floating-point ကိုယ်စားပြုမှုမှတစ်ဆင့် အကောင်အထည်ဖော်သည်။ ဤ granular ချဉ်းကပ်မှုသည် 4-bit ကိုယ်စားပြုမှုကို ရရှိနေစဉ်တွင် ဂဏန်းသင်္ချာတိကျမှုကို ထိန်းသိမ်းထားပြီး transformer architectures အတွက် အရေးကြီးသော dynamic range ကို ထိန်းသိမ်းထားသည်။ format သည် NVIDIA ၏ Tensor Core architecture နှင့် ပေါင်းစပ်ထားပြီး matrix လုပ်ဆောင်ချက်များအတွင်း on-the-fly decompression ဖြင့် ထိရောက်သော mixed-precision တွက်ချက်မှုကို ဖြစ်စေသည်။
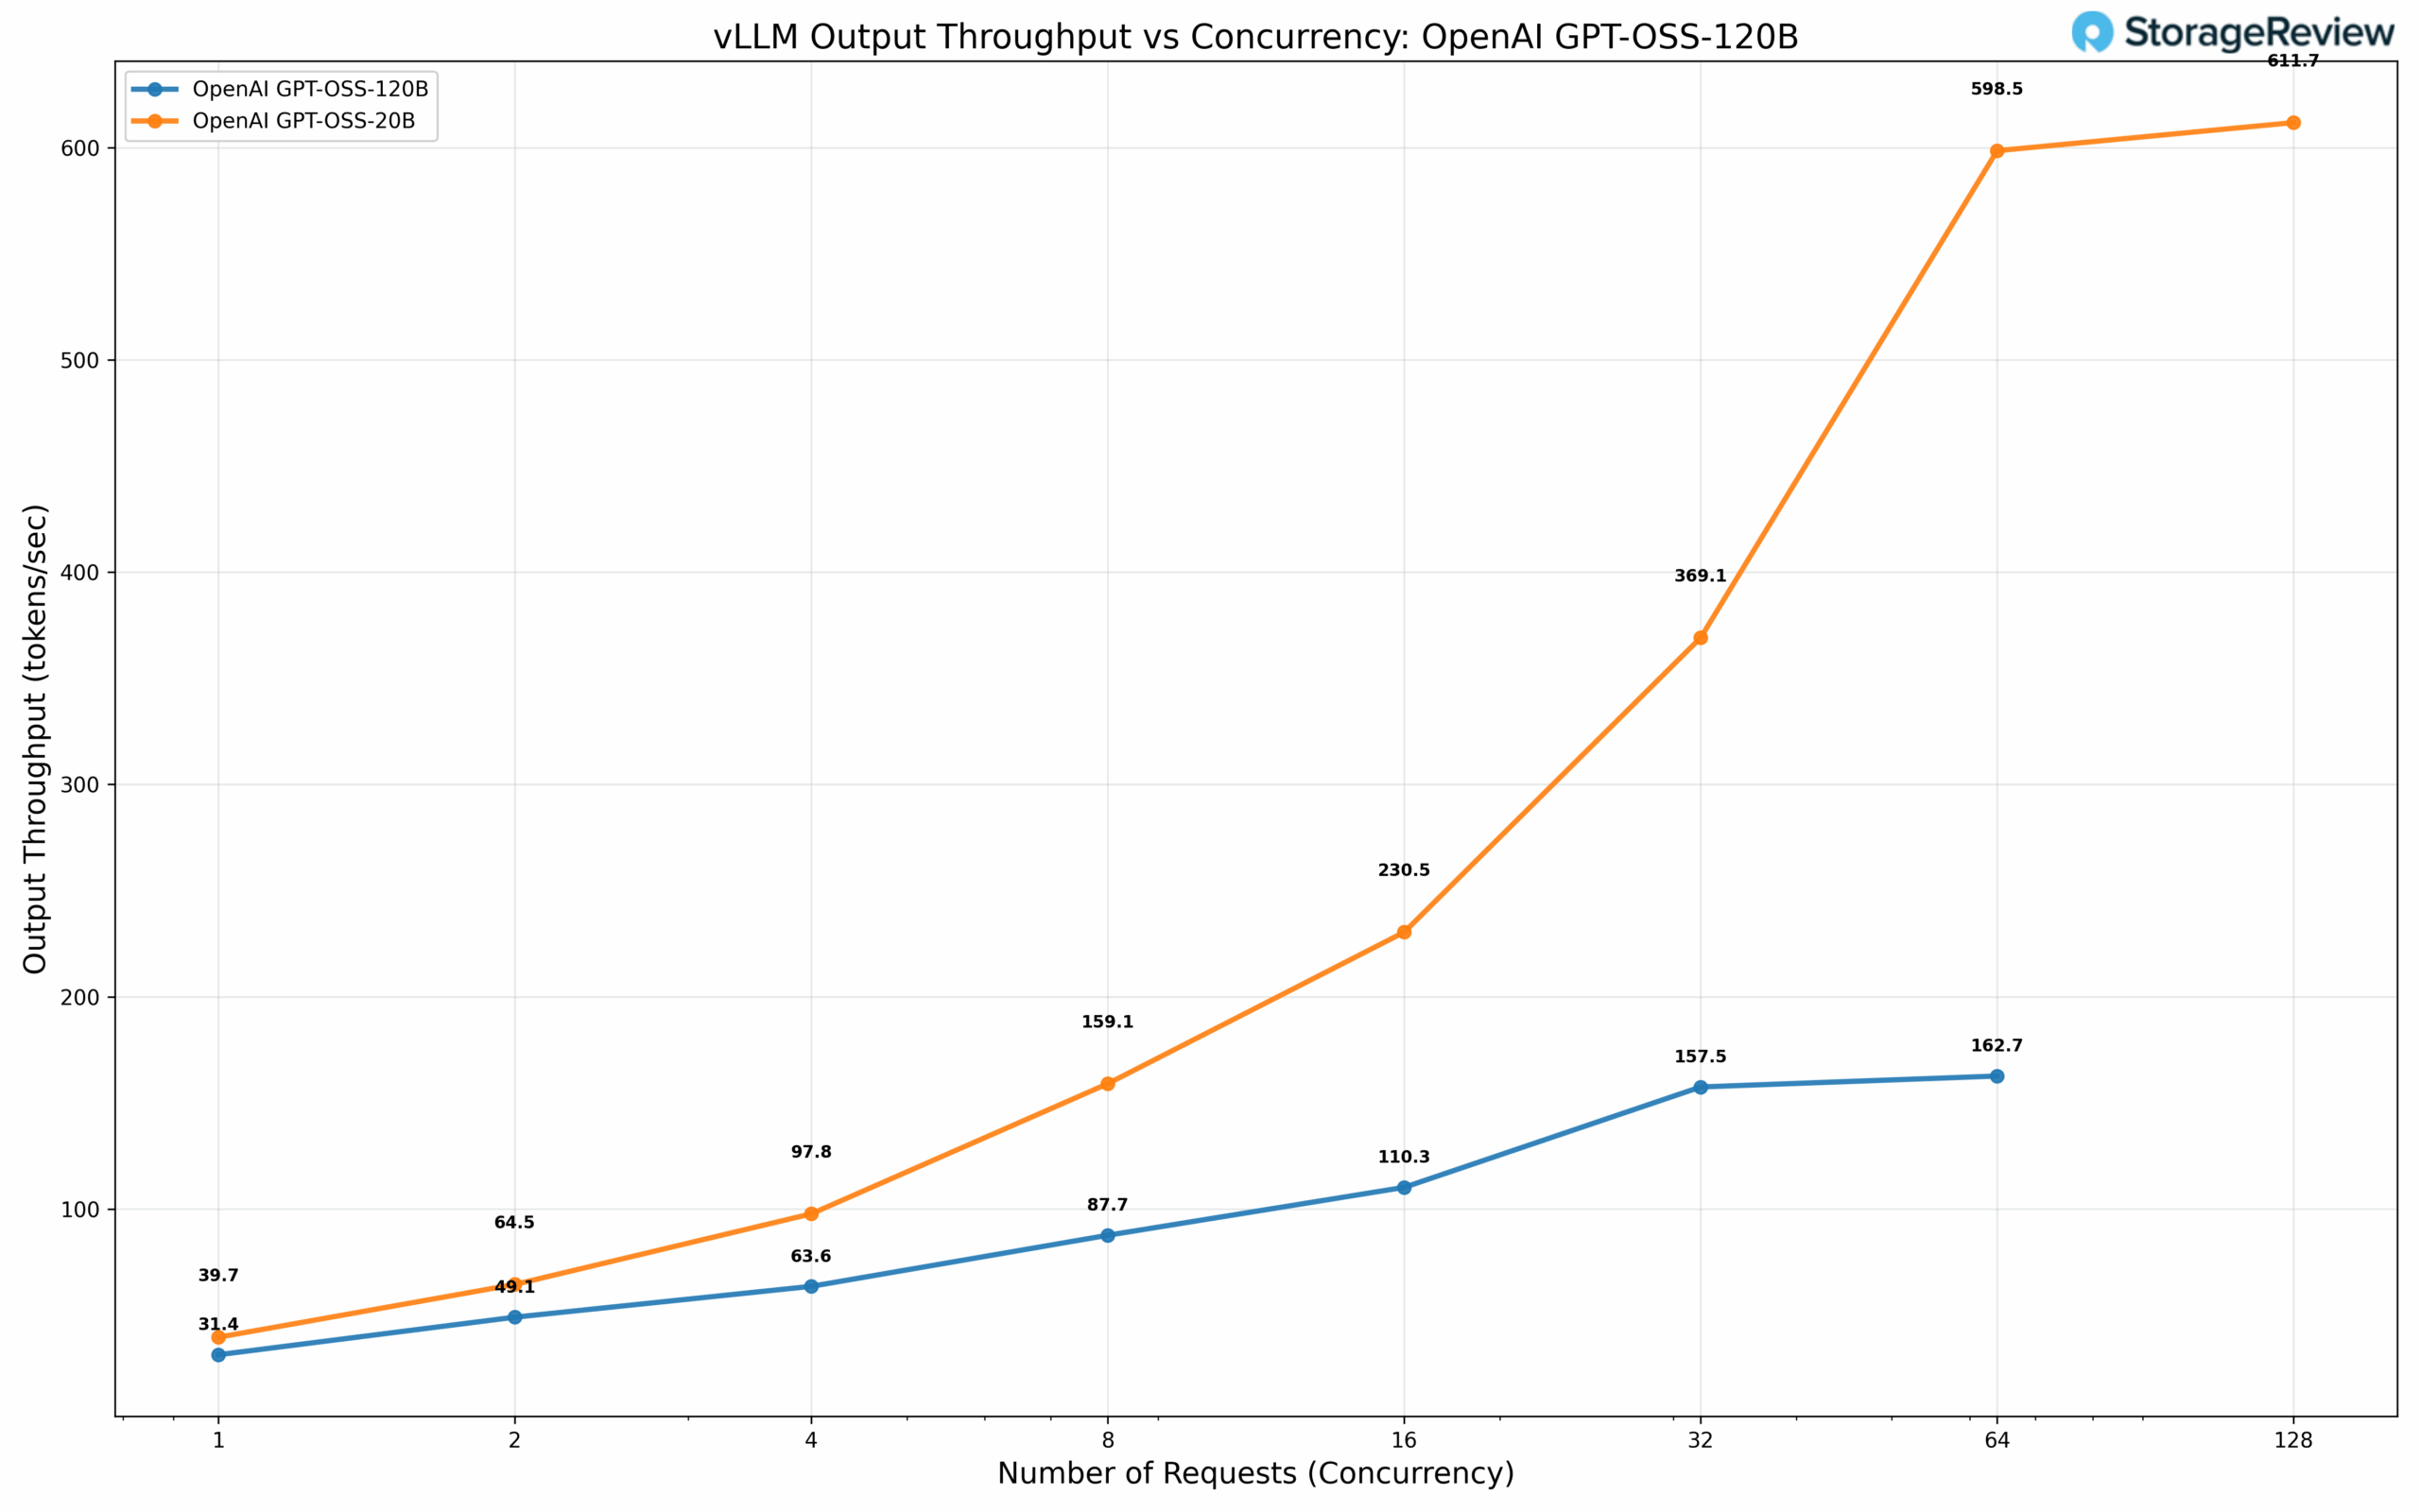
ကျွန်ုပ်တို့သည် OpenAI ၏ GPT OSS မော်ဒယ်များကို NVFP4 quantization ကို အသုံးပြု၍ 20B နှင့် 120B parameter scales များတွင် အကဲဖြတ်ခဲ့ပါသည်။ 20B parameter model သည် concurrency 1 တွင် 39.7 tok/s ရရှိပြီး concurrent requests 128 ခုတွင် 611.7 tok/s အထိ scale လုပ်နိုင်ပါသည်။ 120B parameter variant သည် concurrency 1 တွင် 31.4 tok/s နှင့် concurrent requests 64 ခုတွင် 162.7 tok/s ရရှိပါသည်။
မှတ်ချက်- output throughput သည် request များတစ်လျှောက် ရရှိသော throughput ဖြစ်ပြီး request တစ်ခုစီ၏ throughput မဟုတ်ပါ။
အချိန်အကန့်အသတ်ကြောင့် TensorRT စမ်းသပ်မှုတွေကို အပြီးသတ်နိုင်ခြင်းမရှိခဲ့တာကြောင့်၊ နောက်ထပ် inference frameworks တွေမှာ စွမ်းဆောင်ရည်ကို လေ့လာနိုင်မယ့် spark နဲ့ နောက်ဆက်တွဲအပိုင်းတွေကို စောင့်ကြည့်ပေးပါ။
လေးလံသော ကောက်ချက်ချမှုကို ကြိုတင်ဖြည့်ပြီး ကုဒ်ဖြည်ပါ
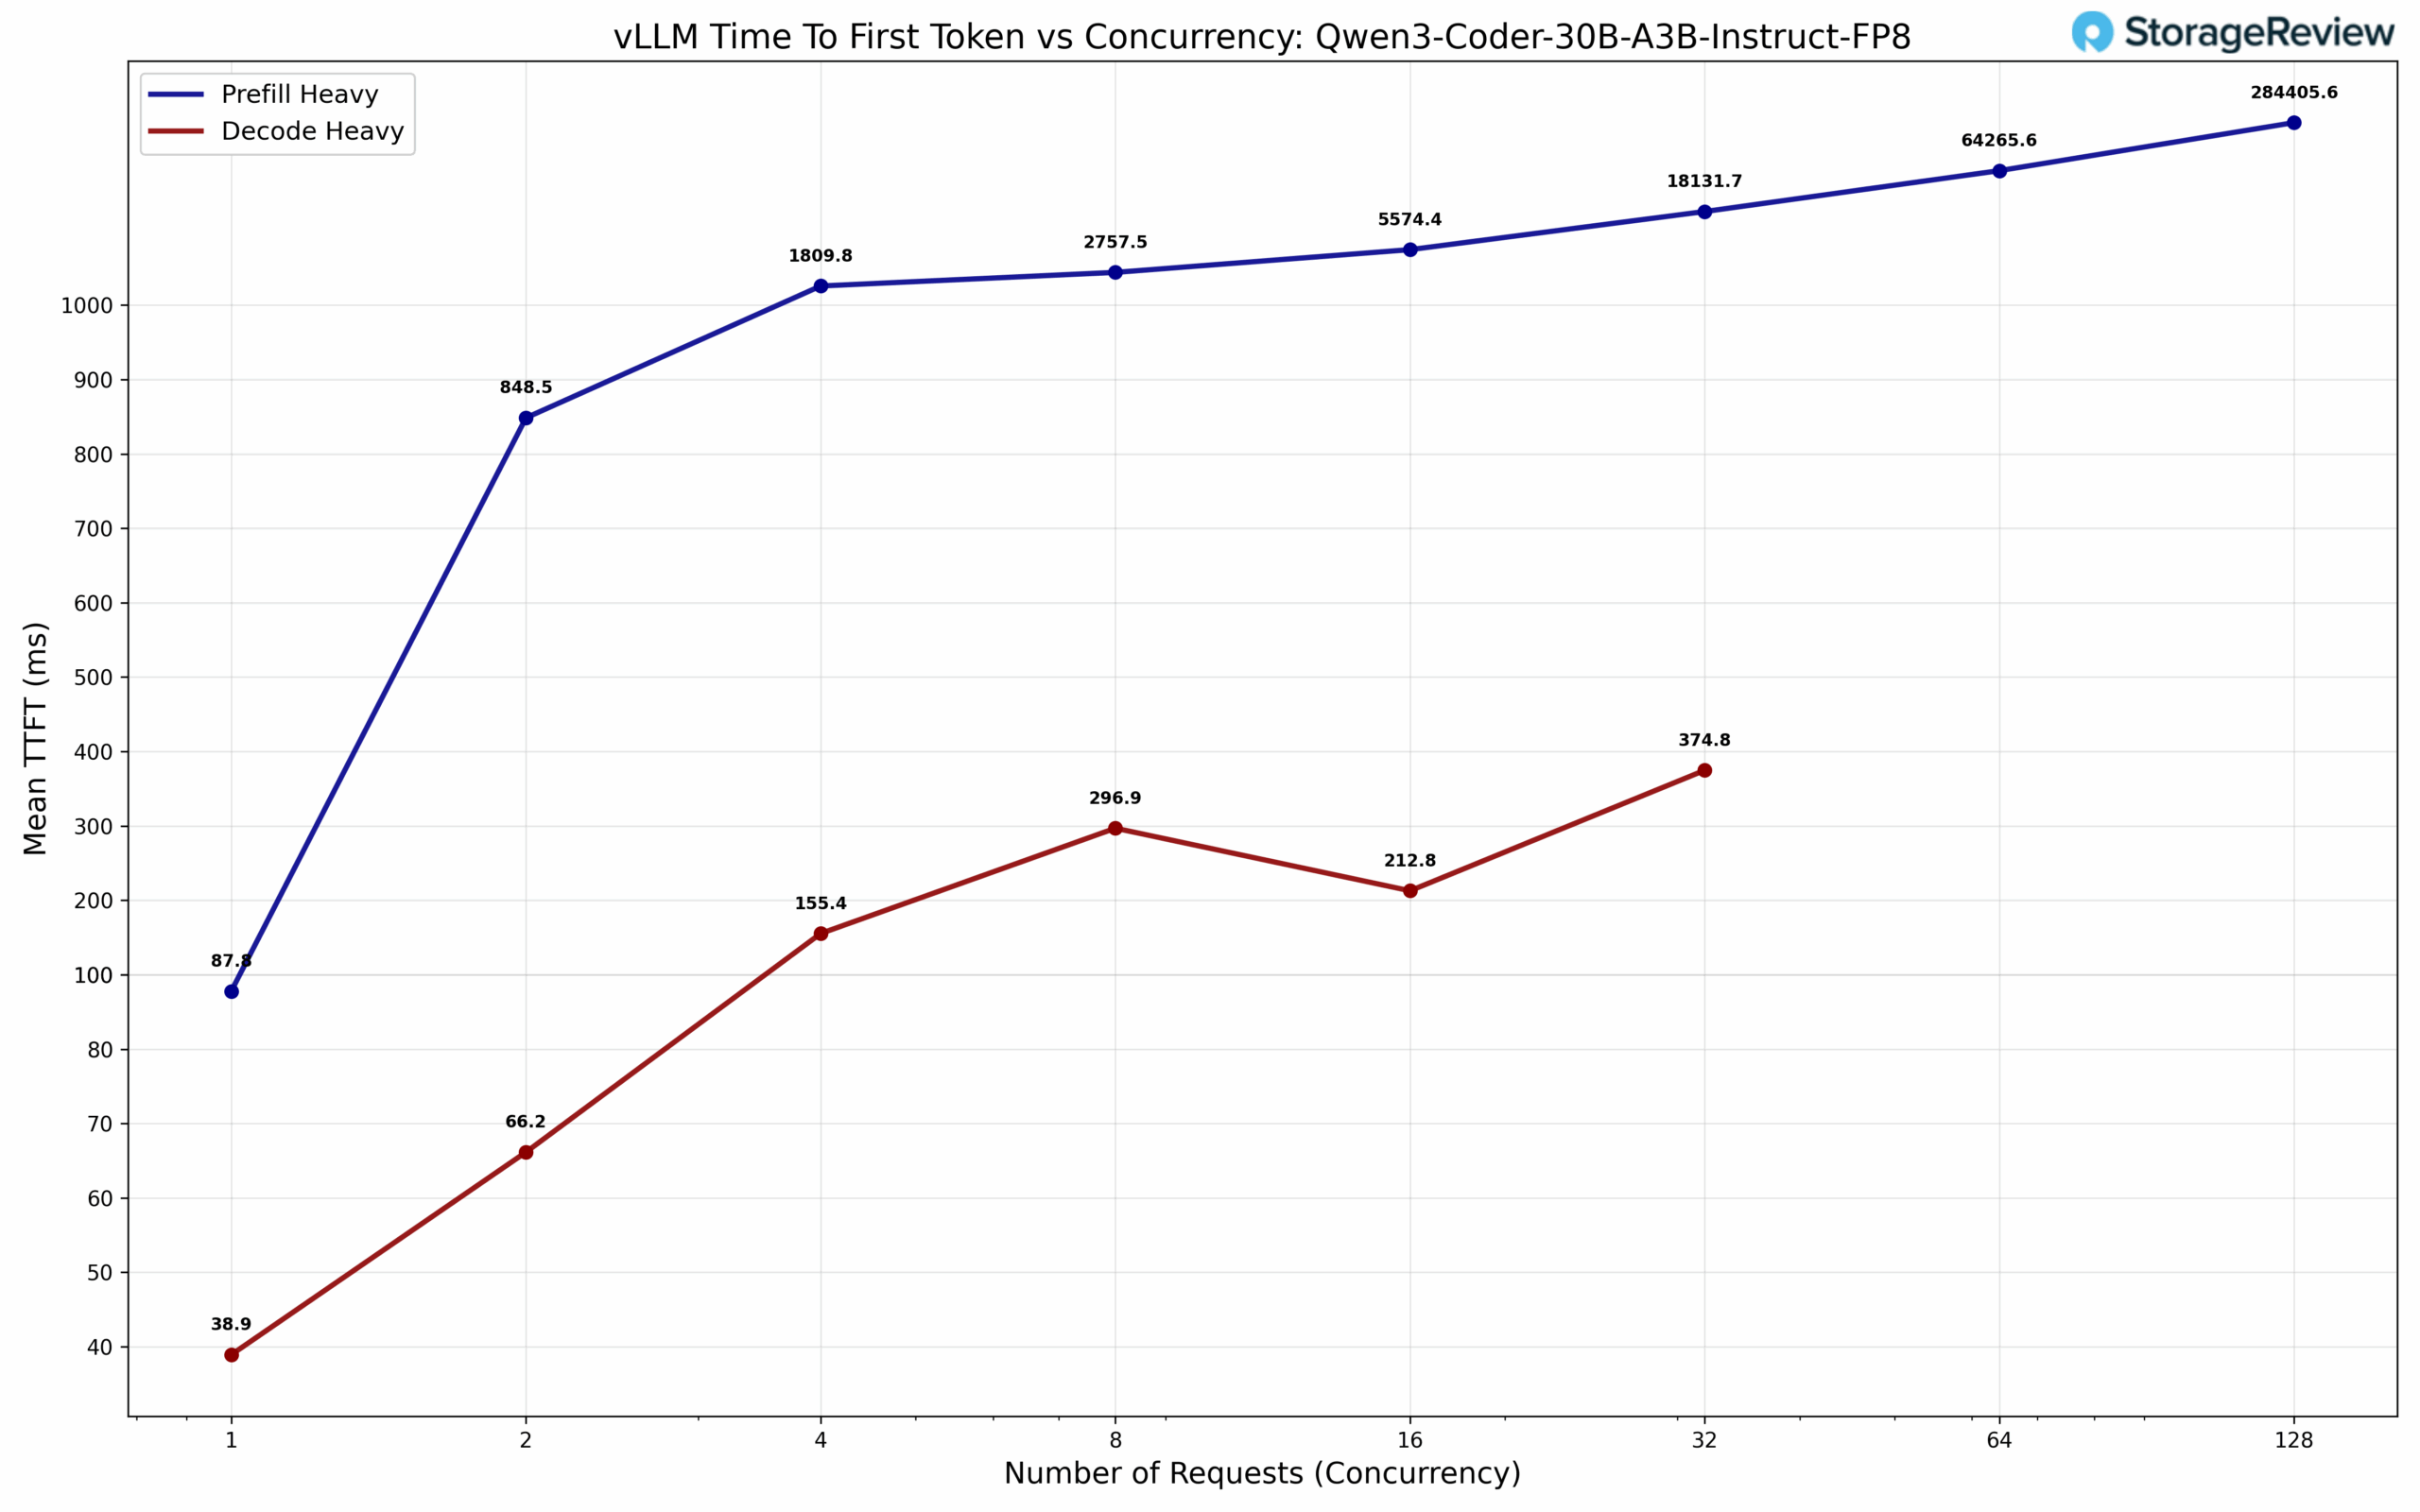
LLM ကောက်ချက်ချမှုကို အခြေခံအားဖြင့် ကွဲပြားသော တွက်ချက်မှုအဆင့်နှစ်ခုအဖြစ် ပိုင်းခြားနိုင်ပြီး၊ တစ်ခုချင်းစီတွင် သိသာထင်ရှားစွာ ကွဲပြားသော စွမ်းဆောင်ရည်လက္ခဏာများနှင့် အရင်းအမြစ်အသုံးပြုမှုပုံစံများကို ပြသထားသည်။ prefill အဆင့်သည် input prompt တစ်ခုလုံးကို parallel operation တစ်ခုတည်းတွင် လုပ်ဆောင်ပြီး input token အားလုံးတွင် အာရုံစူးစိုက်မှုယန္တရားများကို တစ်ပြိုင်နက်တည်း တွက်ချက်ကာ tensor cores နှင့် computational units များကို အပြည့်အဝပြည့်နှက်စေသော compute-intensive operation တစ်ခုဖြစ်သည်။ ဆန့်ကျင်ဘက်အားဖြင့် decode အဆင့်သည် output tokens များကို autoregressively ထုတ်ပေးပြီး တွက်ချက်မှုပြင်းထန်မှုနည်းသော်လည်း model သည် weights များနှင့် ကြီးထွားလာသော key-value cache ကို အကြိမ်ကြိမ်ဝင်ရောက်ရမည်ဖြစ်သောကြောင့် memory bandwidth တွင် သိသာထင်ရှားသော လိုအပ်ချက်များရှိသည့် sequential operations များမှတစ်ဆင့် တစ်ကြိမ်လျှင် token တစ်ခုကို ထုတ်လုပ်ပေးသည်။ ၎င်းသည် အခြေခံအားဖြင့် ကွဲပြားသော bottleneck profiles များကို ဖန်တီးပေးသည်- prefill operations များသည် ပုံမှန်အားဖြင့် compute-bound ဖြစ်ပြီး decode operations များသည် memory bandwidth-intensive ဖြစ်လာပြီး memory subsystem ကန့်သတ်ချက်များကို အထူးထိခိုက်လွယ်စေသည်။
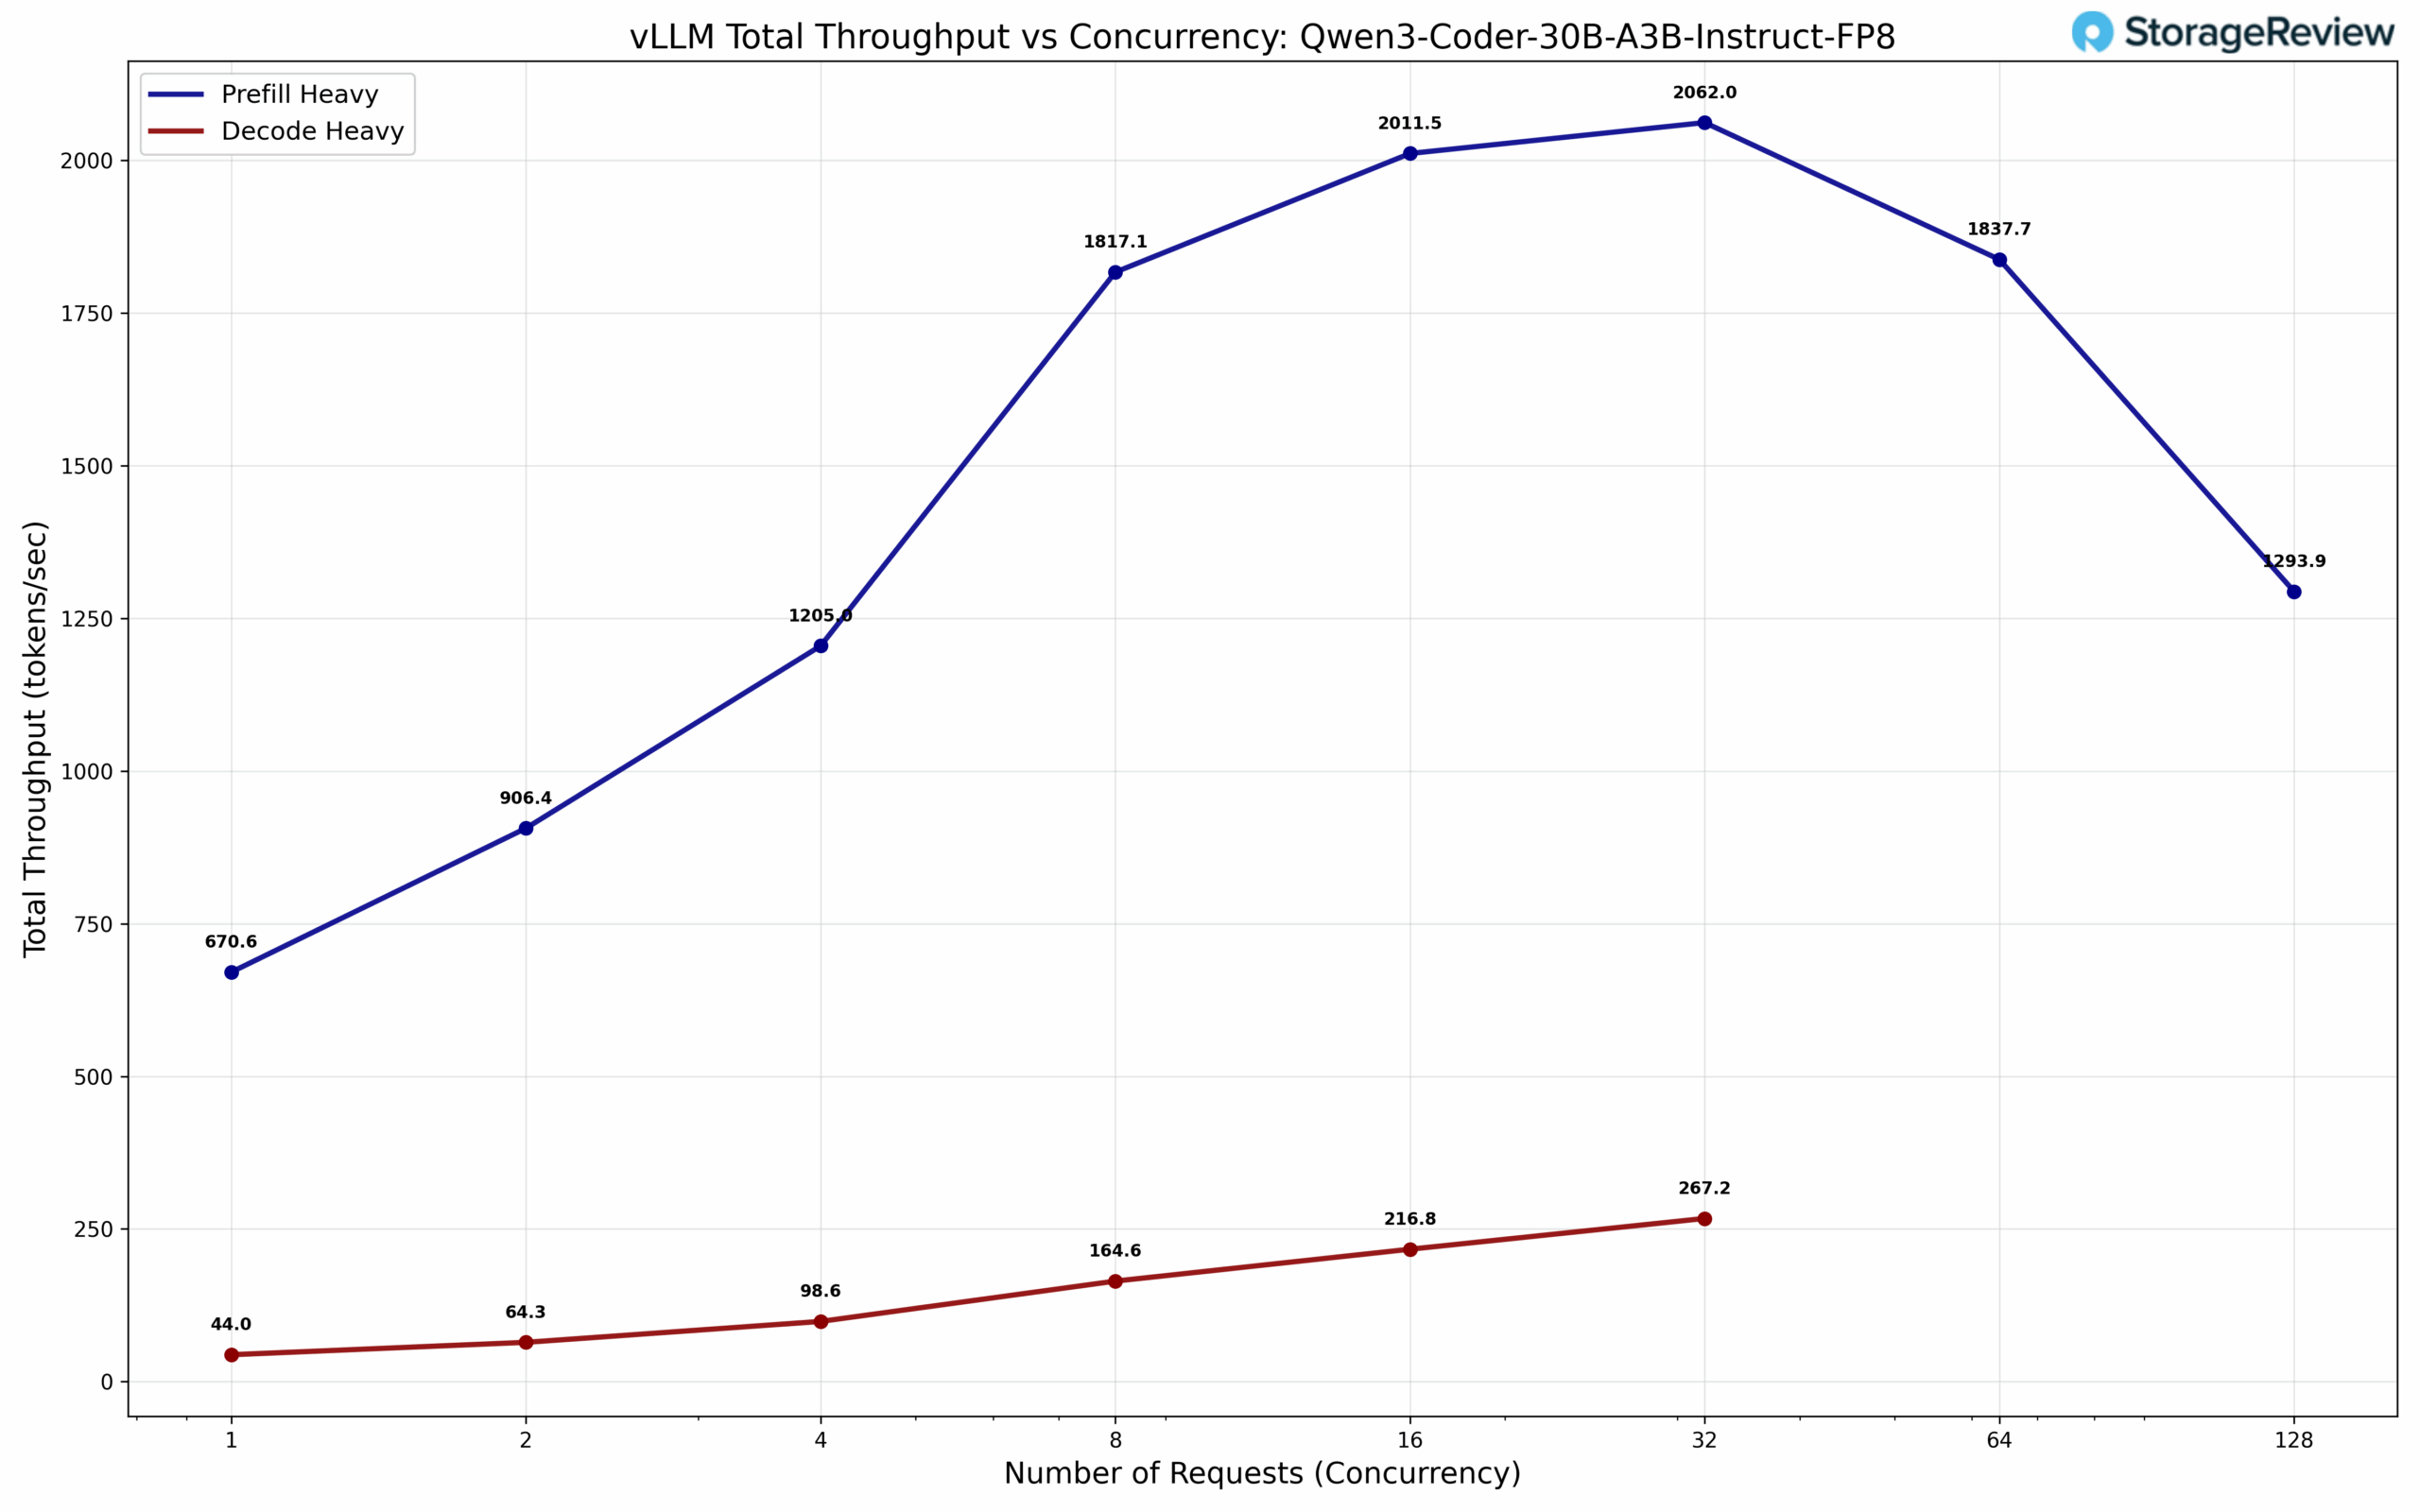
ကျွန်ုပ်တို့သည် workload profile နှစ်ခုတွင် ပြည့်စုံသော စမ်းသပ်မှုကို ပြုလုပ်ခဲ့ပါသည်- input token ၅၁၂ ခုနှင့် output token ၈,၁၉၂ ခုပါသော decode-heavy inference နှင့် input token ၈,၁၉၂ ခုနှင့် output token ၅၁၂ ခုပါသော prefill-heavy inference။ စွမ်းဆောင်ရည် လက္ခဏာရပ်က မျှော်လင့်ထားသည့် ဗိသုကာဆိုင်ရာ အပေးအယူများကို ဖော်ထုတ်ပေးသည်- Spark သည် prefill-heavy workloads များတွင် compute resources များသည် အဓိက bottleneck အဖြစ် ဆက်လက်တည်ရှိနေသော်လည်း decode-heavy scenarios များတွင် စွမ်းဆောင်ရည် လျော့နည်းသွားသည်ကို ပြသသည့် ယှဉ်ပြိုင်နိုင်သော throughput ကို ပြသသည်။ ဤစွမ်းဆောင်ရည် ကွာခြားချက်သည် memory bandwidth ကန့်သတ်ချက်များနှင့် တိကျစွာ ကိုက်ညီပါသည်။ Decode operations များ၏ sequential သဘောသဘာဝနှင့် intensive memory access patterns များသည် Spark ၏ ဗိသုကာတွင် bandwidth ကန့်သတ်ချက်များကို တိုက်ရိုက်ဖော်ထုတ်သည်။ ဤရလဒ်များသည် နောက်အပိုင်းတွင် MAMF တိုင်းတာမှုများကို အဓိပ္ပာယ်ဖွင့်ဆိုရန်အတွက် အရေးကြီးသော အကြောင်းအရာများကို ပံ့ပိုးပေးသည်၊ အဘယ်ကြောင့်ဆိုသော် benchmark suites နှစ်ခုစလုံးသည် memory bandwidth ကို real-world inference deployments များတွင် အခြေခံစွမ်းဆောင်ရည် ကန့်သတ်သည့်အချက်အဖြစ် တသမတ်တည်း ခွဲခြားသတ်မှတ်သောကြောင့်ဖြစ်သည်။
အများဆုံးရရှိနိုင်သော Matmul FLOPS (MAMF)
MAMF (အမြင့်ဆုံးရရှိနိုင်သော Matmul FLOPS) သည် matrix multiplication operations များအတွင်း machine learning accelerators များတွင် ရရှိနိုင်သော တစ်စက္ကန့်လျှင် လက်တွေ့ကျသော peak floating-point operations များကို တိုင်းတာရန် ဒီဇိုင်းထုတ်ထားသော လက်တွေ့ကျသော စွမ်းဆောင်ရည် metric တစ်ခုဖြစ်ပြီး hardware သတ်မှတ်ချက်များတွင် မကြာခဏ ကြော်ငြာထားသော သီအိုရီ peak FLOPS ထက် ပိုမိုတိကျသော benchmark ကို ပေးဆောင်ပါသည်။ ကျွန်ုပ်တို့သည် Stas Beckman မှ mamf-finder benchmark ကို အသုံးပြုနေပါသည်။
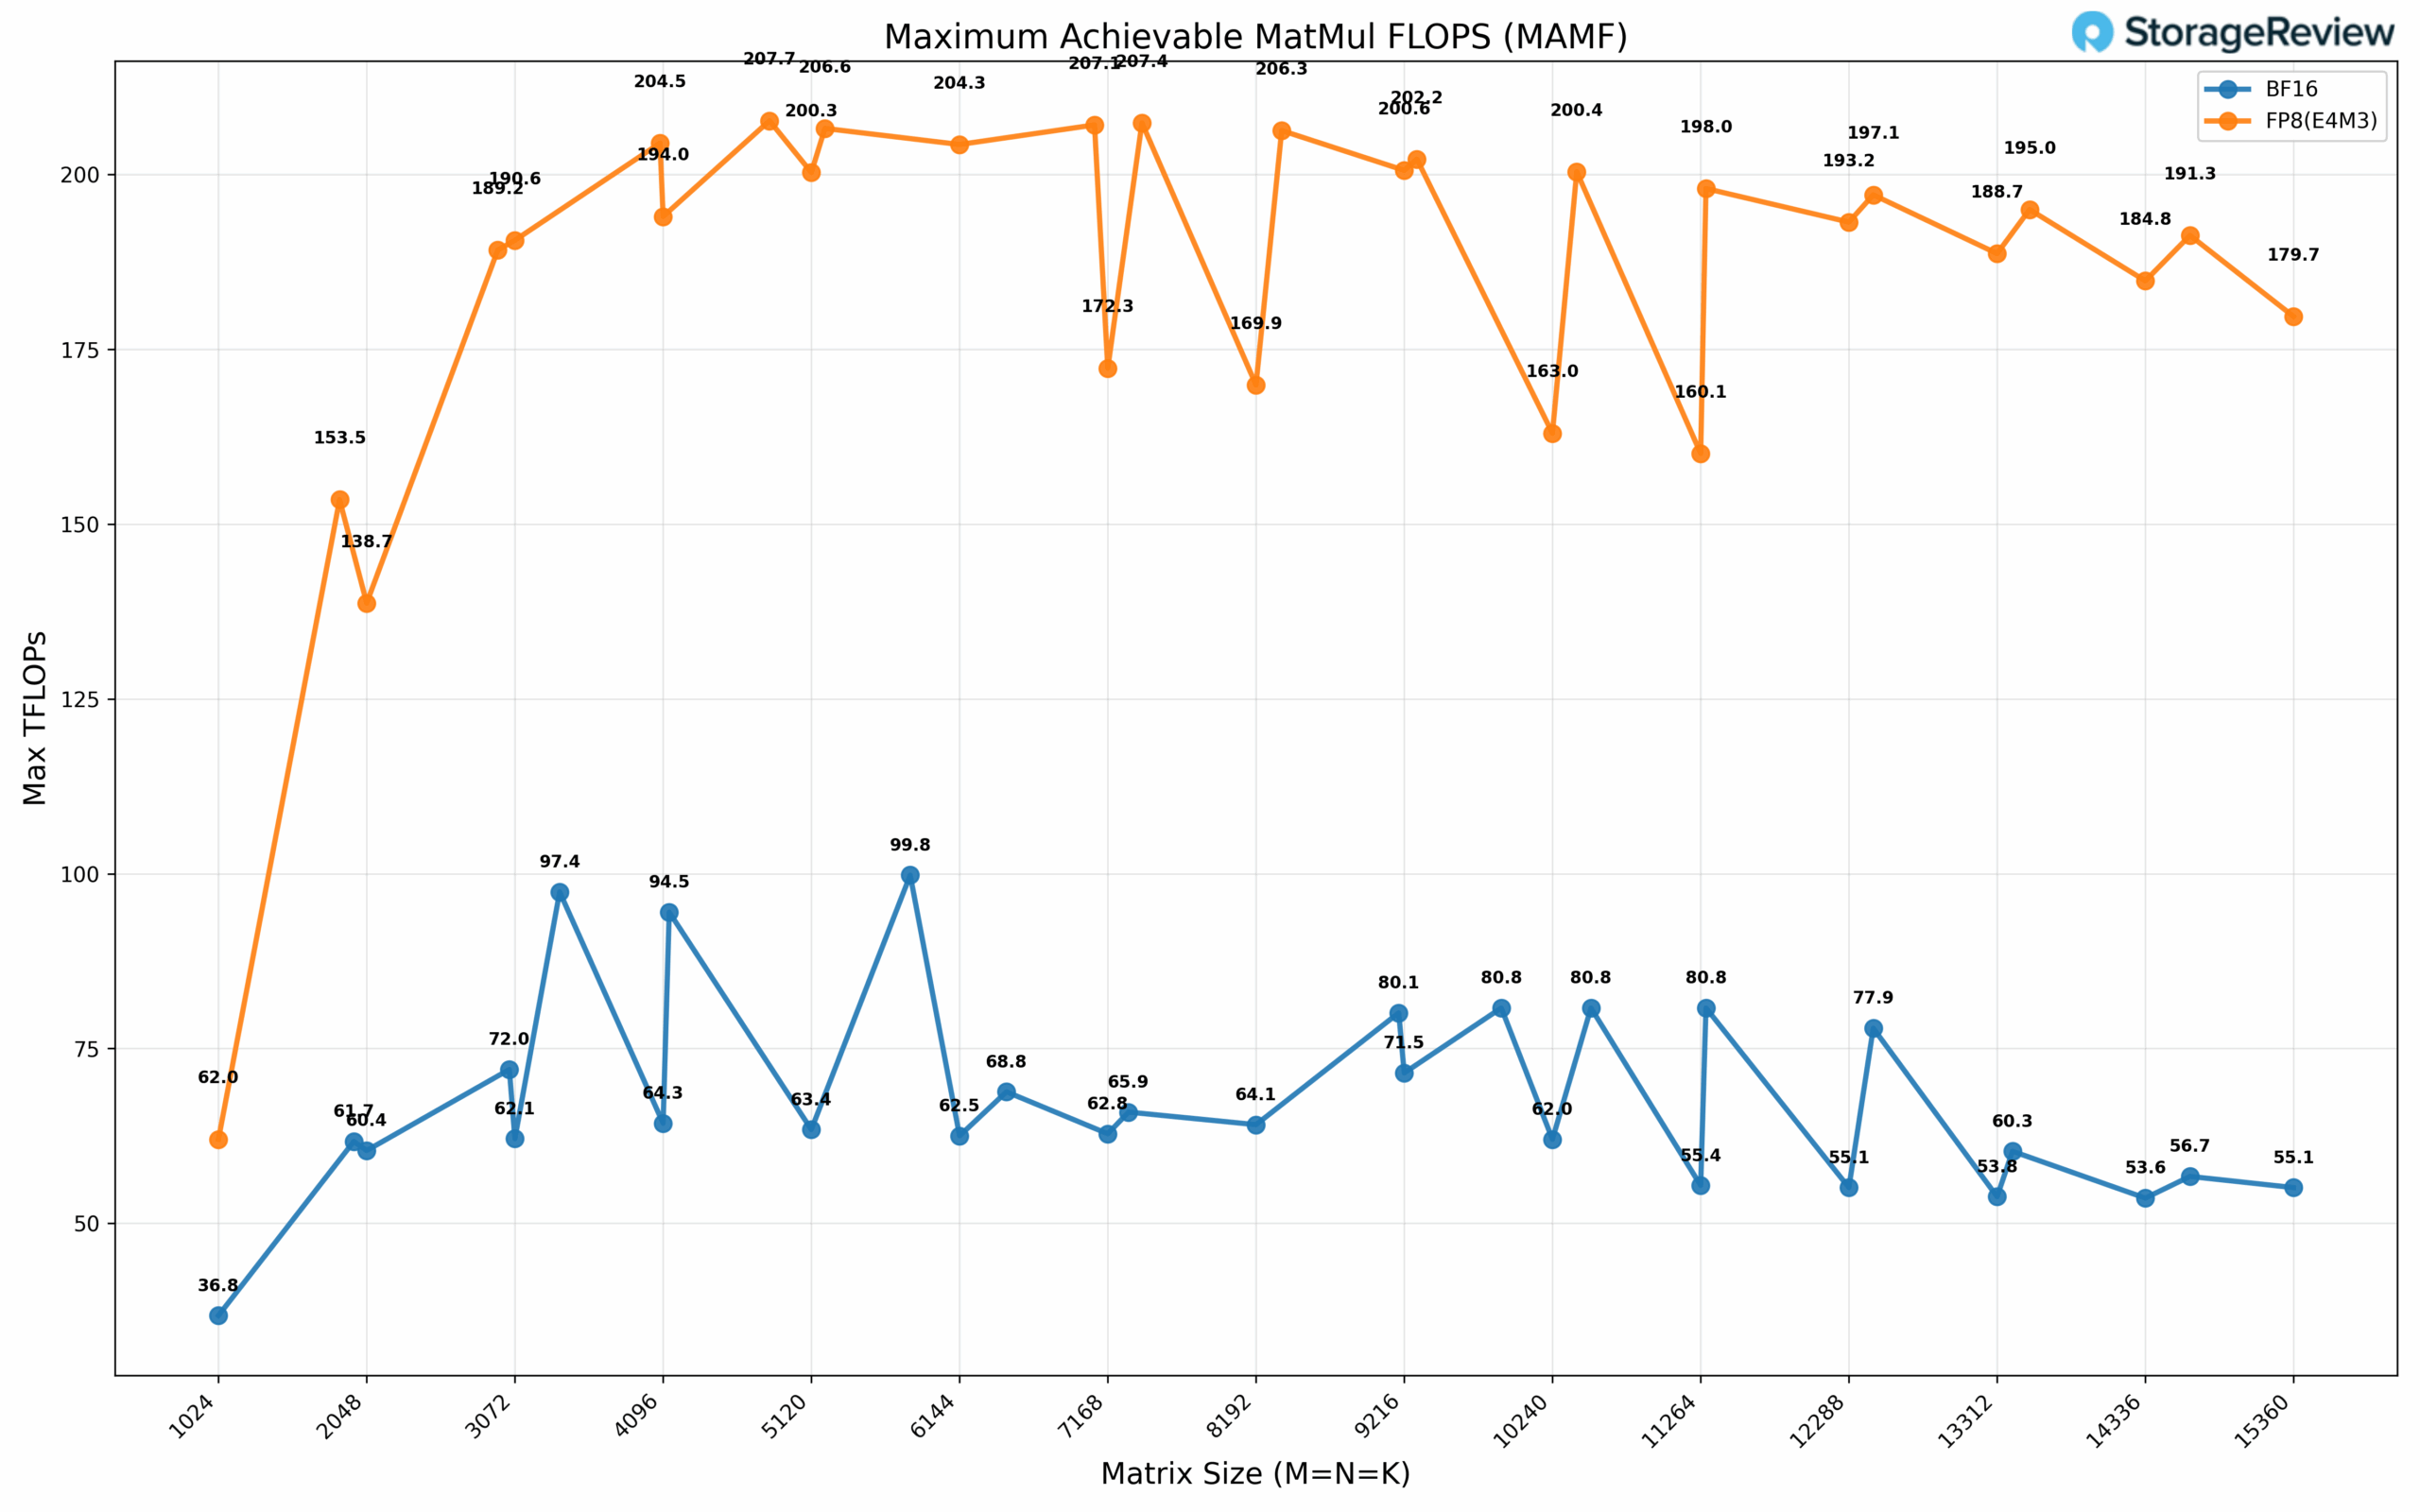
BF16 တိကျမှုတွင်၊ ကျွန်ုပ်တို့သည် 99.8 TFLOPs ၏ MAMF ကိုတွေ့ရှိရပြီး FP8 (E4M3) သည် 207.7 TFLOPs ၏ MAMF ကိုပြသသည်။ အချိန်ကန့်သတ်ချက်များကြောင့်၊ ကျွန်ုပ်တို့သည် ပြည့်စုံသော FP4 MAMF လက္ခဏာရပ်ကို မလုပ်ဆောင်နိုင်ခဲ့ပေ။ သို့သော်၊ တွေ့ရှိထားသော တိကျမှုအခြေခံ scaling ပုံစံများမှ ခန့်မှန်းတွက်ချက်ခြင်းဖြင့်၊ FP8 ထက် 2× စွမ်းဆောင်ရည်တိုးတက်မှုကို နောက်ထပ်မျှော်လင့်ထားပြီး၊ သိပ်သည်းသော FP4 လုပ်ဆောင်ချက်များအတွက် 400 TFLOPs ခန့်ရရှိစေသည်။ 2:1 ဖွဲ့စည်းတည်ဆောက်ထားသော sparsity optimization ကိုထည့်သွင်းစဉ်းစားသောအခါ၊ ၎င်းသည် သီအိုရီ FP4 စွမ်းဆောင်ရည်စွမ်းရည်၏ 80% ခန့်ကို ဘာသာပြန်ဆိုပေးပြီး၊ sparse computational workloads များအောက်တွင် 800 TFLOPs ခန့်ကိုရရှိစေသည်။ ဤ MAMF တိုင်းတာမှုများသည် ဤသုံးသပ်ချက်တွင် ကျွန်ုပ်တို့မဖော်ပြမည့် အကြောင်းရင်းများစွာကြောင့် သီအိုရီအရ ကြော်ငြာထားသော သတ်မှတ်ချက်များအောက်တွင် ကျဆင်းနိုင်ကြောင်း သတိပြုရန်အရေးကြီးပါသည်။
GPU တိုက်ရိုက်သိုလှောင်မှု
Spark မှာ ကျွန်တော်တို့ ပြုလုပ်ခဲ့တဲ့ စမ်းသပ်မှုတွေထဲက တစ်ခုကတော့ MagnumIO GPU Direct Storage (GDS) စမ်းသပ်မှုပါ။ GDS ဆိုတာ NVIDIA မှ တီထွင်ထားတဲ့ လုပ်ဆောင်ချက်တစ်ခုဖြစ်ပြီး NVMe drives တွေ ဒါမှမဟုတ် တခြားမြန်နှုန်းမြင့် storage devices တွေမှာ သိမ်းဆည်းထားတဲ့ data တွေကို access လုပ်တဲ့အခါ GPU တွေကို CPU ကိုကျော်ပြီး လုပ်ဆောင်နိုင်စေပါတယ်။ CPU နဲ့ system memory ကနေတစ်ဆင့် data တွေကို routing လုပ်မယ့်အစား GDS က GPU နဲ့ storage device အကြား တိုက်ရိုက်ဆက်သွယ်မှုကို ဖြစ်စေပြီး latency ကို သိသိသာသာ လျှော့ချပေးပြီး data throughput ကို တိုးတက်စေပါတယ်။
GPU Direct Storage ဘယ်လိုအလုပ်လုပ်လဲ
ရိုးရာအစဉ်အလာအရ GPU တစ်ခုက NVMe drive မှာသိမ်းဆည်းထားတဲ့ဒေတာတွေကို စီမံဆောင်ရွက်တဲ့အခါ ဒေတာဟာ GPU ဆီကိုမရောက်ခင် CPU နဲ့ system memory ကနေတစ်ဆင့် ဦးစွာဖြတ်သန်းသွားရပါမယ်။ ဒီလုပ်ငန်းစဉ်က CPU ဟာ ကြားခံတစ်ခုဖြစ်လာတာကြောင့် နှောင့်နှေးမှုကို တိုးစေပြီး အဖိုးတန် system resource တွေကို သုံးစွဲတာကြောင့် ပိတ်ဆို့မှုတွေကို ဖြစ်ပေါ်စေပါလိမ့်မယ်။ GPU Direct Storage က GPU ကို PCIe bus မှတစ်ဆင့် storage device ကနေ တိုက်ရိုက်ဒေတာတွေကို ရယူနိုင်အောင် လုပ်ပေးခြင်းအားဖြင့် ဒီထိရောက်မှုမရှိခြင်းကို ဖယ်ရှားပေးပါတယ်။ ဒီတိုက်ရိုက်လမ်းကြောင်းက ဒေတာရွှေ့ပြောင်းမှုနဲ့ဆက်စပ်တဲ့ overhead ကို လျော့ကျစေပြီး ဒေတာလွှဲပြောင်းမှုတွေကို ပိုမိုမြန်ဆန်ထိရောက်စေပါတယ်။
AI workloads များ၊ အထူးသဖြင့် deep learning ပါဝင်သည့် workloads များသည် data များစွာအသုံးပြုရပါသည်။ ကြီးမားသော neural network များကို လေ့ကျင့်ပေးရန်အတွက် data terabytes များကို processing လုပ်ရန် လိုအပ်ပြီး data transfer နှောင့်နှေးမှုတစ်စုံတစ်ရာသည် GPU များကို အသုံးမချနိုင်ခြင်းနှင့် လေ့ကျင့်ချိန်ပိုကြာခြင်းတို့ ဖြစ်စေနိုင်ပါသည်။ GPU Direct Storage သည် data ကို GPU သို့ အမြန်ဆုံးပေးပို့ခြင်း၊ အားလပ်ချိန်ကို အနည်းဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းနှင့် တွက်ချက်မှုစွမ်းဆောင်ရည်ကို အမြင့်ဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းဖြင့် ဤစိန်ခေါ်မှုကို ဖြေရှင်းပေးပါသည်။
ထို့အပြင်၊ GDS သည် ဗီဒီယိုလုပ်ဆောင်ခြင်း၊ သဘာဝဘာသာစကားလုပ်ဆောင်ခြင်း သို့မဟုတ် အချိန်နှင့်တပြေးညီ ကောက်ချက်ချခြင်းကဲ့သို့သော ဒေတာအစုအဝေးကြီးများကို streaming လုပ်ခြင်းပါဝင်သည့် workloads များအတွက် အထူးအကျိုးရှိပါသည်။ CPU အပေါ် မှီခိုမှုကို လျှော့ချခြင်းဖြင့် GDS သည် ဒေတာရွှေ့ပြောင်းမှုကို အရှိန်မြှင့်ပေးပြီး အခြားအလုပ်များအတွက် CPU အရင်းအမြစ်များကို လွတ်လပ်စေပြီး စနစ်စွမ်းဆောင်ရည်ကို ပိုမိုမြှင့်တင်ပေးပါသည်။
GDSIO – အတွင်းပိုင်း 4 TB M.2
NVIDIA DGX Spark မှာ သိုလှောင်မှုအတွက် စိတ်ဝင်စားစရာကောင်းတဲ့ ရွေးချယ်မှုတစ်ခုရှိပါတယ်။ သေးငယ်တဲ့ case အတွင်းမှာ အရွယ်အစားထည့်သွင်းစဉ်းစားဖို့အတွက် NVIDIA က အသုံးနည်းတဲ့ Gen5 2242 M.2 SSD ကို ရွေးချယ်ခဲ့ပါတယ်။ ဒီ SSD အမျိုးအစားနဲ့ မရင်းနှီးတဲ့ စာဖတ်သူတွေအတွက် desktop မှာ ပိုအသုံးများတဲ့ 80mm ထက် ပိုတိုတဲ့ 42mm ဗားရှင်းဖြစ်ပါတယ်။ ဒီအရွယ်အစားမှာ အမြင့်ဆုံးစွမ်းရည်က 4 TB ဖြစ်လို့ drive ရွေးချယ်စရာ နည်းပါတယ်။ ဒါပေမယ့် အဓိကပြဿနာက စွမ်းဆောင်ရည်ပါ။ 2242 နဲ့ 2230 မော်ဒယ်တွေလို သေးငယ်တဲ့ SSD တွေက အရွယ်အစားထည့်သွင်းစဉ်းစားမှုကို ဦးစားပေးပြီး drive speed တွေကို ဒုတိယနေရာမှာ ထားရှိပါတယ်။ ၎င်းတို့ကို သယ်ဆောင်ရလွယ်ကူတဲ့ ဂိမ်းစက်များ၊ တက်ဘလက်များနှင့် notebook အချို့တွင် အဖြစ်များပါတယ်။
2230 နှင့် 2242 SSD PCB တွင် နေရာသိပ်မရှိသောကြောင့် controller များ၊ DRAM နှင့် NAND package များအတွက် နေရာနည်းသွားပါသည်။ ကျွန်ုပ်တို့၏ စမ်းသပ်မှုအတွင်း ဤအပေးအယူအချို့ကို ကျွန်ုပ်တို့ တွေ့ရှိခဲ့ပါသည်။ ကျွန်ုပ်တို့၏ GDSIO workload ကို 1 TB သို့မဟုတ် 128 GB footprint တွင် အသုံးပြုသောအခါ SSD သည် lock ဖြစ်ပြီး Spark ကို ပြန်လည် imaging လုပ်ရန် လိုအပ်ပါသည်။ စမ်းသပ်မှု footprint ကို 64 GB သို့ လျှော့ချခြင်းအပြင် thread အရေအတွက် မြင့်မားခြင်းကို လျှော့ချခြင်းဖြင့် ဤပြဿနာကို ဖြေရှင်းနိုင်ခဲ့သည်။ ဤပြဿနာများသည် ယေဘုယျအားဖြင့် ပိုမိုအဖြစ်များသော စွမ်းဆောင်ရည်မြင့် 80mm SSD များတွင် မဖြစ်ပေါ်ပါ။
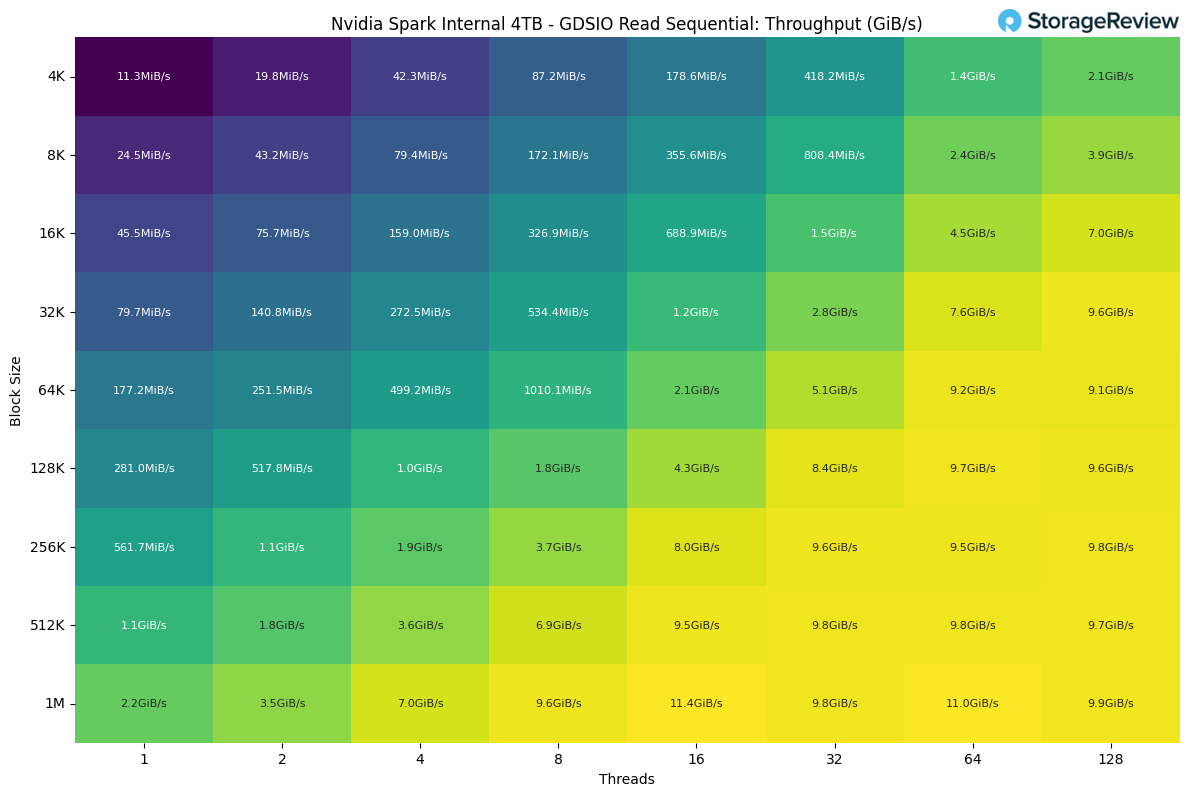
internal drive ရဲ့ Sequential Read စွမ်းဆောင်ရည်ကို ကြည့်မယ်ဆိုရင် 1M block size မှာ thread ၁၆ ခုနဲ့ အမြင့်ဆုံး throughput ကို 11.4 GiB/s ရရှိတာကို တွေ့ရပါတယ်။
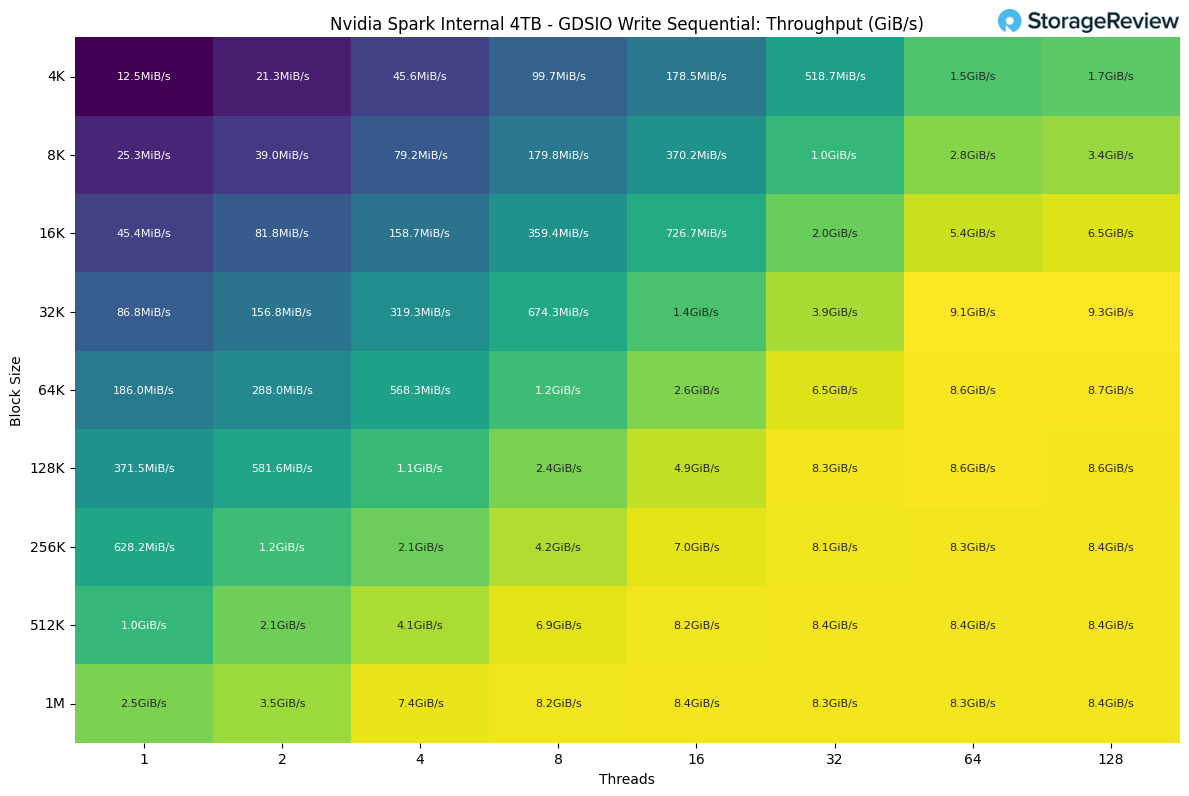
Sequential Write စွမ်းဆောင်ရည်ကို ကြည့်မယ်ဆိုရင် drive ဟာ thread ၁၆ ခုနဲ့ 32k block size မှာ အမြင့်ဆုံး throughput ကို ရရှိပါတယ်။ block size ကြီးတွေမှာ စွမ်းဆောင်ရည်က တည်ငြိမ်နေပြီး ပျမ်းမျှ 8.3 GiB/s ဝန်းကျင်မှာ ရှိပါတယ်။
NVIDIA DGX Spark ကို ပိုမိုလေးလံသော ဖွံ့ဖြိုးတိုးတက်ရေးလုပ်ငန်းများအတွက် ဝယ်ယူလိုသော ဝယ်ယူသူများအတွက်၊ အထူးသဖြင့် ၎င်းတို့မှ သေးငယ်သော cluster များပြုလုပ်နိုင်သည့် စီးပွားရေးလုပ်ငန်းများအတွက်၊ onboard 200Gb NVIDIA ConnectX-7 NIC ကို အသုံးပြုရန် အထူးအကြံပြုလိုပါသည်။
GDSIO – RDMA မှတစ်ဆင့် NVMe-oF
NVIDIA DGX Spark ဖြင့် NVMe-oF RDMA စမ်းသပ်မှုအတွက်၊ ကျွန်ုပ်တို့သည် PEAK:AIO ၏ software ကို အသုံးပြု၍ Micron 9550 3.84TB SSD ခြောက်လုံးပါသည့် Dell PowerEdge R770 တွင် NVMe-oF ပစ်မှတ်တစ်ခု ဖန်တီးခဲ့ပြီး RDMA မှတစ်ဆင့် ချိတ်ဆက်ထားသည်။ ယခင်က ကျွန်ုပ်တို့ဖော်ပြခဲ့သည့်အတိုင်း၊ Spark ၏ CX7 NIC တွင် ထူးခြားချက်များရှိပြီး အချိန်ကန့်သတ်ချက်များကြောင့် Spark ကို 100G ချိတ်ဆက်မှုဖြင့်သာ စမ်းသပ်နိုင်ခဲ့သည်။ Spark နှင့် PEAK:AIO နှစ်ခုစလုံးသည် သိသိသာသာမြင့်မားသော နံပါတ်များကို ရရှိနိုင်သည်။ နောက်ပိုင်းအပိုင်းများတွင် Spark ဖြင့် အပိုသိုလှောင်မှုနှင့် ကွန်ရက်စမ်းသပ်မှုများကို ပြုလုပ်သွားပါမည်။
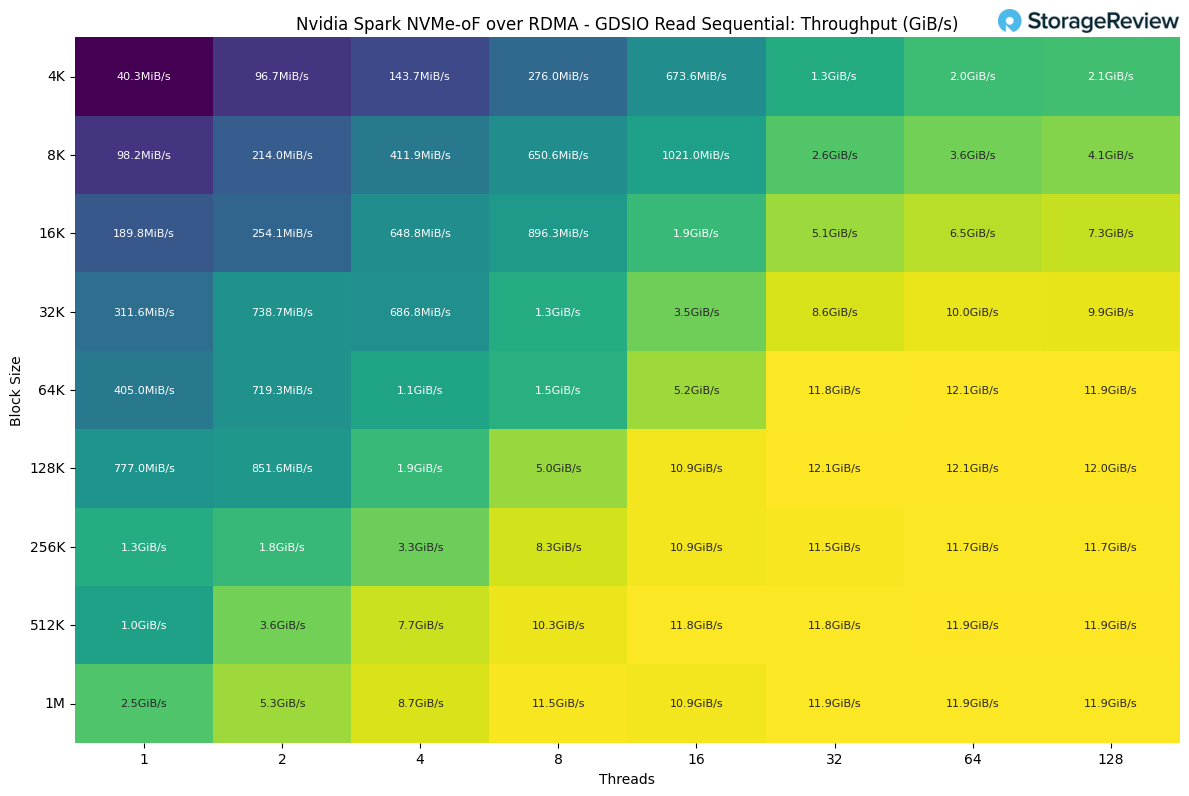
internal drive ရဲ့ Sequential Read စွမ်းဆောင်ရည်ကို ကြည့်မယ်ဆိုရင် thread 32 ခုနဲ့ 128k block size မှာ အမြင့်ဆုံး throughput ကို 12.1 GiB/s ရရှိတာကို တွေ့ရပါတယ်။
Sequential Write စွမ်းဆောင်ရည်ကို ကြည့်မယ်ဆိုရင် drive ဟာ thread ၁၆ ခုနဲ့ 128k block size မှာ အမြင့်ဆုံး throughput ကို ရရှိပါတယ်။ block size ကြီးတွေမှာ စွမ်းဆောင်ရည်က တည်ငြိမ်နေပြီး ပျမ်းမျှ 11.3 GiB/s ဝန်းကျင်မှာ ရှိပါတယ်။
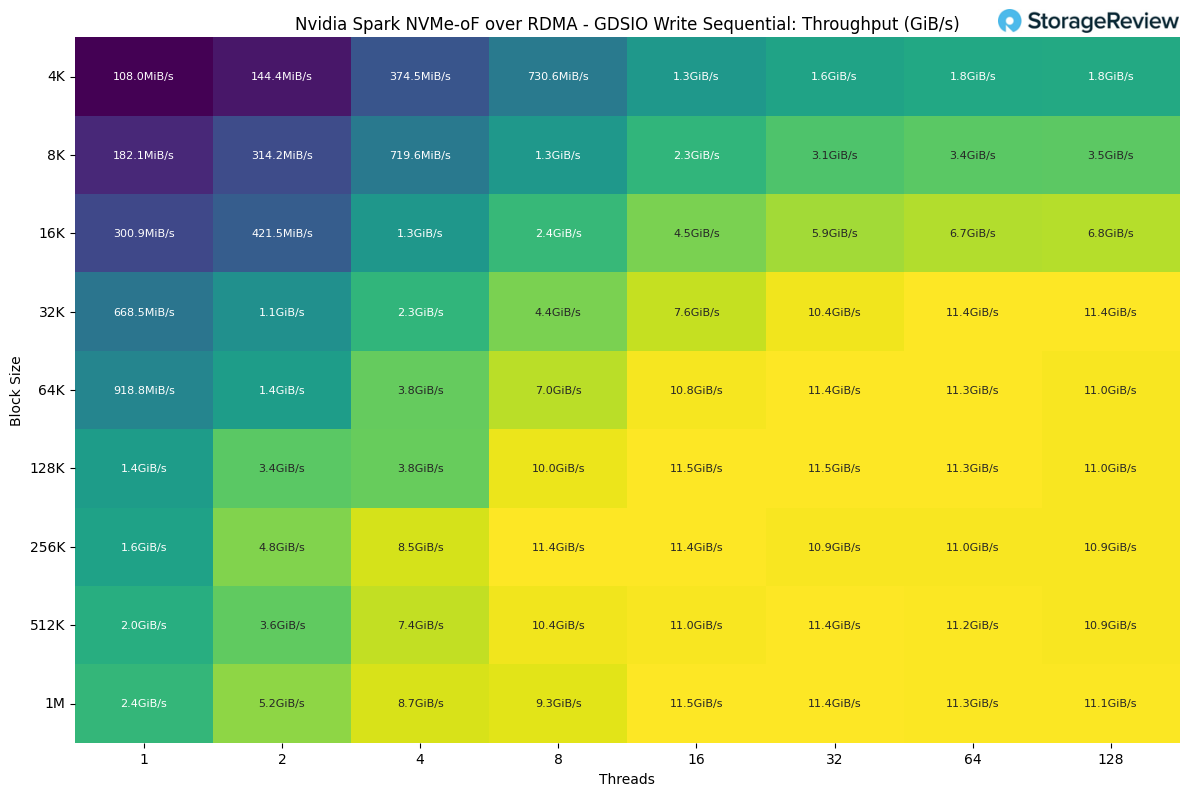
ဒီရလဒ်တွေမှာ ကွဲပြားချက်တွေ အများကြီးရှိပါတယ်၊ အထက်ဖော်ပြပါ အချိန်နဲ့ ကွန်ရက်ဆက်စပ်မှုဆိုင်ရာ အကြောင်းပြချက်တွေကြောင့် သီအိုရီအရ အမြင့်ဆုံးပမာဏရဲ့ တစ်ဝက်ကိုသာ ကျွန်တော်တို့ မြင်တွေ့နေရပါတယ်။ ထို့အပြင် 128k blocksize မှာ အမြင့်ဆုံး throughput ဟာ ကျွန်တော်တို့အသုံးပြုခဲ့တဲ့ enterprise drives တွေ ဒါမှမဟုတ် PEAK:AIO က ဒီ IO ကို ဘယ်လိုကိုင်တွယ်သလဲ စတဲ့ အချက်များစွာပေါ် မူတည်ပါတယ်၊ သင့်ရဲ့ မိုင်အကွာအဝေး ကွဲပြားနိုင်ပြီး အနာဂတ်မှာ spark နဲ့ စမ်းသပ်ခြင်းအားဖြင့် ပိုမိုလုပ်ဆောင်ဖို့ ရည်ရွယ်ထားပါတယ်။
ပထမနေ့ ဆော့ဖ်ဝဲ ဂေဟစနစ်
NVIDIA နှင့် အခြားရောင်းချသူများသည် software readiness တွင် သိသိသာသာ ရင်းနှီးမြှုပ်နှံခဲ့ကြပြီး၊ အစောပိုင်းအသုံးပြုသူများသည် မပြည့်စုံသောစာရွက်စာတမ်းများနှင့် ပျောက်ဆုံးနေသော tooling များကို ဖြတ်သန်းရသည့် ပုံမှန် hardware မိတ်ဆက်ပွဲများနှင့် လုံးဝကွဲပြားပါသည်။ Spark သည် ဘုံ workflow များကို လွှမ်းခြုံထားသော ပြည့်စုံသော playbook များဖြင့် မိတ်ဆက်ခဲ့သည်- diffusion model များအတွက် ComfyUI၊ optimized inference အတွက် TRT-LLM၊ local model serving အတွက် Open WebUI ပါသော Ollama၊ fine-tuning အတွက် Unsloth နှင့် LangGraph ပါသော multi-agent architectures။
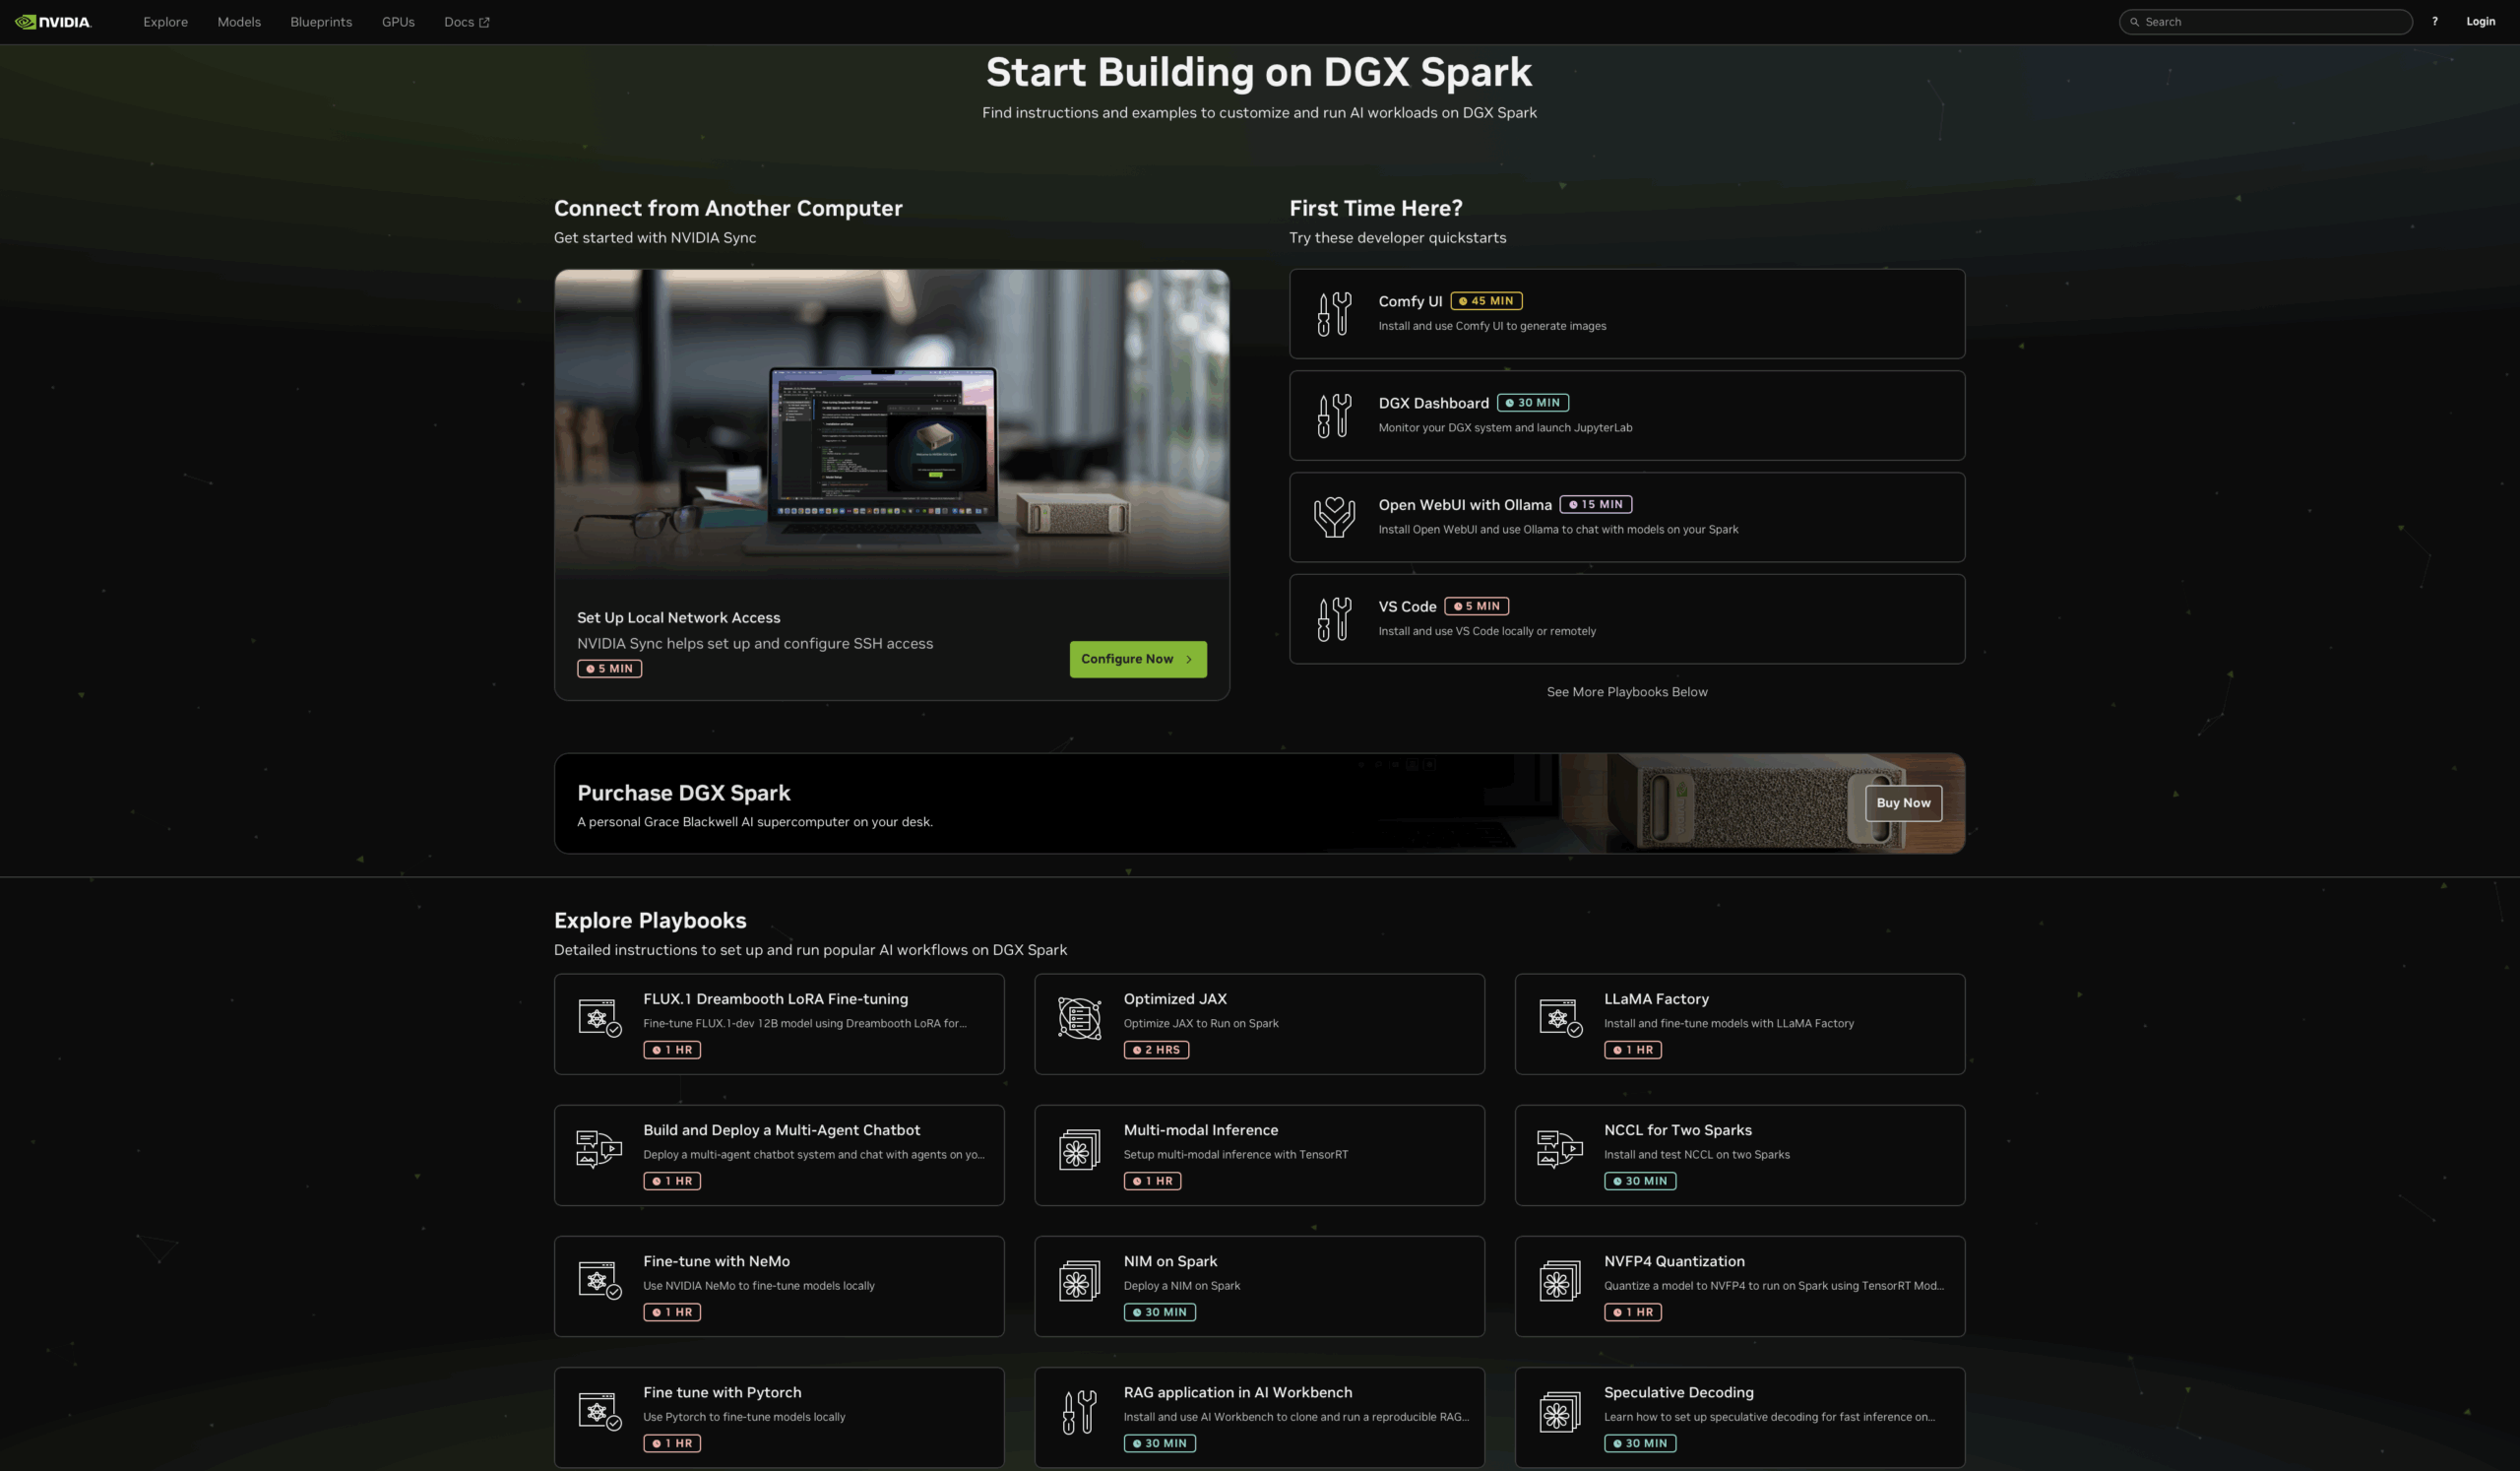
ဤဆော့ဖ်ဝဲလ် ရင့်ကျက်မှုသည် အကဲဖြတ်ခြင်း အတွေ့အကြုံကို ပြောင်းလဲစေသည်။ ပတ်ဝန်းကျင်များကို ပြင်ဆင်ရန် ရက်ပေါင်းများစွာ အချိန်ကုန်ခံမည့်အစား developer များသည် Spark သည် ကိုယ်စားပြု workloads များကို လုပ်ဆောင်ခြင်းဖြင့် ၎င်းတို့၏ လိုအပ်ချက်များနှင့် ကိုက်ညီမှုရှိမရှိကို ချက်ချင်း အကဲဖြတ်နိုင်သည်။ playbook များသည် ညွှန်ကြားချက်များသာမက containerized ပတ်ဝန်းကျင်များ၊ နမူနာ dataset များနှင့် မျှော်လင့်ထားသော စွမ်းဆောင်ရည် မက်ထရစ်များကိုလည်း ပေးပါသည်။
ရရှိနိုင်မှုနှင့် OEM စနစ်များ
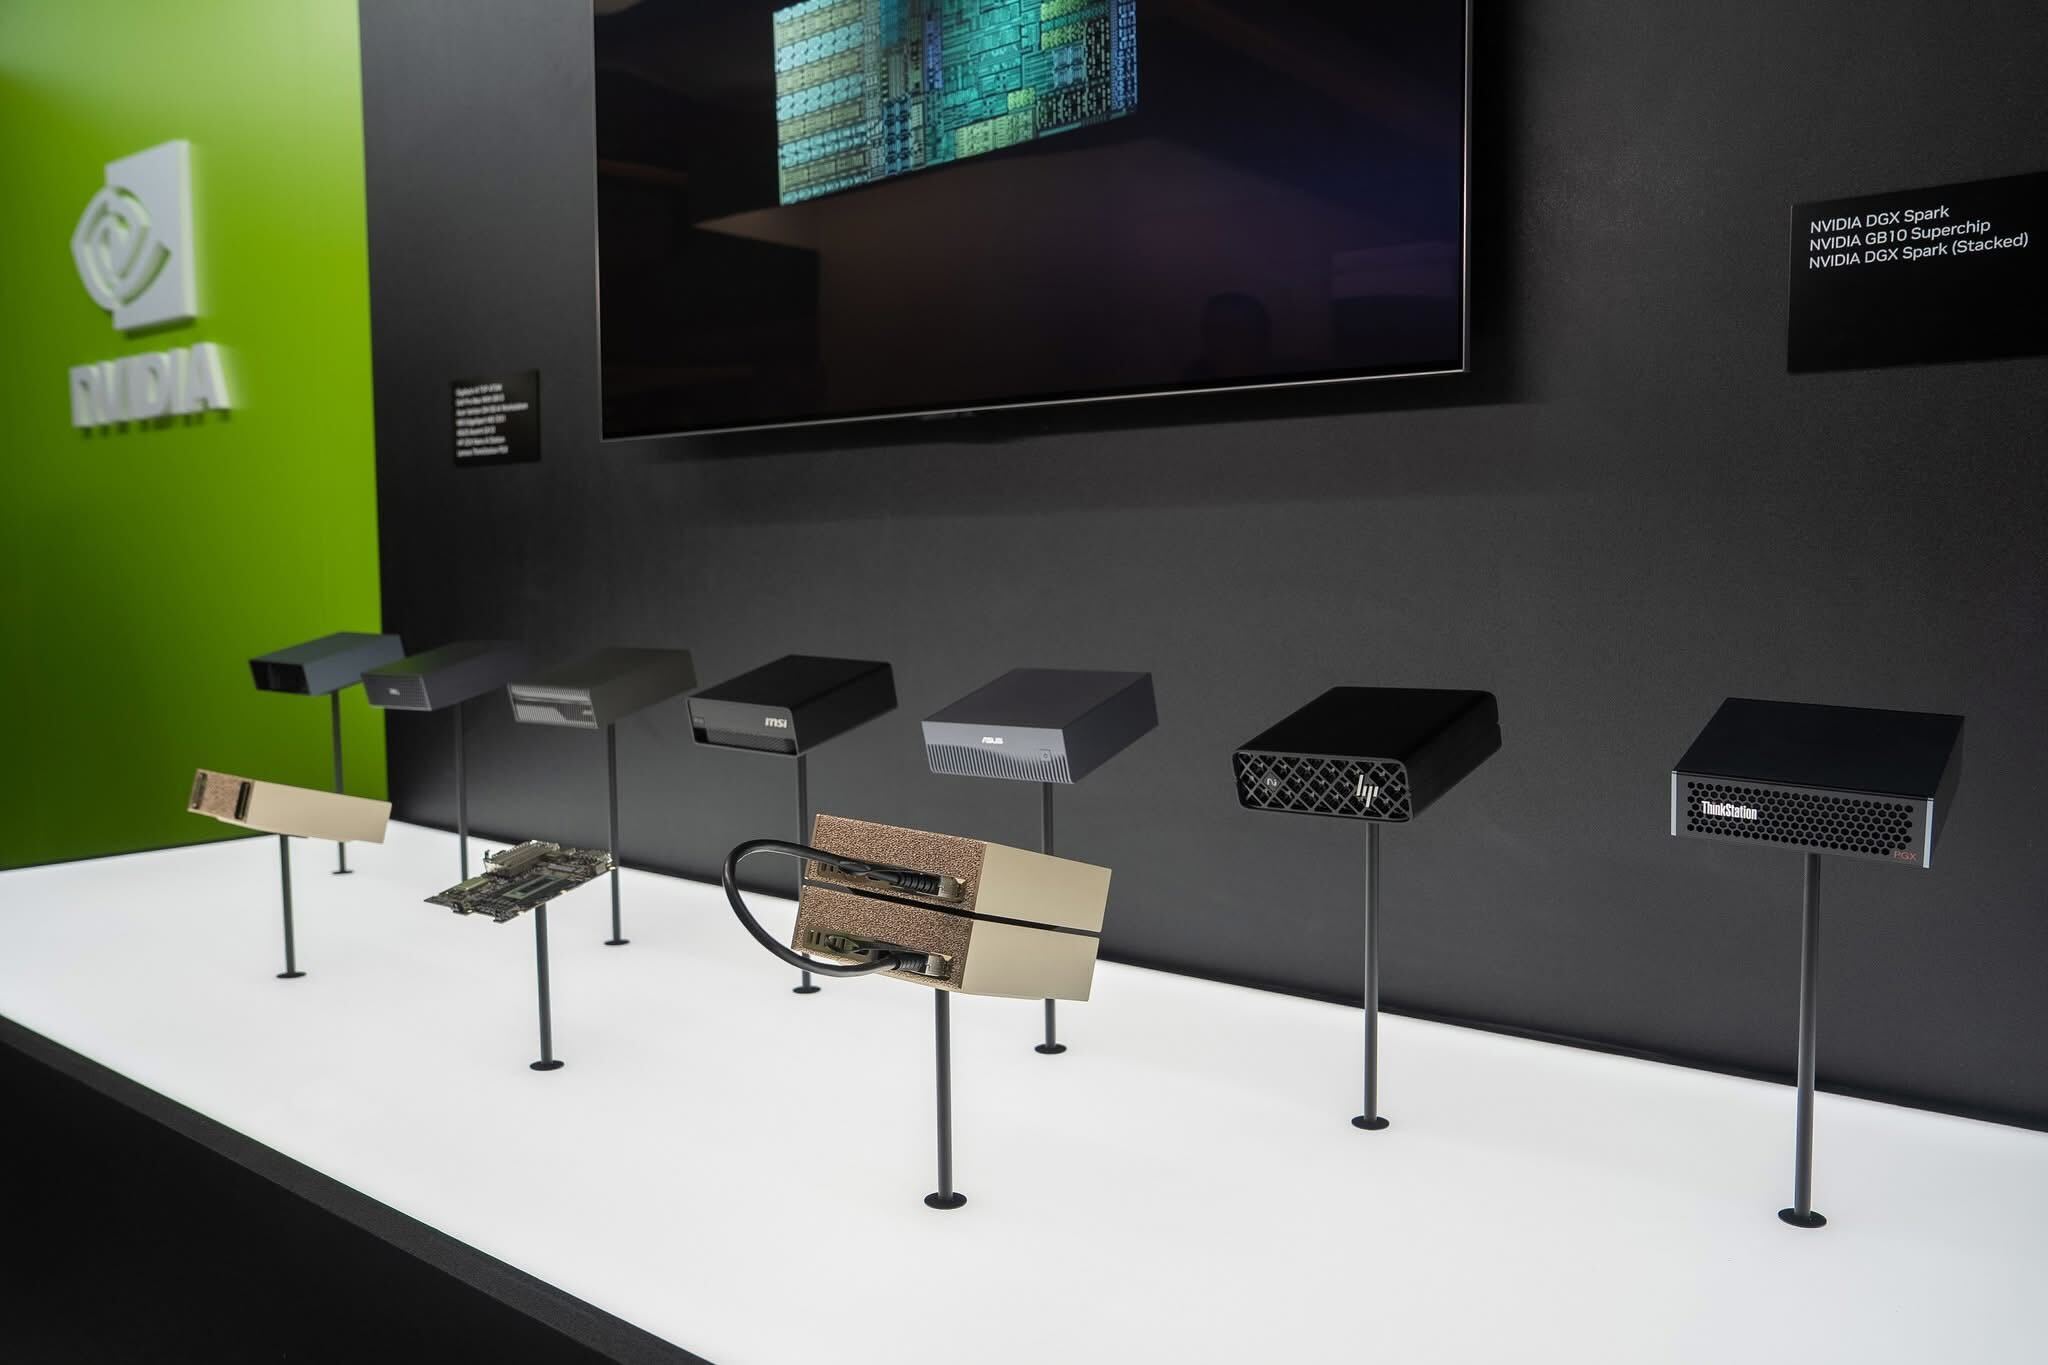
NVIDIA ရဲ့ Founders Edition ကို 4TB configuration အတွက် $3,999 နဲ့ မှာယူနိုင်မှာဖြစ်ပြီး အောက်တိုဘာလ ၁၅ ရက်နေ့မှာ ယေဘုယျအားဖြင့် ရရှိနိုင်မှာဖြစ်ပါတယ်။ NVIDIA ရဲ့ကိုယ်ပိုင်ယူနစ်နဲ့အတူ GB10 desktop အများအပြားဟာ OEM ကြီးတွေဆီကနေ ရောက်ရှိလာတော့မှာပါ။ core hardware တွေက OEM အားလုံးမှာ အတော်လေးဆင်တူပေမယ့် ခွဲခြားဖို့ အနည်းငယ်နေရာလွတ်ရှိနိုင်ပေမယ့် ဈေးနှုန်းကွာခြားမှုအများစုဟာ storage ရွေးချယ်မှုကြောင့် ဖြစ်နိုင်ပါတယ်။ GB 10 ပါဝင်တဲ့ Dell Pro Max၊ Lenovo ThinkStation PGX၊ Acer Veriton GN100 နဲ့ ASUS Ascent GX10 အပါအဝင် ကြေငြာချက်များစွာကို ကျွန်ုပ်တို့တွေ့မြင်ခဲ့ရပြီးဖြစ်ပါတယ်။
အရင်းအမြစ်: Nvidia
ကောက်ချက်
NVIDIA DGX Spark သည် အဆင့်မြင့် AI computing အခြေခံအဆောက်အအုံ၏ အသုံးပြုရလွယ်ကူမှုပုံစံတွင် အခြေခံကျသော ပြောင်းလဲမှုအမှတ်တစ်ခုကို ကိုယ်စားပြုသည်။ GB10 Grace Blackwell Superchip ၏ စွမ်းရည်များဖြစ်သည့် 128 GB unified memory၊ 1 petaFLOP sparse FP4 စွမ်းဆောင်ရည်၊ စတုတ္ထမျိုးဆက် RT Cores နှင့် ConnectX-7 networking တို့ကို ဒေါ်လာ ၃,၉၉၉ ဖြင့် စျေးနှုန်းသတ်မှတ်ထားသော 240W၊ 1.13-liter appliance ထဲသို့ ပေါင်းစည်းခြင်းဖြင့် NVIDIA သည် datacenter-class AI စွမ်းရည်များကို တစ်ဦးချင်းသုတေသီများနှင့် ဖွံ့ဖြိုးတိုးတက်ရေးအဖွဲ့ငယ်များမှ သမိုင်းကြောင်းအရ ခွဲခြားထားသော အတားအဆီးများကို ထိရောက်စွာ ဖြိုခွင်းနိုင်ခဲ့သည်။
အတည်ပြုထားသော ကိရိယာချဉ်းကပ်မှုသည် AI အခြေခံအဆောက်အအုံ ဖြန့်ကျက်မှုတွင် အမြဲတမ်း ပွတ်တိုက်မှုအချက်တစ်ခုဖြစ်သည့် စိတ်ကြိုက်ဖွဲ့စည်းမှုများကို ထိန်းသိမ်းခြင်း၏ လုပ်ငန်းလည်ပတ်မှုဆိုင်ရာ ဝန်ထုပ်ဝန်ပိုးကို ကိုင်တွယ်ဖြေရှင်းပေးသည်။ Spark ယူနစ်များကို ဖြန့်ကျက်နေသော အဖွဲ့အစည်းများသည် DGX OS၊ CUDA toolkit၊ framework containers နှင့် hardware firmware အပါအဝင် NVIDIA ၏ ပြီးပြည့်စုံသော stack ၏ ပြည့်စုံသော စမ်းသပ်မှုနှင့် အတည်ပြုချက်မှ အကျိုးကျေးဇူးရရှိပြီး custom workstation တည်ဆောက်မှုများကို ထိခိုက်စေသော ဖွဲ့စည်းပုံအကြွေးကို ဖယ်ရှားပေးသည်။ DGX Dashboard ၏ ပေါင်းစပ်ထားသော update စီမံခန့်ခွဲမှု၊ စနစ်စောင့်ကြည့်ခြင်းနှင့် JupyterLab ပံ့ပိုးပေးခြင်းတို့က လုပ်ငန်းလည်ပတ်မှုဝန်ထုပ်ဝန်ပိုးကို ပိုမိုလျှော့ချပေးပြီး NVIDIA Sync ၏ အလိုအလျောက် SSH key ဖြန့်ဖြူးမှုနှင့် tunnel စီမံခန့်ခွဲမှုတို့က အဝေးထိန်းဝင်ရောက်ခွင့်ကို အမှန်တကယ် ပွတ်တိုက်မှုမရှိစေပါ။ ချဲ့ထွင်နေသော အဖွဲ့အစည်းများအတွက်၊ ၎င်းသည် တိုင်းတာ၍ရနိုင်သော ပိုမိုမြန်ဆန်သော onboarding ကို ဘာသာပြန်ဆိုသည်- သုတေသီအသစ်များသည် စံသတ်မှတ်ထားသော hardware ကို ရရှိကြပြီး အတည်ပြုထားသော two-node clustering configuration မှတစ်ဆင့် ရှိပြီးသား အခြေခံအဆောက်အအုံနှင့် ချိတ်ဆက်ကာ driver ပဋိပက္ခများ သို့မဟုတ် network fabric configuration ကို ပြဿနာရှာဖွေဖြေရှင်းရန် ရက်များအစား နာရီပိုင်းအတွင်း ထိရောက်သောအလုပ်ကို စတင်ကြသည်။
DGX Spark သည် ကျစ်လစ်ပြီး တိတ်ဆိတ်သော စက်ပစ္စည်းတစ်ခုတွင် စစ်မှန်သော AI စွမ်းအားကို ပေးစွမ်းနိုင်ပြီဖြစ်ပြီး ကျွန်ုပ်တို့၏ အစောပိုင်းရလဒ်များက datacenter overhead မပါဘဲ လေးနက်သောစွမ်းရည်ကို လိုချင်သော အဖွဲ့များအတွက် အဘယ်ကြောင့် အရေးကြီးကြောင်း ပြသနေပါသည်။ ဇာတ်လမ်းသည် ယခုမှစတင်ပါသည်။ scaling efficiency၊ ပိုကြီးသော model footprints နှင့် shared storage architectures များကို စူးစမ်းလေ့လာရန် 200G fabric၊ NVMe-oF targets နှင့် multi-node clustering တို့ဖြင့် ကျွန်ုပ်တို့၏ စမ်းသပ်မှုကို တိုးချဲ့ရန် စီစဉ်ထားပါသည်။ software နှင့် partner ecosystem ရင့်ကျက်လာသည်နှင့်အမျှ Spark ဖြန့်ကျက်မှုများသည် အစွမ်းထက်သော single-node setups များမှ ဤ platform ကို ပိုမိုမြှင့်တင်ပေးသည့် tightly integrated၊ high-throughput mini clusters များအဖြစ် ပြောင်းလဲလာမည်ဟု မျှော်လင့်ပါသည်။

ဦးဆောင်သူစာရင်း- NVIDIA DGX Spark သည် ကျွန်ုပ်တို့၏ Best Desktops for Local AI ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံး Deskside AI System နေရာကို ရယူထားသည် ။
ဦးဆောင်သူစာရင်း- ဤစနစ်အမျိုးအစားအတွက် အရွယ်အစားလမ်းညွှန်ချက်သည် ကျွန်ုပ်တို့၏ RAM၊ GPU နှင့် Agentic AI အတွက်သိုလှောင်မှု လမ်းညွှန်တွင်ရှိသည်။


 အမေဇုံ