

၂၀၂၅ ခုနှစ်၊ ဇန်နဝါရီလ ၃၀ ရက်နေ့တွင် MSRP $1,999 ဖြင့် စတင်ရောင်းချမည့် NVIDIA GeForce RTX 5090 သည် မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော ဂိမ်းကစားခြင်းနှင့် AI workloads များကို ပြန်လည်သတ်မှတ်ပေးမည်ဖြစ်သည်။ Blackwell ဗိသုကာပေါ်တွင် တည်ဆောက်ထားသော ဤ flagship GPU သည် 32GB GDDR7 memory၊ 512-bit memory bus နှင့် CUDA၊ Tensor နှင့် RT core စွမ်းဆောင်ရည်တို့တွင် များစွာတိုးတက်မှုတို့ဖြင့် တွက်ချက်မှုစွမ်းအား၏ နယ်နိမိတ်များကို တွန်းအားပေးသည်။ အရေးကြီးသည်မှာ NVIDIA တွင် 50-Series platform အတွက် AI တောင်းဆိုမှုများစွာရှိပြီး ဤသုံးသပ်ချက်သည် ၎င်းကို စူးစမ်းလေ့လာရန် ရည်ရွယ်ပါသည်။
RTX 5090 ရဲ့ တိုးတက်မှုတွေရဲ့ အဓိကအချက်ကတော့ Multi Frame Generation ပါတဲ့ DLSS 4 ပါ။ AI ကို အသုံးပြုပြီး rendered frame တစ်ခုစီအတွက် frame သုံးခုအထိ ထပ်တိုးထုတ်ပေးပြီး support လုပ်ထားတဲ့ title တွေမှာ 8X performance gains အထိ ပေးစွမ်းနိုင်ပါတယ်။ Transformer-based AI မော်ဒယ်အသစ်က Ray Reconstruction၊ Super Resolution နဲ့ DLAA တို့ကို မြှင့်တင်ပေးပြီး NVIDIA Reflex 2 ကတစ်ဆင့် latency ကို လျှော့ချပေးတဲ့အပြင် visual fidelity ကို သိသိသာသာ တိုးတက်စေပါတယ်။
သိသာထင်ရှားတဲ့ ဂိမ်းကစားခြင်းအကျိုးကျေးဇူးတွေအပြင်၊ RTX 5090 ကို AI powerhouse အဖြစ် ပုံဖော်ထားပြီး native FP4 precision နဲ့ generative AI workflows တွေကို အရှိန်မြှင့်ပေးပြီး ယခင် FP16 အကောင်အထည်ဖော်မှုတွေနဲ့ နှိုင်းယှဉ်ရင် model memory လိုအပ်ချက်တွေကို ထက်ဝက်လျှော့ချပေးပါတယ်။ မကြာသေးခင်က workstation-based AI workloads တွေအတွက် productivity powerhouse ကို ယှဉ်နိုင်မလားဆိုတာ သိရဖို့ RTX 4090 နဲ့ RTX 6000 Ada တို့ကို ကျွန်တော်တို့ လေ့လာကြည့်ခဲ့ပါတယ် ။ ရလဒ်တွေအရ 6000 Ada ရဲ့ လွှမ်းမိုးမှုကို ယေဘုယျအားဖြင့် ပြသနေပေမယ့် ဘတ်ဂျက်နည်းနည်းနဲ့သူတွေအတွက်တော့ 4090 က အံ့သြစရာကောင်းလောက်အောင် ကောင်းမွန်ခဲ့ပါတယ်။ အသစ်ထွက်ရှိလာတဲ့ RTX 5090 ဟာ gaming နဲ့ productivity GPU တွေကြားက ခြားနားချက်ကို embedded AI enhancements အများအပြားနဲ့ ပိုမိုမှုန်ဝါးစေဖို့ ရည်ရွယ်ပါတယ်။
NVIDIA GeForce RTX 5090 Blackwell ဗိသုကာနှင့် ဟာ့ဒ်ဝဲ ဆန်းသစ်တီထွင်မှုများ
RTX 5090 ရဲ့ အဓိကအချက်မှာ CUDA core ၂၁,၇၆၀ ပါဝင်ပြီး RTX 4090 ရဲ့ core ၁၆,၃၈၄ ထက် ၃၃% ပိုများပါတယ်။ ဒီကြီးမားတဲ့ core အရေအတွက်ကို ပဉ္စမမျိုးဆက် Tensor Cores နဲ့ စတုတ္ထမျိုးဆက် RT Cores တွေနဲ့ ပေါင်းစပ်လိုက်တဲ့အခါ ဂိမ်းကစားခြင်း၊ compute-intensive workloads နဲ့ AI acceleration တွေမှာ ယှဉ်နိုင်စရာမရှိတဲ့ စွမ်းဆောင်ရည်ကို ပေးစွမ်းနိုင်ဖို့ ရည်ရွယ်ပါတယ်။
RTX 4090 မှာ ၅၁၂ ခုကနေ တိုးလာတဲ့ ၆၈၀ Tensor Cores ဟာ matrix လုပ်ဆောင်ချက်တွေကို ပိုမိုမြန်ဆန်စေပြီး AI inference ကို ပိုမိုထိရောက်စေပါတယ်။ တစ်ချိန်တည်းမှာပဲ၊ RTX 4090 ရဲ့ ၁၂၈ ခုထက် ၃၃% တိုးလာတဲ့ ၁၇၀ RT Cores ကတော့ ray tracing စွမ်းဆောင်ရည်ကို မြှင့်တင်ပေးပြီး ဂိမ်းတွေနဲ့ ပရော်ဖက်ရှင်နယ် rendering လုပ်ငန်းတွေမှာ ပိုမိုလက်တွေ့ကျတဲ့ အလင်းရောင်၊ အရိပ်နဲ့ ရောင်ပြန်ဟပ်မှုတွေကို ခွင့်ပြုပေးပါတယ်။ ဒီအဆင့်မြှင့်တင်မှုတွေက FP16 စွမ်းဆောင်ရည်ရဲ့ 104.8 TFLOPS ကို ရရှိစေခဲ့ပြီး RTX 4090 ရဲ့ ၈၂.၅၈ TFLOPS ထက် ၂၇% တိုးတက်မှုရှိပါတယ်။
RTX 5090 မှာ 32GB GDDR7 memory ကိုလည်း မိတ်ဆက်ထားပြီး RTX 4090 ရဲ့ 24GB GDDR6X ထက် bandwidth နဲ့ capacity သိသိသာသာ မြှင့်တင်ထားပါတယ်။ 5090 ဟာ 512-bit memory bus ပေါ်မှာ လည်ပတ်ပြီး 1.79 TB/s ရှိတဲ့ memory bandwidth ကို ရရှိပြီး RTX 4090 ရဲ့ 1.01 TB/s ထက် နှစ်ဆနီးပါး မြင့်မားပါတယ်။ ဒီ bandwidth မြင့်တက်လာမှုဟာ AI workloads တွေအတွက် အထူးသဖြင့် သက်ရောက်မှုရှိပါတယ်။ inference မှာ model weight တွေကို မြန်မြန်ဆန်ဆန် access လုပ်ဖို့လိုအပ်ပါတယ်။ ပိုမြန်တဲ့ memory က ရှုပ်ထွေးတဲ့ AI model တွေကို ပိုမိုချောမွေ့စွာ ကိုင်တွယ်နိုင်စေပြီး inference လုပ်နေစဉ်အတွင်း latency ကို လျှော့ချပေးပါတယ်။ ထို့အပြင်၊ bandwidth မြင့်တက်လာခြင်းက GPU Direct Storage ကို အရှိန်မြှင့်ပေးပြီး မြန်နှုန်းမြင့် storage device တွေကနေ ကြီးမားတဲ့ model weight တွေကို တိုက်ရိုက် load လုပ်ခြင်းလိုမျိုး use case တွေကို ခွင့်ပြုပေးပါတယ်။ ဒါက အကြီးဆုံး AI model တွေကိုတောင် memory ထဲကို အပြည့်အဝ load လုပ်စရာမလိုဘဲ run နိုင်စေမှာပါ။
NVIDIA GeForce RTX 50-Series သတ်မှတ်ချက်များ
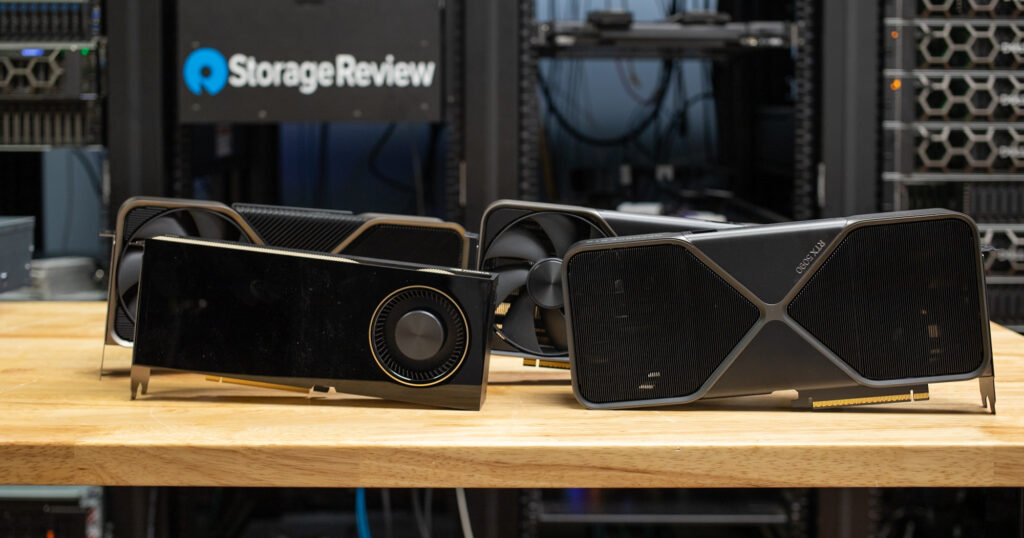
Nvidia RTX 5090 ဟာ RTX 4090 ထက် ရှုထောင့်တိုင်းလိုလိုမှာ သိသာထင်ရှားတဲ့ အဆင့်မြှင့်တင်မှုတစ်ခုကို ကိုယ်စားပြုပါတယ်။ အောက်မှာ GPU နှစ်ခုရဲ့ အသေးစိတ်နှိုင်းယှဉ်ချက်ကို ဖော်ပြထားပါတယ်။
| GPU နှိုင်းယှဉ်ချက် | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX5080 | NVIDIA RTX5070 |
| GPU ကိုအမည် | GB202 | AD102 | GB203 | GB205 |
| ဗိသုကာအတတ်ပညာ | ဘလက်ဝဲလ် ၂.၀ | Ada Lovelace | ဘလက်ဝဲလ် ၂.၀ | ဘလက်ဝဲလ် ၂.၀ |
| လုပ်ငန်းစဉ်အရွယ်အစား | 4 nm | 5 nm | 4 nm | 4 nm |
| transistors | 92,200 သန်း | 76,300 သန်း | 45,600 သန်း | 31,000 သန်း |
| သိပ်သည်းဆ | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း |
| Size ကို Die | 744 mm² | 609 mm² | 378 mm² | 263 mm² |
| slot အကျယ် | Dual- slot | သုံးထပ် slot | Dual- slot | Dual- slot |
| ရှုထောင့် | 304 137 မီလီမီတာမီလီမီတာမီလီမီတာ x x 48 | 304 137 မီလီမီတာမီလီမီတာမီလီမီတာ x x 61 | 304 137 မီလီမီတာမီလီမီတာမီလီမီတာ x x 48 | N / A |
| TDP | 575 ဒဗလျူ | 450 ဒဗလျူ | 360 ဒဗလျူ | 250 ဒဗလျူ |
| အကျိုးရလဒ်များ | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1b ၃ ခု | HDMI 2.1 ၁ ပေါက်၊ DisplayPort 1.4a ၃ ပေါက် | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1b ၃ ခု | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1a ၃ ခု |
| Power က Connectors | 1x 16 pin | 1x 16 pin | 1x 16 pin | 1x 16 pin |
| ဘတ်စ်ကား Interface | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 |
| base နာရီ | 2017 MHz | 2235 MHz | 2295 MHz | 2165 MHz |
| နာရီ Boost | 2407 MHz | 2520 MHz | 2617 MHz | 2510 MHz |
| မှတ်ဉာဏ်နာရီ | 2209 MHz (28 Gbps ထိရောက်မှု) | 1313 MHz (21 Gbps ထိရောက်မှု) | 2366 MHz (30 Gbps ထိရောက်မှု) | 2209 MHz (28 Gbps ထိရောက်မှု) |
| memory အရွယ်အစား | 32 GB ကို | 24 GB ကို | 16 GB ကို | 12 GB ကို |
| memory အမျိုးအစား | GDDR7 | GDDR6X | GDDR7 | GDDR7 |
| မှတ်ဉာဏ်ဘတ်စ်ကား | 512 bit နဲ့ | 384 bit နဲ့ | 256 bit နဲ့ | 192 bit နဲ့ |
| မှတ်ဉာဏ် Bandwidth | ၁ TB / s | ၁ TB / s | 960.0 GB ကို / s နဲ့ | 672.2 GB ကို / s နဲ့ |
| CUDA core | 21,760 | 16,384 | 10,752 | 6,144 |
| Tensor core | 680 | 512 | 336 | 192 |
| ROPs | 192 | 176 | 128 | 64 |
| SM အရေအတွက် | 170 | 128 | 84 | 48 |
| Tensor core | 680 | 512 | 336 | 192 |
| RT ကို core | 170 | 128 | 84 | 48 |
| L1 ကက်ရှ် | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) |
| L2 ကက်ရှ် | 88 ကို MB | 72 ကို MB | 64 ကို MB | 40 ကို MB |
| ပစ်ဇယ်နှုန်း | ၄၆၂.၁ GPixel/s | ၄၆၂.၁ GPixel/s | ၄၆၂.၁ GPixel/s | ၄၆၂.၁ GPixel/s |
| အသွင်အပြင်နှုန်း | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s |
| FP၁၆ (တစ်ဝက်) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) |
| FP32 (float) | 104.8 TFLOPS | 82.58 TFLOPS | 56.28 TFLOPS | 30.84 TFLOPS |
| FP64 (နှစ်ထပ်) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) |
| စတင်ရောင်းချသည့် ဈေးနှုန်း (USD) | $1,999 | $1,599 | $999 | $549 |
NVIDIA GeForce RTX 5090 တည်ဆောက်ပုံနှင့် ဒီဇိုင်း
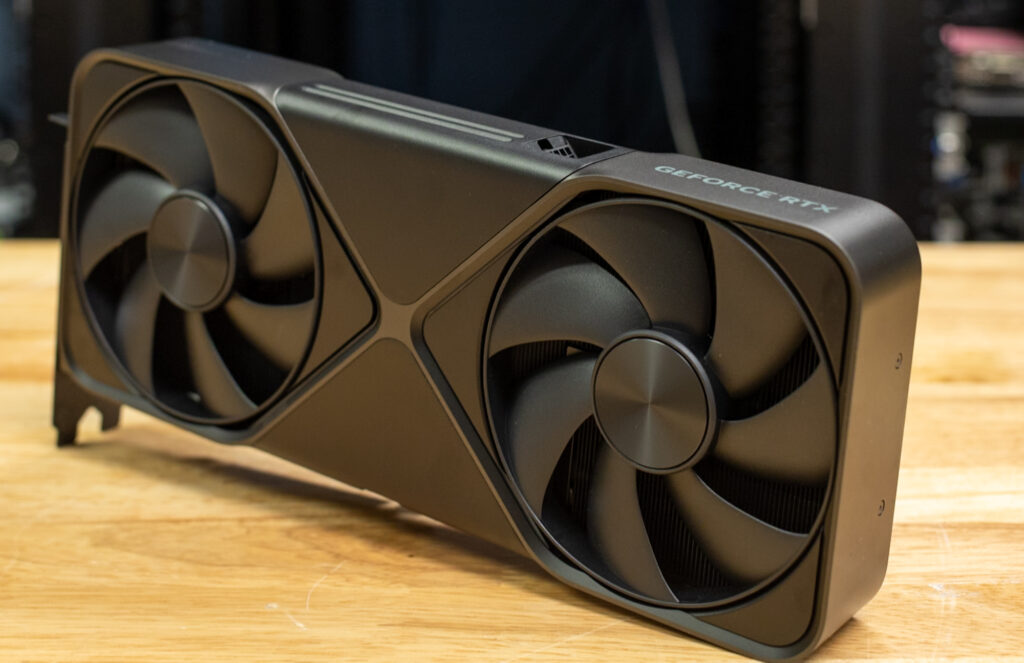
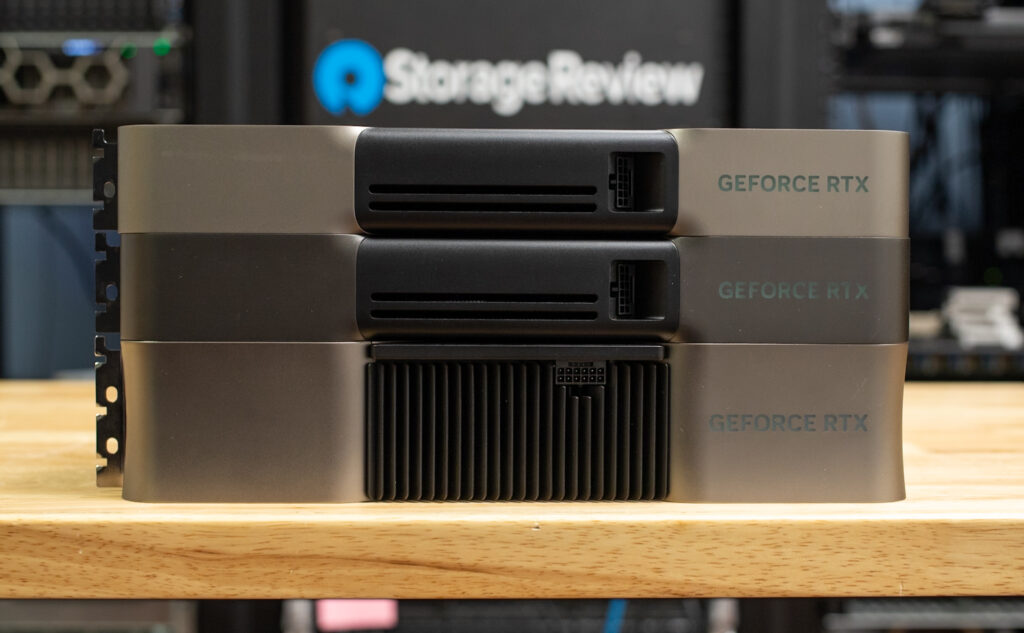
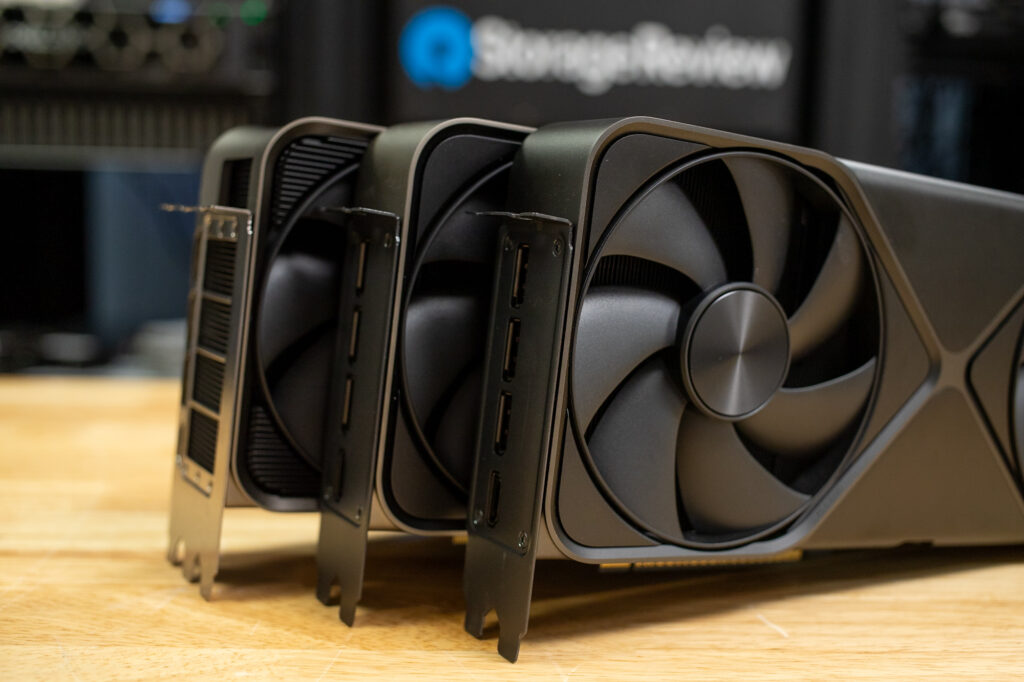
RTX 5090 Founders Edition သည် Nvidia ၏ ချောမွေ့သော စက်မှုဒီဇိုင်းဘာသာစကားကို သိမ်မွေ့သော ပြုပြင်မွမ်းမံမှုများဖြင့် ထိန်းသိမ်းထားသည်။ အလျား 304 မီလီမီတာနှင့် အနံ 137 မီလီမီတာရှိသော ကတ်သည် စံ 2-slot ဖွဲ့စည်းမှုတွင် ကိုက်ညီပြီး ၎င်း၏ပါဝါအတွက် အံ့သြစရာကောင်းလောက်အောင် ကျစ်လျစ်စေသည်။
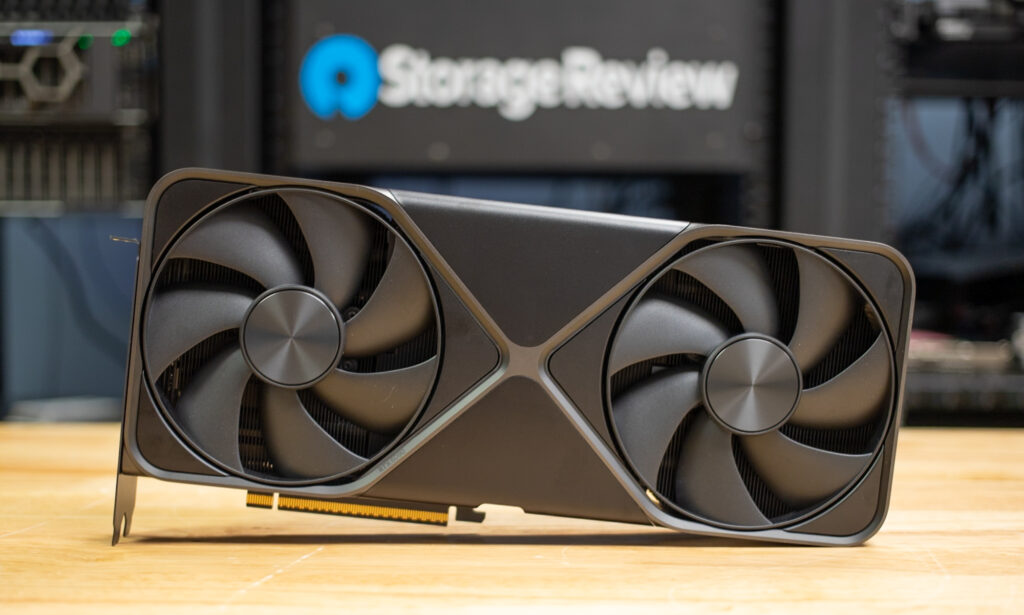
Nvidia ဟာ RTX 5090 အတွက် dual flow-through ဒီဇိုင်းကို မိတ်ဆက်ခဲ့ပြီး အအေးပေးစနစ်နဲ့ လေစီးဆင်းမှုကို တိုးတက်ကောင်းမွန်စေပါတယ်။ ဒီကတ်မှာ Nvidia က 3D vapor chamber လို့ခေါ်တဲ့ လုပ်ဆောင်ချက်တွေ အများကြီးလုပ်ဆောင်ရင်တောင် အပူချိန်ကို ထိန်းချုပ်ပေးနိုင်မယ့် dual axial fan တွေနဲ့ တွဲဖက်ထားပါတယ်။ လက်ထဲမှာ မကိုင်ဘဲ မြင်ရခက်ပေမယ့် ပန်ကာတစ်ခုစီရဲ့ နောက်က heatsink အပိုင်းနှစ်ခုလုံးကနေတစ်ဆင့် အလင်းရောင်ကို မြင်နိုင်ပါတယ်။
ကတ်ရဲ့အလယ်ဗဟိုမှာ ဆားကစ်ဘုတ်ရှိပြီး ဗီဒီယိုအထွက်တစ်ခုချင်းစီကို ဝါယာကြိုးတွေ သယ်ဆောင်ပေးတဲ့ ပြွန်ငယ်လေးတွေရှိပါတယ်။ ဒါက RTX 5090 ရဲ့ အအေးပေးစွမ်းရည်ရဲ့ စွမ်းဆောင်ရည်ကို သိသိသာသာ မြှင့်တင်ပေးပြီး ပါဝါသိသိသာသာ ပိုသုံးနေချိန်မှာတောင် RTX 4090 နဲ့ အလားတူပရိုဖိုင်ကို ထိန်းသိမ်းထားနိုင်ပါတယ်။
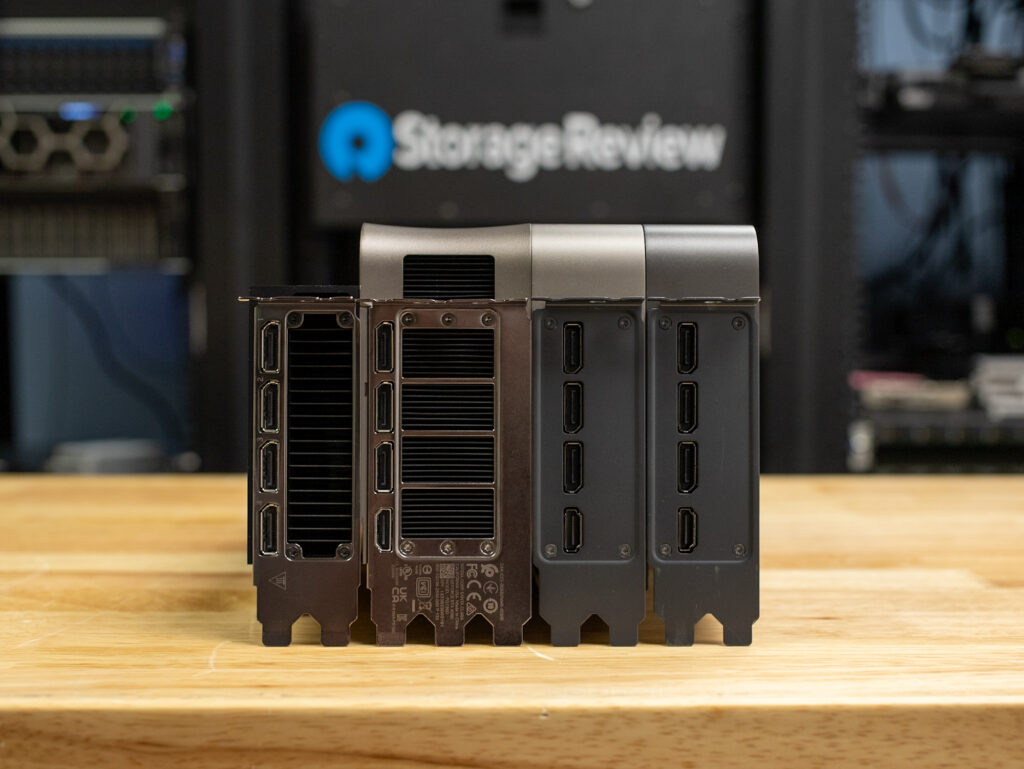
RTX 5090 ရဲ့ အထူးခြားဆုံး လုပ်ဆောင်ချက်တွေထဲက တစ်ခုကတော့ စက်ရုံကနေ တိုက်ရိုက်အသုံးပြုထားတဲ့ အရည်သတ္တု အပူဒြပ်ပေါင်း ပါဝင်တာပါပဲ။ ဒါကြောင့် ရိုးရာ အပူကပ်ခွာထက် အပူစီးကူးမှု ပိုကောင်းပြီး GPU ကို အပူချိန် နည်းပါးစေပြီး စွမ်းဆောင်ရည် မြင့်မားစေပါတယ်။
အများဆုံးပါဝါသုံးစွဲမှု 575W တိုးလာသော်လည်း RTX 5090 သည် ကျစ်လစ်သော dual-slot form factor ကို ဆက်လက်ထိန်းသိမ်းထားသောကြောင့် ပိုမိုကြီးမားသော triple-slot RTX 4090 ထက် high-end PC builds များအတွက် ပိုမိုလွယ်ကူစွာ အသုံးပြုနိုင်ပါသည်။
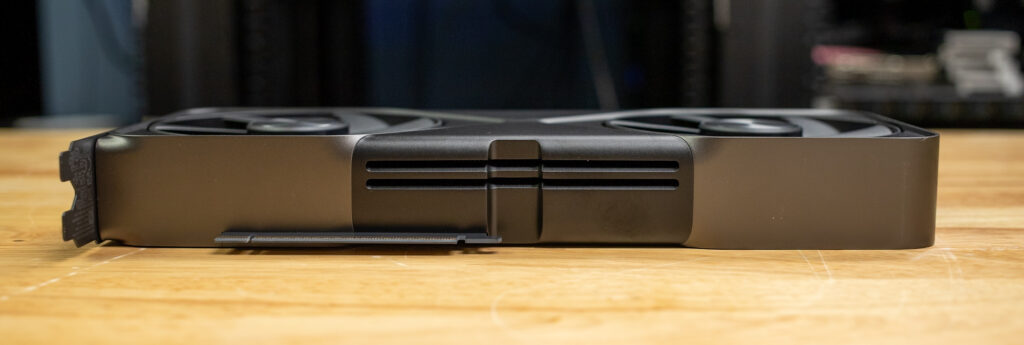
ဒီကတ်က နောက်မျိုးဆက် motherboard တွေနဲ့ peripheral တွေအတွက် bandwidth မြင့်မားတဲ့ PCIe Gen 5 ကိုလည်း ပံ့ပိုးပေးပါတယ်။ ဒါကြောင့် ဂိမ်းကစားခြင်းနဲ့ content ဖန်တီးခြင်းရဲ့ အနာဂတ်အတွက် အသင့်ဖြစ်နေပါပြီ။
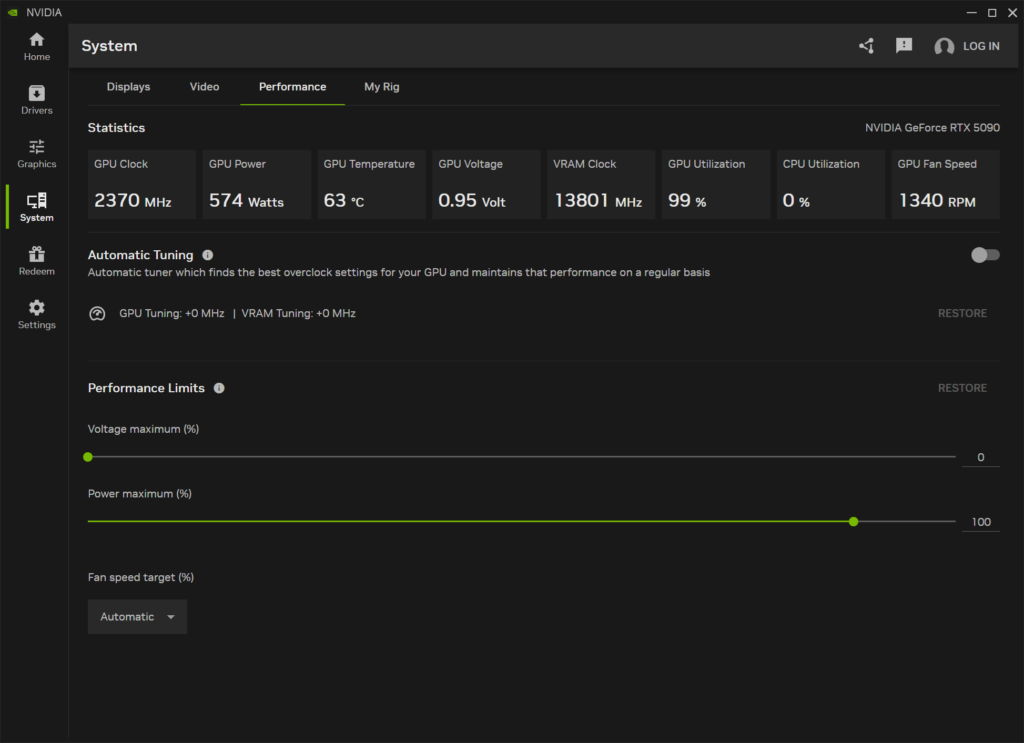
AI ဂိမ်းခေတ်
RTX 5090 ဟာ စွမ်းအင်ပြည့်ဝရုံတင်မကပါဘူး။ AI နဲ့ ဂိမ်းကစားခြင်းကို ပြန်လည်အဓိပ္ပာယ်ဖွင့်ဆိုခြင်းလည်း ဖြစ်ပါတယ်။ Nvidia ဟာ သူ့ရဲ့ AI-driven လုပ်ဆောင်ချက်တွေကို နောက်တစ်ဆင့်တက်လှမ်းနိုင်ခဲ့ပြီး ဒီမျိုးဆက်ဟာ စွမ်းဆောင်ရည်နဲ့ ရုပ်ထွက်အရည်အသွေးကို ပြောင်းလဲစေခဲ့ပါတယ်။

DLSS ၄: Multi-Frame ဖန်တီးခြင်း
DLSS (Deep Learning Super Sampling) သည် Nvidia ၏ GPU များ၏ နှစ်ပေါင်းများစွာ အခြေခံအုတ်မြစ်တစ်ခုဖြစ်ခဲ့သော်လည်း RTX 5090 သည် DLSS 4 ကို မိတ်ဆက်ပေးခဲ့ပြီး ၎င်းသည် အရာအားလုံးကို လုံးဝအသစ်သောအဆင့်သို့ ပို့ဆောင်ပေးပါသည်။ DLSS ၏ ယခင်ဗားရှင်းများသည် ရိုးရာ rendered frame တိုင်းအတွက် AI frame တစ်ခုကို ထုတ်ပေးနိုင်သော်လည်း DLSS 4 သည် rendered frame တိုင်းအတွက် AI frame သုံးခုအထိ ထုတ်ပေးနိုင်ပါသည်။

ဒါကြောင့် အခက်ခဲဆုံးဂိမ်းတွေမှာ setting အားလုံးကို အမြင့်ဆုံးထားရင်တောင် အလွန်ချောမွေ့တဲ့ ဂိမ်းကစားခြင်းအတွေ့အကြုံကို ရရှိစေပါတယ်။ Nvidia ရဲ့ latency-reduction နည်းပညာဖြစ်တဲ့ Reflex 2 နဲ့ တွဲဖက်အသုံးပြုတဲ့အခါ ဂိမ်းတွေဟာ ပိုမိုကောင်းမွန်ပြီး ယခင်ကထက် ပိုမိုတုံ့ပြန်မှုကောင်းမွန်ပါတယ်။
ဓာတ်မှန်ရိုက်ခြင်း ပြန်လည်တည်ဆောက်ခြင်း။
Ray tracing ဟာ အမြဲတမ်း တောင်းဆိုမှုမြင့်မားတဲ့ လုပ်ဆောင်ချက်တစ်ခု ဖြစ်ခဲ့ပေမယ့် RTX 5090 ရဲ့ AI-powered Ray Reconstruction က ဂိမ်းကို ပြောင်းလဲစေပါတယ်။ ရိုးရာ denoisers တွေကို AI-trained network နဲ့ အစားထိုးခြင်းအားဖြင့် Nvidia ဟာ ray-traced reflections၊ shadows နဲ့ lighting ရဲ့ အရည်အသွေးကို သိသိသာသာ တိုးတက်ကောင်းမွန်အောင် လုပ်ဆောင်နိုင်ခဲ့ပါတယ်။
ဒီလုပ်ဆောင်ချက်က ray-traced မြင်ကွင်းတွေအတွက် pixel အပိုတွေကို ထုတ်လုပ်ပေးခြင်းအားဖြင့် ရုပ်ပုံအရည်အသွေးကို မြှင့်တင်ပေးပြီး ပိုမိုလက်တွေ့ကျပြီး စွဲမက်ဖွယ်ကောင်းစေပါတယ်။ အထူးသဖြင့် လိုအပ်ချက်များတဲ့ ခေါင်းစဉ်တွေမှာ ray tracing အတွက် သိသာထင်ရှားတဲ့ ခြေလှမ်းတစ်ခုပါပဲ။
AV1 ကုဒ်သွင်းခြင်းနှင့် ကုဒ်ဖြည်ခြင်း
အကြောင်းအရာဖန်တီးသူများအတွက် RTX 5090 တွင် AV1 အပြည့်အဝ တွဲဖက်အသုံးပြုနိုင်သော 9th Gen NVENC encoders ၃ ခုနှင့် 6th Gen NVDEC decoders ၂ ခု ပါဝင်သည်။ ၎င်းသည် ဗီဒီယို encoding နှင့် decoding ကို ပိုမိုမြန်ဆန်ထိရောက်စေပြီး streamer များနှင့် ဗီဒီယို editor များအတွက် အကောင်းဆုံးရွေးချယ်မှုတစ်ခု ဖြစ်စေသည်။
NVIDIA GeForce RTX 5090 သုံးသပ်ချက် - စွမ်းဆောင်ရည် စံနှုန်းများ
NVIDIA GeForce RTX 5090 အသစ်ရဲ့ အကျိုးကျေးဇူးတွေကို အပြည့်အဝ ရယူနိုင်ဖို့အတွက်၊ ကျွန်တော်တို့ရဲ့ AMD ThreadRipper platform ကို အသုံးပြုထားပါတယ်။ ဒီ system ကို configure လုပ်ထားတဲ့အတိုင်း 64-core CPU နဲ့ water cooling loop ပါဝင်ပါတယ်။ GPU ကို နှောင့်နှေးမှုမရှိဘဲ လုပ်ဆောင်နိုင်စေဖို့အတွက် CPU horsepower အများကြီးပါဝင်ပါတယ်။ system ရဲ့ configuration အပြည့်အစုံကို အောက်မှာ ဖော်ပြထားပါတယ်။
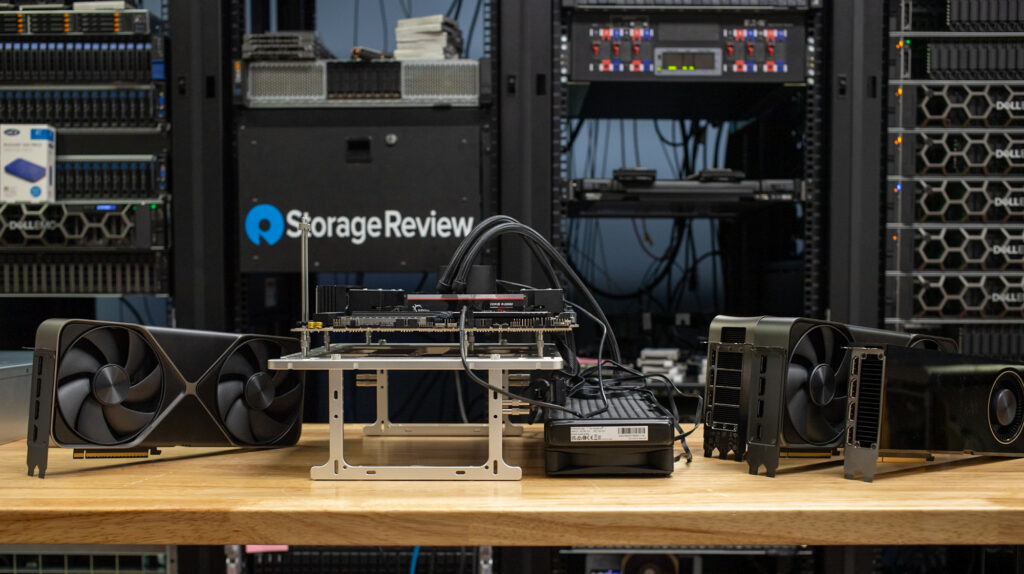
StorageReview AMD ThreadRipper စမ်းသပ်ပလက်ဖောင်း
- motherboard: ASUS Pro WS TRX50-SAGE WIFI
- CPU ကို: AMD Ryzen Threadripper 7980X 64-Core
- ရမ်: 32GB DDR5 4800MT/s
- သိုလှောင်မှု: 2TB Samsung 980 Pro
- OS ကို: Workstations အတွက် Windows 11 Pro
- ကားမောင်းသူ: NVIDIA 571.86 GameReady ဒရိုက်ဘာ
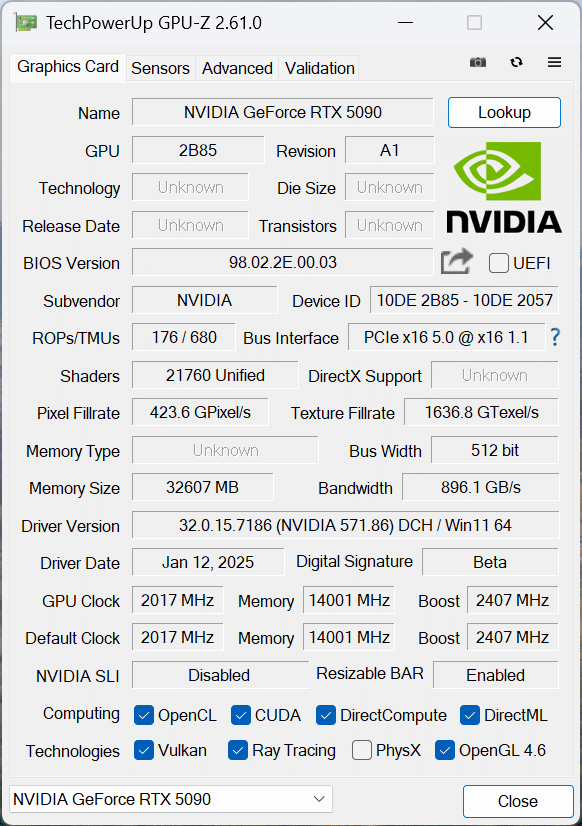
ဤသုံးသပ်ချက်ကို ရေးသားချိန်တွင် ကျွန်ုပ်တို့စမ်းသပ်ထားသော GPU များအတွက် အစောပိုင်းထုတ် NVIDIA 571.86 GameReady drivers များကို အသုံးပြုခဲ့ပါသည် ။ သို့သော်၊ အပလီကေးရှင်းအားလုံးသည် Blackwell ဗိသုကာပုံစံအသစ်ကို အပြည့်အဝ ပံ့ပိုးပေးခြင်းမရှိကြောင်း သတိပြုရန် အရေးကြီးပါသည်။ ကျွန်ုပ်တို့အသုံးပြုခဲ့သော စမ်းသပ်မှုများစွာကို အပ်ဒိတ်လုပ်ထားပြီးဖြစ်ပြီး အများစုကို အပ်ဒိတ်လုပ်နေဆဲဖြစ်သည်။ ထို့ကြောင့် NVIDIA ၏ 50-series GPU အသစ်များနှင့် အသုံးပြုရန် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်လာသည်နှင့်အမျှ စမ်းသပ်မှုဟောင်းများကို ဆက်လက်လေ့လာသွားပါမည်။
UL Procyon: AI စာသားထုတ်လုပ်ခြင်း
Procyon AI Text Generation Benchmark Benchmark သည် ကျစ်လစ်ပြီး တသမတ်တည်းရှိသော အကဲဖြတ်နည်းလမ်းကို ပေးဆောင်ခြင်းဖြင့် AI LLM စွမ်းဆောင်ရည်စမ်းသပ်မှုကို ရိုးရှင်းစေသည်။ ၎င်းသည် မော်ဒယ်အရွယ်အစားကြီးများနှင့် variable factor များ၏ ရှုပ်ထွေးမှုကို လျှော့ချနေစဉ် LLM မော်ဒယ်များစွာတွင် ထပ်ခါတလဲလဲ စမ်းသပ်ခွင့်ပြုသည်။ AI hardware ဦးဆောင်သူများနှင့်အတူ တီထွင်ထားသောကြောင့် ပိုမိုယုံကြည်စိတ်ချရပြီး ထိရောက်သော စွမ်းဆောင်ရည်အကဲဖြတ်မှုများအတွက် ဒေသတွင်း AI accelerator များအသုံးပြုမှုကို အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ပေးသည်။ အောက်တွင်တိုင်းတာထားသော ရလဒ်များကို TensorRT ကို အသုံးပြု၍ စမ်းသပ်ခဲ့သည်။
Procyon® AI Text Generation Benchmark မှာ Nvidia RTX 5090 ဟာ စမ်းသပ်ထားတဲ့ မော်ဒယ်အားလုံးမှာ အမြင့်ဆုံး ಒಟ್ಟಾರೆရမှတ် တွေနဲ့ အမြန်ဆုံးစွမ်းဆောင်ရည်နဲ့ ဦးဆောင်နေပါတယ်-
- phiRTX 5090 မှာ ၅၁,၇၂၅ မှတ် ရရှိထားပြီး RTX 4090 မှာ ၃၈,၈၈၇ မှတ် ရရှိကာ RTX 6000 မှာ ၃၂,၁၃၂ မှတ် ရရှိထားသည်။
- MistralRTX 5090 မှာ ၆,၂၆၇ ရှိပြီး RTX 4090 မှာ ၅,၀၉၄ နှင့် RTX 6000 မှာ ၄,၂၅၅ အသီးသီး ရှိကြသည်။
- လာမာ ၂RTX 5090 က ၆,၁၀၄၊ RTX 4090 က ၄,၈၄၉ နဲ့ RTX 6000 Ada က ၄,၀၂၆။
- လာမာ ၂RTX 5090 မှာ ၆,၅၉၁ ရှိပြီး RTX 4090 မှာ ၅,၀၁၃ နဲ့ RTX 6000 မှာ ၃,၉၅၇ ထက် သာလွန်ပါတယ်။
အလုံးစုံကြာချိန် အရ RTX 5090 သည် အခြား GPU များထက် သာလွန်ကောင်းမွန်ပါသည်။
- phiRTX 5090 ထက် ၂၃.၀၁၈ စက္ကန့်၊ RTX 4090 ထက် ၃၂.၄၄၈ စက္ကန့် နှင့် RTX 6000 Ada ထက် ၃၈.၉၂၃ စက္ကန့် ပိုမြန်သည်။
- MistralRTX 5090 က ၁၂.၅၉၃ စက္ကန့်၊ RTX 4090 က ၁၇.၀၁၀ စက္ကန့် နှင့် RTX 6000 Ada က ၁၉.၀၉၂ စက္ကန့်။
- လာမာ ၂RTX 5090 က ၁၄.၃၀၄ စက္ကန့်၊ RTX 4090 က ၁၉.၉၉၁ စက္ကန့် နဲ့ RTX 6000 က ၂၂.၀၆၂ စက္ကန့် တို့ထက် သာလွန်ပါတယ်။
- လာမာ ၂RTX 5090 ထက် ၂၃.၀၁၈ စက္ကန့်၊ RTX 4090 ထက် ၃၂.၄၄၈ စက္ကန့် နှင့် RTX 6000 Ada ထက် ၃၈.၉၂၃ စက္ကန့် ပိုမြန်သည်။
RTX 5090 သည် ဤစမ်းသပ်မှုတွင် အမျိုးအစားတိုင်းတွင် ပိုမိုကောင်းမွန်သော အလုံးစုံစွမ်းဆောင်ရည်နှင့် ပိုမိုမြန်ဆန်သော လုပ်ဆောင်ချိန်များကို အဆက်မပြတ် ပေးဆောင်ပါသည်။
| UL Procyon: AI စာသားထုတ်လုပ်ခြင်း | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX 6000 Ada |
| Phi ၏ စုစုပေါင်းရမှတ် | 5,749 | 4,958 | 4,508 |
| ပထမဆုံးတိုကင်သို့ Phi ထုတ်ပေးချိန် | 0.244 ့ | 0.255 ့ | 0.288 ့ |
| တစ်စက္ကန့်လျှင် Phi အထွက်တိုကင်များ | 314.435 တိုကင်/s | 244.343 တိုကင်/s | 228.359 တိုကင်/s |
| Phi ၏ စုစုပေါင်းကြာချိန် | 10.280 ့ | 12.872 ့ | 13.869 ့ |
| Mistral ၏ စုစုပေါင်းရမှတ် | 6,267 | 5,094 | 4,255 |
| Mistral ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.297 ့ | 0.322 ့ | 0.419 ့ |
| တစ်စက္ကန့်လျှင် Mistral Output Tokens များ | 255.945 တိုကင်/s | 183.266 တိုကင်/s | 166.633 တိုကင်/s |
| Mistral ၏ စုစုပေါင်းကြာချိန် | 12.593 ့ | 17.010 ့ | 19.092 ့ |
| Llama3 အလုံးစုံရမှတ် | 6,104 | 4,849 | 4,026 |
| Llama3 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.234 ့ | 0.259 ့ | 0.348 ့ |
| တစ်စက္ကန့်လျှင် Llama3 အထွက်တိုကင်များ | 214.285 တိုကင်/s | 150.039 တိုကင်/s | 138.620 တိုကင်/s |
| Llama3 ၏ စုစုပေါင်းကြာချိန် | 14.304 ့ | 19.991 ့ | 22.062 ့ |
| Llama2 အလုံးစုံရမှတ် | 6,591 | 5,013 | 3,957 |
| Llama2 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.419 ့ | 0.500 ့ | 0.679 ့ |
| တစ်စက္ကန့်လျှင် Llama2 အထွက်တိုကင်များ | 134.502 တိုကင်/s | 92.853 တိုကင်/s | 78.532 တိုကင်/s |
| Llama2 ၏ စုစုပေါင်းကြာချိန် | 23.018 ့ | 32.448 ့ | 38.923 ့ |
UL ပရိုဆိုင်ယွန်- AI ရုပ်ပုံမျိုးဆက်
Procyon AI Image Generation Benchmark သည် ပါဝါနည်း NPU များမှ အဆင့်မြင့် GPU များအထိ မတူညီသော ဟာ့ဒ်ဝဲများတွင် AI inference စွမ်းဆောင်ရည်ကို တိုင်းတာရန် တသမတ်တည်းနှင့် တိကျသောနည်းလမ်းကို ပေးဆောင်သည်။ ၎င်းတွင် စမ်းသပ်မှုသုံးခုပါဝင်သည်- အဆင့်မြင့် GPU များအတွက် Stable Diffusion XL (FP16)၊ အလယ်အလတ်ပါဝါရှိသော GPU များအတွက် Stable Diffusion 1.5 (FP16) နှင့် ပါဝါနည်းစက်ပစ္စည်းများအတွက် Stable Diffusion 1.5 (INT8)။ benchmark သည် စနစ်တစ်ခုစီအတွက် အကောင်းဆုံး inference engine ကိုအသုံးပြုပြီး တရားမျှတပြီး နှိုင်းယှဉ်နိုင်သောရလဒ်များကို သေချာစေသည်။
Procyon AI Image Generation Benchmark မှာ Nvidia RTX 5090 ဟာ စမ်းသပ်မှုအားလုံးမှာ တခြား GPU တွေထက် သာလွန်ကောင်းမွန်ပါတယ်။
- တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆)RTX 5090 သည် ಒಟ್ಟಾರೆရမှတ် ၈,၁၉၃၊ ထုတ်လုပ်မှုအချိန် ၁၂.၂၀၄ စက္ကန့်နှင့် ရုပ်ပုံထုတ်လုပ်မှုအမြန်နှုန်း ၀.၇၆၃ စက္ကန့်ဖြင့် ဦးဆောင်နေပါသည်။
- တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8)RTX 5090 သည် စုစုပေါင်းရမှတ် ၇၉,၂၇၂၊ ထုတ်လုပ်မှုအချိန် ၃.၁၅၄ စက္ကန့်နှင့် ရုပ်ပုံထုတ်လုပ်မှုအမြန်နှုန်း ၀.၃၉၄ စက္ကန့်ဖြင့် ထပ်မံဦးဆောင်နေပါသည်။
- တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16)နောက်ဆုံးအနေနဲ့ RTX 5090 ဟာ ಒಟ್ಟಾರೆ 7,179 ရမှတ်နဲ့ တစ်ပုံတစ်ပုံကို 83.573 စက္ကန့်နဲ့ ပုံရိပ်ထုတ်လုပ်မှုအမြန်နှုန်း 5.223 စက္ကန့်နဲ့ ဦးဆောင်နေပါတယ်။
| UL Procyon: AI ပုံရိပ်ထုတ်လုပ်ခြင်း | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX 6000 Ada |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) – အလုံးစုံရမှတ် | 8,193 | 5,260 | 4,230 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) – ಒಟ್ಟಾರೆအချိန် | 12.204 ့ | 19.011 ့ | 23.639 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) – ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) – အလုံးစုံရမှတ် | 79,272 | 62,160 | 55,901 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) – ಒಟ್ಟಾರೆအချိန် | 3.154 ့ | 4.022 ့ | 4.472 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8) – ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) – အလုံးစုံရမှတ် | 7,179 | 5,025 | 3,043 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) – ಒಟ್ಟಾರೆအချိန် | 83.573 ့ | 119.379 ့ | 197.172 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) – ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
လပ်စ်မာ့ခ်
Luxmark သည် open-source ray tracing renderer ဖြစ်သော LuxRender ကို အသုံးပြု၍ အသေးစိတ်ကျသော 3D မြင်ကွင်းများကို ကိုင်တွယ်ရာတွင် စနစ်၏စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည့် GPU benchmark တစ်ခုဖြစ်သည်။ ဤ benchmark သည် server များနှင့် workstation များ၏ graphical rendering စွမ်းရည်ကို အကဲဖြတ်ရန်အတွက် အထူးသဖြင့် visual effect များနှင့် architectural visualization application များအတွက် တိကျသော အလင်း simulation သည် အရေးကြီးပါသည်။
Luxmark OpenCL benchmark မှာ NVIDIA RTX 5090 ဟာ Hall နဲ့ Food GPU စမ်းသပ်မှု နှစ်ခုလုံးအတွက် အမြင့်ဆုံးရမှတ်တွေနဲ့ ဦးဆောင်နေပါတယ်။
- အစားအသောက်ရမှတ်RTX 5090 ၂၃,၁၄၁ ရှိပြီး RTX 4090 ၁၇,၁၇၁ နှင့် RTX 6000 Ada ၁၄,၈၇၃ တို့ကို ကျော်လွန်သွားခဲ့သည်။
- ခန်းမရမှတ်RTX 5090 မှာ ၅၁,၇၂၅ မှတ် ရရှိထားပြီး RTX 4090 မှာ ၃၈,၈၈၇ မှတ် ရရှိကာ RTX 6000 မှာ ၃၂,၁၃၂ မှတ် ရရှိထားသည်။
| Luxmark (မြင့်လေ ပိုကောင်းလေ) | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX 6000 Ada |
| အစားအသောက်ရမှတ် | 23,141 | 17,171 | 14,873 |
| ခန်းမရမှတ် | 51,725 | 38,887 | 32,132 |
Geekbench 6
Geekbench 6 သည် အလုံးစုံစနစ်စွမ်းဆောင်ရည်ကို တိုင်းတာသည့် cross-platform benchmark တစ်ခုဖြစ်သည်။ Geekbench Browser သည် မည်သည့်စနစ်နှင့်မဆို နှိုင်းယှဉ်နိုင်စေပါသည်။
NVIDIA RTX 5090 က Geekbench GPU OpenCL ရမှတ် ၃၇၄,၈၀၇ နဲ့ ဦးဆောင်နေပါတယ်။ ဒီရမှတ်က RTX 6000 Ada ရဲ့ ၃၃၆,၈၈၂ နဲ့ RTX 4090 ရဲ့ ၃၃၃,၃၈၄ တို့ထက် သာလွန်ပြီး ဒီနှိုင်းယှဉ်မှုမှာ ထိပ်တန်းစွမ်းဆောင်ရည်အဖြစ် သတ်မှတ်ခံထားရပါတယ်။
| Geekbench (မြင့်လေ ပိုကောင်းလေ) | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX 6000 Ada |
| GPU OpenCL ရမှတ် | 374,807 | 333,384 | 336,882 |
V Ray
V -Ray Benchmark သည် အဆင့်မြင့် V-Ray 6 အင်ဂျင်များကို အသုံးပြု၍ CPU များ၊ NVIDIA GPU များ သို့မဟုတ် နှစ်မျိုးလုံး၏ rendering စွမ်းဆောင်ရည်ကို တိုင်းတာသည်။ ၎င်းသည် အသုံးပြုသူများ ၎င်းတို့၏စနစ်များ၏ rendering စွမ်းရည်များကို အကဲဖြတ်ရန်နှင့် နှိုင်းယှဉ်နိုင်ရန် မြန်ဆန်သော စမ်းသပ်မှုများနှင့် ရိုးရှင်းသော အမှတ်ပေးစနစ်ကို အသုံးပြုသည်။ ၎င်းသည် ထိရောက်သော စွမ်းဆောင်ရည်ဆိုင်ရာ ထိုးထွင်းသိမြင်မှုများကို ရှာဖွေနေသော ပရော်ဖက်ရှင်နယ်များအတွက် မရှိမဖြစ်ကိရိယာတစ်ခုဖြစ်သည်။
ဤစမ်းသပ်မှုတွင် NVIDIA RTX 5090 သည် အထင်ကြီးလောက်သော ရမှတ် ၁၄,၇၆၄ ဖြင့် ဦးဆောင်နေပြီး RTX 4090 10,847 နှင့် RTX 6000 Ada 10,766 ထက် သိသိသာသာ သာလွန်ကောင်းမွန်ပါသည်။ RTX 5090 သည် rendering စွမ်းဆောင်ရည်တွင် ထပ်မံ၍ ထင်ရှားစွာ လွှမ်းမိုးထားပါသည်။
| V-Ray (မြင့်လေ ပိုကောင်းလေ) | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX 6000 Ada |
| vpath များ | 14,764 | 10,847 | 10,766 |
NVIDIA GeForce RTX 5090 ပါဝါသုံးစွဲမှု
ပါဝါသုံးစွဲမှုသည် မည်သည့် high-end computing platform တွင်မဆို သိသာထင်ရှားသော အစိတ်အပိုင်းတစ်ခုဖြစ်သည်။ GPU မျိုးဆက်သစ်တစ်ခုစီသည် load အောက်တွင် ပါဝါပိုမိုသုံးစွဲပြီး ဆိုလိုသည်မှာ power supply များ ပိုမိုများပြားပြီး အအေးပေးရန်အတွက် လေစီးဆင်းမှု လုံလောက်ပါသည်။ သို့သော် ပါဝါစွမ်းဆောင်ရည်နှင့်ပတ်သက်သည့် အခြားရှုထောင့်တစ်ခုရှိသည်- ပိုမိုမြန်ဆန်သော GPU များသည် ပိုမိုမြင့်မားစွာ မြင့်တက်လာနိုင်သော်လည်း workload တစ်ခုချင်းစီ၏ ကြာချိန် လျော့ကျသွားသည်။
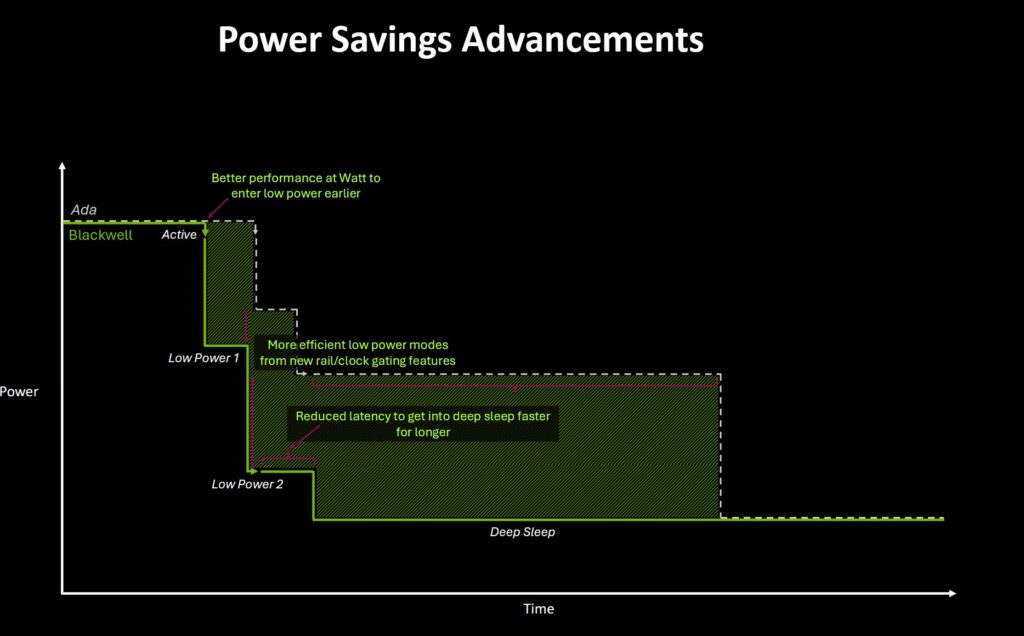
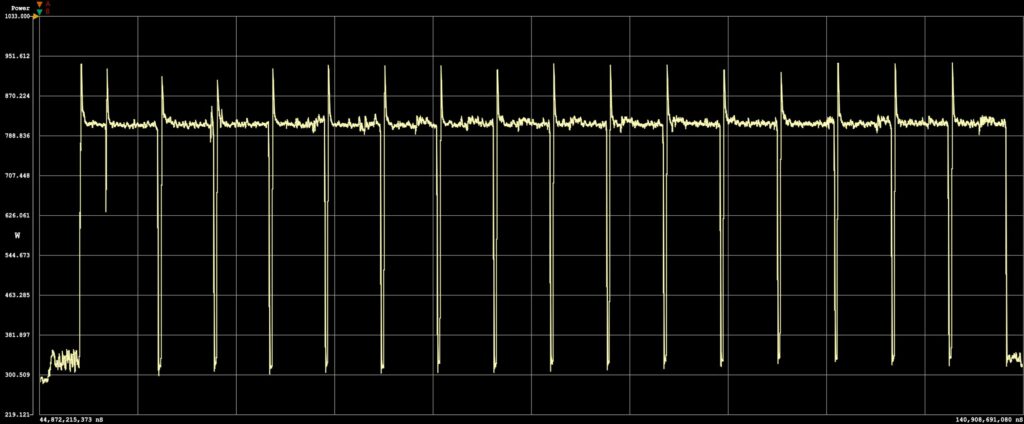
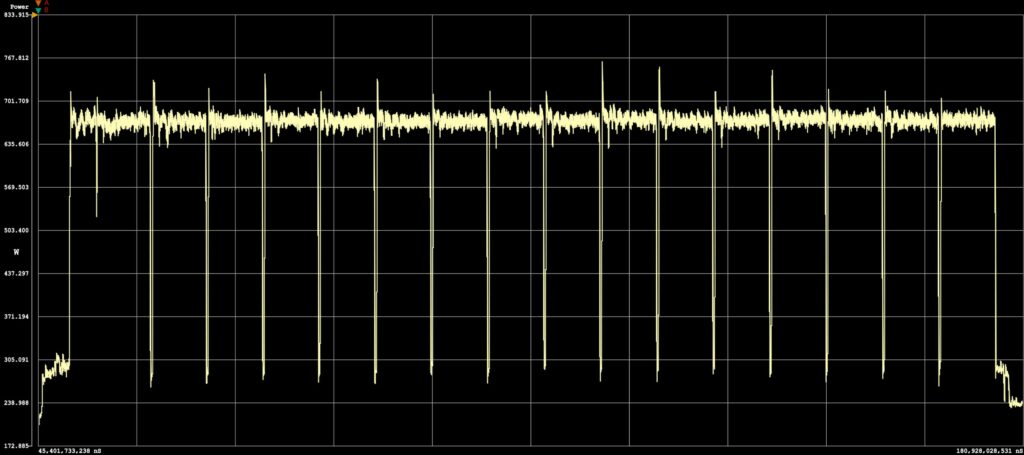
NVIDIA သည် CES 2025 တွင် Editor's Day ၌ Blackwell ဗိသုကာ၏ ပါဝါထိရောက်မှု တိုးတက်လာခြင်းအကြောင်းကို ဆွေးနွေးခဲ့ပြီး AI-driven workload တွင် ကျွန်ုပ်တို့ မြင်တွေ့လိုခဲ့သည်။ ကျွန်ုပ်တို့၏ စမ်းသပ်ဓာတ်ခွဲခန်းတွင် Quarch Mains Analyzer ကို အသုံးပြု၍ Procyon AI Image Generator Stable Diffusion XL FP16 စမ်းသပ်မှုကို လုပ်ဆောင်နေစဉ်အတွင်း သုံးစွဲသော စုစုပေါင်းစနစ်ပါဝါကို တိုင်းတာခဲ့သည် ။ ဤ workload သည် GPU တစ်ခုစီကို ၎င်း၏ ပါဝါကန့်သတ်ချက်များအထိ တွန်းပို့ခဲ့ပြီး ထုတ်လုပ်ထားသော ရုပ်ပုံတစ်ခုစီအတွက် သတ်မှတ်ထားသော စတင်သည့်နေရာနှင့် ရပ်တန့်သည့်နေရာများကို အလွယ်တကူမြင်တွေ့နိုင်စေခဲ့သည်။
ပထမဦးစွာ NVIDIA RTX 6000 Ada ကိုကြည့်မယ်ဆိုရင် အများဆုံးပါဝါသုံးစွဲမှု 300W ရှိပါတယ်။ Procyon AI image-generating test ကိုလုပ်ဆောင်နေစဉ်မှာ system power ဟာ background load 235W ကနေ 514W အထိတိုးလာတာ ဒါမှမဟုတ် load လုပ်နေချိန်မှာ 279W အထိတိုးလာတာကို တွေ့ရပါတယ်။ ပုံတစ်ပုံချင်းစီရဲ့အချိန်ကိုကြည့်တဲ့အခါ ဒုတိယမြောက်နောက်ဆုံးပုံတစ်ပုံမှာ GPU load ဟာ 12.6 စက္ကန့်ကြာမြင့်တာကိုတွေ့ရပါတယ်။ အဲဒီနောက်ဆုံးပုံတစ်ပုံဖန်တီးမှုအတွက် စုစုပေါင်းပါဝါသုံးစွဲမှုက 1.76Wh ရှိခဲ့ပါတယ်။
နောက်တစ်ခုအနေနဲ့ NVIDIA GeForce RTX 4090 နဲ့ စမ်းသပ်မှုအပိုင်းကို ကြည့်မယ်ဆိုရင် အများဆုံးပါဝါသုံးစွဲမှု 450W ရှိပါတယ်။ AI image generating test ကို လုပ်ဆောင်နေချိန်မှာ စနစ်ဟာ 233W ကနေ ပျမ်းမျှ 669W အထိ တိုးလာပြီး load လုပ်နေချိန်မှာ 436W တိုးလာပါတယ်။ ဒုတိယမြောက် image ကနေ နောက်ဆုံး image ကို ဖန်တီးနေတာကို ကြည့်မယ်ဆိုရင် load လုပ်နေချိန်မှာ 7.3 စက္ကန့်ပဲ ကြာပါတယ်။ အဲဒီကာလအတွင်း သုံးစွဲခဲ့တဲ့ စုစုပေါင်းပါဝါအတွက် 1.35Wh ရှိပါတယ်။
နောက်ဆုံးအနေနဲ့ NVIDIA GeForce RTX 5090 အသစ်ကို ကြည့်ကြရအောင်။ အမြင့်ဆုံးပါဝါသုံးစွဲမှု 600W ရှိပါတယ်။ ဒီကတ်က Procyon AI image-generating စမ်းသပ်မှုကို လုပ်ဆောင်နေချိန်မှာ စနစ်က နောက်ခံပါဝါ 272W ကနေ 811W အထိ တိုးလာပြီး 539W အထိ အလုပ်လုပ်ပါတယ်။ ဒုတိယမြောက်နောက်ဆုံးပုံရိပ်ကို ထုတ်လုပ်ဖို့ အချိန် 5.1 စက္ကန့်ပဲကြာပြီး အဲဒီအချိန်အတွင်းမှာ 1.16Wh ကို အသုံးပြုခဲ့ပါတယ်။
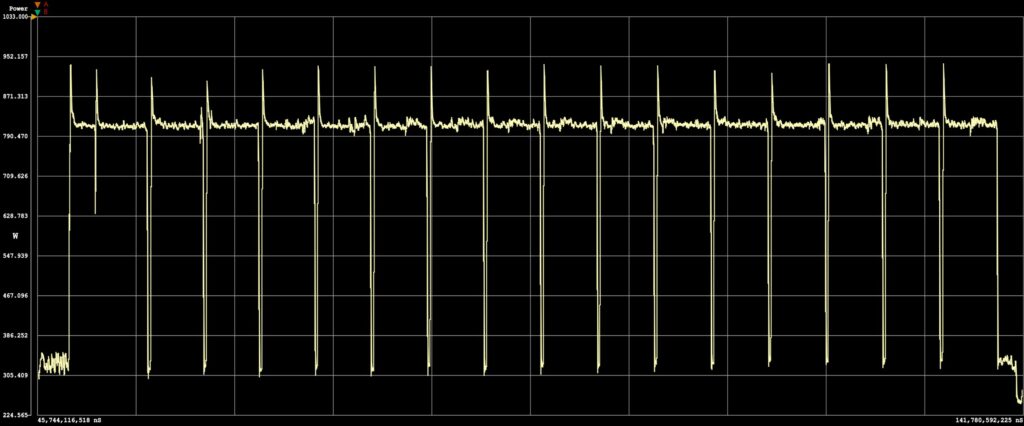
NVIDIA GPU သုံးခုစလုံးကို ကျွန်ုပ်တို့ ဖြတ်သန်းသွားတဲ့အခါ ပိုမြန်တဲ့ မော်ဒယ်တစ်ခုချင်းစီရဲ့ အမြင့်ဆုံးပါဝါသုံးစွဲမှုက တိုးလာပေမယ့် စုစုပေါင်းစွမ်းအင်သုံးစွဲမှုက လျော့ကျသွားပါတယ်။ ဒါက workloads အတွက် GPU အသစ်တွေ ဝယ်ယူဖို့ စဉ်းစားတဲ့အခါ အရေးကြီးတဲ့အချက်တစ်ခုပါ။ ပါဝါသုံးစွဲမှု တိုးလာမှာဖြစ်ပေမယ့် သတ်မှတ်ထားတဲ့ workloads တွေကို ပြီးမြောက်ဖို့ လိုအပ်တဲ့ စွမ်းအင်ကတော့ လျော့ကျသွားပါတယ်။
ကောက်ချက်
ဤသုံးသပ်ချက်သည် NVIDIA GeForce RTX 5090 ၏ အလုံးစုံစွမ်းရည်များကို အလွန်အစောပိုင်း လေ့လာသုံးသပ်ချက်ပေးပါသည်။ ဆော့ဖ်ဝဲအားလုံးကို ဗိသုကာပုံစံအသစ်အတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားခြင်းမဟုတ်သည့်အပြင် AI-centric workloads များအတွက် Linux drivers များကို ဇန်နဝါရီလကုန်တွင် ကတ်ကို အထွေထွေရောင်းချသည်အထိ ရရှိနိုင်မည်မဟုတ်ပါ။
RTX 5090 အသစ်ရဲ့ အားသာချက်ကို ရယူနိုင်တဲ့ workload အားလုံးမှာ စွမ်းဆောင်ရည် အကြီးအကျယ် တိုးတက်လာတာကို ကျွန်တော်တို့ မြင်တွေ့ခဲ့ရပါတယ်။ သဟဇာတမဖြစ်တာကနေ မျှော်မှန်းထားတာထက် နှေးကွေးတဲ့ လုပ်ဆောင်ချက်တွေအထိ အခြေအနေအမျိုးမျိုးကို ကျွန်တော်တို့ မြင်တွေ့ခဲ့ရလို့ application အချို့ဟာ update တွေ လိုအပ်ပါလိမ့်မယ်။ ကျွန်တော်တို့ စိတ်လှုပ်ရှားစရာကတော့ ဒီကတ်ရဲ့ စွမ်းဆောင်ရည် အလားအလာကို မြင်တွေ့ရတာပါပဲ။ Procyon AI စာသားနဲ့ ရုပ်ပုံထုတ်လုပ်မှု workload တွေမှာ RTX 4090 နဲ့ နှိုင်းယှဉ်ရင် RTX 5090 ဟာ အသီးသီး ၁၆% နဲ့ ၅၆% တိုးတက်မှုတွေကို ပေးစွမ်းခဲ့ပါတယ်။ V-Ray rendering စွမ်းဆောင်ရည်ကို တိုင်းတာရာမှာ RTX 5090 ရဲ့ စွမ်းဆောင်ရည်ဟာ ယခင်ထက် ၃၆% တိုးတက်လာခဲ့ပါတယ်။ ကျွန်တော်တို့ မြင်တွေ့နေရတဲ့ GPU-accelerated workload တွေထဲက တစ်ခုမှ လျော့ကျသွားတာ မဟုတ်ပါဘူး။ အရာရာဟာ ပိုမိုပြင်းထန်လာပါတယ်။ AI Assistants ရဲ့ သဘောတရားကို မိတ်ဆက်လိုက်တဲ့အခါ user တွေဟာ ဂိမ်းကစားနေရုံ ဒါမှမဟုတ် အလုပ်လုပ်နေရုံတင် မဟုတ်ဘဲ AI workload ကိုပါ တစ်ပြိုင်နက်တည်း လုပ်ဆောင်နေမှာပါ။ အဲဒါက နောက်ထပ် intensive task တစ်ခုနဲ့အတူ GPU resource တွေ ထပ်မံလိုအပ်ပါလိမ့်မယ်။
ဒါကြောင့် ဈေးနှုန်းနဲ့ တန်ဖိုးအကြောင်း ဆွေးနွေးကြရအောင်။ GeForce RTX 4090 ရဲ့ ကနဦးဈေးနှုန်းက ဒေါ်လာ ၁၅၉၉ ဖြစ်ပြီး GeForce RTX 5090 အသစ်ကတော့ အစဈေးနှုန်းကို ဒေါ်လာ ၁၉၉၉ အထိ တိုးမြှင့်လိုက်ပြီး ထိပ်တန်းဗားရှင်းအတွက် ၂၅% တိုးလာပါတယ်။ ဒါက လူအများအတွက် တန်ပါသလား။ တန်ပါတယ်။ GPU တွေကို အမြင့်ဆုံးအဆင့်ရောက်အောင် မကြာခဏ တွန်းအားပေးတတ်တဲ့ အသုံးပြုသူတွေအတွက် GPU ပိုမြန်တာက အလုပ်တွေ ပိုလုပ်နိုင်အောင် ခွင့်ပြုပေးပါတယ်။ သင့်ရဲ့ workload ကို အချိန်နည်းနည်းနဲ့ လည်ပတ်နိုင်ပြီး ပိုမိုထိရောက်စွာ လုပ်ဆောင်နိုင်မယ်ဆိုရင် သင့် PC ရဲ့ နှစ်တွေတစ်လျှောက် ကုန်ကျစရိတ်က တန်ပါတယ်။ လူတိုင်းက ထိပ်တန်းမော်ဒယ်ကို လိုအပ်ပါသလား။ မလိုအပ်ပါဘူး။ RTX 5070 အပါအဝင် မော်ဒယ်အမျိုးမျိုးကို ဒေါ်လာ ၅၄၉ နဲ့ ရောင်းချပေးမှာဖြစ်ပြီး RTX 5060 ရဲ့ ဈေးနှုန်းက ပိုနည်းပါလိမ့်မယ်။
ဒီနောက်မျိုးဆက်ကတ်နဲ့ ပါဝါသုံးစွဲမှုကလည်း မှတ်သားထားရမယ့်အချက်တစ်ခုပါ။ GeForce RTX 4090 က 450W မှာ ပါဝါအရမ်းသုံးခဲ့ပြီး RTX 5090 ကတော့ 575W အထိ မြင့်တက်သွားခဲ့ပါတယ်။ ဒါက PC နဲ့ workstation chassis ဒီဇိုင်းအတွက် စိန်ခေါ်မှုအသစ်တွေ ဖန်တီးပေးပါလိမ့်မယ်၊ ဘာလို့လဲဆိုတော့ အအေးပေးစနစ် လိုအပ်ချက်တွေနဲ့ ပိုကြီးတဲ့ ပါဝါထောက်ပံ့မှုတွေကို ဖြည့်ဆည်းပေးရမှာမို့လို့ပါ။
အလုံးစုံပြောရရင် NVIDIA GeForce RTX 5090 အသစ်က ကျွန်တော်တို့ကို အထင်ကြီးစေပြီး application support တွေ ပိုကျယ်ပြန့်လာတာနဲ့အမျှ စွမ်းဆောင်ရည်တွေ ဘယ်လောက်ထိ တိုးတက်လာမလဲဆိုတာကို မြင်တွေ့ချင်နေပါတယ်။ RTX 3090 နဲ့ A6000 ဒါမှမဟုတ် RTX 4090 နဲ့ 6000 Ada က အရင်ကလုပ်ခဲ့သလိုပဲ GeForce RTX 5090 က နောက်ထပ် workstation မော်ဒယ်က ဘယ်ကိုဦးတည်နေမလဲဆိုတာကို ညွှန်ပြနေပြီး ကျွန်တော်တို့ မစောင့်နိုင်တော့ပါဘူး။


 အမေဇုံ