

NVIDIA RTX PRO 4500 Blackwell Server Edition သည် data center ပြင်ပရှိ server များတွင် L4 ကို အစားထိုးရန် NVIDIA တည်ဆောက်ထားသော card ဖြစ်သည်- single-slot, PCIe Gen5, passively cooled, 165W, 32GB GDDR7 နှင့် FP4 Tensor Cores နှင့် Multi-Instance GPU အပါအဝင် Blackwell feature set အပြည့်အစုံ ပါဝင်သည်။ HPE သည် ၎င်း၏ Nemotron edge solution တွင် ဤ GPU နှင့် တွဲဖက်အသုံးပြုသည့် short-depth edge server ProLiant DL145 Gen11 ကို ကျွန်ုပ်တို့ထံ ပေးပို့ခဲ့ပြီး၊ ကျွန်ုပ်တို့သည် RTX PRO 4500 နှင့် တူညီသော chassis ရှိ L4 တွင် တူညီသော vLLM serving sweep ကို လုပ်ဆောင်ခဲ့သည်။ ဤ RTX PRO 4500 edge review သည် နှိုင်းယှဉ်ချက်တစ်ခုအကြောင်းဖြစ်သည်- edge box တွင် L4 ကို run ပြီးသား site တစ်ခုသည် 4500 ကို လဲလှယ်ခြင်းဖြင့်၊ tokens၊ latency နှင့် power consumption တို့တွင် ရရှိသောအရာဖြစ်သည်။

လက်တွေ့အားဖြင့် BF16 မော်ဒယ်ငယ်နှစ်ခုတွင် RTX PRO 4500 သည် L4 ၏ output throughput ထက် 2.7x ပိုမိုပေးစွမ်းနိုင်ပြီး L4 သည် queue ထဲသို့ကျနေပြီဖြစ်သော load များတွင် တစ်စက္ကန့်အောက်တွင် first-token latency ကိုထိန်းထားနိုင်ပြီး DL145 ၏ whole-server draw ကို 196W မှ 301W အထိ မြှင့်တင်ပေးပါသည်။ GPU watt တစ်ခုလျှင် gain မှာ 1.3 မှ 1.4x အထိရှိသည်။ card တစ်ခုလျှင် ၎င်းသည် concurrent chat session ၃၂ ခုမှ ၆၄ ခုအထိ ပံ့ပိုးပေးခြင်းနှင့် 256 ခုကို ပံ့ပိုးပေးခြင်းကြား ကွာခြားချက်ဖြစ်သည်။ box တစ်ခုလျှင် DL145 သည် L4 သုံးခုအထိ ရယူပြီး session ၃၂ ခုတွင် သုံးခုစီသည် throughput တွင် 4500 တစ်ခုနီးပါး ရရှိသောကြောင့် 4500 ၏ box-level case သည် per-user speed၊ latency၊ single 32GB memory pool နှင့် FP4 တို့ပေါ်တွင် မူတည်ပါသည်။
ဒါက Metrum AI® Bench Platform မှာရှိတဲ့ သူ့ရဲ့ရှေ့က ကတ်တစ်ခုကို edge server မှာ ကြည့်လိုက်တာနဲ့ ယှဉ်ကြည့်ရင် 24GB နဲ့ 32GB မော်ဒယ်တွေမှာ အဆင်ပြေပြေ တပ်ဆင်နိုင်ပါတယ်။ RTX PRO 4500 Server Edition ဟာ NVIDIA ရဲ့ ကျန်တဲ့ inference lineup တွေနဲ့ ပိုကျယ်ပြန့်တဲ့ နှိုင်းယှဉ်မှုမှာ ပါဝင်ပြီး၊ သီးခြား စမ်းသပ်မှုတစ်ခုအတွက် ကျွန်တော်တို့ လုပ်ဆောင်နေပါတယ်။ ဒီတစ်ခုအတွက် L4 က အသင့်တော်ဆုံး နှိုင်းယှဉ်မှုဖြစ်ပြီး 26B မော်ဒယ်မှာ NVFP4 က ဘယ်လိုပုံစံရှိလဲဆိုတာကို ပြသဖို့ RTX PRO 6000 Blackwell dataset တစ်ခုတည်းကို ထည့်သွင်းထားပါတယ်။ ပိုကြီးတဲ့ ကတ်တစ်ခုနဲ့ တိုင်းတာတဲ့အခါ ဘယ်လိုပုံစံရှိလဲဆိုတာကို ပြသထားပါတယ်။ RTX PRO 6000 ကို HPE edge server မှာ support မလုပ်ပါဘူး။
Key ကို Takeaways
- တူညီသောဆာဗာတွင် L4 ၏ ၂.၇x: Qwen3.5-4B နှင့် Gemma 4 E4B ပေါ်ရှိ input နှင့် output ပေါင်းစပ်မှု ၁၈ ခုတွင်၊ RTX PRO 4500 သည် တစ်ပြိုင်နက်တည်း request ၈ ခုမှ ၃၂ ခုအထိတွင် L4 ၏ output tokens ထက် တစ်စက္ကန့်လျှင် ပျမ်းမျှ ၂.၇ ဆ နှင့် ၂၅၆ ခုတွင် ၃.၀x မှ ၃.၂x အထိ ပေးပို့ခဲ့ပြီး ကတ်နှစ်ခုစလုံးကို HPE ProLiant DL145 Gen11 တစ်ခုတည်းတွင် ထားရှိသည်။
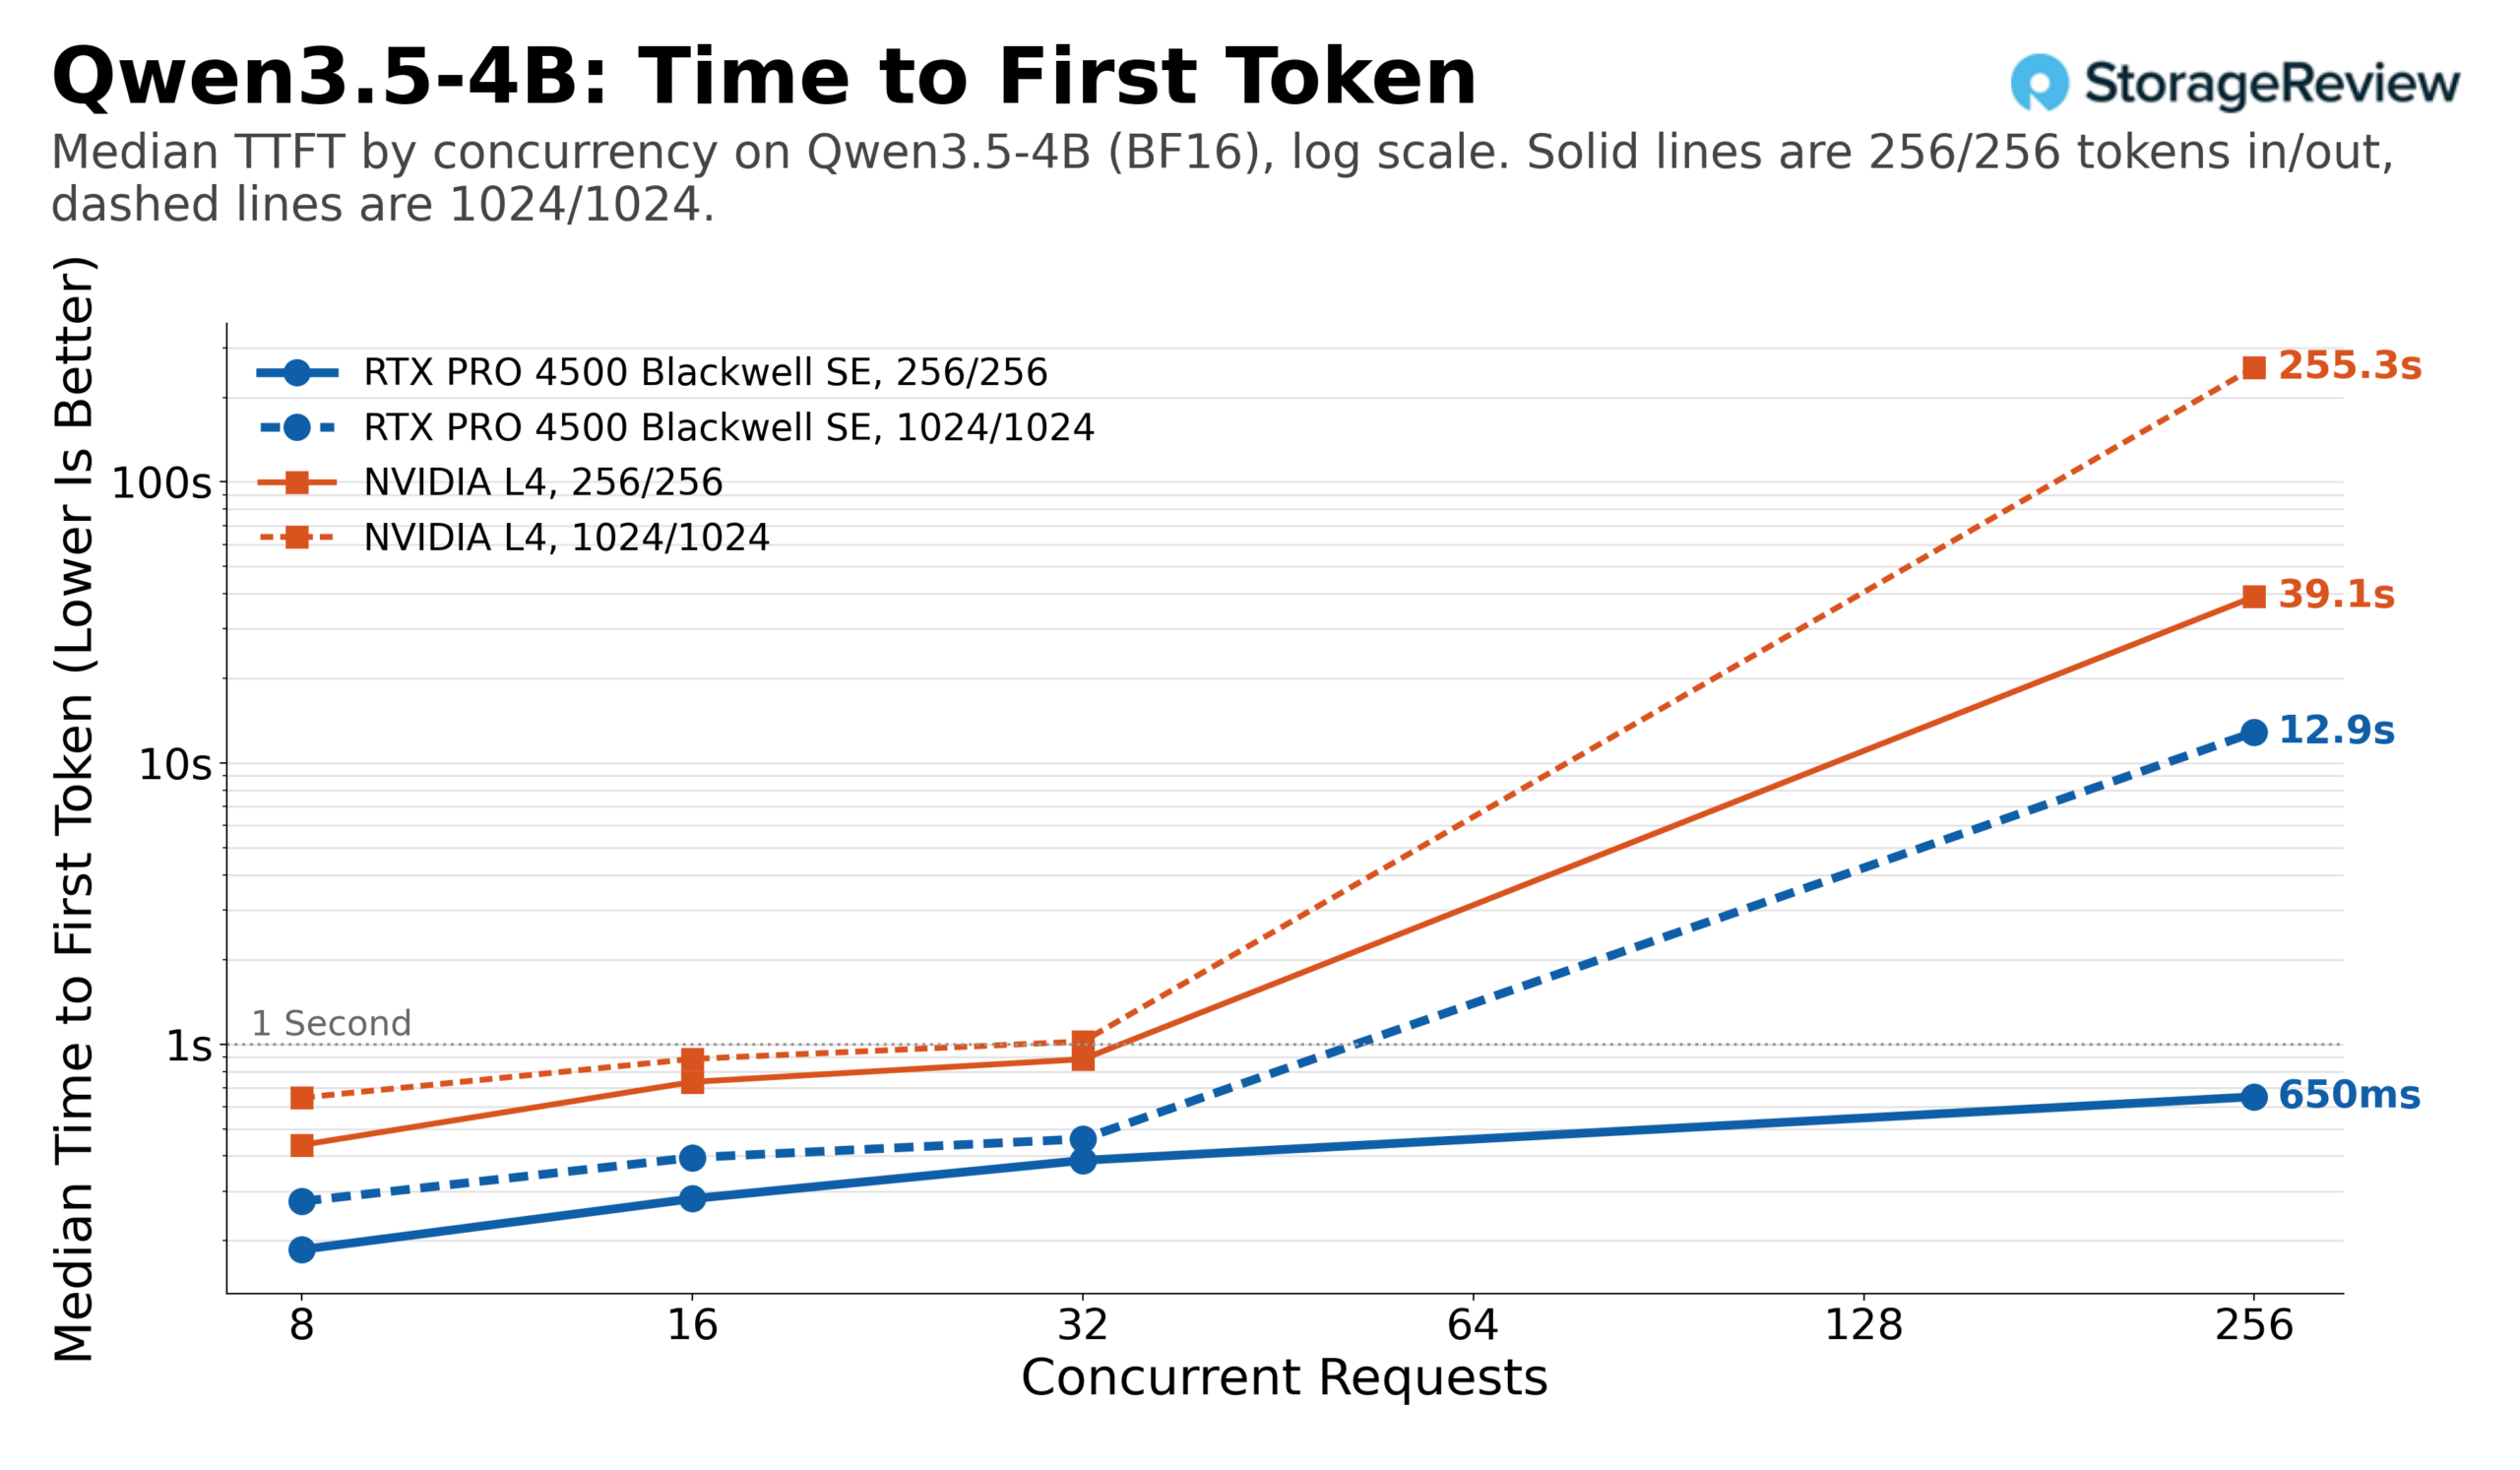
- နှောင့်နှေးမှုက ပိုကြီးတဲ့ ကွာဟချက်ပါ။ L4 မှာ ၃၅ မှ ၄၀ မီလီစက္ကန့်နဲ့ နှိုင်းယှဉ်ရင် 4500 ဟာ token တစ်ခုကို ၁၂ မှ ၁၅ မီလီစက္ကန့်အထိ ထုတ်လုပ်ပေးပြီး တစ်ပြိုင်နက်တည်း request ၂၅၆ ခုမှာ ပထမဆုံး token ကိုရောက်ဖို့ ပျမ်းမျှအချိန်ဟာ ၂၅၆ တိုကင် prompts တွေမှာ ၂၆၄ မီလီစက္ကန့်ကနေ ၆၅၀ မီလီစက္ကန့်အထိ ရှိနေခဲ့ပြီး L4 တွေကတော့ ၉ စက္ကန့်နဲ့ ၃၉ စက္ကန့်အထိ မြင့်တက်လာခဲ့ပါတယ်။
- နံရံမှာ ၁၀၅ ဝပ် ပိုထားရင် တိုကင် ၂.၇ ဆ ပိုရတာပေါ့။ DL145 သည် L4 တွင် 196W ခန့်နှင့် 4500 တွင် 301W ခန့်ကို တစ်ပြိုင်နက်တည်း ထောက်ပံ့ပေးခဲ့သည်။ စနစ်ဝပ်တစ်ခုလျှင် အထွက်တိုကင်များသည် Qwen3.5-4B တွင် 2.7 မှ 5.1 သို့ နှင့် Gemma 4 E4B တွင် 2.9 မှ 5.6 သို့ မြင့်တက်ခဲ့သည်။
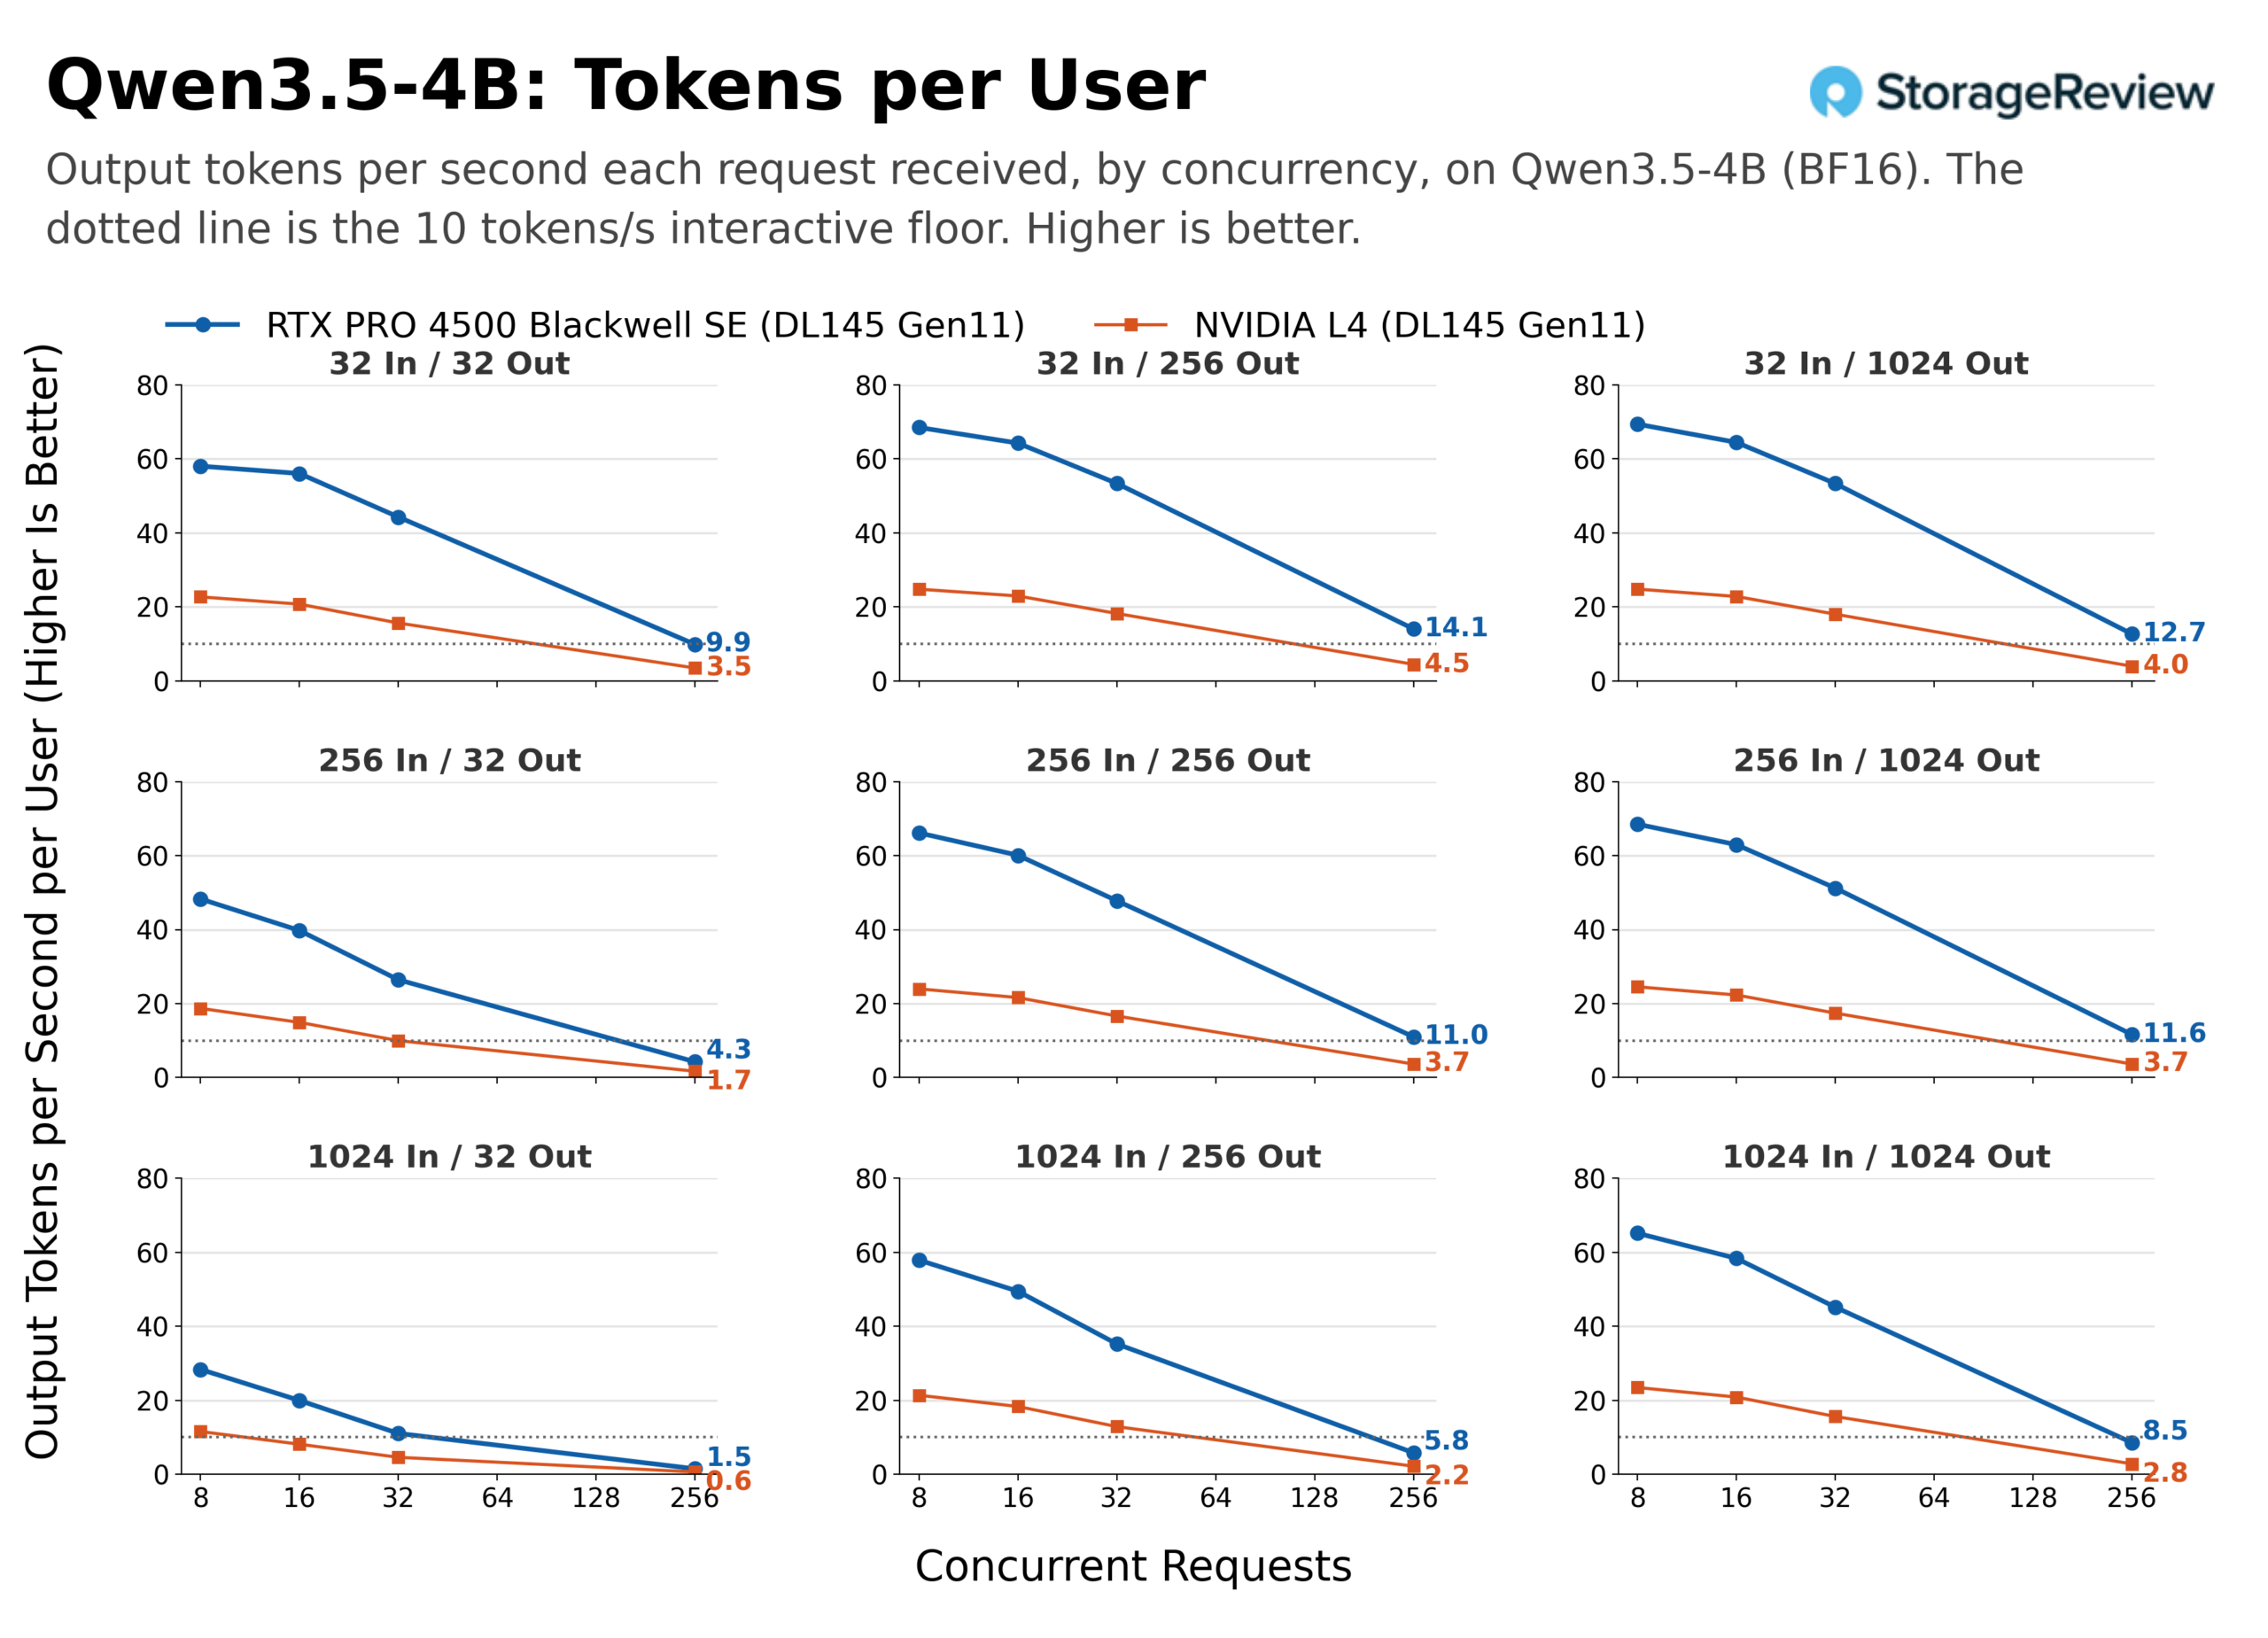
- အသုံးပြုသူတစ်ဦးချင်းစီ၏ မြန်နှုန်းသည် ချက်တင်ပုံသဏ္ဍာန် ညွှန်ကြားချက်များတွင် အစည်းအဝေး ၂၅၆ ခုအထိ ခံနိုင်ရည်ရှိသည်- အထွက်ကို တစ်ပြိုင်နက်တည်းအလိုက် ပိုင်းခြားကြည့်လျှင် 4500 သည် တိုတောင်းသောနှင့် အလတ်စား prompts များအတွက် 256-token သို့မဟုတ် ပိုရှည်သော အဖြေများတွင် တစ်ပြိုင်နက်တည်း 256 ခုဖြင့် အသုံးပြုသူတိုင်းကို တစ်စက္ကန့်လျှင် တိုကင် 11 ခုမှ 22 ခုအထိ ပေးနေဆဲဖြစ်ပြီး L4 သည် 3.7 မှ 8.7 အထိ ကျဆင်းသွားခဲ့သည်။ L4 သည် ပုံအများစုတွင် 32 မှ 256 sessions အကြား ဒုတိယထပ်တွင် တိုကင် 10 ခုအောက်နှင့် prefill-heavy 1,024/32 ပုံတွင် 8 ခုမှ 16 ခုကြား ရှိသည်။ short-answer နှင့် 1,024-token-prompt ပုံများတွင်မှလွဲ၍ 4500 သည် 256 တွင် ၎င်း၏အထက်တွင် ရှိနေပါသည်။
- 32GB နှင့် FP4 သည် L4 သည် မူရင်းအတိုင်း မလည်ပတ်နိုင်သော မော်ဒယ်အတန်းအစားတစ်ခုကို ဖွင့်ပေးသည်- Gemma 4 26B-A4B မှာ NVFP4 မှာ FP8 KV cache ပါတဲ့ 4500 ဟာ 165W မှာ တစ်ပြိုင်နက်တည်း 32 ခုနဲ့ တစ်စက္ကန့်ကို output token 1,613 ခု ထုတ်လုပ်ခဲ့ပြီး RTX PRO 6000 Blackwell က workstation တစ်ခုမှာ 8 ကနေ 32 ခုအထိ တစ်ပြိုင်နက်တည်း 266 ကနေ 471W အထိ ထုတ်လုပ်နိုင်ခဲ့တာနဲ့ ထက်ဝက်လောက်သာ ရှိပါတယ်။ 256 ခု တစ်ပြိုင်နက်တည်းမှာ ကွာဟချက်က 2.5x လောက်အထိ ကျယ်ပြန့်သွားပါတယ်။
RTX PRO 4500 Server Edition ကို ဘာအတွက် ဒီဇိုင်းထုတ်ထားတာလဲ။
NVIDIA က RTX PRO 4500 Blackwell Server Edition ကို GTC 2026 မှာ RTX PRO server မိသားစုရဲ့ entry tier အနေနဲ့ ကြေညာခဲ့ပြီး L4 ရဲ့ ဆက်ခံသူအဖြစ်လည်း ကြေညာခဲ့ပါတယ်။ RTX PRO 4500 Blackwell workstation card နဲ့ နာမည်တူပြီး နှစ်ခုစလုံးမှာ silicon နဲ့ 10,496 CUDA core count ကို မျှဝေထားပေမယ့် ထုတ်ကုန်တွေက ကွဲပြားပါတယ်။ Server Edition မှာ display output နဲ့ fan ကို လျှော့ချထားပြီး board power ကို 165W အထိ ထိန်းထားပေးကာ data center feature set ကို ထည့်သွင်းထားပါတယ်- 16GB instance နှစ်ခုအထိ၊ confidential computing၊ တတိယ NVENC နဲ့ NVDEC နဲ့ vGPU support တို့ပါ။ NVIDIA က memory ကို 800GB/s နဲ့ FP4 Tensor peak ကို 1.6 PFLOPS နဲ့ sparsity မှာ ထားရှိထားပြီး ဒီ card ကို “mainstream data center နဲ့ edge server တွေအတွက် ရည်ရွယ်တဲ့ power-efficient Blackwell GPU” အဖြစ် ဖော်ပြပါတယ်။ ဒီအကြောင်းကို ကျွန်တော်တို့ရဲ့ HPE GTC 2026 coverage မှာ ဖော်ပြခဲ့ပါတယ် ။
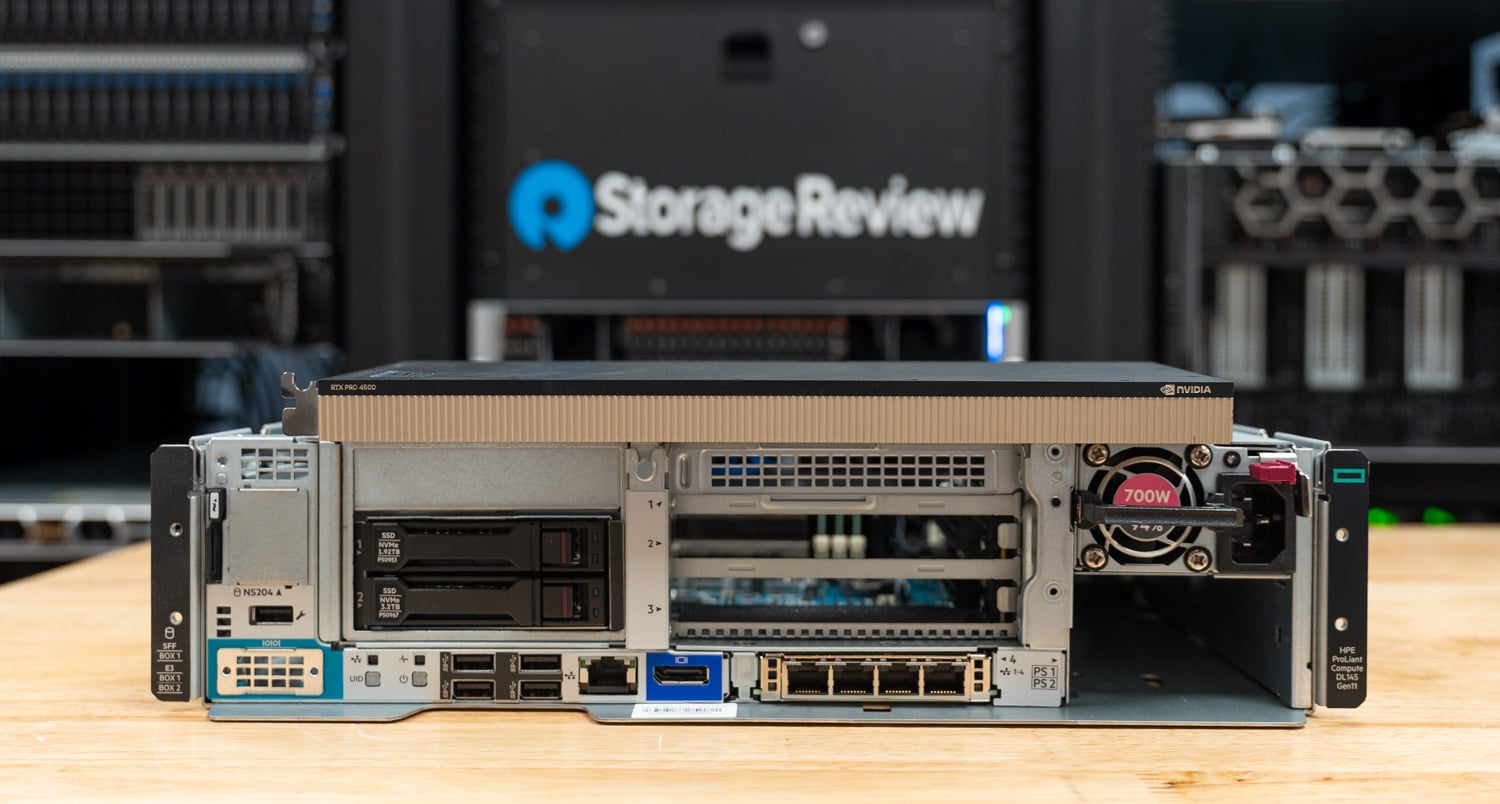
NVIDIA က form factor ကိုလည်း ပြောင်းလဲခဲ့ပါတယ်- ၂၀၂၄ ခုနှစ်မှာ ကျွန်တော်တို့ သုံးသပ်ခဲ့တဲ့ L4 က half-height, half-length, 72W card ဖြစ်ပြီး 24GB GDDR6 300GB/s ပါရှိပါတယ်၊ RTX PRO 4500 Server Edition က full-height, full-length single-slot board ဖြစ်တဲ့အတွက် slot တစ်ခုပဲ ယူပေမယ့် full-length riser နဲ့ 16-pin power feed လိုအပ်ပါတယ်။ DL145 Gen11 ရဲ့ standard slot က full-height, half-length ဖြစ်ပြီး HPE က ကျွန်တော်တို့ရဲ့ unit ကို full-length riser နဲ့ power cable နဲ့ configure လုပ်ထားပါတယ်။ စာရွက်ပေါ်မှာတော့ 4500 က L4 ရဲ့ memory bandwidth ထက် ၂.၇ ဆ၊ memory ၃၃% ပိုကြီးပြီး FP8 Tensor ရဲ့ power ထက် ၁.၇ ဆ ပိုကြီးပြီး L4 မှာ hardware မရှိတဲ့ FP4 path ပါရှိပါတယ်။
| specification | RTX PRO 4500 Blackwell Server Edition | NVIDIA L4 |
|---|---|---|
| ပလက်ဖောင်းခြုံငုံသုံးသပ်ချက် | ||
| ဗိသုကာအတတ်ပညာ | ဘလက်ဝဲလ် | Ada Lovelace |
| CUDA cores များ | 10,496 | 7,424 |
| မှတ်ဉာဏ် | ECC ပါရှိသော 32GB GDDR7 | 24GB GDDR6 |
| မှတ်ဉာဏ် bandwidth ကို | 800GB / s နဲ့ | 300GB / s နဲ့ |
| စွမ်းဆောင်ရည် (NVIDIA ၏ အမြင့်ဆုံးကိန်းဂဏန်းများ၊ နည်းပါးမှုနှင့်အတူ) | ||
| FP32 | 51 TFLOPS | 30.3 TFLOPS |
| FP8 တန်ဆာ | 811 TFLOPS | 485 TFLOPS |
| FP4 တန်ဆာ | ၁၁.၁၅ PFLOPS | အားမထောက်ပံ့ |
| ပါဝါနှင့် ပုံစံအချက် | ||
| ဘုတ်ပါဝါ | 165W | 72W |
| Form ကိုအချက် | တစ်ခုတည်းသော အပေါက်၊ အမြင့်အပြည့်၊ အရှည်အပြည့်၊ passive | တစ်ခုတည်းသော အပေါက်၊ အမြင့်တစ်ဝက်၊ အရှည်တစ်ဝက်၊ passive |
| ပါဝါ connector ကို | PCIe CEM5 ၁၆-ပင် ၁ ခု | အပေါက်ပါ ပါဝါရှိသည် |
| interface | PCIe 5.0 x16 | PCIe 4.0 x16 |
| အင်္ဂါရပ်များ | ||
| ME | 16GB မှာ ၂ ခုအထိ အသုံးပြုနိုင်ပါတယ် | အဘယ်သူမျှမ |
| NVENC / NVDEC | 3 / 3 | 2 / 4 |
| လျှို့ဝှက်တွက်ချက်ခြင်း | နိုင်စွမ်း | အဘယ်သူမျှမ |
Edge Server: HPE ProLiant DL145 Gen11
HPE သည် DL145 Gen11 ကို ဆာဗာအခန်းမရှိသော နေရာများအတွက် ဆာဗာအဖြစ် နေရာချထားပါသည်။ DL145 အတွက် ၎င်း၏ ဖြေရှင်းချက်အကျဉ်းချုပ်တွင် DL145 နှင့် NVIDIA Nemotron တွင် လေဝင်လေထွက်နည်းသော ဗီဒိုများ၊ ဖုန်ထူသောနေရာများနှင့် ပူပြင်းသော သို့မဟုတ် အေးသောနေရာများအတွက် -5C မှ 55C အထိ အဆင့်သတ်မှတ်ထားသော နံရံတွင်တပ်ဆင်နိုင်သော၊ တိတ်ဆိတ်သောသေတ္တာတစ်ခုအကြောင်း ဖော်ပြထားပြီး၊ ပါဝါနှင့် Ethernet သာရှိသော နေရာရာပေါင်းများစွာကို အသုံးပြုရန် iLO နှင့် Compute Ops Management တို့ပါရှိသည်။ HPE သည် လက်လီရောင်းဝယ်ရေး၊ ကျန်းမာရေးစောင့်ရှောက်မှု၊ ဘဏ္ဍာရေး၊ ထုတ်လုပ်ရေးနှင့် စွမ်းအင်တို့ကို ပစ်မှတ်စက်မှုလုပ်ငန်းများအဖြစ် အကြံပြုထားပြီး ၎င်းစာရင်းပြုစုထားသော workloads များသည် ဤသုံးသပ်ချက်က တိုင်းတာသည့် workloads များဖြစ်သည်- သေးငယ်သော ဘာသာစကားမော်ဒယ်များ၊ RAG နှင့် vector search တို့သည် ဒေသတွင်းတွင် လည်ပတ်နေသောကြောင့် latency-sensitive နှင့် ထိန်းညှိထားသောဒေတာများသည် ဆိုက်မှ ဘယ်တော့မှ မထွက်ခွာပါ။ DL145 Gen11 ကို စတင်မိတ်ဆက်ခဲ့စဉ်က ကျွန်ုပ်တို့ ပြန်လည်သုံးသပ်ခဲ့သောကြောင့် ဤနေရာတွင် ပလက်ဖောင်းခရီးစဉ်ကို ထပ်မံမလုပ်ဆောင်တော့ပါ။
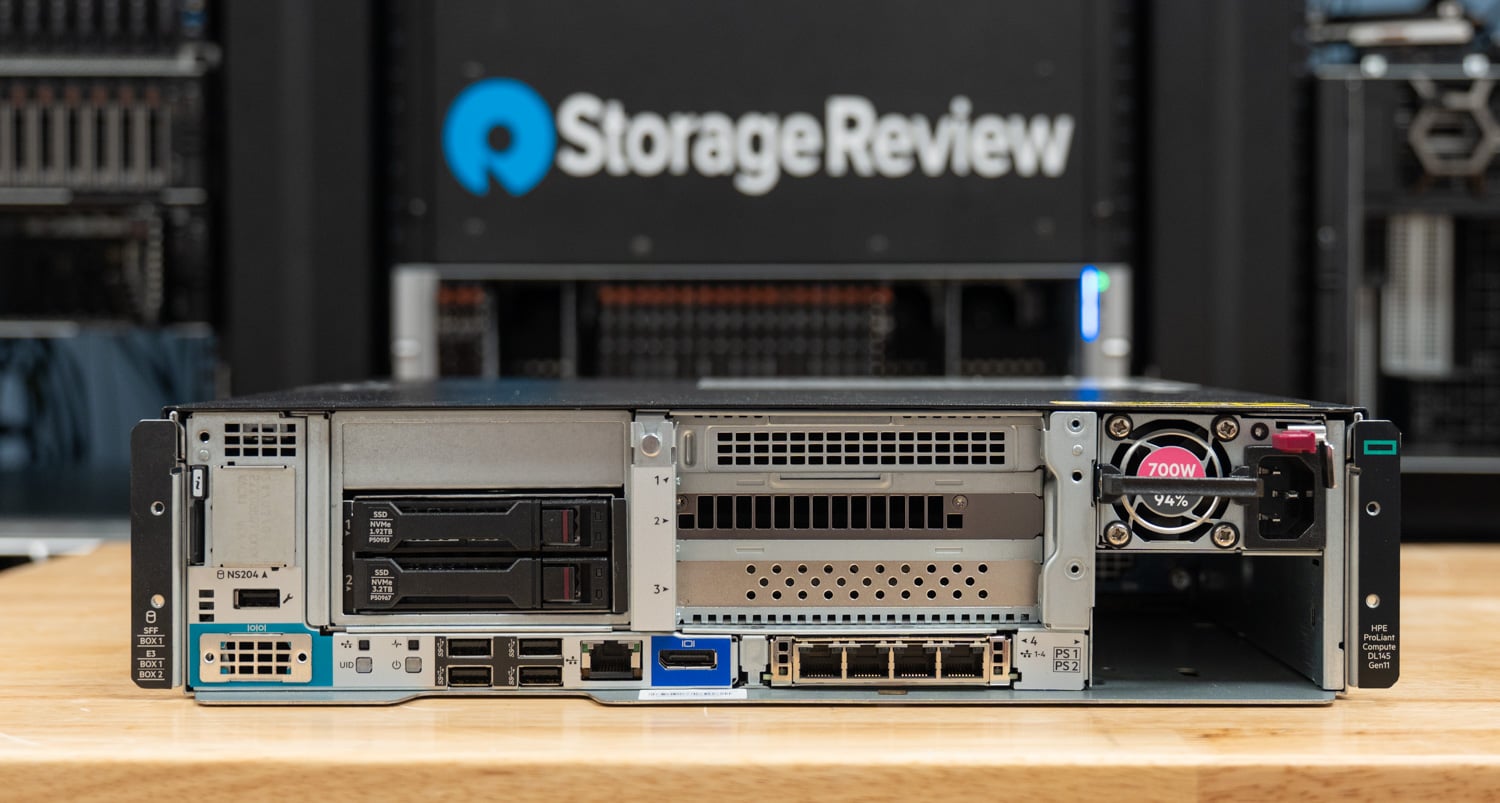
ဒီစမ်းသပ်မှုအတွက် ပေးပို့လိုက်တဲ့ ယူနစ် HPE ကို AMD EPYC 8534P တစ်ခု၊ 64-core၊ 128-thread Siena အစိတ်အပိုင်းတစ်ခု၊ 16GB DIMM ခြောက်ခုမှာ DDR5-4800 96GB နဲ့ full-length riser ပေါ်မှာ RTX PRO 4500 Blackwell Server Edition တို့နဲ့ configure လုပ်ထားပါတယ်။ chassis မှာ two-bay U.3 backplane ပါရှိပါတယ်။ ကျွန်တော်တို့ရဲ့ ယူနစ်မှာ SATA-only backplane cabling ပါရှိတာကြောင့် PCIe sled ပေါ်က 6.4TB Solidigm D7-P5620 NVMe SSD ကနေ boot လုပ်ခဲ့ပါတယ်။ GPU ရလဒ်တွေအပေါ် သက်ရောက်မှုမရှိပါဘူး။ L4 နှိုင်းယှဉ်ချက်မှာ server configuration အတိအကျကိုပဲ အသုံးပြုထားပါတယ်။ 4500 က HPE ရဲ့ Nemotron edge solution အတွက် ဒီ platform မှာ ပို့ပေးတဲ့ card ဖြစ်ပြီး L4 ကတော့ ပြီးခဲ့တဲ့ နှစ်နှစ်က DL145 ပိုင်ရှင်တစ်ယောက်မှာ ဒီနေ့ အဲဒီ slot မှာ ရှိနိုင်ခြေအများဆုံးပါ။
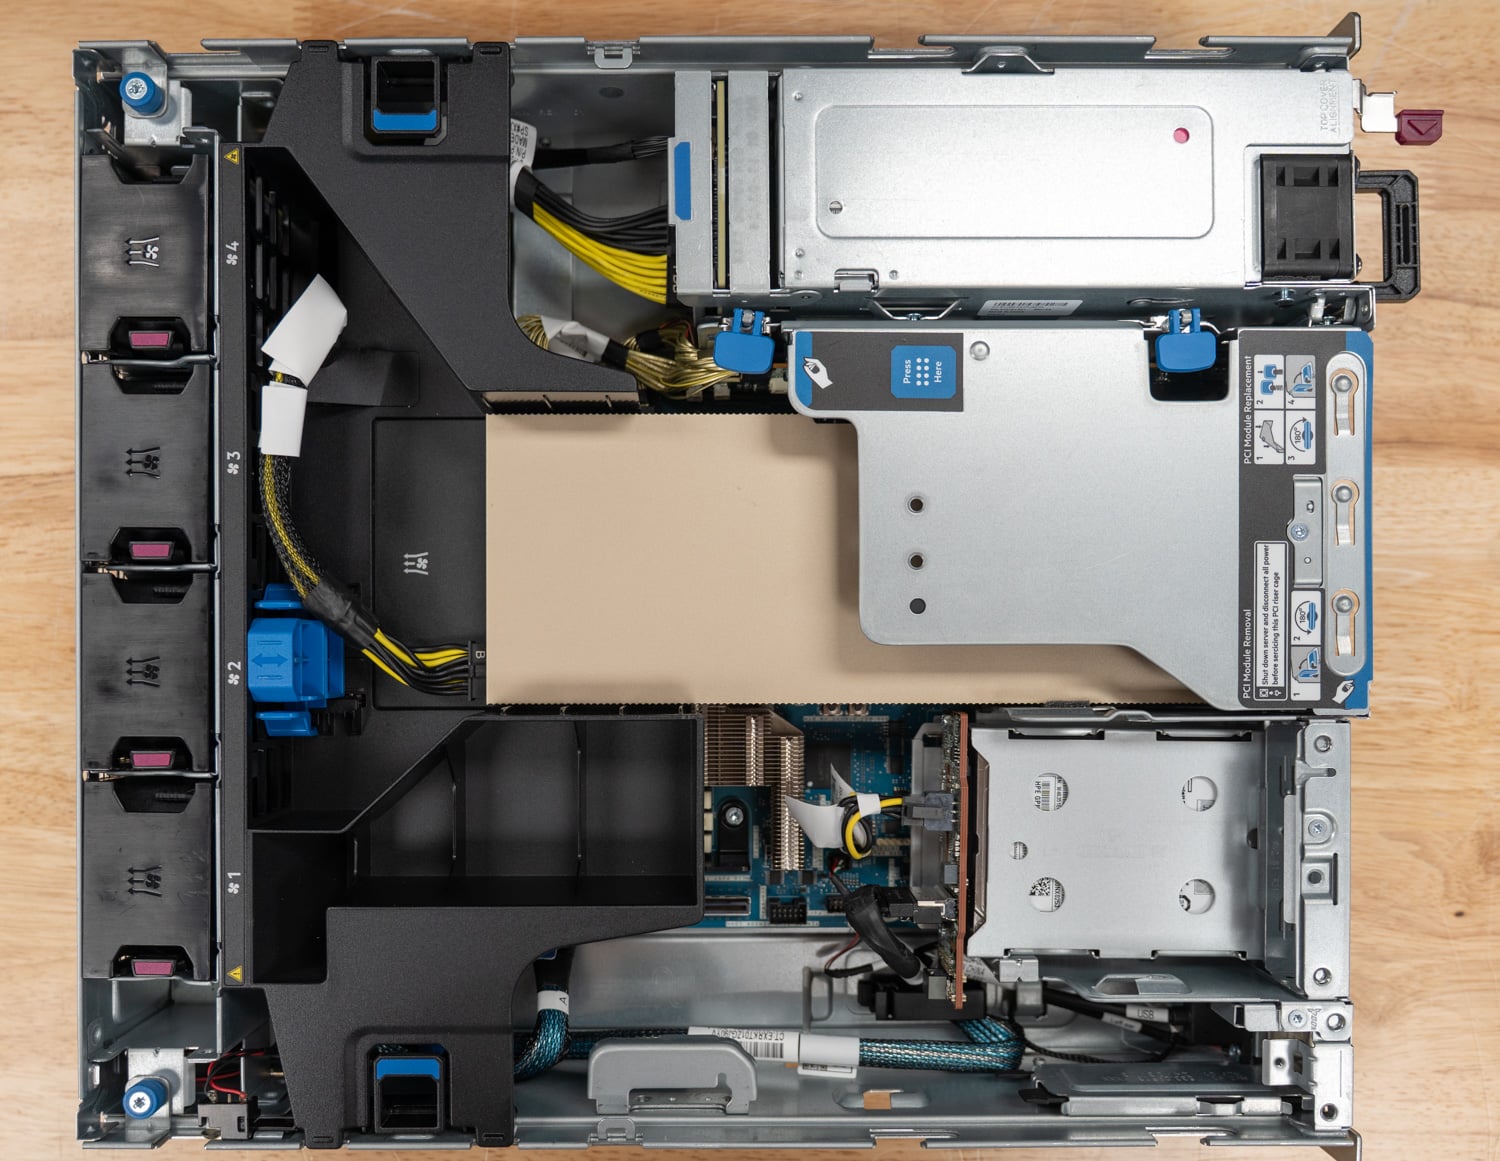
အောက်ဖော်ပြပါ ခွဲခြမ်းစိတ်ဖြာမှုကို နောက်ထပ် platform နံပါတ်နှစ်ခုက ပံ့ပိုးပေးသည်- DL145 သည် iLO မှတစ်ဆင့် server တစ်ခုလုံး၏ ပါဝါကို အစီရင်ခံပြီး Bench Platform သည် GPU ၏ board ပါဝါနှင့်အတူ လည်ပတ်မှုတိုင်းတွင် မှတ်တမ်းတင်ထားသောကြောင့် နံရံတွင်ရှိသော watts နှင့် ကတ်တွင်ရှိသော watts များအကြောင်း ကျွန်ုပ်တို့ ပြောနိုင်ပါသည်။ ထို့အပြင် server ၏ air path သည် passive card နှစ်ခုလုံးကို ၎င်းတို့၏ ကန့်သတ်ချက်များအတွင်း ထိန်းသိမ်းထားသည်- 4500 သည် အရှည်ဆုံးလည်ပတ်မှုများတွင် ပျမ်းမျှ GPU အပူချိန် 84C တွင် အမြင့်ဆုံးရောက်ရှိခဲ့ပြီး L4 သည် 86C တွင် နှစ်ခုစလုံးသည် 2U short-depth chassis တွင် စဉ်ဆက်မပြတ် full-power inference load အောက်တွင် ရှိနေခဲ့သည်။
ကျွန်ုပ်တို့ မည်သို့စမ်းသပ်ခဲ့သနည်း။
ဤသုံးသပ်ချက်တွင်ပါဝင်သော inference data အားလုံးကို Metrum AI Bench Platform (ဗားရှင်း 3.9.2၊ ၎င်း၏ယခင်အမည် Metrum Insights အောက်တွင် run ဖိုင်များတွင် မှတ်တမ်းတင်ထားသည်) ဖြင့် စုဆောင်းထားပြီး၊ vLLM 0.24.0 ကို serving engine အဖြစ် လုပ်ဆောင်သည်။ Bench Platform သည် system တစ်ခုချင်းစီနှင့် နှိုင်းယှဉ်၍ scenarios များ၏ fixed grid ကို လုပ်ဆောင်ပြီး scenario တိုင်းအတွက် throughput၊ latency percentiles၊ GPU telemetry နှင့် host power တို့ကို မှတ်တမ်းတင်ကာ ရလဒ်များကို job တစ်ခုလျှင် single dataset အဖြစ် export လုပ်သည်။ ကျွန်ုပ်တို့သည် Oregon State နှင့် Metrum AI ၏ လုပ်ဆောင်ချက်အကြောင်းကို ယခင်က ရေးသားခဲ့ပြီးဖြစ်ပြီး Dell သည် ၎င်း၏ R770AP နည်းပညာဆိုင်ရာ brief အတွက် တူညီသော platform ကို အသုံးပြုခဲ့သည်။ ကျွန်ုပ်တို့၏ GPU နှိုင်းယှဉ်မှု end-to-end ကို မောင်းနှင်ရန် ၎င်းကို ပထမဆုံးအကြိမ်အဖြစ် အသုံးပြုခဲ့ခြင်းဖြစ်သည်။ Metrum AI ၏ အင်ဂျင်နီယာများနှင့် ကျွန်ုပ်တို့၏ lab သည် အလုပ်များကို အတူတကွ လုပ်ဆောင်ခဲ့ပြီး Bench Platform သည် စုဆောင်းမှုကို လုပ်ဆောင်ပြီး ကျွန်ုပ်တို့၏အဖွဲ့သည် hardware၊ မော်ဒယ်များနှင့် မေးခွန်းများကို သတ်မှတ်ခဲ့သည်။
Metrum AI သည် open-source companion တစ်ခုဖြစ်သည့် Metrum AI Bench CLI ကိုလည်း ထုတ်ဝေထားပြီး စာဖတ်သူများသည် ၎င်းတို့၏ကိုယ်ပိုင်စနစ်များတွင် တူညီသောစမ်းသပ်မှုပုံစံကို လုပ်ဆောင်ရန် အသုံးပြုနိုင်ပါသည်။ Metrum AI သည် မှတ်ပုံတင်ထားသော ကုန်အမှတ်တံဆိပ်တစ်ခုဖြစ်ပြီး Metrum AI Bench CLI နှင့် Metrum AI Bench Platform တို့သည် Metrum AI, Inc. ၏ ကုန်အမှတ်တံဆိပ်များဖြစ်သည်။ Metrum AI Bench ကိုအသုံးပြုခြင်းသည် Metrum AI မှ ထောက်ခံချက်ပေးသည်ဟု မဆိုလိုပါ။
grid သည် prompt ပုံစံ ကိုးခုဖြစ်သည်- input token ၃၂၊ ၂၅၆ နှင့် ၁၀၂၄ ခုပေါင်းစပ်မှုတိုင်းတွင် အများဆုံး output token ၃၂၊ ၂၅၆ နှင့် ၁၀၂၄ ခုပါဝင်ပြီး၊ တစ်ခုချင်းစီကို concurrent request ၁၊ ၈၊ ၁၆၊ ၃၂ နှင့် ၂၅၆ ခုဖြင့် run ပြီး GPU တစ်ခုလျှင် scenario ၄၅ ခုအတွက် လုပ်ဆောင်သည်။ L4 ၏ Gemma 4 run တွင် concurrent request ၆၄ နှင့် ၁၂၈ ခုလည်းပါဝင်ပြီး၊ ၎င်းသည် ၎င်း၏ ceiling ကိုရှာဖွေရာတွင် အသုံးဝင်ကြောင်း တွေ့ရှိရသည်။ scenario တစ်ခုစီသည် concurrent request ၁ မှ ၃၂ အထိ stream တစ်ခုလျှင် ၁၅ ခုပေးပို့ပြီး ၂၅၆ တွင် request ၁,၂၈၀ ပေးပို့သည်။ ၄၅၀၀ ၏ Gemma 4 E4B အလုပ်ကို သုံးကြိမ်လုပ်ဆောင်ခဲ့သည်။ repeats များအကြား scenario-to-scenario variance သည် ၂% အောက်ရှိပြီး၊ ကျွန်ုပ်တို့သည် median ကိုအစီရင်ခံပါသည်။ L4 နှင့် 4500 BF16 အလုပ်များနှင့် Gemma 4 26B အလုပ်နှစ်ခုသည် ကတ်တစ်ခုစီတွင် တစ်ခုစီဖြစ်ပြီး scenario run ၃၇၈ ခုအထိ ရောက်ရှိလာပြီး ၎င်းတို့တစ်လျှောက်တွင် 4500 scenario တစ်ခု၏ တစ်ကြိမ်ထပ်ခါတလဲလဲလုပ်ဆောင်ခြင်းတွင် request တစ်ခု မအောင်မြင်ခဲ့ဘဲ ၎င်းကို ထုတ်ဖော်ပြောကြားရန်အတွက်သာ ဖော်ပြထားပါသည်။
မော်ဒယ်သုံးခုက စမ်းသပ်မှုကို လွှမ်းခြုံထားပါတယ်- Qwen3.5-4B နဲ့ Gemma 4 E4B နှစ်ခုစလုံးဟာ BF16 မှာ BF16 KV cache နဲ့ အလုပ်လုပ်ပြီး L4 နဲ့ 4500 နှစ်ခုစလုံးက လည်ပတ်ပြီး မော်ဒယ်အရွယ်အစားက 24GB ကတ်ပေါ်က edge deployment တစ်ခုဟာ ဒီနေ့ခေတ်မှာ လက်တွေ့ကျကျ လည်ပတ်နေပါတယ်။ Gemma 4 26B-A4B ဟာ 4B active parameters တွေလောက်ရှိတဲ့ 26B mixture-of-experts မော်ဒယ်ဖြစ်ပြီး 4500 မှာ FP8 KV cache နဲ့ပဲ NVFP4 မှာ လည်ပတ်ခဲ့ပြီး Dell Pro Max Tower T2 မှာ RTX PRO 6000 Blackwell Workstation Edition (600W) ကို reference point အနေနဲ့ အသုံးပြုထားပါတယ်။ L4 မှာ native FP4 compute မရှိသလို BF16 မှာ အဲဒီမော်ဒယ်အတွက် နေရာမရှိတာကြောင့် စမ်းသပ်မှုရဲ့ အဲဒီအပိုင်းမှာ မပါဝင်ပါဘူး။
ဇယားများကိုဖတ်ရှုခြင်းနှင့်ပတ်သက်၍ မှတ်စုသုံးခု- ကျွန်ုပ်တို့သည် throughput plot များကို concurrent request ၈ ခုတွင် စတင်ပါသည်။ single-request scenario များသည် လုံလောက်သောတိုတောင်းမှု (၁၅ ခု၊ တစ်ခုလျှင် စက္ကန့်အနည်းငယ်) ဖြစ်သောကြောင့် 4500 ရှိ single-user Qwen scenario တစ်ခုစီ၏ ပထမဆုံး request သည် first-token delay ၃၇ မှ ၃၉ စက္ကန့်အထိ ရောက်ရှိပြီး run ၏ throughput ကိန်းဂဏန်းကို လွဲမှားစေပါသည်။ ထို့ကြောင့် single-user case အတွက် ကျွန်ုပ်တို့သည် per-token latency နှင့် response time ကို အစီရင်ခံပါသည်၊ ၎င်းတို့သည် မထိခိုက်ပါ။ GPU power သည် sampled average တစ်ခုဖြစ်သောကြောင့် ပျမ်းမျှဖြေရှင်းရန် လုံလောက်သော ရှည်လျားသော run များမှ watt လျှင် token များကိုသာ တွက်ချက်ပါသည်၊ ၎င်းသည် လက်တွေ့တွင် concurrent ၁၆ ခုနှင့်အထက်ဖြစ်သည်။ ထို့အပြင် ရှည်လျားသော prompts များဖြင့် 256 concurrent တွင် ကတ်နှစ်ခုစလုံးသည် KV cache နှင့် vLLM queues request များ ကုန်သွားပါသည်။ ထိုအမှတ်များသည် အစစ်အမှန် throughput နံပါတ်များဖြစ်သော်လည်း၊ ထို load ရှိ time-to-first-token ကိန်းဂဏန်းများသည် queue တစ်ခုကို ဖော်ပြပြီး ကျွန်ုပ်တို့သည် concurrent ၃၂ ခုကို latency-sensitive အသုံးပြုမှုအတွက် working range အဖြစ် သတ်မှတ်ပါသည်။
Qwen3.5-4B
အောက်ဖော်ပြပါဇယားကွက်သည် Qwen3.5-4B နှိုင်းယှဉ်ချက်တစ်ခုလုံးကို တစ်ချက်ကြည့်လိုက်ပါ- ကတ်နှစ်ခုလုံးတွင် တစ်စက္ကန့်လျှင် output token များ၊ တစ်ပြိုင်နက်တည်း request ၈ ခုမှ ၂၅၆ ခုအထိ။ တူညီသော curve shape သည် panel ကိုးခုလုံးတွင် ထပ်ခါတလဲလဲဖြစ်ပေါ်ပြီး 4500 opening သည် တစ်ပြိုင်နက်တည်း 8 ခုတွင် L4 opening ဖြစ်ပြီး 32 မှတစ်ဆင့် အနည်းငယ်ပိုမြန်စွာ scale လုပ်ကာ 256 တွင် 2.4x မှ 3.2x သို့ ရောက်ရှိသည်။
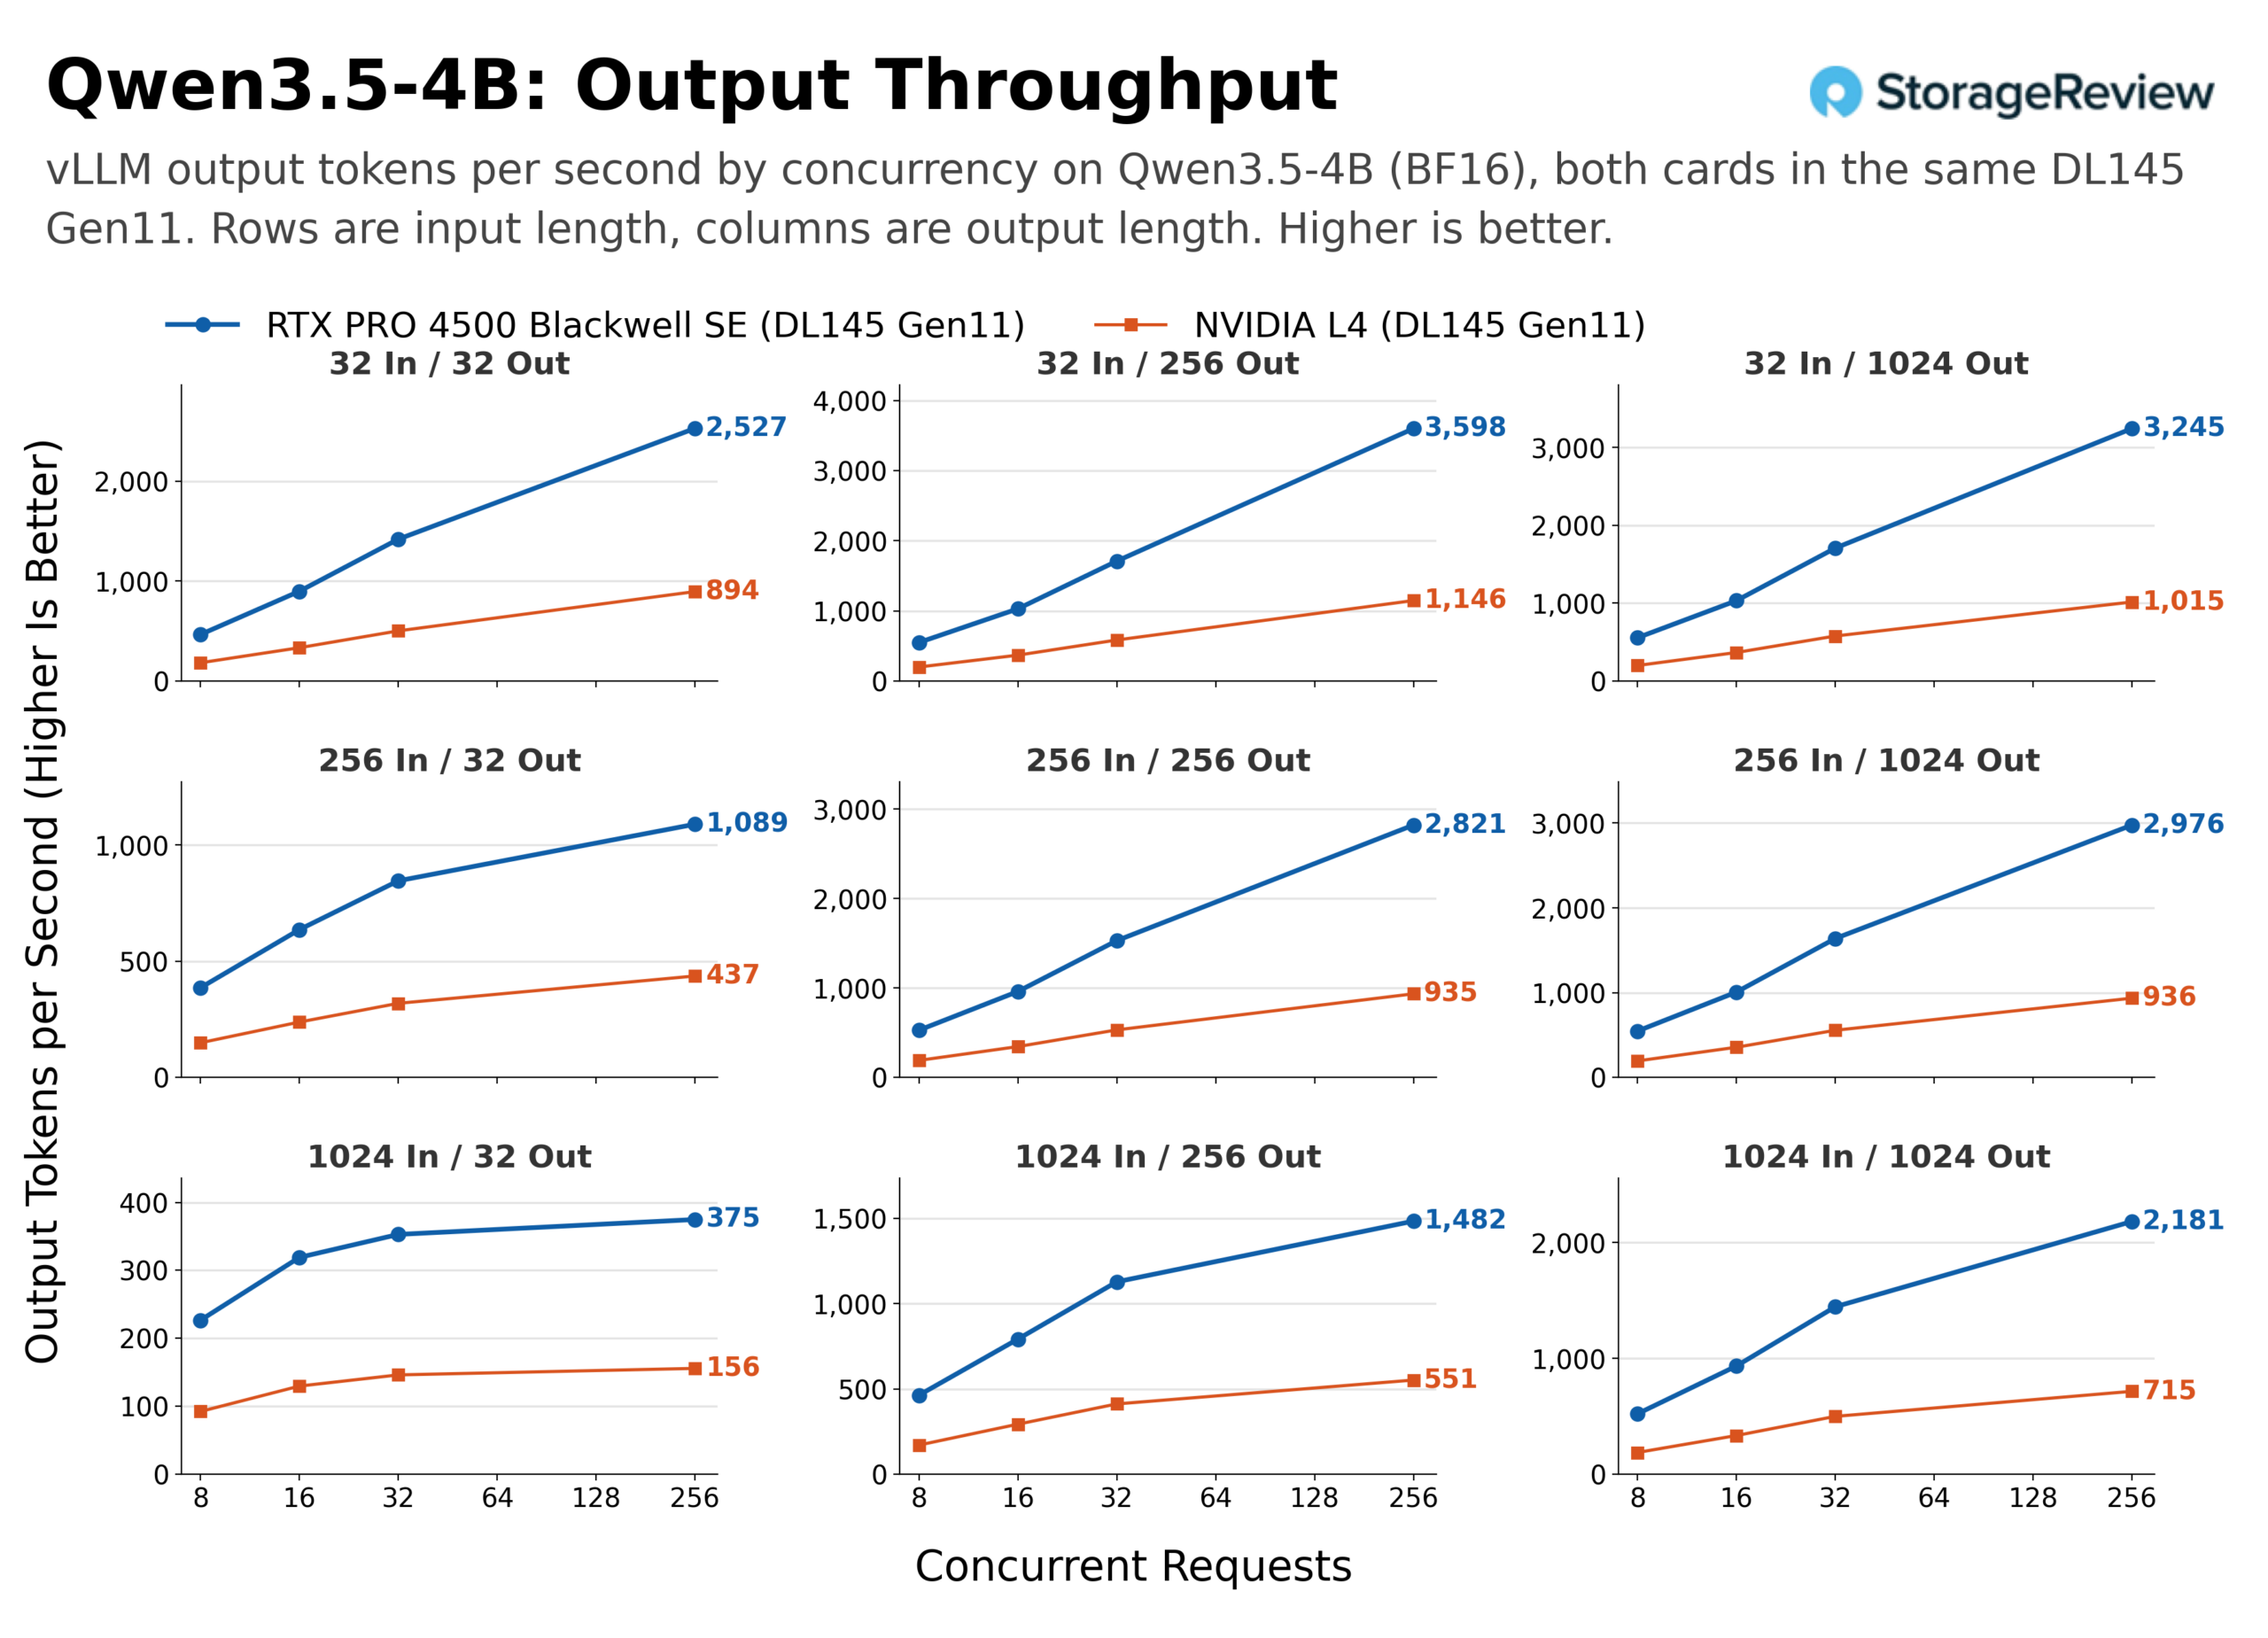
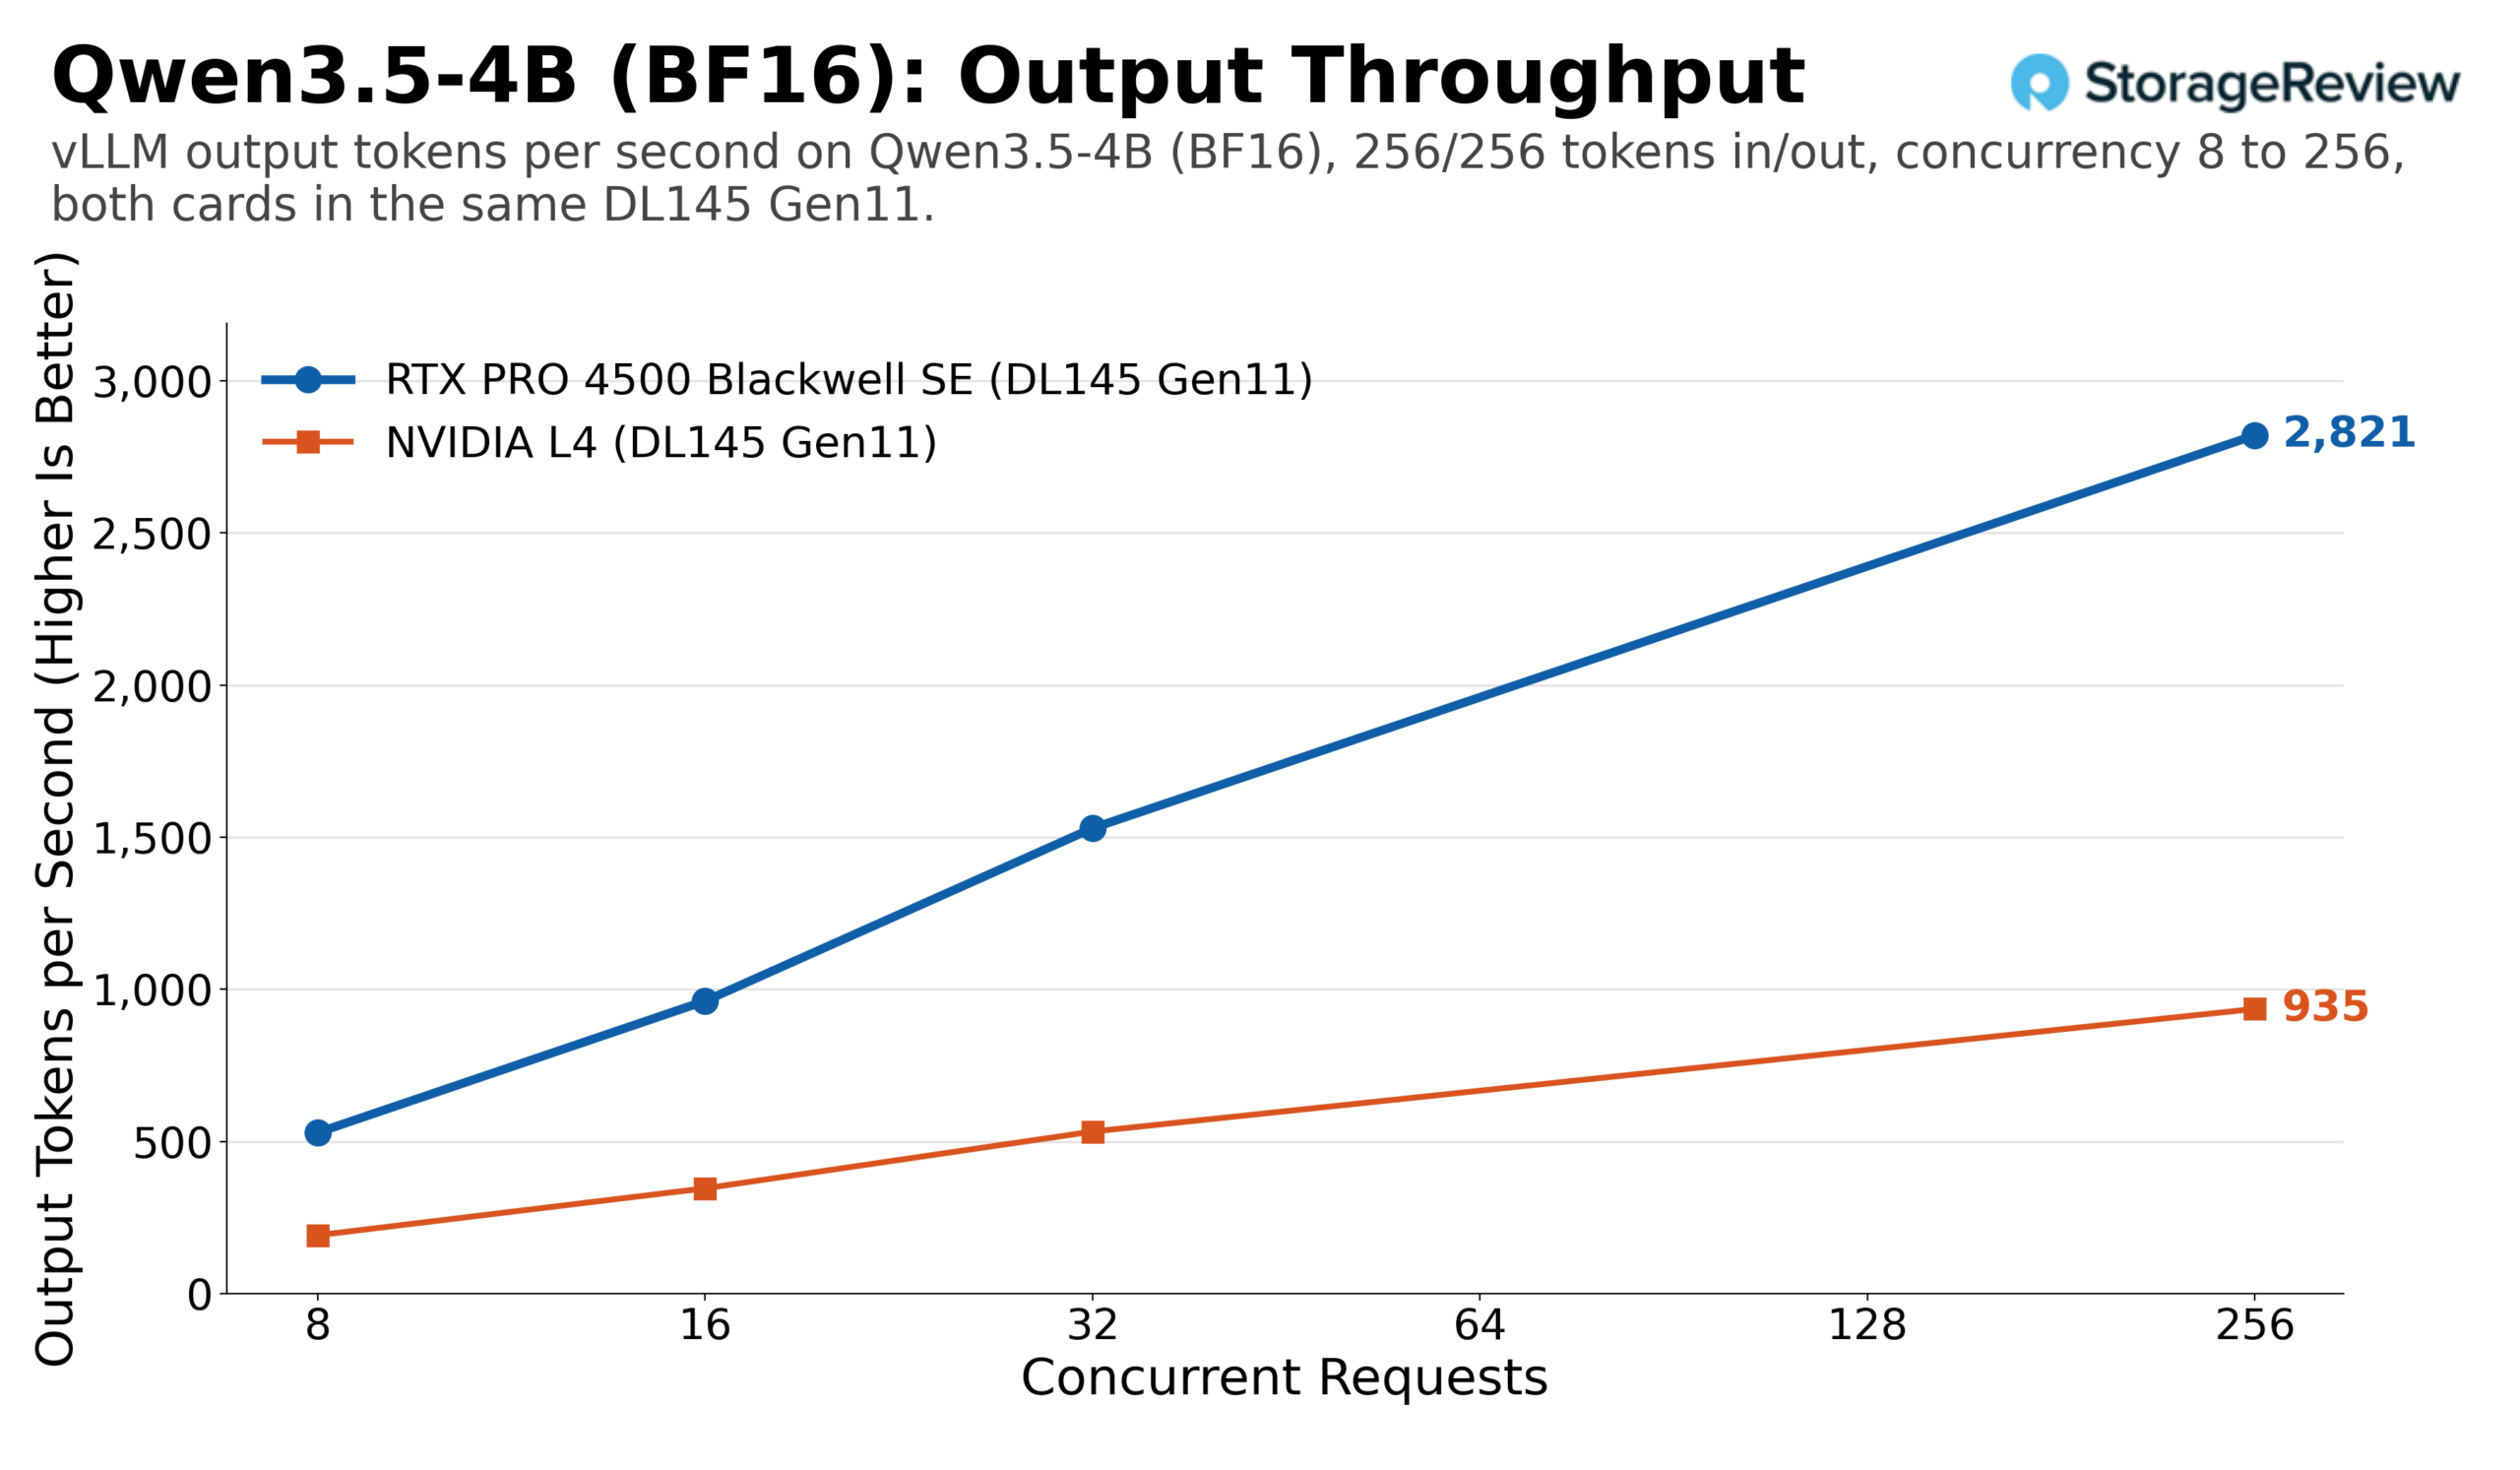
၂၅၆-လက်မ၊ ၂၅၆-ထွက်ပုံသဏ္ဍာန်ကို chat-size reference အဖြစ်ယူခြင်း- တစ်ပြိုင်နက်တည်း ၈ ခုတွင် L4 သည် တစ်စက္ကန့်လျှင် output token ၁၉၂ ခု ထုတ်လုပ်ပြီး ၄၅၀၀ သည် ၅၂၉ (၂.၇၆x)၊ တစ်ပြိုင်နက်တည်း ၃၂ ခုတွင် ၅၃၂ ခုနှင့် နှိုင်းယှဉ်လျှင် ၁,၅၂၉ (၂.၈၇x)၊ တစ်ပြိုင်နက်တည်း ၂၅၆ ခုတွင် ၉၃၅ ခုနှင့် နှိုင်းယှဉ်လျှင် ၂,၈၂၁ (၃.၀၂x)။ အရှည်ဆုံးပုံသဏ္ဍာန်ဖြစ်သည့် တစ်ဖက်လျှင် token ၁၀၂၄ ခုသည် ၎င်းကို တိတိကျကျ ခြေရာခံသည်- တစ်ပြိုင်နက်တည်း ၃၂ ခုတွင် ၄၉၉ ခုနှင့် နှိုင်းယှဉ်လျှင် ၁,၄၄၅ ခုနှင့် ၂၅၆ ခုတွင် ၇၁၅ ခုနှင့် နှိုင်းယှဉ်လျှင် ၂,၁၈၁ ခု။ grid တစ်ခုလုံးတွင် အကျဉ်းဆုံးကွာဟချက်မှာ prefill-heavy 1,024-လက်မ၊ ၃၂-ထွက်ပုံသဏ္ဍာန်ဖြစ်ပြီး ၄၅၀၀ သည် တစ်ပြိုင်နက်တည်း ၈ ခုမှစ၍ တည်ငြိမ်သော ၂.၄x ကို ထိန်းသိမ်းထားသည်၊ အဘယ်ကြောင့်ဆိုသော် ထို workload သည် အလိုအလျောက်လုပ်ဆောင်ခြင်းဖြစ်ပြီး ကတ်နှစ်ခုစလုံးကို အစကတည်းက compute-bound လုပ်ထားသောကြောင့်ဖြစ်သည်။ Qwen3.5-4B ဟာ ကတ်နှစ်ခုလုံးရဲ့ အဲဒီပုံသဏ္ဍာန်မှာ တဖြည်းဖြည်း မြင့်တက်လာပါတယ်။ BF16 ဇယားကွက်တွေမှာ တစ်ပြိုင်နက်တည်း 16 မှာ ကျဆင်းသွားတဲ့ တစ်ခုတည်းသော ကျဆင်းမှုကတော့ 1,024/32 မှာ လည်ပတ်နေတဲ့ 4500 Gemma 4 E4B ဖြစ်ပြီး၊ သုံးကြိမ်စလုံးမှာ ပေါ်လာခဲ့ပါတယ်။ အကြောင်းရင်းကို ကျွန်ုပ်တို့ မဖော်ထုတ်နိုင်သေးပါဘူး။
အသုံးပြုသူတစ်ဦးတည်းအတွက်၊ throughput ratio သည် ကွာခြားချက်ကို လျော့တွက်ပြသည်၊ အဘယ်ကြောင့်ဆိုသော် လူတစ်ဦးမြင်သည်မှာ စကားလုံးများ မည်မျှမြန်မြန်ပေါ်လာသည်ကို ဖော်ပြသည်။ 256/256 shape တွင် 4500 သည် token တစ်ခုလျှင် ပျမ်းမျှ 12.4ms ဖြင့် ထုတ်ပေးပြီး၊ L4 သည် 35.0ms ဖြင့် ထုတ်ပေးသောကြောင့် 256-token အဖြေသည် 4500 တွင် 3.2 စက္ကန့်ခန့်နှင့် L4 တွင် 9.0 စက္ကန့်ခန့် ကြာမြင့်သည်။ 1,024 token တစ်ခုချင်းစီတွင် 36.6 စက္ကန့်နှင့် 13.1 စက္ကန့်ဖြစ်သည်။ ထိုတစ်ဦးတည်းအသုံးပြုသူအတွက် ပထမဆုံး token latency သည် 4500 တွင် 43ms နှင့် L4 တွင် 81ms၊ ရှည်လျားသော prompt အတွက် 219ms နှင့် 99ms ဖြစ်သည်။
load အောက်မှာ latency gap က ပိုကျယ်လာတယ်- 256/256 shape မှာ 32 concurrent မှာ L4 ရဲ့ first token ရဖို့ median time က 884ms ဖြစ်ပြီး 4500 တွေက 386ms ဖြစ်ပါတယ်။ 256 concurrent မှာ L4 က 39 စက္ကန့်အထိ ရောက်သွားခဲ့ပြီး 4500 ကတော့ 650ms မှာ ထိန်းထားနိုင်ခဲ့ပါတယ်။ 1,024/1,024 မှာ L4 က 32 concurrent (1,022ms) မှာ တစ်စက္ကန့်ကျော်ပြီး 256 မှာ 255 စက္ကန့်ကို ရောက်ရှိခဲ့ပြီး ဒါဟာ vLLM ရဲ့ queue မှာ KV cache လွတ်သွားအောင် လေးမိနစ်လောက် စောင့်ဆိုင်းနေရတဲ့ request တစ်ခုပါ။ 4500 က အဲဒီ shape မှာ တစ်စက္ကန့်မျဉ်းကို 256 concurrent မှာ 12.9 စက္ကန့်နဲ့ ဖြတ်ကျော်ခဲ့ပါတယ်။ အောက်ကဇယားမှာ L4 ရဲ့မျဉ်းတွေက plot area ကို 32 နဲ့ 256 ကြားမှာ ထားခဲ့ပြီး 4500 တွေက ပိုတိုတဲ့ shape မှာ တစ်စက္ကန့်အောက်မှာပဲ ရှိနေပါတယ်။
တူညီတဲ့ဒေတာကိုဖတ်ဖို့ နောက်ထပ်နည်းလမ်းတစ်ခုကတော့ အသုံးပြုသူတစ်ဦးချင်းစီပါ- တစ်စက္ကန့်ကို output tokens တွေရပြီး တစ်ပြိုင်နက်တည်း request အရေအတွက်နဲ့စားပါတယ်။ ဒါက queue မှာလူတစ်ဦးချင်းစီမြင်တဲ့နှုန်းပါ။ အောက်က grid မှာ interactive use အတွက် common threshold အဖြစ်ဆောင်ရွက်တဲ့ shape တစ်ခုစီအတွက် ဒုတိယထပ်တစ်ထပ်ကို token ၁၀ ခုနဲ့ နှိုင်းယှဉ်ပြထားပါတယ်။ တစ်ပြိုင်နက်တည်း ၃၂ ခုမှာ ၄၅၀၀ က shape တစ်ခုစီမှာ အသုံးပြုသူတစ်ဦးချင်းစီအတွက် တစ်စက္ကန့်ကို token ၄၄ မှ ၅၃ အထိ ထုတ်ပေးပြီး 1,024-in, 32-out မှာ ၁၁ ခုရှိပါတယ်။ L4 ကတော့ ၁၀ မှ ၁၈ အထိရှိပြီး အဲဒီ shape မှာပဲ ၄.၆ အထိကျဆင်းသွားပါပြီ။ တစ်ပြိုင်နက်တည်း ၂၅၆ ခုတွင် ၄၅၀၀ သည် chat-shaped ပေါင်းစပ်မှုလေးခု (32/256 တွင် ၁၄.၁၊ 32/1,024 တွင် ၁၂.၇၊ 256/256 တွင် ၁၁.၀ နှင့် 256/1,024 တွင် ၁၁.၆) တွင် ကြမ်းပြင်အထက်တွင် ရှိနေသည်၊ 32/32 တွင် ၉.၉ တွင် ၎င်းပေါ်တွင် ကျရောက်ပြီး 1,024-token prompts များနှင့် short-answer shapes များအောက်တွင် ကျရောက်သည်၊ အလုပ်အားလုံးနီးပါးသည် prefill များဖြစ်သည် 1,024/32 တွင် ၁.၅ အထိ ကျဆင်းသွားသည်။ L4 သည် ၂၅၆ ရှိ ပုံသဏ္ဌာန်တိုင်းတွင် ကြမ်းပြင်အောက်တွင် ရှိပြီး ၀.၆ မှ ၄.၅ အကြားတွင် ရှိသည်။ ၃၂ မှ ၂၅၆ အကြားတွင် မည်သည့်အရာကိုမျှ စမ်းသပ်ခြင်းမရှိသောကြောင့် မျဉ်းတစ်ကြောင်းစီသည် အစက်ချထားသော ကြမ်းပြင်ကို ဖြတ်ကျော်သည့် အမှတ်သည် ထို concurrencies နှစ်ခုကြားတွင် တစ်နေရာရာတွင် ရှိသည်။ ဇယားကပြသတာက L4 ရဲ့ဖြတ်ကူးမှုဟာ ပုံသဏ္ဌာန်တိုင်းမှာ 256 မတိုင်ခင်မှာ ရှိနေပြီး 4500 တွေကတော့ chat ပုံသဏ္ဌာန်တွေမှာ 256 ဒါမှမဟုတ် 256 အနီးမှာ ရှိနေပါတယ်။
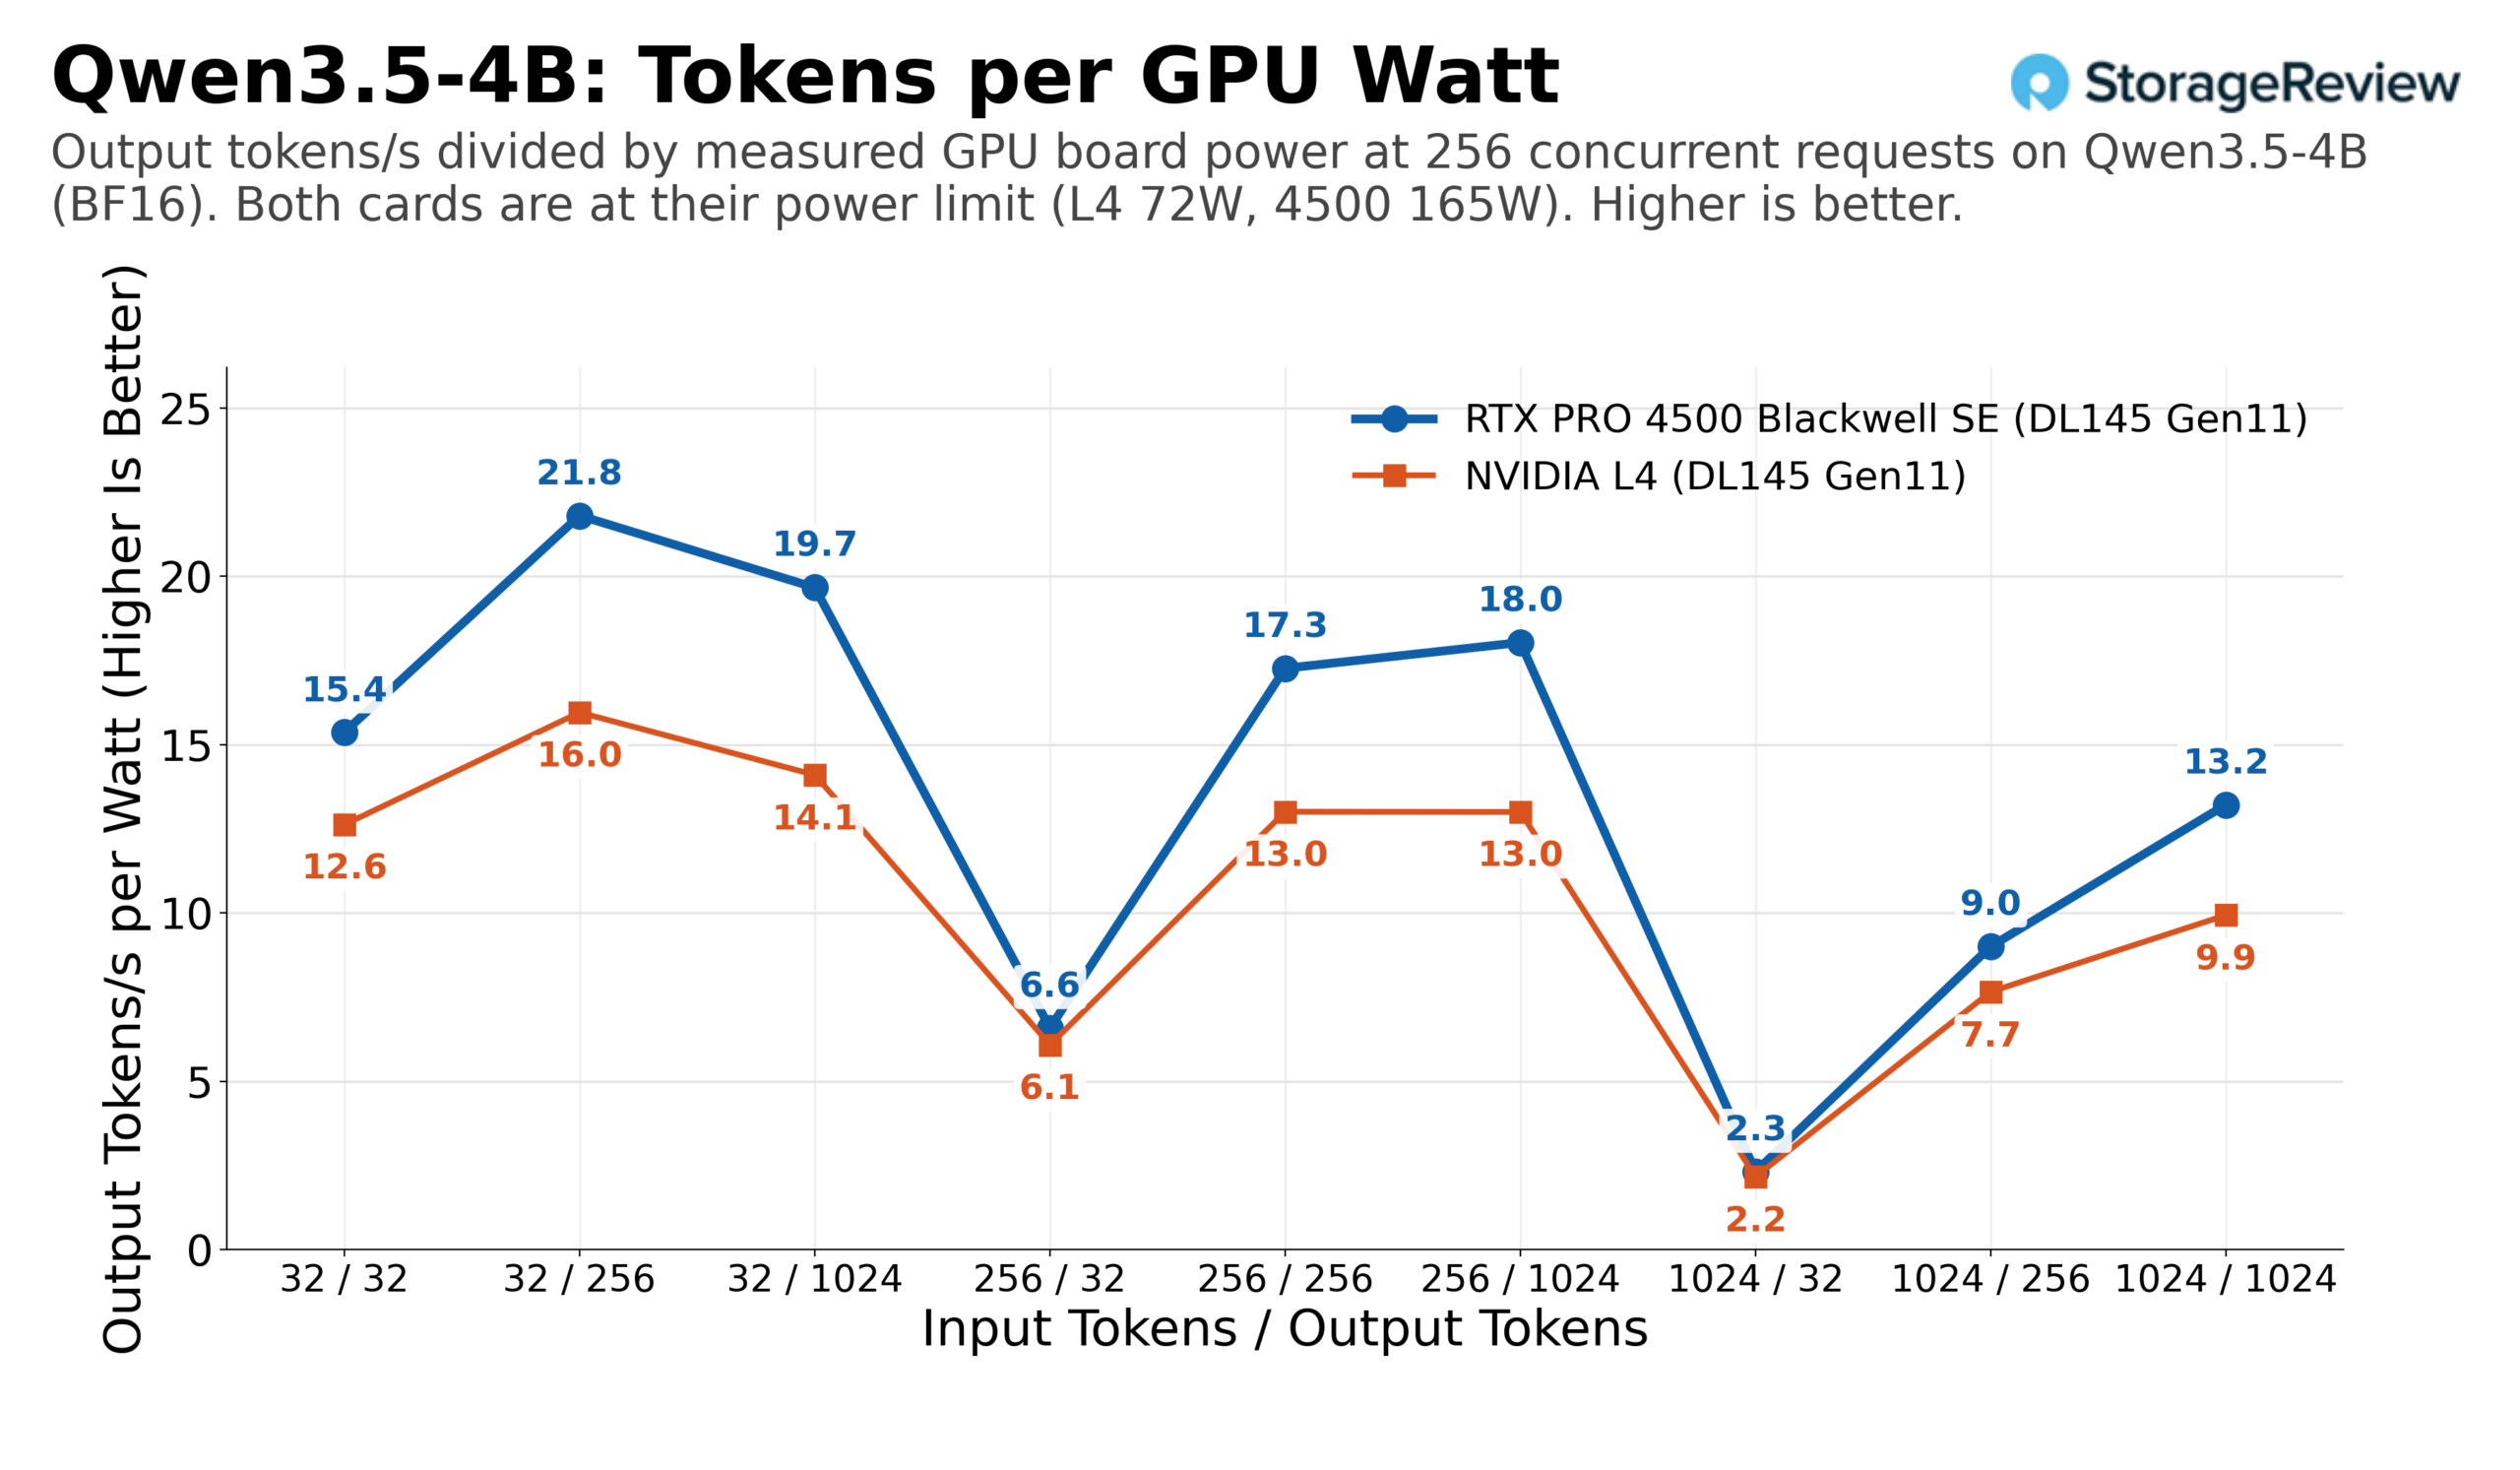
ကတ်နှစ်ခုစလုံးဟာ သူတို့ရဲ့ board power limit တွေဖြစ်တဲ့ L4 အတွက် 72W နဲ့ 4500 အတွက် 165W တို့ဟာ concurrent shape ၁၆ ခုကနေစပြီး အများစုမှာ လည်ပတ်ပါတယ်။ short-output shape တွေကတော့ နိမ့်ကျပါတယ်၊ ဥပမာ 4500 မှာ Qwen3.5-4B 32/32 အတွက် 125W နဲ့ concurrent 32 ခုမှာ လည်ပတ်တာကြောင့် GPU watt တစ်ခုချင်းစီရဲ့ tokens တွေဟာ throughput ကို အနီးကပ်ခြေရာခံပါတယ်။ concurrent 256 ခုမှာ 4500 ဟာ shape ကိုးခုမှာ L4 ရဲ့ output tokens တစ်ခုချင်းစီရဲ့ watt ပျမ်းမျှ 1.33x ကို ထုတ်လုပ်ခဲ့ပြီး prefill-bound 1,024/32 case မှာ 1.07x ကနေ 256/1,024 မှာ 1.39x အထိ ထုတ်လုပ်ခဲ့ပါတယ်။ အဲဒါကို 2.3x power difference နဲ့ မြှောက်လိုက်ရင် 3x throughput lead ကို ရရှိမှာဖြစ်ပြီး Blackwell က 1.33x က watt တစ်ခုချင်းစီရဲ့ ပိုအလုပ်လုပ်ပြီး 4500 က 2.3x က watt ပိုသုံးပါတယ်။
ဂျမ်မာ ၄ E4B
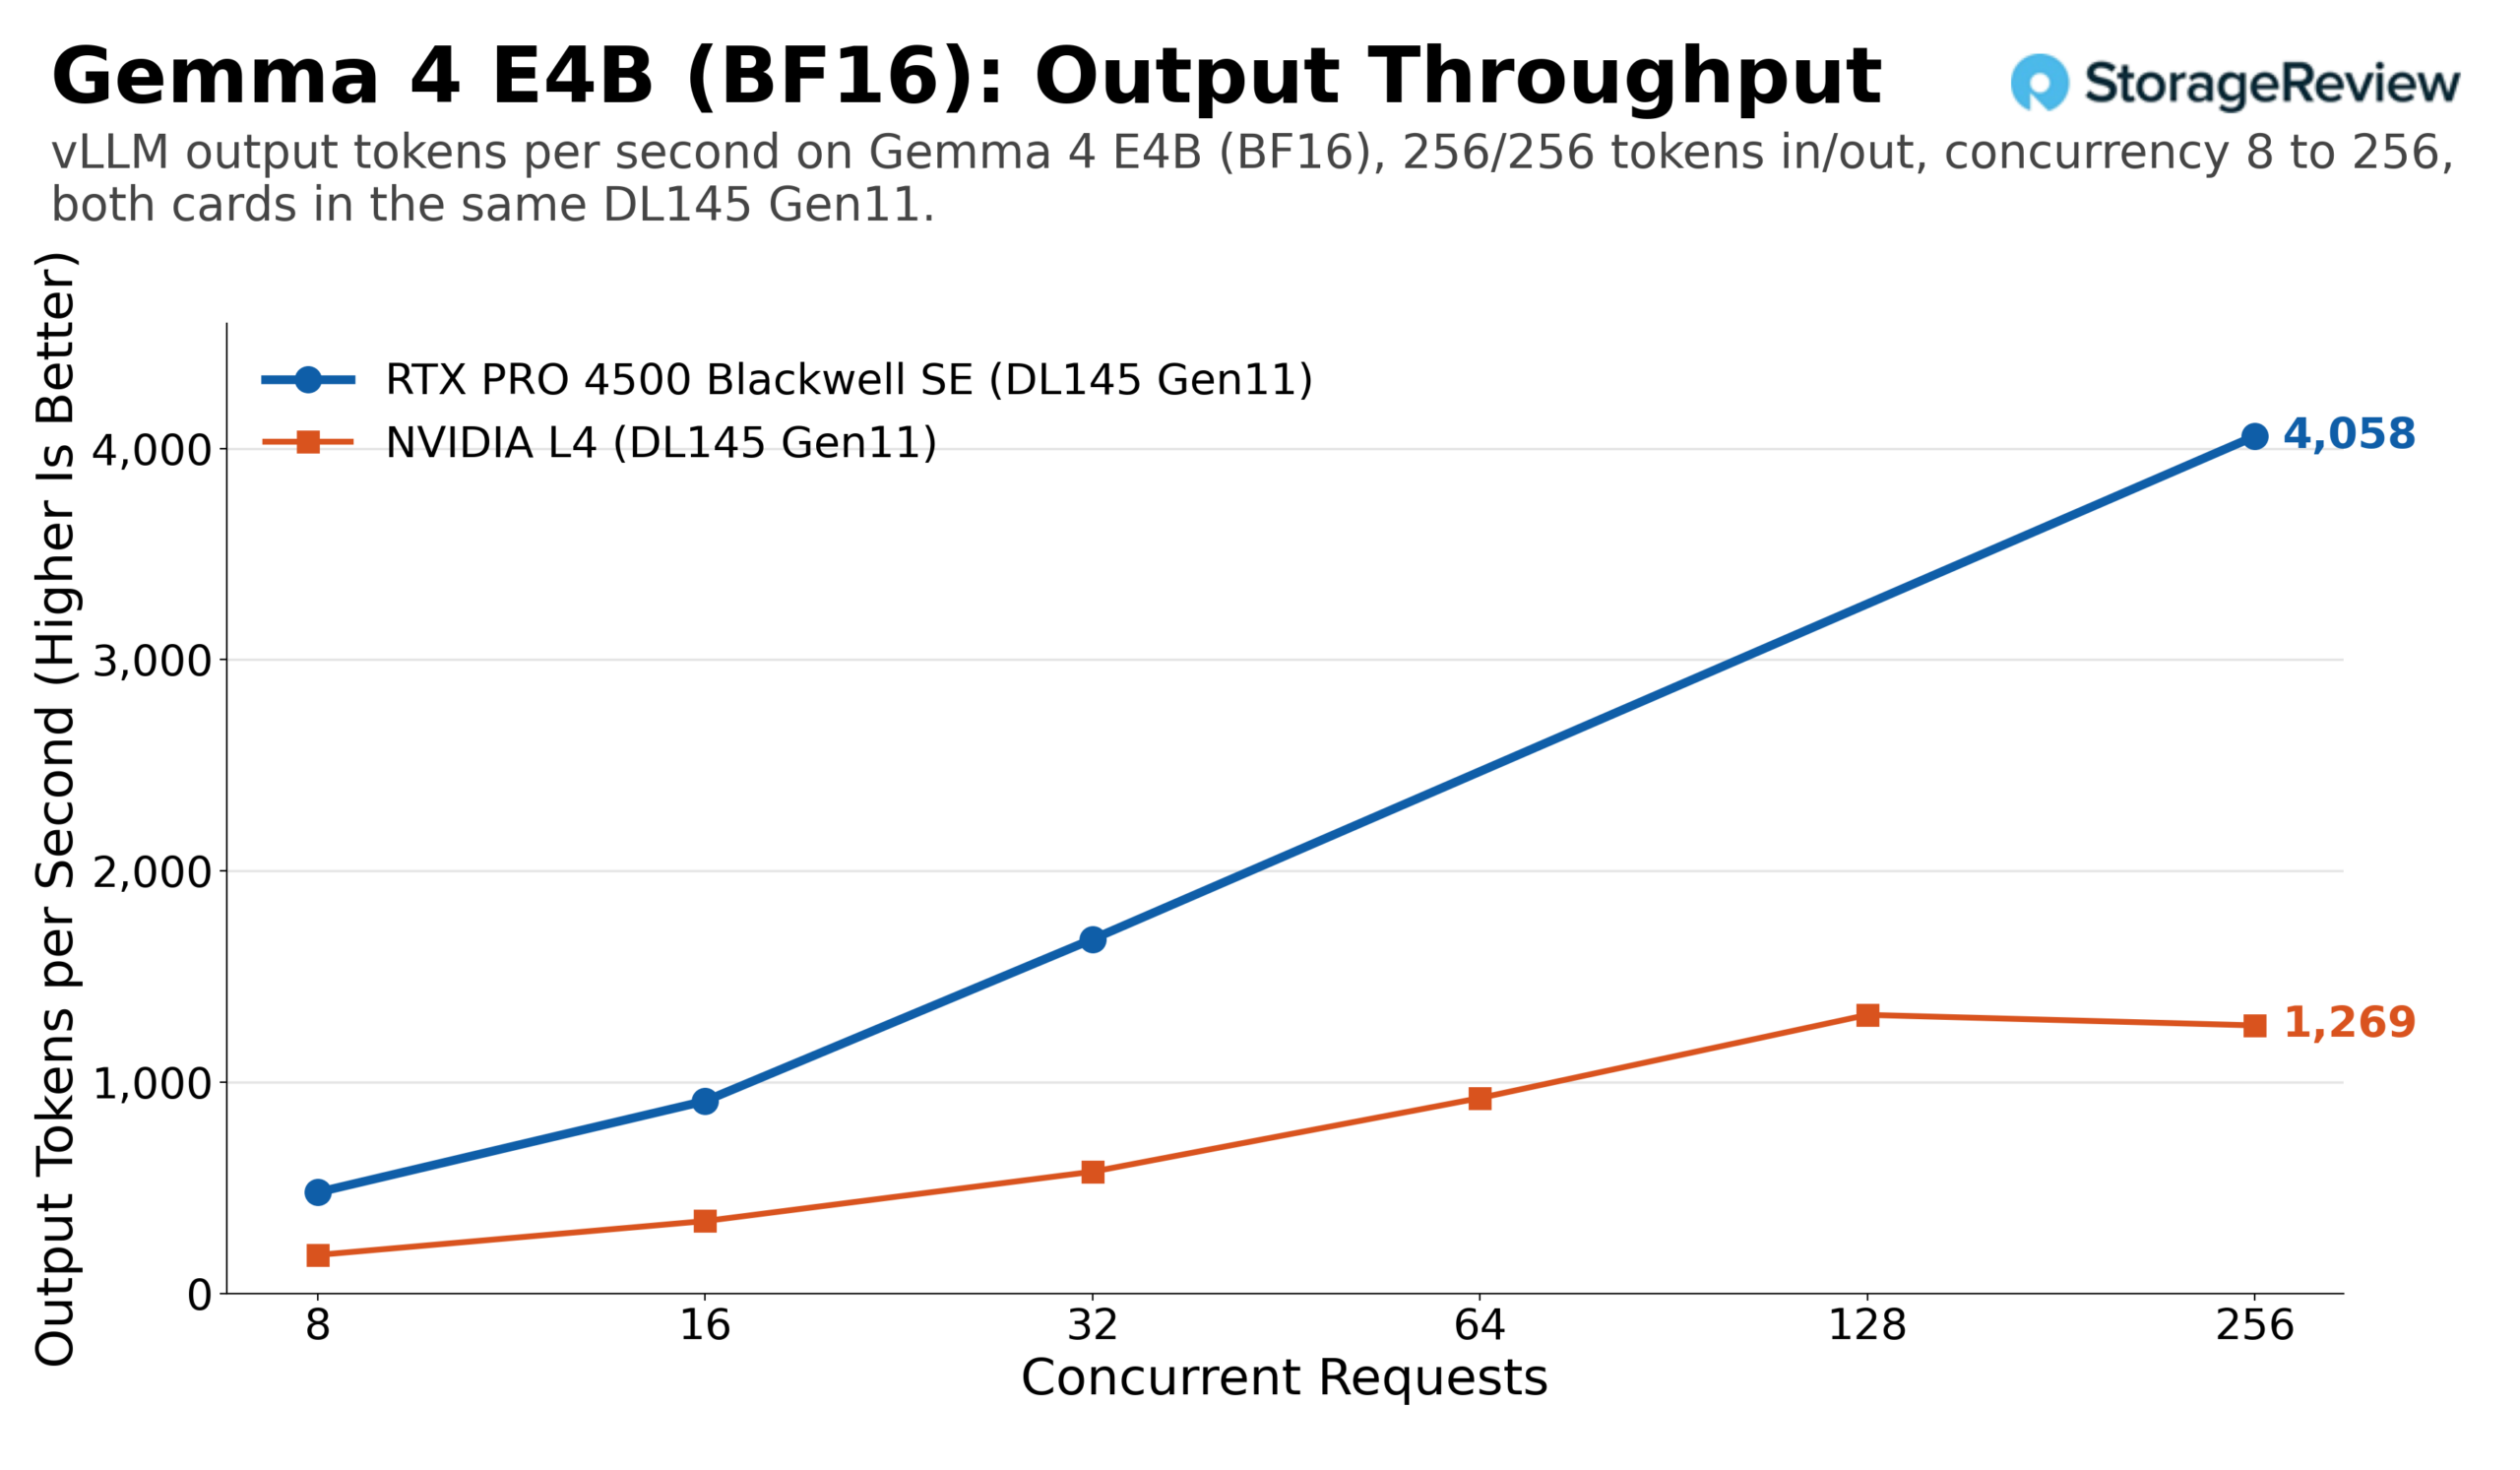
Gemma 4 E4B သည် Google ၏ Gemma 4 မိသားစု၏ သေးငယ်သောအဖွဲ့ဝင်ဖြစ်ပြီး E သည် ထိရောက်သော 4B parameters များအတွက် ကိုယ်စားပြုပြီး ကတ်နှစ်ခုလုံးတွင် Qwen3.5-4B ကဲ့သို့ လုပ်ဆောင်ပြီး grid ၏ထိပ်တွင် အနည်းငယ်ပိုမိုကောင်းမွန်သော scaling ရှိသည်။ 8 မှ 32 concurrent တွင် median throughput ratio သည် 2.67x (2.31x မှ 3.07x အကွာအဝေး) ဖြစ်ပြီး 256 တွင် 3.20x ရှိပြီး 1,024/1,024 shape သည် 3.82x သို့ရောက်ရှိသည်၊ အဘယ်ကြောင့်ဆိုသော် L4 သည် ၎င်း၏ KV cache ကန့်သတ်ချက်ထဲသို့ အလွန်နက်ရှိုင်းစွာရောက်ရှိနေသောကြောင့်ဖြစ်သည်။
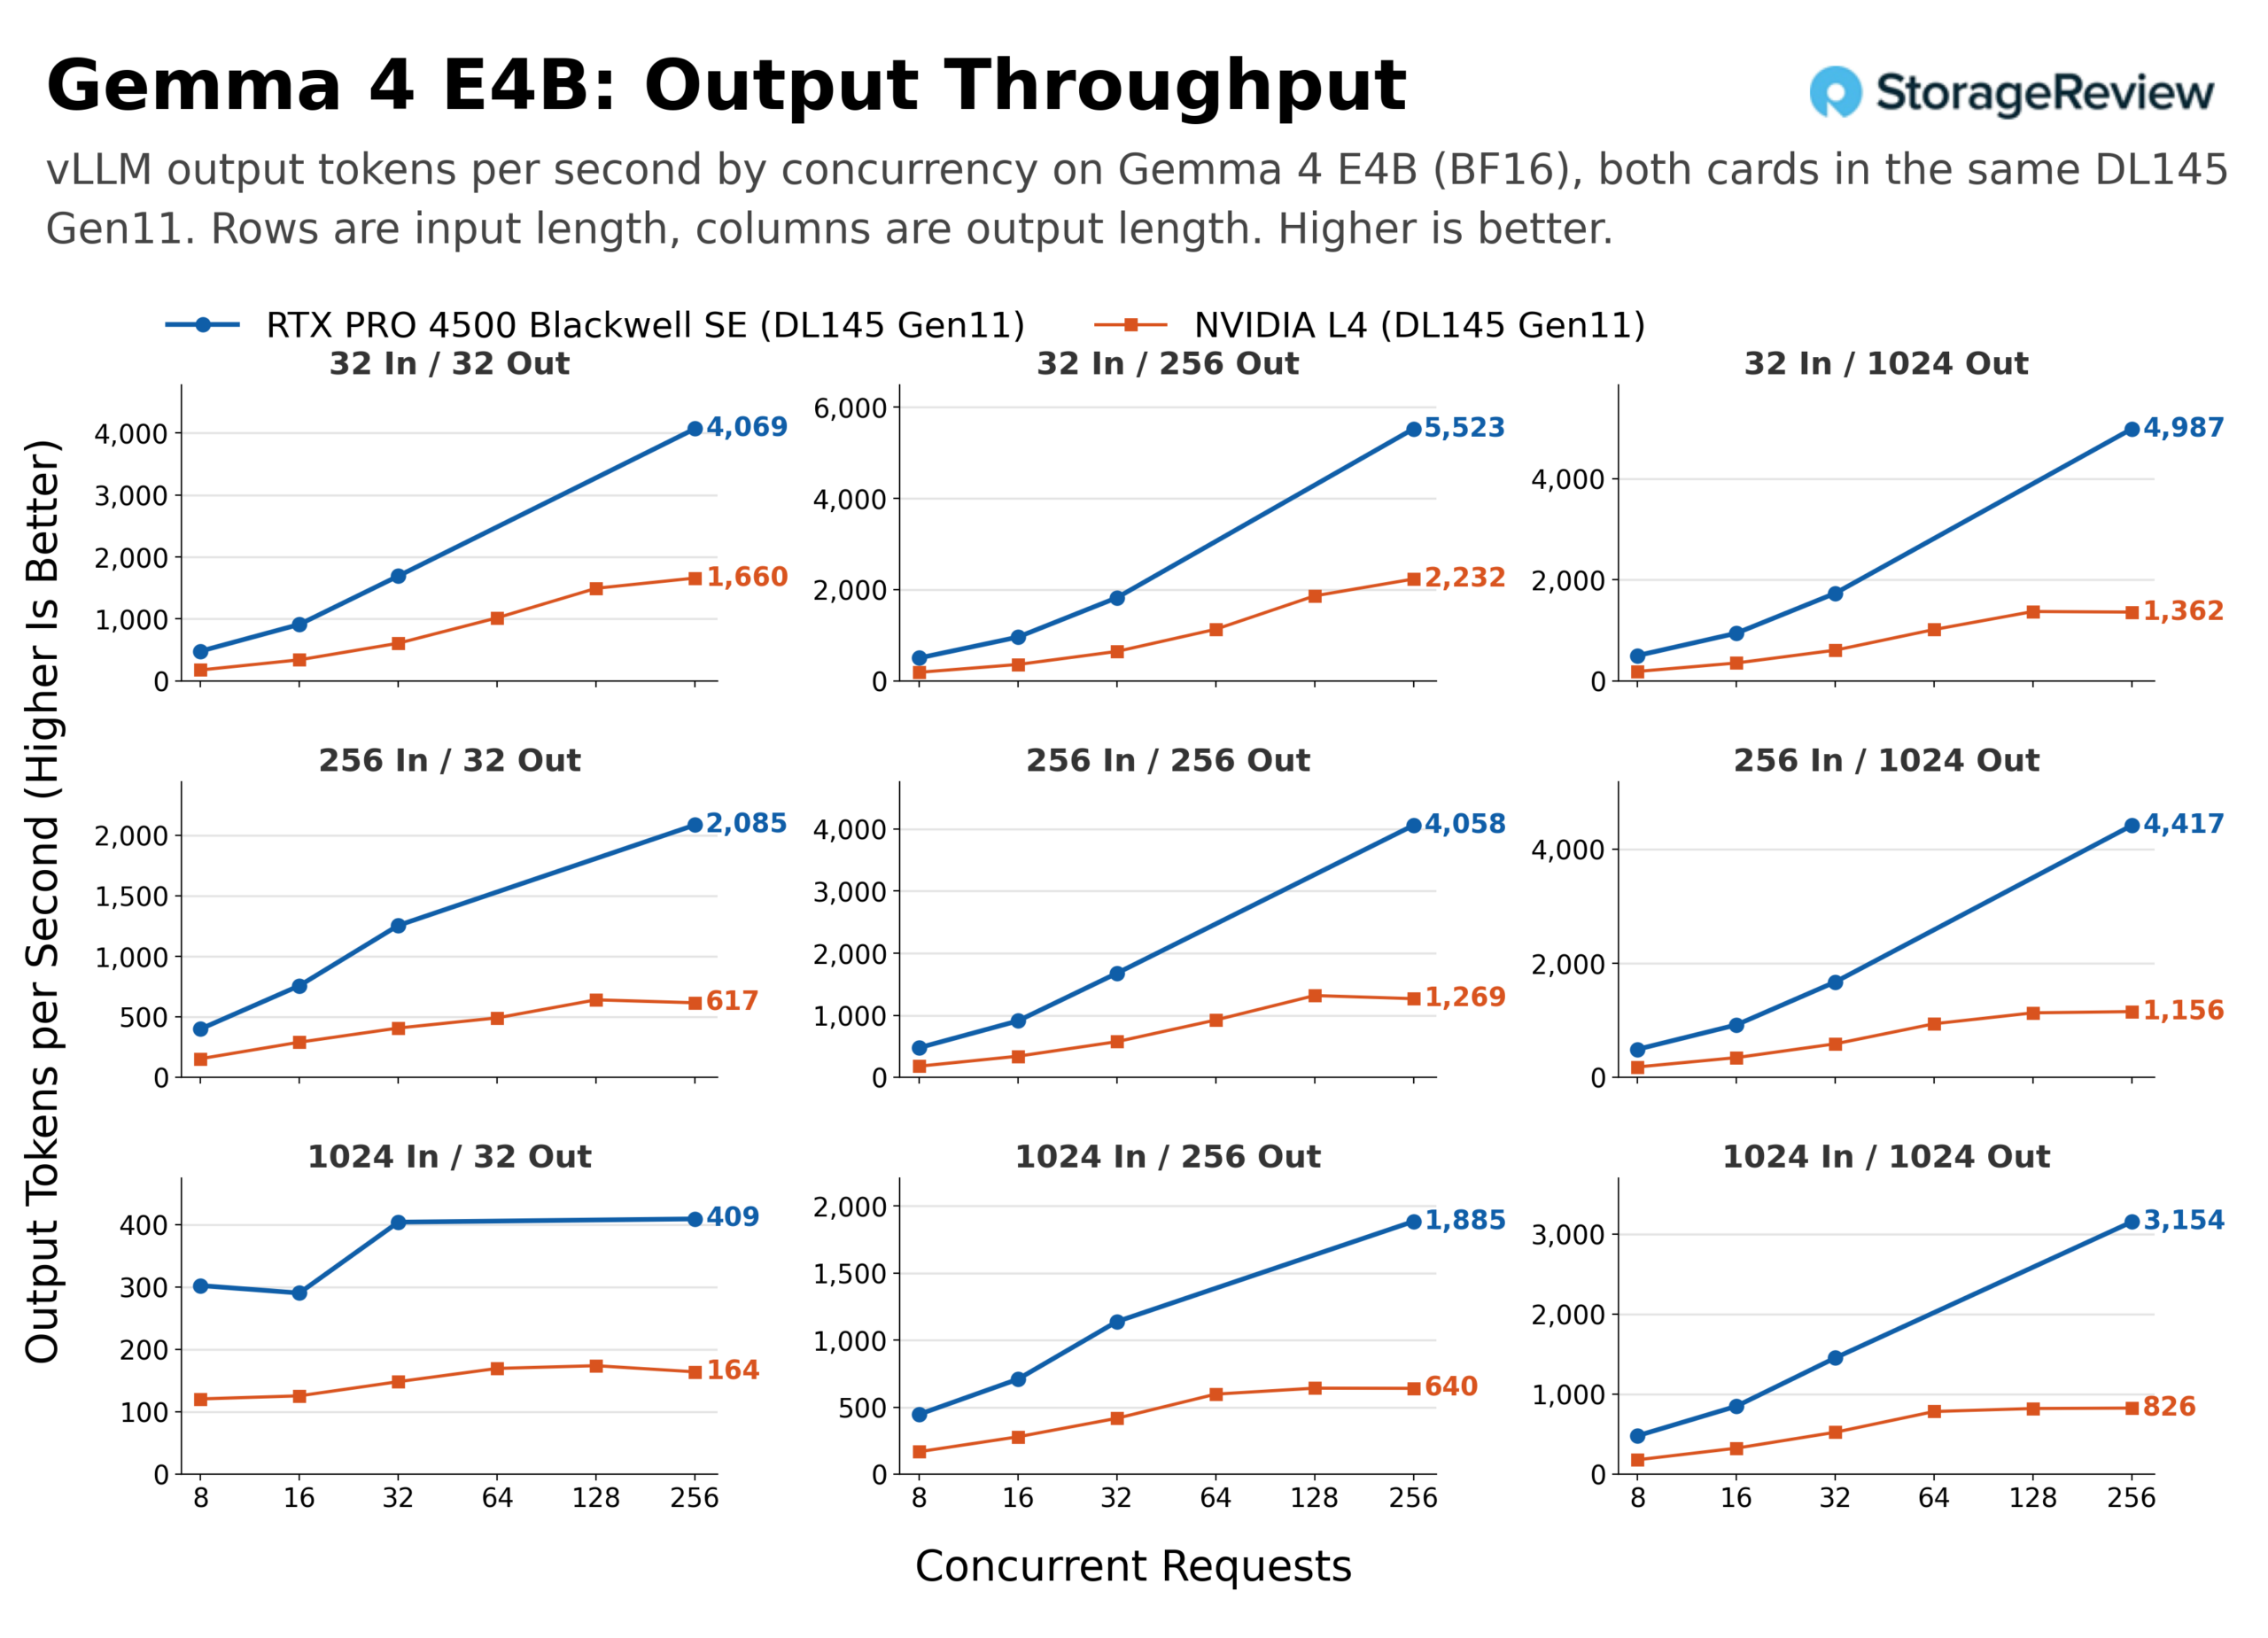
၂၅၆/၂၅၆ ပုံသဏ္ဍာန်တွင် L4 သည် တစ်ပြိုင်နက်တည်း ၈ ခုတွင် တစ်စက္ကန့်လျှင် ၁၈၃ ခု၊ ၃၂ ခုတွင် ၅၇၇ ခု နှင့် ၂၅၆ ခုတွင် ၁၂၆၉ ခု ထုတ်လုပ်ခဲ့ပြီး ၄၅၀၀ သည် ၄၇၉၊ ၁,၆၇၈ နှင့် ၄,၀၅၈ ခု ထုတ်လုပ်ခဲ့သည်။ ၁,၀၂၄/၁,၀၂၄ တွင် L4 သည် ၁၈၀၊ ၅၂၄၊ ၈၂၆ ခု နှင့် ၄၅၀၀ သည် ၄၈၀၊ ၁၄၅၄၊ ၃,၁၅၄ ခု ထုတ်လုပ်ခဲ့သည်။ ရှည်လျားသောပုံသဏ္ဍာန်ရှိ ၄၅၀၀ ၏ ၂၅၆-တစ်ပြိုင်နက်တည်းကိန်းဂဏန်းသည် L4 ၏ ၃.၈ ဆ ရှိပြီး အကြောင်းရင်းကို L4 ၏ကွေးညွှတ်မှုတွင် မြင်နိုင်သည်- ၎င်းသည် တစ်ပြိုင်နက်တည်း ၃၂ မှ ၂၅၆ အထိ တစ်စက္ကန့်လျှင် ၃၀၂ ခုသာ ထည့်သွင်းခဲ့သည်၊ အဘယ်ကြောင့်ဆိုသော် ၎င်းတွင် session များထည့်သွင်းရန် မှတ်ဉာဏ်မကျန်တော့သောကြောင့်ဖြစ်သည်။
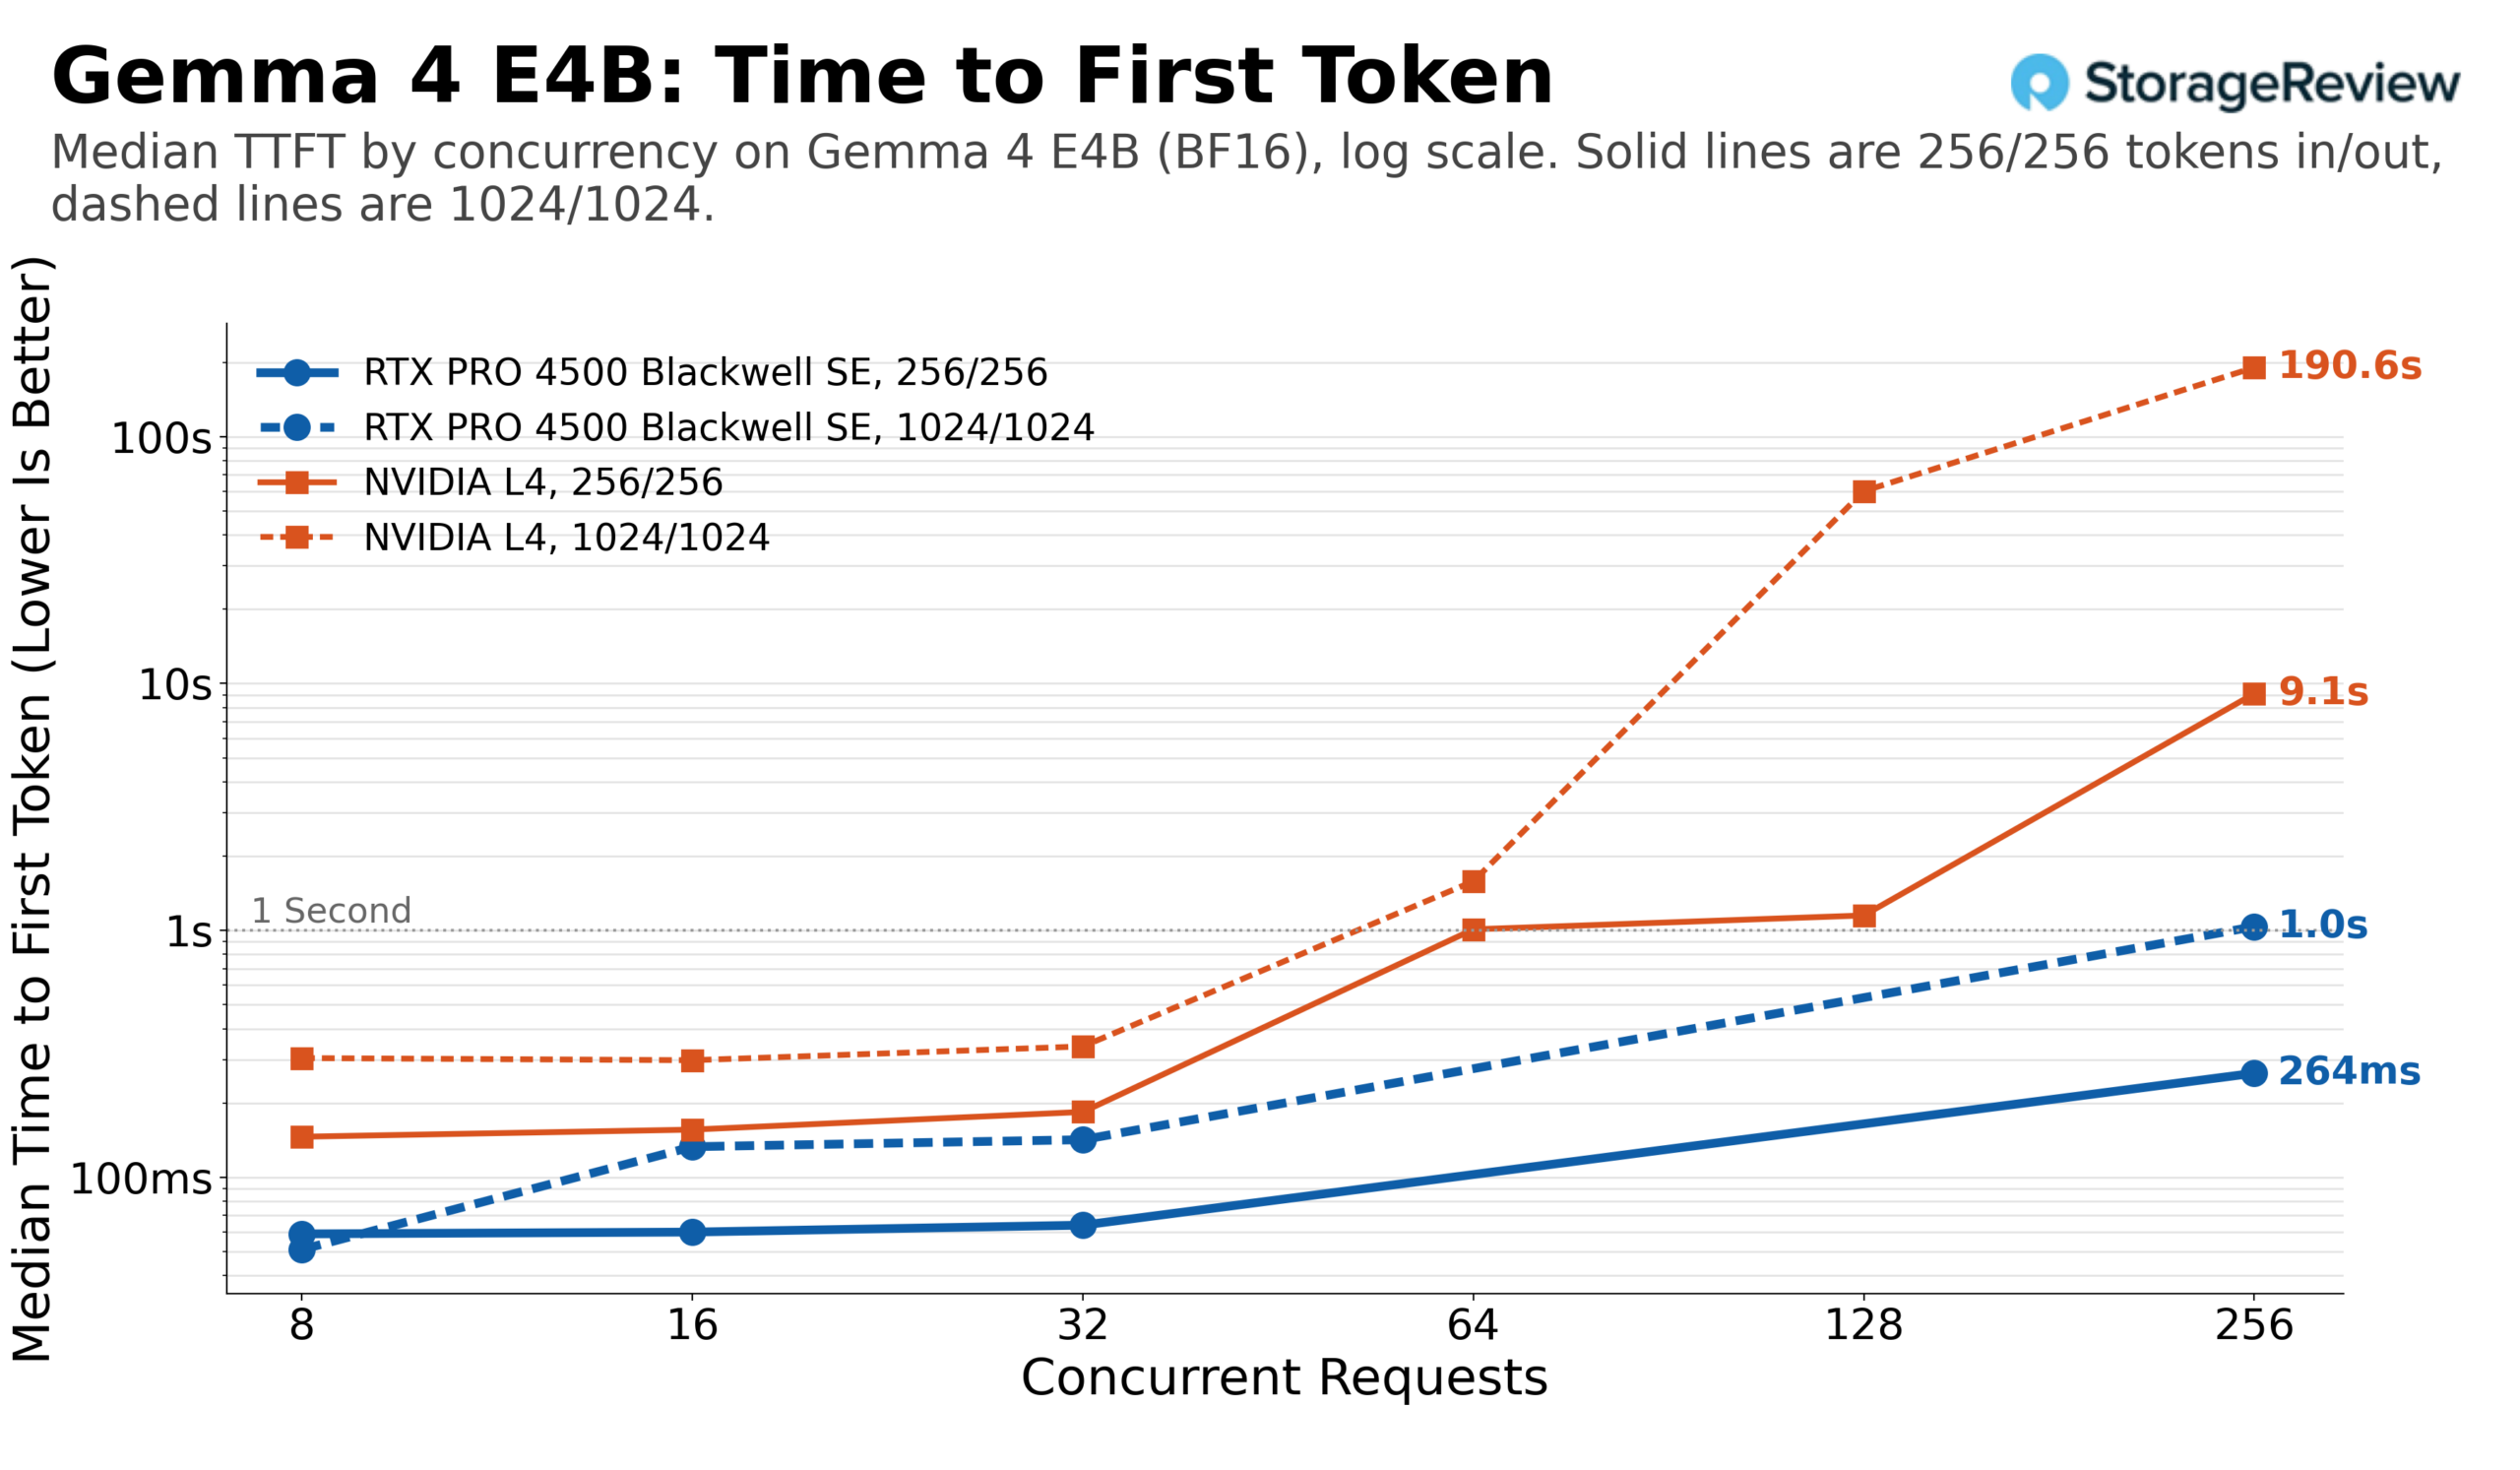
L4 ရဲ့ Gemma 4 အလုပ်မှာ တစ်ပြိုင်နက်တည်း ၆၄ နဲ့ ၁၂၈ ပါဝင်တာကြောင့် ဒီမော်ဒယ်က L4 က ပေးစွမ်းနိုင်တဲ့နေရာကို အတိအကျပြသပါတယ်။ ၂၅၆/၂၅၆ ပုံသဏ္ဍာန်မှာ ပထမဆုံးတိုကင်ရဖို့ ပျမ်းမျှအချိန်ဟာ တစ်ပြိုင်နက်တည်း ၃၂ ခုမှာ ၁၈၄ မီလီစက္ကန့်၊ ၆၄ ခုမှာ တစ်စက္ကန့်ကျော်နဲ့ ၂၅၆ ခုမှာ ၉.၁ စက္ကန့်ဖြစ်ပါတယ်။ ၁,၀၂၄/၁,၀၂၄ မှာ ၃၂ ခုမှာ ၃၃၉ မီလီစက္ကန့်၊ ၆၄ ခုမှာ တစ်စက္ကန့်ကျော်၊ ၁၂၈ ခုမှာ ၆၀ စက္ကန့်နဲ့ ၂၅၆ ခုမှာ ၁၉၁ စက္ကန့်ဖြစ်ပါတယ်။ ၄၅၀၀ ဟာ တစ်ပြိုင်နက်တည်း ၃၂ ခုမှာ ၆၄ မီလီစက္ကန့်နဲ့ ၂၅၆ ခုမှာ ၂၆၄ မီလီစက္ကန့်မှာ ရှိနေပြီး ပုံသဏ္ဍာန်တိုမှာ ၃၂ ခုမှာ ၁၄၂ မီလီစက္ကန့်ဖြစ်ပြီး ၂၅၆ ခုမှာ တစ်စက္ကန့်သာ ကျော်လွန်ပြီး ၁၀၃၆ မီလီစက္ကန့်မှာ ရှိပါတယ်။ ဒါကြောင့် Gemma 4 E4B အတွက် chat-length prompts တွေမှာ ဒီ server ရှိ L4 ဟာ 32-to-64-session card တစ်ခုဖြစ်ပြီး 4500 ကတော့ 256-session card တစ်ခုဖြစ်ပြီး latency လည်း ရှိပါသေးတယ်။
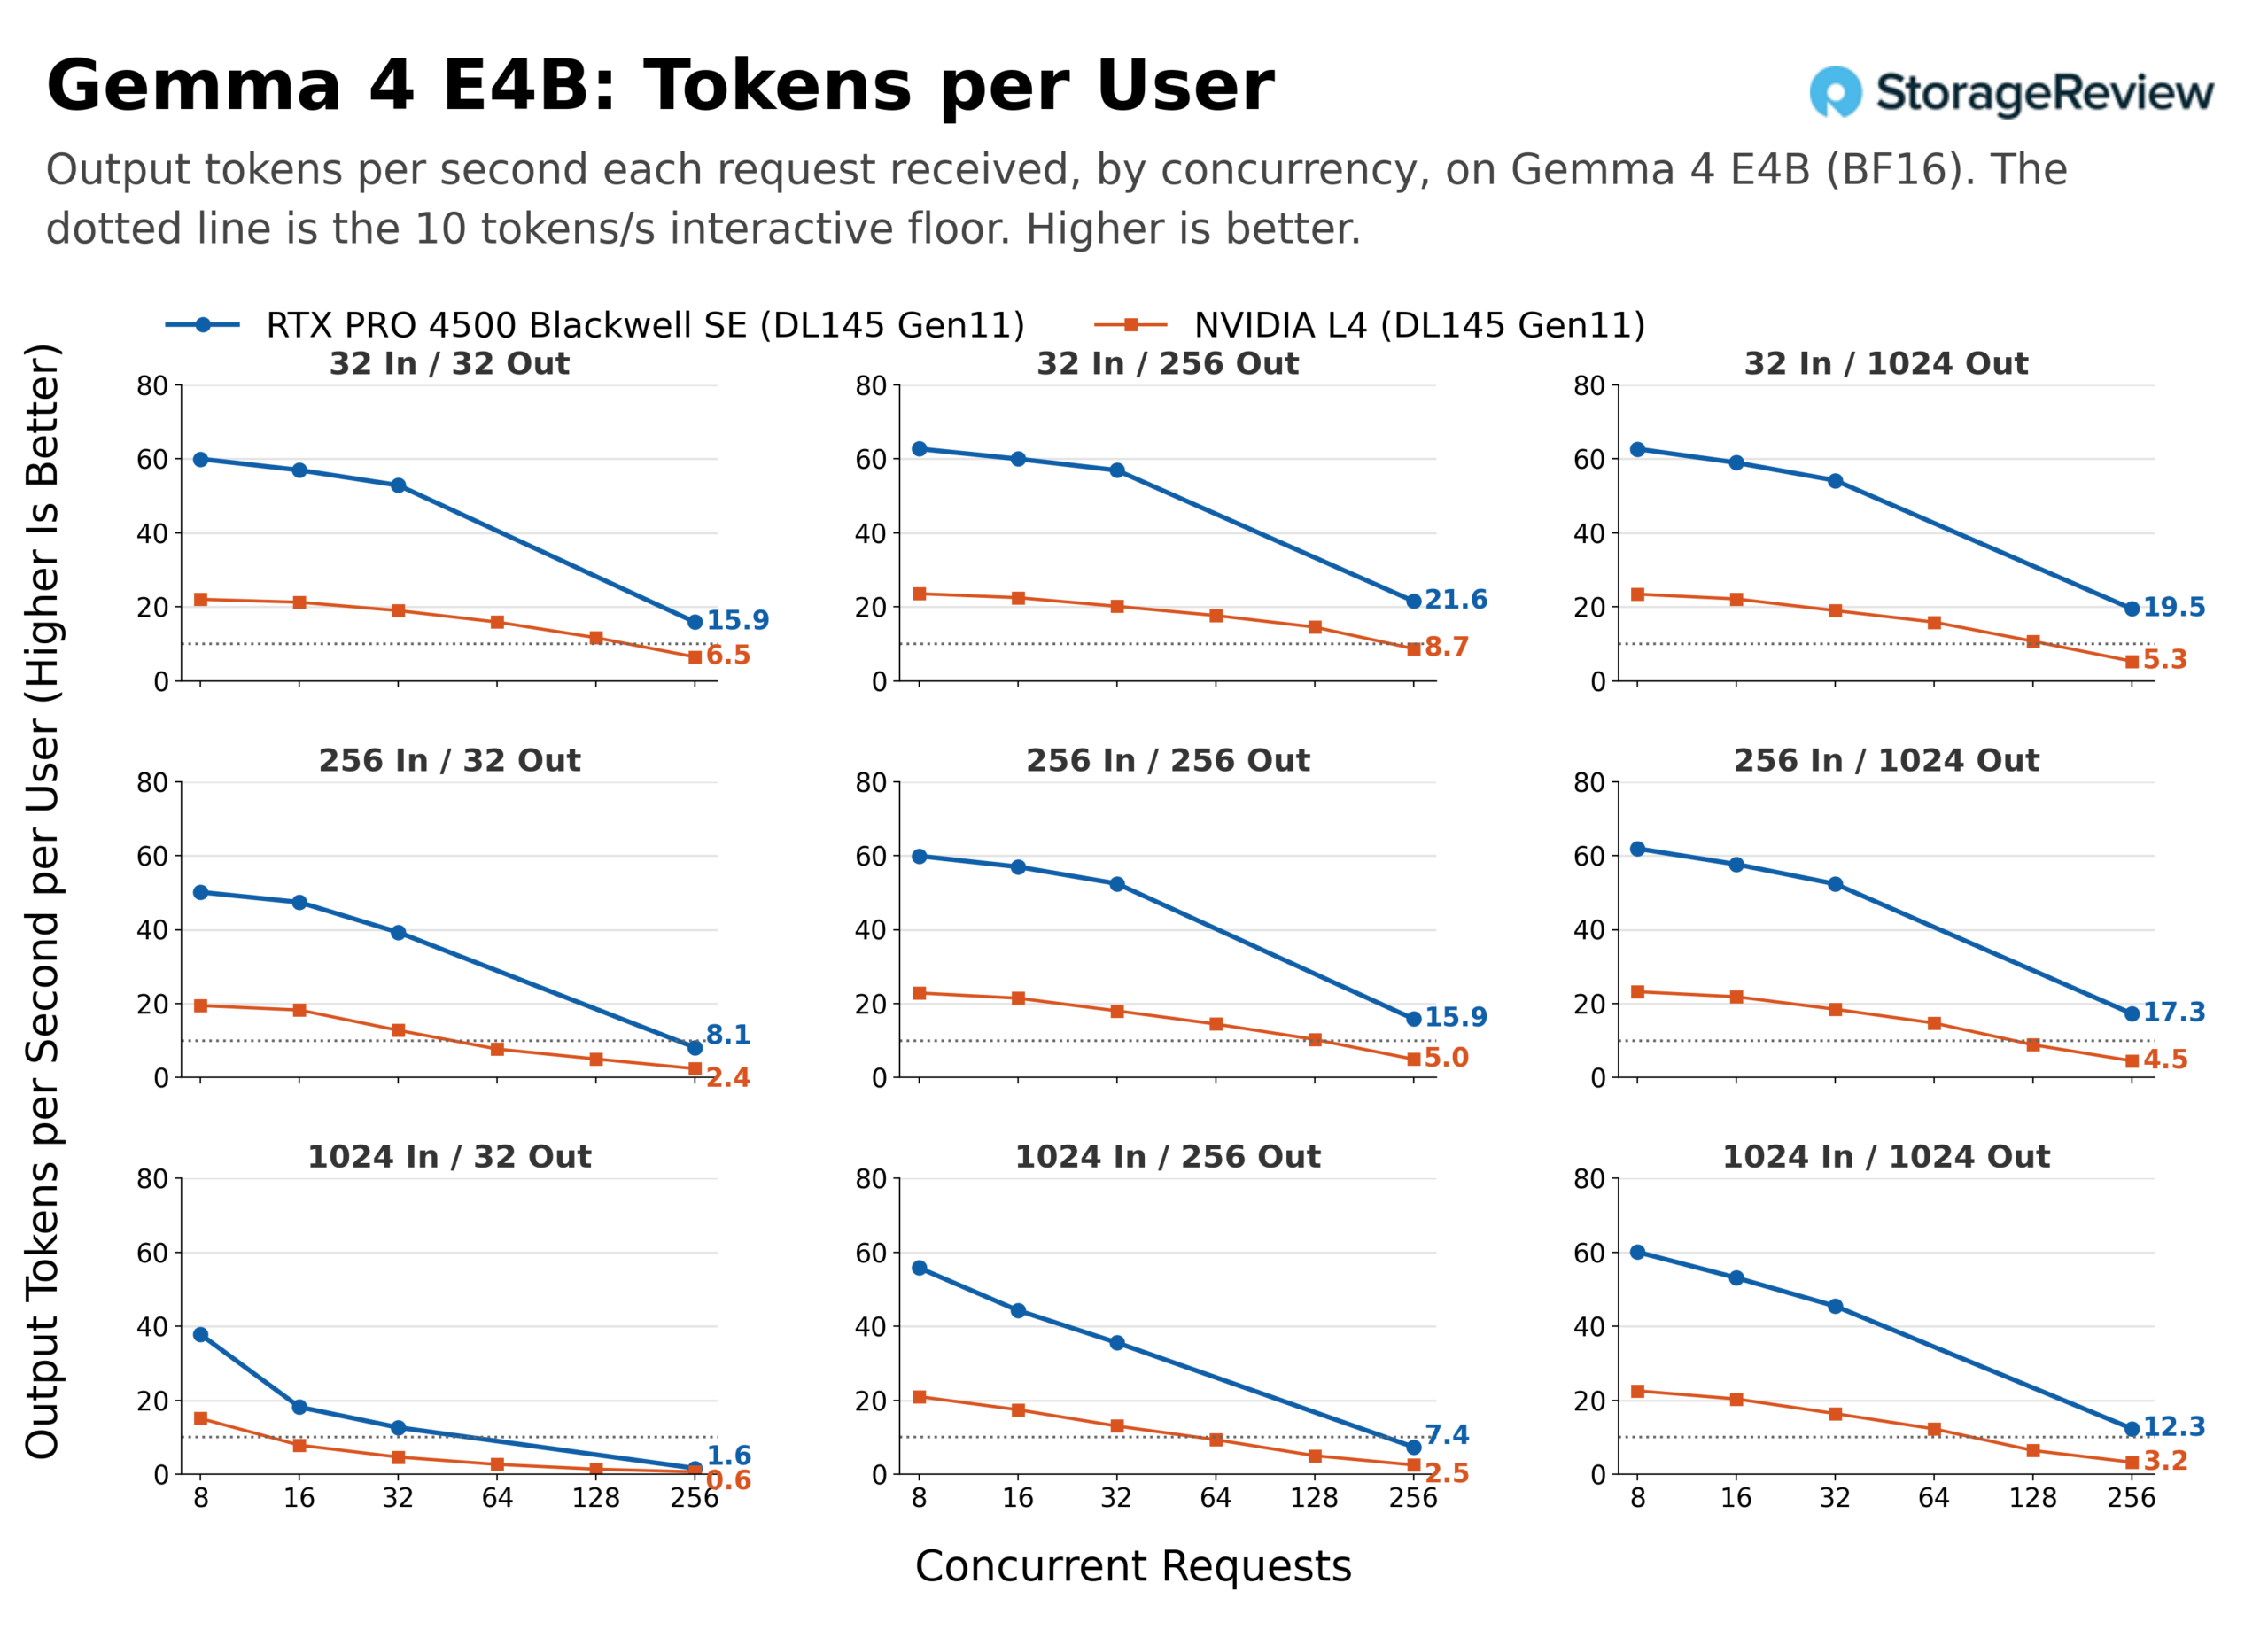
L4 ရဲ့ ၆၄ မှတ်နဲ့ ၁၂၈ မှတ်ဖြည့်ထားတဲ့ per-user view မှာ floor ကိုဖြတ်သွားတဲ့နေရာကို ပြပါတယ်။ ၂၅၆/၂၅၆ မှာ L4 က တစ်ပြိုင်နက်တည်း ၃၂ ခုမှာ user တစ်ယောက်အတွက် တစ်စက္ကန့်ကို token ၁၈.၀၊ ၆၄ ခုမှာ ၁၄.၅၊ ၁၂၈ ခုမှာ ၁၀.၃ နဲ့ ၂၅၆ ခုမှာ ၅.၀ ပေးတာကြောင့် ဒုတိယထပ်မှာ token ၁၀ ခုကို ၁၂၈ နဲ့ ၂၅၆ ကြားမှာ ဖြတ်သွားပါတယ်။ ၂၅၆/၁,၀၂၄ မှာ ၈.၉ x ၁၂၈ ရှိပြီး short-answer နဲ့ ၁၀၂၄-input shapes တွေမှာ floor အောက်မှာ ၆၄ (၂၅၆/၃၂ မှာ ၇.၇၊ ၁၀၂၄/၂၅၆ မှာ ၉.၃) ရှိပါတယ်။ ၄၅၀၀ သည် chat shape များတွင် user တစ်ဦးချင်းစီအတွက် ၅၂ မှ ၅၇ အထိ တစ်ပြိုင်နက်တည်း ၃၂ ခုရှိပြီး shape ကိုးခုအနက် ခြောက်ခုတွင် (၂၅၆/၃၂ မှလွဲ၍ အခြား input shape များတွင် ၁၅.၉ မှ ၂၁.၆ အထိနှင့် 1,024/1,024 တွင် ၁၂.၃ အထိ) ကြမ်းပြင်အထက်တွင် ရှိနေပြီး short-answer shape နှင့် long-prompt shape သုံးခုတွင်သာ အောက်တွင် ကျဆင်းသွားသည် (၂၅၆/၃၂ တွင် ၈.၁၊ ၁,၀၂၄/၂၅၆ တွင် ၇.၄ နှင့် ၁,၀၂၄/၃၂ တွင် ၁.၆)။
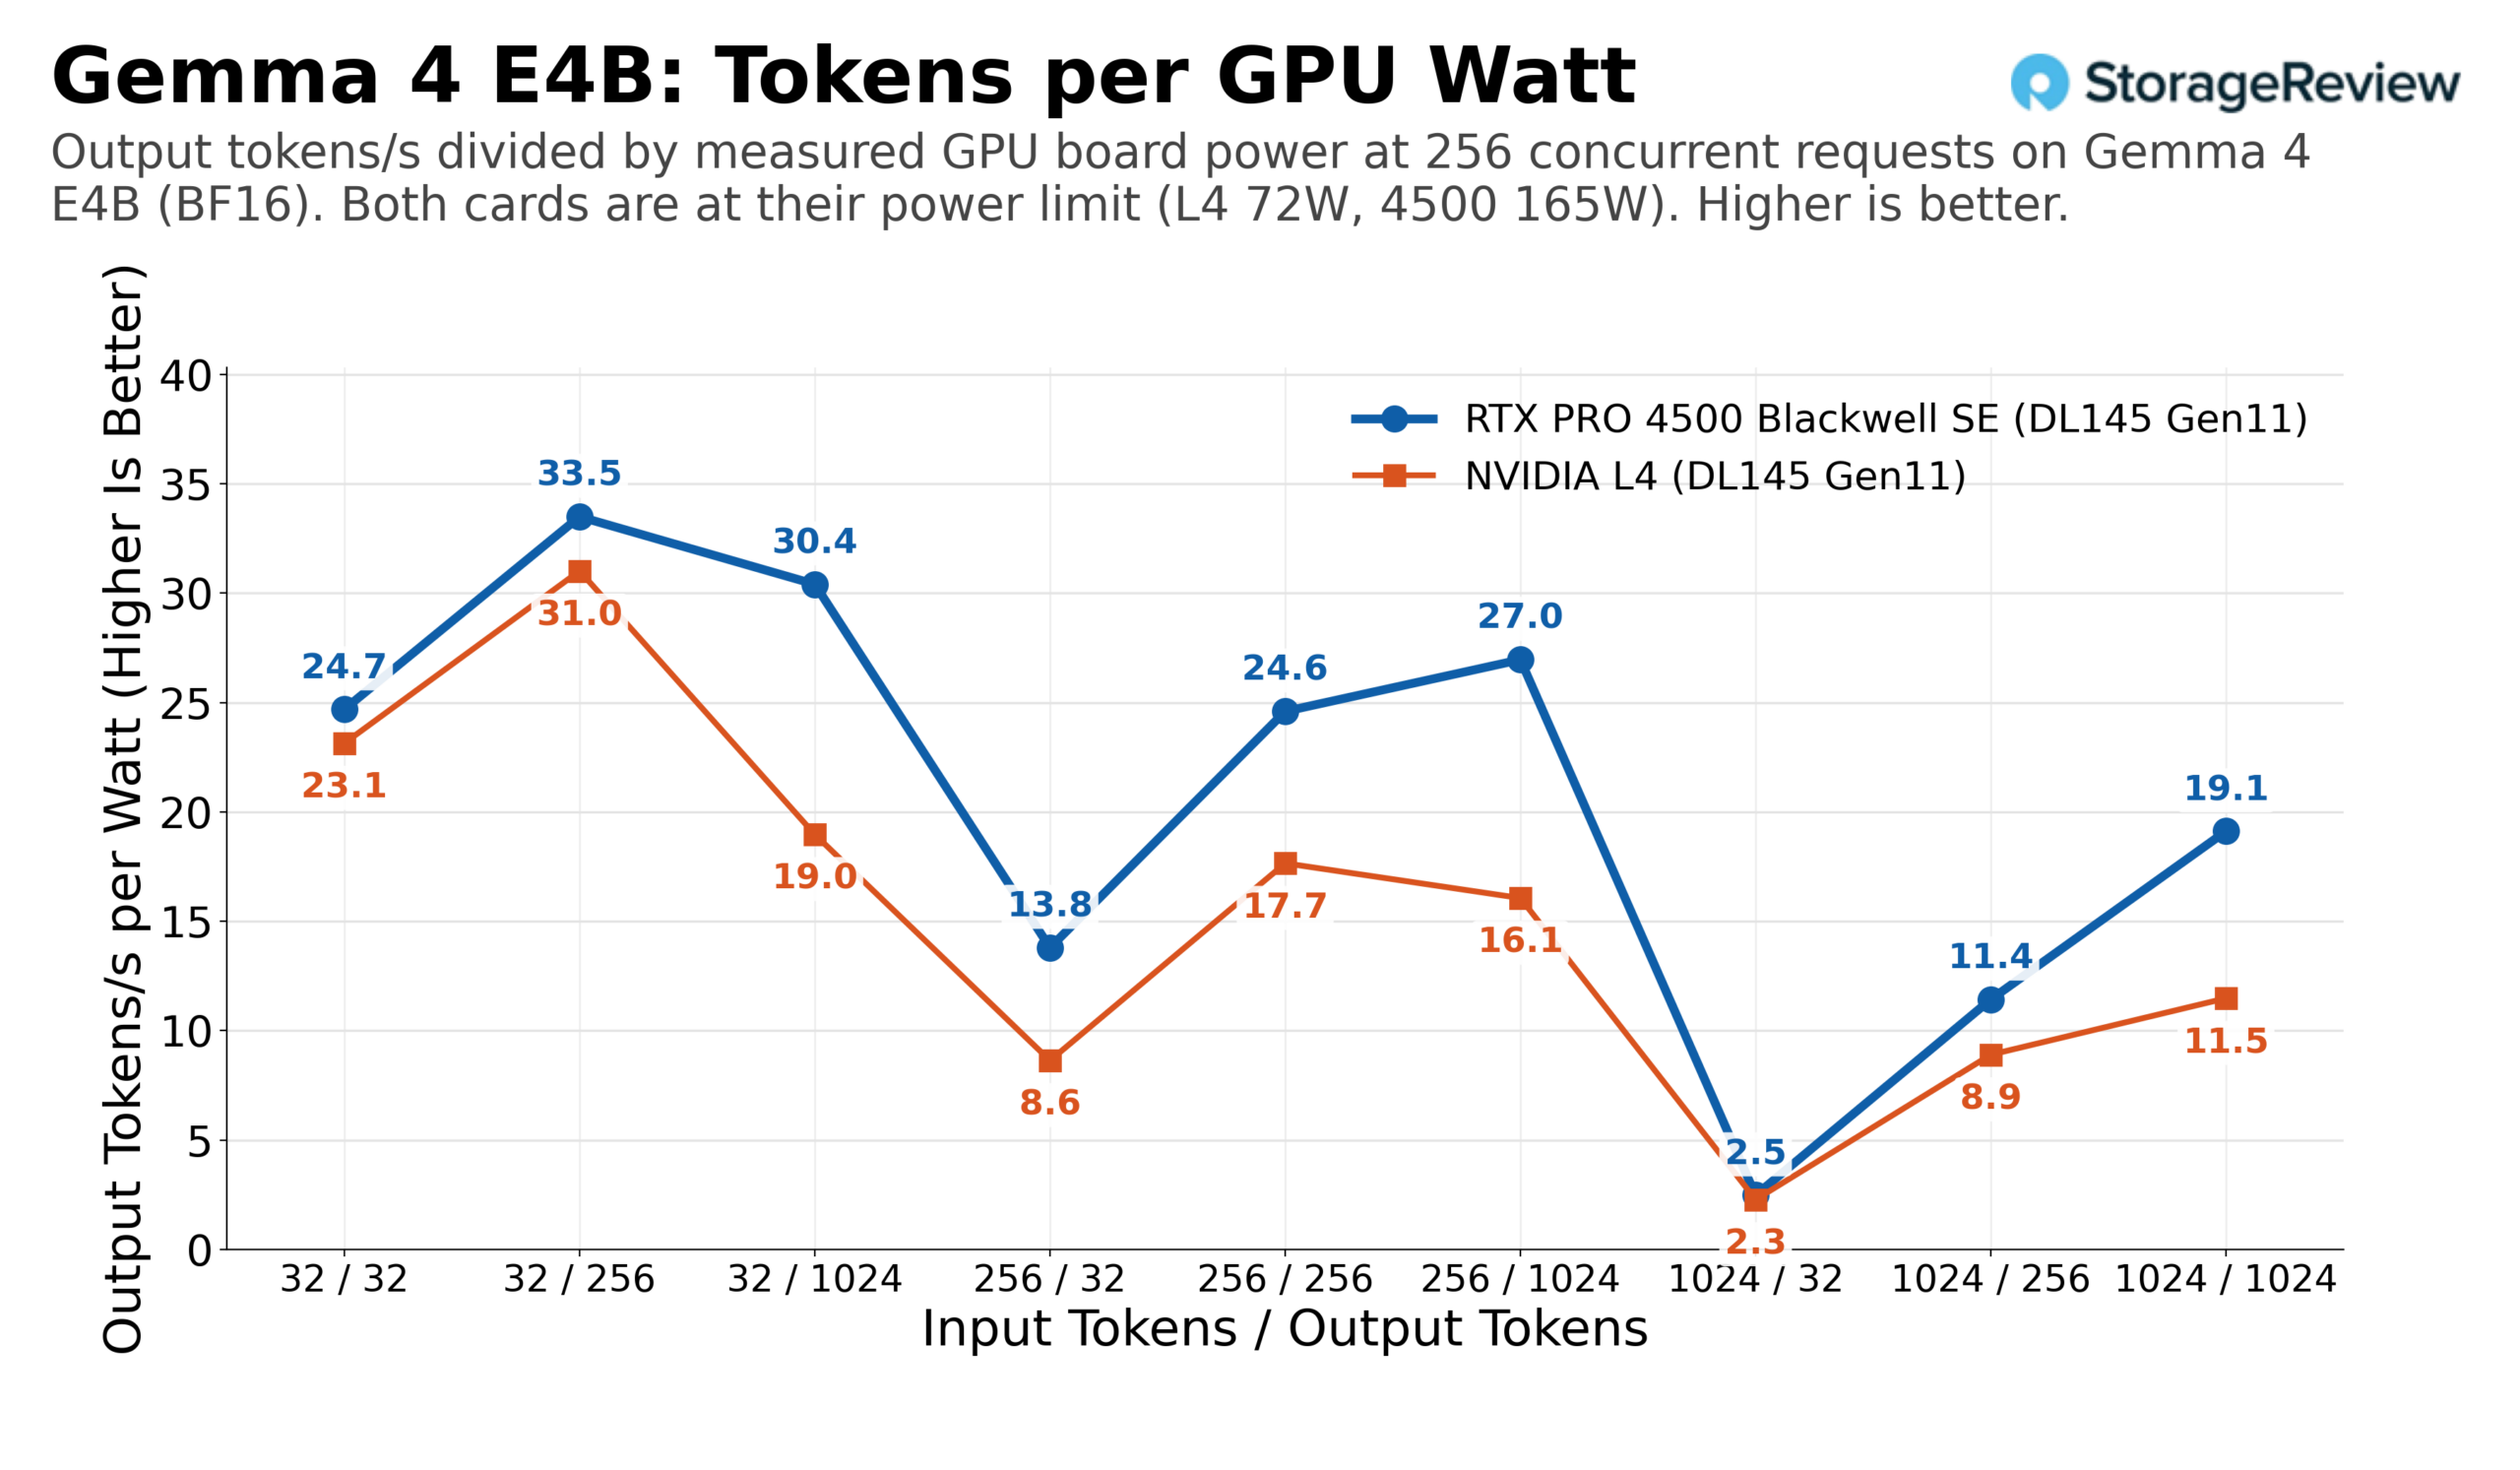
GPU watt တစ်ခုလျှင် Gemma 4 E4B သည် 4500 ကို 256 concurrent တွင် L4 ၏ median 1.39x ပေးထားပြီး အကျယ်ဆုံး margin မှာ 256/1,024 နှင့် 1.6x သို့မဟုတ် အခြား long-answer shapes များတွင် 1.68x သို့မဟုတ် ပိုကောင်းပြီး L4 သည် KV cache အတွက် ရှားပါးကာ အကျဉ်းဆုံး margin မှာ 32/32 တွင် 1.07x ရှိပြီး မည်သည့်ကတ်မဆို workload ဆန့်ထုတ်ရန် တိုတောင်းပါသည်။ 256/256 တွင် တစ်စက္ကန့်လျှင် watt လျှင် 24.6 output tokens ရှိပြီး 17.7 output tokens ရှိသည်။
အသုံးပြုသူတစ်ဦးတည်းအတွက် တိုကင်တစ်ခုလျှင် latency သည် Qwen နှင့် ကိုက်ညီသည်- 4500 တွင် တိုကင်တစ်ခုလျှင် 14.1ms နှင့် L4 တွင် 256/256 တွင် 39.1ms နှင့် 1,024/1,024 တွင် 39.8ms နှင့် 14.6ms၊ ထို့ကြောင့် 1,024-token အဖြေသည် 4500 တွင် 15 စက္ကန့်နှင့် L4 တွင် 41 စက္ကန့်ခန့် ကြာသည်။
နံရံမှာ စွမ်းအား
Edge site တွေမှာ power အနည်းငယ်သာရှိတာကြောင့် DL145 ရဲ့ iLO ကနေတစ်ဆင့် server တစ်ခုလုံးရဲ့ power ကို run တိုင်း track လုပ်ခဲ့ပါတယ်။ load ပေါ့ပါးနေချိန်မှာ၊ GPU က 43 ကနေ 65W အထိ run နေတဲ့ single-user တွေမှာ၊ card တစ်ခုခု install လုပ်ထားတဲ့ server က 160W လောက်မှာ ရှိနေခဲ့ပါတယ်။ 256/256 shape မှာ 32 မှာ တစ်ပြိုင်နက်တည်း run နေတဲ့အတွက် L4 နဲ့ RTX PRO 4500 မှာ 301W ရှိပြီး အဲဒီ medians တွေက BF16 model နှစ်ခုလုံးမှာ ရှိနေပါတယ်။ ကျွန်တော်တို့ မှတ်တမ်းတင်ထားတဲ့ အများဆုံး power က L4 နဲ့ 209W နဲ့ 4500 မှာ 308W ဖြစ်ပါတယ်။ ဒါကြောင့် upgrade လုပ်ဖို့အတွက် wall under load မှာ 105W လောက် ကုန်ကျပြီး card တွေရဲ့ board power ratings မှာ 93W ကွာခြားချက်နဲ့ နီးစပ်သလို conversion loss အနည်းငယ်နဲ့ fan overhead အပိုလည်း ပါဝင်ပါတယ်။
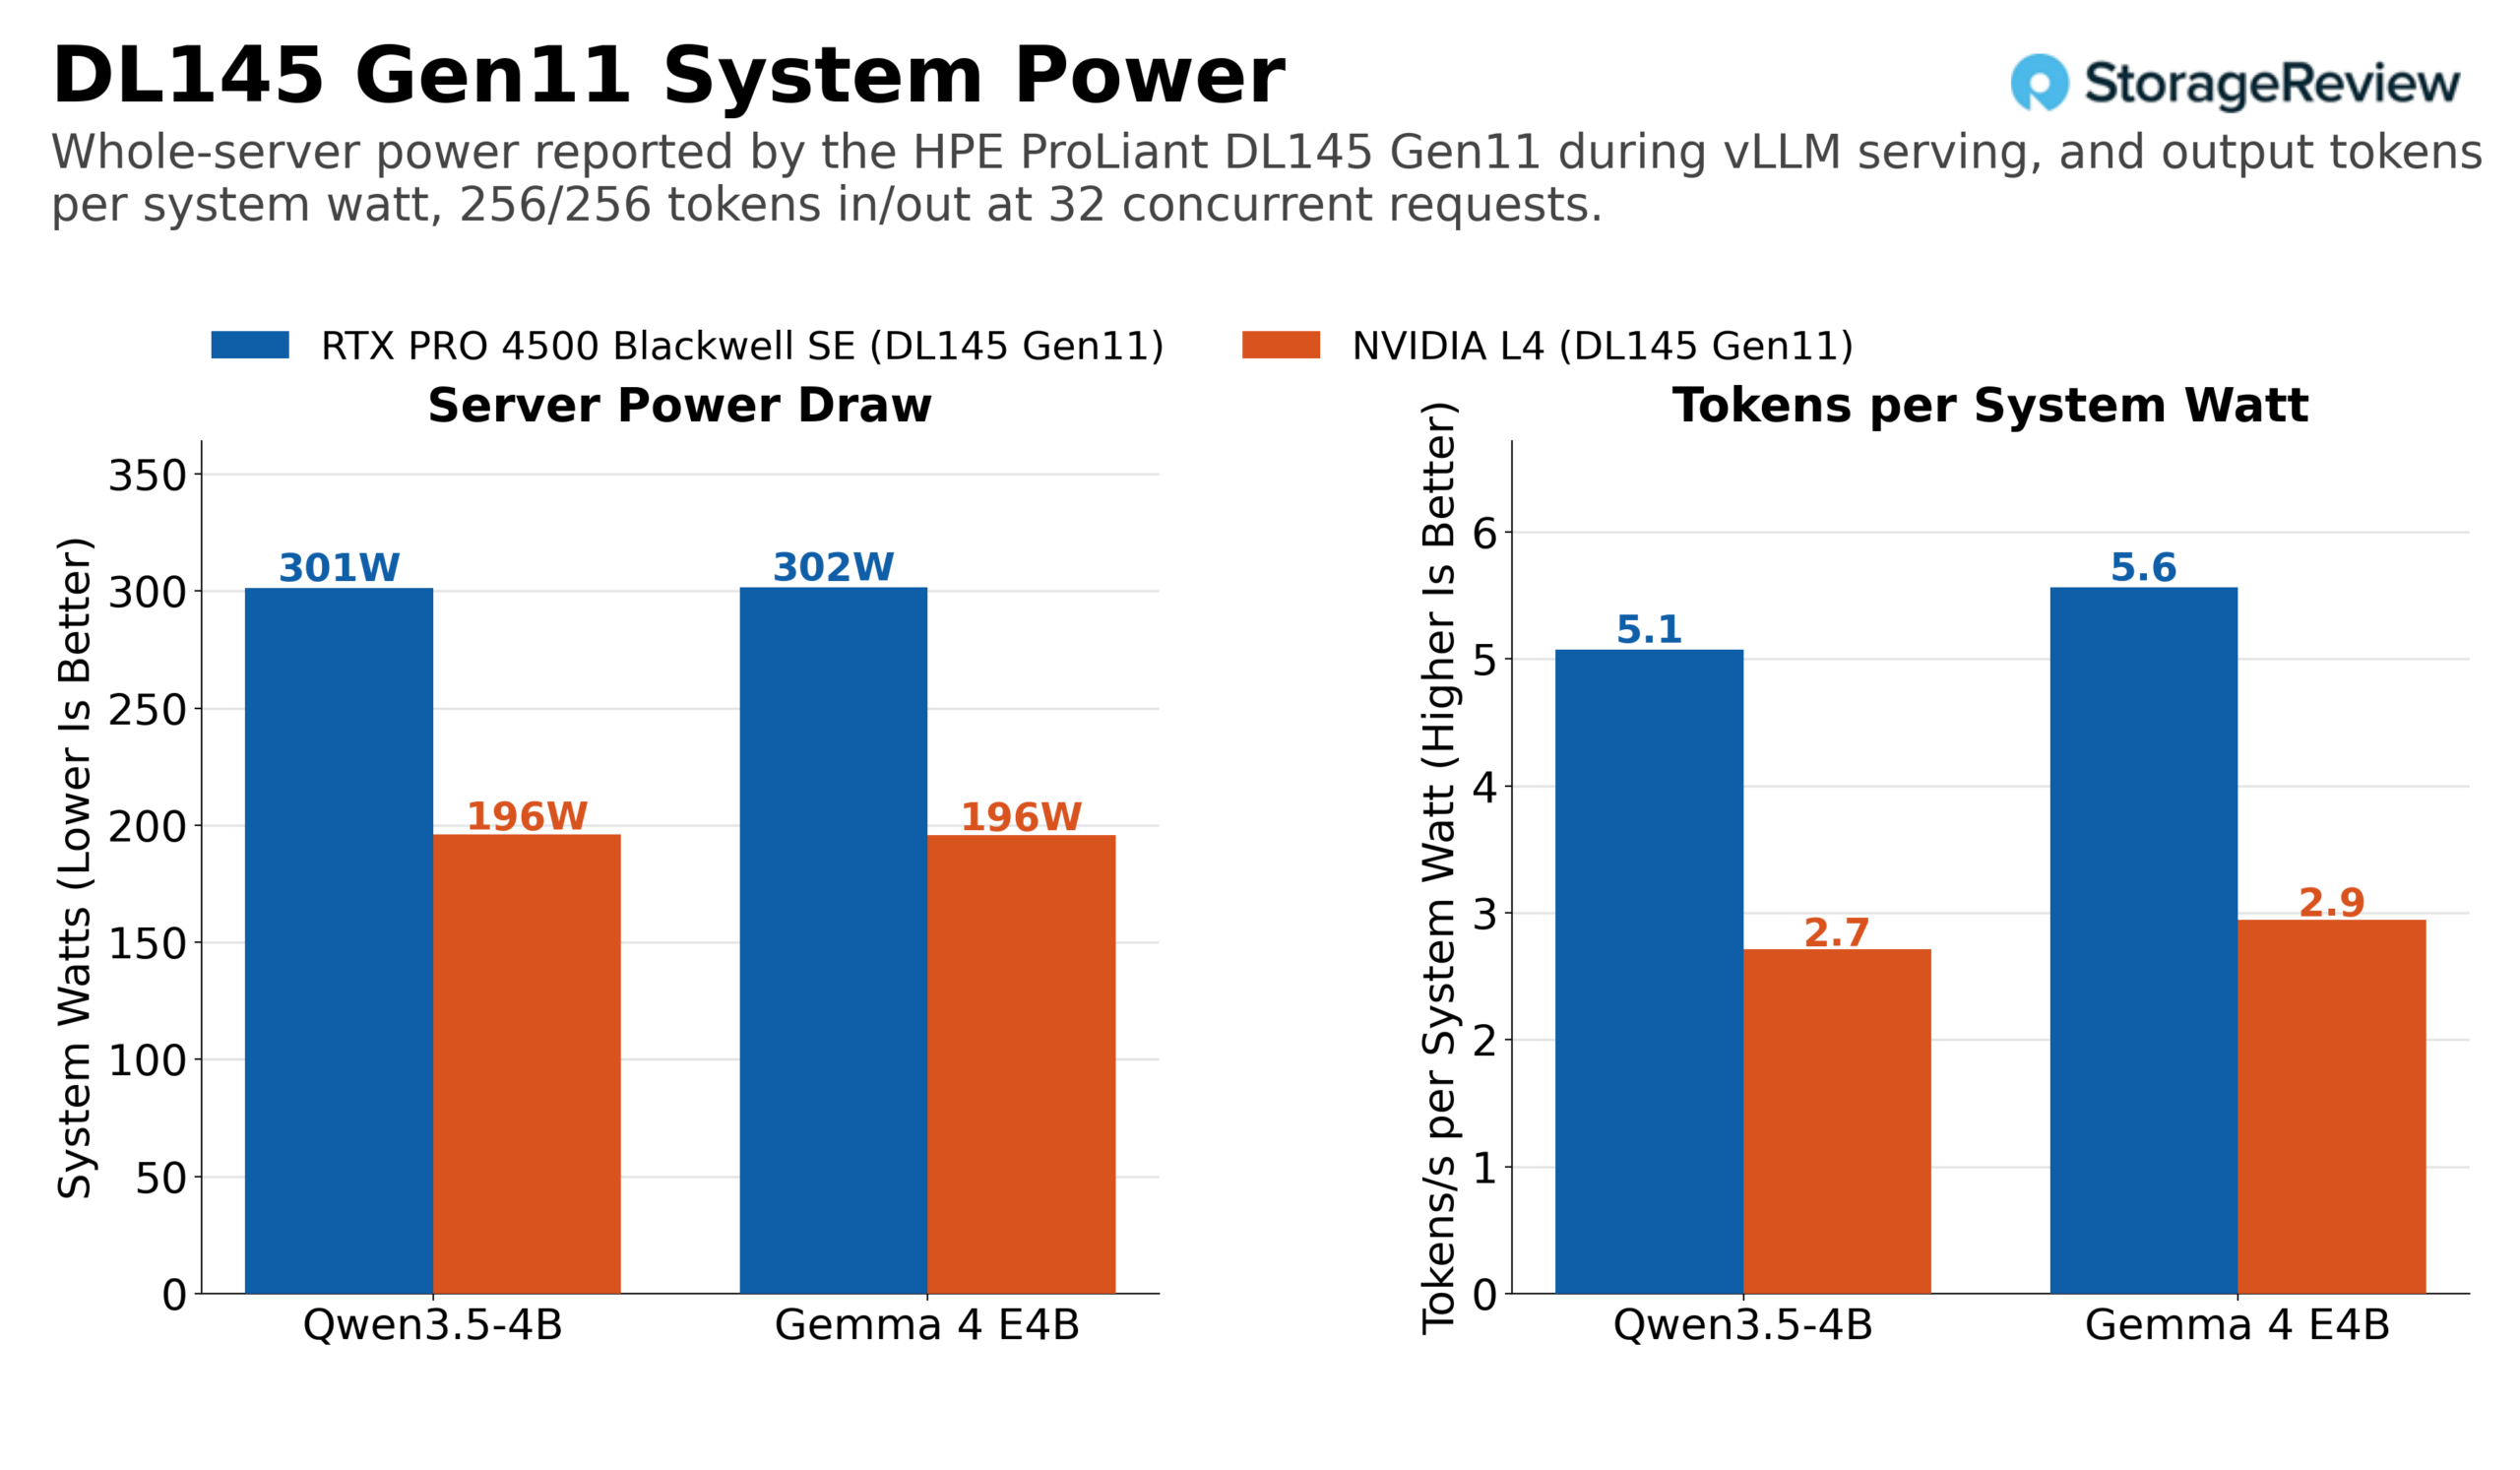
256/256 မှာ တစ်ပြိုင်နက်တည်း 32 ခုမှာ၊ Qwen3.5-4B မှာ L4 နဲ့ 4500 နဲ့ 5.1 မှာ တစ်စက္ကန့်ကို system watt တစ်ခုအတွက် 2.7 output tokens ထုတ်လုပ်ခဲ့ပြီး Gemma 4 E4B, 2.9 နဲ့ 5.6 မှာ တစ်စက္ကန့်ကို system watt တစ်ခုအတွက် 2.7 output tokens ထုတ်လုပ်ခဲ့ပါတယ်။ system-level efficiency gain က card-level တစ်ခုထက် ပိုကြီးပါတယ်။ DL145 ရဲ့ အများစုဟာ fixed cost ဖြစ်တာကြောင့်ပါ။ GPU က တစ်စက္ကန့်ကို tokens 532 ခု ထုတ်လုပ်သည်ဖြစ်စေ၊ 1,529 ခု ထုတ်လုပ်သည်ဖြစ်စေ CPU, memory, fan တွေနဲ့ storage တွေရဲ့ ကုန်ကျစရိတ်က အတူတူပါပဲ။ box အတွက် ငွေပေးချေတဲ့ site တစ်ခုဟာ swap ကနေ watt တစ်ခုအတွက် tokens 1.9x ရရှိပြီးဖြစ်ပြီး card မှာတော့ 1.3x ရရှိပါတယ်။ per-site power budget ပေါ်မှာ အရွယ်အစားရှိတဲ့ fleet တစ်ခုအတွက်ကတော့ ဒါက စီစဉ်ထားရမယ့် ပမာဏပါ။
32GB နဲ့ NVFP4 ဘာတွေထပ်ထည့်ရမလဲ
အထက်ဖော်ပြပါအရာအားလုံးသည် L4 လုပ်ဆောင်နိုင်သောအလုပ်ဖြစ်ပြီး နှေးကွေးသည်။ 4500 ၏ အခြားငြင်းခုံချက်တစ်ခုမှာ L4 သည် natively serve မလုပ်နိုင်သော model class တစ်ခုဖြစ်သည်- NVFP4 ရှိ Gemma 4 26B-A4B၊ token တစ်ခုလျှင် active 4B parameters များပါရှိသော 26B mixture-of-experts model တစ်ခုဖြစ်ပြီး FP8 KV cache ဖြင့် serve လုပ်သည်။ BF16 တွင်၊ ထို model ၏ weight များသည် 24GB ထက်ကျော်လွန်သည်။ NVFP4 တွင်၊ ၎င်းတို့သည် 4500 ၏ 32GB တွင်အလုပ်လုပ်သော KV cache အတွက်နေရာလွတ်ရှိပြီး၊ Blackwell FP4 Tensor Cores များသည် format ကို natively run သည်။ vLLM သည် weight-only kernel မှတစ်ဆင့် L4 ၏ Ada architecture တွင် NVFP4 weight များကို load လုပ်နိုင်ပြီး၊ 14GB ခန့်ရှိသော 4-bit weight များသည် 24GB တွင် fit နိုင်သော်လည်း L4 တွင် native FP4 compute မရှိသောကြောင့်၊ ကျွန်ုပ်တို့သည် ၎င်းကို ထိုနေရာတွင် မလုပ်ဆောင်ခဲ့ပါ။ စကေးအတွက်၊ Dell Pro Max Tower T2 မှာ 96GB၊ 600W ကတ်ဖြစ်တဲ့ RTX PRO 6000 Blackwell Workstation Edition မှာ အဲဒီအလုပ်ကိုပဲ လုပ်ခဲ့ပါတယ်။ အဲဒါက host နဲ့ card class ကွဲပြားပြီး 4500 ရဲ့ နံပါတ်တွေမှာ reference point ရှိစေဖို့အတွက်ပဲ ထည့်သွင်းထားပါတယ်။
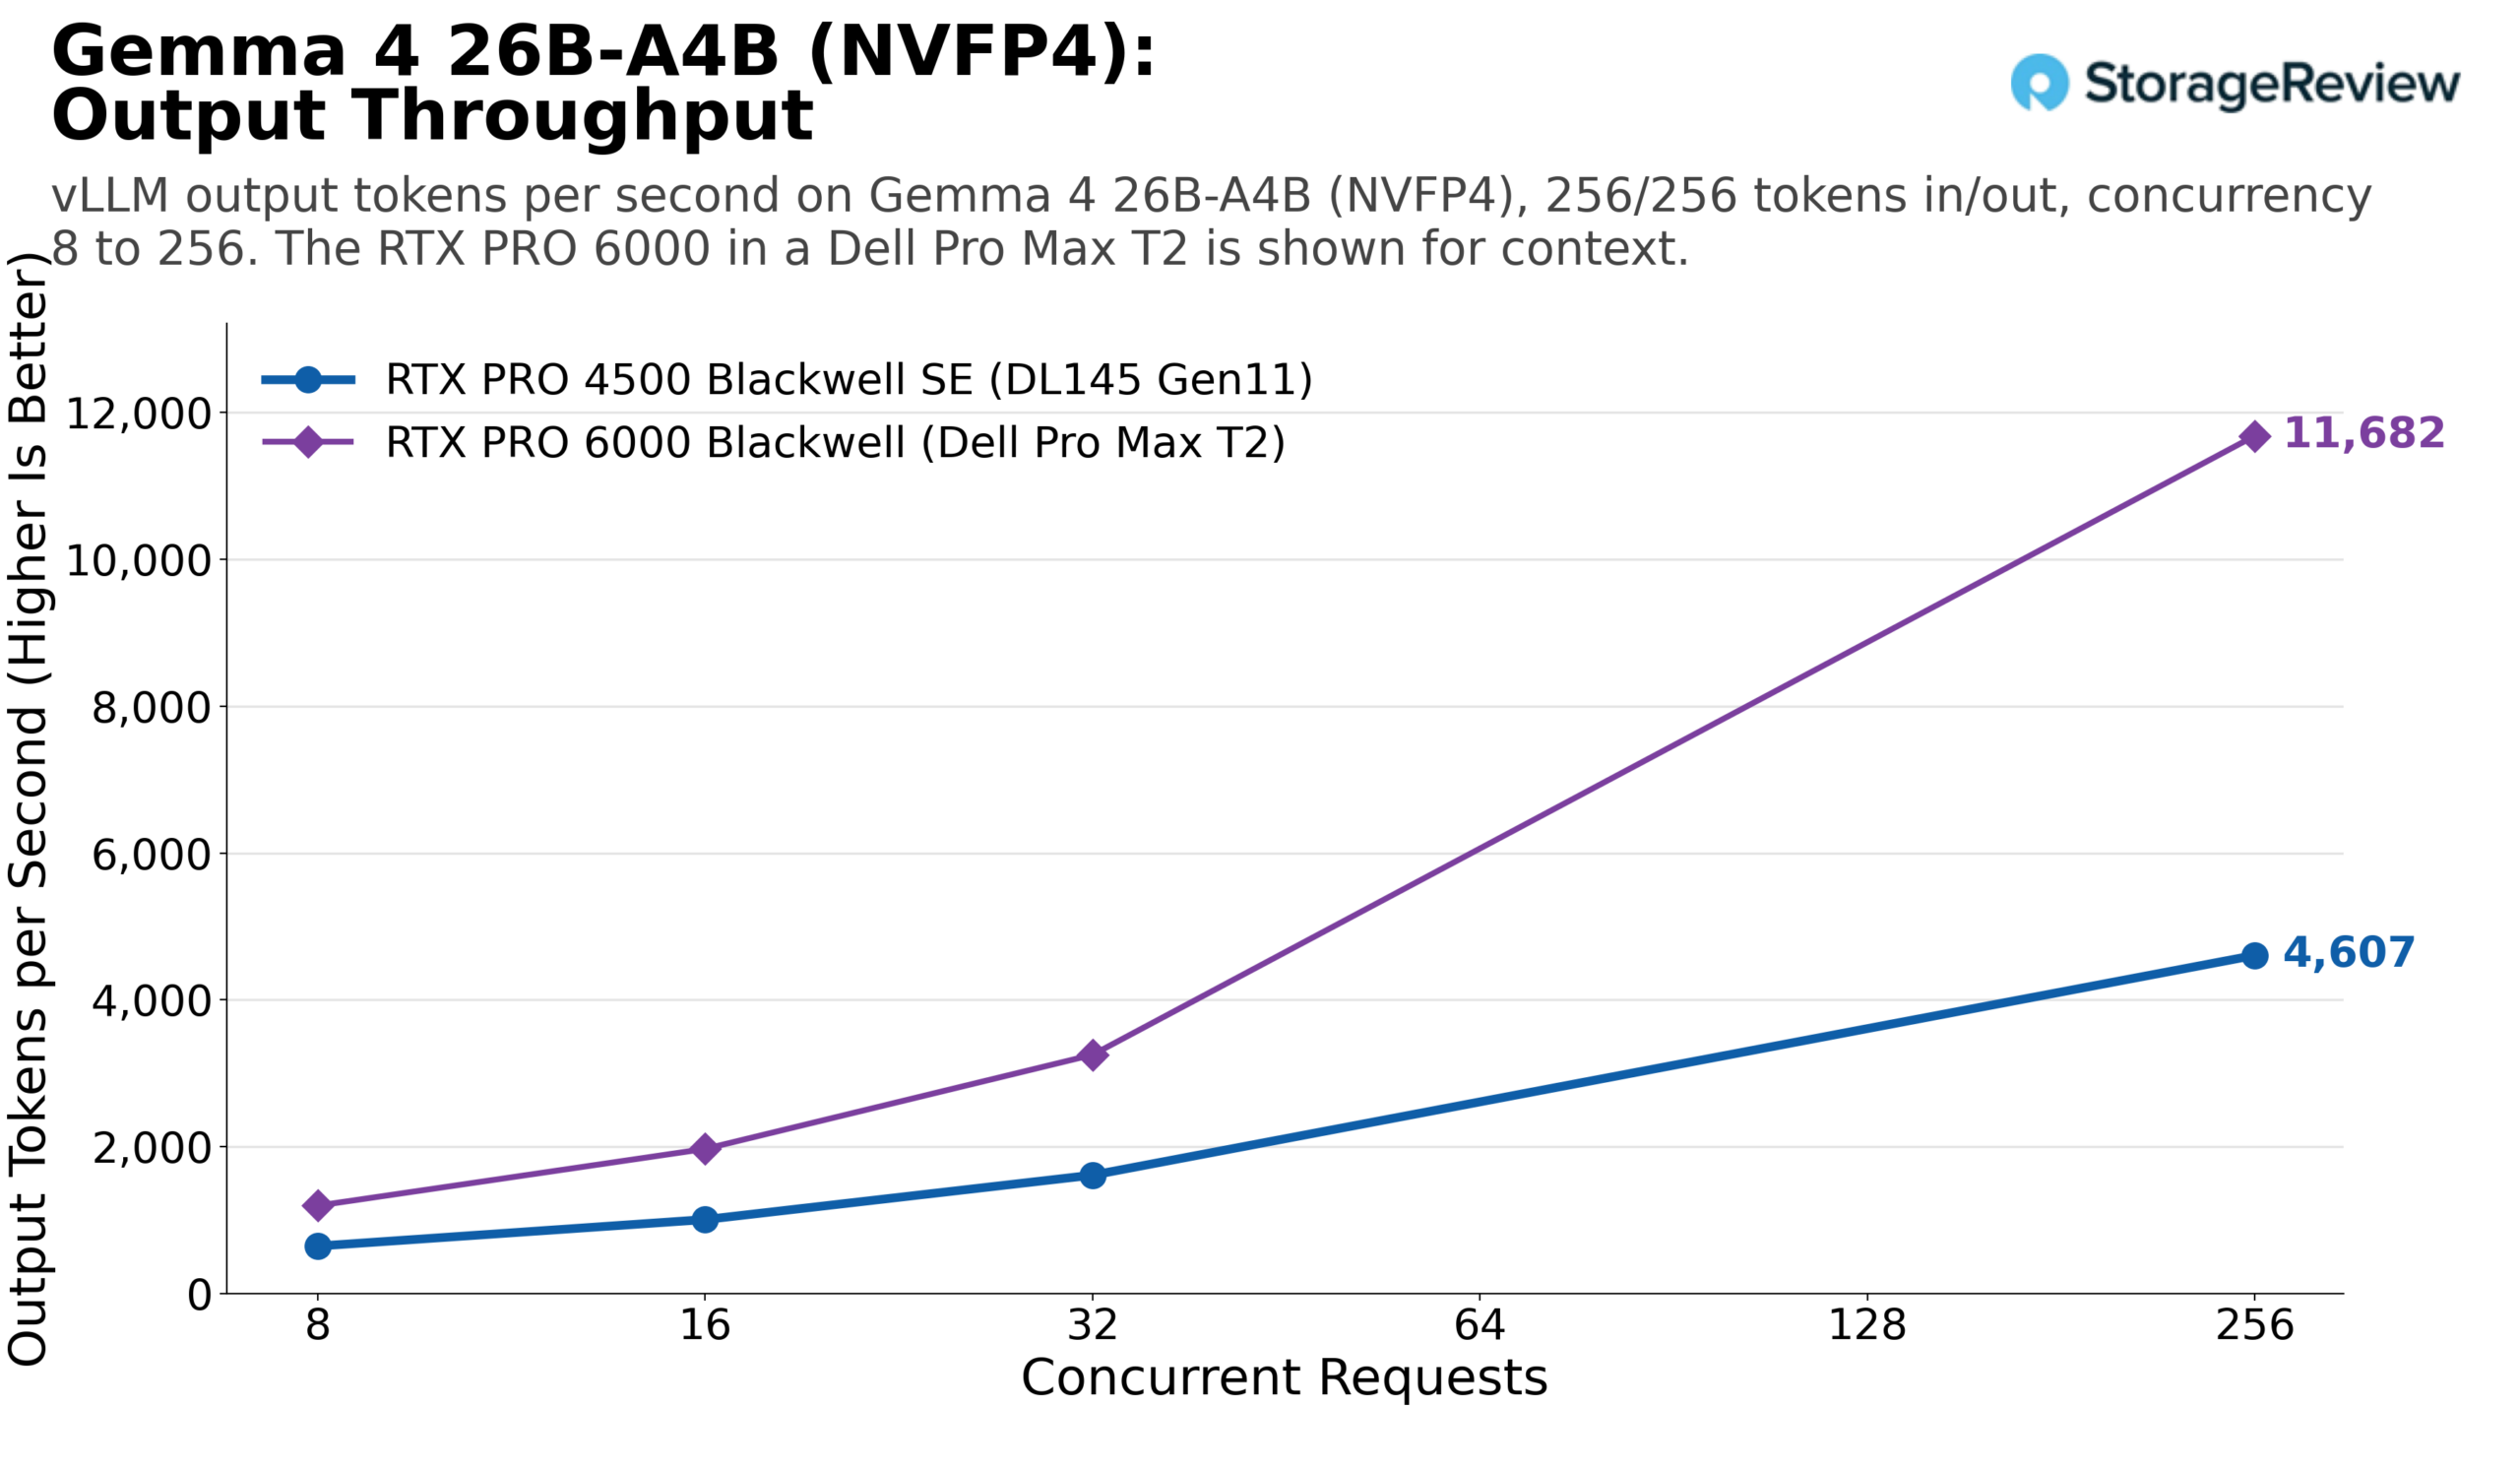
၂၅၆/၂၅၆ တွင် ၄၅၀၀ သည် တစ်ပြိုင်နက်တည်း ၈ ခုဖြင့် တစ်စက္ကန့်လျှင် ၆၄၇ output tokens၊ ၃၂ ခုတွင် ၁,၆၁၃ နှင့် ၂၅၆ ခုတွင် ၄,၆၀၇ ထုတ်လုပ်ခဲ့ပြီး RTX PRO 6000 သည် ၁,၁၉၈၊ ၃,၂၅၂ နှင့် ၁၁,၆၈၂ ထုတ်လုပ်ခဲ့သည်။ တစ်ပြိုင်နက်တည်း ၈ ခုမှ ၃၂ ခုအထိ၊ ၄၅၀၀ သည် prefill-bound 1,024/32 case မှလွဲ၍ ပုံသဏ္ဍာန်တိုင်းတွင် ၆၀၀၀ ၏ ၄၈% မှ ၅၅% တွင်ရှိပြီး တစ်ပြိုင်နက်တည်း ၃၂ ခုတွင် ၂၉% အထိကျဆင်းသွားပြီး ဇယားပါပုံသဏ္ဍာန်များအတွက် ၆၀၀၀ တွင်တိုင်းတာထားသော ၂၆၆W မှ ၄၇၁W တွင် ၁၆၅W တွင်ထိုသို့လုပ်ဆောင်သည်။ တစ်ပြိုင်နက်တည်း ၂၅၆ ခုတွင် ၎င်း၏ 32GB ပြည့်သွားသည်နှင့်အမျှ ၂၃% မှ ၄၂% အထိကျဆင်းသွားသည်။
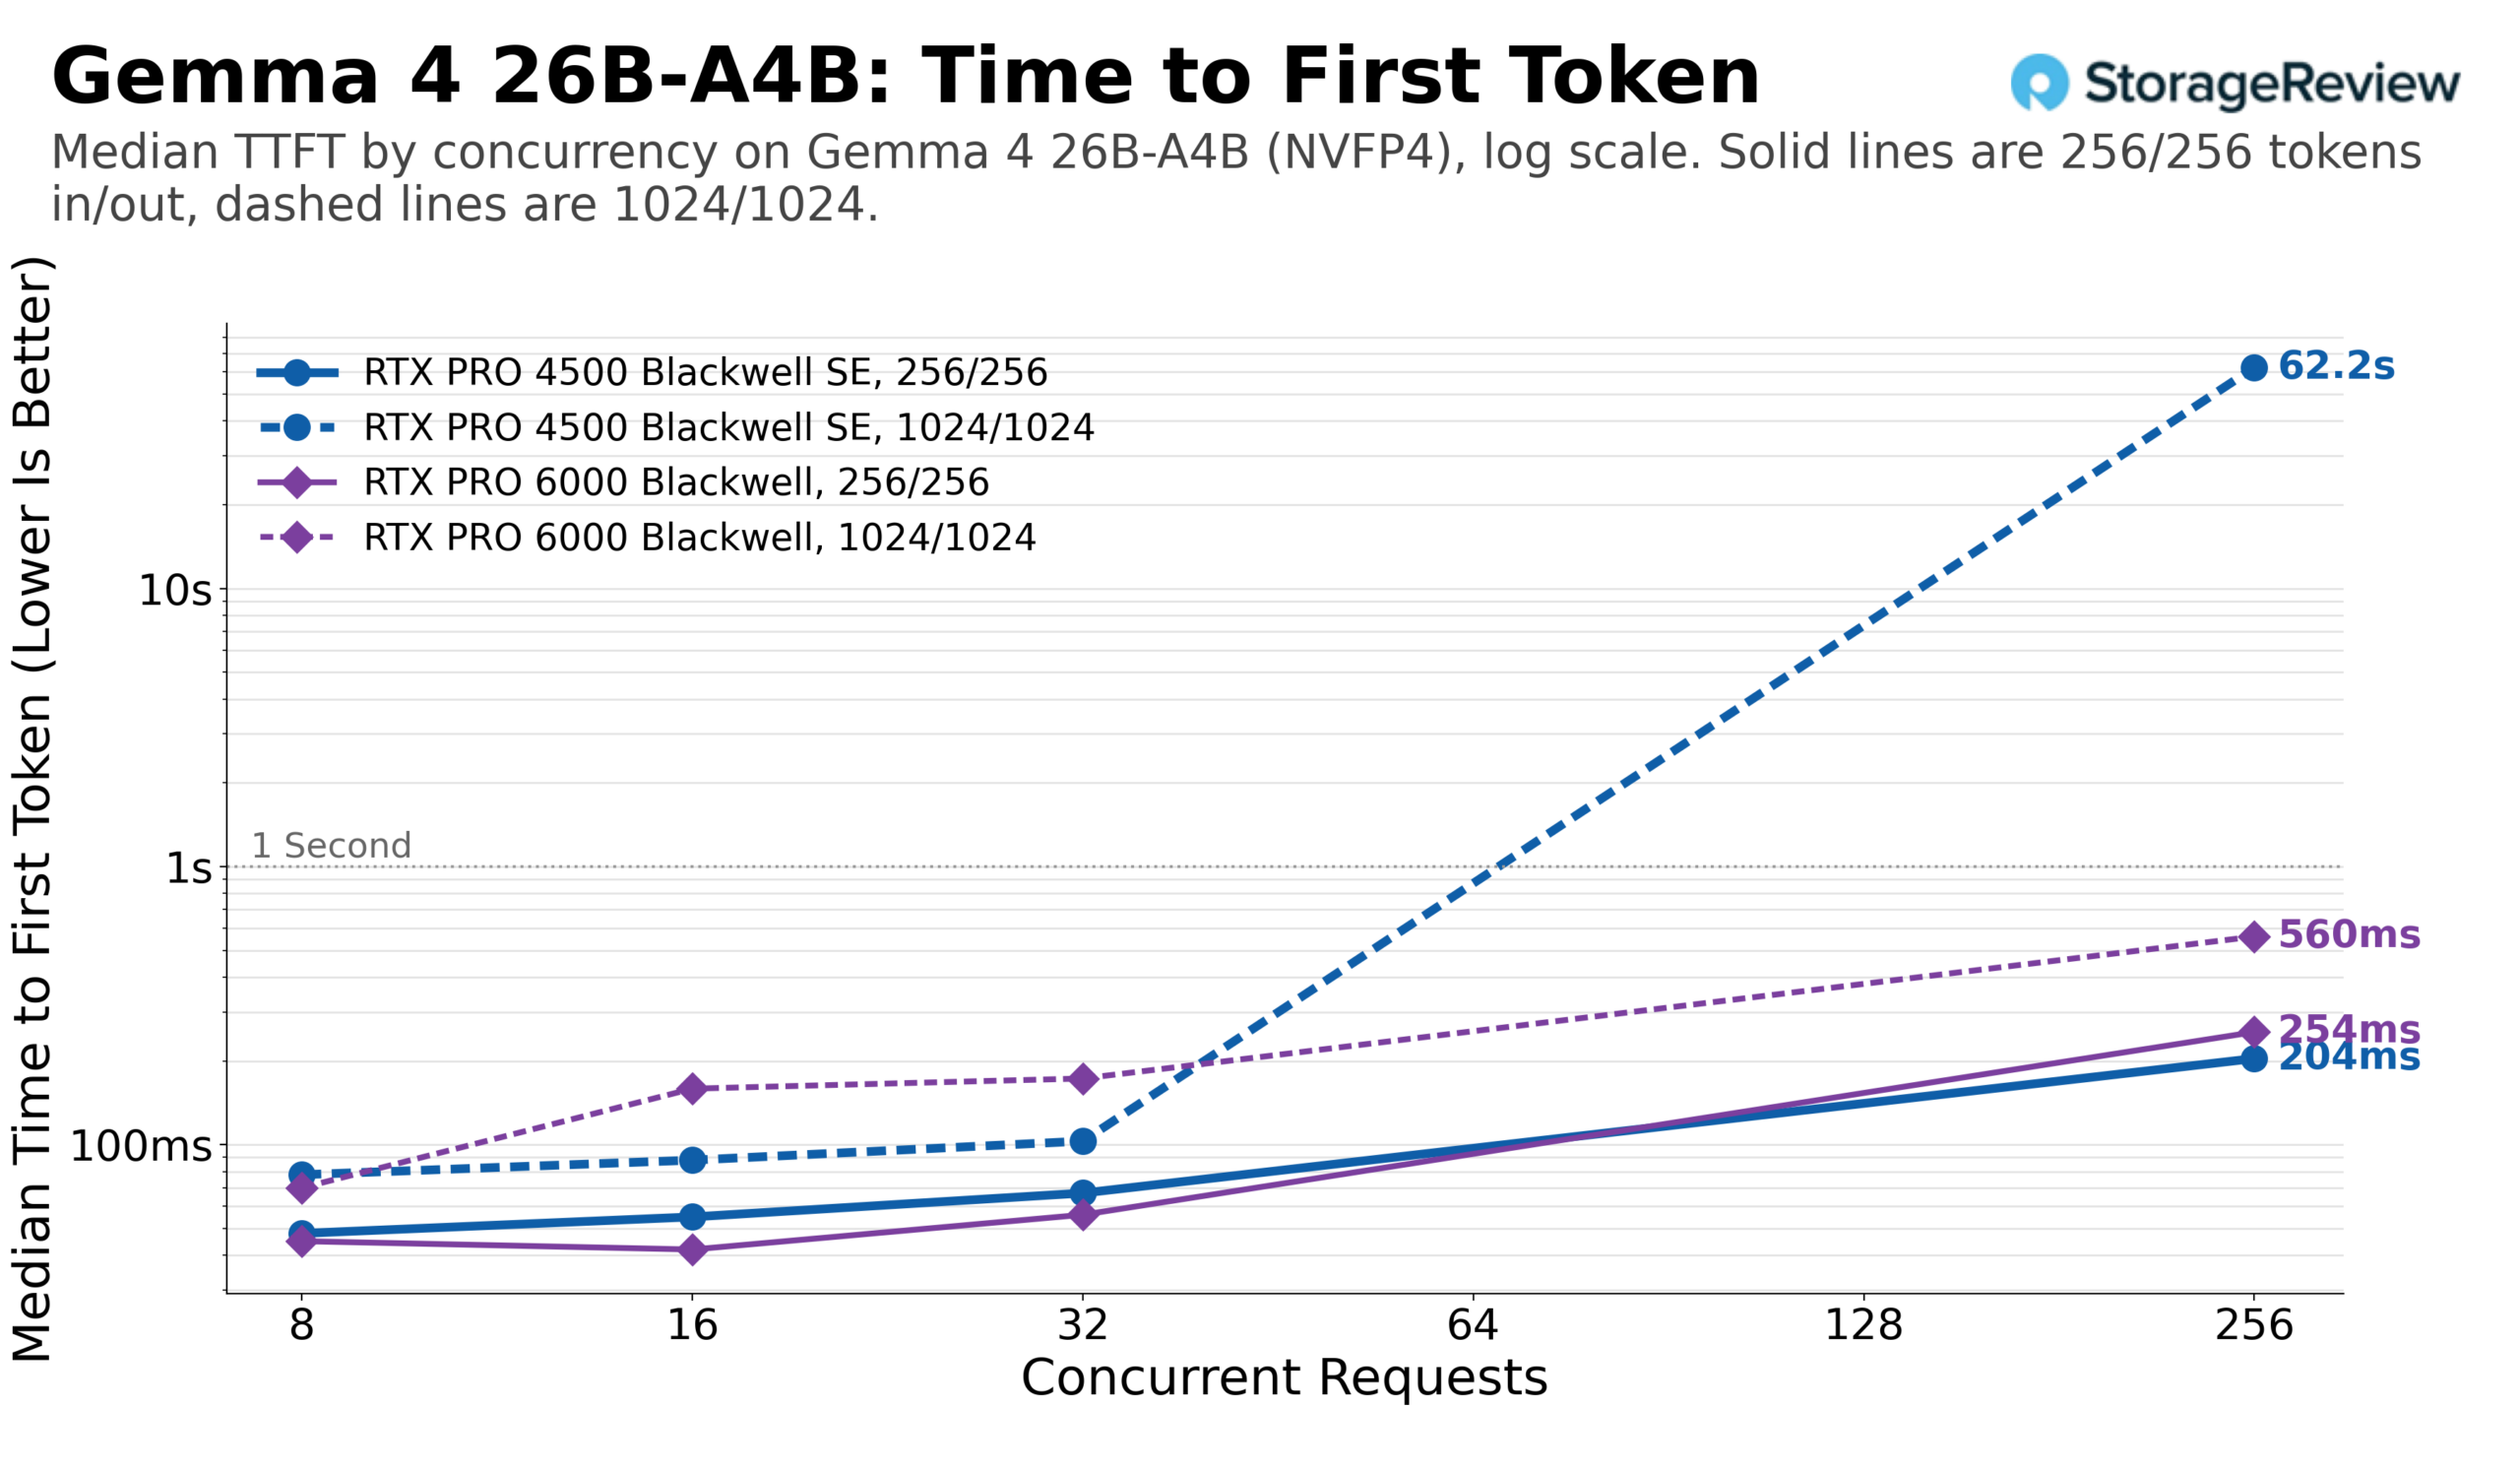
First-token latency က BF16 မော်ဒယ်တွေနဲ့ အတူတူပါပဲ။ တစ်ပြိုင်နက်တည်း ၃၂ ခုမှာ 4500 ရဲ့ median က 256/256 မှာ 67ms နဲ့ 1,024/1,024 မှာ 103ms ဖြစ်ပြီး 6000 ရဲ့ ဆယ်ဂဏန်းအနည်းငယ်အတွင်းမှာပဲ short shape မှာ 256 တစ်ပြိုင်နက်တည်းမှာ 204ms မှာ ရှိနေခဲ့ပါတယ်။ တစ်ပြိုင်နက်တည်းမှာ 256 တစ်ပြိုင်နက်တည်းမှာ 1,024/1,024 မှာ 4500 က 62 စက္ကန့်အထိ queue လုပ်ခဲ့ပြီး memory သုံးဆရှိတဲ့ 6000 က 560ms မှာ သိမ်းဆည်းထားပါတယ်။ 26B MoE အတွက် 4500 က long context မှာ 32-session card ဖြစ်ပြီး chat length မှာ 256-session card ဖြစ်ပြီး L4 မှာမရှိတဲ့ FP4 hardware ပေါ်မှာ model ကို run ပါတယ်။
DL145 သည် 4500 ရှိ 26B မော်ဒယ်အတွက် အများဆုံး 306W သာ သုံးစွဲခဲ့ပြီး 4B မော်ဒယ်များတွင် အများဆုံး 308W သုံးစွဲခဲ့သည်။ အဘယ်ကြောင့်ဆိုသော် ကတ်သည် မည်သည့်နည်းနှင့်မဆို 165W ဖြစ်သောကြောင့်ဖြစ်သည်။ နံရံတွင် 300W ရှိသော edge box တွင် 26B-class မော်ဒယ်သည် ဤနေရာတွင် စွမ်းရည်မြှင့်တင်မှုတစ်ခုဖြစ်ပြီး မော်ဒယ်ငယ်များထက် ပါဝါပိုမိုကုန်ကျခြင်း မရှိပါ။
ကောက်ချက်
NVIDIA သည် RTX PRO 4500 Blackwell Server Edition ကို L4 ထက် ၅ ဆကျော် အဆင့်သတ်မှတ်ပြီး FP4 နှင့် NIM ပေါ်တွင် မူတည်သည့် ကိန်းဂဏန်းဖြစ်သည်။ DL145 Gen11 တွင် အလားတူ BF16 နှိုင်းယှဉ်ချက်တွင် 4500 သည် working concurrency တွင် မော်ဒယ်ငယ်နှစ်ခုတွင် L4 ၏ output throughput ပျမ်းမျှ ၂.၇ ဆ နှင့် saturation တွင် ၃.၀x မှ ၃.၂x အထိ ပေးစွမ်းနိုင်ပြီး၊ single user အတွက် tokens များကို ၂.၈ ဆ ပိုမြန်စေပြီး L4 သည် ဆယ်စက္ကန့်ကြာ queuing လုပ်ခဲ့သည့် load များတွင် first-token latency ကို တစ်စက္ကန့်အောက်တွင် ထိန်းထားနိုင်သည်။ L4 သည် user တိုင်းကို တစ်စက္ကန့်လျှင် output token ၁၀ ခုအထက်ကို shape အများစုတွင် session ၃၂ ခုမှ ၂၅၆ ခုအထိ ထိန်းသိမ်းထားနိုင်ပြီး prefill-heavy 1,024/3.2 shape တွင် ၈ ခုသာ ထားရှိနိုင်ပြီး chat-length prompts များတွင် 4500 သည် ၂၅၆ တွင် ရှိသည်။ 4500 သည် NVFP4 ရှိ Gemma 4 26B-A4B ကိုလည်း အသုံးပြုနိုင်ခဲ့ပြီး၊ L4 တွင် natively run ၍မရသော မော်ဒယ်ဖြစ်သည်။
ကုန်ကျစရိတ်က နံရံမှာ 105W ဖြစ်ပြီး၊ server တစ်ခုလုံး load လုပ်ရင် 196W ကနေ 301W အထိ ကုန်ကျပြီး card မှာ board power ရဲ့ 2.3x ရှိပါတယ်။ GPU မှာ တိုင်းတာရင် 4500 ဟာ output token တစ်ခုအတွက် L4 ထက် 1.3 မှ 1.4x အထိ ထိရောက်မှုရှိပါတယ်။ နံရံမှာ တိုင်းတာရင် system ရဲ့ ကျန် power ကို ဘယ်လိုပဲသုံးသုံး 1.9x လောက်ရှိပါတယ်။ per-box power budget မှာ အရွယ်အစားရှိတဲ့ site တွေက 4500 ဟာ သူတို့သုံးစွဲနေတဲ့ watt တွေကို ပိုကောင်းအောင်အသုံးပြုတာကို တွေ့ရှိမှာဖြစ်ပြီး slot တွေမှာ အရွယ်အစားရှိတဲ့ site တွေက 32 session မှာ L4 သုံးခုရဲ့ box throughput နဲ့ ကိုက်ညီတဲ့ 4500 တစ်ခုကို တွေ့ရှိမှာဖြစ်ပြီး user တစ်ယောက်ကို generation 2.8x ပိုမြန်ပြီး 32GB pool တစ်ခုတည်းကို ရရှိမှာဖြစ်ပါတယ်။
ပြန်လည်သုံးသပ်ချက်ရဲ့ထိပ်ဆုံးက scope caveat က အကျုံးဝင်ပါတယ်၊ ဘာလို့လဲဆိုတော့ ဒါက မော်ဒယ်ငယ်သုံးခုမှာ one edge server မှာ သူ့ရဲ့ရှေ့ကကတ်နဲ့ ယှဉ်ရင် တစ်ကတ်တည်းဖြစ်နေလို့ပါ။ ပြီးတော့ RTX PRO 4500 Server Edition ရဲ့နေရာက L40S၊ RTX PRO 6000 Server Edition နဲ့ လက်ရှိ inference lineup တွေထဲမှာ ပါနေတာက ကျွန်တော်တို့ ပိုကျယ်ပြန့်တဲ့အပိုင်းမှာ လုပ်ဆောင်နေတဲ့ သီးခြားမေးခွန်းတစ်ခုပါ။ L4 ရှိတဲ့ DL145 ပိုင်ရှင်တစ်ယောက်က မေးနေတဲ့မေးခွန်းအတွက် အဖြေက 4500 ဟာ platform တည်ဆောက်ထားတဲ့ အဆင့်မြှင့်တင်မှုဖြစ်ပြီး၊ chassis မှာ full-length riser နဲ့ 16-pin feed ပါရှိမယ်ဆိုရင်၊ ပြီးတော့ HPE ရဲ့ edge မှာ Nemotron အတွက် ဒီကတ်နဲ့ ဒီ server တွဲဖက်မှုက hardware ရဲ့လုပ်ဆောင်ချက်နဲ့ ကောင်းကောင်းကိုက်ညီပါတယ်။
DL145 Gen11 ကိုယ်တိုင်က ကျွန်ုပ်တို့ရဲ့ အစွန်းအပိုင်းမှာ ပေါ်လာပါတယ် အကောင်းဆုံးဆာဗာများ ဦးဆောင်သူစာရင်း၊ ဤရလဒ်သည် ယခုအခါ အနားစွန်း ကောက်ချက်ချမှုဇာတ်လမ်းကို အခြေခံထားသည်။
ဦးဆောင်သူစာရင်း- RTX PRO 4500 Blackwell Server Edition သည် ကျွန်ုပ်တို့၏ အကောင်းဆုံး Enterprise GPU များ ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံး Single-Slot GPU ကို ရရှိထားပြီး L4 သည် 1U နှင့် Edge အတွက် အကောင်းဆုံး Slot-Powered Card ကို ရရှိထားသည်။



 အမေဇုံ