

သြဂုတ်လတွင် NVIDIA သည် ၎င်း၏ ထိပ်တန်း Blackwell desktop ကမ်းလှမ်းချက်ကို ပရော်ဖက်ရှင်နယ်များအတွက် Workstation နှင့် Server ဟူ၍ လမ်းကြောင်းနှစ်ခုခွဲထားသည်။ RTX PRO 6000 Workstation ကတ်ကို tower သို့မဟုတ် desktop chassis အတွင်း အမြင့်ဆုံး compute နှင့် VRAM လိုအပ်သော creator များ၊ အင်ဂျင်နီယာများနှင့် AI developer များအတွက် ဒီဇိုင်းထုတ်ထားသည်။ RTX PRO 6000 Blackwell Server Edition ကို data center ရှိ rack server များနှင့် headless inference သို့မဟုတ် rendering node များအတွက် ဒီဇိုင်းထုတ်ထားသည်။ ယခု workstation card ကို bench ပေါ်တွင် ထားရှိပြီးဖြစ်သောကြောင့် ဤသုံးသပ်ချက်အတွက် အာရုံစိုက်နိုင်ပါပြီ။
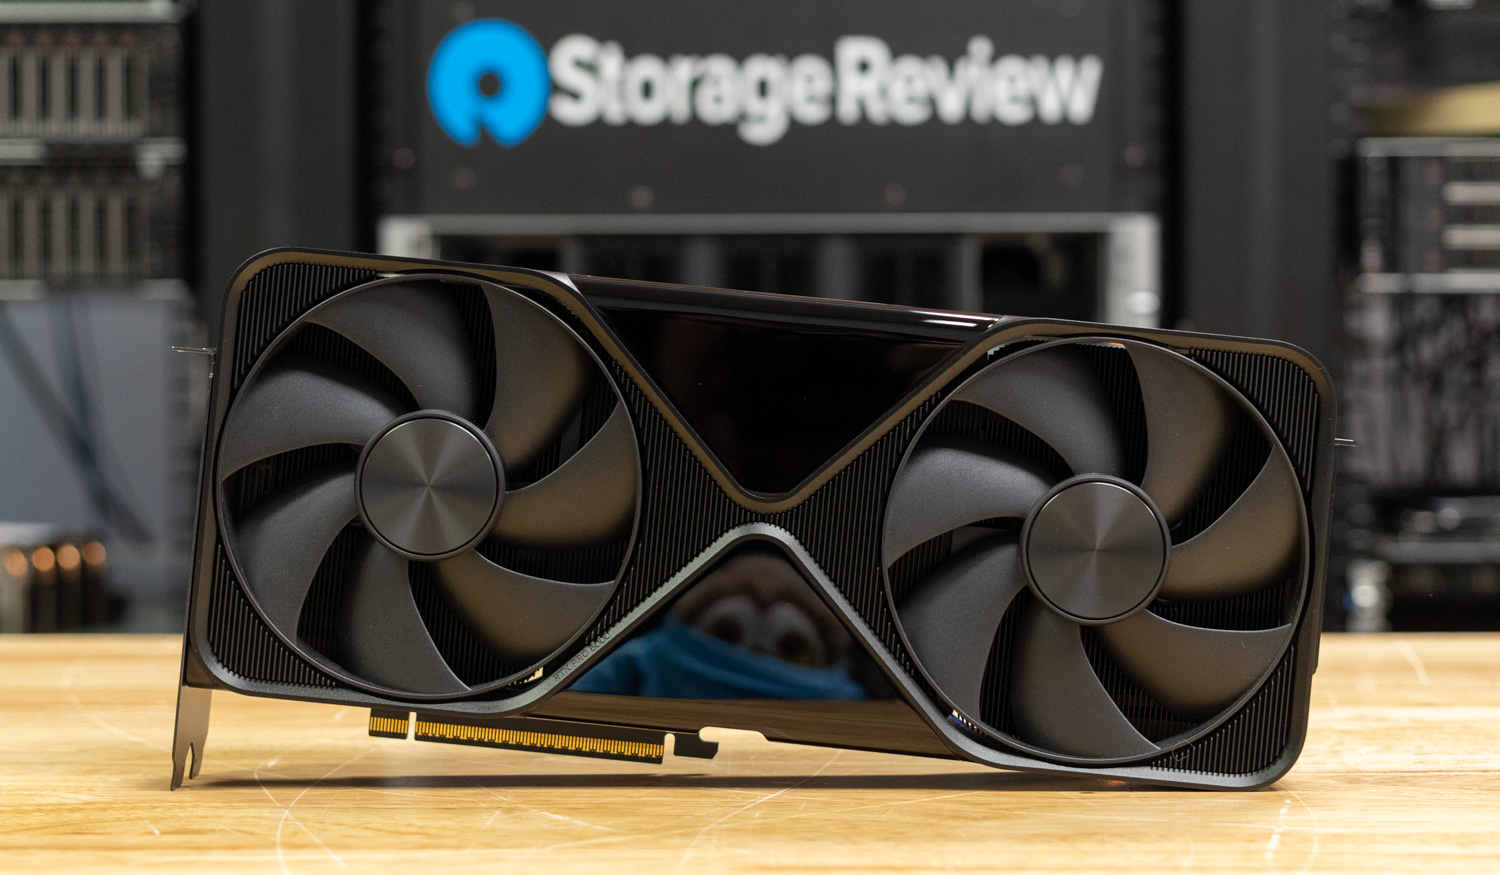
ဒေါ်လာ ၈၅၀၀ တန် RTX PRO 6000 မှာ CUDA cores ၂၄၀၆၄ ခု၊ ပဉ္စမမျိုးဆက် Tensor Cores ၇၅၂ ခု၊ စတုတ္ထမျိုးဆက် RT Cores ၁၈၈ ခု နဲ့ GDDR7 ECC ၉၆ GB ပါဝင်တဲ့ full-fat GB202 ကို ယူဆောင်လာပါတယ်။ ဆွဲဆောင်မှုကို ချက်ချင်းသိသာထင်ရှားစေပါတယ်။ သုံးစွဲသူကတ်တွေ မယှဉ်နိုင်တဲ့ မန်မိုရီစွမ်းရည်၊ pro drivers တွေနဲ့ အထူးပါဝါ ဒါမှမဟုတ် လေစီးဆင်းမှုလိုအပ်ချက်တွေမရှိတဲ့ workstation အစစ်အမှန်တွေနဲ့ ကိုက်ညီတဲ့ dual-slot form factor ကို ရရှိမှာပါ။
NVIDIA က ဒီ GPU ကို ရောနှောထားတဲ့ workflow တွေအတွက် နေရာချပေးပါတယ်။ အဲဒီထဲမှာ ရှည်လျားတဲ့ context ပါဝင်တဲ့ local LLM inference၊ large scene rendering၊ complex simulation နဲ့ multi-GPU research rigs တွေ ပါဝင်ပါတယ်။ လက်တွေ့ကျတဲ့ အထိအတွေ့တွေက ဒီနေရာမှာ အရေးကြီးပါတယ်။ ဒီကတ်က standard PCIe 5.0 x16 interface ကို အသုံးပြုထားပြီး high-resolution၊ high-refresh-rate visualization အတွက် DisplayPort 2.1b output လေးခု ပေးစွမ်းပြီး 600 W configure လုပ်နိုင်တဲ့ TDP ကို ပေးစွမ်းတာကြောင့် integrators တွေအနေနဲ့ အကောင်းဆုံး thermals၊ acoustics ဒါမှမဟုတ် density အတွက် ချိန်ညှိနိုင်ပါတယ်။
ကျွန်ုပ်တို့၏ ရည်မှန်းချက်မှာ ဤ workstation ဗားရှင်းသည် AI၊ rendering နှင့် အထွေထွေ computing တို့တွင် ဓာတ်ခွဲခန်းတွင် မည်သို့စွမ်းဆောင်ရည်ရှိသည်ကို အကဲဖြတ်ရန်နှင့် 96 GB pool ၏ single desktop node ၏ စွမ်းရည်များအပေါ် မည်သို့သက်ရောက်မှုရှိသည်ကို တွက်ချက်ရန်ဖြစ်သည်။
NVIDIA RTX PRO 6000 Workstation နှင့် Server Edition နှိုင်းယှဉ်ချက်
RTX PRO 6000 မျိုးကွဲများသည် Blackwell GB202 အခြေခံမှ စတင်သောကြောင့် စာရွက်ပေါ်တွင် ရင်းနှီးနေပုံရသည်။ ကွာခြားချက်မှာ ၎င်းတို့ကို မည်သို့နှင့် မည်သည့်နေရာတွင် အသုံးချရန် ရည်ရွယ်ထားသည်ဆိုသည့်အချက်ဖြစ်သည်။ ကျွန်ုပ်တို့စမ်းသပ်နေသော workstation ကတ်သည် DisplayPort 2.1b output လေးခုနှင့် studio-class drivers များပါရှိသော self-contained, actively cooled, dual-slot board တစ်ခုဖြစ်သည်။ ၎င်းသည် tower သို့မဟုတ် deskside workstation တွင် တပ်ဆင်နိုင်ပြီး local panel များကို မောင်းနှင်ကာ CUDA၊ TensorRT နှင့် cuDNN တို့နှင့်အတူ ISV-certified DCC နှင့် CAD app များကို လည်ပတ်စေသည်။ workflow များတွင် interactive viewport work, local visualization နှင့် on-box AI တို့ကို ရောနှောထားပါက ၎င်းသည် အရာအားလုံးကို chassis တစ်ခုတည်းတွင် ခန့်မှန်းနိုင်သော acoustics နှင့် thermals များဖြင့် ထားရှိပေးသည့် လမ်းကြောင်းဖြစ်သည်။
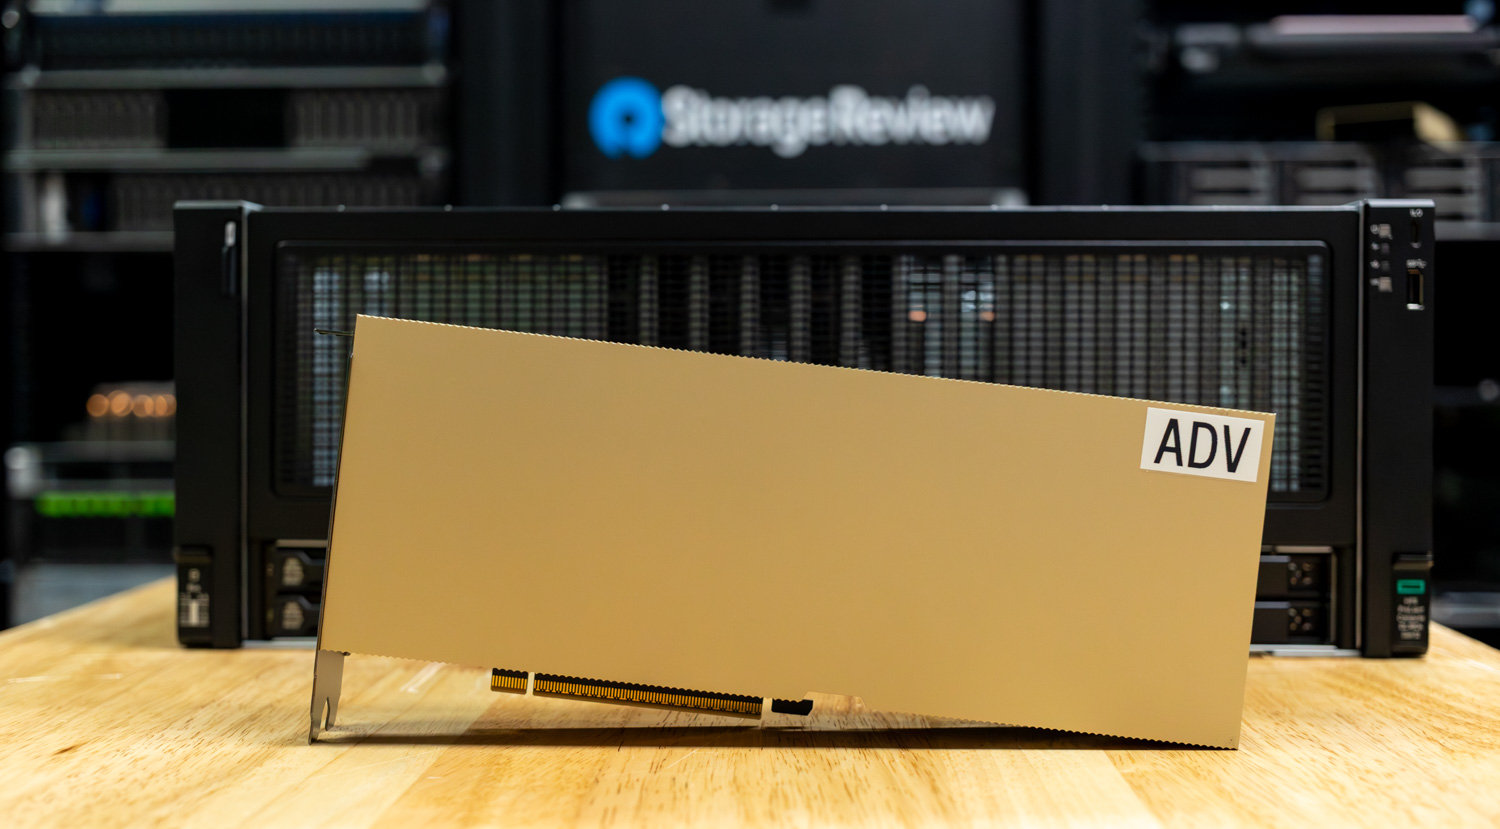
RTX PRO 6000 Blackwell Server Edition ကို ထူးခြားကွဲပြားတဲ့ ရည်ရွယ်ချက်အတွက် ဒီဇိုင်းထုတ်ထားပါတယ်။ ဒါဟာ ဆာဗာတွေအတွက် ရည်ရွယ်ထားတဲ့ headless, rack-first configuration တစ်ခုဖြစ်ပြီး front-to-back airflow နဲ့ remote management capabilities တွေ ပါဝင်ပါတယ်။ အလုပ်တွေကို network ကနေ အချိန်ဇယားဆွဲပြီး ရလဒ်တွေကို remote ကနေ သုံးစွဲတဲ့အတွက် active display output တွေ မရှိပါဘူး။ Firmware, power နဲ့ thermal profile တွေကို scheduler အောက်မှာ 24×7 duty အတွက် ချိန်ညှိထားပြီး NVIDIA AI Enterprise, container orchestration နဲ့ hypervisor passthrough တို့နဲ့ တွဲဖက်အသုံးပြုလေ့ရှိပါတယ်။ အတိုချုပ်ပြောရရင် creator တွေနဲ့ engineer တွေဟာ inference ကြီးကြီးမားမား ဒါမှမဟုတ် simulation batches တွေကို လုပ်ဆောင်နေချိန်မှာပဲ local မှာ အလုပ်ကို ကြည့်ရှုကိုင်တွယ်ဖို့ လိုအပ်တဲ့အခါ workstation model ဟာ မှန်ကန်တဲ့ ရွေးချယ်မှုပါပဲ။ server edition ဟာ data center တစ်ခုမှာ queue တစ်ခုရဲ့နောက်ကွယ်က node တွေကို scaling လုပ်တဲ့အခါ ပိုပြီး အဓိပ္ပာယ်ရှိပါတယ်။ watt၊ cable နဲ့ airflow path တိုင်းဟာ OEM service plan ထဲမှာ ကိုက်ညီရပါမယ်။
NVIDIA RTX PRO 6000 သတ်မှတ်ချက်များ
အောက်ပါဇယားတွင် NVIDIA RTX PRO 6000 ၏ သတ်မှတ်ချက်များကို RTX 5090 နှင့် ယခင် Ada Lovelace မျိုးဆက် RTX 4090 တို့နှင့် နှိုင်းယှဉ်ဖော်ပြထားသည်။
| GPU နှိုင်းယှဉ်ချက် | NVIDIA RTX PRO 6000 | NVIDIA RTX5090 | NVIDIA RTX4090 |
| GPU ကိုအမည် | GB202 | GB202 | AD102 |
| ဗိသုကာအတတ်ပညာ | ဘလက်ဝဲလ် ၂.၀ | ဘလက်ဝဲလ် ၂.၀ | Ada Lovelace |
| လုပ်ငန်းစဉ်အရွယ်အစား | 5 nm | 5 nm | 5 nm |
| transistors | 92,200 သန်း | 92,200 သန်း | 76,300 သန်း |
| သိပ်သည်းဆ | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း | ၁၂၃.၉ မီလီမီတာ / မီလီမီတာစတုရန်း |
| Size ကို Die | 750 mm² | 750 mm² | 609 mm² |
| slot အကျယ် | Dual- slot | Dual- slot | သုံးထပ် slot |
| ရှုထောင့် | 304 137 မီလီမီတာမီလီမီတာမီလီမီတာ x x 40 | 304 137 မီလီမီတာမီလီမီတာမီလီမီတာ x x 48 | 304 137 မီလီမီတာမီလီမီတာမီလီမီတာ x x 61 |
| TDP | 600W | 575W | 450W |
| အကျိုးရလဒ်များ | 4x DisplayPort 2.1b | HDMI 2.1b ၁ ခု၊ DisplayPort 2.1b ၃ ခု | HDMI 2.1 ၁ ပေါက်၊ DisplayPort 1.4a ၃ ပေါက် |
| Power က Connectors | 1x 16 pin | 1x 16 pin | 1x 16 pin |
| ဘတ်စ်ကား Interface | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 4.0 x16 |
| base နာရီ | 1590 MHz | 2017 MHz | 2235 MHz |
| နာရီ Boost | 2617 MHz | 2407 MHz | 2520 MHz |
| မှတ်ဉာဏ်နာရီ | 1750 MHz (28 Gbps ထိရောက်မှု) | 2209 MHz (28 Gbps ထိရောက်မှု) | 1313 MHz (21 Gbps ထိရောက်မှု) |
| memory အရွယ်အစား | 96 GB ကို | 32 GB ကို | 24 GB ကို |
| memory အမျိုးအစား | GDDR7 ECC | GDDR7 | GDDR6X |
| မှတ်ဉာဏ်ဘတ်စ်ကား | 512 bit နဲ့ | 512 bit နဲ့ | 384 bit နဲ့ |
| မှတ်ဉာဏ် Bandwidth | ၁ TB / s | ၁ TB / s | ၁ TB / s |
| CUDA core | 24,064 | 21,760 | 16,384 |
| Tensor core | 752 | 680 | 512 |
| ROPs | 192 | 192 | 176 |
| SM အရေအတွက် | 188 | 170 | 128 |
| RT ကို core | 188 | 170 | 128 |
| L1 ကက်ရှ် | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) | ၁၂၈ KB (SM လျှင်) |
| L2 ကက်ရှ် | 128 ကို MB | 88 ကို MB | 72 ကို MB |
| ပစ်ဇယ်နှုန်း | ၄၆၂.၁ GPixel/s | ၄၆၂.၁ GPixel/s | ၄၆၂.၁ GPixel/s |
| အသွင်အပြင်နှုန်း | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s | ၁,၆၃၇ GTexel/s |
| FP၁၆ (တစ်ဝက်) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) |
| FP32 (float) | 126.0 TFLOPS | 104.8 TFLOPS | 82.58 TFLOPS |
| FP64 (နှစ်ထပ်) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၁.၆၃၇ တီဖလော့ပ် (၁:၆၄) | ၈၇၉.၃ ဂျီအက်ဖ်လော့ပ်စ် (၁:၆၄) |
| စတင်ရောင်းချသည့် ဈေးနှုန်း (USD) | $8,500 | $1,999 | $1,599 |
တည်ဆောက်ခြင်းနှင့်ဒီဇိုင်းဆွဲခြင်း
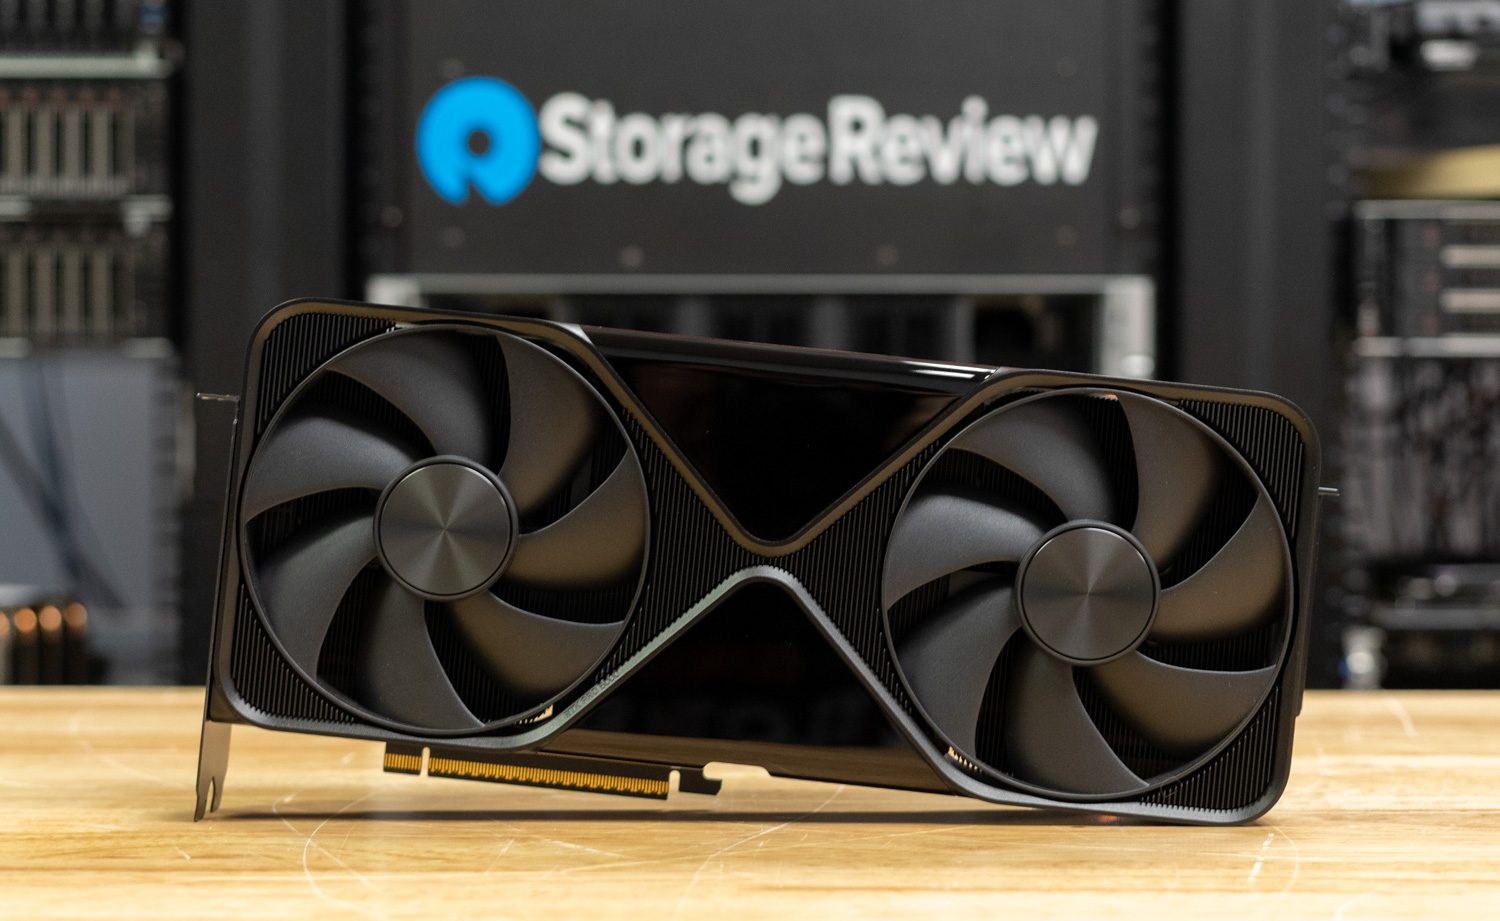
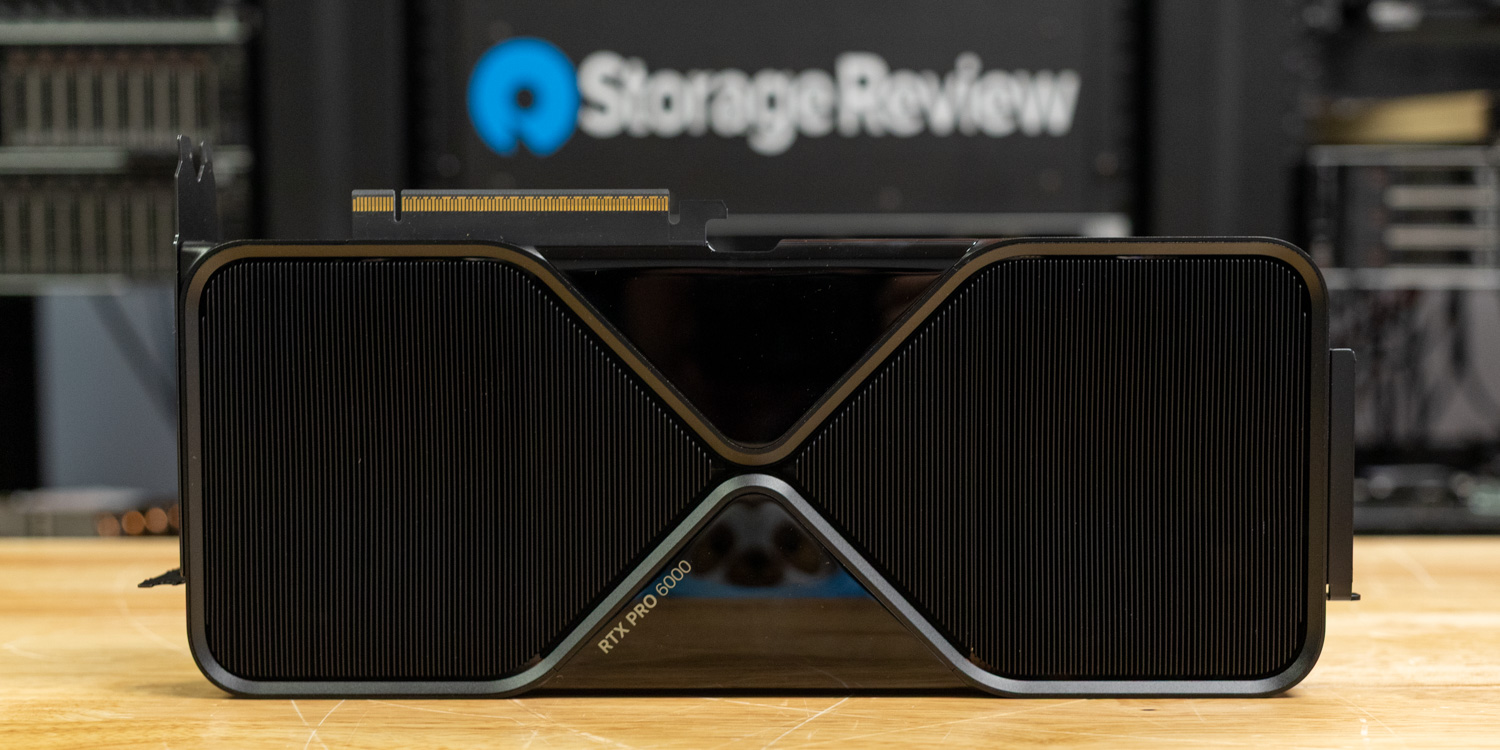
RTX PRO 6000 Workstation GPU သည် RTX 5090 FE တွင်တွေ့ရသည့်အတိုင်း NVIDIA ၏ သန့်ရှင်းပြီး လုပ်ဆောင်နိုင်စွမ်းရှိသော ဒီဇိုင်းကို ဆက်လက်သယ်ဆောင်ထားပြီး စက်မှုလုပ်ငန်းသုံး matte-black finish နှင့် workstation ပတ်ဝန်းကျင်အတွက် အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ထားသော dual-axial fan layout တို့ဖြင့် ပြုလုပ်ထားသည်။ ပန်ကာတစ်ခုစီကို full-length 3D vapor chamber မှတစ်ဆင့် လေစီးဆင်းမှုကို တွန်းပို့ရန် ဒီဇိုင်းထုတ်ထားပြီး ရေရှည်အလုပ်များအောက်တွင် အပူချိန်မျှခြေကို ထိန်းသိမ်းရန် ကူညီပေးသည်။ 304 mm × 137 mm × 40 mm အတိုင်းအတာရှိပြီး dual-slot configuration တွင် သက်တောင့်သက်သာ တပ်ဆင်နိုင်ပြီး ၎င်း၏ 600 W TDP အဆင့်သတ်မှတ်ချက်ကြောင့် ထူးကဲသော စွမ်းဆောင်ရည်သိပ်သည်းဆကို ပေးစွမ်းသည်။
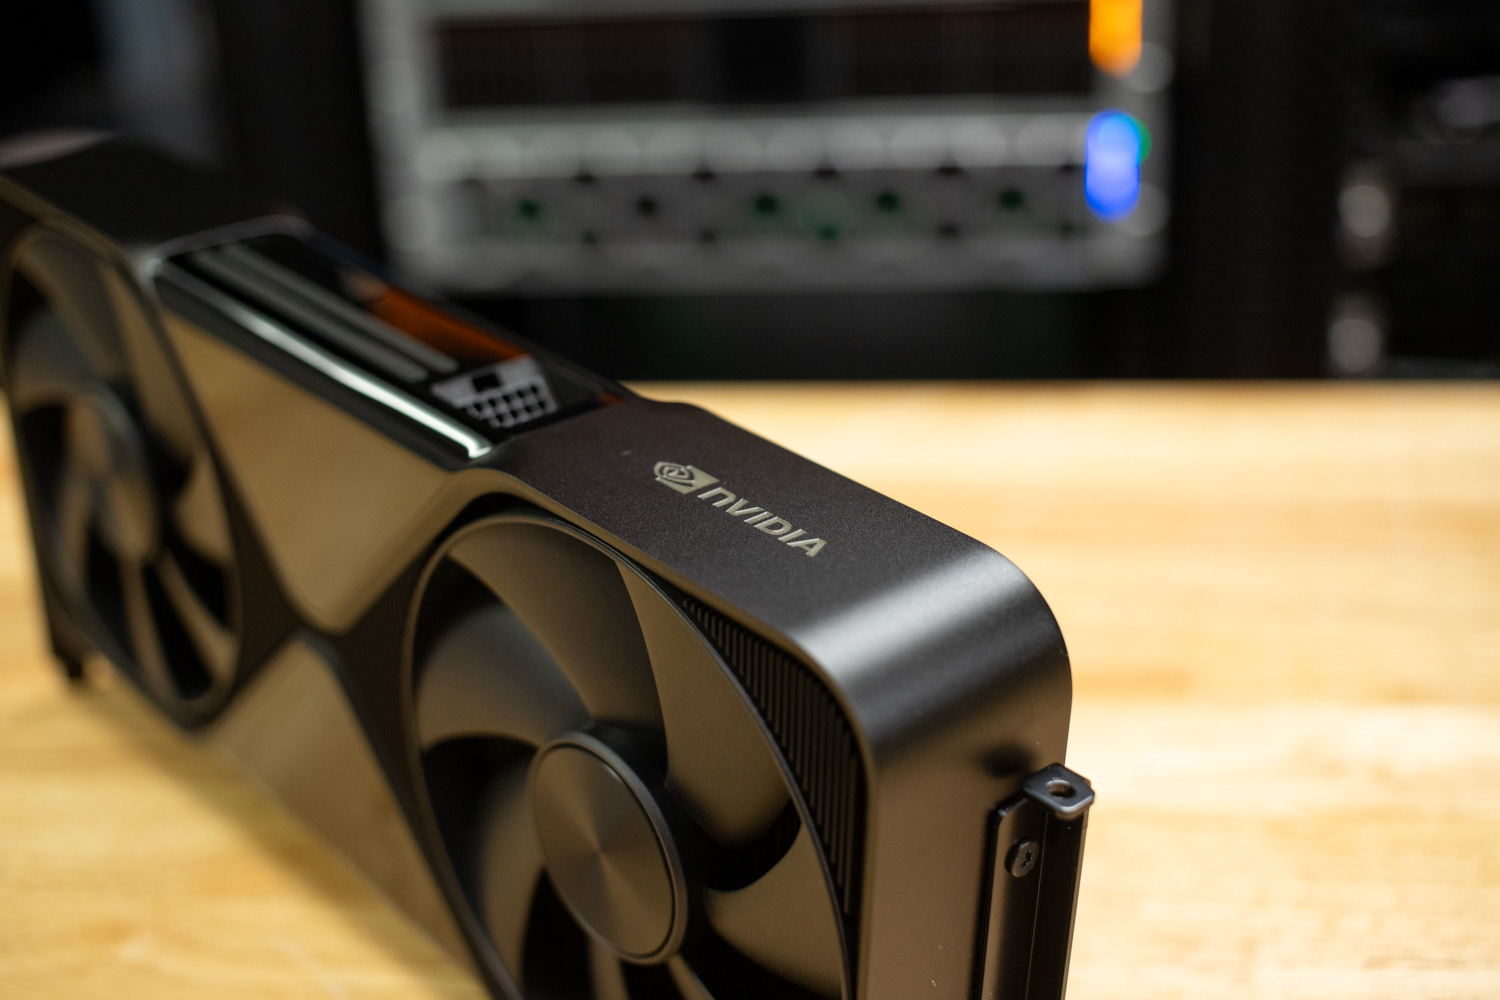
အပေါ်ဘက်အနားတစ်လျှောက်တွင် PRO 6000 တွင် 16-pin power connector တစ်ခုတည်းပါရှိပြီး ၎င်း၏ 96 GB GDDR7 memory နှင့် Blackwell 2.0 architecture အပြည့်အစုံကို ပံ့ပိုးပေးရန် လိုအပ်သော current ကို ပို့ဆောင်ပေးပါသည်။ တည်ဆောက်မှုအရည်အသွေးသည် premium နှင့် rigid ဖြစ်ပြီး fin stack တစ်လျှောက် လေကို ထိရောက်စွာ စီးဆင်းစေသော aluminum shroud ပါရှိသည်။ NVIDIA ၏ သိမ်မွေ့သော branding သည် RGBs သို့မဟုတ် gaming flourishes များမပါဘဲ professional aesthetic ကို ဖြည့်စွက်ပေးပြီး အပူချိန်မြင့်မားသော workstation chassis တွင် ယုံကြည်စိတ်ချရမှုနှင့် စွမ်းဆောင်ရည်ကို အလေးပေးဖော်ပြသည်။
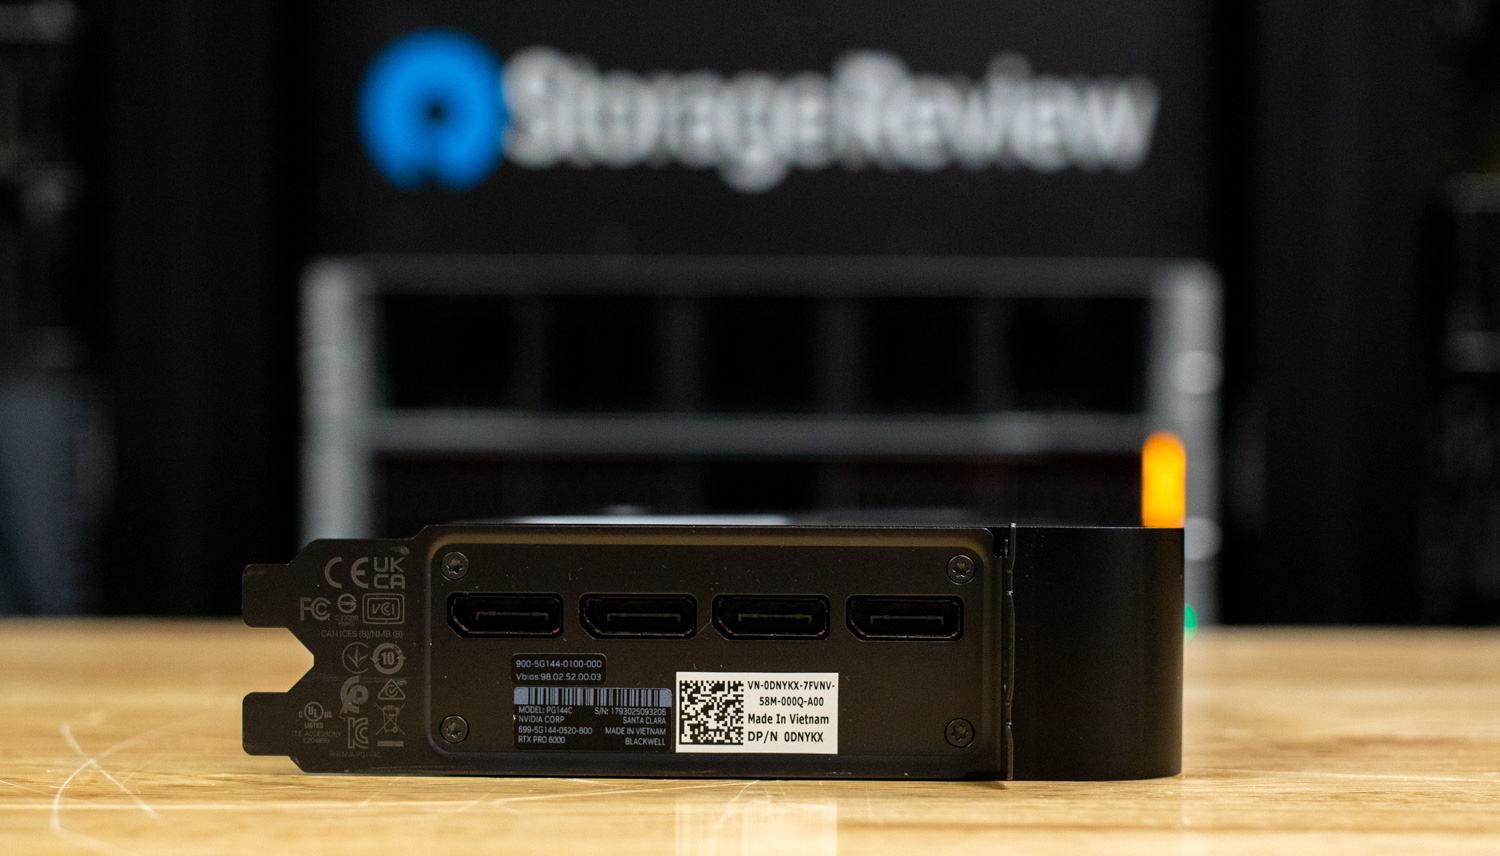
I/O ဘက်ခြမ်းတွင် NVIDIA သည် DisplayPort 2.1b output လေးခုကို ပံ့ပိုးပေးသောကြောင့် multi-monitor 8K setup များ၊ color-accurate HDR workflows များနှင့် အဆင့်မြင့် rendering environments များနှင့် တွဲဖက်အသုံးပြုနိုင်ကြောင်း သေချာစေသည်။ HDMI မှတစ်ဆင့် DisplayPort 2.1b ကိုအသုံးပြုခြင်းသည် ၎င်း၏ professional orientation ကို ထင်ဟပ်စေပြီး high-refresh နှင့် high-resolution display များအတွက် bandwidth မြှင့်တင်ထားသည်။
စွမ်းဆောင်ရည်စမ်းသပ်ခြင်း
ကျွန်ုပ်တို့၏ NVIDIA RTX PRO 6000 နမူနာ၏ စွမ်းဆောင်ရည်ကို အကဲဖြတ်ရန်အတွက်၊ ၎င်းကို NVIDIA ၏ flagship consumer counterparts များဖြစ်သည့် RTX 5090 Founders Edition နှင့် RTX 4090 Founders Edition တို့နှင့် တိုက်ရိုက်နှိုင်းယှဉ်ခဲ့ပါသည်။ raw compute power နှင့် real-world application performance နှစ်မျိုးလုံးကို မီးမောင်းထိုးပြရန်အတွက် professional နှင့် AI-driven workloads များ ရောနှော၍ စမ်းသပ်ခဲ့ပါသည်။ Benchmarks များတွင် UL Procyon AI Text Generation၊ UL Procyon AI Image Generation၊ LuxMark၊ Geekbench 6 နှင့် V-Ray တို့ပါဝင်ပြီး rendering၊ inference နှင့် productivity performance တို့ကို ဟန်ချက်ညီစွာ ခြုံငုံသုံးသပ်နိုင်စေပါသည်။
ဤစံ workloads များအပြင်၊ RTX PRO 6000 ရှိ 96 GB GDDR7 မှတ်ဉာဏ်ကို ပြသရန် ဒီဇိုင်းထုတ်ထားသော ပစ်မှတ်ထားစမ်းသပ်မှုများကိုလည်း ကျွန်ုပ်တို့ ပြုလုပ်ခဲ့ပြီး၊ စွမ်းရည်နှင့် ရေရှည်တည်တံ့သော throughput သည် အရေးကြီးသည့် မော်ဒယ်ကြီးများ၊ resolution မြင့်မားသော datasets များနှင့် ပရော်ဖက်ရှင်နယ် visualization workloads များကို ကိုင်တွယ်ရာတွင် ၎င်း၏ အားသာချက်များကို ပြသခဲ့ပါသည်။
- RTX PRO 6000
- GeForce RTX 5090 FE
- GeForce RTX 4090 FE
- RTX 6000 ADA
NVIDIA RTX PRO 6000 အသစ်ရဲ့ အကျိုးကျေးဇူးတွေကို အပြည့်အဝအသုံးချနိုင်ဖို့အတွက်၊ ကျွန်တော်တို့ရဲ့ AMD ThreadRipper platform ကို အသုံးပြုခဲ့ပါတယ်။ ဒီ system ကို configure လုပ်ထားတဲ့အတိုင်း 64-core CPU နဲ့ water-cooling loop ပါဝင်ပါတယ်။ GPU ကို နှောင့်နှေးမှုမရှိဘဲ လုပ်ဆောင်နိုင်စေဖို့အတွက် အခြေခံ CPU horsepower အများကြီးရှိပါတယ်။ system configuration အပြည့်အစုံကို အောက်မှာ ဖော်ပြထားပါတယ်။
StorageReview AMD ThreadRipper စမ်းသပ်ပလက်ဖောင်း
- motherboard: ASUS Pro WS TRX50-SAGE WIFI
- CPU ကို: AMD Ryzen Threadripper 7980X 64-Core
- ရမ်: 32GB DDR5 4800MT/s
- သိုလှောင်မှု: 2TB Samsung 980 Pro
- OS ကို: Workstations အတွက် Windows 11 Pro
UL Procyon: AI စာသားထုတ်လုပ်ခြင်း
Procyon AI Text Generation Benchmark သည် တိကျပြီး တသမတ်တည်းရှိသော အကဲဖြတ်နည်းလမ်းကို ပံ့ပိုးပေးခြင်းဖြင့် AI LLM စွမ်းဆောင်ရည်စမ်းသပ်မှုကို ပိုမိုကောင်းမွန်စေသည်။ ၎င်းသည် မော်ဒယ်အရွယ်အစားကြီးများနှင့် variable factor များ၏ ရှုပ်ထွေးမှုကို လျှော့ချနေစဉ် LLM မော်ဒယ်များစွာတွင် ထပ်ခါတလဲလဲ စမ်းသပ်နိုင်စေပါသည်။ AI hardware ဦးဆောင်သူများနှင့်အတူ တီထွင်ထားသောကြောင့် ပိုမိုယုံကြည်စိတ်ချရပြီး ထိရောက်သော စွမ်းဆောင်ရည်အကဲဖြတ်မှုများအတွက် ဒေသတွင်း AI accelerator များအသုံးပြုမှုကို အကောင်းဆုံးဖြစ်အောင် ပြုလုပ်ပေးပါသည်။ အောက်တွင်တိုင်းတာထားသော ရလဒ်များကို TensorRT ကို အသုံးပြု၍ စမ်းသပ်ခဲ့သည်။
မော်ဒယ်စမ်းသပ်မှုလေးခုလုံးတွင် NVIDIA RTX PRO 6000 သည် အဆက်မပြတ်ဦးဆောင်နေပါသည်။ Phi မှစတင်၍ PRO 6000 သည် စုစုပေါင်းရမှတ် ၆,၇၇၅ ရရှိခဲ့ပြီး RTX 5090 သည် ၅,၇၄၉၊ RTX 4090 သည် ၄,၉၅၈ နှင့် RTX 6000 Ada သည် ၄,၅၀၈ ဖြင့် ကျော်လွန်ခဲ့သည်။ ၎င်း၏ ပိုမိုမြန်ဆန်သော တိုကင်ထုတ်လုပ်မှုနှုန်း (တိုကင်/စက္ကန့် ၃၂၅.၉) နှင့် နှောင့်နှေးမှုနည်းပါးခြင်း (ပထမဆုံးတိုကင်သို့ ၀.၁၈၂ စက္ကန့်) တို့သည် အချိန်နှင့်တပြေးညီ စာသားထုတ်လုပ်မှုနှင့် ချတ်အခြေခံ AI workloads များတွင် ၎င်း၏တုံ့ပြန်မှုကို အလေးပေးဖော်ပြသည်။
Mistral မှာ ဆက်လက်ဖြစ်ပေါ်နေတဲ့ လမ်းကြောင်းကတော့ PRO 6000 က 7,346 မှတ် ရရှိခဲ့ပြီး 5090 (6,267), 4090 (5,094) နဲ့ 6000 Ada (4,255) တွေထက် များစွာသာလွန်နေပါတယ်။ သူ့ရဲ့ 271.8 tokens/s throughput က သူ့ရဲ့ ပိုကြီးတဲ့ 96 GB memory pool နဲ့ high-context inference အတွက် optimized workstation tuning ရဲ့ အကျိုးကျေးဇူးကို ပြသနေပါတယ်။
Llama3 မှာ PRO 6000 ဟာ ရမှတ် ၆,၅၀၁ နဲ့ ဦးဆောင်နေပြီး RTX 5090 က ၆,၁၀၄၊ 4090 က ၄,၈၄၉ နဲ့ 6000 Ada က ၄,၀၂၆ ရရှိထားပါတယ်။ ဒါက NVIDIA ရဲ့ Blackwell ဗိသုကာရဲ့ တသမတ်တည်းရှိမှုကို မီးမောင်းထိုးပြနေပြီး transformer workloads တွေရဲ့ ရှုပ်ထွေးမှုနဲ့ context length တွေ တိုးလာတာနဲ့အမျှ PRO 6000 ဟာ စွမ်းဆောင်ရည် အားသာချက်တွေကို ထိန်းသိမ်းထားပါတယ်။
နောက်ဆုံးအနေနဲ့၊ ရှည်လျားတဲ့အခြေအနေဆိုင်ရာ ကောက်ချက်ချမှုနဲ့ ရေရှည်စွမ်းဆောင်ရည်ကို အလေးပေးတဲ့ Llama2 မှာ PRO 6000 ဟာ 8,008 ရရှိခဲ့ပြီး 5090၊ 4090 နဲ့ 6000 Ada တွေကတော့ အသီးသီး 6,591၊ 5,013 နဲ့ 3,957 အသီးသီး နောက်ကျကျန်နေခဲ့ပါတယ်။ sequence lengths နဲ့ inference times တွေ တိုးလာပေမယ့် PRO 6000 ဟာ မြန်နှုန်းနဲ့ တည်ငြိမ်မှု နှစ်မျိုးလုံးမှာ ထင်ရှားတဲ့ လွှမ်းမိုးမှုကို ထိန်းသိမ်းထားနိုင်ခဲ့ပြီး စမ်းသပ်ထားတဲ့ တခြား GPU တွေထက် ပိုမြန်ပြီး ပိုချောမွေ့တဲ့ throughput နဲ့ run တွေကို အပြီးသတ်နိုင်ခဲ့ပါတယ်။
| UL Procyon: AI စာသားထုတ်လုပ်ခြင်း | NVIDIA RTX PRO 6000 | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX 6000 Ada |
| Phi ၏ စုစုပေါင်းရမှတ် | 6,775 | 5,749 | 4,958 | 4,508 |
| ပထမဆုံးတိုကင်သို့ Phi ထုတ်ပေးချိန် | 0.182 ့ | 0.244 ့ | 0.255 ့ | 0.288 ့ |
| တစ်စက္ကန့်လျှင် Phi အထွက်တိုကင်များ | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| Phi ၏ စုစုပေါင်းကြာချိန် | 9.498 ့ | 10.280 ့ | 12.872 ့ | 13.869 ့ |
| Mistral ၏ စုစုပေါင်းရမှတ် | 7,346 | 6,267 | 5,094 | 4,255 |
| Mistral ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.229 ့ | 0.297 ့ | 0.322 ့ | 0.419 ့ |
| တစ်စက္ကန့်လျှင် Mistral Output Tokens များ | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| Mistral ၏ စုစုပေါင်းကြာချိန် | 11.493 ့ | 12.593 ့ | 17.010 ့ | 19.092 ့ |
| Llama3 အလုံးစုံရမှတ် | 6,501 | 6,104 | 4,849 | 4,026 |
| Llama3 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.218 ့ | 0.234 ့ | 0.259 ့ | 0.348 ့ |
| တစ်စက္ကန့်လျှင် Llama3 အထွက်တိုကင်များ | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| Llama3 ၏ စုစုပေါင်းကြာချိန် | 13.554 ့ | 14.304 ့ | 19.991 ့ | 22.062 ့ |
| Llama2 အလုံးစုံရမှတ် | 8,008 | 6,591 | 5,013 | 3,957 |
| Llama2 ထုတ်ပေးသည့်အချိန် ပထမဆုံးတိုကင်သို့ | 0.307 ့ | 0.419 ့ | 0.500 ့ | 0.679 ့ |
| တစ်စက္ကန့်လျှင် Llama2 အထွက်တိုကင်များ | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s | ၈.၇၁၂ tok/s |
| Llama2 ၏ စုစုပေါင်းကြာချိန် | 20.712 ့ | 23.018 ့ | 32.448 ့ | 38.923 ့ |
UL ပရိုဆိုင်ယွန်- AI ရုပ်ပုံမျိုးဆက်
Procyon AI Image Generation Benchmark သည် ပါဝါနည်း NPU များမှ အဆင့်မြင့် GPU များအထိ မတူညီသော ဟာ့ဒ်ဝဲအမျိုးမျိုးတွင် AI inference စွမ်းဆောင်ရည်ကို တိုင်းတာရန်အတွက် တသမတ်တည်းနှင့် တိကျသောနည်းလမ်းကို ပေးပါသည်။ ၎င်းတွင် စမ်းသပ်မှုသုံးခုပါဝင်သည်- အဆင့်မြင့် GPU များအတွက် Stable Diffusion XL (FP16)၊ အလယ်အလတ်ပါဝါရှိသော GPU များအတွက် Stable Diffusion 1.5 (FP16) နှင့် ပါဝါနည်းစက်ပစ္စည်းများအတွက် Stable Diffusion 1.5 (INT8)။ benchmark သည် စနစ်တစ်ခုစီအတွက် အကောင်းဆုံး inference engine ကိုအသုံးပြုပြီး တရားမျှတပြီး နှိုင်းယှဉ်နိုင်သောရလဒ်များကို သေချာစေသည်။
Stable Diffusion 1.5 (FP16) မှစတင်၍ NVIDIA RTX PRO 6000 သည် စုစုပေါင်းရမှတ် ၈,၈၆၉ ရရှိခဲ့ပြီး RTX 5090 သည် ၈,၁၉၃၊ RTX 4090 သည် ၅,၂၆၀ နှင့် RTX 6000 Ada သည် ၄,၂၃၀ ထက် သာလွန်ကောင်းမွန်ခဲ့သည်။ PRO 6000 သည် ပုံတစ်ပုံလျှင် ပျမ်းမျှ ၀.၇၀၅ စက္ကန့်ဖြင့် ၁၁.၂၇ စက္ကန့်အတွင်း ရုပ်ပုံထုတ်လုပ်မှုကို ပြီးမြောက်ခဲ့ပြီး ဤစမ်းသပ်မှုတွင် အမြန်ဆုံးဖြစ်သည်။ ၎င်း၏ workstation-optimized tuning နှင့် 96 GB GDDR7 memory သည် စွမ်းဆောင်ရည်ကို မထိခိုက်စေဘဲ စဉ်ဆက်မပြတ်၊ မြင့်မားသောတိကျမှုရှိသော output ကို မည်သို့ရရှိစေသည်ကို ဤအရာက သရုပ်ပြသည်။
lightweight quantized inference performance ကို တိုင်းတာတဲ့ Stable Diffusion 1.5 (INT8) စမ်းသပ်မှုမှာ GPU အားလုံးက အနီးကပ် စွမ်းဆောင်ရည် ပြသနိုင်ခဲ့ပါတယ်။ PRO 6000 က 79,064 မှတ် ရရှိခဲ့ပြီး RTX 5090 ရဲ့ 79,272 မှတ်နဲ့ အတော်လေး တူညီခဲ့ပြီး RTX 4090 (62,160) နဲ့ RTX 6000 Ada (55,901) တို့ကို ဦးဆောင်နေပါတယ်။ INT8 workloads တွေက memory bandwidth နဲ့ capacity ပေါ်မှာ မှီခိုမှု နည်းတဲ့အတွက် ကွာခြားချက်တွေက အနည်းငယ်သာ ရှိပေမယ့် PRO 6000 က ပုံတစ်ပုံကို ပျမ်းမျှ generation time 0.395 စက္ကန့်နဲ့ တသမတ်တည်း ရလဒ်တွေကို ထိန်းသိမ်းထားနိုင်ခဲ့ပါတယ်။
Stable Diffusion XL (FP16) စမ်းသပ်မှုသည် မှတ်ဉာဏ်နှင့် ရေရှည် compute throughput နှစ်မျိုးလုံးကို ဖိအားပေးသည့် ပိုမိုရှည်လျားပြီး ပိုမိုတောင်းဆိုမှုများသော inference run များပါသည့် GPU များကို တွန်းအားပေးသည်။ ဤတွင် PRO 6000 သည် စုစုပေါင်းရမှတ် ၆,၉၉၁ ရရှိခဲ့ပြီး RTX 5090 ၏ ၇,၁၇၉ ထက် အနည်းငယ်နောက်ကျသော်လည်း RTX 4090 ၏ ၅၀၂၅ နှင့် RTX 6000 Ada ၏ ၃၀၄၃ ထက် များစွာသာလွန်သည်။ ၎င်းသည် စုစုပေါင်း render အချိန် ၈၅.၈ စက္ကန့် သို့မဟုတ် ပုံတစ်ပုံလျှင် ၅.၃၆ စက္ကန့်ကို ထိန်းသိမ်းထားနိုင်ပြီး PRO 6000 သည် တိုးချဲ့ထုတ်လုပ်မှု workloads များကို ထိရောက်စွာနှင့် နှေးကွေးမှုမရှိဘဲ ကိုင်တွယ်ကြောင်း ပြသသည်။
| UL Procyon: AI ပုံရိပ်ထုတ်လုပ်ခြင်း | NVIDIA RTX PRO 6000 | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX 6000 Ada |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) – အလုံးစုံရမှတ် | 8,869 | 8,193 | 5,260 | 4,230 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) – ಒಟ್ಟಾರೆအချိန် | 11.274 ့ | 12.204 ့ | 19.011 ့ | 23.639 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (FP၁၆) – ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) – အလုံးစုံရမှတ် | 79,064 | 79,272 | 62,160 | 55,901 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT၈) – ಒಟ್ಟಾರೆအချိန် | 3.162 ့ | 3.154 ့ | 4.022 ့ | 4.472 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု ၁.၅ (INT8) – ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) – အလုံးစုံရမှတ် | 6,991 | 7,179 | 5,025 | 3,043 |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) – ಒಟ್ಟಾರೆအချိန် | 85.819 ့ | 83.573 ့ | 119.379 ့ | 197.172 ့ |
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL (FP16) – ရုပ်ပုံထုတ်လုပ်သည့်အမြန်နှုန်း | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ | ၁၀၅.၂၃၇ စက္ကန့်/ပုံတစ်ပုံ |
Blender ၂.၆၅
Blender သည် open-source 3D modeling application တစ်ခုဖြစ်သည်။ ဤ benchmark ကို Blender Benchmark utility ကို အသုံးပြု၍ လုပ်ဆောင်ခဲ့သည်။ ရမှတ်ကို တစ်မိနစ်လျှင် နမူနာများဖြင့် တိုင်းတာပြီး မြင့်မားသောတန်ဖိုးများသည် ပိုမိုကောင်းမွန်သော စွမ်းဆောင်ရည်ကို ညွှန်ပြသည်။
မြင်ကွင်းသုံးခုလုံးတွင် NVIDIA RTX PRO 6000 သည် ၎င်း၏ Blackwell ဗိသုကာလက်ရာနှင့် တိုးချဲ့ထားသော မှတ်ဉာဏ်စွမ်းရည်၏ အကျိုးကျေးဇူးများကို ပြသခဲ့ပြီး ထိပ်ဆုံးနေရာတွင် ရပ်တည်ခဲ့သည်။ Monster မြင်ကွင်းတွင် PRO 6000 သည် တစ်မိနစ်လျှင် sample ၇,၈၇၀.၁၇ ရရှိခဲ့ပြီး RTX 5090 ထက် ၇,၄၂၁.၅၀ မှတ် ပိုများခဲ့ပြီး RTX 4090 နှင့် RTX 6000 Ada တို့က အသီးသီး ၅,၇၃၃.၉၇ နှင့် ၅,၆၃၂.၆၀ မှတ်ဖြင့် ဒုတိယနေရာတွင် ရပ်တည်ခဲ့သည်။
Junkshop မြင်ကွင်းမှာ PRO 6000 ဟာ တစ်မိနစ်ကို sample ၄,၁၅၈.၉၁ နဲ့ ဆက်လက်ဦးဆောင်နေပြီး RTX 5090 အတွက် ၃,၉၈၀.၁၅၊ RTX 4090 အတွက် ၂,၈၂၇.၈၃ နဲ့ RTX 6000 Ada အတွက် ၂,၆၆၃.၇၇ ရရှိထားပါတယ်။ နောက်ဆုံးအနေနဲ့ shading နဲ့ memory efficiency နှစ်မျိုးလုံးကို အလေးပေးလေ့ရှိတဲ့ Classroom မြင်ကွင်းမှာတော့ PRO 6000 ဟာ တစ်မိနစ်ကို sample ၄,၀၄၁.၁၁ ရရှိခဲ့ပြီး RTX 5090 ရဲ့ ၃,၇၃၂.၆၃ ထက် တစ်ဖန်ပိုမိုသာလွန်နေပြီး RTX 4090 နဲ့ RTX 6000 Ada တွေထက် သိသိသာသာ သာလွန်ကောင်းမွန်ပါတယ်။
| Blender 4.4 (မြင့်လေ ပိုကောင်းလေ) | NVIDIA RTX PRO 6000 | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX 6000 Ada |
| ဧရာမသတ္တဝါကြီး | 7,870.17 | 7,421.50 | 5,733.97 | 5,632.60 |
| အမှိုက်ဆိုင် | 4,158.91 | 3,980.15 | 2,827.83 | 2,663.77 |
| စာသင်ခန်း | 4,041.11 | 3,732.63 | 2,909.35 | 2,818.83 |
လပ်စ်မာ့ခ်
Luxmark သည် open-source ray-tracing renderer ဖြစ်သော LuxRender ကို အသုံးပြု၍ အလွန်အသေးစိတ်ကျသော 3D မြင်ကွင်းများကို ကိုင်တွယ်ရာတွင် စနစ်၏စွမ်းဆောင်ရည်ကို အကဲဖြတ်သည့် GPU benchmark တစ်ခုဖြစ်သည်။ ဤ benchmark သည် ဆာဗာများနှင့် workstation များ၏ graphical rendering စွမ်းရည်များကို အကဲဖြတ်ရန်အတွက် အထူးသဖြင့် visual effect များနှင့် architectural visualization application များတွင် တိကျသောအလင်း simulation သည် အရေးကြီးပါသည်။
Food scene စမ်းသပ်မှုတွင် NVIDIA RTX PRO 6000 သည် ရမှတ် ၂၄,၂၈၇ ဖြင့် ဦးဆောင်နေပြီး RTX 5090 ထက် ၂၃,၁၄၁ ဖြင့် သာလွန်နေပြီး RTX 4090 နှင့် RTX 6000 Ada တို့က အသီးသီး ၁၇,၁၇၁ နှင့် ၁၄,၈၇၃ ဖြင့် ဒုတိယနေရာတွင် ရှိနေသည်။ ဤသည်မှာ PRO 6000 သည် အသေးစိတ် geometry နှင့် lighting workloads များတွင် တည်ငြိမ်မှုဆုံးရှုံးမှု သို့မဟုတ် thermal throttling မရှိဘဲ ချောမွေ့သော ray tracing စွမ်းဆောင်ရည်ကို မည်သို့ထိန်းသိမ်းထားသည်ကို ပြသနေသည်။
ကြီးမားသော geometry နှင့် ရှုပ်ထွေးသော ကမ္ဘာလုံးဆိုင်ရာ အလင်းရောင်ကို အလေးပေးသည့် ပိုမိုတောင်းဆိုမှုများသော Hall မြင်ကွင်းတွင် PRO 6000 သည် 52,588 ဖြင့် ထိပ်ဆုံးရလဒ်ကို ထပ်မံရရှိခဲ့ပြီး RTX 5090 ၏ 51,725 ထက် အနည်းငယ်သာလွန်ကာ RTX 4090 (38,887) နှင့် RTX 6000 Ada (32,132) တို့ထက် များစွာသာလွန်ခဲ့သည်။
| Luxmark (မြင့်လေ ပိုကောင်းလေ) | NVIDIA RTX PRO 6000 | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX 6000 Ada |
| အစားအသောက်ရမှတ် | 24,287 | 23,141 | 17,171 | 14,873 |
| ခန်းမရမှတ် | 52,588 | 51,725 | 38,887 | 32,132 |
Geekbench 6
Geekbench 6 သည် အလုံးစုံစနစ်စွမ်းဆောင်ရည်ကို တိုင်းတာသည့် cross-platform benchmark တစ်ခုဖြစ်သည်။ Geekbench Browser သည် မည်သည့်စနစ်နှင့်မဆို နှိုင်းယှဉ်နိုင်စေပါသည်။
ဤစမ်းသပ်မှုတွင် NVIDIA RTX PRO 6000 သည် GPU OpenCL ရမှတ် 384,158 ရရှိခဲ့ပြီး RTX 5090 (374,807)၊ RTX 4090 (333,384) နှင့် RTX 6000 Ada (336,882) တို့ကို ကျော်လွန်ခဲ့သည်။ PRO 6000 ၏ မြင့်မားသောရမှတ်သည် ၎င်း၏ အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ထားသော workstation ဒီဇိုင်း၊ မြှင့်တင်ထားသော memory bandwidth နှင့် professional driver stack ကို ထင်ဟပ်စေပြီး ၎င်းတို့အားလုံးသည် compute-heavy workloads အမျိုးမျိုးတွင် တသမတ်တည်းစွမ်းဆောင်ရည်ကို ဖြစ်စေသည်။
| Geekbench (မြင့်လေ ပိုကောင်းလေ) | NVIDIA RTX PRO 6000 | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX 6000 Ada |
| GPU OpenCL ရမှတ် | 384,158 | 374,807 | 333,384 | 336,882 |
V Ray
V -Ray Benchmark သည် အဆင့်မြင့် V-Ray 6 အင်ဂျင်များကို အသုံးပြု၍ CPU များ၊ NVIDIA GPU များ သို့မဟုတ် နှစ်မျိုးလုံး၏ rendering စွမ်းဆောင်ရည်ကို တိုင်းတာသည်။ ၎င်းသည် အသုံးပြုသူများ ၎င်းတို့၏စနစ်များ၏ rendering စွမ်းရည်များကို အကဲဖြတ်ရန်နှင့် နှိုင်းယှဉ်နိုင်စေရန်အတွက် မြန်ဆန်သော စမ်းသပ်မှုများနှင့် ရိုးရှင်းသော အမှတ်ပေးစနစ်ကို အသုံးပြုသည်။ ၎င်းသည် ထိရောက်သော စွမ်းဆောင်ရည်ဆိုင်ရာ ထိုးထွင်းသိမြင်မှုများကို ရှာဖွေနေသော ပရော်ဖက်ရှင်နယ်များအတွက် မရှိမဖြစ်ကိရိယာတစ်ခုဖြစ်သည်။
ကျွန်ုပ်တို့၏ စမ်းသပ်မှုတွင် NVIDIA RTX PRO 6000 သည် vpaths 12,128 ရရှိခဲ့ပြီး 14,764 မှတ်ဖြင့် ဦးဆောင်နေသော RTX 5090 နှင့် 10,847 မှတ်ဖြင့် ဦးဆောင်နေသော RTX 4090 တို့ကြားတွင် ရပ်တည်ခဲ့သည်။ RTX 6000 Ada သည် 10,766 မှတ်ဖြင့် အနည်းငယ် နောက်ကျကျန်နေခဲ့သည်။ RTX 5090 သည် ဤ GPU-intensive rendering စမ်းသပ်မှုတွင် အနည်းငယ် ဦးဆောင်နေသော်လည်း PRO 6000 သည် ၎င်း၏ workstation-oriented tuning ကို အားဖြည့်ပေးပြီး rendering loads အပြည့်အောက်တွင် ထိရောက်မှုကို ထိန်းသိမ်းပေးသည့် ခိုင်မာပြီး တသမတ်တည်းရှိသော စွမ်းဆောင်ရည်ကို ပြသခဲ့သည်။
| V-Ray (မြင့်လေ ပိုကောင်းလေ) | NVIDIA RTX PRO 6000 | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX 6000 Ada |
| vpath များ | 12,128 | 14,764 | 10,847 | 10,766 |
LM Studio မော်ဒယ်မျိုးစုံ ကောက်ချက်ချခြင်း စမ်းသပ်ချက်
ဤစမ်းသပ်မှုအတွက်၊ GPT-OSS 120B၊ Gemma 3 (4B၊ 12B နှင့် 27B)၊ Llama 3.1 (8B နှင့် 70B) နှင့် Llama 3.3 70B အပါအဝင် လူကြိုက်များသော ဘာသာစကားကြီး မော်ဒယ်အမျိုးမျိုးတွင် NVIDIA RTX PRO 6000 ၏ စွမ်းဆောင်ရည်ကို အကဲဖြတ်ရန် LM Studio ကို အသုံးပြုခဲ့ပါသည်။ မော်ဒယ်တစ်ခုစီကို တူညီသော ညွှန်ကြားချက်ဖြင့် မေးမြန်းခဲ့ပါသည်။
"ပျင်းရိသူများ၏သမိုင်းနှင့်ပတ်သက်သည့် စကားလုံး ၅၀၀ ပါ ပညာရပ်ဆိုင်ရာစာတမ်းတစ်စောင်ရေးပါ။"
ဤစမ်းသပ်မှုတွင် အဓိကအာရုံစိုက်မှုမှာ တစ်စက္ကန့်လျှင် တိုကင်များ (throughput) နှင့် စုစုပေါင်းအချိန် (ပြီးစီးချိန်) တို့ဖြစ်ပြီး၊ ၎င်းတို့သည် RTX PRO 6000 သည် တူညီသော ထုတ်လုပ်မှုအခြေအနေများအောက်တွင် မတူညီသော မော်ဒယ်အရွယ်အစားနှင့် ရှုပ်ထွေးမှုများကို မည်မျှထိရောက်စွာ ကိုင်တွယ်ဖြေရှင်းသည်ကို အတူတကွ မီးမောင်းထိုးပြသည်။
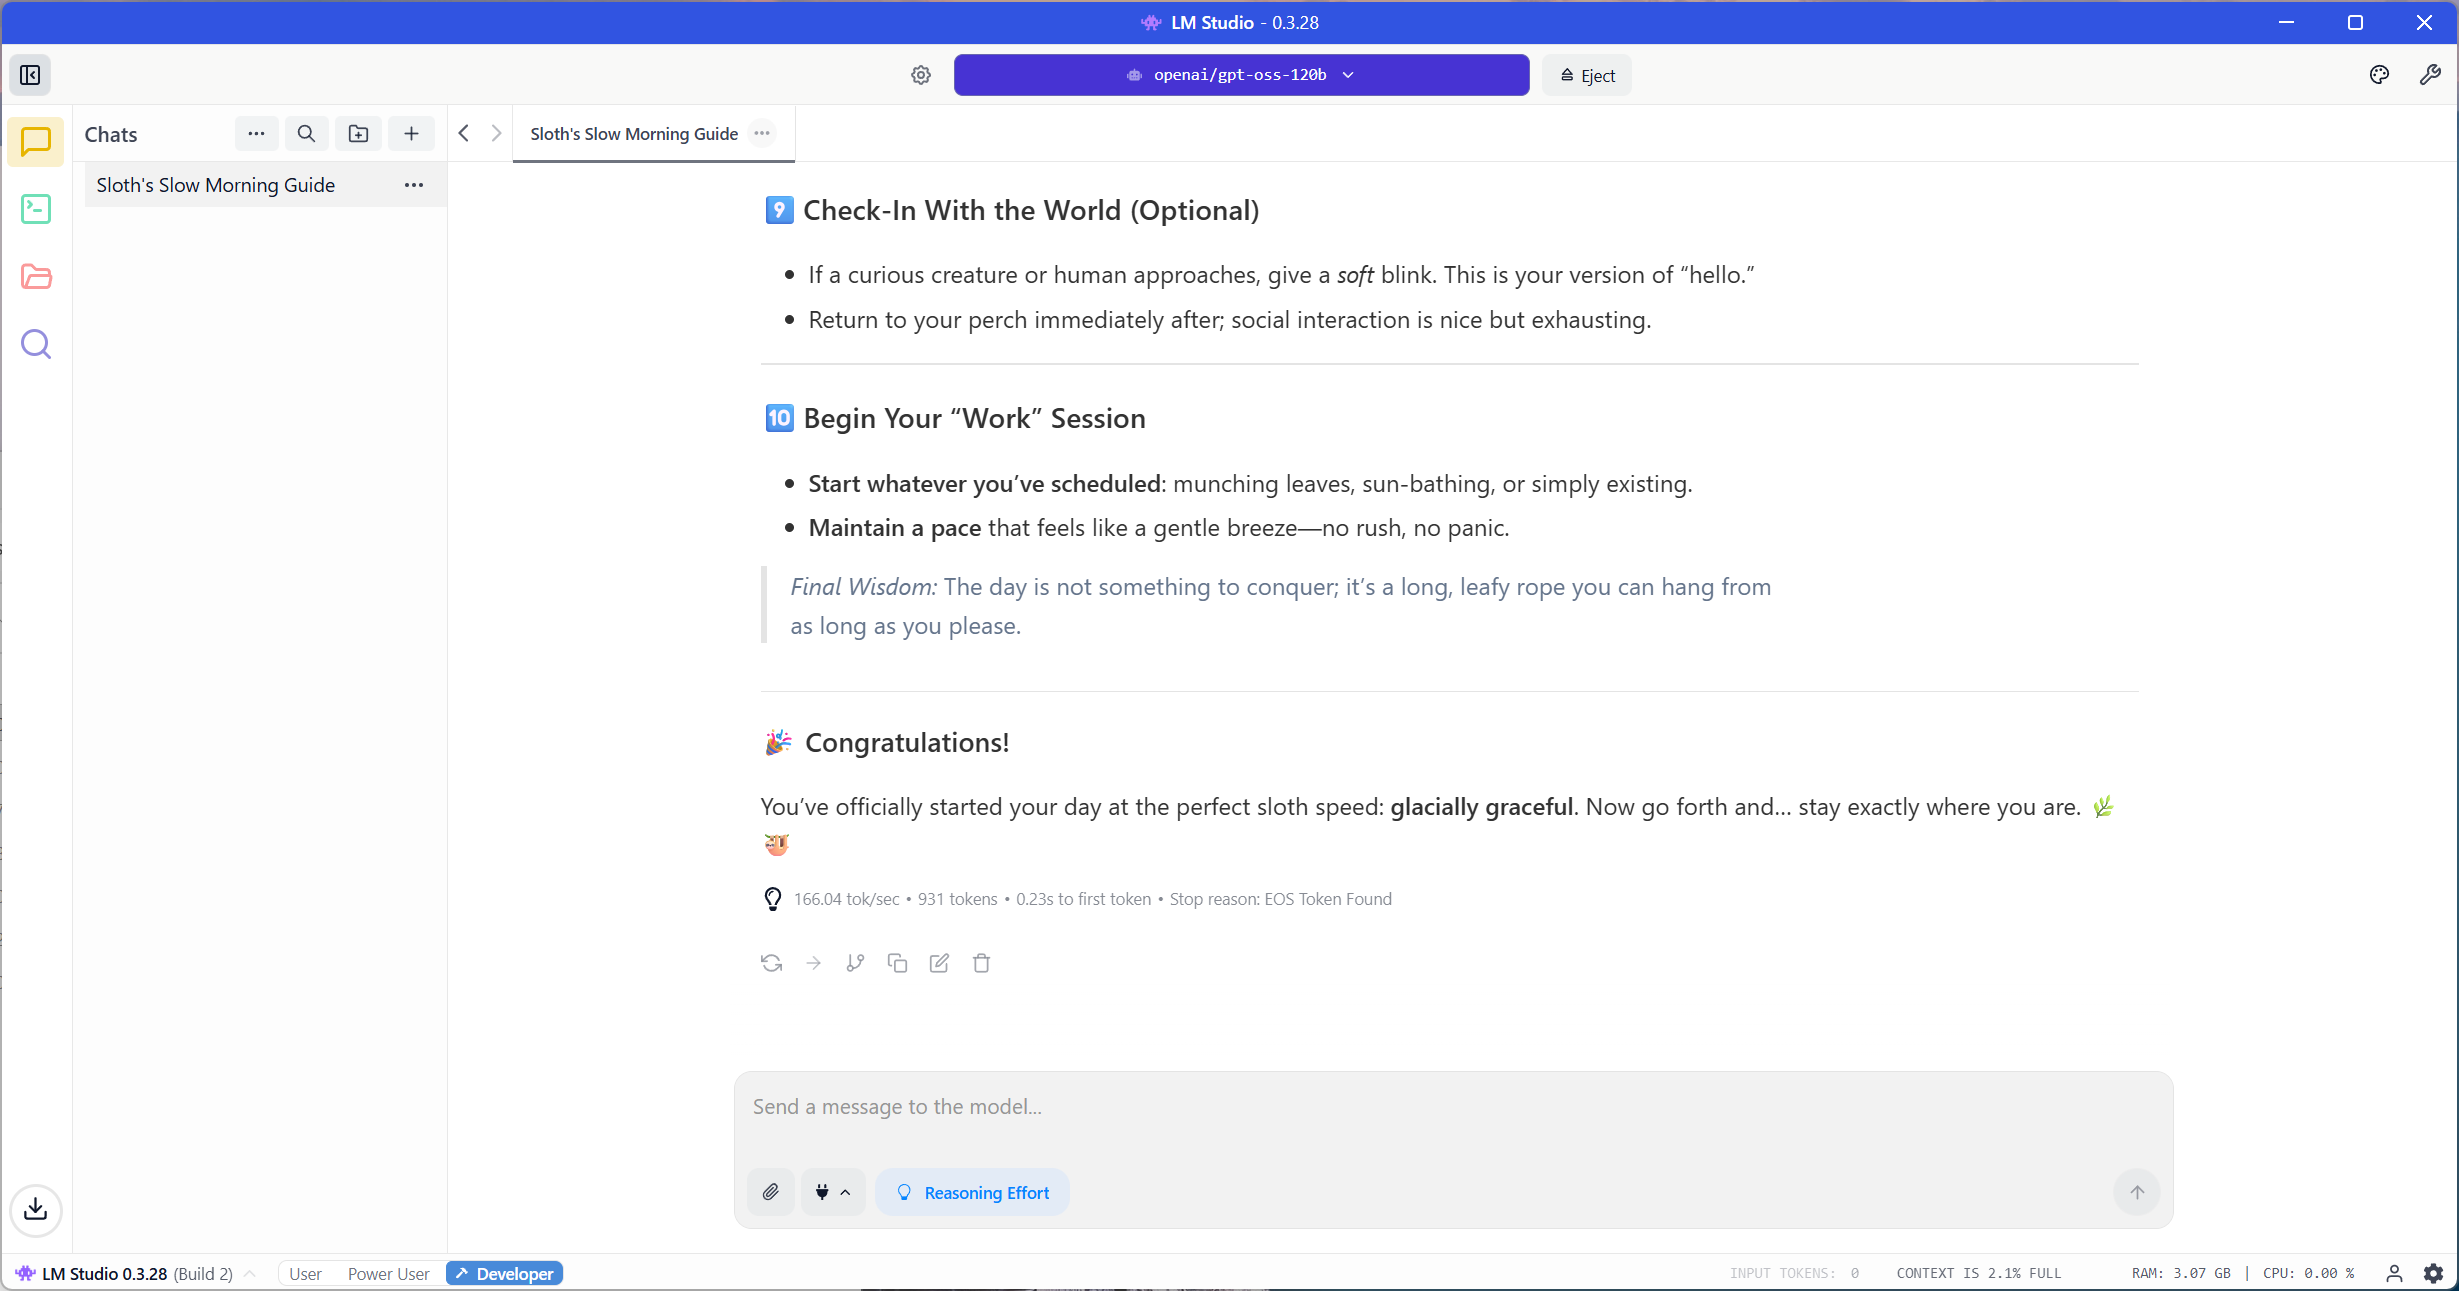
LM Studio inference စမ်းသပ်မှုများတွင် NVIDIA RTX PRO 6000 သည် သေးငယ်သော 4B-parameter မော်ဒယ်များမှသည် ကြီးမားသော 120B-class configuration များအထိ မော်ဒယ်အရွယ်အစားအမျိုးမျိုးတွင် အလွန်ကောင်းမွန်သော စွမ်းဆောင်ရည်နှင့် scalability ကို သရုပ်ပြခဲ့သည်။
ဤစမ်းသပ်မှု၏ အထူးခြားဆုံးအချက်မှာ OpenAI GPT-OSS 120B ဖြစ်ပြီး RTX PRO 6000 သည် တစ်စက္ကန့်လျှင် တိုကင် ၁၆၃.၁ ခု ထုတ်လုပ်ပြီး စကားလုံး ၅၀၀ ထုတ်ပေးမှုကို ၉.၅၄ စက္ကန့်အတွင်း အပြီးသတ်နိုင်ခဲ့သည်။ RTX 5090 ကဲ့သို့သော ကတ်များသည် 120B မော်ဒယ်ကို တင်၍မရ သို့မဟုတ် လုပ်ဆောင်၍မရသည့်အပြင် VRAM အကန့်အသတ်ရှိသောကြောင့် 70B မော်ဒယ်များကိုပင် မကြာခဏ မကိုင်တွယ်နိုင်သောကြောင့် ဤရလဒ်သည် ထင်ရှားပါသည်။ PRO 6000 ၏ 96 GB GDDR7 မှတ်ဉာဏ်သည် ဤကြီးမားသော မော်ဒယ်များကို ဒေသတွင်းတွင် လုပ်ဆောင်နိုင်စေပြီး workstation GPU များကြားတွင် ထူးခြားစွာ လုပ်ဆောင်နိုင်သည်။
မော်ဒယ်ငယ်များအတွက် Gemma 3.4 B သည် အမြင့်ဆုံး throughput ကို ရရှိခဲ့ပြီး တစ်စက္ကန့်လျှင် တိုကင် ၂၂၆.၇ ခုဖြင့် အလုပ်ကို ၃.၅၁ စက္ကန့်အတွင်း ပြီးမြောက်ခဲ့သည်။ Llama 3.1 8B Instruction သည် တစ်စက္ကန့်လျှင် တိုကင် ၁၉၇.၁ ခုနှင့် စုစုပေါင်းအချိန် ၄.၁၇ စက္ကန့်ဖြင့် အနီးကပ်လိုက်လာခဲ့သည်။ ဤလုပ်ဆောင်ချက်များသည် PRO 6000 ၏ အလယ်အလတ်အဆင့် inference workloads များတွင် ထိရောက်မှုနှင့် လျင်မြန်စွာ တုံ့ပြန်မှုကို ပြသနေသည်။
ပိုမိုမြင့်မားသောအဆင့်တွင်၊ Llama 3.1 70B Instruct နှင့် Llama 3.3 70B မော်ဒယ်များသည် တစ်စက္ကန့်လျှင် ပျမ်းမျှ ၃၁.၈ တိုကင်ခန့်ရှိပြီး စုစုပေါင်းထုတ်လုပ်မှုအချိန် ၂၇.၂ စက္ကန့်နှင့် ၂၅.၃ စက္ကန့်ရှိပြီး ၎င်းတို့၏ အရွယ်အစားကြီးမားသော်လည်း တသမတ်တည်းရှိသော အထွက်ကို ပြသနေသည်။
အလုံးစုံသော် RTX PRO 6000 သည် ကြီးမားသော မော်ဒယ်များကို လည်ပတ်သည့်အခါ ထူးချွန်သော တည်ငြိမ်မှု၊ throughput နှင့် စွမ်းရည်ကို ပေးစွမ်းသည်။ ၎င်း၏ 96 GB မှတ်ဉာဏ်စွမ်းရည်သည် စားသုံးသူ GPU များ၏ ကန့်သတ်ချက်များထက် ကျော်လွန်သော workloads များကို ကိုင်တွယ်နိုင်စေပြီး အဆင့်မြင့် AI နှင့် generative မော်ဒယ်ဖွံ့ဖြိုးတိုးတက်မှုအတွက် ယုံကြည်စိတ်ချရသော ဒေသတွင်းစွမ်းဆောင်ရည် လိုအပ်သော developer များ၊ သုတေသီများနှင့် ပရော်ဖက်ရှင်နယ်များအတွက် အကောင်းဆုံးရွေးချယ်မှုတစ်ခု ဖြစ်စေသည်။
| LM Studio (မော်ဒယ် ကောက်ချက်ချမှု ရလဒ်များ) | |||||||||
|---|---|---|---|---|---|---|---|---|---|
| မော်ဒယ်အမည် | တိုကင်များ / စက္ကန့် | ပထမဆုံး တိုကင်(များ) ရရှိရန် အချိန် | စုစုပေါင်းအချိန် (များ) | လှုံ့ဆော်မှုတိုကင်များ | ခန့်မှန်းထားသော တိုကင်များ | စုစုပေါင်းတိုကင်များ | |||
| OpenAI GPT-OSS 120B | 163.15 | 0.193 | 9.543 | 81 | 1,557 | 1,638 | |||
| Gemma 3 4B | 226.73 | 0.113 | 3.51 | 25 | 796 | 821 | |||
| Gemma 3 12B | 117.15 | 0.068 | 8.06 | 25 | 944 | 969 | |||
| Gemma 3 27B | 68.06 | 0.221 | 12.048 | 25 | 820 | 845 | |||
| မက်တာ လာမာ ၃.၁ ၇၀ဘီ ညွှန်ကြားချက် | 197.07 | 0.062 | 4.171 | 49 | 822 | 871 | |||
| မက်တာ လာမာ ၃.၁ ၇၀ဘီ ညွှန်ကြားချက် | 31.84 | 0.159 | 27.227 | 49 | 867 | 916 | |||
| မက်တာ လာမာ ၃.၃ ၇၀ဘီ | 31.74 | 0.323 | 25.329 | 49 | 804 | 853 | |||
NVIDIA RTX PRO 6000 ပါဝါသုံးစွဲမှု
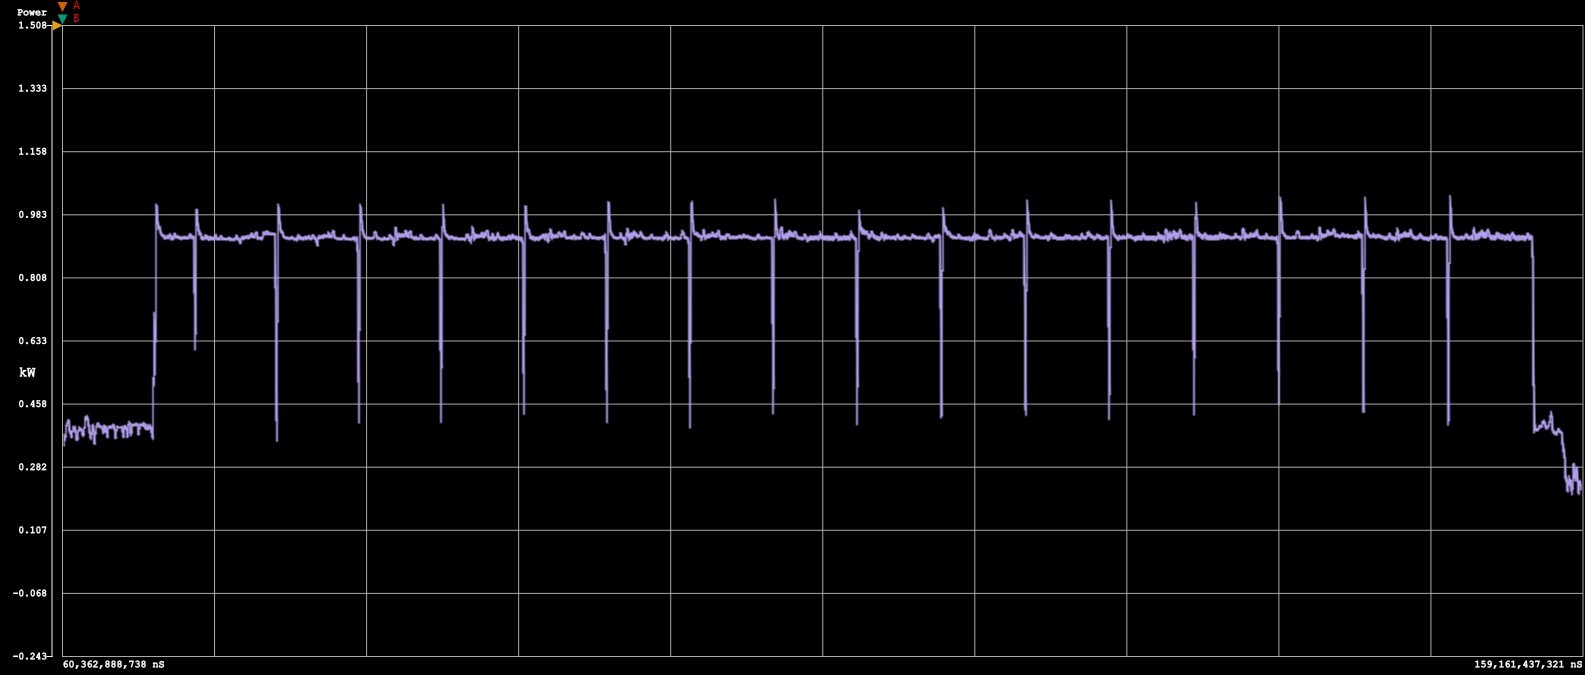
AI workloads များ၏ လက်တွေ့ကမ္ဘာထိရောက်မှုကို အကဲဖြတ်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် UL Procyon AI Image Generation benchmark၊ အထူးသဖြင့် Stable Diffusion XL FP16 စမ်းသပ်မှုကို အသုံးပြုခဲ့ပါသည်။ ဤစမ်းသပ်မှုသည် ဒုတိယနှင့် နောက်ဆုံးထုတ်ပေးသော ရုပ်ပုံများကြား အချိန်ကာလကို အာရုံစိုက်ပြီး အချိန်ကာလပြီးမြောက်ရန် အချိန်၊ အမြင့်ဆုံးနှင့် ရေရှည်ပါဝါဆွဲအားနှင့် ပြီးစီးပြီးနောက် စနစ်အားလပ်ချိန်ကို ဖမ်းယူပါသည်။
ကျွန်ုပ်တို့၏ စမ်းသပ်မှုအတွင်း RTX PRO 6000 သည် စဉ်ဆက်မပြတ် ဝန်အားအောက်တွင် ပျမ်းမျှစနစ်အား 918.5 W ဖြင့် ထိန်းသိမ်းထားနိုင်ခဲ့ပြီး အမြင့်ဆုံး 1,036.3 W တွင် ရောက်ရှိခဲ့ပြီး အလုပ်ပြီးသည်နှင့် အလုပ်မလုပ်သော ပါဝါသည် 152.3 W တွင် ရပ်တန့်သွားခဲ့သည်။ စမ်းသပ်မှု အပြည့်အဝကြားကာလသည် 5.3 စက္ကန့်ကြာမြင့်ခဲ့ပြီး စုစုပေါင်း စွမ်းအင် 1.35 Wh သုံးစွဲခဲ့သည်။ ဤရလဒ်များသည် workstation-class GPU အတွက် အလွန်ကောင်းမွန်သော ပါဝါမှ စွမ်းဆောင်ရည်ထိရောက်မှုကို ပြသနေပြီး၊ ရှည်လျားသော inference workloads များအတွင်း မြင့်မားသော output ကို ထိန်းသိမ်းထားစဉ် ဆွဲအားကို ကောင်းစွာထိန်းချုပ်ထားနိုင်ခဲ့သည်။
အခြား GPU များနှင့် နှိုင်းယှဉ်ပါက RTX PRO 6000 သည် စုစုပေါင်းစွမ်းအင်သုံးစွဲမှုတွင် RTX 4090 နှင့် အနီးစပ်ဆုံးတူညီပြီး ပြီးစီးချိန်ကို ပိုမိုမြန်ဆန်စွာထိန်းသိမ်းထားကာ ပါဝါထိရောက်မှုနှင့် အမြန်နှုန်းနှစ်မျိုးလုံးတွင် RTX 6000 Ada ထက် သိသိသာသာသာလွန်ကောင်းမွန်ပါသည်။ စိတ်ဝင်စားစရာကောင်းသည်မှာ GB202 ချစ်ပ်ကို မျှဝေအသုံးပြုသည့် Blackwell ကတ်အသစ်များသည် ဤအလုပ်ပမာဏအောက်တွင် အလွန်ဆင်တူသော စွမ်းဆောင်ရည်လက္ခဏာများကို ပြသထားပြီး PRO 6000 ၏ TDP မြင့်မားမှုကြောင့် စုစုပေါင်းစွမ်းအင်သုံးစွဲမှုတွင် အနည်းငယ်သာကွာခြားနိုင်ဖွယ်ရှိသည်။ ၎င်းသည် NVIDIA ၏ နောက်ဆုံးမျိုးဆက်သည် ဝပ်တစ်ခုလျှင် စွမ်းဆောင်ရည်ကို သိသိသာသာပြောင်းလဲခြင်းထက် ဆက်လက်တိုးတက်ကောင်းမွန်အောင် လုပ်ဆောင်နေကြောင်း ညွှန်ပြနေသည်။
| တည်ငြိမ်သော ပျံ့နှံ့မှု XL FP16 ရုပ်ပုံပါဝါကို အသုံးပြုထားသည် (နည်းလေ ပိုကောင်းလေ) | NVIDIA RTX PRO 6000 | NVIDIA RTX5090 | NVIDIA RTX4090 | NVIDIA RTX 6000 Ada |
| ပါဝါသုံးစွဲမှု | 1.35Wh | 1.16Wh | 1.35Wh | 1.76Wh |
| စမ်းသပ်ကာလ | 5.3 | 5.1 | 7.3 | 12.6 |
ကောက်ချက်
NVIDIA RTX PRO 6000 သည် ပရော်ဖက်ရှင်နယ် workflow များအတွက် ရရှိနိုင်သော စွမ်းဆောင်ရည်အမြင့်ဆုံး workstation GPU ဖြစ်ပြီး စားပွဲဘေးပုံစံဖြင့် data center အဆင့် စွမ်းဆောင်ရည်ကို ပေးဆောင်ပါသည်။ စမ်းသပ်ချိန်တွင် လက်လီဈေးနှုန်း ဒေါ်လာ ၈၅၀၀ ခန့်ဖြင့် ထုတ်လုပ်မှုလုပ်ငန်းအတွက် ယုံကြည်စိတ်ချရမှု၊ မြင့်မားသော compute density နှင့် ကြီးမားသော ECC memory pool လိုအပ်သော အဖွဲ့များကို ပစ်မှတ်ထားသည်။ CUDA cores ၂၄၀၆၄ ခု၊ Tensor Cores ၇၅၂ ခု၊ GDDR7 ECC ၉၆ GB နှင့် Blackwell ဗိသုကာဖြင့် GeForce RTX 5090 သို့မဟုတ် 4090 ကဲ့သို့သော consumer ကတ်များ၏ လက်တွေ့ကန့်သတ်ချက်များထက် ကျော်လွန်သော workloads များကို ကိုင်တွယ်သည်။ တစ်ဦးချင်း benchmarks များအရ consumer ကတ်သည် raw speed တွင် အသာစီးရနေကြောင်း ပြသနိုင်သော်လည်း capacity၊ stability၊ drivers နှင့် ISV support တို့တွင် အလုံးစုံယူလျှင် RTX PRO 6000 သည် ပရော်ဖက်ရှင်နယ်အသုံးပြုမှုအတွက် ပိုမိုသင့်လျော်ပါသည်။
AI နှင့် ML အတွက် 96 GB pool သည် အဓိကအချက်ဖြစ်သည်။ ၎င်းသည် ရှည်လျားသော context inference နှင့် ဒေသတွင်းတွင် အလွန်ကြီးမားသော checkpoints များကို ခွင့်ပြုပေးပြီး၊ ကျွန်ုပ်တို့သည် တစ်စက္ကန့်လျှင် ခိုင်မာသော tokens များကို ထိန်းသိမ်းထားစဉ် 70B မှ 120B class models များကို run ခြင်းဖြင့် သရုပ်ပြခဲ့သည်။ Rendering နှင့် simulation များသည် ပိုမိုကြီးမားသော L2 cache နှင့် memory bandwidth မှ အကျိုးကျေးဇူးရရှိပြီး Blender၊ V-Ray နှင့် LuxMark တို့တွင် တိုးချဲ့ထားသော loads များအောက်တွင် ခန့်မှန်းနိုင်သော၊ ရေရှည်တည်တံ့သော စွမ်းဆောင်ရည်ကို ပေးဆောင်သည်။
ဒီကတ်ဟာ တကယ့် workstation တွေနဲ့ ကိုက်ညီပါတယ်။ PCIe 5.0 x16 interface၊ DisplayPort 2.1b output လေးခုနဲ့ single 16-pin power input ပါဝင်တဲ့ dual-slot ဒီဇိုင်း ပါရှိပါတယ်။ 600W board power ကို ပံ့ပိုးပေးဖို့အတွက် အရည်အသွေးမြင့် PSU နဲ့ chassis airflow ကို စီစဉ်ပါ။ Multi-GPU ကလည်း ရိုးရှင်းပြီး OEM နဲ့ ISV တွေက AI၊ rendering နဲ့ compute stack တွေမှာ GPU ၂ ခုကနေ ၈ ခုအထိ ပံ့ပိုးပေးပါတယ်။
သင့်အလုပ်မှာ ရှည်လျားတဲ့ context LLM တွေ၊ အလွန်ကြီးမားတဲ့ မြင်ကွင်းတွေ ဒါမှမဟုတ် single node ပေါ်မှာ မြင့်မားတဲ့ တိကျမှုရှိတဲ့ simulation တွေ ပါဝင်နေရင် RTX PRO 6000 က တခြားကတ်တွေနဲ့ မယှဉ်နိုင်တဲ့ စွမ်းရည်နဲ့ တသမတ်တည်းရှိမှုတို့နဲ့ သူ့ရဲ့ ပရီမီယံကို ထိုက်တန်စေပါတယ်။
Nvidia RTX PRO 6000 ထုတ်ကုန်စာမျက်နှာ
ဦးဆောင်သူစာရင်း- RTX PRO 6000 Blackwell Server Edition သည် ကျွန်ုပ်တို့၏ အကောင်းဆုံး Enterprise GPU များ ဦးဆောင်သူစာရင်းတွင် အကောင်းဆုံး Enterprise Inference GPU ကို ရရှိထားပြီး ဤကတ်မှ Workstation Edition အချက်အလက်သည် ဆာဗာအပိုင်းအတွက် ရပ်တည်လျက်ရှိသည်။


 အမေဇုံ