

Checkpointing သည် AI မော်ဒယ်လေ့ကျင့်မှုအတွက် အလွန်အရေးကြီးပြီး ခံနိုင်ရည်ရှိမှု၊ ထိရောက်မှုနှင့် သိမ်းဆည်းထားသောအခြေအနေများမှ လေ့ကျင့်မှုကို ပြန်လည်စတင်ခြင်း သို့မဟုတ် အသေးစိတ်ချိန်ညှိနိုင်စွမ်းတို့ကို သေချာစေသည်။ သို့သော်၊ ပိုမိုရှုပ်ထွေးလာသော မော်ဒယ်များနှင့် ကျယ်ပြန့်သော လေ့ကျင့်ရေးဒေတာစုများပါရှိသော ခေတ်မီ AI workloads များ၏ လိုအပ်ချက်များသည် သိုလှောင်မှုကို ၎င်း၏အကန့်အသတ်အထိ တွန်းပို့ပါသည်။
AI Workflow များတွင် Checkpoint များ၏ အခန်းကဏ္ဍ
AI လေ့ကျင့်ရေးတွင် Checkpointing သည် လေ့ကျင့်နေစဉ်အတွင်း မော်ဒယ်၏ အခြေအနေကို အခါအားလျော်စွာ သိမ်းဆည်းခြင်းပါဝင်သည့် အရေးကြီးသော လုပ်ငန်းစဉ်တစ်ခုဖြစ်သည်။ ဤအခြေအနေတွင် မော်ဒယ်အလေးချိန်များနှင့် ကန့်သတ်ချက်များ၊ optimizer အခြေအနေများ၊ သင်ယူမှုနှုန်းအချိန်ဇယားများနှင့် လေ့ကျင့်ရေး metadata များ ပါဝင်သည်။ Checkpointing သည် သတ်မှတ်ထားသော အချိန်အပိုင်းအခြားများတွင် လေ့ကျင့်ရေးလုပ်ငန်းစဉ်၏ ပြည့်စုံသော snapshot ကို ဖန်တီးပေးပြီး အနှောင့်အယှက်များဖြစ်ပေါ်ပါက လေ့ကျင့်ရေးဆက်လက်လုပ်ဆောင်နိုင်မှုနှင့် ပြန်လည်ကောင်းမွန်လာမှုကို ပေးစွမ်းသည်။
စစ်ဆေးရေးအမှတ်များကို ပုံမှန်အားဖြင့် ထပ်ခါတလဲလဲလုပ်ဆောင်သည့် ကြားကာလများ (ဥပမာ၊ လေ့ကျင့်ရေးအဆင့်တစ်ထောင်တိုင်း) တွင် လုပ်ဆောင်လေ့ရှိသည်။ ခေတ်သစ် LLM လေ့ကျင့်မှုသည် ရက်သတ္တပတ်များ သို့မဟုတ် လပေါင်းများစွာ ကြာမြင့်နိုင်ပြီး ကြီးမားသော တွက်ချက်မှုအရင်းအမြစ်များကို သုံးစွဲနိုင်ပြီး ဖြစ်နိုင်ချေရှိသော ကျရှုံးမှုများကို ကာကွယ်ရန် ဤစစ်ဆေးရေးအမှတ်များကို များစွာအားကိုးအားထားပြုပါသည်။ ဥပမာအားဖြင့်၊ GPT-4 အတန်းအစားကဲ့သို့သော မော်ဒယ်တစ်ခုကို လေ့ကျင့်ခြင်းသည် မော်ဒယ်အရွယ်အစားနှင့် လေ့ကျင့်ရေးဖွဲ့စည်းပုံပေါ် မူတည်၍ ဂစ်ဂါဘိုက်ရာပေါင်းများစွာမှ တယ်ရာဘိုက်များစွာအထိ စစ်ဆေးရေးအမှတ်များကို ထုတ်ပေးနိုင်သည်။
DALL-E မှ ထုတ်လုပ်ထားသော လေ့ကျင့်ရေးလုပ်ငန်းစဉ်
checkpointing ရဲ့ အဓိကရည်ရွယ်ချက်ဟာ backup လုပ်ဆောင်ချက်ထက် ကျော်လွန်ပါတယ်။ ဒါဟာ လေ့ကျင့်ရေးခံနိုင်ရည်ရှိမှုအတွက် အရေးကြီးတဲ့ယန္တရားတစ်ခုအဖြစ် ဆောင်ရွက်ပေးပြီး စနစ်ချို့ယွင်းမှုတွေ၊ ပါဝါပြတ်တောက်မှုတွေ ဒါမှမဟုတ် hardware ပြဿနာတွေဖြစ်လာရင် အစကနေပြန်စမယ့်အစား နောက်ဆုံးသိမ်းဆည်းထားတဲ့အခြေအနေကနေ လေ့ကျင့်မှုကို ပြန်လည်စတင်နိုင်အောင် လုပ်ဆောင်ပေးပါတယ်။ ထို့အပြင် checkpoints တွေဟာ မော်ဒယ်ခွဲခြမ်းစိတ်ဖြာမှုအတွက် အလွန်တန်ဖိုးရှိပြီး သုတေသီတွေအနေနဲ့ လေ့ကျင့်ရေးအဆင့်အမျိုးမျိုးမှာ မော်ဒယ်ရဲ့ဆင့်ကဲဖြစ်စဉ်ကို စစ်ဆေးနိုင်ပြီး စွမ်းဆောင်ရည်ကျဆင်းမှုကို တွေ့ရှိပါက ယခင်အခြေအနေများသို့ ပြန်သွားနိုင်ပါတယ်။
စစ်ဆေးရေးလုပ်ငန်းစဉ်အတွင်း ရေးသားမှုပုံစံများသည် သိုလှောင်မှုရှုထောင့်မှ အထူးစိတ်ဝင်စားဖွယ်ကောင်းပါသည်။ စစ်ဆေးရေးဂိတ်တစ်ခုကို စတင်လိုက်သောအခါ စနစ်သည် ဒေတာအမြောက်အမြားကို ဆက်တိုက်ပုံစံဖြင့် ရေးသားရမည်။ ၎င်းသည် လေ့ကျင့်မှုတွက်ချက်မှုများအတွင်း သိုလှောင်မှုလုပ်ဆောင်ချက် နည်းပါးသောကာလများဖြင့် သွင်ပြင်လက္ခဏာရှိသော ထူးခြားသည့် I/O ပရိုဖိုင်တစ်ခုကို ဖန်တီးပေးပြီး စစ်ဆေးရေးဂိတ်အတွင်း ပြင်းထန်သော၊ မြင့်မားသော bandwidth ရေးသားမှုလုပ်ဆောင်ချက်များဖြင့် လိုက်လံဆောင်ရွက်သည်။ ဤရေးသားမှုလုပ်ဆောင်ချက်များသည် ပုံမှန်အားဖြင့် အစဉ်လိုက်ဖြစ်ပြီး မြင့်မားသော bandwidth အစဉ်လိုက်ရေးသားမှုများအတွက် အကောင်းဆုံးဖြစ်အောင်ပြုလုပ်ထားသော သိုလှောင်မှုစနစ်များမှ သိသိသာသာ အကျိုးကျေးဇူးရရှိနိုင်သည်။
ဖြန့်ဝေထားသော လေ့ကျင့်မှုတွင် မတူညီသော parallelism ဗျူဟာများသည် checkpointing အပြုအမူကို သိသိသာသာ သက်ရောက်မှုရှိနိုင်သည်။ ဤ parallelism ဗျူဟာများသည် လေ့ကျင့်မှုအတွင်း checkpointing ဖြစ်ပေါ်သည့်အချိန်နှင့် မော်ဒယ်၏ မည်သည့်အစိတ်အပိုင်းကို checkpointing လုပ်နေသည်ကို သက်ရောက်မှုရှိသည်။ ခေတ်မီဖြန့်ဝေထားသော လေ့ကျင့်မှု setup များတွင် GPU များစွာသည် တူညီသော layer ၏ မတူညီသော အစိတ်အပိုင်းများကို တစ်ပြိုင်နက်တည်း ရေးသားနိုင်ပြီး ရှုပ်ထွေးသော I/O ပုံစံများကို ဖန်တီးနိုင်သည်။ ဤ parallel ရေးသားနိုင်စွမ်းသည် ထိရောက်မှုအတွက် အဓိကကျသော်လည်း ဂရုတစိုက် ညှိနှိုင်းမှုနှင့် ဒေတာ ညီညွတ်မှုကို ထိန်းသိမ်းနေစဉ်တွင် concurrent write လုပ်ဆောင်မှုများကို ကိုင်တွယ်နိုင်သော ခိုင်မာသော storage system များ လိုအပ်ပါသည်။ ဤလုပ်ငန်းစဉ်ရှိ မည်သည့်အတားအဆီးမဆို အလုံးစုံ လေ့ကျင့်မှု နှောင့်နှေးမှုများထဲသို့ စီးဝင်နိုင်သောကြောင့် storage system သည် ဤ concurrent writes ကို ထိရောက်စွာ စီမံခန့်ခွဲနိုင်ရမည်။
စစ်ဆေးရေးဂိတ်ကို သိုလှောင်မှုသို့ ရေးသားနေစဉ် လေ့ကျင့်ရေးလုပ်ငန်းစဉ်တစ်ခုလုံး ခေတ္တရပ်တန့်သွားသောကြောင့် လေ့ကျင့်ရေးအတားအဆီးများစွာကို ဖြစ်ပေါ်စေနိုင်သည်။ ဥပမာအားဖြင့်၊ ကြီးမားသော လေ့ကျင့်ရေးစနစ်တွင်၊ စစ်ဆေးရေးဂိတ်သည် နာရီအနည်းငယ်တိုင်း မိနစ် ၃၀ ကြာပါက လေ့ကျင့်ရေးကာလတစ်လျှောက်လုံးတွင် စုပေါင်း ရပ်တန့်ချိန် နာရီပေါင်းများစွာ ဖြစ်ပေါ်စေနိုင်သည်။ ၎င်းသည် လေ့ကျင့်ရေးထိရောက်မှုကို တိုက်ရိုက်အကျိုးသက်ရောက်ပြီး အထူးသဖြင့် ကွန်ပျူတာအရင်းအမြစ်များကို အချိန်အလိုက် ငွေတောင်းခံသည့် cloud ပတ်ဝန်းကျင်များတွင် လည်ပတ်မှုကုန်ကျစရိတ်များကို မြင့်တက်စေသည်။
စစ်ဆေးရေးဂိတ်များ ပိုမိုမြန်ဆန်လာခြင်းဖြင့် အဖွဲ့များသည် စစ်ဆေးရေးဂိတ်များကို ပိုမိုမကြာခဏ ဖန်တီးနိုင်ပြီး ပျက်ကွက်မှုများတွင် အများဆုံးဖြစ်နိုင်ခြေရှိသော ဒေတာဆုံးရှုံးမှုကို လျှော့ချပေးပါသည်။ ၎င်းသည် ပိုမိုတက်ကြွသော လေ့ကျင့်ရေးချဉ်းကပ်မှုများနှင့် ပိုမိုကောင်းမွန်သော စမ်းသပ်ထပ်ခါတလဲလဲလုပ်ဆောင်မှုစက်ဝန်းများကို ဖြစ်စေပါသည်။ ထို့အပြင်၊ စစ်ဆေးရေးဂိတ်တင်ချိန် မြန်ဆန်ခြင်းသည် သုတေသီများသည် အခြားနည်းလမ်းများကို စမ်းကြည့်ရန် ယခင်အခြေအနေများမှ ပိုမိုလွယ်ကူစွာ ပြန်လည်ရယူနိုင်သောကြောင့် မတူညီသော လေ့ကျင့်ရေးဖွဲ့စည်းပုံများနှင့် မော်ဒယ်ဗိသုကာများဖြင့် ပိုမိုမြန်ဆန်သော စမ်းသပ်မှုကို လွယ်ကူချောမွေ့စေပါသည်။
ဤစစ်ဆေးရေးဂိတ်လုပ်ဆောင်ချက်များကို ထိရောက်စွာကိုင်တွယ်နိုင်စွမ်းသည် လေ့ကျင့်ရေးအခြေခံအဆောက်အအုံတစ်ခုလုံးတွင် အဓိကအချက်တစ်ချက်ဖြစ်လာသည်။ စစ်ဆေးရေးဂိတ်၏ burst write ပုံစံများနှင့် လေ့ကျင့်ရေး၏ ရေရှည်ဖတ်ရှု/ရေးသားလုပ်ဆောင်ချက်နှစ်ခုလုံးကို စီမံခန့်ခွဲနိုင်သော မြင့်မားသောစွမ်းဆောင်ရည်ရှိသော သိုလှောင်မှုဖြေရှင်းချက်များသည် ဘာသာစကားကြီးများကို လေ့ကျင့်ခြင်း၏ စုစုပေါင်းအချိန်နှင့် ကုန်ကျစရိတ်ကို သိသိသာသာအကျိုးသက်ရောက်စေနိုင်သည်။ ထို့ကြောင့်၊ သိုလှောင်မှုခွဲစနစ်၏ စွမ်းဆောင်ရည်လက္ခဏာများ၊ အထူးသဖြင့် ကြီးမားသော အစဉ်လိုက်ရေးသားမှုများကို ကိုင်တွယ်ခြင်းနှင့် တသမတ်တည်းမြင့်မားသော bandwidth ကို ထိန်းသိမ်းခြင်းတို့သည် LLM လေ့ကျင့်ရေးအခြေခံအဆောက်အအုံကို ဒီဇိုင်းဆွဲရာတွင် အရေးကြီးသော ထည့်သွင်းစဉ်းစားရမည့်အချက်များဖြစ်သည်။
ဤအစီရင်ခံစာအတွက်၊ AI checkpointing အတွက် SSD စွမ်းဆောင်ရည်ကို ကျွန်ုပ်တို့ အကဲဖြတ်လိုခဲ့ပြီး၊ checkpoint မြန်နှုန်း အရေးကြီးသည့်အခါတွင် ဈေးကွက်ရှိ အကြီးဆုံး QLC SSD များနှင့် နှိုင်းယှဉ်ပါက နောက်ဆုံးပေါ် Gen5 SSD များ၏ အကျိုးကျေးဇူးများကို အကဲဖြတ်လိုခဲ့ပြီး၊ လေ့ကျင့်နေသော မော်ဒယ်အတွက် ပိုမိုအကျိုးရှိပါက checkpoint အများအပြားကို သိမ်းဆည်းနိုင်သည်။
Checkpoint စွမ်းဆောင်ရည် – DLIO ဖြင့် Benchmarking လုပ်ခြင်း
AI လေ့ကျင့်ရေးပတ်ဝန်းကျင်များတွင် Solidigm SSD ၏ လက်တွေ့ကမ္ဘာစွမ်းဆောင်ရည်ကို အကဲဖြတ်ရန်အတွက်၊ ကျွန်ုပ်တို့သည် Data and Learning Input/Output (DLIO) benchmark tool ကို အသုံးပြုခဲ့ပါသည် ။ Argonne National Laboratory မှ တီထွင်ထားသော DLIO ကို deep learning workloads များတွင် I/O ပုံစံများကို စမ်းသပ်ရန် အထူးဒီဇိုင်းထုတ်ထားပါသည်။ ၎င်းသည် storage system များသည် checkpointing၊ data ingestion နှင့် model training စိန်ခေါ်မှုများကို မည်သို့ကိုင်တွယ်ဖြေရှင်းသည်ဆိုသည့်အပေါ် ထိုးထွင်းသိမြင်မှုများကို ပေးစွမ်းသည်။
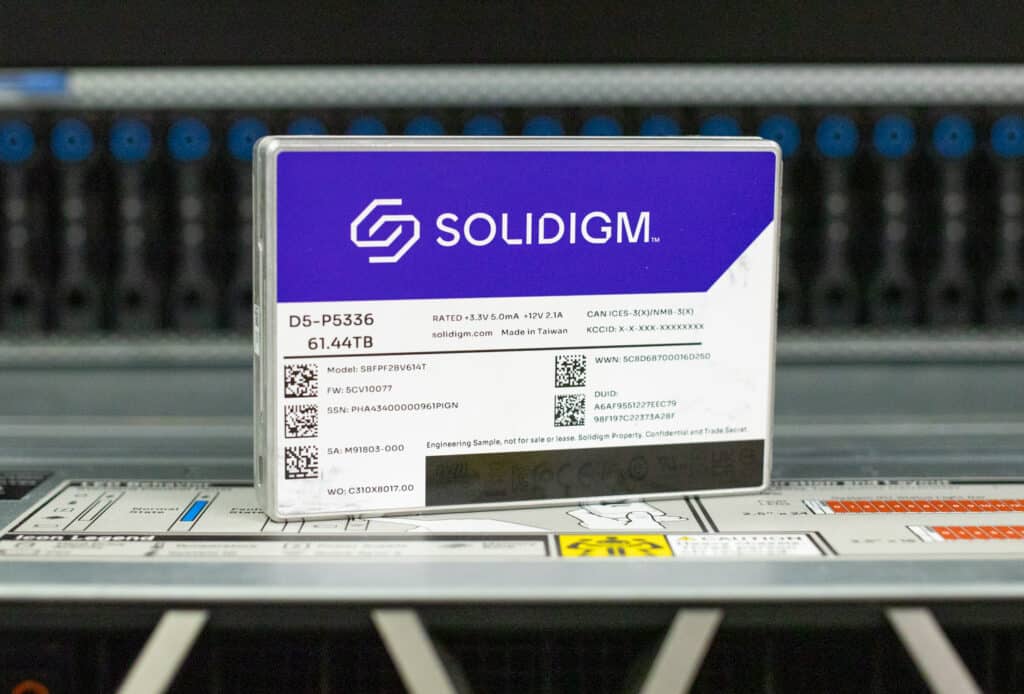
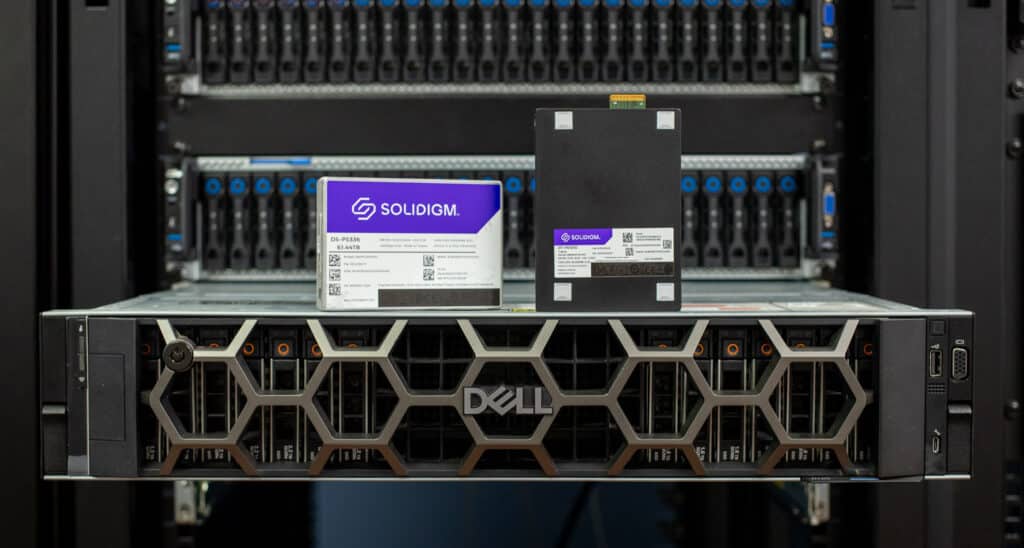
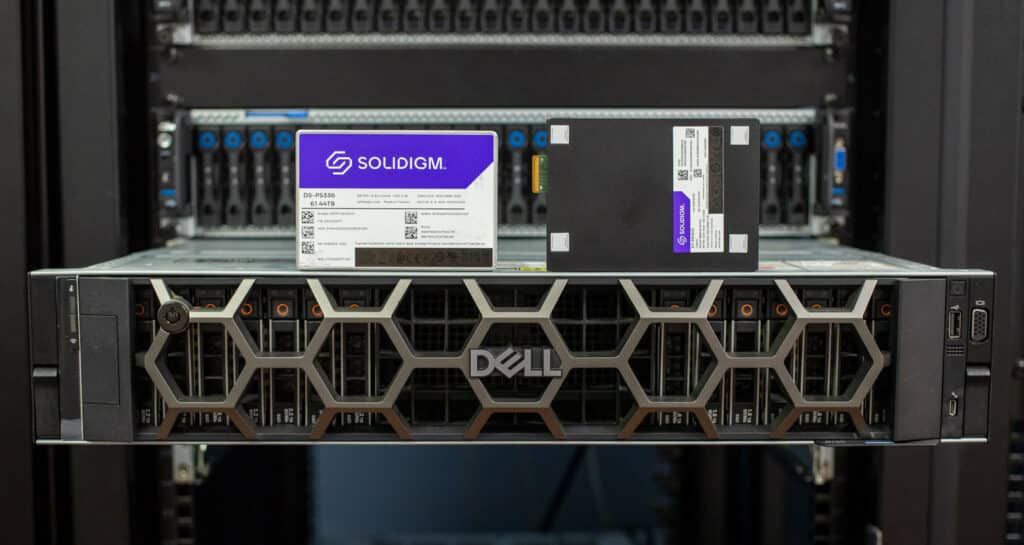
DLIO နှင့်အတူ လုပ်ဆောင်ခြင်းဖြင့်၊ ကျွန်ုပ်တို့သည် ပြင်းထန်သော checkpointing အခြေအနေများအောက်တွင် drive ၏ throughput၊ latency နှင့် ယုံကြည်စိတ်ချရမှုကို တိုင်းတာရန် ရည်ရွယ်ပါသည်။ ဤစမ်းသပ်မှုကို 61.44TB D5-P5336 တွင် ပြုလုပ်ခဲ့သော်လည်း၊ ကနဦးစွမ်းဆောင်ရည်ဒေတာအရ Solidigm D5-P5336 122TB ဗားရှင်းသည် အလားတူစွမ်းဆောင်ရည်ပရိုဖိုင်ကို ပေးဆောင်ကြောင်း ပြသခဲ့သည်။ ဤစမ်းသပ်မှုတွင် PCIe Gen5 ၏ အားသာချက်များကို ပြသရန် TLC-based D7-PS1010 မှ ရလဒ်များကိုလည်း ထည့်သွင်းထားပါသည်။ checkpoints များပေါ်ရှိ ထောင့်နှစ်ခုလုံးကို ပြသရန် ဤ drive နှစ်ခုကို ရွေးချယ်ခဲ့ပြီး တစ်ခုမှာ အမြန်ဆုံး checkpoint အချိန်ဖြစ်ပြီး နောက်တစ်ခုမှာ SSD တစ်ခုတည်းတွင် checkpoints အများဆုံးကို သိမ်းဆည်းထားသည်။
ဤလုပ်ငန်းအတွက် ရွေးချယ်ထားသော ပလက်ဖောင်းမှာ Ubuntu 22.04.02 LTS ကို အသုံးပြုထားသော ကျွန်ုပ်တို့၏ Dell PowerEdge R760 ဖြစ်သည်။ ကျွန်ုပ်တို့သည် ၂၀၂၄ ခုနှစ် ဩဂုတ်လ ၁၃ ရက်နေ့ထုတ် DLIO benchmark version 2.0 ကို အသုံးပြုခဲ့သည်။ ကျွန်ုပ်တို့၏ စနစ်ဖွဲ့စည်းပုံကို အောက်တွင်ဖော်ပြထားသည်-
- Intel Xeon Gold 6430 (32-Core, 2.1GHz) ၂ ခု
- 16 x 64GB DDR5-4400 မှတ်ဉာဏ်
- 480GB Dell BOSS SSD
- စီးရီးကြိုးများ Gen5 JBOF
- 7.68TB Solidigm D7-PS1010
- ၆၁.၄၄TB Solidigm D5-P5336
ကျွန်ုပ်တို့၏ benchmarking သည် လက်တွေ့ကမ္ဘာအခြေအနေများကို ထင်ဟပ်စေရန်အတွက်၊ ကျွန်ုပ်တို့၏ စမ်းသပ်မှုကို LLAMA 3.1 405B model architecture ပေါ်တွင် အခြေခံ၍ model parameters များ၊ optimizer states များနှင့် layer states များကို ဖမ်းယူရန် torch.save() မှတစ်ဆင့် checkpointing ကို အကောင်အထည်ဖော်ခဲ့သည်။ ကျွန်ုပ်တို့၏ setup သည် 8-GPU system တစ်ခုကို simulate လုပ်ခဲ့ပြီး 4-way tensor parallel နှင့် 2-way pipeline parallel processing ပါဝင်သော hybrid parallelism strategy ကို GPU ရှစ်ခုတွင် ဖြန့်ဝေထားသည်။ ဤ configuration သည် checkpoint sizes 1,636 GB ကို ရရှိစေခဲ့ပြီး ခေတ်မီ large language model training လိုအပ်ချက်များကို ကိုယ်စားပြုသည်။
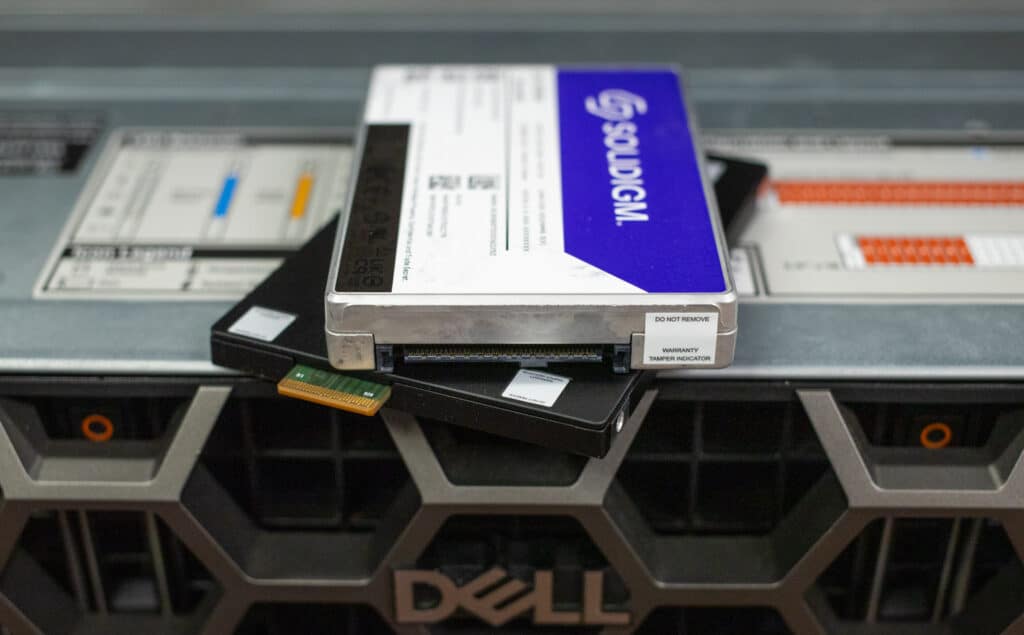
DLIO checkpoint workload အတွက် ကျွန်ုပ်တို့၏ စမ်းသပ်မှုလုပ်ငန်းစဉ်တွင် drive တစ်ခုစီကို အလားတူအသုံးပြုမှုအဆင့်အထိ ဖြည့်သွင်းခြင်းပါဝင်သည်။ 61.44TB Solidigm D5-P5336 အတွက်၊ pass တစ်ခုစီတွင် checkpoint intervals ၃၃ ခုပါဝင်ပြီး စုစုပေါင်း 54TB ရှိသည်။ ပိုသေးငယ်သော 7.68TB D7-PS1010 သည် checkpoint intervals သုံးခုကို အဆင်ပြေစွာ ဆန့်နိုင်ပြီး စုစုပေါင်း footprint 4.9TB ရှိသည်။ နောက်ထပ် checkpoint တစ်ခုသည် D7-PS1010 တွင် ဆန့်နိုင်သော်လည်း ၎င်း၏အသုံးပြုမှုကို ကျွန်ုပ်တို့လိုချင်သည်ထက် အနည်းငယ်ပိုမိုမြင့်မားစေပါသည်။
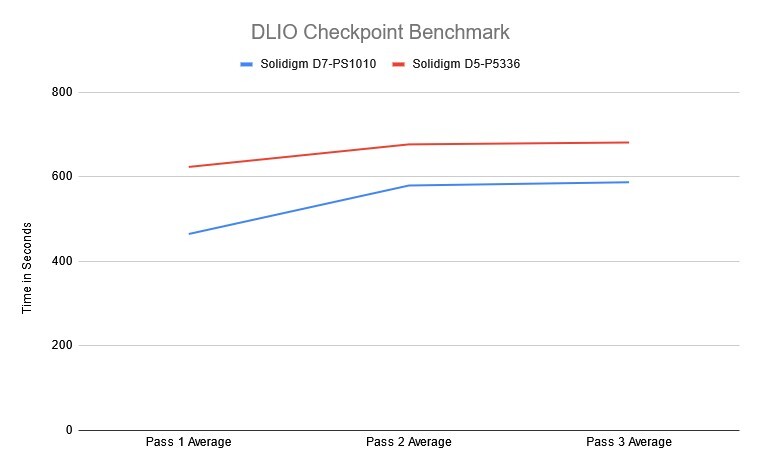
Gen4 QLC-based 61.44TB D5-P5536 ကို Gen5 TLC-based 7.68TB D7-PS1010 နှင့် နှိုင်းယှဉ်သောအခါ DLIO checkpoint workload သည် စိတ်ဝင်စားဖွယ်ရလဒ်များကို ရရှိခဲ့သည်။ ပထမအကြိမ် pass တွင် drive များပြည့်သွားသည်နှင့်အမျှ SSD မော်ဒယ်နှစ်ခုကြား စွမ်းဆောင်ရည်ကွာဟချက် ပိုမိုကျယ်ပြန့်လာသည်ကို ကျွန်ုပ်တို့တွေ့မြင်ခဲ့ရသည်။ Gen4 P5336 မှ 623 စက္ကန့်နှင့် နှိုင်းယှဉ်ပါက ပိုမိုမြန်ဆန်သော Gen5 PS1010 သည် checkpoint တစ်ခုချင်းစီကို ပျမ်းမျှအားဖြင့် 464 စက္ကန့်အတွင်း ပြီးမြောက်ခဲ့သည်။ ဒုတိယနှင့် တတိယအကြိမ်တွင် PS1010 အတွက် 579 စက္ကန့်နှင့် 587 စက္ကန့်နှင့် P5336 အတွက် 676 စက္ကန့်နှင့် 680 စက္ကန့်အထိ ကျဉ်းမြောင်းသွားခဲ့သည်။
စစ်ဆေးရေးဂိတ်ကြားကာလများတွင် အနည်းဆုံးကွာဟချက်ရှိလိုသော စီးပွားရေးလုပ်ငန်းများအတွက်၊ TLC-based Gen5 PS1010 သည် အမြန်ဆုံးပြီးစီးချိန်တွင် အားသာချက်ကို ပေးစွမ်းသည်။ ရည်မှန်းချက်မှာ စစ်ဆေးရေးဂိတ်များစွာကို ကုန်ကျစရိတ်သက်သာစွာ ထိန်းသိမ်းထားရန်ဖြစ်ပါက၊ QLC-based Gen4 P5336 သည် ထိုသို့ပြုလုပ်နိုင်သည်။ ဒုတိယနှင့် တတိယအဆင့်များတွင် မောင်းနှင်မှုနှစ်ခုလုံးအကြား ပျမ်းမျှစစ်ဆေးရေးဂိတ်အချိန် ၁၇% အောက်ကွာခြားချက်ကို ကျွန်ုပ်တို့တိုင်းတာခဲ့သည်။
GPUDirect သိုလှောင်မှု Bandwidth
DLIO သည် AI workflow တွင် flash စွမ်းဆောင်ရည်ကို ပြသသော်လည်း၊ checkpoint တစ်ခုကို ပြန်လည်ရရှိသည်အထိ workload သည် write-based အပြည့်အဝဖြစ်သည်။ AI workloads များတွင် Solidigm D7-PS1010 နှင့် D5-P5336 ၏ အပြည့်အဝပုံရိပ်ကို ပုံဖော်ရန်အတွက် GDSIO ကို အသုံးပြု၍ read bandwidth တိုင်းတာမှုများကို ထည့်သွင်းထားသည်။
GPU Direct Storage ဘယ်လိုအလုပ်လုပ်လဲ
ရိုးရာအစဉ်အလာအရ GPU တစ်ခုက NVMe drive မှာသိမ်းဆည်းထားတဲ့ဒေတာတွေကို စီမံဆောင်ရွက်တဲ့အခါ ဒေတာဟာ GPU ဆီကိုမရောက်ခင် CPU နဲ့ system memory ကနေတစ်ဆင့် ဦးစွာဖြတ်သန်းသွားရပါမယ်။ ဒီလုပ်ငန်းစဉ်က CPU ဟာ ကြားခံတစ်ခုဖြစ်လာတာကြောင့် နှောင့်နှေးမှုကို တိုးစေပြီး အဖိုးတန် system resource တွေကို သုံးစွဲတာကြောင့် ပိတ်ဆို့မှုတွေကို ဖြစ်ပေါ်စေပါလိမ့်မယ်။ GPU Direct Storage က GPU ကို PCIe bus မှတစ်ဆင့် storage device ကနေ တိုက်ရိုက်ဒေတာတွေကို ရယူနိုင်အောင် လုပ်ပေးခြင်းအားဖြင့် ဒီထိရောက်မှုမရှိခြင်းကို ဖယ်ရှားပေးပါတယ်။ ဒီတိုက်ရိုက်လမ်းကြောင်းက ဒေတာရွှေ့ပြောင်းမှုနဲ့ဆက်စပ်တဲ့ overhead ကို လျော့ကျစေပြီး ဒေတာလွှဲပြောင်းမှုတွေကို ပိုမိုမြန်ဆန်ထိရောက်စေပါတယ်။
AI workloads များ၊ အထူးသဖြင့် deep learning ပါဝင်သည့် workloads များသည် data များစွာအသုံးပြုရပါသည်။ ကြီးမားသော neural network များကို လေ့ကျင့်ပေးရန်အတွက် data terabytes များကို processing လုပ်ရန် လိုအပ်ပြီး data transfer နှောင့်နှေးမှုတစ်စုံတစ်ရာသည် GPU များကို အသုံးမချနိုင်ခြင်းနှင့် လေ့ကျင့်ချိန်ပိုကြာခြင်းတို့ ဖြစ်စေနိုင်ပါသည်။ GPU Direct Storage သည် data ကို GPU သို့ အမြန်ဆုံးပေးပို့ခြင်း၊ အားလပ်ချိန်ကို အနည်းဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းနှင့် တွက်ချက်မှုစွမ်းဆောင်ရည်ကို အမြင့်ဆုံးဖြစ်အောင်ပြုလုပ်ခြင်းဖြင့် ဤစိန်ခေါ်မှုကို ဖြေရှင်းပေးပါသည်။
DLIO စမ်းသပ်မှုကဲ့သို့ပင်၊ ရည်မှန်းချက်မှာ မြန်နှုန်းမြင့် Gen5 SSD များနှင့် စွမ်းရည်မြင့် QLC drive များအကြား ကွာခြားချက်များကို ပိုမိုနားလည်ပြီး လက္ခဏာရပ်ဖော်ပြရန်ဖြစ်သည်။ AI workload တိုင်းသည် အတူတူပင်မဟုတ်ပါ၊ drive တစ်ခုချင်းစီသည် လိုအပ်ချက်ပေါ် မူတည်၍ ကွဲပြားသော အားသာချက်များကို ပေးဆောင်သည်။
စမ်းသပ်ခြင်း Configuration Matrix
ကျွန်ုပ်တို့၏ စမ်းသပ်ပလက်ဖောင်းတွင် NVIDIA L4 ဖြင့် အောက်ပါ parameters များ၏ ပေါင်းစပ်မှုတိုင်းကို စနစ်တကျ စမ်းသပ်ခဲ့ပါသည်။
- ဘလောက်အရွယ်အစားများ: 1M၊ 128K၊ 64K၊ 16K၊ 8K
- ချည်အရေအတွက်: ၁၂၈၊ ၆၄၊ ၃၂၊ ၁၆၊ ၈၊ ၄၊ ၁
- အလုပ်အကိုင်အရေအတွက်: ၁၆
- အသုတ်အရွယ်အစားများ: ၁၆
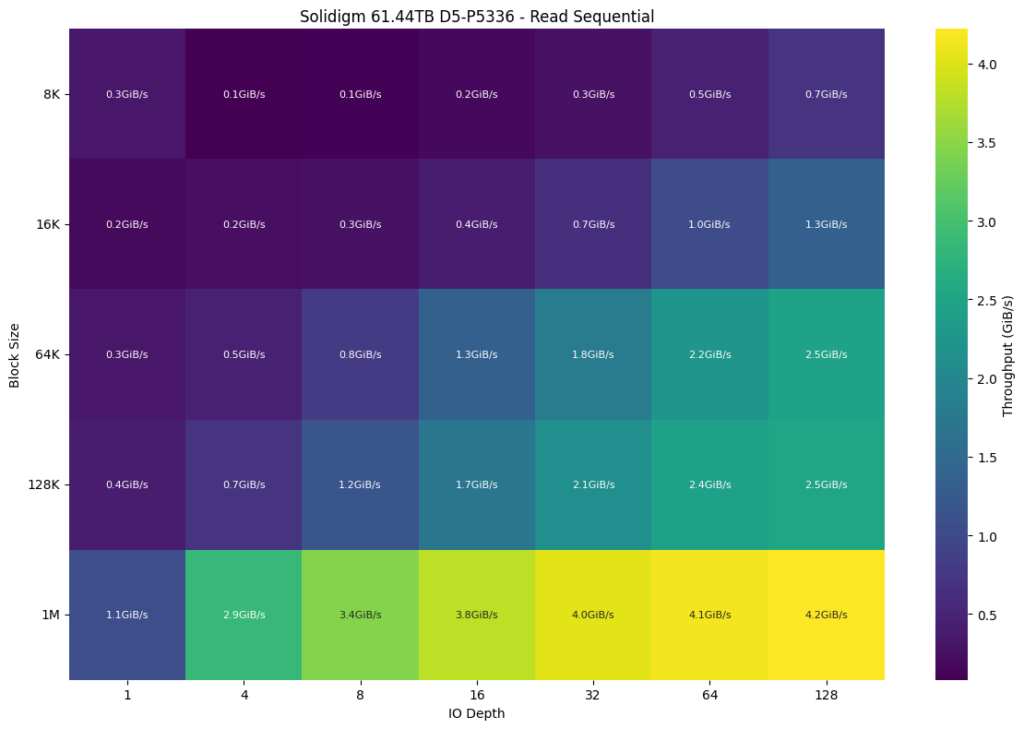
ကျွန်ုပ်တို့ ပထမဆုံးကြည့်ရှုခဲ့တာက QLC-based D5-P5336 ဖြစ်ပြီး IO depth 128 မှာ 1M transfer size ကို အသုံးပြုပြီး 4.2GiB/s အထိ အမြင့်ဆုံးရောက်ရှိခဲ့ပါတယ်။ block size တွေရဲ့ အကျိုးသက်ရောက်မှုက bandwidth ကို သိသိသာသာ မြှင့်တင်ပေးခဲ့ပြီး 8K ကနေ 1M အထိ မြင့်တက်လာခဲ့ပါတယ်။ IO depth တိုးလာခြင်းရဲ့ အားသာချက်က 32 မှာ တဖြည်းဖြည်း လျော့နည်းလာပြီး workload တွေ တည်ငြိမ်လာပါတယ်။
နောက်တစ်ခုအနေနဲ့ Gen5 PS-1010 ကို ကြည့်ကြရအောင်။ 1M block size နဲ့ IO depth 128 မှာ 6.2GiB/s အထိ ချဲ့ထွင်နိုင်ပါတယ်။ အလုံးစုံပြောရရင် Gen4-based P5336 ထက် စွမ်းဆောင်ရည်ပိုကောင်းပြီး အထူးသဖြင့် workload တွေက သိသိသာသာ မြှင့်တင်ပေးခဲ့ပါတယ်။ ထင်ရှားတဲ့ တိုးတက်မှုတစ်ခုကတော့ 128K blocksize မှာ ရှိပြီး IO depth 64 နဲ့ 128 မှာ PS1010 က P5336 ရဲ့ read bandwidth နှစ်ဆပိုပေးစွမ်းနိုင်တဲ့ စွမ်းဆောင်ရည်ပါ။
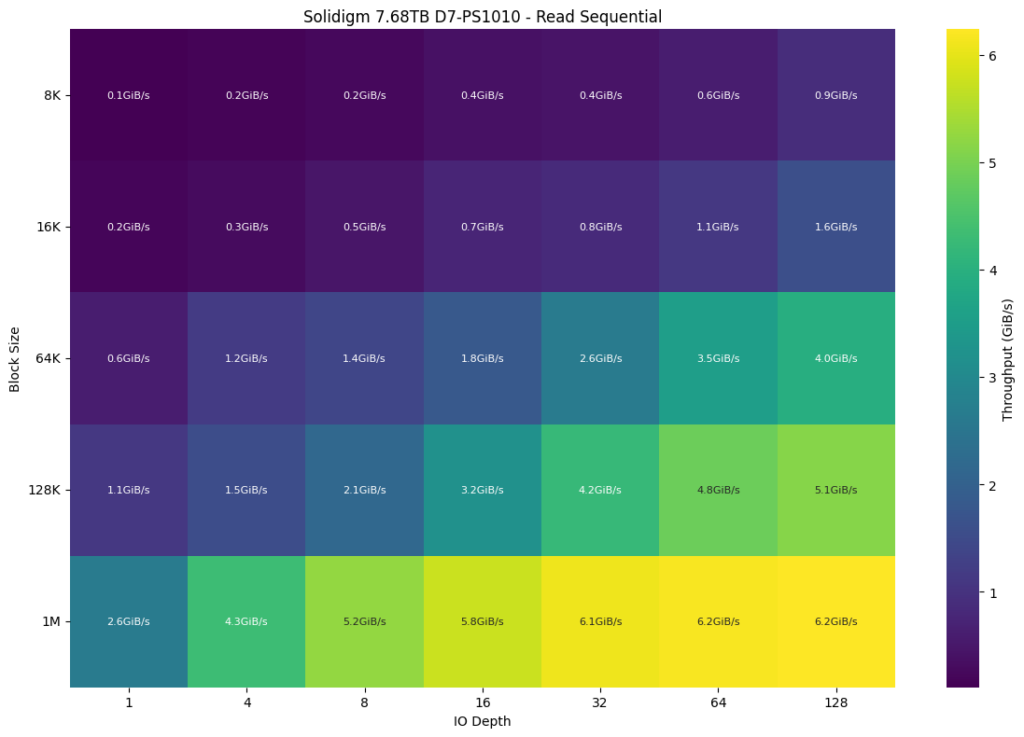
SSD နှစ်ခုစလုံးကို NVIDIA L4 ကို အသုံးပြု၍ စမ်းသပ်ထားကြောင်း သတိပြုရန် အရေးကြီးပါသည်။ Gen4 D5-P5336 သည် ၎င်း၏ အမြင့်ဆုံးအဆင့် သို့မဟုတ် အနီးတွင် ရှိနေပြီး၊ H100 ကဲ့သို့သော မော်ဒယ်မြင့် NVIDIA GPU များသည် D7-PS1010 ဖြင့် ပိုမိုမြင့်မားသော စွမ်းဆောင်ရည်ကို ပြသခဲ့သည်။ drive ၏ အမြန်နှုန်းသည် အချို့သော ဖောက်သည်များအတွက် အဓိက ဆုံးဖြတ်ချက်ချသည့်အချက်ဖြစ်ပြီး အချို့မှာ overall density ကို ဦးစားပေးသည်။ Solidigm သည် ၎င်း၏ QLC နှင့် TLC SSD ကမ်းလှမ်းချက်များ ဖြင့် နှစ်မျိုးလုံး အတွက် ဖြေရှင်းချက်များကို ပေးပါသည် ။
ကောက်ချက်
AI လေ့ကျင့်မှု၏ စကေးနှင့် ရှုပ်ထွေးမှုများ ဆက်လက်တိုးပွားလာသည်နှင့်အမျှ၊ အခြေခံသိုလှောင်မှု အခြေခံအဆောက်အအုံသည် အရှိန်အဟုန်ကို လိုက်မီရုံသာမက အရှိန်အဟုန်ကိုလည်း သတ်မှတ်ပေးရမည်။ အလွန်ကွဲပြားသော SSD နှစ်ခုဖြင့် ကျွန်ုပ်တို့၏ စမ်းသပ်မှုများသည် သိုလှောင်မှုဖြေရှင်းချက်များကို သီးခြားလေ့ကျင့်ရေး ဦးစားပေးမှုများနှင့် ချိန်ညှိခြင်း၏ အရေးပါမှုကို သရုပ်ပြသည်၊ ဥပမာ checkpoint latency ကို လျှော့ချခြင်း သို့မဟုတ် ကုန်ကျစရိတ်သက်သာသော တိုးချဲ့နိုင်မှုအတွက် checkpoint density ကို အမြင့်ဆုံးဖြစ်စေခြင်း။
ကျွန်ုပ်တို့၏ အကဲဖြတ်ချက်တွင်၊ Solidigm D5-P5336 (61.44TB) နှင့် D7-PS1010 (7.68TB) တို့ကို DLIO benchmark နှင့် ကျယ်ပြန့်သော hybrid-parallel LLM checkpointing workflow ကို အသုံးပြု၍ လက်တွေ့ကျသော AI လေ့ကျင့်ရေးအခြေအနေများအောက်တွင် စမ်းသပ်ခဲ့ပါသည်။ Gen4 QLC-based D5-P5336 နှင့် Gen5 TLC-based D7-PS1010 အကြား ပြီးစီးချိန်ကွာခြားချက်များကို မီးမောင်းထိုးပြသည့် drive များပြည့်သွားသည်နှင့်အမျှ များစွာသော run များတွင် checkpoint write စွမ်းဆောင်ရည်ကို ထင်ဟပ်စေသော metrics များကို ကျွန်ုပ်တို့ ဖမ်းယူခဲ့ပါသည်။
D7-PS1010 သည် အမြန်ဆုံး checkpoint writes များကို ပေးပို့နိုင်သော်လည်း D5-P5336 သည် ဆွဲဆောင်မှုရှိသော ကုန်ကျစရိတ်သက်သာမှုနှင့် စွမ်းဆောင်ရည်အားသာချက်များကို စွမ်းဆောင်ရည်အနည်းငယ်သာ ထိခိုက်စေကြောင်း ပြသခဲ့သည်။ NVIDIA L4 GPU မှတစ်ဆင့် GDSIO ပါရှိသော GPU Direct Storage read bandwidths များကို ကျွန်ုပ်တို့ ထပ်မံစစ်ဆေးခဲ့ပါသည်။ Solidigm D5-P5336 သည် 1M transfer size ဖြင့် 4.2GiB/s အထိ read bandwidth ပေးစွမ်းနိုင်ခဲ့ပြီး D7-PS1010 သည် 6.2GiB/s အထိ သိသိသာသာ မြှင့်တင်ပေးနိုင်ကြောင်း ကျွန်ုပ်တို့ တွေ့ရှိခဲ့ပါသည်။ NVIDIA L40s သို့မဟုတ် H100/H200 ကဲ့သို့သော GPU ပိုကြီးသော ကတ်ကို အသုံးပြုခြင်းဖြင့် ပိုမိုအားကောင်းသော စွမ်းဆောင်ရည်ကို သင်တွေ့မြင်ရမည်ဖြစ်သည်။
ရှေ့ကိုမျှော်ကြည့်လျှင် Solidigm D5-P5336 122TB SSD ၏ မကြုံစဖူးစွမ်းရည်သည် AI လေ့ကျင့်မှုနှင့် ဖြန့်ကျက်မှုကို ပြန်လည်ပုံဖော်ရန် အသင့်ရှိနေပါသည်။ မော်ဒယ်အရွယ်အစားများနှင့် checkpointing လိုအပ်ချက်များ ဆက်လက်မြင့်တက်လာသည်နှင့်အမျှ ဤကြီးမားသော drive များသည် ထိရောက်မှုနှင့် ပြောင်းလွယ်ပြင်လွယ်ရှိမှုအဆင့်အသစ်များသို့ တံခါးဖွင့်ပေးပြီး ယခင်က လက်လှမ်းမမီခဲ့သော လေ့ကျင့်ရေးဗျူဟာများကို ဖြစ်ပေါ်စေပါသည်။ Solidigm ၏ စွမ်းရည်မြင့် SSD ဖြေရှင်းချက်များတွင် ဦးဆောင်မှုသည် အဖွဲ့အစည်းများအား drive နည်းပါးသောနေရာတွင် data နှင့် checkpoints များကို ပိုမိုသိမ်းဆည်းနိုင်စေပြီး AI ရှုပ်ထွေးမှု၏ နောက်ထပ်လှိုင်းမှ ၎င်းတို့၏ အခြေခံအဆောက်အအုံများကို အနာဂတ်တွင် ခံနိုင်ရည်ရှိစေရန် ကူညီပေးပါသည်။
ဤအစီရင်ခံစာကို Solidigm မှ ကမကထပြုပါသည်။ ဤအစီရင်ခံစာတွင် ဖော်ပြထားသော အမြင်များနှင့် ထင်မြင်ယူဆချက်အားလုံးသည် ထည့်သွင်းစဉ်းစားနေသော ထုတ်ကုန်(များ)အပေါ် ကျွန်ုပ်တို့၏ ဘက်မလိုက်သော အမြင်ပေါ်တွင် အခြေခံထားပါသည်။


 အမေဇုံ